多言語OCRが間違った言語を
読み取る理由 — 3つの根本原因と修正策
ドキュメントをOCRツールに入力すると、技術的には読めるが間違ったテキストが返ってくることがあります。ドイツ語の請求書では「Rechnung」が「Rechnung」(正しい)と出力されるのに、「Geschäftsführer」が「Geschaftsfuhrer」になってしまう — ウムラウトが消えてしまいました。漢字と英語が混在する日本語の注文書では、「注文書」が簡体字中国語の文字化けとして返されます。あなたはすべて正しくやっていました:画像は鮮明で、コントラストも良く、解像度も十分でした。問題は画像の品質ではありません。言語検出なのです。
重要なポイント
- OCRの出力は技術的に読めるのに完全に間違っていることがあります — イタリア語の€1,250の請求書が、エンジンがイタリア語ドキュメントに英語の数値形式を適用したため€1.25になってしまいます。
- 失敗の原因は文字認識より上流にあります:ほとんどのツールは単語を1つも読む前にページの言語を決定し、選択された言語に一致しない文字はすべて静かに劣化します。
- 検出を修正するのではなくアーキテクチャを修正しましょう — 言語選択のステップなしでドキュメントを視覚的に読むツールは、言語パックを追加してパッチを当てるのではなく、言語検出の問題を根本的に排除します。
OCRの言語検出は単純に聞こえます。最初の数語をスキャンし、言語を推測し、適切な認識モデルを適用するだけです。実際には、予測可能な方法で失敗し、時間を浪費し、一見正しく見えるが詳細が間違っている出力を生成します。そして、複数の言語を含む文書を扱っている場合(グローバル化したビジネスでは、ほとんどの文書が該当します)、失敗率は急上昇します。
この記事では、OCRの言語検出が失敗する3つの具体的なパターンを解説します。どのパターンがあなたの問題の原因かを診断し、実際に有効な修正方法を知ることができます。
原因1: 自動検出が文書全体に対して1つの言語を選択する
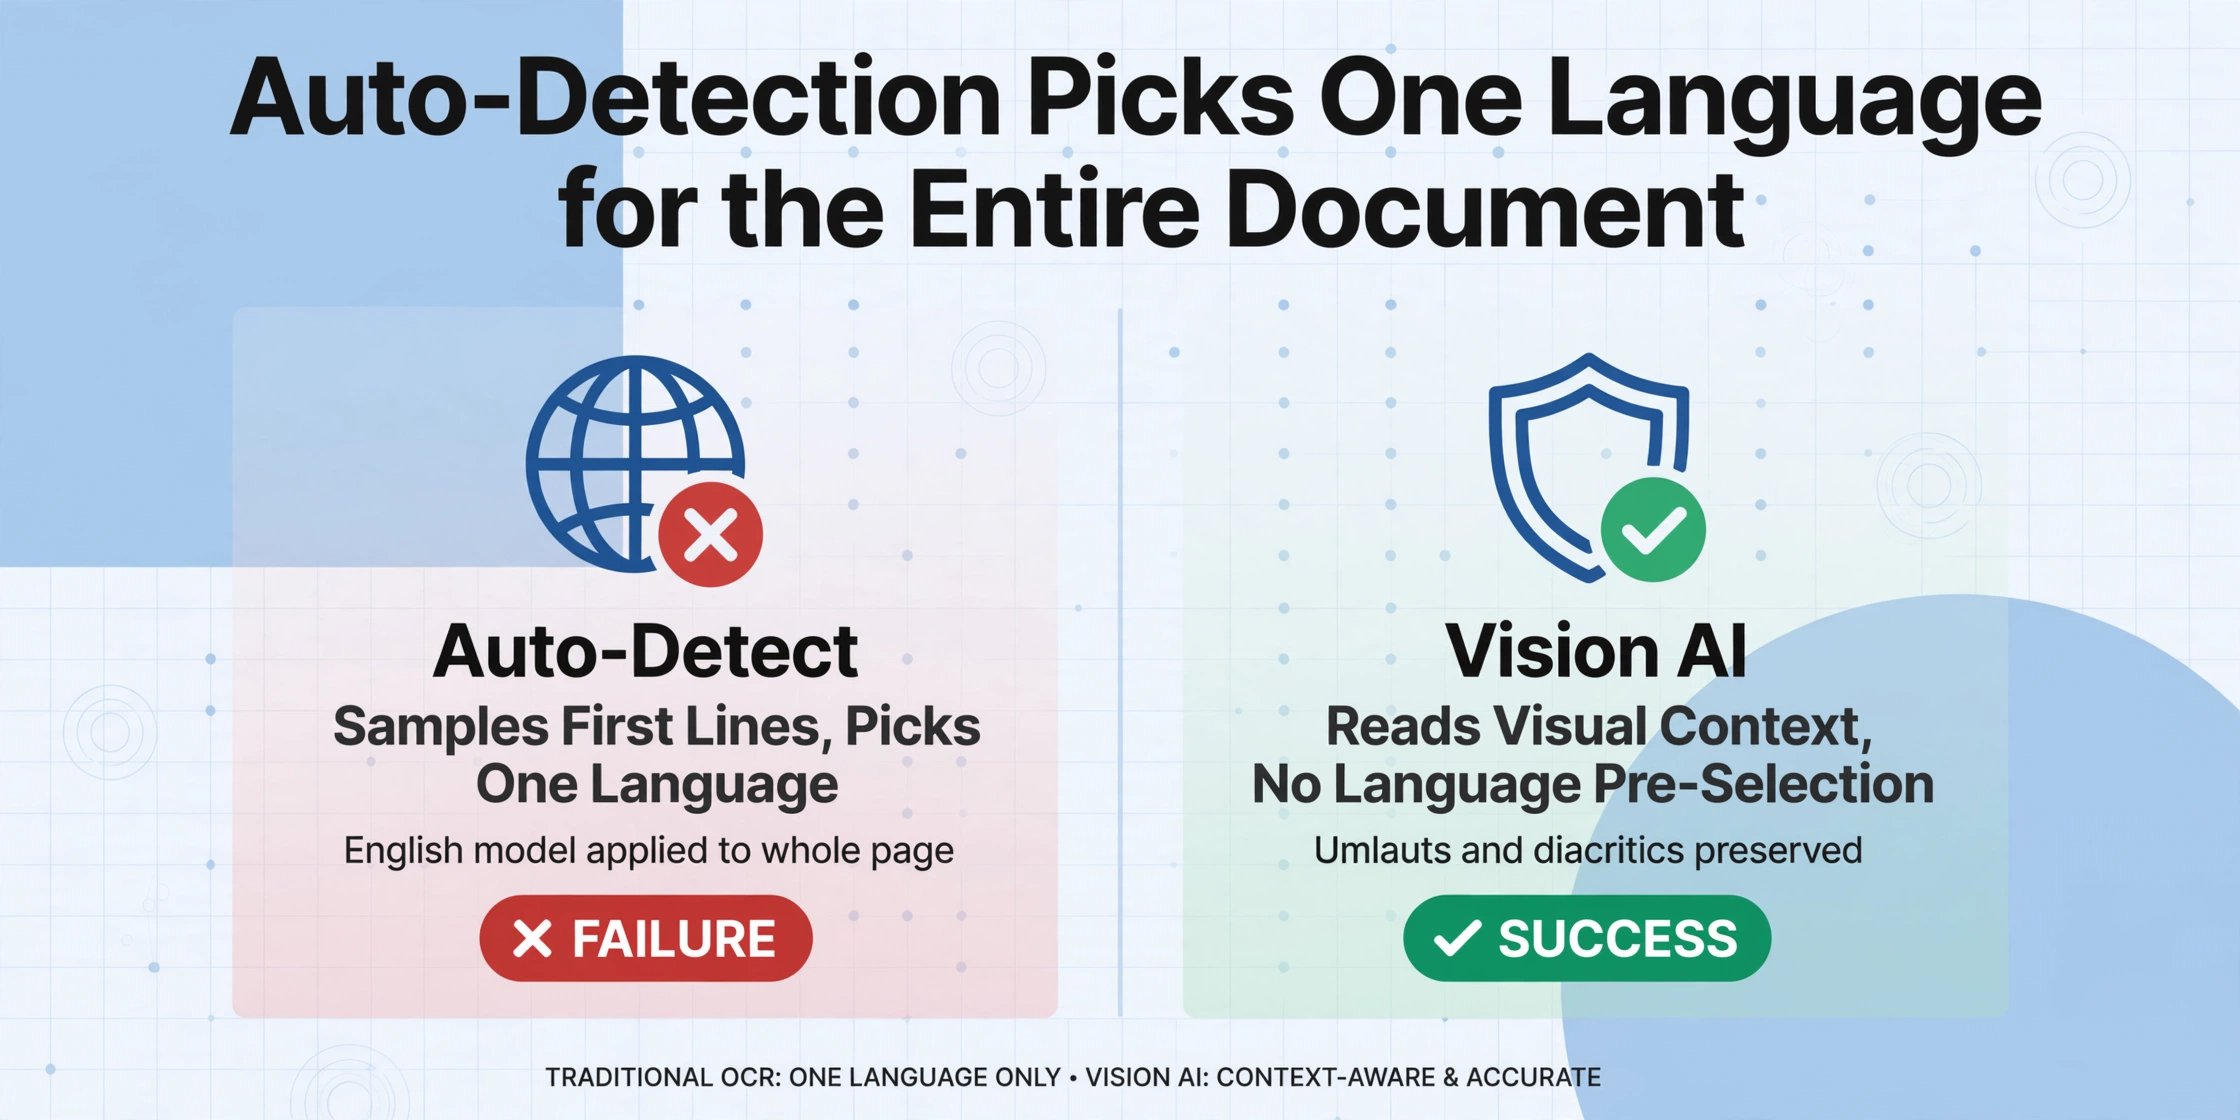
最も一般的なOCR言語検出の問題は、OCRエンジンが1文字も読み取る前に発生します。ほとんどの従来型OCRツールは、文書の最初の数行または数段落をサンプリングし、言語識別アルゴリズム(通常はfastTextやlangdetectなど)を実行して、ページ全体で最も可能性の高い言語を選択する自動検出ステップを使用します。その後、文書全体をその単一言語でトレーニングされた認識モデルにルーティングします。
これは文書が単一言語の場合には問題なく機能します。文書が1つの言語で始まり別の言語に切り替わる場合、または見出しの言語が本文の言語と一致しない場合には、すぐに失敗します。
実例
英語の会社ヘッダー付きのドイツ語請求書:「GlobalTech Solutions Inc. — Rechnungsnummer: 2024-0871 — Lieferdatum: 15. März 2024 — Geschäftsführer: Dr. Müller」。自動検出は上部の「GlobalTech Solutions Inc.」を読み取り、英語を選択します。文書全体が英語の言語モデルで処理されます。結果:「Geschäftsführer」は「Geschaftsfuhrer」、「März」は「Marz」、「Straße」は「Strasse」になります。読めないわけではありませんが、正しくもありません。英語モデルにはこれらの文字の辞書エントリがないため、ウムラウトは静かに削除されます。
同じ問題は、発音区別記号を持つあらゆる言語に影響します。フランス語(élève → eleve)、スペイン語(año → ano)、ポルトガル語(çが削除)、ポーランド語(ł → l)。文字はページ上に視覚的に存在しますが、認識モデルはそれらを想定していないため、最も近いASCII相当にマッピングするか、完全に削除します。
これはOCRエンジンの「バグ」ではありません。これは設計上の前提です。従来のOCRパイプラインは、ページごとに1つの言語という考え方に基づいて構築されています。その前提が崩れると、画像が悪いからではなく、エンジンがドイツ語の辞書でフランス語の単語をデコードしようとしているために、精度が低下します。
原因2: スクリプト混同 — 見た目は似ていても意味が異なる文字
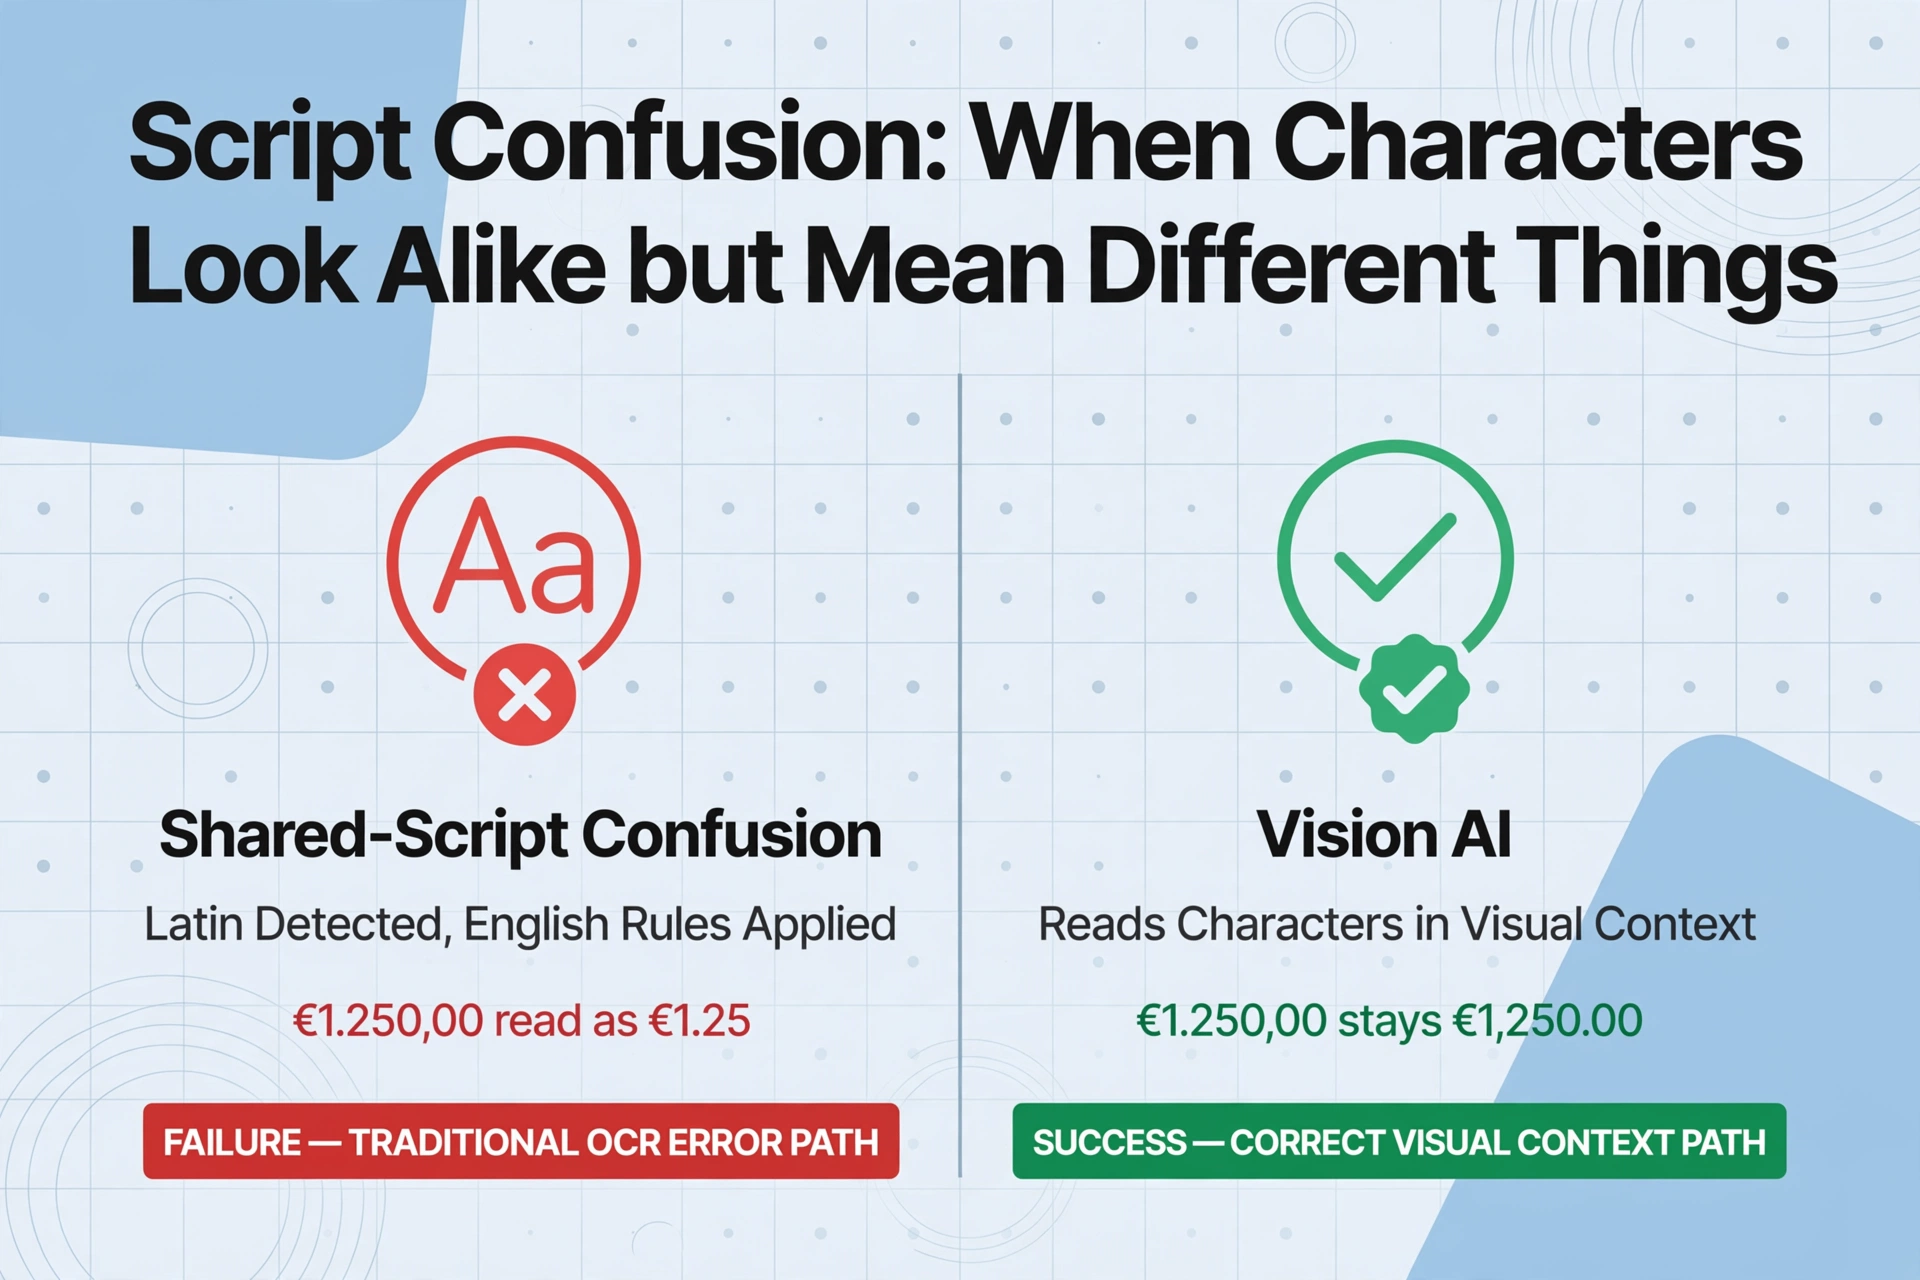
より難しい言語検出の失敗は、スクリプト(文字体系)が複数の言語で共有されている場合や、2つのスクリプトが視覚的に重なる文字を持つ場合に発生します。自動検出はスクリプト自体(ラテン文字、漢字(CJK)、キリル文字)は正しく識別しますが、そのスクリプトファミリー内で誤った言語を選択してしまいます。
共有スクリプトの問題
ラテン文字は、英語、フランス語、ドイツ語、スペイン語、イタリア語、ポルトガル語、オランダ語、スウェーデン語、ノルウェー語など、数十の言語で共有されています。OCRエンジンがラテン文字を検出し、ほとんどのツールのデフォルト言語である英語を自動選択すると、フランス語のアクサンテギュ、ドイツ語のウムラウト、スペイン語のティルデがすべて問題になります。エンジンは文字を読み取ることはできますが、後処理の辞書が英語の綴りルールを適用するため、正しい外国語の単語が英語に「修正」されてしまいます。
実例
イタリアのサプライヤーが「Fattura — Importo: € 1.250,00 — Spedizione: via Roma, 15」という文書を送ってきました。英語として検出されます。OCRエンジンは「1.250,00」のカンマを桁区切りではなく小数点として読み取ります — 英語では小数点にピリオド、桁区切りにカンマを使うのに対し、イタリア語ではその逆だからです。結果として、€1.250,00(1,250ユーロ)が€1.25(1ユーロ25セント)として出力されます。これは読み取りエラーではなく、誤った言語モデルによって引き起こされた形式解釈エラーです。
CJK文字の混同:漢字、漢字、漢字
最も厄介な文字の混同は東アジアの言語で発生します。中国語、日本語、韓国語はすべて中国由来の文字(中国語では漢字、日本語では漢字、韓国語では漢字)を使用しており、多くの個別の文字が3言語すべてで共有されています。日本語の文書は、簡体字中国語の文字と視覚的に一致する漢字を使用しますが、意味、読み方、文脈はまったく異なります。
OCRエンジンが日本語の文書に対して「中国語」を自動検出すると(漢字と漢字が大きく重複するため、これは日常的に発生します)、出力は技術的には読めますが、言語学的には間違っています。エンジンは日本語で書かれたテキストに中国語の文字モデルと辞書バイアスを適用します。日本語の読み方である訓読みや音読みで読まれるべき単語が、中国語の発音になります。ひらがなとカタカナが漢字に混在する日本語のコンテンツは、エンジンがどの文字体系を優先すべきか分からないため、検出をさらに混乱させます。
従来のOCRはこれを二者択一として扱います。ページは中国語か日本語かのどちらかです。「このページは両方である」という概念はありません。簡体字中国語のテキストと英語の製品コードが混在する文書、または日本語の本文と英語の外来語が混在する文書は、正しい解釈と誤った解釈の間で予測不能に切り替わる言語モデルを引き起こします。
原因3:多言語文書が「1ページ1言語」の前提を壊す
最も難しいケース、そして国際ビジネスで最も一般的なケースは、検出の曖昧さではなく、設計上、単一の文書に実際に2つ以上の言語が含まれている場合です。
英語の条項見出しとフランス語の本文で書かれた多国籍契約書を考えてみてください。または、発送元の住所が日本語、宛先が英語、税関申告書が現地語で書かれた配送ラベル。または、スイスのクリニックの医療記録で、受付フォームがドイツ語、検査結果がフランス語、診断サマリーが英語で書かれている場合。これらは特殊なケースではなく、グローバルな運用における日常的な文書です。
従来のOCRは、文書レベルで1つの言語を選択し、それを一律に適用し、一致しないすべてのセグメントで精度の低下を受け入れることで、これらの文書を処理します。その結果、一部のセクションは完璧に見え、他のセクションはまったく別のツールで処理されたように見える出力になります。なぜなら、ある意味では、そうなる運命だったからです。
「多言語モード」をサポートするツールでも、多くの場合、言語モデルを順番に連鎖させることで実現しています。最初に英語、次にフランス語、次にドイツ語を試し、行ごとに最も高い信頼度の結果を採用します。これは実際にはうまく機能しません。異なる言語の隣接する行が互いに影響を与え、信頼度スコアリング自体が言語に依存するためです。英語でトレーニングされたモデルは、トレーニングデータが少ない言語でトレーニングされたモデルよりも、それぞれの言語を正しく読んでいる場合でも、英語のテキストに対して本質的に高い信頼度を持ちます。
ビジョンAIが従来と違う点 — そして、それがなぜ状況を変えるのか
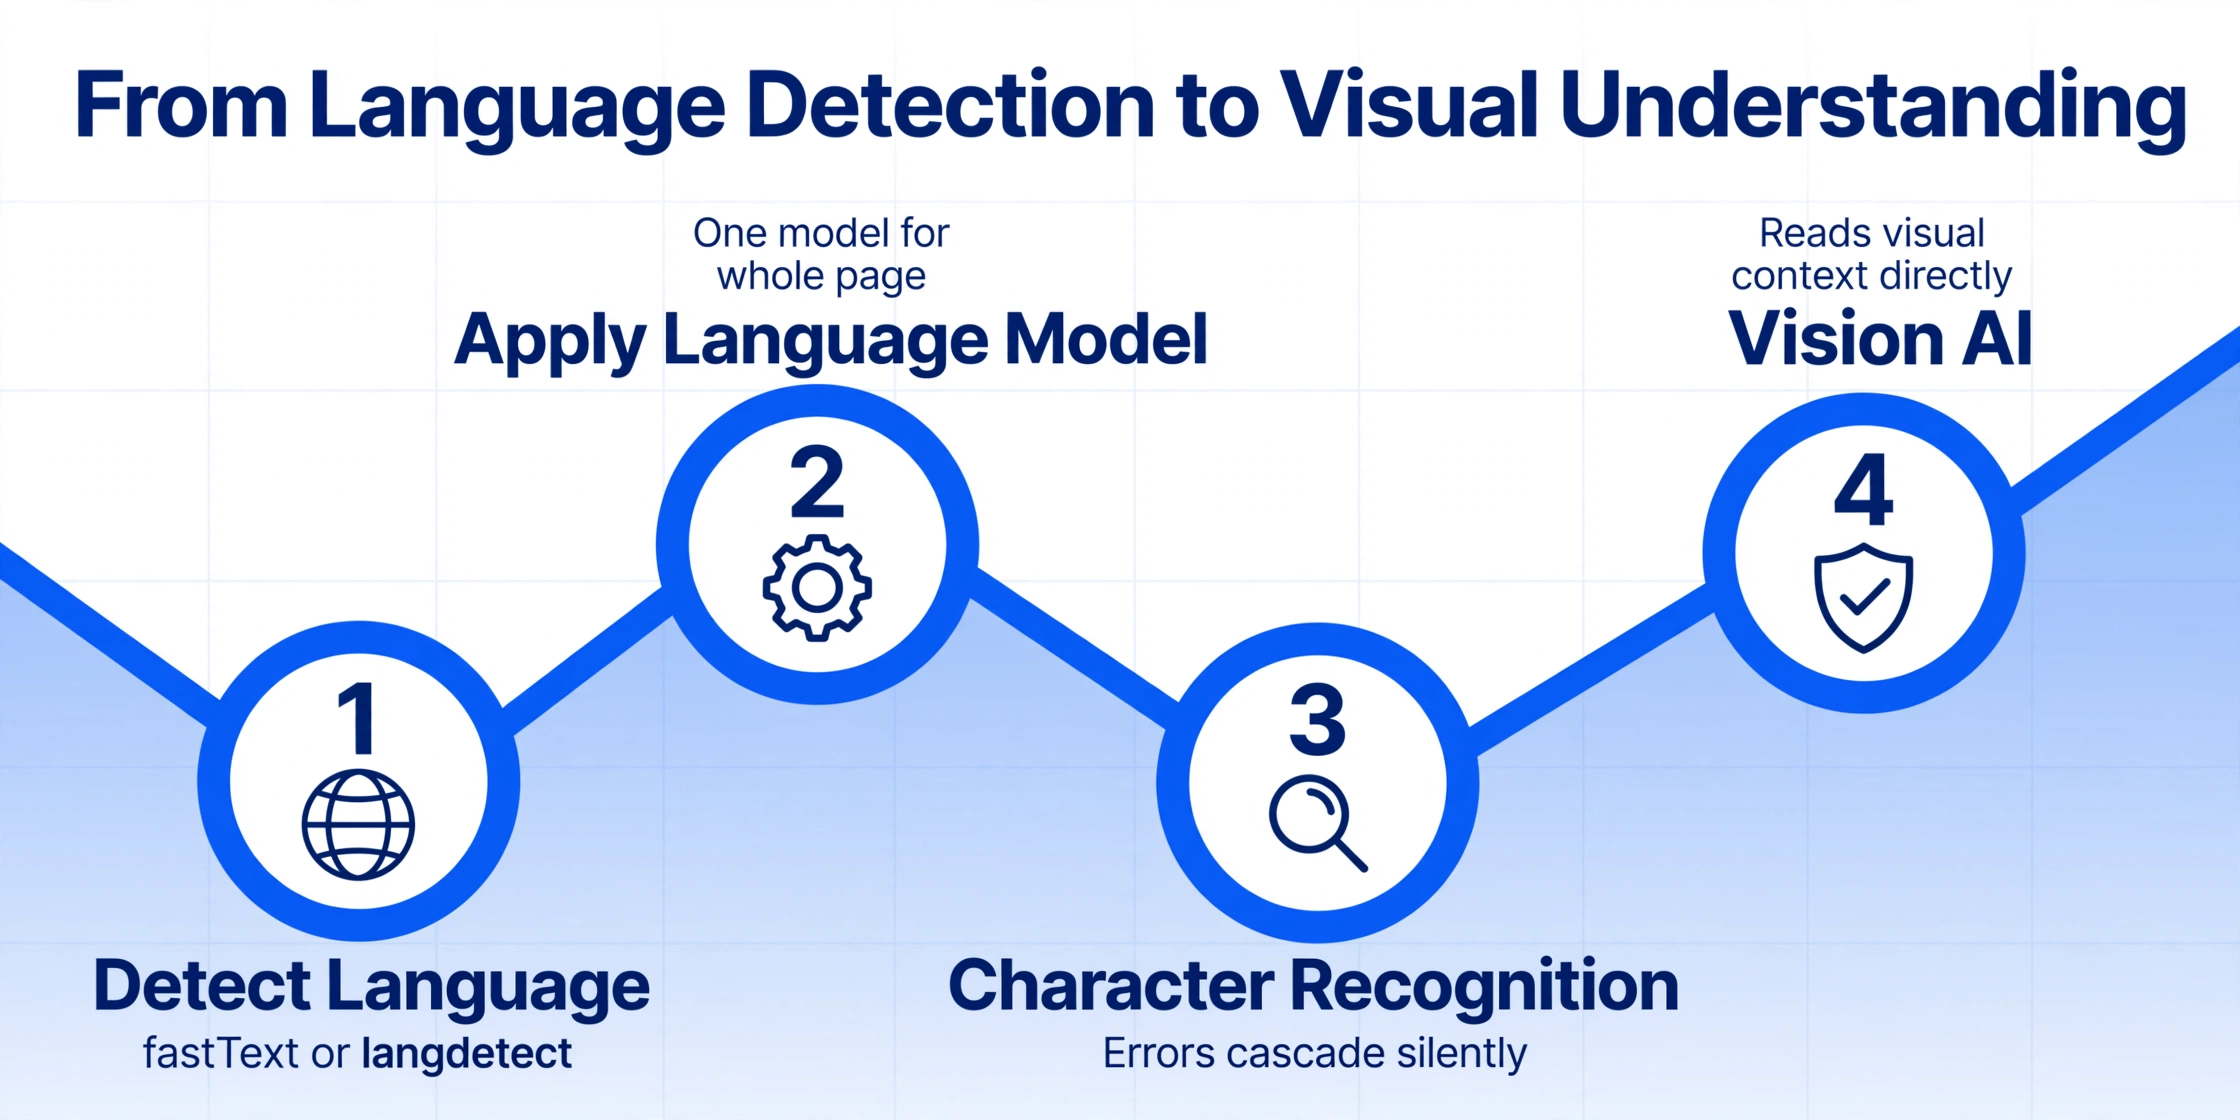
言語検出が失敗し続ける理由は、構造にあります。従来のOCRパイプラインは、言語検出と文字認識を2つの連続する段階に分けています:(1) 言語を特定し、(2) その言語のモデルを適用する。最初の段階で間違えると、2番目の段階では回復するチャンスがゼロになります。
ビジョンAI — ImageToTable.aiのようなツールの背後にある技術 — は、このパイプラインを単一の意味理解ステップに凝縮します。「これは何語か?」と尋ねてから「これらのピクセルはどんな文字を形成するか?」と尋ねる代わりに、モデルは視覚的なコンテンツを全体的に読み取ります:事前に選択された言語モデルに依存せず、視覚的な文脈の中で文字、数字、記号を解釈します。
このパラダイムシフト — スクリプト固有の認識モデルから視覚的な意味理解へ — は、言語の自動検出エラーが文字認識の失敗に連鎖しないことを意味します。なぜなら、文字認識はそもそも言語の選択に依存していなかったからです。英語の用語を含む日本語の請求書、フランス語の条項を含むドイツ語の契約書、3つのスクリプトが混在する配送ラベル — それぞれが1つの言語バケットに分類されなければならないページではなく、視覚的な全体として読み取られます。
これはビジョンAIが完璧であることを意味するのではなく、失敗のモードが変わることを意味します。間違った言語モデルが選択されたためにウムラウトを黙って落とす代わりに、モデルは文字を正しく読み取るか、曖昧な領域をレビューのためにフラグ付けします。出力は黙って間違っているのではなく、正しいか明示的に不確かかのどちらかです。初めて、「言語検出問題」は優れたOCR結果の根本原因ではなくなります。
今すぐできること — 実践的な修正方法
どのツールを使っている場合でも、OCR出力の言語検出エラーをすぐに減らすための3つの方法があります。
OCRツールが手動での言語選択に対応している場合は、それを利用しましょう。単一言語のドキュメントの場合、これだけで自動検出を完全に排除できます。複数言語が混在するドキュメントの場合は、主要言語を指定し、ツールが副次言語のフォールバックに対応しているか確認してください(この機能を明示していないツールも多いですが、試してみる価値はあります)。Tesseractは「+」演算子 — eng+deu+fra — をサポートしており、複数の言語モデルを並列処理してセグメントごとに最適なものを選択します。ただし前述の通り、これにも精度上の限界があります。
最も確実な修正方法は、スクリプト固有のモデルではなく文書を意味的に読むビジョンAIベースの抽出ツールを使うことです。こうしたツールは「これは何語ですか?」と聞きません。なぜなら、その答えはページの読み取り方法に関係ないからです。ドキュメントがドイツ語、日本語、アラビア語、またはその3つの混在であっても、出力は同じです — モデルは視覚コンテンツを直接処理します。
クリーンな単一言語のテストサンプルでOCRの言語検出精度をベンチマークしてはいけません — 実際の運用ドキュメントはそんなに単純ではありません。最悪の複数言語混在ドキュメントを3つ取り上げてください — ドイツ語-英語の請求書、日本語-英語のスペックシート、フランス語-英語の契約書 — そして候補ツールで実行してみましょう。価値の高い特定フィールドを確認してください:ヨーロッパ式と米国式の数値フォーマットが混在する金額、発音区別符号付きの名前、複数スクリプトが混在する住所など。実際のドキュメントでこれらを正しく処理できるツールこそが、本番環境で機能するツールです。
エスカレーションのタイミング:修正不可能な言語問題の見分け方
言語検出の問題の中には、設定やワークフローの変更で解決できるものもあります。一方で、ツール自体がアーキテクチャ上、あなたのドキュメントセットを処理できないことを示すものもあります。その違いを見分ける方法は次のとおりです。
OCRツールがほぼ正確な出力を生成するものの、混在言語ページでダイアクリティカルマークを落としたり、数字の書式を誤読したりすることがある場合、手動での言語指定や後処理によるクリーンアップで解決できる可能性が高いです。例えばTesseractは、複数の言語パックと特定のページセグメンテーションモードを設定でき、検出エラーを大幅に減らせます。
ツールが一貫して、セクション全体が間違った出力を生成する場合 — ドイツ語の本文が英語として読まれる、日本語の段落全体が中国語として返される、または複数のスクリプトを含むページをまったく処理できない — 手動設定では修正できません。アーキテクチャ自体がボトルネックです。この場合の解決策は、言語の事前選択に依存しないビジョンAIツールに移行することです。
クイック診断チェックリスト
- ✓ 出力は正しい文字だがダイアクリティカルマークが欠落(ドイツ語のウムラウト、フランス語のアクセント) → 修正可能(手動の言語選択または言語パック)
- ✓ 出力は正しいテキストだが数字の書式が間違っている(カンマとピリオド) → 修正可能(手動の言語+ロケール設定)
- ✗ セクション全体が間違ったスクリプトで読まれる(漢字が中国語の漢字として、キリル文字がラテン文字として) → アーキテクチャ上の問題(ビジョンAIに切り替え)
- ✗ 混在言語ドキュメントが実行ごとに一貫性のない出力を生成する → アーキテクチャ上の問題(自動検出は確率的に不安定)
- ✗ 実際の内容に関係なく、すべてのドキュメントが英語として読まれる → アーキテクチャ上の問題(ツールが英語をデフォルトとし、実際の検出がない)
よくある質問
OCRは、同じページに複数の言語が含まれる文書でも機能しますか?
対応を謳うツールもありますが、実際はアーキテクチャ次第です。文書レベルで単一言語を検出する従来のOCRツールは、検出された言語と一致しない言語セグメントでは精度が低下します。言語の事前選択を必要とせず、文書を意味的に読み取るビジョンAIツールは、そもそも言語検出を必要としないため、複数言語が混在するページを根本的によりうまく処理できます。複数言語の文書がワークフローの定番であるなら、ツールを導入する前に、実際の文書構成でテストしてください。
追加の言語パックをインストールすれば、OCRの言語検出を修正できますか?
Tesseractのようなツールでは、その通りです。正しい.traineddataファイルをインストールし、-lパラメータで複数言語(例:eng+deu+fra)を設定すれば、既知の言語での検出エラーを減らせます。ただし、この方法でも、言語モデルが正しいテキストセグメントに適用されることが前提です。行ごとに言語が切り替わる複数言語ページでは、「+」演算子は単一言語よりは良いものの、セグメントごとの言語割り当てよりは明らかに精度が低い、ベストエフォート型のマージを生成します。手動でのパックインストールを必要としない自動検出には、ビジョンAIツールが根本的に異なるアプローチを提供します。
OCRツールが日本語を中国語として読み取るのはなぜですか?
日本語と中国語は、多くの文字(日本語の漢字、中国語の漢字)を共有しています。多くの従来型OCRエンジンは「CJK」を広範なスクリプトカテゴリとして検出し、最も大きなトレーニングデータセットを持つ簡体字中国語をデフォルトにします。ツールは漢字を文字レベルでは正しく読み取りますが、中国語の辞書バイアスと言語モデルを適用するため、日本語固有の文字(ひらがな、カタカナ)を誤解釈し、共有文字に誤った読み方を適用します。修正方法は、ツールが対応していれば文書言語として日本語を手動指定するか、スクリプト分類ゲートではなく書記体系をネイティブに認識するビジョンAIモデルを使用することです。
OCRがドイツ語/フランス語の文書からウムラウトやアクセント記号を頻繁に落とすのはなぜですか?
最も一般的な理由は、OCRエンジンが文書言語を「英語」と検出し、英語の認識モデルを適用したことです。英語モデルにはä、ö、ü、ß、é、è、ê、ñ、çなどの文字のエントリがありません。エンジンがこれらの文字に遭遇すると、作業用文字セット内で最も近い文字(通常はアクセント記号のないラテン文字相当)にマッピングします。文書言語としてドイツ語、フランス語、またはスペイン語を手動指定するか(または多言語モードを使用する)と、通常は解決します。それでも解決しない場合、ツールにこれらの言語用の言語固有モデルがそもそも存在しない可能性があります。
自動検出と手動の言語選択では、精度にどのような違いがありますか?
クリーンで単一言語の文書の場合、その差は小さいことが多いです。主要言語では最新の自動検出が95%以上の精度を達成します。しかし、複数言語が混在するコンテンツ、特殊な書式、またはトレーニングデータセットが小さい言語の文書では、その差は大幅に広がります。既知の単一言語文書で手動の言語選択を行うと、検出ステップが失敗要因として排除されるため、最高の精度が得られます。複数言語が混在する文書では、手動選択だけでは不十分です。ツールがセグメントごとの言語割り当てをサポートするか、言語分類にまったく依存しない意味論的リーディングアプローチを使用する必要があります。
言語検出の問題は画像品質やOCR設定の問題ではありません — あなたのツールが言語を読み取り開始前に通過しなければならないゲートとして扱うか、それとも決定する必要のない無関係な詳細として扱うかの問題なのです。