Pourquoi l'OCR multilingue continue
de se tromper de langue — 3 causes racines et solutions
Vous envoyez un document à un outil OCR et vous récupérez un texte techniquement lisible — mais faux. Une facture allemande ressort avec "Rechnung" correct, mais "Geschäftsführer" devient "Geschaftsfuhrer" — les trémas ont disparu. Un bon de commande japonais mélangeant Kanji et anglais renvoie "注文書" en caractères chinois simplifiés déformés. Vous avez tout fait correctement : l'image était nette, le contraste bon, la résolution suffisante. Le problème n'est pas la qualité de l'image. C'est la détection de langue.
Points clés à retenir
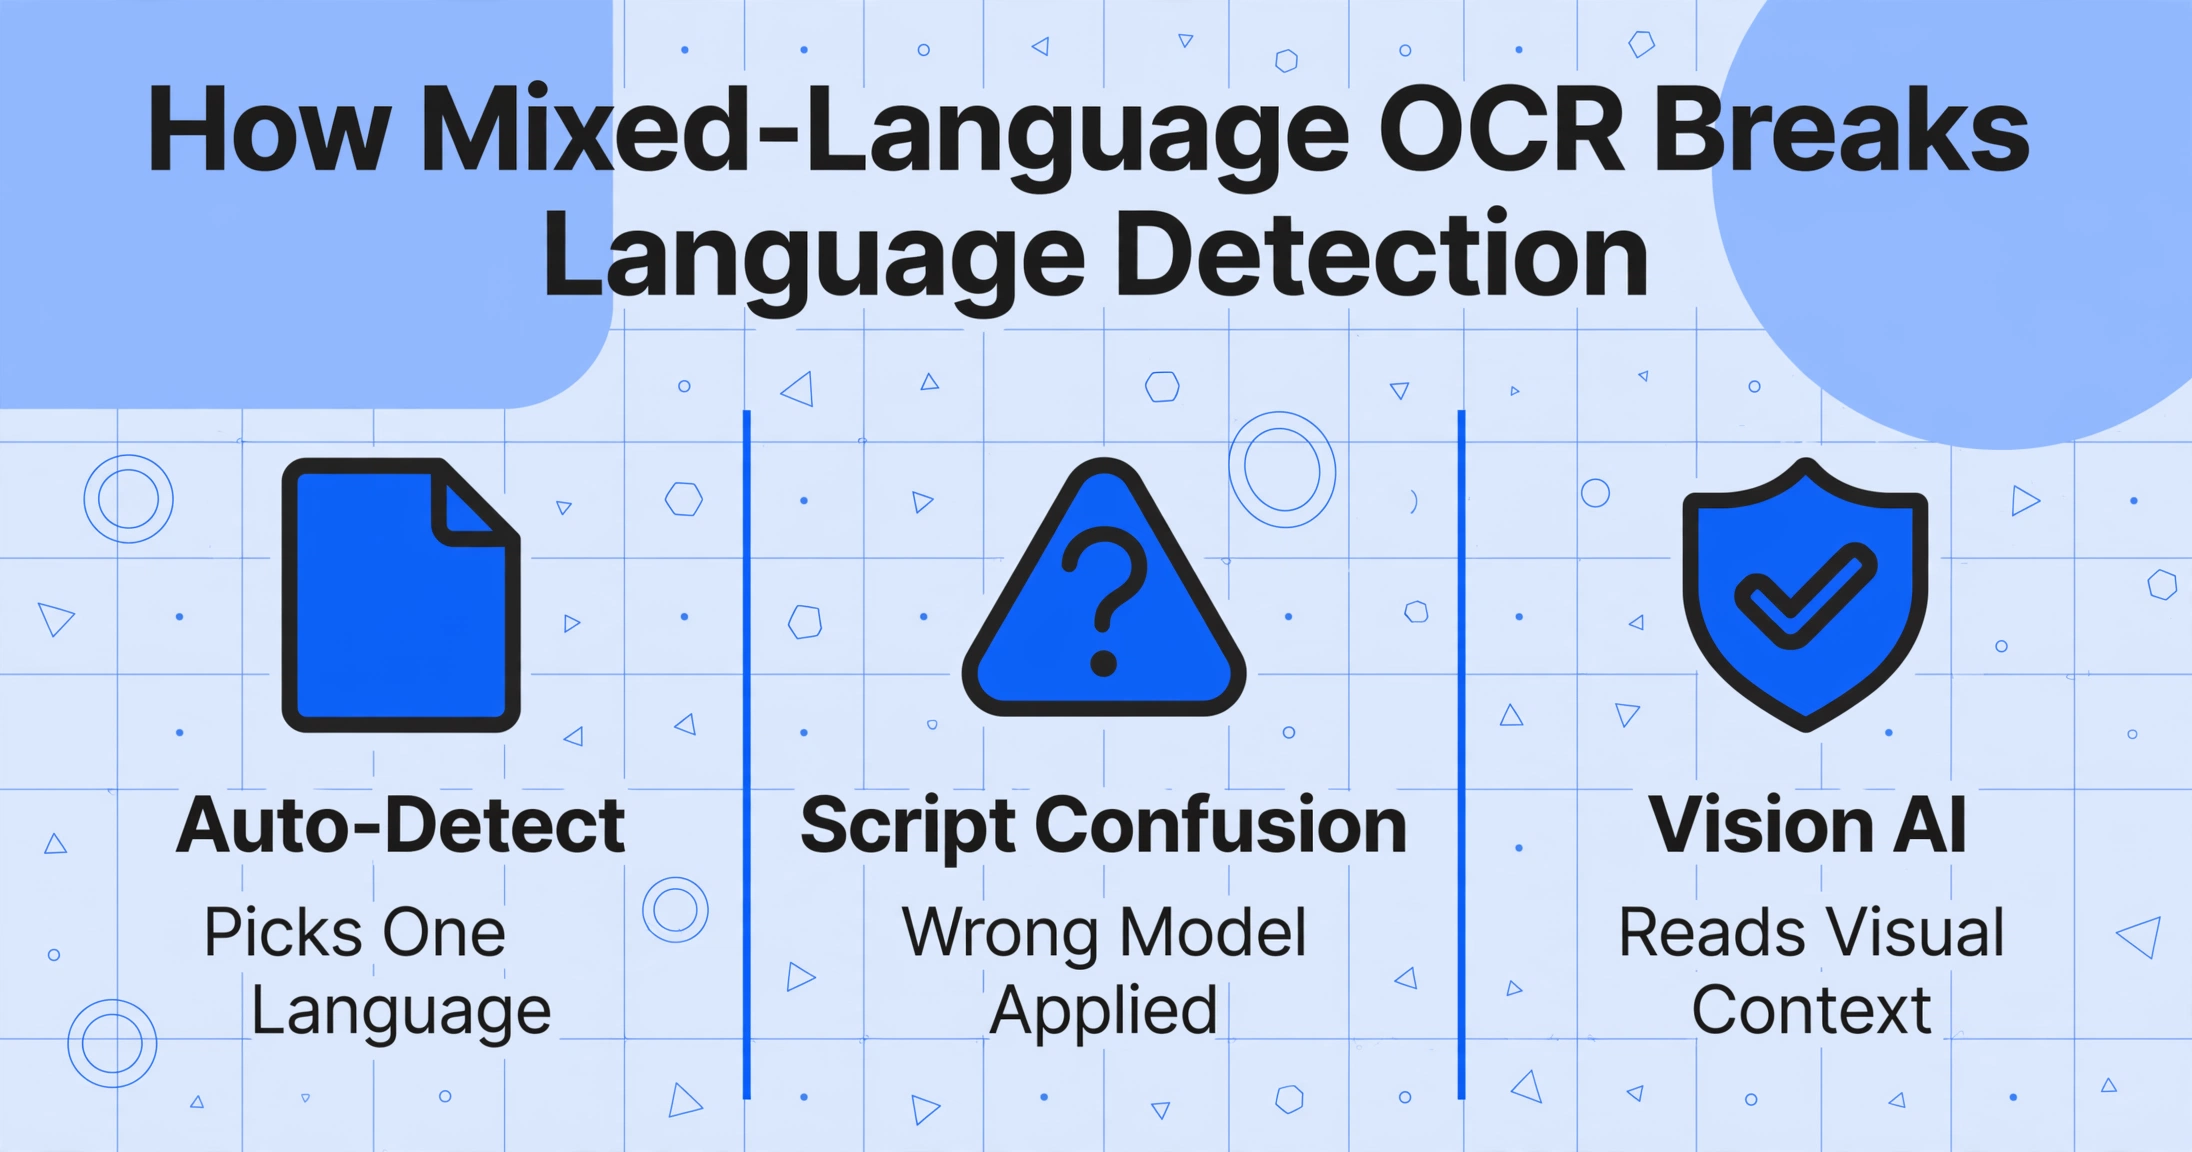
- La sortie OCR peut être techniquement lisible mais entièrement fausse — une facture italienne de 1 250 € devient 1,25 € parce que le moteur a appliqué le formatage numérique anglais à un document italien.
- Le point de défaillance se situe en amont de la reconnaissance des caractères : la plupart des outils décident la langue de la page avant de lire un seul mot, et chaque caractère qui ne correspond pas à la langue choisie est silencieusement dégradé.
- Corrigez l'architecture, pas la détection — les outils qui lisent les documents visuellement, sans étape de sélection de langue, éliminent le problème de détection de langue plutôt que de le rapiécer avec plus de packs linguistiques.
La détection de langue en OCR semble simple : analyser les premiers mots, deviner la langue, appliquer le bon modèle de reconnaissance. En pratique, elle échoue de manière prévisible, vous fait perdre du temps et produit des résultats qui semblent corrects à première vue mais sont faux dans le détail. Et si vous travaillez avec des documents multilingues — ce qui, dans une entreprise mondialisée, concerne la plupart des documents — le taux d'échec grimpe en flèche.
Cet article passe en revue les trois façons spécifiques dont la détection de langue en OCR échoue, afin que vous puissiez diagnostiquer laquelle est à l'origine de votre problème et savoir quel correctif s'applique réellement.
Cause 1 : La détection automatique choisit une seule langue pour tout le document
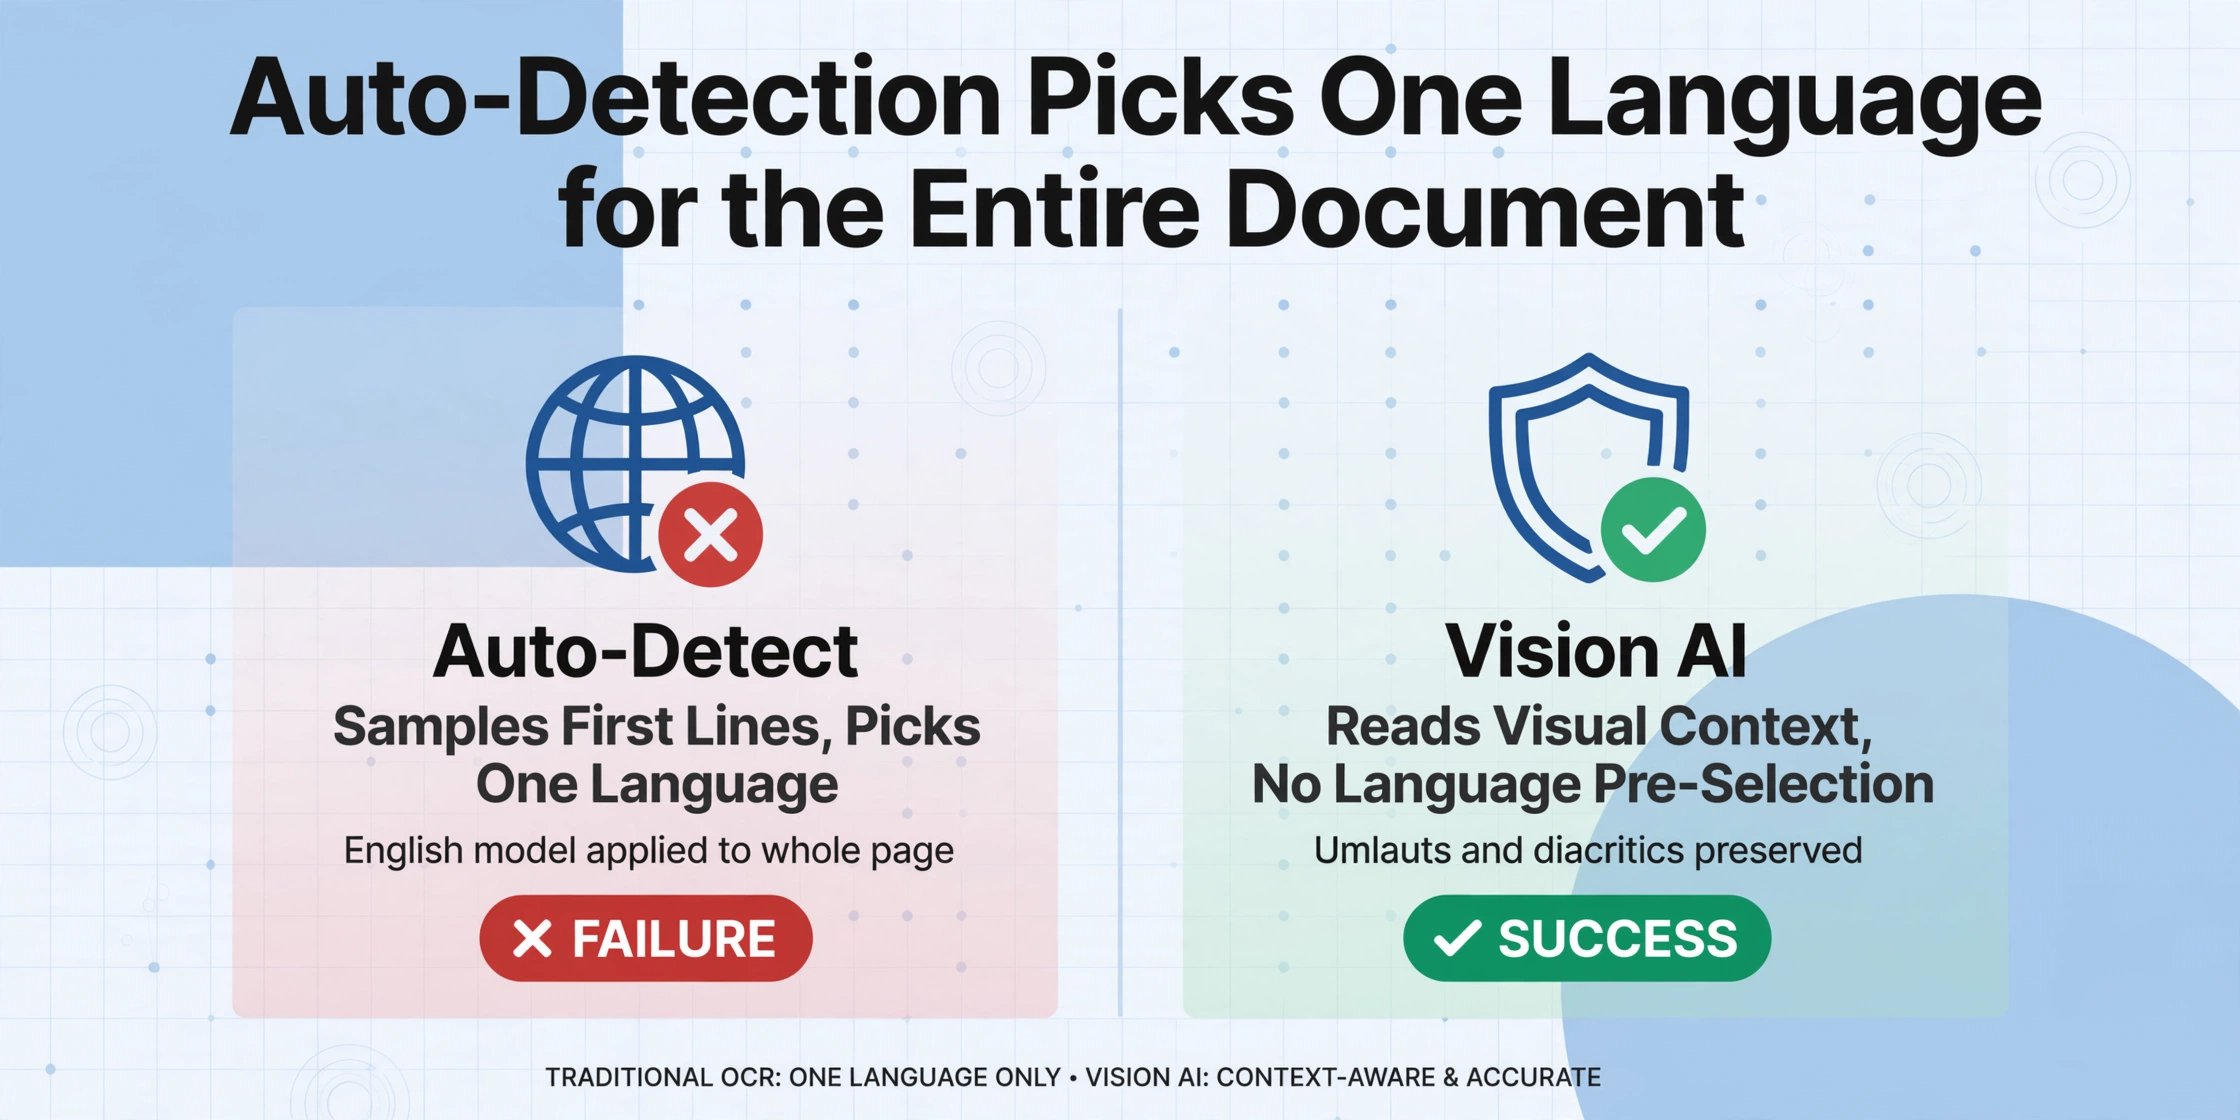
Le problème de détection de langue en OCR le plus courant survient avant même que le moteur OCR ne lise un seul caractère. La plupart des outils OCR traditionnels utilisent une étape de détection automatique qui échantillonne les premières lignes ou paragraphes d'un document, exécute un algorithme d'identification de langue — généralement quelque chose comme fastText ou langdetect — et choisit la langue la plus probable pour toute la page. Ensuite, il achemine tout le document via un modèle de reconnaissance entraîné sur cette seule langue.
Cela fonctionne bien lorsque le document est monolingue. Cela échoue immédiatement lorsque le document commence dans une langue et passe à une autre, ou lorsque la langue du titre ne correspond pas à celle du corps du texte.
Exemple concret
Une facture allemande avec un en-tête de société anglais : "GlobalTech Solutions Inc. — Rechnungsnummer: 2024-0871 — Lieferdatum: 15. März 2024 — Geschäftsführer: Dr. Müller." La détection automatique lit "GlobalTech Solutions Inc." en haut et sélectionne l'anglais. Tout le document est traité avec le modèle de langue anglais. Résultat : "Geschäftsführer" devient "Geschaftsfuhrer", "März" devient "Marz", et "Straße" est rendu comme "Strasse" — pas illisible, mais pas correct non plus. Les trémas sont silencieusement supprimés car le modèle anglais n'a pas d'entrées de dictionnaire pour ces caractères.
Le même problème touche toute langue avec des signes diacritiques — le français (élève → eleve), l'espagnol (año → ano), le portugais (ç supprimé), le polonais (ł → l). Les caractères sont visuellement présents sur la page, mais le modèle de reconnaissance ne les attend pas, il les mappe donc à l'équivalent ASCII le plus proche ou les supprime entièrement.
Ce n'est pas un « bug » du moteur OCR. C'est une hypothèse de conception : les pipelines OCR traditionnels sont construits autour de l'idée d'une langue par page. Lorsque cette hypothèse est rompue, la précision chute non pas parce que l'image est mauvaise — mais parce que le moteur essaie de décoder un mot français avec un dictionnaire allemand.
Cause 2 : Confusion de système d'écriture — quand des caractères se ressemblent mais signifient des choses différentes
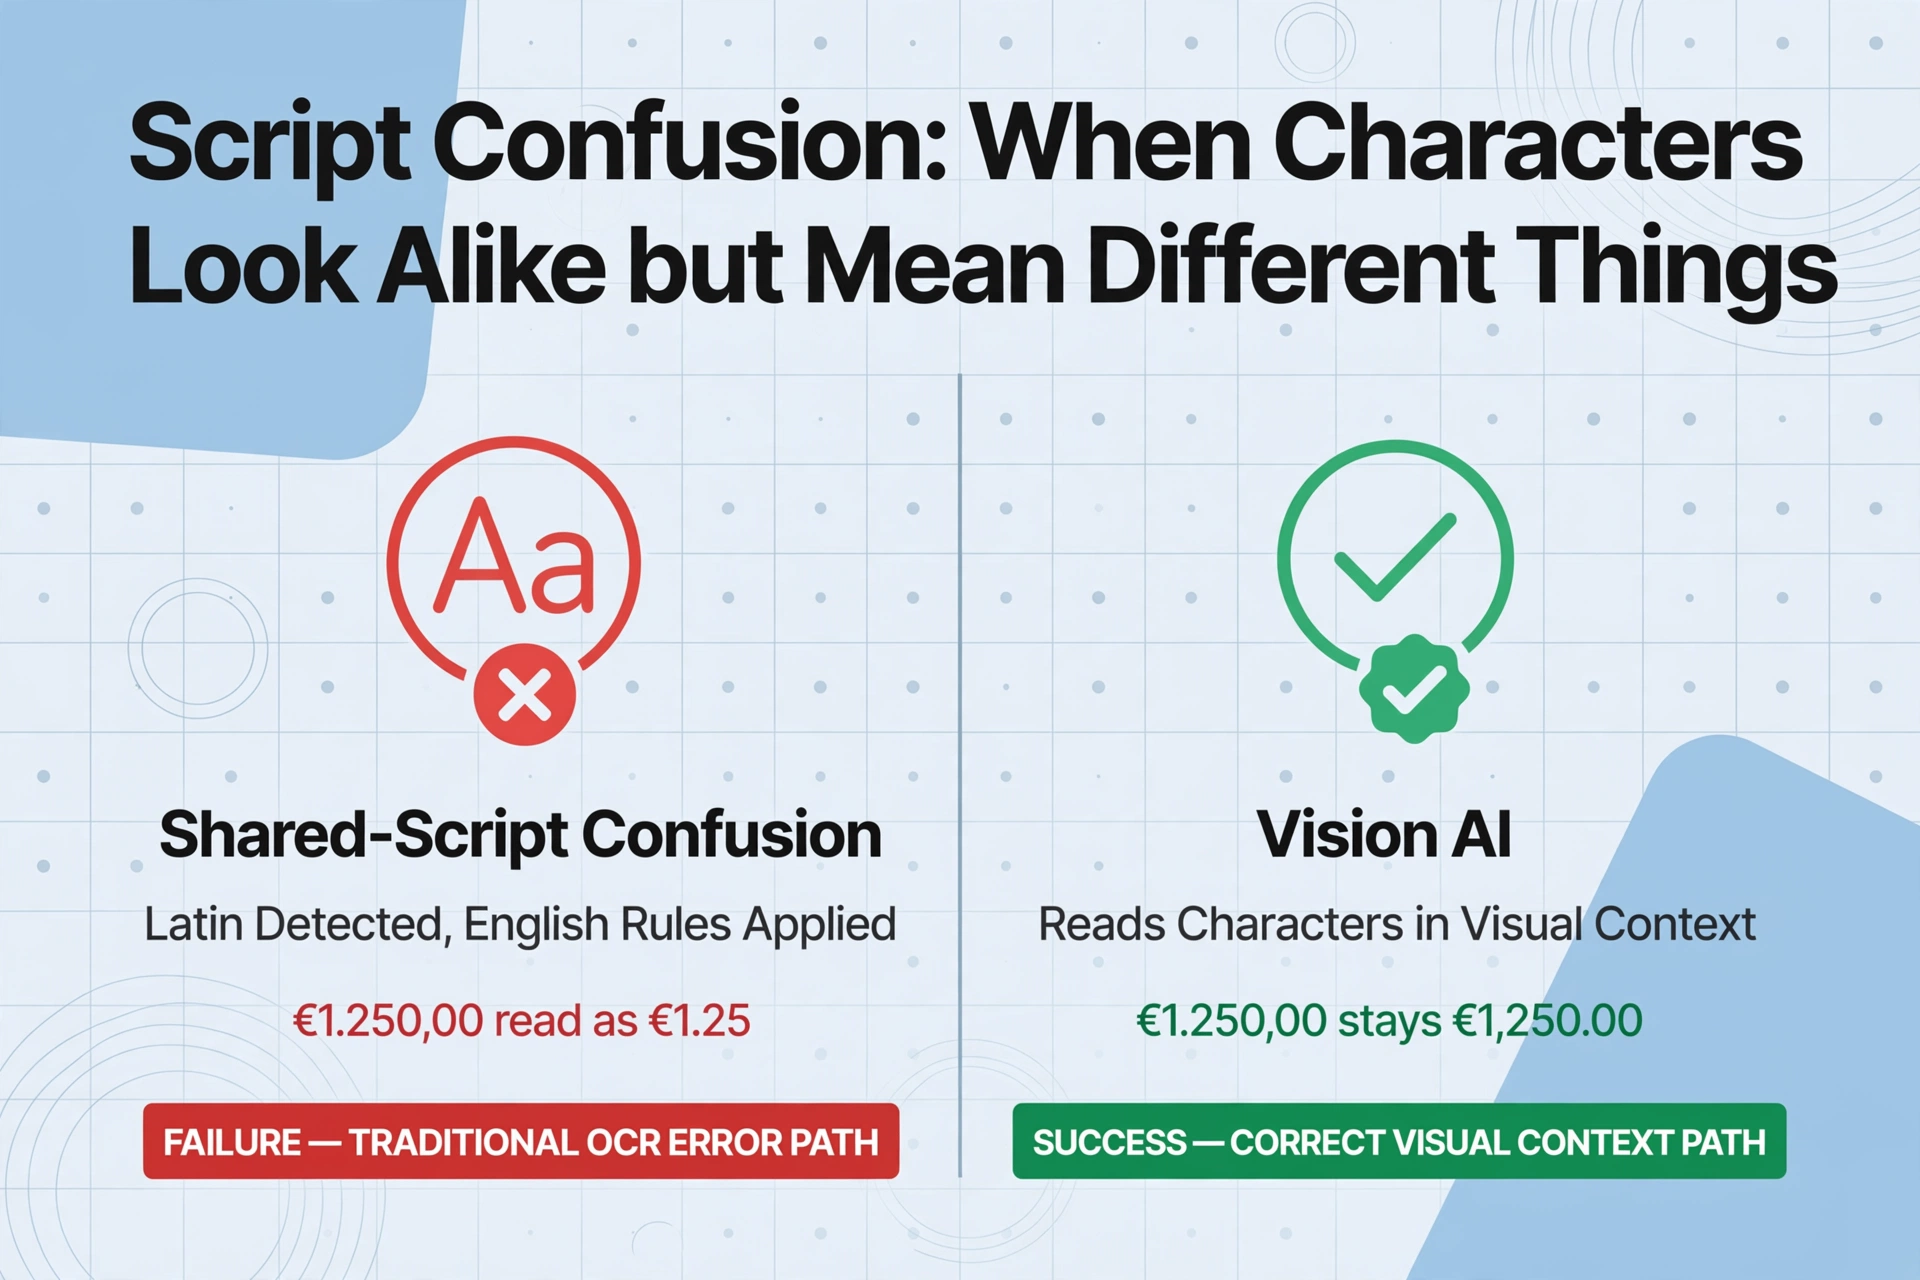
Une classe plus difficile d'échec de détection de langue se produit lorsque le système d'écriture est partagé entre plusieurs langues, ou lorsque deux systèmes d'écriture ont des caractères visuellement similaires. La détection automatique identifie correctement le système d'écriture — latin, han (CJC), cyrillique — mais choisit la mauvaise langue au sein de cette famille de systèmes d'écriture.
Le problème du système d'écriture partagé
Le système d'écriture latin est partagé par l'anglais, le français, l'allemand, l'espagnol, l'italien, le portugais, le néerlandais, le suédois, le norvégien et des dizaines d'autres langues. Lorsqu'un moteur OCR détecte le système d'écriture latin et sélectionne automatiquement l'anglais — la langue par défaut de la plupart des outils — chaque accent aigu français, Umlaut allemand et tilde espagnol devient un problème. Le moteur peut lire les caractères, mais son dictionnaire de post-traitement applique les règles orthographiques anglaises, donc des mots étrangers valides se font « corriger » en anglais.
Exemple concret
Un fournisseur italien envoie un document avec « Fattura — Importo: € 1.250,00 — Spedizione: via Roma, 15 ». Détecté comme anglais. Le moteur OCR lit la virgule dans « 1.250,00 » comme un séparateur décimal plutôt qu'un séparateur de milliers — car l'anglais utilise des points pour les décimales et des virgules pour les groupements, tandis que l'italien fait l'inverse. Le résultat : €1.250,00 (mille deux cent cinquante euros) est affiché comme €1.25 (un euro et vingt-cinq centimes). Ce n'est pas une erreur de lecture — c'est une erreur d'interprétation de formatage causée par le mauvais modèle de langue.
Confusion des écritures CJK : Kanji, Hanzi et Hanja
La confusion d'écritures la plus problématique se produit dans les langues d'Asie de l'Est. Le chinois, le japonais et le coréen utilisent tous des caractères d'origine chinoise (Hanzi en chinois, Kanji en japonais, Hanja en coréen), et de nombreux caractères individuels sont partagés entre les trois. Un document japonais utilise des caractères Kanji qui correspondent visuellement aux caractères chinois simplifiés — mais le sens, la lecture et le contexte sont entièrement différents.
Lorsque le moteur OCR détecte automatiquement le « chinois » pour un document japonais — ce qui arrive couramment car les Kanji et les Hanzi se chevauchent largement — la sortie est techniquement lisible mais linguistiquement incorrecte. Le moteur applique des modèles de caractères chinois et un biais de dictionnaire à un texte écrit en japonais. Les mots qui devraient être lus en Kun-yomi ou On-yomi (lectures japonaises) reçoivent des prononciations chinoises. Le contenu japonais mixte — Hiragana et Katakana entremêlés de Kanji — perturbe davantage la détection car le moteur ne sait pas quel système d'écriture prioriser.
L'OCR traditionnel traite cela comme un choix binaire : soit la page est chinoise, soit elle est japonaise. Il n'a pas de concept de « cette page est les deux ». Un document qui mélange du texte chinois simplifié avec des codes produit anglais, ou du texte japonais avec des emprunts anglais, déclenche des modèles de langue qui alternent de manière imprévisible entre interprétations correctes et incorrectes.
Cause 3 : les documents multilingues brisent l'hypothèse « une langue par page »
Le cas le plus difficile — et le plus courant dans les affaires internationales — est un document unique qui contient réellement deux langues ou plus, non pas en raison d'une ambiguïté de détection mais par conception.
Prenons un contrat multinational avec des en-têtes de clauses en anglais et un corps de texte en français. Ou une étiquette d'expédition qui indique l'adresse d'origine en japonais, la destination en anglais et les déclarations douanières dans la langue locale. Ou un dossier médical d'une clinique suisse, où le formulaire d'admission est en allemand, les résultats de laboratoire en français et le résumé du diagnostic en anglais. Ce ne sont pas des cas marginaux — ce sont des documents courants dans les opérations mondiales.
L'OCR traditionnel traite ces documents en sélectionnant une langue au niveau du document, en l'appliquant uniformément et en acceptant la perte de précision sur chaque segment qui ne correspond pas. Le résultat est une sortie où certaines sections semblent parfaites et d'autres semblent avoir été traitées avec un outil complètement différent — car dans un sens, c'était prévu ainsi.
Même les outils qui prennent en charge le « mode multilingue » le font souvent en enchaînant les modèles de langue séquentiellement — essayer l'anglais d'abord, puis le français, puis l'allemand, et prendre le résultat avec la plus haute confiance par ligne. Cela fonctionne mal en pratique car les lignes adjacentes dans différentes langues s'influencent mutuellement, et le score de confiance lui-même dépend de la langue : un modèle entraîné sur l'anglais a intrinsèquement une confiance plus élevée sur le texte anglais qu'un modèle entraîné sur une langue avec moins de données d'entraînement, même lorsque les deux lisent correctement leurs langues respectives.
Ce que l'IA de vision fait différemment — et pourquoi cela change la donne
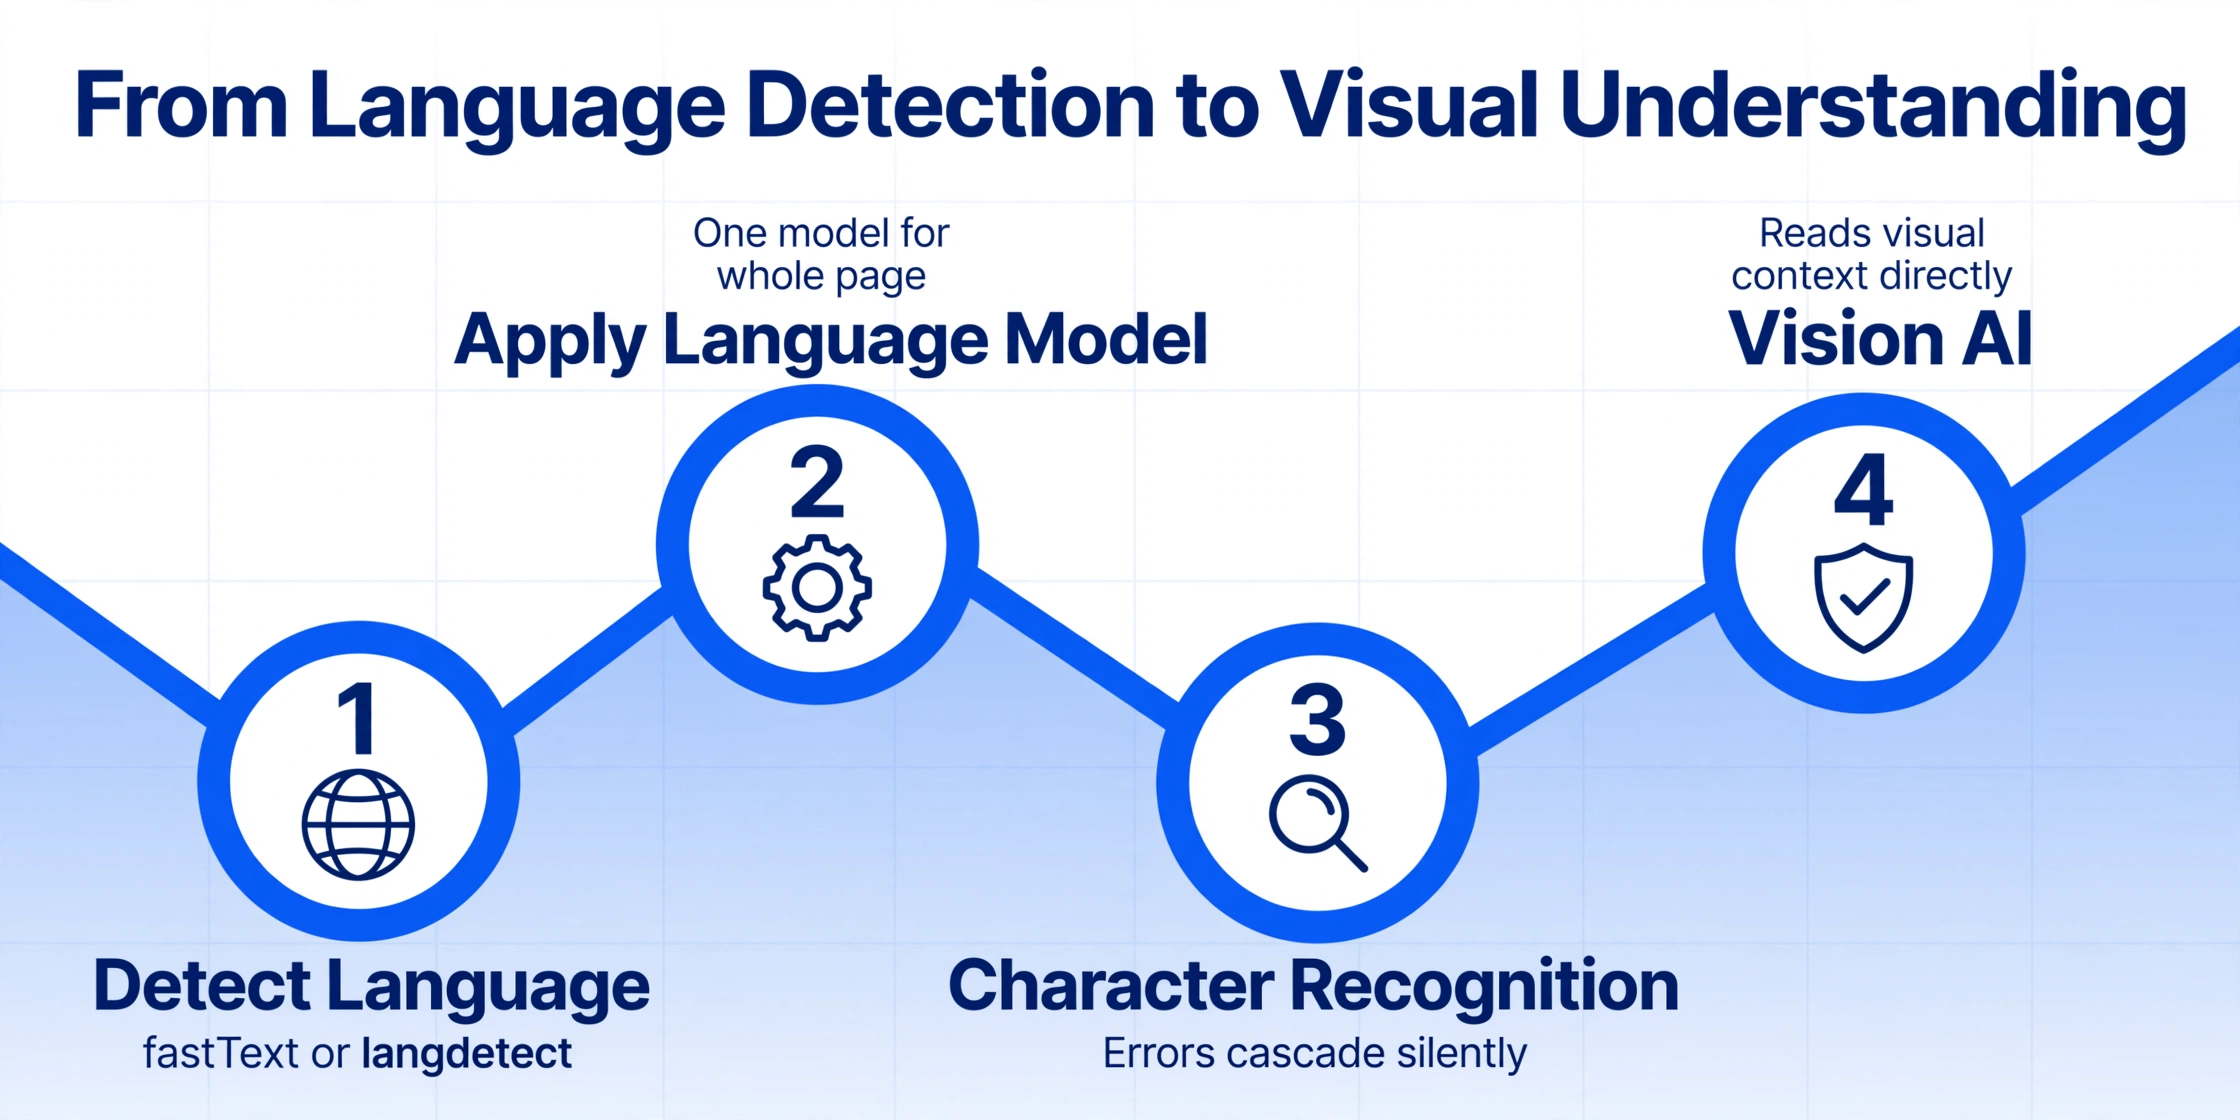
La raison pour laquelle la détection de langue échoue sans cesse est architecturale. Les pipelines OCR traditionnels séparent la détection de langue de la reconnaissance de caractères en deux étapes séquentielles : (1) identifier la langue, puis (2) appliquer le modèle pour cette langue. Si la première étape se trompe, la seconde n'a aucune chance de se rattraper.
L'IA de vision — la technologie derrière des outils comme ImageToTable.ai — condense ce pipeline en une seule étape de compréhension sémantique. Au lieu de se demander « quelle est cette langue ? » puis « quels caractères ces pixels forment-ils ? », le modèle lit le contenu visuel de manière holistique : il interprète les caractères, les chiffres et les symboles dans leur contexte visuel, indépendamment d'un modèle linguistique présélectionné.
Ce changement de paradigme — des modèles de reconnaissance spécifiques à une écriture à la compréhension sémantique visuelle — signifie que les erreurs de détection automatique de langue ne peuvent pas se propager en échecs de reconnaissance de caractères, car la reconnaissance de caractères n'a jamais dépendu de la sélection de langue en premier lieu. Une facture japonaise avec des termes anglais, un contrat allemand avec des clauses françaises, une étiquette d'expédition avec trois écritures — chacun est lu comme un tout visuel, et non comme une page qui doit être classée dans une seule catégorie de langue.
Cela ne signifie pas que l'IA de vision est parfaite — cela signifie que le mode d'échec change. Au lieu de supprimer silencieusement les trémas parce que le mauvais modèle de langue a été sélectionné, le modèle soit lit correctement les caractères, soit signale les zones ambiguës pour examen. Le résultat n'est pas silencieusement faux ; il est soit correct, soit explicitement incertain. Pour la première fois, le « problème de détection de langue » cesse d'être la cause racine des mauvais résultats OCR.
Ce que vous pouvez faire dès maintenant — solutions pratiques
Quel que soit l'outil que vous utilisez, voici trois choses qui réduiront immédiatement les erreurs de détection de langue dans votre sortie OCR.
Si votre outil OCR permet la sélection manuelle de la langue, utilisez-la. Pour les documents monolingues, cela élimine entièrement la détection automatique. Pour les documents multilingues, spécifiez une langue principale et vérifiez si l'outil prend en charge une langue secondaire de secours (beaucoup ne mentionnent pas cette fonctionnalité, mais cela vaut la peine de tester). Tesseract prend en charge l'opérateur « + » — eng+deu+fra — qui traite plusieurs modèles de langue en parallèle et sélectionne la meilleure correspondance par segment, bien que, comme indiqué plus haut, cela ait ses propres limites de précision.
La solution la plus fiable est d'utiliser un outil d'extraction basé sur l'IA vision qui lit les documents de manière sémantique plutôt qu'avec des modèles spécifiques à un système d'écriture. Ces outils ne demandent pas « quelle est cette langue ? » car la réponse n'a aucune incidence sur la façon dont ils lisent la page. Le résultat est le même que votre document soit en allemand, en japonais, en arabe ou dans un mélange des trois — le modèle traite directement le contenu visuel.
Ne testez pas la précision de la détection de langue OCR sur des échantillons monolingues propres — vos documents de production ne sont pas si simples. Prenez vos trois pires documents multilingues — une facture allemand-anglais, une fiche technique japonais-anglais, un contrat français-anglais — et exécutez-les avec vos outils candidats. Vérifiez les champs à forte valeur : montants avec formatage numérique européen vs américain, noms avec signes diacritiques, adresses avec systèmes d'écriture mixtes. L'outil qui gère correctement ces cas sur vos documents réels est celui qui fonctionnera en production.
Quand passer à l'étape supérieure : reconnaître un problème de langue irréparable
Certains problèmes de détection de langue peuvent être résolus par la configuration et des changements de flux de travail. D'autres indiquent que l'outil est architecturalement incapable de gérer votre ensemble de documents. Voici comment faire la différence.
Si votre outil OCR produit des résultats globalement corrects mais omet parfois des diacritiques ou lit mal le format des nombres sur des pages multilingues, la spécification manuelle de la langue ou un nettoyage post-traitement résoudra probablement le problème. Tesseract, par exemple, peut être configuré avec plusieurs packs de langues et des modes de segmentation de page spécifiques qui réduisent considérablement les erreurs de détection.
Si votre outil produit régulièrement des résultats où des sections entières sont fausses — du texte allemand lu comme de l'anglais, des paragraphes entiers en japonais renvoyés comme du chinois, ou une incapacité totale à gérer des pages avec plus d'un système d'écriture — la configuration manuelle ne résoudra pas le problème. L'architecture elle-même est le goulot d'étranglement. Dans ce cas, la solution est de passer à un outil d'IA vision qui ne dépend pas de la présélection de la langue.
Liste de contrôle de diagnostic rapide
- ✓ La sortie a des caractères corrects mais des diacritiques manquants (umlauts allemands, accents français) → Réparable (sélection manuelle de la langue ou pack de langues)
- ✓ La sortie a le bon texte mais un format de nombre incorrect (virgule vs point) → Réparable (configuration manuelle de la langue et des paramètres régionaux)
- ✗ Des sections entières sont lues dans le mauvais système d'écriture (Kanji comme Hanzi, cyrillique comme latin) → Architectural (passer à l'IA vision)
- ✗ Les documents multilingues produisent des résultats incohérents entre différentes exécutions → Architectural (la détection automatique est probabilistiquement instable)
- ✗ Chaque document est lu comme de l'anglais quel que soit le contenu réel → Architectural (l'outil utilise l'anglais par défaut sans détection réelle)
Questions fréquemment posées
L'OCR fonctionne-t-il avec des documents contenant plusieurs langues sur la même page ?
Certains outils prétendent le prendre en charge, mais la réalité dépend de l'architecture. Les outils OCR traditionnels qui détectent une seule langue au niveau du document dégradent la précision sur tout segment linguistique ne correspondant pas à la langue détectée. Les outils d'IA vision qui lisent les documents de manière sémantique — sans nécessiter de présélection de langue — gèrent fondamentalement mieux les pages multilingues, car ils n'ont jamais eu besoin de détection de langue pour commencer. Si les documents multilingues font partie intégrante de votre flux de travail, testez spécifiquement sur votre combinaison de documents avant de vous engager sur un outil.
Puis-je corriger la détection de langue de l'OCR en installant des packs de langues supplémentaires ?
Pour des outils comme Tesseract, oui — installer les fichiers .traineddata corrects et configurer le paramètre -l avec plusieurs langues (par ex., eng+deu+fra) peut réduire les erreurs de détection sur les langues connues. Cependant, cette approche suppose toujours que les modèles de langue sont appliqués aux bons segments de texte. Sur les pages multilingues où les lignes alternent entre les langues, l'opérateur « + » produit une fusion au mieux qui est meilleure qu'une seule langue mais toujours nettement moins précise qu'une affectation de langue par segment. Pour une détection automatique qui ne nécessite pas d'installation manuelle de packs, les outils d'IA vision offrent une approche fondamentalement différente.
Pourquoi mon outil OCR lit-il le japonais comme du chinois ?
Le japonais et le chinois partagent un grand nombre de caractères (Kanji en japonais, Hanzi en chinois). De nombreux moteurs OCR traditionnels détectent « CJK » comme une catégorie de système d'écriture large et utilisent par défaut le chinois simplifié, car il possède le plus grand ensemble de données d'entraînement. L'outil lit correctement les Kanji au niveau des caractères, mais applique un biais de dictionnaire et des modèles de langue chinois, ce qui signifie qu'il interprète mal les caractères uniquement japonais (Hiragana, Katakana) et applique des lectures incorrectes aux caractères partagés. La solution est soit de spécifier manuellement le japonais comme langue du document (si l'outil le prend en charge), soit d'utiliser un modèle d'IA vision qui reconnaît les systèmes d'écriture nativement plutôt que via une passerelle de classification de script.
Pourquoi l'OCR supprime-t-il sans cesse les trémas et les accents de mes documents allemands/français ?
La raison la plus courante est que le moteur OCR a détecté « anglais » comme langue du document et a appliqué un modèle de reconnaissance anglais. Les modèles anglais n'ont aucune entrée pour ä, ö, ü, ß, é, è, ê, ñ, ç et les caractères similaires. Lorsque le moteur les rencontre, il les mappe au caractère le plus proche dans son jeu de caractères de travail — généralement l'équivalent latin non accentué. Spécifier manuellement l'allemand, le français ou l'espagnol comme langue du document (ou utiliser un mode multilingue) résout généralement ce problème. Si ce n'est pas le cas, votre outil peut ne pas avoir de modèles spécifiques à la langue pour ces langues du tout.
Quelle est la différence de précision entre la détection automatique et la sélection manuelle de la langue ?
Sur des documents propres et monolingues, la différence est souvent faible — la détection automatique moderne atteint une précision de 95 %+ pour les langues principales. Sur des documents au contenu mixte, au format inhabituel ou dans des langues disposant de jeux de données d'entraînement plus restreints, l'écart se creuse considérablement. La sélection manuelle de la langue sur un document monolingue connu offre la meilleure précision possible, car elle élimine l'étape de détection en tant que point de défaillance. Sur les documents multilingues, la sélection manuelle seule ne suffit pas — l'outil doit prendre en charge l'attribution de la langue par segment ou utiliser une approche de lecture sémantique qui ne dépend pas du tout de la classification linguistique.
Le problème de détection de langue ne concerne pas la qualité de l'image ni les réglages OCR — il s'agit de savoir si votre outil traite la langue comme une barrière à franchir avant la lecture, ou comme un détail sans importance qu'il n'est jamais nécessaire de décider.