Warum Mixed-Language-OCR
die Sprache falsch erkennt – 3 Ursachen und Lösungen
Du fütterst ein Dokument in ein OCR-Tool und bekommst Text zurück, der technisch lesbar ist – aber falsch. Eine deutsche Rechnung gibt "Rechnung" als "Rechnung" aus (korrekt), aber "Geschäftsführer" wird zu "Geschaftsfuhrer" – die Umlaute sind verschwunden. Ein japanischer Auftrag mit gemischten Kanji- und englischen Zeichen liefert "注文書" als verstümmelte vereinfachte chinesische Zeichen. Du hast alles richtig gemacht: Das Bild war klar, der Kontrast gut, die Auflösung ausreichend. Das Problem ist nicht die Bildqualität. Es ist die Spracherkennung.
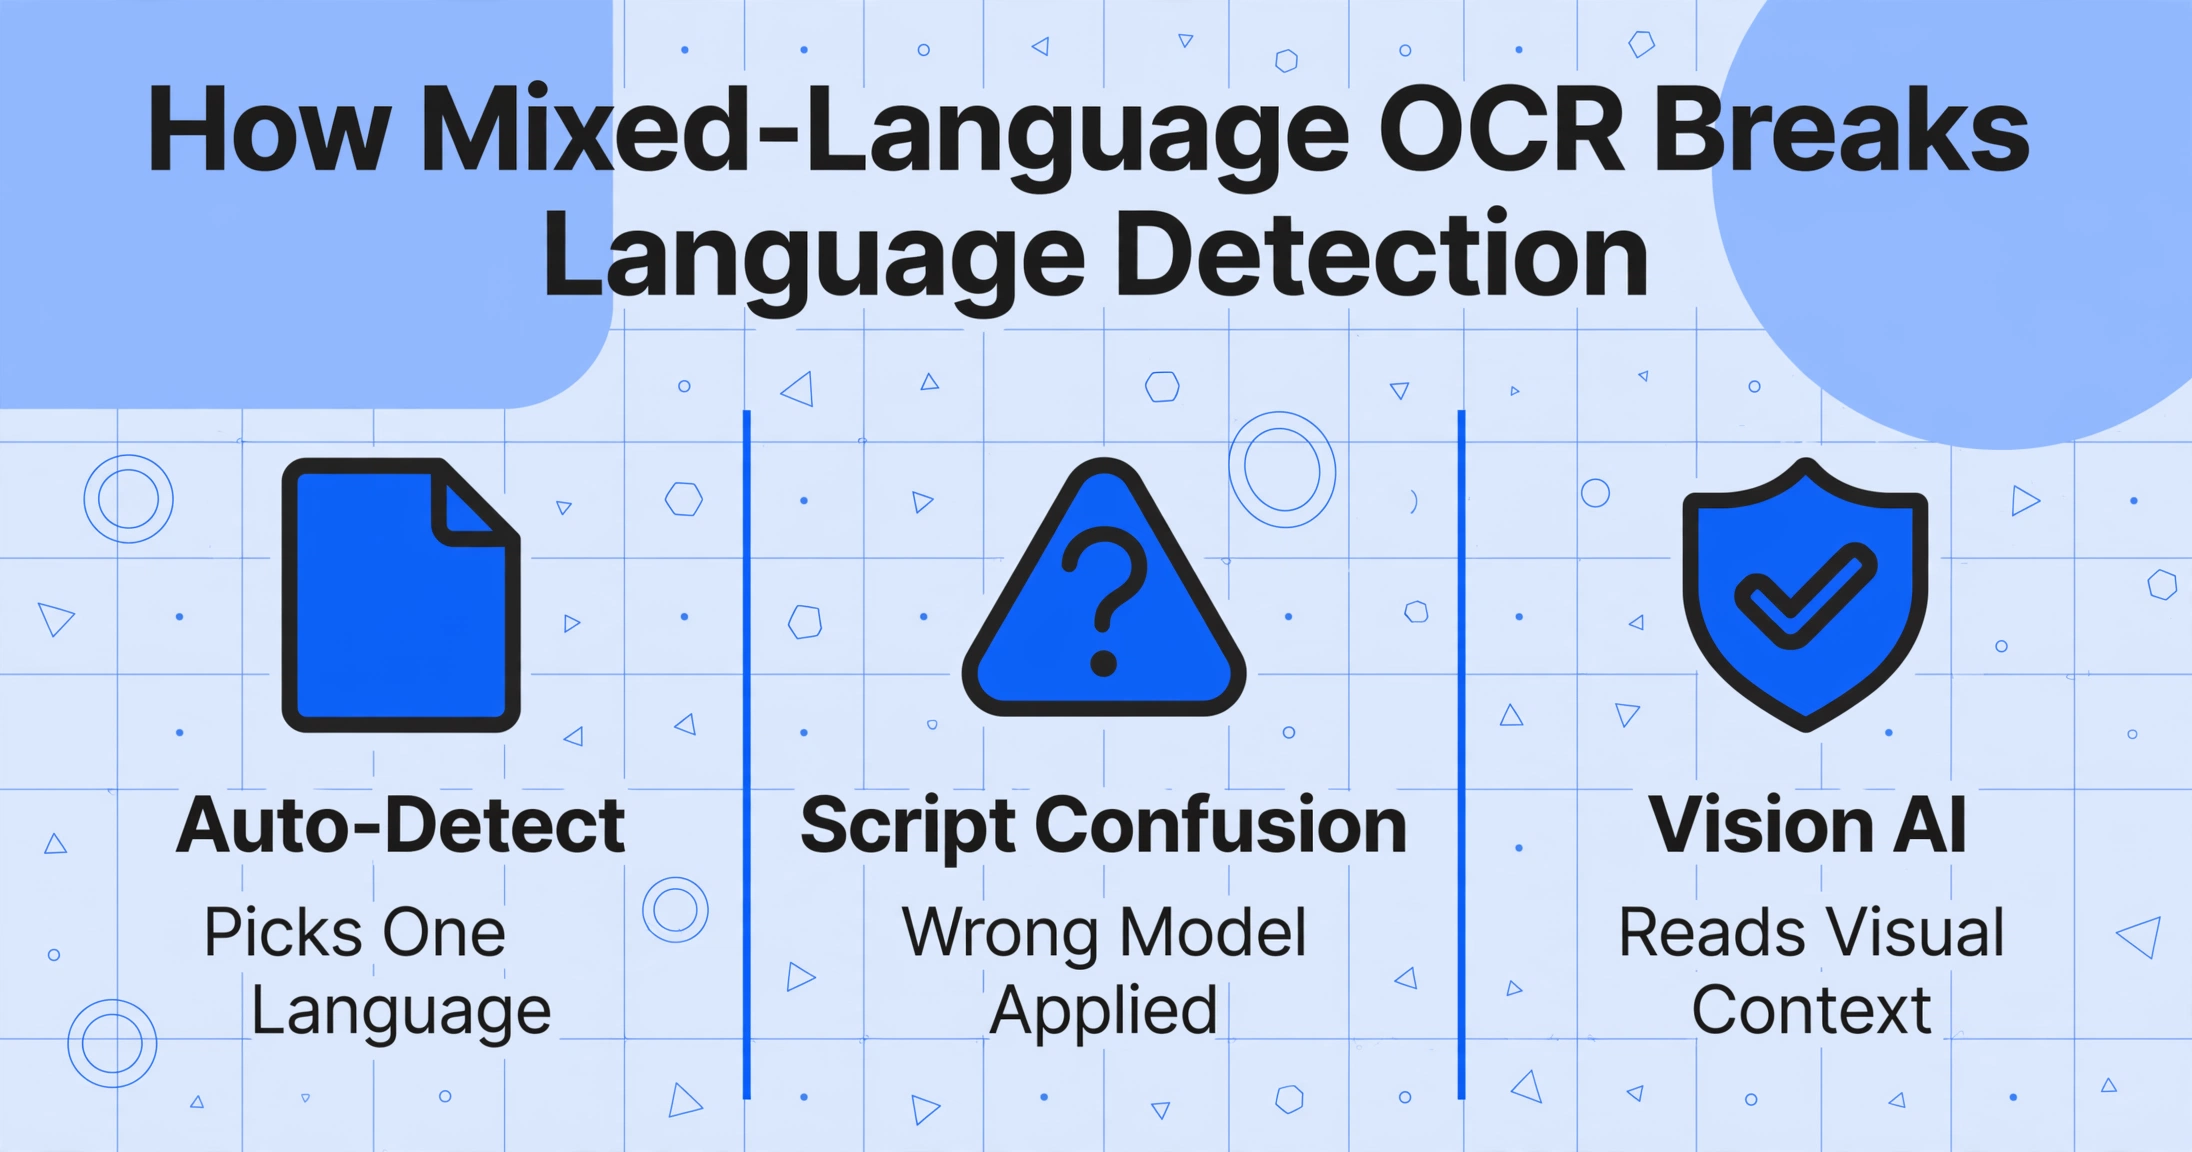
Die wichtigsten Erkenntnisse
- OCR-Ausgabe kann technisch lesbar, aber völlig falsch sein – eine italienische Rechnung über 1.250 € wird zu 1,25 €, weil die Engine englische Zahlenformatierung auf ein italienisches Dokument anwendet.
- Der Fehlerpunkt liegt vor der Zeichenerkennung: Die meisten Tools entscheiden die Sprache der Seite, bevor sie ein einziges Wort lesen, und jedes Zeichen, das nicht zur gewählten Sprache passt, wird stillschweigend verschlechtert.
- Behebe die Architektur, nicht die Erkennung – Tools, die Dokumente visuell lesen, ohne einen Sprachauswahl-Schritt, beseitigen das Spracherkennungsproblem, statt es mit weiteren Sprachpaketen zu flicken.
Die Spracherkennung bei OCR klingt unkompliziert: die ersten Wörter scannen, die Sprache erraten, das passende Erkennungsmodell anwenden. In der Praxis scheitert sie auf vorhersehbare Weise, kostet dich Zeit und liefert Ergebnisse, die auf den ersten Blick richtig aussehen, im Detail aber falsch sind. Und wenn du mit Dokumenten arbeitest, die mehr als eine Sprache enthalten — was in einem globalisierten Geschäft bei den meisten Dokumenten der Fall ist — steigt die Fehlerquote steil an.
Dieser Artikel zeigt die drei konkreten Wege, auf denen die OCR-Spracherkennung scheitert, damit du diagnostizieren kannst, welche Ursache dein Problem ist, und weißt, welche Lösung tatsächlich greift.
Ursache 1: Automatische Erkennung wählt eine Sprache für das gesamte Dokument
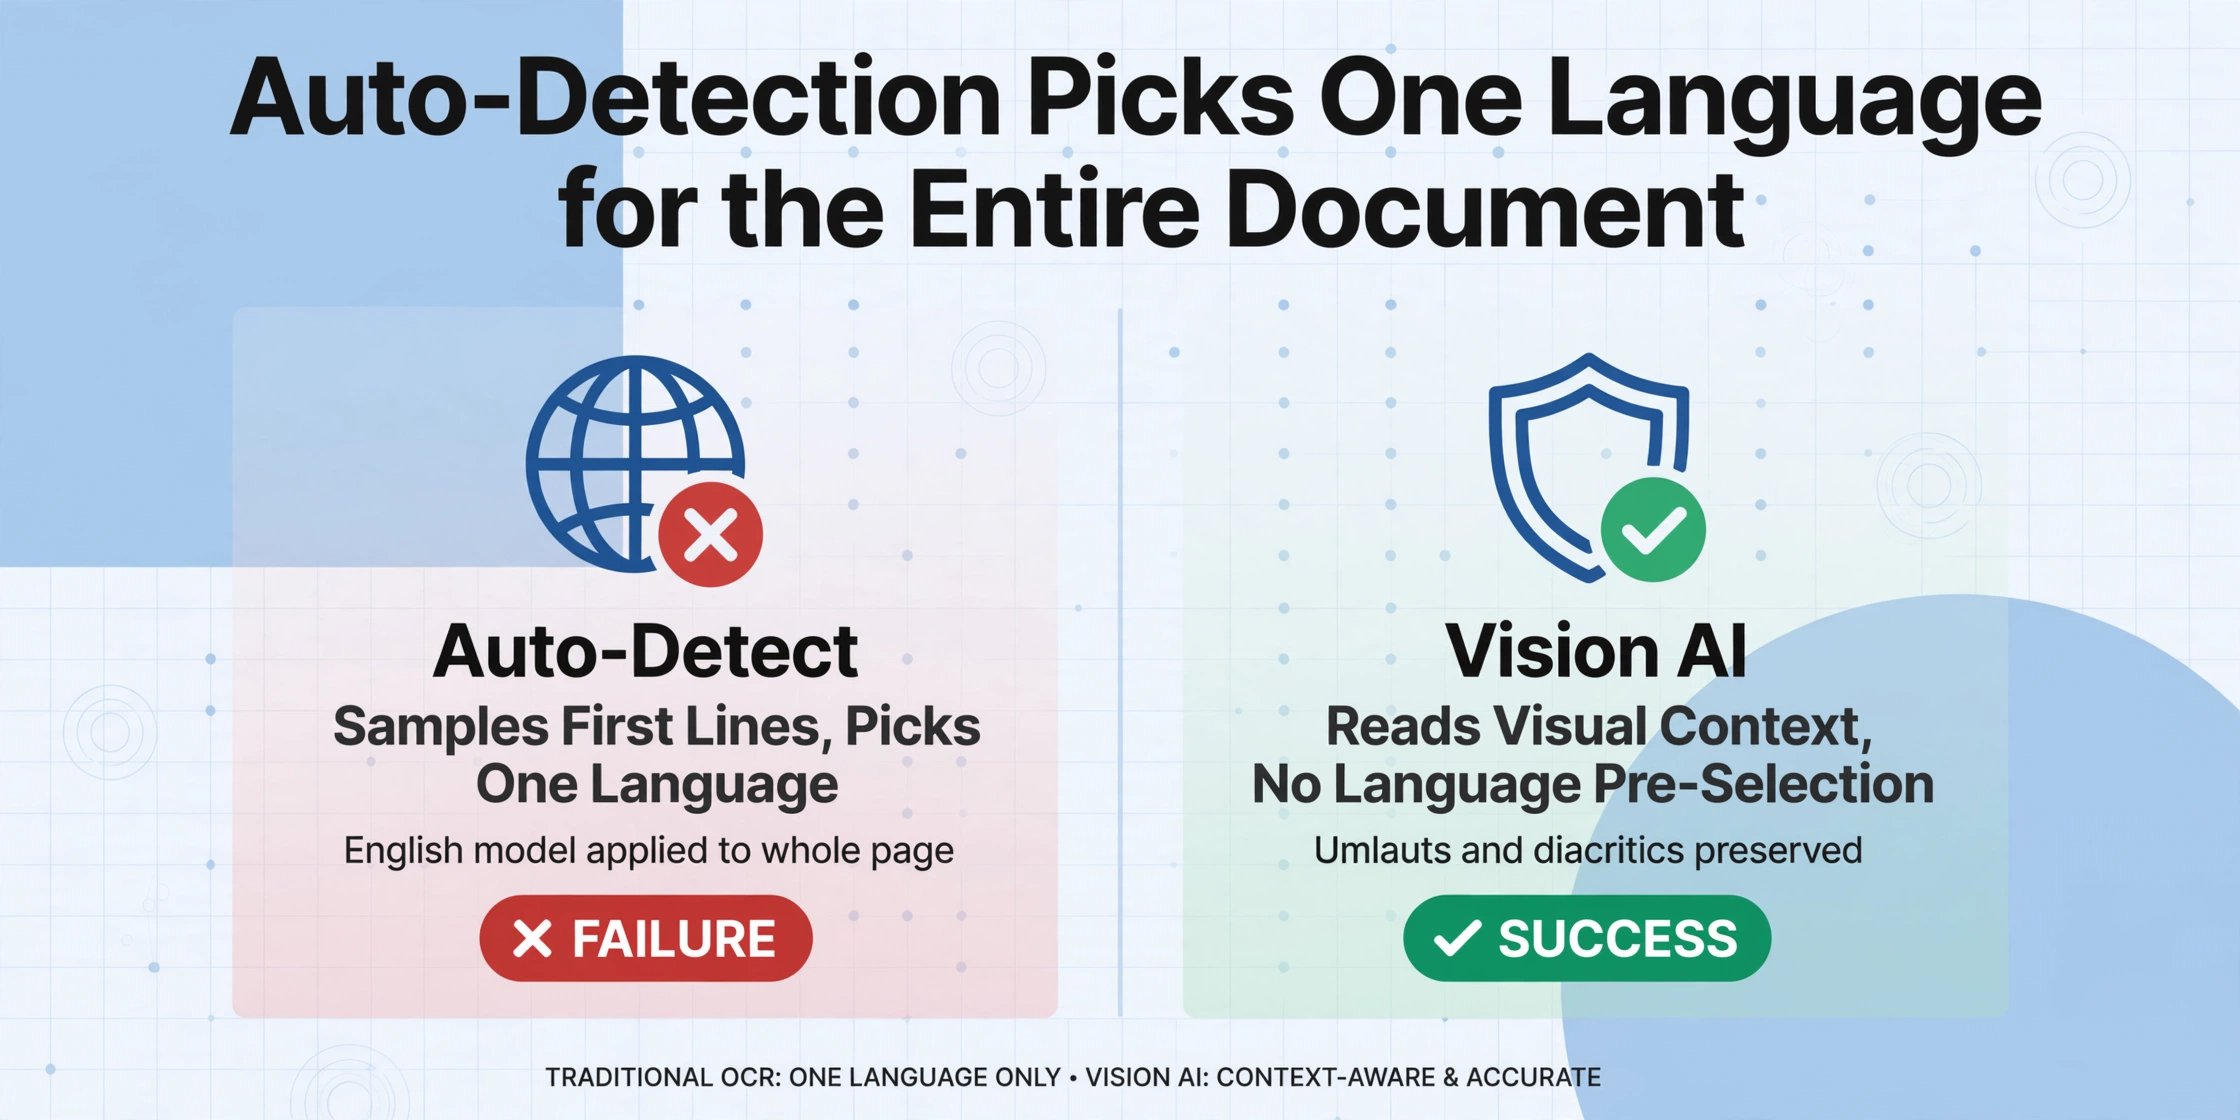
Das häufigste Problem bei der OCR-Spracherkennung tritt auf, bevor die OCR-Engine auch nur ein einziges Zeichen liest. Die meisten traditionellen OCR-Tools verwenden einen Schritt zur automatischen Erkennung, der die ersten Zeilen oder Absätze eines Dokuments abtastet, einen Algorithmus zur Sprachidentifikation ausführt — typischerweise etwas wie fastText oder langdetect — und die wahrscheinlichste Sprache für die gesamte Seite auswählt. Dann wird das gesamte Dokument durch ein Erkennungsmodell geleitet, das auf dieser einen Sprache trainiert wurde.
Das funktioniert gut, wenn das Dokument einsprachig ist. Es scheitert sofort, wenn das Dokument in einer Sprache beginnt und in eine andere wechselt, oder wenn die Sprache der Überschrift nicht der Sprache des Fließtexts entspricht.
Praxisbeispiel
Eine deutsche Rechnung mit englischem Firmenkopf: "GlobalTech Solutions Inc. — Rechnungsnummer: 2024-0871 — Lieferdatum: 15. März 2024 — Geschäftsführer: Dr. Müller." Die automatische Erkennung liest oben "GlobalTech Solutions Inc." und wählt Englisch. Das gesamte Dokument wird mit dem englischen Sprachmodell verarbeitet. Ergebnis: "Geschäftsführer" wird zu "Geschaftsfuhrer", "März" zu "Marz" und "Straße" wird als "Strasse" ausgegeben — nicht unlesbar, aber auch nicht korrekt. Die Umlaute werden stillschweigend entfernt, weil das englische Modell keine Wörterbucheinträge für diese Zeichen hat.
Dasselbe Problem betrifft jede Sprache mit diakritischen Zeichen — Französisch (élève → eleve), Spanisch (año → ano), Portugiesisch (ç wird entfernt), Polnisch (ł → l). Die Zeichen sind auf der Seite visuell vorhanden, aber das Erkennungsmodell erwartet sie nicht, also ordnet es sie dem nächstgelegenen ASCII-Äquivalent zu oder entfernt sie vollständig.
Das ist kein "Bug" in der OCR-Engine. Es ist eine Design-Annahme: Traditionelle OCR-Pipelines sind um die Idee einer Sprache pro Seite herum aufgebaut. Wenn diese Annahme bricht, sinkt die Genauigkeit nicht, weil das Bild schlecht ist — sondern weil die Engine versucht, ein französisches Wort mit einem deutschen Wörterbuch zu dekodieren.
Ursache 2: Schriftsystem-Verwechslung – wenn Zeichen ähnlich aussehen, aber Unterschiedliches bedeuten
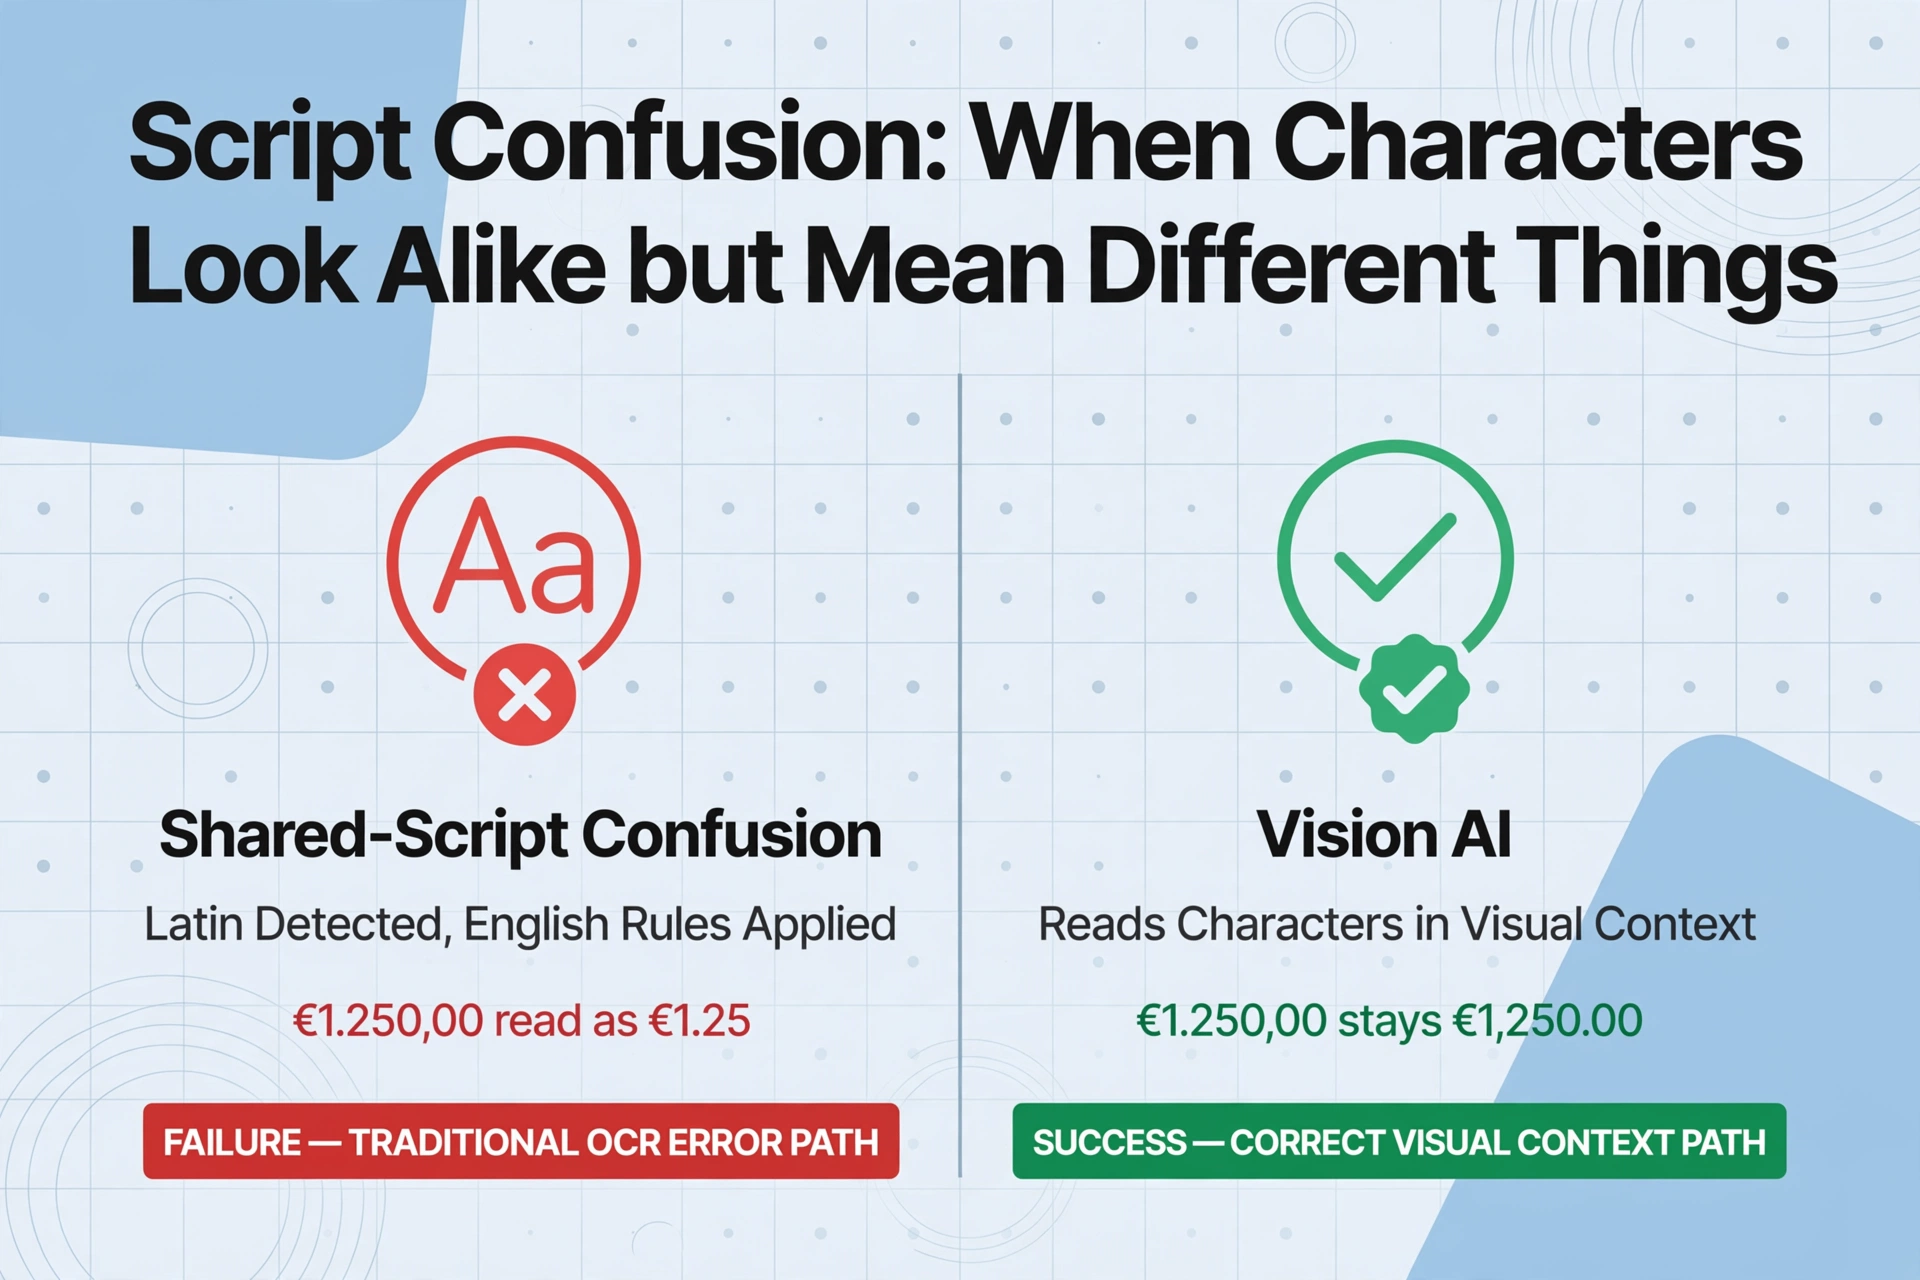
Eine schwierigere Klasse von Spracherkennungsfehlern tritt auf, wenn das Schriftsystem (die Schrift) von mehreren Sprachen geteilt wird oder wenn zwei Schriftsysteme visuell überlappende Zeichen haben. Die automatische Erkennung identifiziert das Schriftsystem korrekt – Lateinisch, Han (CJK), Kyrillisch – wählt aber die falsche Sprache innerhalb dieser Schriftsystem-Familie.
Das Problem geteilter Schriftsysteme
Das lateinische Schriftsystem wird von Englisch, Französisch, Deutsch, Spanisch, Italienisch, Portugiesisch, Niederländisch, Schwedisch, Norwegisch und Dutzenden anderen Sprachen geteilt. Wenn eine OCR-Engine lateinische Schrift erkennt und automatisch Englisch auswählt – die Standardsprache der meisten Tools – wird jedes französische Accent aigu, deutsche Umlaut und spanische Tilde zum Problem. Die Engine kann die Zeichen lesen, aber ihr Nachbearbeitungswörterbuch wendet englische Rechtschreibregeln an, sodass gültige Fremdwörter ins Englische „korrigiert" werden.
Praxisbeispiel
Ein italienischer Lieferant sendet ein Dokument mit „Fattura — Importo: € 1.250,00 — Spedizione: via Roma, 15." Als Englisch erkannt. Die OCR-Engine liest das Komma in „1.250,00" als Dezimaltrennzeichen statt als Tausendertrennzeichen – weil Englisch Punkte für Dezimalstellen und Kommas für Gruppierung verwendet, während Italienisch es umgekehrt macht. Das Ergebnis: €1.250,00 (eintausendzweihundertfünfzig Euro) wird als €1.25 (ein Euro und fünfundzwanzig Cent) ausgegeben. Das ist kein Lesefehler – es ist ein Formatierungsinterpretationsfehler, der durch das falsche Sprachmodell verursacht wird.
CJK-Schriftsystem-Verwechslung: Kanji, Hanzi und Hanja
Die schmerzhafteste Schriftsystem-Verwechslung passiert in ostasiatischen Sprachen. Chinesisch, Japanisch und Koreanisch verwenden alle aus dem Chinesischen stammende Schriftzeichen (Hanzi im Chinesischen, Kanji im Japanischen, Hanja im Koreanischen), und viele einzelne Zeichen sind allen drei gemeinsam. Ein japanisches Dokument verwendet Kanji-Zeichen, die optisch mit vereinfachten chinesischen Zeichen übereinstimmen – aber Bedeutung, Lesart und Kontext sind völlig unterschiedlich.
Wenn die OCR-Engine für ein japanisches Dokument automatisch „Chinesisch“ erkennt – was routinemäßig passiert, weil Kanji und Hanzi sich stark überschneiden –, ist die Ausgabe technisch lesbar, aber sprachlich falsch. Die Engine wendet chinesische Zeichenmodelle und Wörterbuch-Biasing auf Text an, der auf Japanisch geschrieben wurde. Wörter, die als Kun-yomi oder On-yomi (japanische Lesarten) gelesen werden sollten, erhalten chinesische Aussprachen. Gemischter japanischer Inhalt – Hiragana und Katakana durchsetzt mit Kanji – verwirrt die Erkennung weiter, weil die Engine nicht weiß, welchem Schriftsystem sie Priorität geben soll.
Traditionelle OCR behandelt das als binär: Entweder ist die Seite chinesisch oder japanisch. Sie hat kein Konzept für „diese Seite ist beides.“ Ein Dokument, das vereinfachten chinesischen Text mit englischen Produktcodes mischt, oder japanischen Fließtext mit englischen Lehnwörtern, löst Sprachmodelle aus, die unvorhersehbar zwischen korrekten und falschen Interpretationen wechseln.
Ursache 3: Gemischtsprachige Dokumente brechen die Annahme „Eine Sprache pro Seite“
Der schwierigste Fall – und der häufigste im internationalen Geschäft – ist ein einzelnes Dokument, das tatsächlich zwei oder mehr Sprachen enthält, nicht wegen Erkennungs-Mehrdeutigkeit, sondern absichtlich.
Denk an einen multinationalen Vertrag mit englischen Klausel-Überschriften und französischem Fließtext. Oder ein Versandetikett mit der Herkunftsadresse auf Japanisch, dem Ziel auf Englisch und Zollerklärungen in der Landessprache. Oder eine Krankenakte aus einer Schweizer Klinik, in der das Aufnahmeformular auf Deutsch ist, die Laborergebnisse auf Französisch und die Diagnosezusammenfassung auf Englisch. Das sind keine Randfälle – das sind Routine-Dokumente im globalen Betrieb.
Traditionelle OCR verarbeitet diese Dokumente, indem sie eine Sprache auf Dokumentebene auswählt, sie einheitlich anwendet und den Genauigkeitsverlust bei jedem Segment akzeptiert, das nicht übereinstimmt. Das Ergebnis ist eine Ausgabe, in der einige Abschnitte perfekt aussehen und andere, als wären sie mit einem völlig anderen Tool verarbeitet worden – denn in gewissem Sinne sollten sie das auch.
Selbst Tools, die den „Mehrsprachen-Modus“ unterstützen, tun das oft, indem sie Sprachmodelle sequenziell verketten – erst Englisch versuchen, dann Französisch, dann Deutsch, und pro Zeile das Ergebnis mit der höchsten Konfidenz nehmen. Das funktioniert in der Praxis schlecht, weil benachbarte Zeilen in verschiedenen Sprachen sich gegenseitig beeinflussen und die Konfidenzbewertung selbst sprachabhängig ist: Ein auf Englisch trainiertes Modell hat auf englischem Text von Natur aus höhere Konfidenz als ein Modell, das auf einer Sprache mit weniger Trainingsdaten trainiert wurde, selbst wenn beide ihre jeweiligen Sprachen korrekt lesen.
Was Vision-KI anders macht – und warum das die Gleichung verändert
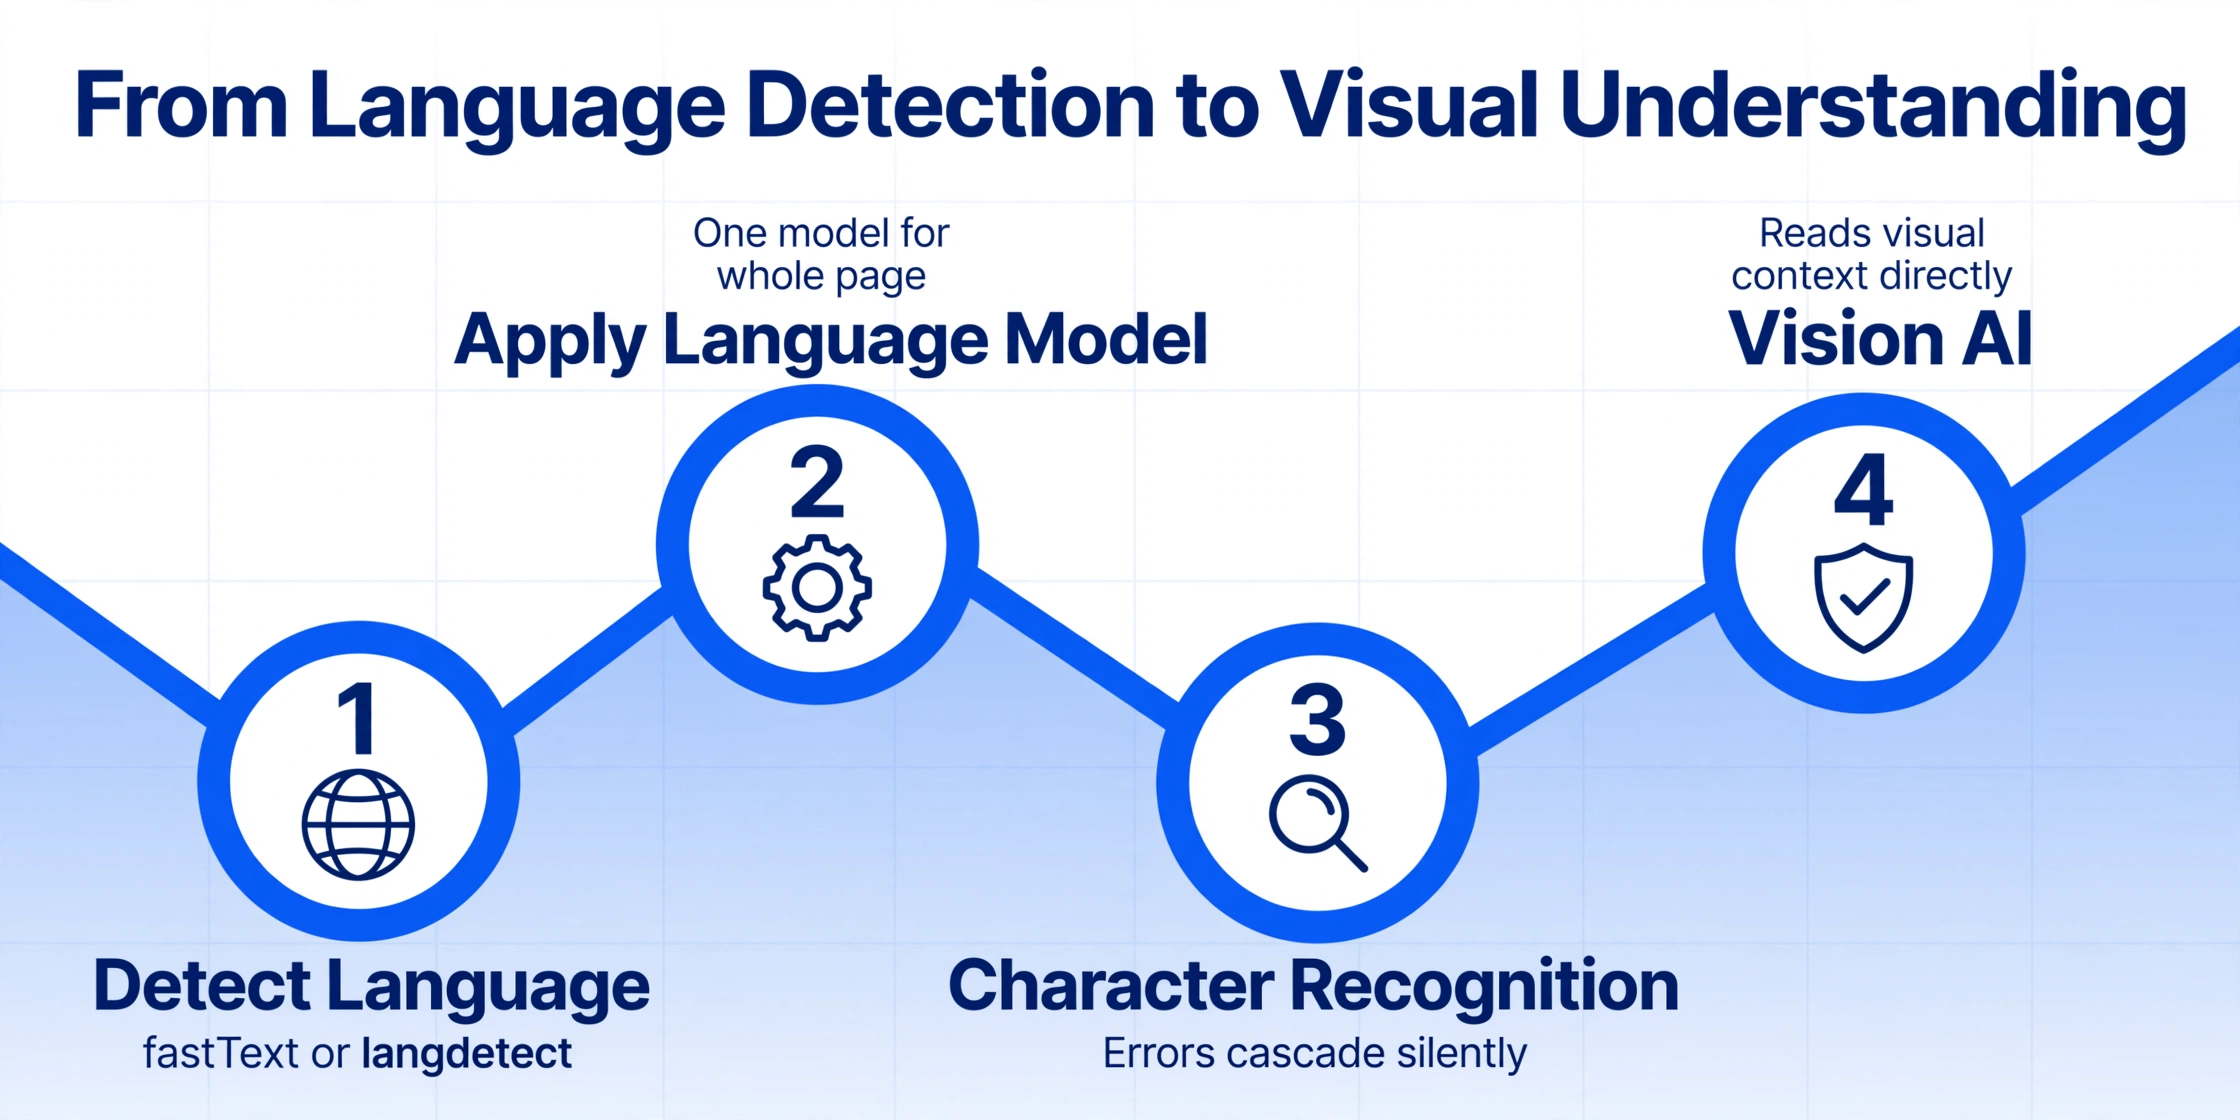
Der Grund, warum die Spracherkennung immer wieder scheitert, ist architektonischer Natur. Traditionelle OCR-Pipelines trennen die Spracherkennung von der Zeichenerkennung in zwei aufeinanderfolgende Stufen: (1) die Sprache identifizieren, dann (2) das Modell für diese Sprache anwenden. Wenn Stufe eins falsch liegt, hat Stufe zwei keine Chance auf Korrektur.
Vision-KI – die Technologie hinter Tools wie ImageToTable.ai – fasst diese Pipeline zu einem einzigen Schritt des semantischen Verständnisses zusammen. Statt zu fragen „Welche Sprache ist das?“ und dann „Welche Zeichen bilden diese Pixel?“, liest das Modell den visuellen Inhalt ganzheitlich: Es interpretiert Zeichen, Zahlen und Symbole in ihrem visuellen Kontext, unabhängig von einem vorab ausgewählten Sprachmodell.
Dieser Paradigmenwechsel – von schriftsystemspezifischen Erkennungsmodellen zu visuellem semantischem Verständnis – bedeutet, dass Fehler bei der automatischen Spracherkennung nicht mehr zu Fehlern bei der Zeichenerkennung führen können, weil die Zeichenerkennung nie von der Sprachauswahl abhängig war. Eine japanische Rechnung mit englischen Begriffen, ein deutscher Vertrag mit französischen Klauseln, ein Versandetikett mit drei Schriftsystemen – jedes wird als visuelles Ganzes gelesen, nicht als eine Seite, die in eine Sprachkategorie eingeordnet werden muss.
Das heißt nicht, dass Vision-KI perfekt ist – es bedeutet, dass sich die Art des Scheiterns ändert. Statt stillschweigend Umlaute zu verschlucken, weil das falsche Sprachmodell ausgewählt wurde, liest das Modell die Zeichen entweder korrekt oder markiert mehrdeutige Bereiche zur Überprüfung. Die Ausgabe ist nicht stillschweigend falsch; sie ist entweder richtig oder explizit unsicher. Zum ersten Mal hört das „Spracherkennungsproblem“ auf, die Ursache für schlechte OCR-Ergebnisse zu sein.
Was du jetzt tun kannst – praktische Lösungen
Unabhängig davon, welches Tool du verwendest, gibt es drei Dinge, die Spracherkennungsfehler in deiner OCR-Ausgabe sofort reduzieren.
Wenn dein OCR-Tool eine manuelle Sprachauswahl erlaubt, nutze sie. Bei einsprachigen Dokumenten umgehst du damit die automatische Erkennung komplett. Bei gemischtsprachigen Dokumenten gib eine Hauptsprache an und prüfe, ob das Tool eine sekundäre Sprach-Fallback-Option unterstützt (viele bewerben diese Funktion nicht, aber es lohnt sich, sie zu testen). Tesseract unterstützt einen „+“-Operator – eng+deu+fra – der mehrere Sprachmodelle parallel verarbeitet und pro Segment die beste Übereinstimmung wählt, auch wenn dies, wie oben erwähnt, eigene Genauigkeitsgrenzen hat.
Die zuverlässigste Lösung ist die Nutzung eines Vision-KI-basierten Extraktionstools, das Dokumente semantisch liest statt über schriftsystemspezifische Modelle. Diese Tools fragen nicht „Welche Sprache ist das?“, weil die Antwort für die Art, wie sie die Seite lesen, irrelevant ist. Das Ergebnis ist identisch, ob dein Dokument auf Deutsch, Japanisch, Arabisch oder in einer Mischung aus allen dreien vorliegt – das Modell verarbeitet den visuellen Inhalt direkt.
Teste die Spracherkennungsgenauigkeit von OCR nicht an sauberen einsprachigen Testproben – deine Produktionsdokumente sind nicht so einfach. Nimm deine drei schwierigsten gemischtsprachigen Dokumente – eine deutsch-englische Rechnung, ein japanisch-englisches Datenblatt, einen französisch-englischen Vertrag – und lass sie durch deine Kandidaten-Tools laufen. Prüfe bestimmte hochwertige Felder: Beträge mit europäischer vs. US-Zahlenformatierung, Namen mit Diakritika, Adressen mit gemischten Schriftsystemen. Das Tool, das diese auf deinen echten Dokumenten korrekt verarbeitet, ist das, das in der Produktion funktioniert.
Wann eskalieren: Ein nicht behebbares Spracherkennungsproblem erkennen
Manche Spracherkennungsprobleme lassen sich durch Konfiguration und Workflow-Änderungen beheben. Andere deuten darauf hin, dass das Tool selbst architektonisch nicht in der Lage ist, deinen Dokumentbestand zu verarbeiten. So erkennst du den Unterschied.
Wenn dein OCR-Tool überwiegend korrekte Ausgabe liefert, aber gelegentlich diakritische Zeichen weglässt oder Zahlenformate auf gemischtsprachigen Seiten falsch liest, löst das manuelle Festlegen der Sprache oder eine Nachbearbeitung das Problem wahrscheinlich. Tesseract zum Beispiel kann mit mehreren Sprachpaketen und spezifischen Seiten-Segmentierungsmodi konfiguriert werden, die Erkennungsfehler deutlich reduzieren.
Wenn dein Tool durchgängig Ausgabe liefert, bei der ganze Abschnitte falsch sind – deutscher Fließtext als Englisch gelesen, japanische ganze Absätze als Chinesisch zurückgegeben oder eine völlige Unfähigkeit, Seiten mit mehr als einem Schriftsystem zu verarbeiten – wird manuelle Konfiguration das nicht beheben. Die Architektur selbst ist der Engpass. In diesem Fall ist die Lösung, zu einem Vision-KI-Tool zu wechseln, das nicht von der Sprachvorauswahl abhängt.
Schnelle Diagnose-Checkliste
- ✓ Ausgabe hat korrekte Zeichen, aber fehlende diakritische Zeichen (deutsche Umlaute, französische Akzente) → Behebbar (manuelle Sprachauswahl oder Sprachpaket)
- ✓ Ausgabe hat den richtigen Text, aber das falsche Zahlenformat (Komma vs. Punkt) → Behebbar (manuelle Sprach- und Gebietsschema-Konfiguration)
- ✗ Ganze Abschnitte werden im falschen Schriftsystem gelesen (Kanji als Hanzi, Kyrillisch als Lateinisch) → Architektonisch (zu Vision-KI wechseln)
- ✗ Gemischtsprachige Dokumente liefern bei verschiedenen Durchläufen inkonsistente Ausgabe → Architektonisch (automatische Erkennung ist probabilistisch instabil)
- ✗ Jedes Dokument wird unabhängig vom tatsächlichen Inhalt als Englisch gelesen → Architektonisch (Tool standardmäßig auf Englisch ohne echte Erkennung)
Häufig gestellte Fragen
Funktioniert OCR mit Dokumenten, die mehr als eine Sprache auf derselben Seite enthalten?
Einige Tools behaupten, das zu unterstützen, aber die Realität hängt von der Architektur ab. Traditionelle OCR-Tools, die eine einzelne Sprache auf Dokumentebene erkennen, verschlechtern die Genauigkeit bei jedem Sprachsegment, das nicht der erkannten Sprache entspricht. Vision-KI-Tools, die Dokumente semantisch lesen – ohne dass eine Sprache vorab ausgewählt werden muss –, verarbeiten mehrsprachige Seiten grundlegend besser, weil sie von vornherein keine Spracherkennung benötigen. Wenn mehrsprachige Dokumente regelmäßig Teil deines Workflows sind, teste gezielt mit deiner Dokumentmischung, bevor du dich für ein Tool entscheidest.
Kann ich die OCR-Spracherkennung durch die Installation zusätzlicher Sprachpakete verbessern?
Bei Tools wie Tesseract ja – die Installation der richtigen .traineddata-Dateien und die Konfiguration des -l-Parameters mit mehreren Sprachen (z. B. eng+deu+fra) können Erkennungsfehler bei bekannten Sprachen reduzieren. Dieser Ansatz setzt jedoch weiterhin voraus, dass die Sprachmodelle auf die richtigen Textsegmente angewendet werden. Auf mehrsprachigen Seiten, auf denen sich Zeilen abwechselnd in verschiedenen Sprachen abwechseln, erzeugt der „+“-Operator eine Best-Effort-Zusammenführung, die besser ist als eine einzelne Sprache, aber immer noch messbar ungenauer als eine sprachspezifische Zuordnung pro Segment. Für eine automatische Erkennung ohne manuelle Paketinstallation bieten Vision-KI-Tools einen grundlegend anderen Ansatz.
Warum liest mein OCR-Tool Japanisch als Chinesisch?
Japanisch und Chinesisch teilen eine große Anzahl von Zeichen (Kanji im Japanischen, Hanzi im Chinesischen). Viele traditionelle OCR-Engines erkennen „CJK“ als breite Schriftsystem-Kategorie und standardisieren auf vereinfachtes Chinesisch, weil es den größten Trainingsdatensatz hat. Das Tool liest die Kanji auf Zeichenebene korrekt, wendet aber chinesische Wörterbuch-Bias und Sprachmodelle an, was bedeutet, dass es nur im Japanischen vorkommende Zeichen (Hiragana, Katakana) falsch interpretiert und falsche Lesarten auf gemeinsame Zeichen anwendet. Die Lösung ist entweder, Japanisch manuell als Dokumentensprache anzugeben (falls das Tool das unterstützt) oder ein Vision-KI-Modell zu verwenden, das Schriftsysteme nativ erkennt, statt über ein Skript-Klassifikations-Gate zu gehen.
Warum lässt OCR immer wieder Umlaute und Akzente aus meinen deutschen/französischen Dokumenten weg?
Der häufigste Grund ist, dass die OCR-Engine „Englisch“ als Dokumentensprache erkannt und ein englisches Erkennungsmodell angewendet hat. Englische Modelle haben keine Einträge für ä, ö, ü, ß, é, è, ê, ñ, ç und ähnliche Zeichen. Wenn die Engine darauf stößt, ordnet sie sie dem nächstgelegenen Zeichen in ihrem Arbeitszeichensatz zu – normalerweise dem unakzentuierten lateinischen Äquivalent. Die manuelle Angabe von Deutsch, Französisch oder Spanisch als Dokumentensprache (oder die Verwendung eines mehrsprachigen Modus) löst das normalerweise. Wenn nicht, verfügt dein Tool möglicherweise überhaupt nicht über sprachspezifische Modelle für diese Sprachen.
Wie groß ist der Genauigkeitsunterschied zwischen automatischer Erkennung und manueller Sprachauswahl?
Bei sauberen, einsprachigen Dokumenten ist der Unterschied oft gering – moderne automatische Erkennung erreicht bei gängigen Sprachen eine Genauigkeit von über 95 %. Bei Dokumenten mit gemischten Inhalten, ungewöhnlicher Formatierung oder Sprachen mit kleineren Trainingsdatensätzen wird die Lücke deutlich größer. Die manuelle Sprachauswahl bei einem bekannten einsprachigen Dokument liefert die bestmögliche Genauigkeit, da sie den Erkennungsschritt als Fehlerquelle eliminiert. Bei gemischtsprachigen Dokumenten reicht die manuelle Auswahl allein nicht aus – das Tool muss eine sprachspezifische Zuweisung pro Segment unterstützen oder einen semantischen Leseansatz verwenden, der gar nicht von der Sprachklassifizierung abhängt.
Das Spracherkennungsproblem hat nichts mit Bildqualität oder OCR-Einstellungen zu tun – es geht darum, ob dein Tool Sprache als ein Tor behandelt, das vor dem Lesen passiert werden muss, oder als ein irrelevantes Detail, das nie entschieden werden muss.