Por que o OCR Multilíngue Continua
Errando o Idioma — 3 Causas Raiz e Correções
Você insere um documento em uma ferramenta de OCR e recebe um texto tecnicamente legível — mas errado. Uma fatura alemã gera "Rechnung" como "Rechnung" (correto), mas "Geschäftsführer" vira "Geschaftsfuhrer" — os tremas desapareceram. Um pedido de compra japonês com Kanji e inglês misturados retorna "注文書" como caracteres chineses simplificados distorcidos. Você fez tudo certo: a imagem estava nítida, o contraste era bom, a resolução era adequada. O problema não é a qualidade da imagem. É a detecção de idioma.
Principais Conclusões
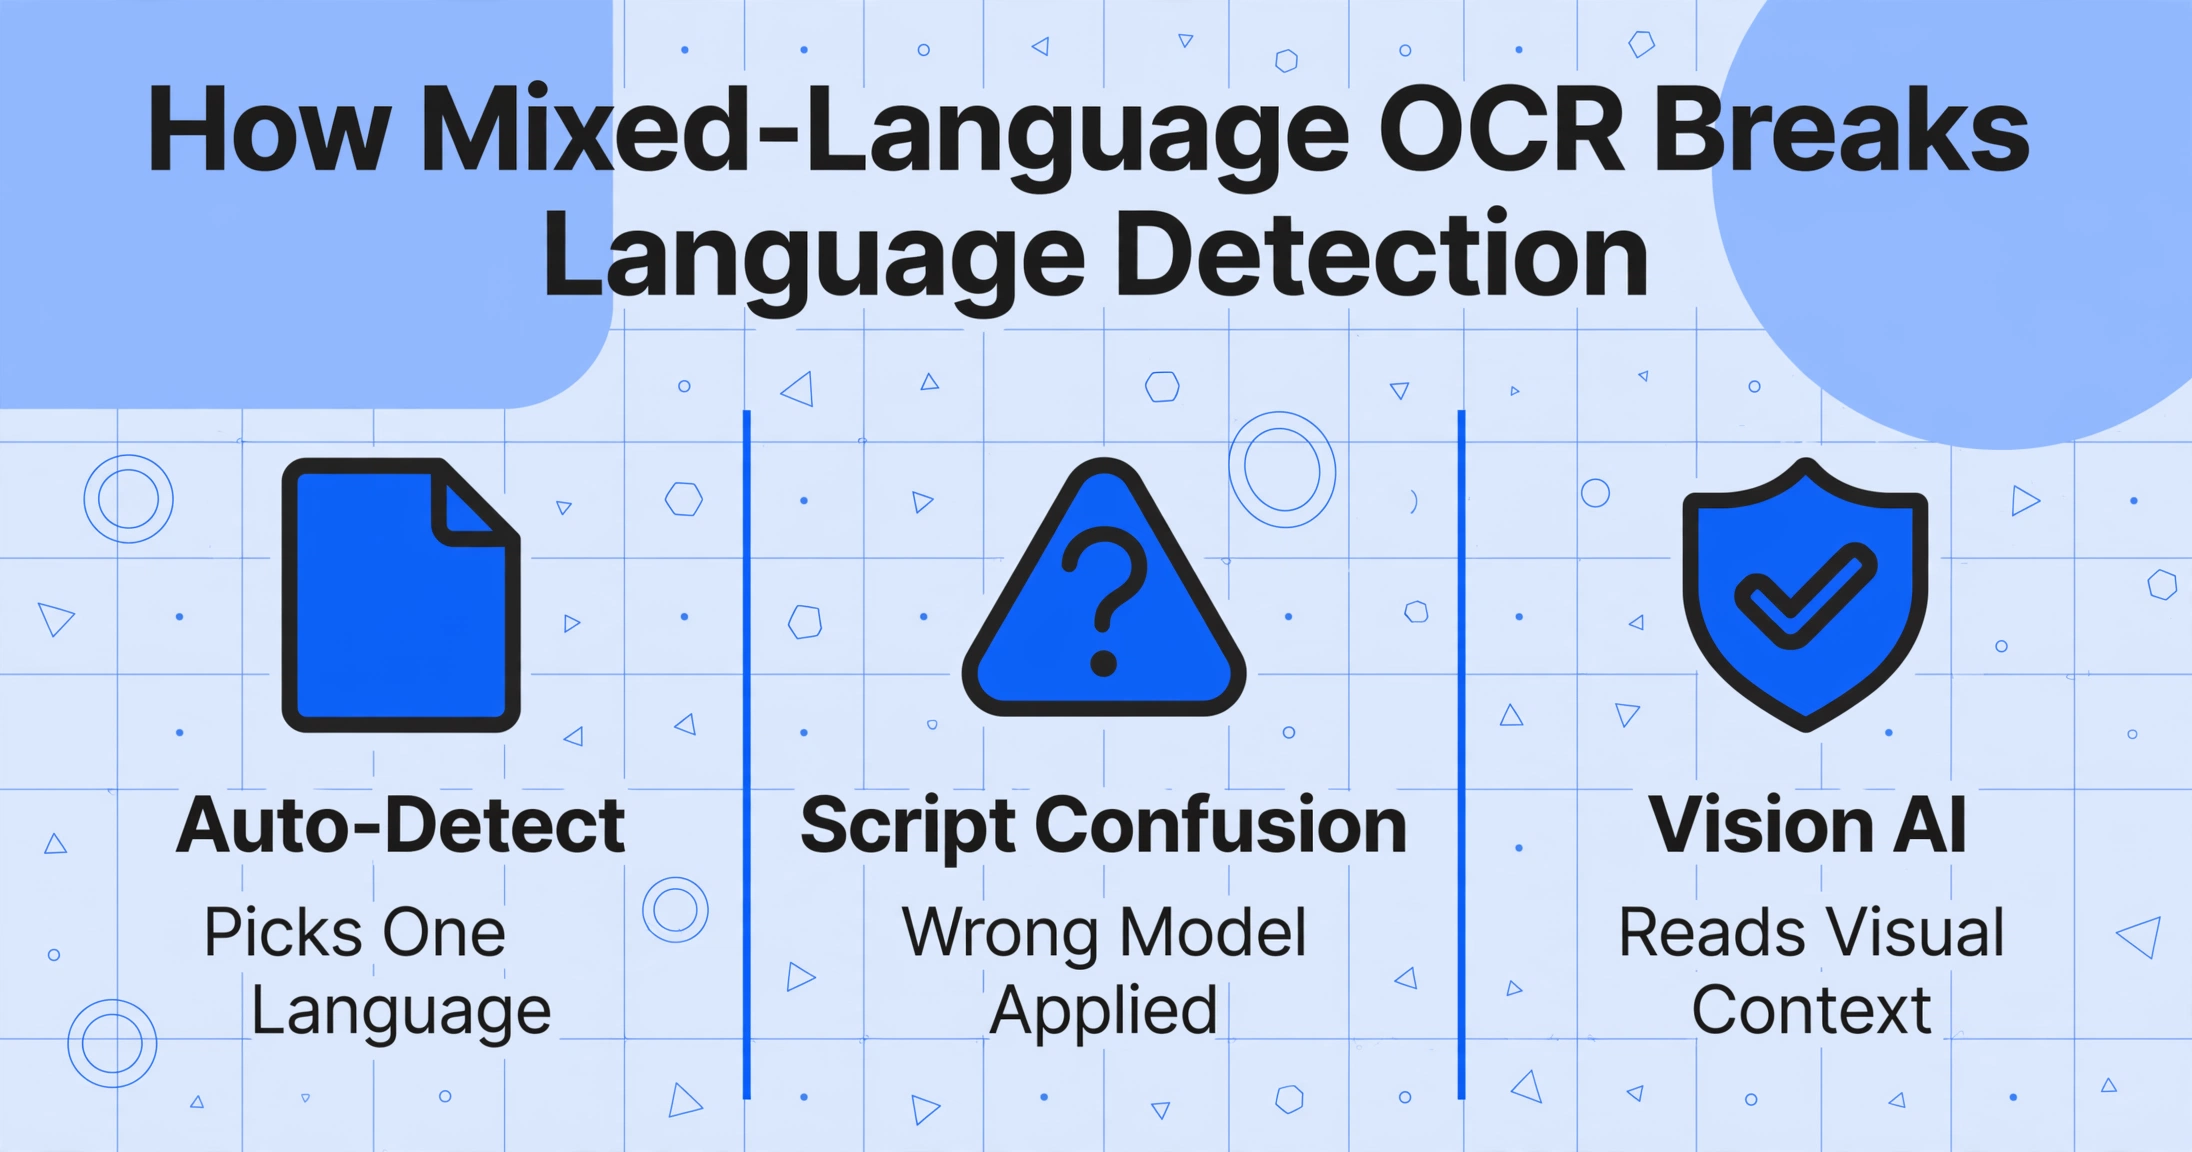
- A saída do OCR pode ser tecnicamente legível e totalmente errada — uma fatura italiana de €1.250 vira €1.25 porque o mecanismo aplicou formatação numérica em inglês a um documento italiano.
- O ponto de falha está antes do reconhecimento de caracteres: a maioria das ferramentas decide o idioma da página antes de ler uma única palavra, e cada caractere que não corresponde ao idioma escolhido é silenciosamente degradado.
- Corrija a arquitetura, não a detecção — ferramentas que leem documentos visualmente, sem uma etapa de seleção de idioma, eliminam o problema de detecção de idioma em vez de remendá-lo com mais pacotes de idiomas.
A detecção de idioma por OCR parece simples: examinar as primeiras palavras, adivinar o idioma e aplicar o modelo de reconhecimento correto. Na prática, falha de maneiras previsíveis que custan tempo e producen resultados que parecen corretos à primeira vista, mas estão errados nos detalhes. E se você trabalha com documentos que contienen más de un idioma — o que, em um negocio globalizado, é a maioria dos documentos — a taxa de falhas aumenta drasticamente.
Este artigo analiza as três maneiras específicas em que a detecção de idioma por OCR falha, para que você possa diagnosticar qual está causando seu problema e saber qual correção realmente se aplica.
Causa 1: A Detecção Automática Selecciona um Único Idioma para Todo o Documento
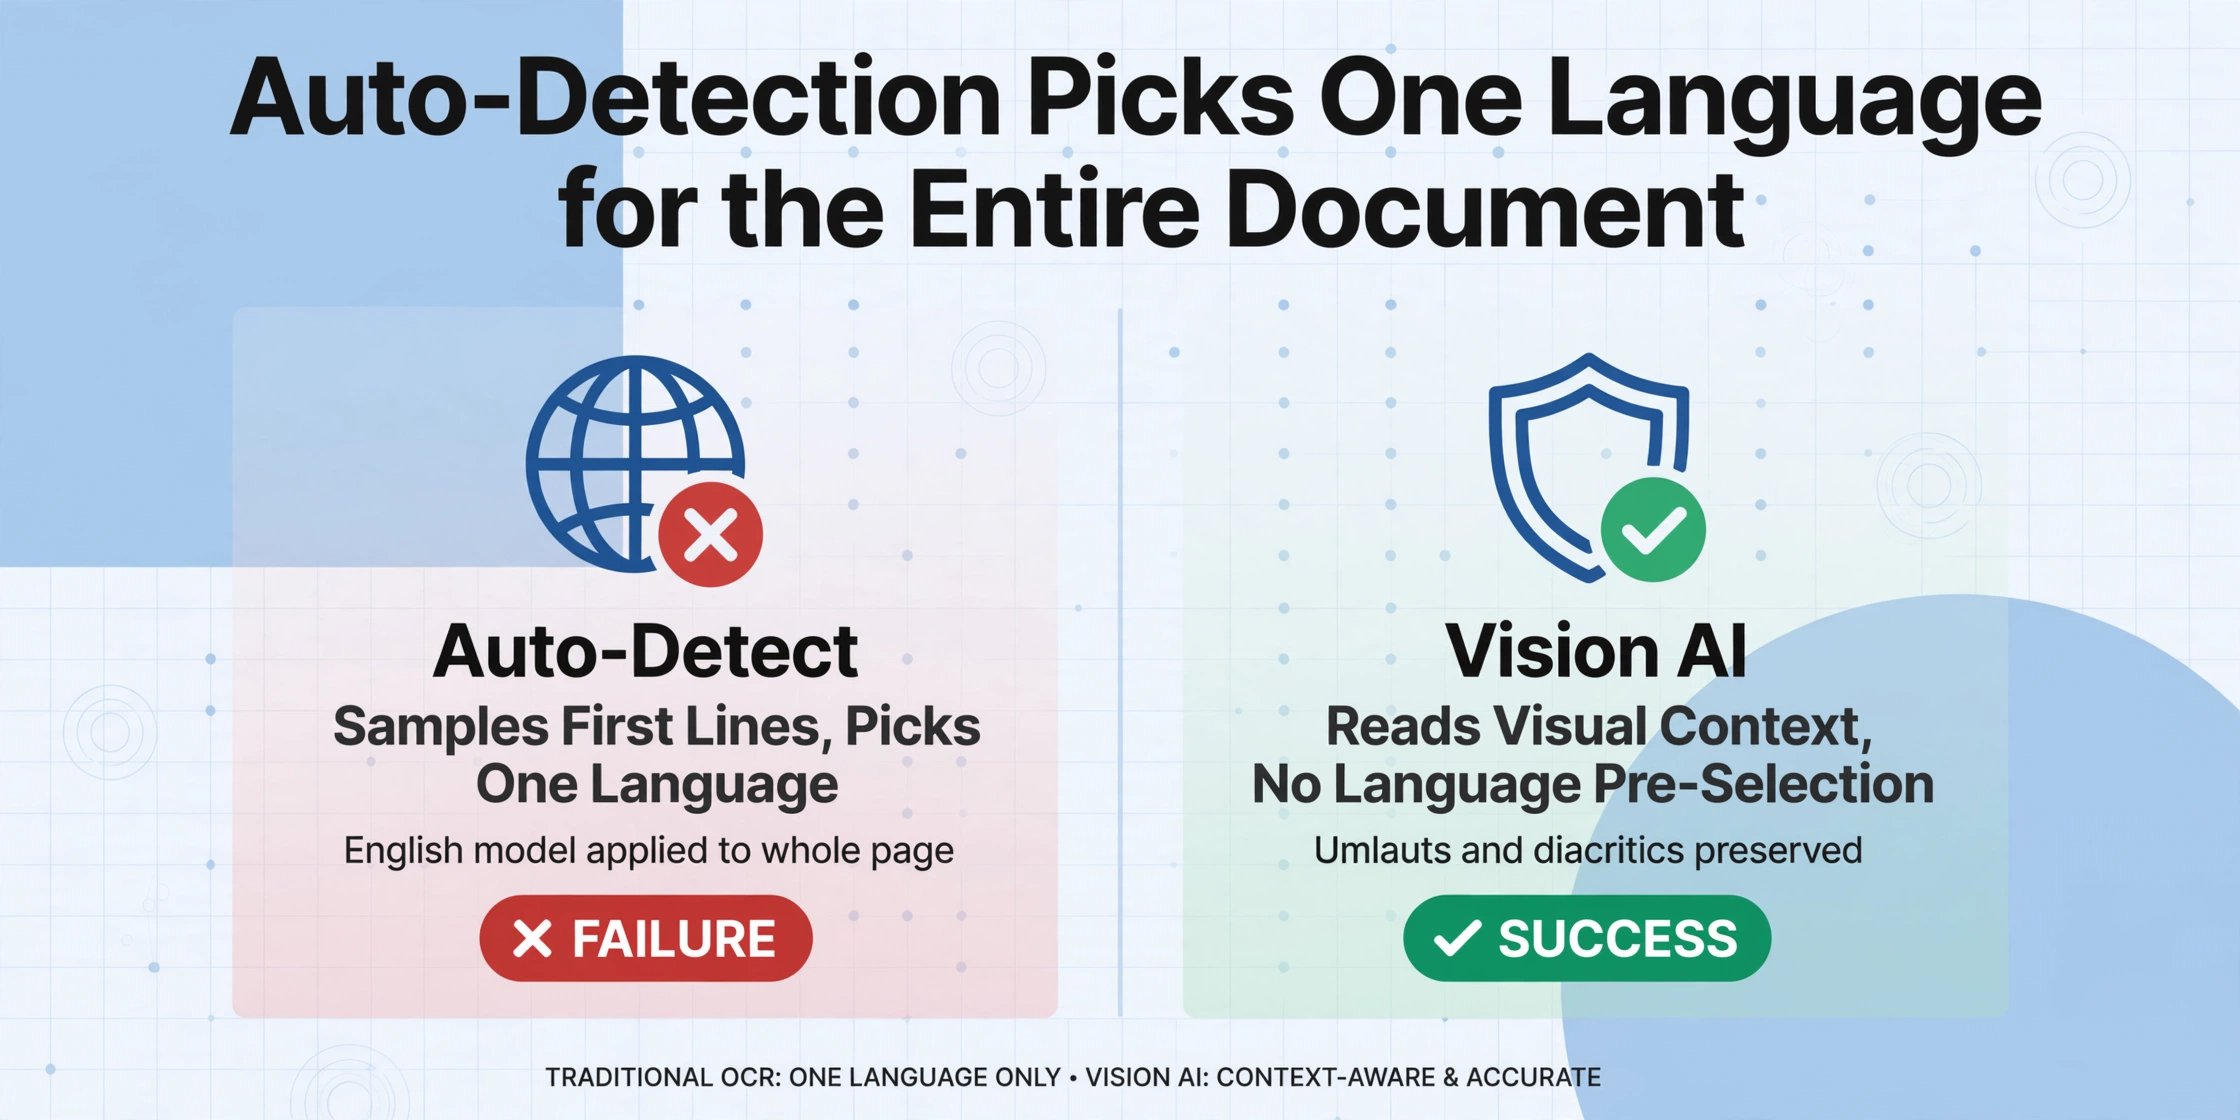
O problema mais comum de detecção de idioma por OCR ocorre antes que o motor de OCR lea um único caractere. A maioria das herramientas tradicionais de OCR usa uma etapa de detecção automática que examina as primeiras líneas ou parágrafos de um documento, executa um algoritmo de identificação de idioma — tipicamente algo como fastText ou langdetect — e selecciona o idioma mais probable para toda a página. Depois, rota todo o documento através de um modelo de reconhecimento treinado nesse único idioma.
Isso funciona bem quando o documento é monolingüe. Falha imediatamente quando o documento começa em um idioma e cambia a outro, ou quando o idioma do título não coincide com o idioma do corpo.
Exemplo do Mundo Real
Uma factura alemã com cabeçalho em inglês: "GlobalTech Solutions Inc. — Rechnungsnummer: 2024-0871 — Lieferdatum: 15. März 2024 — Geschäftsführer: Dr. Müller." A detecção automática lee "GlobalTech Solutions Inc." no topo e selecciona inglês. Todo o documento é processado com o modelo de idioma inglês. Resultado: "Geschäftsführer" se torna "Geschaftsfuhrer," "März" se torna "Marz," e "Straße" se renderiza como "Strasse" — não ilegible, mas tampouco correto. Os umlauts são eliminados silenciosamente porque o modelo inglês não tem entradas de dicionário para esses caracteres.
O mesmo problema afeta qualquer idioma com diacríticos — francês (élève → eleve), espanhol (año → ano), português (ç eliminado), polaco (ł → l). Os caracteres estão visualmente presentes na página, mas o modelo de reconhecimento não os espera, então os mapea ao equivalente ASCII mais próximo ou os elimina por completo.
Isso não é um "bug" no motor de OCR. É uma suposição de diseño: os pipelines tradicionais de OCR são construidos em torno da ideia de um idioma por página. Quando essa suposição se rompe, a precisão cae não porque a imagem seja má — mas porque o motor está tentando decodificar uma palavra francesa com um dicionário alemán.
Causa 2: Confusão de Sistemas de Escrita — Quando Caracteres se Parecem, mas Têm Significados Diferentes
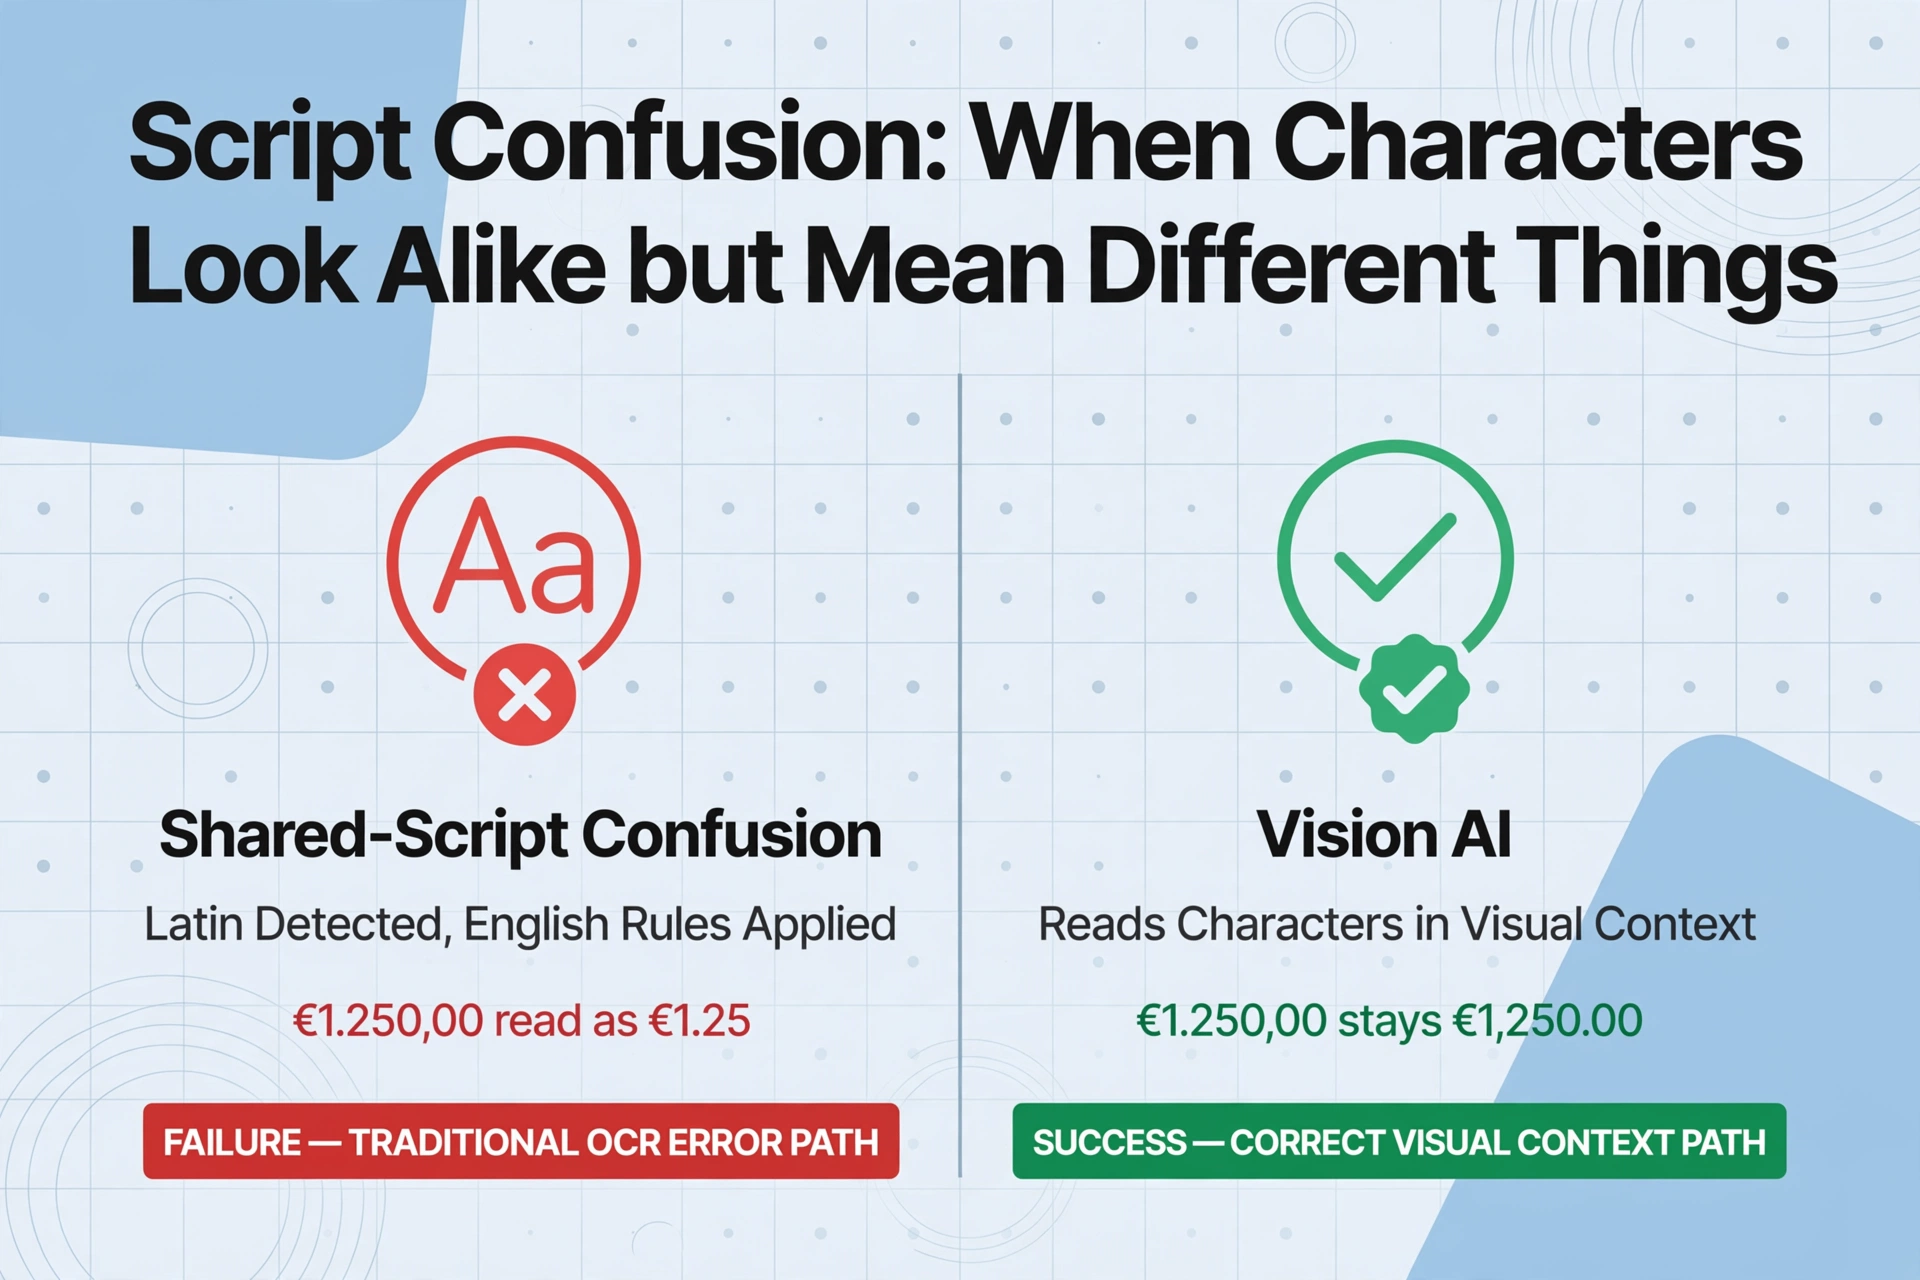
Uma classe mais difícil de falha na detecção de idioma ocorre quando o sistema de escrita é compartilhado entre idiomas, ou quando dois sistemas de escrita têm caracteres visualmente superpostos. A detecção automática identifica corretamente o sistema de escrita — latino, han (CJK), cirílico — mas escolge o idioma errado dentro dessa família de sistemas de escrita.
O Problema do Sistema de Escrita Compartilhado
O sistema de escrita latino é compartilhado por inglês, francês, alemán, espanhol, italiano, português, holandês, sueco, norueguês e dezenas de outros idiomas. Quando um motor de OCR detecta o sistema de escrita latino e seleciona automaticamente o inglês — o idioma padrão para a maioria das ferramentas — cada acento agudo francês, Umlaut alemán e tilde espanhol se torna um problema. O motor consegue ler os caracteres, mas seu dicionário de pós-processamento aplica regras ortográficas do inglês, então palavras estrangeiras válidas são "corrigidas" para o inglês.
Exemplo do Mundo Real
Um fornecedor italiano envia um documento com "Fattura — Importo: € 1.250,00 — Spedizione: via Roma, 15." Detectado como inglês. O motor de OCR lê a vírgula em "1.250,00" como separador decimal em vez de separador de milhar — porque o inglês usa pontos para decimais e vírgulas para agrupamento, enquanto o italiano faz o oposto. O resultado: €1.250,00 (mil duzentos cinquenta euros) é emitido como €1.25 (um euro e vinte cinco centavos). Este não é um erro de leitura — é um erro de interpretação de formatação causado pelo modelo de idioma errado.
Confusão de Sistemas de Escrita CJK: Kanji, Hanzi e Hanja
A confusão mais problemática de sistemas de escrita acontece nos idiomas do Leste Asiático. Chinês, japonês e coreano usam caracteres derivados do chinês (Hanzi em chinês, Kanji em japonês, Hanja em coreano), e muitos caracteres individuais são compartilhados entre os três. Um documento japonês usa caracteres Kanji que visualmente correspondem aos caracteres do chinês simplificado — mas o significado, a leitura e o contexto são totalmente diferentes.
Quando o mecanismo de OCR detecta automaticamente "chinês" para um documento japonês — o que acontece rotineiramente porque Kanji e Hanzi se sobrepõem bastante — a saída é tecnicamente legível, mas linguisticamente incorreta. O mecanismo aplica modelos de caracteres chineses e viés de dicionário a um texto escrito em japonês. Palavras que deveriam ser lidas como Kun-yomi ou On-yomi (leituras japonesas) recebem pronúncias chinesas. Conteúdo japonês misto — Hiragana e Katakana intercalados com Kanji — confunde ainda mais a detecção, porque o mecanismo não sabe qual sistema de escrita priorizar.
OCR tradicional trata isso como algo binário: ou a página é chinesa, ou é japonesa. Ele não tem o conceito de "esta página é ambas". Um documento que mistura texto em chinês simplificado com códigos de produto em inglês, ou texto japonês com palavras emprestadas do inglês, aciona modelos de idioma que alternam de forma imprevisível entre interpretações corretas e incorretas.
Causa 3: Documentos em Vários Idiomas Quebram a Premissa de "Um Idioma por Página"
O caso mais difícil — e o mais comum nos negócios internacionais — é um único documento que contém genuinamente dois ou mais idiomas, não por ambiguidade de detecção, mas por design.
Considere um contrato multinacional escrito com cabeçalhos de cláusulas em inglês e corpo do texto em francês. Ou uma etiqueta de envio que lista o endereço de origem em japonês, o destino em inglês e as declarações alfandegárias no idioma local. Ou um prontuário médico de uma clínica suíça, em que o formulário de admissão está em alemão, os resultados de laboratório em francês e o resumo do diagnóstico em inglês. Esses não são casos isolados — são documentos rotineiros em operações globais.
O OCR tradicional processa esses documentos selecionando um idioma no nível do documento, aplicando-o de forma uniforme e aceitando a perda de precisão em cada segmento que não corresponde. O resultado é uma saída em que algumas seções parecem perfeitas e outras parecem ter sido processadas por uma ferramenta completamente diferente — porque, de certa forma, era isso que se esperava.
Até mesmo ferramentas que suportam o "modo de vários idiomas" geralmente fazem isso encadeando modelos de idioma sequencialmente — tentam inglês primeiro, depois francês, depois alemão, e usam o resultado de maior confiança por linha. Isso funciona mal na prática porque linhas adjacentes em idiomas diferentes influenciam umas às outras, e a própria pontuação de confiança depende do idioma: um modelo treinado em inglês tem confiança inerentemente maior em texto em inglês do que um modelo treinado em um idioma com menos dados de treinamento, mesmo quando ambos estão lendo corretamente seus respectivos idiomas.
O que a IA de visão faz de diferente — e por que isso muda o jogo
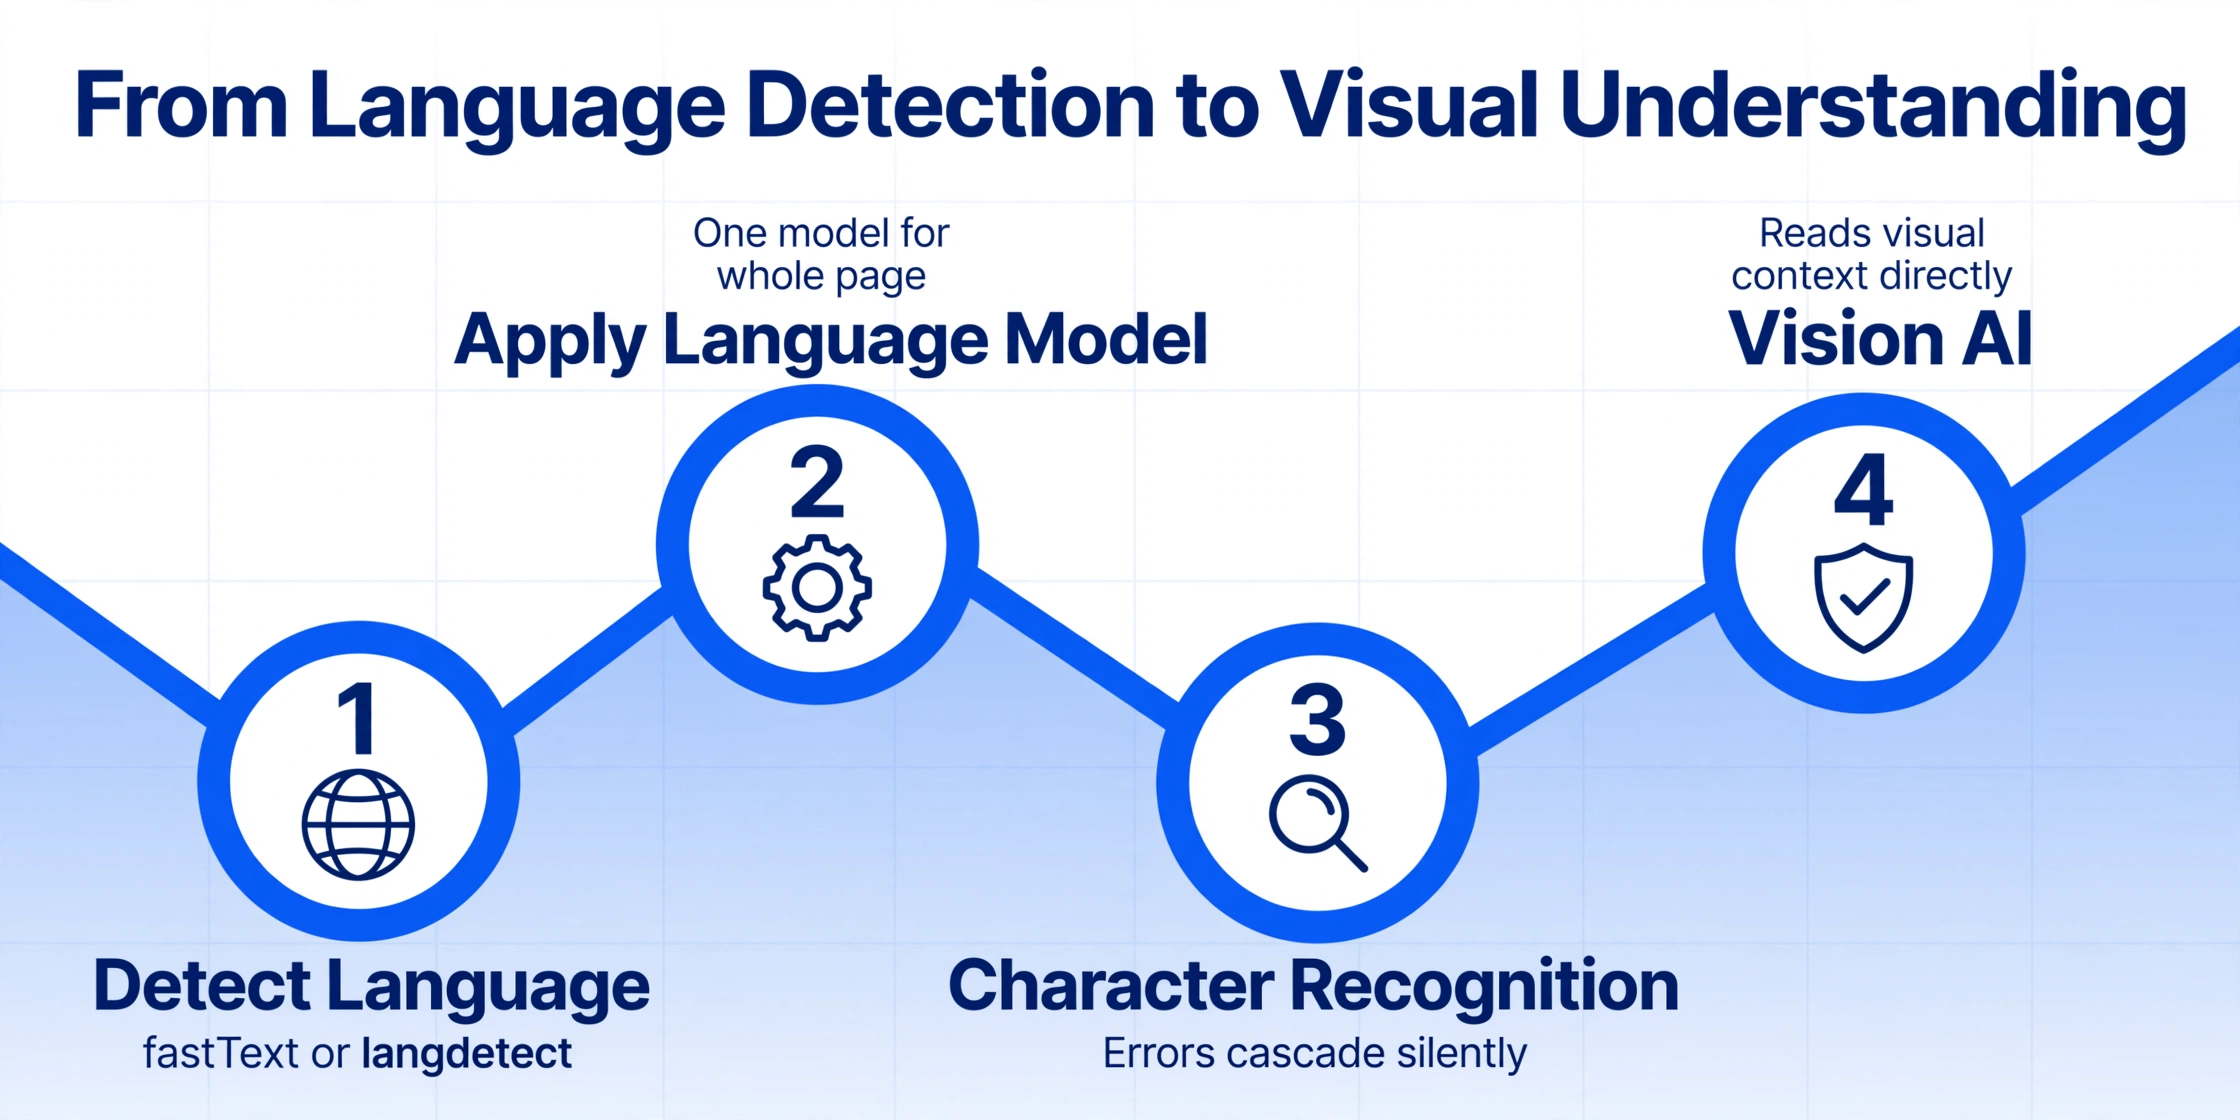
O motivo pelo qual a detecção de idioma continua falhando é arquitetural. Pipelines tradicionais de OCR separam a detecção de idioma do reconhecimento de caracteres em duas etapas sequenciais: (1) identificar o idioma e, em seguida, (2) aplicar o modelo para esse idioma. Se a primeira etapa errar, a segunda não tem nenhuma chance de recuperação.
A IA de visão — a tecnologia por trás de ferramentas como ImageToTable.ai — colapsa esse pipeline em uma única etapa de compreensão semântica. Em vez de perguntar "qual é o idioma?" e depois "quais caracteres esses pixels formam?", o modelo lê o conteúdo visual de forma holística: ele interpreta caracteres, números e símbolos em seu contexto visual, independente de um modelo de idioma pré-selecionado.
Essa mudança de paradigma — de modelos de reconhecimento específicos por sistema de escrita para compreensão semântica visual — significa que erros de detecção automática de idioma não podem se propagar para falhas de reconhecimento de caracteres, porque o reconhecimento de caracteres nunca dependeu da seleção de idioma em primeiro lugar. Uma fatura japonesa com termos em inglês, um contrato alemão com cláusulas em francês, uma etiqueta de envio com três sistemas de escrita — cada um é lido como um todo visual, não como uma página que deve ser classificada em uma única categoria de idioma.
Isso não significa que a IA de visão seja perfeita — significa que o modo de falha muda. Em vez de descartar silenciosamente os tremas porque o modelo de idioma errado foi selecionado, o modelo ou lê os caracteres corretamente ou sinaliza regiões ambíguas para revisão. A saída não está silenciosamente errada; ela está correta ou explicitamente incerta. Pela primeira vez, o "problema de detecção de idioma" deixa de ser a causa raiz de resultados ruins de OCR.
O que você pode fazer agora — correções práticas
Independentemente da ferramenta que você usa, aqui estão três coisas que reduzirão imediatamente os erros de detecção de idioma na sua saída de OCR.
Se a sua ferramenta de OCR permite seleção manual de idioma, use-a. Para documentos em um único idioma, isso elimina a detecção automática por completo. Para documentos com vários idiomas, especifique um idioma principal e verifique se a ferramenta oferece suporte a um idioma secundário como fallback (muitas não divulgam esse recurso, mas vale a pena testar). O Tesseract suporta o operador "+" — eng+deu+fra — que processa vários modelos de idioma em paralelo e seleciona a melhor correspondência por segmento, embora, como mencionado acima, isso tenha suas próprias limitações de precisão.
A correção mais confiável é usar uma ferramenta de extração baseada em IA de visão que lê documentos semanticamente, em vez de usar modelos específicos de sistema de escrita. Essas ferramentas não perguntam "qual é o idioma?" porque a resposta é irrelevante para a forma como leem a página. A saída é a mesma se o seu documento está em alemão, japonês, árabe ou uma mistura dos três — o modelo processa o conteúdo visual diretamente.
Não avalie a precisão da detecção de idioma do OCR em amostras de teste limpas em um único idioma — seus documentos de produção não são tão simples. Pegue seus três piores documentos com vários idiomas — uma fatura em alemão-inglês, uma ficha técnica em japonês-inglês, um contrato em francês-inglês — e execute-os nas ferramentas candidatas. Verifique campos específicos de alto valor: valores com formatação numérica europeia vs. americana, nomes com diacríticos, endereços com sistemas de escrita mistos. A ferramenta que lidar com isso corretamente nos seus documentos reais é a que funcionará em produção.
Quando Escalar: Reconhecendo um Problema de Idioma Irreparável
Alguns problemas de detecção de idioma podem ser resolvidos com mudanças de configuração e fluxo de trabalho. Outros indicam que a ferramenta em si é arquiteturalmente incapaz de lidar com seu conjunto de documentos. Veja como diferenciar os casos.
Se sua ferramenta de OCR produz resultados majoritariamente corretos, mas ocasionalmente omite diacríticos ou lê errado a formatação de números em páginas com vários idiomas, a especificação manual do idioma ou a limpeza pós-processamento provavelmente resolverão o problema. O Tesseract, por exemplo, pode ser configurado com vários pacotes de idiomas e modos específicos de segmentação de página que reduzem significativamente os erros de detecção.
Se sua ferramenta produz consistentemente resultados em que seções inteiras estão erradas — texto em alemão lido como inglês, parágrafos inteiros em japonês retornados como chinês, ou uma incapacidade total de lidar com páginas que usam mais de um sistema de escrita — a configuração manual não vai resolver. A arquitetura em si é o gargalo. Nesse caso, a solução é migrar para uma ferramenta de IA de visão que não dependa da pré-seleção de idioma.
Checklist Rápido de Diagnóstico
- ✓ A saída tem caracteres corretos, mas faltam diacríticos (umlauts em alemão, acentos em francês) → Corrigível (seleção manual de idioma ou pacote de idiomas)
- ✓ A saída tem o texto certo, mas o formato numérico errado (vírgula vs ponto) → Corrigível (configuração manual de idioma + localidade)
- ✗ Seções inteiras lidas no sistema de escrita errado (Kanji como Hanzi, cirílico como latino) → Arquitetural (mude para IA de visão)
- ✗ Documentos com vários idiomas produzem resultados inconsistentes entre execuções diferentes → Arquitetural (a detecção automática é probabilisticamente instável)
- ✗ Todo documento é lido como inglês, independentemente do conteúdo real → Arquitetural (a ferramenta usa inglês como padrão sem detecção real)
Perguntas Frequentes
O OCR funciona com documentos que contêm mais de um idioma na mesma página?
Algumas ferramentas afirmam ter suporte, mas a realidade depende da arquitetura. Ferramentas de OCR tradicionais que detectam um único idioma no nível do documento degradam a precisão em qualquer segmento de idioma que não corresponda ao idioma detectado. Ferramentas de IA de visão que leem documentos semanticamente — sem exigir pré-seleção de idioma — lidam com páginas multilíngues de forma fundamentalmente melhor, pois nunca precisaram de detecção de idioma para começar. Se documentos multilíngues são uma parte regular do seu fluxo de trabalho, teste especificamente na sua combinação de documentos antes de se comprometer com uma ferramenta.
Posso corrigir a detecção de idioma do OCR instalando pacotes de idiomas adicionais?
Para ferramentas como Tesseract, sim — instalar os arquivos .traineddata corretos e configurar o parâmetro -l com vários idiomas (por exemplo, eng+deu+fra) pode reduzir erros de detecção em idiomas conhecidos. No entanto, essa abordagem ainda pressupõe que os modelos de idioma sejam aplicados aos segmentos de texto corretos. Em páginas multilíngues onde as linhas alternam entre idiomas, o operador "+" produz uma mesclagem de melhor esforço que é melhor do que um único idioma, mas ainda mensuravelmente menos precisa do que a atribuição de idioma por segmento. Para detecção automática que não exige instalação manual de pacotes, as ferramentas de IA de visão oferecem uma abordagem fundamentalmente diferente.
Por que minha ferramenta de OCR lê japonês como chinês?
Japonês e chinês compartilham um grande conjunto de caracteres (Kanji em japonês, Hanzi em chinês). Muitos mecanismos de OCR tradicionais detectam "CJK" como uma categoria ampla de sistema de escrita e usam como padrão o chinês simplificado, pois ele tem o maior conjunto de dados de treinamento. A ferramenta lê os Kanji corretamente no nível do caractere, mas aplica viés de dicionário chinês e modelos de idioma, o que significa que ela interpreta mal caracteres exclusivos do japonês (Hiragana, Katakana) e aplica leituras incorretas a caracteres compartilhados. A correção é especificar manualmente o japonês como idioma do documento (se a ferramenta suportar) ou usar um modelo de IA de visão que reconheça sistemas de escrita nativamente, em vez de por meio de uma etapa de classificação de sistema de escrita.
Por que o OCR continua removendo tremas e acentos dos meus documentos em alemão/francês?
O motivo mais comum é que o mecanismo de OCR detectou "inglês" como idioma do documento e aplicou um modelo de reconhecimento em inglês. Os modelos em inglês não têm entradas para ä, ö, ü, ß, é, è, ê, ñ, ç e caracteres semelhantes. Quando o mecanismo os encontra, ele os mapeia para o caractere mais próximo em seu conjunto de caracteres de trabalho — geralmente o equivalente latino sem acento. Especificar manualmente alemão, francês ou espanhol como idioma do documento (ou usar um modo multilíngue) geralmente resolve isso. Se não resolver, sua ferramenta pode não ter modelos específicos de idioma para esses idiomas.
Qual é a diferença de precisão entre a detecção automática e a seleção manual de idioma?
Em documentos limpos e monolíngues, a diferença costuma ser pequena — a detecção automática moderna atinge mais de 95% de precisão para os principais idiomas. Em documentos com conteúdo misto, formatação incomum ou idiomas com conjuntos de dados de treinamento menores, a diferença aumenta significativamente. A seleção manual de idioma em um documento monolíngue conhecido oferece a melhor precisão possível, pois elimina a etapa de detecção como ponto de falha. Em documentos com idiomas mistos, a seleção manual por si só não é suficiente — a ferramenta deve oferecer suporte à atribuição de idioma por segmento ou usar uma abordagem de leitura semântica que não dependa da classificação de idioma.
O problema de detecção de idioma não é sobre qualidade de imagem ou configurações de OCR — é sobre se sua ferramenta trata o idioma como uma barreira que deve ser superada antes da leitura começar, ou como um detalhe irrelevante que nunca precisa ser decidido.