Por qué el OCR multilingüe sigue
equivocando el idioma: 3 causas raíz y soluciones
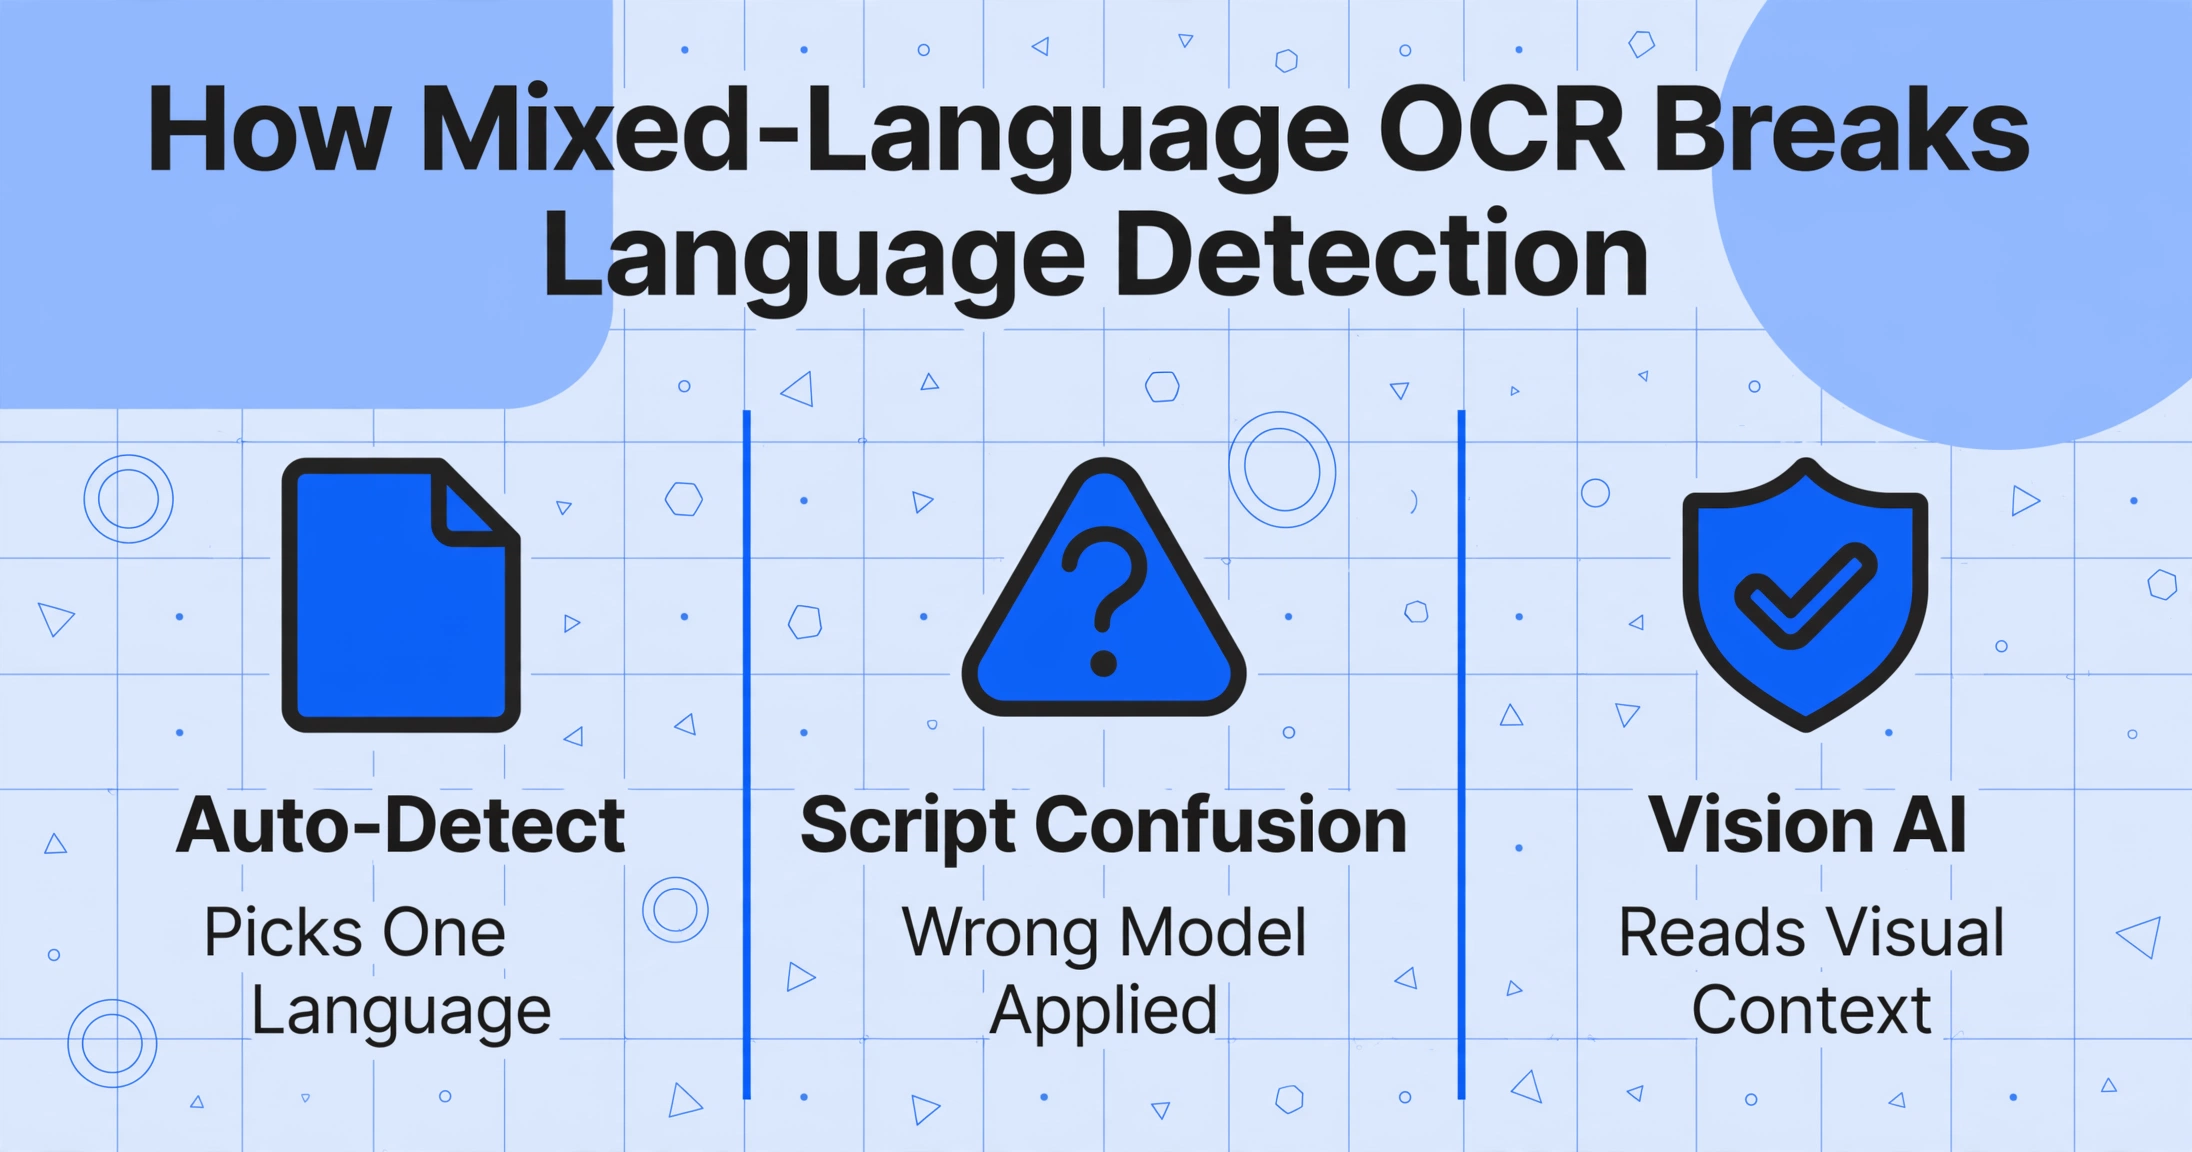
Le pasas un documento a una herramienta de OCR y obtienes texto técnicamente legible, pero incorrecto. Una factura alemana genera "Rechnung" como "Rechnung" (correcto), pero "Geschäftsführer" se convierte en "Geschaftsfuhrer": las diéresis desaparecieron. Una orden de compra japonesa con kanji e inglés mezclados devuelve "注文書" como caracteres chinos simplificados distorsionados. Hiciste todo bien: la imagen era nítida, el contraste era bueno, la resolución era adecuada. El problema no es la calidad de la imagen. Es la detección de idioma.
Conclusiones clave
- La salida del OCR puede ser técnicamente legible y, aun así, completamente incorrecta: una factura italiana de 1.250 € se convierte en 1,25 € porque el motor aplicó el formato numérico inglés a un documento italiano.
- El punto de fallo está antes del reconocimiento de caracteres: la mayoría de las herramientas deciden el idioma de la página antes de leer una sola palabra, y cada carácter que no coincide con el idioma elegido se degrada silenciosamente.
- Arregla la arquitectura, no la detección: las herramientas que leen documentos de forma visual, sin un paso de selección de idioma, eliminan el problema de la detección de idioma en lugar de parchearlo con más paquetes de idiomas.
La detección de idioma en OCR parece sencilla: escanear las primeras palabras, adivinar el idioma y aplicar el modelo de reconocimiento correcto. En la práctica, falla de maneras predecibles que te cuestan tiempo y producen resultados que parecen correctos a simple vista, pero que están mal en los detalles. Y si trabajas con documentos que contienen más de un idioma — que, en un negocio globalizado, es la mayoría de los documentos — la tasa de fallos aumenta considerablemente.
Este artículo repasa las tres formas específicas en que la detección de idioma en OCR falla, para que puedas diagnosticar cuál está causando tu problema y sepas qué solución aplica realmente.
Causa 1: La detección automática elige un solo idioma para todo el documento
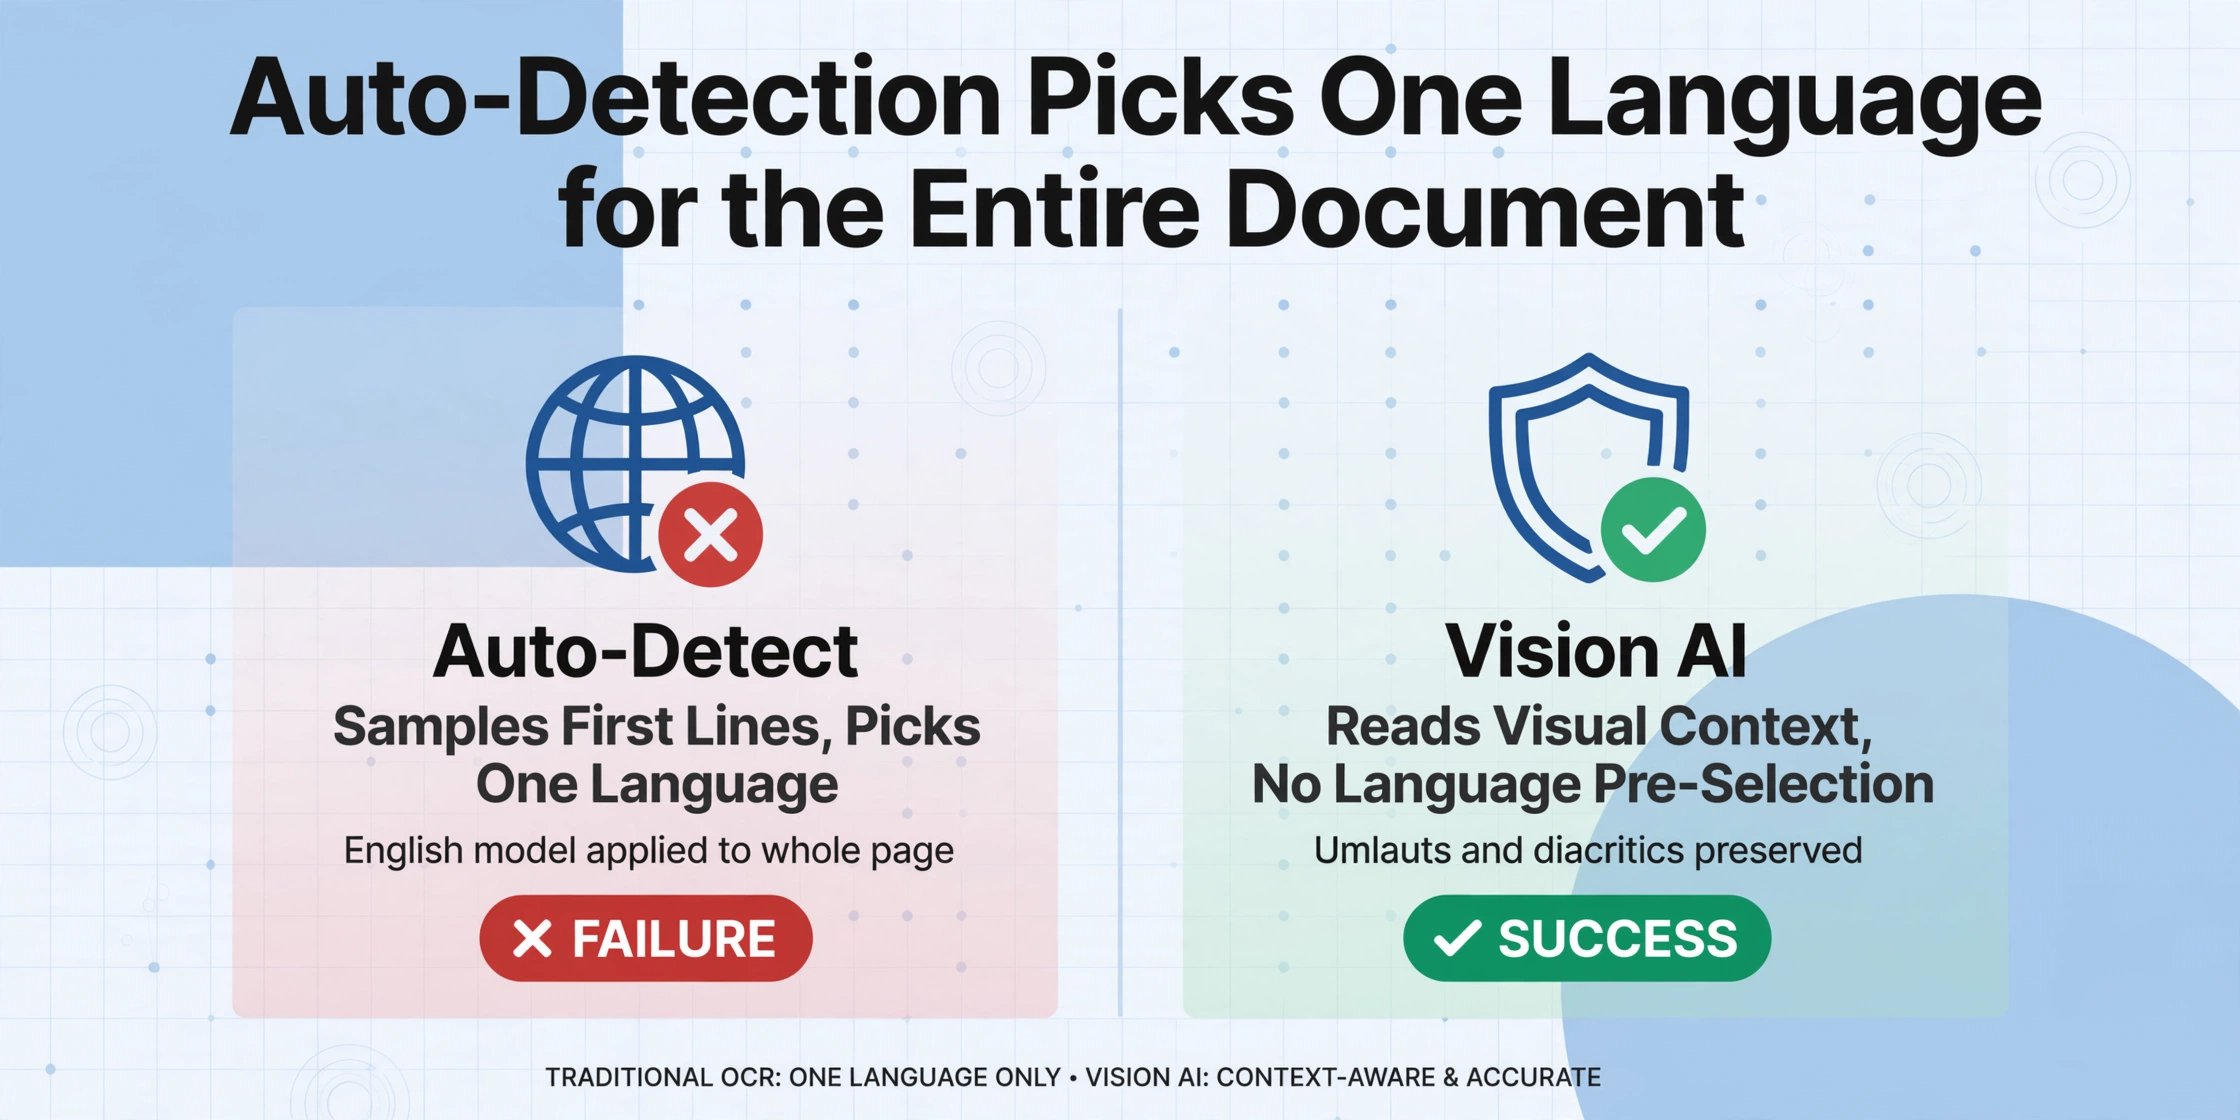
El problema más común de detección de idioma en OCR ocurre antes de que el motor de OCR lea un solo carácter. La mayoría de las herramientas de OCR tradicionales usan un paso de detección automática que muestrea las primeras líneas o párrafos de un documento, ejecuta un algoritmo de identificación de idioma — típicamente algo como fastText o langdetect — y elige el idioma más probable para toda la página. Luego procesa todo el documento con un modelo de reconocimiento entrenado en ese único idioma.
Esto funciona bien cuando el documento es monolingüe. Falla inmediatamente cuando el documento comienza en un idioma y cambia a otro, o cuando el idioma de los encabezados no coincide con el del cuerpo.
Ejemplo real
Una factura alemana con un encabezado de empresa en inglés: "GlobalTech Solutions Inc. — Rechnungsnummer: 2024-0871 — Lieferdatum: 15. März 2024 — Geschäftsführer: Dr. Müller". La detección automática lee "GlobalTech Solutions Inc." en la parte superior y selecciona inglés. Todo el documento se procesa con el modelo de idioma inglés. Resultado: "Geschäftsführer" se convierte en "Geschaftsfuhrer", "März" en "Marz" y "Straße" se renderiza como "Strasse" — no ilegible, pero tampoco correcto. Las diéresis se eliminan silenciosamente porque el modelo inglés no tiene entradas de diccionario para esos caracteres.
El mismo problema afecta a cualquier idioma con diacríticos — francés (élève → eleve), español (año → ano), portugués (ç eliminada), polaco (ł → l). Los caracteres están visualmente presentes en la página, pero el modelo de reconocimiento no los espera, así que los asigna al equivalente ASCII más cercano o los elimina por completo.
Esto no es un "error" del motor de OCR. Es una suposición de diseño: los flujos de OCR tradicionales se construyen en torno a la idea de un idioma por página. Cuando esa suposición se rompe, la precisión cae no porque la imagen sea mala — sino porque el motor intenta decodificar una palabra francesa con un diccionario alemán.
Causa 2: Confusión de sistemas de escritura — cuando los caracteres se parecen pero significan cosas distintas
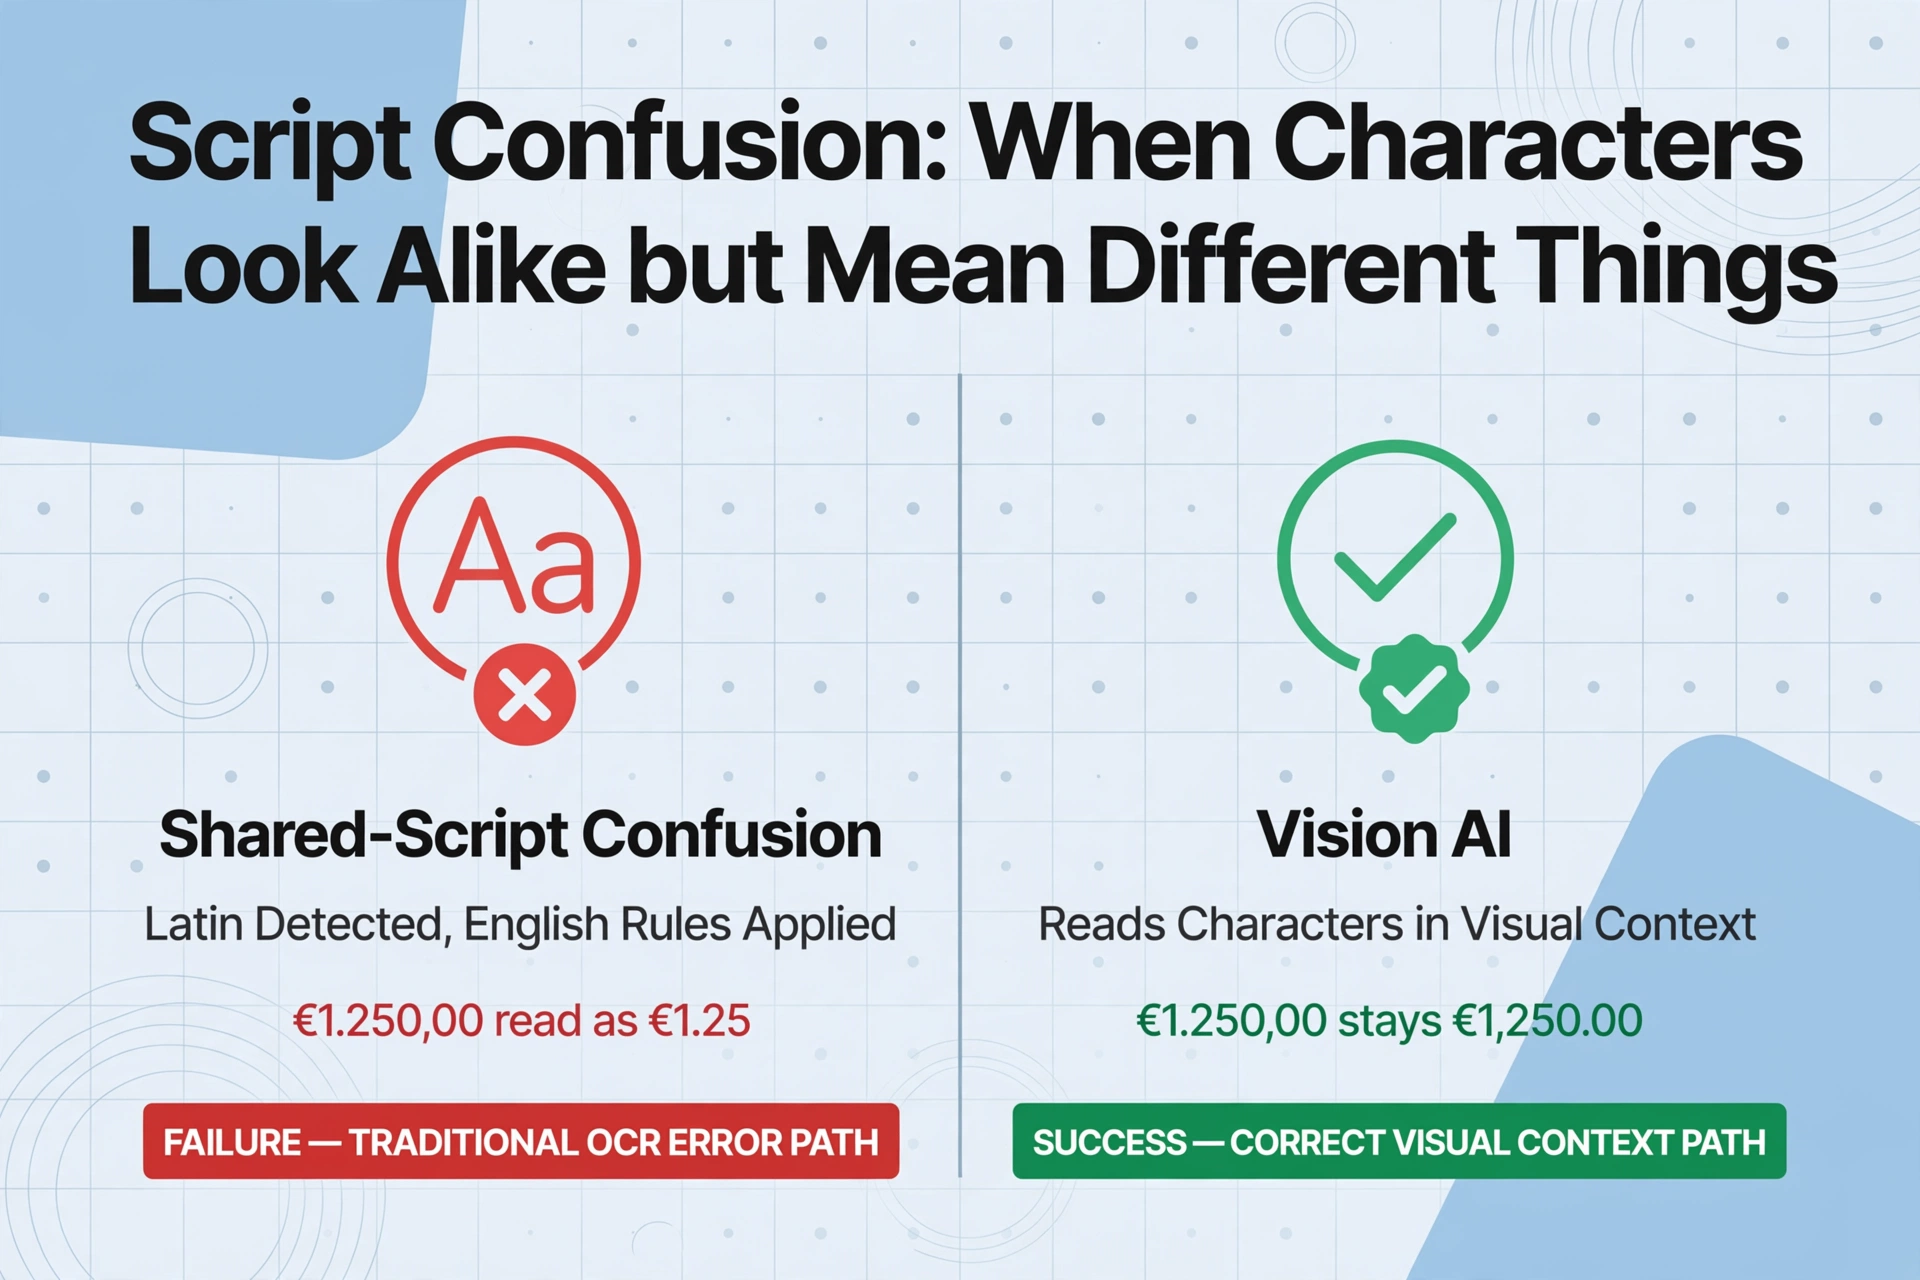
Una clase más difícil de fallo en la detección de idioma ocurre cuando el sistema de escritura se comparte entre idiomas, o cuando dos sistemas de escritura tienen caracteres visualmente superpuestos. La detección automática identifica correctamente el sistema de escritura — latino, han (CJK), cirílico — pero elige el idioma equivocado dentro de esa familia de sistemas de escritura.
El problema de los sistemas de escritura compartidos
El sistema de escritura latino es compartido por inglés, francés, alemán, español, italiano, portugués, neerlandés, sueco, noruego y docenas de otros idiomas. Cuando un motor de OCR detecta el sistema de escritura latino y selecciona automáticamente el inglés — el idioma predeterminado de la mayoría de las herramientas — cada acento agudo francés, diéresis alemana y tilde española se convierte en un problema. El motor puede leer los caracteres, pero su diccionario de posprocesamiento aplica reglas ortográficas del inglés, por lo que las palabras extranjeras válidas se "corrigen" al inglés.
Ejemplo del mundo real
Un proveedor italiano envía un documento con "Fattura — Importo: € 1.250,00 — Spedizione: via Roma, 15". Se detecta como inglés. El motor de OCR lee la coma en "1.250,00" como separador decimal en lugar de separador de miles — porque el inglés usa puntos para decimales y comas para agrupación, mientras que el italiano hace lo contrario. El resultado: €1.250,00 (mil doscientos cincuenta euros) se genera como €1.25 (un euro con veinticinco céntimos). Esto no es un error de lectura — es un error de interpretación de formato causado por el modelo de idioma incorrecto.
Confusión de sistemas de escritura CJK: Kanji, Hanzi y Hanja
La confusión de sistemas de escritura más problemática ocurre en los idiomas de Asia Oriental. El chino, el japonés y el coreano usan caracteres derivados del chino (Hanzi en chino, Kanji en japonés, Hanja en coreano), y muchos caracteres individuales se comparten entre los tres. Un documento japonés usa caracteres Kanji que coinciden visualmente con los caracteres del chino simplificado, pero el significado, la lectura y el contexto son completamente diferentes.
Cuando el motor de OCR detecta automáticamente «chino» para un documento japonés — algo que ocurre habitualmente porque Kanji y Hanzi se superponen en gran medida — el resultado es técnicamente legible pero lingüísticamente incorrecto. El motor aplica modelos de caracteres chinos y sesgos de diccionario a texto escrito en japonés. Las palabras que deberían leerse como Kun-yomi u On-yomi (lecturas japonesas) reciben pronunciaciones chinas. El contenido mixto japonés — Hiragana y Katakana intercalados con Kanji — confunde aún más la detección porque el motor no sabe qué sistema de escritura priorizar.
El OCR tradicional trata esto como algo binario: o la página es china, o es japonesa. No tiene el concepto de «esta página es ambas cosas». Un documento que mezcla texto en chino simplificado con códigos de producto en inglés, o texto japonés con préstamos del inglés, activa modelos de idioma que alternan de forma impredecible entre interpretaciones correctas e incorrectas.
Causa 3: Los documentos multilingües rompen el supuesto de «un idioma por página»
El caso más difícil — y el más común en los negocios internacionales — es un documento único que contiene genuinamente dos o más idiomas, no por ambigüedad en la detección sino por diseño.
Considere un contrato multinacional con encabezados de cláusulas en inglés y texto del cuerpo en francés. O una etiqueta de envío que lista la dirección de origen en japonés, el destino en inglés y las declaraciones de aduana en el idioma local. O un expediente médico de una clínica suiza, donde el formulario de admisión está en alemán, los resultados de laboratorio en francés y el resumen del diagnóstico en inglés. Estos no son casos extremos — son documentos habituales en operaciones globales.
El OCR tradicional procesa estos documentos seleccionando un idioma a nivel de documento, aplicándolo de manera uniforme y aceptando la pérdida de precisión en cada segmento que no coincide. El resultado es una salida donde algunas secciones se ven perfectas y otras parecen procesadas con una herramienta completamente distinta — porque en cierto sentido, así debía ser.
Incluso las herramientas que admiten «modo multilingüe» a menudo lo hacen encadenando modelos de idioma de forma secuencial — probar primero inglés, luego francés, luego alemán, y tomar el resultado de mayor confianza por línea. Esto funciona mal en la práctica porque las líneas adyacentes en diferentes idiomas se influyen entre sí, y la puntuación de confianza en sí misma depende del idioma: un modelo entrenado en inglés tiene inherentemente mayor confianza en texto inglés que un modelo entrenado en un idioma con menos datos de entrenamiento, incluso cuando ambos leen correctamente sus respectivos idiomas.
Qué hace diferente la IA de visión — y por qué cambia las reglas del juego
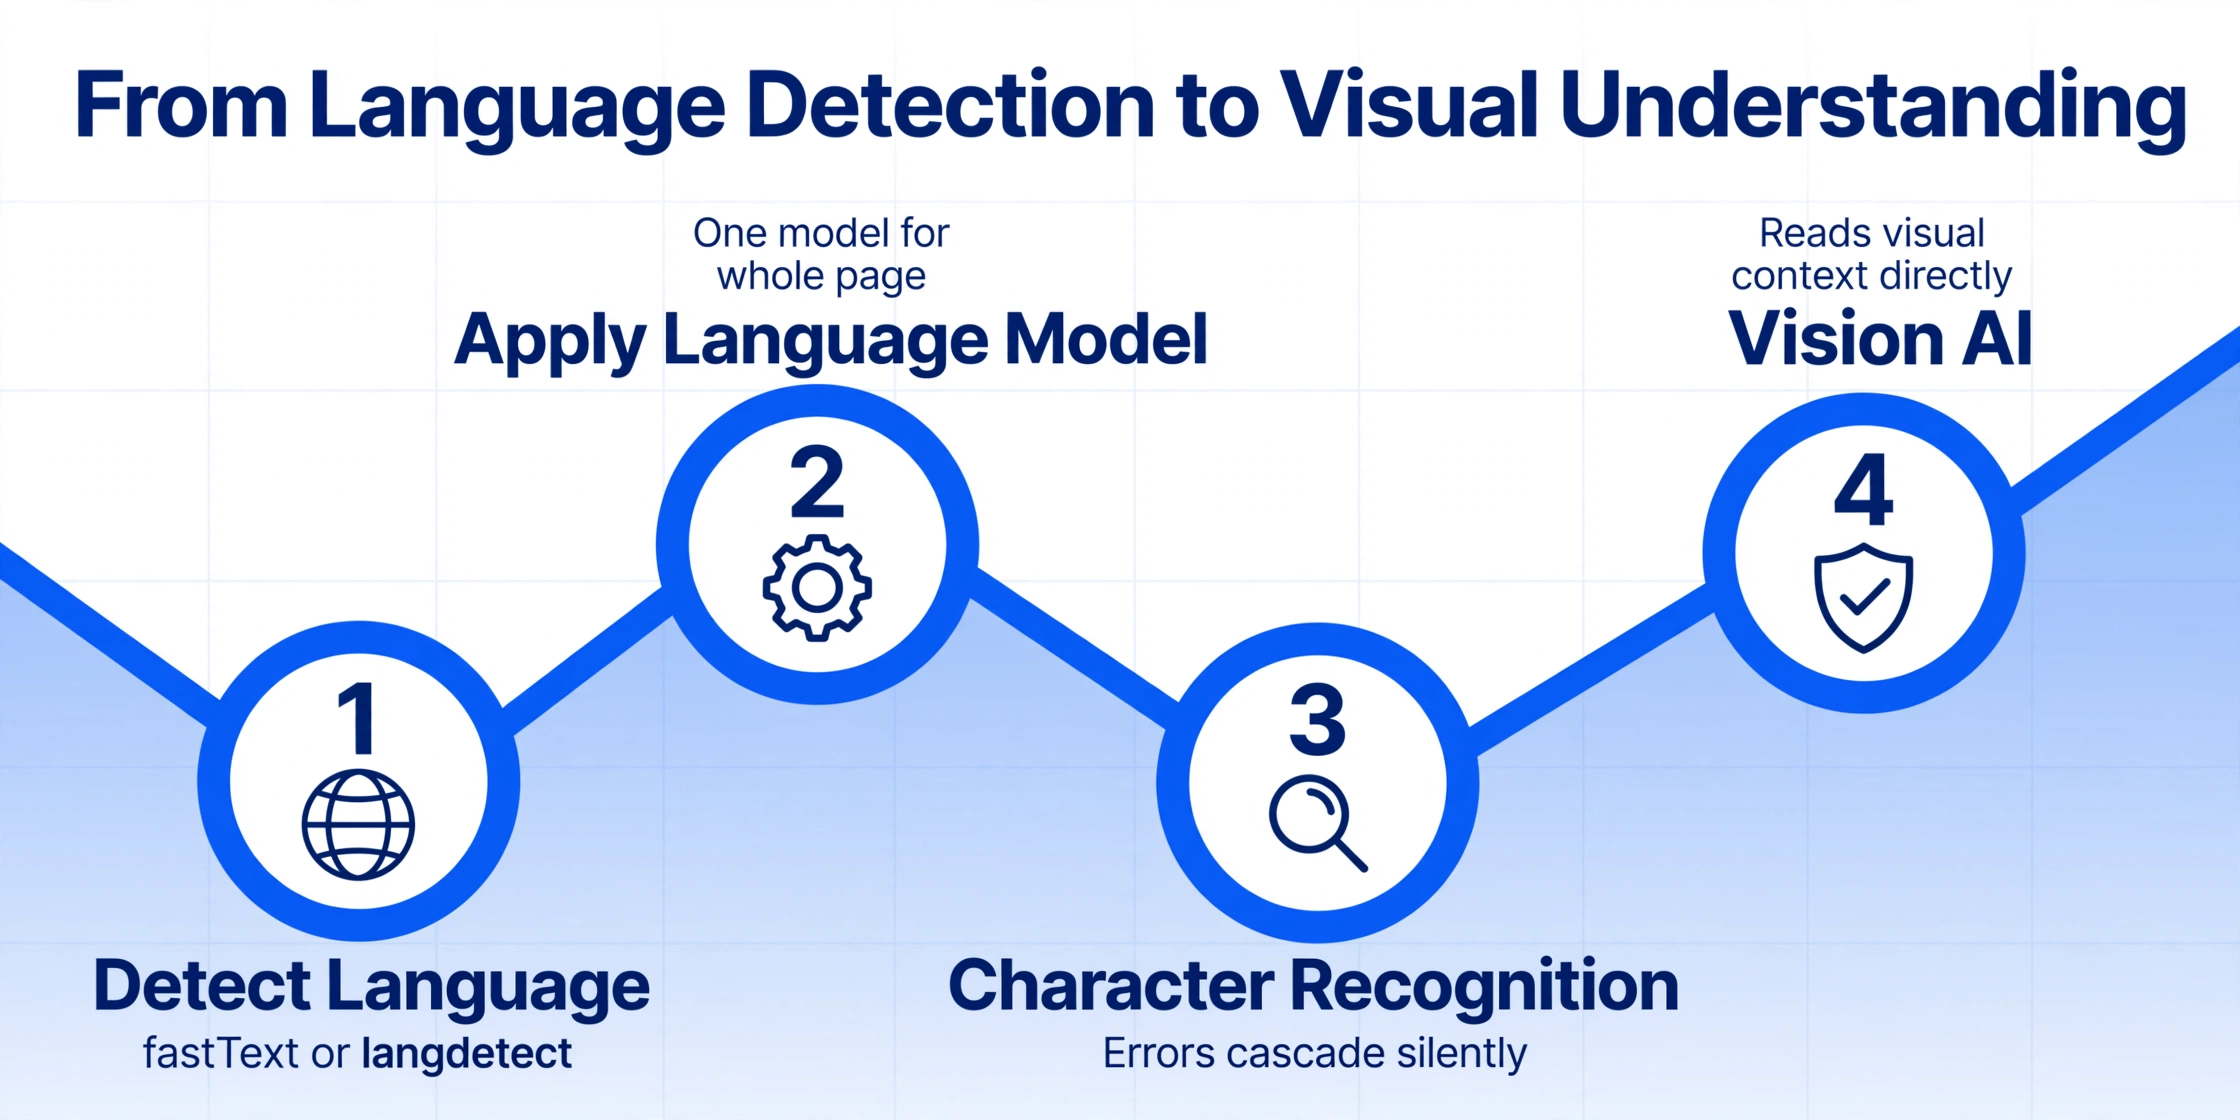
La razón por la que la detección de idioma sigue fallando es arquitectónica. Los flujos de OCR tradicionales separan la detección de idioma del reconocimiento de caracteres en dos etapas secuenciales: (1) identificar el idioma y luego (2) aplicar el modelo para ese idioma. Si la primera etapa falla, la segunda no tiene ninguna posibilidad de recuperarse.
La IA de visión — la tecnología detrás de herramientas como ImageToTable.ai — condensa este flujo en un único paso de comprensión semántica. En lugar de preguntar «¿qué idioma es este?» y luego «¿qué caracteres forman estos píxeles?», el modelo lee el contenido visual de forma holística: interpreta caracteres, números y símbolos en su contexto visual, independientemente de un modelo de idioma preseleccionado.
Este cambio de paradigma — de modelos de reconocimiento específicos por sistema de escritura a comprensión semántica visual — significa que los errores de detección automática de idioma no pueden propagarse a fallos de reconocimiento de caracteres, porque el reconocimiento de caracteres nunca dependió de la selección de idioma en primer lugar. Una factura japonesa con términos en inglés, un contrato alemán con cláusulas en francés, una etiqueta de envío con tres sistemas de escritura — cada uno se lee como un todo visual, no como una página que debe clasificarse en una sola categoría de idioma.
Esto no significa que la IA de visión sea perfecta — significa que el modo de fallo cambia. En lugar de omitir silenciosamente las diéresis porque se seleccionó el modelo de idioma equivocado, el modelo o lee los caracteres correctamente o marca las regiones ambiguas para revisión. El resultado no es silenciosamente incorrecto; o es correcto o es explícitamente incierto. Por primera vez, el «problema de detección de idioma» deja de ser la causa raíz de los malos resultados de OCR.
Qué puedes hacer ahora mismo: soluciones prácticas
Independientemente de la herramienta que uses, estas son tres cosas que reducirán de inmediato los errores de detección de idioma en tu salida de OCR.
Si tu herramienta de OCR permite la selección manual de idioma, úsala. Para documentos de un solo idioma, esto elimina por completo la detección automática. Para documentos multilingües, especifica un idioma principal y comprueba si la herramienta admite un idioma secundario de respaldo (muchas no anuncian esta función, pero vale la pena probarla). Tesseract admite el operador "+" — eng+deu+fra — que procesa varios modelos de idioma en paralelo y selecciona la mejor coincidencia por segmento, aunque como se indicó antes, esto tiene sus propias limitaciones de precisión.
La solución más fiable es usar una herramienta de extracción basada en IA de visión que lea los documentos de forma semántica en lugar de usar modelos específicos de sistema de escritura. Estas herramientas no preguntan "¿qué idioma es este?" porque la respuesta es irrelevante para cómo leen la página. El resultado es el mismo tanto si tu documento está en alemán, japonés, árabe o una mezcla de los tres: el modelo procesa el contenido visual directamente.
No evalúes la precisión de la detección de idioma del OCR con muestras limpias de un solo idioma: tus documentos de producción no son tan simples. Toma tus tres peores documentos multilingües — una factura alemán-inglés, una ficha técnica japonés-inglés, un contrato francés-inglés — y pásalos por tus herramientas candidatas. Revisa campos específicos de alto valor: importes con formato numérico europeo frente al estadounidense, nombres con diacríticos, direcciones con sistemas de escritura mixtos. La herramienta que maneje correctamente estos casos con tus documentos reales es la que funcionará en producción.
Cuándo escalar: cómo reconocer un problema de idioma irreparable
Algunos problemas de detección de idioma se pueden resolver con cambios de configuración y de flujo de trabajo. Otros indican que la herramienta en sí es arquitectónicamente incapaz de manejar tu conjunto de documentos. Así puedes diferenciarlos.
Si tu herramienta de OCR produce resultados mayormente correctos pero de vez en cuando omite diacríticos o lee mal el formato de números en páginas con varios idiomas, la especificación manual del idioma o una limpieza posterior probablemente lo resuelvan. Tesseract, por ejemplo, se puede configurar con varios paquetes de idioma y modos específicos de segmentación de página que reducen significativamente los errores de detección.
Si tu herramienta produce de forma constante resultados donde secciones enteras están mal — texto en alemán leído como inglés, párrafos completos en japonés devueltos como chino, o una incapacidad total para manejar páginas con más de un sistema de escritura — la configuración manual no lo solucionará. La arquitectura en sí es el cuello de botella. En ese caso, la solución es pasar a una herramienta de IA de visión que no dependa de la preselección de idioma.
Lista de verificación rápida
- ✓ La salida tiene caracteres correctos pero le faltan diacríticos (diéresis en alemán, acentos en francés) → Reparable (selección manual de idioma o paquete de idioma)
- ✓ La salida tiene el texto correcto pero el formato de número es incorrecto (coma vs punto) → Reparable (configuración manual de idioma y configuración regional)
- ✗ Secciones enteras se leen en el sistema de escritura incorrecto (kanji como hanzi, cirílico como latino) → Arquitectónico (cambia a IA de visión)
- ✗ Los documentos con varios idiomas producen resultados inconsistentes entre ejecuciones → Arquitectónico (la detección automática es probabilísticamente inestable)
- ✗ Todos los documentos se leen como inglés sin importar el contenido real → Arquitectónico (la herramienta usa inglés por defecto sin detección real)
Preguntas Frecuentes
¿El OCR funciona con documentos que contienen más de un idioma en la misma página?
Algunas herramientas afirman tener soporte, pero la realidad depende de la arquitectura. Las herramientas OCR tradicionales que detectan un solo idioma a nivel de documento degradarán la precisión en cualquier segmento de idioma que no coincida con el idioma detectado. Las herramientas de IA de visión que leen documentos de forma semántica — sin requerir preselección de idioma — manejan páginas multilingües fundamentalmente mejor porque nunca necesitaron detección de idioma desde el principio. Si los documentos multilingües son parte habitual de tu flujo de trabajo, prueba específicamente con tu combinación de documentos antes de comprometerte con una herramienta.
¿Puedo corregir la detección de idioma del OCR instalando paquetes de idioma adicionales?
Para herramientas como Tesseract, sí — instalar los archivos .traineddata correctos y configurar el parámetro -l con varios idiomas (p. ej., eng+deu+fra) puede reducir los errores de detección en idiomas conocidos. Sin embargo, este enfoque aún asume que los modelos de idioma se aplican a los segmentos de texto correctos. En páginas multilingües donde las líneas alternan entre idiomas, el operador "+" produce una fusión de mejor esfuerzo que es mejor que un solo idioma pero sigue siendo notablemente menos precisa que la asignación de idioma por segmento. Para la detección automática que no requiere instalación manual de paquetes, las herramientas de IA de visión ofrecen un enfoque fundamentalmente diferente.
¿Por qué mi herramienta OCR lee el japonés como chino?
El japonés y el chino comparten un gran conjunto de caracteres (Kanji en japonés, Hanzi en chino). Muchos motores OCR tradicionales detectan "CJK" como una categoría amplia de sistema de escritura y se decantan por el chino simplificado porque tiene el conjunto de datos de entrenamiento más grande. La herramienta lee los Kanji correctamente a nivel de carácter, pero aplica sesgos de diccionario y modelos de idioma chinos, lo que significa que interpreta mal los caracteres exclusivos del japonés (Hiragana, Katakana) y aplica lecturas incorrectas a los caracteres compartidos. La solución es especificar manualmente el japonés como idioma del documento (si la herramienta lo permite) o usar un modelo de IA de visión que reconozca sistemas de escritura de forma nativa en lugar de a través de una clasificación de sistema de escritura.
¿Por qué el OCR sigue eliminando las diéresis y los acentos de mis documentos en alemán/francés?
La razón más común es que el motor OCR detectó "inglés" como idioma del documento y aplicó un modelo de reconocimiento en inglés. Los modelos en inglés no tienen entradas para ä, ö, ü, ß, é, è, ê, ñ, ç y caracteres similares. Cuando el motor los encuentra, los asigna al carácter más cercano en su conjunto de caracteres de trabajo — normalmente el equivalente latino sin acento. Especificar manualmente alemán, francés o español como idioma del documento (o usar un modo multilingüe) suele resolver esto. Si no lo resuelve, es posible que tu herramienta no tenga modelos específicos de idioma para esos idiomas en absoluto.
¿Cuál es la diferencia de precisión entre la detección automática y la selección manual de idioma?
En documentos limpios de un solo idioma, la diferencia suele ser pequeña: la detección automática moderna alcanza más del 95% de precisión en los idiomas principales. En documentos con contenido mixto, formato inusual o idiomas con conjuntos de datos de entrenamiento más pequeños, la brecha se amplía significativamente. La selección manual de idioma en un documento monolingüe conocido ofrece la mejor precisión posible porque elimina el paso de detección como punto de fallo. En documentos con idiomas mixtos, la selección manual por sí sola no es suficiente: la herramienta debe admitir la asignación de idioma por segmento o utilizar un enfoque de lectura semántica que no dependa en absoluto de la clasificación de idiomas.
El problema de la detección de idioma no tiene que ver con la calidad de la imagen ni con la configuración del OCR: se trata de si tu herramienta trata el idioma como una puerta que debe superarse antes de comenzar a leer, o como un detalle irrelevante que nunca necesita decidirse.