OCR精度をフィールド別に検証:
全体で95%、重要なフィールドでは60%
「精度95%」は、ほとんどのOCRツールが最初に掲げる数字です。しかし、200件の請求書をパイプラインに通した後、抽出されたフィールドを手作業で修正するのに火曜日の午後を費やしているなら、その95%という主張は、誰かの都合のいい丸め誤差のように感じ始めるでしょう。その理由は、数字が捏造されているからではありません。精度はフィールドの種類によって決して均一ではないからです。そして、OCRが間違えるフィールドは、下流のシステムが実際に依存しているフィールドに不釣り合いなほど集中しています。この記事では、そのギャップをフィールドごとに測定し、各フィールドタイプがなぜ異なる形で失敗するのかを説明し、それぞれを修正するためのコストを示します。
重要なポイント
- OCRは95%の精度を報告しながら、会計システムが機能するために不可欠な3つのフィールドタイプでは、黙って60%にまで低下しています。
- 5つの異なるフィールドタイプは、5つのまったく異なる理由で失敗します。そして、スキャン解像度を上げても、そのうちの1つも修正できません。
- ダッシュボードの精度数値を、フィールドタイプごとの修正時間という1つの指標に置き換え、ImageToTable.aiを使って、表面の症状ではなく構造的な根本原因に各失敗モードに対処しましょう。
「95%精度」の問題
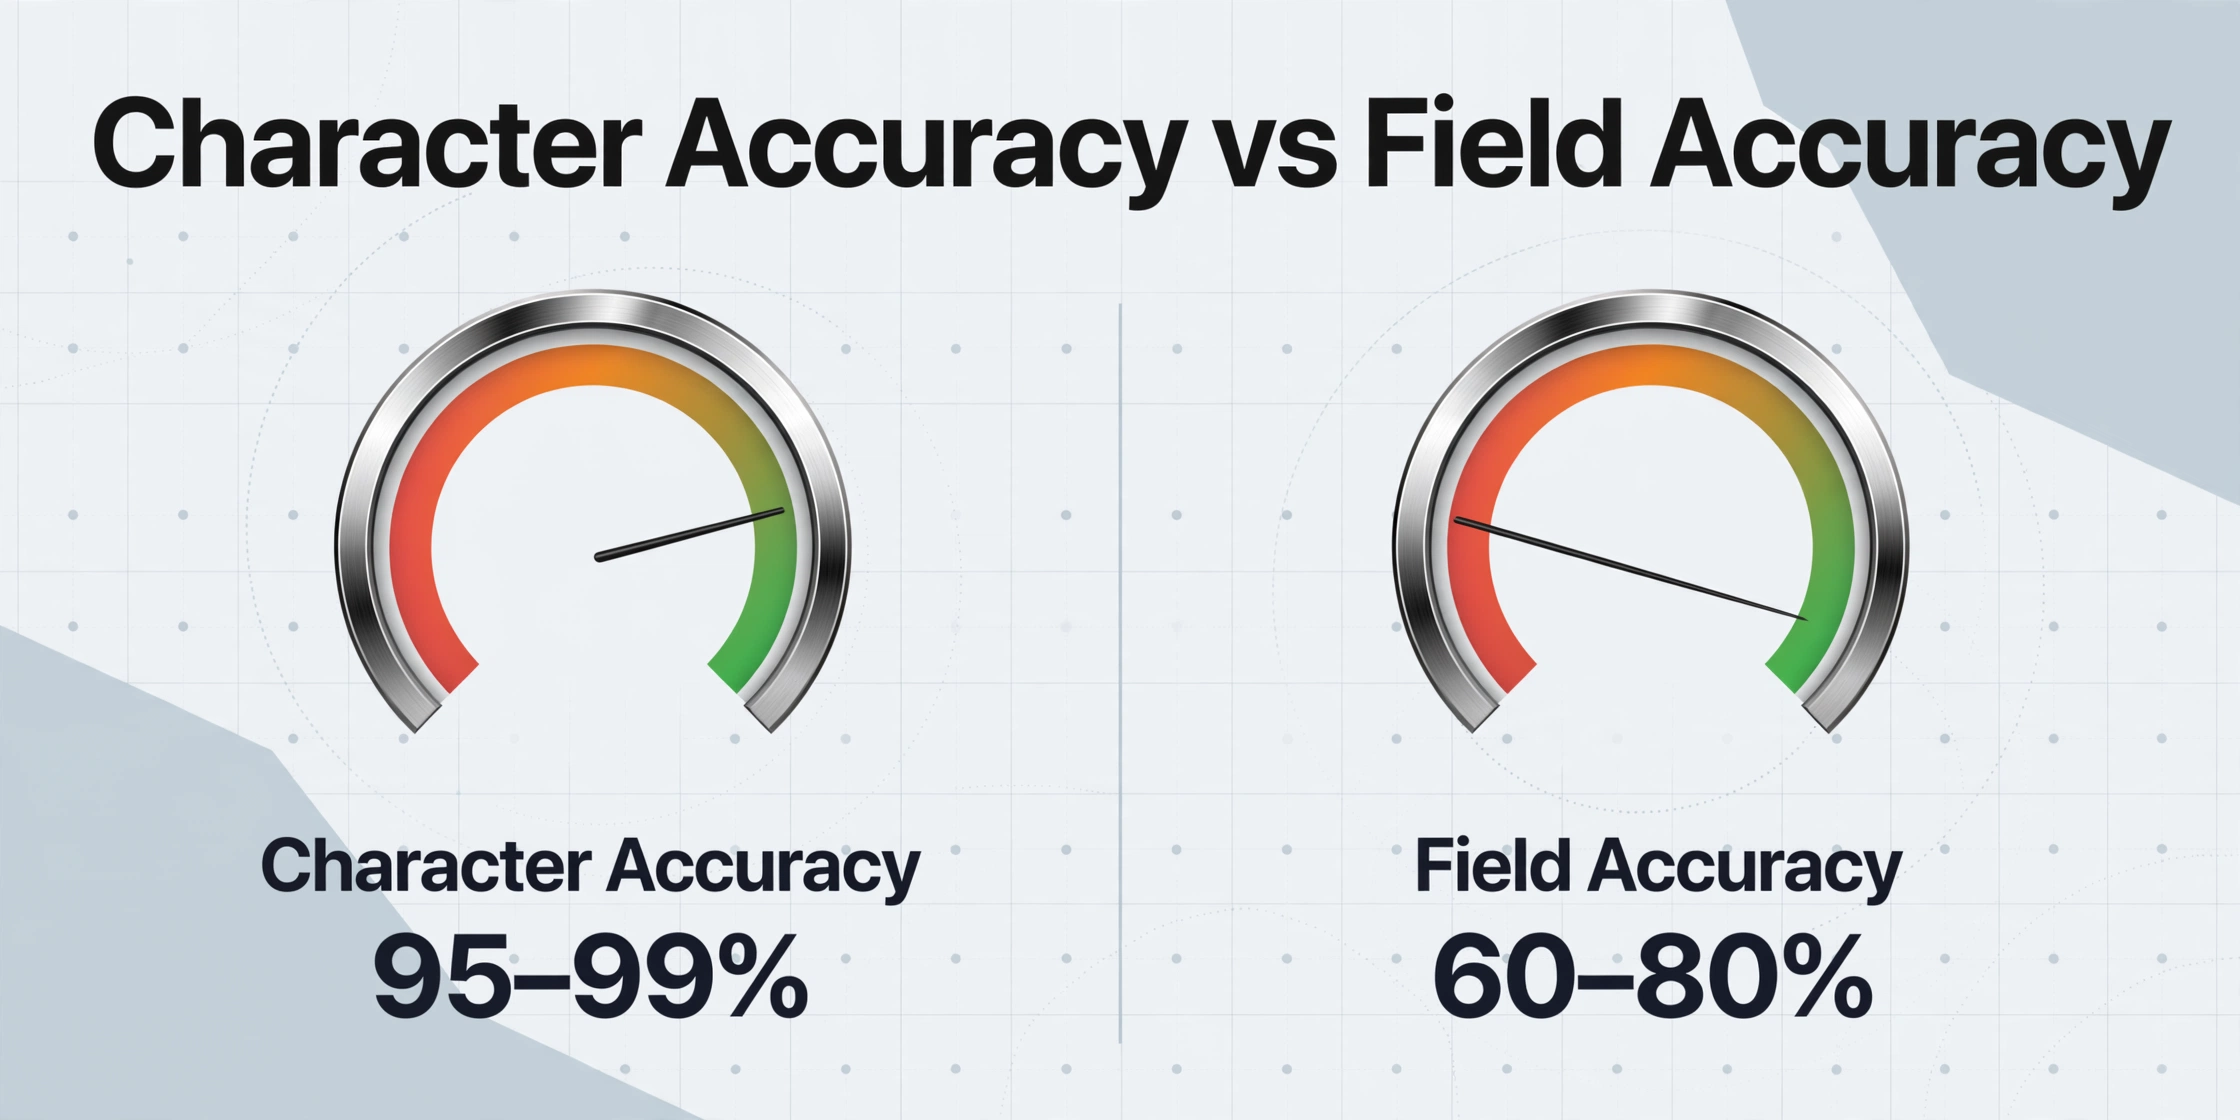
従来のOCRエンジンは、文字レベルの精度、つまり文書画像から正しく認識された個々の文字の割合で自らを評価します。Googleが保守するオープンソースのベンチマークであるTesseract 5は、クリーンな印刷文書で95%の文字精度を達成しています。ABBYY FineReaderのようなエンタープライズエンジンは、実験室環境では97〜99%に達します。これらは実際のテストセットで測定された実際の数値です。
しかし、文字精度は、企業が実際に必要とするもの、つまり完全で正確なデータフィールドの指標としては不十分です。10桁の請求書番号で1桁の誤読があれば、フィールド全体が間違っていることになります。1,000文字のページで99%の文字精度とは、10文字が間違っていることを意味し、その10文字の誤りが対象となる15フィールドのうち3つに含まれていれば、フィールドレベルの精度は80%に低下します。TDWIは、本番のOCRパイプラインでこの正確なシナリオを記録しています。ダッシュボードは99%と報告しますが、抽出されたビジネスフィールドの5つに1つにはエラーが含まれています。
さらに悪いことに、エラーは均等に分布しません。従来のOCRは、いくつかのフィールドタイプではほぼ毎回正しく認識します。他のフィールドは、抽出が行われなかったも同然のほどに失敗します。問題は、失敗しやすいフィールド(明細行の金額、手書きの日付、表構造のデータ)が、修正に最もコストがかかるフィールドでもあることです。
印刷された日付と数字 — OCRが正しく処理できるもの
きれいで印刷された、コントラストの高い文書では、従来のOCRは標準的な位置にある日付やドル金額をうまく処理できます。請求書の日付が白い背景に11ptのArialで「06/09/2026」と300 DPIで印刷されていれば、OCRはほぼ完璧な文字精度で読み取ります。ベンダーの請求書で一貫した位置、右下隅に「$1,234.56」と印刷された合計金額は、適切に管理されたテンプレートと組み合わせれば確実に抽出できます。
これらは、OCRベンダーが宣伝する95〜99%の数字を生み出すフィールドです。これらは最良のシナリオを表しています:標準化されたフォント、予測可能な位置、高いコントラスト。ここが従来のOCRが本当に機能する場所です。
しかし、フォーマットが変わるとすぐに亀裂が現れます。「09/06/2026」と書かれた日付 — これは6月9日(米国)ですか、それとも9月6日(英国)ですか?従来のOCRにはその違いを検出する仕組みがなく、数字を忠実に読み取り、下流のシステムは推測するか、米国形式をデフォルトにします。Pythonベースのヨーロッパの請求書パイプラインを構築しているRedditユーザーがまさにこの問題を記録しています:イタリアの請求書は31/12/2024、ドイツの請求書は31.12.2024、英国の請求書は31/12/2024(同じ構文、異なる日/月の順序)を使用します。ロケールを認識した正規化がなければ、複数国の請求書バッチから抽出された日付は、静かに月が入れ替わります。
ドル金額には、より微妙な失敗モードがあります。きれいに印刷された「$1,234.56」は問題なく読み取れます。しかし、明細行の小計「$1,234.56」が請求書の合計「$1,234.56」の1行上にある場合 — 同じ数字、異なる意味 — テンプレートベースの抽出は間違った方を引き出すリスクがあります。通貨記号のバリエーションが問題を悪化させます:「€1.234,56」(ヨーロッパの小数点カンマ)、「¥1,235」(日本円、小数なし)、または通貨記号なしで印刷された金額は、それぞれ異なる解析ルールに引っかかる可能性があります。
名前と住所 — 文字は正しい、文脈が間違っている
表面的には、名前と住所はOCRにとって簡単そうに見えます。それらはテキストであり、通常は読みやすいフォントで印刷され、珍しいグリフは含まれていません。従来のOCRエンジンは、「John Smith」という文字列を高い信頼度で正しく認識し、「123 Main Street, Springfield, IL 62701」という住所もほぼ同様に認識します。
失敗は文字認識ではありません。フィールド識別です。OCRは「John Smith」をページ上の文字として読み取ります。それが顧客名なのか、ベンダー名なのか、送付先連絡先なのか、承認マネージャーなのかは認識しません。これらの関係は文書のレイアウトによって定義されます — John Smithは「請求先:」、「送付先:」、または「差出人:」の隣に印刷されているかもしれません — そして従来のOCRのボトムアップ文字パイプラインは、レイアウトがベンダーごとに異なる場合、ラベルを関連する値に接続できません。
これが、テンプレートベースのシステムがベンダーのレイアウトごとに個別の座標マップを必要とする理由です。テンプレートは「顧客名はピクセル座標(450、320)にある」と指定します。新しいベンダーが顧客名を(520、280)に置くと、テンプレートは空白スペースまたは間違ったフィールドをキャプチャします。問題はベンダー数に応じて拡大します:20のベンダーは20のテンプレートの構築と維持を意味します。200のベンダーは、テンプレートのメンテナンスがフルタイムの仕事になることを意味します。
この失敗のコストは、しばしば検出されないため、陰湿です。誤ってマッピングされた名前フィールドはフォーマットエラーをスローしません — 「Sarah Chen」は、顧客フィールドにあってもベンダーフィールドにあっても有効な名前です。間違いは後で表面化します。支払いが間違ったエンティティに送られるか、レポートが取引を間違った取引相手の下にグループ化するときです。
明細行とテーブル — OCRが構造を失う箇所
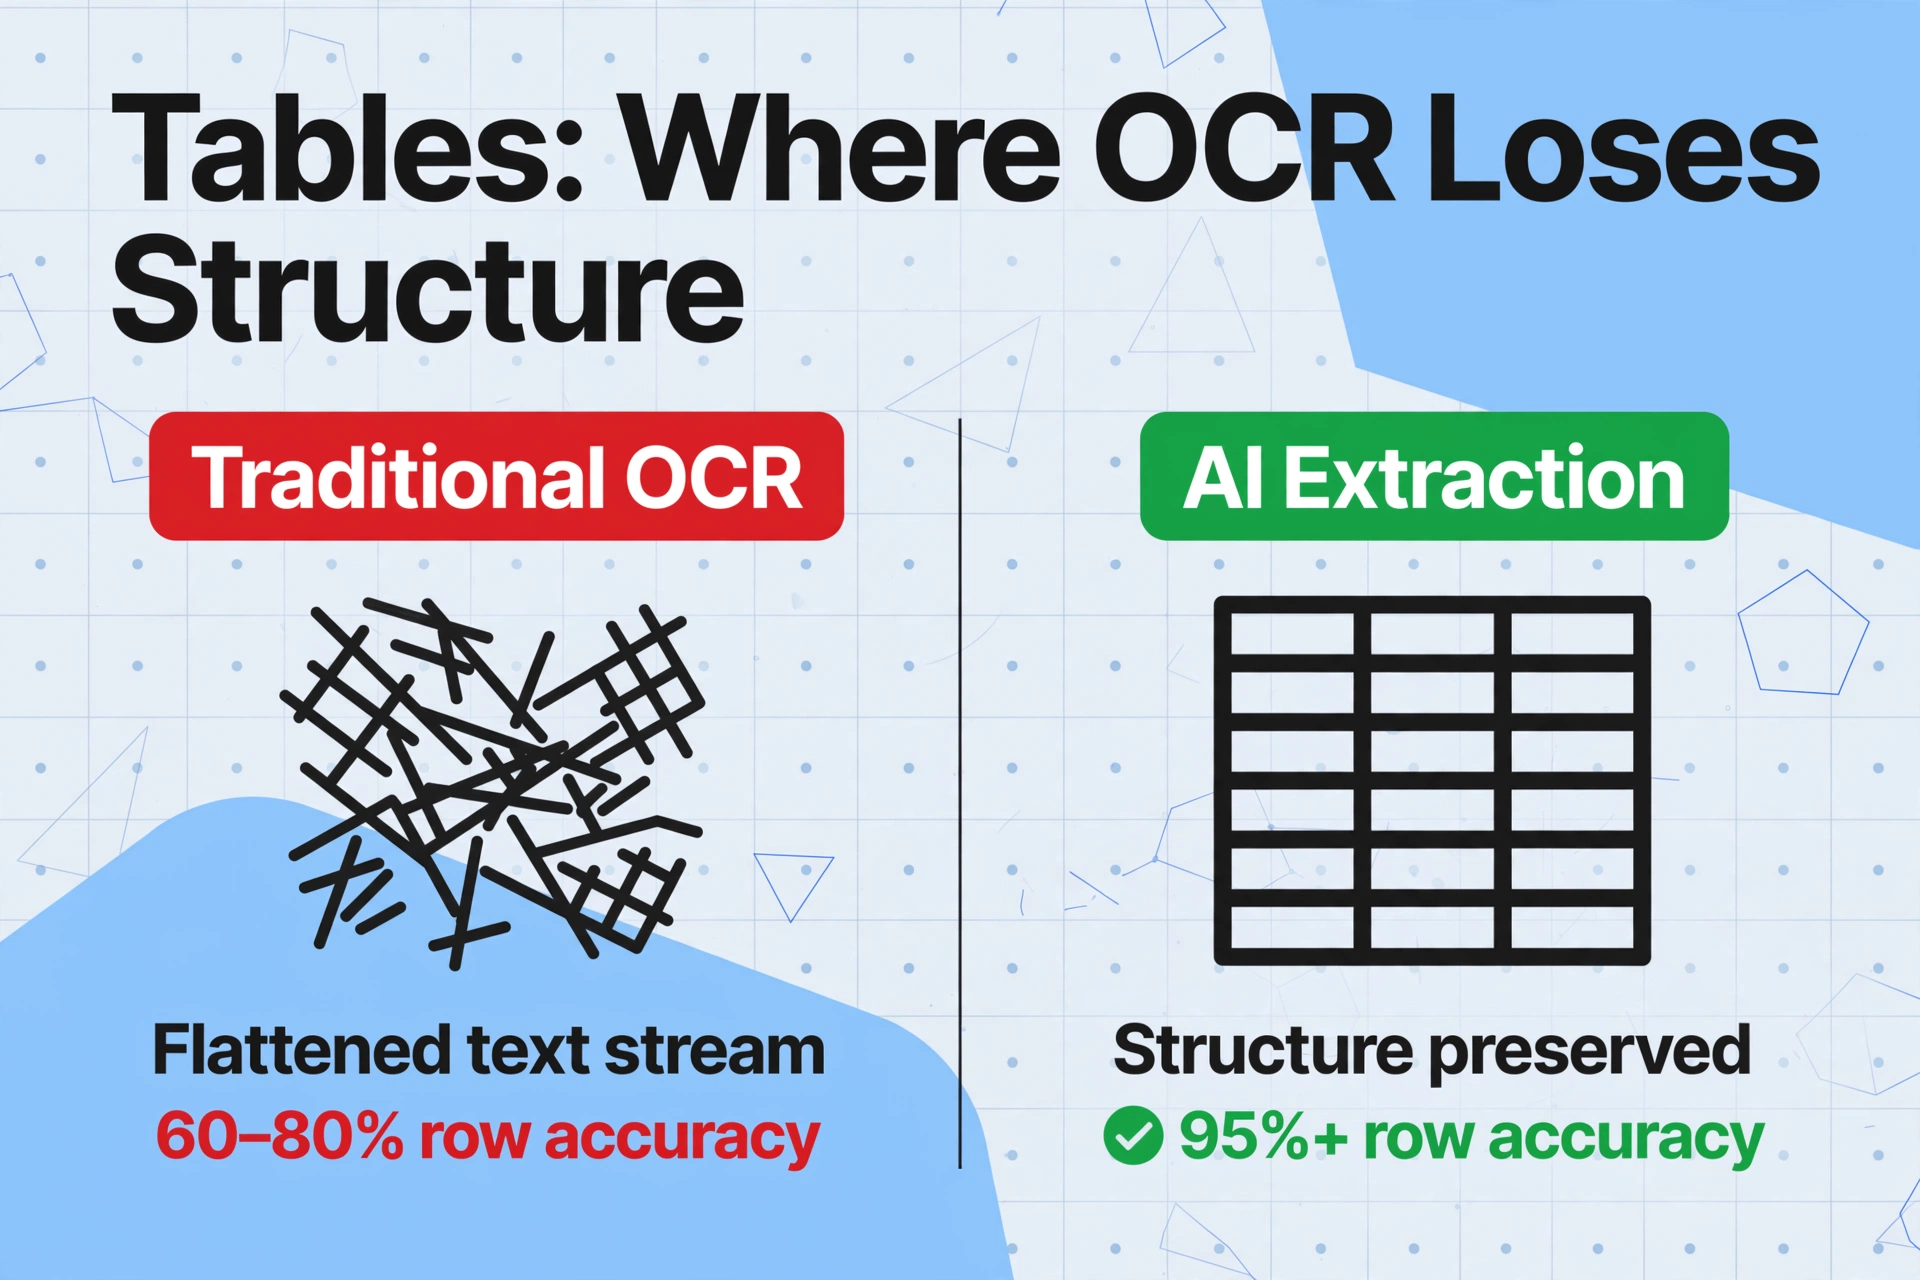
テーブルは従来のOCRにとって最大の失敗要因であり、ほぼすべてのビジネスドキュメントに登場します。請求書の明細行、発注書の詳細、経費報告書の内訳、銀行取引明細書の取引行などです。問題は構造的なものにあります。OCRエンジンは、文字を読み順(左から右、上から下)に沿って線形のストリームとして出力します。3列5行のテーブルは、テキスト断片の単一シーケンスに平坦化され、どの値がどのヘッダーに属するかを定義する列境界は消えてしまいます。
本番環境のベンチマークがその損害を定量化しています。複雑なテーブルレイアウト(セル結合、ネストされたヘッダー、不揃いな列幅)では、従来のOCRの行レベル精度は60〜80%に低下します。「数量」列に入れるべき値が「単価」列に入ってしまったり、2行にわたる説明文が2つの別々のエントリに分割されたり、OCRが列区切り線を数字の「1」と混同して小数点の位置が1桁ずれたりします。
これは文字認識の失敗ではありません。OCRエンジンは個々の文字を正しく読み取ります。「5」「pcs」「$12.50」などです。しかし、下流のシステムには、どの文字がどの行・列に属するかを再構築する手段がありません。出力はインターリーブされたテキストの寄せ集めとなり、行ごとに手動で再構築する必要があります。
テンプレートベースのアプローチは、テーブル領域を定義することでこの問題を解決しようとします。「明細行テーブルはY=600で始まりY=900で終わる」といった具合です。しかし、テーブルの高さは明細行の数によって変わります。同じベンダーからの1行の注文と20行の注文では、まったく異なる長さのテーブルが生成されます。テンプレートの固定領域は、テーブルの一部しか捕捉できないか、さらに悪いことに、テーブル以下の無関係なテキストを最後の行に取り込んでしまいます。テーブルデータを構造化スプレッドシートに抽出するための実践的なガイドでは、重要な変数は、抽出エンジンが表構造を意味的に理解できるかどうかです。単にバウンディングボックス内の文字を読み取るだけではありません。
チェックボックス、スタンプ、複合コンテンツ — 従来のOCRでは見えないもの
従来のOCRが失敗するのではなく、そもそも検出できない文書要素のカテゴリがあります。これらの要素は出力を生成しないか、文字化けした文字を生成するか、最悪の場合、隣接するテキストフィールドの抽出を汚染します。
チェックボックス。チェック済みのボックス(✓)と未チェックのボックス(☐)は、人間の読者には視覚的に区別できますが、従来のOCRエンジンにとってはどちらも検出しきい値付近の低コントラストの塊です。OCRは一方を汚れとして、もう一方を「何もない」として認識するか、チェックマークを「V」「7」、またはランダムなグリフとして読み取る場合があります。「このボックスはチェックされている」という意図は決して捕捉されません。チェックボックスフィールドに依存するフォーム(保険申請書、検査レポート、コンプライアンスチェックリスト)では、OCRが文書を処理した後、すべてのチェックボックスを100%手動でレビューする必要があります。
スタンプと透かし。請求書の本文に重ねられた「PAID」スタンプ、契約書ページ全体にわたる「CONFIDENTIAL」透かし、または発注書に重ねられた赤い会社印は、すべて同じ失敗を引き起こします。同じ空間領域に2つの視覚情報レイヤーが存在するのです。従来のOCRは前景と背景を分離できず、単一のノイズの多い画像領域として認識し、文字化けしたテキストか何も生成しません。スタンプのテキストとその下の文書テキストの両方が読み取れなくなります。
複合コンテンツ。色付きの背景に印刷されたテキスト、暗いヘッダー上の白いテキスト、または網掛けされた表セル内のデータ値は、すべてOCRエンジンが必要とするコントラストを下回ります。「Invoice」と書かれた白いテキストの暗い青のヘッダーバーは、空白として出力される場合があります。エンジンの二値化ステップが領域全体を黒に変換し、白いテキストを完全に失うためです。薄いグレーの交互行バンドに印刷された金額は、グレーの背景と黒いテキストのコントラストがエンジンの感度曲線を下回ると、文字が欠落する可能性があります。
これらの失敗は、テーブルや手書き文字の問題とは根本的に異なります。テーブルはOCRが構造を失うために失敗します。チェックボックスとスタンプは、OCRがそもそも検出しないために失敗します。この違いは修正方法に影響します。壊れたテーブルは後処理できますが、抽出されなかったものを後処理することはできません。
手書き文字—30–60%の崖
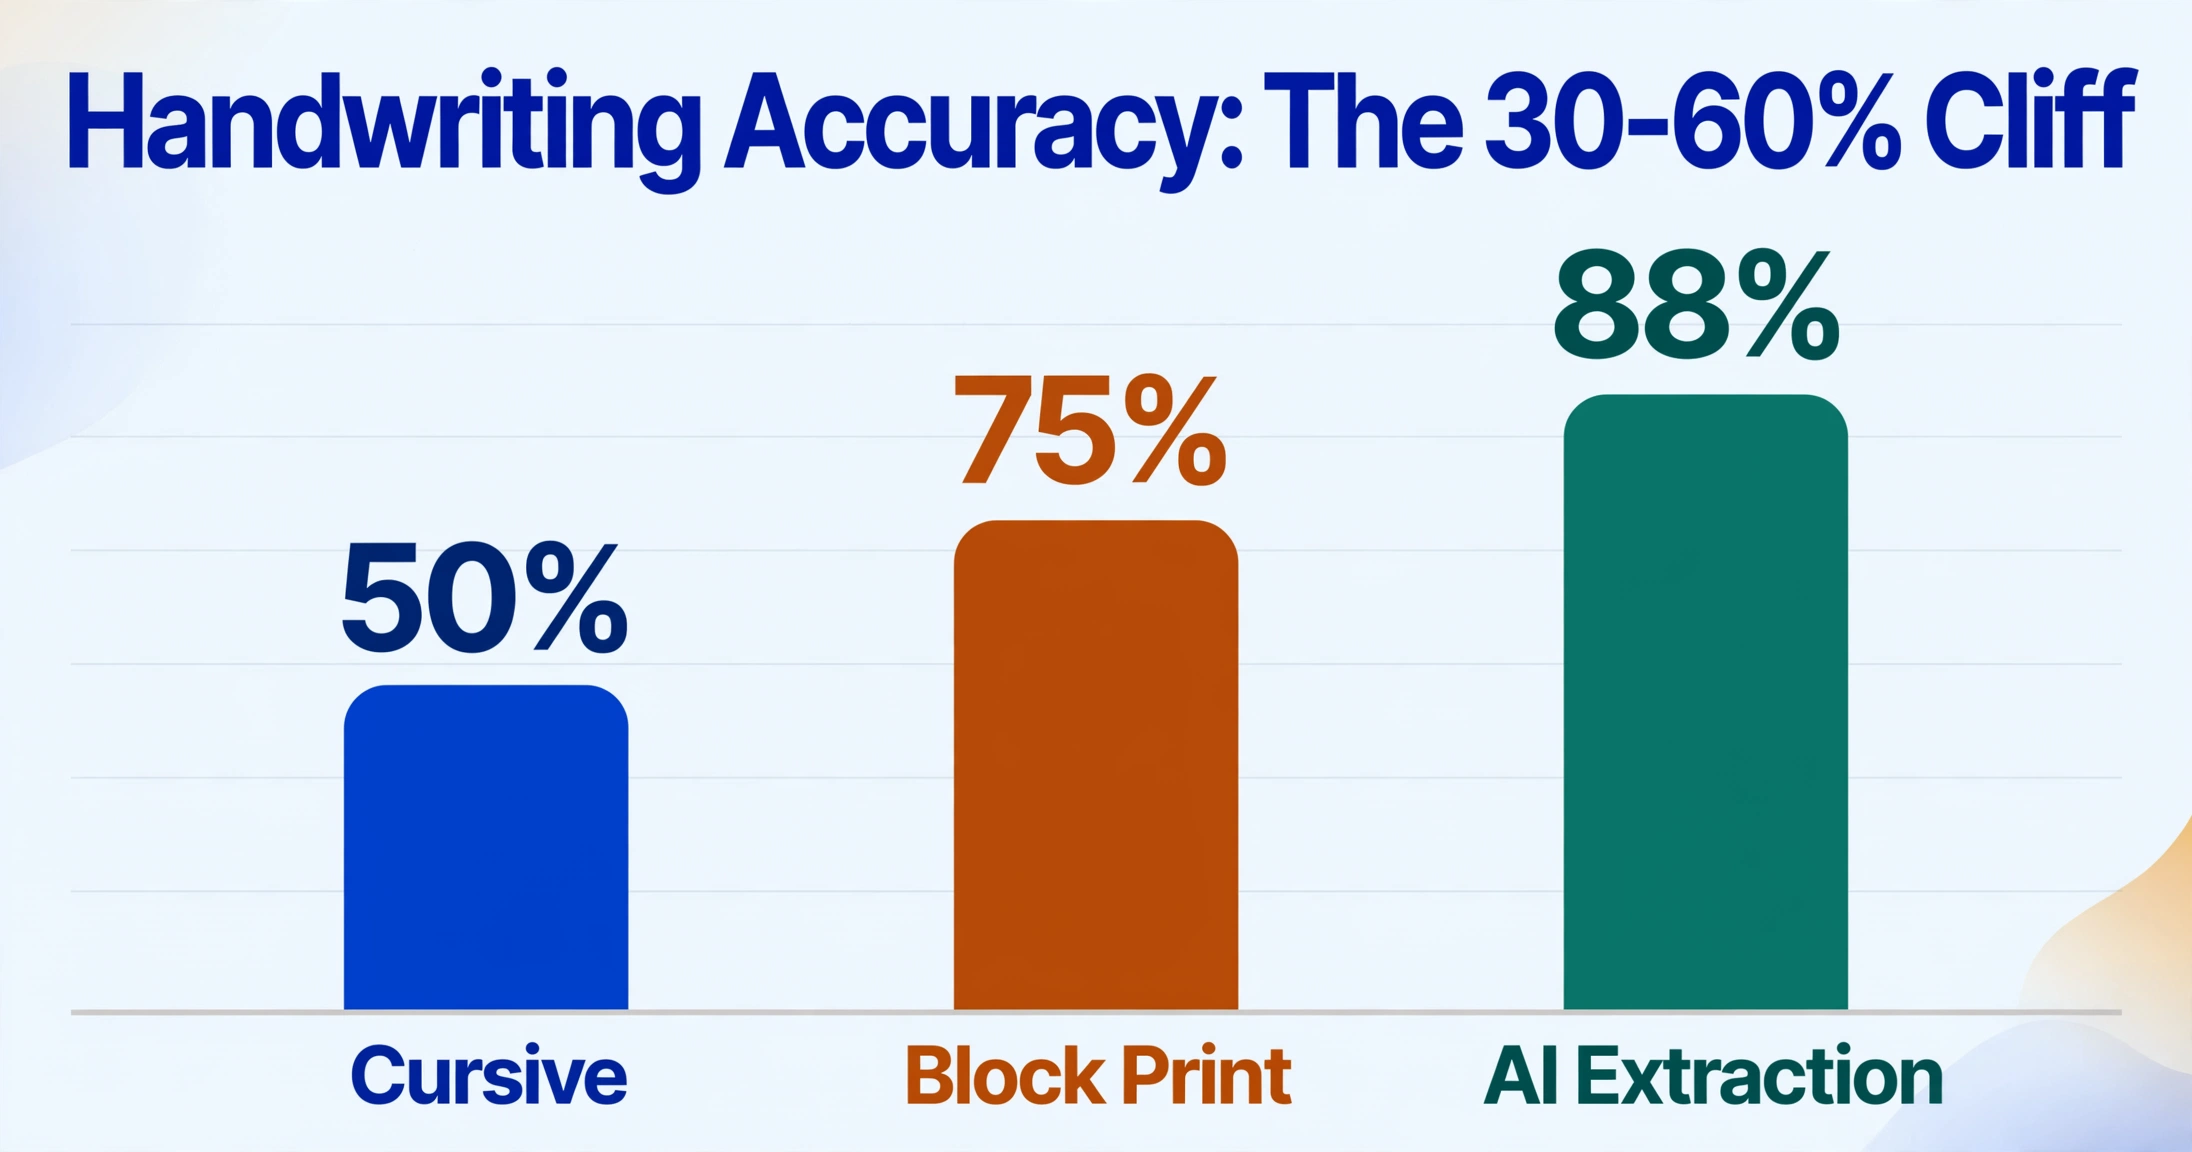
手書き文字はOCRで最も難しい問題であり、精度の数字にもそれが表れています。従来のOCRエンジンでは、文字枠に収められたブロック体の手書き文字で、文字精度は約75%に達します。筆記体は50%以下に落ち込みます。これはOCRSolutionsが実世界のフォーム処理パイプラインで実施した本番ベンチマークのデータであり、きれいに書かれた学習サンプルを使った実験室環境での結果ではありません。
理由は機械的なものにあります。従来のOCRは、既知の文字形状のデータベースに対して個々のグリフをパターンマッチングすることで機能します。印刷された「A」は常に印刷された「A」のように見えます。フォントのバリエーションは多少ありますが、文字の骨格は一貫しています。手書きの「A」には一貫した骨格がありません。傾き、ストロークの太さ、リガチャの接続、文字間隔、ベースラインのずれはすべて、書き手によって異なり、同じ書き手が1ページの中で書いた場合でも、しばしば異なります。マッチすべき安定したパターンがない場合、固定されたグリフデータベースへのパターンマッチングは失敗します。
筆記体はすべての問題を悪化させます。文字がつながると、エンジンはある文字がどこで終わり、次の文字がどこから始まるのかを判断できなくなります。つながった「tion」という並びは、文字データベースの何にも一致しない、区別不能な単一のグリフになります。筆記体に対する一般的なOCR出力は、ランダムな文字列になります。「total」が「totl」、「January」が「Jnury」になるといった具合です。エンジンは、印刷文字のOCRを信頼できるものにする視覚的なセグメンテーションの手がかりなしに、個々の文字形状を推測しています。
実際的な結果として、手書きの要素を含むドキュメントワークフロー——署名入りの納品書、手書きで記入された点検フォーム、鉛筆で時間が書き込まれた紙のタイムシート——では、OCR完了後に手動データ入力のステップが発生します。手動入力を排除するはずのツールは、印刷された部分しか処理できません。人間が手書きで書いたものはすべて、元の文書を読んだ人間が転記する必要があります。特に手書き文書を扱うワークフロー、例えば手書きフォームをデジタルテキストに変換するといったケースでは、抽出エンジンの選択によって、文書全体が自動処理されるか、印刷されたヘッダーだけが残るかが決まります。
AI抽出がフィールドタイプごとに異なる理由
AIベースの抽出は、これらすべての問題を単一の画一的なメカニズムで解決するわけではありません。各フィールドタイプは異なる理由で失敗し、AI抽出はそれぞれの理由に異なる能力で対応します — メカニックがガスケットの漏れと電気系統の故障を、どちらもエンジンの調子が悪いからといって同じように修理しないのと同じです。
氏名と住所の場合(コンテキスト問題): AIビジョンモデルは、文書構造との関係で各テキストが意味することを理解しながら、文書を上から下へ読み取ります。ImageToTable.aiのようなツールでカスタム列抽出を設定するとき — 「顧客名」「仕入先住所」「請求書番号」などのフィールド名を入力するとき — AIはピクセル座標を探すのではありません。意味的な説明に一致する値を文書全体からスキャンします。「Bill To:」の横にある「John Smith」は、ページ上のどこにあっても顧客名にマッピングされます。テンプレートも、座標マップも、仕入先が請求書を再設計したときの再構築も不要です。これが、複数仕入先の文書バッチにおいて、テンプレートベースの精度60%とAI抽出の95%+の差を埋めるメカニズムです。
明細行とテーブルの場合(構造問題): AIビジョンモデルは、ページをテキストストリームに平坦化するのではなく、空間レイアウトの内部表現 — 列、行、セル結合、入れ子ヘッダー — を維持します。請求書から明細行を抽出するとき、モデルはテーブル領域を特定し、行と列に分割し、各セル値をその列ヘッダーに関連付けます。出力は、従来のOCRが破棄するテーブル構造を保持します。これにより、複雑なレイアウトでの行レベルの精度が60〜80%から90%+の範囲に引き上げられます。
チェックボックスと混合コンテンツの場合(検出問題): AIビジョンモデルは、テキストに変換する前に文書を画像として処理します。つまり、チェックボックス、スタンプ、透かしを、人間の読者がするのと同じように — 周囲のテキストとは別の明確な視覚要素として「見る」ことができます。チェックされたボックスは、ランダムなグリフではなくチェックマークとして認識されます。テキストに重なったスタンプは別のレイヤーとして識別され、モデルはそこにあるべきものを推論することで下のテキストを抽出できます。
手書き文字の場合(パターン失敗): 何百万もの手書きサンプルで訓練されたAIモデルは、グリフの骨格を照合するのではなく、ストロークパターンの背後にある意図を理解することで文字を認識することを学びます。コンテキストが、個々の文字認識が見逃す部分を補完します。モデルが請求書の下部にある「Amount Due」というラベルのフィールドで「Totl」を読み取った場合、「Total」に解決します — 「a」を突然認識したからではなく、「Totl」がそのラベルとその位置にあるなら「Total」でなければならないからです。この文脈補正が、手書き文字の精度をブロック体で50%から85〜93%、筆記体で75〜85%に引き上げるのです。
これらのメカニズムはどれも魔法ではありません。それぞれ極端な条件下 — ひどく劣化したスキャン、人間でも判読できない手書き文字、目に見える列境界のないテーブル — では失敗します。しかし、各メカニズムは従来のOCRが対応できない特定の失敗モードを狙っています。全フィールドタイプにわたる累積効果が、文書バッチを「手動レビュー40%必要」から「手動レビュー5%必要」に変えるのです。
その違いは、試してみるとすぐにわかります。以下のデモは、上で説明したのと同じフィールドタイプ — 日付、金額、仕入先名、明細行、税 — を含む請求書を、AI抽出パイプラインで処理します。テンプレートも、座標マッピングも、必要な列名を入力する以外の事前設定もありません。
ファイルは安全に処理され、保存されることはありません。
OCRの監査方法: 修正に最もコストがかかるフィールドはどれか
現在ドキュメント処理パイプラインを運用しているなら、最も有益なのは全体の精度パーセンテージではなく、フィールドタイプ別の修正コストを測定することです。95%の全体精度はダッシュボード上では良好に見えます。しかしフィールド別の内訳を見れば、5%のエラーがどこに集中しているか、そしてそれらのエラーを修正するのに実際にどれだけのコストがかかるかがわかります。
現在の抽出パイプラインでフィールドレベルの精度監査を実行する方法は次のとおりです:
本番環境から100件のドキュメントをサンプリングする。
クリーンなテストセットは使わないでください。通常の営業日にパイプラインが実際に処理するものを何でも使ってください。複数のベンダー、複数のフォーマット、チームが実際に提出するスキャン品質など、そのままです。
抽出エラーをフィールドタイプごとに分類する。
各エラーを日付、金額、名前/住所、明細行(テーブル)、チェックボックス、手書き文字、混在コンテンツとしてタグ付けします。1つのエラーにフィールドタイプと根本原因の両方がある場合があります。両方を記録してください。
エラー数だけでなく、修正時間を測定する。
ずれた明細行のテーブル行を修正するには、元のドキュメントを照合しながら2〜3分かかることもあります。日付形式の修正は10秒です。エラー数ではなく、時間を数えてください。
フィールドタイプごとのエラー率に、フィールドごとの修正コストを掛ける。
修正に1件あたり2ドルかかる金額の5%のエラー率と、修正に1件あたり0.50ドルかかる氏名の20%のエラー率は異なります。エラー率×修正コストの積が最も高いフィールドタイプが、あなたのボトルネックです。
従来のOCRパイプラインで複数ベンダーの請求書を処理する場合、この監査を実施すると一貫したパターンが浮かび上がります。明細行とテーブルが最も多くの修正時間を消費します。これはエラー数が最も多いからではなく(そのカテゴリは手書き文字が最多)、各テーブルエラーの修正には元のドキュメントから行と列の関係を再構築する必要があるためです。500件の請求書で5つの明細行がある場合の20%のテーブルエラー率は、手動で再構築する500行を意味します。1行あたり2分だと、修正時間は16時間になります。これは2営業日以上に相当し、OCRが自動処理するはずだったバッチに対してです。
金額と日付は、生のエラー率は低いものの、見逃した場合の影響が大きいため、2番目に高コストなカテゴリです。誤った請求書合計がERPに入ると、調整差異が発生し、その解消にはフィールドレベルの修正で防ぐよりもはるかに多くのコストがかかります。こうしたフィールドレベルの失敗がパイプライン全体の非効率にどのように積み重なるかについては、AI OCRと従来のOCRの精度ベンチマークの比較と、AIデータ入力の精度期待値の設定に関する実践ガイドをご覧ください。
どのフィールドタイプがチームの時間を奪っているかがわかったら、次の質問は、抽出エンジンがその特定のフィールドタイプをよりうまく処理できるかどうかです。ボトルネックがテーブル構造なら、セマンティックなテーブル理解を持たないエンジンに切り替えても、問題が同じ問題に置き換わるだけです。ボトルネックが手書き文字やチェックボックスなら、それらを検出できないエンジンでは決して改善されません。監査は、抽出が失敗していることだけでなく、どこで失敗しているかを教えてくれます。そして、その「どこ」が、アップグレードが実際にボトルネックに対処するのか、それとも同じエラーログのロゴを変えるだけなのかを決定づけます。
FAQ
従来のOCRは、他の文書タイプよりも得意な文書タイプがありますか?
はい。従来のOCRは、レイアウトが一貫した、きれいな印刷物、単一カラムのテキスト文書(契約書、レター、単一ソースからの標準化されたフォーム)では良好に機能します。テーブル、手書き文字、混在フォント、低コントラスト、またはソース間でのレイアウトのばらつきがある文書では、精度が低下します。その差はわずかではありません。タイプライターで書かれたレターはフィールド精度98%で抽出できる一方、明細行テーブルを含む複数ベンダーの請求書バッチは60〜85%でしか抽出できません。
高解像度でスキャンすれば、従来のOCRの精度を向上できますか?
ある程度までは可能です。300 DPI(標準的な推奨値)でのスキャンは、150 DPIや遠くから撮影したスマートフォンの写真と比較して、文字認識を改善します。しかし、解像度の向上は文字レベルのエラーにのみ影響し、本番パイプラインでの修正時間の大部分を占める構造的な失敗(テーブル、フィールドマッピング、チェックボックス)には何の効果もありません。壊れたテーブルの鮮明な画像は、やはり壊れたテーブルです。
どの抽出システムにとっても、最も難しいフィールドタイプは何ですか?
手書き文字(特に筆記体)は、AIベースの抽出を含むあらゆるシステムにとって、最も難しいフィールドタイプであり続けています。多様な手書き文字データセットでトレーニングされたAIモデルは、ブロック体で85〜93%、筆記体で75〜85%の精度を達成しており、これは従来のOCRの30〜60%からの大幅な改善ですが、99%ではありません。手書きフィールドが重要なデータ(支払金額、患者名、コンプライアンスチェック値)を担うワークフローでは、低信頼度の抽出に対するヒューマン・イン・ザ・ループによるレビューが依然として最も安全なアプローチです。
ImageToTable.aiは手書きドキュメントを処理できますか?
ImageToTable.aiは、同じドキュメント内の手書き文字、印刷テキスト、チェックボックス、スタンプ、表構造を認識できる視覚言語モデルを使用しています。手書き文字の認識精度は、読みやすさと筆記スタイルに依存します — きれいなブロック体は確実に抽出できますが、大きく装飾された筆記体は手動での確認が必要な場合があります。このモデルは、ドキュメントのどの領域から読み取ったかを示す視覚的な手掛かりを提供するため、手書きフィールドを全体を読み直すことなく素早くスポットチェックできます。ドキュメントが主に手書きの場合は、スケーリング前に特定の手書きサンプルで精度を測定するため、小さなバッチテストから始めることを検討してください。
ImageToTable.aiのテーブル抽出は従来のOCRとどう違うのですか?
従来のOCRは線形のテキストストリームを出力します。テーブルはフラット化されます。ImageToTable.aiはドキュメントを視覚的なレイアウトとして処理し、テーブル領域を検出し、行と列をセグメント化し、各セル値を列ヘッダーに関連付けます。出力はテーブル構造を保持します — 各行は出力スプレッドシートの行になり、各列は指定した列名にマッピングされます。これはテンプレートなしで機能するため、同じベンダーからの5行の請求書と20行の請求書の両方が、テーブルの高さに関係なく正しく抽出されます。従来のアプローチとの違いについての詳しい説明は、AIデータ入力の概要をご覧ください。
問題はOCRにエラーがあるかどうかではありません。どの抽出システムにもエラーはあります。問題は、そのエラーが1分で直せる箇所に集中しているか、それとも1つのミスが1時間の照合作業に発展するフィールドに集中しているかです。次のバッチで監査を実行してください — 全体的な精度ではなく、フィールドタイプごとの修正時間を測定すれば、自分がどちらのケースに該当するかがわかります。