Precisão de OCR por Campo:
95% no Geral, 60% nos Campos que Importam
"95% de precisão" é o número que a maioria das ferramentas de OCR usa como destaque. Mas quando você processa um lote de 200 faturas pelo pipeline e ainda gasta a tarde de terça-feira corrigindo manualmente os campos extraídos, essa afirmação de 95% começa a parecer um erro de arredondamento a favor de outra pessoa. O motivo não é que o número seja inventado. É que a precisão nunca é uniforme entre os tipos de campo — e os campos que o OCR erra são desproporcionalmente aqueles dos quais seus sistemas downstream realmente dependem. Este artigo mede a diferença campo por campo, explica por que cada tipo de campo falha de maneira diferente e mostra o que custa corrigir cada um deles.
Principais Conclusões
- Seu OCR relata 95% de precisão enquanto cai silenciosamente para 60% nos três tipos de campo sem os quais seu sistema contábil não pode funcionar.
- Cinco tipos diferentes de campo falham por cinco razões completamente diferentes — e atualizar para uma resolução de digitalização mais alta não resolve nenhuma delas.
- Substitua o número de precisão do painel por uma métrica — tempo de correção por tipo de campo — e use o ImageToTable.ai para abordar cada modo de falha em sua raiz estrutural em vez de seu sintoma superficial.
O Problema da "Precisão de 95%"
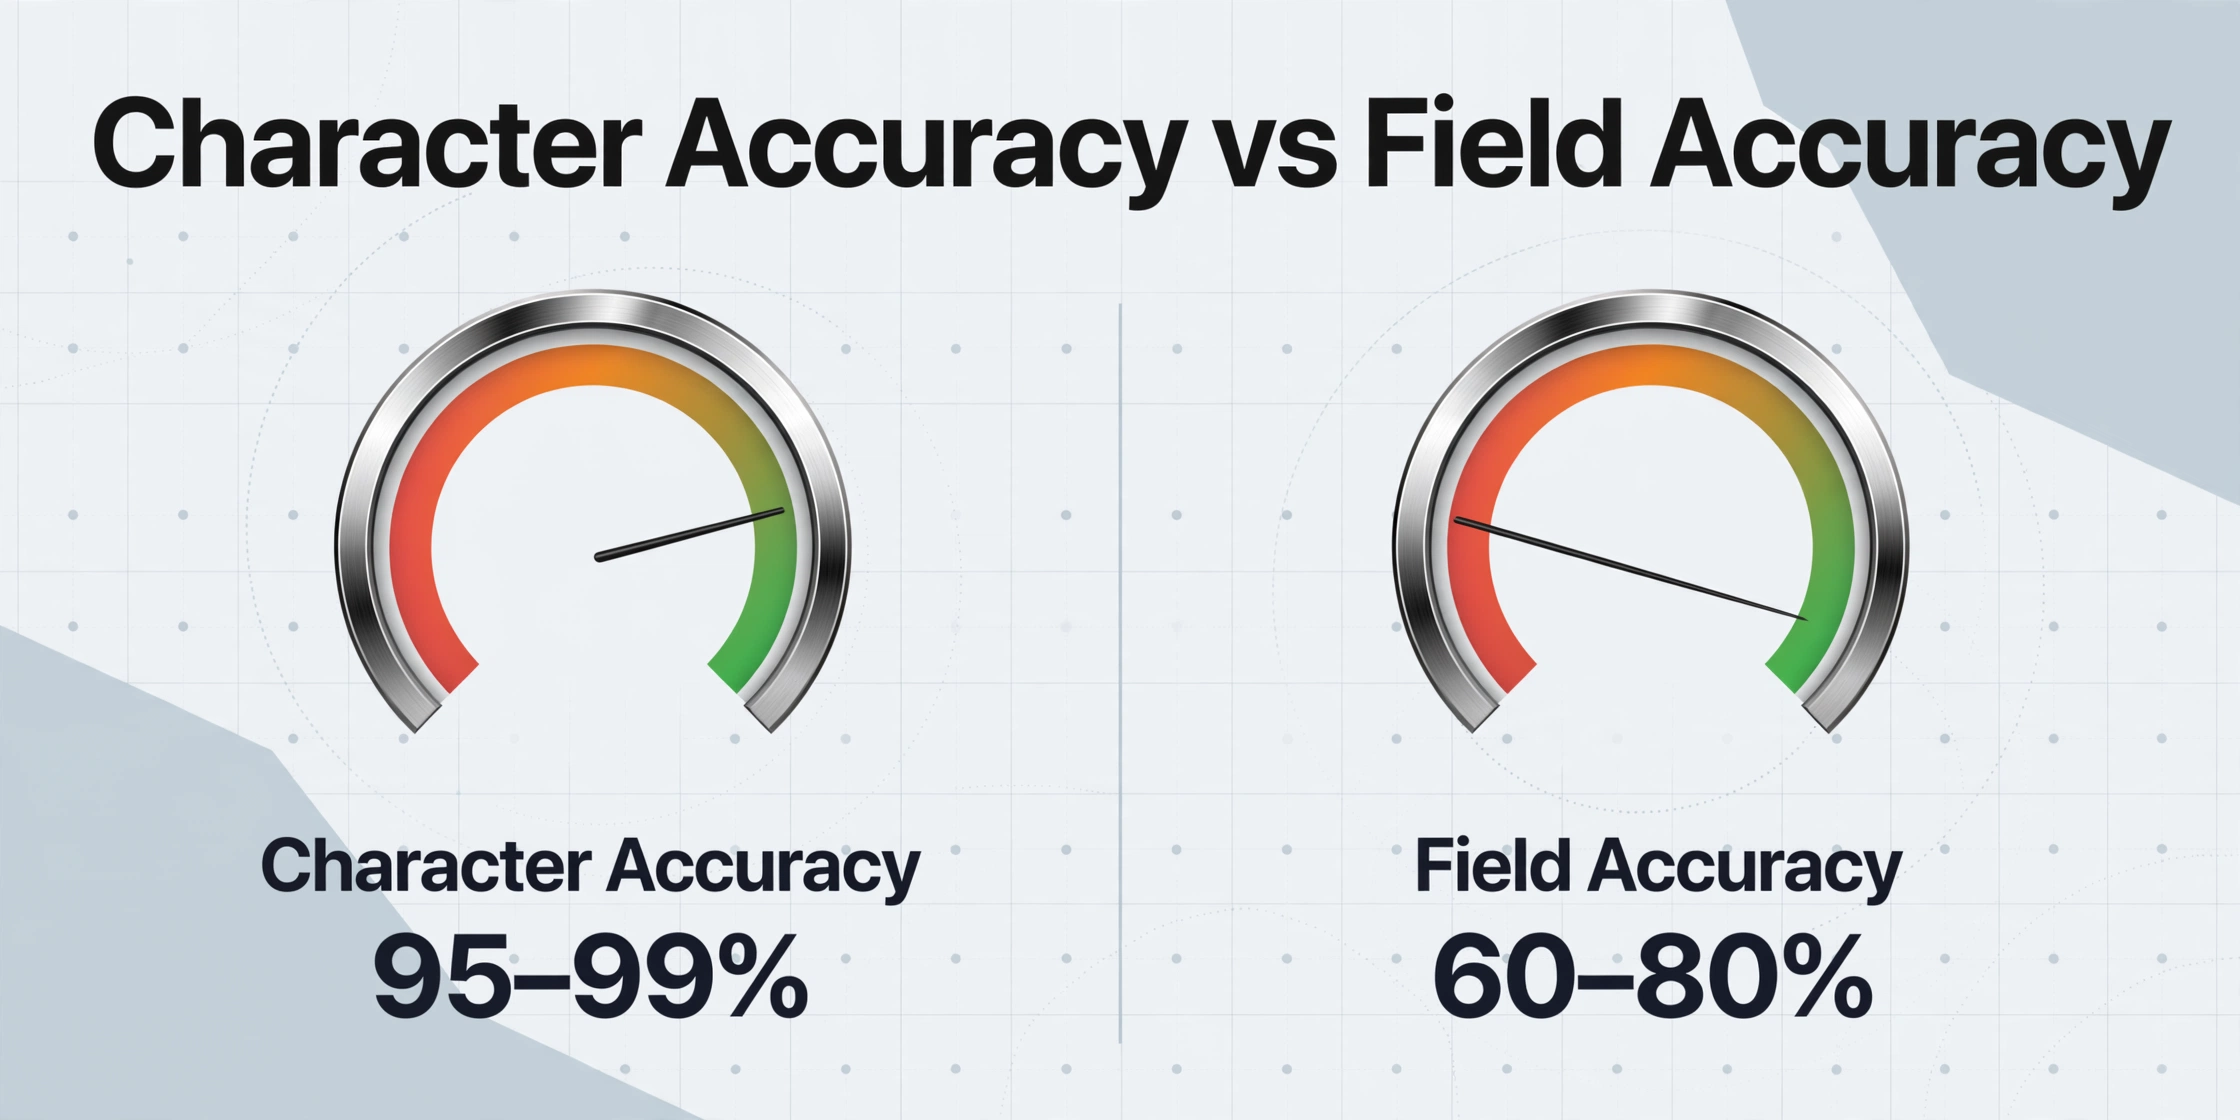
Os mecanismos de OCR tradicionais se medem pela precisão em nível de caracteres — o percentual de caracteres individuais reconhecidos corretamente a partir da imagem de um documento. O Tesseract 5, referência de código aberto mantida pelo Google, alcança 95% de precisão de caracteres em documentos impressos limpos. Mecanismos empresariais como o ABBYY FineReader chegam a 97–99% em condições de laboratório. Esses são números reais medidos em conjuntos de teste reais.
Mas a precisão de caracteres é um indicador ruim do que as empresas realmente precisam: campos de dados completos e corretos. Um único dígito lido errado em um número de fatura de 10 dígitos significa que o campo inteiro está errado. Uma precisão de caracteres de 99% em uma página de 1.000 caracteres significa que 10 caracteres estão errados — e se esses 10 caracteres errados caírem dentro de 3 dos seus 15 campos-alvo, a precisão em nível de campo cai para 80%. O TDWI documentou exatamente esse cenário em pipelines de OCR em produção: o painel reporta 99%, mas 1 em cada 5 campos de negócio extraídos contém um erro.
O que torna isso pior é que os erros não se distribuem uniformemente. O OCR tradicional acerta alguns tipos de campo quase sempre. Outros falham tão gravemente que a extração poderia nem ter acontecido. O problema é que os campos com maior probabilidade de falhar — valores em dólar em itens de linha, datas em escrita manual, dados estruturados em tabelas — são também os campos onde um erro é mais caro de corrigir.
Datas e Números Impressos — O Que o OCR Faz Bem
Em documentos impressos, limpos e de alto contraste, o OCR tradicional maneja bem datas e valores em dólar em posições padrão. Uma data de fatura impressa como "06/09/2026" em Arial 11pt sobre fundo branco a 300 DPI será lida pelo OCR com precisão de caracteres quase perfeita. Um valor total impresso como "$1.234,56" no canto inferior direito, posicionado de forma consistente nas faturas de um fornecedor, é extraído de forma confiável quando combinado com um modelo bem mantido.
Estes são os campos que producen os números de 95–99% que os fornecedores de OCR citam. Eles representam o melhor cenário: fontes padronizadas, posições previsíveis, alto contraste. É aqui que o OCR tradicional realmente funciona.
As rachaduras aparecem assim que os formatos variam. Uma data escrita como "09/06/2026" — é 9 de junho (EUA) ou 6 de setembro (Reino Unido)? O OCR tradicional não tem mecanismo para detectar a diferença; ele lê fielmente os dígitos, e o sistema downstream adivina ou usa por padrão o formato dos EUA. Um usuário do Reddit que construía um pipeline de faturas europeo em Python documentou exatamente este problema: faturas italianas usam 31/12/2024, faturas alemãs usam 31.12.2024, e faturas británicas usam 31/12/2024 (mesma sintaxis, ordem de dia/mês diferente). Sem normalização ciente do locale, datas extraídas de lotes de faturas de vários países são silenciosamente embaraladas por meses.
Os valores em dólar têm um modo de falha mais sutil. Un "$1.234,56" impresso limpiamente se lee bien. Pero cuando un subtotal de item de línea de "$1.234,56" está una fila encima de un total de factura de "$1.234,56" — mismo número, significado diferente — la extracción basada en plantillas corre el riesgo de tomar el equivocado. Las variantes de símbolos de moneda agravan el problema: "€1.234,56" (coma decimal europea), "¥1,235" (yen japonés, sin decimales), o cantidades impresas sin ningún símbolo de moneda pueden hacer tropezar diferentes reglas de análisis.
Nombres y Direcciones — Caracteres Correctos, Contexto Incorrecto
En la superficie, los nombres y direcciones parecen fáciles para el OCR. Son texto, generalmente impreso en fuentes legibles, y no contienen glifos inusuales. Un motor de OCR tradicional reconocerá correctamente la cadena "John Smith" con alta confianza y la dirección "123 Main Street, Springfield, IL 62701" casi igual de bien.
El fallo no es el reconocimiento de caracteres. Es la identificación del campo. El OCR lee "John Smith" como caracteres en una página. No sabe si ese texto es el nombre del cliente, el nombre del proveedor, el contacto de envío o el gerente aprobador. Estas relaciones están definidas por el diseño del documento — John Smith podría estar impreso junto a "Bill To:", "Ship To:", o "From:" — y el pipeline de caracteres de abajo hacia arriba del OCR tradicional no puede conectar una etiqueta con su valor asociado cuando los diseños cambian entre proveedores.
Esta es la razón por la que los sistemas basados en plantillas requieren un mapa de coordenadas separado para cada diseño de proveedor. La plantilla dice "el nombre del cliente está en las coordenadas de píxeles (450, 320)". Cuando un nuevo proveedor pone el nombre del cliente en (520, 280), la plantilla captura espacio en blanco o el campo equivocado. El problema escala con el número de proveedores: 20 proveedores significan 20 plantillas para construir y mantener. 200 proveedores significan que el mantenimiento de plantillas se convierte en un trabajo de tiempo completo.
El costo de este fallo es insidioso porque a menudo pasa desapercibido. Un campo de nombre mapeado incorrectamente no arroja un error de formato — "Sarah Chen" es un nombre válido ya sea que esté en el campo del cliente o en el del proveedor. El error sale a la superficie más tarde, cuando un pago va a la entidad equivocada o un informe agrupa transacciones bajo la contraparte incorrecta.
Itens de Linha e Tabelas — Onde o OCR Perde a Estrutura
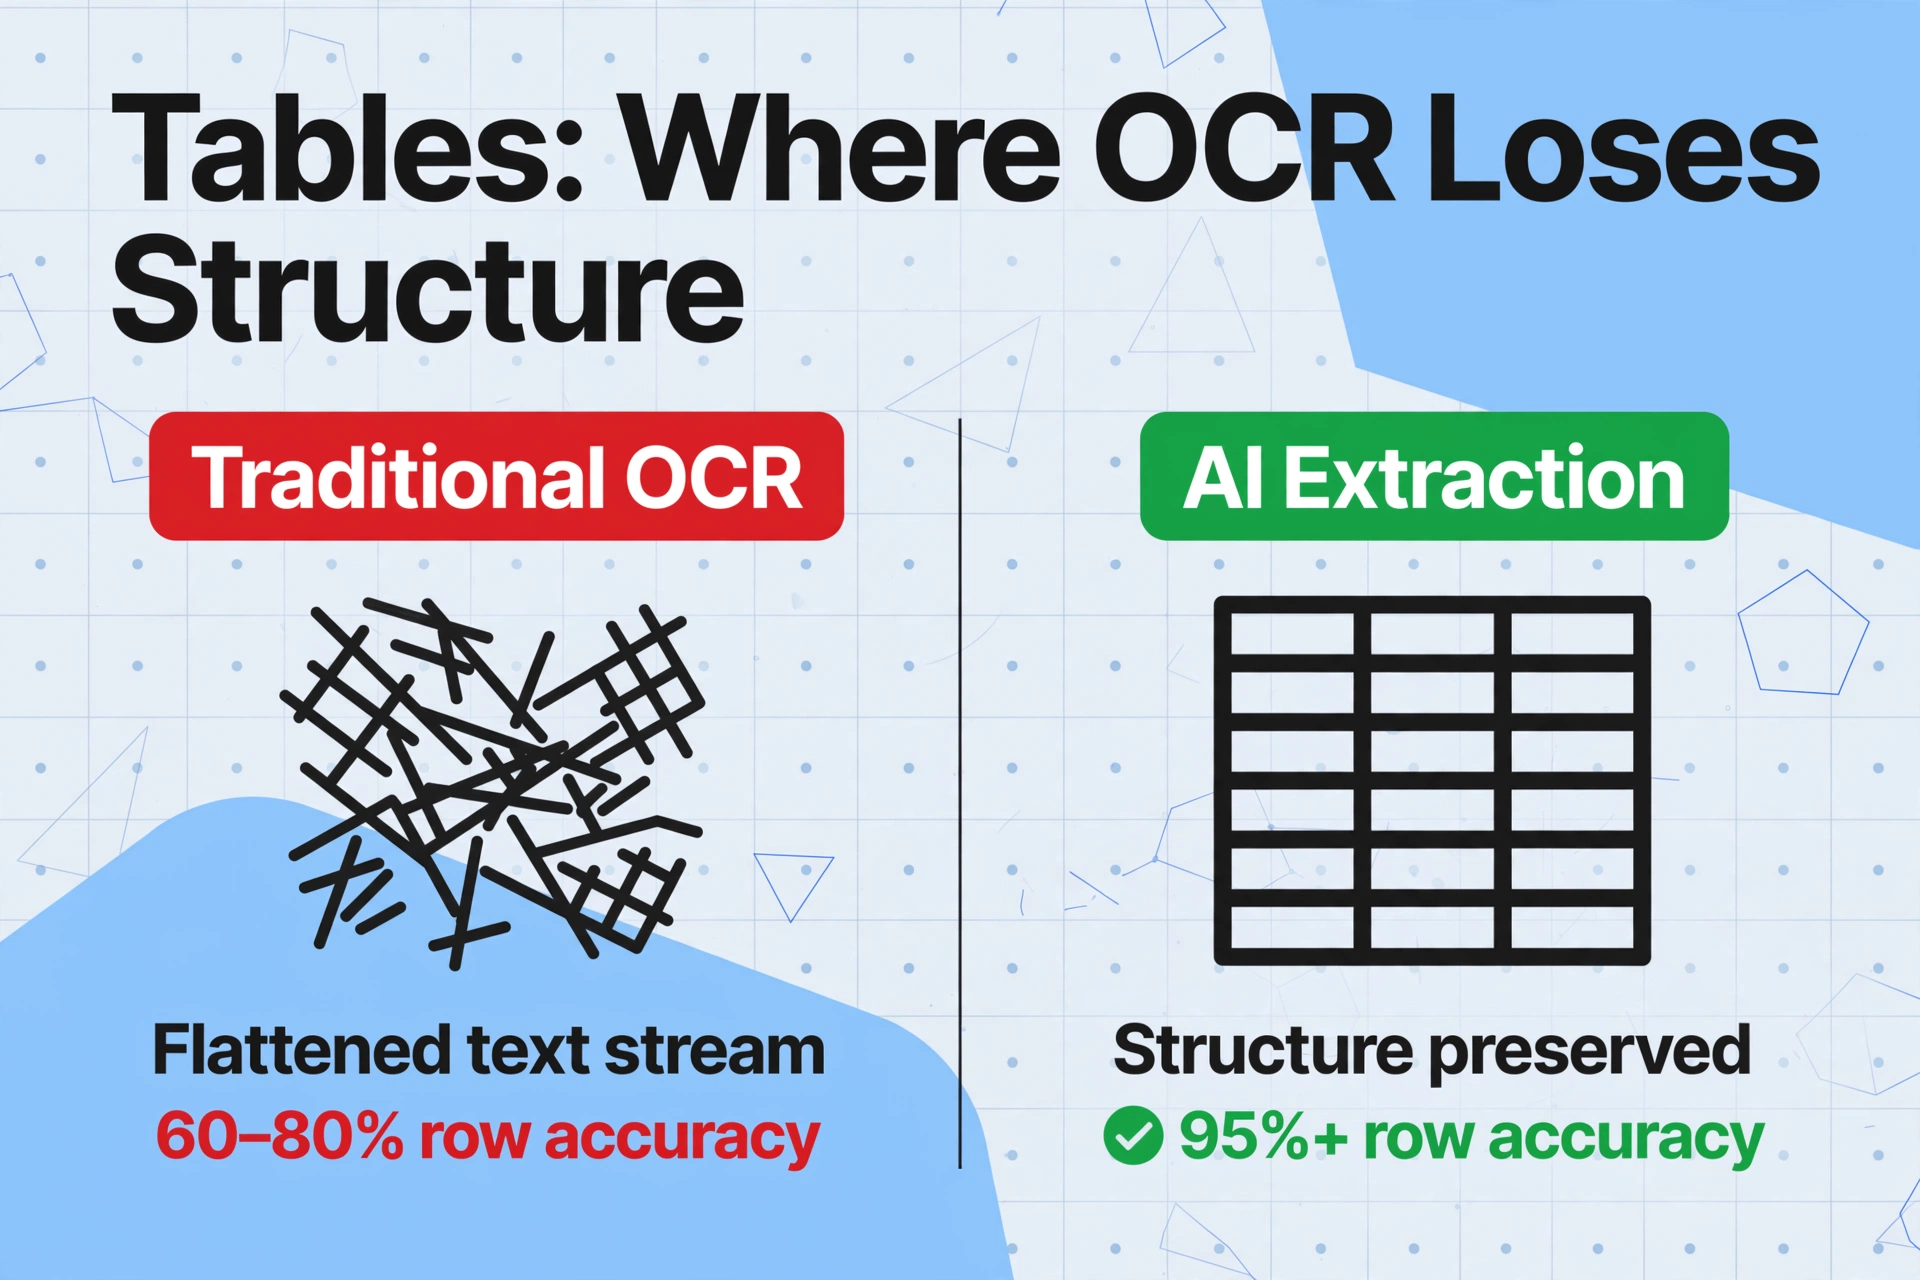
As tabelas são o maior ponto de falha do OCR tradicional, e aparecem em quase todo documento empresarial: itens de linha de faturas, detalhes de pedidos de compra, detalhamentos de relatórios de despesas, linhas de transações de extratos bancários. O problema é arquitetural. Os mecanismos de OCR produzem um fluxo linear de caracteres organizados por ordem de leitura — da esquerda para a direita, de cima para baixo. Uma tabela de três colunas com cinco linhas é achatada em uma única sequência de fragmentos de texto, e os limites das colunas que definem qual valor pertence a qual cabeçalho evaporam.
Os benchmarks de produção quantificam o dano. Em layouts de tabela complexos — células mescladas, cabeçalhos aninhados, larguras de coluna inconsistentes — a precisão em nível de linha do OCR tradicional cai para 60–80%. Um valor destinado à coluna "quantidade" acaba na coluna "preço unitário". Uma linha que abrange duas linhas de descrição é dividida em duas entradas separadas. Pontos decimais migram uma posição quando o OCR confunde uma linha separadora de coluna com o numeral "1".
Isso não é uma falha de reconhecimento de caracteres. O mecanismo de OCR lê os caracteres individuais corretamente — "5", "pcs", "$12.50" — mas o sistema downstream não tem como reconstruir quais caracteres pertencem a qual linha e coluna. A saída é uma mistura de texto intercalado que exige reconstrução manual, linha por linha.
As abordagens baseadas em modelo tentam resolver isso definindo regiões de tabela: "a tabela de itens de linha começa em Y=600 e termina em Y=900." Mas as alturas das tabelas variam com o número de itens de linha. Um pedido de uma linha e um pedido de 20 linhas do mesmo fornecedor produzem tabelas de comprimentos completamente diferentes. A região fixa do modelo captura apenas parte da tabela ou, pior, puxa texto não relacionado abaixo da tabela para a última linha. Para um guia prático sobre extração de dados de tabelas para planilhas estruturadas, a variável crítica é se o mecanismo de extração entende a estrutura tabular semanticamente — não apenas lê caracteres dentro de uma caixa delimitadora.
Caixas de Seleção, Carimbos e Conteúdo Misto — O Que o OCR Tradicional Não Consegue Ver
Existe uma categoria de elementos de documento nos quais o OCR tradicional não falha — simplesmente não consegue detectá-los. Esses elementos não producen nenhuna saída, geran caracteres inútilies ou, no peor dos casos, contaminan a extração de campos de texto adjacentes.
Caixas de seleção. Uma caixa marcada (✓) e uma caixa desmarcada (☐) são visualmente distintas para um lector humano, mas para um motor de OCR tradicional ambas são manchas de baixo contraste próximas ao limiar de detección. O OCR pode registrar uma como uma mancha e a outra como "nada", ou pode ler a marca como um carácter solto — um "V", um "7" ou um glifo aleatório. A intenção — "esta caixa está marcada" — nunca é capturada. Formulários que dependen de campos de caixa de seleção (solicitudes de seguro, informes de inspección, listas de verificación de conformidade) requieren revisión manual 100% de cada caixa após o OCR processar o documento.
Carimbos e marcas de água. Um carimbo "PAGADO" sobreposto ao corpo de uma fatura, uma marca de água "CONFIDENCIAL" em uma página de contrato ou um selo vermelho da empresa sobre uma ordem de compra crian todos o mesmo fallo: duas capas de informação visual ocupando a mesma região espacial. O OCR tradicional não consegue separar o primeiro plano do fundo; ve uma única região de imagem ruidosa e produce texto ilegible ou nada. Tanto o texto do carimbo como o texto subjacente do documento se tornan ilegibles.
Conteúdo misto. Texto impresso sobre fondos coloridos, texto branco sobre cabeçalhos escuros ou valores de dados dentro de células de tabela sombreadas reducen o contraste por debajo do limiar que os motores de OCR necesitan. Uma barra de cabeçalho azul escuro com texto branco que diz "Fatura" pode sair em branco — a etapa de binarização do motor converte toda a região a negro e perde o texto branco por completo. Un valor em dólares impresso em uma fila alternada de cor gris clara pode perder caracteres quando o contraste entre o fondo gris e o texto negro cae por debajo da curva de sensibilidade do motor.
Estos fallos son fundamentalmente diferentes dos problemas de tabelas ou escrita manual. As tabelas falhan porque o OCR perde a estrutura. As caixas de seleção e os carimbos falhan porque o OCR nunca os detecta em primeiro lugar. A diferença importa para a correção: você pode pós-processar uma tabela rota, mas não pode pós-processar algo que nunca foi extraído.
Escritura manual — o precipício de 30–60%
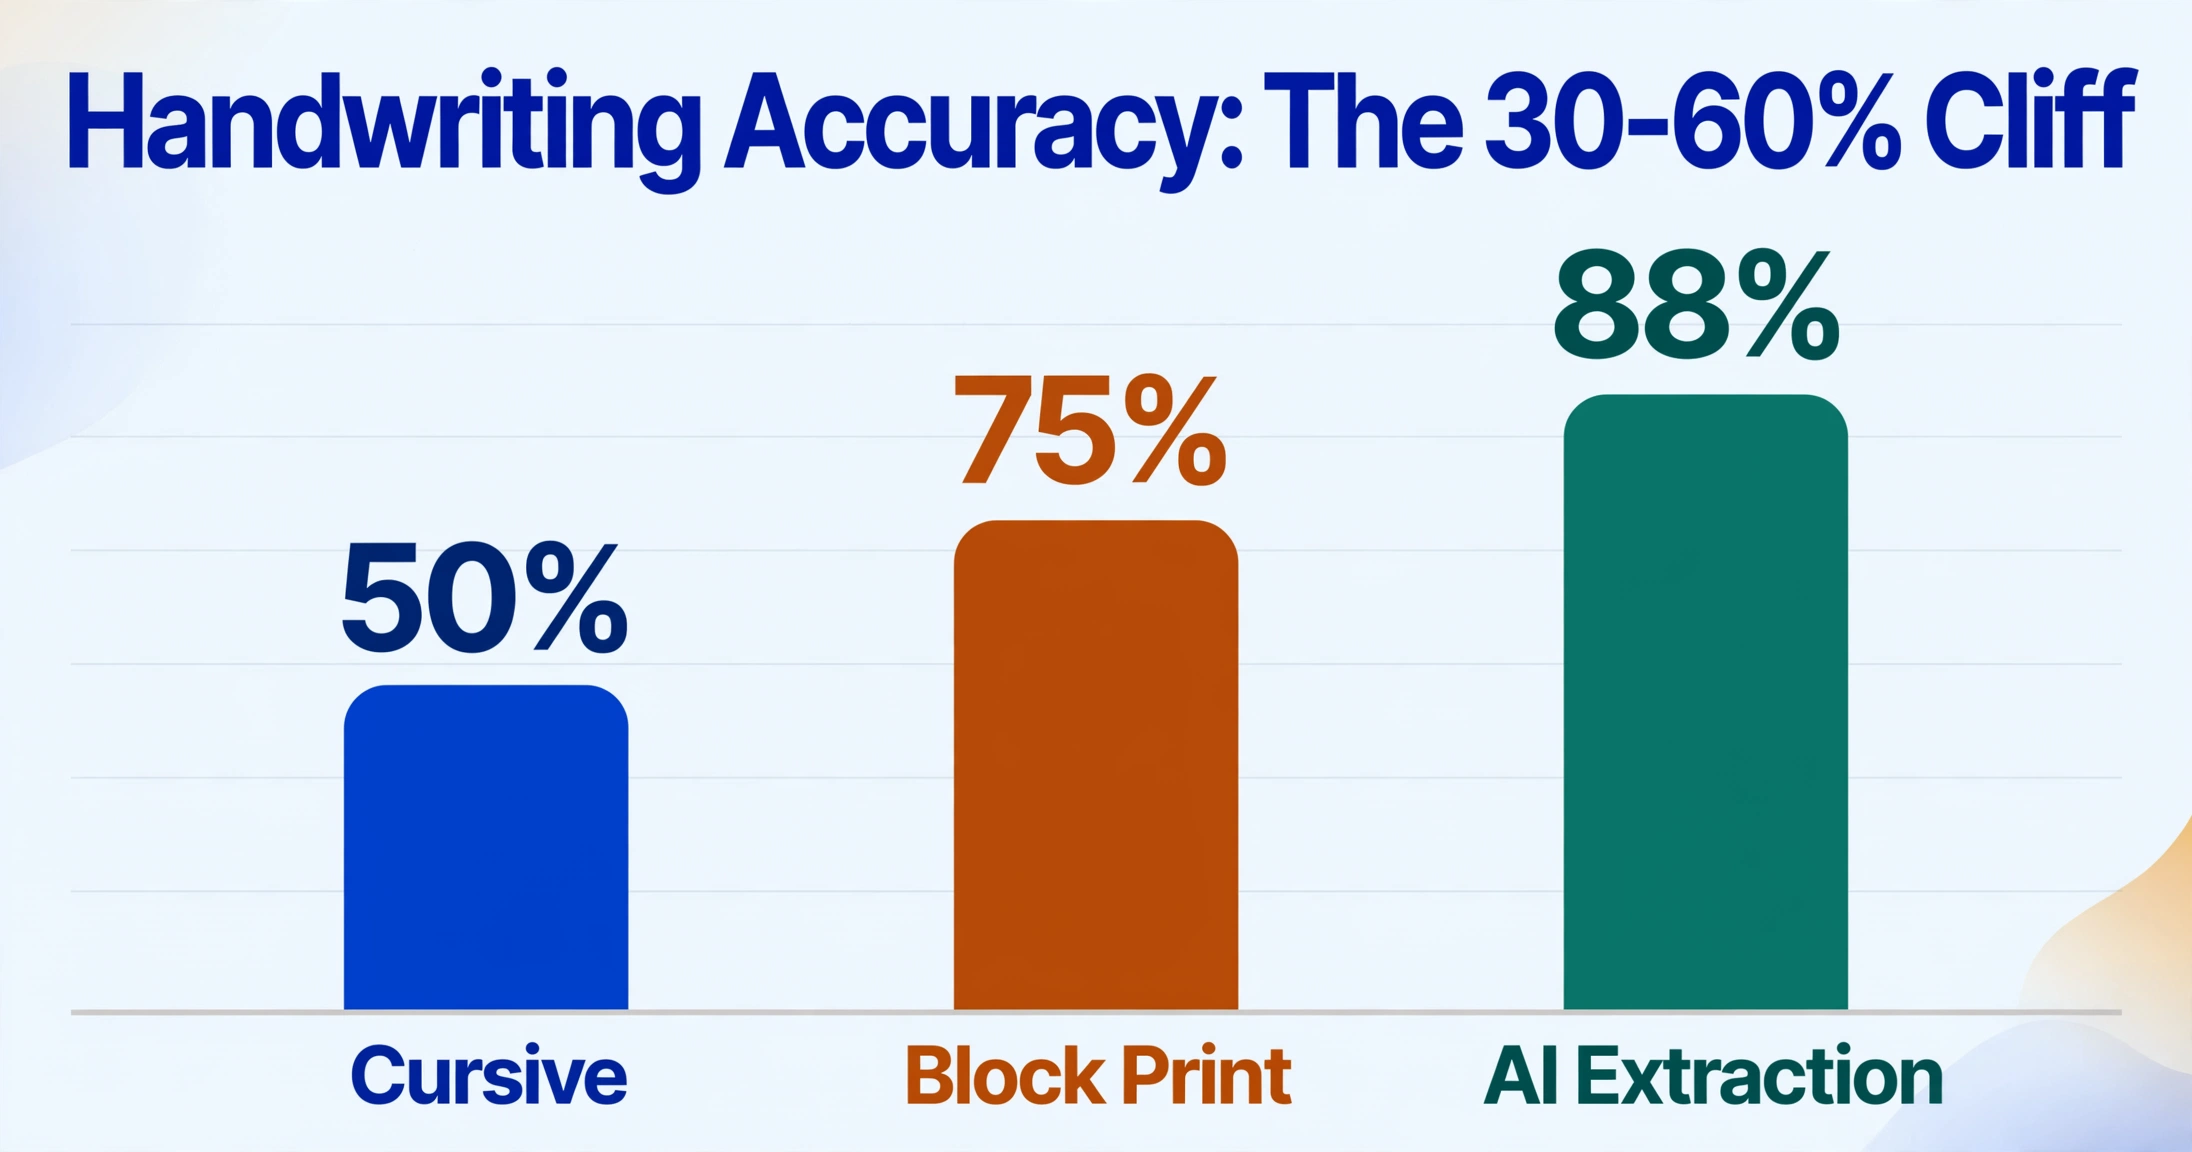
O texto manuscrito é o problema mais difícil em OCR, e os números de precisão refletem isso. Para motores OCR tradicionais, a escrita em letra de imprensa com caixas de caracteres restringidas alcanza cerca de 75% de precisão de caracteres. A escrita cursiva cae a 50% ou menos. Estes são os dados de benchmarks de produção de OCRSolutions em pipelines reais de processamento de formulários — não condições de laboratório com amostras de treinamento escritas de forma limpa.
A razão é mecánica. O OCR tradicional funciona comparando glifos individuais com uma base de dados de formas de caracteres conhecidas. O "A" impresso sempre parece um "A" impresso — existem variações menores de fonte, mas o esqueleto do caractere é consistente. O "A" manuscrito não tem esqueleto consistente. Inclinación, grosor del trazo, conexiones de ligaduras, espaciado entre letras y deriva de la línea base varían entre escritores — y a menudo dentro de la salida del mismo escritor en una sola página. La comparación de patrones contra una base de datos de glifos fijos falla cuando no hay un patrón estable que comparar.
La cursiva agrava todos los problemas. Cuando las letras se conectan, el motor no puede determinar dónde termina un carácter y comienza el siguiente. La secuencia conectada "tion" se convierte en un único glifo indiferenciado que no coincide con nada en la base de datos de caracteres. Las salidas comunes de OCR para escritura cursiva son cadenas de caracteres aleatorios — "totl" por "total", "Jnury" por "January" — donde el motor está adivinando formas de letras individuales sin las señales de segmentación visual que hacen confiable el OCR impreso.
La consecuencia práctica es que cualquier flujo de trabajo de documentos con un componente manuscrito — una nota de entrega firmada, un formulario de inspección llenado a mano, una hoja de horas en papel con horas escritas a lápiz — crea un paso de entrada manual de datos después de que el OCR termina. La herramienta que se suponía que eliminaría la entrada manual solo puede manejar la parte impresa; todo lo que un humano escribió a mano aún necesita ser transcrito por un humano que lea el original. Para flujos de trabajo que específicamente involucran documentos manuscritos como convertir formularios manuscritos a texto digital, la elección del motor de extracción determina si todo el documento se procesa automáticamente o solo sobreviven los encabezados impresos.
Por que a Extração por IA Trata Cada Tipo de Campo de Forma Diferente
A extração baseada em IA não resolve todos esses problemas com um único mecanismo indiferenciado. Cada tipo de campo falha por um motivo diferente, e a extração por IA aborda cada motivo com uma capacidade diferente — assim como um mecânico conserta um vazamento de junta de forma diferente de uma falha elétrica, mesmo que ambos façam o motor funcionar mal.
Para nomes e endereços (problema de contexto): Os modelos de visão por IA leem documentos de cima para baixo, entendendo o que cada trecho de texto significa em relação à estrutura do documento. Quando você configura a Extração de Colunas Personalizadas em uma ferramenta como o ImageToTable.ai — digitando nomes de campos como "Nome do Cliente", "Endereço do Fornecedor", "Número da Fatura" — a IA não procura coordenadas de pixels. Ela examina o documento em busca de valores que correspondam à descrição semântica. "João da Silva" ao lado de "Cobrar de:" é mapeado para Nome do Cliente, independentemente de onde apareça na página. Sem modelos, sem mapas de coordenadas, sem reconstrução quando um fornecedor redesenha sua fatura. Esse é o mecanismo que fecha a lacuna entre 60% de precisão baseada em modelo e 95%+ de extração por IA em lotes de documentos de vários fornecedores.
Para itens de linha e tabelas (problema de estrutura): Os modelos de visão por IA mantêm uma representação interna do layout espacial — colunas, linhas, células mescladas, cabeçalhos aninhados — em vez de achatar a página em um fluxo de texto. Ao extrair itens de linha de uma fatura, o modelo identifica a região da tabela, segmenta-a em linhas e colunas e associa cada valor de célula ao seu cabeçalho de coluna. A saída preserva a estrutura da tabela que o OCR tradicional descarta. Isso eleva a precisão no nível de linha de 60–80% para a faixa de 90%+ em layouts complexos.
Para caixas de seleção e conteúdo misto (problema de detecção): Os modelos de visão por IA processam o documento como uma imagem antes de convertê-lo em texto. Isso significa que eles podem "ver" uma caixa de seleção, um carimbo ou uma marca d'água da mesma forma que um leitor humano — como um elemento visual distinto, separado do texto ao redor. Uma caixa marcada é reconhecida como uma marca de verificação, não como um glifo aleatório. Um carimbo sobreposto ao texto é identificado como uma camada separada, e o modelo pode extrair o texto subjacente raciocinando sobre o que deveria estar ali.
Para escrita manual (falha de padrão): Os modelos de IA treinados em milhões de amostras de escrita manual aprendem a reconhecer letras não pela correspondência de esqueletos de glifos, mas entendendo a intenção por trás de um padrão de traço. O contexto preenche o que o reconhecimento individual de letras não capta. Se o modelo lê "Totl" em um campo rotulado como "Valor Devido" no rodapé de uma fatura, ele resolve para "Total" — não porque reconheceu o "a" de repente, mas porque "Totl" com esse rótulo e nessa posição deve ser "Total". Essa correção contextual é o que eleva a precisão da escrita manual de 50% para a faixa de 85–93% em letra de forma e 75–85% em cursiva.
Nenhum desses mecanismos é mágica. Cada um falha em condições extremas — digitalizações severamente degradadas, escrita manual ilegível até para um humano, tabelas sem limites visíveis de coluna. Mas cada mecanismo visa um modo de falha específico para o qual o OCR tradicional não tem resposta. O efeito cumulativo em todos os tipos de campo é o que transforma um lote de documentos de "precisa de 40% de revisão manual" para "precisa de 5% de revisão manual".
A diferença fica imediatamente visível quando você experimenta. A demonstração abaixo processa uma fatura com os mesmos tipos de campo discutidos acima — datas, valores em dólar, nome do fornecedor, itens de linha, imposto — por meio de um pipeline de extração por IA. Sem modelos, sem mapeamento de coordenadas, sem pré-configuração além de digitar os nomes das colunas que você deseja.
Os arquivos são processados com segurança e não são armazenados.
Como Auditar Seu OCR: Quais Campos Custam Mais para Corrigir
Se você está executando um pipeline de processamento de documentos hoje, a coisa mais útil que pode fazer é medir o custo de correção por tipo de campo — não pela porcentagem geral de precisão. Uma taxa geral de 95% parece boa em um painel. Uma análise por campo mostra onde os 5% de erros estão concentrados e quanto esses erros realmente custam para corrigir.
Veja como executar uma auditoria de precisão em nível de campo no seu pipeline de extração atual:
Amostre 100 documentos da produção.
Não use seu conjunto de testes limpo — use o que seu pipeline realmente processa em um dia normal de trabalho. Fornecedores mistos, formatos mistos, qualquer qualidade de digitalização que sua equipe realmente envia.
Categorize cada erro de extração por tipo de campo.
Marque cada erro como Data, Valor em Dólar, Nome/Endereço, Item de Linha (tabela), Caixa de Seleção, Escrita Manual ou Conteúdo Misto. Um erro pode ter tanto um tipo de campo quanto uma causa raiz — registre ambos.
Meça o tempo de correção, não apenas a contagem de erros.
Corrigir uma linha de item de linha desalinhada pode levar de 2 a 3 minutos de referência cruzada com o documento original. Corrigir um formato de data leva 10 segundos. Conte os minutos, não os erros.
Multiplique a taxa de erro por tipo de campo pelo custo de correção por campo.
Uma taxa de erro de 5% em valores em dólar que custam $2 cada para corrigir é diferente de uma taxa de erro de 20% em nomes que custam $0,50 cada. O tipo de campo com o maior produto de taxa de erro × custo de correção é seu gargalo.
Quando as equipes realizam essa auditoria em pipelines de OCR tradicionais processando faturas de vários fornecedores, um padrão consistente emerge. Itens de linha e tabelas consomem mais tempo de correção — não porque têm a maior contagem de erros (escrita manual vence nessa categoria), mas porque cada erro de tabela exige reconstruir a relação linha-e-coluna do documento original. Uma taxa de erro de tabela de 20% em 500 faturas com 5 itens de linha cada significa 500 linhas para reconstruir manualmente. A 2 minutos por linha, são 16 horas de tempo de correção — mais de dois dias úteis completos — para um lote que o OCR deveria processar automaticamente.
Valores em dólar e datas, apesar das taxas de erro brutas mais baixas, são a segunda categoria mais cara porque as consequências de erros não detectados são altas. Um total de fatura incorreto que passa para o ERP cria uma discrepância de conciliação que custa muito mais para desembaraçar do que a correção em nível de campo teria custado para detectar. Para uma visão mais ampla de como essas falhas em nível de campo se agregam em ineficiência total do pipeline, veja nossa análise de benchmarks de precisão de OCR de IA vs OCR tradicional e nosso guia prático para definir expectativas de precisão para entrada de dados com IA.
Depois de saber quais tipos de campo estão consumindo o tempo da sua equipe, a próxima pergunta é se o mecanismo de extração consegue lidar melhor com esses tipos específicos de campo. Se o seu gargalo é a estrutura de tabelas, mudar para um mecanismo sem compreensão semântica de tabelas troca um problema pelo mesmo problema. Se o seu gargalo é escrita manual ou caixas de seleção, um mecanismo que não consegue detectá-los nunca vai melhorar. A auditoria mostra não apenas que a extração está falhando, mas onde — e o "onde" determina se uma atualização realmente resolve o gargalo ou apenas muda o logotipo no mesmo log de erros.
FAQ
O OCR tradicional funciona melhor em alguns tipos de documento do que em outros?
Sim. O OCR tradicional tem bom desempenho em documentos de texto limpos, impressos, de coluna única e com layouts consistentes — contratos, cartas, formulários padronizados de uma única fonte. A precisão cai em qualquer documento com tabelas, escrita manual, fontes mistas, baixo contraste ou variação de layout entre fontes. A diferença não é marginal: uma carta datilografada pode extrair com 98% de precisão de campo, enquanto um lote de faturas de vários fornecedores com tabelas de itens de linha extrai com 60–85%.
Posso melhorar a precisão do OCR tradicional digitalizando em resolução mais alta?
Até certo ponto. Digitalizar a 300 DPI (a recomendação padrão) melhora o reconhecimento de caracteres em comparação com 150 DPI ou fotos de smartphone tiradas à distância. Mas as melhorias de resolução afetam apenas erros no nível de caracteres — elas não fazem nada pelas falhas estruturais (tabelas, mapeamento de campos, caixas de seleção) que respondem pela maior parte do tempo de correção em pipelines de produção. Uma imagem mais nítida de uma tabela quebrada ainda é uma tabela quebrada.
Qual é o tipo de campo mais difícil para qualquer sistema de extração acertar?
Escrita manual — especificamente cursiva — continua sendo o tipo de campo mais difícil para qualquer sistema, incluindo extração baseada em IA. Modelos de IA treinados em conjuntos diversos de dados de escrita manual alcançam 85–93% em letra de forma e 75–85% em cursiva, o que é uma melhoria significativa em relação aos 30–60% do OCR tradicional, mas não chega a 99%. Para fluxos de trabalho em que campos manuscritos carregam dados críticos (valores de pagamento, nomes de pacientes, valores de verificação de conformidade), a revisão humana de extrações de baixa confiança ainda é a abordagem mais segura.
O ImageToTable.ai lida com documentos manuscritos?
O ImageToTable.ai usa um modelo de visão-linguagem que reconhece escrita manual, texto impresso, caixas de seleção, carimbos e estruturas de tabela no mesmo documento. A precisão do reconhecimento de escrita manual depende da legibilidade e do estilo de escrita — letras de forma nítidas são extraídas de forma confiável, enquanto cursivas muito estilizadas podem ainda exigir verificação manual. O modelo fornece dicas visuais mostrando quais regiões do documento ele leu, para que você possa verificar rapidamente campos manuscritos sem reler o documento inteiro. Se seus documentos são principalmente manuscritos, considere começar com um teste em lote pequeno para medir a precisão em suas amostras específicas de escrita manual antes de escalar.
Como o ImageToTable.ai lida com a extração de tabelas de forma diferente do OCR tradicional?
O OCR tradicional gera um fluxo de texto linear. As tabelas são achatadas. O ImageToTable.ai processa o documento como um layout visual, detectando regiões de tabela, segmentando linhas e colunas e associando cada valor de célula ao cabeçalho da coluna. A saída preserva a estrutura da tabela — cada linha vira uma linha na sua planilha de saída, cada coluna corresponde ao nome de coluna que você especificou. Isso funciona sem modelo, ou seja, uma fatura de 5 linhas e uma fatura de 20 linhas do mesmo fornecedor são extraídas corretamente, independentemente da altura da tabela. Para uma explicação mais detalhada de como isso difere das abordagens tradicionais, veja nossa visão geral sobre entrada de dados com IA.
A questão não é se o seu OCR tem erros. Todo sistema de extração tem. A questão é se os erros se concentram em correções de um minuto ou em campos onde cada erro se transforma em uma hora de reconciliação. Faça a auditoria no seu próximo lote — meça o tempo de correção por tipo de campo, não pela precisão geral — e você saberá em qual categoria está.