Précision OCR par champ :
95 % au global, 60 % sur les champs qui comptent
« 95 % de précision » est le chiffre que la plupart des outils OCR mettent en avant. Mais lorsque vous lancez un lot de 200 factures dans le pipeline et que vous passez encore votre mardi après-midi à corriger manuellement les champs extraits, cette promesse de 95 % commence à ressembler à une erreur d'arrondi qui joue en faveur de quelqu'un d'autre. La raison n'est pas que ce chiffre soit inventé. C'est que la précision n'est jamais uniforme selon les types de champs — et les champs que l'OCR se trompe sont de manière disproportionnée ceux dont vos systèmes en aval dépendent réellement. Cet article mesure l'écart champ par champ, explique pourquoi chaque type de champ échoue différemment, et montre ce que coûte la correction de chacun.
Points clés à retenir
- Votre OCR affiche 95 % de précision tout en chutant silencieusement à 60 % sur les trois types de champs sans lesquels votre système comptable ne peut pas fonctionner.
- Cinq types de champs différents échouent pour cinq raisons complètement différentes — et passer à une résolution de numérisation plus élevée n'en résout absolument aucun.
- Remplacez le chiffre de précision du tableau de bord par une seule métrique — le temps de correction par type de champ — et utilisez ImageToTable.ai pour traiter chaque mode de défaillance à sa racine structurelle plutôt qu'à son symptôme superficiel.
Le problème de la « précision de 95 % »
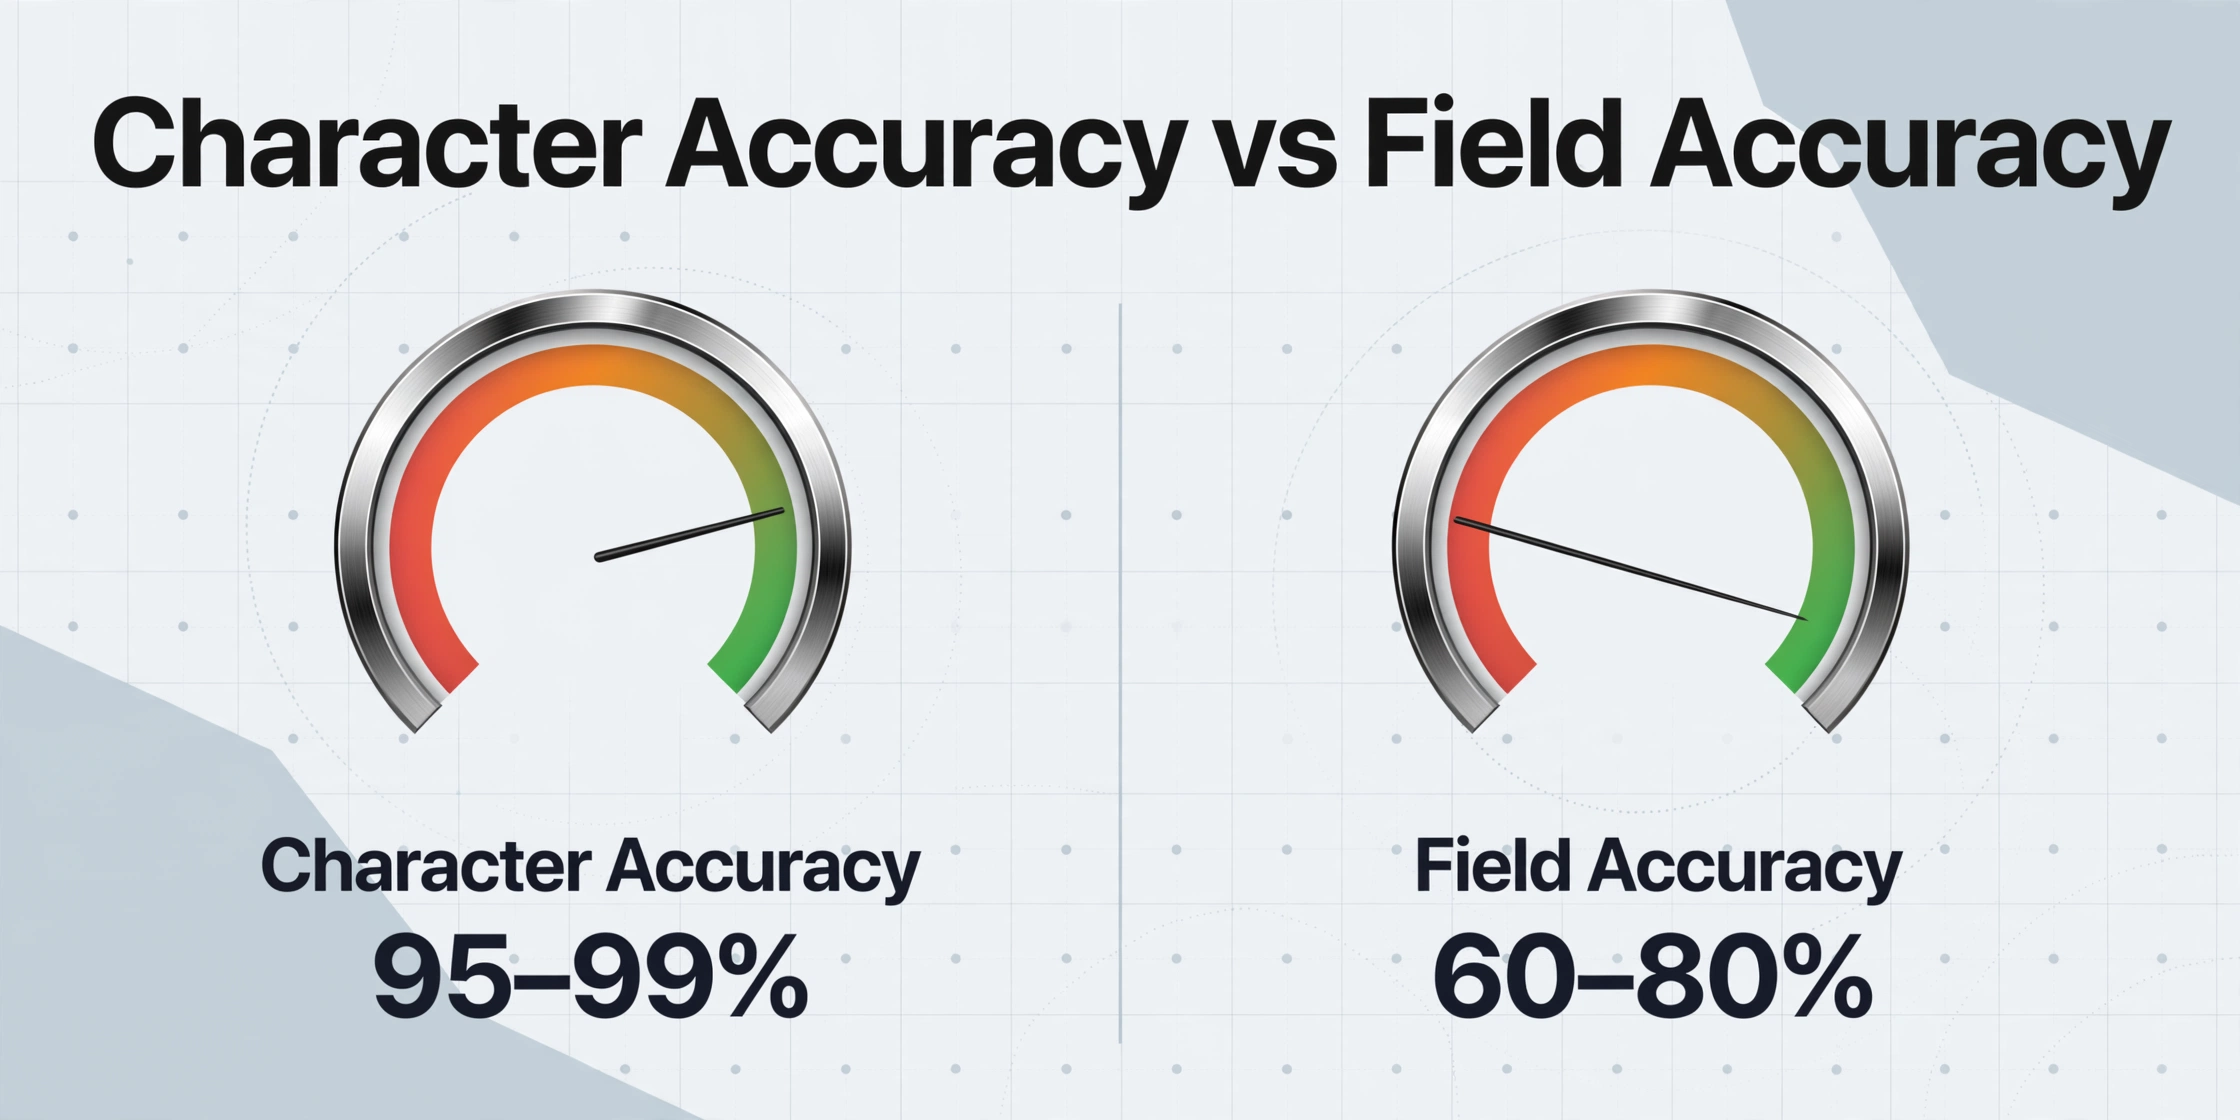
Les moteurs OCR traditionnels mesurent leur performance au niveau de la précision des caractères — le pourcentage de caractères individuels correctement reconnus à partir d'une image de document. Tesseract 5, la référence open source maintenue par Google, atteint une précision de 95 % sur les documents imprimés propres. Les moteurs d'entreprise comme ABBYY FineReader atteignent 97 à 99 % en conditions de laboratoire. Ce sont des chiffres réels mesurés sur des ensembles de test réels.
Mais la précision des caractères est un indicateur médiocre de ce dont les entreprises ont réellement besoin : des champs de données complets et corrects. Un seul chiffre mal lu dans un numéro de facture à 10 chiffres rend tout le champ erroné. Une précision de 99 % sur une page de 1 000 caractères signifie que 10 caractères sont faux — et si ces 10 caractères erronés se trouvent dans 3 de vos 15 champs cibles, la précision au niveau des champs chute à 80 %. Le TDWI a documenté ce scénario exact dans des pipelines OCR en production : le tableau de bord affiche 99 %, mais 1 champ métier extrait sur 5 contient une erreur.
Ce qui aggrave la situation, c'est que les erreurs ne se répartissent pas uniformément. L'OCR traditionnel réussit certains types de champs presque à chaque fois. D'autres échouent si gravement que l'extraction aurait tout aussi bien pu ne pas avoir lieu. Le problème est que les champs les plus susceptibles d'échouer — les montants en dollars sur les lignes d'article, les dates manuscrites, les données structurées en tableaux — sont aussi ceux où une erreur coûte le plus cher à corriger.
Dates et chiffres imprimés — ce que l'OCR réussit bien
Sur des documents propres, imprimés et à contraste élevé, l'OCR traditionnel gère bien les dates et les montants en dollars dans des positions standard. Une date de facture imprimée comme « 06/09/2026 » en Arial 11 pt sur fond blanc à 300 DPI sera reconnue par l'OCR avec une précision de caractères quasi parfaite. Un montant total imprimé comme « 1 234,56 $ » dans le coin inférieur droit, positionné de manière cohérente sur les factures d'un fournisseur, est extrait de manière fiable lorsqu'il est combiné à un modèle bien entretenu.
Ce sont les champs qui produisent les chiffres de 95 à 99 % que les fournisseurs d'OCR citent. Ils représentent le scénario idéal : polices standardisées, positions prévisibles, contraste élevé. C'est là que l'OCR traditionnel fonctionne réellement.
Les failles apparaissent dès que les formats varient. Une date écrite « 09/06/2026 » — est-ce le 9 juin (format US) ou le 6 septembre (format UK) ? L'OCR traditionnel n'a aucun mécanisme pour détecter la différence ; il lit fidèlement les chiffres, et le système en aval devine ou utilise par défaut le format américain. Un utilisateur de Reddit construisant un pipeline de factures européennes en Python a documenté exactement ce problème : les factures italiennes utilisent 31/12/2024, les factures allemandes utilisent 31.12.2024, et les factures britanniques utilisent 31/12/2024 (même syntaxe, ordre jour/mois différent). Sans normalisation tenant compte de la locale, les dates extraites de lots de factures multi-pays mélangent silencieusement les mois.
Les montants en dollars ont un mode de défaillance plus subtil. Un « 1 234,56 $ » proprement imprimé se lit bien. Mais lorsqu'un sous-total de ligne d'article de « 1 234,56 $ » se trouve une ligne au-dessus d'un total de facture de « 1 234,56 $ » — même nombre, signification différente — l'extraction basée sur un modèle risque de prendre le mauvais. Les variantes de symboles monétaires aggravent le problème : « 1.234,56 € » (virgule décimale européenne), « 1 235 ¥ » (yen japonais, sans décimale), ou des montants imprimés sans aucun symbole monétaire peuvent chacun déclencher des règles d'analyse différentes.
Noms et adresses — caractères corrects, contexte erroné
En apparence, les noms et les adresses semblent faciles pour l'OCR. Ce sont du texte, généralement imprimé dans des polices lisibles, et ils ne contiennent pas de glyphes inhabituels. Un moteur d'OCR traditionnel reconnaîtra correctement la chaîne « John Smith » avec une grande confiance et l'adresse « 123 Main Street, Springfield, IL 62701 » presque aussi bien.
L'échec n'est pas la reconnaissance des caractères. C'est l'identification du champ. L'OCR lit « John Smith » comme des caractères sur une page. Il ne sait pas si ce texte est le nom du client, le nom du fournisseur, le contact de livraison ou le responsable approbateur. Ces relations sont définies par la mise en page du document — John Smith peut être imprimé à côté de « Bill To : », « Ship To : » ou « From : » — et le pipeline de caractères ascendant de l'OCR traditionnel ne peut pas relier une étiquette à sa valeur associée lorsque les mises en page changent d'un fournisseur à l'autre.
C'est pourquoi les systèmes basés sur des modèles exigent une carte de coordonnées distincte pour chaque mise en page de fournisseur. Le modèle indique « le nom du client se trouve aux coordonnées de pixels (450, 320) ». Lorsqu'un nouveau fournisseur place le nom du client à (520, 280), le modèle capture un espace vide ou le mauvais champ. Le problème s'amplifie avec le nombre de fournisseurs : 20 fournisseurs signifient 20 modèles à créer et à maintenir. 200 fournisseurs signifient que la maintenance des modèles devient un travail à temps plein.
Le coût de cet échec est insidieux car il passe souvent inaperçu. Un champ de nom mal mappé ne génère pas d'erreur de format — « Sarah Chen » est un nom valide, qu'il se trouve dans le champ client ou le champ fournisseur. L'erreur apparaît plus tard, lorsqu'un paiement est envoyé à la mauvaise entité ou qu'un rapport regroupe des transactions sous la mauvaise contrepartie.
Lignes d'article et tableaux — là où l'OCR perd la structure
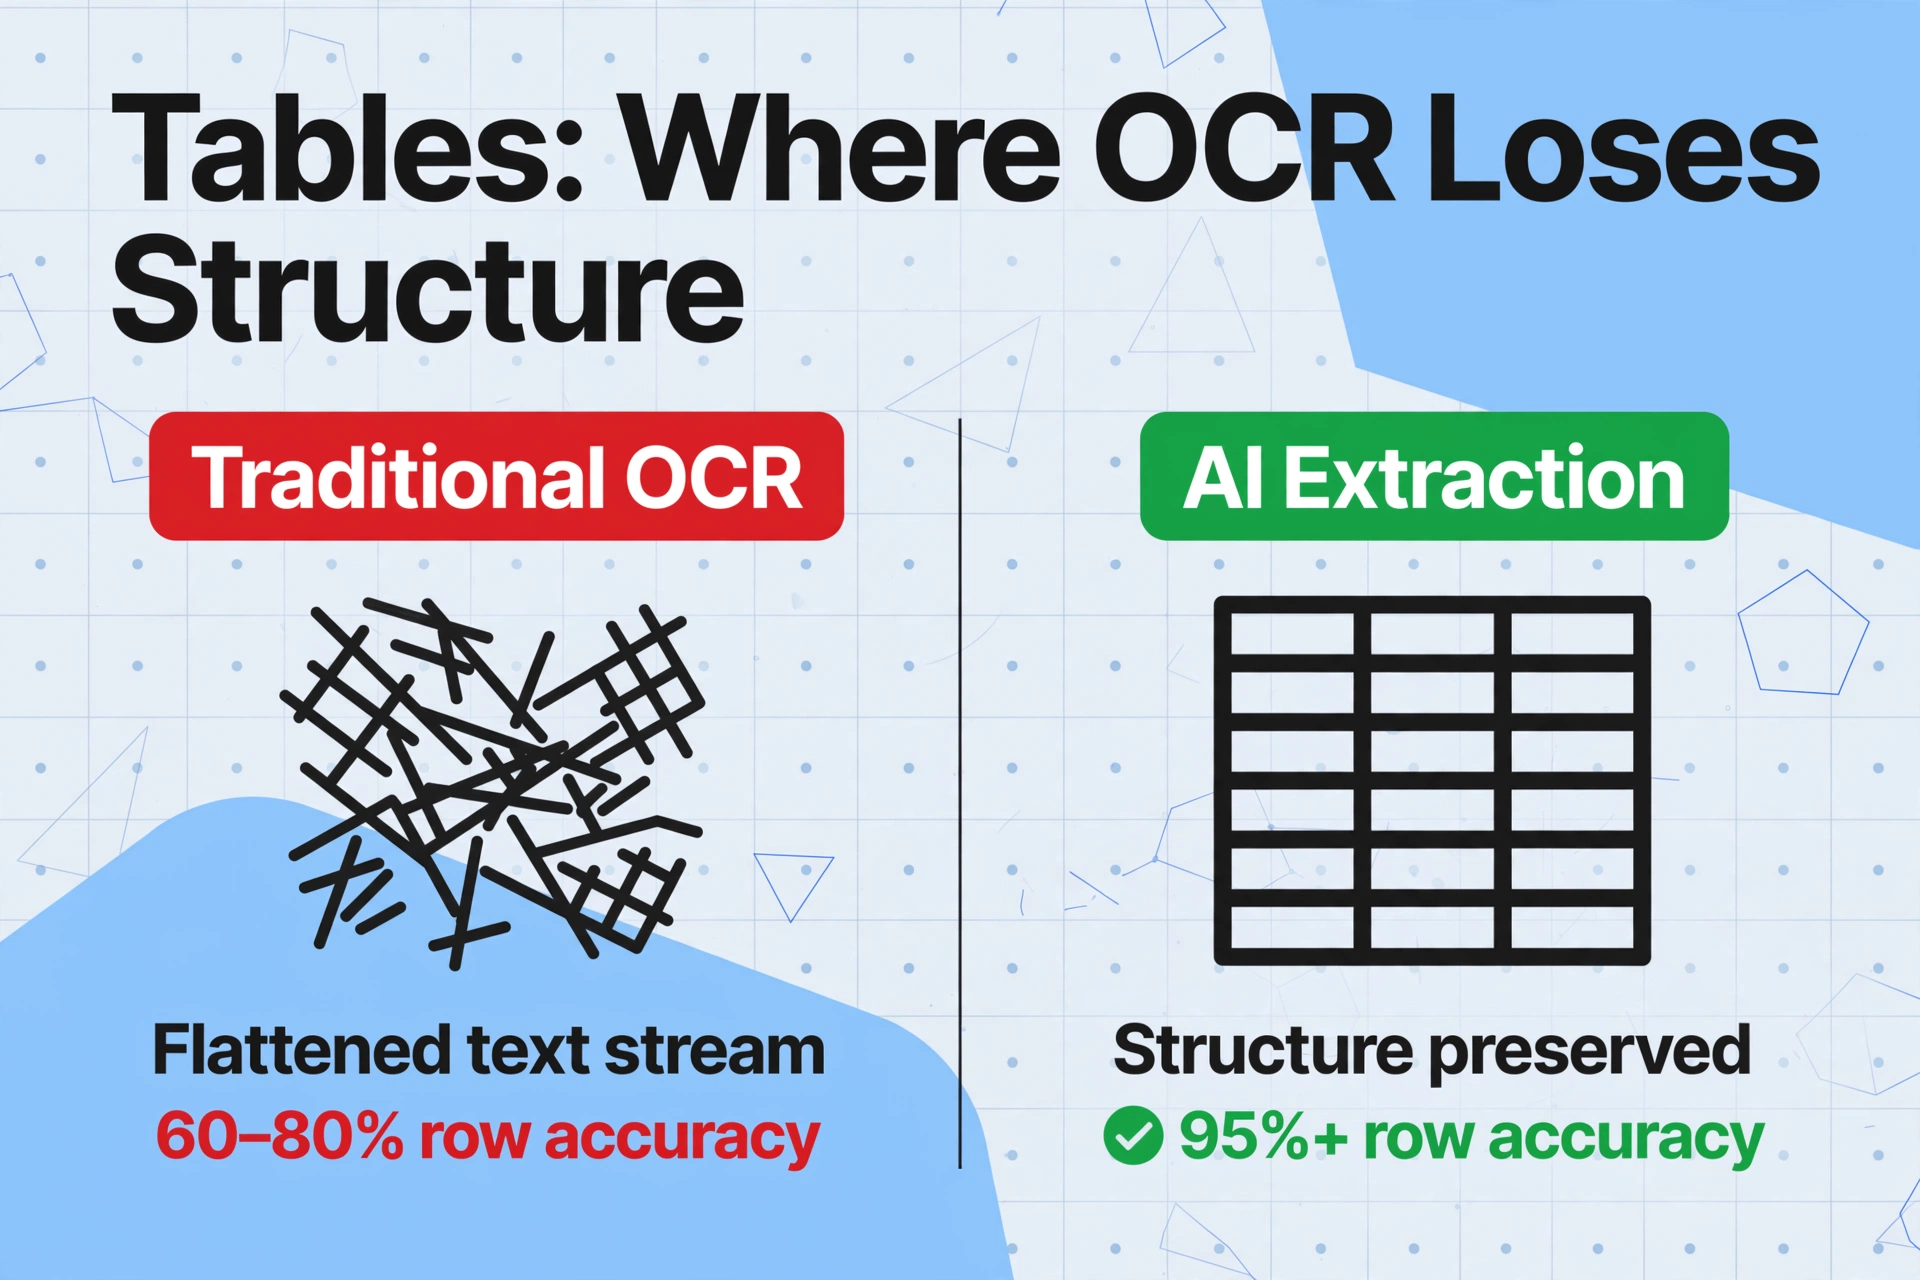
Les tableaux constituent le plus grand point de défaillance de l'OCR traditionnel, et ils apparaissent sur presque tous les documents professionnels : lignes d'article de factures, détails de bons de commande, ventilations de notes de frais, lignes de transactions de relevés bancaires. Le problème est d'ordre architectural. Les moteurs OCR produisent un flux linéaire de caractères organisé selon l'ordre de lecture — de gauche à droite, de haut en bas. Un tableau à trois colonnes et cinq lignes est aplati en une seule séquence de fragments de texte, et les limites de colonnes qui définissent quelle valeur appartient à quel en-tête disparaissent.
Les benchmarks de production quantifient les dégâts. Sur des mises en page de tableaux complexes — cellules fusionnées, en-têtes imbriqués, largeurs de colonnes incohérentes — la précision au niveau des lignes de l'OCR traditionnel chute à 60–80 %. Une valeur destinée à la colonne « quantité » se retrouve dans la colonne « prix unitaire ». Une ligne s'étendant sur deux lignes de description est scindée en deux entrées distinctes. Les décimales se déplacent d'une position lorsque l'OCR confond une ligne de séparation de colonnes avec le chiffre « 1 ».
Ce n'est pas un échec de reconnaissance de caractères. Le moteur OCR lit correctement les caractères individuels — « 5 », « pcs », « 12,50 $ » — mais le système en aval n'a aucun moyen de reconstruire quels caractères appartiennent à quelle ligne et à quelle colonne. Le résultat est un fouillis de texte entrelacé qui exige une reconstruction manuelle, ligne par ligne.
Les approches basées sur des modèles tentent de résoudre ce problème en définissant des régions de tableau : « le tableau des lignes d'article commence à Y=600 et se termine à Y=900 ». Mais la hauteur des tableaux varie selon le nombre de lignes d'article. Une commande d'une ligne et une commande de 20 lignes du même fournisseur produisent des tableaux de longueurs complètement différentes. La région fixe du modèle capture soit seulement une partie du tableau, soit, pire, intègre du texte sans rapport situé sous le tableau dans la dernière ligne. Pour un guide pratique sur l'extraction de données de tableaux vers des feuilles de calcul structurées, la variable critique est de savoir si le moteur d'extraction comprend la structure tabulaire de manière sémantique — et non pas seulement lit des caractères dans un cadre délimité.
Cases à cocher, tampons et contenu mixte — ce que l'OCR traditionnel ne peut pas voir
Il existe une catégorie d'éléments de documents sur laquelle l'OCR traditionnel n'échoue pas — il ne peut tout simplement pas les détecter du tout. Ces éléments ne produisent aucune sortie, génèrent des caractères parasites ou, pire encore, contaminent l'extraction des champs de texte adjacents.
Cases à cocher. Une case cochée (✓) et une case non cochée (☐) sont visuellement distinctes pour un lecteur humain, mais pour un moteur d'OCR traditionnel, ce sont toutes deux des zones de faible contraste proches du seuil de détection. L'OCR peut enregistrer l'une comme une tache et l'autre comme « rien », ou lire la coche comme un caractère parasite — un « V », un « 7 » ou un glyphe aléatoire. L'intention — « cette case est cochée » — n'est jamais capturée. Les formulaires qui reposent sur des champs de cases à cocher (demandes d'assurance, rapports d'inspection, listes de contrôle de conformité) exigent une vérification manuelle à 100 % de chaque case après le traitement du document par l'OCR.
Tampons et filigranes. Un tampon « PAYÉ » apposé sur le corps d'une facture, un filigrane « CONFIDENTIEL » traversant une page de contrat, ou un sceau d'entreprise rouge superposé à un bon de commande créent tous la même défaillance : deux couches d'informations visuelles occupant la même région spatiale. L'OCR traditionnel ne peut pas séparer le premier plan de l'arrière-plan ; il voit une seule région d'image bruitée et produit soit un texte illisible, soit rien. Le texte du tampon et le texte du document sous-jacent deviennent tous deux illisibles.
Contenu mixte. Le texte imprimé sur des fonds colorés, le texte blanc sur des en-têtes sombres, ou les valeurs de données dans des cellules de tableau ombrées réduisent tous le contraste en dessous du seuil requis par les moteurs d'OCR. Une barre d'en-tête bleu foncé avec du texte blanc indiquant « Facture » peut ressortir vide — l'étape de binarisation du moteur convertit toute la région en noir et perd entièrement le texte blanc. Un montant en dollars imprimé sur une bande de rangée alternée gris clair peut perdre des caractères lorsque le contraste entre le fond gris et le texte noir tombe sous la courbe de sensibilité du moteur.
Ces défaillances sont fondamentalement différentes des problèmes de tableaux ou d'écriture manuscrite. Les tableaux échouent parce que l'OCR perd la structure. Les cases à cocher et les tampons échouent parce que l'OCR ne les détecte jamais en premier lieu. La différence importe pour la remédiation : vous pouvez post-traiter un tableau cassé, mais vous ne pouvez pas post-traiter quelque chose qui n'a jamais été extrait.
Écriture manuscrite — le précipice des 30–60 %
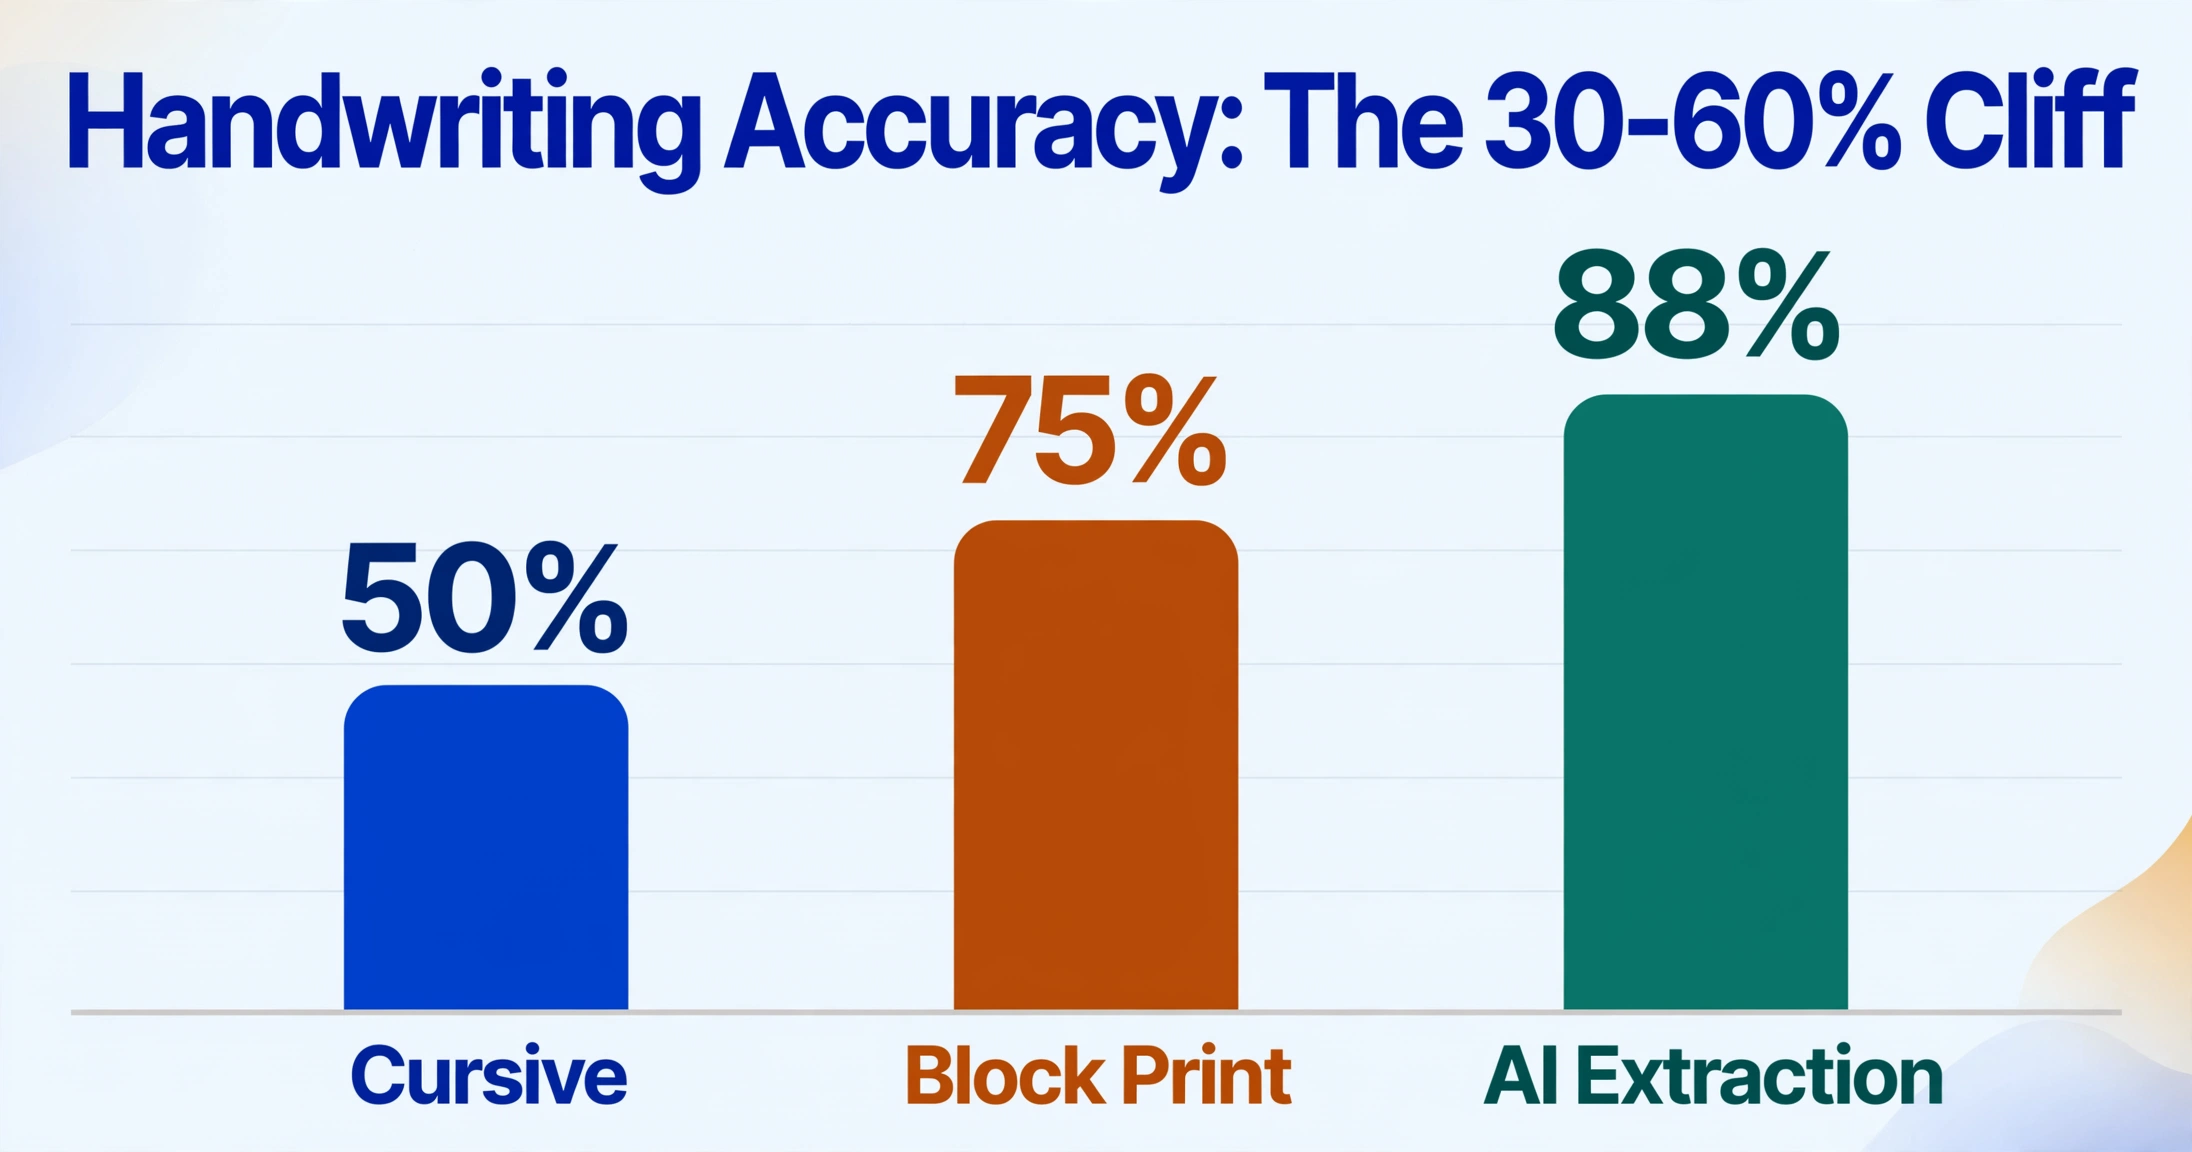
Le texte manuscrit est le problème le plus difficile en OCR, et les chiffres de précision le reflètent. Pour les moteurs OCR traditionnels, l'écriture manuscrite en lettres moulées avec des zones de caractères contraintes atteint environ 75 % de précision au niveau des caractères. L'écriture cursive tombe à 50 % ou moins. Ces données proviennent des benchmarks de production d'OCRSolutions sur des pipelines réels de traitement de formulaires — pas de conditions de laboratoire avec des échantillons d'entraînement soigneusement écrits.
La raison est mécanique. L'OCR traditionnel fonctionne en comparant des glyphes individuels à une base de données de formes de caractères connues. Un « A » imprimé ressemble toujours à un « A » imprimé — des variations mineures de police existent, mais le squelette du caractère est cohérent. Un « A » manuscrit n'a pas de squelette cohérent. L'inclinaison, l'épaisseur du trait, les connexions de ligatures, l'espacement des lettres et la dérive de la ligne de base varient d'un scripteur à l'autre — et souvent au sein même de la production d'un même scripteur sur une seule page. La comparaison de motifs avec une base de données de glyphes fixes échoue lorsqu'il n'existe aucun motif stable à comparer.
L'écriture cursive aggrave tous les problèmes. Lorsque les lettres sont connectées, le moteur ne peut pas déterminer où un caractère se termine et où le suivant commence. La séquence connectée « tion » devient un glyphe unique indifférencié qui ne correspond à rien dans la base de données de caractères. Les sorties OCR courantes pour l'écriture cursive sont des chaînes de caractères aléatoires — « totl » pour « total », « Jnury » pour « January » — où le moteur devine les formes de lettres individuelles sans les indices de segmentation visuelle qui rendent l'OCR imprimé fiable.
La conséquence pratique est que tout flux de travail documentaire comportant une composante manuscrite — un bon de livraison signé, un formulaire d'inspection rempli à la main, une feuille de temps papier avec des heures au crayon — crée une étape de saisie manuelle des données après la fin de l'OCR. L'outil censé éliminer la saisie manuelle ne peut traiter que la partie imprimée ; tout ce qu'une personne a écrit à la main doit encore être transcrit par un humain lisant l'original. Pour les flux de travail qui impliquent spécifiquement des documents manuscrits comme la conversion de formulaires manuscrits en texte numérique, le choix du moteur d'extraction détermine si l'ensemble du document est traité automatiquement ou si seuls les en-têtes imprimés survivent.
Pourquoi l'extraction par IA traite chaque type de champ différemment
L'extraction par IA ne résout pas tous ces problèmes avec un mécanisme unique et indifférencié. Chaque type de champ échoue pour une raison différente, et l'extraction par IA répond à chaque raison avec une capacité différente — tout comme un mécanicien répare une fuite de joint différemment d'un défaut électrique, même si les deux font tourner le moteur de manière défaillante.
Pour les noms et adresses (problème de contexte) : Les modèles de vision IA lisent les documents de haut en bas en comprenant ce que chaque texte signifie par rapport à la structure du document. Lorsque vous configurez l'Extraction de colonnes personnalisées dans un outil comme ImageToTable.ai — en saisissant des noms de champs comme « Nom du client », « Adresse du fournisseur », « Numéro de facture » — l'IA ne cherche pas des coordonnées de pixels. Elle scanne le document pour trouver des valeurs correspondant à la description sémantique. « John Smith » à côté de « Facturé à : » est associé au Nom du client, peu importe où il apparaît sur la page. Pas de modèles, pas de cartes de coordonnées, pas de reconstruction lorsqu'un fournisseur redessine sa facture. C'est ce mécanisme qui comble l'écart entre une précision de 60 % basée sur des modèles et une précision de 95 %+ avec l'extraction par IA sur des lots de documents multi-fournisseurs.
Pour les lignes d'article et les tableaux (problème de structure) : Les modèles de vision IA maintiennent une représentation interne de la disposition spatiale — colonnes, lignes, cellules fusionnées, en-têtes imbriqués — plutôt que d'aplatir la page en un flux de texte. Lors de l'extraction de lignes d'article d'une facture, le modèle identifie la zone du tableau, la segmente en lignes et colonnes, et associe chaque valeur de cellule à son en-tête de colonne. La sortie préserve la structure du tableau que l'OCR traditionnel rejette. Cela fait passer la précision au niveau des lignes de 60–80 % à plus de 90 % sur des mises en page complexes.
Pour les cases à cocher et le contenu mixte (problème de détection) : Les modèles de vision IA traitent le document comme une image avant de le convertir en texte. Cela signifie qu'ils peuvent « voir » une case à cocher, un tampon ou un filigrane de la même manière qu'un lecteur humain — comme un élément visuel distinct du texte environnant. Une case cochée est reconnue comme une coche, pas comme un glyphe aléatoire. Un tampon superposé sur du texte est identifié comme une couche séparée, et le modèle peut extraire le texte en dessous en raisonnant sur ce qui devrait s'y trouver.
Pour l'écriture manuscrite (échec de modèle) : Les modèles IA entraînés sur des millions d'échantillons d'écriture manuscrite apprennent à reconnaître les lettres non pas en comparant des squelettes de glyphes, mais en comprenant l'intention derrière un motif de trait. Le contexte comble ce que la reconnaissance individuelle des lettres manque. Si le modèle lit « Totl » dans un champ intitulé « Montant dû » en bas d'une facture, il résout en « Total » — non pas parce qu'il a soudainement reconnu le « a », mais parce que « Totl » avec cette étiquette et cette position doit être « Total ». Cette correction contextuelle est ce qui fait passer la précision de l'écriture manuscrite de 50 % à 85–93 % pour l'écriture en caractères d'imprimerie et de 75–85 % pour l'écriture cursive.
Aucun de ces mécanismes n'est magique. Chacun échoue dans des conditions extrêmes — scans gravement dégradés, écriture manuscrite illisible même pour un humain, tableaux sans limites de colonnes visibles. Mais chaque mécanisme cible un mode de défaillance spécifique auquel l'OCR traditionnel n'a pas de réponse. L'effet cumulatif sur tous les types de champs est ce qui fait passer un lot de documents de « nécessite 40 % de révision manuelle » à « nécessite 5 % de révision manuelle ».
La différence devient immédiatement visible lorsque vous essayez. La démo ci-dessous traite une facture avec les mêmes types de champs discutés ci-dessus — dates, montants en dollars, nom du fournisseur, lignes d'article, taxes — via un pipeline d'extraction par IA. Pas de modèles, pas de cartographie de coordonnées, pas de pré-configuration au-delà de la saisie des noms de colonnes souhaités.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Comment auditer votre OCR : quels champs coûtent le plus à corriger
Si vous exploitez aujourd'hui un pipeline de traitement de documents, la chose la plus utile à faire est de mesurer le coût de correction par type de champ — et non par taux de précision global. Un taux global de 95 % semble satisfaisant sur un tableau de bord. Une ventilation par champ vous indique où se concentrent les 5 % d'erreurs et ce que ces erreurs coûtent réellement à corriger.
Voici comment mener un audit de précision au niveau des champs sur votre pipeline d'extraction actuel :
Échantillonnez 100 documents issus de la production.
N'utilisez pas votre jeu de test propre — utilisez ce que votre pipeline traite réellement lors d'une journée de travail normale. Fournisseurs variés, formats variés, quelle que soit la qualité de numérisation soumise par votre équipe.
Catégorisez chaque erreur d'extraction par type de champ.
Étiquetez chaque erreur comme Date, Montant en dollars, Nom/Adresse, Ligne d'article, Case à cocher, Écriture manuscrite ou Contenu mixte. Une erreur peut avoir à la fois un type de champ et une cause racine — enregistrez les deux.
Mesurez le temps de correction, pas seulement le nombre d'erreurs.
Corriger une ligne d'article mal alignée dans un tableau peut prendre 2 à 3 minutes de recoupement avec le document original. Corriger un format de date prend 10 secondes. Comptez les minutes, pas les erreurs.
Multipliez le taux d'erreur par type de champ par le coût de correction par champ.
Un taux d'erreur de 5 % sur les montants en dollars qui coûtent 2 $ chacun à corriger diffère d'un taux d'erreur de 20 % sur les noms qui coûtent 0,50 $ chacun. Le type de champ présentant le produit le plus élevé de taux d'erreur × coût de correction est votre goulot d'étranglement.
Lorsque les équipes réalisent cet audit sur des pipelines OCR traditionnels traitant des factures multi-fournisseurs, un schéma cohérent se dégage. Les lignes d'article et les tableaux consomment le plus de temps de correction — non pas parce qu'ils présentent le taux d'erreur le plus élevé (l'écriture manuscrite remporte cette catégorie), mais parce que chaque erreur de tableau exige de reconstruire la relation ligne-colonne à partir du document original. Un taux d'erreur de 20 % sur les tableaux à travers 500 factures avec 5 lignes d'article chacune signifie 500 lignes à reconstruire manuellement. À 2 minutes par ligne, cela représente 16 heures de temps de correction — plus de deux journées complètes de travail — pour un lot que l'OCR était censé traiter automatiquement.
Les montants en dollars et les dates, malgré des taux d'erreur bruts plus faibles, constituent la deuxième catégorie la plus coûteuse, car les conséquences des erreurs manquées sont élevées. Un total de facture erroné qui passe dans l'ERP crée un écart de rapprochement dont le démêlage coûte bien plus cher que la correction au niveau du champ aurait coûté pour l'éviter. Pour une vue plus large de la manière dont ces défaillances au niveau des champs s'agrègent en inefficacité globale du pipeline, consultez notre analyse des benchmarks de précision de l'IA OCR par rapport à l'OCR traditionnel et notre guide pratique pour définir des attentes de précision pour la saisie de données par IA.
Une fois que vous savez quels types de champs consomment le temps de votre équipe, la question suivante est de savoir si le moteur d'extraction peut mieux gérer ces types de champs spécifiques. Si votre goulot d'étranglement est la structure des tableaux, passer à un moteur sans compréhension sémantique des tableaux remplace un problème par le même problème. Si votre goulot d'étranglement est l'écriture manuscrite ou les cases à cocher, un moteur qui ne peut pas les détecter ne s'améliorera jamais. L'audit vous indique non seulement que l'extraction échoue, mais où — et ce « où » détermine si une mise à niveau résout réellement le goulot d'étranglement ou change simplement le logo sur le même journal d'erreurs.
FAQ
L'OCR traditionnel fonctionne-t-il mieux sur certains types de documents que sur d'autres ?
Oui. L'OCR traditionnel fonctionne bien sur les documents texte imprimés, propres, à colonne unique et avec des mises en page cohérentes — contrats, lettres, formulaires standardisés provenant d'une source unique. La précision diminue sur tout document contenant des tableaux, de l'écriture manuscrite, des polices mixtes, un faible contraste ou des variations de mise en page entre les sources. L'écart n'est pas marginal : une lettre dactylographiée peut atteindre 98 % de précision sur les champs, tandis qu'un lot de factures multi-fournisseurs avec des tableaux de lignes d'article atteint 60 à 85 %.
Puis-je améliorer la précision de l'OCR traditionnel en numérisant à une résolution plus élevée ?
Jusqu'à un certain point. La numérisation à 300 DPI (la recommandation standard) améliore la reconnaissance des caractères par rapport à 150 DPI ou aux photos prises de loin avec un smartphone. Mais les améliorations de résolution n'affectent que les erreurs au niveau des caractères — elles ne corrigent rien aux défaillances structurelles (tableaux, mappage des champs, cases à cocher) qui représentent la majorité du temps de correction dans les pipelines de production. Une image plus nette d'un tableau cassé reste un tableau cassé.
Quel est le type de champ le plus difficile à traiter correctement pour tout système d'extraction ?
L'écriture manuscrite — en particulier l'écriture cursive — reste le type de champ le plus difficile pour tout système, y compris l'extraction basée sur l'IA. Les modèles d'IA entraînés sur des ensembles de données d'écriture manuscrite variés atteignent 85 à 93 % sur l'écriture en caractères d'imprimerie et 75 à 85 % sur l'écriture cursive, ce qui représente une amélioration significative par rapport aux 30 à 60 % de l'OCR traditionnel, mais pas 99 %. Pour les flux de travail où les champs manuscrits contiennent des données critiques (montants de paiement, noms de patients, valeurs de contrôle de conformité), la revue humaine des extractions à faible confiance reste l'approche la plus sûre.
ImageToTable.ai gère-t-il les documents manuscrits ?
ImageToTable.ai utilise un modèle vision-langage capable de reconnaître l'écriture manuscrite, le texte imprimé, les cases à cocher, les tampons et les structures de tableau dans un même document. La précision de la reconnaissance de l'écriture manuscrite dépend de la lisibilité et du style d'écriture — une écriture en lettres capitales bien nettes s'extrait de manière fiable, tandis qu'une cursive très stylisée peut encore nécessiter une vérification manuelle. Le modèle fournit des indices visuels montrant les régions du document qu'il a lues, afin que vous puissiez rapidement vérifier les champs manuscrits sans relire l'intégralité du document. Si vos documents sont principalement manuscrits, envisagez de commencer par un petit test par lot pour mesurer la précision sur vos échantillons d'écriture spécifiques avant de passer à l'échelle.
Comment ImageToTable.ai gère-t-il l'extraction de tableaux différemment de l'OCR traditionnel ?
L'OCR traditionnel produit un flux de texte linéaire. Les tableaux sont aplatis. ImageToTable.ai traite le document comme une mise en page visuelle, détectant les régions de tableau, segmentant les lignes et les colonnes, et associant chaque valeur de cellule à son en-tête de colonne. La sortie préserve la structure du tableau — chaque ligne devient une ligne dans votre feuille de calcul de sortie, chaque colonne correspond au nom de colonne que vous avez spécifié. Cela fonctionne sans modèle, ce qui signifie qu'une facture de 5 lignes et une facture de 20 lignes du même fournisseur s'extraient toutes deux correctement, quelle que soit la hauteur du tableau. Pour une explication plus approfondie de la différence avec les approches traditionnelles, consultez notre aperçu de la saisie de données par IA.
La question n'est pas de savoir si votre OCR comporte des erreurs. Tout système d'extraction en a. La question est de savoir si les erreurs se concentrent dans des corrections d'une minute ou dans des champs où chaque erreur entraîne une cascade de réconciliation d'une heure. Réalisez l'audit sur votre prochain lot — mesurez le temps de correction par type de champ, et non par précision globale — et vous saurez dans quelle catégorie vous vous trouvez.