Pourquoi la précision de l’OCR chute sur
les écritures manuscrites, les PDF scannés et les tableaux — et ce que vous pouvez y faire
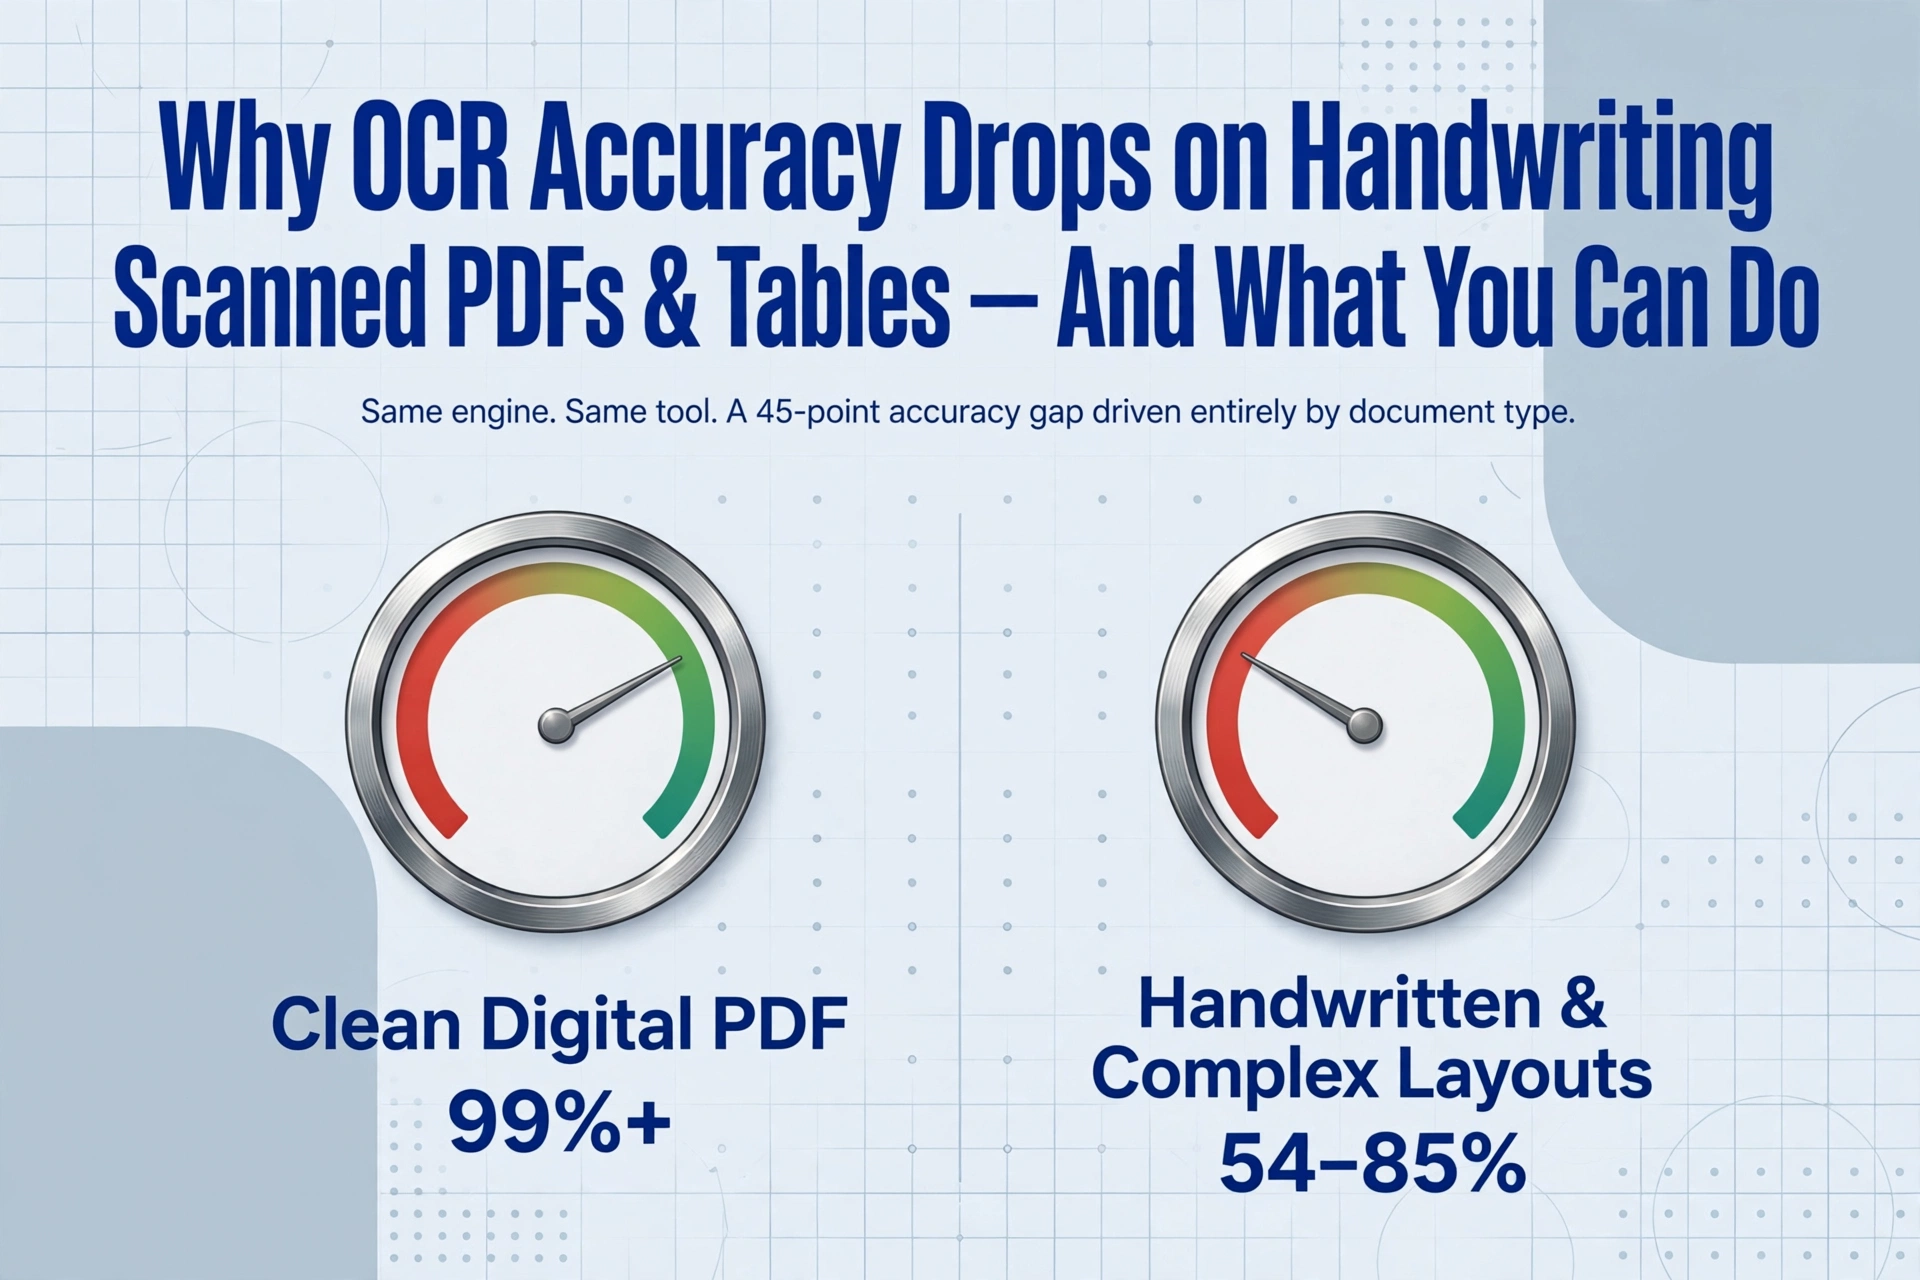
Quand un fournisseur d’OCR annonce « 99 % de précision », il parle presque toujours de la précision au niveau des caractères sur des textes anglais imprimés et propres — pas de savoir si le total du bon de livraison manuscrit de votre fournisseur sera correct. Ce chiffre est réel, mais il est assorti de conditions : il a été mesuré sur des documents choisis pour donner de bons résultats. Remplacez-les par un reçu froissé photographié sur un bureau, un contrat scanné depuis un fax ou un formulaire rempli au stylo à bille, et le même outil peut tomber à 60 %, 40 %, ou moins. La précision ne chute pas au hasard — elle chute de façon prévisible selon le type de document que vous lui soumettez. Comprendre ces schémas fait la différence entre choisir le bon outil et blâmer le mauvais.
Points clés
- Les fournisseurs d’OCR ne mentent pas sur les 99 % de précision — mais ce chiffre provient de PDF numériques propres ; avec une écriture manuscrite, une photo de téléphone ou un tableau complexe, le même moteur tombe sous les 60 %.
- La chute est prévisible, pas aléatoire — l’écriture cursive supprime les espaces entre les caractères dont dépend la segmentation, les photos de téléphone cumulent cinq distorsions simultanées, et les cellules de tableau fusionnées créent une ambiguïté structurelle qu’aucun moteur au niveau des pixels ne peut résoudre.
- Un modèle de vision-langage effectue une lecture sémantique — il déduit qu’un chiffre maculé entre « $ » et « .00 » est un 9, pas un 8 — le même mécanisme qui rend l’écriture cursive et les cellules de tableau lisibles ; testez vos trois pires documents.
L'idée fausse sur la précision de l'OCR
Chaque outil OCR sur le marché revendique une haute précision — Tesseract, Google Cloud Vision, Amazon Textract — ils publient tous des chiffres dans la plage de 95 à 99 %. Le référentiel AIMultiple OCR confirme que les principaux services OCR cloud dépassent 99,2 % sur les documents de catégorie 1 : textes dactylographiés sur fonds propres et à contraste élevé. Mais ce même référentiel révèle autre chose — sur la catégorie 3 (documents manuscrits et à mise en page complexe), la précision s'effondre entre 54 % et 85 %. Mêmes outils. Mêmes moteurs. Un écart de 45 points entièrement déterminé par le type de document traité.
La référence — PDF numériques propres
Un PDF numérique propre — une facture exportée d'un logiciel de comptabilité, un contrat enregistré depuis Word, un relevé bancaire téléchargé depuis un portail web — est l'entrée idéale pour tout système OCR. Le texte est net, les polices sont standard et le contraste est quasi parfait. Sur ces documents, les moteurs OCR modernes dépassent régulièrement 99 % de précision au niveau des caractères. Les erreurs restantes se limitent généralement à des cas particuliers : ligatures inhabituelles, très petites tailles de police (moins de 6 pt) ou caractères ornementaux dans les en-têtes. C'est ce scénario qui alimente l'affirmation de « précision de 99 % » — et c'est la référence à partir de laquelle chaque autre type de document représente une dégradation mesurable.
PDF numérisés — là où commence la dégradation de la qualité
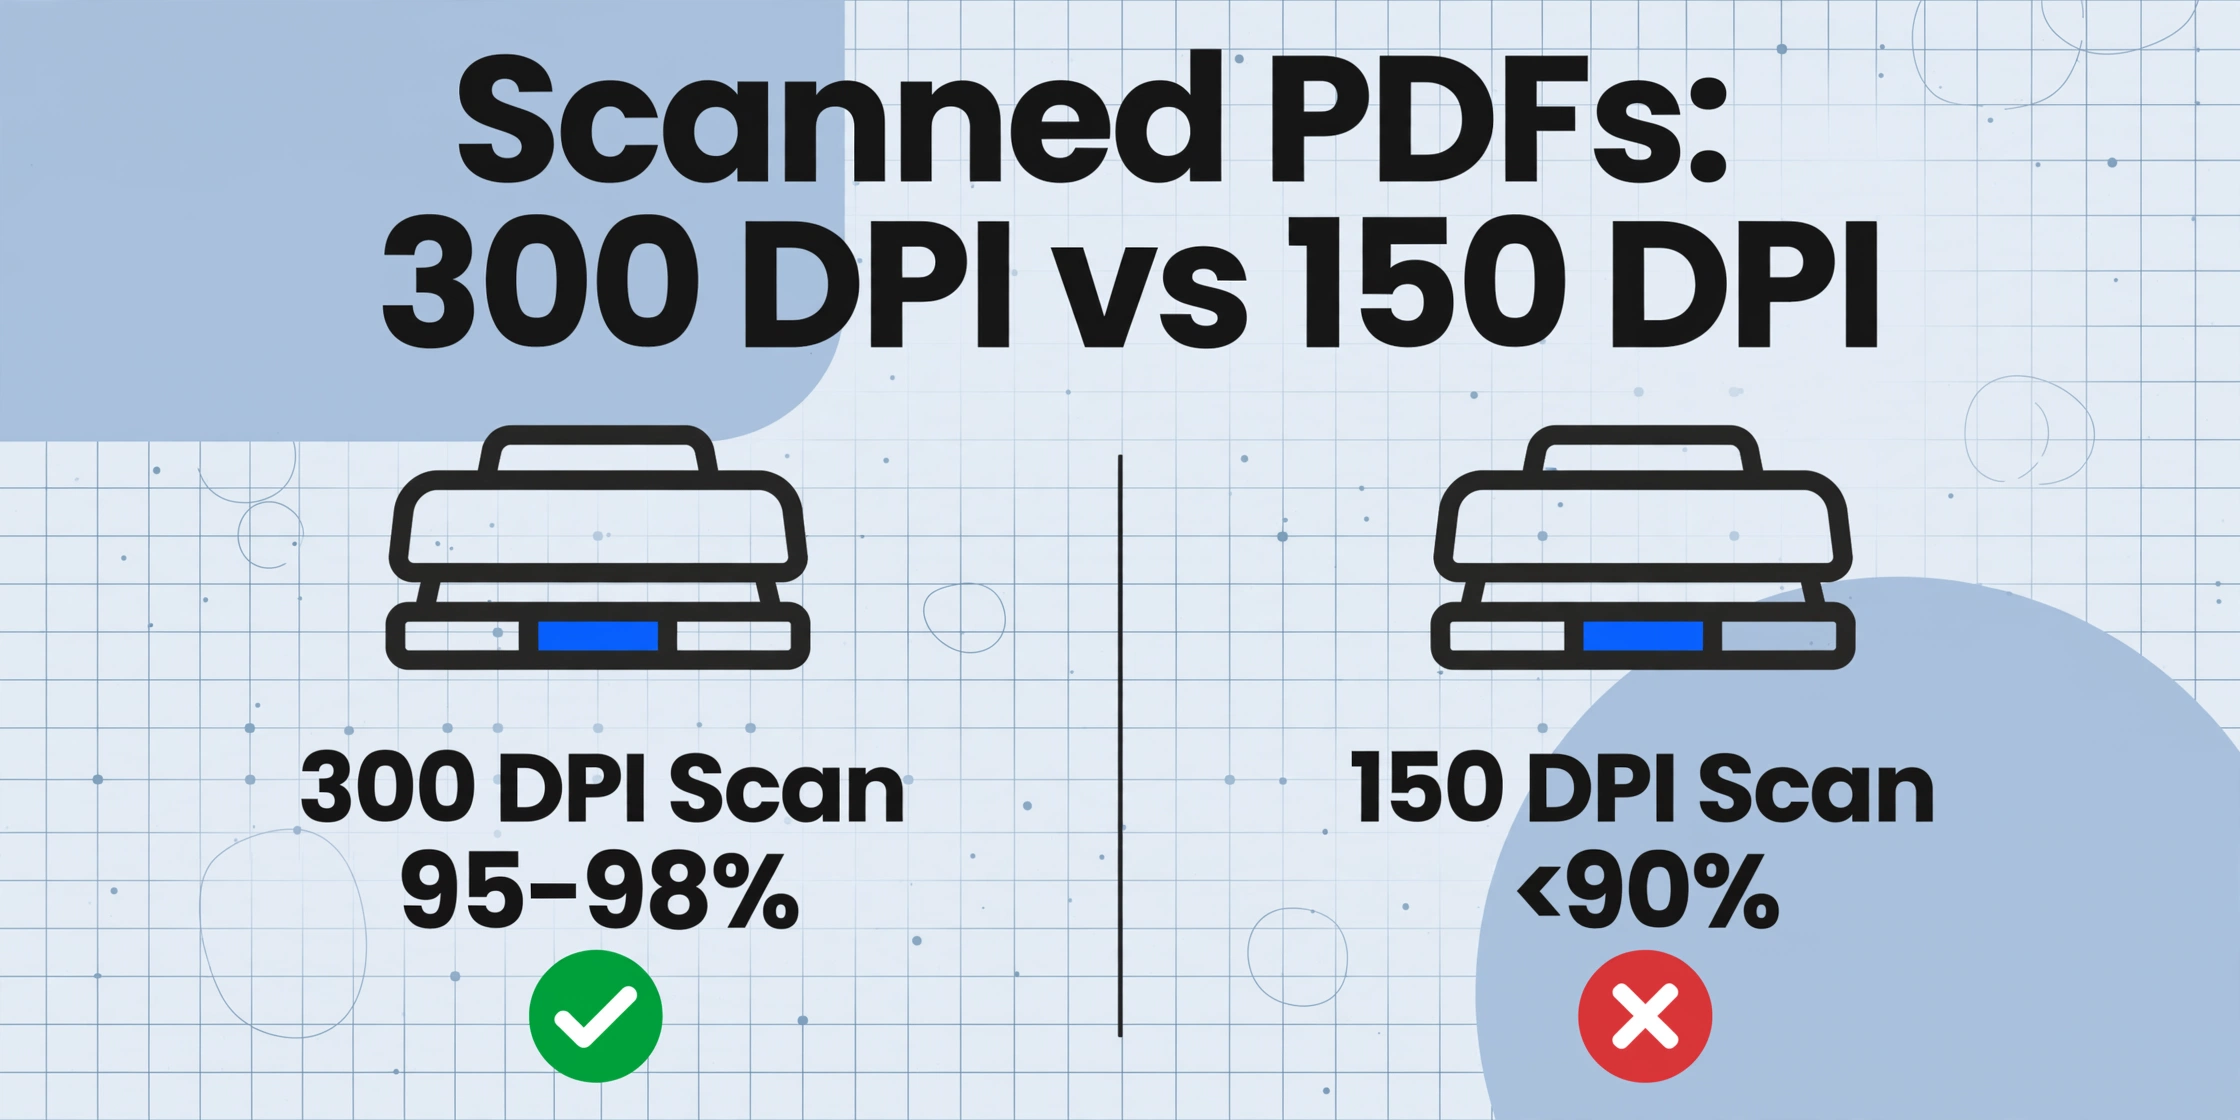
Un PDF numérisé est une photographie d'une page imprimée, et cette image introduit plusieurs sources d'erreur qu'un PDF numérique n'a pas. La perte de résolution est la première : une numérisation à 200 DPI donne au moteur environ 8 pixels de hauteur pour un caractère de 10 points. Descendez à 150 DPI — courant en numérisation par lots — et le même caractère ne fait plus que 6 pixels de haut. Le moteur doit deviner les traits à partir d'une poignée de pixels.
Le bruit et les artefacts ajoutent une autre couche. Les capteurs de scanner introduisent du grain ; la texture du papier (papier journal, papier thermique, papier recyclé) ajoute des motifs que le moteur peut interpréter à tort comme faisant partie d'un caractère. L'inclinaison — même de 2 à 3 degrés par rapport à l'axe — oblige le moteur à corriger la rotation avant de segmenter les caractères, augmentant mesurablement le taux d'erreur. Et le contenu superposé — tampons, signatures, filigranes sur du texte imprimé — crée une ambiguïté qu'aucun OCR au niveau des pixels ne peut résoudre : un tampon « PAYÉ » sur un total de facture rend les deux illisibles.
Une bonne numérisation à 300 DPI d'un texte imprimé propre atteint encore 95 à 98 % de précision au niveau des caractères. Une numérisation de mauvaise qualité à 150 DPI du même document peut tomber sous 90 %.
Écriture manuscrite — le problème fondamental des limites
Le texte manuscrit n'est pas une version plus difficile du texte imprimé. C'est un problème de reconnaissance fondamentalement différent. Les caractères imprimés ont des limites claires et cohérentes — des espaces entre les lettres, des lignes de base uniformes, des formes prévisibles. Un moteur d'OCR segmente un mot imprimé en caractères individuels en utilisant ces espaces, puis compare chaque forme à une bibliothèque. Cela fonctionne parce que l'indice de segmentation (l'espace) est fiable.
L'écriture cursive supprime entièrement ces limites. Les lettres se connectent. La fin d'un caractère est le début du suivant. Un « n » minuscule suivi d'un « i » peut ressembler à un « u ». Un « r » suivi d'un « n » peut ressembler à un « m ». Le moteur ne peut pas segmenter le mot parce que les espaces ont été délibérément éliminés par une écriture rapide.
Les chiffres de l'industrie le confirment. Les benchmarks d'AIMultiple montrent que les services d'OCR cloud traditionnels dépassant 99 % sur le texte imprimé tombent dans la plage de 60 à 85 % sur l'écriture manuscrite. Sur une cursive brouillonne ou des documents mixtes imprimés et manuscrits, l'écart peut atteindre 40 points de pourcentage ou plus. L'écriture manuscrite de style imprimé — les majuscules en bloc — s'en sort mieux car elle préserve les limites, mais introduit son propre problème : une variabilité infinie des formes. Personne ne forme un « G » de la même manière, et toute bibliothèque de correspondance de formes a des angles morts. Pour les outils conçus pour gérer cela, consultez notre comparaison des OCR pour l'écriture manuscrite.
Photos de téléphone — plusieurs facteurs de dégradation combinés
Si les documents numérisés dégradent la précision par deux ou trois facteurs, les photos de téléphone en combinent cinq ou six simultanément. La distorsion de perspective est la plus destructrice : à moins que le téléphone ne soit tenu parfaitement parallèle au document — ce qui n'arrive presque jamais — la page est photographiée en angle, créant un trapèze où la taille des caractères et l'espacement des lignes varient de manière incohérente dans l'image.
Les variations d'éclairage aggravent le problème : une zone lumineuse au centre, des ombres sur les bords, une ombre sur une rangée de chiffres qui fait paraître les caractères fusionnés. Le flou de mouvement d'un léger tremblement de la main brouille les bords des caractères de 1 à 2 pixels. Les reflets et l'éblouissement du papier brillant peuvent effacer entièrement des sections entières de texte.
L'effet cumulatif est dramatique. Un outil qui obtient 99 % sur un PDF numérique peut tomber sous les 70 % sur une photo de téléphone du même document. L'information est toute présente sur la page physique, mais l'image l'a dégradée au-delà d'une reconnaissance fiable.
Tableaux complexes et cellules fusionnées — quand la structure s'effondre
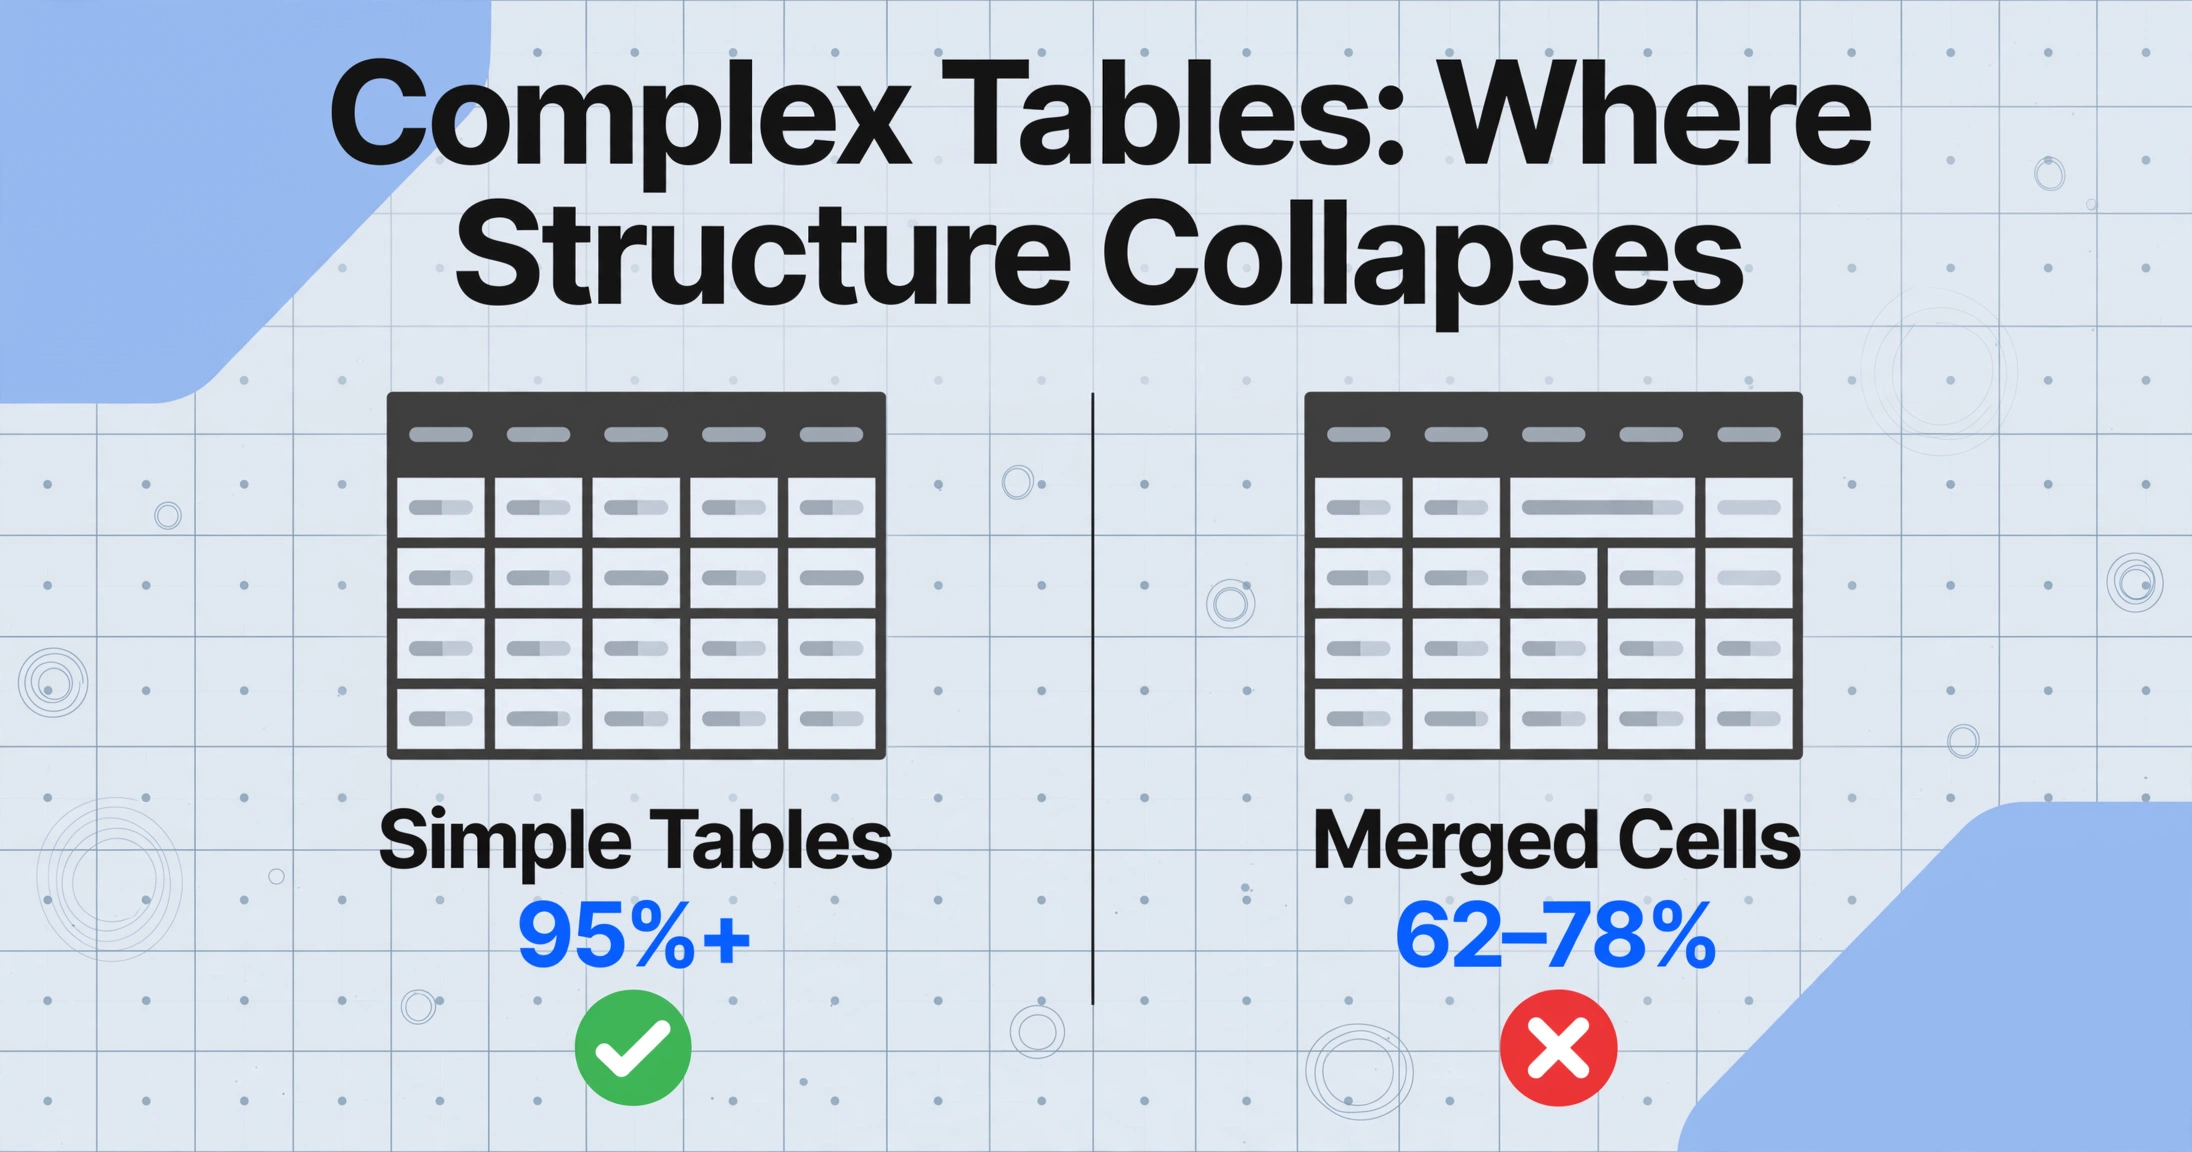
Les tableaux posent un type de défi différent. Il ne s'agit pas de lire des caractères — l'OCR moderne peut lire les chiffres dans les cellules assez bien. Le problème est structurel : le moteur doit déterminer à quelle cellule appartient chaque valeur, ce qui nécessite de comprendre la grille du tableau, pas seulement ses caractères. Les cellules fusionnées sont le casseur le plus courant. Un en-tête s'étendant sur trois colonnes, une cellule « Notes » s'étendant sur deux lignes, une étiquette de sous-total fusionnée sur la première colonne — ces motifs brisent l'hypothèse ligne par ligne que la plupart des moteurs OCR utilisent pour reconstruire les tableaux.
La recherche académique confirme que c'est un problème ouvert. Une étude arXiv de 2024 a constaté que même les modèles spécialisés d'extraction de tableaux n'atteignent que 62-78 % de précision sur les tableaux complexes avec cellules fusionnées et structures irrégulières — un écart de plus de 20 points en dessous de la reconnaissance de tableaux simples. Les tableaux imbriqués et les tableaux multipages où les en-têtes changent de position font grimper les taux d'échec encore plus haut. L'extraction basée sur VLM lit les tableaux sémantiquement — elle peut reconnaître que « Description de l'article » régit la colonne en dessous, quel que soit le nombre de cellules couvertes par cet en-tête. Pour en savoir plus sur la différence entre la précision au niveau des champs et les métriques de caractères, consultez notre guide sur ce que signifie réellement la précision OCR.
Ce que vous pouvez réellement contrôler
Plusieurs facteurs de précision sont sous votre contrôle, et y remédier peut souvent apporter des gains plus importants que de changer de moteur :
Préparation des documents. Numérisez à 300 DPI minimum — la résolution OCR universellement recommandée. Utilisez de l'encre noire sur papier blanc pour un contraste maximal. Aplatissez les documents pliés ou froissés avant la numérisation ; un pli traversant une ligne de texte équivaut à des données manquantes.
Choix de l'outil. Le facteur différenciant clé est de savoir si un outil utilise l'OCR par correspondance de motifs (Tesseract, ABBYY classique, la plupart des API cloud) ou l'extraction par modèle de langage visuel (ImageToTable.ai et les services récents basés sur les LLM). Les outils basés sur VLM lisent les documents de manière sémantique — ils peuvent utiliser le contexte environnant pour résoudre les caractères ambigus. Un chiffre taché entre un signe dollar et « .00 » est presque certainement un 9, pas un 8 — un VLM peut faire cette inférence ; un moteur OCR basé sur les pixels ne le peut pas.
Validation en post-traitement. Intégrez des attentes de format dans votre flux de travail : un numéro de facture suit un modèle, une date suit un calendrier, un total est un nombre positif. Lorsque les données extraites violent un modèle, signalez-les pour examen — non pas parce que l'outil est mauvais, mais parce que certains types de documents produisent toujours des résultats incertains. Des règles comme « Le total doit être égal à la somme des lignes ± 0,01 » permettent de détecter les erreurs les plus importantes sans examiner chaque champ.
Comment interpréter les affirmations de précision des fournisseurs
Chaque fournisseur d'OCR publie des chiffres. Voici comment les lire :
Demandez quel type de document a été testé. Si le fournisseur ne le précise pas, supposez le type le plus facile disponible. Demandez quelle métrique a été utilisée. La précision au niveau des caractères (CER) est la plus indulgente. La précision au niveau des champs — c'est-à-dire si chaque donnée extraite est entièrement correcte — détermine si votre flux de travail fonctionne. Un outil avec 99 % de CER peut avoir 80 % de précision au niveau des champs sur le même document, comme expliqué dans notre guide des métriques de précision OCR. Renseignez-vous sur la distribution des erreurs. Si les erreurs se concentrent sur les nombres, les codes et les identifiants — ce qui est souvent le cas, car ce sont les caractères qui se ressemblent le plus pour les moteurs OCR — le même taux d'erreur peut être catastrophique. Testez sur vos propres documents. Trois de vos documents les plus difficiles, cinq minutes de test, vous en apprendront plus que n'importe quel benchmark publié.
FAQ
Pourquoi la précision de l'OCR chute-t-elle autant sur l'écriture manuscrite ?
L'OCR traditionnel fonctionne en segmentant le texte en caractères individuels. L'écriture cursive supprime les espaces dont dépend la segmentation — les lettres se connectent, donc le moteur ne peut pas déterminer où un caractère se termine et où le suivant commence. C'est un problème structurel, pas un problème de qualité. Même des scans de cursive en résolution parfaite produisent une précision inférieure à celle de scans médiocres de texte imprimé.
Quelle est la meilleure résolution pour numériser des documents pour l'OCR ?
300 DPI est la norme de l'industrie. En dessous de 200 DPI, la précision diminue sensiblement car les bords des caractères deviennent trop grossiers pour une segmentation fiable. Au-dessus de 600 DPI, la taille des fichiers augmente sans gain supplémentaire de précision.
Les outils OCR basés sur l'IA peuvent-ils gérer des types de documents que l'OCR traditionnel ne peut pas ?
Les outils basés sur des modèles de langage visuel (VLM) gèrent une gamme plus large de types de documents car ils lisent sémantiquement plutôt que pixel par pixel. Ils utilisent le contexte pour résoudre les caractères ambigus et maintiennent une conscience structurelle des tableaux et des cellules fusionnées. Cependant, aucun outil n'atteint une précision égale sur tous les types, et des entrées de très mauvaise qualité dégradent tout système.
Le format du document (PDF vs JPG vs PNG) affecte-t-il la précision de l'OCR ?
Le format importe moins que son contenu. Un PDF numérique avec texte intégré n'a pas besoin d'OCR — le texte est déjà lisible par machine. Un PDF scanné et un JPG du même document produisent une précision équivalente à résolution et compression égales.
Pourquoi mon outil OCR fonctionne-t-il bien sur les factures mais échoue sur les bons de livraison ?
C'est un problème de structure. Les factures suivent des mises en page clé-valeur prévisibles. Les bons de livraison utilisent souvent des tableaux complexes avec des cellules fusionnées, des hauteurs de lignes irrégulières et des cellules multilignes — des motifs structurels que l'OCR traditionnel gère mal. Le moteur n'a pas changé ; le document a franchi un seuil structurel que l'outil ne peut pas analyser.
Le prétraitement peut-il améliorer la précision de l'OCR sur les types de documents difficiles ?
Un prétraitement de base — redressement, conversion en niveaux de gris, seuillage adaptatif — peut améliorer la précision de 5 à 15 % sur les documents scannés et les photos de téléphone. Mais cela ne comblera pas l'écart sur l'écriture manuscrite ou les tableaux complexes, car ce sont des problèmes de reconnaissance structurelle, pas des problèmes de qualité d'image.