Por qué la precisión del OCR cae en
escritura a mano, PDFs escaneados y tablas — y qué puede hacer al respecto
Cuando un proveedor de OCR dice "99% de precisión", casi siempre se refiere a la precisión a nivel de caracteres en texto inglés limpio e impreso — no a si el total de la nota de entrega manuscrita de su proveedor saldrá correcto. Ese número es real, pero viene con letra pequeña: se midió en documentos seleccionados para producir buenos resultados. Cambie a un recibo arrugado fotografiado sobre un escritorio, un contrato escaneado de una máquina de fax, o un formulario rellenado con bolígrafo, y esa misma herramienta puede ofrecer un 60%, un 40% o menos. La precisión no cae al azar — cae de formas predecibles según el tipo de documento que le introduzca. Entender esos patrones es la diferencia entre elegir la herramienta correcta y culpar a la equivocada.
Conclusiones Clave
- Los proveedores de OCR no mienten sobre la precisión del 99% — pero el número proviene de PDFs digitales limpios; cambie a escritura a mano, una foto de teléfono o una tabla compleja, y el mismo motor cae por debajo del 60%.
- La caída es predecible, no aleatoria — la escritura cursiva elimina los espacios entre caracteres de los que depende la segmentación, las fotos de teléfono combinan cinco distorsiones simultáneas, y las celdas de tabla fusionadas crean una ambigüedad estructural que ningún motor a nivel de píxeles puede resolver.
- Un modelo de lenguaje visual lee semánticamente — infiere que un dígito borroso entre "$" y ".00" es un 9, no un 8 — el mismo mecanismo que hace legibles la cursiva y las celdas de tabla; pruebe sus propios tres peores documentos.
El Concepto Erróneo Sobre la Precisión del OCR
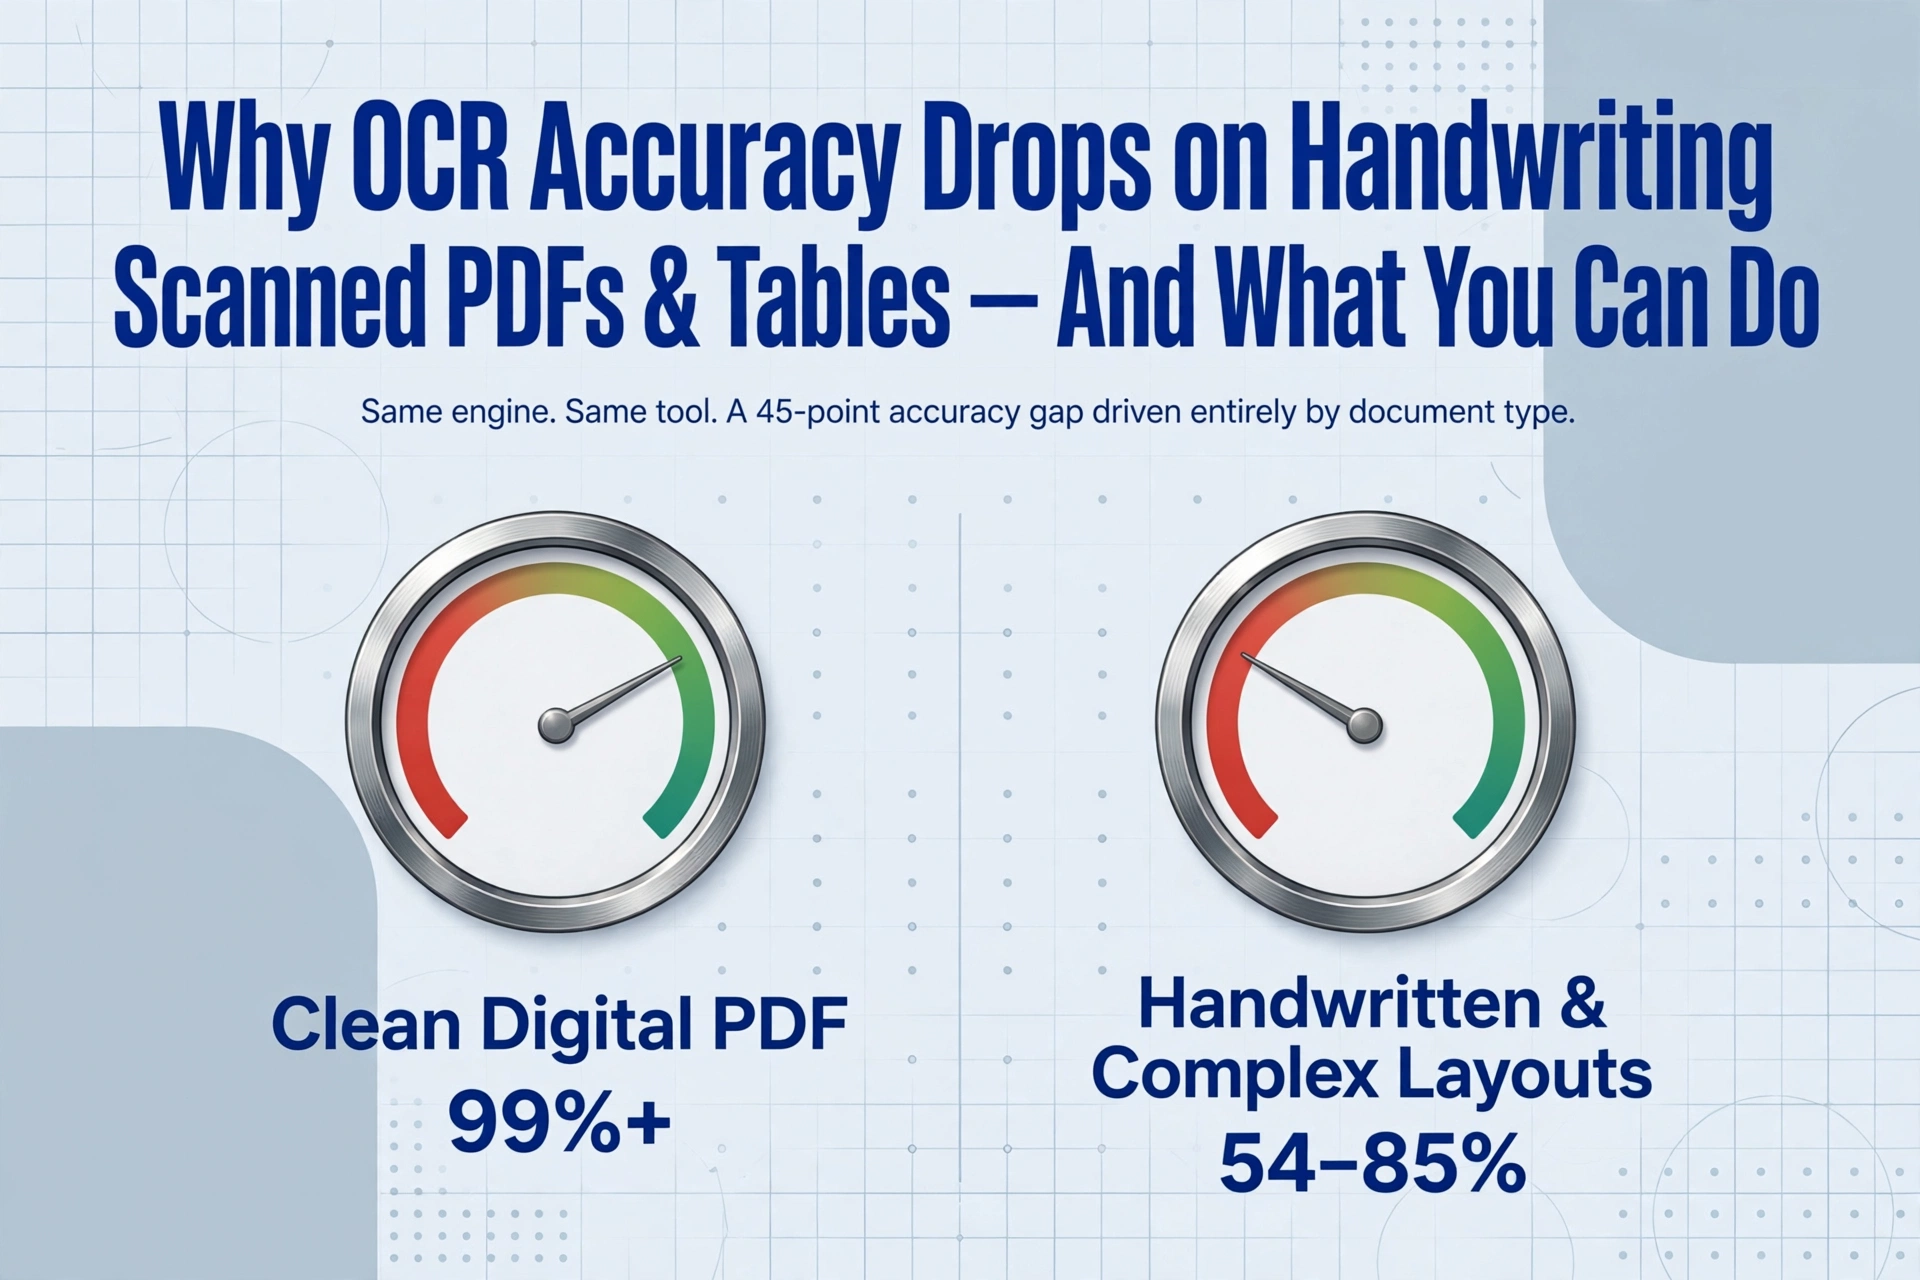
Toda herramienta de OCR en el mercado afirma tener alta precisión — Tesseract, Google Cloud Vision, Amazon Textract — todas publican cifras en el rango del 95-99%. El AIMultiple OCR Benchmark confirma que los principales servicios de OCR en la nube superan el 99.2% en documentos de Categoría 1: textos mecanografiados sobre fondos limpios y de alto contraste. Pero ese mismo benchmark revela algo más — en la Categoría 3 (documentos manuscritos y de diseño complejo), la precisión cae a entre 54% y 85%. Las mismas herramientas. Los mismos motores. Una brecha de 45 puntos impulsada enteramente por qué tipo de documento se procesa.
La Base — PDFs Digitales Limpios
Un PDF digital limpio — una factura exportada desde un software de contabilidad, un contrato guardado desde Word, un extracto bancario descargado de un portal web — es la entrada ideal para cualquier sistema de OCR. El texto es nítido, las fuentes son estándar y el contraste es casi perfecto. En estos documentos, los motores de OCR modernos superan rutinariamente el 99% de precisión de caracteres. Los errores restantes suelen limitarse a casos extremos: ligaduras inusuales, tamaños de fuente muy pequeños (menos de 6pt) o caracteres ornamentales en encabezados. Este es el escenario que respalda la afirmación del "99% de precisión" — y es la base desde la cual cada otro tipo de documento representa una degradación medible.
PDFs Escaneados — Donde Comienza la Degradación de Calidad
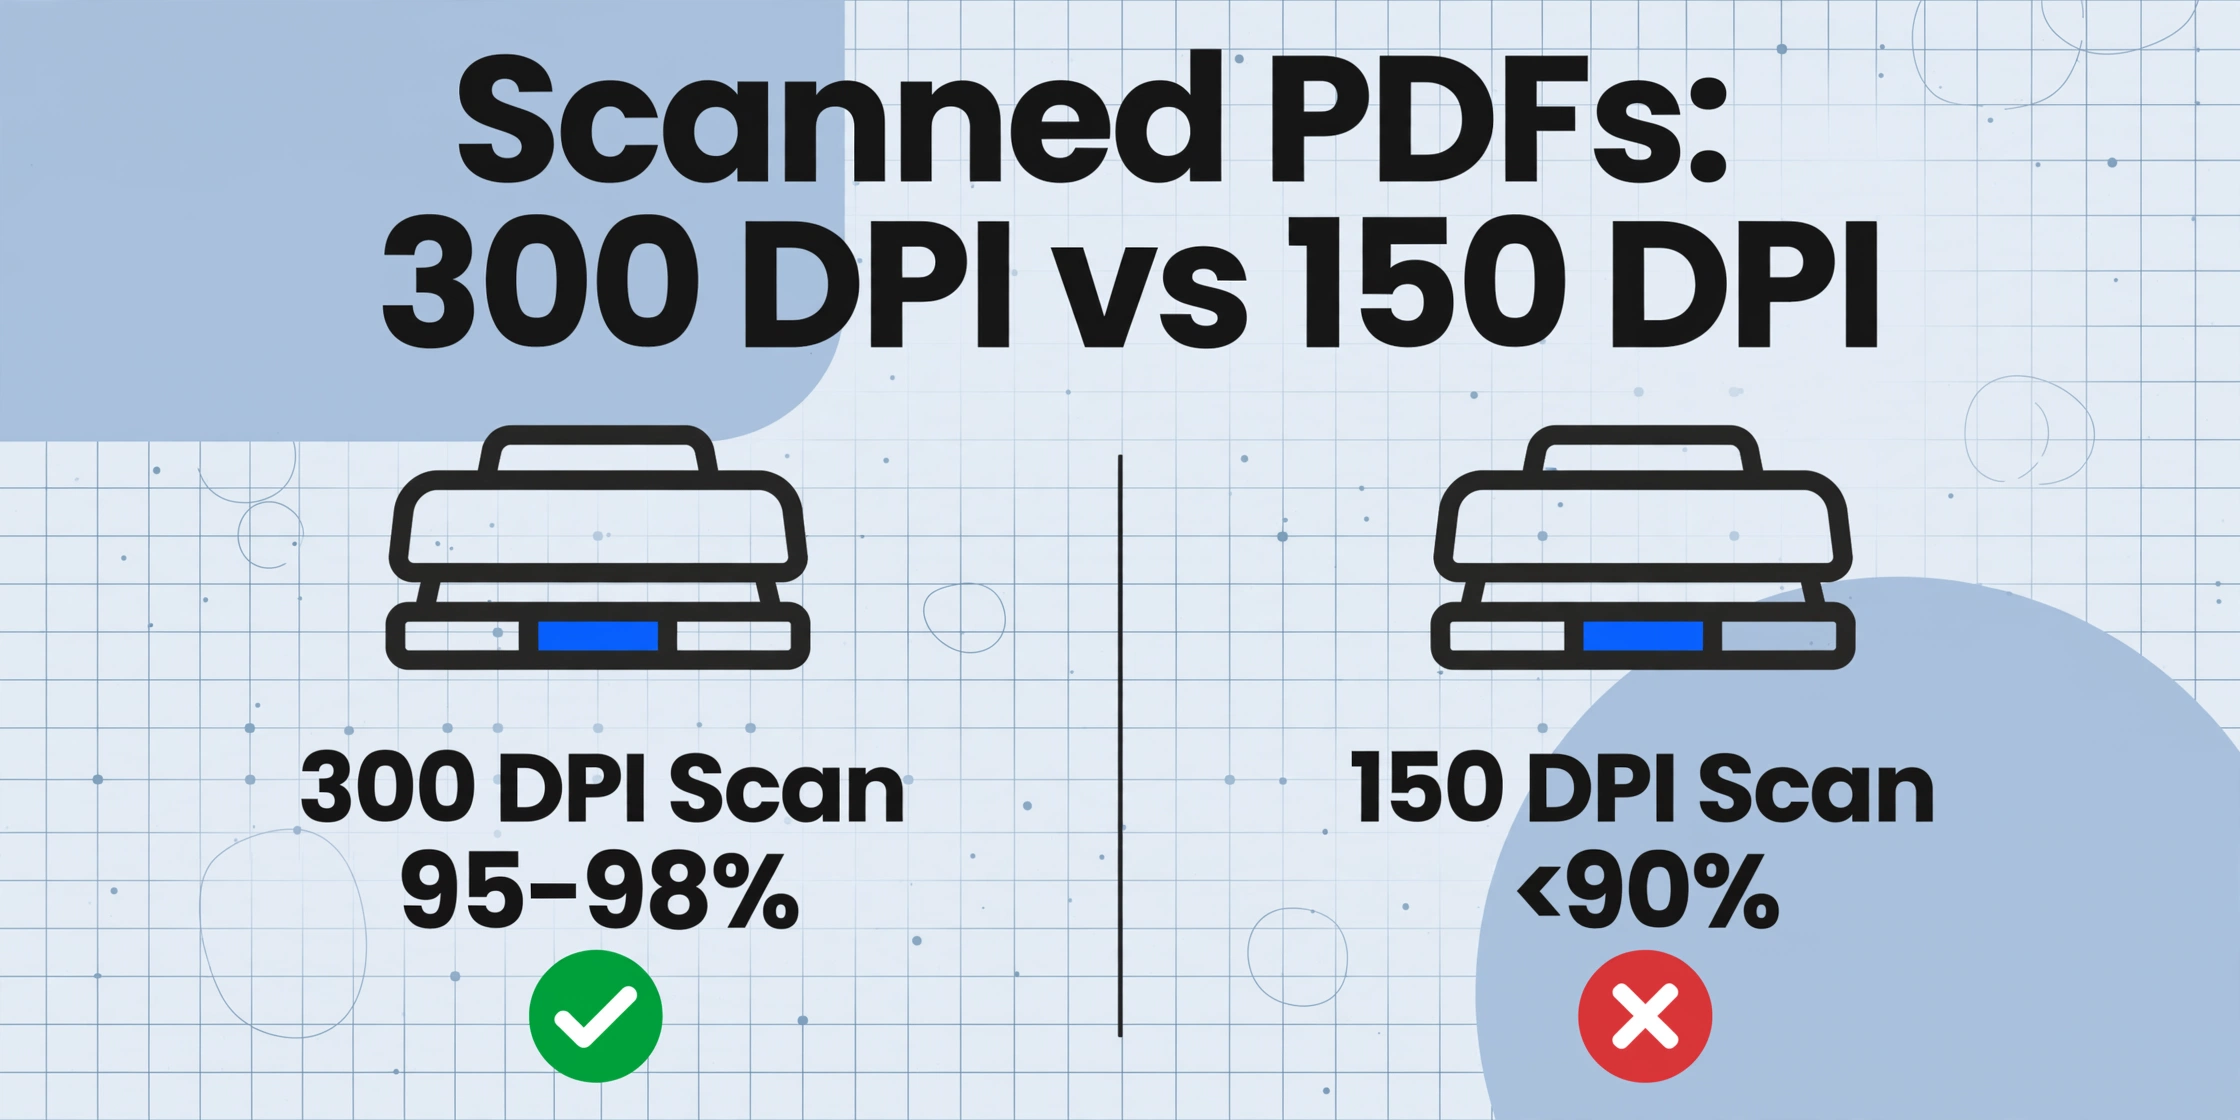
Un PDF escaneado es una fotografía de una página impresa, y esa imagen introduce varias fuentes de error que un PDF digital no tiene. La pérdida de resolución es la primera: un escaneo a 200 DPI le da al motor aproximadamente 8 píxeles de altura para un carácter de 10 puntos. Baje a 150 DPI — común en escaneo por lotes — y el mismo carácter tiene solo 6 píxeles de altura. El motor tiene que adivinar trazos a partir de un puñado de píxeles.
El ruido y los artefactos añaden otra capa. Los sensores del escáner introducen grano; la textura del papel (papel periódico, papel térmico, papel reciclado) añade patrones que el motor puede malinterpretar como parte de un carácter. La inclinación — incluso 2-3 grados fuera de lo recto — obliga al motor a corregir la rotación antes de segmentar caracteres, aumentando mediblemente la tasa de error. Y el contenido superpuesto — sellos, firmas, marcas de agua sobre texto impreso — crea ambigüedad que ningún OCR a nivel de píxeles puede resolver: un sello de "PAGADO" sobre el total de una factura deja ambos ilegibles.
Un buen escaneo de 300 DPI de texto impreso limpio aún logra una precisión de caracteres del 95-98%. Un escaneo de baja calidad de 150 DPI del mismo documento puede caer por debajo del 90%.
Escritura a mano: el problema fundamental de los límites
El texto manuscrito no es una versión más difícil del texto impreso. Es un problema de reconocimiento fundamentalmente diferente. Los caracteres impresos tienen límites claros y consistentes: espacios entre letras, líneas base uniformes, formas predecibles. Un motor de OCR segmenta una palabra impresa en caracteres individuales usando esos espacios y luego compara cada forma con una biblioteca. Esto funciona porque la señal de segmentación (el espacio) es confiable.
La escritura cursiva elimina esos límites por completo. Las letras se conectan. El final de un carácter es el comienzo del siguiente. Una "n" minúscula seguida de una "i" puede parecerse a una "u". Una "r" seguida de una "n" puede parecer una "m". El motor no puede segmentar la palabra porque los espacios han sido eliminados deliberadamente al escribir rápido.
Las cifras de la industria lo confirman. Los puntos de referencia de AIMultiple muestran que los servicios de OCR en la nube tradicionales que superan el 99% en texto impreso caen al rango del 60-85% en escritura a mano. En cursiva desordenada o documentos mixtos impresos y manuscritos, la brecha puede alcanzar 40 puntos porcentuales o más. La escritura a mano estilo imprenta — mayúsculas de bloque — funciona mejor porque preserva los límites, pero introduce su propio problema: variabilidad infinita de formas. No hay dos personas que formen una "G" de la misma manera, y cualquier biblioteca de coincidencia de patrones tiene puntos ciegos. Para herramientas diseñadas para manejar esto, consulte nuestra comparación de OCR para escritura a mano.
Fotos de teléfono: múltiples factores de degradación combinados
Si los documentos escaneados degradan la precisión mediante dos o tres factores, las fotos de teléfono combinan cinco o seis simultáneamente. La distorsión de perspectiva es la más destructiva: a menos que el teléfono se sostenga perfectamente paralelo al documento — lo que casi nunca ocurre — la página se fotografía en ángulo, creando un trapezoide donde los tamaños de los caracteres y el espaciado de las líneas varían de manera inconsistente en toda la imagen.
La variación de iluminación agrava el problema: un punto brillante en el centro, sombras en los bordes, una sombra sobre una fila de números que hace que los caracteres parezcan fusionarse. El desenfoque de movimiento incluso por un temblor sutil de la mano desdibuja los bordes de los caracteres en 1-2 píxeles. Los reflejos y el brillo del papel satinado pueden borrar secciones enteras de texto por completo.
El efecto acumulativo es dramático. Una herramienta que obtiene un 99% en un PDF digital puede caer por debajo del 70% en una foto de teléfono del mismo documento. La información está toda en la página física, pero la imagen la ha degradado más allá del reconocimiento confiable.
Tablas complejas y celdas combinadas: cuando la estructura se desmorona
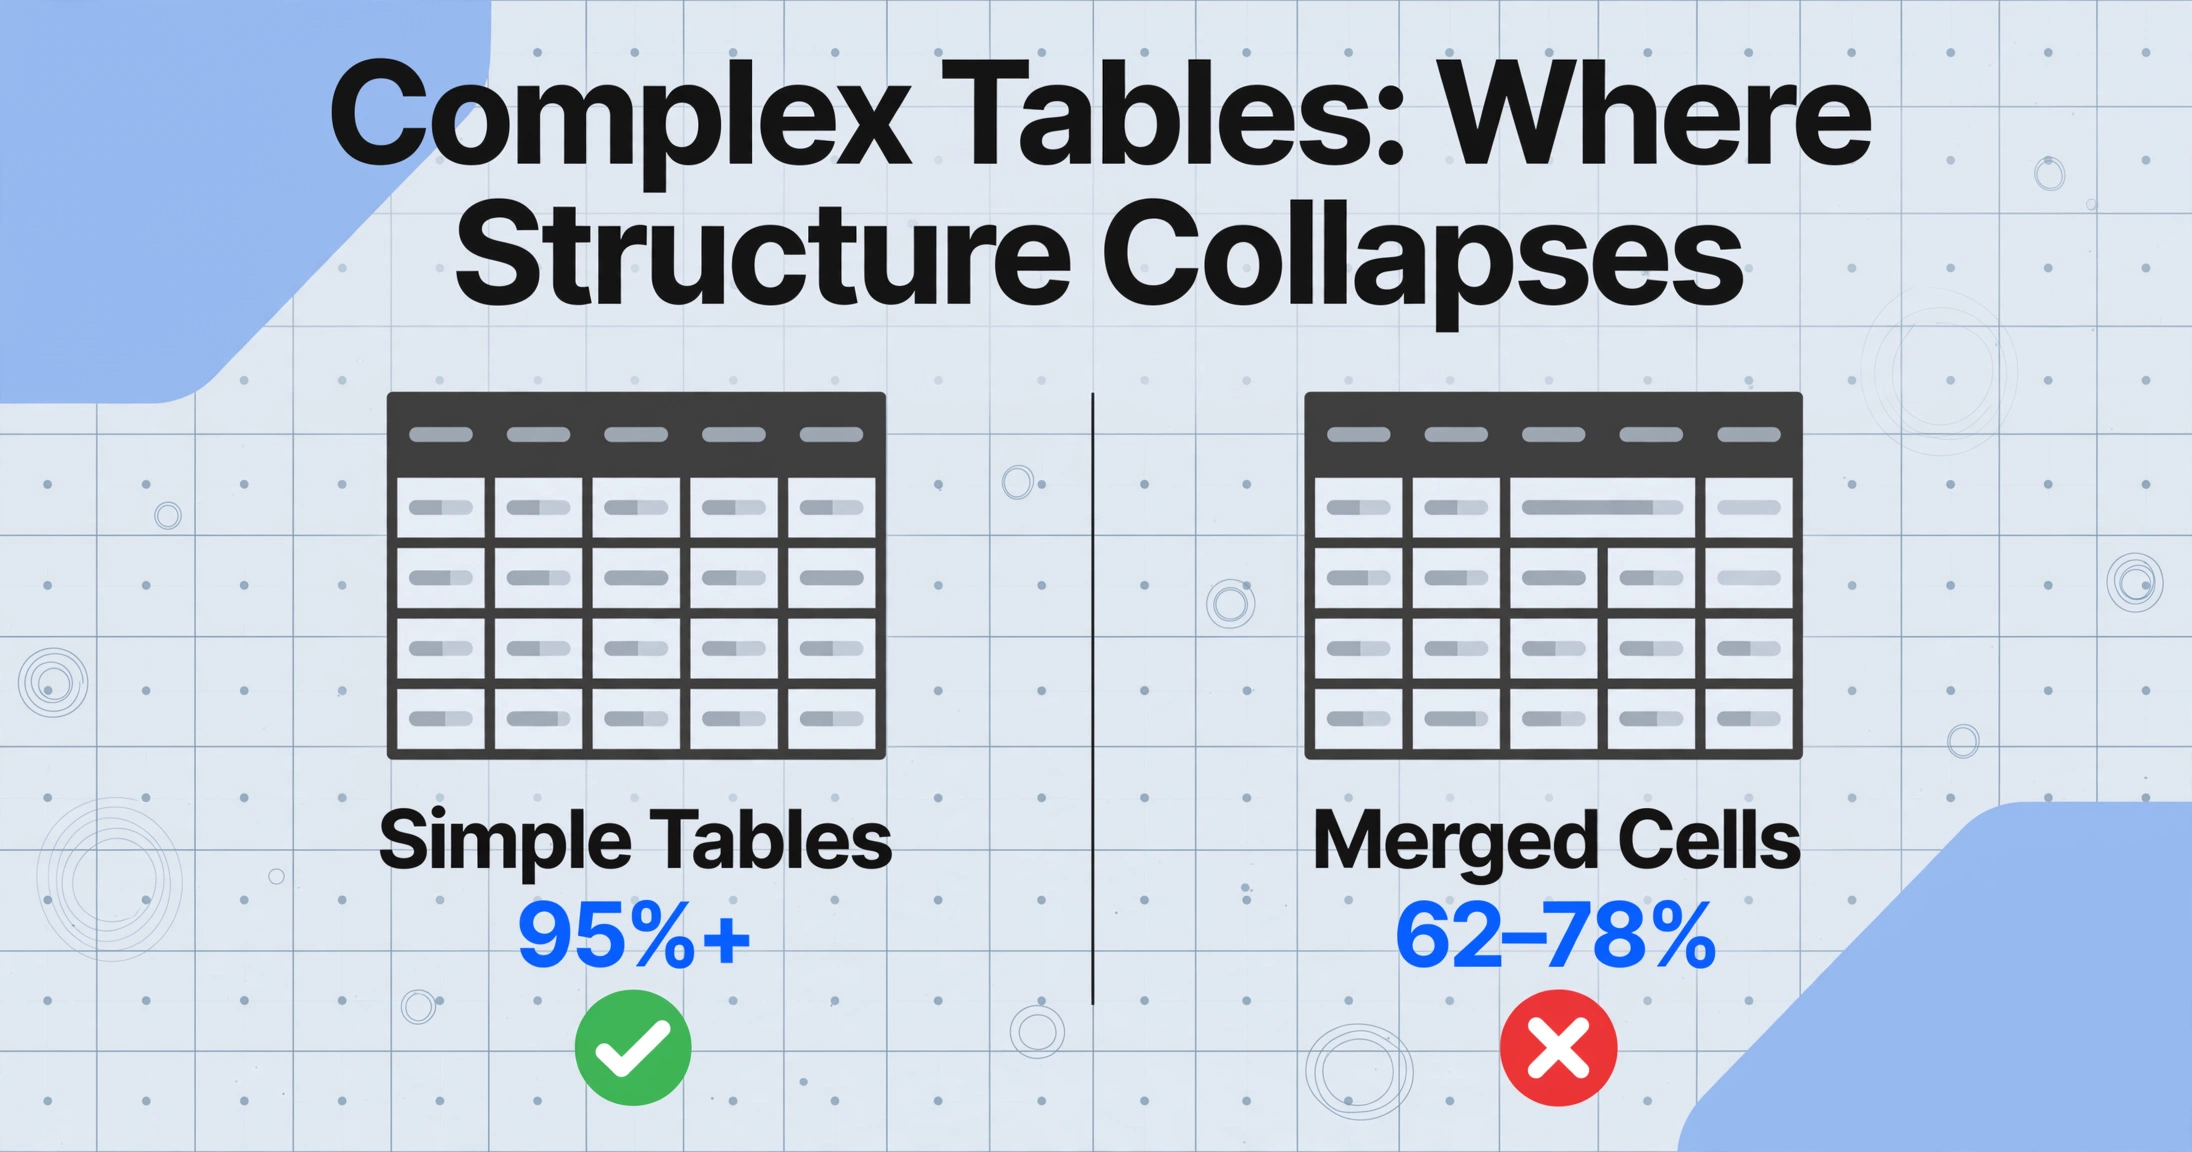
Las tablas plantean un tipo de desafío diferente. No se trata de leer caracteres: el OCR moderno puede leer los números dentro de las celdas razonablemente bien. El problema es estructural: el motor debe determinar a qué celda pertenece cada valor, y eso requiere comprender la cuadrícula de la tabla, no solo sus caracteres. Las celdas combinadas son el factor de ruptura más común. Un encabezado que abarca tres columnas, una celda de "Notas" que abarca dos filas, una etiqueta de subtotal que se fusiona en la primera columna: estos patrones rompen la suposición fila por fila que la mayoría de los motores de OCR utilizan para reconstruir tablas.
La investigación académica confirma que este es un problema abierto. Un estudio de arXiv de 2024 encontró que incluso los modelos especializados de extracción de tablas logran solo un 62-78% de precisión en tablas complejas con celdas combinadas y estructuras irregulares, una brecha de más de 20 puntos por debajo del reconocimiento de tablas simples. Las tablas anidadas y las tablas de varias páginas donde los encabezados cambian de posición elevan aún más las tasas de fallo. La extracción basada en VLM lee las tablas semánticamente: puede reconocer que "Descripción del artículo" gobierna la columna debajo de ella, independientemente de cuántas celdas abarque ese encabezado. Para obtener más información sobre cómo la precisión a nivel de campo difiere de las métricas de caracteres, consulte nuestra guía sobre qué significa realmente la precisión del OCR.
Lo que Realmente Puedes Controlar
Varios factores de precisión están bajo tu control, y abordarlos suele generar mayores mejoras que cambiar de motor:
Preparación del documento. Escanea a un mínimo de 300 DPI, la resolución de OCR universalmente recomendada. Usa tinta negra sobre papel blanco para máximo contraste. Aplana documentos doblados o arrugados antes de escanear; un pliegue que atraviesa una línea de texto equivale a datos faltantes.
Selección de la herramienta. El diferenciador clave es si la herramienta usa OCR por coincidencia de patrones (Tesseract, ABBYY clásico, la mayoría de las APIs en la nube) o extracción con modelos de lenguaje visual (ImageToTable.ai y servicios más nuevos basados en LLM). Las herramientas basadas en VLM leen documentos de forma semántica: pueden usar el contexto circundante para resolver caracteres ambiguos. Un dígito borroso entre un signo de dólar y ".00" es casi con certeza un 9, no un 8 — un VLM puede hacer esa inferencia; un motor de OCR basado en píxeles no puede.
Validación posterior al procesamiento. Incorpora expectativas de formato en tu flujo de trabajo: un número de factura sigue un patrón, una fecha sigue un calendario, un total es un número positivo. Cuando los datos extraídos violan un patrón, márcalos para revisión — no porque la herramienta sea mala, sino porque ciertos tipos de documentos siempre producen resultados inciertos. Reglas como "El total debe ser igual a la suma de las partidas ± 0.01" detectan los errores más importantes sin revisar cada campo.
Cómo Interpretar las Afirmaciones de Precisión de los Proveedores
Cada proveedor de OCR publica cifras. Así debes leerlas:
Pregunta qué tipo de documento se probó. Si el proveedor no lo especifica, asume que fue el tipo más fácil disponible. Pregunta qué métrica se usó. La precisión a nivel de carácter (CER) es la más indulgente. La precisión a nivel de campo — si cada dato extraído es completamente correcto — determina si tu flujo de trabajo funciona. Una herramienta con 99% de CER puede tener 80% de precisión a nivel de campo en el mismo documento, como se explica en nuestra guía de métricas de precisión de OCR. Pregunta sobre la distribución de errores. Si los errores se concentran en números, códigos e identificadores — lo cual suele ocurrir, porque son los caracteres que más se parecen entre sí para los motores de OCR — la misma tasa de error puede ser catastrófica. Prueba con tus propios documentos. Tres de tus documentos más difíciles y cinco minutos de pruebas te dirán más que cualquier punto de referencia publicado.
Preguntas frecuentes
¿Por qué la precisión del OCR cae tanto con la escritura a mano?
El OCR tradicional funciona segmentando el texto en caracteres individuales. La escritura cursiva elimina los espacios de los que depende la segmentación: las letras se conectan, por lo que el motor no puede determinar dónde termina un carácter y comienza el siguiente. Esto es un problema estructural, no de calidad. Incluso los escaneos de cursiva con resolución perfecta producen una precisión menor que los escaneos mediocres de texto impreso.
¿Cuál es la mejor resolución para escanear documentos para OCR?
300 DPI es el estándar de la industria. Por debajo de 200 DPI, la precisión cae notablemente, ya que los bordes de los caracteres se vuelven demasiado gruesos para una segmentación fiable. Por encima de 600 DPI, los tamaños de archivo crecen sin mejoras adicionales en la precisión.
¿Pueden las herramientas de OCR basadas en IA manejar tipos de documentos que el OCR tradicional no puede?
Las herramientas de modelos de lenguaje visual (VLM) manejan una gama más amplia de tipos de documentos porque leen semánticamente en lugar de píxel por píxel. Usan el contexto para resolver caracteres ambiguos y mantienen conciencia estructural de tablas y celdas combinadas. Sin embargo, ninguna herramienta logra una precisión igual en todos los tipos, y las entradas de muy baja calidad degradan cualquier sistema.
¿El formato del documento (PDF vs JPG vs PNG) afecta la precisión del OCR?
El formato importa menos que su contenido. Un PDF digital con texto incrustado no necesita OCR: el texto ya es legible por máquina. Un PDF escaneado y un JPG del mismo documento producen una precisión equivalente con la misma resolución y compresión.
¿Por qué mi herramienta de OCR funciona bien con facturas pero falla con albaranes?
Esto es un problema de estructura. Las facturas siguen diseños predecibles de clave-valor. Los albaranes suelen usar tablas complejas con celdas combinadas, alturas de fila irregulares y celdas multilínea: patrones estructurales que el OCR tradicional maneja mal. El motor no ha cambiado; el documento ha cruzado un umbral estructural que la herramienta no puede analizar.
¿Puede el preprocesamiento mejorar la precisión del OCR en tipos de documentos difíciles?
El preprocesamiento básico — enderezado, conversión a escala de grises, umbral adaptativo — puede mejorar la precisión entre un 5 y un 15 % en documentos escaneados y fotos de teléfono. Pero no cerrará la brecha en escritura a mano o tablas complejas, porque esos son problemas estructurales de reconocimiento, no de calidad de imagen.