Warum die OCR-Genauigkeit bei
Handschrift, gescannten PDFs und Tabellen sinkt – und was Sie dagegen tun können
Wenn ein OCR-Anbieter „99 % Genauigkeit" angibt, meint er damit fast immer die Genauigkeit auf Zeichenebene bei sauberen, gedruckten englischen Texten – nicht, ob die Summe auf dem handschriftlichen Lieferschein Ihres Lieferanten korrekt herauskommt. Diese Zahl ist real, aber sie kommt mit einem Kleingedruckten: Sie wurde an Dokumenten gemessen, die so ausgewählt wurden, dass sie gute Ergebnisse liefern. Ersetzen Sie das durch einen zerknitterten Kassenzettel, der auf einem Schreibtisch fotografiert wurde, einen gescannten Vertrag aus einem Faxgerät oder ein mit Kugelschreiber ausgefülltes Formular – und dasselbe Tool kann 60 %, 40 % oder weniger liefern. Die Genauigkeit sinkt nicht zufällig – sie sinkt auf vorhersehbare Weise, je nachdem, welche Art von Dokument Sie einspeisen. Diese Muster zu verstehen, ist der Unterschied zwischen der Wahl des richtigen Tools und dem Beschuldigen des falschen.
Die wichtigsten Erkenntnisse
- OCR-Anbieter lügen nicht bei den 99 % Genauigkeit – aber die Zahl stammt von sauberen digitalen PDFs; bei Handschrift, einem Handyfoto oder einer komplexen Tabelle fällt dieselbe Engine unter 60 %.
- Der Abfall ist vorhersehbar, nicht zufällig – Schreibschrift eliminiert die Zeichenabstände, auf die die Segmentierung angewiesen ist, Handyfotos kombinieren fünf gleichzeitige Verzerrungen, und zusammengeführte Tabellenzellen erzeugen strukturelle Mehrdeutigkeit, die keine Engine auf Pixelebene auflösen kann.
- Ein Vision-Language-Modell liest semantisch – es schließt daraus, dass eine verschmierte Ziffer zwischen „$" und „.00" eine 9 ist, nicht eine 8 – derselbe Mechanismus, der Schreibschrift und Tabellenzellen lesbar macht; testen Sie Ihre eigenen drei schwierigsten Dokumente.
Das Missverständnis über die OCR-Genauigkeit
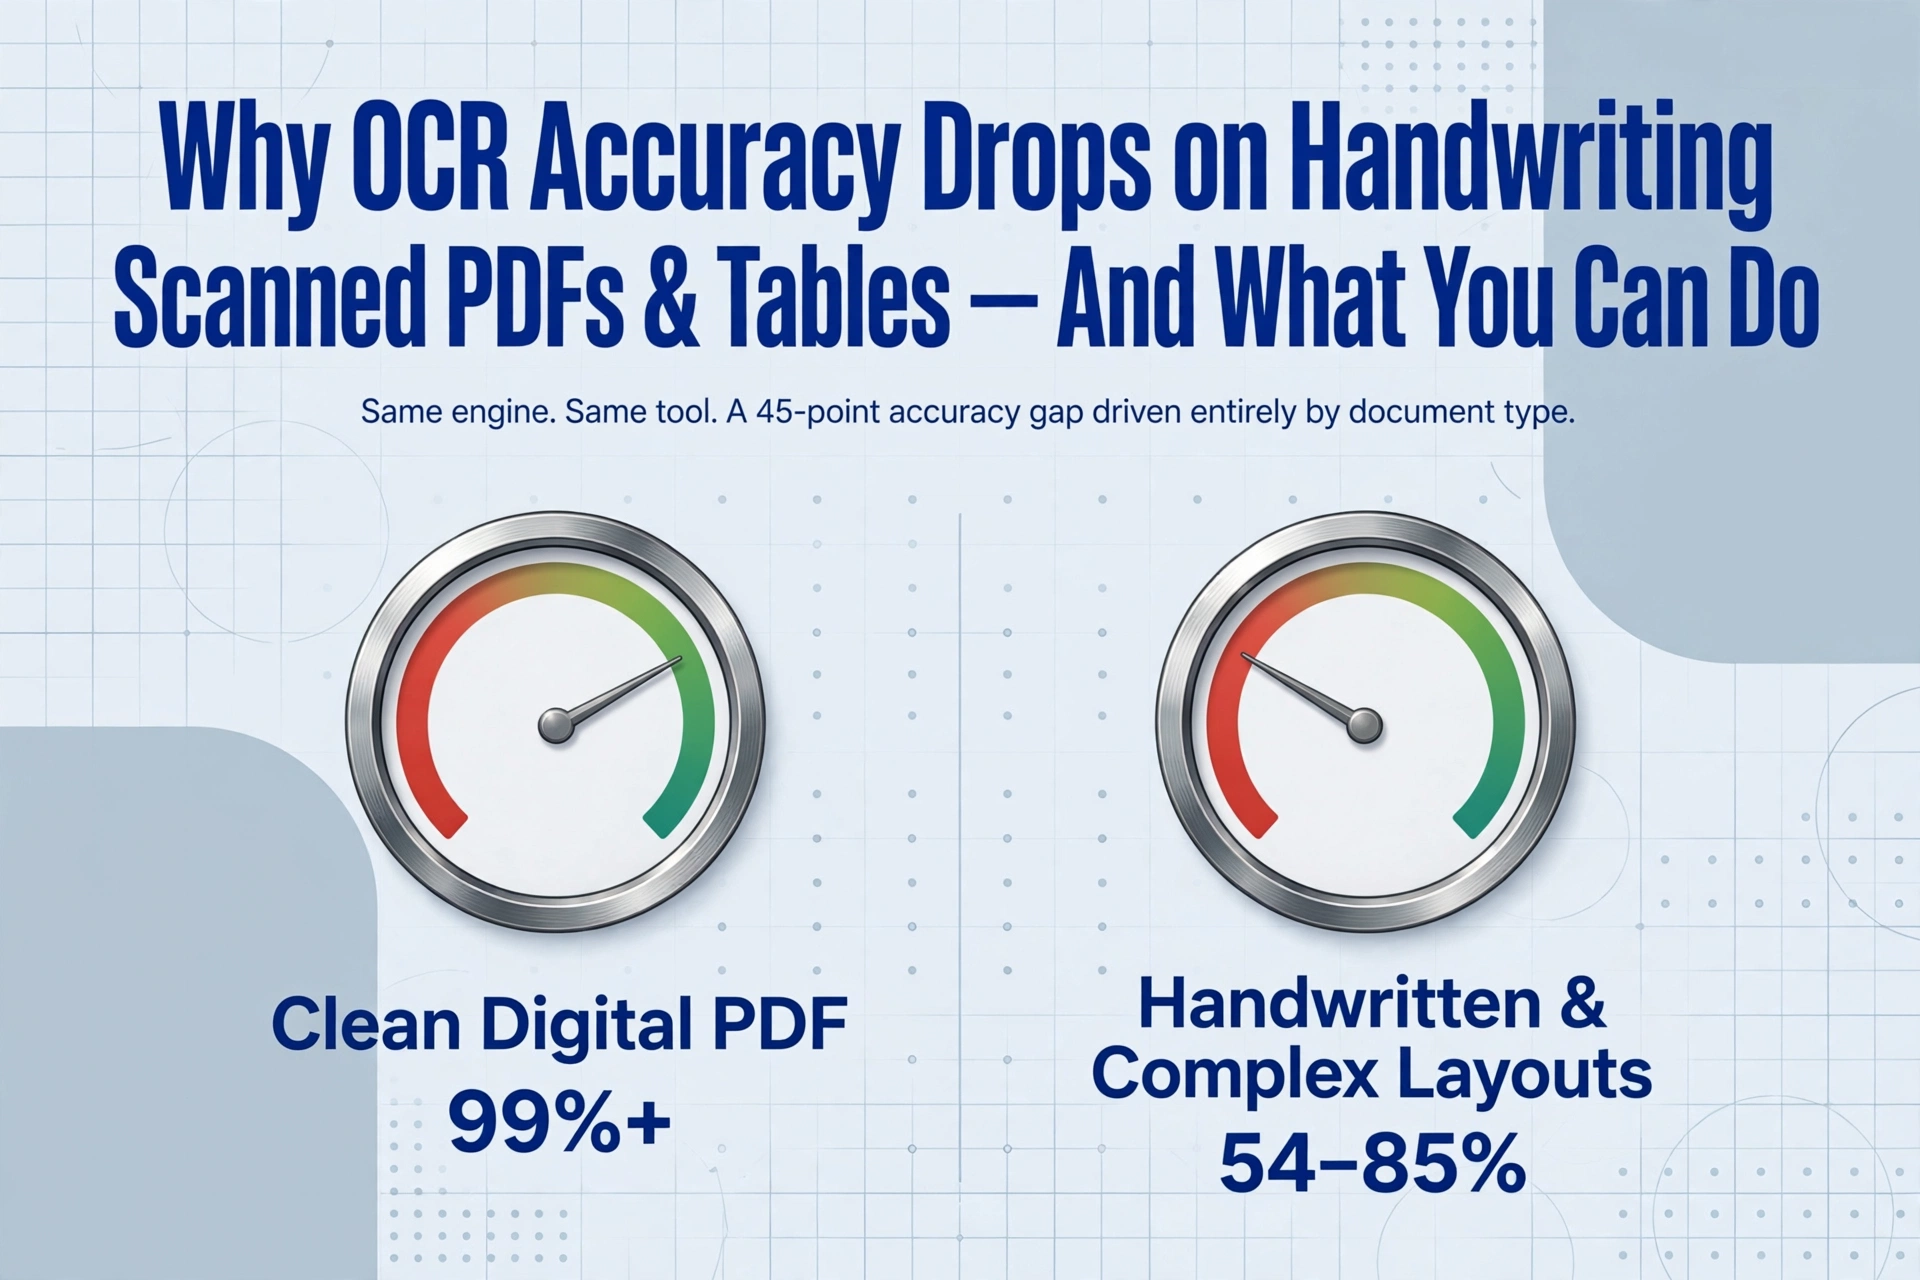
Jedes OCR-Tool auf dem Markt behauptet eine hohe Genauigkeit – Tesseract, Google Cloud Vision, Amazon Textract – sie alle veröffentlichen Zahlen im Bereich von 95-99 %. Der AIMultiple OCR-Benchmark bestätigt, dass führende Cloud-OCR-Dienste bei Dokumenten der Kategorie 1 – getippte Texte auf sauberen, kontrastreichen Hintergründen – über 99,2 % erreichen. Aber derselbe Benchmark zeigt auch etwas anderes: Bei Kategorie 3 (handgeschriebene und komplexe Layout-Dokumente) fällt die Genauigkeit auf 54 % bis 85 %. Gleiche Tools. Gleiche Engines. Eine Lücke von 45 Punkten, die vollständig durch die Art des Dokuments verursacht wird, das hineingegeben wird.
Die Basis – Saubere digitale PDFs
Ein sauberes digitales PDF – eine aus Buchhaltungssoftware exportierte Rechnung, ein aus Word gespeicherter Vertrag, ein von einem Webportal heruntergeladener Kontoauszug – ist der ideale Input für jedes OCR-System. Der Text ist scharf, die Schriftarten sind Standard und der Kontrast ist nahezu perfekt. Bei diesen Dokumenten übertreffen moderne OCR-Engines routinemäßig 99 % Zeichengenauigkeit. Verbleibende Fehler beschränken sich typischerweise auf Randfälle: ungewöhnliche Ligaturen, sehr kleine Schriftgrößen (unter 6 pt) oder dekorative Zeichen in Kopfzeilen. Dies ist das Szenario, das die Behauptung „99 % Genauigkeit“ stützt – und es ist die Basis, von der aus jeder andere Dokumenttyp eine messbare Verschlechterung darstellt.
Gescannte PDFs – Wo die Qualitätsverschlechterung beginnt
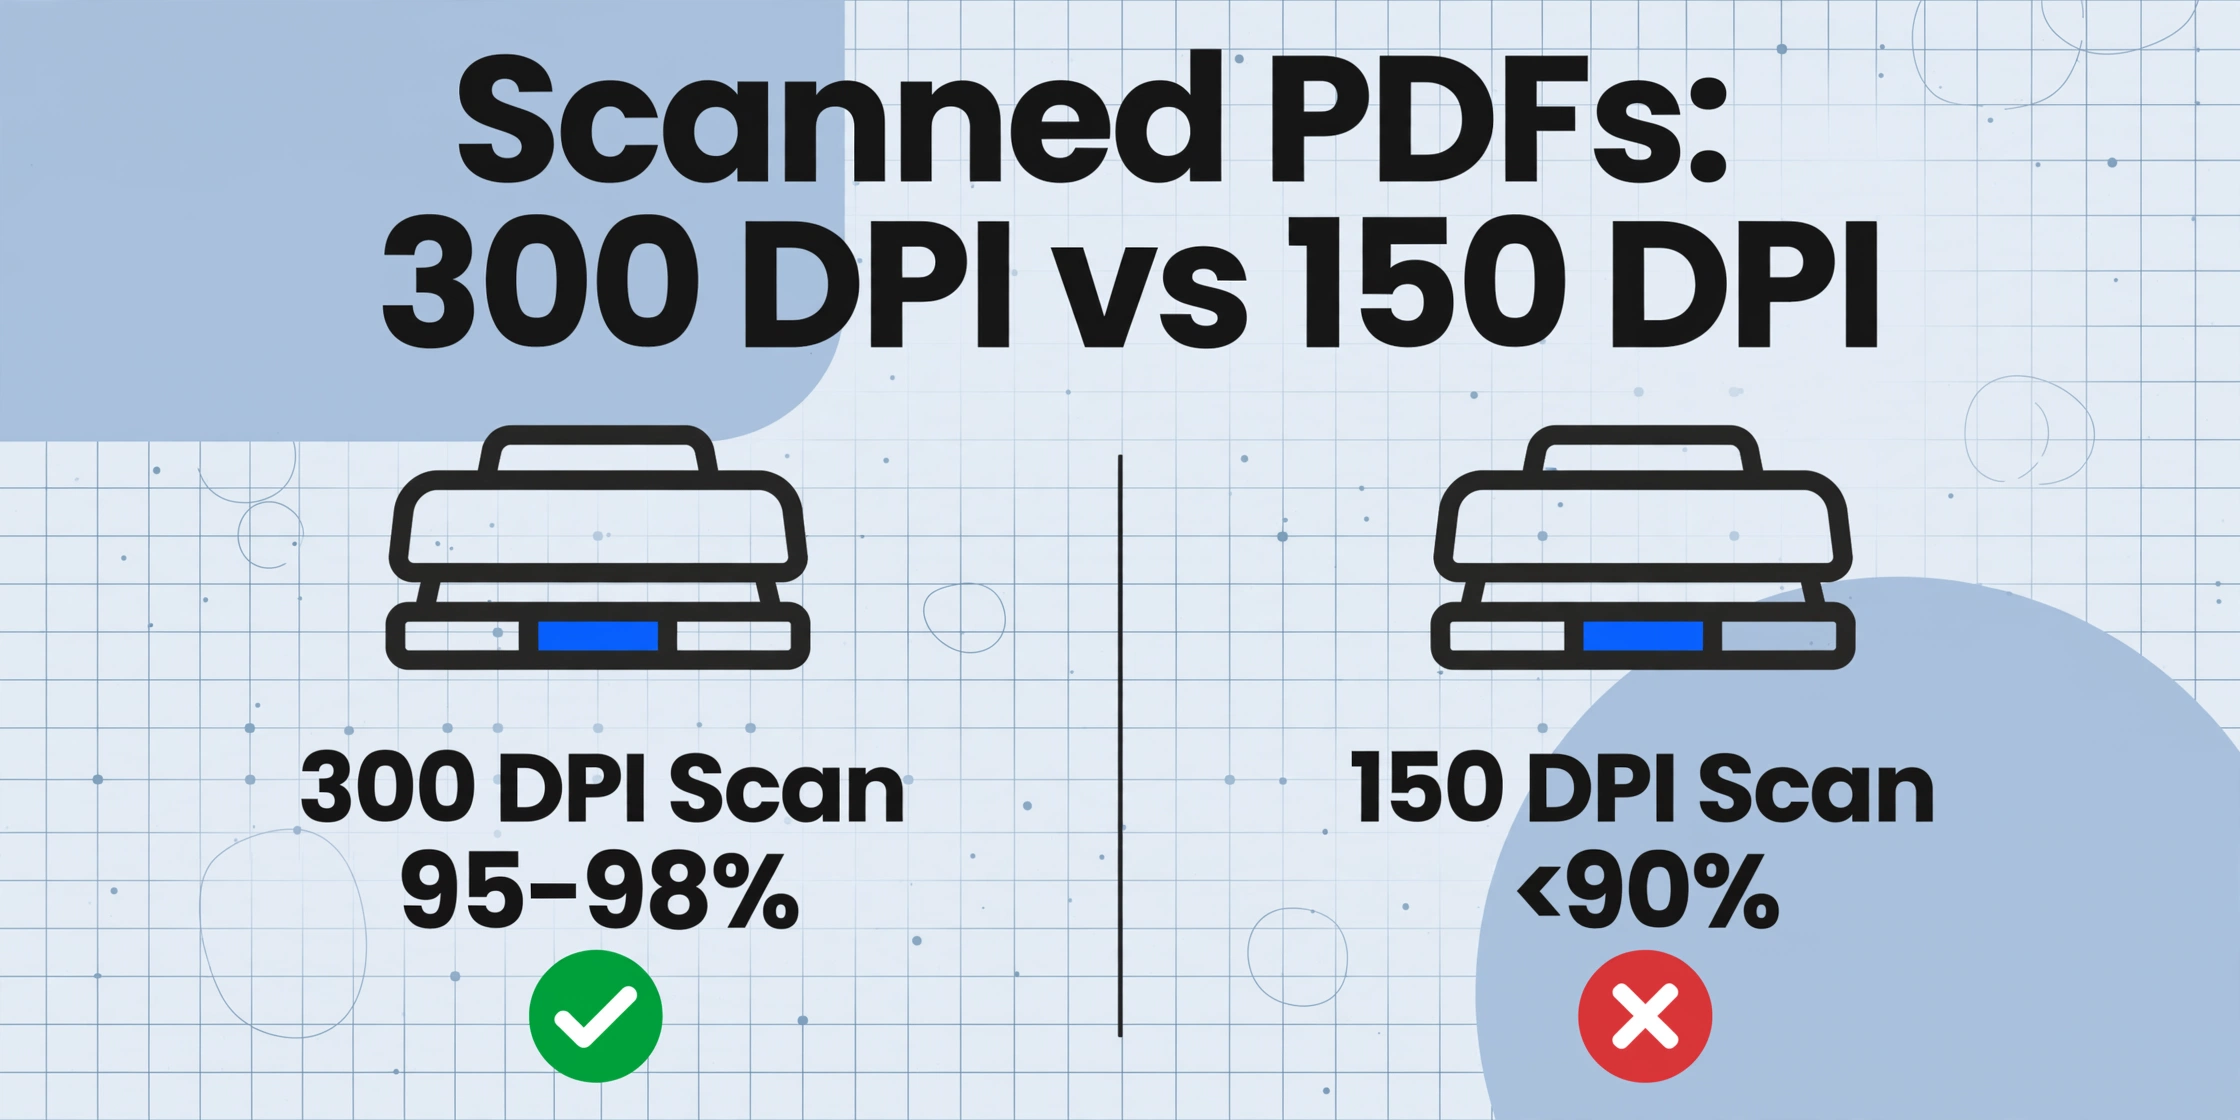
Ein gescanntes PDF ist ein Foto einer gedruckten Seite, und dieses Bild führt mehrere Fehlerquellen ein, die ein digitales PDF nicht hat. Auflösungsverlust ist die erste: Ein Scan mit 200 DPI gibt der Engine etwa 8 Pixel Höhe für ein 10-Punkt-Zeichen. Reduzieren Sie auf 150 DPI – üblich beim Batch-Scannen – und dasselbe Zeichen ist nur noch 6 Pixel hoch. Die Engine muss Striche aus einer Handvoll Pixeln erraten.
Rauschen und Artefakte fügen eine weitere Ebene hinzu. Sensorscanner erzeugen Körnung; Papierstruktur (Zeitungspapier, Thermopapier, Recyclingpapier) fügt Muster hinzu, die die Engine als Teil eines Zeichens fehlinterpretieren kann. Schräglage – selbst 2-3 Grad von der Geraden – zwingt die Engine, die Rotation zu korrigieren, bevor sie Zeichen segmentiert, was die Fehlerrate messbar erhöht. Und überlappende Inhalte – Stempel, Unterschriften, Wasserzeichen über gedrucktem Text – erzeugen Mehrdeutigkeiten, die keine Pixel-basierte OCR auflösen kann: Ein „BEZAHLT“-Stempel über einer Rechnungssumme macht beide unlesbar.
Ein guter 300-DPI-Scan von sauberem gedrucktem Text erreicht immer noch 95-98 % Zeichengenauigkeit. Ein minderwertiger 150-DPI-Scan desselben Dokuments kann unter 90 % fallen.
Handschrift – Das grundlegende Grenzproblem
Handgeschriebener Text ist keine schwierigere Version von gedrucktem Text. Es ist ein grundlegend anderes Erkennungsproblem. Gedruckte Zeichen haben klare, konsistente Grenzen – Abstände zwischen Buchstaben, einheitliche Grundlinien, vorhersehbare Formen. Eine OCR-Engine segmentiert ein gedrucktes Wort mithilfe dieser Abstände in einzelne Zeichen und gleicht dann jede Form mit einer Bibliothek ab. Das funktioniert, weil das Segmentierungssignal (der Abstand) zuverlässig ist.
Kursive Handschrift entfernt diese Grenzen vollständig. Buchstaben verbinden sich. Das Ende eines Zeichens ist der Anfang des nächsten. Ein kleines „n“ gefolgt von einem „i“ kann identisch mit einem „u“ aussehen. Ein „r“ gefolgt von einem „n“ kann wie ein „m“ aussehen. Die Engine kann das Wort nicht segmentieren, weil die Abstände durch schnelles Schreiben bewusst eliminiert wurden.
Die Branchenzahlen bestätigen das. AIMultiple-Benchmarks zeigen, dass traditionelle Cloud-OCR-Dienste, die bei gedrucktem Text über 99 % erreichen, bei Handschrift auf 60–85 % abfallen. Bei unordentlicher Kursivschrift oder gemischten Dokumenten aus Druck und Handschrift kann die Lücke 40 Prozentpunkte oder mehr betragen. Handschrift im Druckstil – Blockschrift – schneidet besser ab, weil sie Grenzen bewahrt, bringt aber ihr eigenes Problem mit sich: unendliche Formvariabilität. Keine zwei Personen formen ein „G“ auf dieselbe Weise, und jede Musterabgleich-Bibliothek hat blinde Flecken. Für Tools, die dafür entwickelt wurden, siehe unseren Handschrift-OCR-Vergleich.
Handyfotos – Mehrere Degradationsfaktoren kombiniert
Wenn gescannte Dokumente die Genauigkeit durch zwei oder drei Faktoren verschlechtern, kombinieren Handyfotos fünf oder sechs gleichzeitig. Perspektivverzerrung ist am zerstörerischsten: Wenn das Handy nicht perfekt parallel zum Dokument gehalten wird – was fast nie passiert –, wird die Seite in einem Winkel fotografiert, wodurch ein Trapez entsteht, bei dem Zeichengrößen und Zeilenabstände im Bild inkonsistent variieren.
Lichtschwankungen verschärfen das Problem: ein heller Fleck in der Mitte, Schatten an den Rändern, ein Schatten über einer Zahlenreihe, der Zeichen verschmelzen lässt. Bewegungsunschärfe durch selbst ein subtiles Zittern der Hand verwischt Zeichenkanten um 1–2 Pixel. Reflexionen und Blendung von glänzendem Papier können ganze Textabschnitte vollständig auswaschen.
Der kumulative Effekt ist dramatisch. Ein Tool, das bei einem digitalen PDF 99 % erreicht, kann bei einem Handyfoto desselben Dokuments unter 70 % fallen. Die Informationen sind alle auf der physischen Seite vorhanden, aber das Bild hat sie über das zuverlässig Erkennbare hinaus degradiert.
Komplexe Tabellen und zusammengeführte Zellen – wenn die Struktur kollabiert
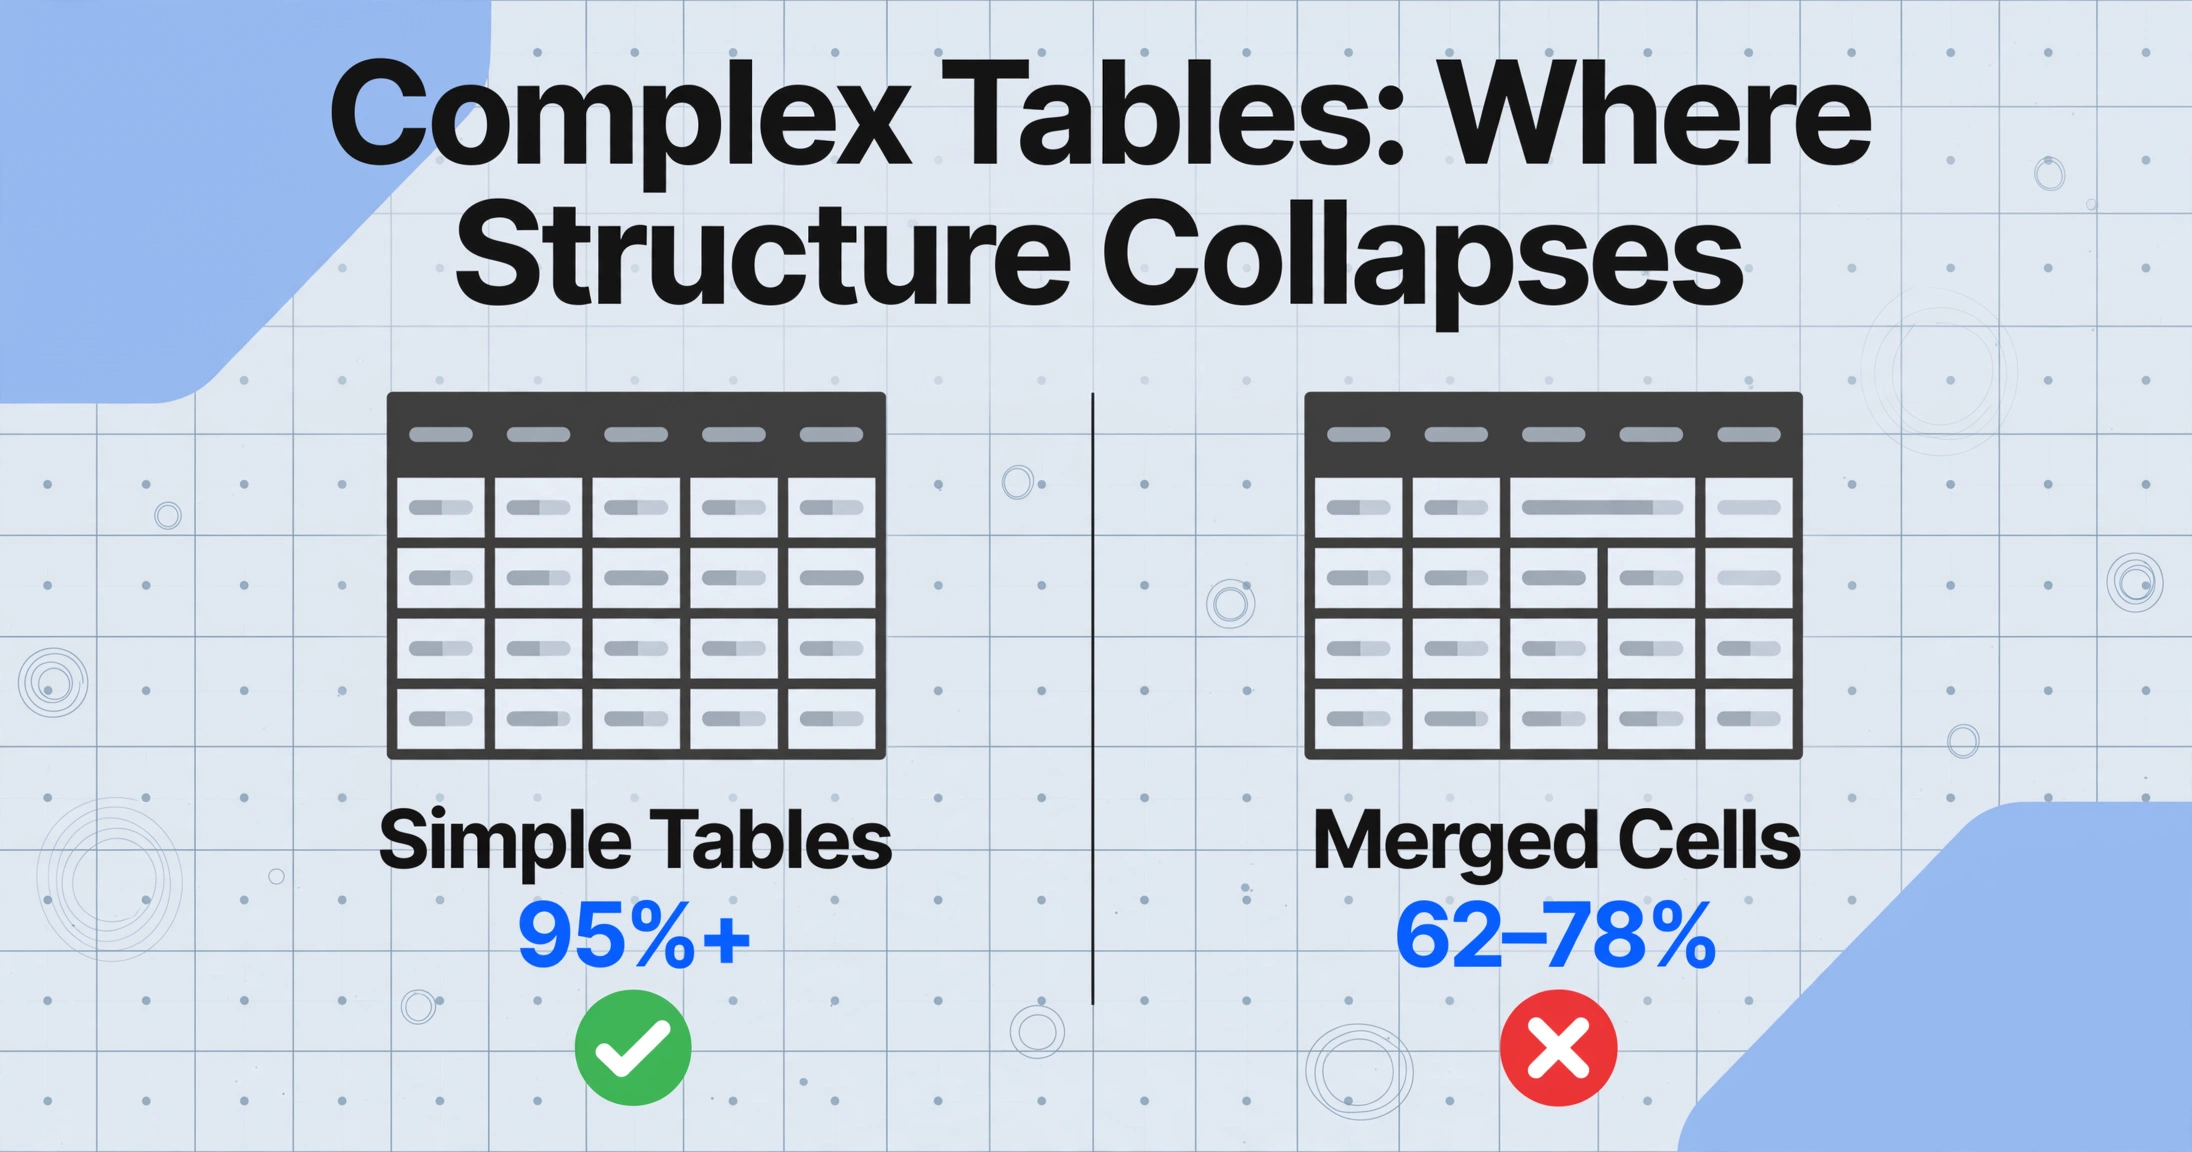
Tabellen stellen eine andere Art von Herausforderung dar. Es geht nicht um das Lesen von Zeichen – moderne OCR kann die Zahlen in den Zellen recht gut lesen. Das Problem ist struktureller Natur: Die Engine muss bestimmen, zu welcher Zelle jeder Wert gehört, und das erfordert das Verständnis des Tabellenrasters, nicht nur der Zeichen. Zusammengeführte Zellen sind der häufigste Stolperstein. Ein Header, der sich über drei Spalten erstreckt, eine „Notizen"-Zelle, die sich über zwei Zeilen erstreckt, eine Zwischensummen-Beschriftung, die sich über die erste Spalte erstreckt – solche Muster durchbrechen die zeilenweise Annahme, auf der die meisten OCR-Engines beim Rekonstruieren von Tabellen basieren.
Die akademische Forschung bestätigt, dass dies ein offenes Problem ist. Eine arXiv-Studie aus dem Jahr 2024 ergab, dass selbst spezialisierte Tabellenextraktionsmodelle bei komplexen Tabellen mit zusammengeführten Zellen und unregelmäßigen Strukturen nur eine Genauigkeit von 62-78 % erreichen – eine Lücke von über 20 Punkten im Vergleich zur Erkennung einfacher Tabellen. Verschachtelte Tabellen und mehrseitige Tabellen, bei denen sich die Position der Header verschiebt, treiben die Fehlerraten noch weiter in die Höhe. VLM-basierte Extraktion liest Tabellen semantisch – sie kann erkennen, dass „Item Description" die darunterliegende Spalte regelt, unabhängig davon, über wie viele Zellen sich dieser Header erstreckt. Weitere Informationen darüber, wie sich die Genauigkeit auf Feldebene von Zeichenmetriken unterscheidet, finden Sie in unserem Leitfaden zu was OCR-Genauigkeit tatsächlich bedeutet.
Was Sie tatsächlich kontrollieren können
Mehrere Genauigkeitsfaktoren liegen in Ihrer Hand, und deren Behebung bringt oft größere Verbesserungen als ein Wechsel der Engine:
Dokumentvorbereitung. Scannen Sie mit mindestens 300 DPI – der allgemein empfohlenen OCR-Auflösung. Verwenden Sie schwarze Tinte auf weißem Papier für maximalen Kontrast. Glätten Sie gefaltete oder zerknitterte Dokumente vor dem Scannen; eine Falz durch eine Textzeile ist dasselbe wie fehlende Daten.
Tool-Auswahl. Der entscheidende Unterschied ist, ob ein Tool musterbasiertes OCR (Tesseract, klassisches ABBYY, die meisten Cloud-APIs) oder Extraktion per Vision-Language-Modell (ImageToTable.ai und neuere LLM-gestützte Dienste) verwendet. VLM-basierte Tools lesen Dokumente semantisch – sie können den umgebenden Kontext nutzen, um mehrdeutige Zeichen aufzulösen. Eine verschmierte Ziffer zwischen einem Dollarzeichen und „.00" ist mit hoher Wahrscheinlichkeit eine 9, keine 8 – ein VLM kann diese Schlussfolgerung ziehen; eine pixelbasierte OCR-Engine nicht.
Validierung nach der Verarbeitung. Bauen Sie Formaterwartungen in Ihren Workflow ein: Eine Rechnungsnummer folgt einem Muster, ein Datum folgt einem Kalender, eine Summe ist eine positive Zahl. Wenn extrahierte Daten gegen ein Muster verstoßen, markieren Sie sie zur Überprüfung – nicht weil das Tool schlecht ist, sondern weil bestimmte Dokumenttypen immer unsichere Ergebnisse liefern. Regeln wie „Summe muss der Summe der Positionen ± 0,01 entsprechen" fangen die wichtigsten Fehler ab, ohne jedes Feld zu prüfen.
So lesen Sie Genauigkeitsangaben von Anbietern
Jeder OCR-Anbieter veröffentlicht Zahlen. So lesen Sie sie:
Fragen Sie, welcher Dokumenttyp getestet wurde. Wenn der Anbieter es nicht angibt, gehen Sie vom einfachsten verfügbaren Typ aus. Fragen Sie, welche Metrik verwendet wurde. Zeichengenauigkeit (CER) ist die nachsichtigste. Feldgenauigkeit – ob jeder extrahierte Datenpunkt vollständig korrekt ist – entscheidet, ob Ihr Workflow funktioniert. Ein Tool mit 99 % CER kann bei demselben Dokument 80 % Feldgenauigkeit haben, wie in unserem Leitfaden zu OCR-Genauigkeitsmetriken erläutert. Fragen Sie nach der Fehlerverteilung. Wenn Fehler bei Zahlen, Codes und Kennungen gehäuft auftreten – was sie oft tun, weil dies die Zeichen sind, die OCR-Engines am ähnlichsten sehen – kann dieselbe Fehlerrate katastrophal sein. Testen Sie mit Ihren eigenen Dokumenten. Drei Ihrer schlimmsten Dokumente und fünf Minuten Testzeit sagen Ihnen mehr als jeder veröffentlichte Benchmark.
FAQ
Warum sinkt die OCR-Genauigkeit bei Handschrift so stark?
Traditionelle OCR funktioniert, indem sie Text in einzelne Zeichen segmentiert. Kursivschrift entfernt die Lücken, von denen die Segmentierung abhängt – Buchstaben sind verbunden, sodass die Engine nicht bestimmen kann, wo ein Zeichen endet und das nächste beginnt. Dies ist ein strukturelles Problem, kein Qualitätsproblem. Selbst Scans von Kursivschrift in perfekter Auflösung erzielen eine geringere Genauigkeit als mittelmäßige Scans von gedrucktem Text.
Welche Auflösung ist beim Scannen von Dokumenten für OCR am besten?
300 DPI ist der Industriestandard. Unter 200 DPI sinkt die Genauigkeit messbar, da Zeichenkanten für eine zuverlässige Segmentierung zu grob werden. Über 600 DPI wachsen die Dateigrößen ohne weitere Genauigkeitsgewinne.
Können KI-basierte OCR-Tools Dokumenttypen verarbeiten, die traditionelle OCR nicht kann?
Tools mit Vision-Language-Modellen (VLM) verarbeiten eine größere Bandbreite an Dokumenttypen, da sie semantisch statt pixelweise lesen. Sie nutzen Kontext, um mehrdeutige Zeichen aufzulösen, und behalten die strukturelle Wahrnehmung von Tabellen und verbundenen Zellen bei. Allerdings erzielt kein Tool gleiche Genauigkeit über alle Typen hinweg, und Eingaben sehr schlechter Qualität beeinträchtigen jedes System.
Beeinflusst das Dokumentformat (PDF vs. JPG vs. PNG) die OCR-Genauigkeit?
Das Format ist weniger wichtig als sein Inhalt. Ein digitales PDF mit eingebettetem Text benötigt keine OCR – der Text ist bereits maschinenlesbar. Ein gescanntes PDF und ein JPG desselben Dokuments erzielen bei gleicher Auflösung und Kompression gleichwertige Genauigkeit.
Warum funktioniert mein OCR-Tool bei Rechnungen gut, versagt aber bei Lieferscheinen?
Dies ist ein Strukturproblem. Rechnungen folgen vorhersehbaren Schlüssel-Wert-Layouts. Lieferscheine verwenden oft komplexe Tabellen mit verbundenen Zellen, unregelmäßigen Zeilenhöhen und mehrzeiligen Zellen – strukturelle Muster, die traditionelle OCR schlecht verarbeitet. Die Engine hat sich nicht geändert; das Dokument hat eine strukturelle Schwelle überschritten, die das Tool nicht parsen kann.
Kann die Vorverarbeitung die OCR-Genauigkeit bei schwierigen Dokumenttypen verbessern?
Grundlegende Vorverarbeitung – Schräglagenkorrektur, Graustufenkonvertierung, adaptives Thresholding – kann die Genauigkeit bei gescannten Dokumenten und Handyfotos um 5–15 % verbessern. Sie schließt jedoch die Lücke bei Handschrift oder komplexen Tabellen nicht, da dies strukturelle Erkennungsprobleme sind, keine Bildqualitätsprobleme.