Por que a precisão do OCR cai em
Manuscritos, PDFs digitalizados e tabelas — e o que você pode fazer
Quando um fornecedor de OCR diz "99% de precisão", quase sempre está falando de precisão em nível de caractere em texto impresso, limpo e em inglês — não se o total na nota de entrega manuscrita do seu fornecedor sairá correto. Esse número é real, mas vem com letras miúdas: foi medido em documentos selecionados para produzir bons resultados. Troque por um recibo amassado fotografado sobre uma mesa, um contrato digitalizado de uma máquina de fax ou um formulário preenchido à caneta esferográfica, e essa mesma ferramenta pode entregar 60%, 40% ou menos. A precisão não cai aleatoriamente — cai de formas previsíveis dependendo do tipo de documento que você fornece. Entender esses padrões é a diferença entre escolher a ferramenta certa e culpar a errada.
Principais conclusões
- Os fornecedores de OCR não estão mentindo sobre 99% de precisão — mas o número vem de PDFs digitais limpos; troque por manuscrito, uma foto de celular ou uma tabela complexa, e o mesmo mecanismo cai abaixo de 60%.
- A queda é previsível, não aleatória — a escrita cursiva elimina os espaços entre caracteres dos quais a segmentação depende, fotos de celular acumulam cinco distorções simultâneas, e células de tabela mescladas criam ambiguidade estrutural que nenhum mecanismo em nível de pixel consegue resolver.
- Um modelo de visão-linguagem lê semanticamente — ele infere que um dígito borrado entre "$" e ".00" é um 9, não um 8 — o mesmo mecanismo que torna a escrita cursiva e as células de tabela legíveis; teste seus próprios três piores documentos.
O Equívoco Sobre a Precisão do OCR
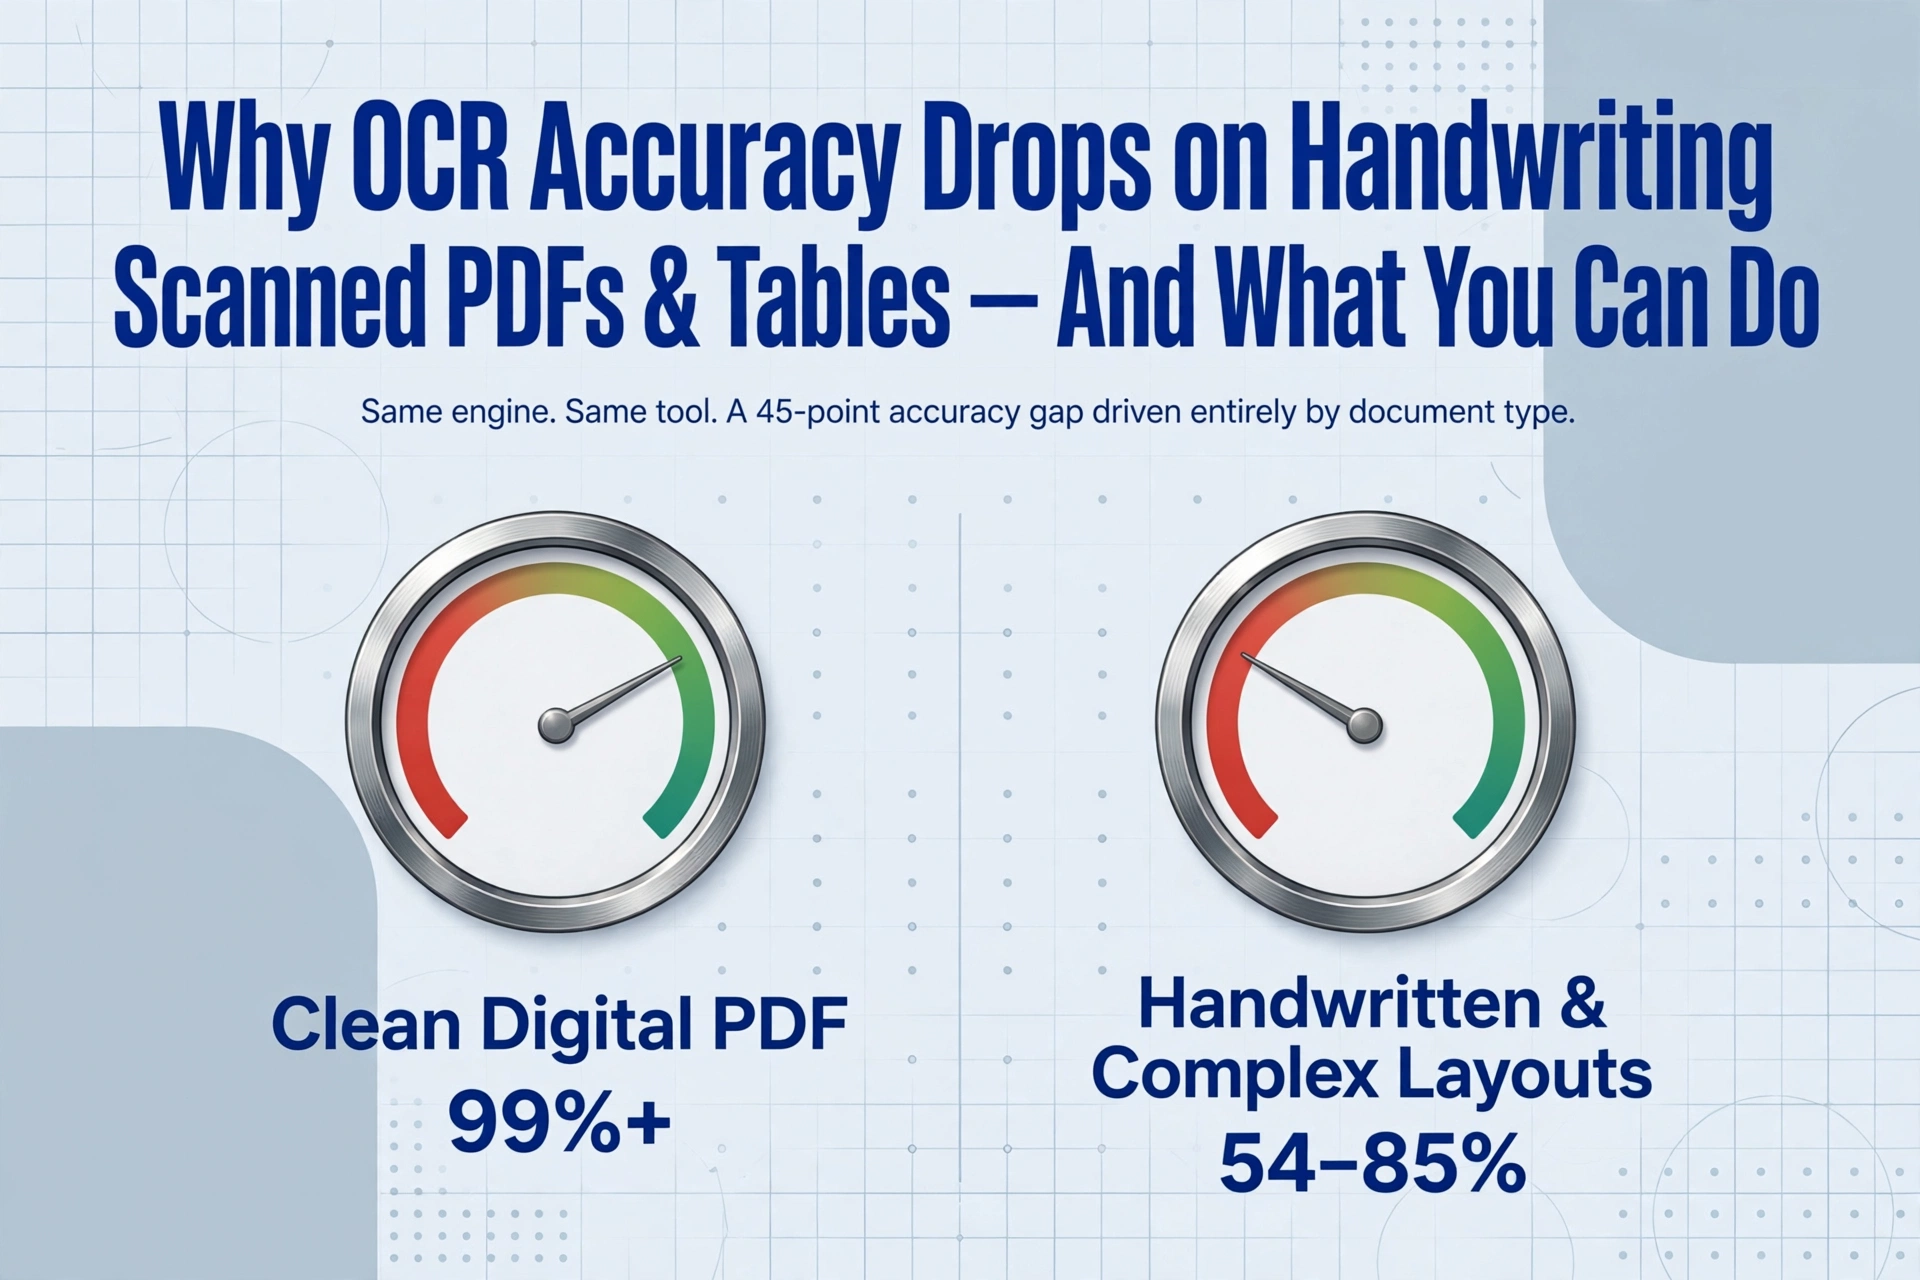
Toda ferramenta de OCR no mercado afirma ter alta precisão — Tesseract, Google Cloud Vision, Amazon Textract — todas publicam números na faixa de 95-99%. O AIMultiple OCR Benchmark confirma que os principais serviços de OCR em nuvem ultrapassam 99,2% em documentos da Categoria 1: textos digitados em fundos limpos e de alto contraste. Mas esse mesmo benchmark revela outra coisa — na Categoria 3 (documentos manuscritos e de layout complexo), a precisão cai para entre 54% e 85%. As mesmas ferramentas. Os mesmos motores. Uma diferença de 45 pontos causada inteiramente por que tipo de documento entra.
A Linha de Base — PDFs Digitais Limpos
Um PDF digital limpo — uma fatura exportada de um software de contabilidade, um contrato salvo do Word, um extrato bancário baixado de um portal web — é a entrada ideal para qualquer sistema de OCR. O texto é nítido, as fontes são padrão e o contraste é quase perfeito. Nesses documentos, os motores de OCR modernos rotineiramente ultrapassam 99% de precisão de caracteres. Os erros restantes geralmente se limitam a casos extremos: ligaduras incomuns, tamanhos de fonte muito pequenos (abaixo de 6pt) ou caracteres ornamentais em cabeçalhos. Este é o cenário que sustenta a afirmação de "99% de precisão" — e é a linha de base a partir da qual todo outro tipo de documento representa uma degradação mensurável.
PDFs Digitalizados — Onde Começa a Degradação da Qualidade
Um PDF digitalizado é uma fotografia de uma página impressa, e essa imagem introduz várias fontes de erro que um PDF digital não tem. Perda de resolução é a primeira: uma digitalização a 200 DPI dá ao motor cerca de 8 pixels de altura para um caractere de 10 pontos. Caia para 150 DPI — comum em digitalização em lote — e o mesmo caractere tem apenas 6 pixels de altura. O motor precisa adivinhar os traços a partir de um punhado de pixels.
Ruído e artefatos adicionam outra camada. Os sensores do scanner introduzem granulação; a textura do papel (papel jornal, papel térmico, papel reciclado) adiciona padrões que o motor pode interpretar erroneamente como parte de um caractere. Inclinação — mesmo 2-3 graus fora do alinhamento — força o motor a corrigir a rotação antes de segmentar os caracteres, aumentando mensuravelmente a taxa de erro. E conteúdo sobreposto — carimbos, assinaturas, marcas d'água sobre o texto impresso — cria uma ambiguidade que nenhum OCR em nível de pixel consegue resolver: um carimbo "PAID" sobre o total de uma fatura torna ambos ilegíveis.
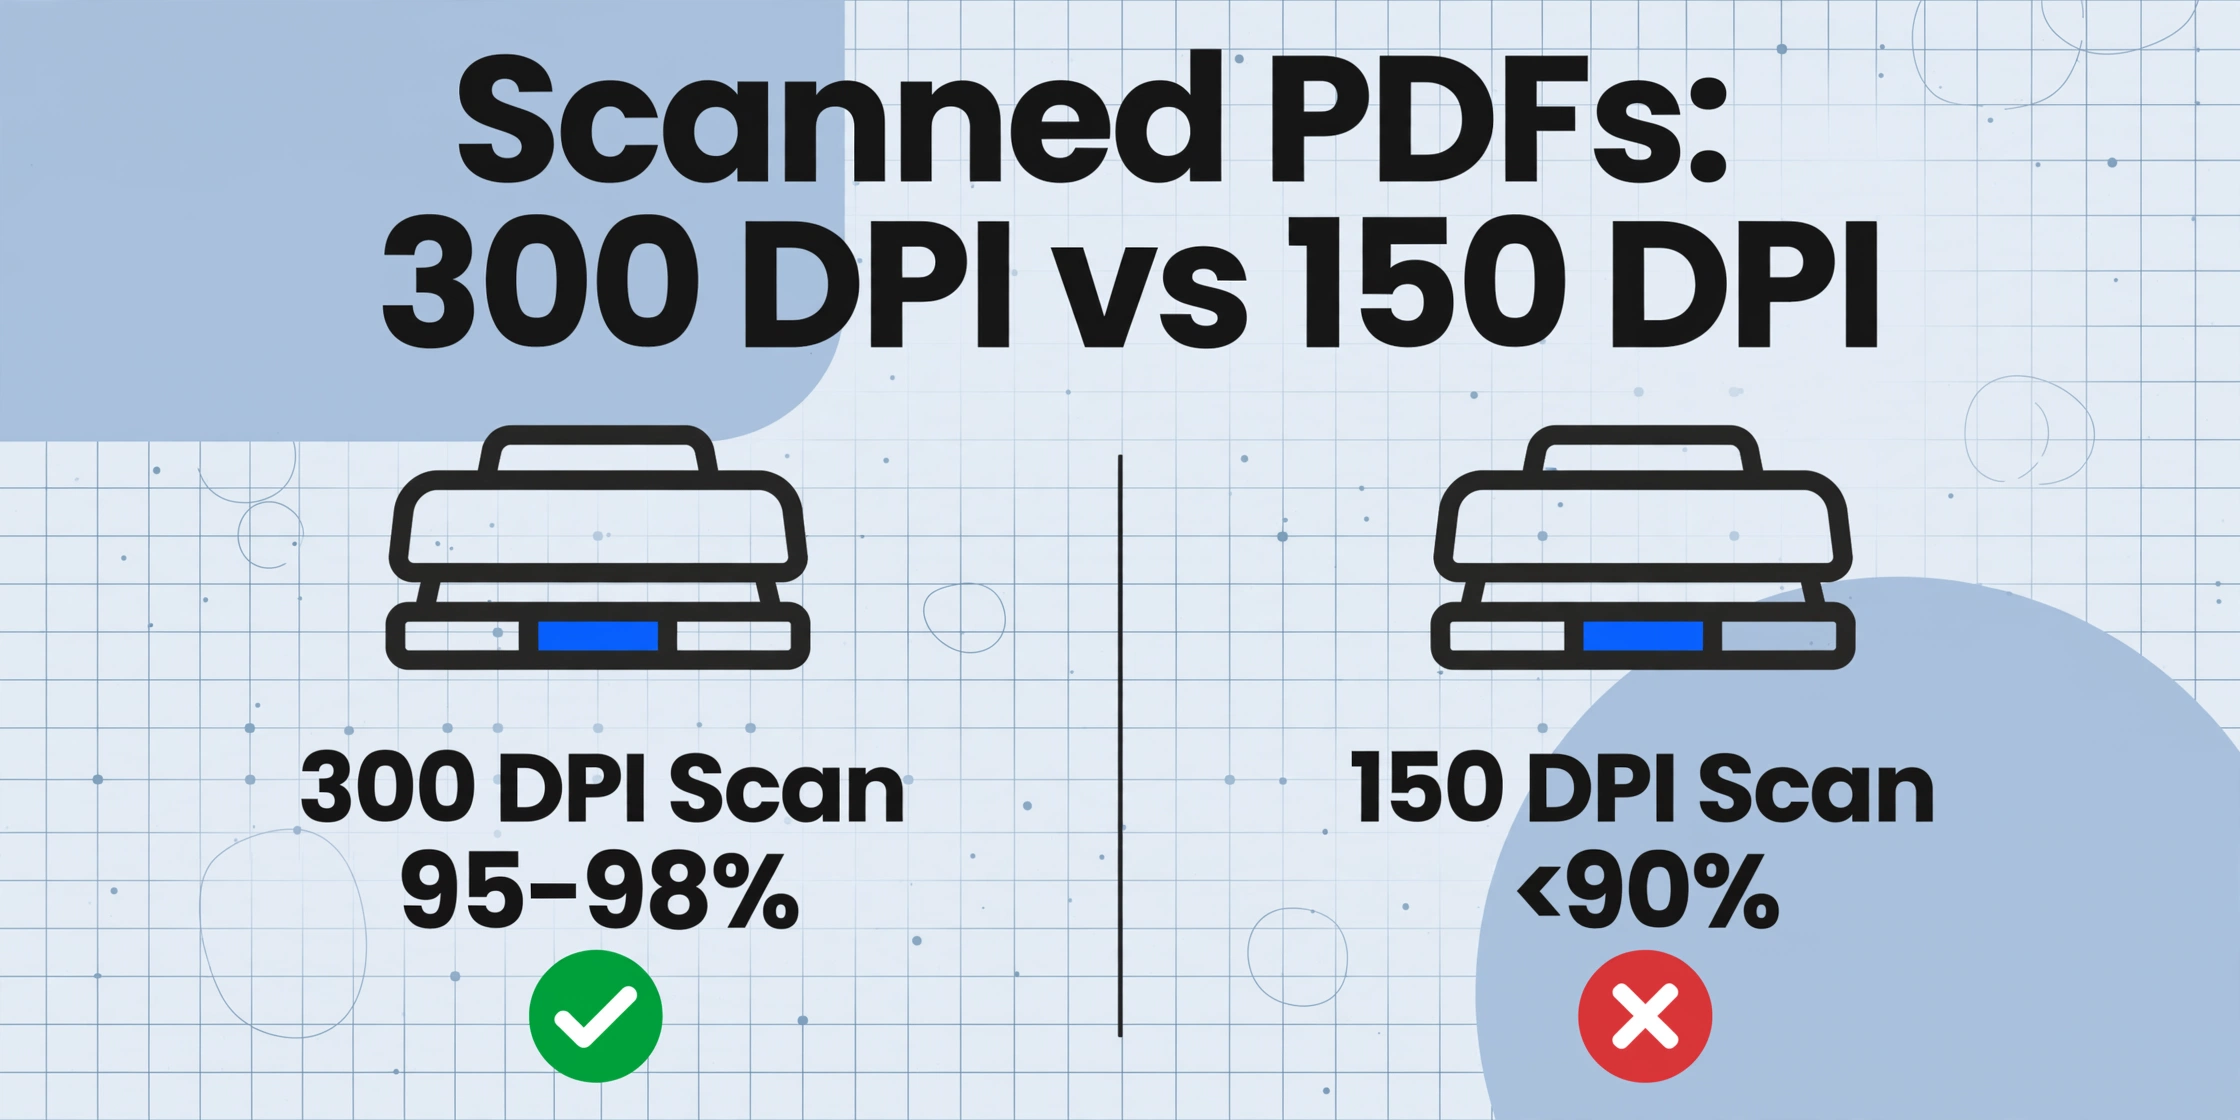
Uma boa digitalização a 300 DPI de texto impresso limpo ainda atinge 95-98% de precisão de caracteres. Uma digitalização de baixa qualidade a 150 DPI do mesmo documento pode cair abaixo de 90%.
Manuscrito — O Problema Fundamental de Limites
Texto manuscrito não é uma versão mais difícil do texto impresso. É um problema de reconhecimento fundamentalmente diferente. Caracteres impressos têm limites claros e consistentes — espaços entre letras, linhas de base uniformes, formas previsíveis. Um mecanismo de OCR segmenta uma palavra impressa em caracteres individuais usando esses espaços e depois compara cada forma com uma biblioteca. Isso funciona porque a pista de segmentação (o espaço) é confiável.
A caligrafia cursiva elimina esses limites por completo. As letras se conectam. O fim de um caractere é o início do próximo. Um "n" minúsculo seguido de um "i" pode parecer idêntico a um "u". Um "r" seguido de um "n" pode parecer um "m". O mecanismo não consegue segmentar a palavra porque os espaços foram deliberadamente eliminados pela escrita rápida.
Os números do setor confirmam isso. Os benchmarks da AIMultiple mostram que serviços tradicionais de OCR em nuvem que ultrapassam 99% em texto impresso caem para a faixa de 60-85% em manuscrito. Em cursiva difícil ou documentos mistos de impresso e manuscrito, a diferença pode chegar a 40 pontos percentuais ou mais. A escrita manual em estilo de imprensa — letras de forma maiúsculas — se sai melhor porque preserva os limites, mas introduz seu próprio problema: variabilidade infinita de formas. Duas pessoas não formam um "G" da mesma maneira, e qualquer biblioteca de correspondência de padrões tem pontos cegos. Para ferramentas projetadas para lidar com isso, consulte nossa comparação de OCR para manuscrito.
Fotos de Celular — Múltiplos Fatores de Degradação Combinados
Se documentos digitalizados degradam a precisão por dois ou três fatores, fotos de celular combinam cinco ou seis simultaneamente. A distorção de perspectiva é a mais destrutiva: a menos que o celular seja mantido perfeitamente paralelo ao documento — o que quase nunca acontece — a página é fotografada em ângulo, criando um trapézio em que os tamanhos dos caracteres e o espaçamento entre linhas variam de forma inconsistente pela imagem.
A variação de iluminação agrava o problema: um ponto brilhante no centro, sombras nas bordas, uma sombra sobre uma fileira de números que faz os caracteres parecerem se fundir. O desfoque de movimento, mesmo de um leve tremor de mão, borra as bordas dos caracteres em 1-2 pixels. Reflexos e brilho de papel brilhante podem apagar seções inteiras de texto por completo.
O efeito cumulativo é dramático. Uma ferramenta que atinge 99% em um PDF digital pode cair abaixo de 70% em uma foto de celular do mesmo documento. A informação está toda lá na página física, mas a imagem a degradou além do reconhecimento confiável.
Tabelas complexas e células mescladas — quando a estrutura entra em colapso
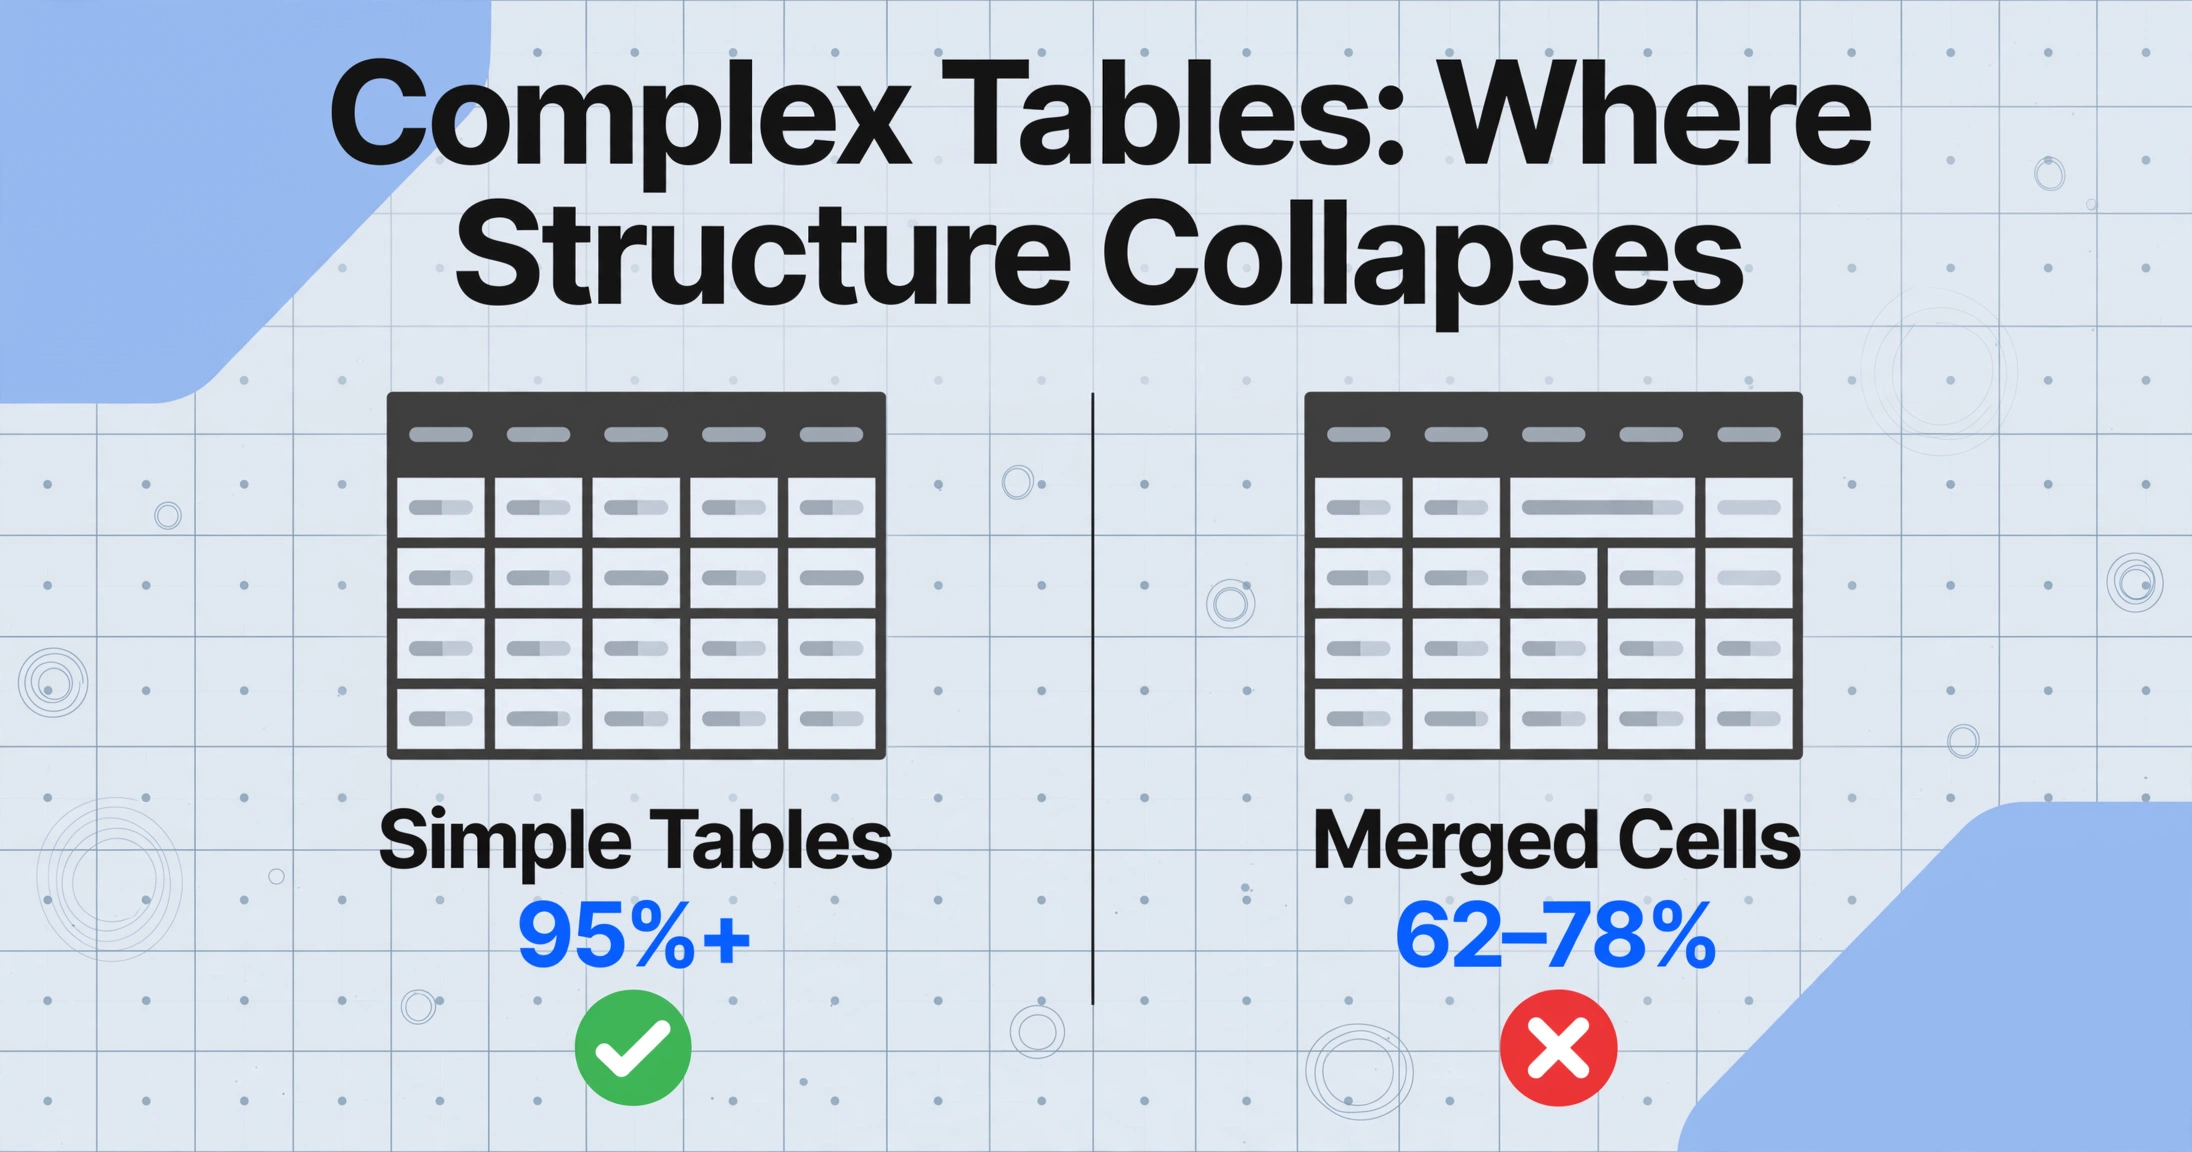
Tabelas apresentam um tipo diferente de desafio. Não se trata de ler caracteres — o OCR moderno consegue ler os números dentro das células razoavelmente bem. O problema é estrutural: o mecanismo precisa determinar a qual célula cada valor pertence, e isso exige entender a grade da tabela, não apenas seus caracteres. Células mescladas são o que mais quebra tudo. Um cabeçalho que abrange três colunas, uma célula de "Notes" que abrange duas linhas, um rótulo de subtotal mesclado ao longo da primeira coluna — esses padrões quebram a suposição linha a linha que a maioria dos mecanismos de OCR usa para reconstruir tabelas.
A pesquisa acadêmica confirma que este é um problema em aberto. Um estudo do arXiv de 2024 descobriu que até modelos especializados de extração de tabelas alcançam apenas 62-78% de precisão em tabelas complexas com células mescladas e estruturas irregulares — uma diferença de mais de 20 pontos abaixo do reconhecimento de tabelas simples. Tabelas aninhadas e tabelas de várias páginas, onde os cabeçalhos mudam de posição, elevam ainda mais as taxas de falha. A extração baseada em VLM lê tabelas semanticamente — ela consegue reconhecer que "Item Description" governa a coluna abaixo dele, independentemente de quantas células esse cabeçalho abrange. Para saber mais sobre como a precisão em nível de campo difere das métricas de caracteres, consulte nosso guia sobre o que a precisão do OCR realmente significa.
O Que Você Realmente Pode Controlar
Vários fatores de precisão estão sob seu controle, e resolvê-los costuma gerar ganhos maiores do que trocar de motor:
Preparação do documento. Digitalize a no mínimo 300 DPI — a resolução de OCR universalmente recomendada. Use tinta preta em papel branco para máximo contraste. Alise documentos dobrados ou enrugados antes de digitalizar; um vinco sobre uma linha de texto equivale a um dado ausente.
Escolha da ferramenta. O diferencial crítico é se a ferramenta usa OCR por correspondência de padrões (Tesseract, ABBYY clássico, a maioria das APIs de nuvem) ou extração por modelo de visão-linguagem (ImageToTable.ai e serviços mais recentes baseados em LLM). Ferramentas baseadas em VLM leem documentos semanticamente — podem usar o contexto ao redor para resolver caracteres ambíguos. Um dígito borrado entre um cifrão e ".00" é quase certamente um 9, não um 8 — um VLM consegue fazer essa inferência; um motor de OCR baseado em pixels, não.
Validação pós-processamento. Incorpore expectativas de formato ao seu fluxo de trabalho: um número de fatura segue um padrão, uma data segue um calendário, um total é um número positivo. Quando os dados extraídos violam um padrão, sinalize para revisão — não porque a ferramenta é ruim, mas porque certos tipos de documento sempre produzem resultados incertos. Regras como "O total deve ser igual à soma dos itens ± 0,01" capturam os erros que mais importam sem revisar cada campo.
Como Ler as Alegações de Precisão dos Fornecedores
Todo fornecedor de OCR publica números. Veja como lê-los:
Pergunte qual tipo de documento foi testado. Se o fornecedor não especificar, presuma o tipo mais fácil disponível. Pergunte qual métrica foi usada. A precisão em nível de caractere (CER) é a mais tolerante. A precisão em nível de campo — se cada dado extraído está completamente correto — determina se seu fluxo de trabalho funciona. Uma ferramenta com 99% de CER pode ter 80% de precisão em nível de campo no mesmo documento, como explicado em nosso guia de métricas de precisão de OCR. Pergunte sobre a distribuição dos erros. Se os erros se concentram em números, códigos e identificadores — o que costuma acontecer, pois são os caracteres mais parecidos entre si para motores de OCR — a mesma taxa de erro pode ser catastrófica. Teste com seus próprios documentos. Três dos seus documentos mais difíceis, cinco minutos de teste, dirão mais do que qualquer benchmark publicado.
Perguntas frequentes
Por que a precisão do OCR cai tanto em textos manuscritos?
O OCR tradicional funciona segmentando o texto em caracteres individuais. A escrita cursiva elimina os espaços dos quais a segmentação depende — as letras se conectam, então o mecanismo não consegue determinar onde um caractere termina e o próximo começa. Esse é um problema estrutural, não um problema de qualidade. Até digitalizações em resolução perfeita de escrita cursiva produzem precisão menor do que digitalizações medíocres de texto impresso.
Qual é a melhor resolução para digitalizar documentos para OCR?
300 DPI é o padrão do setor. Abaixo de 200 DPI, a precisão cai de forma mensurável, pois as bordas dos caracteres ficam grossas demais para uma segmentação confiável. Acima de 600 DPI, o tamanho dos arquivos aumenta sem ganhos adicionais de precisão.
Ferramentas de OCR baseadas em IA conseguem lidar com tipos de documento que o OCR tradicional não consegue?
Ferramentas de modelo de linguagem visual (VLM) lidam com uma variedade maior de tipos de documento porque leem semanticamente, e não pixel a pixel. Elas usam o contexto para resolver caracteres ambíguos e mantêm a percepção estrutural de tabelas e células mescladas. No entanto, nenhuma ferramenta alcança precisão igual em todos os tipos, e entradas de qualidade muito ruim degradam qualquer sistema.
O formato do documento (PDF vs JPG vs PNG) afeta a precisão do OCR?
O formato importa menos do que o que está nele. Um PDF digital com texto incorporado não precisa de OCR — o texto já é legível por máquina. Um PDF digitalizado e um JPG do mesmo documento produzem precisão equivalente em resolução e compressão iguais.
Por que minha ferramenta de OCR funciona bem em faturas, mas falha em notas de entrega?
Esse é um problema de estrutura. As faturas seguem layouts previsíveis de chave-valor. As notas de entrega costumam usar tabelas complexas com células mescladas, alturas de linha irregulares e células de várias linhas — padrões estruturais que o OCR tradicional lida mal. O mecanismo não mudou; o documento cruzou um limite estrutural que a ferramenta não consegue analisar.
O pré-processamento pode melhorar a precisão do OCR em tipos de documento difíceis?
O pré-processamento básico — correção de inclinação, conversão para escala de cinza, limiarização adaptativa — pode melhorar a precisão em 5-15% em documentos digitalizados e fotos de celular. Mas não vai fechar a lacuna em escrita manuscrita ou tabelas complexas, porque esses são problemas de reconhecimento estrutural, não de qualidade de imagem.