なぜOCR精度が低下するのか:
手書き文字、スキャンPDF、表―そして対策
OCRベンダーが「精度99%」と言うとき、それはほぼ常に、きれいな印刷された英語テキストに対する文字レベルでの精度を指しています。仕入先が手書きで記入した納品書の合計金額が正しく読み取れるかどうかではありません。その数字は本物ですが、細かい条件付きです。良い結果が出るように選ばれた文書で測定されたものです。机の上で撮影したくしゃくしゃのレシート、ファックスで送られたスキャン済み契約書、ボールペンで記入されたフォームに置き換えると、同じツールでも精度は60%や40%、あるいはそれ以下に落ちます。精度の低下はランダムに起こるのではなく、どんな種類の文書を入力するかによって予測可能な形で起こります。そのパターンを理解することが、正しいツールを選ぶか、間違ったツールを非難するかの違いを生みます。
重要なポイント
- OCRベンダーは99%の精度について嘘をついているわけではありません。ただし、その数字はきれいなデジタルPDFからのものであり、手書き文字、スマホの写真、複雑な表に置き換えると、同じエンジンでも60%以下に低下します。
- 低下はランダムではなく予測可能です。筆記体はセグメンテーションが依存する文字間のギャップをなくし、スマホの写真は5つの同時歪みを複合させ、結合された表のセルはピクセルレベルのエンジンでは解決できない構造的な曖昧さを生み出します。
- 視覚言語モデルは意味的に読み取ります。「$」と「.00」の間の汚れた数字が8ではなく9であると推論します。これは筆記体や表のセルが読み取れるのと同じ仕組みです。ご自身の最も読みにくい文書3つでテストしてみてください。
OCR精度に関する誤解
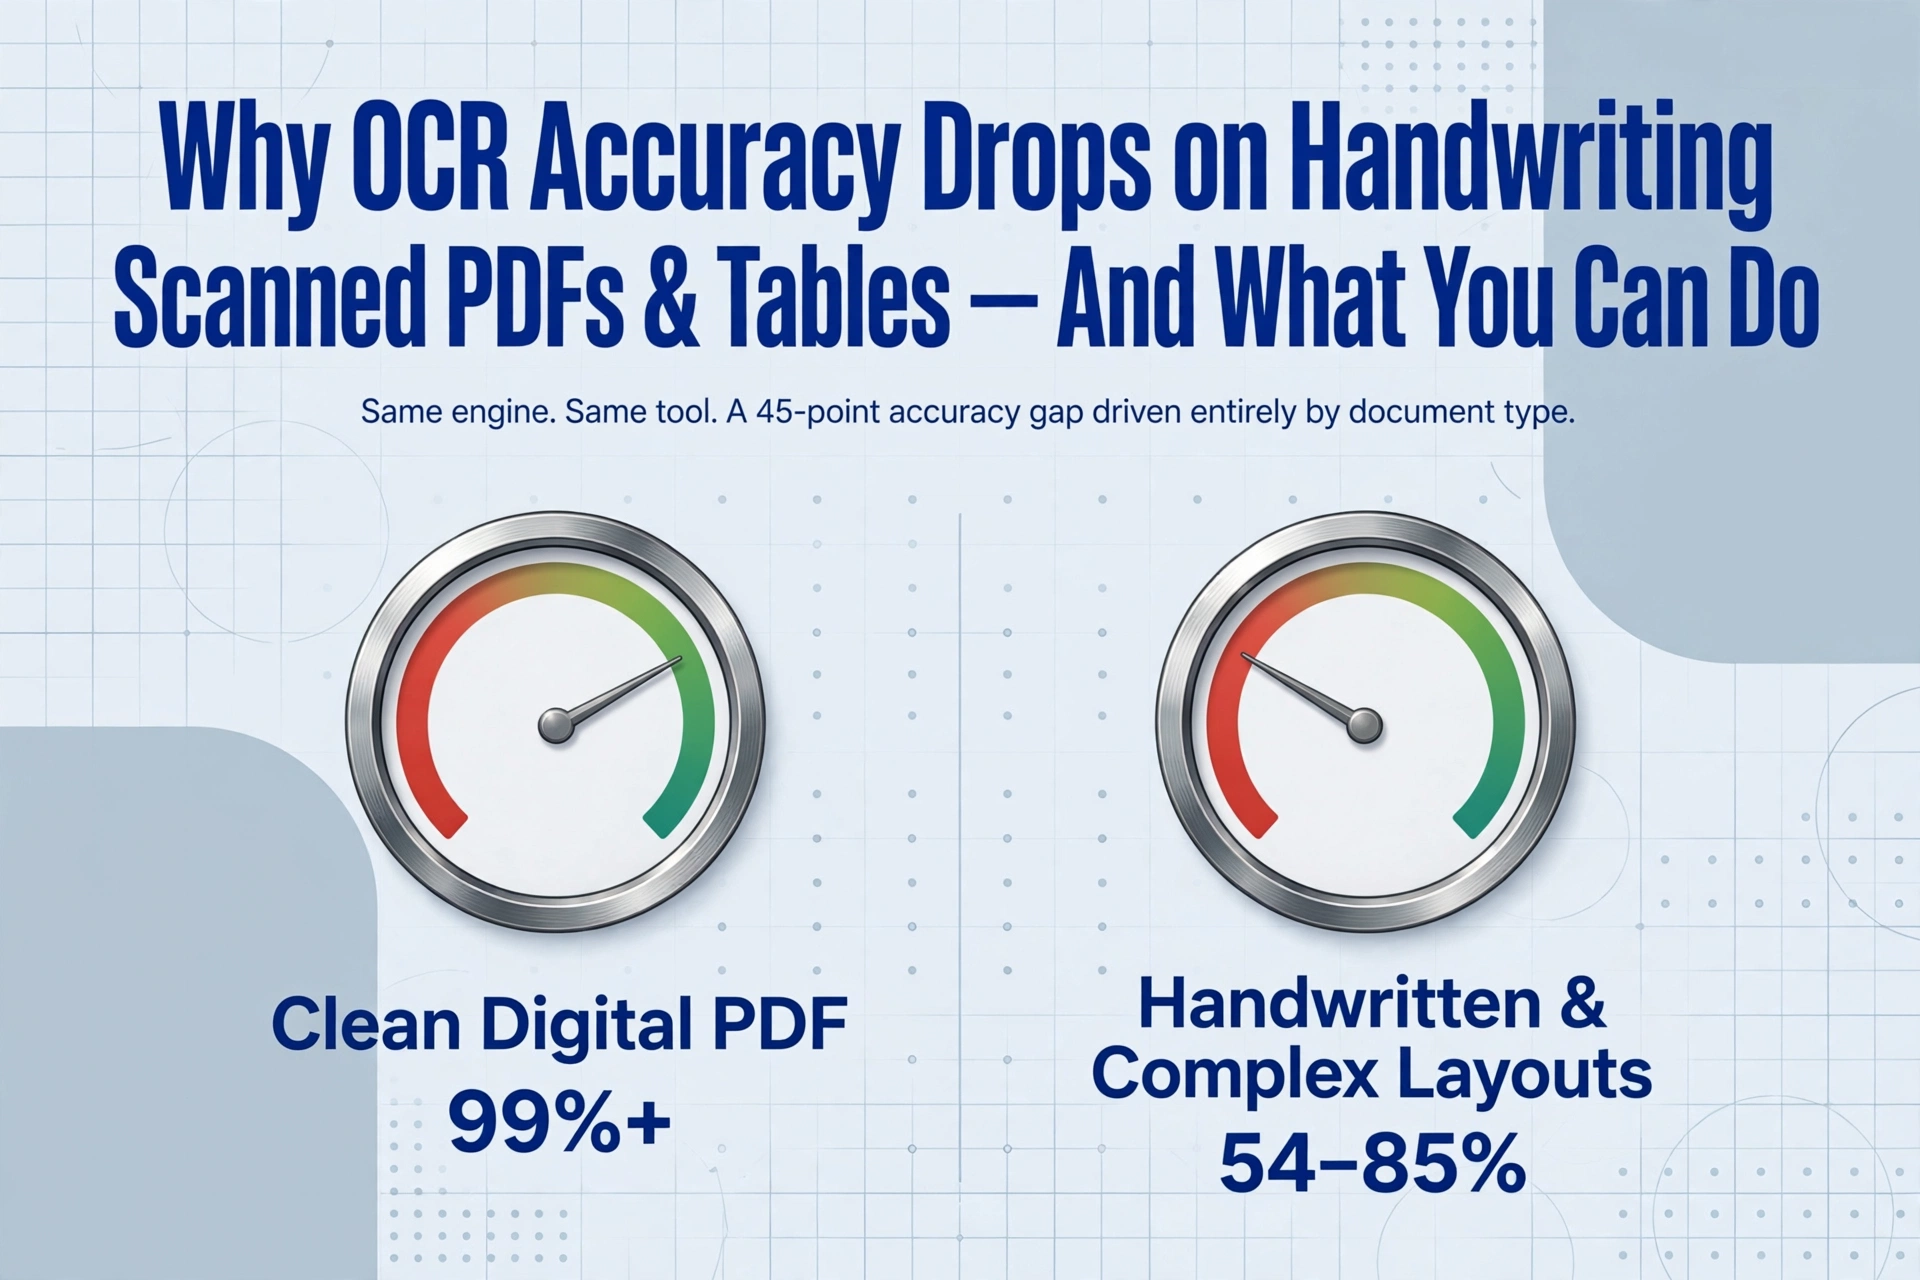
市場のOCRツールはすべて高い精度を謳っています。Tesseract、Google Cloud Vision、Amazon Textract — いずれも95〜99%の数値を公表しています。AIMultiple OCRベンチマークは、主要なクラウドOCRサービスがカテゴリ1の文書(クリーンで高コントラストな背景の活字文書)で99.2%を超えることを確認しています。しかし、同じベンチマークは別の事実も明らかにしています。カテゴリ3(手書き文字や複雑なレイアウトの文書)では、精度は54%から85%にまで低下します。同じツール、同じエンジンなのに、45ポイントもの差が生じるのは、入力される文書の種類によって完全に左右されるからです。
基本ケース — クリーンなデジタルPDF
クリーンなデジタルPDF — 会計ソフトから書き出した請求書、Wordから保存した契約書、Webポータルからダウンロードした銀行明細書 — は、あらゆるOCRシステムにとって理想的な入力です。文字は鮮明で、フォントは標準的で、コントラストもほぼ完璧です。このような文書では、最新のOCRエンジンは文字精度99%を日常的に超えます。残るエラーは通常、特殊な合字、非常に小さなフォントサイズ(6pt未満)、ヘッダーの装飾文字などのエッジケースに限られます。これが「99%の精度」という主張を支えるシナリオであり、他のすべての文書タイプが測定可能な精度低下を示す基準点でもあります。
スキャンPDF — 品質低下の始まり
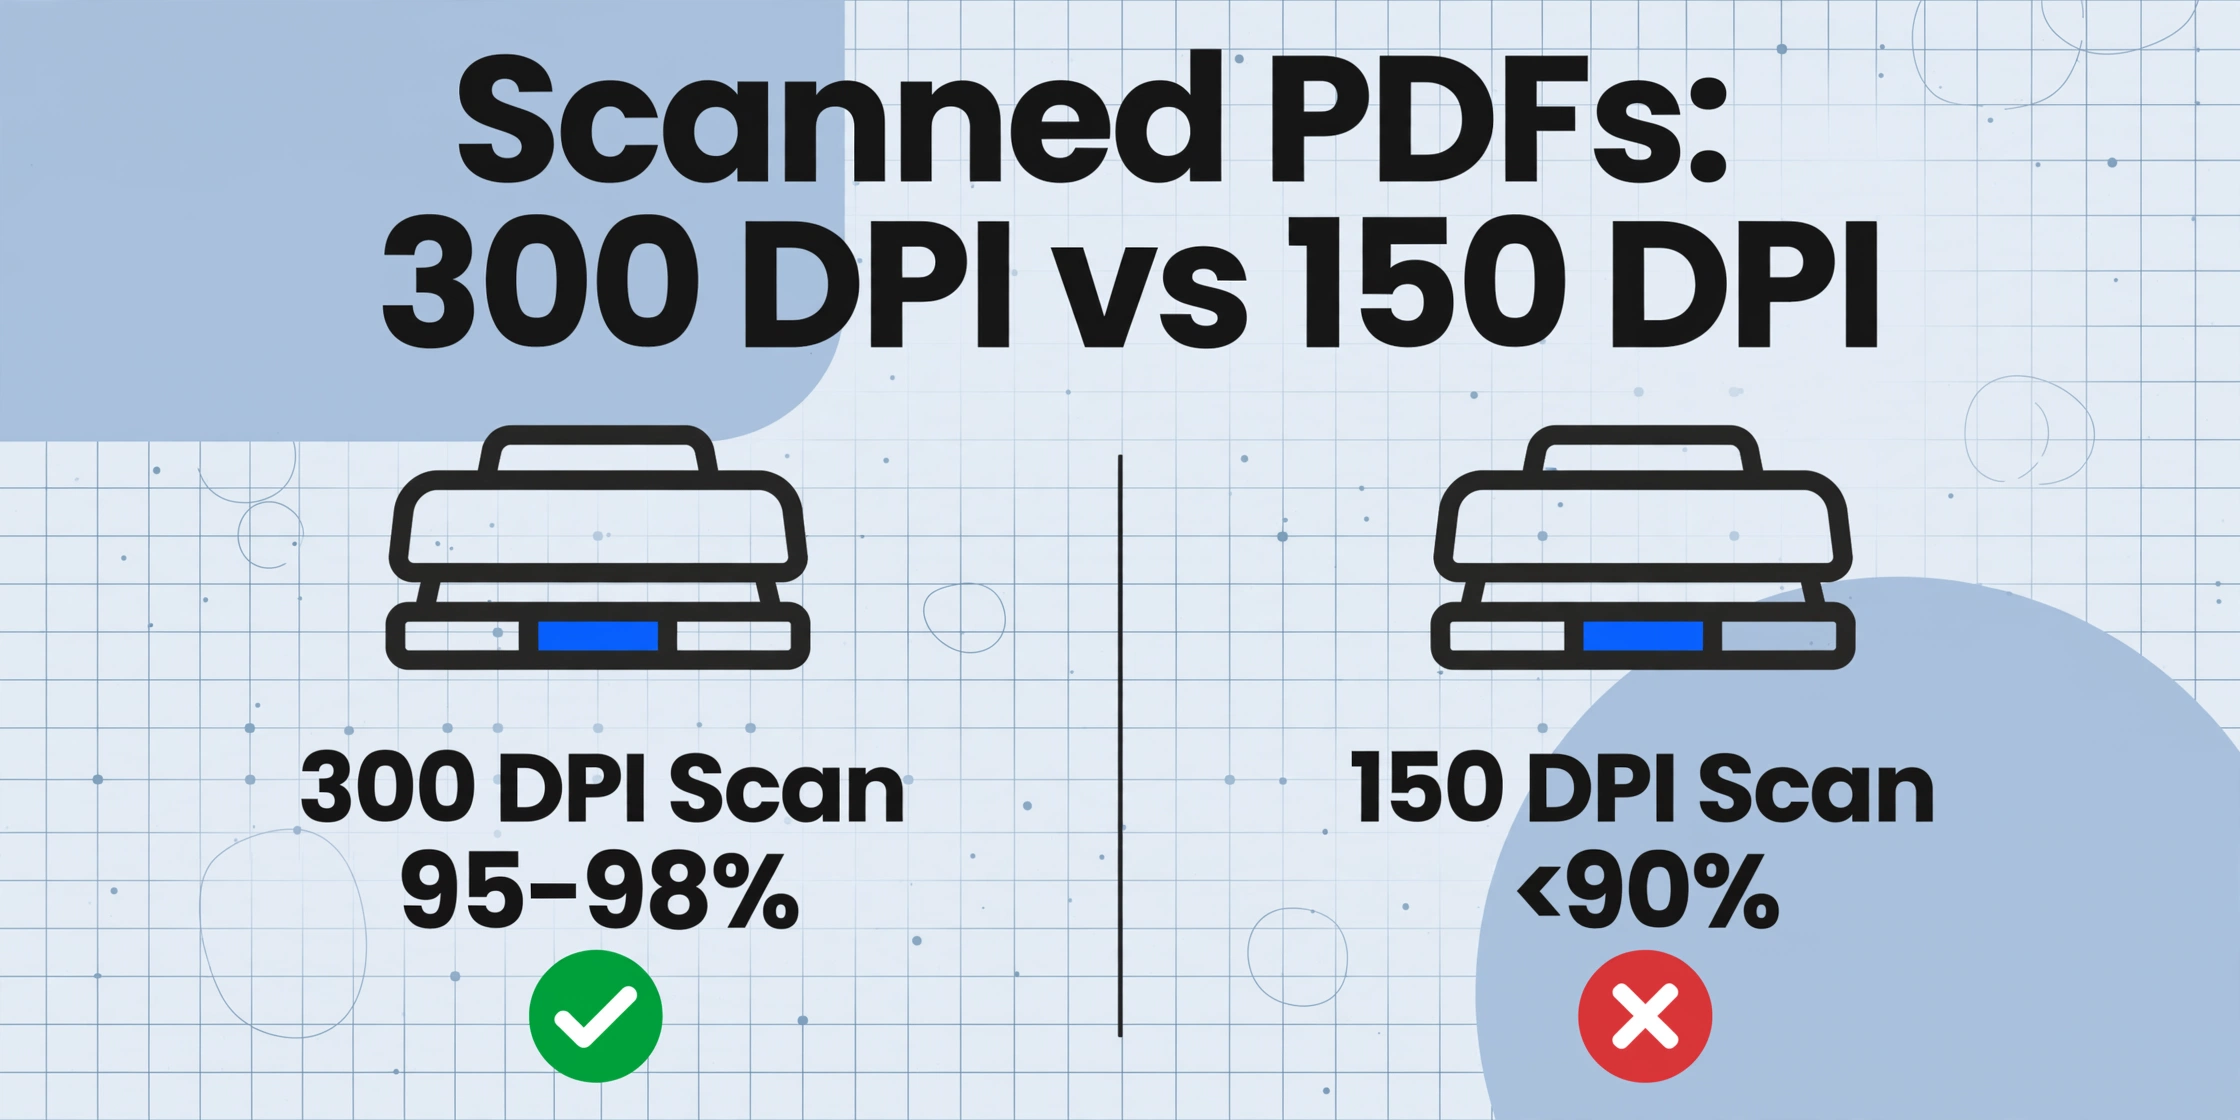
スキャンPDFは印刷ページの写真であり、その画像にはデジタルPDFにはない複数のエラー要因が含まれます。解像度の低下が最初の要因です。200 DPIでスキャンすると、10ポイントの文字に対してエンジンは約8ピクセルの高さしか得られません。バッチスキャンで一般的な150 DPIに下げると、同じ文字はわずか6ピクセルの高さになります。エンジンはわずかなピクセルからストロークを推測しなければなりません。
ノイズとアーティファクトもさらに別の層を追加します。スキャナのセンサーは粒子状のノイズを生み出し、紙の質感(新聞紙、感熱紙、再生紙)はエンジンが文字の一部と誤解釈するパターンを追加します。傾き — わずか2〜3度の傾きでも — エンジンは文字を分割する前に回転補正を強いられ、エラー率が測定可能なほど増加します。そして重なり合うコンテンツ — 印字テキストの上にあるスタンプ、署名、透かし — は、ピクセルレベルのOCRでは解決できない曖昧さを生み出します。請求書の合計金額に「PAID」スタンプが押されると、両方とも判読不能になります。
クリーンな印刷テキストの300 DPIスキャンは、依然として95〜98%の文字精度を達成します。同じ文書の低品質な150 DPIスキャンでは、90%を下回る可能性があります。
手書き文字 — 根本的な境界問題
手書き文字は、印刷文字のより難しいバージョンではありません。これは根本的に異なる認識問題です。印刷文字には明確で一貫した境界があります — 文字間の隙間、均一なベースライン、予測可能な形状。OCRエンジンは、その隙間を使って印刷された単語を個々の文字に分割し、各形状をライブラリと照合します。これは、セグメンテーションの手がかり(隙間)が信頼できるため機能します。
筆記体の手書き文字は、それらの境界を完全に取り除きます。文字はつながります。ある文字の終わりは次の文字の始まりです。小文字の「n」に「i」が続くと、「u」と見分けがつかないことがあります。「r」に「n」が続くと「m」のように見えることがあります。エンジンは単語を分割できません。なぜなら、素早く書くことによって隙間が意図的に排除されているからです。
業界の数字がこれを裏付けています。AIMultipleのベンチマークによると、印刷文字で99%を超える従来のクラウドOCRサービスは、手書き文字では60〜85%の範囲に落ち込みます。乱雑な筆記体や印刷と手書きが混在したドキュメントでは、その差は40ポイント以上に達することがあります。印刷スタイルの手書き文字 — ブロック体の大文字 — は境界が保たれるため良好ですが、独自の問題を引き起こします:無限の形状のばらつきです。同じ「G」を書く人は二人といません。パターンマッチングライブラリには死角があります。これらを処理するように設計されたツールについては、手書きOCR比較をご覧ください。
スマホ写真 — 複数の劣化要因が組み合わさる
スキャンしたドキュメントが2〜3つの要因で精度を低下させるなら、スマホ写真は5〜6つを同時に組み合わせます。遠近歪みが最も破壊的です:スマホがドキュメントに対して完全に平行に保持されない限り — これはほとんど起こりません — ページは斜めから撮影され、文字サイズや行間隔が画像全体で一貫せず変化する台形が生じます。
照明のばらつきが問題を悪化させます:中央の明るいスポット、端の影、数字の行を横切る影で文字が融合して見えることがあります。モーションブラーは、わずかな手の震えでも文字のエッジを1〜2ピクセルぼかします。反射とグレアは、光沢紙からテキストのセクション全体を完全に白飛びさせることがあります。
累積的な影響は劇的です。デジタルPDFで99%を達成するツールでも、同じドキュメントのスマホ写真では70%を下回ることがあります。情報はすべて物理的なページに存在しますが、画像が信頼できる認識を超えて劣化させてしまっています。
複雑なテーブルと結合セル — 構造が崩れるとき
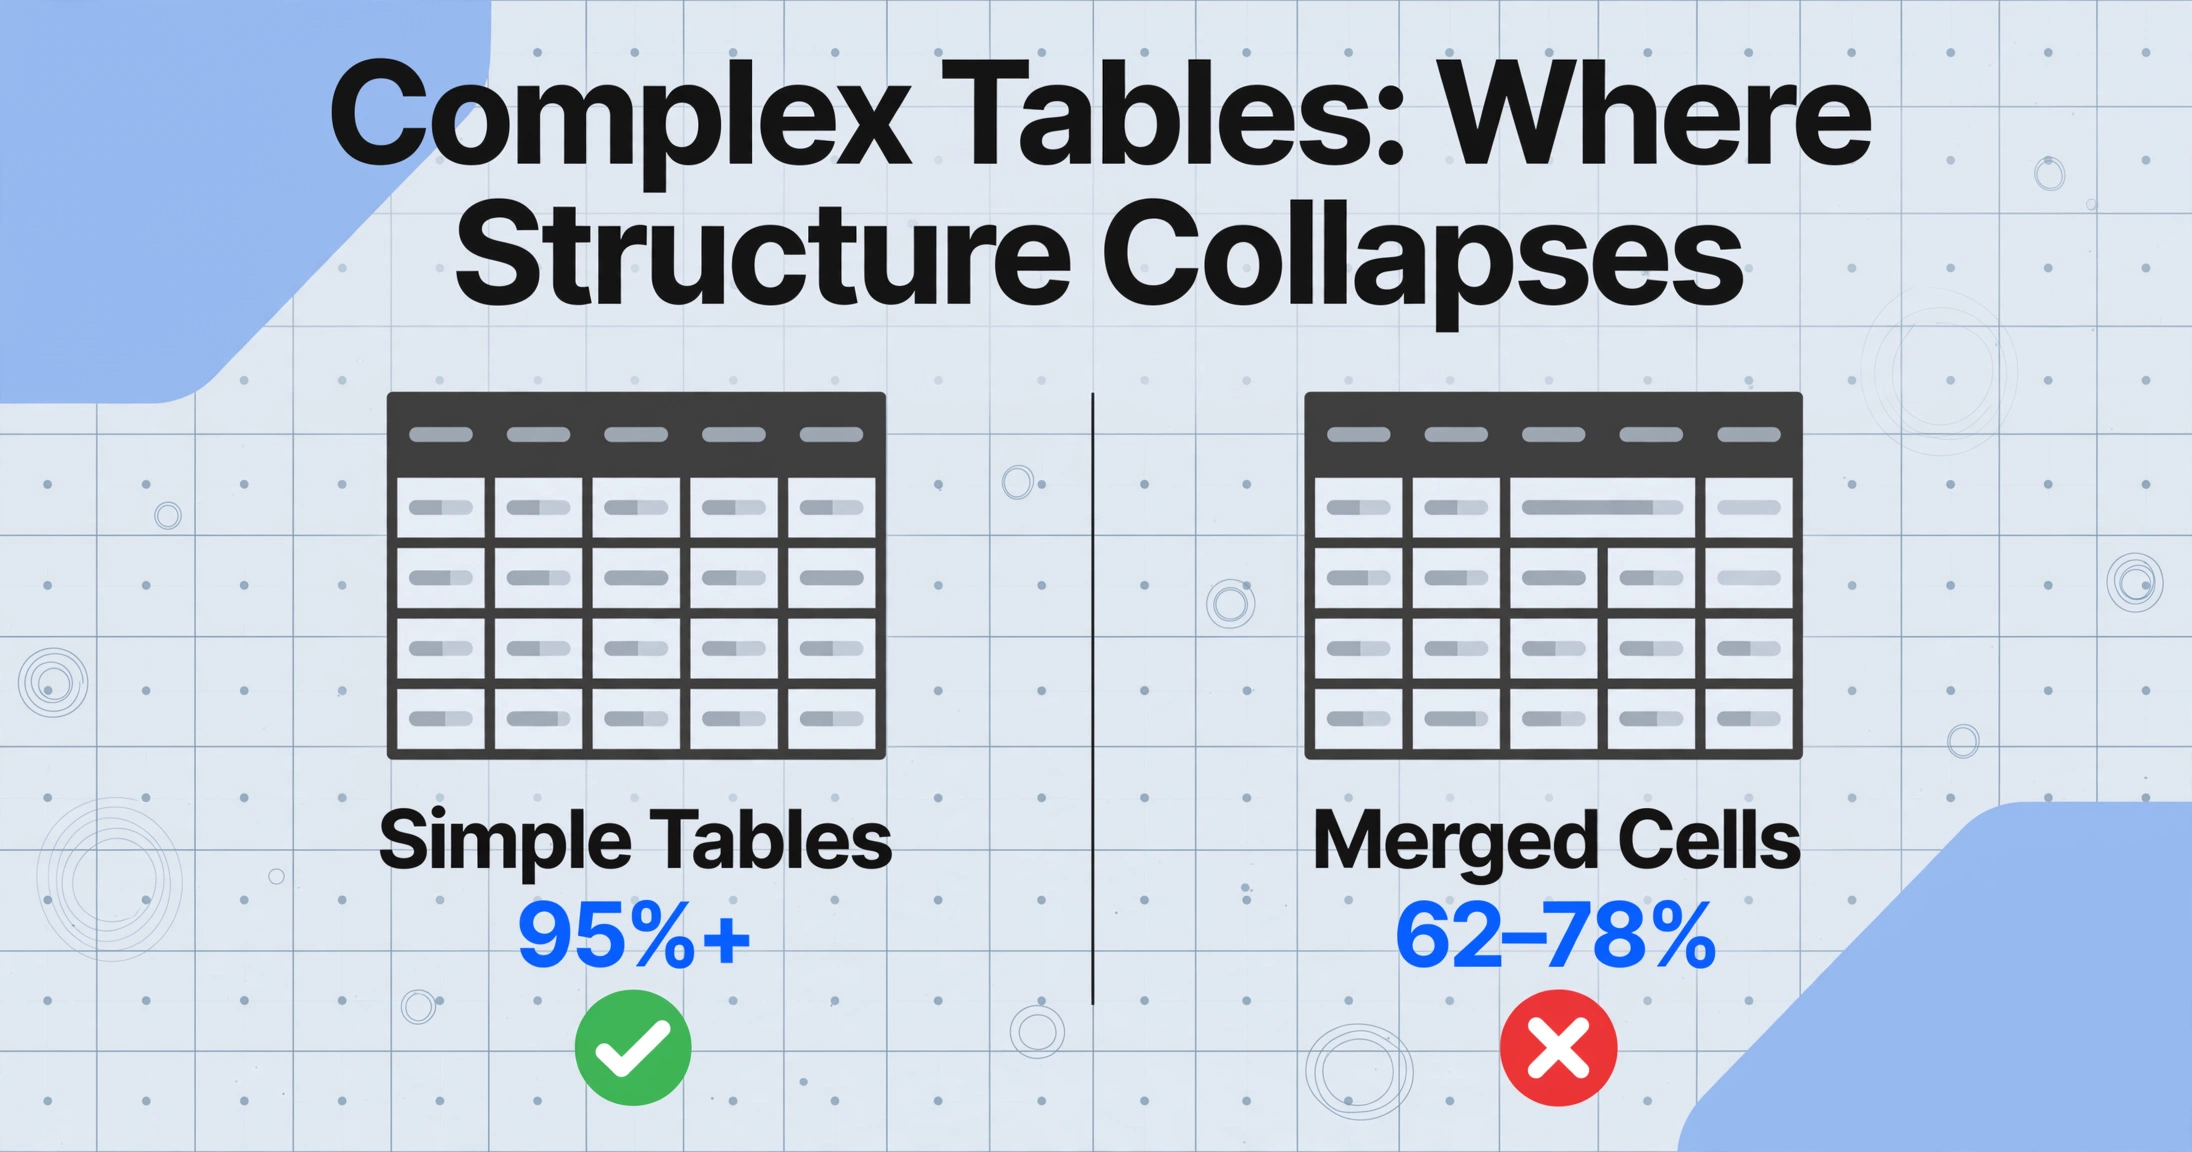
テーブルは別種の課題を提起します。文字を読むことではありません — 最新のOCRはセル内の数字をかなり正確に読むことができます。問題は構造的なものです。エンジンは各値がどのセルに属するかを判断する必要があり、それにはテーブルのグリッドを理解することが求められます。文字だけでは不十分です。結合セルは最も一般的な破綻要因です。3列にまたがるヘッダー、2行にまたがる「Notes」セル、最初の列にマージされる小計ラベル — これらのパターンは、ほとんどのOCRエンジンがテーブルを再構築する際に使用する行ごとの前提を崩します。
学術研究はこれが未解決の問題であることを裏付けています。2024年のarXiv研究では、専門のテーブル抽出モデルでも、結合セルや不規則な構造を持つ複雑なテーブルでは62〜78%の精度しか達成できず、単純なテーブル認識よりも20ポイント以上低いことが判明しました。ヘッダー位置が変わるネストされたテーブルや複数ページのテーブルでは、失敗率がさらに高くなります。VLMベースの抽出はテーブルを意味的に読み取ります — ヘッダーがいくつのセルにまたがっていても、「Item Description」がその下の列を支配していることを認識できます。フィールドレベルの精度が文字指標とどう異なるかについては、OCR精度が実際に意味するものに関するガイドをご覧ください。
実際に制御できる要素
精度に影響する要素のいくつかはユーザー側で制御可能であり、それらに対処することでエンジンを切り替えるよりも大きな改善が得られることがよくあります。
ドキュメントの準備。最低300 DPIでスキャンしてください。これは広く推奨されるOCR解像度です。最大のコントラストを得るために、白い紙に黒いインクを使用してください。折り目やしわのあるドキュメントはスキャン前に平らにしてください。テキストの行を通る折り目は、データの欠落と同じことです。
ツールの選択。重要な違いは、ツールがパターンマッチングOCR(Tesseract、従来のABBYY、ほとんどのクラウドAPI)を使用するか、ビジョン言語モデルによる抽出(ImageToTable.aiおよび新しいLLM搭載サービス)を使用するかです。VLMベースのツールはドキュメントを意味的に読み取ります。周囲の文脈を利用して曖昧な文字を解決できます。ドル記号と「.00」の間の汚れた数字は、ほぼ確実に8ではなく9です。VLMはその推論ができますが、ピクセルベースのOCRエンジンにはできません。
後処理の検証。ワークフローに形式の期待値を組み込んでください。請求書番号はパターンに従い、日付はカレンダーに従い、合計は正の数値です。抽出データがパターンに違反する場合は、レビュー用にフラグを立ててください。ツールが悪いからではなく、特定のドキュメントタイプは常に不確実な結果を生み出すからです。「合計は明細項目の合計±0.01に等しくなければならない」のようなルールは、すべてのフィールドをレビューすることなく、最も重要なエラーを捕捉します。
ベンダーの精度主張の読み方
すべてのOCRベンダーが数値を公表しています。その読み方は以下のとおりです。
テストされたドキュメントタイプを確認してください。ベンダーが指定しない場合は、最も簡単なタイプが使用されたと想定してください。使用された指標を確認してください。文字レベルの精度(CER)は最も寛容な指標です。フィールドレベルの精度(抽出された各データポイントが完全に正しいかどうか)が、ワークフローが機能するかどうかを決定します。CERが99%のツールでも、同じドキュメントでフィールドレベルの精度が80%になる可能性があります。詳細はOCR精度指標ガイドで説明しています。エラーの分布を確認してください。エラーが数字、コード、識別子に集中する場合(OCRエンジンにとって最も似ている文字であるため、よく発生します)、同じエラー率でも壊滅的な結果になる可能性があります。自社のドキュメントでテストしてください。最悪のケースのドキュメント3件と5分間のテストは、公開されたベンチマークよりも多くの情報をもたらします。
FAQ
手書き文字でOCR精度が大きく低下するのはなぜですか?
従来のOCRはテキストを個々の文字に分割して認識します。筆記体では分割の前提となる文字間の隙間がなくなり、文字が連結するため、エンジンは文字の境界を特定できません。これは画質の問題ではなく構造的な問題です。解像度が完璧な筆記体スキャンでも、印刷物の平凡なスキャンより精度が低くなります。
OCR用文書スキャンの最適な解像度は?
300 DPIが業界標準です。200 DPI未満では文字の輪郭が粗くなり分割が不安定になるため、精度が顕著に低下します。600 DPIを超えると、精度向上なしにファイルサイズだけが増加します。
AIベースのOCRツールは従来のOCRが処理できない文書タイプに対応できますか?
視覚言語モデル(VLM)ツールは、ピクセル単位ではなく意味的に読み取るため、より広範な文書タイプに対応できます。文脈を利用して曖昧な文字を解決し、表や結合セルの構造認識を維持します。ただし、全タイプで同等の精度を達成するツールはなく、品質の低い入力はどのシステムも劣化させます。
文書形式(PDF vs JPG vs PNG)はOCR精度に影響しますか?
形式よりも内容が重要です。テキストが埋め込まれたデジタルPDFはOCR不要です。スキャンPDFと同一文書のJPGは、同じ解像度と圧縮率であれば同等の精度を生み出します。
請求書ではうまく機能するOCRツールが納品書では失敗するのはなぜですか?
これは構造の問題です。請求書は予測可能なキーと値のレイアウトに従います。納品書は結合セル、不規則な行高、複数行セルを含む複雑な表を使用することが多く、従来のOCRが苦手とする構造パターンです。エンジンは変わっていません。文書がツールが解析できない構造的しきい値を超えたのです。
前処理は難しい文書タイプのOCR精度を向上できますか?
基本的な前処理(傾き補正、グレースケール変換、適応的二値化)は、スキャン文書やスマホ写真で精度を5〜15%向上できます。ただし、手書き文字や複雑な表のギャップは埋められません。これらは画質の問題ではなく構造認識の問題だからです。