Precisión de OCR por campo:
95% en general, 60% en los campos que importan
«95% de precisión» es el número con el que la mayoría de las herramientas de OCR encabezan su propuesta. Pero cuando procesas un lote de 200 facturas y aun así pasas la tarde del martes corrigiendo manualmente los campos extraídos, esa afirmación del 95% empieza a sentirse como un error de redondeo a favor de otro. La razón no es que el número sea falso. Es que la precisión nunca es uniforme entre los tipos de campo — y los campos que el OCR falla son desproporcionadamente los que tus sistemas posteriores realmente necesitan. Este artículo mide la brecha campo por campo, explica por qué cada tipo de campo falla de manera diferente y muestra cuánto cuesta corregir cada uno.
Conclusiones clave
- Tu OCR reporta un 95% de precisión mientras cae silenciosamente al 60% en los tres tipos de campo que tu sistema contable no puede funcionar sin ellos.
- Cinco tipos de campo diferentes fallan por cinco razones completamente distintas — y mejorar la resolución de escaneo no soluciona exactamente ninguno de ellos.
- Reemplaza el número de precisión del panel con una métrica — tiempo de corrección por tipo de campo — y usa ImageToTable.ai para abordar cada modo de fallo en su raíz estructural en lugar de su síntoma superficial.
El problema del «95 % de precisión»
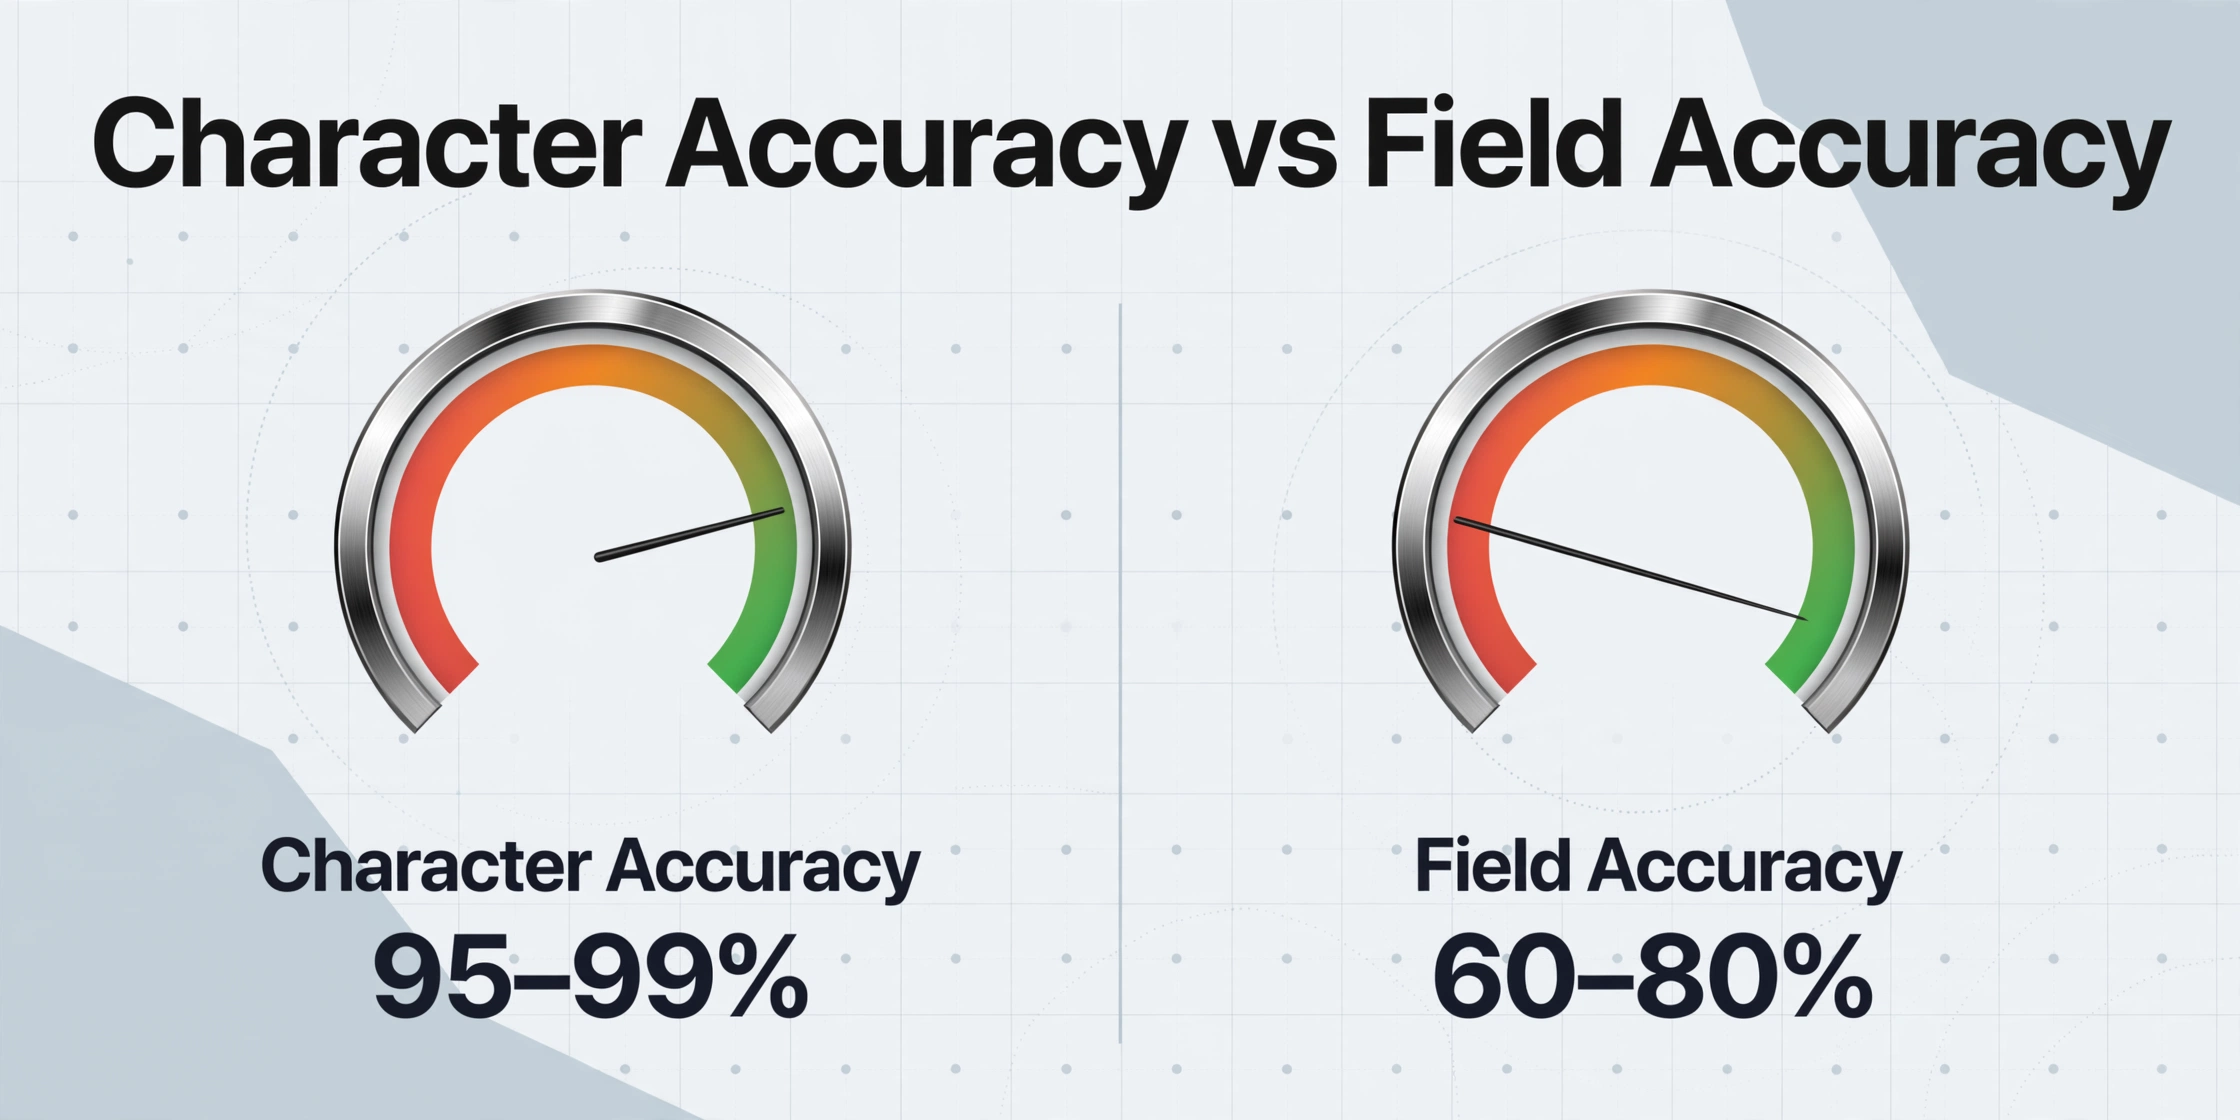
Los motores OCR tradicionales se miden por su precisión a nivel de caracteres: el porcentaje de caracteres individuales reconocidos correctamente a partir de la imagen de un documento. Tesseract 5, el referente de código abierto mantenido por Google, alcanza un 95 % de precisión de caracteres en documentos impresos limpios. Motores empresariales como ABBYY FineReader llegan al 97–99 % en condiciones de laboratorio. Son cifras reales medidas sobre conjuntos de prueba reales.
Pero la precisión de caracteres es un indicador deficiente de lo que las empresas realmente necesitan: campos de datos completos y correctos. Un solo dígito mal leído en un número de factura de 10 dígitos invalida todo el campo. Una precisión de caracteres del 99 % en una página de 1000 caracteres significa que 10 caracteres son incorrectos; y si esos 10 caracteres erróneos caen dentro de 3 de sus 15 campos objetivo, la precisión a nivel de campo cae al 80 %. TDWI documentó exactamente este escenario en pipelines de OCR en producción: el panel muestra 99 %, pero 1 de cada 5 campos de negocio extraídos contiene un error.
Lo que agrava esto es que los errores no se distribuyen de manera uniforme. El OCR tradicional acierta casi siempre en algunos tipos de campo. Otros fallan tan gravemente que la extracción es como si no hubiera ocurrido. El problema es que los campos con más probabilidad de fallar —importes en dólares en las partidas, fechas escritas a mano, datos estructurados en tablas— son también los campos donde un error resulta más costoso de corregir.
Fechas y Números Impresos: Lo que el OCR Hace Bien
En documentos impresos, limpios y de alto contraste, el OCR tradicional maneja bien las fechas y los montos en dólares en posiciones estándar. Una fecha de factura impresa como «06/09/2026» en Arial de 11 pt sobre fondo blanco a 300 DPI se procesará con una precisión de caracteres casi perfecta. Un monto total impreso como «$1,234.56» en la esquina inferior derecha, posicionado de manera consistente en las facturas de un proveedor, se extrae de forma fiable cuando se combina con una plantilla bien mantenida.
Estos son los campos que producen los números del 95–99% que citan los proveedores de OCR. Representan el mejor escenario posible: fuentes estandarizadas, posiciones predecibles y alto contraste. Aquí es donde el OCR tradicional realmente funciona.
Las grietas aparecen en cuanto varían los formatos. Una fecha escrita como «09/06/2026»: ¿es el 9 de junio (EE. UU.) o el 6 de septiembre (Reino Unido)? El OCR tradicional no tiene mecanismo para detectar la diferencia; lee los dígitos fielmente, y el sistema posterior adivina o usa por defecto el formato estadounidense. Un usuario de Reddit que construía un pipeline de facturas europeas en Python documentó exactamente este problema: las facturas italianas usan 31/12/2024, las alemanas usan 31.12.2024 y las británicas usan 31/12/2024 (misma sintaxis, diferente orden de día/mes). Sin una normalización consciente de la configuración regional, las fechas extraídas de lotes de facturas de varios países se mezclan silenciosamente por meses.
Los montos en dólares tienen un modo de fallo más sutil. Un «$1,234.56» impreso limpiamente se lee bien. Pero cuando el subtotal de una partida de «$1,234.56» está una fila encima del total de la factura de «$1,234.56» — el mismo número, diferente significado — la extracción basada en plantillas corre el riesgo de tomar el equivocado. Las variantes de símbolos de moneda agravan el problema: «€1.234,56» (coma decimal europea), «¥1,235» (yen japonés, sin decimales), o montos impresos sin ningún símbolo de moneda pueden activar diferentes reglas de análisis.
Nombres y Direcciones: Caracteres Correctos, Contexto Incorrecto
En apariencia, los nombres y las direcciones parecen fáciles para el OCR. Son texto, generalmente impreso en fuentes legibles, y no contienen glifos inusuales. Un motor de OCR tradicional reconocerá correctamente la cadena «John Smith» con alta confianza y la dirección «123 Main Street, Springfield, IL 62701» casi igual de bien.
El fallo no es el reconocimiento de caracteres. Es la identificación del campo. El OCR lee «John Smith» como caracteres en una página. No sabe si ese texto es el nombre del cliente, el del proveedor, el contacto de envío o el gerente que aprueba. Estas relaciones se definen por el diseño del documento — John Smith podría estar impreso junto a «Bill To:», «Ship To:» o «From:» — y el pipeline de caracteres ascendente del OCR tradicional no puede conectar una etiqueta con su valor asociado cuando los diseños cambian entre proveedores.
Por eso los sistemas basados en plantillas requieren un mapa de coordenadas separado para el diseño de cada proveedor. La plantilla dice «el nombre del cliente está en las coordenadas de píxel (450, 320)». Cuando un nuevo proveedor coloca el nombre del cliente en (520, 280), la plantilla captura un espacio en blanco o el campo equivocado. El problema escala con el número de proveedores: 20 proveedores significan 20 plantillas que construir y mantener. 200 proveedores significan que el mantenimiento de plantillas se convierte en un trabajo a tiempo completo.
El costo de este fallo es insidioso porque a menudo pasa desapercibido. Un campo de nombre mal asignado no genera un error de formato — «Sarah Chen» es un nombre válido tanto si está en el campo del cliente como en el del proveedor. El error sale a la superficie más tarde, cuando un pago va a la entidad equivocada o un informe agrupa transacciones bajo la contraparte incorrecta.
Partidas y Tablas: donde el OCR pierde la estructura
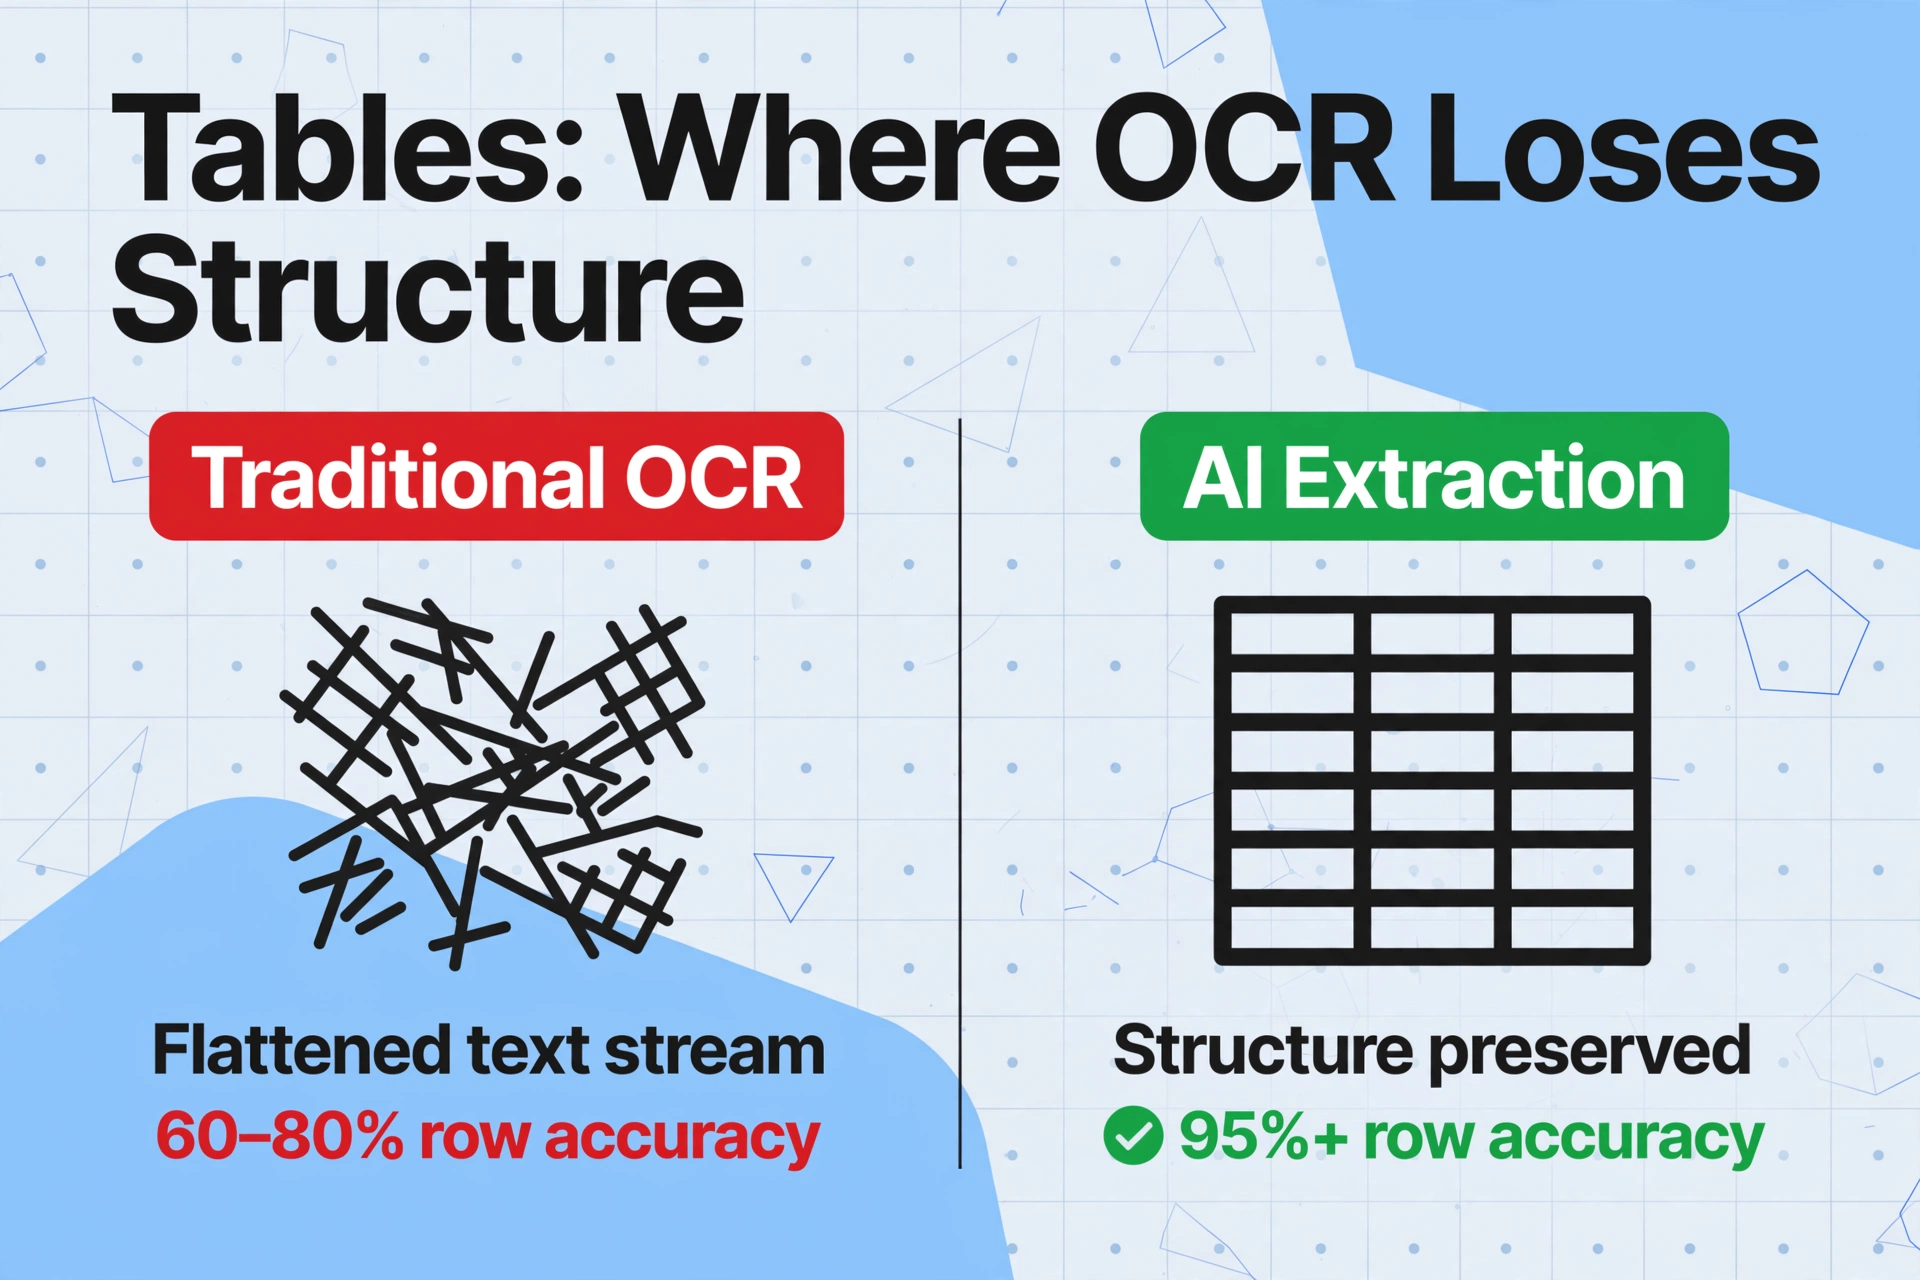
Las tablas son el mayor punto de fallo del OCR tradicional, y aparecen en casi todos los documentos empresariales: partidas de facturas, detalles de órdenes de compra, desgloses de informes de gastos, filas de transacciones de extractos bancarios. El problema es arquitectónico. Los motores de OCR generan un flujo lineal de caracteres organizados por orden de lectura — de izquierda a derecha, de arriba a abajo. Una tabla de tres columnas con cinco filas se aplana en una única secuencia de fragmentos de texto, y los límites de columna que definen qué valor pertenece a qué encabezado se desvanecen.
Los puntos de referencia de producción cuantifican el daño. En diseños de tablas complejos — celdas combinadas, encabezados anidados, anchos de columna inconsistentes — la precisión a nivel de fila del OCR tradicional cae al 60–80%. Un valor destinado a la columna "cantidad" termina en la columna "precio unitario". Una fila que abarca dos líneas de descripción se divide en dos entradas separadas. Los puntos decimales se desplazan una posición cuando el OCR confunde una línea separadora de columna con el numeral "1".
Esto no es un fallo de reconocimiento de caracteres. El motor de OCR lee los caracteres individuales correctamente — "5", "pcs", "$12.50" — pero el sistema posterior no tiene forma de reconstruir qué caracteres pertenecen a qué fila y columna. El resultado es un revoltijo de texto intercalado que requiere reconstrucción manual, fila por fila.
Los enfoques basados en plantillas intentan resolver esto definiendo regiones de tabla: "la tabla de partidas comienza en Y=600 y termina en Y=900". Pero las alturas de las tablas varían según el número de partidas. Un pedido de una línea y un pedido de 20 líneas del mismo proveedor producen tablas de longitudes completamente diferentes. La región fija de la plantilla captura solo una parte de la tabla o, peor, arrastra texto no relacionado debajo de la tabla hacia la última fila. Para una guía práctica sobre extraer datos de tablas a hojas de cálculo estructuradas, la variable crítica es si el motor de extracción comprende la estructura tabular semánticamente — no solo lee caracteres dentro de un cuadro delimitador.
Casillas de verificación, sellos y contenido mixto: lo que el OCR tradicional no puede ver
Existe una categoría de elementos documentales en los que el OCR tradicional no falla: simplemente no puede detectarlos en absoluto. Estos elementos no producen salida alguna, generan caracteres basura o, lo que es peor, contaminan la extracción de campos de texto adyacentes.
Casillas de verificación. Una casilla marcada (✓) y una sin marcar (☐) son visualmente distintas para un lector humano, pero para un motor de OCR tradicional ambas son manchas de bajo contraste cerca del umbral de detección. El OCR puede registrar una como una mancha y la otra como «nada», o puede leer la marca como un carácter suelto: una «V», un «7» o un glifo aleatorio. La intención («esta casilla está marcada») nunca se captura. Los formularios que dependen de campos de casillas de verificación (solicitudes de seguro, informes de inspección, listas de verificación de cumplimiento) requieren una revisión manual del 100 % de cada casilla después de que el OCR procesa el documento.
Sellos y marcas de agua. Un sello de «PAGADO» superpuesto al cuerpo de una factura, una marca de agua de «CONFIDENCIAL» en una página de contrato o un sello rojo de empresa superpuesto a una orden de compra crean todos el mismo fallo: dos capas de información visual que ocupan la misma región espacial. El OCR tradicional no puede separar el primer plano del fondo; ve una única región de imagen ruidosa y produce texto ilegible o nada. El texto del sello y el texto del documento subyacente quedan ambos ilegibles.
Contenido mixto. El texto impreso sobre fondos de color, el texto blanco sobre encabezados oscuros o los valores de datos dentro de celdas de tabla sombreadas reducen el contraste por debajo del umbral que necesitan los motores de OCR. Una barra de encabezado azul oscuro con texto blanco que dice «Factura» puede salir en blanco: el paso de binarización del motor convierte toda la región en negro y pierde el texto blanco por completo. Un importe en dólares impreso en una banda de fila alterna gris claro puede perder caracteres cuando el contraste entre el fondo gris y el texto negro cae por debajo de la curva de sensibilidad del motor.
Estos fallos son fundamentalmente diferentes de los problemas de tablas o de escritura a mano. Las tablas fallan porque el OCR pierde la estructura. Las casillas de verificación y los sellos fallan porque el OCR nunca los detecta en primer lugar. La diferencia importa para la corrección: se puede posprocesar una tabla rota, pero no se puede posprocesar algo que nunca se extrajo.
Escritura a mano: el precipicio del 30–60%
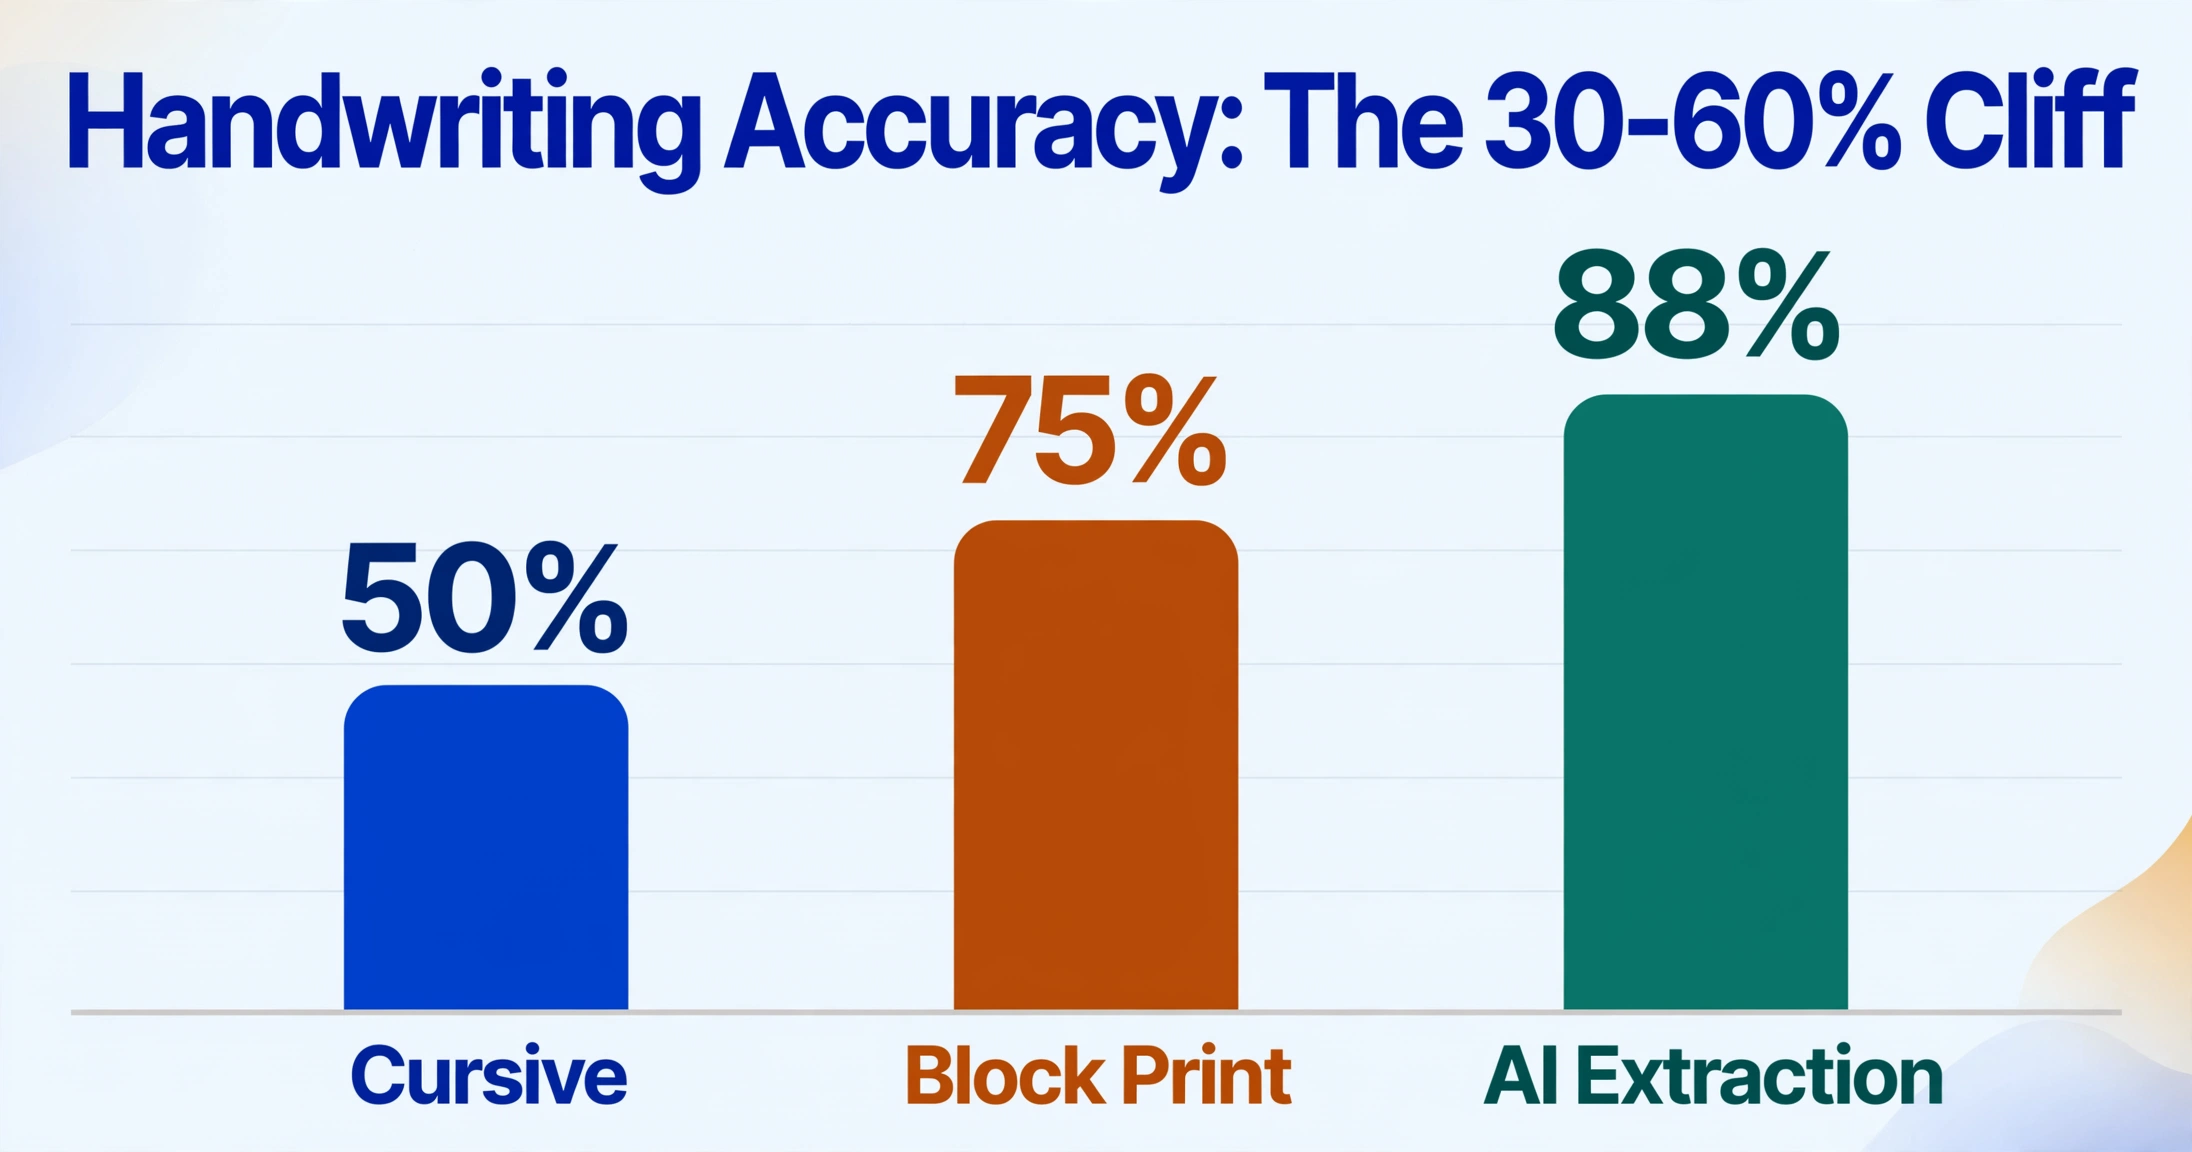
El texto escrito a mano es el problema más difícil en OCR, y los índices de precisión lo reflejan. Para los motores de OCR tradicionales, la letra de imprenta con recuadros de caracteres limitados alcanza alrededor de 75% de precisión por carácter. La escritura cursiva baja a 50% o menos. Estos son los datos de las pruebas de producción de OCRSolutions en flujos reales de procesamiento de formularios, no condiciones de laboratorio con muestras de entrenamiento escritas con esmero.
La razón es mecánica. El OCR tradicional funciona comparando patrones de glifos individuales con una base de datos de formas de caracteres conocidas. Una "A" impresa siempre se parece a una "A" impresa: existen variaciones menores de fuente, pero el esqueleto del carácter es consistente. Una "A" manuscrita no tiene un esqueleto consistente. La inclinación, el grosor del trazo, las ligaduras, el espaciado entre letras y la desviación de la línea base varían entre escritores y, a menudo, dentro de la misma producción de un escritor en una sola página. La comparación de patrones con una base de datos fija de glifos falla cuando no hay un patrón estable que comparar.
La escritura cursiva agrava todos los problemas. Cuando las letras se conectan, el motor no puede determinar dónde termina un carácter y comienza el siguiente. La secuencia conectada "tion" se convierte en un único glifo indiferenciado que no coincide con nada en la base de datos de caracteres. Las salidas comunes de OCR para escritura cursiva son cadenas de caracteres aleatorios — "totl" por "total", "Jnury" por "January" — donde el motor adivina las formas de las letras individuales sin las pistas de segmentación visual que hacen fiable el OCR de texto impreso.
La consecuencia práctica es que cualquier flujo de trabajo documental con un componente manuscrito — una nota de entrega firmada, un formulario de inspección rellenado a mano, una hoja de horas en papel con horas anotadas a lápiz — crea un paso de entrada manual de datos después de que el OCR termine. La herramienta que se suponía que eliminaría la entrada manual solo puede procesar la parte impresa; todo lo que una persona escribió a mano aún debe ser transcrito por un humano que lea el original. Para flujos de trabajo que implican específicamente documentos manuscritos como convertir formularios manuscritos a texto digital, la elección del motor de extracción determina si el documento completo se procesa automáticamente o solo sobreviven los encabezados impresos.
Por qué la extracción con IA maneja cada tipo de campo de manera diferente
La extracción basada en IA no resuelve todos estos problemas con un único mecanismo indiferenciado. Cada tipo de campo falla por una razón distinta, y la extracción con IA aborda cada razón con una capacidad diferente — igual que un mecánico arregla una fuga en la junta de manera distinta a un fallo eléctrico, aunque ambos hagan que el motor funcione mal.
Para nombres y direcciones (problema de contexto): Los modelos de visión con IA leen los documentos de arriba hacia abajo comprendiendo lo que cada fragmento de texto significa en relación con la estructura del documento. Cuando configura la Extracción de Columnas Personalizadas en una herramienta como ImageToTable.ai — escribiendo nombres de campos como "Customer Name," "Vendor Address," "Invoice Number" — la IA no busca coordenadas de píxeles. Escanea el documento en busca de valores que coincidan con la descripción semántica. "John Smith" junto a "Bill To:" se asigna a Customer Name sin importar dónde aparezca en la página. Sin plantillas, sin mapas de coordenadas, sin reconstrucción cuando un proveedor rediseña su factura. Este es el mecanismo que cierra la brecha entre el 60% de precisión basada en plantillas y más del 95% de extracción con IA en lotes de documentos de múltiples proveedores.
Para partidas y tablas (problema de estructura): Los modelos de visión con IA mantienen una representación interna del diseño espacial — columnas, filas, celdas combinadas, encabezados anidados — en lugar de aplanar la página en un flujo de texto. Al extraer partidas de una factura, el modelo identifica la región de la tabla, la segmenta en filas y columnas, y asocia cada valor de celda con su encabezado de columna. La salida conserva la estructura de tabla que el OCR tradicional descarta. Esto eleva la precisión a nivel de fila del 60–80% al rango de más del 90% en diseños complejos.
Para casillas de verificación y contenido mixto (problema de detección): Los modelos de visión con IA procesan el documento como una imagen antes de convertirlo a texto. Esto significa que pueden "ver" una casilla de verificación, un sello o una marca de agua de la misma manera que un lector humano — como un elemento visual distinto separado del texto circundante. Una casilla marcada se reconoce como una marca de verificación, no como un glifo aleatorio. Un sello superpuesto al texto se identifica como una capa separada, y el modelo puede extraer el texto subyacente razonando sobre lo que debería estar allí.
Para escritura a mano (fallo de patrón): Los modelos de IA entrenados con millones de muestras de escritura a mano aprenden a reconocer letras no mediante la coincidencia de esqueletos de glifos, sino comprendiendo la intención detrás de un patrón de trazos. El contexto completa lo que el reconocimiento individual de letras no capta. Si el modelo lee "Totl" en un campo etiquetado como "Amount Due" al final de una factura, lo resuelve como "Total" — no porque de repente reconoció la "a," sino porque "Totl" con esa etiqueta y esa posición debe ser "Total." Esta corrección contextual es lo que eleva la precisión de la escritura a mano del 50% al rango del 85–93% en letra de imprenta y del 75–85% en cursiva.
Ninguno de estos mecanismos es magia. Cada uno falla en condiciones extremas — escaneos severamente degradados, escritura a mano ilegible incluso para un humano, tablas sin límites de columna visibles. Pero cada mecanismo apunta a un modo de fallo específico para el que el OCR tradicional no tiene respuesta. El efecto acumulativo en todos los tipos de campo es lo que cambia un lote de documentos de "necesita 40% de revisión manual" a "necesita 5% de revisión manual."
La diferencia se vuelve inmediatamente visible cuando lo prueba. La demostración a continuación procesa una factura con los mismos tipos de campo discutidos anteriormente — fechas, montos en dólares, nombre del proveedor, partidas, impuestos — a través de un pipeline de extracción con IA. Sin plantillas, sin mapeo de coordenadas, sin configuración previa más allá de escribir los nombres de las columnas que desea.
Los archivos se procesan de forma segura y no se almacenan.
Cómo auditar su OCR: qué campos cuestan más corregir
Si hoy ejecuta un pipeline de procesamiento de documentos, lo más útil que puede hacer es medir el costo de corrección por tipo de campo, no por el porcentaje general de precisión. Una tasa general del 95% se ve bien en un panel. Un desglose por campo le indica dónde se concentra el 5% de los errores y cuánto cuesta corregirlos.
Así se realiza una auditoría de precisión a nivel de campo en su pipeline de extracción actual:
Tome una muestra de 100 documentos de producción.
No use su conjunto de pruebas limpio: use lo que su canalización realmente procesa en un día laboral normal. Proveedores mixtos, formatos mixtos, cualquier calidad de escaneo que su equipo realmente envíe.
Clasifique cada error de extracción por tipo de campo.
Etiquete cada error como Fecha, Monto en dólares, Nombre/Dirección, Partida (tabla), Casilla de verificación, Escritura a mano o Contenido mixto. Un error puede tener tanto un tipo de campo como una causa raíz: registre ambos.
Mida el tiempo de corrección, no solo el número de errores.
Corregir una fila de tabla de partidas desalineada puede tomar de 2 a 3 minutos de referencias cruzadas con el documento original. Corregir un formato de fecha toma 10 segundos. Cuente los minutos, no los errores.
Multiplique la tasa de error por tipo de campo por el costo de corrección por campo.
Una tasa de error del 5% en montos en dólares que cuestan $2 cada uno para corregir es diferente de una tasa de error del 20% en nombres que cuestan $0.50 cada uno. El tipo de campo con el mayor producto de tasa de error × costo de corrección es su cuello de botella.
Cuando los equipos realizan esta auditoría en canalizaciones de OCR tradicionales que procesan facturas de múltiples proveedores, surge un patrón consistente. Las partidas y las tablas consumen la mayor parte del tiempo de corrección, no porque tengan la tasa de error más alta (la escritura a mano gana esa categoría), sino porque cada error de tabla requiere reconstruir la relación fila-columna a partir del documento original. Una tasa de error de tabla del 20% en 500 facturas con 5 partidas cada una significa 500 filas para reconstruir manualmente. A 2 minutos por fila, eso son 16 horas de tiempo de corrección, más de dos días laborales completos, para un lote que el OCR debía procesar automáticamente.
Los montos en dólares y las fechas, a pesar de tener tasas de error brutas más bajas, son la segunda categoría más costosa porque las consecuencias de los errores no detectados son altas. Un total de factura incorrecto que pasa al ERP crea una discrepancia de conciliación que cuesta mucho más desenredar de lo que habría costado detectar la corrección a nivel de campo. Para una visión más amplia de cómo estos fallos a nivel de campo se agregan en la ineficiencia total de la canalización, consulte nuestro desglose de puntos de referencia de precisión de AI OCR vs OCR tradicional y nuestra guía práctica para establecer expectativas de precisión para la entrada de datos con IA.
Una vez que sepa qué tipos de campos están consumiendo el tiempo de su equipo, la siguiente pregunta es si el motor de extracción puede manejar mejor esos tipos de campos específicos. Si su cuello de botella es la estructura de tablas, cambiar a un motor sin comprensión semántica de tablas reemplaza un problema por el mismo problema. Si su cuello de botella es la escritura a mano o las casillas de verificación, un motor que no puede detectarlas nunca mejorará. La auditoría le indica no solo que la extracción está fallando, sino dónde — y el dónde determina si una actualización realmente aborda el cuello de botella o solo cambia el logotipo en el mismo registro de errores.
Preguntas frecuentes
¿El OCR tradicional funciona mejor en algunos tipos de documentos que en otros?
Sí. El OCR tradicional funciona bien en documentos de texto limpios, impresos, de una sola columna y con diseños consistentes — contratos, cartas, formularios estandarizados de una sola fuente. La precisión disminuye en cualquier documento con tablas, escritura a mano, fuentes mixtas, bajo contraste o variación de diseño entre fuentes. La diferencia no es marginal: una carta mecanografiada podría extraerse con un 98% de precisión de campos, mientras que un lote de facturas de múltiples proveedores con tablas de partidas se extrae con un 60–85%.
¿Puedo mejorar la precisión del OCR tradicional escaneando a mayor resolución?
Hasta cierto punto. Escanear a 300 DPI (la recomendación estándar) mejora el reconocimiento de caracteres en comparación con 150 DPI o con fotos de teléfonos inteligentes tomadas desde lejos. Pero las mejoras de resolución solo afectan los errores a nivel de caracteres — no hacen nada por los fallos estructurales (tablas, mapeo de campos, casillas de verificación) que representan la mayor parte del tiempo de corrección en los flujos de producción. Una imagen más nítida de una tabla rota sigue siendo una tabla rota.
¿Cuál es el tipo de campo más difícil de procesar correctamente para cualquier sistema de extracción?
La escritura a mano — específicamente la cursiva — sigue siendo el tipo de campo más difícil para cualquier sistema, incluida la extracción basada en IA. Los modelos de IA entrenados con diversos conjuntos de datos de escritura a mano logran un 85–93% en letra de imprenta y un 75–85% en cursiva, lo que supone una mejora significativa frente al 30–60% del OCR tradicional, pero no un 99%. Para los flujos de trabajo donde los campos escritos a mano contienen datos críticos (montos de pago, nombres de pacientes, valores de verificación de cumplimiento), la revisión humana de las extracciones de baja confianza sigue siendo el enfoque más seguro.
¿ImageToTable.ai maneja documentos escritos a mano?
ImageToTable.ai utiliza un modelo de visión y lenguaje que puede reconocer escritura a mano, texto impreso, casillas de verificación, sellos y estructuras de tablas dentro del mismo documento. La precisión del reconocimiento de escritura a mano depende de la legibilidad y el estilo de escritura: la letra de molde clara se extrae de manera confiable, mientras que la escritura cursiva muy estilizada puede requerir verificación manual. El modelo proporciona señales visuales que muestran las regiones del documento de las que leyó, para que pueda revisar rápidamente los campos escritos a mano sin volver a leer todo el documento. Si sus documentos son principalmente escritos a mano, considere comenzar con una prueba de lote pequeño para medir la precisión en sus muestras específicas de escritura a mano antes de escalar.
¿Cómo maneja ImageToTable.ai la extracción de tablas de manera diferente al OCR tradicional?
El OCR tradicional produce un flujo de texto lineal. Las tablas se aplastan. ImageToTable.ai procesa el documento como un diseño visual, detectando regiones de tablas, segmentando filas y columnas, y asociando cada valor de celda con su encabezado de columna. La salida conserva la estructura de la tabla: cada fila se convierte en una fila en su hoja de cálculo de salida, cada columna se asigna al nombre de columna que especificó. Esto funciona sin plantilla, lo que significa que una factura de 5 filas y una factura de 20 filas del mismo proveedor se extraen correctamente independientemente de la altura de la tabla. Para una explicación más detallada de cómo esto difiere de los enfoques tradicionales, consulte nuestra descripción general de la entrada de datos con IA.
La pregunta no es si su OCR tiene errores. Todo sistema de extracción los tiene. La pregunta es si los errores se concentran en correcciones de un minuto o en campos donde cada error se convierte en una hora de conciliación. Ejecute la auditoría en su próximo lote — mida el tiempo de corrección por tipo de campo, no por la precisión general — y sabrá en qué categoría se encuentra.