OCR-Genauigkeit nach Feld:
95 % insgesamt, 60 % bei den Feldern, die zählen
„95 % Genauigkeit“ ist die Zahl, mit der die meisten OCR-Tools werben. Aber wenn Sie einen Stapel von 200 Rechnungen durch die Pipeline schicken und trotzdem den Dienstagnachmittag damit verbringen, extrahierte Felder manuell zu korrigieren, fühlt sich diese 95-%-Behauptung wie ein Rundungsfehler zu Ihren Ungunsten an. Der Grund ist nicht, dass die Zahl erfunden ist. Es ist, dass die Genauigkeit nie über alle Feldtypen hinweg einheitlich ist – und die Felder, die OCR falsch erkennt, sind überproportional die, von denen Ihre nachgelagerten Systeme tatsächlich abhängen. Dieser Artikel misst die Lücke Feld für Feld, erklärt, warum jeder Feldtyp anders versagt, und zeigt, was die Korrektur jedes einzelnen kostet.
Die wichtigsten Erkenntnisse
- Ihre OCR meldet 95 % Genauigkeit, fällt aber still auf 60 % bei den drei Feldtypen, ohne die Ihr Buchhaltungssystem nicht funktionieren kann.
- Fünf verschiedene Feldtypen scheitern aus fünf völlig unterschiedlichen Gründen – und eine höhere Scan-Auflösung behebt genau keinen davon.
- Ersetzen Sie die Dashboard-Genauigkeitszahl durch eine Kennzahl – Korrekturzeit pro Feldtyp – und nutzen Sie ImageToTable.ai, um jeden Fehlermodus an seiner strukturellen Wurzel zu beheben, statt am oberflächlichen Symptom.
Das „95%-Genauigkeit“-Problem
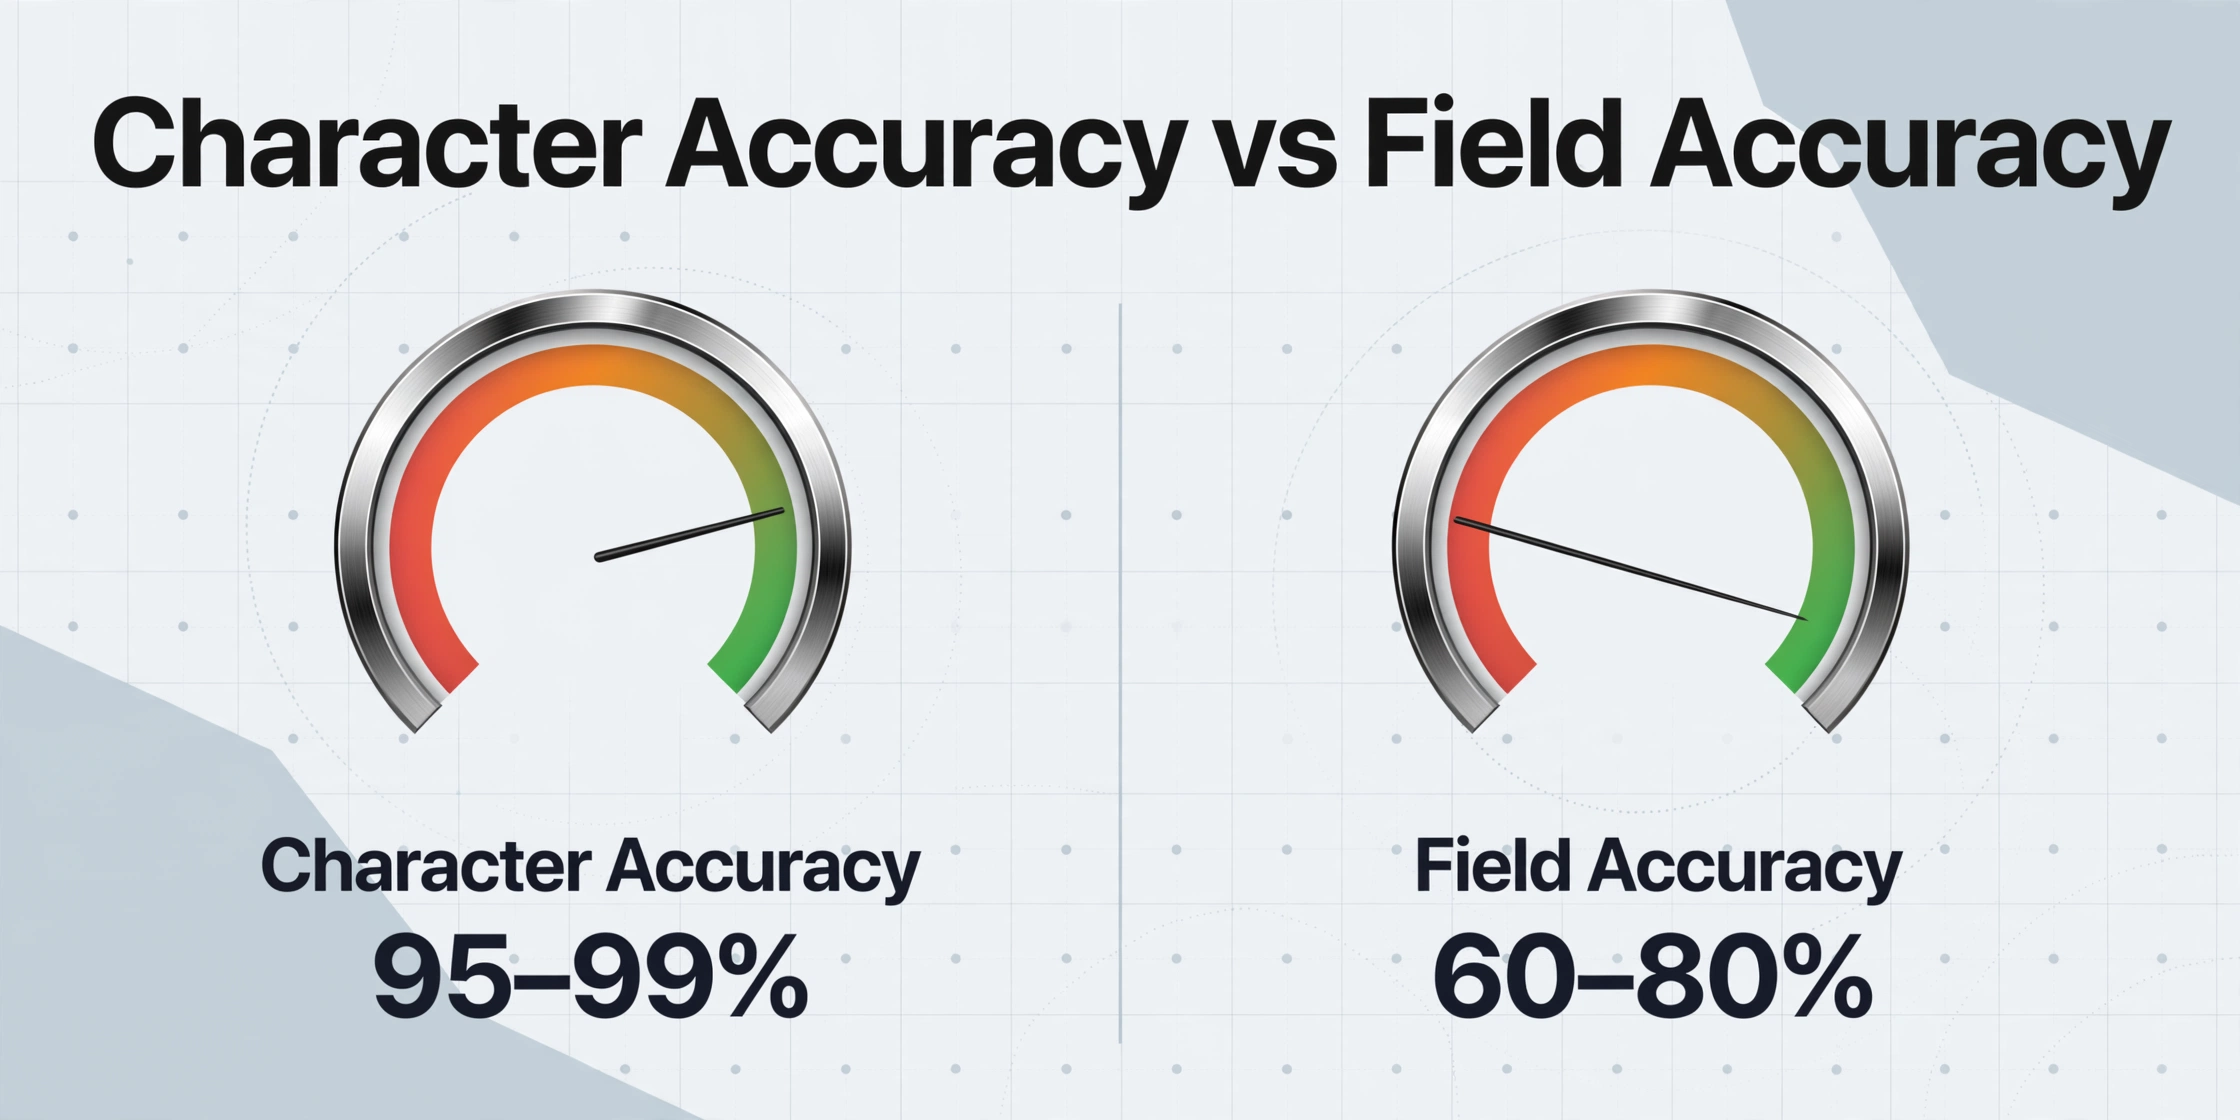
Herkömmliche OCR-Engines messen sich an der Zeichengenauigkeit – dem Prozentsatz der einzelnen Zeichen, die aus einem Dokumentbild korrekt erkannt werden. Tesseract 5, der von Google gepflegte Open-Source-Benchmark, erreicht bei sauberen gedruckten Dokumenten eine Zeichengenauigkeit von 95 %. Enterprise-Engines wie ABBYY FineReader erreichen unter Laborbedingungen 97–99 %. Das sind reale Zahlen, gemessen an realen Testdatensätzen.
Doch die Zeichengenauigkeit ist ein schlechter Indikator für das, was Unternehmen tatsächlich brauchen: vollständige, korrekte Datenfelder. Eine einzige falsch erkannte Ziffer in einer 10-stelligen Rechnungsnummer macht das gesamte Feld unbrauchbar. Bei 99 % Zeichengenauigkeit auf einer Seite mit 1.000 Zeichen sind 10 Zeichen falsch – und wenn diese 10 falschen Zeichen in 3 Ihrer 15 Zielfelder fallen, sinkt die Feldgenauigkeit auf 80 %. Das TDWI hat genau dieses Szenario in realen OCR-Pipelines dokumentiert: Das Dashboard meldet 99 %, aber 1 von 5 extrahierten Geschäftsfeldern enthält einen Fehler.
Erschwerend kommt hinzu, dass sich Fehler nicht gleichmäßig verteilen. Bei einigen Feldtypen liegt die herkömmliche OCR fast immer richtig. Andere versagen so häufig, dass die Extraktion genauso gut hätte ausbleiben können. Das Problem: Gerade die Felder, die am wahrscheinlichsten fehlschlagen – Dollar-Beträge auf Positionen, handschriftliche Daten, tabellenförmige Daten – sind auch die Felder, deren Fehler am teuersten zu beheben sind.
Gedruckte Daten und Zahlen – was OCR zuverlässig erkennt
Bei sauberen, gedruckten Dokumenten mit hohem Kontrast verarbeitet herkömmliche OCR Daten und Dollar-Beträge an Standardpositionen gut. Ein Rechnungsdatum wie „06/09/2026" in 11pt Arial auf weißem Hintergrund bei 300 DPI wird von OCR mit nahezu perfekter Zeichengenauigkeit erfasst. Ein Gesamtbetrag wie „$1.234,56" in der unteren rechten Ecke, der bei den Rechnungen eines Anbieters konsistent positioniert ist, lässt sich mit einer gut gepflegten Vorlage zuverlässig extrahieren.
Das sind die Felder, die die von OCR-Anbietern genannten 95–99 %-Werte erzielen. Sie stellen das Best-Case-Szenario dar: standardisierte Schriftarten, vorhersehbare Positionen, hoher Kontrast. Hier funktioniert herkömmliche OCR wirklich.
Die Schwächen zeigen sich, sobald Formate variieren. Ein Datum wie „09/06/2026" – ist das der 9. Juni (US) oder der 6. September (UK)? Herkömmliche OCR hat keinen Mechanismus, um den Unterschied zu erkennen; sie liest die Ziffern getreu, und das nachgelagerte System rät oder verwendet standardmäßig das US-Format. Ein Reddit-Nutzer, der eine europäische Rechnungspipeline mit Python aufbaute, dokumentierte genau dieses Problem: Italienische Rechnungen verwenden 31/12/2024, deutsche Rechnungen 31.12.2024 und britische Rechnungen 31/12/2024 (gleiche Syntax, andere Reihenfolge von Tag und Monat). Ohne eine lokalisierungsbewusste Normalisierung werden Daten aus Rechnungsstapeln mehrerer Länder stillschweigend um Monate verschoben.
Dollar-Beträge haben eine subtilere Fehlerquelle. Ein sauber gedruckter Betrag „$1.234,56" wird problemlos gelesen. Steht jedoch eine Positionssumme von „$1.234,56" eine Zeile über einem Rechnungsgesamtbetrag von „$1.234,56" – gleiche Zahl, andere Bedeutung –, riskiert die vorlagenbasierte Extraktion, den falschen Wert zu ziehen. Varianten von Währungssymbolen verschärfen das Problem: „€1.234,56" (europäisches Dezimalkomma), „¥1.235" (japanischer Yen, ohne Dezimalstellen) oder Beträge ganz ohne Währungssymbol können jeweils unterschiedliche Parsing-Regeln auslösen.
Namen und Adressen – Zeichen richtig, Kontext falsch
Oberflächlich betrachtet scheinen Namen und Adressen für OCR einfach zu sein. Sie sind Text, meist in lesbaren Schriftarten gedruckt, und enthalten keine ungewöhnlichen Zeichen. Eine herkömmliche OCR-Engine erkennt die Zeichenfolge „John Smith" mit hoher Konfidenz korrekt und die Adresse „123 Main Street, Springfield, IL 62701" fast ebenso gut.
Der Fehler liegt nicht in der Zeichenerkennung, sondern in der Feldidentifikation. OCR liest „John Smith" als Zeichen auf einer Seite. Sie weiß nicht, ob dieser Text der Kundenname, der Anbietername, der Lieferkontakt oder der genehmigende Manager ist. Diese Beziehungen werden durch das Layout des Dokuments definiert – John Smith könnte neben „Bill To:", „Ship To:" oder „From:" stehen – und die Bottom-up-Zeichenpipeline herkömmlicher OCR kann ein Label nicht mit seinem zugehörigen Wert verknüpfen, wenn sich Layouts zwischen Anbietern unterscheiden.
Deshalb benötigen vorlagenbasierte Systeme eine separate Koordinatenkarte pro Anbieterlayout. Die Vorlage besagt: „Der Kundenname befindet sich an den Pixelkoordinaten (450, 320)." Wenn ein neuer Anbieter den Kundennamen bei (520, 280) platziert, erfasst die Vorlage leeren Raum oder das falsche Feld. Das Problem skaliert mit der Anzahl der Anbieter: 20 Anbieter bedeuten 20 zu erstellende und zu pflegende Vorlagen. 200 Anbieter machen die Vorlagenpflege zu einem Vollzeitjob.
Die Kosten dieses Fehlers sind tückisch, weil er oft unbemerkt bleibt. Ein falsch zugeordnetes Namensfeld löst keinen Formatfehler aus – „Sarah Chen" ist ein gültiger Name, egal ob im Kunden- oder Anbieterfeld. Der Fehler tritt erst später zutage, wenn eine Zahlung an die falsche Stelle geht oder ein Bericht Transaktionen dem falschen Geschäftspartner zuordnet.
Positionen und Tabellen – wo OCR die Struktur verliert
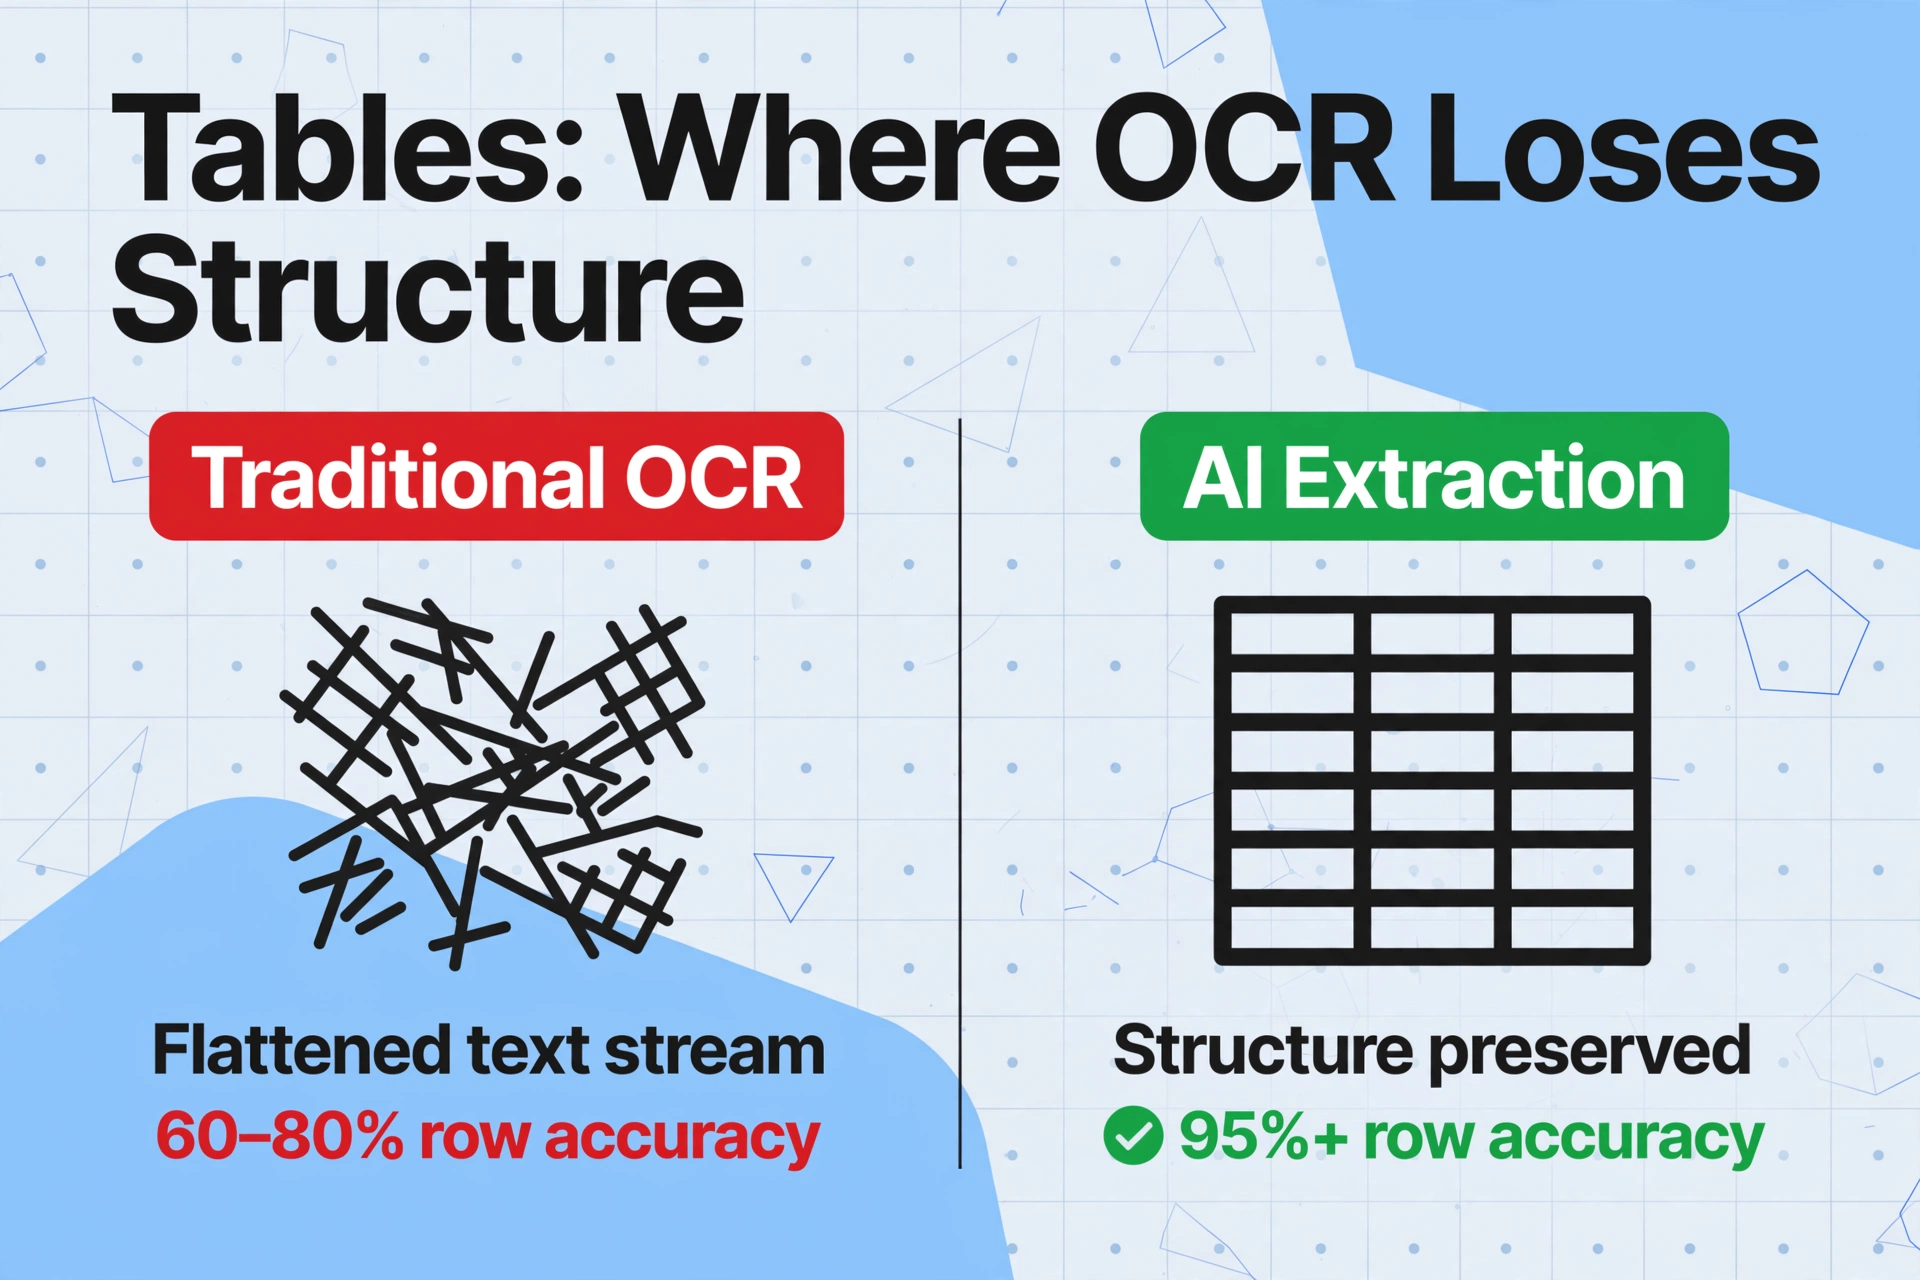
Tabellen sind der größte einzelne Schwachpunkt traditioneller OCR und erscheinen auf fast jedem Geschäftsdokument: Rechnungspositionen, Bestelldetails, Spesenabrechnungen, Transaktionszeilen von Kontoauszügen. Das Problem ist architektonischer Natur. OCR-Engines geben einen linearen Zeichenstrom aus, der nach Lesereihenfolge organisiert ist – von links nach rechts, von oben nach unten. Eine Tabelle mit drei Spalten und fünf Zeilen wird zu einer einzigen Sequenz von Textfragmenten abgeflacht, und die Spaltengrenzen, die definieren, welcher Wert zu welchem Kopf gehört, verschwinden.
Produktions-Benchmarks beziffern den Schaden. Bei komplexen Tabellenlayouts – zusammengeführte Zellen, verschachtelte Kopfzeilen, uneinheitliche Spaltenbreiten – sinkt die Zeilengenauigkeit traditioneller OCR auf 60–80 %. Ein Wert, der für die Spalte „Menge“ bestimmt war, landet in der Spalte „Einzelpreis“. Eine Zeile, die sich über zwei Beschreibungszeilen erstreckt, wird in zwei separate Einträge aufgeteilt. Dezimalpunkte wandern um eine Position, wenn OCR eine Spaltentrennlinie mit der Ziffer „1“ verwechselt.
Das ist kein Zeichenerkennungsfehler. Die OCR-Engine liest einzelne Zeichen korrekt – „5“, „Stk.“, „$12.50“ – aber das nachgelagerte System hat keine Möglichkeit zu rekonstruieren, welche Zeichen zu welcher Zeile und Spalte gehören. Die Ausgabe ist ein Durcheinander verschachtelter Texte, das eine manuelle Rekonstruktion Zeile für Zeile erfordert.
Vorlagenbasierte Ansätze versuchen, dies durch die Definition von Tabellenbereichen zu lösen: „Die Positionstabelle beginnt bei Y=600 und endet bei Y=900.“ Aber Tabellenhöhen variieren mit der Anzahl der Positionen. Eine Ein-Zeilen-Bestellung und eine 20-Zeilen-Bestellung desselben Anbieters erzeugen Tabellen völlig unterschiedlicher Länge. Der feste Bereich der Vorlage erfasst entweder nur einen Teil der Tabelle oder zieht, schlimmer noch, unzusammenhängenden Text unterhalb der Tabelle in die letzte Zeile. Für einen praktischen Leitfaden zum Extrahieren von Tabellendaten in strukturierte Tabellenkalkulationen ist die entscheidende Variable, ob die Extraktions-Engine tabellarische Struktur semantisch versteht – nicht nur Zeichen innerhalb eines Begrenzungsrahmens liest.
Kontrollkästchen, Stempel und gemischte Inhalte – was herkömmliche OCR nicht erkennen kann
Es gibt eine Kategorie von Dokumentelementen, bei denen herkömmliche OCR nicht versagt – sie kann sie schlichtweg gar nicht erkennen. Diese Elemente erzeugen keine Ausgabe, generieren Zeichensalat oder – am schlimmsten – verunreinigen die Extraktion benachbarter Textfelder.
Kontrollkästchen. Ein angekreuztes Kästchen (✓) und ein leeres Kästchen (☐) sind für einen menschlichen Leser visuell klar unterscheidbar, aber für eine herkömmliche OCR-Engine sind beide nur kontrastarme Flecken nahe der Erkennungsschwelle. OCR registriert das eine möglicherweise als Schmierer und das andere als „nichts“, oder sie liest das Häkchen als einzelnes Zeichen – ein „V“, eine „7“ oder ein beliebiges Glyph. Die Absicht – „dieses Kästchen ist angekreuzt“ – wird nie erfasst. Formulare, die auf Kontrollkästchenfeldern basieren (Versicherungsanträge, Inspektionsberichte, Compliance-Checklisten), erfordern nach der OCR-Verarbeitung eine 100%ige manuelle Prüfung jedes einzelnen Kästchens.
Stempel und Wasserzeichen. Ein „PAID“-Stempel auf einem Rechnungskörper, ein „CONFIDENTIAL“-Wasserzeichen auf einer Vertragsseite oder ein rotes Firmensiegel auf einer Bestellung erzeugen alle denselben Fehler: zwei Ebenen visueller Informationen im selben räumlichen Bereich. Herkömmliche OCR kann Vordergrund nicht von Hintergrund trennen; sie sieht eine einzige verrauschte Bildregion und erzeugt entweder verstümmelten Text oder nichts. Sowohl der Stempeltext als auch der darunterliegende Dokumenttext werden unleserlich.
Gemischte Inhalte. Text auf farbigem Hintergrund, weißer Text auf dunklen Kopfzeilen oder Datenwerte in schattierten Tabellenzellen reduzieren den Kontrast unter die Schwelle, die OCR-Engines benötigen. Eine dunkelblaue Kopfzeile mit weißem Text „Rechnung“ kann als leer ausgegeben werden – der Binarisierungsschritt der Engine wandelt die gesamte Region in Schwarz um und verliert den weißen Text vollständig. Ein Dollar-Betrag in einer hellgrauen alternierenden Zeilenband kann Zeichen verlieren, wenn der Kontrast zwischen grauem Hintergrund und schwarzem Text unter die Empfindlichkeitskurve der Engine fällt.
Diese Fehler unterscheiden sich grundlegend von den Tabellen- oder Handschriftproblemen. Tabellen scheitern, weil OCR die Struktur verliert. Kontrollkästchen und Stempel scheitern, weil OCR sie von vornherein nie erkennt. Der Unterschied ist für die Behebung entscheidend: Sie können eine defekte Tabelle nachbearbeiten, aber Sie können nichts nachbearbeiten, was nie extrahiert wurde.
Handschrift – Die 30–60-%-Klippe
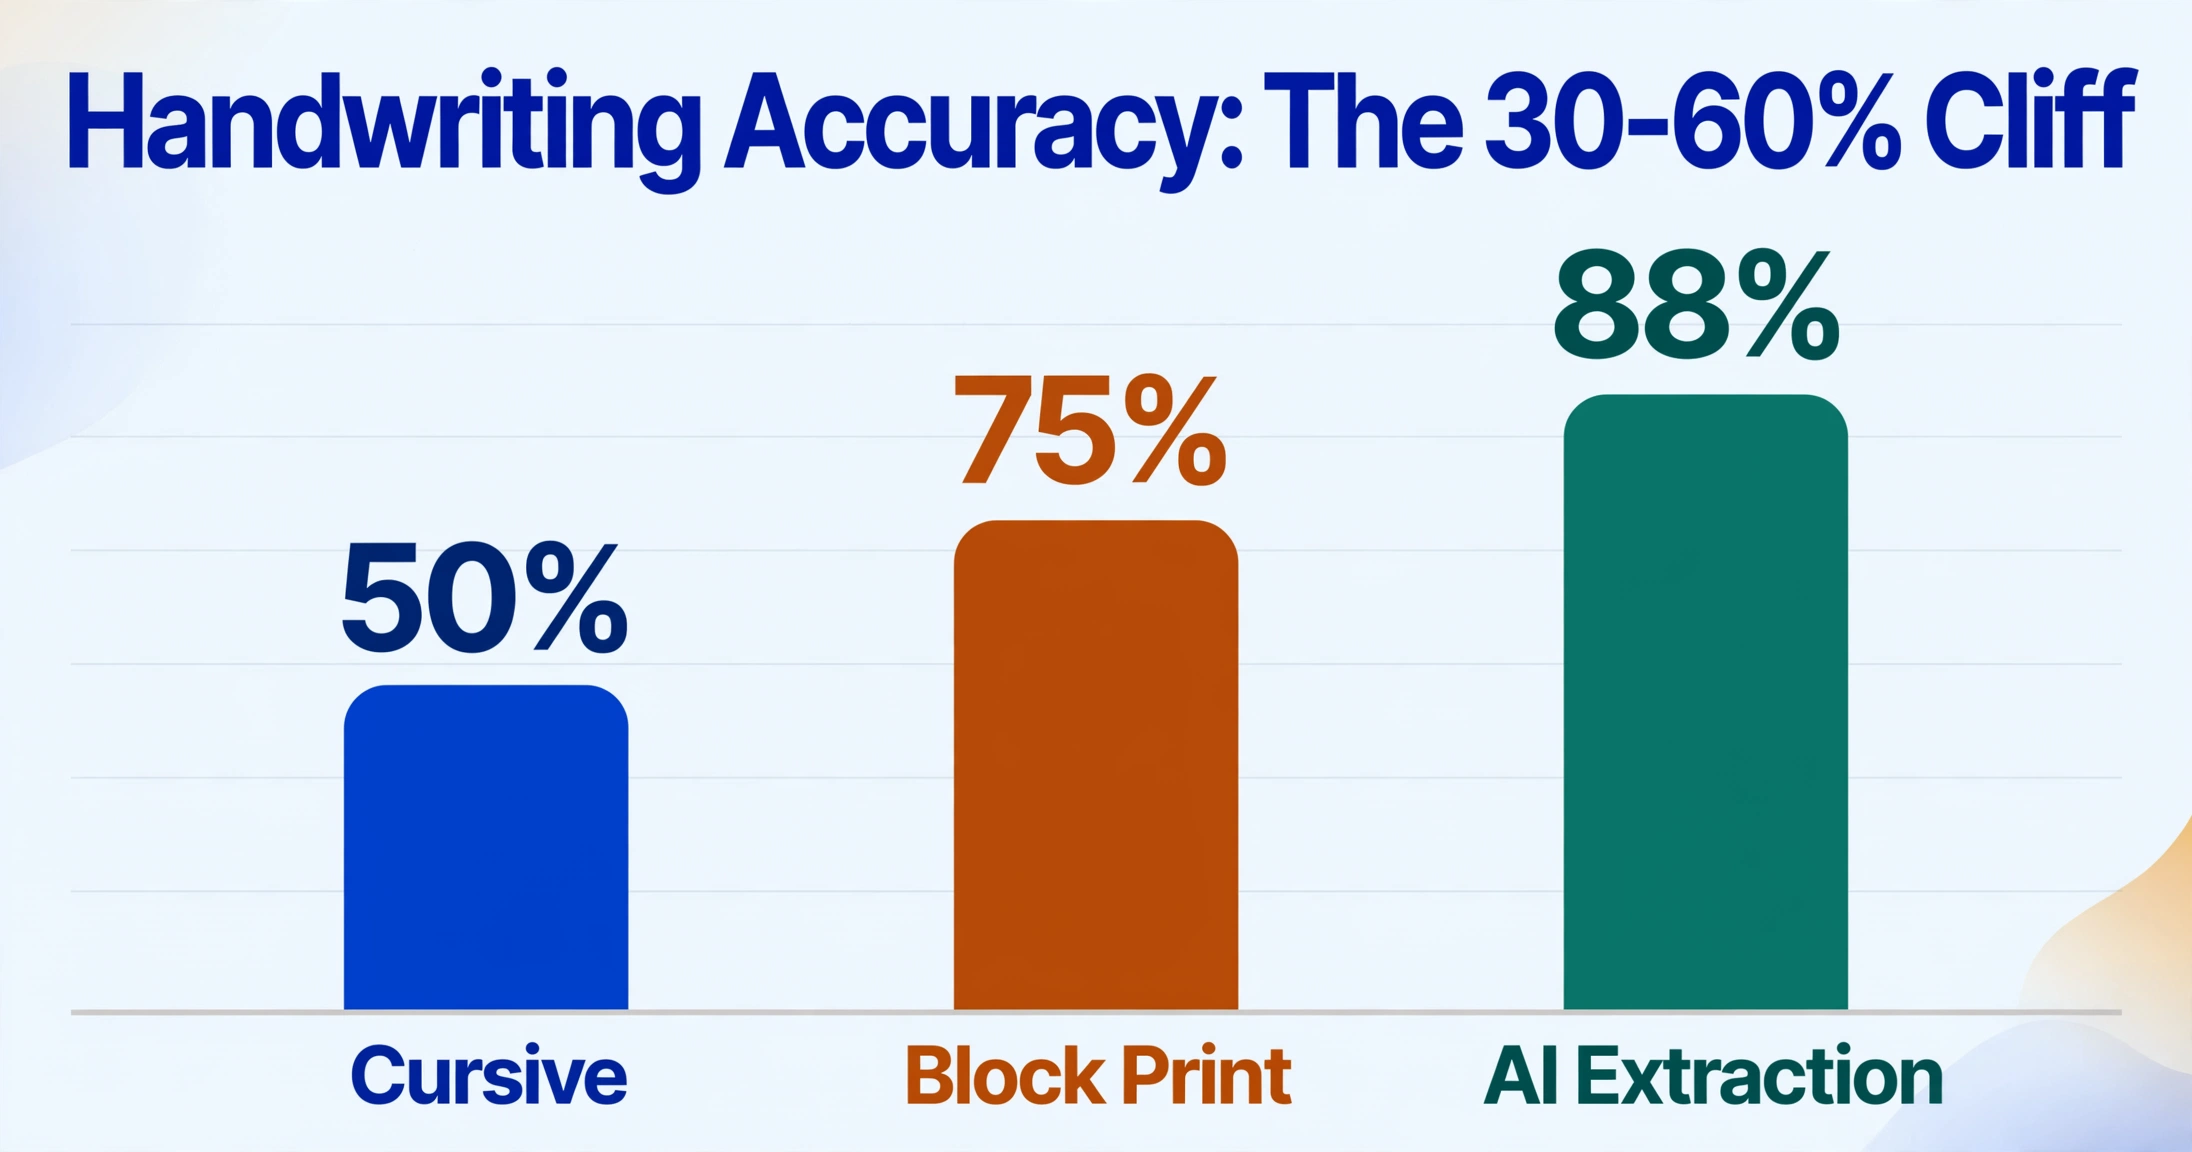
Handschrift ist das schwierigste Problem in der OCR, und die Genauigkeitszahlen spiegeln das wider. Bei herkömmlichen OCR-Engines erreicht Druckschrift mit eingeschränkten Zeichenfeldern eine Zeichengenauigkeit von rund 75 %. Schreibschrift fällt auf 50 % oder weniger. Das sind die Daten aus dem Produktions-Benchmarking von OCRSolutions mit realen Formularverarbeitungs-Pipelines – keine Laborbedingungen mit sauber geschriebenen Trainingsbeispielen.
Der Grund ist mechanischer Natur. Traditionelle OCR funktioniert, indem sie einzelne Glyphen per Musterabgleich mit einer Datenbank bekannter Zeichenformen vergleicht. Gedrucktes „A“ sieht immer aus wie gedrucktes „A“ – es gibt kleinere Schriftvarianten, aber das Zeichengrundgerüst ist konsistent. Handgeschriebenes „A“ hat kein konsistentes Grundgerüst. Neigung, Strichstärke, Ligaturverbindungen, Buchstabenabstand und Grundlinienversatz variieren zwischen verschiedenen Schreibern – und oft sogar innerhalb der Ausgabe desselben Schreibers auf einer einzigen Seite. Musterabgleich gegen eine feste Glyphendatenbank versagt, wenn es kein stabiles Muster zum Abgleichen gibt.
Schreibschrift verschärft jedes Problem zusätzlich. Wenn Buchstaben verbunden sind, kann die Engine nicht bestimmen, wo ein Zeichen endet und das nächste beginnt. Die verbundene Sequenz „tion“ wird zu einer einzigen undifferenzierten Glyphe, die mit nichts in der Zeichendatenbank übereinstimmt. Typische OCR-Ausgaben für Schreibschrift sind Ketten zufälliger Zeichen – „totl“ für „total“, „Jnury“ für „January“ – wo die Engine einzelne Buchstabenformen errät, ohne die visuellen Segmentierungshinweise, die gedruckte OCR zuverlässig machen.
Die praktische Konsequenz ist: Jeder Dokumentworkflow mit Handschriftanteil – ein unterschriebener Lieferschein, ein handschriftlich ausgefülltes Inspektionsformular, ein Papier-Stundenzettel mit Bleistifteinträgen – erzeugt nach Abschluss der OCR einen manuellen Datenerfassungsschritt. Das Tool, das die manuelle Erfassung eigentlich überflüssig machen sollte, kann nur den gedruckten Teil verarbeiten; alles, was ein Mensch von Hand geschrieben hat, muss weiterhin von einem Menschen transkribiert werden, der das Original liest. Für Workflows, die speziell handschriftliche Dokumente betreffen, etwa das Konvertieren handschriftlicher Formulare in digitalen Text, entscheidet die Wahl der Extraktions-Engine darüber, ob das gesamte Dokument automatisch verarbeitet wird oder nur die gedruckten Kopfzeilen überleben.
Warum KI-Extraktion jeden Feldtyp anders behandelt
KI-basierte Extraktion löst nicht alle diese Probleme mit einem einzigen, undifferenzierten Mechanismus. Jeder Feldtyp scheitert aus einem anderen Grund, und KI-Extraktion begegnet jedem Grund mit einer anderen Fähigkeit – so wie ein Mechaniker eine Dichtungsleckage anders behebt als einen elektrischen Defekt, auch wenn beide den Motor schlecht laufen lassen.
Bei Namen und Adressen (Kontextproblem): KI-Visionsmodelle lesen Dokumente von oben nach unten, indem sie verstehen, was jeder Textabschnitt in Bezug auf die Dokumentstruktur bedeutet. Wenn Sie Benutzerdefinierte Spaltenextraktion in einem Tool wie ImageToTable.ai konfigurieren – Feldnamen wie „Kundenname“, „Lieferantenadresse“, „Rechnungsnummer“ eingeben – sucht die KI nicht nach Pixelkoordinaten. Sie scannt das Dokument nach Werten, die zur semantischen Beschreibung passen. „John Smith“ neben „Rechnung an:“ wird unabhängig von seiner Position auf der Seite dem Kundennamen zugeordnet. Keine Vorlagen, keine Koordinatenkarten, kein Neuaufbau, wenn ein Lieferant seine Rechnung neu gestaltet. Dies ist der Mechanismus, der die Lücke zwischen 60 % vorlagenbasierter Genauigkeit und 95 %+ KI-Extraktion bei Dokumentenstapeln mehrerer Lieferanten schließt.
Bei Positionen und Tabellen (Strukturproblem): KI-Visionsmodelle halten eine interne Darstellung des räumlichen Layouts aufrecht – Spalten, Zeilen, übergreifende Zellen, verschachtelte Kopfzeilen – anstatt die Seite in einen Textstrom zu vereinfachen. Beim Extrahieren von Positionen aus einer Rechnung identifiziert das Modell den Tabellenbereich, segmentiert ihn in Zeilen und Spalten und ordnet jeden Zellenwert seiner Spaltenüberschrift zu. Die Ausgabe bewahrt die Tabellenstruktur, die herkömmliche OCR verwirft. Dadurch steigt die Genauigkeit auf Zeilenebene von 60–80 % auf über 90 % bei komplexen Layouts.
Bei Kontrollkästchen und gemischten Inhalten (Erkennungsproblem): KI-Visionsmodelle verarbeiten das Dokument als Bild, bevor sie es in Text umwandeln. Das bedeutet, sie können ein Kontrollkästchen, einen Stempel oder ein Wasserzeichen so „sehen“, wie ein menschlicher Leser es kann – als eigenständiges visuelles Element, getrennt vom umgebenden Text. Ein angekreuztes Kästchen wird als Häkchen erkannt, nicht als zufälliges Zeichen. Ein über Text gelegter Stempel wird als separate Ebene identifiziert, und das Modell kann den darunterliegenden Text extrahieren, indem es darüber nachdenkt, was dort sein sollte.
Bei Handschrift (Musterfehler): KI-Modelle, die mit Millionen von Handschriftproben trainiert wurden, lernen Buchstaben nicht durch den Abgleich von Glyphenskeletten zu erkennen, sondern durch das Verständnis der Absicht hinter einem Strichmuster. Kontext füllt aus, was die einzelne Buchstabenerkennung übersieht. Liest das Modell „Totl“ in einem Feld mit der Bezeichnung „Fälliger Betrag“ am Ende einer Rechnung, löst es das zu „Total“ auf – nicht weil es plötzlich das „a“ erkannt hat, sondern weil „Totl“ mit dieser Bezeichnung und dieser Position „Total“ sein muss. Diese kontextuelle Korrektur hebt die Handschriftgenauigkeit von 50 % auf 85–93 % bei Druckschrift und 75–85 % bei Schreibschrift.
Keiner dieser Mechanismen ist Zauberei. Jeder versagt unter extremen Bedingungen – stark degradierte Scans, Handschrift, die selbst für Menschen unleserlich ist, Tabellen ohne sichtbare Spaltengrenzen. Aber jeder Mechanismus zielt auf eine spezifische Fehlerart ab, für die herkömmliche OCR keine Antwort hat. Der kumulative Effekt über alle Feldtypen hinweg ist das, was einen Dokumentenstapel von „benötigt 40 % manuelle Prüfung“ zu „benötigt 5 % manuelle Prüfung“ verändert.
Der Unterschied wird sofort sichtbar, wenn Sie es ausprobieren. Die Demo unten verarbeitet eine Rechnung mit denselben oben besprochenen Feldtypen – Daten, Dollar-Beträge, Lieferantenname, Positionen, Steuer – durch eine KI-Extraktionspipeline. Keine Vorlagen, keine Koordinatenzuordnung, keine Vorkonfiguration außer der Eingabe der gewünschten Spaltennamen.
Dateien werden sicher verarbeitet und nicht gespeichert.
So prüfen Sie Ihre OCR: Welche Felder am teuersten zu korrigieren sind
Wenn Sie heute eine Dokumentenverarbeitungs-Pipeline betreiben, ist das Nützlichste, was Sie tun können, die Korrekturkosten nach Feldtyp zu messen – nicht nach der Gesamtgenauigkeit in Prozent. Eine Gesamtquote von 95 % sieht auf einem Dashboard gut aus. Eine Aufschlüsselung nach Feld zeigt Ihnen, wo die 5 % Fehler konzentriert sind und was diese Fehler tatsächlich kosten, um sie zu beheben.
So führen Sie eine Feldgenauigkeitsprüfung Ihrer aktuellen Extraktions-Pipeline durch:
Stichprobe von 100 Dokumenten aus der Produktion.
Verwenden Sie nicht Ihren sauberen Testsatz – nutzen Sie das, was Ihre Pipeline an einem normalen Arbeitstag tatsächlich verarbeitet. Gemischte Anbieter, gemischte Formate, jede Scan-Qualität, die Ihr Team tatsächlich einreicht.
Kategorisieren Sie jeden Extraktionsfehler nach Feldtyp.
Markieren Sie jeden Fehler als Datum, Dollar-Betrag, Name/Adresse, Position (Tabelle), Kontrollkästchen, Handschrift oder gemischter Inhalt. Ein Fehler kann sowohl einen Feldtyp als auch eine Ursache haben – erfassen Sie beides.
Messen Sie die Korrekturzeit, nicht nur die Fehleranzahl.
Das Korrigieren einer verschobenen Positionszeile in einer Tabelle kann 2–3 Minuten dauern, da Sie die Originaldokumente abgleichen müssen. Ein Datumsformat zu korrigieren dauert 10 Sekunden. Zählen Sie die Minuten, nicht die Fehler.
Multiplizieren Sie die Fehlerrate pro Feldtyp mit den Korrekturkosten pro Feld.
Eine Fehlerrate von 5 % bei Dollar-Beträgen, die jeweils $2 zur Korrektur kosten, ist etwas anderes als eine Fehlerrate von 20 % bei Namen, die jeweils $0,50 kosten. Der Feldtyp mit dem höchsten Produkt aus Fehlerrate × Korrekturkosten ist Ihr Engpass.
Wenn Teams diese Prüfung mit herkömmlichen OCR-Pipelines durchführen, die Rechnungen von mehreren Anbietern verarbeiten, zeigt sich ein konsistentes Muster. Positionen und Tabellen verbrauchen die meiste Korrekturzeit – nicht weil sie die höchste Fehlerrate haben (Handschrift gewinnt in dieser Kategorie), sondern weil jeder Tabellenfehler erfordert, dass die Zeilen- und Spaltenbeziehung aus dem Originaldokument rekonstruiert wird. Eine Tabellenfehlerrate von 20 % bei 500 Rechnungen mit jeweils 5 Positionen bedeutet 500 manuell zu rekonstruierende Zeilen. Bei 2 Minuten pro Zeile sind das 16 Stunden Korrekturzeit – mehr als zwei volle Arbeitstage – für einen Batch, den die OCR eigentlich automatisch verarbeiten sollte.
Dollar-Beträge und Daten sind trotz niedrigerer Rohfehlerraten die zweitteuerste Kategorie, weil die Folgen übersehener Fehler hoch sind. Eine falsche Rechnungssumme, die ins ERP gelangt, erzeugt eine Abstimmungsdifferenz, deren Auflösung weit mehr kostet, als die Feldkorrektur gekostet hätte. Für einen breiteren Überblick darüber, wie sich diese Feldfehler zu einer gesamten Pipeline-Ineffizienz summieren, lesen Sie unsere Aufschlüsselung der Genauigkeits-Benchmarks von AI OCR im Vergleich zu herkömmlicher OCR und unseren praktischen Leitfaden zum Festlegen von Genauigkeitserwartungen für die KI-Dateneingabe.
Sobald Sie wissen, welche Feldtypen die meiste Zeit Ihres Teams beanspruchen, stellt sich die Frage, ob die Extraktions-Engine diese spezifischen Feldtypen besser verarbeiten kann. Wenn Ihr Engpass die Tabellenstruktur ist, ersetzt der Wechsel zu einer Engine ohne semantisches Tabellenverständnis ein Problem durch dasselbe Problem. Wenn Ihr Engpass Handschrift oder Kontrollkästchen sind, wird eine Engine, die diese nicht erkennen kann, niemals eine Verbesserung bringen. Das Audit zeigt Ihnen nicht nur, dass die Extraktion fehlschlägt, sondern wo — und das „Wo“ bestimmt, ob ein Upgrade den Engpass tatsächlich behebt oder nur das Logo auf demselben Fehlerprotokoll ändert.
FAQ
Funktioniert herkömmliche OCR bei bestimmten Dokumenttypen besser als bei anderen?
Ja. Herkömmliche OCR funktioniert gut bei sauberen, gedruckten, einspaltigen Textdokumenten mit konsistentem Layout — Verträge, Briefe, standardisierte Formulare aus einer einzigen Quelle. Die Genauigkeit sinkt bei Dokumenten mit Tabellen, Handschrift, gemischten Schriftarten, geringem Kontrast oder Layout-Abweichungen zwischen verschiedenen Quellen. Der Unterschied ist nicht marginal: Ein maschinengeschriebener Brief kann mit 98 % Feldgenauigkeit extrahiert werden, während eine Charge von Rechnungen mehrerer Anbieter mit Positionstabellen nur 60–85 % erreicht.
Kann ich die Genauigkeit herkömmlicher OCR durch Scannen mit höherer Auflösung verbessern?
Bis zu einem gewissen Grad. Das Scannen mit 300 DPI (die Standardempfehlung) verbessert die Zeichenerkennung im Vergleich zu 150 DPI oder aus der Distanz aufgenommenen Smartphone-Fotos. Aber Auflösungsverbesserungen wirken sich nur auf Fehler auf Zeichenebene aus — sie beheben nichts an den strukturellen Schwächen (Tabellen, Feldzuordnung, Kontrollkästchen), die den Großteil der Korrekturzeit in Produktionspipelines ausmachen. Ein schärferes Bild einer kaputten Tabelle ist immer noch eine kaputte Tabelle.
Welcher Feldtyp ist für jedes Extraktionssystem am schwersten korrekt zu erfassen?
Handschrift — insbesondere Schreibschrift — bleibt der schwierigste Feldtyp für jedes System, einschließlich KI-basierter Extraktion. KI-Modelle, die mit vielfältigen Handschrift-Datensätzen trainiert wurden, erreichen 85–93 % bei Druckschrift und 75–85 % bei Schreibschrift — eine deutliche Verbesserung gegenüber den 30–60 % herkömmlicher OCR, aber keine 99 %. Bei Workflows, in denen handschriftliche Felder kritische Daten tragen (Zahlungsbeträge, Patientennamen, Compliance-Prüfwerte), ist die Überprüfung von Extraktionen mit geringer Konfidenz durch Menschen weiterhin der sicherste Ansatz.
Verarbeitet ImageToTable.ai handschriftliche Dokumente?
ImageToTable.ai verwendet ein Vision-Language-Modell, das Handschrift, gedruckten Text, Kontrollkästchen, Stempel und Tabellenstrukturen im selben Dokument erkennen kann. Die Genauigkeit der Handschrifterkennung hängt von Lesbarkeit und Schreibstil ab – saubere Blockschrift wird zuverlässig extrahiert, während stark verschnörkelte Schreibschrift möglicherweise eine manuelle Überprüfung erfordert. Das Modell liefert visuelle Hinweise, die zeigen, aus welchen Bereichen des Dokuments es gelesen hat, sodass Sie handschriftliche Felder schnell stichprobenartig prüfen können, ohne das gesamte Dokument erneut zu lesen. Wenn Ihre Dokumente überwiegend handschriftlich sind, sollten Sie mit einem kleinen Batch-Test beginnen, um die Genauigkeit anhand Ihrer spezifischen Handschriftproben zu messen, bevor Sie skalieren.
Wie unterscheidet sich die Tabellenextraktion von ImageToTable.ai von herkömmlicher OCR?
Herkömmliche OCR liefert einen linearen Textstrom. Tabellen werden dabei eingeebnet. ImageToTable.ai verarbeitet das Dokument als visuelles Layout, erkennt Tabellenbereiche, segmentiert Zeilen und Spalten und ordnet jeden Zellenwert seiner Spaltenüberschrift zu. Die Ausgabe bewahrt die Tabellenstruktur – jede Zeile wird zu einer Zeile in Ihrer Ausgabetabelle, jede Spalte wird der von Ihnen angegebenen Spaltenname zugeordnet. Dies funktioniert ohne Vorlage, sodass eine Rechnung mit 5 Positionen und eine Rechnung mit 20 Positionen desselben Anbieters unabhängig von der Tabellenhöhe korrekt extrahiert werden. Eine ausführlichere Erklärung, wie sich dies von herkömmlichen Ansätzen unterscheidet, finden Sie in unserer Übersicht zur KI-Datenerfassung.
Die Frage ist nicht, ob Ihre OCR Fehler macht. Jedes Extraktionssystem hat welche. Die Frage ist, ob sich die Fehler auf Ein-Minuten-Korrekturen konzentrieren oder auf Felder, in denen jeder Fehler zu einer Stunde Abgleicharbeit führt. Führen Sie den Audit bei Ihrem nächsten Batch durch – messen Sie die Korrekturzeit nach Feldtyp, nicht die Gesamtgenauigkeit – und Sie wissen, in welcher Kategorie Sie sich befinden.