OCR精度を向上させる方法:
実際に効果のある10の実践的なヒント
このガイドを読み終える頃には、スキャンとドキュメント前処理のワークフローで何を変更すれば、OCR結果を測定可能な形で改善できるかを正確にご理解いただけます。「より良い画像を使う」といった曖昧なアドバイスではなく、具体的で実行可能な手順と、その根拠となる数値をご紹介します。各ヒントは、「なぜ重要か」「何をすべきか」「どれだけの精度を回復できるか」という3つの問いに答えます。コストがかからないものもあれば(スキャナー設定の変更)、数秒の前処理を必要とするものもあります。すべて効果があります。
重要なポイント
- OCR精度の15〜20%は、エンジンがドキュメントを処理する前に失われます。150 DPIのスキャンでは、eとcを区別するのに十分なピクセルがなく、どんな高級なOCRツールでも、そもそも取り込まれなかった情報を読み取ることはできません。
- 文字精度99%はほぼ完璧に聞こえますが、計算してみると、密度の高いページ1枚につき50文字の誤りが発生することになります。そして、請求書の合計金額の数字を1つ読み間違えるだけで、抽出結果全体が役に立たなくなります。
- コストがかからない3つの変更、つまり300 DPIでスキャンする、ページを平らにして均一な光を当てる、デスキュー(傾き補正)を有効にする、だけで、前処理や新しいエンジン、お金をかけずに、精度の問題の80%を解決できます。
始める前に
OCRの精度はパイプライン全体に依存します。入力画像の品質、OCRエンジンがそれを処理する方法、そして出力後に何をするか。このチェーンのどこかに弱点があると、最終結果が低下します。
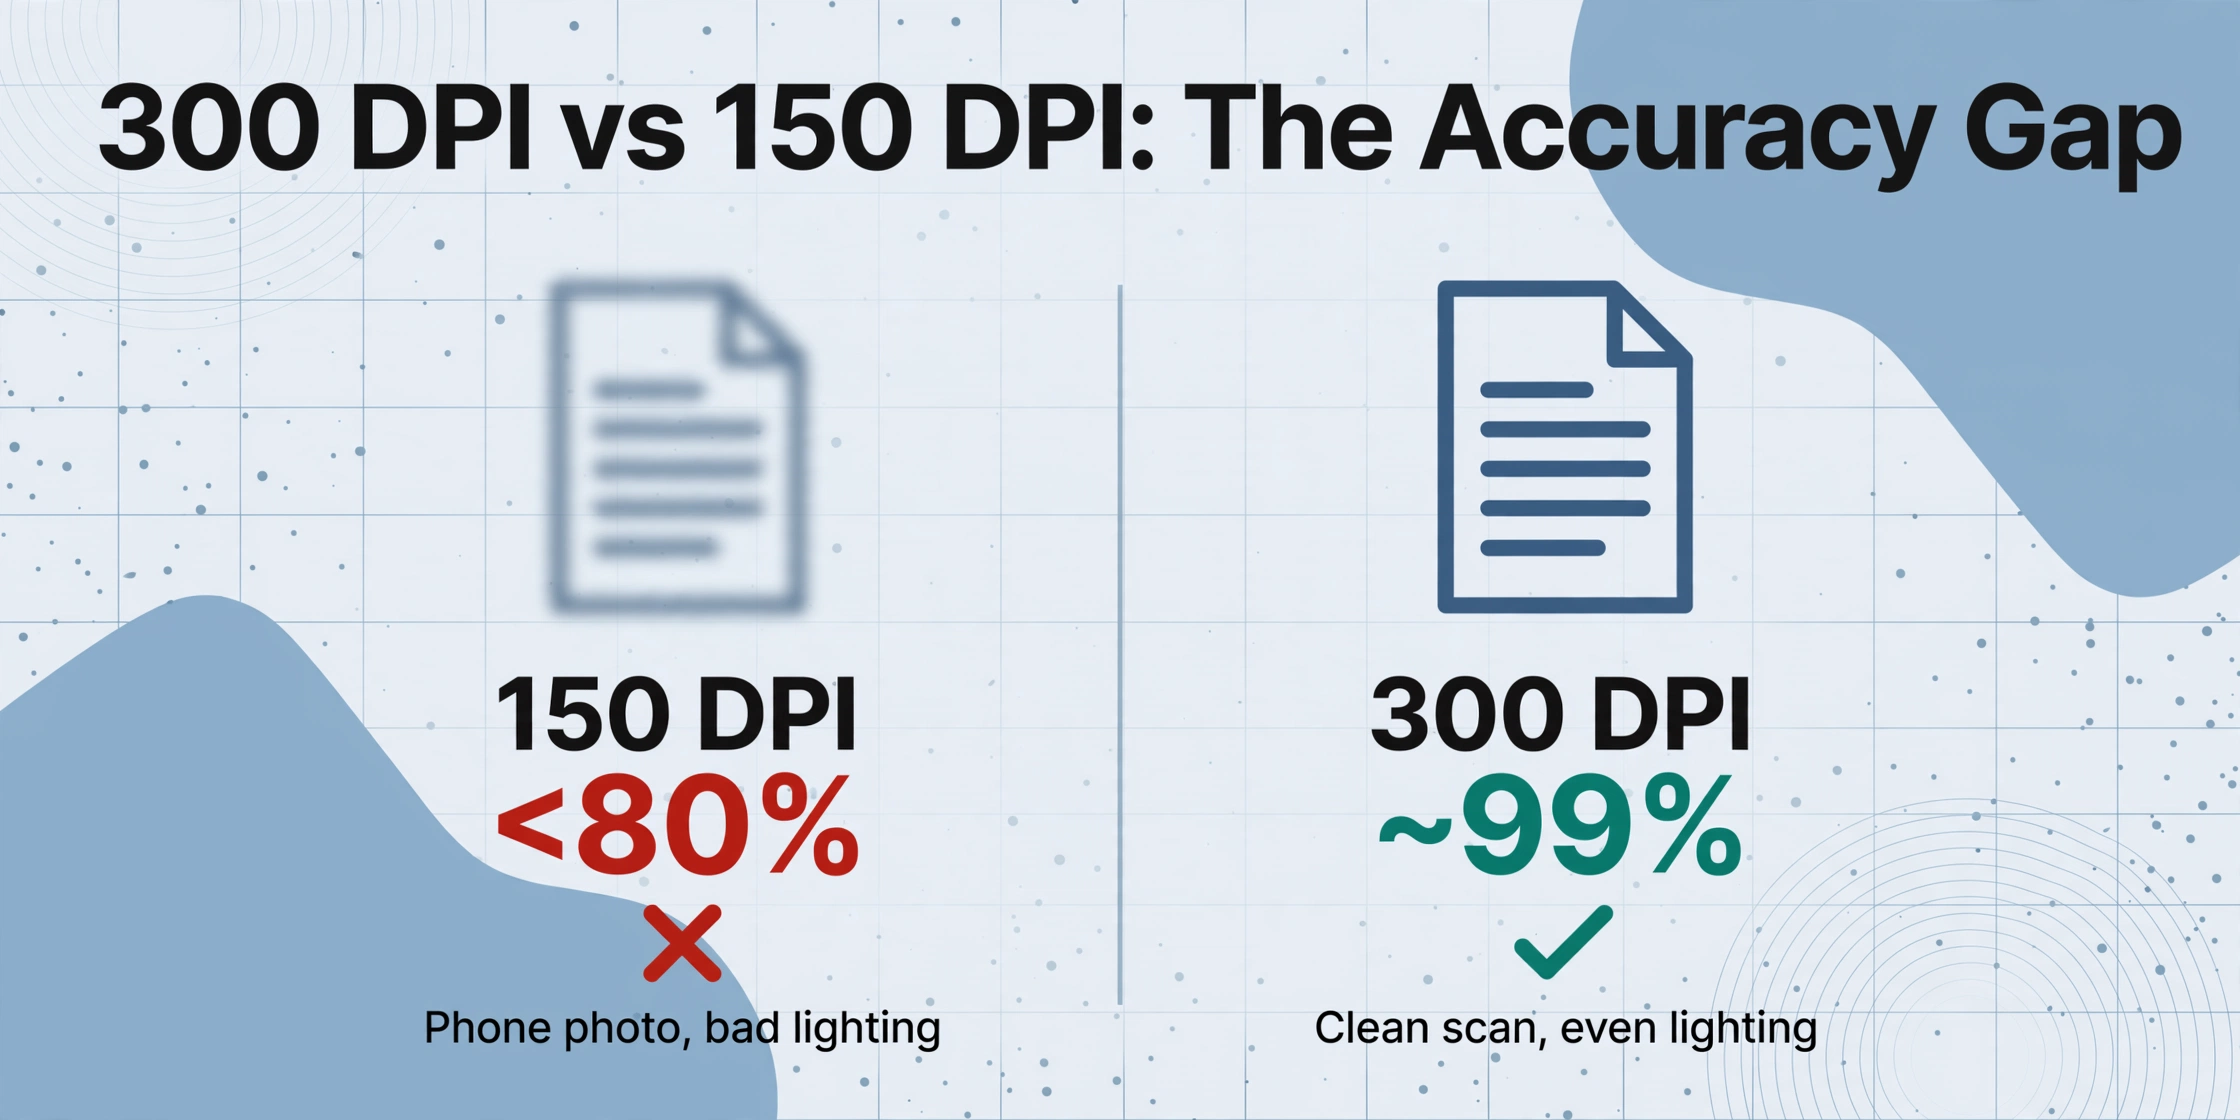
良いニュースは、最大の改善効果は最も初期の段階(スキャン品質と画像前処理)で得られることであり、そのほとんどを自分でコントロールできることです。300 DPIで均一な照明と適切なコントラストでスキャンしたドキュメントは、最新のOCRエンジンで99%近い精度を達成できます。同じドキュメントを150 DPIで、照明の悪い環境でスマートフォンの写真からスキャンした場合、どのOCRソフトウェアを使用しても80%に達するのがやっとでしょう。
このガイドでは、効果の高い順に10のテクニックを紹介します。最初のいくつかから始めてください。それだけで精度の問題のほとんどが解決します。
OCR精度の測定方法や、ベンダーの主張が誤解を招く理由に馴染みがない場合は、まずOCR精度とは実際には何を意味するのか?をお読みください。以下のヒントをより有意義にする、文字レベルとフィールドレベルの精度の違いを説明しています。
1. 300 DPI以上でスキャンする
重要な理由:画像解像度は、OCR精度において最もコントロールしやすい要素です。OCRエンジンが文字を認識しようとするとき、形状を判別するのに十分なピクセルが必要です(「e」のループ、「t」の横棒、「M」のセリフなど)。ピクセルが少なすぎると、異なる文字が同じようなぼやけた形状に潰れてしまいます。AI MultipleのOCR精度ベンチマークによると、150 DPIでスキャンしたドキュメントは、同じドキュメントを300 DPIでスキャンした場合と比較して15〜20%の精度低下が見られます。150 DPIを下回ると、精度は急激に落ち込みます。
対処法:スキャナーを少なくとも300 DPI(1インチあたりのドット数)に設定してください。小さなフォント(8ポイント未満)や密度の高い表を含むドキュメントには、400〜600 DPIを使用してください。600 DPIを超えるのは避けてください。収穫逓減が発生します。600 DPIは小さなフォントで300 DPIより約2〜3%向上しますが、1,200 DPIはほとんど改善せず、ファイルサイズと処理時間が3倍になります。
スマートフォンの写真の場合:最近のスマートフォンのほとんどは、300 DPI相当をはるかに超える画像を撮影できます。問題は実効解像度です。遠すぎる場所から撮影したり、斜めから撮影したりすると、テキストが占めるピクセル数が減ります。ドキュメントがフレームの大部分を占めるように近づいて撮影してください。目安として、スマートフォンの画面で全てのテキストを快適に読めるなら、解像度はおそらく十分です。
期待できる改善効果:低解像度スキャンと比較して15〜20%の向上。これは最も投資対効果の高い変更です。スキャナー設定を調整するだけでコストはかかりません。
2. 照明条件を整える(特にスマホ撮影の場合)
重要な理由:不均一な照明は、文書全体に影、ハイライト、グラデーションを生み出します。OCRエンジンはテキストを読み取る前に、これらをすべて除去する必要があります。請求書の日付に影がかかると、「2024-03-15」が「2024-03-1S」と誤認識されることがあります。「5」が部分的に隠れているためです。デスクランプの映り込みは、列全体を白飛びさせることがあります。
対処法:文書を平らな面に置き、均一で拡散した光を当てます。手やスマホの影ができるような真上の直射光は避けてください。曇天の日の窓からの自然光が最適なことが多いです。定期的に文書をスキャンする場合は、小型のフラットベッドスキャナやドキュメントフィーダースキャナを使えば、照明のばらつきを完全に排除できます。
バッチ取り込みの場合:フラットベッドスキャナやドキュメントフィーダーは、制御された一貫した照明を提供します。処理量に見合うのであれば、一貫した照明だけでも精度向上の効果はハードウェアのコストに見合うことが多いです。
期待できる改善効果:以前は照明が不十分だったモバイル撮影文書では5〜10%。さらに重要なのは、照明のばらつきによって生じる予測不能なエラーを排除できることです。こうしたエラーは、もっともらしく見えるため見逃されがちです。
3. 画像のコントラストを強調する
重要な理由:低コントラスト(明るいグレーの背景に濃いグレーのテキスト)は、OCR精度の静かな殺し屋です。人間がかろうじて読める文字も、OCRエンジンには同じように見えます。テキストが背景に溶け込み、エンジンは部分的な形状情報に基づいて推測することになります。
対処法:テキストと背景のコントラストを高めます。最も効果的な方法は、コントラスト制限適応ヒストグラム均等化(CLAHE)です。これは、均一な領域のノイズを過度に増幅することなく、局所的なコントラストを強調します。標準的なグローバルヒストグラム均等化も有効ですが、ノイズの多い背景を悪化させる可能性があります。
実際には:多くのOCRツール(Adobe Acrobat、ABBYY FineReader、Tesseractなど)には、コントラスト強調機能が組み込まれています。自分で画像を前処理する場合は、OpenCVのcreateCLAHE関数で直接制御できます。ほとんどの文書では、クリップリミットを2.0〜3.0、タイルグリッドサイズを8×8に設定してください。
期待できる改善効果:自然にコントラストが低い文書(色あせたレシート、古いコピー、時間の経過とともに色あせた感熱紙の印字など)では5〜10%です。
4. 傾き補正(傾いたページ)
重要な理由: わずかに回転した文書(5度程度、目で見てほとんど気にならない程度)でも、OCRの単語誤り率を15%以上増加させる可能性があります。エンジンは水平なテキストベースラインに依存して行や単語を分割します。ベースラインが傾くと行分割が失敗し、2つの行の文字が結合したり、1つの行が断片に分割されたりします。その結果、元の文書とは似ても似つかないスクランブルされた出力になります。
対処方法: デスキュー(傾き補正または回転補正とも呼ばれます)を使用します。ほとんどのOCRソフトウェアには自動デスキュー機能が含まれているので、それを有効にしてください。手動で前処理する場合は、傾き角度を検出し(通常はハフ変換または最大テキストブロックの境界ボックスを使用)、その角度の負の値だけ画像を回転させます。ScanTailor、unpaper(Linux)、Adobe Acrobatの組み込みデスキュー機能などが適切に処理します。
重要な閾値: Tesseract OCRは、約±2度の傾きであれば精度の大幅な低下なしに処理できます。2度を超えると自動デスキューが必須になります。10度を超えると、一部のOCRエンジンは完全に失敗します。
期待される改善効果: 目立つ傾きのあるページで単語誤り率が10〜15%削減されます。これは最も簡単な修正の1つで、ほとんどのスキャンソフトウェアではチェックボックス1つで済みます。
5. 正しい言語を設定する
重要な理由: OCRエンジンは言語モデルを使用して文字を曖昧性なく識別します。エンジンが英語に設定されている場合、「rn」(rの後にn)が特定の文脈で「m」よりも可能性の高い文字シーケンスであることを認識しますが、「an」の後に続く単語が特定の文字の組み合わせで始まる可能性が低いことも認識します。文書がドイツ語でエンジンが英語に設定されている場合、一般的なドイツ語の文字の組み合わせ(「ß」「ä」「ö」など)を誤解釈し、誤った言語モデルに基づいて誤った修正を強制する可能性があります。
対処方法: OCR言語を文書に合わせて設定します。文書に複数の言語が含まれている場合(例:フランス語の用語を含む英語の請求書)、関連するすべての言語を選択します。最新のOCRエンジンのほとんどは多言語モードをサポートしています。追加言語を有効にすることによるパフォーマンスコストは無視できる程度ですが、誤った言語を使用することによる精度コストは重大です。
多言語文書: 国際的な請求書、EUの税関フォーム、バイリンガル契約書などの文書では、言語が混在することがよくあります。OCRエンジンで関連する言語(例:英語+フランス語+ドイツ語)を有効にすると、エンジンがフランス語の単語を「無効な」英語の綴りと見なして誤読するという一般的な障害モードを回避できます。
期待される改善効果: 非ネイティブ言語の文書で3〜8%の改善が見込めます。さらに重要なのは、言語固有の文字に関する壊滅的な失敗を減らすことです。
文書の種類によって、言語設定の変更に対する反応は異なります。詳細な内訳については、文書タイプ別のOCR精度低下の理由をご覧ください。
6. グレースケール変換と適応的二値化を適用する
重要な理由:カラー画像には、OCRエンジンが文字認識に必要とする以上のデータが含まれています。その余分なデータには、ノイズ、圧縮アーティファクト、文字のセグメンテーションを妨げる色のグラデーションが含まれることがよくあります。グレースケール変換は、輝度情報を保持しながら色の次元を除去します。二値化はさらに一歩進んで、画像を白背景に黒文字の純粋な形式に変換します。これは、ほとんどのOCRエンジンが内部的に好む形式です。
実行方法:まずグレースケール変換を適用します。次に、適応的二値化(グローバル二値化ではなく)を使用して画像を二値化します。グローバル二値化は画像全体に1つのしきい値を適用するため、照明が不均一な文書や部分的な影がある文書ではうまく機能しません。適応的二値化は領域ごとに局所的なしきい値を計算するため、グラデーションを自然に処理できます。
推奨方法:クリーンな文書には大津の二値化が良い出発点です。照明が変動する文書には、適応的ガウス二値化(OpenCVのadaptiveThresholdとADAPTIVE_THRESH_GAUSSIAN_C、ブロックサイズ11〜15、Cパラメータ2〜5)を使用してください。
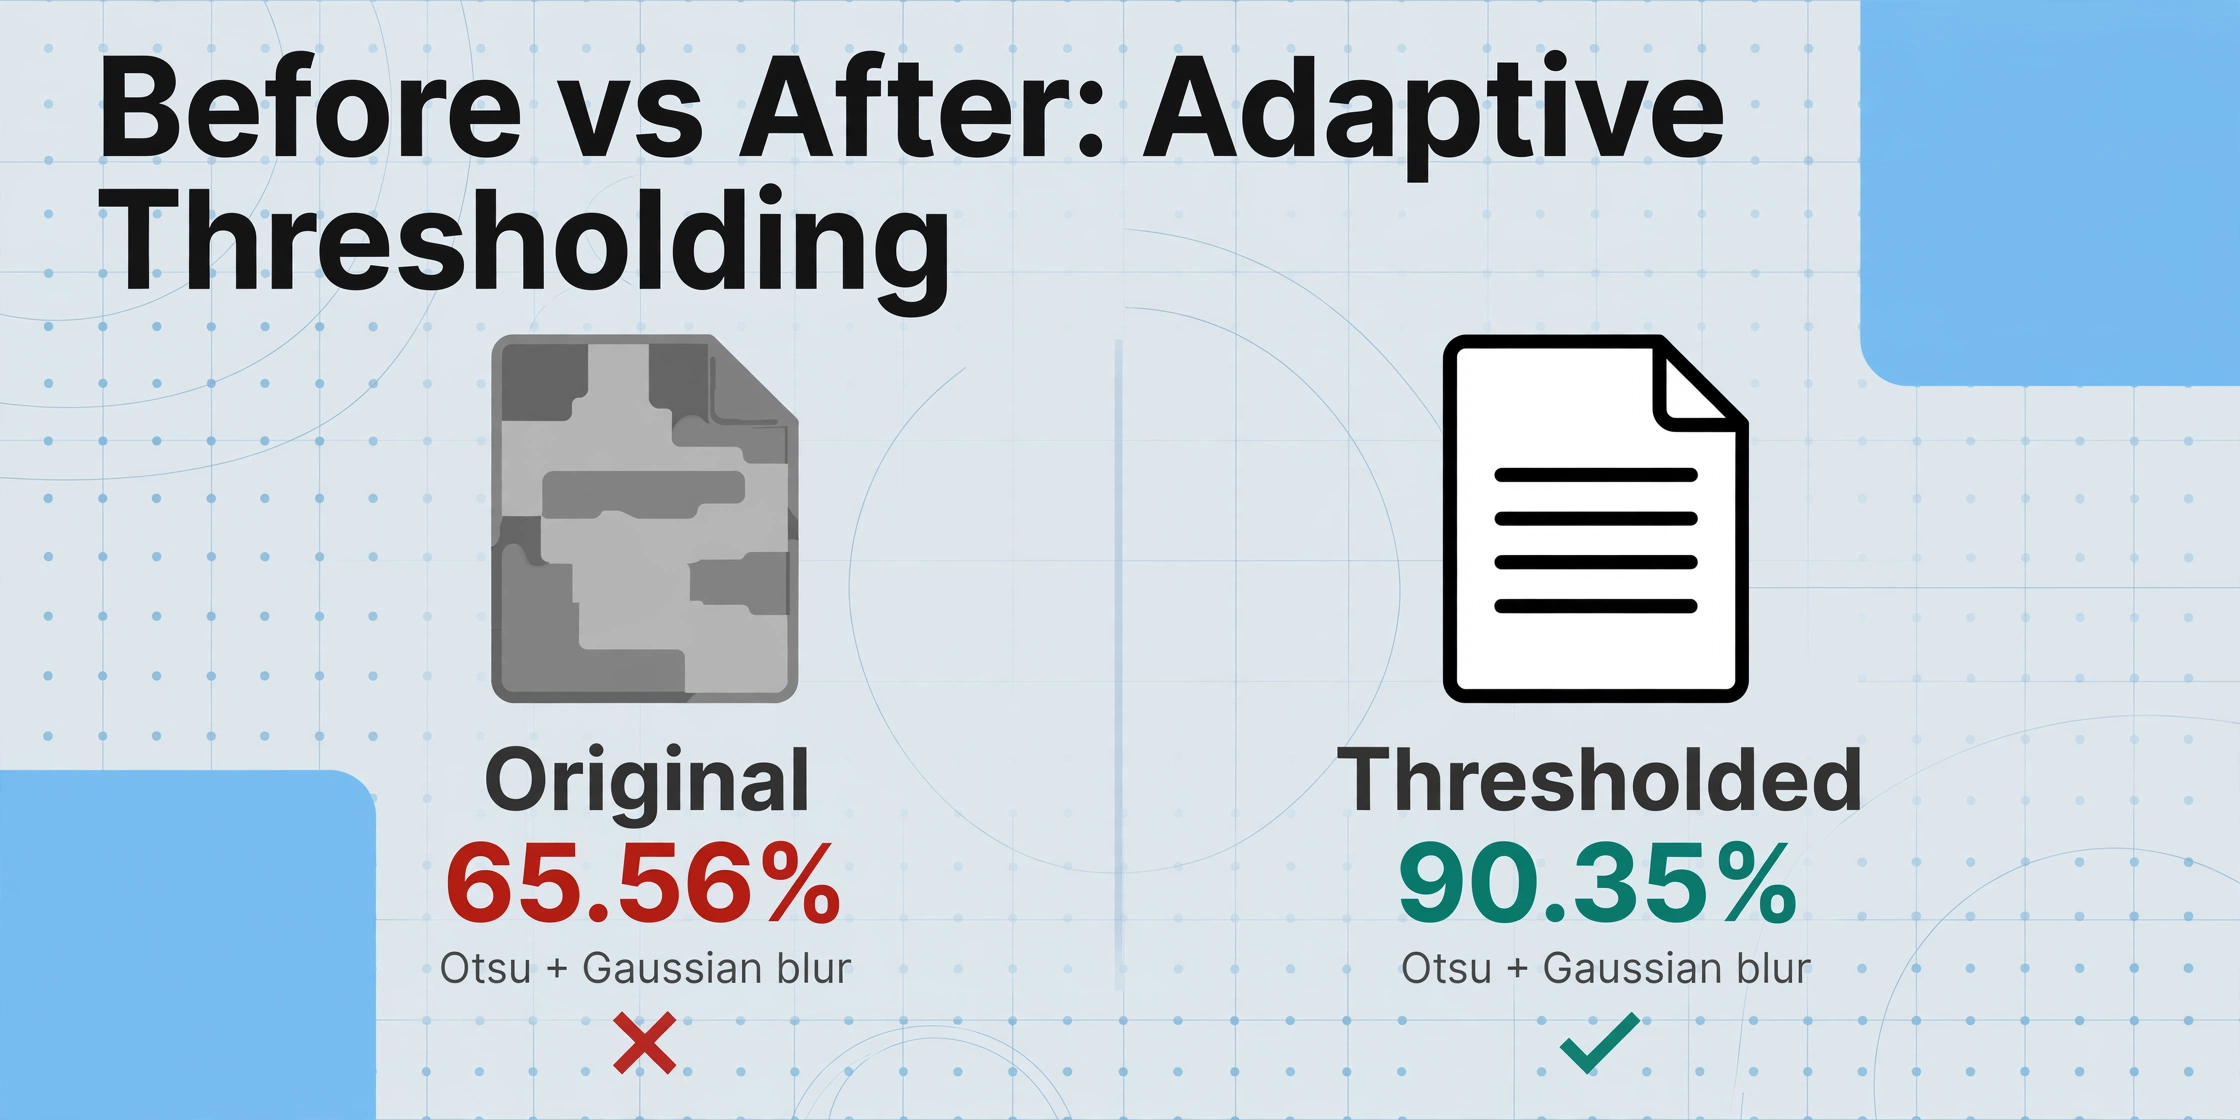
期待される改善効果:背景ノイズや色のグラデーションがある文書では、精度が5〜15%絶対値で向上します。International Journal of Environmental Sciencesに掲載された研究では、大津の二値化とガウシアンブラーを適用することで、印刷テキストのOCR精度が65.56%から90.35%に向上したことが報告されています。
7. 後処理でスペルチェックと辞書検証を活用する
重要な理由: 最高のOCRパイプラインでも誤りは発生します。文字精度99%でも、100文字に1文字は誤りがあることになり、5,000文字(密度の高いページ約1枚分)の文書では50件の誤りになります。これらの誤りの多くは微妙なものです。「rn」が「m」と読まれたり、「cl」が「d」と読まれたり、「0」(ゼロ)が「O」(オー)と読まれたりします。スペルチェッカーは抽出された「1O」が「10」であるべきかどうかは判断できませんが、後処理の検証レイヤーはそれを疑わしいとフラグし、ドメイン固有の修正を適用できます。
対処方法: OCR出力をドメイン固有の辞書を持つスペルチェッカーに通します。実用的な2層アプローチは次のとおりです。
レイヤー1 — 一般的なスペルチェック: 出力を言語スペルチェッカー(Hunspell、LanguageTool、またはワープロソフトの内蔵チェッカーでも可)に通します。ドメイン用語ではない明らかなスペルミスを修正します。
レイヤー2 — カスタム辞書: ドメイン固有の用語(ベンダー名、製品コード、標準用語、法務フレーズ)の辞書を作成します。OCR出力に出現するが、一般的な辞書にもカスタム辞書にもない単語をフラグします。フラグされた用語は手動で確認します。
期待される改善効果: 単独では1〜3%の精度向上ですが、重要なのは他のすべてをすり抜ける誤り(「1O」と「10」の問題、「rn」と「m」の混同、重要用語のスペルミス)を捕捉できることです。本番ワークフローでは、自動OCR検証に関する公開研究によると、後処理検証は残存するOCR単語誤りの約60%を捕捉します。
8. 重要フィールドを個別に検証する
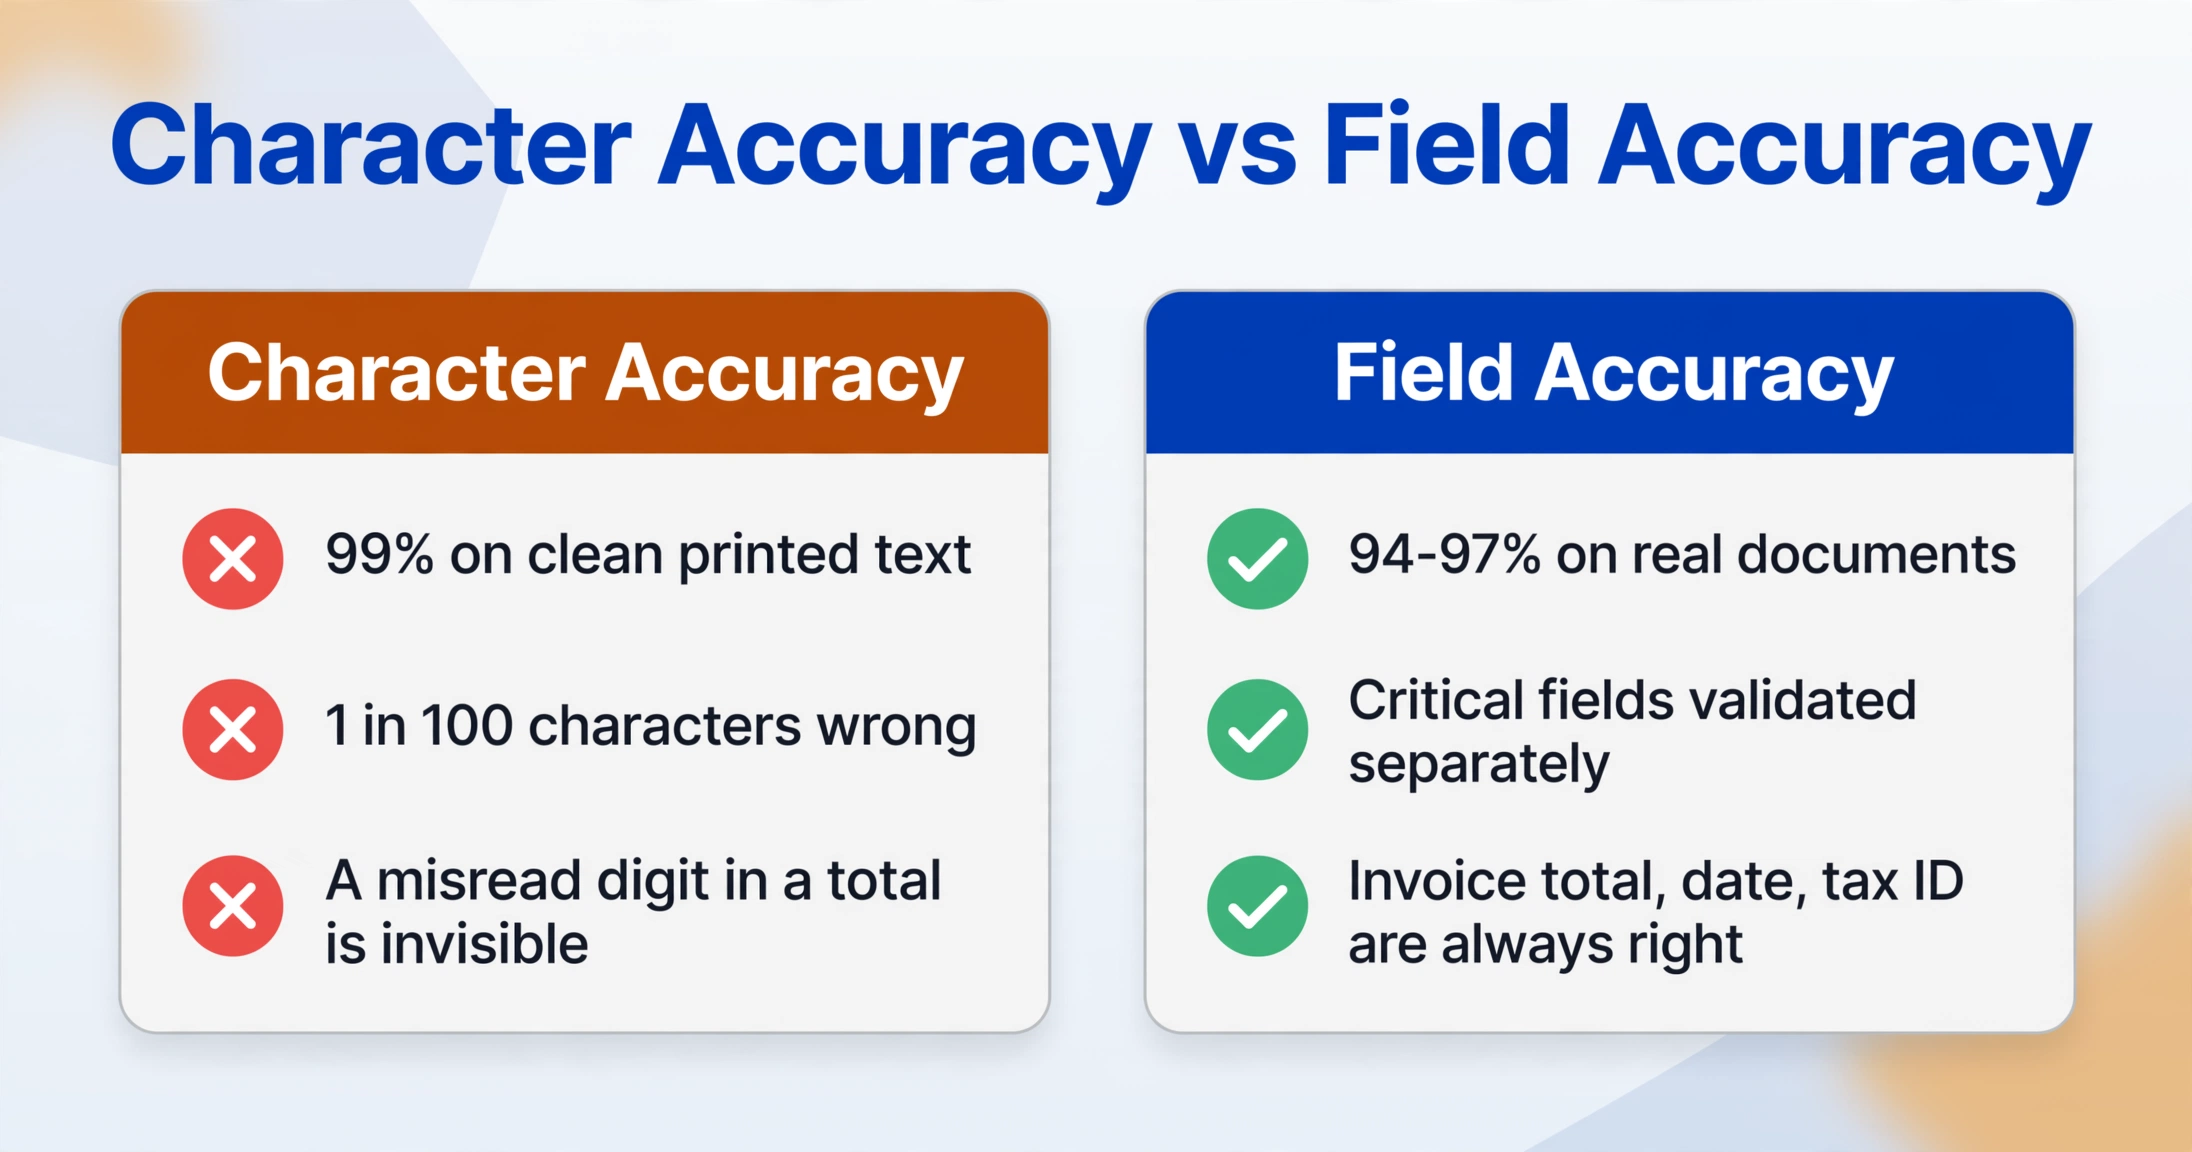
重要な理由: すべてのフィールドが同等ではありません。本文の段落での文字の読み間違いは無害です。読者は理解できます。しかし、請求書の合計金額、期日、税IDの数字の読み間違いは致命的です。文字レベルの精度とフィールドレベルの精度の区別は、OCR品質における最も重要な概念です。文字精度が99%でも、5桁の金額の1桁を読み間違えれば、請求書の合計金額を誤る可能性があります。
対処方法: 文書内の重要フィールド(金額、日付、請求書番号、ベンダー登録ID、数量)を特定し、それらのフィールドにのみ厳格な検証を適用します。
金額フィールド: 抽出された値が期待される形式(数値、小数点の有無、妥当な範囲内)と一致するか確認します。パターンから逸脱する値をフラグします — 例えば、ほとんどの仕入先請求書が$100〜$5,000の範囲であるのに、合計が$1,200,000となっている場合は、読み取りミスの可能性が高いです。
日付フィールド: 期待される日付形式(YYYY-MM-DD vs DD/MM/YYYY)、範囲(遠い未来や遠い過去でないこと)、および論理的な整合性(請求日より後の支払期日)に対して検証します。
数値識別子: 請求書番号、発注書番号、税IDは多くの場合、特定のパターンに従います。既知の形式が「INV-2026-XXXXX」の場合、一致しない抽出番号をフラグします。
期待される改善効果: このヒントは全体的な精度を向上させるものではなく、実用可能な精度を向上させます。最も重要なフィールドが正しいことを保証し、重要でないテキストの軽微なエラーは許容します。ビジネスワークフローでは、これは完全な手動レビューが必要な出力と、スポットチェック後に直接使用できる出力との違いです。
ビジネス文書においてフィールドレベルの精度が重要となる指標である理由の詳細については、OCR精度とは実際には何を意味するのか?をご覧ください。
9. 可能な場合はOCRに適したフォントを選択する
重要な理由: すべてのフォントがOCRエンジンにとって同等というわけではありません。Arial、Helvetica、Courier、Times New Roman(通常のウェイト)のようなシンプルで均一、かつスペースが適切なフォントは、最も高い認識率を生み出します。装飾フォント、スクリプトフォント、凝縮フォント、および非常に細いストロークのフォントは、文字間の差異が小さくなりすぎて、エンジンが確実に区別できないため、問題が発生します。
対処方法: ドキュメントを自分で作成する場合(請求書、発注書、契約書の生成)、10 pt以上の標準的なサンセリフまたはセリフフォントを使用してください。避けるべきもの:
- スクリプトまたは手書き風フォント(文字間の境界があいまいになります)
- 凝縮フォント(文字が近すぎてセグメンテーションが困難です)
- 非常に明るいまたは細いフォント(ストローク幅がOCRエンジンが解像できるしきい値を下回ります)
- すでに小さいフォントのイタリック変種(斜体により実効的な文字間隔が減少します)
受信側の場合: このヒントは主に予防的なものです。サプライヤーが難しいフォントでドキュメントを送信する場合、前処理(特にコントラスト強調と適応的二値化)である程度補正できますが、認識率は標準フォントよりも低くなります。これを理解することで、現実的な期待値を設定できます: ドキュメント作成者によるフォント選択の不備は、前処理の品質に関係なく精度を制限する可能性があります。
期待される改善効果: 難しいフォント(スクリプト、装飾、または非常に細い)から標準フォントに切り替えると、2〜5%の改善が見込まれます。さらに重要なのは、特定のフォントの一部の文字が一貫して誤読され、他の文字は問題ないという「ランダムな失敗」パターンを排除できることです。
10. クリーンな原本から始める
重要な理由: 根本的に劣化したソースからテキストを完全に復元できる前処理はありません。財布に6ヶ月入っていたしわくちゃのレシート、ファックス後にスキャンされた契約書、経年で黒ずんだ感熱紙の印刷物 — これらの文書は情報を恒久的に失っています。前処理でノイズ除去、傾き補正、コントラスト強調はできますが、もはや存在しないピクセルを復元することはできません。
対処法: スキャナーに通す前に文書の品質を考えましょう。
- 原本は平らで乾燥した状態で保管してください。しわくちゃの紙は折り目による影と永久的な歪みを生みます。
- 重要な文書については、物理的なコピーをスキャンするのではなく、送信元にクリーンなコピーまたはデジタル原本(PDF)を依頼してください。
- ファックス機を通った文書のスキャンは避けてください — ファックスは画像を大幅に圧縮し、重大なアナログノイズを導入します。
- 損傷した原本をどうしてもデジタル化する必要がある場合は、手動検証を優先してください — 自動処理では完全に修正できないエラーが発生します。
期待できる改善効果: 現在のソース文書の劣化度合いに完全に依存するため、定量化は困難です。しかし、簡単なテストがあります:あなた自身が文字を確信を持って読めないなら、OCRエンジンも読めません。それを、よりクリーンなソースに投資するか、手動レビューが必要だと受け入れるかの判断基準にしてください。
一般的なOCR問題のトラブルシューティング
10のヒントをすべて適用しても、精度の問題が残ることがあります。以下は最も一般的な失敗モードとその診断方法です。
OCRが「rn」を「m」と読んだり、「0」を「O」と読んだりするケースが続く場合、原因はほぼ解像度かフォントにあります。DPIを400以上に上げ、フォントが凝縮されていたり極端に細かったりしないか確認してください。カスタム文字ホワイトリスト(例:金額フィールドは数字のみ)を安全策として設定することもできます。
これはOCRエンジンではなく、ドキュメント自体に問題があることを示しています。特殊なフォント、印字品質の低さ、元のコントラスト不足、標準外のレイアウトがないか確認してください。ヒント5(言語設定)を再確認しましょう。ドキュメントタイプによっては、言語設定の誤りに敏感なものがあります。
従来のOCRは手書き文字を根本的に苦手としています。手書き文字で文字精度90%でも、OCR手書き文字精度:90%のCERでも合計値が誤る理由で説明されているように、合計値が誤ることになります。手書きドキュメントには、手書き文字向けに設計されたAI抽出ツールを使用し、重要なフィールドは手動での検証を計画してください。
複雑なテーブルレイアウトには、レイアウトを認識する処理が必要です。標準のOCRはページを単一のテキストストリームとして扱います。テーブルの位置がずれる場合は、お使いのOCRツールがレイアウト解析やテーブル抽出モードに対応しているか確認してください。罫線(テーブルの枠線)を除去する前処理は、逆効果になることがあります。表構造を理解するOCRエンジンを使用してください。
よくある質問
あらゆる文書でOCR精度99%を達成できますか?
いいえ。多くのベンダーが掲げる99%という数値は、標準的なフォントで印刷された、きれいな単一言語の文書における文字レベルの精度を指しており、実際の文書にはほとんど当てはまりません。複合的な文書ワークフロー(スマホ写真、スキャン紙、複数のレイアウトと言語)では、フィールドレベルで94〜97%の精度が現実的な目標です。上記のヒントでその差を大幅に縮められますが、一部の文書タイプ(手書き、非常に古いスキャン、感熱紙)では常に手動レビューが必要です。
DPIが高いほどOCR精度は常に向上しますか?
ある程度まではその通りです。150 DPIから300 DPIへの変更では明確な精度向上(15〜20%)が見られます。300 DPIから600 DPIへの変更では、小さなフォントで2〜3%の向上です。600 DPIを超えると精度向上はごくわずかですが、ファイルサイズと処理時間は大幅に増加します。最適なのは、ほとんどの文書で300 DPI、非常に小さな文字(8ポイント未満)の文書では400〜600 DPIです。
OCRにはJPEGとTIFFのどちらが適していますか?
可逆圧縮のTIFF(またはPNG)の方がJPEGより優れています。JPEGは非可逆形式であり、ファイルサイズを減らすために画像データを破棄しますが、その破棄されるデータにはOCRエンジンが使用する微妙な文字エッジ情報が含まれていることがよくあります。JPEGを使用する必要がある場合は、品質を最大(95〜100%)に設定してください。長期的な文書保存とバッチOCRには、非圧縮TIFFまたは高品質PDFが標準的な推奨事項です。
スマホのカメラはフラットベッドスキャナーと同等に機能しますか?
一貫して同等とは言えません。最新のスマホカメラは十分な解像度を持っていますが、フラットベッドスキャナーが排除する変動要因(照明のばらつき、台形歪み(文書に完全に平行でないことによる遠近効果)、レンズ歪み、モーションブラー)が生じます。注意深く撮影したスマホ写真は、スキャナーに近いOCR結果を生み出せます。平均的なスマホ写真は著しく劣ります。実際の差は、撮影の注意深さに応じて5〜10%の精度差になることがよくあります。
前処理ソフトウェアを使用すべきですか、それともOCRエンジンに任せるべきですか?
最新のOCRエンジンのほとんどには、組み込みの前処理(自動傾き補正、コントラスト調整、二値化)が含まれています。一貫したソースからのきれいな文書には、組み込みの処理で十分です。難しい文書(古いスキャン、スマホ写真、かすれた感熱印刷)には、専用ツール(ScanTailor、OpenCVスクリプト、Adobe Acrobatなどの前処理オプション)による手動前処理で、より細かい制御が可能になります。目安としては、組み込みの前処理が文書の80〜90%を良好に処理し、残りの10〜20%を不十分に処理する場合は、例外を手動で前処理してください。
OCRの精度は使用とともに向上しますか?
従来のOCRエンジンの場合、答えは「いいえ」です。処理するドキュメントの数に関係なく、エンジンは変わりません。視覚言語モデルを使用するAI抽出ツールの場合、答えはもう少し複雑です。基盤となるモデルは定期的に更新されるため、精度は時間とともに向上する可能性がありますが、従来の意味でのユーザーごとの学習はありません(モデルはあなたの修正を記憶しません)。実際的な意味合いとしては、精度の問題を追跡し、繰り返し発生するエラーパターンに基づいて前処理パイプラインを調整することです。ツールがあなたのミスから学習するのを待つのではなく。
上記の10のヒントは、スキャンボタンに触れた瞬間から最終出力を確認する瞬間まで、完全な精度パイプラインを構成します。 順番に取り組んでください。解像度と照明から始め(最も効果の高い変更)、必要なドキュメントには前処理を追加し、後処理の検証を使用してすり抜けるエラーをキャッチします。ほとんどのユーザーは、ヒント1〜4で精度の問題の80%が解決されることを発見しています。ヒント5〜10で残りのギャップを埋めます。
10すべてを適用した後も精度の問題が発生している場合、制限はおそらくOCRエンジン自体にあります。すべてのエンジンが難しいドキュメントを同等に処理できるわけではありません。次のステップは、実際のばらつきに対応するように設計されたツールでドキュメントをテストすることです。サンプルを実行して、上記のヒントでギャップがどの程度埋まったかを確認してください。