紙の通帳問題
中小企業が気づかないうちに負っているコスト
2024年、日本の消費者決済の42.8%がキャッシュレス化され、PayPay、Suica、政府のポイント還元によって過去最高を記録しました。しかし、日本の銀行に行けば、ATMは今でも紙の通帳を吐き出します。銀行通帳(通帳)—1970年代に遡る機械で1行ずつ更新される印刷された台帳—は、ゆうちょ銀行の約1億2000万口座と、MUFGやSMBCなどのメガバンクのさらに数千万口座にとって、今でも主要な金融活動の記録です。弥生会計やfreeeで複式簿記を必要とする青色申告を行う中小企業の経営者にとって、印刷された各行はデジタルの仕訳帳の1行にならなければなりません。その2つの間の橋渡しは、キーボードの前にいる人間、つまり5cm×7cmの列に並んだ省略された日本語コードを見つめ、それぞれが何を意味するのかを判断しようとしている人間なのです。
重要なポイント
- 通帳の各行は、1桁を入力する前に、まず和暦の年号と銀行固有の略語コードを解読することを要求します。入力自体がボトルネックだったのではなく、隠れた翻訳作業こそが問題だったのです。
- 定期的なATM訪問を逃すと、合計記帳によって通帳から個々の取引が永久に消去されます。これは、四半期ごとの財務諸表がそれに依存しているまさにその時に、データを破壊するスペース最適化なのです。
- 通帳のどの行でも1桁の読み間違いは、その後のすべてのページのすべての残高を静かに破壊します。そして、そのエラーは会計ソフトが照合を拒否するまで隠れたままなのです。
通帳パラドックス:2024年の会計ワークフローに残る1970年代の書類
日本は、物理的な銀行通帳が今なお大衆向け金融商品として残る唯一の先進国です。MUFGやSMBCの支店に入れば、ATMが最新の取引を綴じ込み式の通帳に直接印字します。ドットマトリックス印字ヘッドによる5列——日付(月日)、摘要コード(摘要)、お支払金額、お預り金額、差引残高。この形式は、銀行窓口担当者が手作業で残高を照合し、CSVエクスポートという概念が存在しなかった時代に設計されました。それ以来、実質的に変わっていません。
一方、日本の中小企業が使う会計ソフト——70万社以上が利用する弥生会計、45万の有料顧客を抱えるクラウド会計のリーダーfreee、44万2千の有料企業を擁するMoneyForward Cloud——は根本的に異なる前提で動いています。取引データがデジタルで届くことを前提としているのです。CSVインポート、銀行APIフィード、自動記帳ルール。通帳はその前提のすべてを同時に破ります。
これは「デジタルリテラシー」の問題でも「日本は遅れている」という決まり文句でもありません。書類形式の不一致です。金融活動を記録するインフラとそれを記帳するインフラは、50年の隔たりを持ち、互いに連携する必要のなかった異なる業界によって構築されました——そしてその橋渡しを、人が読み取って打ち直すことで担わされているのです。
ゆうちょ銀行だけでも約1億2千万口座を保有しています——国民一人につきほぼ一つの割合です。MUFG、SMBC、みずほを合わせればさらに数千万口座になります。その大半は今も紙の通帳をデフォルトで発行しています。インターネットバンキングを利用している顧客でさえ、日常の確認はデジタル、確定記録は通帳と、両方を持つことが多いのです。所得税法第143条に基づき65万円の特別控除を受ける代わりに適正な複式簿記を義務付けられる青色申告を行う個人事業主にとって、通帳のすべてのページのすべての取引は仕訳に遡れる必要があります。通帳は任意ではありません。それは監査証跡なのです。
構造的な問題を率直に言えば、人間の窓口担当者が目で残高を確認するために設計された書類が、機械可読な取引フィード用に設計されたソフトウェアの主要なデータソースとして使われています。その不一致は絶対的であり、そのコストはすべてキーボードの前の人間にのしかかります。
本当の作業は入力ではない — 翻訳だ
通帳データ入力の問題を語る際の定番は「入力に時間がかかりすぎる」というものだ。この捉え方は間違っており、労力が実際にどこにかかっているかを隠してしまう。タイピング速度はボトルネックではない。ボトルネックは、通帳の各行が、キーを1回打つ前に一連の認知的な翻訳を必要とすることだ。
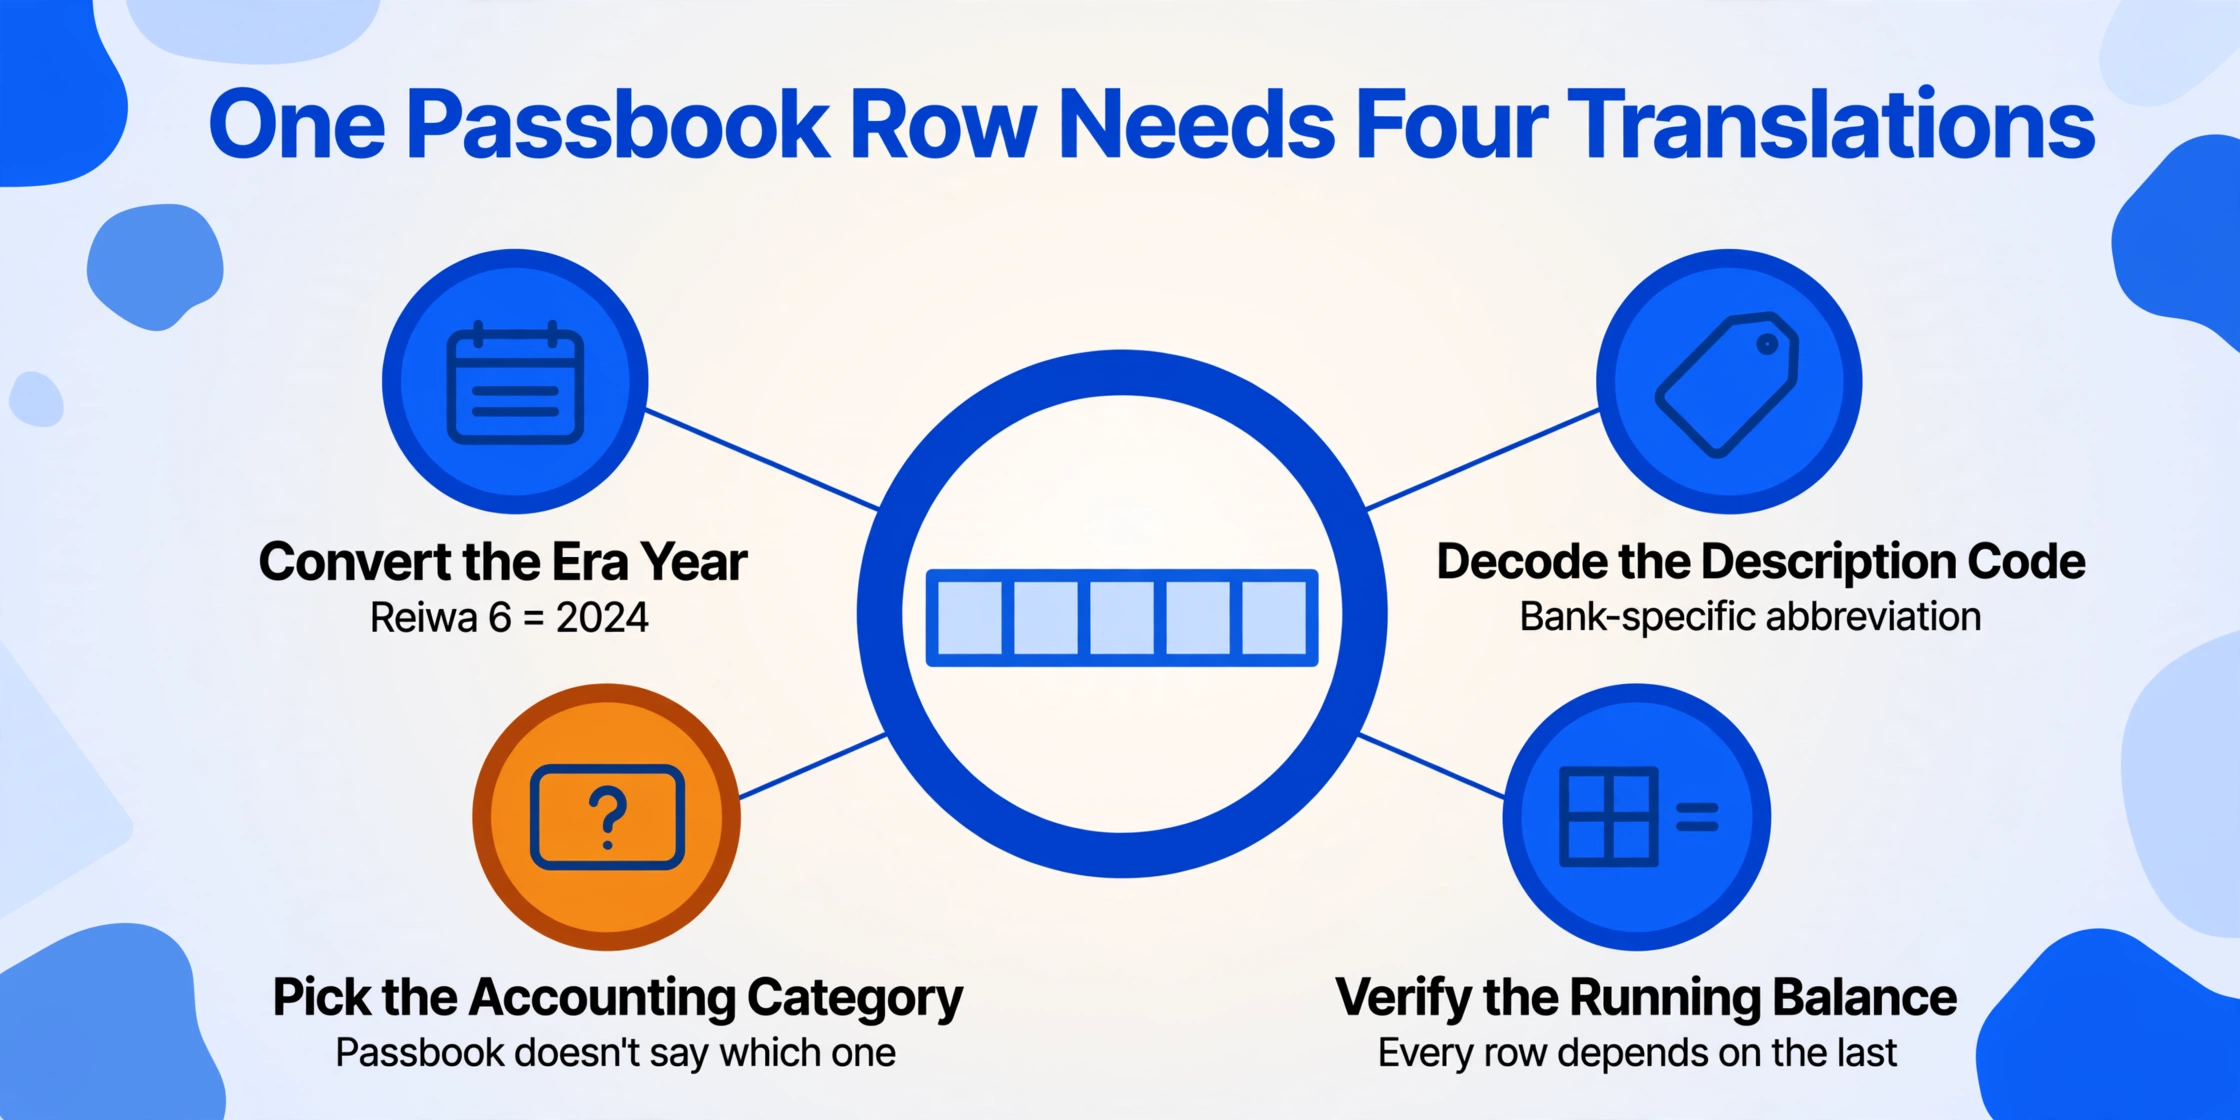
通帳の1行を声に出して読み、判断の数を数えてみてほしい:
和暦を解読する。 通帳には「R6.3.15」と印字されている — 令和6年3月15日。令和6年は西暦2024年だ。しかし令和は2019年5月1日に始まったため、令和1年は8ヶ月しかない。そして平成31年(2019年1月〜4月)も2019年だ。電卓アプリではこの変換はできない。頭の中でやるしかない。
摘要コードを解読する。 摘要欄には「振込IB1」とある。これはMUFGのインターネットバンキングによる入金を表す内部略号だ。しかしゆうちょ銀行では、給与の入金は「振込」と表示される — あるいは、雇用主が給与専用の電子メッセージで送信した場合は単に「給与」とだけ表示されることもある。同じ経済事象でも、どの銀行が印字したかによって異なるラベルが付く。
会計カテゴリを判断する。 通帳の行にある「カード」は、キャッシュカードによるATM引き出し、クレジットカードの支払い引き落とし、デビットカードでの購入のいずれかを意味し得る — 3つは異なる会計処理が必要だ。通帳はどれかを教えてくれない。記憶するか、領収書と突き合わせるしかない。
差引残高を検証する。 通帳の差引残高は、前回残高からこの行の引き出しを引き、この行の入金を足したものと一致するはずだ。数字を1つ読み間違えるだけで — 8,000円の引き出しを80,000円と誤認するなど — 以降のすべてのページのすべての残高が数学的に狂ってしまう。この検証は各行で行う必要がある。
5つのフィールドを入力するのは数秒で済む。本当に時間がかかるのは上記の4つの判断であり、それはすべての行で求められる同じ4つの判断だ。入力速度は関係ない。通帳データ入力を行う人は、データ入力係ではない。彼らは、銀行コード略語、和暦の年号計算、会計カテゴリのロジックをリアルタイムで解釈する存在だ——それらの変換レイヤーが存在する前に設計された機械が印刷した文書を相手にしているのだ。
同じ構造的なギャップ——文書形式と宛先システムが異なる言語を話し、人間が翻訳を担う状況——は国境を越えて見られる。英国のフリーランサーは、銀行明細書と請求書をSA100フォームの各欄に変換する際にほぼ同じミスマッチに直面し、オーストラリアの給与チームはPAYGサマリーが給与ソフトがネイティブに読み取れない形式で届くという問題に遭遇する。日本の通帳は、同じ構造的な摩擦に、日本特有の要素——銀行ごとに異なる摘要コード体系——を掛け合わせているのだ。
なぜ銀行ごとに言語が違うのか:誰も語らない摘要コード問題
日本の通帳の摘要欄は、ページ上で最も情報密度の高いフィールドであり、同時に最も不透明な部分でもある。これは取引の人間可読な説明ではない。銀行固有の略号コードであり、漢字、カタカナ、半角カタカナ、英数字が密集した形で印刷され、ATMのドットマトリクス印字ヘッドが出力する狭い欄に収めるため、多くの場合12〜16文字程度に切り詰められている。
三菱UFJ銀行だけでも、参考資料に200以上の異なる摘要コードを掲載している——しかもそれは最も一般的なものだけだ。同じ取引種別が、主要な通帳発行機関でどう表記されるかの例をいくつか挙げる:
| 取引種別 | 三菱UFJ銀行 通帳摘要 | ゆうちょ銀行 摘要 | 実際の意味 |
|---|---|---|---|
| 給与入金 | 給料 | 振込 | 雇用主からの給与振込——ただしゆうちょ銀行のATMは「給料」というラベルを表示できない。三菱UFJのシステムが処理する給与専用の電子メッセージ形式を、ゆうちょ銀行は処理しないためだ |
| インターネットバンキング振込(入金) | 振込IB1 | 振込 | 同じ経済事象でも、まったく異なる略号——三菱UFJはチャネル(IB=インターネットバンキング)をコード化するが、ゆうちょ銀行はしない |
| ATM現金引き出し | カード | 現金 | 三菱UFJは手段(カード)を使い、ゆうちょ銀行は結果(現金)を使う——通帳利用者は各銀行がどの慣例に従うかを知っておく必要がある |
| 公共料金自動引き落とし | 口座振替 | 自動支払 | 同じ機能でも異なる用語——どちらも「自動口座引き落とし」を意味するが、異なる日本語の語彙を使っている |
| 合計記帳 | 合計記帳 | (銀行により異なる) | 印刷されなかった複数の取引が1行に圧縮される——個々の取引詳細は通帳から恒久的に失われる |
これは単なる小さな不便ではありません。日常業務用にMUFG、税金積立用にゆうちょ銀行、給与支払い用に信用金庫——3つの通帳を管理する小規模事業主は、3種類の異なる摘要コードの語彙に直面します。同じ経済事象が通帳ごとに異なる名称で表示され、それを統一的に解読する仕組みは存在しません。事業主は無給の副業として暗号解読者になるのです。
日本最大のQ&AフォーラムであるYahoo知恵袋で、現役の会計士が直接こう質問しました:「すべての顧客の通帳取引履歴を手作業でExcelに入力しなければなりません。手入力には膨大な時間がかかります。MoneyForwardやfreeeのような会計ソフトを使わずに、通帳取引履歴をExcelに変換する方法はないでしょうか?」 最も支持された回答は現実的でした:顧客にネットバンキングへ登録してもらい、データをダウンロードしてもらうこと。2番目の回答は現実をより正直に語っていました:「OCRは存在しますが、読み取りエラーのチェックは依然として必要です。そのチェックだけでかなりの時間がかかります。」
合計記帳:銀行の解決策があなたの問題を生む
日本の通帳システムには、記帳を怠った人に構造的なペナルティをもたらす機能が組み込まれています。それは合計記帳(gōkei kichō)と呼ばれ、几帳面な人には報い、忙しい人には機械的な無関心をもって罰します。
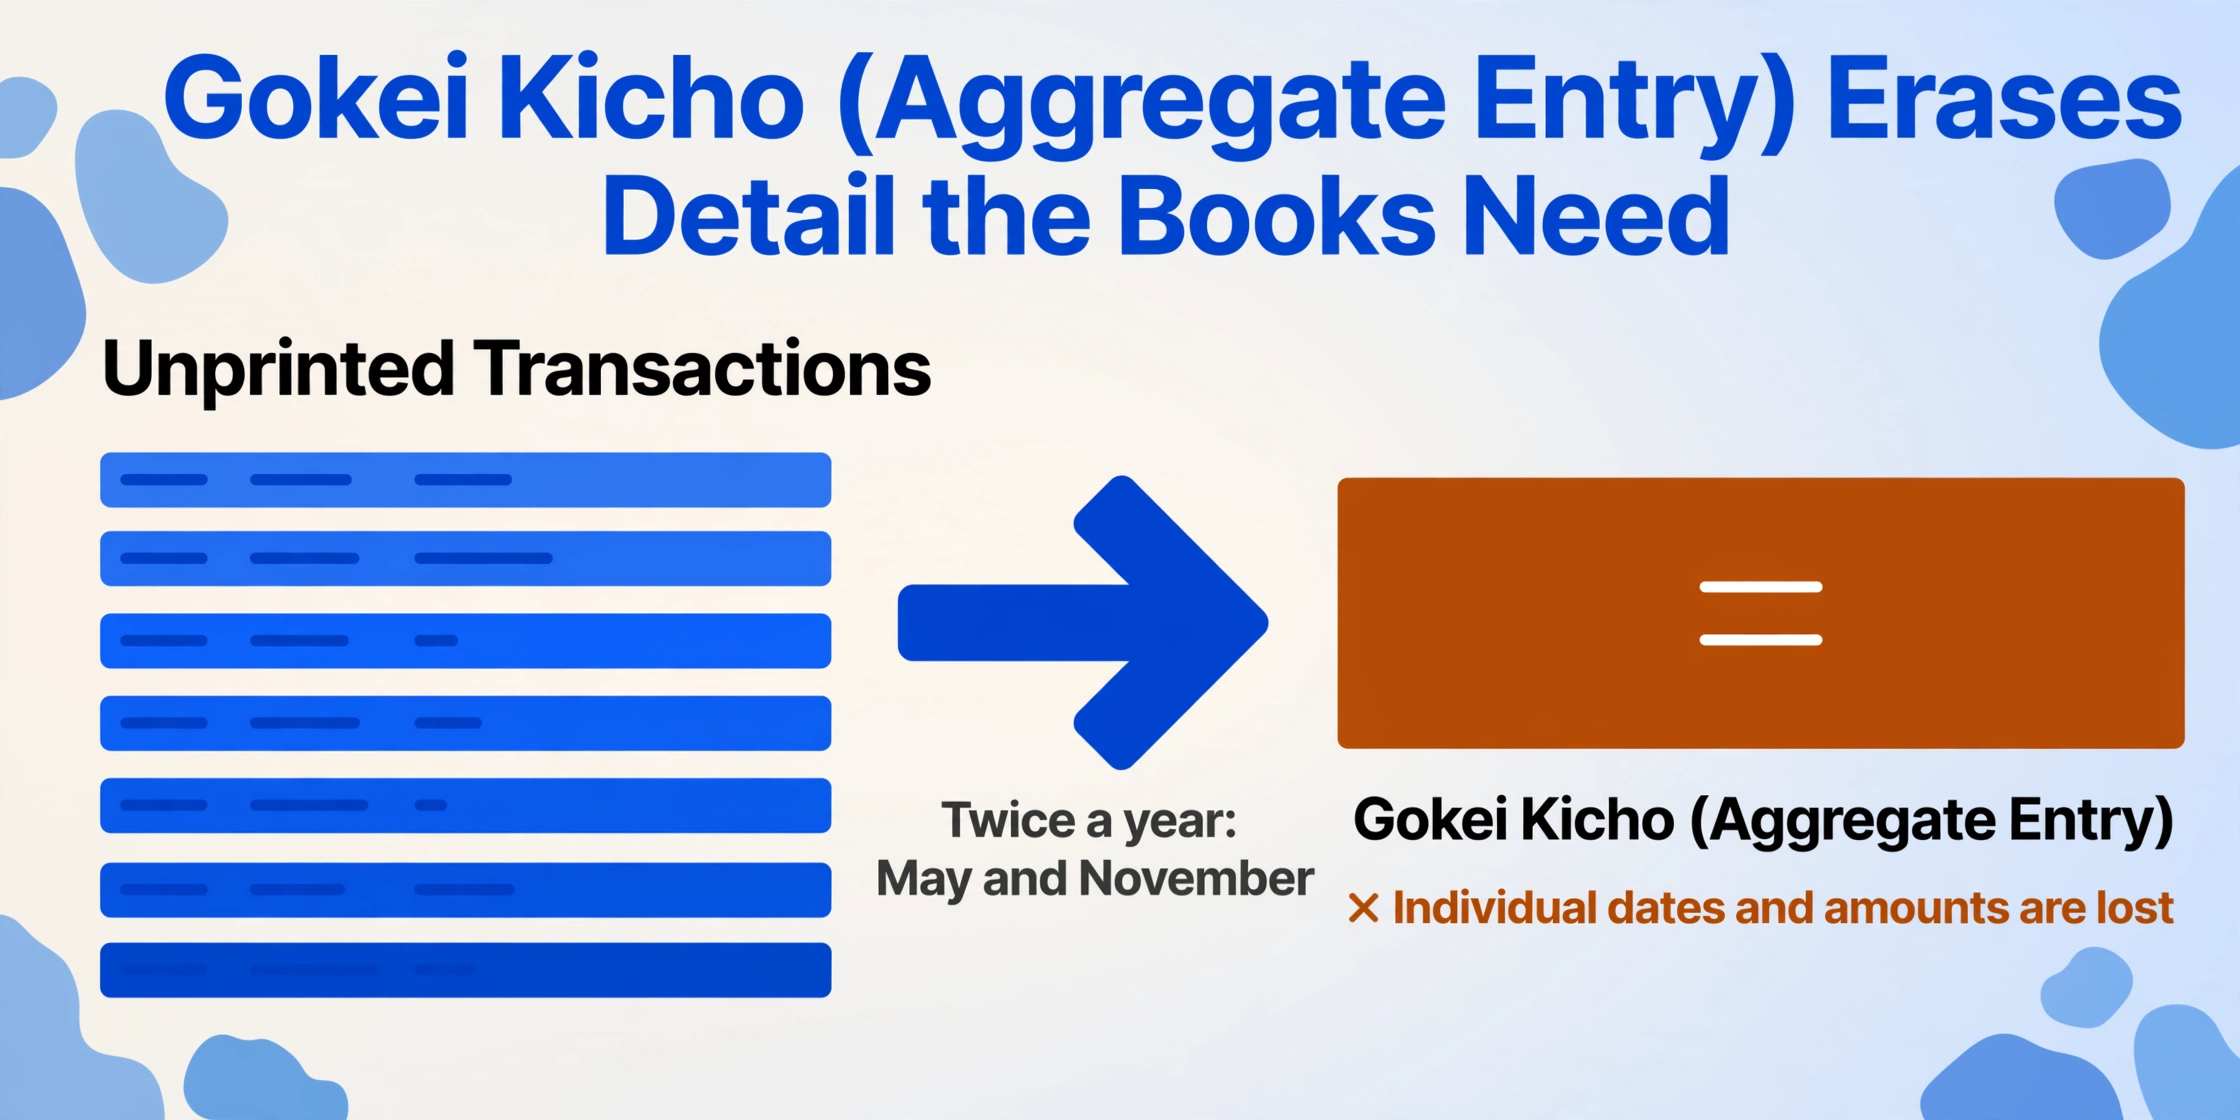
MUFGでの仕組みは次のとおりです。他のほとんどの日本の銀行も同様のメカニズムを採用しています。ATMで通帳を更新していないために、取引が通帳に記帳されずに口座に蓄積されると、銀行は最終的にそれらを統合します。年に2回、5月と11月の第3土曜日に、MUFGは全口座をスキャンします。3月末または9月末時点で未記帳の取引が閾値件数を超えている口座は、それらの取引が1行に圧縮されます:合計記帳。取引の合計件数と純額を1行で示すだけです。個々の取引——日付、金額、摘要コード——はすべて通帳から永久に失われます。
通帳を主要な記録として頼りにしている人にとっての結果は次のとおりです:
- 通帳から失われた取引を復元することはできません。個々の明細は紙面上に存在したことがありません。集約処理によって上書きされた、印字されない電子記録としてのみ存在していました。
- 3月と9月は、まさに小規模事業者が四半期または半期の決算書類を準備する時期です。集約のタイミングは、事業主が明細化されたデータを最も必要とする瞬間と重なります。
- 特定の取引への異議申し立てが不可能になります。6件の取引が集約されて20万円が口座から引き出された場合、どの引き出しがどれなのか、それぞれがいつ発生したのか、摘要コードが何だったのかを判別できません。税務調査において、これは記録の欠落です。
MUFGのウェブサイト自体も、このシステムをほぼ付け足しのようにしか言及していません。「合計記帳を避けるため、定期的に通帳を記帳してください」という脚注に埋もれています。そのトーンは、毎週銀行を訪れて最新の明細を印字する退職者を想定しています。レストラン、工房、コンサルティング業を営み、せいぜい月に一度しか銀行に行けない小規模事業者にとって、合計記帳は複利的に膨らむ時間の負担です。訪問を逃せばデータは永久に失われ、銀行からの取引履歴の印字請求なしには埋められない帳簿の欠落に直面します。そしてその請求には、ありがたいことに約1週間かかり、普通郵便で届きます。
ゆうちょ銀行はこれを異なる方法で処理します。同じ固定日付の集約ではなく、通帳のページ上限による方式です。標準的な通帳には、銀行にもよりますが、およそ50〜100行の印字された取引明細が収容されます。ページが尽きると、ATMが自動的に新しい通帳を発行します。古い通帳の最後の印字行と新しい通帳の最初の印字行の間の取引は、新しい通帳の最初のページに要約されます。その間の個々の取引は?紙から消えます。新しい通帳は繰越残高と履歴なしで新しく始まります。
通帳は、人々が毎週銀行を訪れ、新しい明細を手作業で確認する世界のために設計されました。その世界では、合計記帳は合理的なスペース最適化です。通帳がデジタル会計ワークフローの原本となる世界では、それはデータ破壊の仕組みです。そして、ページ上にもう存在しないデータを自動化で回避することはできません。
アプリだけではギャップを埋められない理由
日本の家計簿・会計アプリ — マネーフォワードME(1,780万人のユーザー)、Zaim、Moneytree、そして業務向けのfreeeや弥生 — はすべてAPIによる銀行口座連携に対応しています。インターネットバンキングが有効な口座では、新しい取引が自動的にアプリへ取り込まれます。毎月の支出を管理する家庭にとっては、これで今後の問題はほぼ解決されます。
しかし、確定申告を準備する小規模事業者にとっては、話がまったく違います。理由は3つあります:
登録前のデータのギャップ
API連携アプリは登録日以降の取引を取り込みます。登録日より前の、インターネットバンキング開始前に印字された通帳のページにしか存在しない何年分もの取引履歴には遡ってアクセスできません。2024年にMUFGのインターネットバンキングを開設した事業者でも、2022年と2023年の記録は引き出しの中の紙の通帳に残ったままです。青色申告のためには、その年分を手入力する必要があり、アプリはこれに対して何の助けにもなりません。
エコシステムの囲い込み問題
アプリに取り込まれた取引であっても、他のツールで使える形式でデータを取り出すのは簡単ではありません。マネーフォワードはCSVデータをエクスポートできますが、フィールドのマッピングやカテゴリの割り当てはマネーフォワード独自のものです。マネーフォワードからfreeeへ移行する場合、すべての取引を再カテゴリ化する必要があります。Zaimのような個人向けアプリから弥生のような会計プラットフォームへ移行する場合は、完全にやり直しになります。アプリは便利さを提供しますが、同時に新たな形式依存の層を追加しているのです。
手書き記入の盲点
日本の通帳には手書きの追記が含まれることがよくあります — 謎の「振込」行の横に鉛筆で書かれた、特定の顧客からの支払いであることを示すメモ、または残高が一致しないときに書き込まれた訂正などです。マネーフォワードの領収書OCRのようなスキャンアプリは、機械印字された通帳の記入事項の上に重ねられた手書き文字を読み取るようには設計されていません。特に手書きが狭い欄の境界線をまたいでいる場合はなおさらです。
アプリは得意なことがあります:最近の出来事を表示し、カテゴリ分けを手助けすることです。しかし、1970年代の印刷文書と構造化データを期待する会計システムの間の橋渡しとして設計されたわけではありません。その橋は今も人間です — そしてアプリは、その便利さゆえに、橋の両端がどれだけ離れているかを人間により強く意識させるだけになっています。
エラーが連鎖する場所: 残高の連鎖的なズレ
小規模事業者が扱う書類 — 請求書、領収書、発注書、納品書 — の中で、通帳は決定的な点で独特です。そのデータ行は独立していません。各行の差引残高は、それ以前のすべての行が正しいことに依存しています。200行ある通帳の47行目の数字が1つ間違っていると、47行目だけに影響するのではありません。48行目から200行目までが壊れます。エラー以降に印字されたすべての残高が、実際の残高と一致しなくなります。
これにより、他の書類タイプにはない検証の負担が生じます。請求書の束なら、それぞれを独立して処理できます — 23番目の請求書のエラーは24番目の請求書に影響しません。通帳の場合、すべての行の残高を検証するか(前残高+入金-出金=現在残高を確認する)、バッチ内のエラーが静かに連鎖することを受け入れるかのどちらかです。店を閉めた後、夜遅くに作業している小規模事業者のほとんどは、リスクに気づかずに後者の選択をしています。
これは仮定の話ではありません。Yahoo知恵袋で、あるユーザーが自分の作業フローを説明していました: 通帳データを手動でExcelに入力し、合計を銀行の明細と照合するというものです。回答者はCSVダウンロードからOCRまでの解決策を提案しましたが、根本的な問題 — 単一のミスが最終合計が一致するまで検出されずに伝播する — は形式に内在するものとして認識されていました。ある回答者は、OCRを使っても「読み取りエラーをチェックする必要があり、そのチェックだけでかなりの時間がかかる」と指摘しました。通帳の場合、「チェック」は数行のスポットチェックを意味しません。すべての行で残高の連鎖を検証することを意味します。
和暦問題:元号が変わるたびに年がリセットされる問題
日本には2つの暦が並行して存在します。世界標準の西暦と、天皇の在位に基づいて年を数える和暦です。通帳には和暦で日付が印字されます。例:令和6年3月15日。会計ソフト(弥生会計、freee、MoneyForward Cloud)はどちらの形式も受け付けますが、各日付がどの元号に属するかを指定しない限り、両者を変換することはできません。そして元号が変わると、年号は1にリセットされます。
実際の困難は、二重の暦制度が存在すること自体ではありません。問題は境界の年——元号が年の途中で変わり、新旧両方の元号が同じ西暦年を指す年です:
| 西暦年 | 通帳に印字される和暦年 | 変換の課題 |
|---|---|---|
| 1989 | 昭和64年(1月1日〜7日)/ 平成元年(1月8日〜12月31日) | 昭和64年はわずか7日間。平成元年は1月8日に始まりました。昭和64.1.5と印字された通帳の行 = 1989年。平成1.12.20と印字された行 = これも1989年。同じ暦年なのに、2つの異なる元号表記があります。 |
| 2019 | 平成31年(1月1日〜4月30日)/ 令和元年(5月1日〜12月31日) | 直近の移行。2019年4月に印字された通帳ページは「平成31年」。2019年5月に印字されたページは「令和元年」。どちらも2019年です。元号の境界をまたいで取引を時系列に並べるには、入力する人が平成31.4.30 → 令和1.5.1を連続する日付として頭の中で変換する必要があります。 |
| 2026(今年) | 令和8年 | 今はまだ単純ですが、次の移行——いつ来るにせよ——同じ境界問題を引き起こします。移行期をまたぐ通帳には、同じ税務年度に対して2つの異なる元号表記が存在することになります。 |
3冊の通帳を管理し、青色申告を行う事業者にとって、元号問題は摘要コード問題と重なります。令和6年を2024年に変換するだけではありません。MUFGの通帳の「振込TB1」が、ゆうちょ銀行の通帳の「振込」と同じ入金かどうかを判断しながら変換するのです——しかも、通帳の繰越時期によっては、一方の通帳の元号表記が他方と異なる月もあります。
和暦はなくなりません。政府の書類、税務書類、銀行の明細書はすべて和暦を使用します。小規模事業者が利用する会計ソフトはどちらの形式も受け付けます。しかし、両者間の変換は依然として人手によるステップであり——変換のたびに年がずれ、誤った税務年度に取引が計上されるリスクがあります。
効率化の鍵は「速く打つこと」ではなく「翻訳レイヤーをなくすこと」
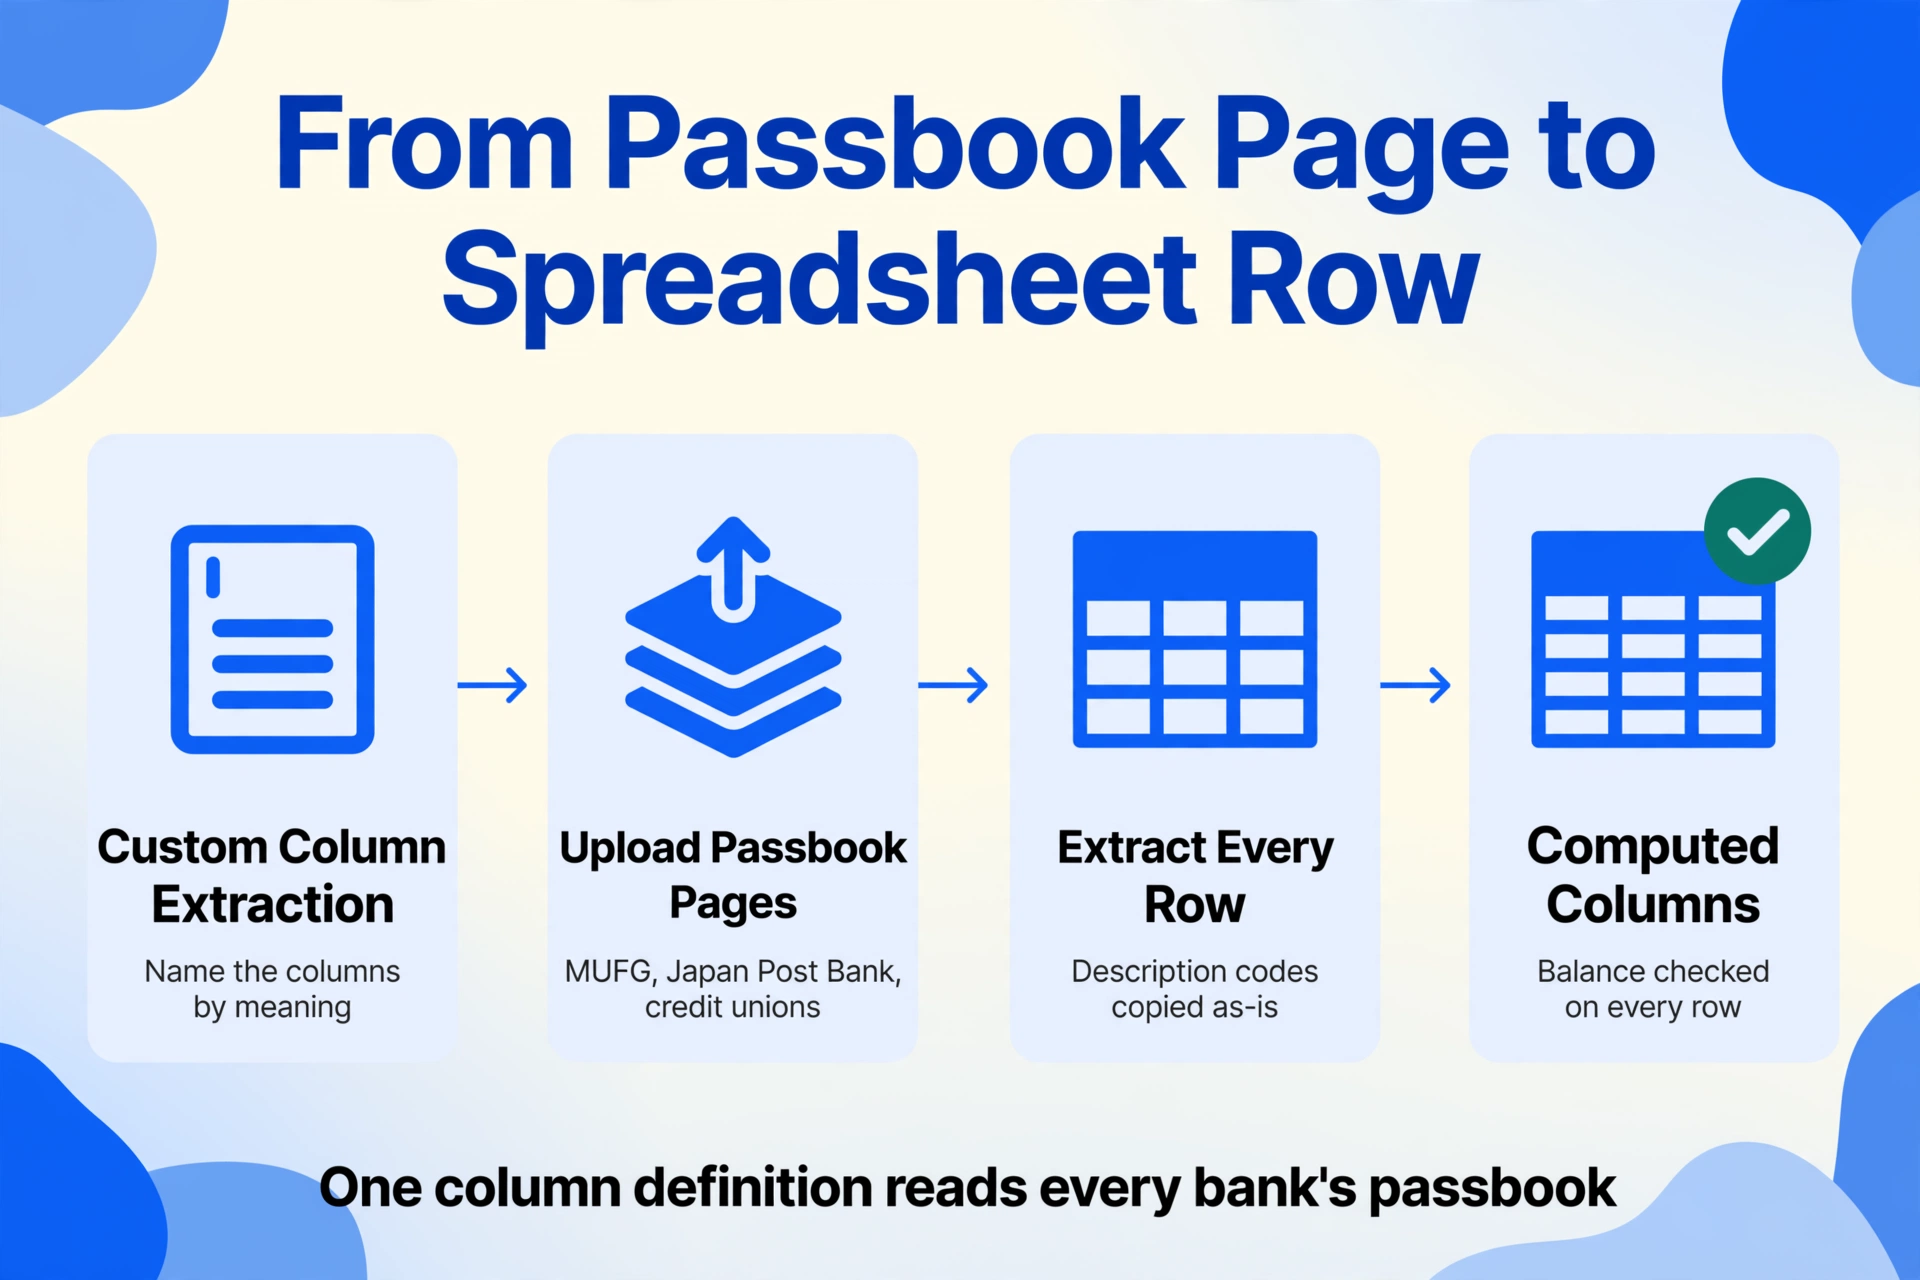
構造的な問題が、通帳ページと会計ソフトの間にある手作業の翻訳レイヤーだとしたら、解決策は「速く打つ」ことでも「もっと良いアプリを使う」ことでもありません。通帳データを抽出し、翻訳ステップを迂回する方法——通帳の5列形式を読み取り、銀行固有の摘要略語を解読したり、和暦を変換したり、差引残高を手動で検証したりする必要なく、構造化データを直接生成する方法——でなければなりません。
この問題に適したアプローチはセマンティック抽出です。「日付」「摘要」「おろし金額」「預かり金額」「残高」といった意味で列を指定すると、固定テンプレートに一致させるのではなく、文書レイアウトを理解して各値を読み取ります。日本の通帳形式は銀行間で標準化されているため(5列、同じ順序、同じ一般的なレイアウト)、セマンティックモデルはMUFG、ゆうちょ銀行、地域の信用金庫のページを同じ列定義で読み取ることができます。銀行ごとに変わるのは摘要コードだけで、これらは後で分類するためにそのまま抽出されるテキストにすぎません。
これがカスタム列抽出の核となる考え方です。フィールドにボックスを描いたり、銀行ごとに解析ルールを作成したりする代わりに、必要な列名を入力して通帳ページをアップロードするだけです。AIが各ページを読み取り、表形式のレイアウトを理解して5つの列を特定し、取引ごとにスプレッドシートの行を生成します。計算列(例:「残高チェック(前回残高+預かり-おろし)」)を追加すると、ツールは差引残高が合わないすべての行にフラグを立てるため、データが会計ソフトに入る前にエラーが発生した場所を正確に把握できます。
ファイルは安全に処理され、保存されません。
最初の通帳ページのアップロードから整形されたスプレッドシートの取得までの完全なステップバイステップの抽出ワークフローは、日本語の通帳抽出ガイドに記載されています。また、複数年にわたる複数の通帳を扱う場合、バッチ処理アプローチは、異なる銀行のページを単一の支出台帳に統合し、すべての和暦日付を変換し、すべての残高を一度に検証します。これは、3冊の通帳×3年で280件の取引、1,400のデータポイント、そして単一ページ抽出では手作業が残るマージステップがある場合に重要です。
これらは通帳をなくすものではありません。日本の銀行インフラは、今後何年も通帳を発行し続けるでしょう。変わるのは、ATMの向こう側にいる人が毎月、銀行コードの翻訳者になり、連鎖する残高の監査人にならなければならないかどうかです。それとも、抽出が数秒で完了し、人間の作業が実際に人間の判断を必要とする部分(取引の分類と申告書の提出)に移るかどうかです。
よくある質問
なぜ日本の銀行は紙の通帳の発行をやめないのですか?
メガバンク数行は現在、デジタル専用の代替手段を提供しています。例えばMUFGのEco通帳(インターネット通帳)は、紙の通帳をブラウザやアプリのインターフェースに置き換え、特典として一部のATM手数料を免除します。しかし、切り替えると紙の通帳は永久に無効になり、多くの顧客——特に高齢の口座保有者や、通帳を正式な記録として使用している個人事業主——は切り替えをためらいます。取引記録としての通帳の法的地位は日本の銀行業務に深く根付いており、それを変えるにはソフトウェアのリリース速度では進まない規制上・文化上の変化が必要です。
スマホで通帳を撮影して、アプリに読み取らせることはできますか?
はい、ただし条件付きです。日本の通帳専用に設計された一部のAI-OCRサービス(SmartOCRやShuttle Smileなど)は、撮影した通帳ページの印字文字を高い精度で読み取れます——SmartOCRは機械印字テキストで99.8%の精度を謳っています。ただし、撮影したページにはスキャンにはない課題があります:遠近歪み(斜めから撮影した通帳は列が台形に見える)、通帳の綴じ目部分の照明ムラ、狭い列に圧縮された半角カタカナの判読性低下などです。通帳ページへの手書きの注記はさらに精度を下げます。技術は存在し機能しますが、良好な入力品質と——会計目的には——出力の人的検証が必要です。
Eco通帳(インターネット通帳)に切り替えると、通帳データはどうなりますか?
MUFGのEco通帳は、インターネットバンキングでアクセスできるデジタル形式で最大10年分の取引履歴を保持します。旧紙通帳で既に合計記帳された過去の取引は、取引履歴の印字を別途請求することで取得できます——ただし、請求した場合に限ります。注意点:Eco通帳に切り替えると、紙の通帳は永久に無効化されます。元に戻すことはできません。後で税務調査やローン申請のために紙の記録が必要になった場合は、デジタルインターフェースからダウンロードして印刷する必要があります。
freeeや弥生会計などの会計ソフトを使えば、通帳データの抽出は不要になりますか?
API経由で銀行口座を連携した後の取引については、アプリが自動的に取引データを取得します。連携前の取引——ほとんどの中小企業にとっては何年分もの履歴——は、依然として通帳ページにのみ存在します。アプリは過去の履歴を遡って取り込むことはできません。また、連携済みの口座でも自動分類は完璧ではありません:取引先からの「振込」入金と、自分自身の別口座からの「振込」は同じように見え、アプリは手動ルールや修正なしでは区別できません。アプリは日々のデータ入力を減らしますが、過去の記録や正確性の検証のための通帳データ抽出の必要性はなくなりません。
同じ抽出設定を、MUFG・ゆうちょ銀行・地方銀行など異なる銀行の通帳に使えますか?
はい、使えます。銀行によって摘要コードは異なりますが、通帳の5列レイアウト(日付・摘要・お引き出し・お預かり入れ・差引残高)は、日本のほぼすべての金融機関で標準化されています。セマンティック抽出は、レイアウトをテーブルとして理解して読み取るため、銀行ごとのテンプレートは不要です。列を内容と位置で識別するので、固定ルールに依存しません。列を一度定義すれば、同じ定義がMUFG・ゆうちょ銀行・SMBC・地方信用金庫の通帳でそのまま使えます。摘要コードは(前述のとおり)銀行ごとに異なりますが、テキストとして抽出されるため、抽出後ではなく抽出後に分類します。
毎月の通帳の束が机に届いたとき(3冊の通帳、それぞれに約60行の新しい明細、各行に5つのフィールドと4つの判断)、実際に何が起きているのかを認識することが重要です。「データ入力」でも「簿記」でもなく、昭和時代から変わらない文書形式と、根本的に異なるロジックで動作する会計ソフトウェアとの間のリアルタイムの翻訳作業です。タイピングは仕事のごく一部です。意味の解読(このコードは何を意味するのか、これは何年なのか、これはどの銀行の略号体系なのか)に時間がかかり、エラーが発生するのはそこです。抽出が数秒で完了し、残された判断が数字をどう扱うかだけになったとき、自分の通帳ページがどう見えるかを確認してください。