Le problème du livret papier
Coûte plus cher aux PME japonaises qu'elles ne le pensent
En 2024, 42,8 % des paiements des consommateurs au Japon étaient sans espèces — un record porté par PayPay, Suica et les programmes de remise du gouvernement. Entrez dans n'importe quelle banque japonaise, cependant, et le distributeur automatique crache toujours un livret papier. Le livret bancaire (通帳, tsūchō) — un registre imprimé mis à jour ligne par ligne sur des machines datant des années 1970 — reste le principal registre de l'activité financière d'environ 120 millions de comptes Japan Post Bank et de dizaines de millions d'autres dans les mégabanques comme MUFG et SMBC. Pour le propriétaire de petite entreprise qui dépose une déclaration de revenus bleue (青色申告) exigeant une comptabilité en partie double dans Yayoi Accounting (弥生会計) ou freee, chacune de ces lignes imprimées doit devenir une écriture de journal numérique. Le pont entre les deux est un être humain devant un clavier, qui fixe une colonne de 5 cm × 7 cm de codes japonais abrégés et tente de décider ce que chacun signifie.
Points clés à retenir
- Chaque ligne du livret exige d'abord de décoder une année d'ère et un code d'abréviation propre à la banque avant de pouvoir saisir un seul chiffre — la saisie n'a jamais été le goulot d'étranglement, c'est le travail de traduction caché qui l'était.
- Manquez une visite régulière au distributeur et 合計記帳 efface définitivement les transactions individuelles de votre livret — une optimisation d'espace qui détruit vos données exactement au moment où les états financiers trimestriels en dépendent.
- Un seul chiffre mal lu sur une ligne du livret corrompt silencieusement tous les soldes qui suivent sur toutes les pages suivantes — et l'erreur reste cachée jusqu'à ce que votre logiciel comptable refuse de se rapprocher.
Le paradoxe du livret bancaire : un document des années 1970 dans un flux de travail comptable de 2024
Le Japon est la seule économie développée où le livret bancaire physique reste un instrument financier de masse. Entrez dans une agence MUFG ou SMBC et le distributeur imprimera vos dernières transactions directement dans un carnet relié — cinq colonnes sur une tête d'impression matricielle : date (月日), code description (摘要), montant de retrait (お支払金額), montant de dépôt (お預り金額) et solde courant (差引残高). Le format a été conçu à une époque où les guichetiers vérifiaient les soldes à la main et où le concept d'export CSV n'existait pas. Il n'a pas changé de manière significative depuis.
Pourtant, les logiciels de comptabilité utilisés par les petites entreprises japonaises — Yayoi Accounting (弥生会計), utilisé par plus de 700 000 entreprises ; freee, le leader du marché de la comptabilité cloud avec 450 000 clients payants ; et MoneyForward Cloud, avec 442 000 entreprises payantes — reposent sur une hypothèse fondamentalement différente. Ils supposent que les données de transaction arrivent sous forme numérique. Import CSV, flux API bancaire ou règles de comptabilité automatisées. Le livret viole toutes ces hypothèses à la fois.
Ce n'est pas un problème de « culture numérique » ni un cliché du type « le Japon est en retard ». C'est une inadéquation de format de document : l'infrastructure qui enregistre l'activité financière et celle qui la comptabilise ont été construites à 50 ans d'écart par des secteurs différents qui n'ont jamais eu à communiquer entre eux — et une personne doit combler le fossé en lisant et en ressaisissant.
La Japan Post Bank (ゆうちょ銀行) détient à elle seule environ 120 millions de comptes — près d'un par citoyen. MUFG, SMBC et Mizuho en détiennent collectivement des dizaines de millions de plus. La plupart de ces comptes émettent encore un livret papier par défaut. Même les clients qui ont activé la banque en ligne détiennent souvent les deux : l'interface numérique pour les vérifications quotidiennes, le livret pour l'enregistrement définitif. Pour le travailleur indépendant (個人事業主) déposant une déclaration bleue (青色申告) — qui accorde une déduction spéciale de 650 000 ¥ en vertu de l'article 143 de la loi sur l'impôt sur le revenu en échange d'une comptabilité en partie double correcte — chaque transaction de chaque page de livret doit pouvoir être rattachée à une écriture de journal. Le livret n'est pas facultatif. C'est la piste d'audit.
Le problème structurel, dit simplement : un document conçu pour qu'un guichetier humain vérifie un solde à l'œil est utilisé comme source de données principale pour un logiciel conçu pour des flux de transactions lisibles par machine. L'inadéquation est totale, et son coût retombe entièrement sur la personne au clavier.
Le vrai travail n'est pas la saisie — c'est la traduction
La présentation standard du problème de la saisie des données de livret bancaire est « ça prend trop de temps à taper ». Cette présentation est erronée, et elle l'est d'une manière qui masque où va réellement l'effort. La vitesse de frappe n'est pas le goulot d'étranglement. Le goulot d'étranglement, c'est que chaque ligne d'un livret exige une série de traductions cognitives avant qu'une seule frappe puisse être effectuée.
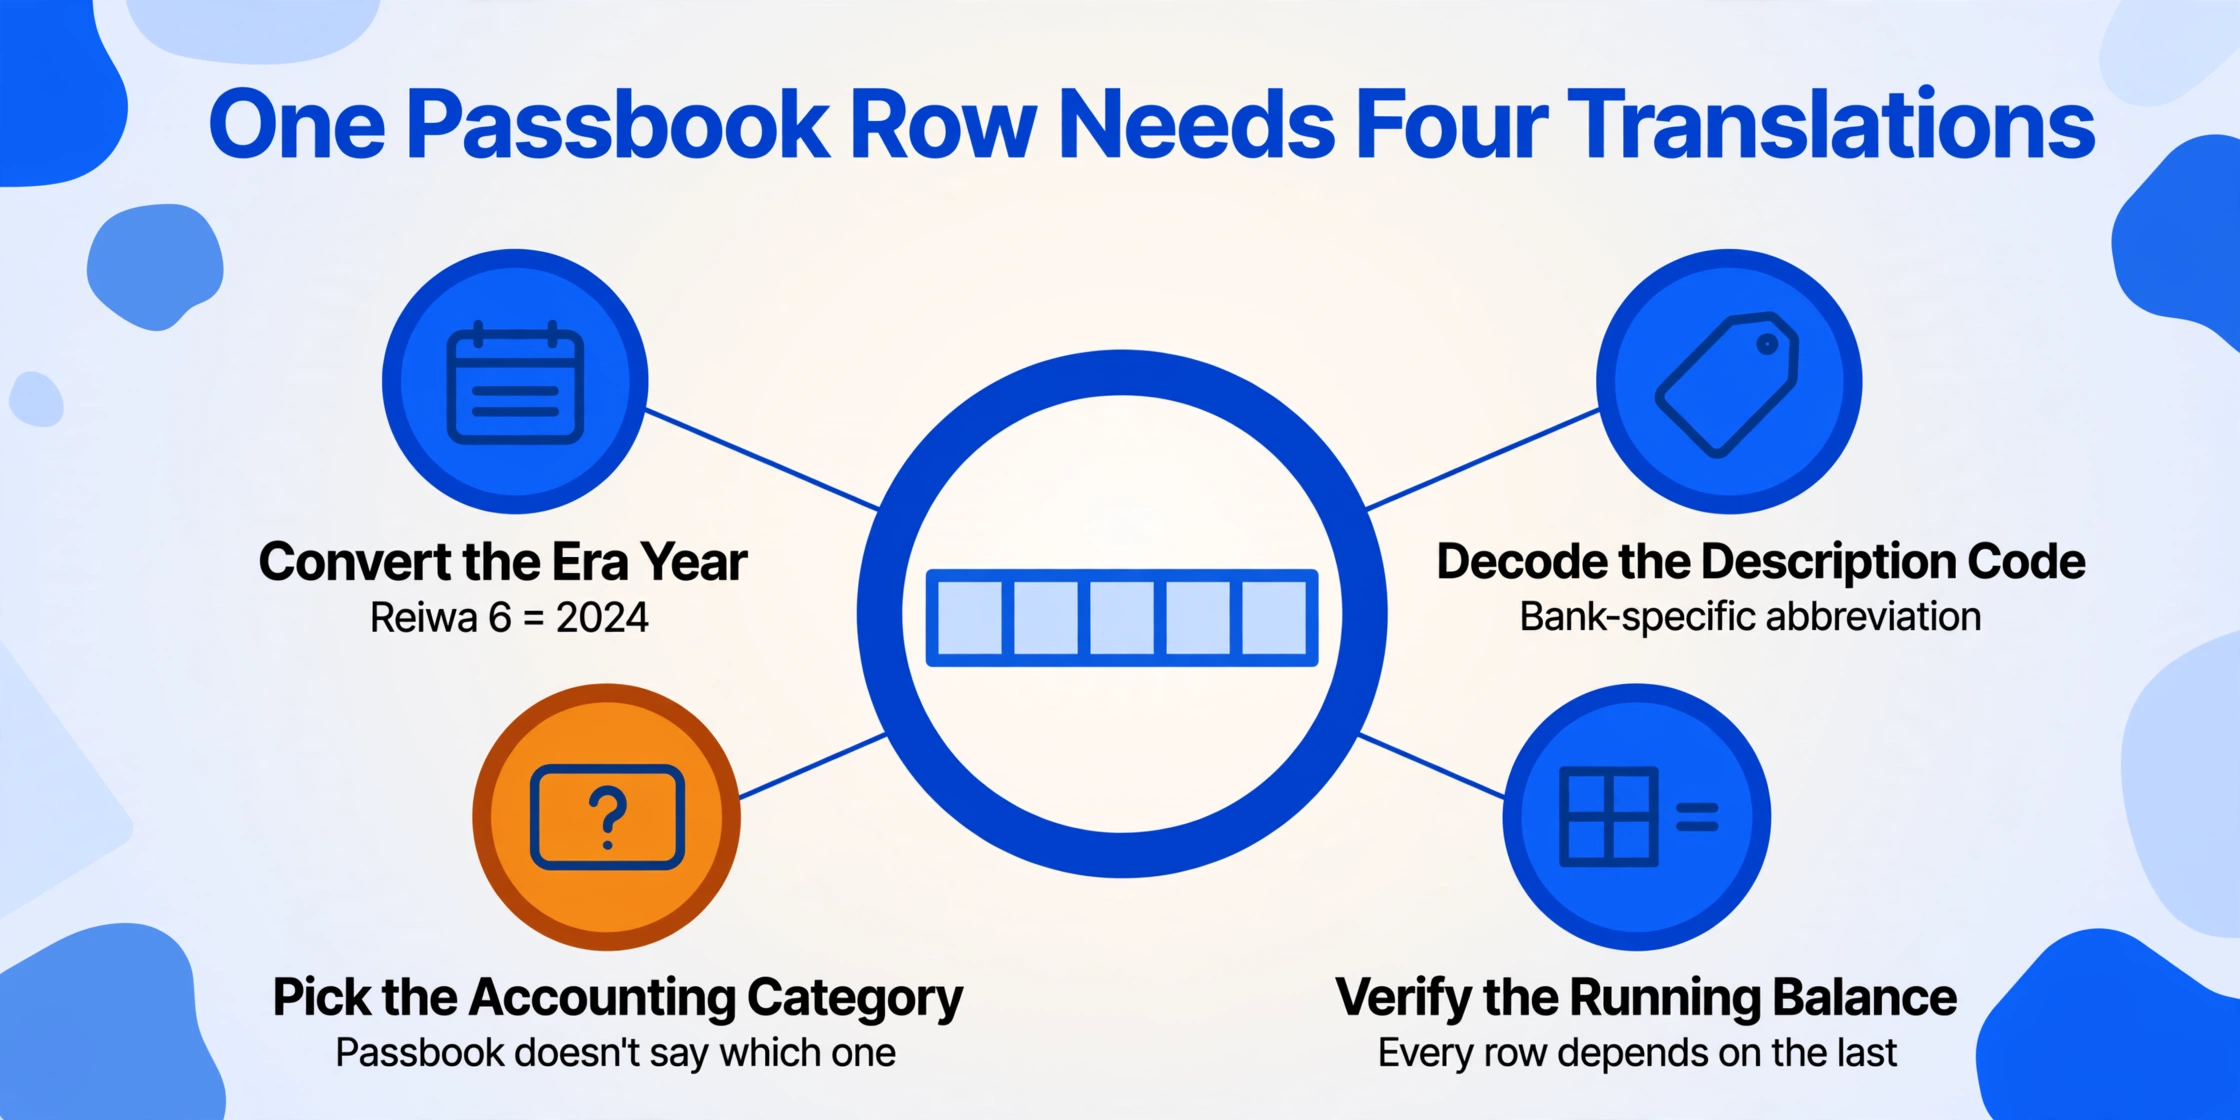
Lisez une seule ligne de livret à voix haute et comptez les décisions :
Décoder l'année d'ère. Le livret imprime « R6.3.15 » — Reiwa 6, 15 mars. Reiwa 6 correspond à 2024 dans le calendrier grégorien. Mais Reiwa a commencé le 1er mai 2019, donc Reiwa 1 ne compte que 8 mois. Et Heisei 31 (qui a couru de janvier à avril 2019) est aussi 2019. Aucune application de calculatrice ne fait cette conversion ; vous la faites de tête.
Décoder le code de description. La colonne 摘要 indique « 振込IB1 ». C'est l'abréviation interne de MUFG pour un virement bancaire en ligne entrant sur ce compte. Mais à la Japan Post Bank (ゆうちょ銀行), un dépôt de salaire apparaît comme « 振込 » — ou parfois simplement « 給与 » si l'employeur l'a envoyé via un message électronique spécifique à la paie. Le même événement économique apparaît sous différentes étiquettes selon la banque qui l'a imprimé.
Décider de la catégorie comptable. « カード » (carte) sur une ligne de livret peut signifier un retrait au distributeur avec une carte de retrait, une déduction de paiement par carte de crédit, ou un achat par carte de débit — trois traitements comptables différents. Le livret ne vous dit pas lequel. Vous devez vous en souvenir, ou recouper avec un reçu.
Vérifier le solde courant. Le 差引残高 du livret doit être égal au solde précédent moins le retrait de cette ligne plus le dépôt de cette ligne. Un seul chiffre mal lu — un retrait de 8 000 ¥ pris pour 80 000 ¥ — et chaque solde ultérieur sur chaque page suivante est mathématiquement faux. Cette vérification doit se faire sur chaque ligne.
Saisir les cinq champs prend quelques secondes. Les quatre décisions ci-dessus prennent le vrai temps, et ce sont les quatre mêmes décisions que chaque ligne exige, quelle que soit votre vitesse de frappe. La personne qui saisit les données d'un livret bancaire n'est pas un employé de saisie. C'est un interprète en temps réel des abréviations bancaires, du calcul des années d'ère, et de la logique des catégories comptables — travaillant à partir d'un document imprimé par une machine conçue avant que ces couches de traduction n'existent.
La même lacune structurelle — où un format de document et un système de destination parlent des langues différentes, laissant une personne traduire — se retrouve au-delà des frontières. Les indépendants britanniques font face à un décalage quasi identique lorsqu'ils traduisent des relevés bancaires et des factures dans les cases du formulaire SA100, et les équipes de paie australiennes le rencontrent lorsque les résumés PAYG arrivent dans des formats qu'aucun logiciel de paie ne lit nativement. Le livret bancaire japonais ne fait que reprendre cette friction structurelle et la multiplier par un facteur propre au Japon : un système de codes de description qui varie selon la banque.
Pourquoi chaque banque parle son propre langage : le problème des codes 摘要 dont personne ne parle
La colonne de description d'un livret bancaire japonais est le champ le plus dense en informations de la page — et aussi le plus opaque. Ce n'est pas une description lisible du transaction. C'est un code d'abréviation propre à la banque, imprimé dans un mélange dense de kanji, katakana, katakana demi-chasse et caractères alphanumériques, souvent tronqué pour tenir dans environ 12 à 16 positions de caractères sur une colonne étroite imprimée par une tête matricielle de distributeur automatique.
La banque MUFG publie à elle seule un document de référence listant plus de 200 codes 摘要 distincts — et ce ne sont que les plus courants. Voici un échantillon de ce à quoi ressemble le même type de transaction dans les principales institutions émettrices de livrets :
| Type de transaction | 摘要 du livret MUFG | 摘要 de la Japan Post Bank | Ce que cela signifie réellement |
|---|---|---|---|
| Dépôt de salaire | 給料 | 振込 | Virement de paie de l'employeur — mais les distributeurs de la Japan Post Bank ne peuvent pas afficher le libellé « salaire » car ils ne traitent pas le format de message électronique spécifique à la paie que le système de MUFG gère |
| Virement bancaire en ligne (entrant) | 振込IB1 | 振込 | Même événement économique, abréviation complètement différente — MUFG encode le canal (IB = internet banking), la Japan Post Bank ne le fait pas |
| Retrait d'espèces au distributeur | カード | 現金 | MUFG utilise le moyen (carte), la Japan Post Bank utilise le résultat (espèces) — l'utilisateur du livret doit savoir quelle convention chaque banque suit |
| Paiement automatique de factures | 口座振替 | 自動支払 | Même fonction, termes différents — les deux signifient « prélèvement automatique » mais utilisent des mots japonais différents |
| Enregistrement agrégé (合計記帳) | 合計記帳 | (varie) | Plusieurs transactions non imprimées regroupées en une seule ligne — les détails individuels des transactions sont définitivement perdus du livret |
Ce n'est pas qu'un simple désagrément. Un propriétaire de petite entreprise qui tient trois livrets — MUFG pour les opérations courantes, Japan Post Bank (ゆうちょ銀行) pour les réserves fiscales, et un crédit mutuel régional (信用金庫) pour la paie — doit composer avec trois vocabulaires de codes de description différents. Le même événement économique apparaît sous des noms différents sur chaque livret, et aucun décodeur unifié n'existe. Le propriétaire d'entreprise devient cryptographe comme travail secondaire non rémunéré.
Sur Yahoo 知恵袋, le plus grand forum de questions-réponses du Japon, un comptable en exercice a posé la question directement : « Je dois saisir manuellement tout l'historique des transactions des livrets de nos clients dans Excel. La saisie manuelle prend énormément de temps. Existe-t-il un moyen de convertir l'historique des transactions d'un livret en Excel sans utiliser de logiciel de comptabilité comme MoneyForward ou freee ? » La réponse la plus votée était pragmatique : demander au client de s'inscrire à la banque en ligne et de télécharger les données. La deuxième réponse était plus honnête sur la réalité : « L'OCR existe, mais il faut quand même vérifier les erreurs de lecture. La vérification à elle seule prend un temps considérable. »
Aggregate Entry (合計記帳) : la solution de la banque qui crée votre problème
Il existe une fonctionnalité intégrée au système de livrets japonais qui transforme un inconvénient en pénalité structurelle pour quiconque prend du retard dans l'enregistrement. Elle s'appelle l'enregistrement agrégé (合計記帳, gōkei kichō), et elle récompense les diligents et punit les occupés avec une indifférence mécanique égale.
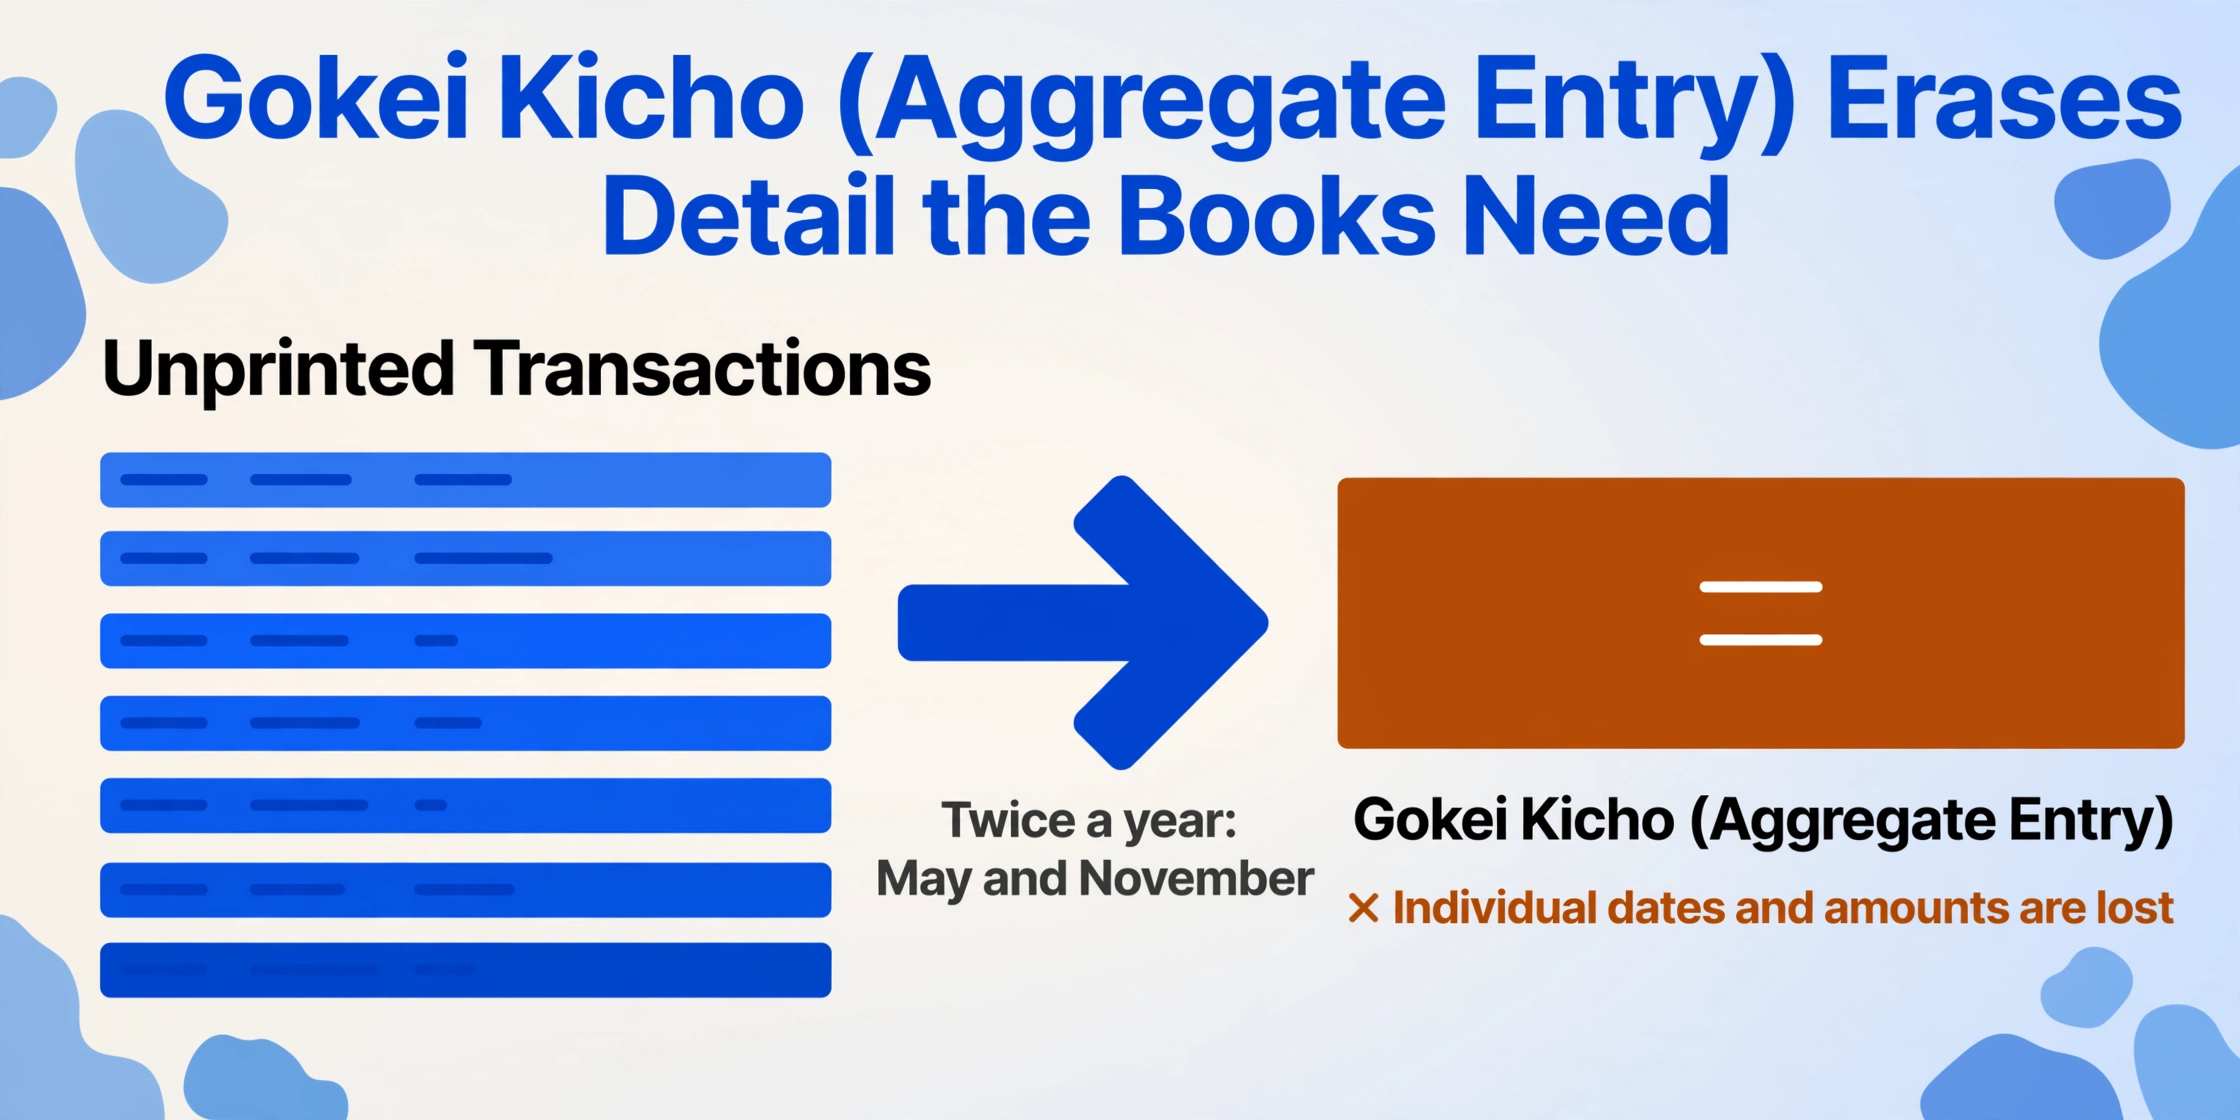
Voici comment cela fonctionne chez MUFG, et la plupart des autres banques japonaises utilisent un mécanisme similaire. Si des transactions s'accumulent sur votre compte sans être imprimées dans le livret — parce que vous n'avez pas visité un distributeur pour le mettre à jour — la banque finit par les consolider. Deux fois par an, le troisième samedi de mai et de novembre, MUFG analyse tous les comptes. Tout compte présentant des transactions non imprimées dépassant un seuil à la fin de mars ou de septembre voit ces transactions regroupées en une seule ligne : 合計記帳. Une ligne indiquant le nombre total de transactions et leur montant net combiné. Chaque transaction individuelle — les dates, les montants, les codes de description — est définitivement perdue du livret.
Les conséquences pour quelqu'un qui s'appuie sur le livret comme registre principal :
- Les transactions perdues ne peuvent pas être reconstituées à partir du livret. Les lignes individuelles n'ont jamais existé sur papier. Elles n'existaient que sous forme de relevés électroniques non imprimés qui ont été écrasés par le processus d'agrégation.
- Mars et septembre sont précisément les mois où les petites entreprises préparent leurs états financiers trimestriels ou semestriels. Le déclenchement de l'agrégation coïncide avec le moment exact où un chef d'entreprise a le plus besoin de données désagrégées.
- Contester une transaction spécifique devient impossible. Si 200 000 ¥ ont été retirés du compte en six transactions agrégées, vous ne pouvez pas savoir quel retrait correspond à quoi, ni quand chacun a eu lieu, ni quels étaient les codes de description. Lors d'un contrôle fiscal, c'est une lacune documentaire.
Le site web de MUFG mentionne ce système presque comme une réflexion après coup — noyé dans une note de bas de page qui dit « veuillez mettre à jour votre livret régulièrement pour éviter l'enregistrement agrégé ». Le ton suppose un retraité qui se rend à la banque chaque semaine pour imprimer les dernières lignes. Pour le propriétaire de petite entreprise qui gère un restaurant, un atelier ou un cabinet de conseil et qui ne va à la banque qu'une fois par mois au maximum, 合計記帳 est une taxe sur leur temps qui s'accumule : manquez une visite, perdez des données définitivement, et faites face à une lacune dans les livres qui ne peut être comblée qu'en demandant un relevé d'historique de transactions à la banque — ce qui, aimablement, prend environ une semaine et arrive par courrier ordinaire.
La Japan Post Bank traite cela différemment — non pas par la même agrégation à date fixe, mais par les limites de pages du livret. Un livret standard contient environ 50 à 100 lignes de transactions imprimées selon la banque. Lorsque les pages sont épuisées, le distributeur automatique émet automatiquement un nouveau livret. Les transactions entre la dernière ligne imprimée de l'ancien livret et la première ligne imprimée du nouveau sont résumées sur la page d'ouverture du nouveau livret. Les transactions individuelles entre les deux ? Disparues du papier. Le nouveau livret repart avec un solde reporté et aucun historique.
Le livret a été conçu pour un monde où les gens se rendaient à la banque chaque semaine et vérifiaient manuellement chaque nouvelle ligne. Dans ce monde, 合計記帳 est une optimisation d'espace raisonnable. Dans le monde où le livret est le document source d'un flux de travail comptable numérique, c'est un mécanisme de destruction de données — et vous ne pouvez pas automatiser votre chemin autour de données qui n'existent plus sur la page.
Pourquoi les applications seules ne suffisent pas à combler l'écart
Les applications japonaises de finances personnelles et de comptabilité — MoneyForward ME (17,8 millions d'utilisateurs), Zaim, Moneytree, ainsi que freee et Yayoi destinées aux entreprises — proposent toutes une liaison des comptes bancaires via API. Pour les comptes où la banque en ligne est activée, les nouvelles transactions sont importées automatiquement dans l'application. Pour un ménage qui suit ses dépenses mensuelles, cela résout en grande partie le problème des transactions à venir.
Pour le propriétaire de petite entreprise qui prépare sa déclaration fiscale, cela ne suffit pas. Trois raisons :
L'écart avant l'inscription
Les applications connectées par API importent les transactions à partir du jour de l'inscription. Elles ne peuvent pas — et ne peuvent pas — remonter dans les années d'historique de transactions qui n'existent que sur les pages du livret imprimées avant l'activation de la banque en ligne. Un propriétaire d'entreprise qui a souscrit à la banque en ligne MUFJ en 2024 a encore 2022 et 2023 dans un livret papier dans un tiroir. Ces années doivent encore être saisies manuellement pour une déclaration bleue, et les applications n'offrent aucune aide pour cela.
Le problème du verrouillage de l'écosystème
Même pour les transactions qui sont importées dans les applications, récupérer les données dans un format utilisable par un autre outil n'est pas simple. MoneyForward exporte des données CSV, mais les correspondances de champs et les affectations de catégories sont spécifiques à MoneyForward. Passer de MoneyForward à freee signifie recatégoriser chaque transaction. Passer d'une application personnelle comme Zaim à une plateforme comptable comme Yayoi signifie tout recommencer. Les applications ajoutent de la commodité, mais elles ajoutent aussi une nouvelle couche de dépendance au format.
L'angle mort des saisies manuscrites
Les livrets bancaires au Japon contiennent souvent des ajouts manuscrits — une note au crayon à côté d'une ligne « 振込 » mystérieuse identifiant un paiement client spécifique, ou une correction écrite lorsque le solde ne correspond pas. Les applications de numérisation comme l'OCR de reçus de MoneyForward ne sont pas conçues pour lire l'écriture manuscrite superposée aux entrées imprimées du livret, surtout lorsque l'écriture traverse les étroites limites des colonnes.
Les applications sont bonnes dans ce qu'elles font : vous montrer ce qui s'est passé récemment et vous aider à le catégoriser. Elles n'ont pas été conçues pour être le pont entre un document imprimé des années 1970 et un système comptable qui attend des données structurées. Ce pont est encore une personne — et les applications, malgré toute leur commodité, n'ont fait que rendre la personne plus consciente de la distance entre les deux extrémités du pont.
Là où les erreurs s'accumulent : la cascade du solde courant
Parmi tous les documents qu'un petit entrepreneur manipule — factures, reçus, bons de commande, bons de livraison — le livret de compte (通帳) est unique sur un point essentiel : ses lignes de données ne sont pas indépendantes. Le solde courant (差引残高) de chaque ligne dépend de l'exactitude de toutes les lignes précédentes. Un chiffre erroné à la ligne 47 d'un livret de 200 lignes n'affecte pas seulement la ligne 47. Il corrompt les lignes 48 à 200. Chaque solde imprimé après l'erreur sera en désaccord avec la réalité.
Cela crée une charge de vérification que les autres types de documents n'imposent pas. Avec une pile de factures, vous pouvez traiter chacune indépendamment — une erreur sur la facture 23 n'affecte pas la facture 24. Avec un livret de compte, soit vous vérifiez le solde de chaque ligne (en contrôlant que Solde précédent + Dépôt – Retrait = Solde courant), soit vous acceptez que toute erreur du lot se propage silencieusement vers l'avant. La plupart des petits entrepreneurs, travaillant tard le soir après la fermeture du magasin, choisissent la deuxième option sans réaliser le risque.
Ce n'est pas une hypothèse. Sur Yahoo知恵袋, un utilisateur a décrit son flux de travail : saisir manuellement les données du livret dans Excel et recouper les totaux avec les relevés bancaires. Les répondants ont proposé des solutions allant du téléchargement CSV à l'OCR, mais le problème sous-jacent — qu'une seule erreur se propage sans être détectée jusqu'à ce que le total final ne corresponde pas — a été reconnu comme inhérent au format. Un répondant a noté que même avec l'OCR, « vous devez quand même vérifier les erreurs de lecture, et la vérification seule prend un temps considérable ». Pour un livret de compte, « vérifier » ne signifie pas contrôler quelques lignes au hasard. Cela signifie vérifier la cascade des soldes sur chaque ligne.
Le problème du 和暦 : quand l'année change à chaque changement d'empereur
Le Japon utilise deux systèmes de calendrier en parallèle. Le calendrier grégorien, utilisé dans le reste du monde, et le calendrier japonais par ères (和暦, wareki), qui nomme les années d'après l'empereur régnant. Un livret bancaire imprime les dates au format de l'ère : 令和6年3月15日 (Reiwa 6, 15 mars). Le logiciel de comptabilité — Yayoi, freee, MoneyForward — accepte les deux formats, mais ne peut pas convertir de l'un à l'autre sans qu'on lui précise à quelle ère appartient chaque date. Et lorsque l'ère change, les numéros d'année repartent à 1.
La difficulté pratique ne réside pas dans l'existence du double système. Ce sont les années charnières — les années où une ère a changé en cours d'année et où les anciennes et nouvelles étiquettes d'ère se réfèrent à la même année grégorienne :
| Année grégorienne | Année d'ère sur le livret | Défi de conversion |
|---|---|---|
| 1989 | 昭和64年 (1er–7 janv.) / 平成元年 (8 janv.–31 déc.) | Showa 64 a duré exactement 7 jours ; Heisei 1 a commencé le 8 janvier. Une ligne de livret datée 昭和64.1.5 = 1989. Une ligne de livret datée 平成1.12.20 = également 1989. Même année civile, deux étiquettes d'ère différentes. |
| 2019 | 平成31年 (1er janv.–30 avr.) / 令和元年 (1er mai–31 déc.) | La transition actuelle. Une page de livret imprimée en avril 2019 indique 平成31年. Une page imprimée en mai 2019 indique 令和元年. Les deux correspondent à 2019. Trier les transactions chronologiquement à travers la frontière d'ère signifie que la personne qui saisit les données doit mentalement mapper 平成31.4.30 → 令和1.5.1 comme des dates consécutives. |
| 2026 (année en cours) | 令和8年 | Plus simple maintenant, mais la prochaine transition — quand elle viendra — créera le même problème de frontière. Un livret couvrant la transition aura deux étiquettes d'ère différentes pour la même année fiscale. |
Pour une entreprise qui conserve trois livrets et dépose une déclaration bleue, le problème des ères se cumule avec celui des codes de description. Il ne s'agit pas seulement de convertir Reiwa 6 en 2024. Il faut aussi, en même temps, déchiffrer si « 振込TB1 » sur le livret MUFG correspond au même dépôt que « 振込 » sur le livret de Japan Post Bank — pendant un mois où l'étiquette d'ère sur un livret peut différer de l'autre si l'un a été imprimé juste avant et l'autre juste après un renouvellement de livret.
Le calendrier par ères n'est pas près de disparaître. Les formulaires gouvernementaux, les documents fiscaux et les relevés bancaires l'utilisent tous. Le logiciel de comptabilité qu'une petite entreprise doit alimenter accepte les deux formats. Mais la conversion entre les deux reste une étape manuelle — et chaque conversion est une occasion pour une année d'être mal alignée, créant des transactions qui apparaissent dans la mauvaise année fiscale.
Le vrai raccourci n'est pas de taper plus vite — c'est de supprimer la couche de traduction
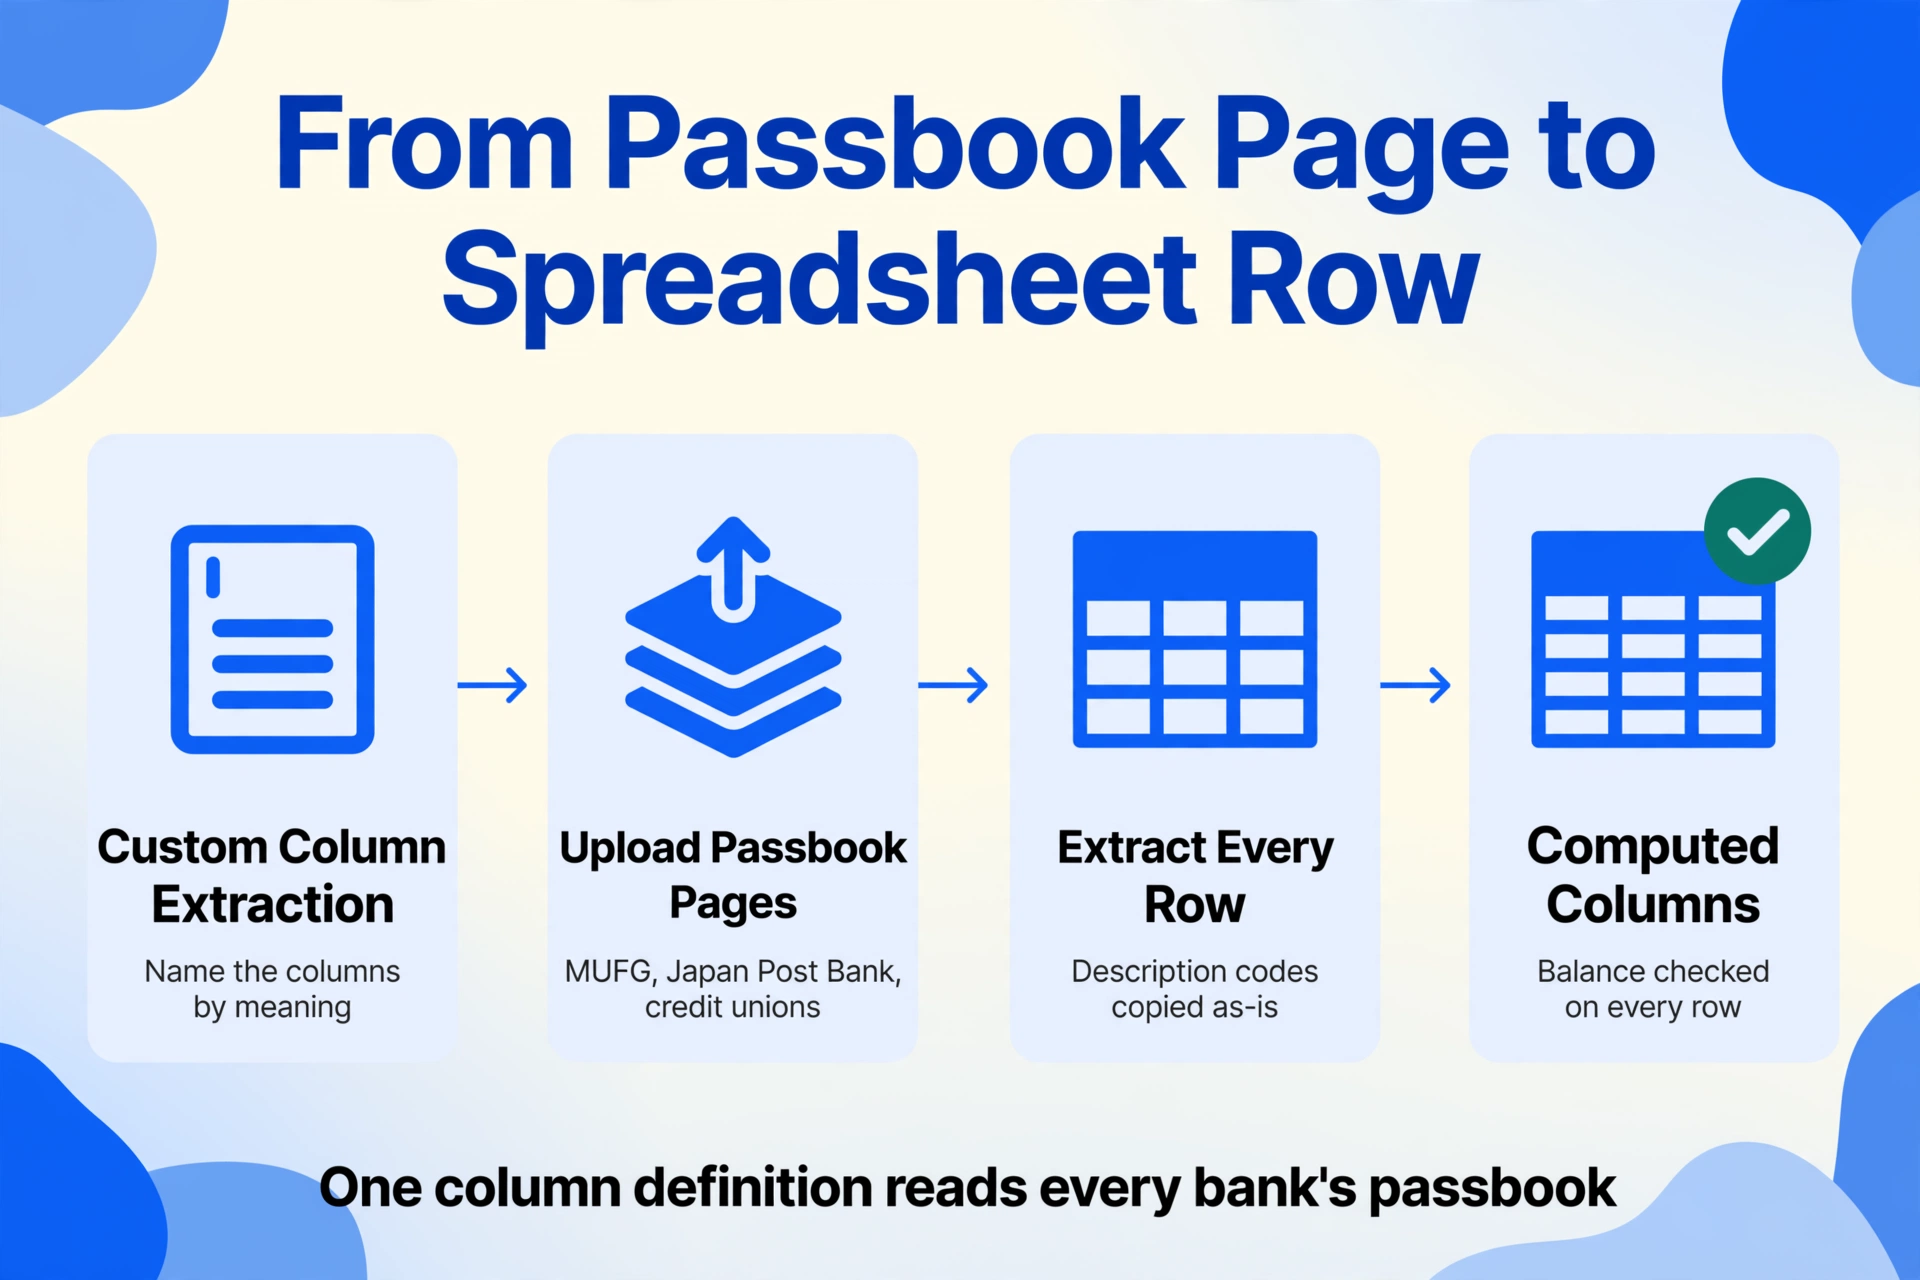
Si le problème structurel est une couche de traduction manuelle entre les pages du livret et le logiciel comptable, la solution ne peut pas être « taper plus vite » ou « utiliser une meilleure application ». Il faut un moyen d'extraire les données du livret qui contourne l'étape de traduction — qui lit le format à cinq colonnes du livret et produit directement des données structurées, sans obliger la personne à décoder les abréviations de description propres à chaque banque, à convertir les années d'ère, ou à vérifier manuellement les soldes courants.
L'approche adaptée à ce problème est l'extraction sémantique : vous indiquez à l'outil ce que signifient les colonnes — « Date », « Description », « Retrait », « Dépôt », « Solde » — et il lit la page du livret et trouve chaque valeur en comprenant la mise en page du document, sans correspondre à un modèle fixe. Comme les formats de livrets japonais sont standardisés entre les banques (cinq colonnes, même ordre, même disposition générale), un modèle sémantique peut lire les pages de MUFG, de ゆうちょ銀行 (Japan Post Bank) et d'un crédit mutuel régional avec la même définition de colonnes — la seule chose qui change d'une banque à l'autre, ce sont les codes de description, et ce ne sont que du texte que l'outil extrait tel quel pour que vous les catégorisiez ensuite.
C'est l'idée centrale derrière l'Extraction de colonnes personnalisées. Au lieu de dessiner des cadres autour des champs ou de créer des règles d'analyse par banque, vous saisissez les noms de colonnes souhaités et téléversez les pages du livret. L'IA lit chaque page, localise les cinq colonnes en comprenant la disposition tabulaire, et remplit une ligne de feuille de calcul par transaction. Ajoutez une colonne calculée — par exemple, « Vérification du solde (solde précédent + dépôt – retrait) » — et l'outil signale chaque ligne où le solde courant ne correspond pas, pour que vous sachiez exactement où une erreur s'est produite avant que les données n'entrent dans votre logiciel comptable.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Le flux de travail complet d'extraction étape par étape — de la première page de 通帳 téléchargée à l'obtention d'une feuille de calcul formatée — est documenté dans le guide d'extraction des 通帳 japonais. Et pour gérer plusieurs 通帳 sur plusieurs années, l'approche de traitement par lots fusionne les pages de différentes banques en un seul registre de dépenses, avec toutes les dates d'ères converties et tous les soldes vérifiés en une seule passe — ce qui compte quand trois 通帳 × trois ans signifient 280 transactions, 1 400 points de données, et une étape de fusion manuelle que l'extraction d'une seule page laisse sur votre bureau.
Rien de tout cela ne fait disparaître le 通帳. L'infrastructure bancaire japonaise continuera de les imprimer pendant des années. Ce qui change, c'est de savoir si la personne de l'autre côté du distributeur doit devenir chaque mois un traducteur de codes bancaires et un auditeur de soldes en cascade — ou si l'extraction se fait en quelques secondes et que le travail humain se déplace vers la partie qui exige réellement un jugement humain : catégoriser les transactions et remplir la déclaration.
Questions fréquentes
Pourquoi les banques japonaises ne cessent-elles pas simplement d'émettre des livrets papier ?
Plusieurs mégabanques proposent désormais des alternatives 100 % numériques — l'Eco通帳 de MUFG (livret internet), par exemple, remplace le livret papier par une interface navigateur ou application et supprime certains frais de guichet automatique comme incitation. Mais y passer désactive définitivement le livret papier, ce que de nombreux clients — en particulier les titulaires plus âgés et les petits entrepreneurs qui utilisent le livret comme registre officiel — hésitent à faire. Le statut juridique du livret en tant que relevé de transactions est profondément ancré dans la pratique bancaire japonaise, et le modifier exige des changements réglementaires et culturels qui ne suivent pas le rythme des versions logicielles.
Puis-je simplement photographier mon livret avec mon téléphone et faire lire l'image par une application ?
Oui, avec des réserves. Certains services d'OCR par IA (comme SmartOCR et Shuttle Smile, conçus spécifiquement pour les livrets japonais) peuvent lire les pages photographiées avec une grande précision pour les caractères imprimés — SmartOCR revendique 99,8 % pour le texte imprimé par machine. Cependant, les pages photographiées présentent des défis que les scans n'ont pas : distorsion de perspective (le livret photographié en biais rend les colonnes trapézoïdales), éclairage inégal sur la reliure du livret et lisibilité réduite des caractères katakana demi-largeur déjà compressés dans des colonnes étroites. Les annotations manuscrites sur les pages du livret réduisent encore la précision. La technologie existe et fonctionne, mais elle exige une bonne qualité d'entrée et — à des fins comptables — une vérification humaine des résultats.
Qu'advient-il de mes données de livret si je passe à l'Eco通帳 (livret internet) ?
L'Eco通帳 de MUFG conserve jusqu'à 10 ans d'historique de transactions au format numérique, accessible via la banque en ligne. Les transactions passées déjà agrégées (合計記帳) sur votre ancien livret papier peuvent être récupérées via une demande distincte d'impression de l'historique des transactions — mais uniquement si vous en faites la demande. Le piège : une fois que vous passez à l'Eco通帳, votre livret papier est désactivé définitivement. Vous ne pouvez pas revenir en arrière. Si vous avez besoin plus tard d'un relevé papier pour un contrôle fiscal ou une demande de prêt, vous devrez télécharger et imprimer depuis l'interface numérique.
L'utilisation d'un logiciel comptable comme freee ou Yayoi élimine-t-elle le besoin d'extraire les données du livret ?
Pour les transactions qui surviennent après la liaison de votre compte bancaire via API, les applications récupèrent automatiquement les données de transaction. Pour tout ce qui s'est produit avant la liaison — ce qui, pour la plupart des petites entreprises, représente des années d'historique — les données restent dans les pages du livret. Les applications ne peuvent pas reconstituer l'historique. Et même pour les comptes liés, l'auto-catégorisation n'est pas parfaite : un dépôt « 振込 » d'un client ressemble à un virement « 振込 » depuis votre propre autre compte, et l'application ne peut pas les distinguer sans règles manuelles ou corrections. Les applications réduisent la saisie continue de données mais n'éliminent pas le besoin d'extraction des données du livret pour les relevés historiques et la vérification de l'exactitude.
La même configuration d'extraction peut-elle fonctionner avec différents livrets bancaires — MUFG, Japan Post Bank, banques régionales ?
Oui. Malgré les différences de codes de description entre les banques, la disposition en cinq colonnes du livret (date, description, retrait, dépôt, solde) est standardisée dans pratiquement toutes les institutions financières japonaises. L'extraction sémantique lit la disposition en la comprenant comme un tableau — elle n'a pas besoin de modèles par banque, car elle identifie les colonnes par leur contenu et leur position plutôt que par un ensemble fixe de règles. Définissez les colonnes une fois, et la même définition fonctionne avec les livrets MUFG, Japan Post Bank, SMBC et des crédits mutuels régionaux. Les codes de description différeront (comme documenté ci-dessus), mais ils sont extraits sous forme de texte — vous les catégorisez après l'extraction, pas pendant celle-ci.
La prochaine fois que la pile mensuelle de 通帳 atterrit sur le bureau — trois livrets, peut-être 60 nouvelles lignes entre eux, chaque ligne contenant cinq champs et quatre décisions — il vaut la peine de nommer ce qui se passe réellement. Pas de la « saisie de données », pas de la « comptabilité », mais un exercice de traduction en temps réel entre un format de document inchangé depuis l'ère Showa et un logiciel comptable qui fonctionne selon une logique fondamentalement différente. La frappe est la plus petite partie du travail. Le décodage du sens — que dit ce code, quelle année est-ce, quel système d'abréviations de banque est-ce — c'est là que les heures passent et que les erreurs se logent. Voyez à quoi ressemblent vos propres pages de 通帳 lorsque l'extraction se fait en quelques secondes et que la seule décision restante est de savoir quoi faire des chiffres.