Google Vision vs AWS Textract vs Azure:
クラウドOCR比較2026
どのクラウド基盤を利用しているかで、最も統合コストが低いOCR APIが決まります。すでにAWSを利用しているチームは、TextractのIAMおよびS3統合に追加コストを支払う必要はありません。Google Cloudを利用している企業は、Vision APIのCloud Storageパイプラインで同じ利点を得られます。Microsoftを利用している企業は、Azure FoundryのDocument Intelligenceから評価を始めることで、評価時間を短縮できます。問題は、どのOCRエンジンが技術的に優れているかではなく、どのエンジンが自社のインフラにとって最も安価に導入できるかです。
重要なポイント
- 3つのクラウドOCR API、3つの仕様書は、すべて同じように見えます。テキスト抽出は1,000ページあたり$1.50、印刷テキストの精度は約95%です。
- 重要な価格は基本的なOCRレートではなく、構造化抽出ティアです。Textractは1,000ページあたり$1.50から$65に跳ね上がる一方、Azureのプリビルトモデルは$10のままです。
- 利用中のクラウド基盤が、最初のドキュメントを開く前に、最も安価なOCR APIの導入先をすでに決定しています。AWSを利用しているチームは、TextractのIAM統合オーバーヘッドをゼロにでき、同じインフラ上の利点がGoogle CloudとMicrosoft 365にも適用されます。
クイック比較:3つのクラウドOCR APIを横並びで
各項目の詳細に入る前に、概要をご覧ください。以下の数値は、月間100万ページまでの米国東部リージョンのベースライン価格です。価格はリージョンやボリューム層によって変動しますが、相対的な位置関係は変わりません。
| 項目 | Google Cloud Vision | AWS Textract | Azure Document Intelligence |
|---|---|---|---|
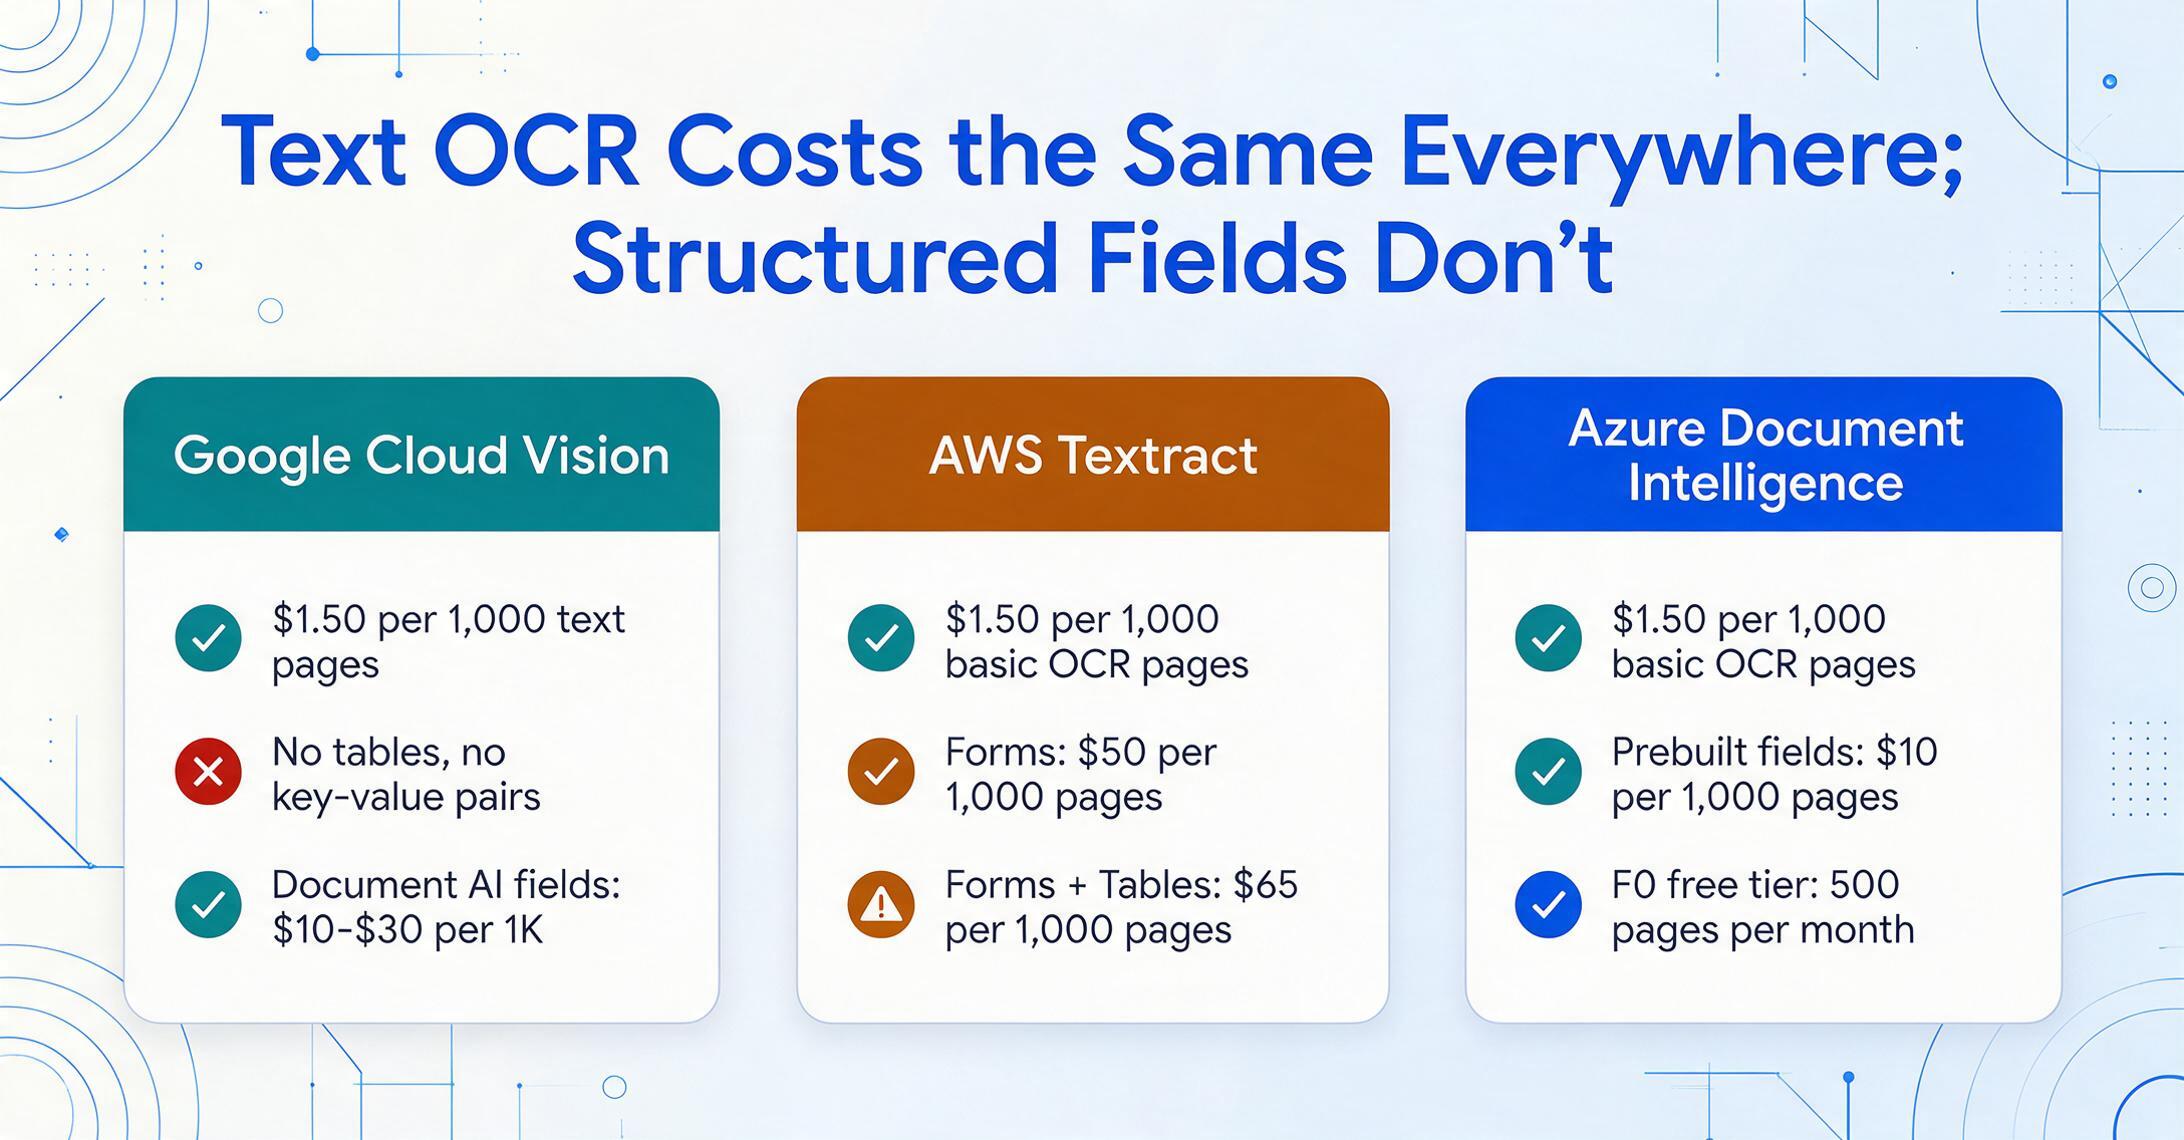
| 基本OCR(1,000ページあたり) | $1.50 | $1.50 | $1.50 |
| 表抽出(1,000ページあたり) | 非対応(Vision API) | $15.00 | $10.00 |
| フォーム/キー値抽出(1,000ページあたり) | 非対応(Vision API) | $50.00 | $10.00(プリビルト) |
| 手書き文字対応 | 対応(DOCUMENT_TEXT_DETECTION) | 英語のみ | 9言語 |
| 印刷文字の精度 | 約95%(DeltOCR Bench) | 約95%(DeltOCR Bench) | 約96%(DeltOCR Bench) |
| 無料枠 | 機能あたり月1,000ユニット | 月1,000ページ(3ヶ月間) | 月500ページ(F0) |
| 対応言語(印刷文字) | 200以上 | 6言語(EN, ES, DE, FR, IT, PT) | 100以上 |
| SDK対応言語 | Python, Java, Node.js, Go, C#, PHP, Ruby | Python, Java, .NET, Ruby, PHP, Go, C++ | Python, C#, Java, JavaScript, Go |
| プリビルト文書モデル | 請求書、領収書、銀行明細書、W-2、給与明細、公共料金請求書、身分証明書(Document AI経由) | 請求書/経費、身分証明書、融資 | 請求書、領収書、身分証明書、W-2、1098、健康保険証、契約書、婚姻証明書 |
この表から最も重要な点は、Google Cloud VisionとAWS Textractは同等の製品ではないということです。Vision APIはOCR機能を含む汎用画像分析サービスです。Textractは文書抽出に特化したサービスです。GoogleのTextract相当品はDocument AIですが、Document AIの価格はより高く、特殊プロセッサで1,000ページあたり$10〜$30です。公平な比較のため、この記事では必要に応じてVision API(基本OCR)とDocument AI(構造化抽出)の両方を取り上げます。
次元1:価格 — ページ単位の内訳
OCR APIを評価するチームにとって、毎月の請求額は最初に重要となる数字です。しかし、クラウドOCRの価格は階層的であり、月1,000ページで最も安い選択肢が、100,000ページでは最も安いとは限りません。
Google Cloud Visionの価格
Cloud Visionは機能単位モデルを採用しています。TEXT_DETECTIONとDOCUMENT_TEXT_DETECTIONは、月間の最初の1,000単位が無料で、以降は1,000単位あたり$1.50です。500万単位を超えると、1,000単位あたり$0.60に下がります。ただし、各機能リクエストは別々の単位としてカウントされます。1つの画像に対してテキストとラベルの両方を分析すると2単位になります。純粋なOCRワークロードの場合、1回のTEXT_DETECTION呼び出しは1単位です。月100,000ページの場合、$150を支払うことになります。
構造化抽出(請求書、フォーム、テーブル)が必要な場合、Vision APIだけでは不十分です。Document AIが必要で、Enterprise Document OCR Processorは1,000ページあたり$1.50ですが、Invoice ParserやForm Parserなどの専門プロセッサは1,000ページあたり$10〜$30かかります。
AWS Textractの価格
Textractはページ単位で請求されますが、料金は呼び出すAPIに完全に依存します。DetectDocumentText(基本OCR)は、最初の100万ページまで1,000ページあたり$1.50で、Googleの基本料金と同じです。100万ページを超えると、1,000ページあたり$0.60に下がります。違いが現れるのは構造化データが必要な場合です。Forms付きのAnalyzeDocumentは1,000ページあたり$50、Tablesは1,000ページあたり$15、Queriesは1,000ページあたり$15です。3つすべてを組み合わせると、1,000ページあたり$65になります。
月100万ページを超えるとボリュームディスカウントが適用されますが、そのしきい値を下回る場合、コストは急速に積み上がります。ある開発者はTextractの基本OCR価格($0.0015/ページ)を見積もって予算を立てましたが、実際に必要なフォームとテーブル機能が30〜40倍のコストになることを後で発見しました。これが最も一般的なTextractの価格設定の驚きです。
Azure Document Intelligenceの料金
Azureは、Read、Layout、Prebuilt、Customの各ティアにサービスを分けています。Readモデル(OCRのみ)は、1,000ページあたり約$1.50です。LayoutおよびPrebuiltモデル(請求書、領収書、ID、W-2など)は、1,000ページあたり約$10です。Custom抽出モデルは、最大500ドキュメントの無料トレーニング後、1,000ページあたり約$50です。クエリフィールドや数式抽出などのアドオン機能は、基本モデルコストに20〜30%の追加料金がかかります。
Azureが価格面で優位に立つのはPrebuiltモデルティアです。請求書・領収書の抽出が1,000ページあたり$10であるのに対し、TextractのFormsは1,000ページあたり$50です。この5倍の差は、規模が大きくなると重要です。毎月50,000件の請求書を処理するチームは、AzureのPrebuiltモデルで$500、TextractのForms APIで$2,500かかります。
料金の結論
基本的なOCRのみのワークロードでは、3社とも1,000ページあたり$1.50でほぼ横並びです。差が生じるのは、構造化抽出が必要な場合です。AzureのPrebuiltモデルは、請求書・領収書の解析への最も安価な道です。Textractの組み合わせ料金は、フォーム+テーブル+クエリを同時に必要とするチームには不利です。GoogleのDocument AIは中間に位置しますが、Vision APIから別の製品ティアへの移行が必要です。
次元2:ドキュメント機能 — テーブル、フォーム、手書き、言語
クリーンな印刷テキストに対する生のOCR精度は当然の前提です。どのクラウドAPIも、タイプされたドキュメントでは94%を超えます。本当の差別化要因は、どのドキュメントタイプを得意とし、どのタイプを不得意とするかです。
テーブルとフォーム
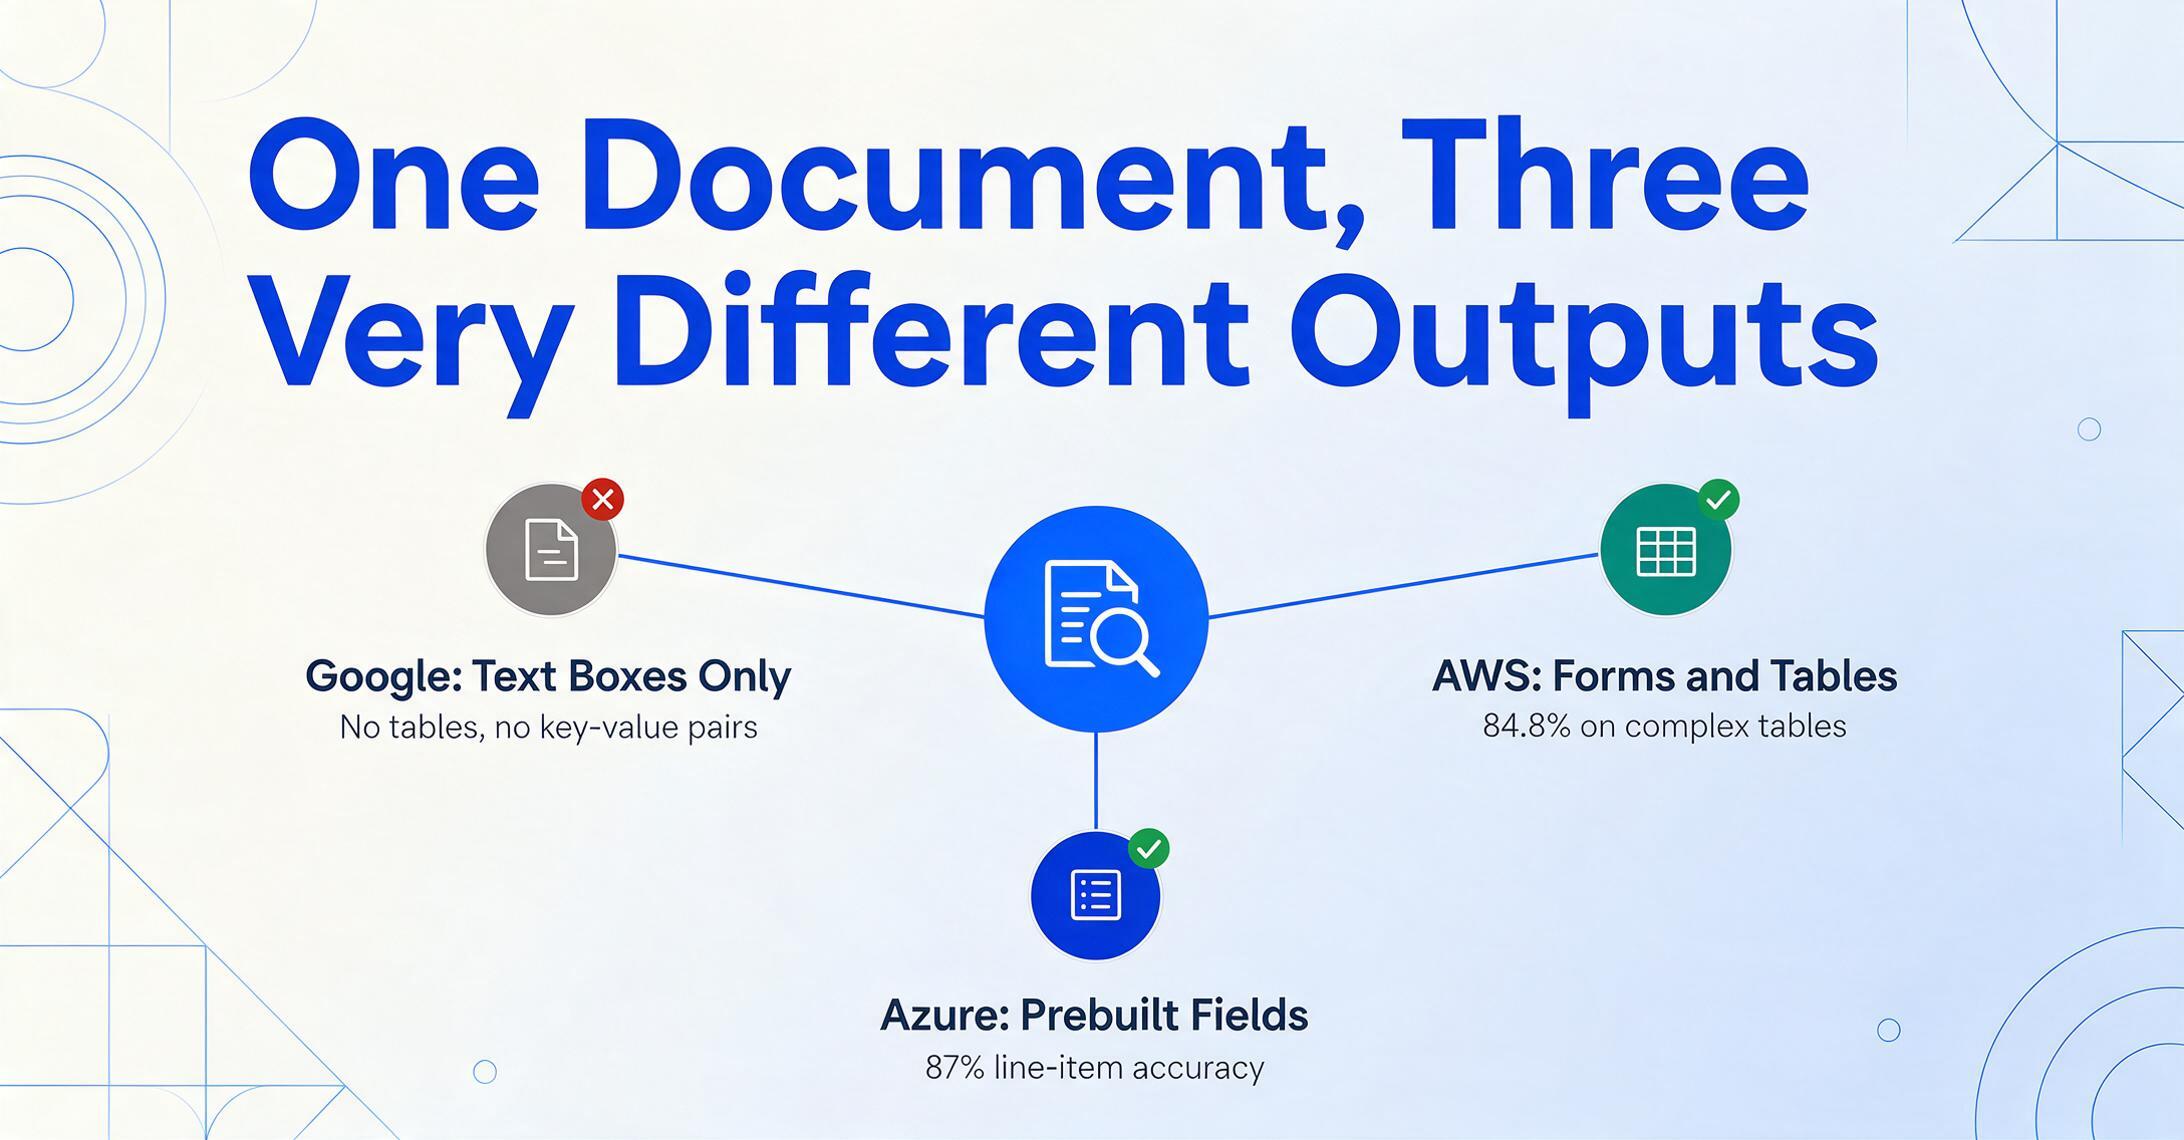
この次元において、3つのAPIは最も大きく分岐します。Google Cloud Vision(基本のOCR製品)は、テーブルやキーと値のペアを抽出しません。検出されたテキストの周囲にバウンディングボックスを、ページ、ブロック、段落、単語という構造的階層とともに返しますが、テーブルのセルやフォームのフィールドを理解することはありません。Google Cloudでテーブル抽出が必要な場合は、Document AIのLayout Parser(1,000ページあたり$10)またはカスタムプロセッサを使用する必要があります。
AWS TextractのAnalyzeDocument APIには、専用のForms機能とTables機能があります。Formsはキーと値のペア(ラベル:値)を信頼度スコア付きで返します。Tablesは行/列インデックスと結合セルの処理を含むセルレベルのデータを返します。独立したベンチマークによると、Textractは複雑なテーブル抽出で約84.8%の精度を達成していますが、結果は文書の品質によって大きく異なります。
Azure Document IntelligenceのLayoutモデルは、テーブルと選択マークをネイティブに処理し、プリビルトのInvoiceモデルは明細項目を含む構造化フィールドを出力します。これは、請求書パイプラインを構築するほとんどのチームが実際に必要とするものです。ベンチマークデータによると、Azureは明細項目の抽出精度87%を達成しており、この特定のタスクでは両競合他社をわずかに上回っています。
手書き文字
Google Cloud Visionは、DOCUMENT_TEXT_DETECTION機能を通じて手書き文字をサポートしており、印刷テキストと手書きテキストの両方を1回の呼び出しで処理します。きれいな手書き文字に対する精度は競争力がありますが、筆記体や低コントラストのスキャンでは精度が著しく低下します。
AWS Textractは2022年に手書き文字認識を追加しましたが、英語の文書に限定されており、精度は印刷テキストのパフォーマンスよりも著しく低くなっています。AWSのドキュメント自体が、最良の結果を得るために最低150 DPIと直立したテキストの向きを推奨しています。手書き文字が多い文書では、多くのチームがTextractの出力を後段のLLMにエクスポートしてクリーンアップしています。これはStack OverflowやAWS re:Postで頻繁に見られるパターンです。
Azure Document Intelligenceは、英語、フランス語、ドイツ語、イタリア語、日本語、韓国語、ポルトガル語、スペイン語、中国語(簡体字)を含む9言語の手書き文字をサポートしています。ベンチマークデータによると、Azureの印刷/手書き混在文書の精度はTextractを上回っていますが、純粋な手書き文字認識は依然として専用のVLMソリューションには及びません。
言語サポート
Google Cloud Visionは、印刷テキストで200以上の言語、手書き文字で50以上の言語をサポートしており、ここでリードしています。Azure Document Intelligenceは、印刷テキストで100以上の言語、手書き文字で9つの言語をサポートしています。AWS Textractは、印刷テキストでわずか6言語(英語、スペイン語、ドイツ語、イタリア語、フランス語、ポルトガル語)、手書き文字は英語のみであり、大幅に遅れを取っています。日本語のサプライヤーからの請求書やアラビア語の契約書を処理する場合、Textractは別途翻訳レイヤーなしでは事実上使用できません。
次元3:統合 — SDKの品質、エコシステム、ドキュメント
これは、ほとんどの比較記事が省略する次元ですが、チームが2週間でリリースできるか、2ヶ月かかるかを左右します。
Google Cloudの統合
GoogleのPython SDKはよく設計されています。google-cloud-visionライブラリは他のGoogle Cloudクライアントライブラリと一貫性があり、APIリファレンスも充実しています。Vision APIは、画像の直接アップロード、base64エンコード、Cloud Storage URIをサポートしており、Cloud Storageがbase64よりも約25%高速な最速のオプションです。Google Cloudのネットワークインフラストラクチャは、SearchやYouTubeを支えるのと同じ専用ファイバー上で動作し、AWSやAzureのデフォルトのネットワーク層よりもクロスリージョンのレイテンシが15〜25%低くなります。
欠点は、Googleの製品命名が混乱を招くことです。「Google Cloud OCR」を検索する開発者は、Cloud Vision、Document AI、そして廃止されたOCR On-Prem(2025年9月に終了)を見つけることになります。間違った製品を選ぶと、後で抽出レイヤーを再構築する必要が生じます。Vision APIは座標付きのテキストを提供します。Document AIは構造化されたフィールドを提供します。この2つの間のギャップは、本格的なエンジニアリングプロジェクトです。
AWSの統合
Textractの最も強力な統合上の利点は、主要なすべての言語でAWS SDKを通じてネイティブにアクセスできることです。パイプラインがすでに文書保存にS3、サーバーレス処理にLambda、オーケストレーションにStep Functionsを使用している場合、Textractはクロスクラウド設定なしで導入できます。boto3 SDKは成熟しており、ドキュメントも充実していて、より広範なAWS APIパターンと一貫性があります。
ただし、Stack Overflowでよくある不満には、手動のNextToken追跡が必要なページネーション処理、高容量パイプラインでクォータ増加リクエストが必要な100同時ジョブのソフト制限、Textractのブロックベースの応答JSONからテーブル構造を再構築するためのカスタム後処理の構築が必要なことが含まれます。あるStack Overflowのスレッドでは、Textractが生のOCRモードで「表形式の情報などの文書の構造をすべて取り除く」ため、開発者が構造を自分で再推論する必要があると指摘されています。
Azure統合
Azure Document Intelligenceは、より広範なMicrosoftエコシステムの恩恵を受けています。Python、C#、Java、JavaScript向けのSDKが利用可能で、完全な非同期サポートを備えています。ローコードチーム向けには、Power Automateコネクタを使用することで、カスタムコードなしでドキュメント処理ワークフローを実現できます。これは、すでにMicrosoft 365とPower Platformを利用している組織にとって大きな利点です。
Document Intelligence Studioは、テスト中に即時の精度メトリクスとフィールドレベルの信頼度スコアを提供するため、パイロット評価中のフィードバックループを短縮します。約260万ページのバースト取り込みを処理したあるr/AZUREユーザーは、サービスが約12時間で問題なくスケールし、前払いのボリュームディスカウントにより初月のコストが削減されたと報告しています。Azureのドキュメントは包括的ですが、Foundry Tools、AI Services、および従来のCognitive Servicesページに分散しており、この再編成が初期設定時に開発者を悩ませています。
次元4: 精度 — ベンチマークが実際に示すもの
クラウドOCRベンダーは精度の主張を公表していますが、独立したベンチマークはより微妙な状況を示しています。DeltOCR Bench(2025年11月)は、混合ドキュメントタイプで主要なOCRサービスを評価し、以下の印刷テキスト精度スコアを明らかにしました:
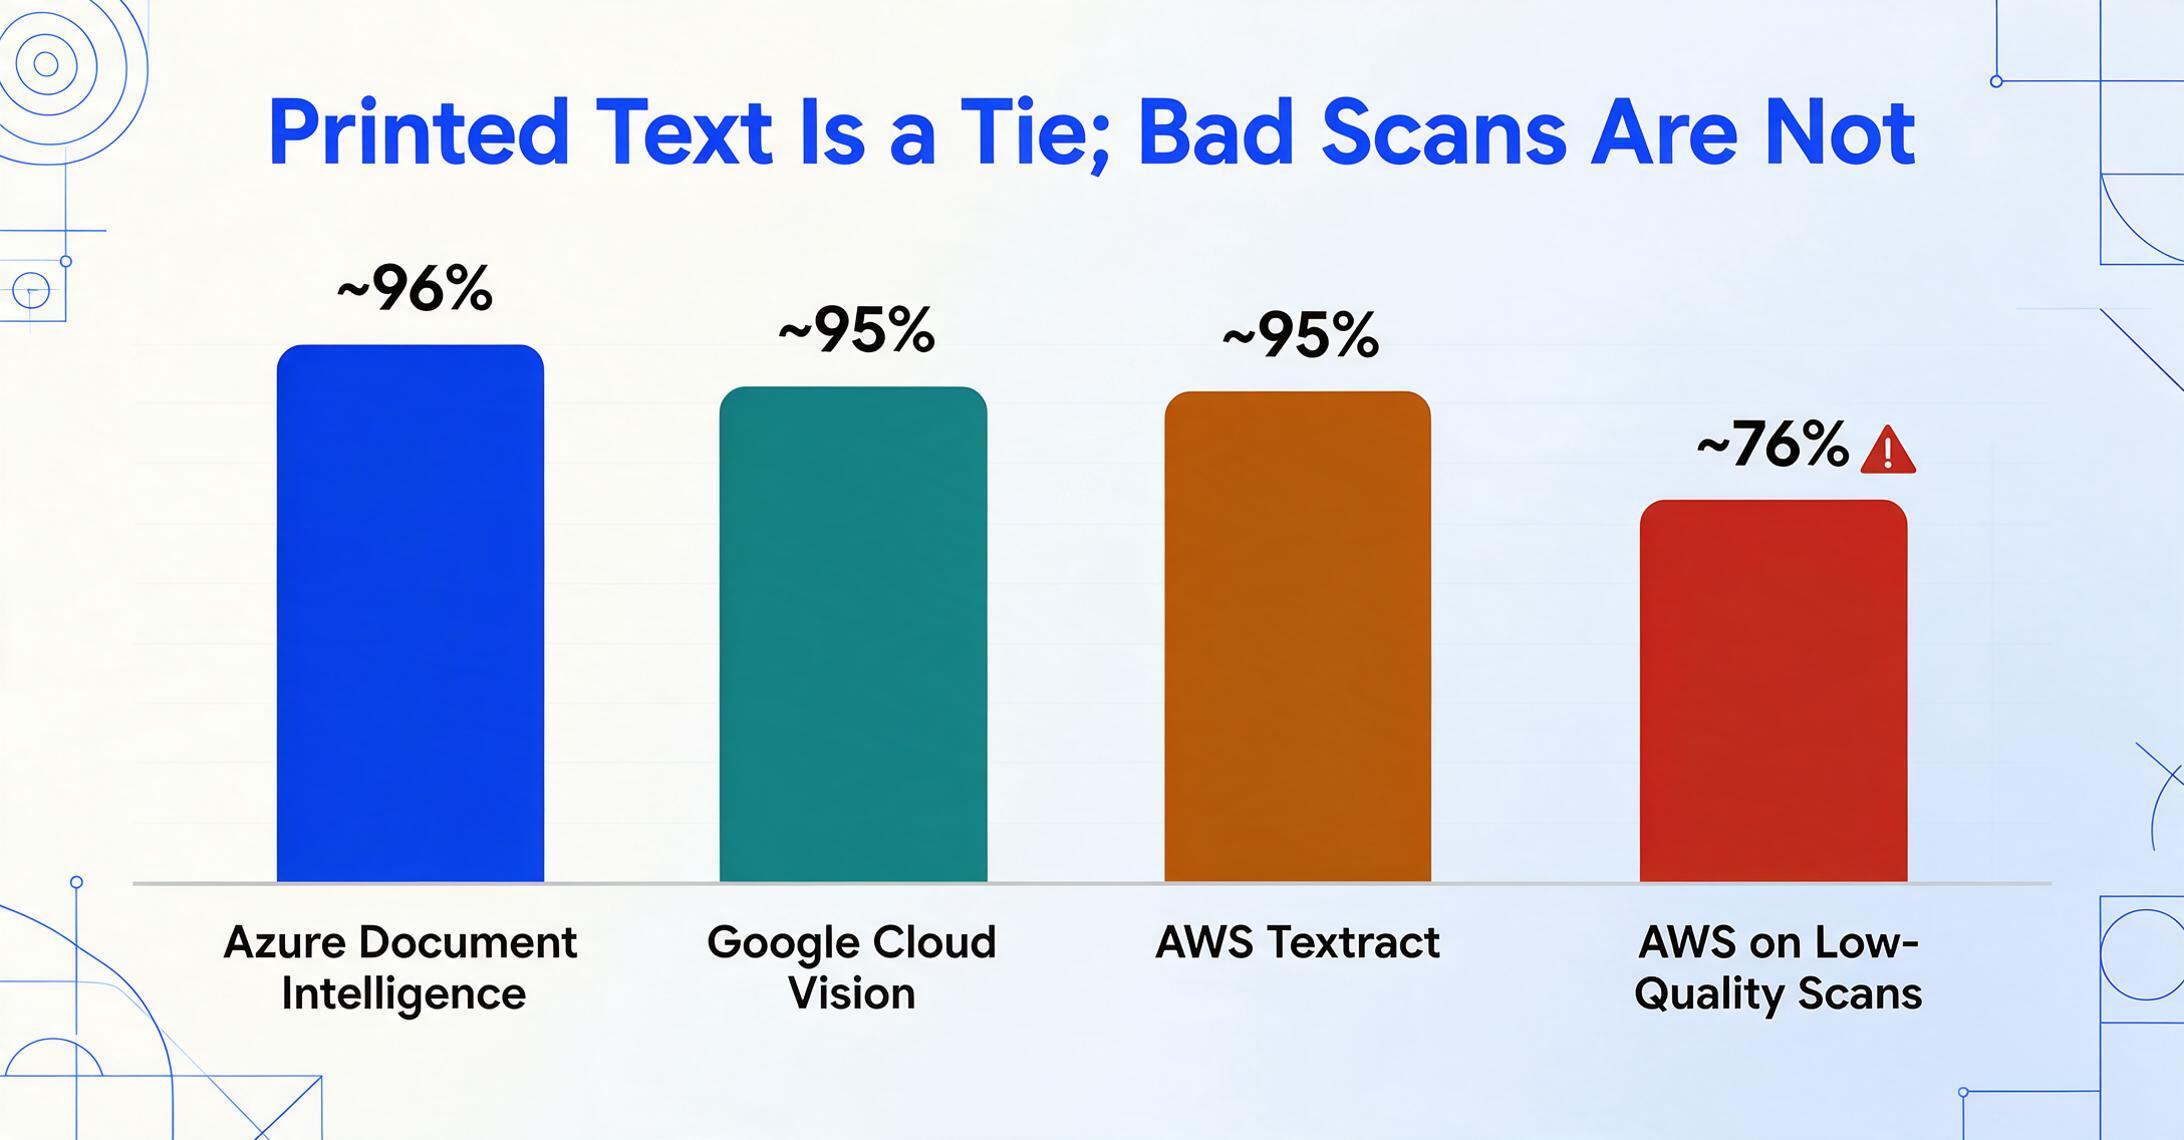
- Azure Document Intelligence: 約96% — 3社の中で最も高い印刷テキスト精度。標準的なフォームとクリーンなドキュメントで特に強力
- Google Cloud Vision: 約95% — 印刷テキストではTextractとほぼ同等。高密度なドキュメントページでわずかに優れたパフォーマンス
- AWS Textract: 約95% — タイプされたテキストでは競争力があるが、低品質スキャンでは約76%に低下(独立したテストによる)
BusinessWareTech 2025年の請求書抽出ベンチマークは、5つのツールのフィールドレベルの精度をテストし、財務ドキュメントでより大きなばらつきを発見しました:
- Azure Document Intelligence: 請求書のフィールド精度93%
- Google Document AI: フィールド精度82%
- AWS Textract: フィールド精度78%
これらの数値から得られる教訓: クリーンでタイプされたドキュメントでは、3社すべてが優れており、ほとんどのユースケースでは精度の差はわずかです。請求書、複雑なレイアウト、低品質のスキャンでは、その差は広がります — そしてAzureは、そのような困難なシナリオで一貫して優れたパフォーマンスを発揮します。手書き文字では、3社すべてが専用のVLMソリューションに劣りますが、Azureは3社の中で最も広範な言語カバレッジを提供します。
Google VisionとTesseractの両方をテストしたあるStack Overflowユーザーは、「Google Visionは66.6%の精度」だったのに対し、Tesseractは特定のデータセットで82%を達成したと報告しています。これは、精度はドキュメントに依存し、ベンチマークは方向性を示すものであり、絶対的なものではないことを思い出させます。常に自社のドキュメントでテストしてください。
重要な洞察
クラウドOCR API間の精度ギャップは、どのクラウドOCR APIとビジョン言語モデルアプローチとの間の精度ギャップよりも小さい。複雑な文書の場合、マルチモーダルLLM(GPT-4o、Gemini、Claude)は現在95〜98%のフィールド精度を達成しており、従来のクラウドOCRサービスの78〜93%の範囲から大幅に向上している。トレードオフはコストとレイテンシーだが、進む方向性は明確だ。
Google Visionが適しているケース
Google Cloud Visionは、すでにGoogle Cloudでワークロードを実行しており、構造化文書抽出ではなく汎用OCRが必要な場合に適した選択肢です。機能ごとに月間最初の1,000ユニットが無料のため、低ボリュームの評価ではコストゼロで利用できます。200以上の言語サポートは他に類を見ません。文書が日本語、アラビア語、ヒンディー語、ヨーロッパ言語にわたる場合、Vision APIは1回の呼び出しで処理します。
テキストのみ(テーブルやフォームは不要)を必要とするチームにとって、Vision APIの1,000ページあたり$1.50は競争力があり、そのスループットは優れています。2026年のベンチマークでは、生のOCR処理の「スピード王」と評されました。パイプラインが「10,000枚の画像からすべてのテキストを抽出して保存する」というものであれば、Vision APIはGoogle Cloud上で最速かつ最もコスト効率の高い経路です。
ただし、評価しているものを正確に把握してください。Cloud VisionはTextractやDocument Intelligenceの代替品ではありません。明細項目のある請求書、キーと値のペアのあるフォームなど、構造化抽出が必要な場合は、比較対象は独自の価格設定と学習曲線を持つGoogle Document AIに移ります。
AWS Textractが適しているケース
AWS Textractは、文書パイプライン全体がすでにAWSにある場合の自然な選択肢です。文書をS3に保存し、Lambdaで処理し、Step Functionsでオーケストレーションし、Amazon A2Iで結果をレビューする場合、Textractはクロスクラウド設定なしで統合できます。VPCピアリングも、別のAPIキーも、異なるIAMパターンも不要です。
TextractのAnalyzeExpense APIは請求書とレシートの抽出専用に設計されており、要約フィールドと明細項目グループを持つ型付きExpenseDocumentオブジェクトを返します。生のOCR出力の上に抽出レイヤーを構築する必要はありません。標準化された文書タイプ(同じベンダー、一貫したレイアウト)を大量(月間50,000ページ以上)に処理するチームにとって、Textractの予測可能なページ単位の価格設定とボリュームディスカウントはコストの予測可能性をもたらします。
Queries機能(「請求書の合計はいくらですか?」などの自然言語の質問ができる機能)は、スキーマを構築せずに特定のフィールドを抽出するのに本当に役立ちます。ただし、ページあたり30クエリの制限と、Queries機能の1,000ページあたり$15のコストは積み重なります。また、6言語の上限は多言語文書パイプラインにとって厳しい制約です。
Azure Document Intelligenceが適しているケース
Azure Document Intelligenceは、プリビルトモデルの豊富さ、印刷テキストの精度、Microsoftエコシステムとの統合という3つの点で優れています。
組織がMicrosoft 365を利用し、SharePointでドキュメントを保存している、またはPower Automateのライセンスを保有している場合、Document Intelligenceは統合の手間が最も少ない選択肢です。プリビルトモデルライブラリには、請求書、領収書、身分証明書、W-2、1098税務フォーム、健康保険証、契約書、婚姻証明書が含まれており、GoogleやAWSが標準で提供するものよりも専門化されたプロセッサが揃っています。多様なドキュメントタイプを処理するチームにとって、カスタムモデルのトレーニングの必要性が減ります。
独立したベンチマークデータでは、Azureは印刷テキストの精度で常にトップクラスに位置しています。特に請求書抽出では、Azureの93%のフィールド精度がGoogle(82%)とAWS(78%)を大きく上回っています。複雑または可変形式のドキュメントでの精度が最優先事項である場合、Azureは従来型クラウドOCRの中でもっとも強力な選択肢です。
Azureの9言語対応の手書きテキストサポートは、英語のみ対応のTextractの手書き認識よりも優れています。医療用問診票や現場点検レポートなど、印刷と手書きが混在するドキュメントでは、Azureは1回の処理で両方に対応します。
ノーコードの代替案:OCRパイプラインを構築したくない場合
クラウドOCRベンダーのいずれも直接対応していないシナリオがあります。それは、ドキュメント抽出が必要だが、クラウドネイティブなエンジニアリングチームではない場合です。Vision API、Textract、Document Intelligenceを中心にパイプラインを構築するには、最低でもドキュメントのアップロード、JSONレスポンスの解析、出力スキーマへのフィールドマッピング、エラー処理のコードを書く必要があります。これは経験豊富なチームでも数週間かかるエンジニアリングプロジェクトです。
ImageToTable.aiはそのギャップを埋めます。3つのクラウドOCR APIとは異なるカテゴリ、つまりOCRではなくAIデータ抽出に位置づけられます。従来のOCRではなく視覚言語モデルを基盤としており、文字認識ではなく意味的にドキュメントを理解します。ドキュメントをアップロードし、必要な列名(例:「請求書番号」「支払期日」「合計」)を入力すると、AIがページ上の位置やベンダーのレイアウトに関係なく、意味に基づいて各値を特定します。
クラウドOCR APIが座標と信頼度スコアを提供し、それを回答に組み立てる必要があるのに対し、ImageToTable.aiはスプレッドシートを提供します。バッチ処理(請求書50枚をアップロードしてExcelファイル1つを取得)、抽出中に結果を計算する計算列(「行合計=数量×単価」など)、およびAPI統合なしで抽出データをスプレッドシートに直接書き込むGoogle Sheetsアドオンをサポートしています。
クラウドOCR APIを評価しているエンジニアチームにとって、ImageToTable.aiは代替品ではありません。異なるユーザー向けの異なるツールです。しかし、抽出すべきドキュメントがあり、専任の統合チームがない組織であれば、構築に数週間かかるクラウドOCRパイプラインに着手する前に、テストする価値があります。従来のOCRとAI抽出の違いをご覧ください。また、これら3つのクラウドAPIを、デスクトップツール、無料コンバーター、AI抽出アプリを含むOCR市場全体と比較したい場合は、OCRソフトウェア市場マップで幅広い比較をご確認いただけます。
FAQ
月10,000ページの場合、最も安いクラウドOCR APIはどれですか?
基本OCR(テキストのみ)の場合、3つともほぼ同じコストで、月10,000ページで約$15です。構造化抽出(明細行付きの請求書)の場合、Azureのプリビルトモデルが1,000ページあたり$10で最も安く、次いでGoogle Document AIが1,000ページあたり$10〜$30、AWS TextractのForms + Tablesの組み合わせが1,000ページあたり$65で最も高額です。
手書き文字の処理に最も優れているAPIはどれですか?
3つのクラウドOCR APIはいずれも手書き文字で最高水準ではありません。GPT-5(約95%)やMistral OCR 3(約89%)のような専用VLMソリューションが、単独の手書き文字ではすべてのAPIを上回ります。3つの中では、Azure Document Intelligenceが手書き文字の言語サポート(9言語)で最も幅広く、Google Visionは英語の手書き文字を適切に処理します。AWS Textractは英語の手書き文字のみをサポートし、印刷テキストよりも精度が著しく低くなります。
クラウドアカウントなしでこれらのAPIを使用できますか?
いいえ。3つすべてにアクティブなクラウド請求アカウントが必要です。Googleは新規顧客に$300の無料クレジットを提供しています。AWSは3ヶ月の無料利用枠(Textractで月1,000ページ)を提供しています。Azureは月500ページの無料F0ティアを提供しています。いずれもオフラインや登録済みの支払い方法なしでは動作しません。
最も多くの言語をサポートしているAPIはどれですか?
Google Cloud Visionは、印刷テキストで200以上の言語、手書きで50以上の言語をサポートしており、トップです。Azure Document Intelligenceは、印刷テキストで100以上の言語、手書きで9言語をサポートしています。AWS Textractは、印刷テキストでは6言語のみ、手書きでは英語のみのサポートで、多言語ドキュメント処理において大きな制限となります。
カスタムモデルのトレーニングは必要ですか?
標準的なドキュメントタイプ(請求書、領収書、W-2、ID)の場合、3つすべてがすぐに使える事前構築済みモデルを提供しています。カスタムまたは特殊なドキュメント形式の場合、AzureとGoogle Document AIはカスタムトレーニングをサポートしています。AWS Textractは、自社のドキュメントでトレーニングしたカスタムアダプターをサポートしています(トレーニングは無料、推論時は1,000ページあたり$25)。ベンダーのベンチマークによると、カスタムトレーニングにより、特定のドキュメント形式での精度が通常5〜15%向上します。
Google Cloud VisionとDocument AIの違いは何ですか?
Cloud Visionは、OCRを機能の1つとして含む汎用画像解析APIです。テキストをバウンディングボックスと構造階層(ページ→ブロック→段落→単語)とともに返します。Document AIは、請求書、領収書、銀行明細書、その他のドキュメントタイプに特化したプロセッサを備えた、ドキュメント特化型プラットフォームです。Document AIは、生のテキストではなく構造化されたフィールド(例:「請求書合計:$1,234.56」)を返します。Cloud Visionは、単純なOCRにはより安価で高速なオプションです。Document AIは、構造化されたドキュメント抽出にはより正確なオプションです。これらがAI抽出とどのように異なるかの詳細については、OCRとAI抽出の比較をご覧ください。
あなたのクラウドスタックが決める
Google Cloud Vision、AWS Textract、Azure Document Intelligenceは、それぞれ特定のインフラストラクチャ環境において正しい答えです。Google Cloudを使用していてテキストが必要な場合は、Vision APIを使用してください。AWSを使用していて構造化された請求書抽出が必要な場合は、TextractのAnalyzeExpenseを使用してください。Microsoft 365を使用していて、複数のドキュメントタイプにわたって正確な事前構築済み抽出が必要な場合は、Document Intelligenceを使用してください。
これをベンチマークの問題(どのAPIが最も高い精度を持つか?)として扱い、勝者を選びたくなるかもしれません。しかし、クリーンなタイプ済みドキュメントにおける3つの精度の差は1〜2%以内です。実際のコスト差はページあたりのセントではなく、統合に費やすエンジニアリング時間です。そしてそのコストは、ほぼ完全に、APIが既存のインフラストラクチャにどれだけ適合するかによって決まります。
特定のクラウドに縛られておらず、統合コードを書かずにドキュメントデータを抽出したいだけなら、そのユースケース向けに設計されたツールから始めることを検討してください。ImageToTable.aiを自分のドキュメントでテストする — SDKのインストールは不要です。