Google Vision vs AWS Textract vs Azure:
Comparação de OCR em Nuvem 2026
Sua stack de nuvem determina qual API de OCR tem o menor custo de integração. Uma equipe já na AWS não paga nada extra pela integração do Textract com IAM e S3. Uma empresa no Google Cloud obtém a mesma vantagem com o pipeline do Cloud Storage na Vision API. E uma casa Microsoft encurta sua avaliação começando pelo Document Intelligence no Azure Foundry. A questão não é qual mecanismo de OCR é tecnicamente melhor — é qual deles sua infraestrutura torna mais barato adotar.
Principais Conclusões
- Três APIs de OCR em nuvem, três fichas técnicas, e todas parecem idênticas — US$ 1,50 por 1.000 páginas para extração de texto com ~95% de precisão em texto impresso.
- O preço que importa não é a taxa básica de OCR — é o nível de extração estruturada, onde o Textract salta de US$ 1,50 para US$ 65 por 1.000 páginas enquanto os modelos predefinidos da Azure permanecem em US$ 10.
- Sua stack de nuvem já decidiu qual API de OCR é a mais barata de adotar antes de você abrir um único documento — uma equipe na AWS paga zero custo de integração com IAM para o Textract, e a mesma vantagem de infraestrutura se aplica no Google Cloud e no Microsoft 365.
Comparação Rápida: Três APIs de OCR na Nuvem Lado a Lado
Antes de mergulhar em cada dimensão, aqui está a visão geral. Esses números são a referência do Leste dos EUA para o primeiro milhão de páginas por mês. Os preços variam por região e faixa de volume, mas as posições relativas permanecem consistentes.
| Dimensão | Google Cloud Vision | AWS Textract | Azure Document Intelligence |
|---|---|---|---|
| OCR básico (por 1K páginas) | $1,50 | $1,50 | $1,50 |
| Extração de tabelas (por 1K páginas) | Indisponível (Vision API) | $15,00 | $10,00 |
| Formulário/chave-valor (por 1K páginas) | Indisponível (Vision API) | $50,00 | $10,00 (pré-construído) |
| Suporte a manuscrito | Sim (DOCUMENT_TEXT_DETECTION) | Inglês apenas | 9 idiomas |
| Precisão em texto impresso | ~95% (DeltOCR Bench) | ~95% (DeltOCR Bench) | ~96% (DeltOCR Bench) |
| Camada gratuita | 1.000 unidades/mês por recurso | 1.000 páginas/mês (3 meses) | 500 páginas/mês (F0) |
| Idiomas (impresso) | 200+ | 6 (EN, ES, DE, FR, IT, PT) | 100+ |
| SDKs disponíveis | Python, Java, Node.js, Go, C#, PHP, Ruby | Python, Java, .NET, Ruby, PHP, Go, C++ | Python, C#, Java, JavaScript, Go |
| Modelos de documentos pré-construídos | Fatura, recibo, extrato bancário, W-2, holerite, conta, identidade (via Document AI) | Fatura/despesa, identidade, empréstimo | Fatura, recibo, RG, W-2, 1098, cartão de saúde, contrato, certidão de casamento |
A conclusão mais importante desta tabela: Google Cloud Vision e AWS Textract não são produtos equivalentes. A Vision API é um serviço geral de análise de imagens que inclui OCR. O Textract é um serviço de extração de documentos especializado. O equivalente do Google ao Textract é o Document AI, mas o preço do Document AI começa mais alto — US$ 10 a US$ 30 por 1.000 páginas para processadores especializados. Para uma comparação justa, este artigo aborda a Vision API (OCR básico) e o Document AI (extração estruturada) quando relevante.
Dimensão 1: Preços — O Detalhamento por Página
Para equipes que avaliam APIs de OCR, a fatura mensal é o primeiro número que importa. Mas o preço do OCR em nuvem é estratificado, e a opção mais barata para 1.000 páginas por mês não é a mais barata para 100.000.
Preços do Google Cloud Vision
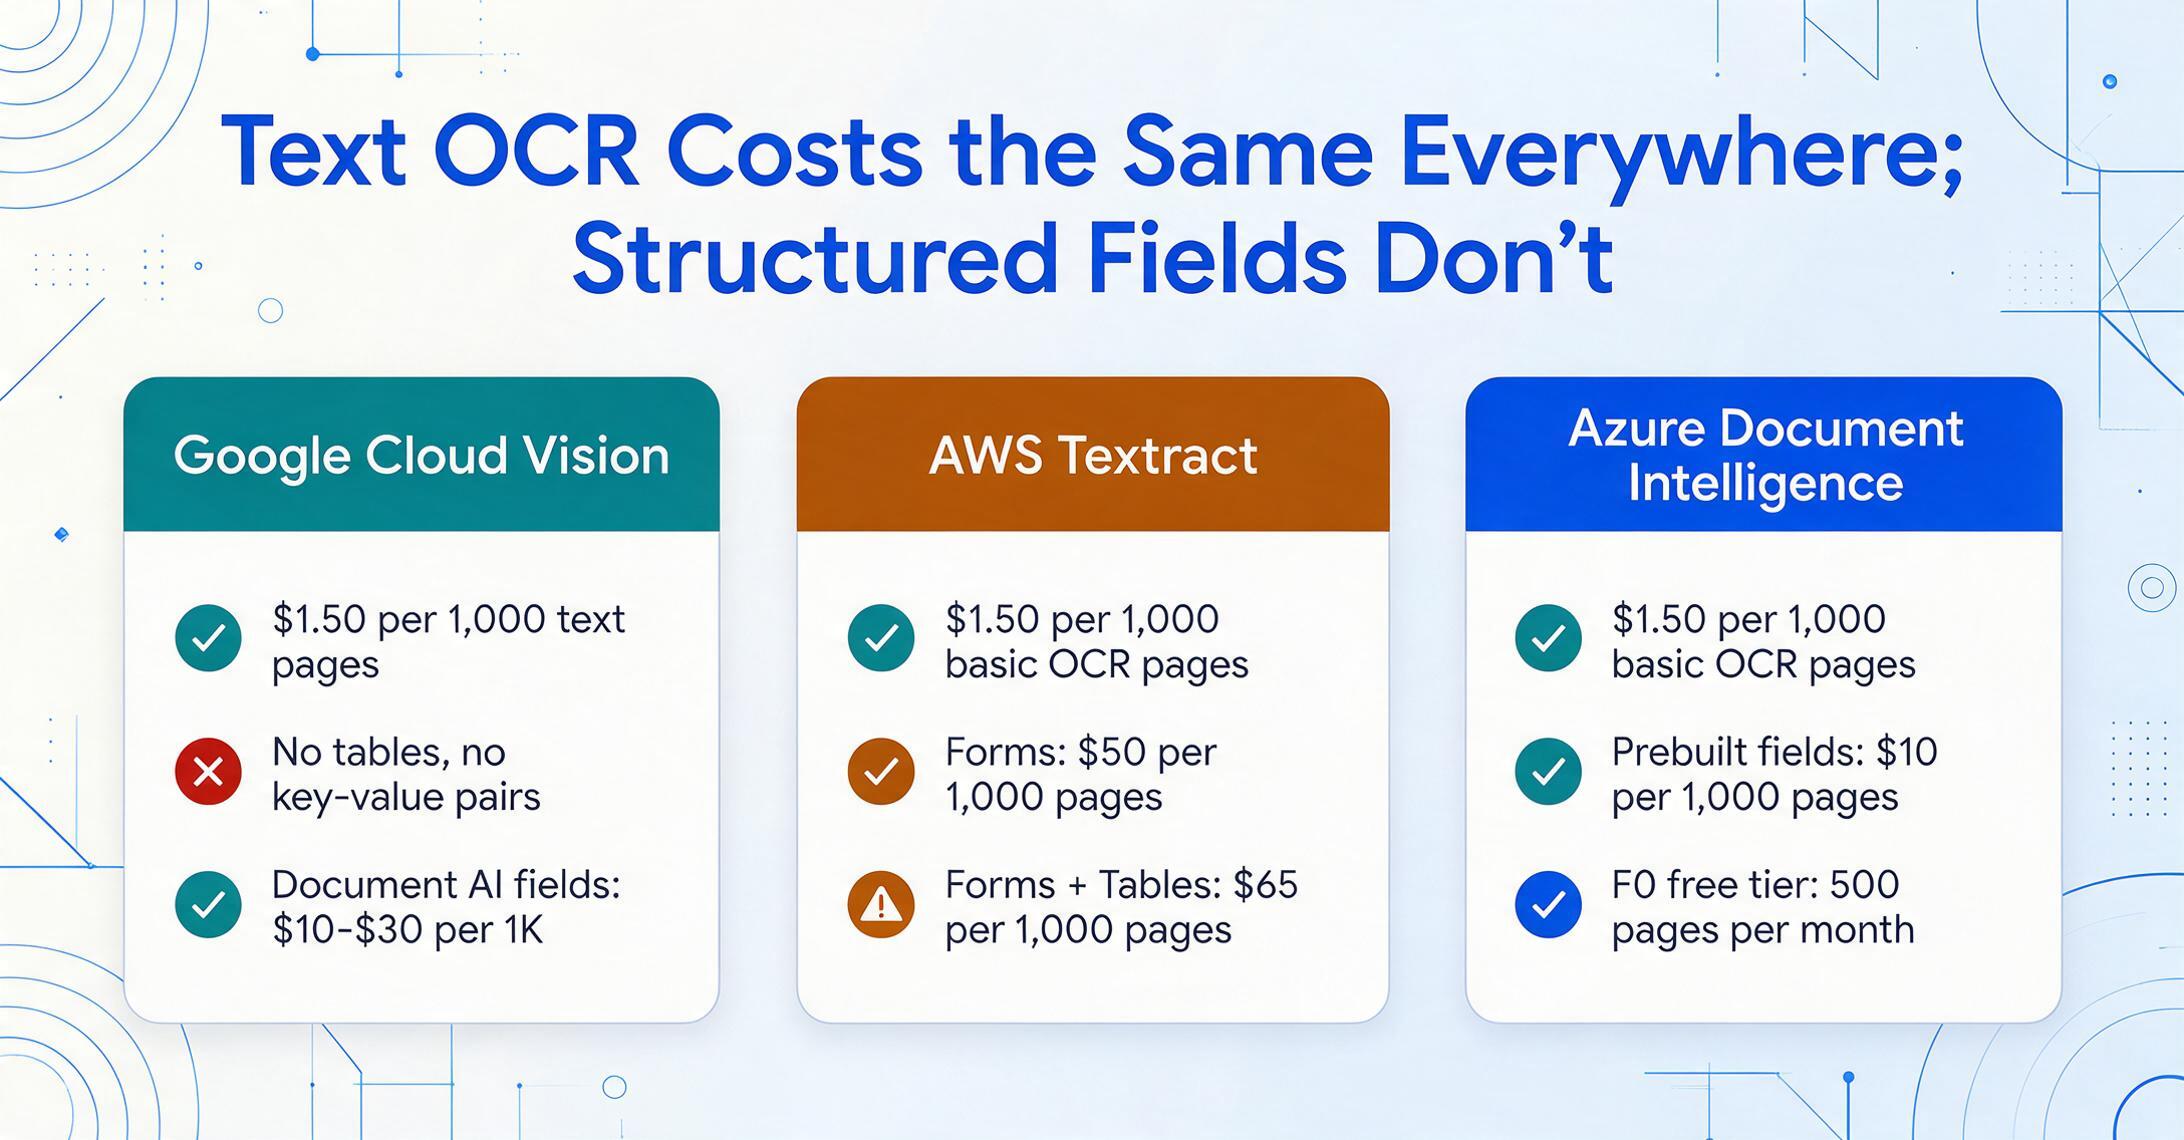
O Cloud Vision usa um modelo de unidade por recurso. TEXT_DETECTION e DOCUMENT_TEXT_DETECTION custam US$ 1,50 por 1.000 unidades após as primeiras 1.000 unidades gratuitas por mês. Acima de 5 milhões de unidades, o preço cai para US$ 0,60 por 1.000. Mas cada solicitação de recurso conta como uma unidade separada — analisar uma imagem para texto e rótulos custa 2 unidades. Para uma carga de trabalho de OCR puro, uma única chamada TEXT_DETECTION é uma unidade. Com 100.000 páginas por mês, você paga US$ 150.
Se você precisa de extração estruturada (faturas, formulários, tabelas), a Vision API sozinha não resolve. Você precisa do Document AI, onde o Enterprise Document OCR Processor custa US$ 1,50 por 1.000 páginas, mas processadores especializados como Invoice Parser ou Form Parser custam US$ 10 a US$ 30 por 1.000 páginas.
Preços do AWS Textract
O Textract cobra por página, mas a taxa depende inteiramente de qual API você chama. DetectDocumentText (OCR básico) custa US$ 1,50 por 1.000 páginas para o primeiro milhão — o mesmo que o valor base do Google. Acima de um milhão de páginas, cai para US$ 0,60 por 1.000. A diferença aparece quando você precisa de dados estruturados: AnalyzeDocument com Forms custa US$ 50 por 1.000 páginas, Tables adiciona US$ 15 por 1.000, e Queries custam US$ 15 por 1.000. Combine os três e você paga US$ 65 por 1.000 páginas.
Descontos por volume se aplicam acima de um milhão de páginas por mês, mas abaixo desse limite, os custos aumentam rapidamente. Um desenvolvedor citou o preço do OCR básico do Textract (US$ 0,0015/página) e montou um orçamento, depois descobriu que os recursos de formulários e tabelas que ele realmente precisava custavam 30 a 40 vezes mais. Essa é a surpresa de preço mais comum do Textract.
Preços do Azure Document Intelligence
O Azure divide suas ofertas em camadas Read, Layout, Prebuilt e Custom. O modelo Read (somente OCR) custa cerca de US$ 1,50 por 1.000 páginas. Os modelos Layout e prebuilt (Invoice, Receipt, ID, W-2, etc.) custam aproximadamente US$ 10 por 1.000 páginas. Os modelos de extração personalizada custam cerca de US$ 50 por 1.000 páginas após treinamento gratuito em até 500 documentos. Recursos adicionais, como campos de consulta e extração de fórmulas, adicionam uma sobretaxa de 20 a 30% sobre o custo do modelo base.
Onde o Azure vence em preço é na camada de modelos prebuilt: US$ 10 por 1.000 páginas para extração de faturas e recibos, contra US$ 50 por 1.000 do Textract para Forms. Essa diferença de 5x importa em escala. Uma equipe que processa 50.000 faturas por mês paga US$ 500 com os modelos prebuilt do Azure, contra US$ 2.500 com a API Forms do Textract.
Veredito sobre Preços
Para cargas de trabalho somente de OCR, os três estão essencialmente empatados em US$ 1,50 por 1.000 páginas. A divergência acontece quando você precisa de extração estruturada. Os modelos prebuilt do Azure são o caminho mais barato para análise de faturas/recibos. O preço combinado do Textract penaliza equipes que precisam de forms + tabelas + consultas simultaneamente. O Document AI do Google fica no meio, mas exige migrar da Vision API para uma camada de produto diferente.
Dimensão 2: Recursos de Documentos — Tabelas, Formulários, Manuscritos e Idiomas
A precisão bruta de OCR em texto impresso limpo é o básico — toda API em nuvem excede 94% em documentos digitados. Os verdadeiros diferenciais são os tipos de documento que eles lidam bem e os que não lidam.
Tabelas e Formulários
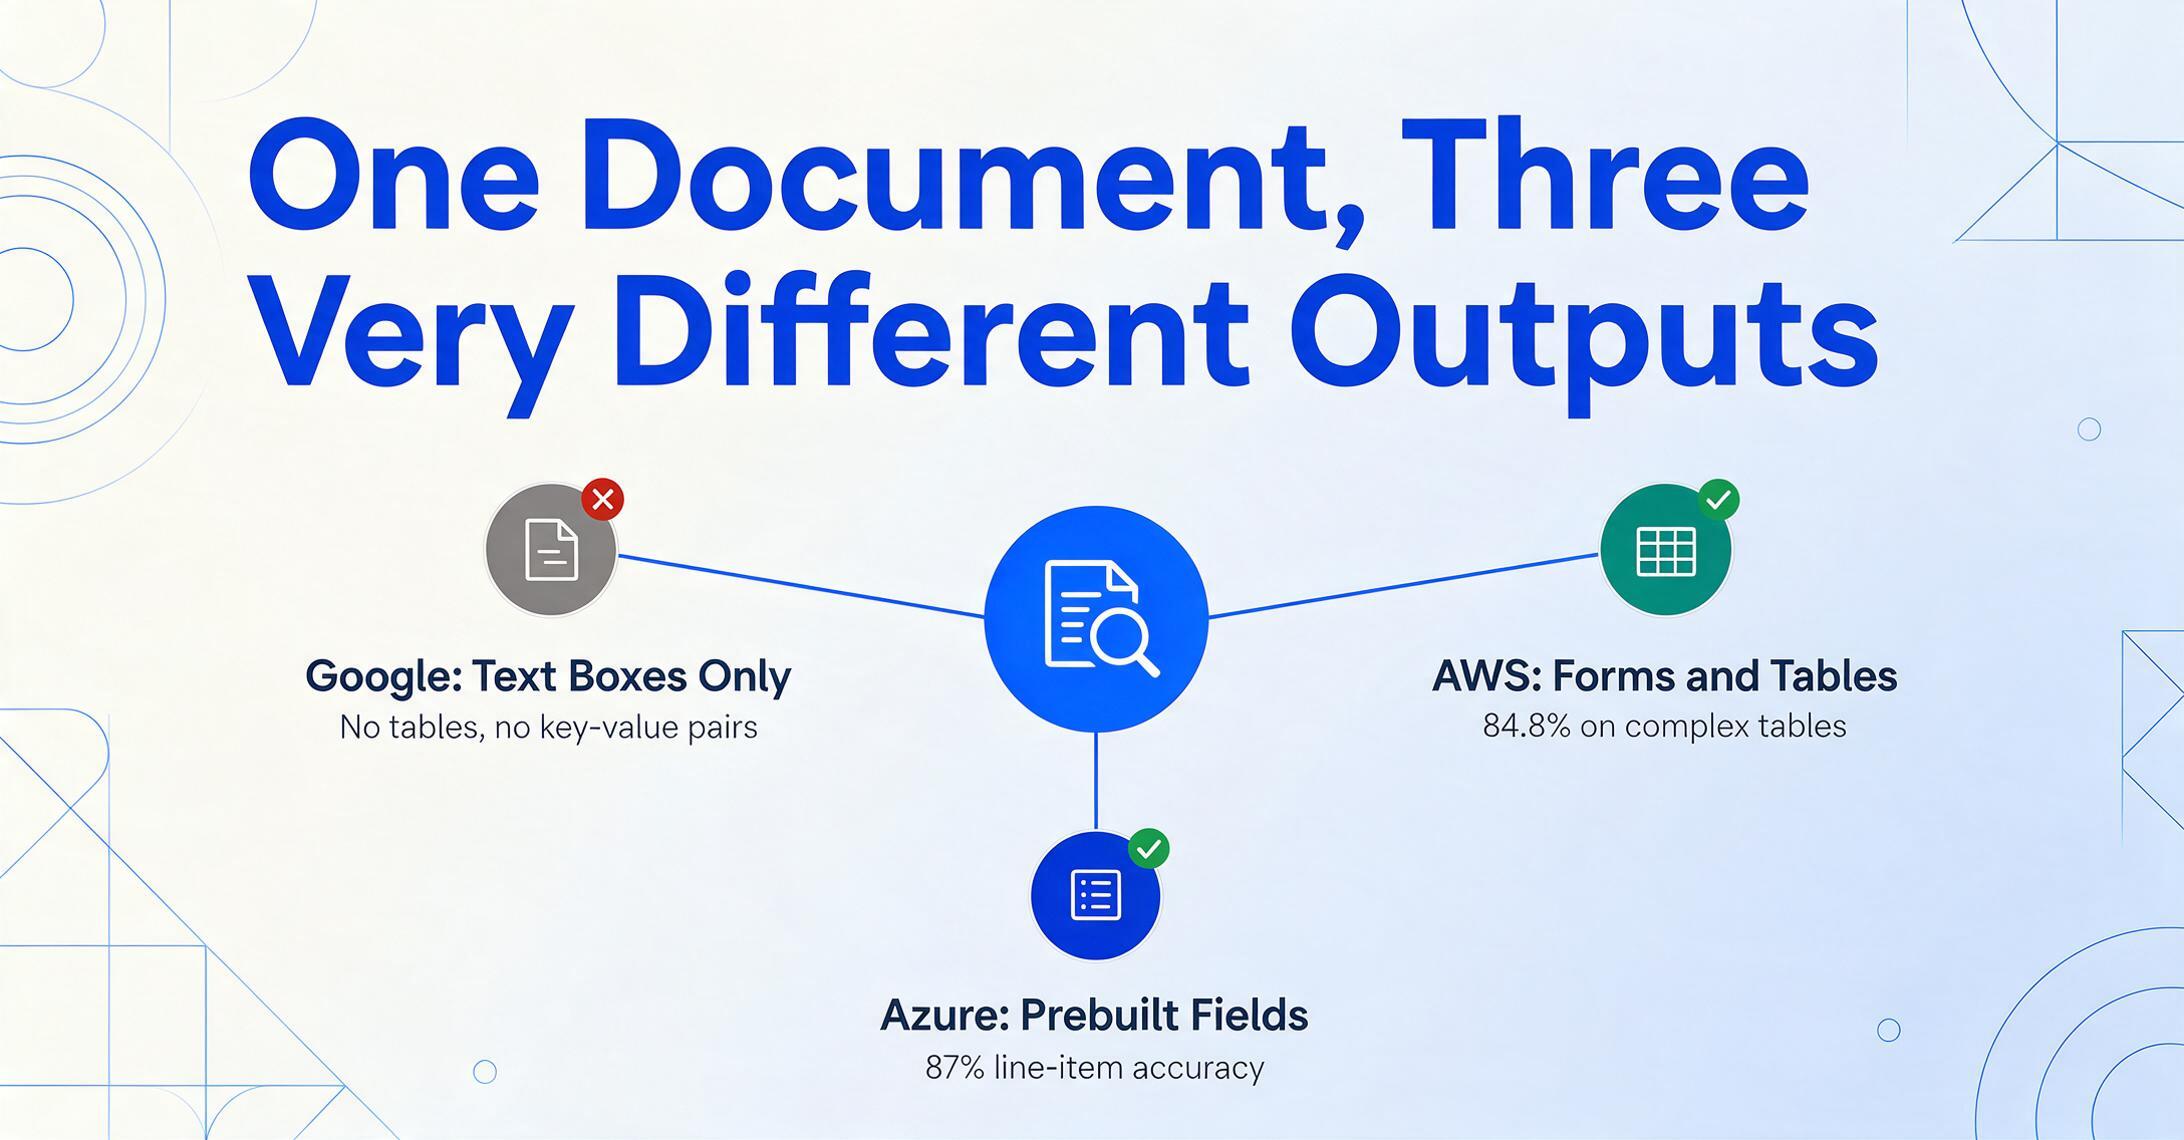
Esta é a dimensão em que as três APIs mais divergem. O Google Cloud Vision (o produto OCR base) não extrai tabelas nem pares chave-valor. Ele retorna caixas delimitadoras ao redor do texto detectado com uma hierarquia estrutural — página, bloco, parágrafo, palavra — mas sem compreensão de células de tabela ou campos de formulário. Se você precisar de extração de tabelas no Google Cloud, é necessário usar o Layout Parser do Document AI (US$ 10 por 1.000 páginas) ou um processador personalizado.
A API AnalyzeDocument do AWS Textract possui recursos dedicados de Formulários e Tabelas. Formulários retorna pares chave-valor (rótulo: valor) com pontuações de confiança. Tabelas retorna dados em nível de célula com índices de linha/coluna e tratamento de células mescladas. Benchmarks independentes mostram que o Textract atinge aproximadamente 84,8% de precisão na extração de tabelas complexas, embora os resultados variem significativamente conforme a qualidade do documento.
O modelo Layout do Azure Document Intelligence lida com tabelas e marcas de seleção nativamente, e seu modelo pré-configurado de Faturas gera campos estruturados, incluindo itens de linha — que é o que a maioria das equipes que criam pipelines de faturas realmente precisa. Dados de benchmark mostram que o Azure atinge 87% de precisão na extração de itens de linha, ficando ligeiramente à frente dos dois concorrentes nessa tarefa específica.
Manuscritos
O Google Cloud Vision suporta manuscritos por meio do recurso DOCUMENT_TEXT_DETECTION, cobrindo texto impresso e manuscrito em uma única chamada. A precisão em manuscritos legíveis é competitiva, mas degrada significativamente em letra cursiva ou digitalizações de baixo contraste.
O AWS Textract adicionou reconhecimento de manuscritos em 2022, mas é limitado a documentos em inglês e a precisão é visivelmente menor do que o desempenho em texto impresso. A própria documentação da AWS recomenda um mínimo de 150 DPI e orientação vertical do texto para melhores resultados. Em documentos com muitos manuscritos, muitas equipes exportam a saída do Textract para um LLM downstream para limpeza — um padrão visto com frequência no Stack Overflow e no AWS re:Post.
O Azure Document Intelligence suporta manuscritos em nove idiomas, incluindo inglês, francês, alemão, italiano, japonês, coreano, português, espanhol e chinês simplificado. Dados de benchmark colocam a precisão do Azure em documentos mistos (impresso/manuscrito) acima da do Textract, embora o reconhecimento puro de manuscritos ainda fique atrás de soluções VLM especializadas.
Suporte a Idiomas
O Google Cloud Vision lidera aqui com suporte a mais de 200 idiomas para texto impresso e mais de 50 para manuscrito. O Azure Document Intelligence oferece suporte a mais de 100 idiomas para texto impresso e 9 para manuscrito. O AWS Textract fica bem atrás, com apenas seis idiomas para texto impresso (inglês, espanhol, alemão, italiano, francês e português) e somente inglês para manuscrito. Se o seu pipeline de documentos processa faturas de fornecedores japoneses ou contratos em árabe, o Textract é efetivamente inutilizável sem uma camada de tradução separada.
Dimensão 3: Integração — Qualidade do SDK, Ecossistema e Documentação
Esta é a dimensão que a maioria dos artigos de comparação ignora, mas é ela que determina se sua equipe entrega em duas semanas ou em dois meses.
Integração com Google Cloud
O SDK Python do Google é bem projetado — a biblioteca google-cloud-vision é consistente com outras bibliotecas de cliente do Google Cloud, e a referência da API é completa. A Vision API suporta upload direto de imagem, codificação base64 e URIs do Cloud Storage, sendo o Cloud Storage a opção mais rápida em cerca de 25% em relação ao base64. A infraestrutura de rede do Google Cloud — que roda na mesma fibra privada que alimenta a Pesquisa e o YouTube — oferece latência entre regiões 15-25% menor do que os níveis de rede padrão da AWS ou Azure.
O ponto negativo: a nomenclatura de produtos do Google causa confusão. Um desenvolvedor que pesquisa "Google Cloud OCR" encontra o Cloud Vision, o Document AI e o OCR On-Prem descontinuado (encerrado em setembro de 2025). Escolher o produto errado significa reconstruir a camada de extração depois. A Vision API fornece texto com coordenadas. O Document AI fornece campos estruturados. A diferença entre eles é um projeto completo de engenharia.
Integração com AWS
A maior vantagem de integração do Textract é o acesso nativo por meio do SDK da AWS em todas as principais linguagens. Se o seu pipeline já usa S3 para armazenamento de documentos, Lambda para processamento serverless e Step Functions para orquestração, o Textract se integra sem configuração entre nuvens. O SDK boto3 é maduro, bem documentado e consistente com o padrão geral da API da AWS.
No entanto, reclamações comuns no Stack Overflow incluem: tratamento de paginação que exige rastreamento manual do NextToken, um limite flexível de 100 trabalhos simultâneos que exige solicitações de aumento de cota para pipelines de alto volume, e a necessidade de criar pós-processamento personalizado para reconstruir a estrutura de tabelas a partir do JSON de resposta baseado em blocos do Textract. Um tópico do Stack Overflow observa que o Textract "remove do documento qualquer estrutura, como informações tabulares" no modo OCR bruto, exigindo que os desenvolvedores infiram a estrutura por conta própria.
Integração com Azure
O Azure Document Intelligence se beneficia do ecossistema mais amplo da Microsoft. Os SDKs estão disponíveis para Python, C#, Java e JavaScript com suporte total a async. Para equipes com pouco código, os conectores do Power Automate permitem fluxos de trabalho de processamento de documentos sem qualquer código personalizado — uma vantagem significativa para organizações que já usam Microsoft 365 e Power Platform.
O Document Intelligence Studio fornece métricas de precisão imediatas e pontuações de confiança em nível de campo durante os testes, o que reduz o ciclo de feedback durante a avaliação piloto. Um usuário do r/AZURE processando cerca de 2,6 milhões de páginas de ingestão em lote observou que o serviço escalou sem problemas em cerca de 12 horas, com descontos por volume pré-pagos reduzindo os custos do primeiro mês. A documentação do Azure é abrangente, mas está distribuída entre as páginas do Foundry Tools, AI Services e os legados Cognitive Services — uma reorganização que frustra os desenvolvedores durante a configuração inicial.
Dimensão 4: Precisão — O Que os Benchmarks Realmente Dizem
Os fornecedores de OCR em nuvem publicam alegações de precisão, mas benchmarks independentes contam uma história mais detalhada. O DeltOCR Bench (novembro de 2025) avaliou os principais serviços de OCR em tipos mistos de documentos e encontrou as seguintes pontuações de precisão para texto impresso:
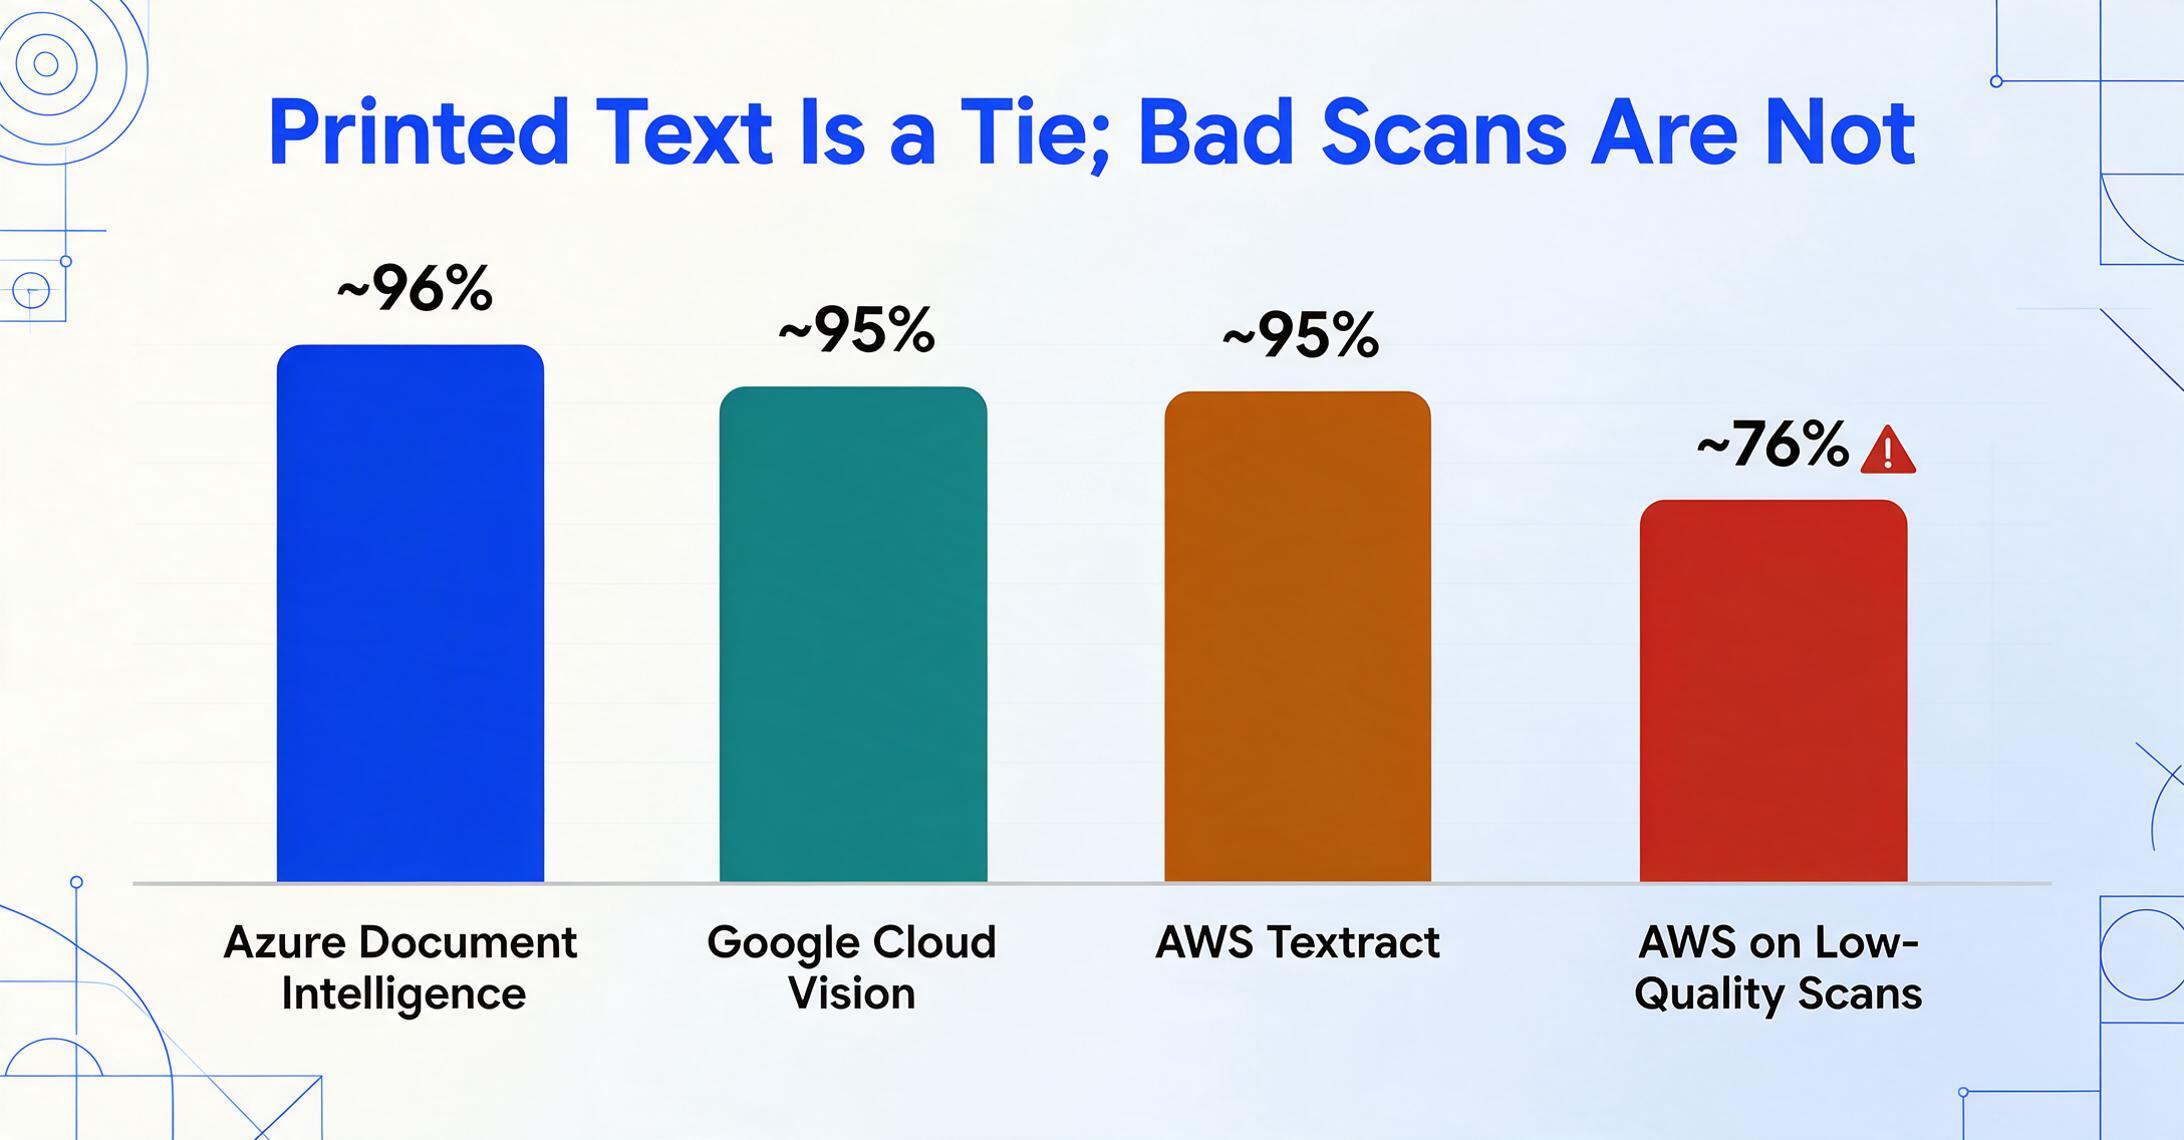
- Azure Document Intelligence: ~96% — maior precisão de texto impresso entre os três, particularmente forte em formulários padrão e documentos limpos
- Google Cloud Vision: ~95% — praticamente empatado com o Textract em texto impresso, com desempenho ligeiramente melhor em páginas de documentos densas
- AWS Textract: ~95% — competitivo em texto digitado, mas cai para ~76% em digitalizações de baixa qualidade (de acordo com testes independentes)
O benchmark de extração de faturas BusinessWareTech 2025 testou a precisão em nível de campo em cinco ferramentas e encontrou uma variação maior em documentos financeiros:
- Azure Document Intelligence: 93% de precisão de campo em faturas
- Google Document AI: 82% de precisão de campo
- AWS Textract: 78% de precisão de campo
O que extrair desses números: Em documentos limpos e digitados, os três são excelentes e as diferenças de precisão são marginais para a maioria dos casos de uso. Em faturas, layouts complexos e digitalizações de baixa qualidade, a lacuna aumenta — e o Azure supera consistentemente nesses cenários mais difíceis. Em manuscritos, todos os três ficam atrás de soluções VLM criadas para esse fim, embora o Azure ofereça a cobertura de idiomas mais ampla entre os três.
Um usuário do Stack Overflow testando o Google Vision e o Tesseract relatou que "o Google Vision atingiu 66,6% de precisão", enquanto o Tesseract alcançou 82% em seu conjunto de dados específico — um lembrete de que a precisão depende do documento e que os benchmarks são direcionais, não absolutos. Sempre teste com seus próprios documentos.
Insight principal
A diferença de precisão entre as APIs de OCR em nuvem é menor do que a diferença entre qualquer API de OCR em nuvem e uma abordagem baseada em modelo de visão-linguagem. Para documentos complexos, LLMs multimodais (GPT-4o, Gemini, Claude) agora alcançam 95-98% de precisão de campos — um salto significativo em relação à faixa de 78-93% dos serviços tradicionais de OCR em nuvem. O trade-off é custo e latência, mas a direção é clara.
Quando o Google Vision Faz Mais Sentido
O Google Cloud Vision é a escolha certa quando você já executa workloads no Google Cloud e sua necessidade é OCR de propósito geral, em vez de extração estruturada de documentos. As primeiras 1.000 unidades por mês por recurso são gratuitas, tornando-o sem custo para avaliação de baixo volume. O suporte a mais de 200 idiomas é incomparável — se seus documentos abrangem japonês, árabe, hindi e idiomas europeus, a Vision API os processa em uma única chamada.
Para equipes que precisam apenas de texto (não tabelas, não formulários), o preço de US$ 1,50 por 1.000 páginas da Vision API é competitivo, e sua taxa de transferência é excelente — um benchmark de 2026 a descreveu como o "rei da velocidade" para processamento bruto de OCR. Se seu pipeline é "extrair todo o texto de 10.000 imagens e armazená-lo", a Vision API é o caminho mais rápido e barato no Google Cloud.
Mas seja preciso sobre o que você está avaliando. O Cloud Vision não é um substituto direto para o Textract ou o Document Intelligence. Se você precisa de extração estruturada — faturas com itens de linha, formulários com pares chave-valor — a comparação muda para o Google Document AI, que tem seu próprio preço e curva de aprendizado.
Quando o AWS Textract Faz Mais Sentido
O AWS Textract é a escolha natural quando todo o seu pipeline de documentos já vive na AWS. Se você armazena documentos no S3, processa com Lambda, orquestra com Step Functions e revisa resultados pelo Amazon A2I, o Textract se integra sem nenhuma configuração entre nuvens — sem VPC peering, sem chaves de API separadas, sem padrões IAM diferentes.
A API AnalyzeExpense do Textract é projetada especificamente para extração de faturas e recibos e retorna objetos ExpenseDocument tipados com campos de resumo e grupos de itens de linha — sem necessidade de construir uma camada de extração sobre a saída bruta do OCR. Para equipes que processam tipos padronizados de documentos (mesmos fornecedores, layouts consistentes) em alto volume (mais de 50.000 páginas por mês), o preço previsível por página e os descontos por volume do Textract tornam o custo previsível.
O recurso Queries — em que você faz perguntas em linguagem natural como "qual é o total da fatura?" — é genuinamente útil para extrair campos específicos sem construir um schema. No entanto, o limite de 30 consultas por página e o custo de US$ 15 por 1.000 páginas do recurso Queries se acumulam. E o teto de seis idiomas é uma restrição difícil para pipelines de documentos multilíngues.
Quando o Azure Document Intelligence Faz Mais Sentido
O Azure Document Intelligence se destaca em três frentes: amplitude dos modelos pré-treinados, precisão em texto impresso e integração com o ecossistema Microsoft.
Se sua organização usa Microsoft 365, armazena documentos no SharePoint ou tem licenças do Power Automate, o Document Intelligence é a opção que exige menos esforço de integração. A biblioteca de modelos pré-treinados cobre notas fiscais, recibos, documentos de identidade, formulários W-2, formulários fiscais 1098, cartões de plano de saúde, contratos e certidões de casamento — mais processadores especializados do que o Google ou a AWS oferecem prontamente. Para equipes que processam tipos variados de documentos, isso reduz a necessidade de treinar modelos personalizados.
Os dados de benchmarks independentes colocam consistentemente o Azure no topo — ou perto dele — em precisão de texto impresso. Na extração de notas fiscais especificamente, a precisão de 93% do Azure supera o Google (82%) e a AWS (78%) por uma margem significativa. Se a precisão em documentos complexos ou de formato variável é sua principal preocupação, o Azure é a opção mais forte entre os OCRs tradicionais em nuvem.
O suporte a texto manuscrito em nove idiomas dá ao Azure uma vantagem sobre o reconhecimento de manuscrito apenas em inglês do Textract. Para documentos mistos, impressos e manuscritos, como formulários médicos de admissão ou relatórios de inspeção de campo, o Azure processa ambos em uma única passada.
Alternativa Sem Código: Quando Você Não Quer Criar um Pipeline de OCR
Existe um cenário que nenhum dos fornecedores de OCR em nuvem aborda diretamente: você precisa de extração de documentos, mas sua equipe não é de engenharia nativa de nuvem. Criar um pipeline com Vision API, Textract ou Document Intelligence exige — no mínimo — escrever código para enviar documentos, analisar respostas JSON, mapear campos para o esquema de saída e tratar erros. Isso é um projeto de engenharia de várias semanas, mesmo para equipes experientes.
ImageToTable.ai preenche essa lacuna. Ele se enquadra em uma categoria diferente das três APIs de OCR em nuvem — extração de dados com IA, em vez de OCR. Construído com modelos de linguagem de visão em vez de OCR tradicional, ele entende documentos semanticamente, e não por reconhecimento de caracteres. Você envia um documento, digita os nomes das colunas desejadas (por exemplo, "Número da Nota Fiscal", "Data de Vencimento", "Total") e a IA localiza cada valor pelo significado — independentemente de onde ele aparece na página ou com qual layout do fornecedor você está lidando.
Enquanto as APIs de OCR em nuvem fornecem coordenadas e pontuações de confiança que você precisa montar para obter respostas, o ImageToTable.ai entrega uma planilha. Ele oferece suporte a processamento em lote — envie 50 notas fiscais e receba um único arquivo Excel — colunas calculadas que calculam resultados durante a extração (como "Total da Linha = Qtd × Preço Unitário") e um complemento do Google Sheets que grava os dados extraídos diretamente na sua planilha, sem qualquer integração de API.
Se você é uma equipe de engenharia avaliando APIs de OCR em nuvem, o ImageToTable.ai não é um substituto — é uma ferramenta diferente para um usuário diferente. Mas se sua organização tem documentos para extrair e nenhuma equipe de integração dedicada, vale a pena testar antes de se comprometer com um pipeline de OCR em nuvem que levaria semanas para ser construído. Veja como ele difere da OCR tradicional versus extração por IA. E se você quiser comparar essas três APIs de nuvem com o mercado completo de OCR — ferramentas de desktop, conversores gratuitos e aplicativos de extração por IA juntos — nosso mapa do mercado de software OCR cobre essa comparação mais ampla.
FAQ
Qual API de OCR em nuvem é mais barata a 10.000 páginas por mês?
Para OCR básico (somente texto), as três custam praticamente o mesmo — cerca de US$ 15 por mês a 10.000 páginas. Para extração estruturada (faturas com itens de linha), os modelos pré-construídos do Azure a US$ 10 por 1.000 páginas são os mais baratos, seguidos pelo Google Document AI a US$ 10-US$ 30 por 1.000 páginas, sendo a combinação Forms + Tables do AWS Textract a US$ 65 por 1.000 páginas a mais cara.
Qual API lida melhor com escrita manual?
Nenhuma das três APIs de OCR em nuvem é a melhor da categoria para escrita manual — soluções VLM específicas como GPT-5 (~95%) e Mistral OCR 3 (~89%) superam todas elas em escrita manual isolada. Entre as três, o Azure Document Intelligence oferece o suporte mais amplo de idiomas para escrita manual (9 idiomas). O Google Vision lida adequadamente com escrita manual em inglês. O AWS Textract só suporta escrita manual em inglês, com precisão visivelmente menor do que em texto impresso.
Posso usar essas APIs sem uma conta na nuvem?
Não. Todas as três exigem uma conta de cobrança ativa na nuvem. O Google oferece US$ 300 em créditos gratuitos para novos clientes. A AWS oferece um nível gratuito de 3 meses (1.000 páginas por mês para Textract). O Azure oferece um nível gratuito F0 a 500 páginas por mês. Nenhuma delas funciona offline ou sem um método de pagamento registrado.
Qual API oferece suporte ao maior número de idiomas?
O Google Cloud Vision lidera com mais de 200 idiomas para texto impresso e mais de 50 para manuscrito. O Azure Document Intelligence oferece suporte a mais de 100 idiomas para texto impresso e 9 para manuscrito. O AWS Textract oferece suporte a apenas 6 idiomas para texto impresso e somente inglês para manuscrito — uma limitação significativa para o processamento de documentos multilíngues.
Preciso treinar modelos personalizados?
Para tipos de documentos padrão (faturas, recibos, W-2s, documentos de identidade), os três oferecem modelos pré-treinados que funcionam imediatamente. Para formatos de documentos personalizados ou incomuns, o Azure e o Google Document AI oferecem suporte a treinamento personalizado. O AWS Textract oferece suporte a adaptadores personalizados treinados com seus próprios documentos (treinamento gratuito, US$ 25 por 1.000 páginas na inferência). O treinamento personalizado normalmente melhora a precisão no seu formato de documento específico em 5-15%, de acordo com benchmarks dos fornecedores.
Qual é a diferença entre o Google Cloud Vision e o Document AI?
O Cloud Vision é uma API de análise de imagens de uso geral que inclui OCR como um de seus recursos. Ele retorna texto com caixas delimitadoras e uma hierarquia estrutural (página → bloco → parágrafo → palavra). O Document AI é uma plataforma específica para documentos, com processadores especializados para faturas, recibos, extratos bancários e outros tipos de documentos. O Document AI retorna campos estruturados (por exemplo, "Total da fatura: US$ 1.234,56") em vez de texto bruto. O Cloud Vision é a opção mais barata e rápida para OCR simples. O Document AI é a opção mais precisa para extração de documentos estruturados. Para uma explicação detalhada de como eles diferem da extração por IA, consulte OCR vs Extração por IA.
Sua Infraestrutura em Nuvem Decide
O Google Cloud Vision, o AWS Textract e o Azure Document Intelligence são cada um a resposta certa para um contexto específico de infraestrutura. Se você está no Google Cloud e precisa de texto, use a Vision API. Se você está na AWS e precisa de extração estruturada de faturas, use o AnalyzeExpense do Textract. Se você está no Microsoft 365 e precisa de extração precisa com modelos pré-treinados em vários tipos de documentos, use o Document Intelligence.
A tentação é tratar isso como uma questão de benchmark — qual API tem a maior precisão? — e escolher a vencedora. Mas as diferenças de precisão entre as três em documentos limpos e digitados estão dentro de 1-2%. A diferença real de custo não está em centavos por página; está nas horas de engenharia gastas na integração. E esse custo é determinado quase inteiramente por quão bem a API se encaixa na sua infraestrutura existente.
Se você não está vinculado a uma nuvem específica e simplesmente deseja extrair dados de documentos sem escrever código de integração, considere começar com uma ferramenta projetada para esse caso de uso. Teste o ImageToTable.ai com seus próprios documentos — sem necessidade de instalação de SDK.