Google Vision vs AWS Textract vs Azure:
Comparación de OCR en la nube 2026
Su stack en la nube determina qué API de OCR tiene el menor costo de integración. Un equipo que ya usa AWS no paga nada extra por la integración de Textract con IAM y S3. Una tienda de Google Cloud obtiene la misma ventaja con el pipeline de Cloud Storage de Vision API. Y una casa de Microsoft acorta su evaluación comenzando con Document Intelligence en Azure Foundry. La pregunta no es qué motor de OCR es técnicamente mejor — es cuál su infraestructura hace más económico de adoptar.
Conclusiones Clave
- Tres APIs de OCR en la nube, tres fichas técnicas, y todas parecen idénticas — $1.50 por 1,000 páginas de extracción de texto con ~95% de precisión en texto impreso.
- El precio que importa no es el de OCR básico — es el nivel de extracción estructurada, donde Textract salta de $1.50 a $65 por 1,000 páginas mientras que los modelos predefinidos de Azure se mantienen en $10.
- Su stack en la nube ya decidió cuál API de OCR es más económica de adoptar antes de abrir un solo documento — un equipo en AWS paga cero sobrecosto de integración con IAM para Textract, y la misma ventaja de infraestructura aplica en Google Cloud y Microsoft 365.
Comparativa rápida: Tres APIs de OCR en la nube, una al lado de la otra
Antes de profundizar en cada dimensión, aquí tienes una vista general. Estos números corresponden a la zona EE. UU. Este para el primer millón de páginas al mes. Los precios varían según la región y el volumen, pero las posiciones relativas se mantienen constantes.
| Dimensión | Google Cloud Vision | AWS Textract | Azure Document Intelligence |
|---|---|---|---|
| OCR básico (por cada 1K páginas) | $1.50 | $1.50 | $1.50 |
| Extracción de tablas (por cada 1K páginas) | No disponible (Vision API) | $15.00 | $10.00 |
| Formularios/clave-valor (por cada 1K páginas) | No disponible (Vision API) | $50.00 | $10.00 (predefinido) |
| Soporte para escritura a mano | Sí (DOCUMENT_TEXT_DETECTION) | Solo inglés | 9 idiomas |
| Precisión en texto impreso | ~95 % (DeltOCR Bench) | ~95 % (DeltOCR Bench) | ~96 % (DeltOCR Bench) |
| Nivel gratuito | 1000 unidades/mes por función | 1000 páginas/mes (3 meses) | 500 páginas/mes (F0) |
| Idiomas (texto impreso) | 200+ | 6 (EN, ES, DE, FR, IT, PT) | 100+ |
| Lenguajes SDK | Python, Java, Node.js, Go, C#, PHP, Ruby | Python, Java, .NET, Ruby, PHP, Go, C++ | Python, C#, Java, JavaScript, Go |
| Modelos de documentos predefinidos | Factura, recibo, extracto bancario, W-2, recibo de nómina, servicio público, identidad (a través de Document AI) | Factura/gasto, identidad, préstamo | Factura, recibo, identificación, W-2, 1098, tarjeta de salud, contrato, acta de matrimonio |
La conclusión más importante de esta tabla: Google Cloud Vision y AWS Textract no son productos equivalentes. Vision API es un servicio general de análisis de imágenes que incluye OCR. Textract es un servicio de extracción de documentos creado específicamente para ello. El equivalente de Google a Textract es Document AI, pero su precio inicial es más alto: de $10 a $30 por cada 1000 páginas para procesadores especializados. Para una comparación justa, este artículo cubre Vision API (OCR básico) y Document AI (extracción estructurada) cuando sea relevante.
Dimensión 1: Precios — El desglose por página
Para los equipos que evalúan API de OCR, la factura mensual es el primer número que importa. Pero los precios del OCR en la nube están escalonados, y la opción más barata a 1,000 páginas al mes no es la más barata a 100,000.
Precios de Google Cloud Vision
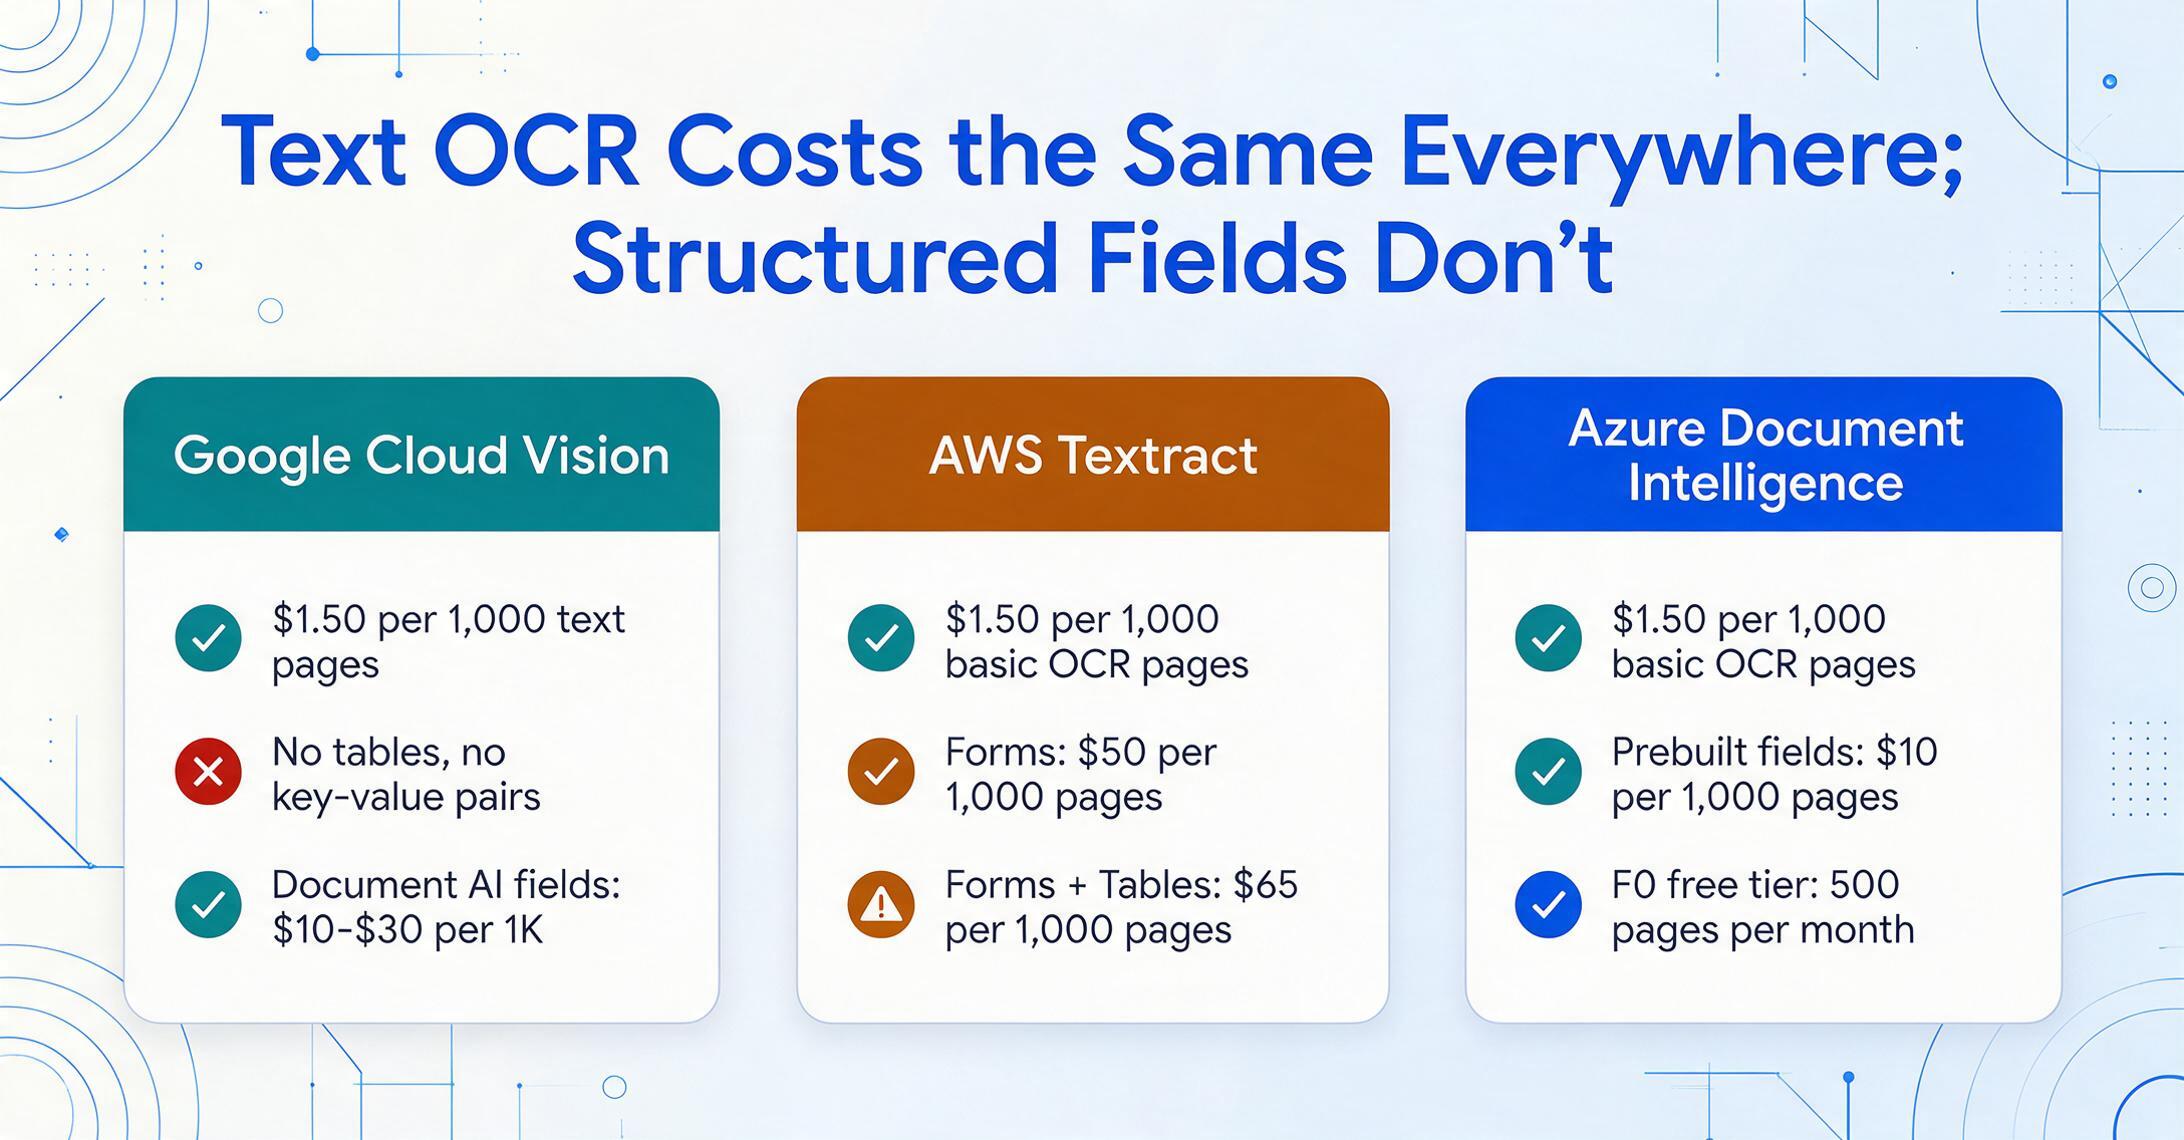
Cloud Vision utiliza un modelo de unidades por función. TEXT_DETECTION y DOCUMENT_TEXT_DETECTION cuestan cada una $1.50 por cada 1,000 unidades después de las primeras 1,000 unidades gratuitas al mes. Por encima de 5 millones de unidades, el precio baja a $0.60 por cada 1,000. Pero cada solicitud de función cuenta como una unidad separada: analizar una imagen para texto y etiquetas cuesta 2 unidades. Para una carga de trabajo de solo OCR, una sola llamada a TEXT_DETECTION es una unidad. A 100,000 páginas al mes, pagas $150.
Si necesitas extracción estructurada (facturas, formularios, tablas), la API de Vision por sí sola no te llevará allí. Necesitas Document AI, donde el Procesador de OCR de Documentos Empresariales cuesta $1.50 por cada 1,000 páginas, pero los procesadores especializados como el Analizador de Facturas o el Analizador de Formularios cuestan $10-$30 por cada 1,000 páginas.
Precios de AWS Textract
Textract factura por página, pero la tarifa depende completamente de a qué API llames. DetectDocumentText (OCR básico) cuesta $1.50 por cada 1,000 páginas para el primer millón, lo mismo que la tarifa base de Google. Más allá de un millón de páginas, baja a $0.60 por cada 1,000. La diferencia aparece cuando necesitas datos estructurados: AnalyzeDocument con Formularios cuesta $50 por cada 1,000 páginas, Tablas añade $15 por cada 1,000, y Consultas cuestan $15 por cada 1,000. Combina los tres y pagas $65 por cada 1,000 páginas.
Los descuentos por volumen se aplican por encima de un millón de páginas al mes, pero por debajo de ese umbral, los costos se acumulan rápidamente. Un desarrollador citó el precio del OCR básico de Textract ($0.0015/página) y elaboró un presupuesto, y luego descubrió que las funciones de formularios y tablas que realmente necesitaba costaban 30-40 veces más. Esta es la sorpresa de precios más común de Textract.
Precios de Azure Document Intelligence
Azure divide sus ofertas en niveles Read, Layout, Prebuilt y Custom. El modelo Read (solo OCR) cuesta alrededor de $1.50 por 1,000 páginas. Los modelos Layout y Prebuilt (Invoice, Receipt, ID, W-2, etc.) cuestan aproximadamente $10 por 1,000 páginas. Los modelos de extracción personalizada cuestan alrededor de $50 por 1,000 páginas después del entrenamiento gratuito en hasta 500 documentos. Las capacidades adicionales como campos de consulta y extracción de fórmulas añaden un recargo del 20-30% sobre el costo base del modelo.
Donde Azure gana en precios es en el nivel de modelos Prebuilt: $10 por 1,000 páginas para extracción de facturas y recibos frente a los $50 por 1,000 de Textract para Forms. Esa diferencia de 5x importa a escala. Un equipo que procesa 50,000 facturas al mes paga $500 con los modelos Prebuilt de Azure frente a $2,500 con la API Forms de Textract.
Veredicto de Precios
Para cargas de trabajo de solo OCR, los tres están prácticamente empatados en $1.50 por 1,000 páginas. La divergencia ocurre cuando se necesita extracción estructurada. Los modelos Prebuilt de Azure son la vía más económica para el procesamiento de facturas y recibos. El precio combinado de Textract penaliza a los equipos que necesitan forms + tables + queries simultáneamente. Google Document AI se sitúa en el medio, pero requiere migrar de Vision API a un nivel de producto diferente.
Dimensión 2: Funciones de Documentos — Tablas, Formularios, Escritura Manual e Idiomas
La precisión básica de OCR en texto impreso limpio es un requisito mínimo — cada API en la nube supera el 94% en documentos mecanografiados. Los verdaderos diferenciadores son los tipos de documentos que manejan bien y los que no.
Tablas y Formularios
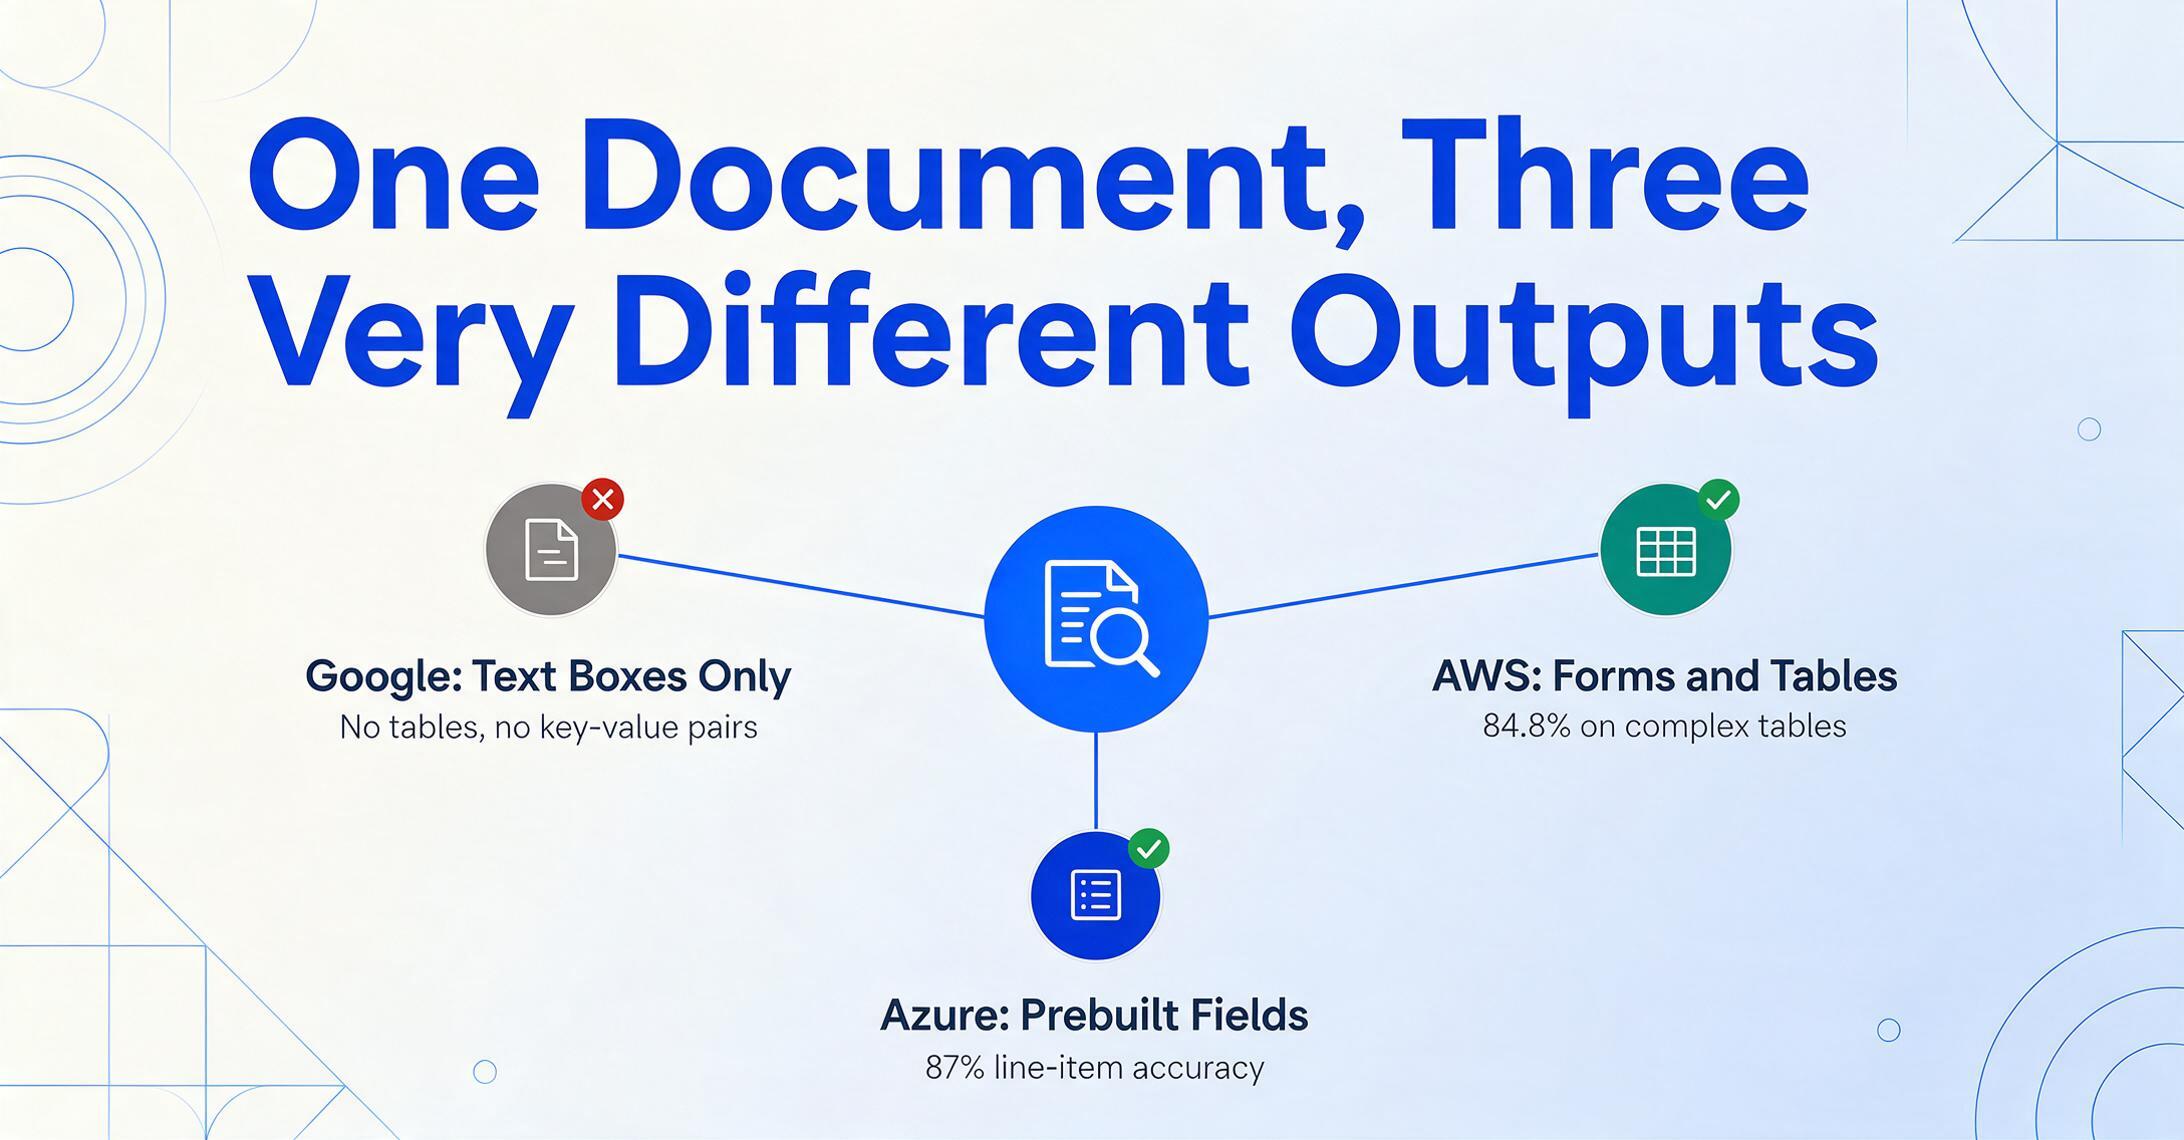
Esta es la dimensión donde las tres API divergen más notablemente. Google Cloud Vision (el producto OCR base) no extrae tablas ni pares clave-valor. Devuelve cuadros delimitadores alrededor del texto detectado con una jerarquía estructural (página, bloque, párrafo, palabra), pero sin comprensión de celdas de tabla ni campos de formulario. Si necesita extracción de tablas en Google Cloud, debe usar el Analizador de Diseño de Document AI ($10 por 1,000 páginas) o un procesador personalizado.
La API AnalyzeDocument de AWS Textract tiene funciones dedicadas de Formularios y Tablas. Formularios devuelve pares clave-valor (etiqueta: valor) con puntuaciones de confianza. Tablas devuelve datos a nivel de celda con índices de fila/columna y manejo de celdas combinadas. Los análisis comparativos independientes muestran que Textract logra aproximadamente un 84.8% de precisión en la extracción de tablas complejas, aunque los resultados varían significativamente según la calidad del documento.
El modelo de Diseño de Azure Document Intelligence maneja tablas y marcas de selección de forma nativa, y su modelo de Factura predefinido genera campos estructurados, incluidos los artículos de línea, que es lo que la mayoría de los equipos que crean canalizaciones de facturas realmente necesitan. Los datos de referencia muestran que Azure logra un 87% de precisión en la extracción de artículos de línea, ligeramente por delante de ambos competidores en esta tarea específica.
Escritura a Mano
Google Cloud Vision admite escritura a mano mediante su función DOCUMENT_TEXT_DETECTION, que cubre texto impreso y manuscrito en una sola llamada. La precisión en escritura a mano limpia es competitiva, pero se degrada significativamente en escritura cursiva o escaneos de bajo contraste.
AWS Textract añadió el reconocimiento de escritura a mano en 2022, pero está limitado a documentos en inglés y la precisión es notablemente menor que el rendimiento en texto impreso. La propia documentación de AWS recomienda un mínimo de 150 DPI y una orientación vertical del texto para obtener los mejores resultados. En documentos con mucho contenido manuscrito, muchos equipos exportan la salida de Textract a un LLM posterior para su limpieza, un patrón que se ve con frecuencia en Stack Overflow y AWS re:Post.
Azure Document Intelligence admite escritura a mano en nueve idiomas, incluidos inglés, francés, alemán, italiano, japonés, coreano, portugués, español y chino simplificado. Los datos de referencia sitúan la precisión de Azure en documentos mixtos impresos/manuscritos por encima de la de Textract, aunque el reconocimiento de escritura a mano pura todavía va por detrás de las soluciones VLM especializadas.
Compatibilidad de idiomas
Google Cloud Vision lidera aquí con soporte para más de 200 idiomas en texto impreso y más de 50 en escritura a mano. Azure Document Intelligence admite más de 100 idiomas para texto impreso y 9 para escritura a mano. AWS Textract queda muy rezagado con solo seis idiomas para texto impreso (inglés, español, alemán, italiano, francés y portugués) y solo inglés para escritura a mano. Si su canal de procesamiento de documentos maneja facturas de proveedores japoneses o contratos en árabe, Textract es prácticamente inutilizable sin una capa de traducción independiente.
Dimensión 3: Integración — calidad del SDK, ecosistema y documentación
Esta es la dimensión que la mayoría de los artículos comparativos omiten, pero determina si su equipo entrega en dos semanas o en dos meses.
Integración con Google Cloud
El SDK de Python de Google está bien diseñado: la biblioteca google-cloud-vision es coherente con otras bibliotecas cliente de Google Cloud, y la referencia de la API es exhaustiva. La API de Vision admite carga directa de imágenes, codificación base64 y URI de Cloud Storage, siendo Cloud Storage la opción más rápida en aproximadamente un 25% frente a base64. La infraestructura de red de Google Cloud — que opera sobre la misma fibra privada que impulsa Search y YouTube — ofrece una latencia entre regiones un 15-25% menor que los niveles de red predeterminados de AWS o Azure.
La desventaja: la nomenclatura de productos de Google causa confusión. Un desarrollador que busque "Google Cloud OCR" encontrará Cloud Vision, Document AI y el obsoleto OCR On-Prem (cerrado en septiembre de 2025). Elegir el producto equivocado implica reconstruir la capa de extracción más adelante. La API de Vision le ofrece texto con coordenadas. Document AI le ofrece campos estructurados. La brecha entre ambos es un proyecto de ingeniería completo.
Integración con AWS
La mayor ventaja de integración de Textract es el acceso nativo a través del SDK de AWS en todos los lenguajes principales. Si su canal ya utiliza S3 para el almacenamiento de documentos, Lambda para el procesamiento sin servidor y Step Functions para la orquestación, Textract se integra sin configuración entre nubes. El SDK boto3 es maduro, está bien documentado y es coherente con el patrón general de la API de AWS.
Sin embargo, las quejas habituales en Stack Overflow incluyen: manejo de paginación que requiere seguimiento manual de NextToken, un límite flexible de 100 trabajos concurrentes que exige solicitudes de aumento de cuota para canales de alto volumen, y la necesidad de crear posprocesamiento personalizado para reconstruir la estructura de tablas a partir del JSON de respuesta basado en bloques de Textract. Un hilo de Stack Overflow señala que Textract "despoja al documento de cualquier estructura, como la información tabular", en el modo OCR sin procesar, lo que obliga a los desarrolladores a reinferir la estructura por su cuenta.
Integración con Azure
Azure Document Intelligence se beneficia del ecosistema más amplio de Microsoft. Los SDK están disponibles para Python, C#, Java y JavaScript con soporte completo de async. Para equipos con poco código, los conectores de Power Automate permiten flujos de trabajo de procesamiento de documentos sin necesidad de código personalizado, una ventaja significativa para organizaciones que ya usan Microsoft 365 y Power Platform.
Document Intelligence Studio proporciona métricas de precisión inmediatas y puntuaciones de confianza a nivel de campo durante las pruebas, lo que reduce el ciclo de retroalimentación durante la evaluación piloto. Un usuario de r/AZURE que procesó ~2.6 millones de páginas de ingesta masiva señaló que el servicio escaló sin problemas en unas 12 horas, y que los descuentos por volumen prepagados redujeron los costos del primer mes. La documentación de Azure es completa, pero está dispersa entre las páginas de Foundry Tools, AI Services y las heredadas de Cognitive Services, una reorganización que frustra a los desarrolladores durante la configuración inicial.
Dimensión 4: Precisión — Lo que Realmente Dicen los Benchmarks
Los proveedores de OCR en la nube publican afirmaciones de precisión, pero los benchmarks independientes cuentan una historia más matizada. DeltOCR Bench (noviembre de 2025) evaluó los principales servicios de OCR en tipos de documentos mixtos y encontró las siguientes puntuaciones de precisión para texto impreso:
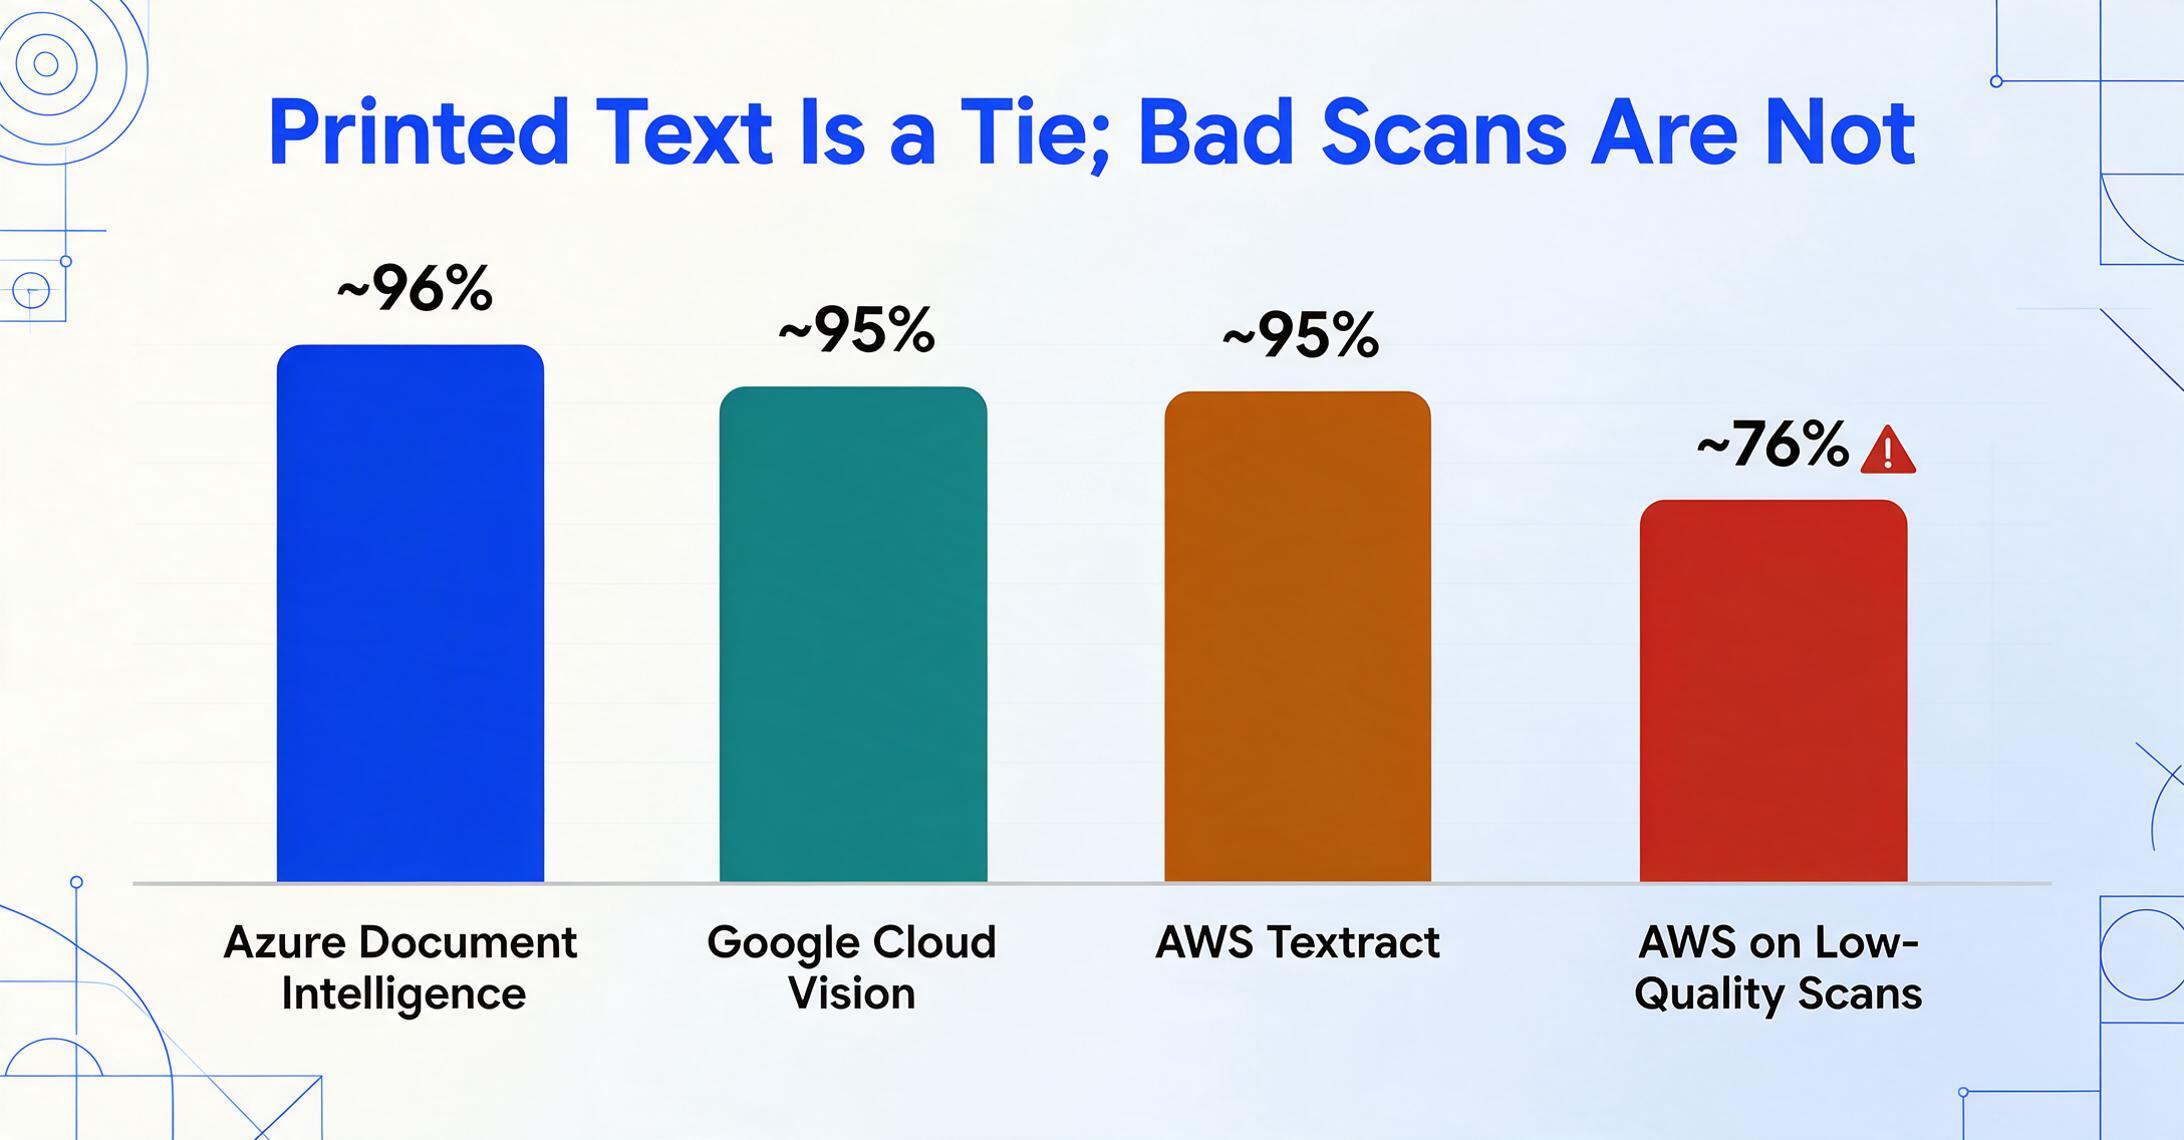
- Azure Document Intelligence: ~96% — la mayor precisión de texto impreso entre los tres, particularmente fuerte en formularios estándar y documentos limpios
- Google Cloud Vision: ~95% — prácticamente empatado con Textract en texto impreso, con un rendimiento ligeramente mejor en páginas de documentos densos
- AWS Textract: ~95% — competitivo en texto mecanografiado, pero cae a ~76% en escaneos de baja calidad (según pruebas independientes)
El benchmark de extracción de facturas de BusinessWareTech 2025 probó la precisión a nivel de campo en cinco herramientas y encontró una varianza más amplia en documentos financieros:
- Azure Document Intelligence: 93% de precisión de campo en facturas
- Google Document AI: 82% de precisión de campo
- AWS Textract: 78% de precisión de campo
Qué concluir de estos números: En documentos limpios y mecanografiados, los tres son excelentes y las diferencias de precisión son marginales para la mayoría de los casos de uso. En facturas, diseños complejos y escaneos de baja calidad, la brecha se amplía, y Azure supera consistentemente en esos escenarios más difíciles. En escritura a mano, los tres quedan por detrás de las soluciones VLM especializadas, aunque Azure ofrece la cobertura de idiomas más amplia entre los tres.
Un usuario de Stack Overflow que probó tanto Google Vision como Tesseract informó que «Google Vision alcanzó un 66.6% de precisión», mientras que Tesseract logró un 82% en su conjunto de datos específico, un recordatorio de que la precisión depende del documento y que los benchmarks son orientativos, no absolutos. Siempre pruebe con sus propios documentos.
Información clave
La brecha de precisión entre las API de OCR en la nube es menor que la brecha entre cualquier API de OCR en la nube y un enfoque basado en modelos de visión y lenguaje. Para documentos complejos, los LLM multimodales (GPT-4o, Gemini, Claude) alcanzan ahora una precisión de campo del 95-98%, un salto significativo frente al rango del 78-93% de los servicios tradicionales de OCR en la nube. La contrapartida es el costo y la latencia, pero la dirección es clara.
Cuándo Google Vision Tiene Más Sentido
Google Cloud Vision es la opción adecuada cuando ya ejecutas cargas de trabajo en Google Cloud y tu necesidad es OCR de propósito general en lugar de extracción estructurada de documentos. Las primeras 1,000 unidades por mes por función son gratuitas, lo que lo hace de costo cero para evaluaciones de bajo volumen. El soporte de más de 200 idiomas es inigualable: si tus documentos abarcan japonés, árabe, hindi e idiomas europeos, Vision API los procesa en una sola llamada.
Para equipos que solo necesitan texto (no tablas, no formularios), Vision API a $1.50 por 1,000 páginas es competitivo, y su rendimiento es excelente: un análisis comparativo de 2026 lo describió como el "rey de la velocidad" para el procesamiento OCR bruto. Si tu flujo es "extraer todo el texto de 10,000 imágenes y almacenarlo", Vision API es la vía más rápida y económica en Google Cloud.
Pero sé preciso sobre lo que estás evaluando. Cloud Vision no es un reemplazo directo de Textract o Document Intelligence. Si necesitas extracción estructurada — facturas con partidas, formularios con pares clave-valor — la comparación se traslada a Google Document AI, que tiene su propio precio y curva de aprendizaje.
Cuándo AWS Textract Tiene Más Sentido
AWS Textract es la opción natural cuando todo tu flujo de documentos ya vive en AWS. Si almacenas documentos en S3, los procesas con Lambda, los orquestas con Step Functions y revisas los resultados mediante Amazon A2I, Textract se integra sin configuración entre nubes: sin emparejamiento de VPC, sin claves API separadas, sin patrones IAM diferentes.
La API AnalyzeExpense de Textract está diseñada específicamente para la extracción de facturas y recibos, y devuelve objetos ExpenseDocument tipados con campos de resumen y grupos de partidas — sin necesidad de construir una capa de extracción sobre la salida OCR bruta. Para equipos que procesan tipos de documentos estandarizados (mismos proveedores, diseños consistentes) a gran volumen (más de 50,000 páginas al mes), el precio predecible por página y los descuentos por volumen de Textract hacen que el costo sea predecible.
La función Queries — donde haces preguntas en lenguaje natural como "¿cuál es el total de la factura?" — es genuinamente útil para extraer campos específicos sin construir un esquema. Sin embargo, el límite de 30 consultas por página y el costo de $15 por 1,000 páginas de la función Queries se acumulan. Y el límite de seis idiomas es una restricción dura para flujos de documentos multilingües.
Cuándo Azure Document Intelligence tiene más sentido
Azure Document Intelligence destaca en tres frentes: amplitud de modelos predefinidos, precisión en texto impreso e integración con el ecosistema de Microsoft.
Si su organización opera con Microsoft 365, usa SharePoint para el almacenamiento de documentos o tiene licencias de Power Automate, Document Intelligence es la opción con menor esfuerzo de integración. La biblioteca de modelos predefinidos cubre facturas, recibos, documentos de identidad, formularios W-2, formularios fiscales 1098, tarjetas de seguro médico, contratos y certificados de matrimonio: más procesadores especializados que los que Google o AWS ofrecen de serie. Para equipos que procesan tipos diversos de documentos, esto reduce la necesidad de entrenar modelos personalizados.
Los datos de referencia independientes sitúan constantemente a Azure en la cima o cerca de ella en precisión de texto impreso. En la extracción de facturas específicamente, la precisión de campos del 93% de Azure supera a Google (82%) y AWS (78%) por un margen significativo. Si la precisión en documentos complejos o de formato variable es su principal preocupación, Azure es la opción más sólida de OCR tradicional en la nube.
El soporte de Azure para texto manuscrito en nueve idiomas le da una ventaja sobre el reconocimiento de escritura a mano solo en inglés de Textract. Para documentos mixtos impresos/manuscritos como formularios de admisión médica o informes de inspección de campo, Azure procesa ambos en una sola pasada.
Alternativa sin código: cuando no quiere crear un pipeline de OCR
Existe un escenario que ninguno de los proveedores de OCR en la nube aborda directamente: usted necesita extracción de documentos, pero no es un equipo de ingeniería nativo de la nube. Crear un pipeline alrededor de Vision API, Textract o Document Intelligence requiere — como mínimo — escribir código para subir documentos, analizar respuestas JSON, asignar campos a su esquema de salida y gestionar errores. Esto es un proyecto de ingeniería de varias semanas incluso para equipos con experiencia.
ImageToTable.ai cubre esa brecha. Se sitúa en una categoría diferente a las tres APIs de OCR en la nube: extracción de datos con IA en lugar de OCR. Construido sobre modelos de lenguaje de visión en lugar de OCR tradicional, comprende los documentos semánticamente en lugar de por reconocimiento de caracteres. Usted sube un documento, escribe los nombres de las columnas que desea (p. ej., «Número de Factura», «Fecha de Vencimiento», «Total») y la IA localiza cada valor por significado, sin importar dónde aparezca en la página o con qué formato de proveedor esté trabajando.
Mientras que las APIs de OCR en la nube le dan coordenadas y puntuaciones de confianza que debe ensamblar en respuestas, ImageToTable.ai le entrega una hoja de cálculo. Admite procesamiento por lotes: suba 50 facturas y obtenga un solo archivo de Excel; columnas calculadas que generan resultados durante la extracción (como «Total de Línea = Cantidad × Precio Unitario»), y un complemento de Google Sheets que escribe los datos extraídos directamente en su hoja de cálculo sin necesidad de integración de API.
Si usted es un equipo de ingeniería que evalúa APIs de OCR en la nube, ImageToTable.ai no es un reemplazo — es una herramienta diferente para un usuario diferente. Pero si su organización tiene documentos que extraer y no cuenta con un equipo de integración dedicado, vale la pena probarlo antes de comprometerse con un flujo de OCR en la nube que tomaría semanas en construirse. Vea cómo se diferencia del OCR tradicional frente a la extracción con IA. Y si desea comparar estas tres APIs de nube con todo el mercado de OCR — herramientas de escritorio, convertidores gratuitos y aplicaciones de extracción con IA juntos — nuestro mapa del mercado de software OCR cubre esa comparación más amplia.
Preguntas frecuentes
¿Qué API de OCR en la nube es la más económica a 10,000 páginas por mes?
Para OCR básico (solo texto), las tres cuestan aproximadamente lo mismo — alrededor de $15 por mes a 10,000 páginas. Para extracción estructurada (facturas con partidas), los modelos preconstruidos de Azure a $10 por 1,000 páginas son los más económicos, seguidos por Google Document AI a $10-$30 por 1,000 páginas, siendo la combinación Forms + Tables de AWS Textract a $65 por 1,000 páginas la más costosa.
¿Qué API maneja mejor la escritura a mano?
Ninguna de las tres APIs de OCR en la nube es la mejor en su clase para escritura a mano — las soluciones VLM especializadas como GPT-5 (~95%) y Mistral OCR 3 (~89%) superan a todas ellas en escritura a mano aislada. Entre las tres, Azure Document Intelligence ofrece el soporte de idiomas más amplio para escritura a mano (9 idiomas). Google Vision maneja adecuadamente la escritura a mano en inglés. AWS Textract solo admite escritura a mano en inglés con una precisión notablemente menor que el texto impreso.
¿Puedo usar estas APIs sin una cuenta en la nube?
No. Las tres requieren una cuenta de facturación activa en la nube. Google ofrece $300 en créditos gratuitos para nuevos clientes. AWS proporciona un nivel gratuito de 3 meses (1,000 páginas por mes para Textract). Azure ofrece un nivel gratuito F0 de 500 páginas por mes. Ninguna funciona sin conexión ni sin un método de pago registrado.
¿Qué API admite más idiomas?
Google Cloud Vision lidera con más de 200 idiomas para texto impreso y más de 50 para escritura a mano. Azure Document Intelligence admite más de 100 idiomas para texto impreso y 9 para escritura a mano. AWS Textract solo admite 6 idiomas para texto impreso y únicamente inglés para escritura a mano, una limitación significativa para el procesamiento de documentos multilingües.
¿Necesito entrenar modelos personalizados?
Para tipos de documentos estándar (facturas, recibos, formularios W-2, identificaciones), los tres ofrecen modelos preentrenados que funcionan de inmediato. Para formatos de documentos personalizados o inusuales, Azure y Google Document AI admiten entrenamiento personalizado. AWS Textract admite adaptadores personalizados entrenados con sus propios documentos (gratis para entrenar, $25 por 1,000 páginas en inferencia). El entrenamiento personalizado suele mejorar la precisión en su formato de documento específico entre un 5 y un 15 %, según los puntos de referencia de los proveedores.
¿Cuál es la diferencia entre Google Cloud Vision y Document AI?
Cloud Vision es una API de análisis de imágenes de propósito general que incluye OCR como una de sus funciones. Devuelve texto con cuadros delimitadores y una jerarquía estructural (página → bloque → párrafo → palabra). Document AI es una plataforma específica para documentos con procesadores especializados para facturas, recibos, estados de cuenta bancarios y otros tipos de documentos. Document AI devuelve campos estructurados (por ejemplo, «Total de la factura: $1,234.56») en lugar de texto sin procesar. Cloud Vision es la opción más económica y rápida para OCR simple. Document AI es la opción más precisa para la extracción estructurada de documentos. Para una explicación detallada de cómo se diferencian de la extracción con IA, consulte OCR vs Extracción con IA.
Su Stack de Nube Decide
Google Cloud Vision, AWS Textract y Azure Document Intelligence son cada uno la respuesta correcta para un contexto de infraestructura específico. Si está en Google Cloud y necesita texto, use la API de Vision. Si está en AWS y necesita extracción estructurada de facturas, use AnalyzeExpense de Textract. Si está en Microsoft 365 y necesita extracción preentrenada precisa en múltiples tipos de documentos, use Document Intelligence.
La tentación es tratar esto como una cuestión de puntos de referencia (¿qué API tiene la mayor precisión?) y elegir al ganador. Pero las diferencias de precisión entre los tres en documentos limpios y mecanografiados están dentro del 1-2 %. La diferencia de costo real no son centavos por página; son horas de ingeniería dedicadas a la integración. Y ese costo está determinado casi por completo por qué tan bien se adapta la API a su infraestructura existente.
Si no está vinculado a una nube específica y simplemente desea extraer datos de documentos sin escribir código de integración, considere comenzar con una herramienta diseñada para ese caso de uso. Pruebe ImageToTable.ai con sus propios documentos — no se requiere instalación de SDK.