Google Vision vs AWS Textract vs Azure :
Comparatif OCR Cloud 2026
Votre pile cloud détermine quelle API OCR a le coût d'intégration le plus bas. Une équipe déjà sur AWS ne paie rien de plus pour l'intégration IAM et S3 de Textract. Une entreprise sur Google Cloud bénéficie du même avantage avec le pipeline Cloud Storage de Vision API. Et une maison Microsoft raccourcit son évaluation en commençant par Document Intelligence dans Azure Foundry. La question n'est pas de savoir quel moteur OCR est techniquement le meilleur — c'est celui que votre infrastructure rend le moins cher à adopter.
Points clés à retenir
- Trois API OCR cloud, trois fiches techniques, et elles semblent toutes identiques — 1,50 $ pour 1 000 pages d'extraction de texte avec une précision d'environ 95 % sur le texte imprimé.
- Le prix qui compte n'est pas le tarif OCR de base — c'est le niveau d'extraction structurée, où Textract passe de 1,50 $ à 65 $ pour 1 000 pages tandis que les modèles prédéfinis d'Azure restent à 10 $.
- Votre pile cloud a déjà décidé quelle API OCR est la moins chère à adopter avant même que vous ouvriez un seul document — une équipe sur AWS ne paie aucun frais d'intégration IAM pour Textract, et le même avantage d'infrastructure s'applique sur Google Cloud et Microsoft 365.
Comparaison rapide : trois API OCR cloud côte à côte
Avant d'entrer dans le détail, voici une vue d'ensemble. Ces chiffres correspondent à la région US Est pour le premier million de pages par mois. Les prix varient selon la région et le volume, mais les positions relatives restent stables.
| Dimension | Google Cloud Vision | AWS Textract | Azure Document Intelligence |
|---|---|---|---|
| OCR de base (pour 1 000 pages) | 1,50 $ | 1,50 $ | 1,50 $ |
| Extraction de tableaux (pour 1 000 pages) | Non disponible (Vision API) | 15,00 $ | 10,00 $ |
| Formulaire/clé-valeur (pour 1 000 pages) | Non disponible (Vision API) | 50,00 $ | 10,00 $ (prédéfini) |
| Reconnaissance d'écriture manuscrite | Oui (DOCUMENT_TEXT_DETECTION) | Anglais uniquement | 9 langues |
| Précision texte imprimé | ~95 % (DeltOCR Bench) | ~95 % (DeltOCR Bench) | ~96 % (DeltOCR Bench) |
| Offre gratuite | 1 000 unités/mois par fonctionnalité | 1 000 pages/mois (3 mois) | 500 pages/mois (F0) |
| Langues (imprimé) | 200+ | 6 (EN, ES, DE, FR, IT, PT) | 100+ |
| Langages SDK | Python, Java, Node.js, Go, C#, PHP, Ruby | Python, Java, .NET, Ruby, PHP, Go, C++ | Python, C#, Java, JavaScript, Go |
| Modèles documentaires prédéfinis | Facture, reçu, relevé bancaire, W-2, fiche de paie, facture de services, pièce d'identité (via Document AI) | Facture/dépense, identité, prêt | Facture, reçu, pièce d'identité, W-2, 1098, carte de santé, contrat, acte de mariage |
Le point clé de ce tableau : Google Cloud Vision et AWS Textract ne sont pas des produits équivalents. Vision API est un service général d'analyse d'images incluant l'OCR. Textract est un service d'extraction documentaire spécialisé. L'équivalent Google de Textract est Document AI, mais sa tarification démarre plus haut — 10 à 30 $ pour 1 000 pages pour les processeurs spécialisés. Pour une comparaison équitable, cet article couvre Vision API (OCR de base) et Document AI (extraction structurée) lorsque pertinent.
Dimension 1 : Tarifs — Le détail par page
Pour les équipes qui évaluent les API OCR, la facture mensuelle est le premier chiffre qui compte. Mais la tarification de l'OCR cloud est stratifiée, et l'option la moins chère à 1 000 pages par mois ne l'est pas à 100 000.
Tarifs de Google Cloud Vision
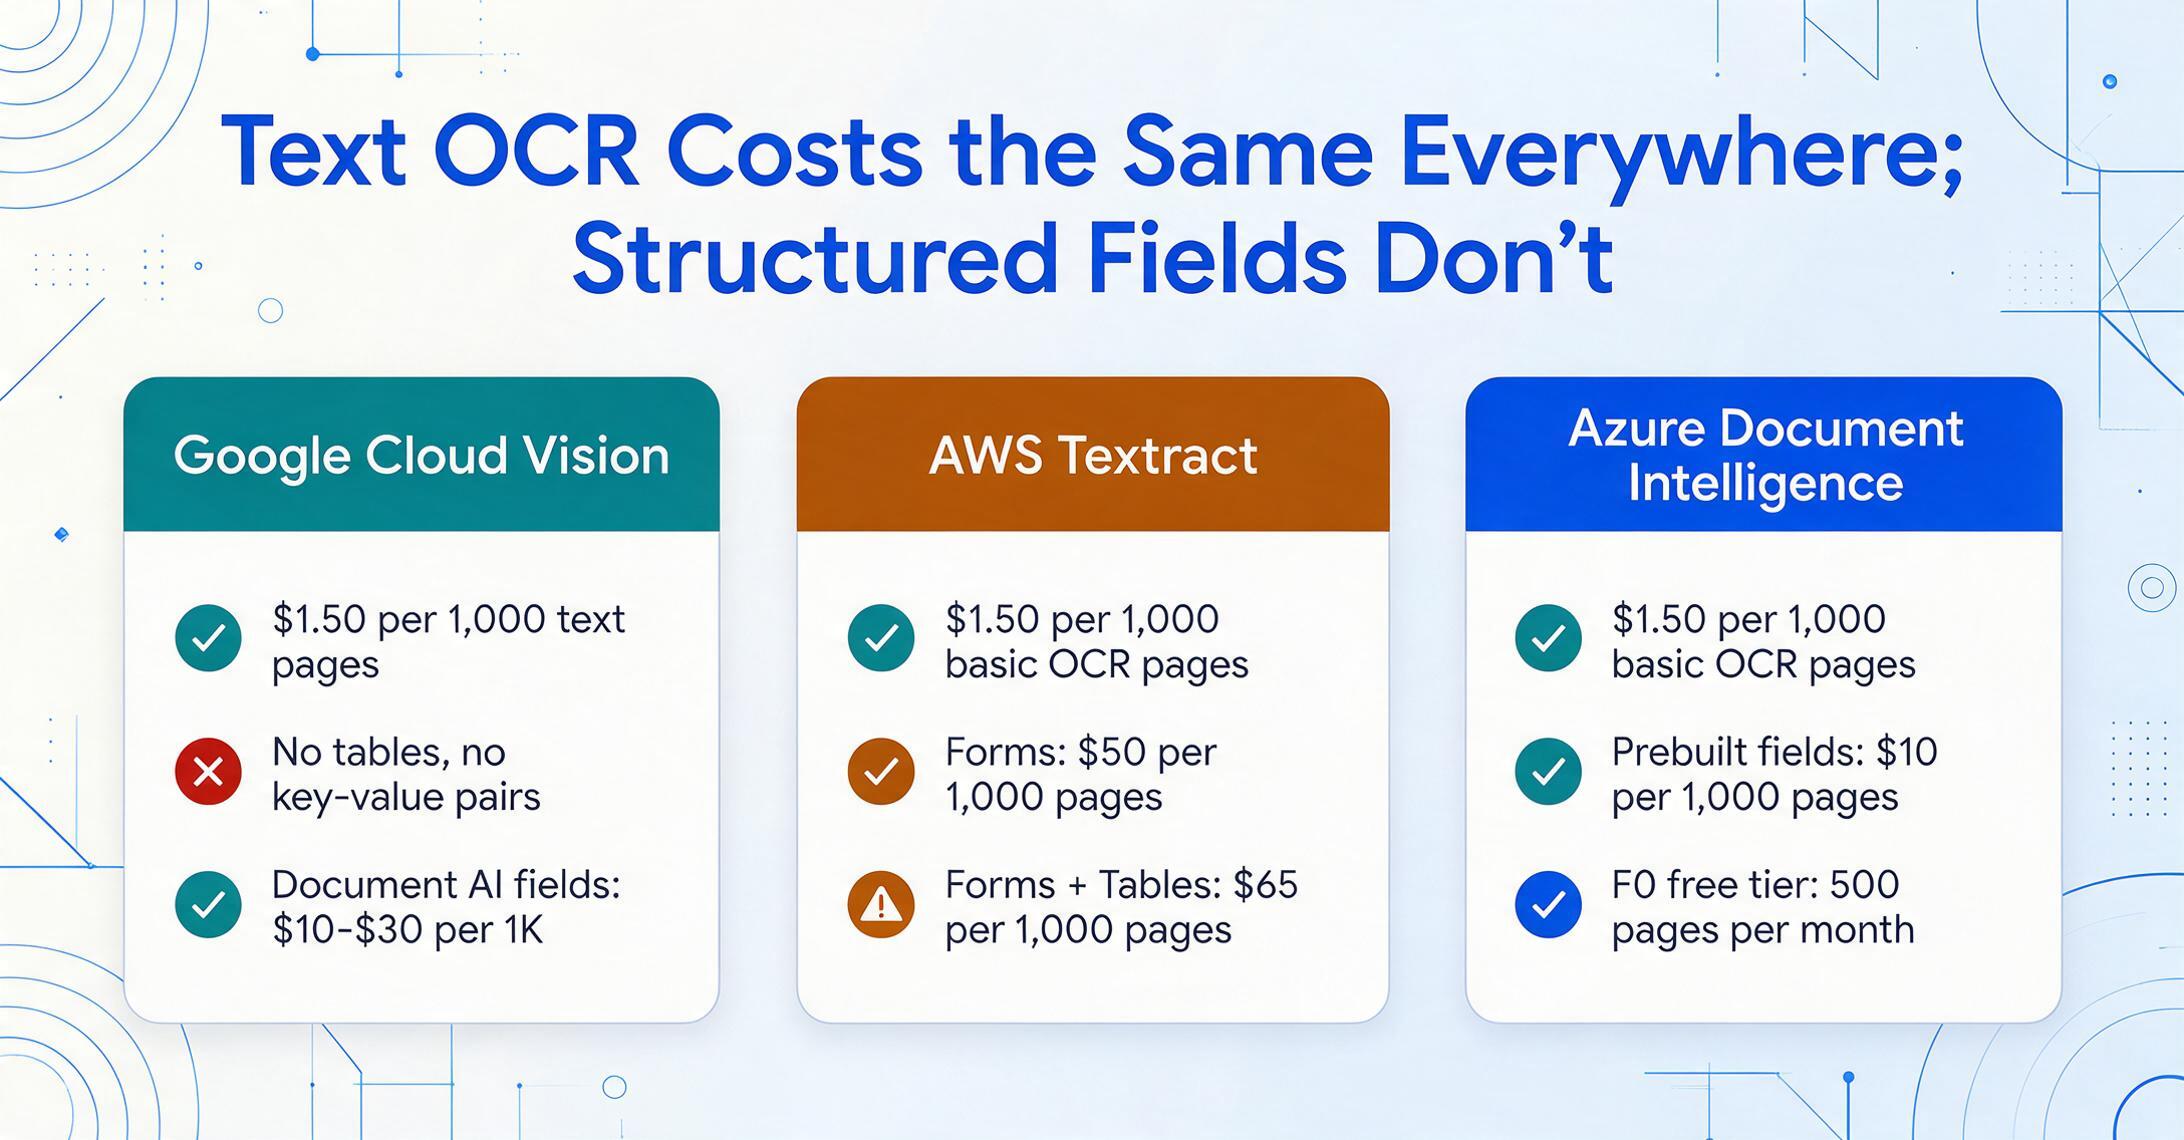
Cloud Vision utilise un modèle d'unité par fonctionnalité. TEXT_DETECTION et DOCUMENT_TEXT_DETECTION coûtent chacune 1,50 $ pour 1 000 unités après les 1 000 premières unités gratuites par mois. Au-delà de 5 millions d'unités, le prix tombe à 0,60 $ pour 1 000. Mais chaque demande de fonctionnalité compte comme une unité distincte — analyser une image pour le texte et les étiquettes coûte 2 unités. Pour une charge de travail OCR pure, un seul appel TEXT_DETECTION équivaut à une unité. À 100 000 pages par mois, vous payez 150 $.
Si vous avez besoin d'une extraction structurée (factures, formulaires, tableaux), l'API Vision seule ne suffit pas. Vous avez besoin de Document AI, où le processeur Enterprise Document OCR coûte 1,50 $ pour 1 000 pages, mais les processeurs spécialisés comme Invoice Parser ou Form Parser coûtent 10 $ à 30 $ pour 1 000 pages.
Tarifs d'AWS Textract
Textract facture par page, mais le tarif dépend entièrement de l'API que vous appelez. DetectDocumentText (OCR de base) coûte 1,50 $ pour 1 000 pages pour le premier million — le même prix que la référence de Google. Au-delà d'un million de pages, le prix tombe à 0,60 $ pour 1 000. La différence apparaît lorsque vous avez besoin de données structurées : AnalyzeDocument avec Forms coûte 50 $ pour 1 000 pages, Tables ajoute 15 $ pour 1 000, et Queries coûte 15 $ pour 1 000. Combinez les trois et vous payez 65 $ pour 1 000 pages.
Des remises sur volume s'appliquent au-delà d'un million de pages par mois, mais en dessous de ce seuil, les coûts s'accumulent rapidement. Un développeur a cité le prix de l'OCR de base de Textract (0,0015 $/page) et a établi un budget, puis a découvert que les fonctionnalités de formulaires et de tableaux dont il avait réellement besoin coûtaient 30 à 40 fois plus cher. C'est la surprise tarifaire la plus courante avec Textract.
Tarification d'Azure Document Intelligence
Azure répartit ses offres en niveaux Read, Layout, Prebuilt et Custom. Le modèle Read (OCR uniquement) coûte environ 1,50 $ pour 1 000 pages. Les modèles Layout et Prebuilt (factures, reçus, pièces d'identité, W-2, etc.) coûtent environ 10 $ pour 1 000 pages. Les modèles d'extraction personnalisés coûtent environ 50 $ pour 1 000 pages après un entraînement gratuit sur jusqu'à 500 documents. Des fonctionnalités complémentaires comme les champs de requête et l'extraction de formules ajoutent un supplément de 20 à 30 % au coût du modèle de base.
Là où Azure gagne sur la tarification, c'est au niveau des modèles Prebuilt : 10 $ pour 1 000 pages pour l'extraction de factures et de reçus, contre 50 $ pour 1 000 pages pour Forms chez Textract. Cette différence de 5x compte à grande échelle. Une équipe traitant 50 000 factures par mois paie 500 $ avec les modèles Prebuilt d'Azure, contre 2 500 $ avec l'API Forms de Textract.
Verdict sur la tarification
Pour les charges de travail OCR de base, les trois sont essentiellement à égalité à 1,50 $ pour 1 000 pages. La divergence apparaît lorsque vous avez besoin d'une extraction structurée. Les modèles Prebuilt d'Azure sont le chemin le moins cher vers l'analyse de factures et de reçus. La tarification combinée de Textract pénalise les équipes qui ont besoin de formulaires, de tableaux et de requêtes simultanément. Google Document AI se situe au milieu, mais nécessite de migrer de Vision API vers un autre niveau de produit.
Dimension 2 : Fonctionnalités documentaires — Tableaux, formulaires, écriture manuscrite et langues
La précision OCR brute sur du texte imprimé propre est un prérequis — chaque API cloud dépasse 94 % sur les documents tapés. Les véritables différenciateurs sont les types de documents qu'elles gèrent bien et ceux qu'elles gèrent moins bien.
Tableaux et formulaires
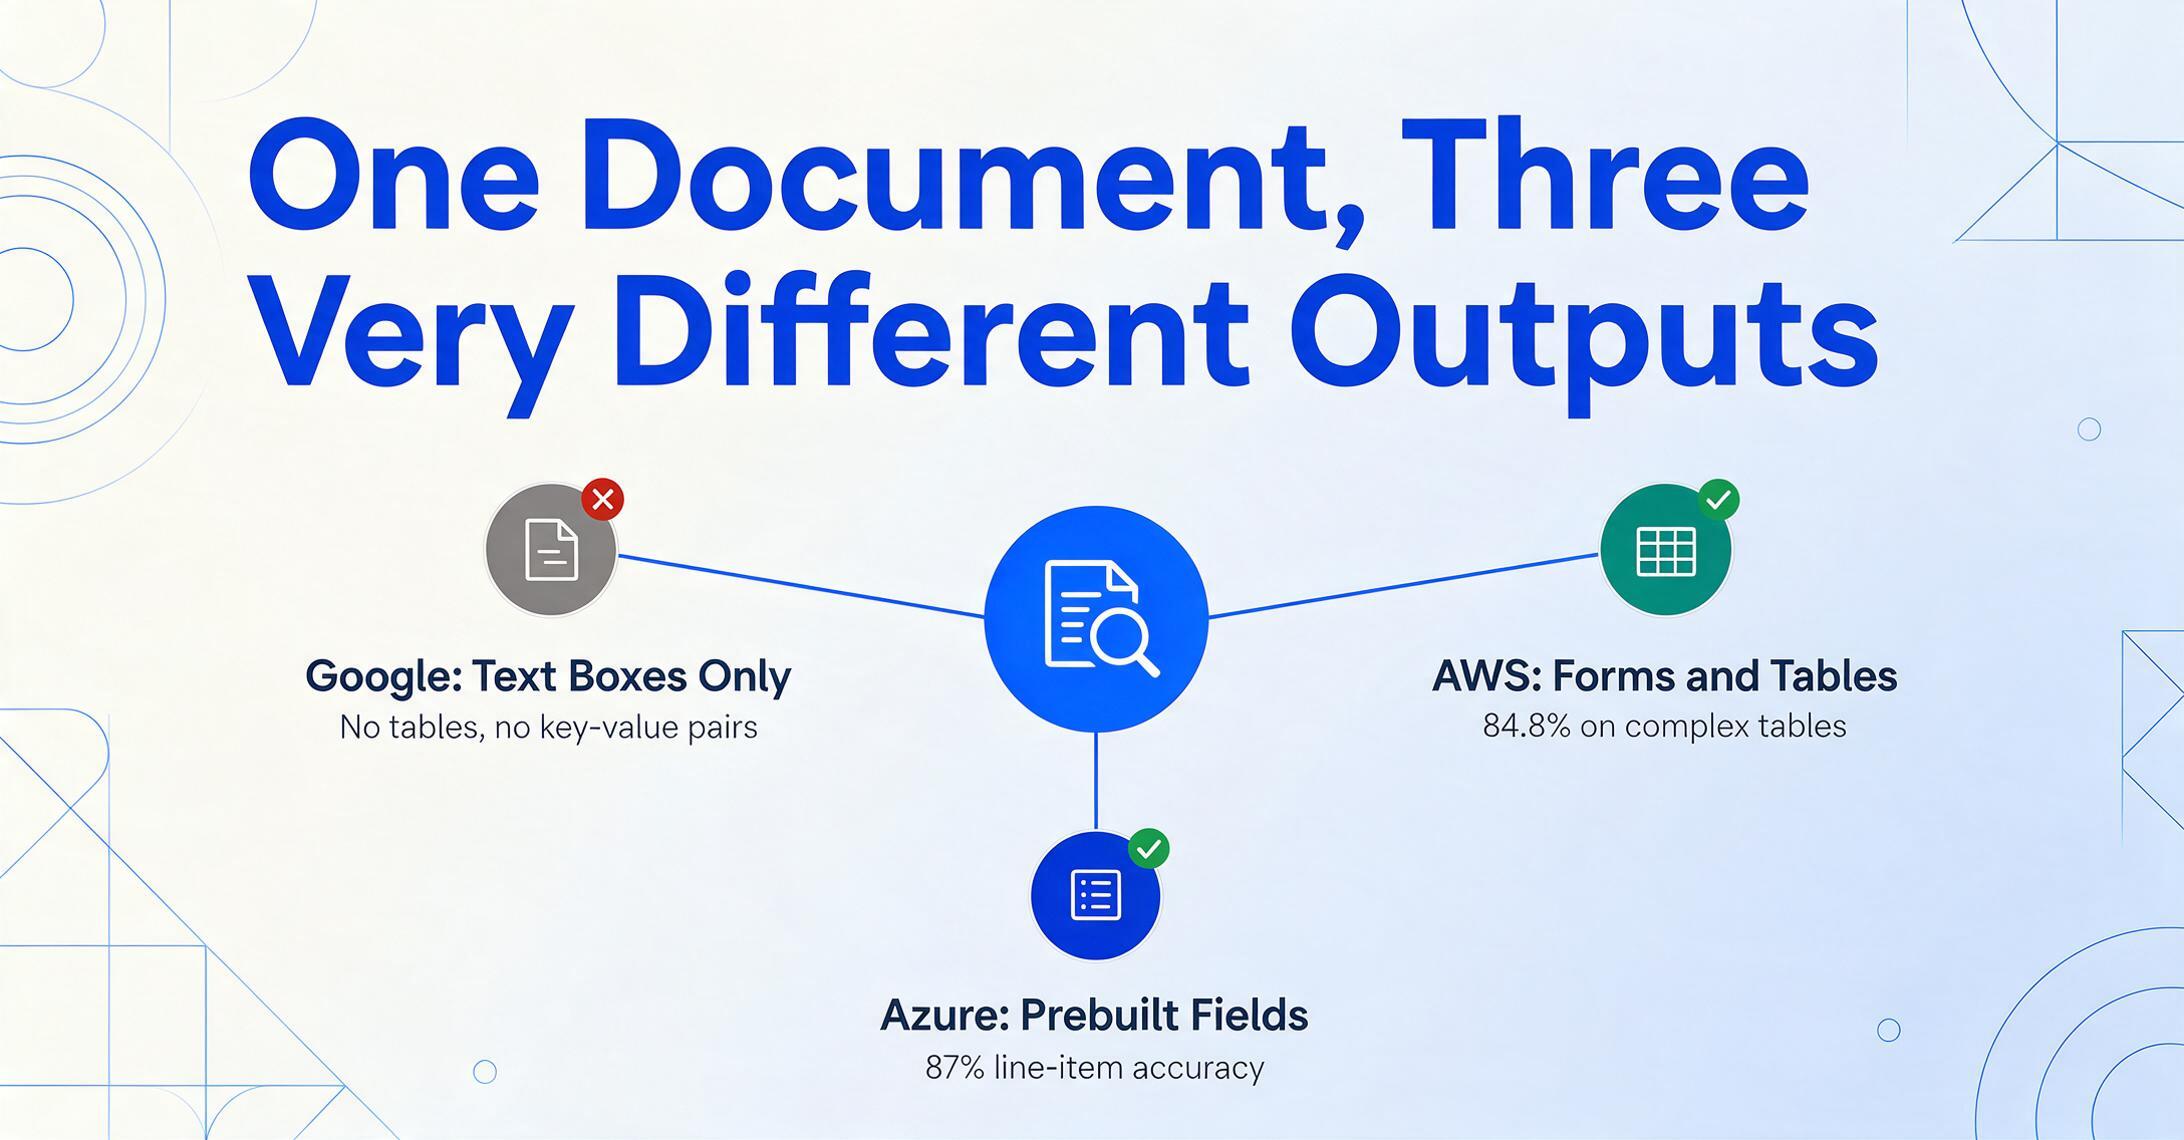
C'est la dimension où les trois API divergent le plus nettement. Google Cloud Vision (le produit OCR de base) n'extrait ni tableaux ni paires clé-valeur. Il renvoie des cadres de délimitation autour du texte détecté avec une hiérarchie structurelle — page, bloc, paragraphe, mot — mais sans compréhension des cellules de tableau ni des champs de formulaire. Si vous avez besoin d'une extraction de tableaux sur Google Cloud, vous devez utiliser le Layout Parser de Document AI (10 $ pour 1 000 pages) ou un processeur personnalisé.
L'API AnalyzeDocument d'AWS Textract dispose de fonctions dédiées Forms et Tables. Forms renvoie des paires clé-valeur (libellé : valeur) avec des scores de confiance. Tables renvoie des données au niveau des cellules avec des indices de lignes/colonnes et la gestion des cellules fusionnées. Des benchmarks indépendants montrent que Textract atteint environ 84,8 % de précision sur l'extraction de tableaux complexes, bien que les résultats varient considérablement selon la qualité des documents.
Le modèle Layout d'Azure Document Intelligence gère nativement les tableaux et les marques de sélection, et son modèle préconfiguré Invoice génère des champs structurés, y compris les lignes d'article — ce dont la plupart des équipes qui créent des pipelines de facturation ont réellement besoin. Les données de benchmark montrent qu'Azure atteint 87 % de précision d'extraction des lignes d'article, légèrement devant ses deux concurrents sur cette tâche spécifique.
Écriture manuscrite
Google Cloud Vision prend en charge l'écriture manuscrite via sa fonctionnalité DOCUMENT_TEXT_DETECTION, couvrant le texte imprimé et manuscrit en un seul appel. La précision sur une écriture manuscrite propre est compétitive, mais se dégrade considérablement sur l'écriture cursive ou les scans à faible contraste.
AWS Textract a ajouté la reconnaissance de l'écriture manuscrite en 2022, mais elle est limitée aux documents en anglais et la précision est nettement inférieure à celle du texte imprimé. La documentation AWS elle-même recommande un minimum de 150 DPI et une orientation verticale du texte pour de meilleurs résultats. Sur les documents à forte densité d'écriture manuscrite, de nombreuses équipes exportent la sortie de Textract vers un LLM en aval pour le nettoyage — un schéma fréquemment observé sur Stack Overflow et AWS re:Post.
Azure Document Intelligence prend en charge l'écriture manuscrite dans neuf langues, dont l'anglais, le français, l'allemand, l'italien, le japonais, le coréen, le portugais, l'espagnol et le chinois simplifié. Les données de benchmark placent la précision d'Azure sur les documents mixtes imprimés/manuscrits au-dessus de celle de Textract, bien que la reconnaissance pure de l'écriture manuscrite reste en retrait par rapport aux solutions VLM spécialisées.
Prise en charge des langues
Google Cloud Vision est en tête ici avec la prise en charge de plus de 200 langues pour le texte imprimé et de plus de 50 pour l'écriture manuscrite. Azure Document Intelligence prend en charge plus de 100 langues pour le texte imprimé et 9 pour l'écriture manuscrite. AWS Textract est nettement à la traîne avec seulement six langues pour le texte imprimé (anglais, espagnol, allemand, italien, français et portugais) et uniquement l'anglais pour l'écriture manuscrite. Si votre pipeline de documents traite des factures de fournisseurs japonais ou des contrats en arabe, Textract est de fait inutilisable sans couche de traduction séparée.
Dimension 3 : Intégration — qualité du SDK, écosystème et documentation
C'est la dimension que la plupart des articles comparatifs omettent, mais c'est elle qui détermine si votre équipe livre en deux semaines ou en deux mois.
Intégration Google Cloud
Le SDK Python de Google est bien conçu — la bibliothèque google-cloud-vision est cohérente avec les autres bibliothèques clientes de Google Cloud, et la référence API est exhaustive. L'API Vision prend en charge le téléchargement direct d'images, l'encodage base64 et les URI Cloud Storage, le Cloud Storage étant l'option la plus rapide d'environ 25 % par rapport au base64. L'infrastructure réseau de Google Cloud — fonctionnant sur la même fibre privée qui alimente Search et YouTube — offre une latence interrégionale inférieure de 15 à 25 % à celle des niveaux de réseau par défaut d'AWS ou d'Azure.
L'inconvénient : la dénomination des produits Google prête à confusion. Un développeur qui recherche « Google Cloud OCR » trouve Cloud Vision, Document AI et l'OCR On-Prem obsolète (arrêté en septembre 2025). Choisir le mauvais produit signifie devoir reconstruire la couche d'extraction plus tard. L'API Vision vous donne du texte avec des coordonnées. Document AI vous donne des champs structurés. L'écart entre les deux représente un projet d'ingénierie complet.
Intégration AWS
Le principal avantage d'intégration de Textract est l'accès natif via le SDK AWS dans tous les principaux langages. Si votre pipeline utilise déjà S3 pour le stockage de documents, Lambda pour le traitement sans serveur et Step Functions pour l'orchestration, Textract s'intègre sans configuration inter-cloud. Le SDK boto3 est mature, bien documenté et cohérent avec le modèle d'API AWS plus large.
Cependant, les plaintes courantes sur Stack Overflow incluent : la gestion de la pagination qui nécessite un suivi manuel du NextToken, une limite logicielle de 100 travaux simultanés qui exige des demandes d'augmentation de quota pour les pipelines à volume élevé, et la nécessité de créer un post-traitement personnalisé pour reconstruire la structure des tableaux à partir du JSON de réponse basé sur les blocs de Textract. Un fil Stack Overflow note que Textract « dépouille le document de toute structure comme les informations tabulaires » en mode OCR brut, obligeant les développeurs à réinférer la structure eux-mêmes.
Intégration Azure
Azure Document Intelligence bénéficie de l'écosystème Microsoft plus large. Des SDK sont disponibles pour Python, C#, Java et JavaScript avec une prise en charge complète de l'asynchrone. Pour les équipes low-code, les connecteurs Power Automate permettent de créer des flux de traitement de documents sans aucun code personnalisé — un avantage considérable pour les organisations qui utilisent déjà Microsoft 365 et Power Platform.
Le Document Intelligence Studio fournit des mesures de précision immédiates et des scores de confiance au niveau des champs pendant les tests, ce qui réduit la boucle de rétroaction lors de l'évaluation pilote. Un utilisateur de r/AZURE traitant environ 2,6 millions de pages en ingestion par rafales a noté que le service s'était adapté sans problème en environ 12 heures, les remises sur volume prépayées ayant réduit les coûts du premier mois. La documentation d'Azure est complète mais répartie entre les pages Foundry Tools, AI Services et les anciennes pages Cognitive Services — une réorganisation qui frustre les développeurs lors de la configuration initiale.
Dimension 4 : Précision — Ce que disent réellement les benchmarks
Les fournisseurs d'OCR cloud publient des affirmations de précision, mais les benchmarks indépendants racontent une histoire plus nuancée. Le DeltOCR Bench (novembre 2025) a évalué les principaux services OCR sur des types de documents mixtes et a constaté les scores de précision de texte imprimé suivants :
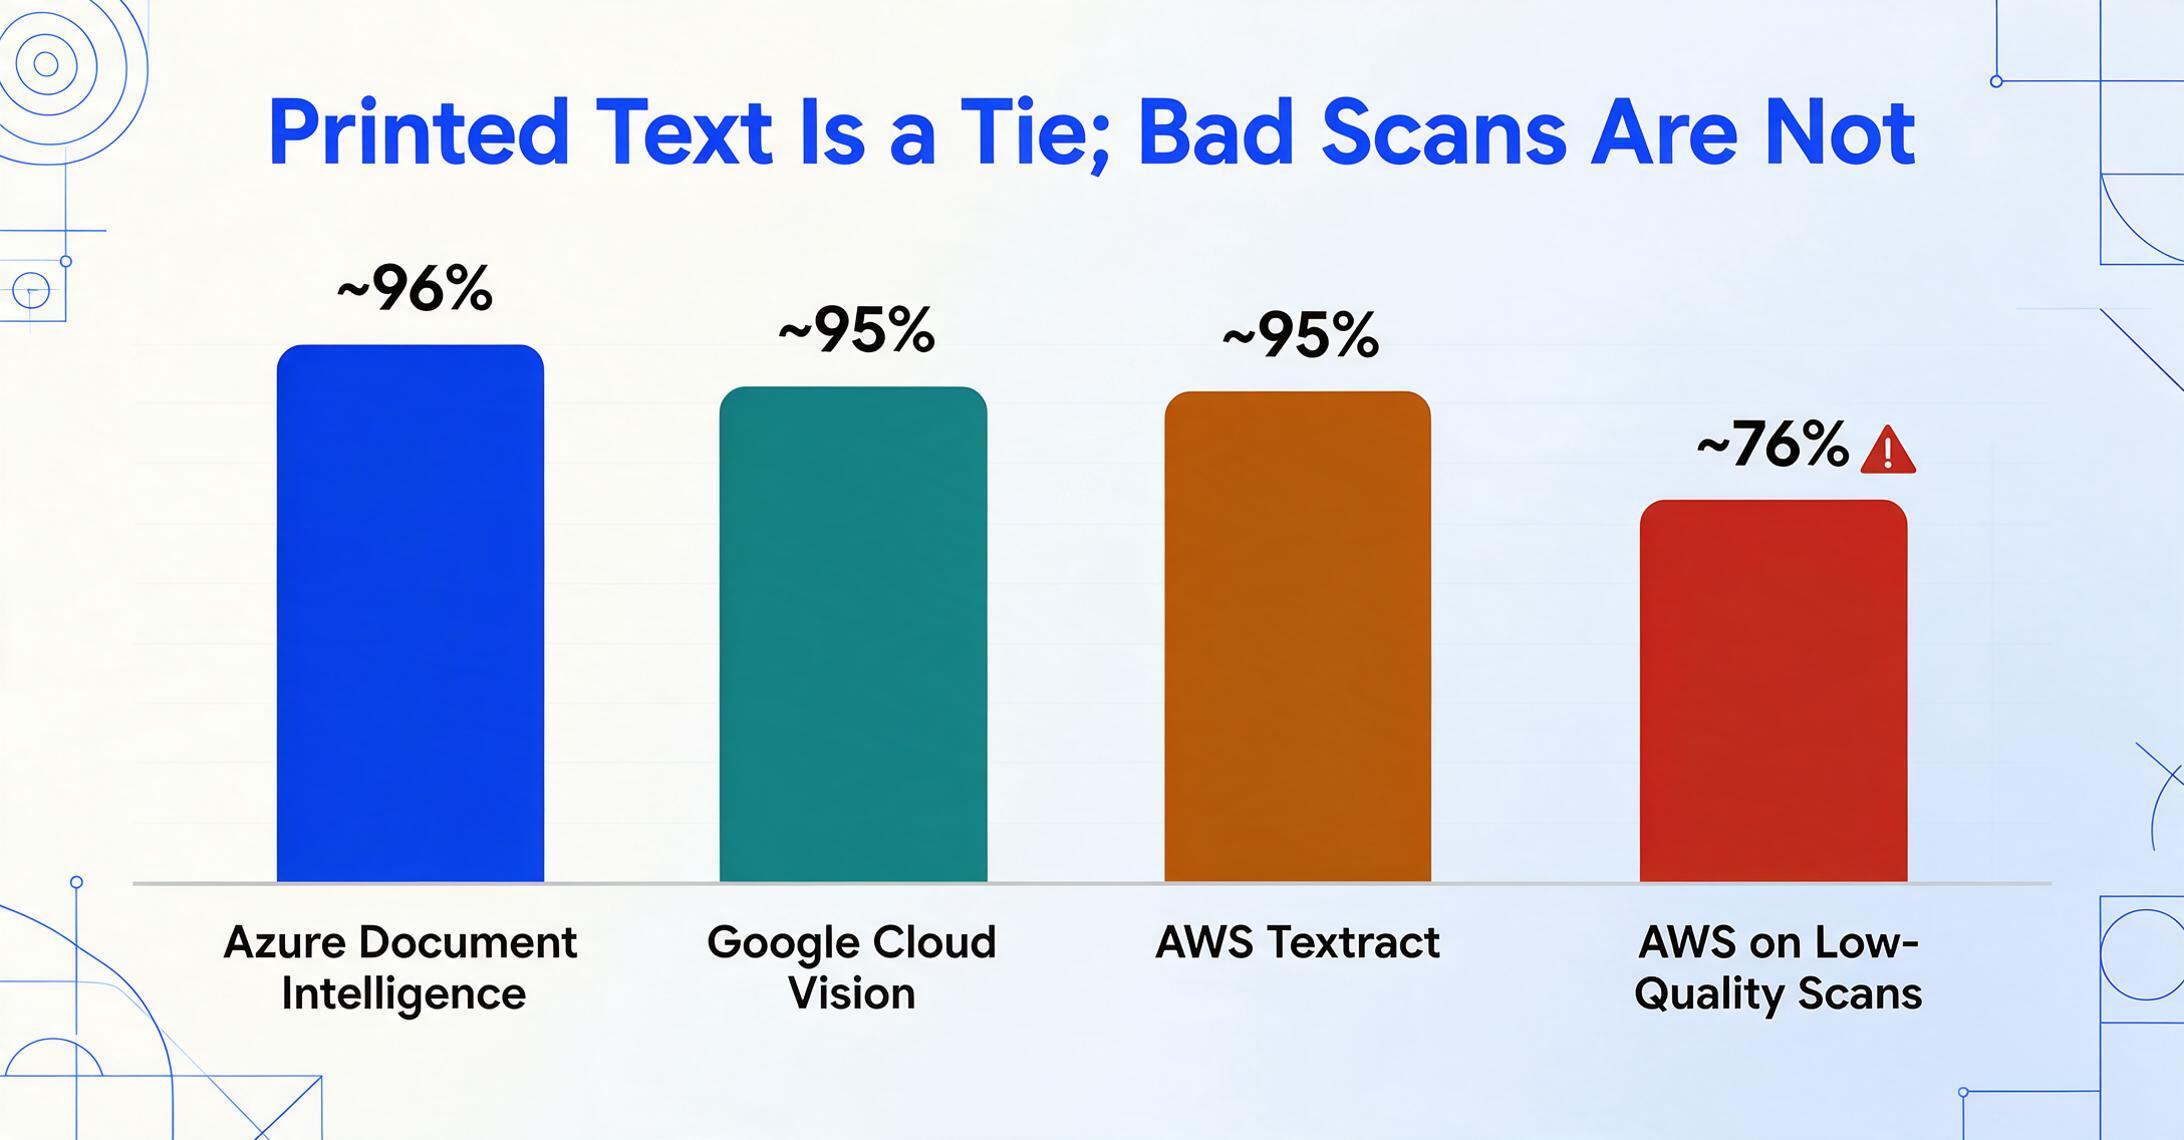
- Azure Document Intelligence : ~96 % — précision de texte imprimé la plus élevée des trois, particulièrement solide sur les formulaires standard et les documents propres
- Google Cloud Vision : ~95 % — essentiellement à égalité avec Textract sur le texte imprimé, avec des performances légèrement meilleures sur les pages de documents denses
- AWS Textract : ~95 % — compétitif sur le texte tapé mais chute à ~76 % sur les scans de mauvaise qualité (selon des tests indépendants)
Le benchmark d'extraction de factures BusinessWareTech 2025 a testé la précision au niveau des champs sur cinq outils et a constaté une variance plus large sur les documents financiers :
- Azure Document Intelligence : 93 % de précision des champs sur les factures
- Google Document AI : 82 % de précision des champs
- AWS Textract : 78 % de précision des champs
Ce qu'il faut retenir de ces chiffres : Sur les documents tapés et propres, les trois sont excellents et les différences de précision sont marginales pour la plupart des cas d'utilisation. Sur les factures, les mises en page complexes et les scans de mauvaise qualité, l'écart se creuse — et Azure surpasse systématiquement les autres dans ces scénarios plus difficiles. Sur l'écriture manuscrite, les trois sont à la traîne par rapport aux solutions VLM spécialisées, bien qu'Azure offre la couverture linguistique la plus large des trois.
Un utilisateur de Stack Overflow testant à la fois Google Vision et Tesseract a rapporté que « Google Vision a atteint une précision de 66,6 % » tandis que Tesseract a obtenu 82 % sur leur ensemble de données spécifique — un rappel que la précision dépend du document et que les benchmarks sont indicatifs, pas absolus. Testez toujours avec vos propres documents.
Point clé
L'écart de précision entre les API OCR cloud est plus faible que l'écart entre n'importe quelle API OCR cloud et une approche par modèle de vision-langage. Pour les documents complexes, les LLM multimodaux (GPT-4o, Gemini, Claude) atteignent désormais une précision de 95 à 98 % sur les champs — un bond significatif par rapport à la fourchette de 78 à 93 % des services OCR cloud traditionnels. Le compromis se situe au niveau du coût et de la latence, mais la tendance est claire.
Quand Google Vision est plus pertinent
Google Cloud Vision est le bon choix lorsque vous exécutez déjà des charges de travail sur Google Cloud et que votre besoin est de l'OCR à usage général plutôt qu'une extraction structurée de documents. Les 1 000 premières unités par mois et par fonctionnalité sont gratuites, ce qui rend l'évaluation à faible volume sans coût. La prise en charge de plus de 200 langues est inégalée — si vos documents couvrent le japonais, l'arabe, l'hindi et les langues européennes, l'API Vision les traite en un seul appel.
Pour les équipes qui n'ont besoin que de texte (pas de tableaux, pas de formulaires), le tarif de 1,50 $ pour 1 000 pages de l'API Vision est compétitif, et son débit est excellent — un benchmark de 2026 l'a décrite comme le « roi de la vitesse » pour le traitement OCR brut. Si votre pipeline consiste à « extraire tout le texte de 10 000 images et à le stocker », l'API Vision est le chemin le plus rapide et le moins cher sur Google Cloud.
Mais soyez précis sur ce que vous évaluez. Cloud Vision n'est pas un remplacement direct de Textract ou de Document Intelligence. Si vous avez besoin d'une extraction structurée — factures avec lignes d'articles, formulaires avec paires clé-valeur — la comparaison se déplace vers Google Document AI, qui a sa propre tarification et sa propre courbe d'apprentissage.
Quand AWS Textract est plus pertinent
AWS Textract est le choix naturel lorsque l'ensemble de votre pipeline documentaire vit déjà dans AWS. Si vous stockez des documents dans S3, les traitez avec Lambda, orchestrez avec Step Functions et examinez les résultats via Amazon A2I, Textract s'intègre sans aucune configuration inter-cloud — pas de peering VPC, pas de clés API séparées, pas de modèles IAM différents.
L'API AnalyzeExpense de Textract est spécialement conçue pour l'extraction de factures et de reçus et renvoie des objets ExpenseDocument typés avec des champs récapitulatifs et des groupes de lignes d'articles — pas besoin de construire une couche d'extraction par-dessus la sortie OCR brute. Pour les équipes traitant des types de documents standardisés (mêmes fournisseurs, mises en page cohérentes) à volume élevé (plus de 50 000 pages par mois), la tarification prévisible par page de Textract et ses remises sur volume rendent les coûts prévisibles.
La fonctionnalité Queries — où vous posez des questions en langage naturel comme « quel est le total de la facture ? » — est réellement utile pour extraire des champs spécifiques sans construire de schéma. Cependant, la limite de 30 requêtes par page et le coût de 15 $ pour 1 000 pages de la fonctionnalité Queries s'additionnent. Et le plafond de six langues est une contrainte stricte pour les pipelines documentaires multilingues.
Quand Azure Document Intelligence est plus pertinent
Azure Document Intelligence se distingue sur trois plans : la diversité des modèles prédéfinis, la précision sur le texte imprimé et l'intégration avec l'écosystème Microsoft.
Si votre organisation utilise Microsoft 365, SharePoint pour le stockage de documents ou dispose de licences Power Automate, Document Intelligence est l'option qui demande le moins d'efforts d'intégration. La bibliothèque de modèles prédéfinis couvre les factures, reçus, pièces d'identité, formulaires W-2, formulaires fiscaux 1098, cartes d'assurance maladie, contrats et certificats de mariage — soit plus de processeurs spécialisés que ce que Google ou AWS proposent nativement. Pour les équipes qui traitent des types de documents variés, cela réduit le besoin de formation de modèles personnalisés.
Les données de référence indépendantes placent systématiquement Azure au sommet ou presque en matière de précision sur le texte imprimé. Sur l'extraction de factures en particulier, la précision de 93 % d'Azure sur les champs devance nettement Google (82 %) et AWS (78 %). Si la précision sur des documents complexes ou à format variable est votre priorité, Azure est le choix traditionnel le plus solide en OCR cloud.
La prise en charge du texte manuscrit en neuf langues par Azure lui donne un avantage sur la reconnaissance manuscrite limitée à l'anglais de Textract. Pour les documents mixtes imprimés/manuscrits comme les formulaires d'admission médicale ou les rapports d'inspection terrain, Azure traite les deux en une seule passe.
Alternative sans code : quand vous ne voulez pas créer de pipeline OCR du tout
Il existe un scénario qu'aucun fournisseur d'OCR cloud n'aborde directement : vous avez besoin d'extraction de documents, mais vous n'êtes pas une équipe d'ingénierie cloud-native. Créer un pipeline autour de Vision API, Textract ou Document Intelligence nécessite — au minimum — d'écrire du code pour téléverser des documents, analyser les réponses JSON, mapper les champs vers votre schéma de sortie et gérer les erreurs. C'est un projet d'ingénierie de plusieurs semaines, même pour des équipes expérimentées.
ImageToTable.ai comble cette lacune. Il se situe dans une catégorie différente des trois API OCR cloud — l'extraction de données par IA plutôt que l'OCR. Conçu sur des modèles de langage visuels plutôt que sur l'OCR traditionnel, il comprend les documents sémantiquement plutôt que par reconnaissance de caractères. Vous téléversez un document, saisissez les noms de colonnes souhaités (par exemple « Numéro de facture », « Date d'échéance », « Total »), et l'IA localise chaque valeur par le sens — quel que soit l'endroit où elle apparaît sur la page ou la mise en page du fournisseur concerné.
Là où les API OCR cloud vous donnent des coordonnées et des scores de confiance que vous devez assembler pour obtenir des réponses, ImageToTable.ai vous fournit une feuille de calcul. Il prend en charge le traitement par lots — téléversez 50 factures et obtenez un seul fichier Excel — les colonnes calculées qui calculent des résultats pendant l'extraction (comme « Total ligne = Qté × Prix unitaire »), et un module complémentaire Google Sheets qui écrit les données extraites directement dans votre feuille de calcul, sans aucune intégration API.
Si vous êtes une équipe d'ingénieurs qui évalue des API OCR cloud, ImageToTable.ai n'est pas un remplacement — c'est un outil différent pour un utilisateur différent. Mais si votre organisation a des documents à extraire et aucune équipe d'intégration dédiée, cela vaut la peine de le tester avant de vous engager dans un pipeline OCR cloud qui prendrait des semaines à construire. Découvrez en quoi il diffère de l'OCR traditionnel par rapport à l'extraction par IA. Et si vous voulez comparer ces trois API cloud à l'ensemble du marché de l'OCR — outils de bureau, convertisseurs gratuits et applications d'extraction par IA ensemble — notre carte du marché des logiciels OCR couvre cette comparaison plus large.
FAQ
Quelle API OCR cloud est la moins chère à 10 000 pages par mois ?
Pour l'OCR de base (texte uniquement), les trois coûtent à peu près le même prix — environ 15 $ par mois pour 10 000 pages. Pour l'extraction structurée (factures avec lignes de détail), les modèles préconstruits d'Azure à 10 $ pour 1 000 pages sont les moins chers, suivis de Google Document AI à 10 $–30 $ pour 1 000 pages, la combinaison Forms + Tables d'AWS Textract à 65 $ pour 1 000 pages étant la plus chère.
Quelle API gère le mieux l'écriture manuscrite ?
Aucune des trois API OCR cloud n'est la meilleure de sa catégorie pour l'écriture manuscrite — des solutions VLM spécialisées comme GPT-5 (~95 %) et Mistral OCR 3 (~89 %) surpassent toutes les trois sur l'écriture manuscrite isolée. Parmi les trois, Azure Document Intelligence offre la prise en charge linguistique la plus large pour l'écriture manuscrite (9 langues). Google Vision gère correctement l'écriture manuscrite en anglais. AWS Textract ne prend en charge que l'écriture manuscrite en anglais, avec une précision nettement inférieure à celle du texte imprimé.
Puis-je utiliser ces API sans compte cloud ?
Non. Les trois exigent un compte de facturation cloud actif. Google offre 300 $ de crédits gratuits aux nouveaux clients. AWS propose un niveau gratuit de 3 mois (1 000 pages par mois pour Textract). Azure offre un niveau gratuit F0 à 500 pages par mois. Aucune ne fonctionne hors ligne ou sans méthode de paiement enregistrée.
Quelle API prend en charge le plus de langues ?
Google Cloud Vision est en tête avec plus de 200 langues pour le texte imprimé et plus de 50 pour l'écriture manuscrite. Azure Document Intelligence prend en charge plus de 100 langues pour le texte imprimé et 9 pour l'écriture manuscrite. AWS Textract ne prend en charge que 6 langues pour le texte imprimé et uniquement l'anglais pour l'écriture manuscrite — une limitation importante pour le traitement de documents multilingues.
Dois-je entraîner des modèles personnalisés ?
Pour les types de documents standard (factures, reçus, formulaires W-2, pièces d'identité), les trois offrent des modèles préétablis qui fonctionnent directement. Pour les formats de documents personnalisés ou inhabituels, Azure et Google Document AI prennent en charge l'entraînement personnalisé. AWS Textract prend en charge des adaptateurs personnalisés entraînés sur vos propres documents (gratuits à entraîner, 25 $ pour 1 000 pages à l'inférence). L'entraînement personnalisé améliore généralement la précision sur votre format de document spécifique de 5 à 15 %, selon les références des fournisseurs.
Quelle est la différence entre Google Cloud Vision et Document AI ?
Cloud Vision est une API d'analyse d'images à usage général qui inclut l'OCR parmi ses fonctionnalités. Elle renvoie le texte avec des cadres de délimitation et une hiérarchie structurelle (page → bloc → paragraphe → mot). Document AI est une plateforme spécifique aux documents avec des processeurs spécialisés pour les factures, les reçus, les relevés bancaires et d'autres types de documents. Document AI renvoie des champs structurés (par exemple, « Total de la facture : 1 234,56 $ ») plutôt que du texte brut. Cloud Vision est l'option la moins chère et la plus rapide pour l'OCR simple. Document AI est l'option la plus précise pour l'extraction structurée de documents. Pour une explication détaillée de la différence avec l'extraction par IA, voir OCR vs Extraction par IA.
Votre pile cloud décide
Google Cloud Vision, AWS Textract et Azure Document Intelligence sont chacun la bonne réponse pour un contexte d'infrastructure spécifique. Si vous êtes sur Google Cloud et avez besoin de texte, utilisez l'API Vision. Si vous êtes sur AWS et avez besoin d'une extraction structurée de factures, utilisez AnalyzeExpense de Textract. Si vous êtes sur Microsoft 365 et avez besoin d'une extraction préétablie précise sur plusieurs types de documents, utilisez Document Intelligence.
La tentation est de traiter cela comme une question de référence — quelle API a la plus grande précision ? — et de choisir le gagnant. Mais les différences de précision entre les trois sur des documents propres et tapés sont de 1 à 2 %. La véritable différence de coût ne réside pas dans les centimes par page ; elle réside dans les heures d'ingénierie consacrées à l'intégration. Et ce coût est déterminé presque entièrement par la façon dont l'API s'intègre à votre infrastructure existante.
Si vous n'êtes pas lié à un cloud spécifique et souhaitez simplement extraire des données de documents sans écrire de code d'intégration, envisagez de commencer avec un outil conçu pour ce cas d'usage. Testez ImageToTable.ai sur vos propres documents — aucune installation de SDK requise.