Google Vision vs AWS Textract vs Azure:
Cloud-OCR-Vergleich 2026
Ihr Cloud-Stack bestimmt, welche OCR-API die geringsten Integrationskosten hat. Ein Team, das bereits auf AWS arbeitet, zahlt für die IAM- und S3-Integration von Textract nichts extra. Ein Google-Cloud-Shop erhält denselben Vorteil mit der Cloud-Storage-Pipeline der Vision API. Und ein Microsoft-Haus verkürzt seine Evaluierung, indem es mit Document Intelligence in Azure Foundry startet. Die Frage ist nicht, welche OCR-Engine technisch am besten ist – sondern welche Ihre Infrastruktur am günstigsten zu integrieren macht.
Wichtigste Erkenntnisse
- Drei Cloud-OCR-APIs, drei Datenblätter, und sie sehen alle identisch aus – $1,50 pro 1.000 Seiten für Textextraktion bei ~95 % Genauigkeit bei gedrucktem Text.
- Der entscheidende Preis ist nicht der Basis-OCR-Tarif – sondern die Stufe für strukturierte Extraktion, bei der Textract von $1,50 auf $65 pro 1.000 Seiten springt, während die vorgefertigten Modelle von Azure bei $10 bleiben.
- Ihr Cloud-Stack hat bereits entschieden, welche OCR-API am günstigsten zu integrieren ist, bevor Sie auch nur ein Dokument geöffnet haben – ein Team auf AWS zahlt null IAM-Integrationsaufwand für Textract, und derselbe Infrastrukturvorteil gilt für Google Cloud und Microsoft 365.
Kurzvergleich: Drei Cloud-OCR-APIs im Überblick
Bevor wir in die Details einsteigen, hier die Übersicht. Die Zahlen basieren auf dem US-Ost-Basistarif für die ersten eine Million Seiten pro Monat. Die Preise variieren je nach Region und Volumenstufe, die relativen Unterschiede bleiben jedoch bestehen.
| Dimension | Google Cloud Vision | AWS Textract | Azure Document Intelligence |
|---|---|---|---|
| Basis-OCR (pro 1.000 Seiten) | 1,50 $ | 1,50 $ | 1,50 $ |
| Tabellenextraktion (pro 1.000 Seiten) | Nicht verfügbar (Vision API) | 15,00 $ | 10,00 $ |
| Formular-/Schlüssel-Wert-Extraktion (pro 1.000 Seiten) | Nicht verfügbar (Vision API) | 50,00 $ | 10,00 $ (vorgefertigt) |
| Handschriftunterstützung | Ja (DOCUMENT_TEXT_DETECTION) | Nur Englisch | 9 Sprachen |
| Genauigkeit (Druckschrift) | ~95 % (DeltOCR Bench) | ~95 % (DeltOCR Bench) | ~96 % (DeltOCR Bench) |
| Kostenloses Kontingent | 1.000 Einheiten/Monat pro Funktion | 1.000 Seiten/Monat (3 Monate) | 500 Seiten/Monat (F0) |
| Sprachen (Druckschrift) | 200+ | 6 (EN, ES, DE, FR, IT, PT) | 100+ |
| SDK-Sprachen | Python, Java, Node.js, Go, C#, PHP, Ruby | Python, Java, .NET, Ruby, PHP, Go, C++ | Python, C#, Java, JavaScript, Go |
| Vorgefertigte Dokumentenmodelle | Rechnung, Quittung, Kontoauszug, W-2, Gehaltsabrechnung, Nebenkostenabrechnung, Ausweis (über Document AI) | Rechnung/Spesen, Ausweis, Kreditvergabe | Rechnung, Quittung, Ausweis, W-2, 1098, Gesundheitskarte, Vertrag, Heiratsurkunde |
Die wichtigste Erkenntnis aus dieser Tabelle: Google Cloud Vision und AWS Textract sind keine gleichwertigen Produkte. Die Vision API ist ein allgemeiner Bildanalyse-Dienst, der OCR beinhaltet. Textract ist ein speziell entwickelter Dokumentenextraktionsdienst. Das Google-Äquivalent zu Textract ist Document AI, dessen Preise jedoch höher beginnen – 10–30 $ pro 1.000 Seiten für spezialisierte Prozessoren. Für einen fairen Vergleich behandelt dieser Artikel sowohl die Vision API (Basis-OCR) als auch Document AI (strukturierte Extraktion), wo dies relevant ist.
Dimension 1: Preise – Die Kosten pro Seite
Für Teams, die OCR-APIs evaluieren, ist die monatliche Rechnung die erste Kennzahl, die zählt. Doch die Preisgestaltung von Cloud-OCR ist vielschichtig – und die günstigste Option bei 1.000 Seiten pro Monat ist nicht unbedingt die günstigste bei 100.000 Seiten.
Preise für Google Cloud Vision
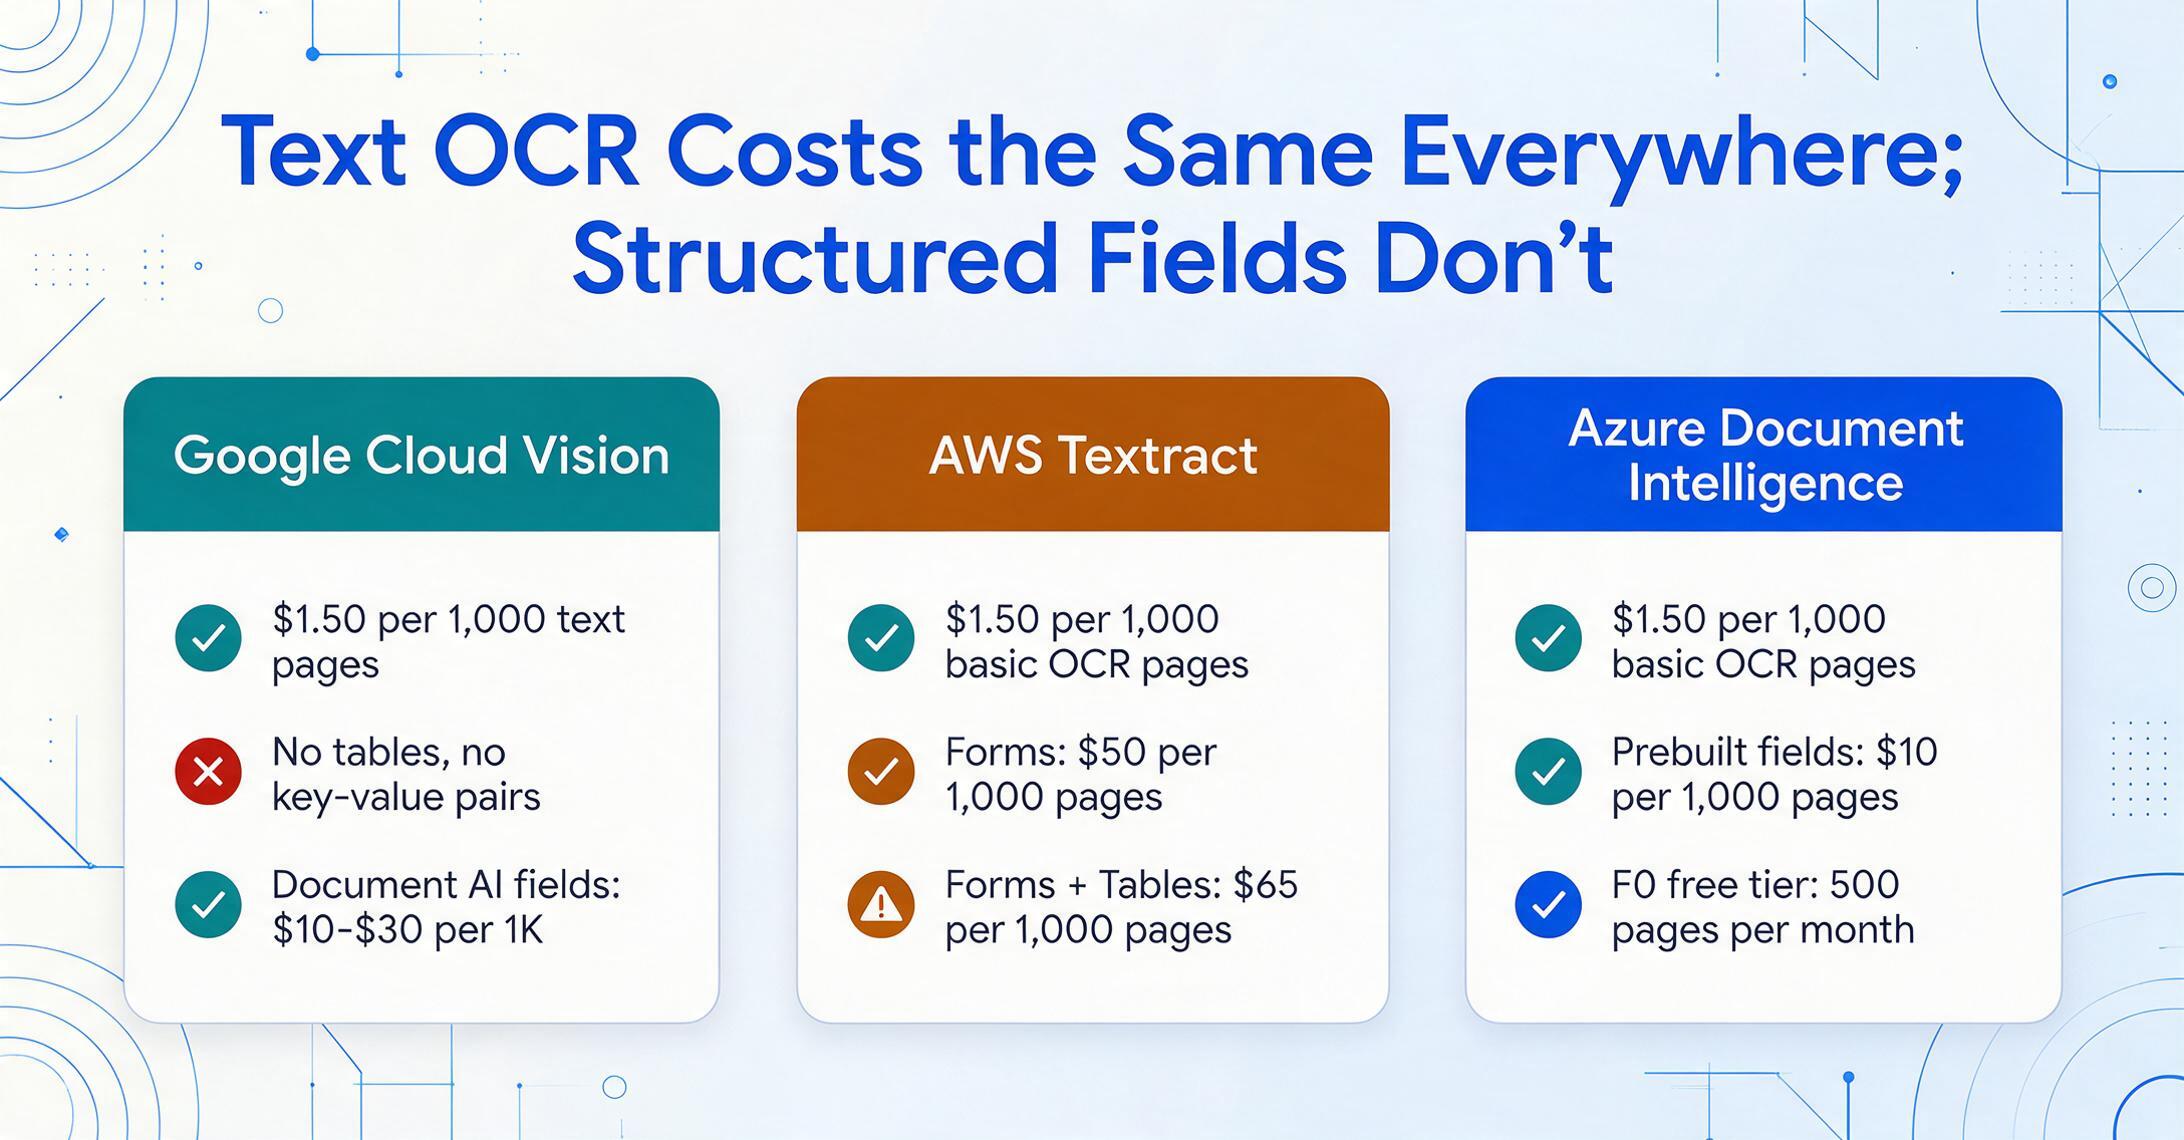
Cloud Vision verwendet ein Modell mit Abrechnung pro Funktion. TEXT_DETECTION und DOCUMENT_TEXT_DETECTION kosten jeweils $1,50 pro 1.000 Einheiten, nachdem die ersten 1.000 Einheiten pro Monat kostenlos sind. Über 5 Millionen Einheiten sinkt der Preis auf $0,60 pro 1.000. Jede Funktionsanfrage zählt jedoch als separate Einheit – die Analyse eines Bildes auf Text und Labels kostet also 2 Einheiten. Für eine reine OCR-Workload ist ein einzelner TEXT_DETECTION-Aufruf eine Einheit. Bei 100.000 Seiten pro Monat zahlen Sie $150.
Wenn Sie strukturierte Extraktion benötigen (Rechnungen, Formulare, Tabellen), reicht die Vision API allein nicht aus. Sie benötigen Document AI, wo der Enterprise Document OCR Processor $1,50 pro 1.000 Seiten kostet, spezialisierte Prozessoren wie Invoice Parser oder Form Parser jedoch $10-$30 pro 1.000 Seiten.
Preise für AWS Textract
Textract rechnet pro Seite ab, aber der Satz hängt vollständig davon ab, welche API Sie aufrufen. DetectDocumentText (Basis-OCR) kostet für die erste Million Seiten $1,50 pro 1.000 Seiten – derselbe Preis wie die Basisversion von Google. Über eine Million Seiten sinkt der Preis auf $0,60 pro 1.000. Der Unterschied zeigt sich, wenn Sie strukturierte Daten benötigen: AnalyzeDocument mit Forms kostet $50 pro 1.000 Seiten, Tables kostet $15 pro 1.000 und Queries ebenfalls $15 pro 1.000. Kombinieren Sie alle drei, zahlen Sie $65 pro 1.000 Seiten.
Mengenrabatte gelten oberhalb von einer Million Seiten pro Monat, aber unterhalb dieser Schwelle summieren sich die Kosten schnell. Ein Entwickler, der den Basis-OCR-Preis von Textract ($0,0015/Seite) zitiert und ein Budget aufgestellt hatte, stellte fest, dass die tatsächlich benötigten Forms- und Tables-Funktionen 30-40x mehr kosteten. Das ist die häufigste Preisüberraschung bei Textract.
Preise für Azure Document Intelligence
Azure unterteilt seine Angebote in die Stufen Read, Layout, Prebuilt und Custom. Das Read-Modell (nur OCR) kostet etwa $1,50 pro 1.000 Seiten. Layout- und Prebuilt-Modelle (Rechnung, Beleg, Ausweis, W-2 usw.) kosten ungefähr $10 pro 1.000 Seiten. Benutzerdefinierte Extraktionsmodelle kosten rund $50 pro 1.000 Seiten nach kostenlosem Training mit bis zu 500 Dokumenten. Zusatzfunktionen wie Abfragefelder und Formelextraktion schlagen einen Aufschlag von 20–30 % auf die Basiskosten des Modells auf.
Wo Azure preislich punktet, ist die Prebuilt-Modell-Stufe: $10 pro 1.000 Seiten für Rechnungs- und Belegextraktion gegenüber $50 pro 1.000 Seiten bei Textract für Formulare. Dieser 5-fache Unterschied macht sich im großen Maßstab bemerkbar. Ein Team, das 50.000 Rechnungen pro Monat verarbeitet, zahlt $500 mit Azure-Prebuilt-Modellen gegenüber $2.500 mit der Forms-API von Textract.
Preis-Fazit
Für reine OCR-Workloads sind alle drei praktisch gleichauf bei $1,50 pro 1.000 Seiten. Die Unterschiede zeigen sich, wenn Sie strukturierte Extraktion benötigen. Die Prebuilt-Modelle von Azure sind der günstigste Weg zur Rechnungs- und Belegverarbeitung. Die Kombinationspreise von Textract bestrafen Teams, die Formulare + Tabellen + Abfragen gleichzeitig benötigen. Google Document AI liegt in der Mitte, erfordert jedoch die Migration von der Vision API zu einer anderen Produktstufe.
Dimension 2: Dokumentfunktionen – Tabellen, Formulare, Handschrift und Sprachen
Die reine OCR-Genauigkeit bei sauberem gedrucktem Text ist Grundvoraussetzung – jede Cloud-API übertrifft 94 % bei getippten Dokumenten. Die wirklichen Unterscheidungsmerkmale sind die Dokumenttypen, die sie gut verarbeiten, und die, bei denen sie es nicht tun.
Tabellen und Formulare
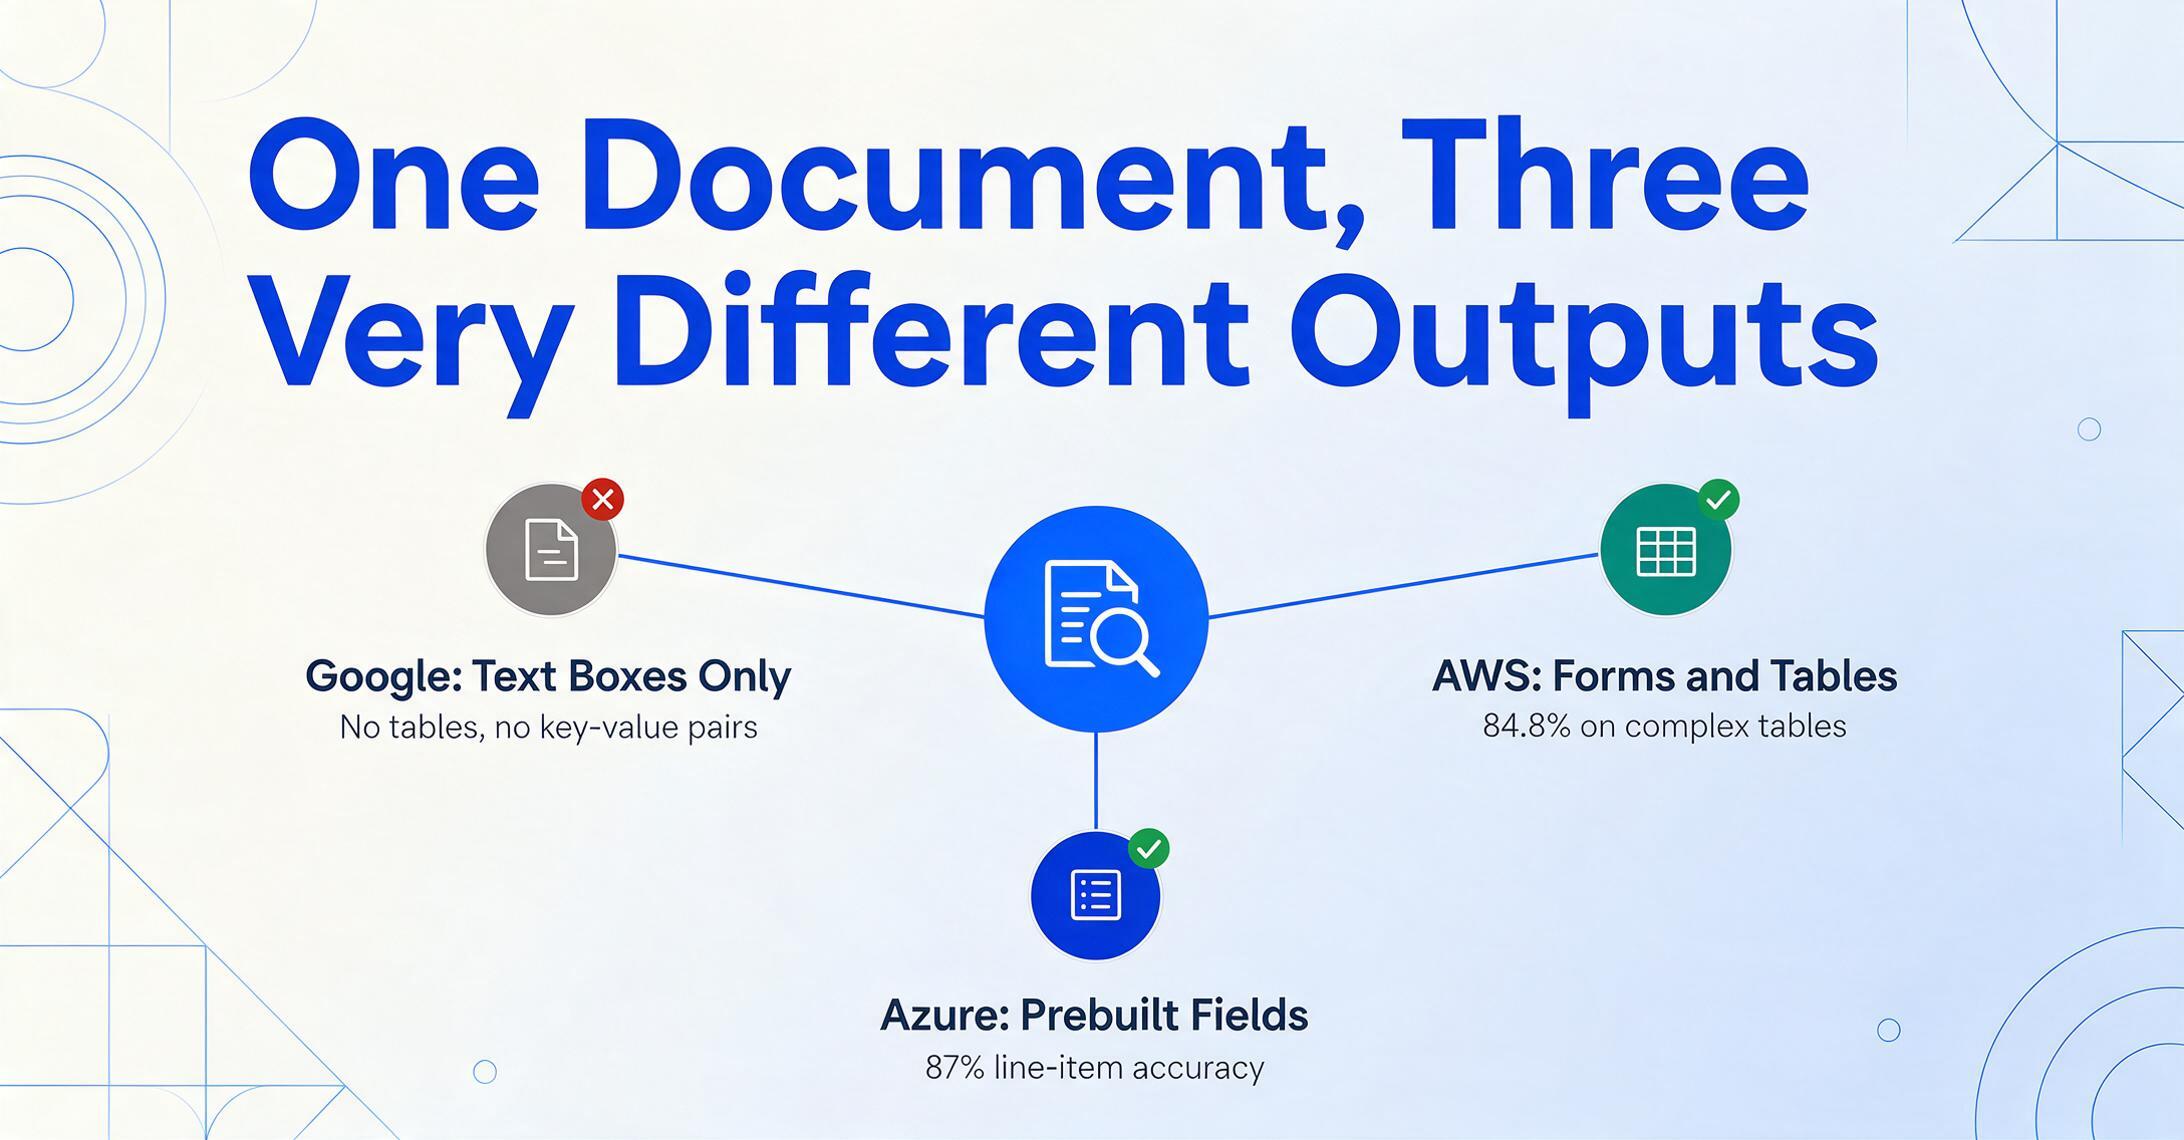
In dieser Dimension unterscheiden sich die drei APIs am stärksten. Google Cloud Vision (das Basis-OCR-Produkt) extrahiert keine Tabellen oder Schlüssel-Wert-Paare. Es liefert Begrenzungsrahmen um erkannten Text mit einer strukturellen Hierarchie – Seite, Block, Absatz, Wort –, aber kein Verständnis von Tabellenzellen oder Formularfeldern. Wenn Sie Tabellenextraktion in Google Cloud benötigen, müssen Sie den Layout-Parser von Document AI ($10 pro 1.000 Seiten) oder einen benutzerdefinierten Prozessor verwenden.
Die AnalyzeDocument-API von AWS Textract verfügt über dedizierte Funktionen für Formulare und Tabellen. Formulare liefern Schlüssel-Wert-Paare (Bezeichnung: Wert) mit Konfidenzwerten. Tabellen liefern Daten auf Zellenebene mit Zeilen-/Spaltenindizes und Behandlung zusammengeführter Zellen. Unabhängige Benchmarks zeigen, dass Textract bei komplexer Tabellenextraktion eine Genauigkeit von etwa 84,8 % erreicht, wobei die Ergebnisse je nach Dokumentqualität erheblich variieren.
Das Layout-Modell von Azure Document Intelligence verarbeitet Tabellen und Auswahlmarkierungen nativ, und das vorgefertigte Rechnungsmodell gibt strukturierte Felder einschließlich Positionspositionen aus – was die meisten Teams, die Rechnungspipelines erstellen, tatsächlich benötigen. Benchmark-Daten zeigen, dass Azure bei der Extraktion von Positionspositionen eine Genauigkeit von 87 % erreicht und damit bei dieser spezifischen Aufgabe leicht vor beiden Wettbewerbern liegt.
Handschrift
Google Cloud Vision unterstützt Handschrift über die Funktion DOCUMENT_TEXT_DETECTION und erfasst gedruckten und handschriftlichen Text in einem einzigen Aufruf. Die Genauigkeit bei sauberer Handschrift ist wettbewerbsfähig, nimmt jedoch bei Kursivschrift oder Scans mit geringem Kontrast deutlich ab.
AWS Textract hat die Handschrifterkennung 2022 hinzugefügt, sie ist jedoch auf englische Dokumente beschränkt und die Genauigkeit ist deutlich geringer als bei gedrucktem Text. Die AWS-Dokumentation selbst empfiehlt mindestens 150 DPI und eine aufrechte Textausrichtung für beste Ergebnisse. Bei handschriftlastigen Dokumenten exportieren viele Teams die Textract-Ausgabe zur Bereinigung an ein nachgelagertes LLM – ein Muster, das häufig auf Stack Overflow und AWS re:Post zu sehen ist.
Azure Document Intelligence unterstützt Handschrift in neun Sprachen, darunter Englisch, Französisch, Deutsch, Italienisch, Japanisch, Koreanisch, Portugiesisch, Spanisch und vereinfachtes Chinesisch. Benchmark-Daten ordnen die Genauigkeit von Azure bei gemischten gedruckten/handschriftlichen Dokumenten über der von Textract ein, obwohl die reine Handschrifterkennung weiterhin hinter spezialisierten VLM-Lösungen zurückbleibt.
Sprachunterstützung
Google Cloud Vision führt hier mit Unterstützung für über 200 Sprachen bei gedrucktem Text und über 50 bei Handschrift. Azure Document Intelligence unterstützt über 100 Sprachen bei gedrucktem Text und 9 bei Handschrift. AWS Textract liegt mit nur sechs Sprachen für gedruckten Text (Englisch, Spanisch, Deutsch, Italienisch, Französisch und Portugiesisch) und nur Englisch für Handschrift deutlich zurück. Wenn Ihre Dokumenten-Pipeline Rechnungen von japanischen Lieferanten oder Verträge auf Arabisch verarbeitet, ist Textract ohne eine separate Übersetzungsebene praktisch unbrauchbar.
Dimension 3: Integration – SDK-Qualität, Ökosystem und Dokumentation
Dies ist die Dimension, die die meisten Vergleichsartikel auslassen, aber sie entscheidet darüber, ob Ihr Team in zwei Wochen oder zwei Monaten liefert.
Google Cloud Integration
Das Python-SDK von Google ist gut gestaltet – die Bibliothek google-cloud-vision ist konsistent mit anderen Google-Cloud-Client-Bibliotheken, und die API-Referenz ist gründlich. Die Vision API unterstützt den direkten Bild-Upload, Base64-Kodierung und Cloud-Storage-URIs, wobei Cloud Storage mit etwa 25 % schneller als Base64 die schnellste Option ist. Die Netzwerkinfrastruktur von Google Cloud – die auf derselben privaten Glasfaser läuft, die auch Search und YouTube betreibt – bietet 15–25 % geringere Cross-Region-Latenz als die Standard-Netzwerktarife von AWS oder Azure.
Der Nachteil: Die Produktbenennung von Google verursacht Verwirrung. Ein Entwickler, der nach „Google Cloud OCR“ sucht, findet Cloud Vision, Document AI und das veraltete OCR On-Prem (im September 2025 eingestellt). Die Wahl des falschen Produkts bedeutet, dass die Extraktionsebene später neu aufgebaut werden muss. Die Vision API liefert Text mit Koordinaten. Document AI liefert strukturierte Felder. Die Lücke dazwischen ist ein vollständiges Engineering-Projekt.
AWS Integration
Der stärkste Integrationsvorteil von Textract ist der native Zugriff über das AWS-SDK in jeder gängigen Sprache. Wenn Ihre Pipeline bereits S3 für die Dokumentspeicherung, Lambda für die serverlose Verarbeitung und Step Functions für die Orchestrierung verwendet, lässt sich Textract ohne Cross-Cloud-Konfiguration integrieren. Das boto3-SDK ist ausgereift, gut dokumentiert und konsistent mit dem allgemeinen AWS-API-Muster.
Häufige Beschwerden auf Stack Overflow umfassen jedoch: die Paginierung, die manuelles NextToken-Tracking erfordert, ein Soft-Limit von 100 gleichzeitigen Jobs, das für Pipelines mit hohem Volumen eine Erhöhung des Kontingents erfordert, und die Notwendigkeit, benutzerdefinierte Nachbearbeitung zu erstellen, um die Tabellenstruktur aus dem blockbasierten Antwort-JSON von Textract zu rekonstruieren. Ein Stack-Overflow-Thread stellt fest, dass Textract das Dokument im reinen OCR-Modus „jeglicher Struktur wie tabellarischer Informationen beraubt“, sodass Entwickler die Struktur selbst neu ableiten müssen.
Azure-Integration
Azure Document Intelligence profitiert vom breiteren Microsoft-Ökosystem. SDKs sind für Python, C#, Java und JavaScript mit vollständiger Async-Unterstützung verfügbar. Für Low-Code-Teams ermöglichen Power Automate-Konnektoren Dokumentenverarbeitungs-Workflows ohne jeglichen benutzerdefinierten Code – ein erheblicher Vorteil für Organisationen, die bereits Microsoft 365 und Power Platform nutzen.
Das Document Intelligence Studio liefert während des Testens sofortige Genauigkeitsmetriken und Feldgenauigkeits-Scores, was die Feedback-Schleife während der Pilotbewertung verkürzt. Ein r/AZURE-Nutzer, der etwa 2,6 Millionen Seiten in einem Burst verarbeitete, berichtete, dass der Dienst ohne Probleme in etwa 12 Stunden skalierte, wobei Vorauszahlungsrabatte die Kosten des ersten Monats senkten. Die Azure-Dokumentation ist umfassend, aber über Foundry Tools, AI Services und veraltete Cognitive Services-Seiten verstreut – eine Umstrukturierung, die Entwickler bei der Ersteinrichtung frustriert.
Dimension 4: Genauigkeit – Was die Benchmarks tatsächlich aussagen
Cloud-OCR-Anbieter veröffentlichen Genauigkeitsangaben, aber unabhängige Benchmarks erzählen eine differenziertere Geschichte. Der DeltOCR Bench (November 2025) bewertete führende OCR-Dienste bei gemischten Dokumenttypen und ermittelte die folgenden Genauigkeitswerte für gedruckten Text:
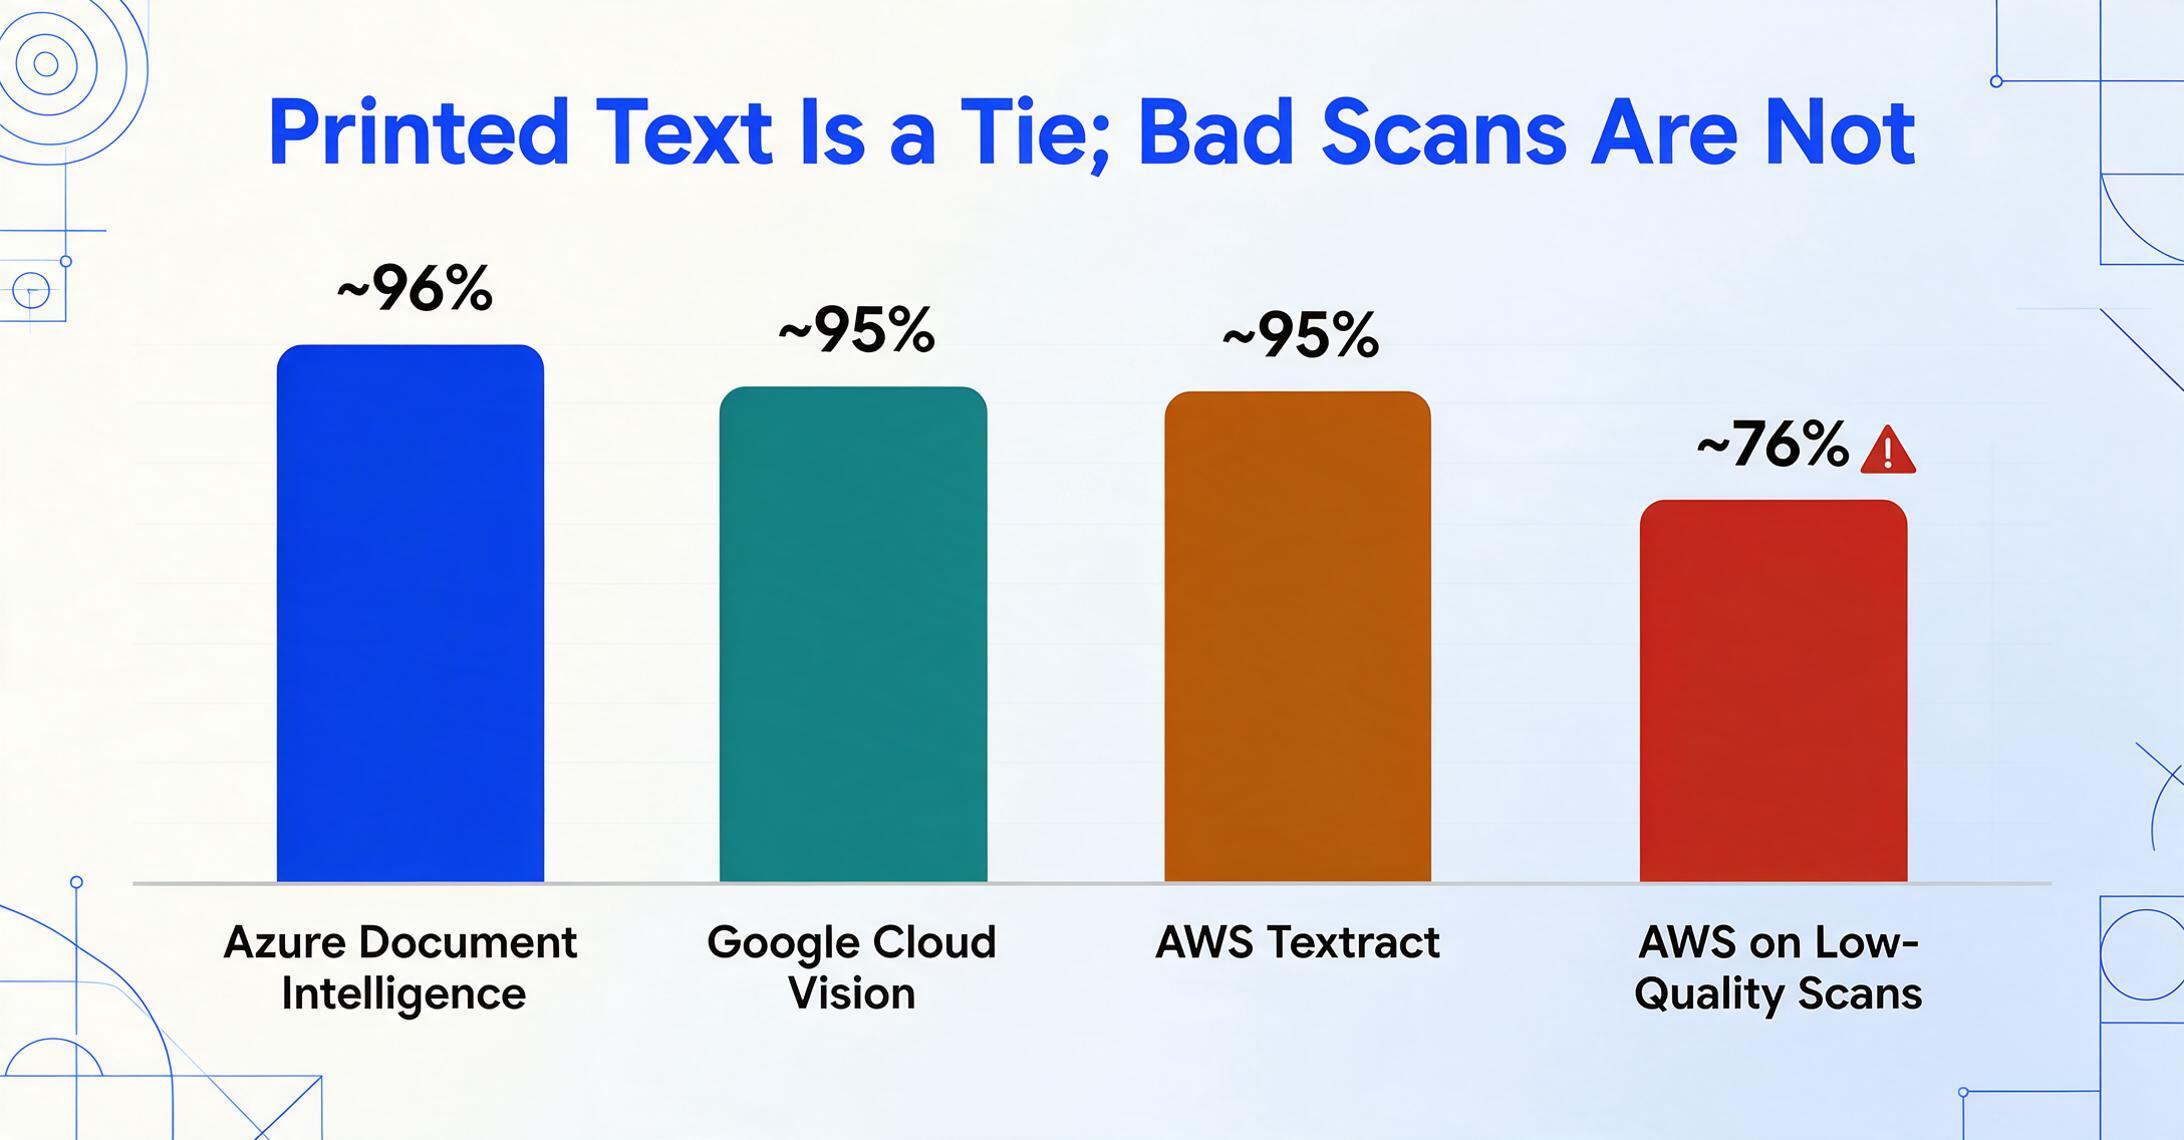
- Azure Document Intelligence: ~96 % – höchste Genauigkeit bei gedrucktem Text der drei, besonders stark bei Standardformularen und sauberen Dokumenten
- Google Cloud Vision: ~95 % – im Wesentlichen gleichauf mit Textract bei gedrucktem Text, mit etwas besserer Leistung bei dichten Dokumentseiten
- AWS Textract: ~95 % – konkurrenzfähig bei getipptem Text, fällt aber bei minderwertigen Scans auf ~76 % ab (laut unabhängigen Tests)
Der BusinessWareTech 2025 Rechnungs-Extraktions-Benchmark testete die Feldgenauigkeit von fünf Tools und fand bei Finanzdokumenten größere Abweichungen:
- Azure Document Intelligence: 93 % Feldgenauigkeit bei Rechnungen
- Google Document AI: 82 % Feldgenauigkeit
- AWS Textract: 78 % Feldgenauigkeit
Was Sie aus diesen Zahlen mitnehmen sollten: Bei sauberen, getippten Dokumenten sind alle drei ausgezeichnet und die Genauigkeitsunterschiede sind für die meisten Anwendungsfälle marginal. Bei Rechnungen, komplexen Layouts und minderwertigen Scans wird die Kluft größer – und Azure schneidet in diesen schwierigeren Szenarien durchweg besser ab. Bei Handschrift bleiben alle drei hinter spezialisierten VLM-Lösungen zurück, obwohl Azure die breiteste Sprachabdeckung der drei bietet.
Ein Stack Overflow-Nutzer, der sowohl Google Vision als auch Tesseract testete, berichtete, dass „Google Vision eine Genauigkeit von 66,6 % erreichte“, während Tesseract bei seinem spezifischen Datensatz 82 % erzielte – eine Erinnerung daran, dass Genauigkeit dokumentabhängig ist und Benchmarks richtungsweisend, nicht absolut sind. Testen Sie immer mit Ihren eigenen Dokumenten.
Wichtige Erkenntnis
Der Genauigkeitsunterschied zwischen Cloud-OCR-APIs ist geringer als der Unterschied zwischen jeder Cloud-OCR-API und einem Ansatz mit visuellen Sprachmodellen. Bei komplexen Dokumenten erreichen multimodale LLMs (GPT-4o, Gemini, Claude) heute eine Feldgenauigkeit von 95–98 % – ein deutlicher Sprung gegenüber der Spanne von 78–93 % bei herkömmlichen Cloud-OCR-Diensten. Der Kompromiss sind Kosten und Latenz, aber die Richtung ist klar.
Wann Google Vision die bessere Wahl ist
Google Cloud Vision ist die richtige Wahl, wenn Sie bereits Workloads in Google Cloud ausführen und Ihren Bedarf als Allzweck-OCR und nicht als strukturierte Dokumentextraktion definieren. Die ersten 1.000 Einheiten pro Monat und Funktion sind kostenlos, was eine Evaluierung mit geringem Volumen ohne Kosten ermöglicht. Die Unterstützung von über 200 Sprachen ist unübertroffen – wenn Ihre Dokumente Japanisch, Arabisch, Hindi und europäische Sprachen umfassen, verarbeitet die Vision API sie in einem einzigen Aufruf.
Für Teams, die nur Text benötigen (keine Tabellen, keine Formulare), sind die $1,50 pro 1.000 Seiten der Vision API wettbewerbsfähig, und der Durchsatz ist ausgezeichnet – ein Benchmark aus dem Jahr 2026 bezeichnete sie als „Geschwindigkeitskönig“ für die reine OCR-Verarbeitung. Wenn Ihre Pipeline darin besteht, „Text aus 10.000 Bildern zu extrahieren und zu speichern“, ist die Vision API der schnellste und günstigste Weg in Google Cloud.
Aber seien Sie präzise, was Sie bewerten. Cloud Vision ist kein direkter Ersatz für Textract oder Document Intelligence. Wenn Sie eine strukturierte Extraktion benötigen – Rechnungen mit Positionen, Formulare mit Schlüssel-Wert-Paaren – verschiebt sich der Vergleich zu Google Document AI, das eine eigene Preisgestaltung und Lernkurve hat.
Wann AWS Textract die bessere Wahl ist
AWS Textract ist die natürliche Wahl, wenn Ihre gesamte Dokumenten-Pipeline bereits in AWS läuft. Wenn Sie Dokumente in S3 speichern, sie mit Lambda verarbeiten, mit Step Functions orchestrieren und Ergebnisse über Amazon A2I prüfen, integriert sich Textract ohne Cross-Cloud-Konfiguration – kein VPC-Peering, keine separaten API-Schlüssel, keine anderen IAM-Muster.
Die AnalyzeExpense-API von Textract ist speziell für die Rechnungs- und Belegextraktion konzipiert und gibt typisierte ExpenseDocument-Objekte mit Zusammenfassungsfeldern und Positionsgruppen zurück – ohne dass Sie eine Extraktionsebene über der rohen OCR-Ausgabe aufbauen müssen. Für Teams, die standardisierte Dokumenttypen (gleiche Anbieter, konsistente Layouts) in hohem Volumen (über 50.000 Seiten pro Monat) verarbeiten, machen die vorhersehbare Preisgestaltung pro Seite und Mengenrabatte von Textract die Kosten planbar.
Die Queries-Funktion – bei der Sie Fragen in natürlicher Sprache stellen können, z. B. „Wie hoch ist die Rechnungssumme?“ – ist wirklich nützlich, um bestimmte Felder zu extrahieren, ohne ein Schema aufzubauen. Allerdings summieren sich das Limit von 30 Abfragen pro Seite und die Kosten von $15 pro 1.000 Seiten für die Queries-Funktion. Und die Begrenzung auf sechs Sprachen ist eine harte Einschränkung für mehrsprachige Dokumenten-Pipelines.
Wann Azure Document Intelligence mehr Sinn ergibt
Azure Document Intelligence punktet in drei Bereichen: Umfang der vorgefertigten Modelle, Genauigkeit bei gedrucktem Text und Integration in das Microsoft-Ökosystem.
Wenn Ihr Unternehmen auf Microsoft 365 läuft, SharePoint für die Dokumentenspeicherung nutzt oder über Power Automate-Lizenzen verfügt, ist Document Intelligence die Option mit dem geringsten Integrationsaufwand. Die Bibliothek vorgefertigter Modelle deckt Rechnungen, Belege, Ausweisdokumente, W-2-Formulare, 1098-Steuerformulare, Krankenversicherungskarten, Verträge und Heiratsurkunden ab – mehr spezialisierte Prozessoren als Google oder AWS standardmäßig anbieten. Für Teams, die unterschiedliche Dokumenttypen verarbeiten, reduziert dies den Bedarf an individuellem Modelltraining.
Die unabhängigen Benchmark-Daten platzieren Azure bei der Genauigkeit bei gedrucktem Text durchgängig an der Spitze oder nahe der Spitze. Speziell bei der Rechnungsextraktion übertrifft Azures Feldgenauigkeit von 93 % Google (82 %) und AWS (78 %) mit deutlichem Abstand. Wenn Genauigkeit bei komplexen oder formatvariablen Dokumenten Ihr Hauptanliegen ist, ist Azure die stärkste Wahl unter den traditionellen Cloud-OCR-Diensten.
Azures Unterstützung für handschriftlichen Text in neun Sprachen verschafft ihm einen Vorteil gegenüber Textracts rein englischer Handschrifterkennung. Bei gemischten gedruckten/handschriftlichen Dokumenten wie medizinischen Aufnahmeformularen oder Feldinspektionsberichten verarbeitet Azure beides in einem einzigen Durchgang.
No-Code-Alternative: Wenn Sie gar keine OCR-Pipeline aufbauen möchten
Es gibt ein Szenario, das keiner der Cloud-OCR-Anbieter direkt adressiert: Sie benötigen Dokumentextraktion, sind aber kein cloud-natives Engineering-Team. Der Aufbau einer Pipeline rund um Vision API, Textract oder Document Intelligence erfordert – mindestens – das Schreiben von Code zum Hochladen von Dokumenten, Parsen von JSON-Antworten, Zuordnen von Feldern zu Ihrem Ausgabeschema und Behandeln von Fehlern. Selbst für erfahrene Teams ist dies ein mehrwöchiges Engineering-Projekt.
ImageToTable.ai schließt diese Lücke. Es gehört in eine andere Kategorie als die drei Cloud-OCR-APIs – KI-Datenextraktion statt OCR. Auf Vision-Sprachmodellen statt traditioneller OCR aufgebaut, versteht es Dokumente semantisch statt über Zeichenerkennung. Sie laden ein Dokument hoch, geben die gewünschten Spaltennamen ein (z. B. „Rechnungsnummer", „Fälligkeitsdatum", „Gesamtsumme"), und die KI findet jeden Wert anhand der Bedeutung – unabhängig davon, wo er auf der Seite erscheint oder mit welchem Anbieter-Layout Sie es zu tun haben.
Während die Cloud-OCR-APIs Ihnen Koordinaten und Konfidenzwerte liefern, die Sie selbst zu Antworten zusammensetzen müssen, liefert Ihnen ImageToTable.ai eine Tabelle. Es unterstützt Batch-Verarbeitung – 50 Rechnungen hochladen und eine Excel-Datei erhalten – berechnete Spalten, die Ergebnisse während der Extraktion berechnen (wie „Positionssumme = Menge × Einzelpreis"), sowie ein Google-Sheets-Add-on, das extrahierte Daten direkt in Ihre Tabelle schreibt – ohne jegliche API-Integration.
Wenn Sie als Engineering-Team Cloud-OCR-APIs evaluieren, ist ImageToTable.ai kein Ersatz – es ist ein anderes Werkzeug für einen anderen Nutzer. Wenn Ihre Organisation jedoch Dokumente zu extrahieren hat und kein dediziertes Integrationsteam, lohnt sich ein Test, bevor Sie sich auf eine Cloud-OCR-Pipeline festlegen, deren Aufbau Wochen dauern würde. Sehen Sie, wie es sich von traditioneller OCR im Vergleich zu KI-Extraktion unterscheidet. Und wenn Sie diese drei Cloud-APIs gegen den gesamten OCR-Markt abwägen möchten – Desktop-Tools, kostenlose Konverter und KI-Extraktions-Apps zusammen –, bietet unsere OCR-Software-Marktübersicht diesen umfassenderen Vergleich.
FAQ
Welche Cloud-OCR-API ist bei 10.000 Seiten pro Monat am günstigsten?
Für grundlegende OCR (nur Text) kosten alle drei ungefähr gleich viel – etwa $15 pro Monat bei 10.000 Seiten. Für strukturierte Extraktion (Rechnungen mit Positionen) sind Azures vorgefertigte Modelle mit $10 pro 1.000 Seiten am günstigsten, gefolgt von Google Document AI mit $10–$30 pro 1.000 Seiten, während AWS Textracts Kombination aus Forms + Tables mit $65 pro 1.000 Seiten am teuersten ist.
Welche API verarbeitet Handschrift am besten?
Keine der drei Cloud-OCR-APIs ist bei Handschrift führend – speziell entwickelte VLM-Lösungen wie GPT-5 (~95 %) und Mistral OCR 3 (~89 %) übertreffen sie alle bei isolierter Handschrift. Unter den dreien bietet Azure Document Intelligence die breiteste Sprachunterstützung für Handschrift (9 Sprachen). Google Vision verarbeitet englische Handschrift angemessen. AWS Textract unterstützt nur englische Handschrift mit deutlich geringerer Genauigkeit als gedruckten Text.
Kann ich diese APIs ohne Cloud-Konto nutzen?
Nein. Alle drei erfordern ein aktives Cloud-Abrechnungskonto. Google bietet $300 an Startguthaben für Neukunden. AWS bietet eine kostenlose Testphase von 3 Monaten (1.000 Seiten pro Monat für Textract). Azure bietet einen kostenlosen F0-Tarif mit 500 Seiten pro Monat. Keine davon funktioniert offline oder ohne registrierte Zahlungsmethode.
Welche API unterstützt die meisten Sprachen?
Google Cloud Vision führt mit über 200 Sprachen für gedruckten Text und über 50 für Handschrift. Azure Document Intelligence unterstützt über 100 Sprachen für gedruckten Text und 9 für Handschrift. AWS Textract unterstützt nur 6 Sprachen für gedruckten Text und ausschließlich Englisch für Handschrift – eine erhebliche Einschränkung für die Verarbeitung mehrsprachiger Dokumente.
Muss ich benutzerdefinierte Modelle trainieren?
Für Standarddokumenttypen (Rechnungen, Belege, W-2-Formulare, Ausweise) bieten alle drei vorgefertigte Modelle, die sofort einsatzbereit sind. Für benutzerdefinierte oder ungewöhnliche Dokumentformate unterstützen Azure und Google Document AI ein individuelles Training. AWS Textract unterstützt benutzerdefinierte Adapter, die mit Ihren eigenen Dokumenten trainiert werden (kostenlos zu trainieren, $25 pro 1.000 Seiten bei der Inferenz). Laut Herstellerangaben verbessert ein individuelles Training die Genauigkeit bei Ihrem spezifischen Dokumentformat in der Regel um 5-15 %.
Was ist der Unterschied zwischen Google Cloud Vision und Document AI?
Cloud Vision ist eine allgemeine Bildanalyse-API, die OCR als eine ihrer Funktionen umfasst. Sie liefert Text mit Begrenzungsrahmen und einer strukturellen Hierarchie (Seite → Block → Absatz → Wort). Document AI ist eine dokumentenspezifische Plattform mit spezialisierten Prozessoren für Rechnungen, Belege, Kontoauszüge und andere Dokumenttypen. Document AI liefert strukturierte Felder (z. B. „Rechnungssumme: $1.234,56") statt Rohtext. Cloud Vision ist die günstigere und schnellere Option für einfache OCR. Document AI ist die genauere Option für die strukturierte Dokumentextraktion. Eine ausführliche Erklärung, wie sich diese von der KI-Extraktion unterscheiden, finden Sie unter OCR vs. KI-Extraktion.
Ihr Cloud-Stack entscheidet
Google Cloud Vision, AWS Textract und Azure Document Intelligence sind jeweils die richtige Antwort für einen bestimmten Infrastrukturkontext. Wenn Sie Google Cloud nutzen und Text benötigen, verwenden Sie die Vision API. Wenn Sie AWS nutzen und eine strukturierte Rechnungsextraktion benötigen, verwenden Sie AnalyzeExpense von Textract. Wenn Sie Microsoft 365 nutzen und eine genaue vorgefertigte Extraktion über mehrere Dokumenttypen hinweg benötigen, verwenden Sie Document Intelligence.
Die Versuchung besteht darin, dies als Benchmark-Frage zu behandeln – welche API hat die höchste Genauigkeit? – und den Gewinner zu küren. Doch die Genauigkeitsunterschiede zwischen den drei Anbietern liegen bei sauberen, getippten Dokumenten innerhalb von 1-2 %. Der eigentliche Kostenunterschied liegt nicht in Cent pro Seite, sondern in den Ingenieursstunden, die für die Integration aufgewendet werden. Und diese Kosten werden fast vollständig davon bestimmt, wie gut die API in Ihre bestehende Infrastruktur passt.
Wenn Sie nicht an eine bestimmte Cloud gebunden sind und einfach Dokumentdaten extrahieren möchten, ohne Integrationscode zu schreiben, sollten Sie ein Tool in Betracht ziehen, das für diesen Anwendungsfall entwickelt wurde. Testen Sie ImageToTable.ai mit Ihren eigenen Dokumenten – keine SDK-Installation erforderlich.