無料OCR vs 有料OCR 2026
無料がサブスクリプションより高くつくとき
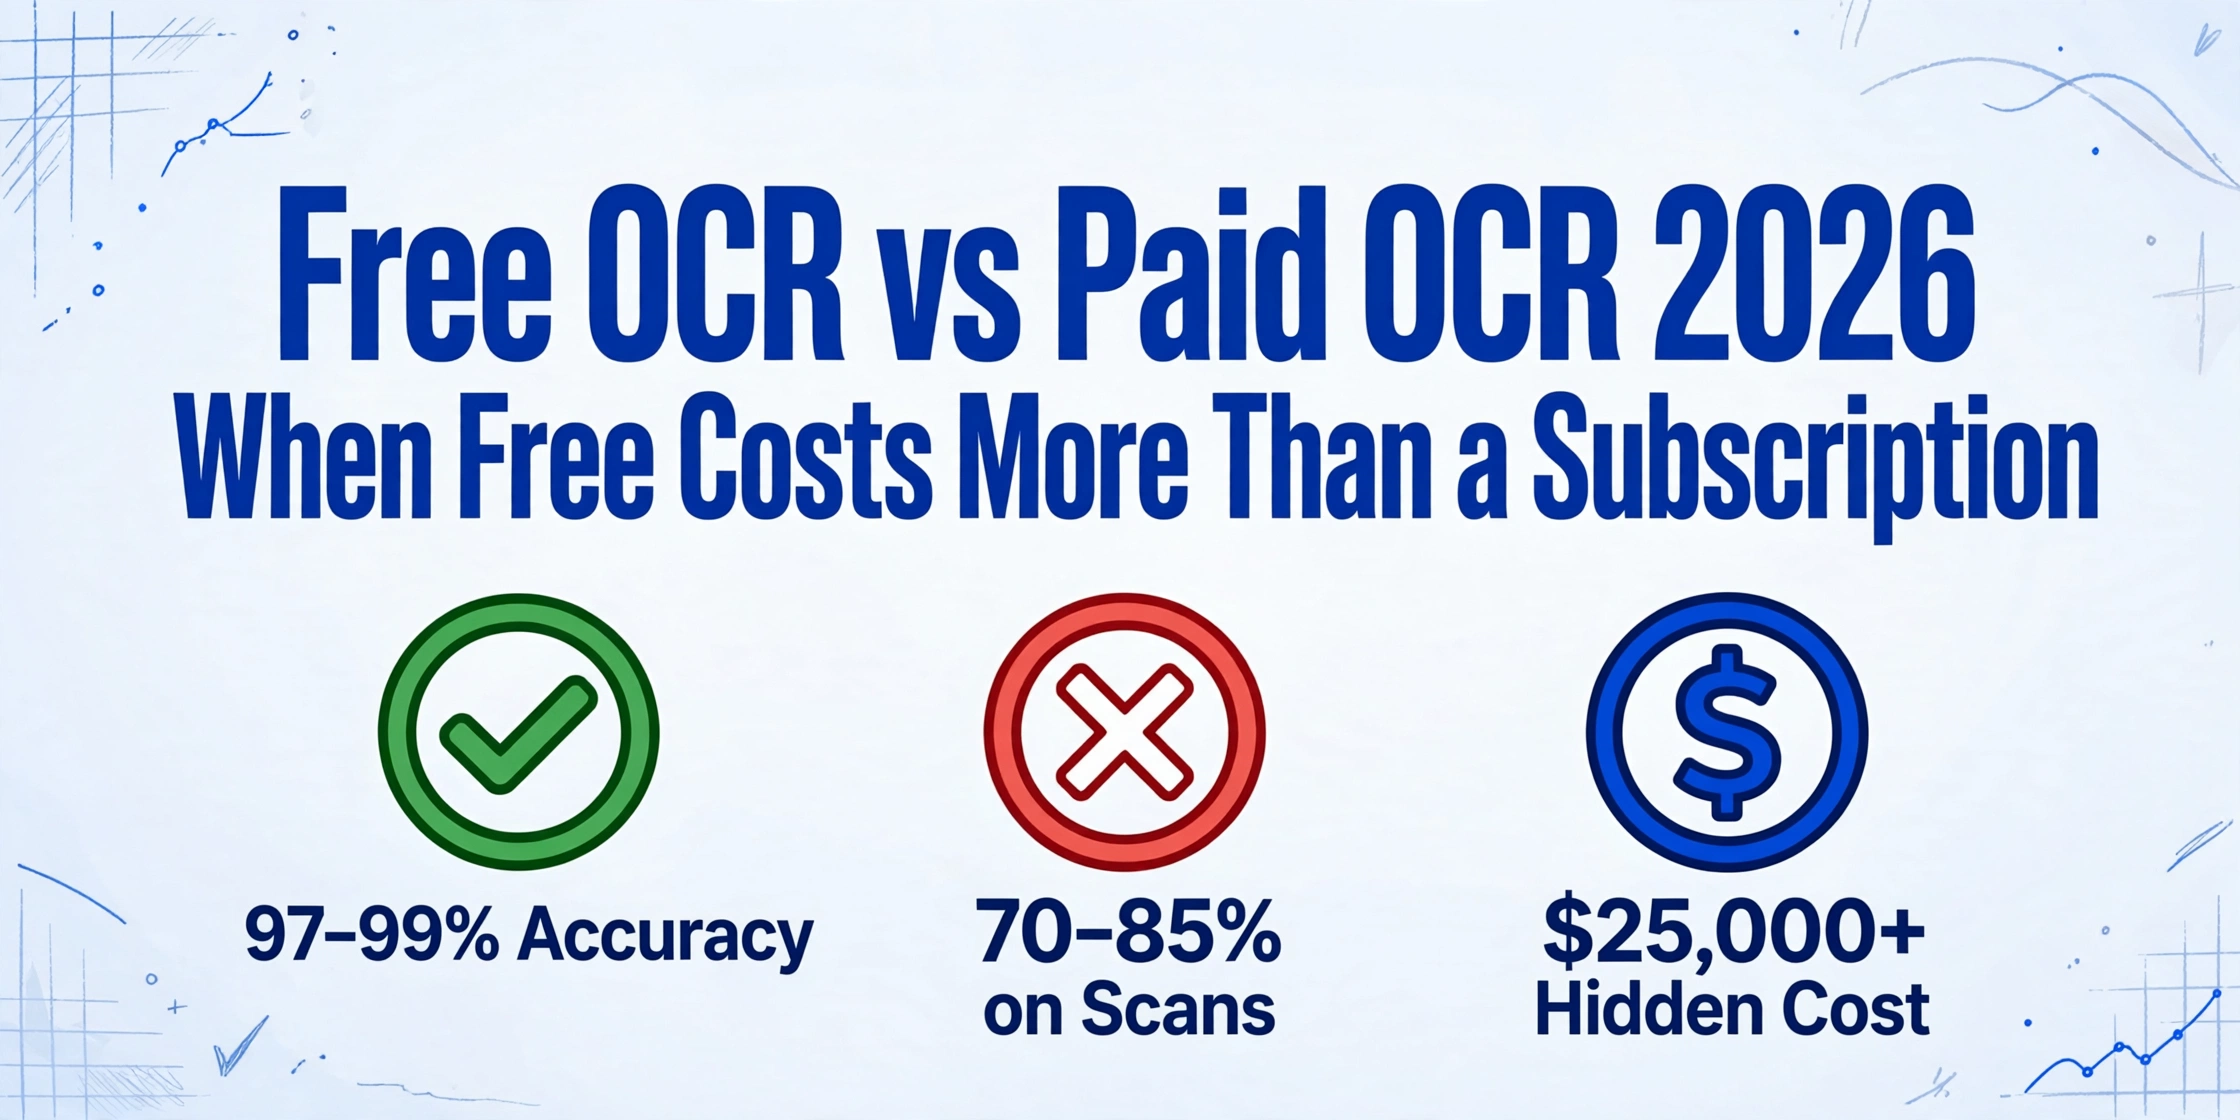
これは機能比較ではありません。月10件、月500件、月5,000件という3つの実際の文書ボリュームを用いた所有コスト分析です。問題は無料OCRが存在するかどうかではなく、「無料」に隠されたセットアップ時間、修正作業、メンテナンスが実際にはサブスクリプションよりも高くつくかどうかです。
重要なポイント
- $0は文書自動化において最も危険な価格帯です。なぜなら、コストをソフトウェア予算から人件費へ移すからです。
- 月額$20のサブスクリプションで、毎月15時間の手動修正が不要になります。その作業コストだけで、どんな妥当な時給でもライセンス費用を上回ります。
- 無料ツールと有料ツールを比較する際に注目すべき唯一の数字は、文書1件あたりの総コストです。セットアップ償却、修正作業、メンテナンス、ライセンスを合計し、ボリュームで割ります。
フレームワーク:OCRの総コスト
無料OCRと有料OCRの比較のほとんどは、ライセンス料金で止まっています。ライセンスが月額$0対$Xなら、無料の勝ちで、それで終わりです。しかし、この枠組みでは、OCRツールが実際にビジネスのコストを削減できるかどうかを左右するほとんどすべての要素が見落とされています。
光学文字認識(画像やスキャン文書内のテキストを機械可読データに変換する技術)は、認識ステップのみを構成します。実際に重要なのはパイプライン全体です。つまり、ツールに文書を取り込み、ツールが使用可能なデータを抽出し、誤りを修正し、必要な場所にデータをエクスポートすることです。無料ツールは、コストをライセンスからパイプラインの他のすべてのステップに移行させます。
この記事では、4つのコスト次元にわたってOCRの選択肢を評価します。
- セットアップコスト — ツールをワークフローにインストール、設定、統合するための時間
- 文書ごとの修正作業 — 抽出エラーの修正に費やす時間
- メンテナンスのオーバーヘッド — 文書形式の変更に伴い、パイプラインを稼働し続けるための労力
- ライセンスまたはサブスクリプション料金 — 初期費用または継続的な支払い
各コスト次元の重要度は、処理する文書数によって異なります。そのため、3つのボリュームレベルで計算を実行します。
クイック比較:2026年の無料OCRと有料OCR
2026年のOCR環境は、大きく3つのカテゴリに分かれます。TesseractやPaddleOCRのような無料のオープンソースツールはソフトウェアに費用はかかりませんが、技術的なセットアップが必要です。Google Cloud Vision、AWS Textract、Azure Document IntelligenceなどのクラウドAPIサービスは、セットアップ不要で1ページごとに料金がかかります。そして、最新のAI抽出APIは、定額制または1ページごとの料金で、テンプレート不要のセマンティック抽出を提供します。
| 項目 | 無料オープンソース(Tesseract、PaddleOCR) | クラウドAPI(Google、AWS、Azure) | フリーミアムAI抽出 |
|---|---|---|---|
| 精度 — クリーンなPDF | 95–99% | 99%以上 | 99%以上 |
| 精度 — スキャンまたは写真 | 70–85% | 97–99% | 95–99% |
| 導入コスト | エンジニアリング40〜80時間 | 2〜8時間(API統合) | 0〜1時間(アップロードするだけ) |
| テーブル/構造化エクスポート | 不十分 — カスタムコードが必要 | 良好 — 標準搭載 | 優れている — ネイティブExcel/Sheets |
| 手書き文字対応 | 非対応 | 一部対応 | ビジョンモデルで対応 |
| テンプレート不要の抽出 | カスタムトレーニングが必要 | レイアウト依存 | ネイティブ — セマンティック抽出 |
| メンテナンス | 継続的な開発時間が必要 | ベンダー管理 | ベンダー管理 |
| ライセンス費用 | $0 | $1.50/1,000ページ | 無料枠+月額約$10〜 |
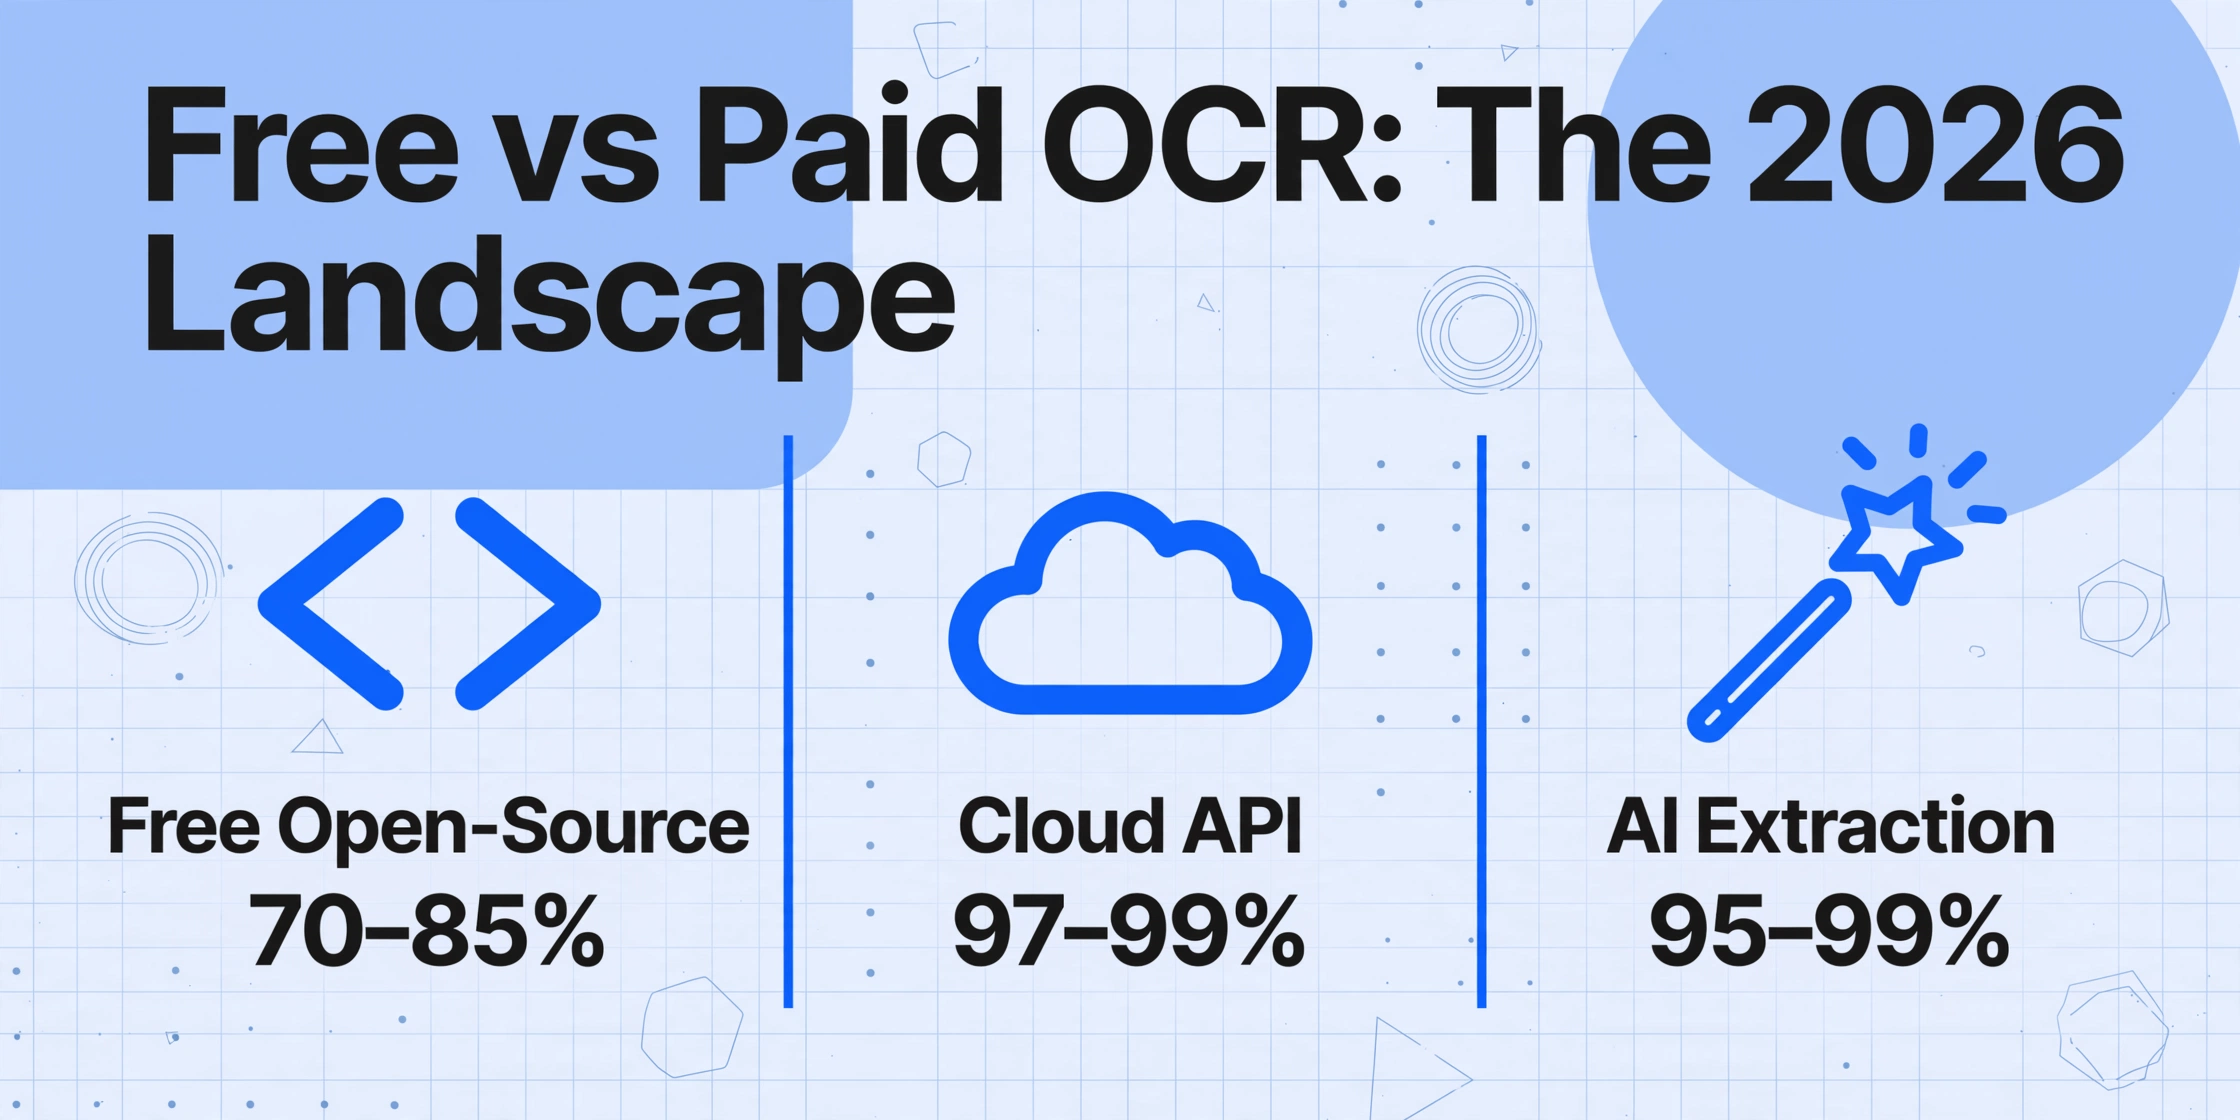
この表は、各カテゴリでできることを示しています。しかし重要なのは能力ではなく、その能力のギャップがあなたの特定のワークフローでどれだけのコストになるかです。
実際のコストの枠組み
これを具体的にするために、シンプルな計算式を使用します。
年間総コスト = ライセンス料 + 初期設定(3年間で償却) + 修正作業 + メンテナンス
適切に構築されたOCRパイプラインは、大規模な再構築が必要になるまで約3年間は持続するはずなので、初期設定は3年間で償却します。修正作業は、中小企業の文書処理を担当する正社員またはフリーランスのオペレーターの平均的なコストである、実効時間給$35/時間で計算されます。
以下の3つのシナリオは、OCRツールをワークフローに導入するユーザーとの会話に基づいて、実際に見られる最も一般的な文書量を表しています。
シナリオ1: 月10件の文書 — たまに使うユーザー
フリーランスの簿記係が、クライアントから月に10件の請求書PDFを受け取ります。文書はクリーンで、量も少なく、目的はクライアントの記録と照合するための基本的なテキスト抽出です。
| コスト項目 | 無料のオープンソース | クラウドAPI | フリーミアムAI抽出 |
|---|---|---|---|
| ライセンス / サブスクリプション | $0 | $0(無料枠内) | $0(無料枠で対応) |
| 初期設定(3年間償却) | $600~$900/年 | $0 | $0 |
| 修正作業 | 約$140~$210/年 | 約$35~$70/年 | 約$35~$70/年 |
| 年間総コスト | $740~$1,110 | $35~$70 | $35~$70 |
月10件の文書の場合、無料のオープンソースツールの初期設定コストが他のすべてを圧倒します。3年間で償却しても、開発者が本番パイプラインを構築するために必要な40~80時間により、「無料」オプションが最も高額になります。
たまに使うユーザーにとって賢明な選択は、無料のクラウドAPIティア(多くは月500~1,000ページ無料)または無料利用枠のあるフリーミアムツールを使用することです。どちらも、クリーンなPDFに対して初期設定なしで高い精度を提供します。オープンソースの道は、すでに技術インフラがあり、パイプラインがこの単一のユースケース以上の用途に役立つ場合にのみ意味があります。
シナリオ2:月500ドキュメント — 成長する中小企業
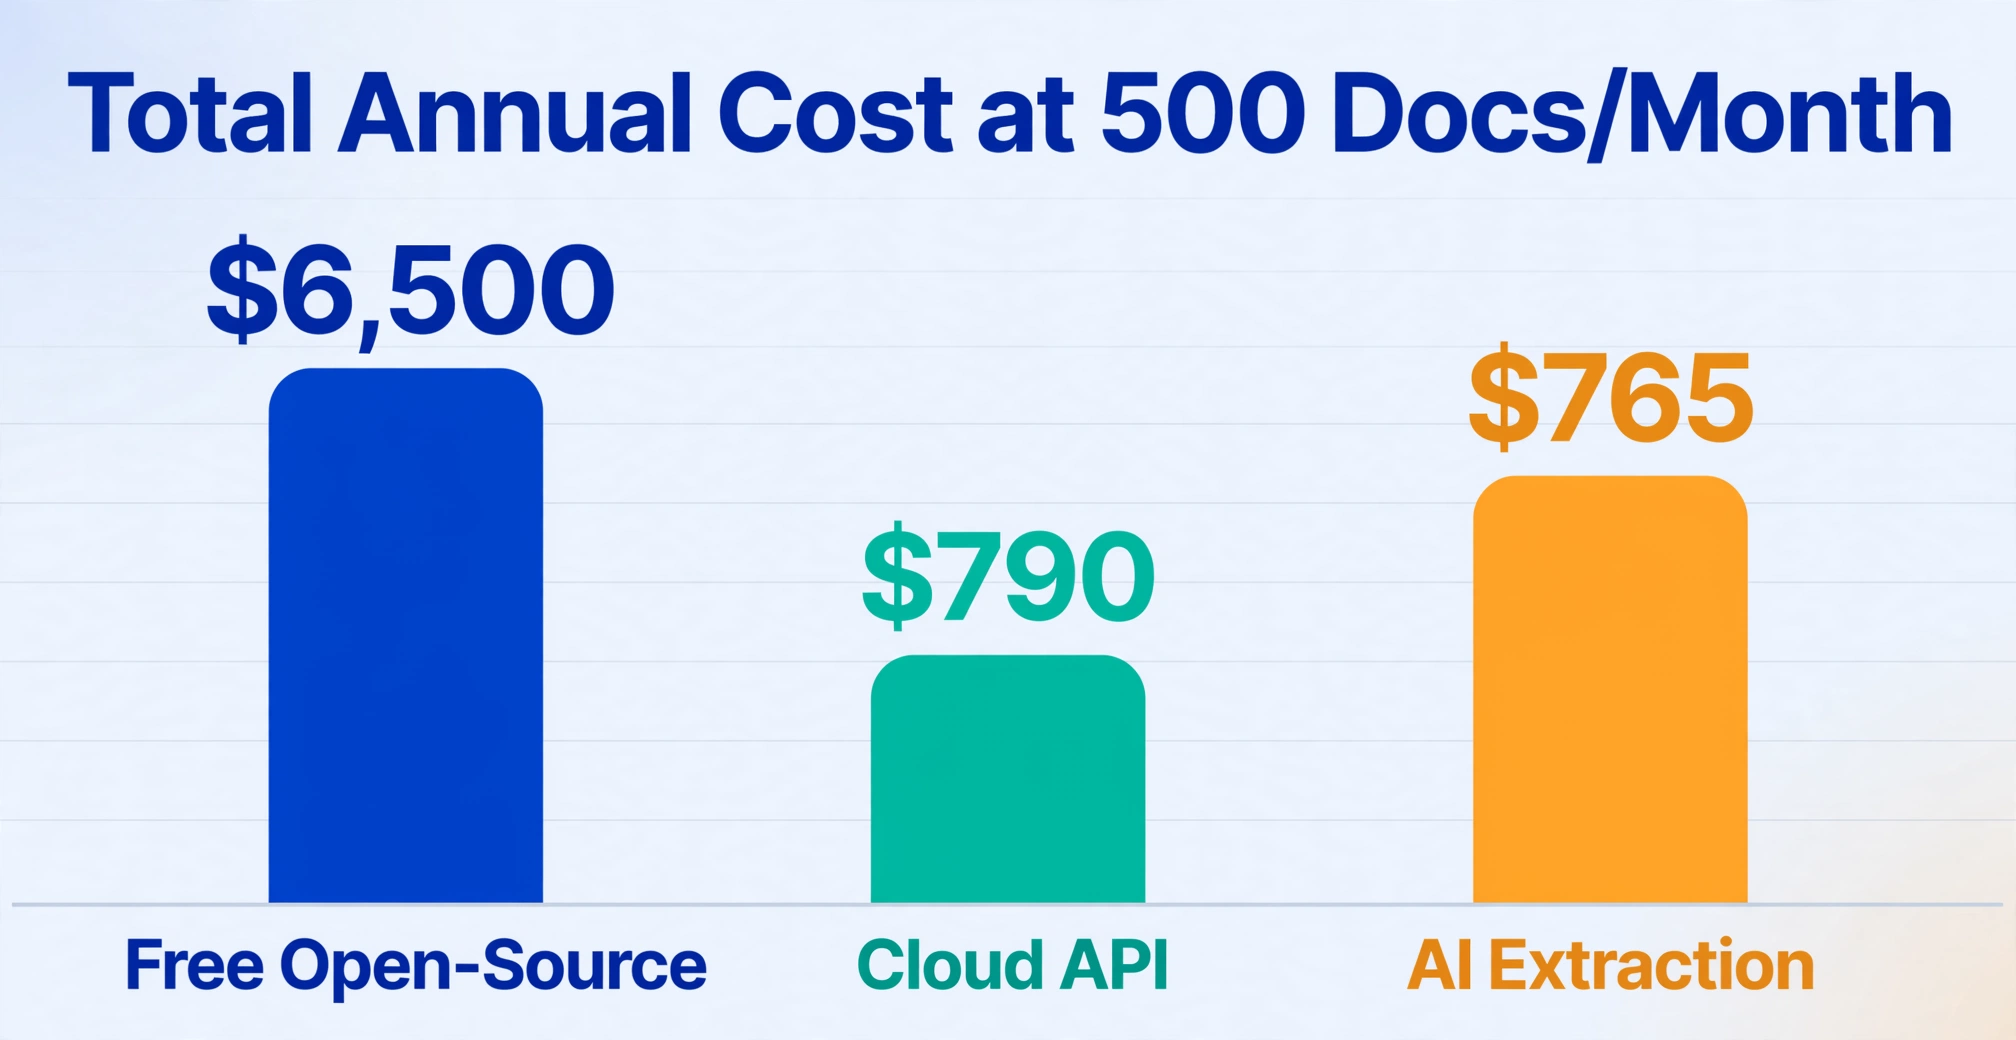
ある小規模建設下請け業者は、毎月500件の請求書と納品書を処理しています。ドキュメントは複数のベンダーから届き、クリーンなPDFとしてメールで送られるものもあれば、現場監督がスマートフォンで撮影したものもあります。フォーマットの不統一は例外ではなく、標準的な状態です。
| コスト項目 | 無料オープンソース | クラウドAPI | フリーミアムAI抽出 |
|---|---|---|---|
| ライセンス / サブスクリプション | $0 | 約$90/年 | 約$120–$240/年 |
| セットアップ(3年償却) | $600–$900/年 | $0 | $0 |
| 修正作業(推定) | 約$2,100–$4,200/年 | 約$350–$700/年 | 約$175–$525/年 |
| メンテナンス | 約$700–$1,400/年 | $0 | $0 |
| 年間総コスト | $3,400–$6,500 | $440–$790 | $295–$765 |
ここで経済性は決定的に逆転します。月500ドキュメントの処理量では、実際のスキャンにおける無料ツールの15~25%のエラー率による修正作業が、有料ツールに必要な予算全体よりも多くの時間を消費します。下請け業者の現場監督、またはパートタイムの管理者は、抽出ミスの修正に毎月20~40時間を費やしています。1時間あたりの複合コストが$35の場合、これは目に見えない労働として毎月$700~$1,400に相当します。
オープンソースのOCRツールは精度を向上させるように調整できますが、調整自体にも時間がかかります。パイプラインが較正された基準から逸脱する新しいベンダーフォーマットが現れるたびに、新たなエラーが発生します。無料の列にあるメンテナンス項目は理論上の話ではありません。サプライヤーが請求書のレイアウトを変更した際に、画像前処理パイプラインの更新、モデルの再トレーニング、後処理スクリプトの調整に費やされる開発者の時間を指しています。
クラウドAPIオプションはセットアップとメンテナンスを排除しますが、一貫性のないドキュメントレイアウトには依然として苦労する可能性があります。フリーミアムAI抽出カテゴリ — 視覚言語モデルを使用してドキュメント構造を位置的にではなく意味的に理解するツール — は、設定なしでフォーマットのばらつきを処理するため、修正作業の推定値が3つの中で最も低くなっています。
シナリオ3:月5,000件の文書 — 成長企業
中堅物流企業は毎月5,000件の文書を処理しています。発注書、納品書、配達確認書、そして数百社のサプライヤーからの請求書が混在しています。文書はあらゆる形式で届きます — メール添付のPDF、スキャンした複数ページのTIFF、倉庫の書類を撮影したスマートフォンの写真などです。
| コスト項目 | 無料オープンソース | クラウドAPI | フリーミアムAI抽出 |
|---|---|---|---|
| ライセンス/サブスクリプション | $0 | 約$900/年 | 約$600〜$2,400/年 |
| セットアップ(3年償却) | $600〜$900/年 | $0 | $0 |
| 修正作業(推定) | 約$21,000〜$42,000/年 | 約$3,500〜$7,000/年 | 約$1,750〜$3,500/年 |
| メンテナンス | 約$3,500〜$7,000/年 | $0 | $0 |
| 年間総コスト | $25,100〜$49,900 | $4,400〜$7,900 | $2,350〜$5,900 |
月5,000件の文書処理では、無料と有料のコスト差は桁違いになります。最も控えめな見積もりでも、無料オープンソースのルートは年間$25,000以上かかります — そのほぼ全額が修正作業とメンテナンスです。年収$35,000のデータ入力担当者1人で、このボリュームの修正作業の約25〜30%を処理できます(エラー率15〜20%を想定)。より現実的には、OCRエラーを修正するだけでフルタイム担当者が1〜2人必要です。この人件費だけで、すべての有料オプションを上回ります。
また、このボリュームではエラーの深刻度が最も重要になります。数週間気づかれずに経過した請求書金額の誤読 — $14,500が$74,500として認識される — は、会計システム全体での追跡と修正に2〜4時間かかる可能性があります(r/AccountingのRedditユーザーの指摘)。月5,000件の文書では、重大エラー率が1%でも、毎月50件のインシデントが発生することになります。
クラウドAPIやAI抽出ツールはすべてのエラーを排除するわけではありませんが、実在の文書に対する97〜99%の精度により、残りの修正は既存のチーム体制で対応可能です。有料サブスクリプションは、置き換える人件費と比較すれば誤差のようなものです。
「無料」OCRの隠れたコスト
ライセンス料はゼロ。しかし総コストはゼロではありません。価格ページには載らず、チームのタイムシートに現れるコストをご紹介します:
1. エンジニアリング設定時間
Tesseractのインストールは5分で完了します。しかし、実際のビジネス文書から信頼性の高い構造化出力を得るには数週間かかります。適切なページ分割モードの選択、OpenCVによる画像前処理(傾き補正、二値化、ノイズ除去)、生の出力をクリーンアップする後処理スクリプトの作成、OCRエンジンをデータベースやスプレッドシートに接続するパイプラインの構築が必要です。Tesseract GitHubリポジトリには、より良い結果を得るために画像品質を向上させる必要があると明記されています — その改善作業こそがエンジニアリング時間です。
本番パイプラインに40〜80時間かかり、フルロードで時給$70〜$100の開発者を想定すると、初期費用は$2,800〜$8,000になります — 1枚の文書も処理される前の話です。
2. エラー修正の労力
無料のOCRエンジンは、実際のビジネスワークフローで主流となるスキャン文書や写真に対して70〜85%の精度です。クリーンな機械印字PDFは例外であり、標準ではありません。抽出エラーが発生するたびに、人間が誤りを見つけ、確認し、修正する必要があります。規模が大きくなると、これが支配的なコストになります。
エラー修正の最も厄介な点は、それがコストとして認識されないことです。「OCRエラーの修正」に小切手を書く人はいません。それは、管理者が毎日1時間余分に費やし、簿記係がすべての入力を二重チェックし、買掛金担当者が残業するという形で現れます。しかし、それは実際のコストであり、ソフトウェア予算ではなく給与計算に表れます。
3. 継続的なメンテナンス
業務文書は変化します。サプライヤーが請求書のレイアウトを変更する。運送会社が新しい納品書フォーマットを導入する。ベンダーがデジタルファイルではなくスキャン画像のPDFを送り始める。こうした変更のたびに、パイプラインが更新されるまでOCRの精度が低下する可能性があります。誰かがこれらの精度低下を監視し、原因を調査し、前処理や後処理のロジックを調整する必要があります。その「誰か」はソフトウェアベンダーではありません。オープンソースツールにはベンダーが存在しないからです。
4. 不足機能の回避策
無料のOCRエンジンは手書き文字を処理できず、表を構造化された行に抽出できず、チェックボックスの意味を理解できず、署名や印鑑を認識できません。文書にこれらの要素が含まれている場合(ほとんどの業務文書に含まれています)、回避策を構築する必要があります。その回避策もまた、予算外のプロジェクトになります。
ここに、従来のOCRと現代のAI抽出の差が最も顕著に現れます。従来のOCRエンジンは認識ツールであり、ピクセルを文字に変換します。一方、AI OCRソフトウェアのような現代のツールは、文書構造を意味的に理解するビジョン言語モデルを使用します。ヘッダーとデータセルの違いを認識し、明示的な境界線がなくても表を識別し、テキストだけでなく意味を抽出します。
無料のOCRが適切な選択となる場合
無料のオープンソースOCRは罠ではありません。特定の状況では、実際に適切なツールです:
- カスタムパイプラインを構築する開発者で、社内にOCRの専門知識がある場合。TesseractやPaddleOCRの柔軟性により、あらゆるパラメータを調整し、スタックに深く統合できます。
- レイアウトが一貫したクリーンなデジタルPDFのみを処理する場合。標準フォントの機械印字テキストに対するTesseractの精度は99%に近づきます。
- 処理量が非常に少ない場合(月50ドキュメント未満)。このレベルでは、最適でない無料パイプラインでも、有料ツールの評価・導入にかかる認知的オーバーヘッドよりも総労働コストが低くなります。
- 厳格なデータ居住地要件やエアギャップ要件があり、文書をクラウドサービスに送信できない場合。セルフホストのオープンソースOCRが唯一の選択肢です。
- 研究やアーカイブのデジタル化を行っており、構造化データを必要とする業務プロセスに出力を供給しない場合。
これらのケースには共通点があります:セットアップとメンテナンスのコストを吸収できるエンジニアリングリソースをすでに持っているか、またはエラー修正が最小限で済むほど出力品質の要件が低いかのいずれかです。
有料OCRが実際に安くなるケース
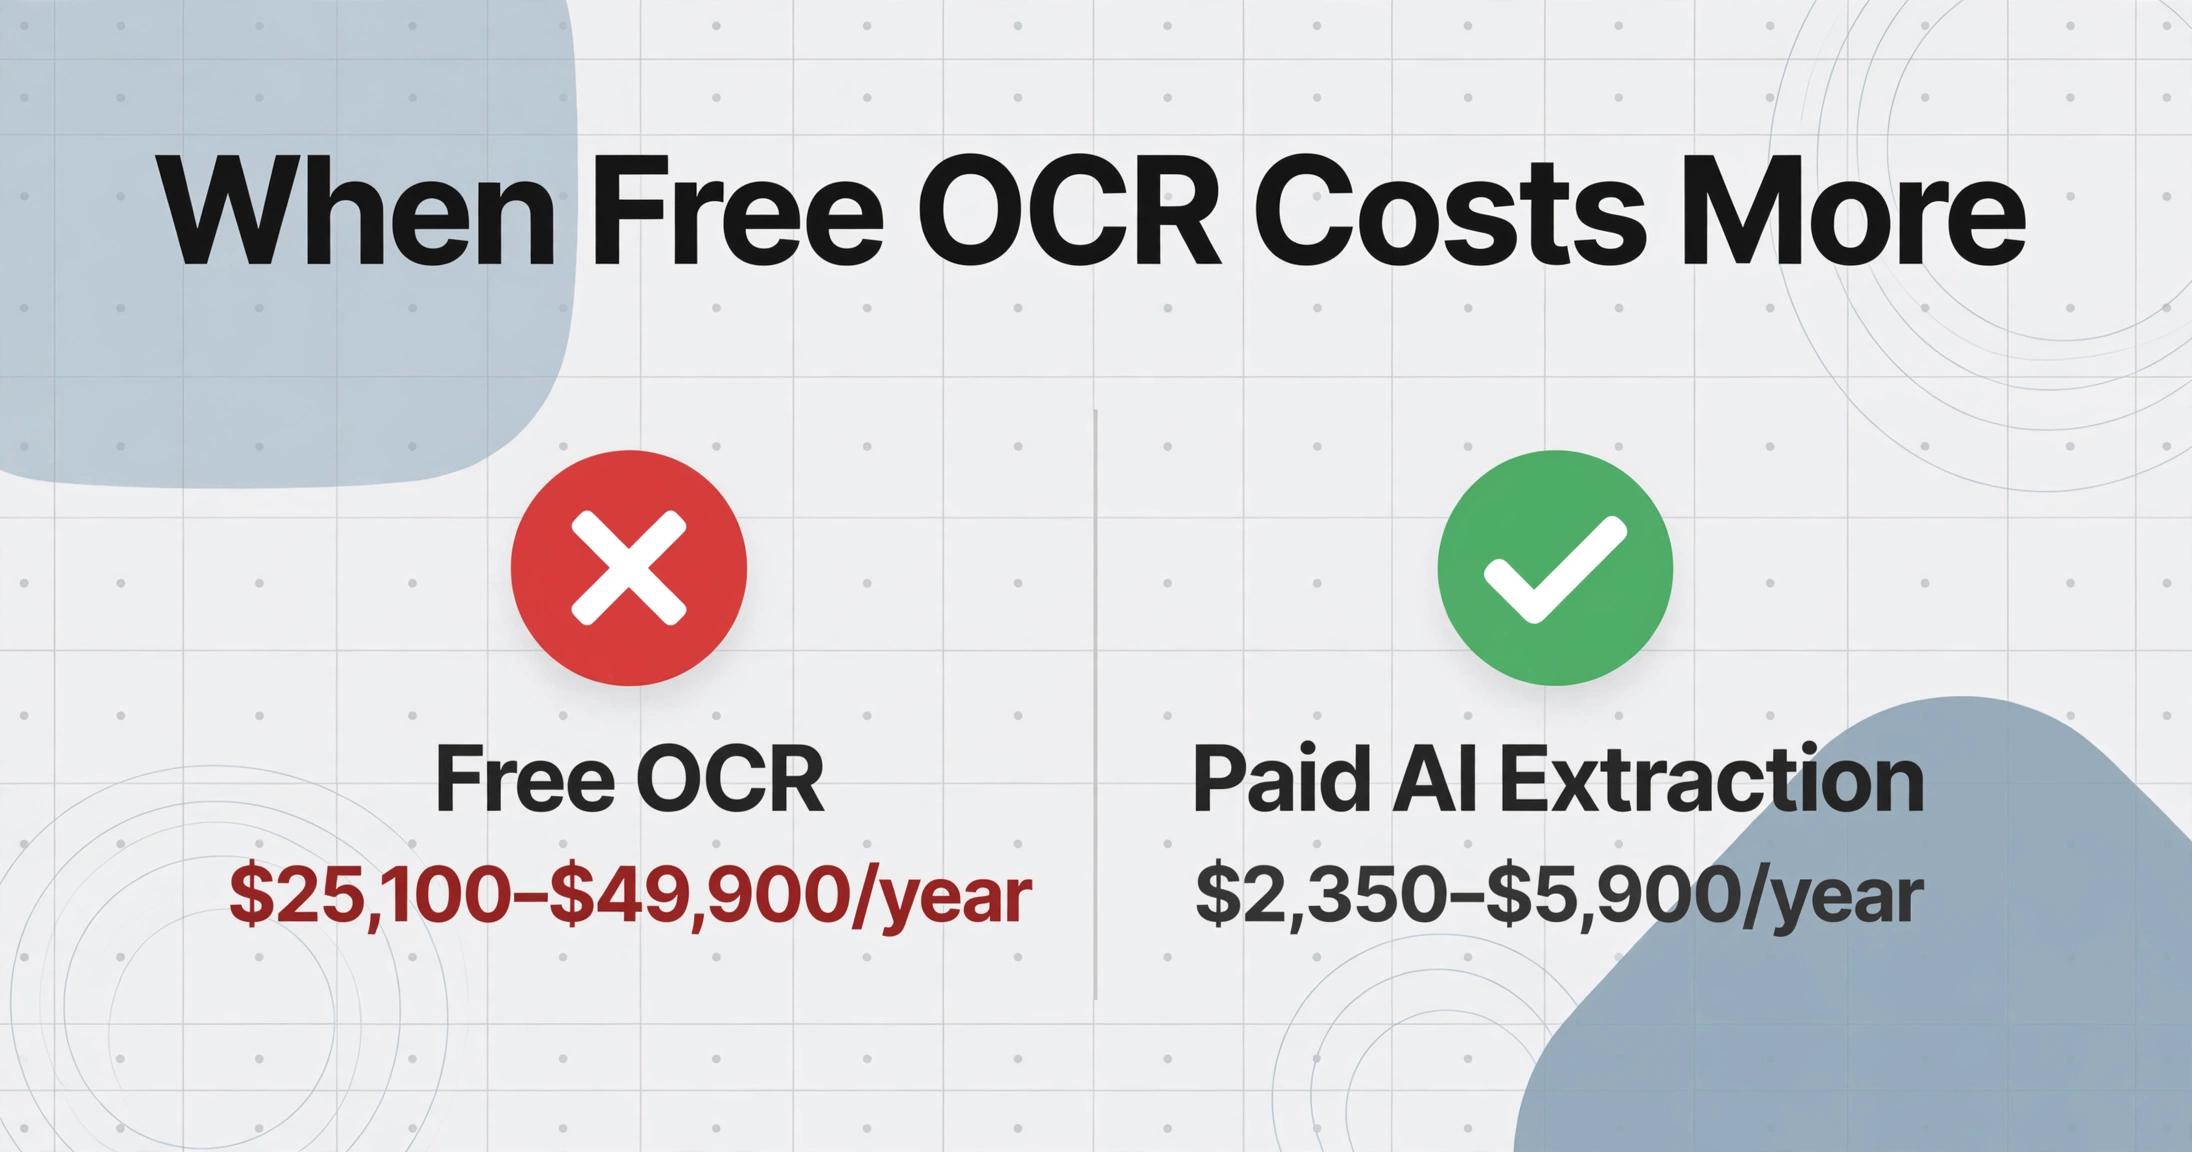
以下のいずれかに当てはまる場合、有料オプションの方が総コストで安くなる可能性が高いです:
- 毎月100件以上のドキュメントを処理している、しかも形式が異なる複数のソースから。このボリュームでの無料OCRによる修正作業は、すでにサブスクリプション費用を上回ります。
- ドキュメントにスキャン、写真、手書き文字が含まれている。非理想的な入力に対する無料OCRの精度は70〜85%に低下し、有料ツールの97〜99%との差はボリュームが増えるほど急速に広がります。
- 構造化データ出力が必要 — 生テキストではなく、特定の列を持つExcel行。オープンソースOCRの上にテーブル抽出を構築するのは、大規模なエンジニアリングプロジェクトです。
- 専任のエンジニアチームがいない。OCR設定を外部委託や「社内のITに詳しい人」に依存している場合、その人が去ると知識も失われます。
- 精度エラーがコンプライアンスや財務リスクを伴う。間違った請求書合計、誤読された税ID、配送伝票の誤った日付は、罰金、監査指摘、顧客トラブルにつながる可能性があります。
私たちが最もよく見かける間違いは、ライセンス費用だけを見積もることです。月額20ドルのサブスクリプションで15時間の手動修正が不要になれば、どんな妥当な時給でも元が取れます。ソフトウェアのコストが、それが置き換える労働力を上回ることはほぼありません。
これこそが最新のOCRソフトウェアが提供する核心です:単なる文字認識ではなく、最小限の人的介入でドキュメントから利用可能なデータへの完全なパイプライン。サブスクリプションが支払うのは認識ではなく、そのパイプラインなのです。
FAQ
2026年に無料のOCRは業務利用に十分な精度がありますか?
文書の品質によります。Tesseractなどの無料OCRは、標準フォントのきれいな機械印字PDFでは95〜99%の精度を達成します。しかし、実際の業務文書の大半を占めるスキャン文書、写真、非標準レイアウトでは、精度は70〜85%に低下します。そのレベルでは、4〜6枚に1枚の文書で、少なくとも1つの重大な抽出エラーが発生します。たまの個人利用であれば許容できるかもしれません。しかし、会計、在庫、コンプライアンスにデータを供給する業務プロセスでは、許容できないリスクと修正のオーバーヘッドが生じます。
無料のOCRツールで表をExcelに抽出できますか?
信頼性は高くありません。Tesseractなどのオープンソースエンジンは、生のテキストまたはhOCR(HTMLベースのOCR形式)を出力します。これらのエンジンはテーブル構造を理解しません。どのセルがどの行に属するか、列ヘッダーが下のデータに適用されるか、結合セルがどのように動作すべきかを認識しません。その出力を利用可能なExcelテーブルに変換するには、カスタム後処理コードが必要です。Google Document AIやAWS TextractなどのクラウドAPIには、これをネイティブに処理する専用のフォーム・テーブル抽出モデルがあります。フリーミアム層を備えた無料OCRツールの中には構造化出力を提供するものもありますが、無料層は通常、月間ページ数に制限があります。
無料のOCRパイプラインのセットアップにはどのくらい時間がかかりますか?
エンジンのインストールには数分かかります。実際の文書を確実に処理できる本番パイプラインの構築には、OCR経験のある開発者で40〜80時間かかり、経験がない場合はさらに時間がかかります。これには、画像前処理(傾き補正、二値化、ノイズ除去)、適切なページ分割モードの選択、出力をクリーンアップする後処理スクリプトの作成、文書取り込みワークフローの構築、エラーモニタリングの設定が含まれます。セットアップコストは、ほとんどの比較で無視されている無料OCRの最大の隠れたコストです。
無料のOCRは手書き文字を読み取れますか?
いいえ。TesseractとPaddleOCRは印刷文字の認識用に設計されています。手書き文字認識機能はありません。一部のクラウドAPIは限定的な手書き文字対応を提供していますが、信頼性の高い手書き文字抽出(特に筆記体や混在する手書き形式)には、手書き文書データセットで特別に訓練された最新のビジョン言語モデルが必要です。これは無料ツールが太刀打ちできない機能領域です。
有料OCRが無料より安くなるのはどのボリュームからですか?
当社のコストモデリングに基づくと、損益分岐点は月あたり約100〜150文書です。それ未満では、無料ツールの修正作業は十分に小さく、セットアップコスト(償却後)が支配的ですが、既にインフラをお持ちであれば正当化できます。月あたり150文書を超えると、無料ツールの精度低下による修正作業が、費やした時間を考慮すると一貫して有料代替品のサブスクリプション費用を上回ります。月あたり500文書以上では、その差は十分に大きく、有料オプションが明確に安価になります。
損益分岐点を見つける
計算はビジネスごとに異なります。実際の文書品質、受け取るフォーマット、必要な精度によって数字は変わります。どちらのオプションがコストを削減できるかを知る唯一の方法は、実際の文書でテストすることです。