OCR gratuito vs OCR de pago 2026
Cuando lo gratuito cuesta más que una suscripción
Esto no es una comparativa de funciones. Es un análisis de costo de propiedad con tres volúmenes reales de documentos: 10 al mes, 500 al mes y 5,000 al mes. La pregunta no es si existe el OCR gratuito, sino si el tiempo de configuración, el trabajo de corrección y el mantenimiento ocultos en lo «gratuito» cuestan realmente más que una suscripción.
Conclusiones clave
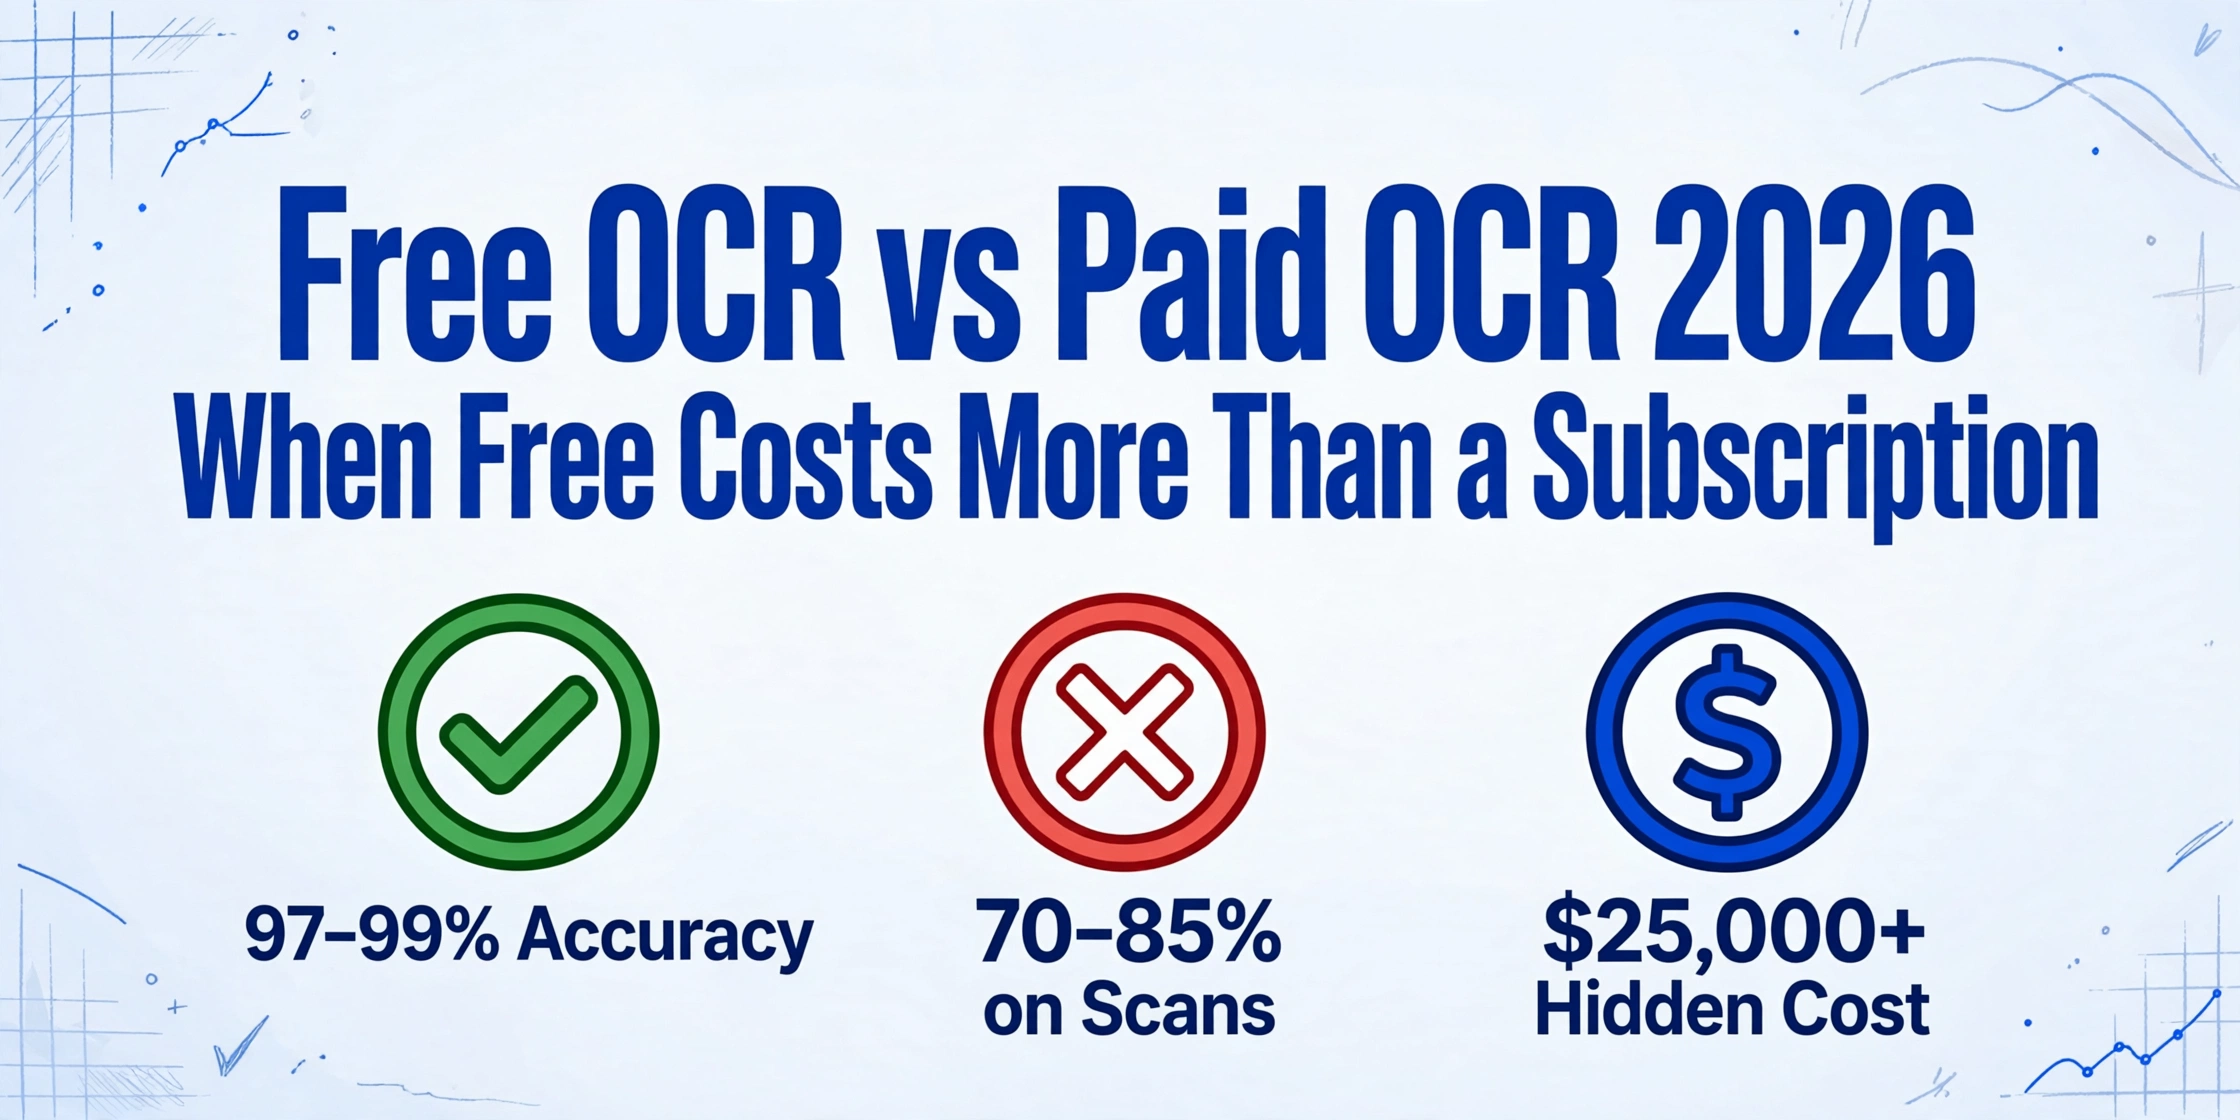
- $0 es el precio más peligroso en la automatización de documentos porque traslada el costo de tu partida de software a tu nómina.
- Una suscripción de $20 al mes elimina 15 horas de corrección manual al mes; solo la mano de obra cuesta más que la licencia a cualquier tarifa horaria razonable.
- El único número que merece la pena comparar entre herramientas gratuitas y de pago es el costo total por documento: suma la amortización de la configuración, el trabajo de corrección, el mantenimiento y la licencia, y divide por el volumen.
El Marco: Costo Total del OCR
La mayoría de las comparaciones entre OCR gratuito y de pago se detienen en la tarifa de licencia. Una licencia cuesta $0 frente a $X al mes, así que la opción gratuita gana, fin de la historia. Pero ese enfoque ignora casi todo lo que determina si una herramienta de OCR realmente le ahorra dinero a su empresa.
El reconocimiento óptico de caracteres — la tecnología que convierte texto en imágenes y documentos escaneados en datos legibles por máquina — comprende solo el paso de reconocimiento. Lo que importa en la práctica es el flujo completo: llevar el documento a la herramienta, hacer que la herramienta extraiga datos utilizables, corregir lo que falló y exportar esos datos donde los necesita. Las herramientas gratuitas trasladan el costo de la licencia a todos los demás pasos de ese flujo.
Este artículo evalúa las opciones de OCR en cuatro dimensiones de costo:
- Costo de configuración — tiempo para instalar, configurar e integrar la herramienta en un flujo de trabajo
- Trabajo de corrección por documento — tiempo dedicado a corregir errores de extracción
- Gastos generales de mantenimiento — esfuerzo para mantener el flujo en funcionamiento a medida que cambian los formatos de documentos
- Tarifa de licencia o suscripción — el pago inicial o recurrente
Cada dimensión de costo importa de manera diferente según cuántos documentos procese. Por eso calculamos los números en tres niveles de volumen.
Comparación rápida: OCR gratuito vs de pago en 2026
El panorama del OCR en 2026 se divide en tres grandes categorías. Las herramientas gratuitas de código abierto como Tesseract y PaddleOCR no cobran nada por el software, pero requieren configuración técnica. Los servicios de API en la nube como Google Cloud Vision, AWS Textract y Azure Document Intelligence cobran por página sin configuración. Y las API modernas de extracción con IA ofrecen extracción semántica sin plantilla a una tarifa plana de suscripción o por página.
| Dimensión | Código abierto gratuito (Tesseract, PaddleOCR) | API en la nube (Google, AWS, Azure) | Extracción de IA freemium |
|---|---|---|---|
| Precisión — PDF limpio | 95–99% | 99%+ | 99%+ |
| Precisión — escaneo o foto | 70–85% | 97–99% | 95–99% |
| Costo de configuración | 40–80 horas de ingeniería | 2–8 horas (integración de API) | 0–1 hora (subir y listo) |
| Exportación de tablas / estructurada | Deficiente — requiere código personalizado | Buena — integrada | Excelente — Excel / Sheets nativo |
| Soporte de escritura a mano | No compatible | Parcial | Compatible mediante modelos de visión |
| Extracción sin plantilla | Requiere entrenamiento personalizado | Depende del diseño | Nativa — extracción semántica |
| Mantenimiento | Tiempo de desarrollo continuo | Gestionado por el proveedor | Gestionado por el proveedor |
| Costo de licencia | $0 | $1.50 / 1,000 páginas | Plan gratuito + desde ~$10/mes |
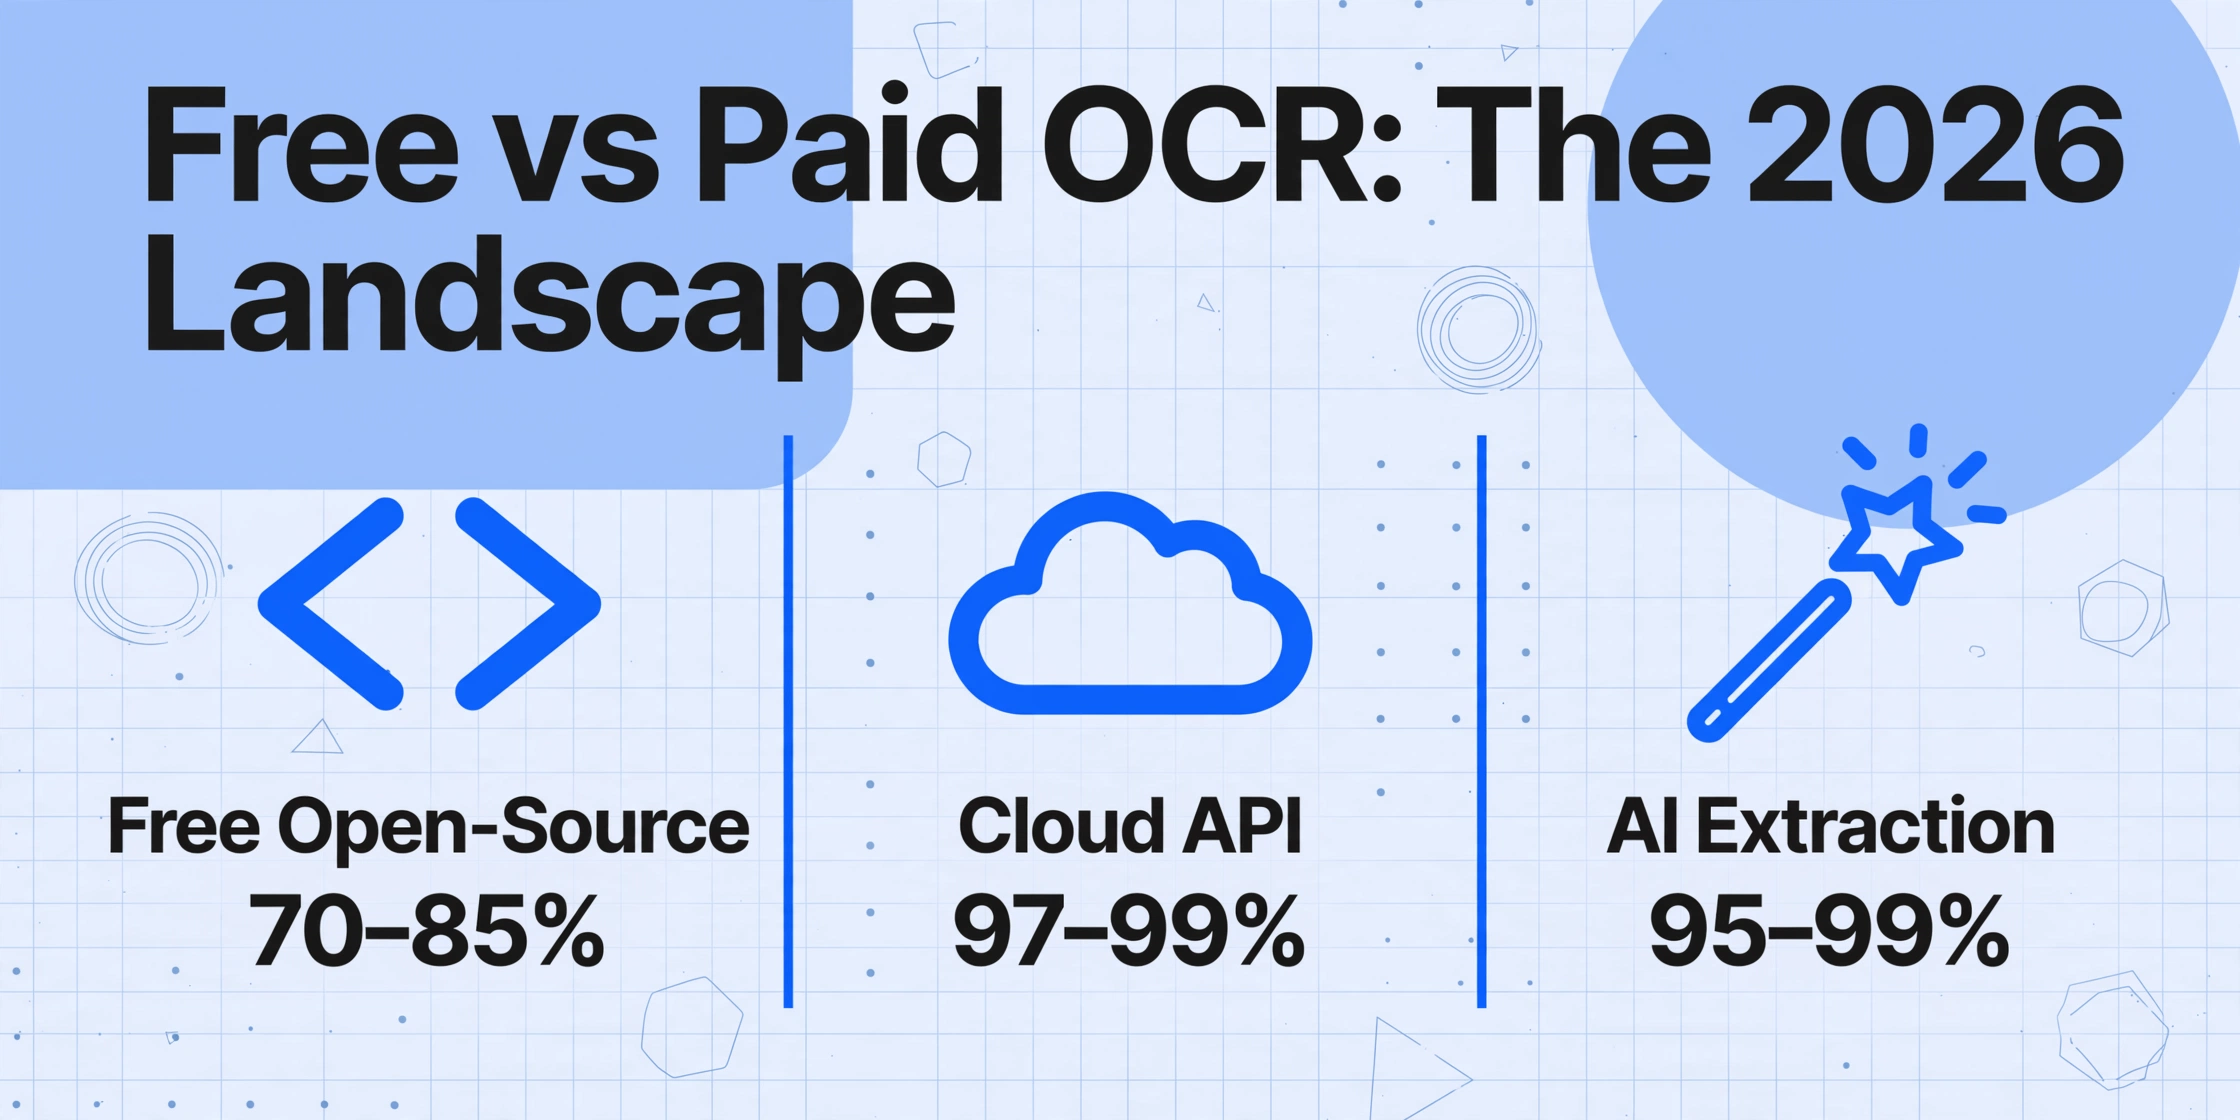
La tabla muestra lo que cada categoría puede hacer. Pero la pregunta no es la capacidad — es cuánto cuestan esas brechas de capacidad en tu flujo de trabajo específico.
El Marco de Costos Reales
Para que esto sea concreto, usamos una fórmula simple:
Costo Anual Total = Tarifa de Licencia + Configuración (amortizada en 3 años) + Mano de Obra de Corrección + Mantenimiento
Amortizamos la configuración en 3 años porque un pipeline de OCR bien construido debería durar ese tiempo antes de una reconstrucción importante. La mano de obra de corrección se calcula a una tarifa horaria efectiva de $35/hora — aproximadamente el costo combinado de un empleado asalariado o un operador independiente que maneja el procesamiento de documentos en el contexto de una pequeña empresa.
Los tres escenarios que siguen representan los volúmenes de documentos más comunes que vemos en la práctica, basados en conversaciones con usuarios que evalúan herramientas de OCR para sus flujos de trabajo.
Escenario 1: 10 Documentos al Mes — El Usuario Ocasional
Un contador independiente recibe 10 PDF de facturas al mes de sus clientes. Los documentos son limpios, los volúmenes son bajos y el objetivo es la extracción básica de texto para cotejar con los registros del cliente.
| Componente de Costo | Código Abierto Gratuito | API en la Nube | Extracción de IA Freemium |
|---|---|---|---|
| Licencia / suscripción | $0 | $0 (se mantiene dentro del nivel gratuito) | $0 (el nivel gratuito cubre esto) |
| Configuración (amortizada en 3 años) | $600–$900/año (40–80 h × $35 / 3) | $0 | $0 |
| Mano de obra de corrección | ~$140–$210/año (~10 min/doc × 120 docs × brecha) | ~$35–$70/año | ~$35–$70/año |
| Costo anual total | $740–$1,110 | $35–$70 | $35–$70 |
Con 10 documentos al mes, el costo de configuración de una herramienta de código abierto gratuita eclipsa todo lo demás. Incluso amortizado en tres años, las 40–80 horas que un desarrollador necesita para construir un pipeline de producción hacen que la opción "gratuita" sea la más cara por un amplio margen.
Para el usuario ocasional, la decisión inteligente es usar un nivel gratuito de API en la nube (la mayoría ofrece 500–1,000 páginas gratuitas al mes) o una herramienta freemium con un nivel de uso gratuito. Ambas ofrecen alta precisión en PDF limpios con cero configuración. La ruta de código abierto solo tiene sentido si ya cuenta con la infraestructura técnica y el pipeline sirve para más que este único caso de uso.
Escenario 2: 500 documentos al mes — la pequeña empresa en crecimiento
Un subcontratista de construcción procesa 500 facturas y albaranes al mes. Los documentos provienen de varios proveedores: algunos se envían por correo como PDF limpios, otros los fotografían los supervisores de obra con sus teléfonos. La inconsistencia de formatos es la norma, no la excepción.
| Componente de costo | Código abierto gratuito | API en la nube | Extracción de IA freemium |
|---|---|---|---|
| Licencia / suscripción | $0 | ~$90/año (6,000 páginas × $1.50/1k) | ~$120–$240/año |
| Configuración (amortizada a 3 años) | $600–$900/año | $0 | $0 |
| Mano de obra de corrección (est.) | ~$2,100–$4,200/año (~20% de tasa de error, 10–15 min/doc de corrección) | ~$350–$700/año | ~$175–$525/año |
| Mantenimiento | ~$700–$1,400/año (cambios de formato del proveedor, deriva del modelo) | $0 | $0 |
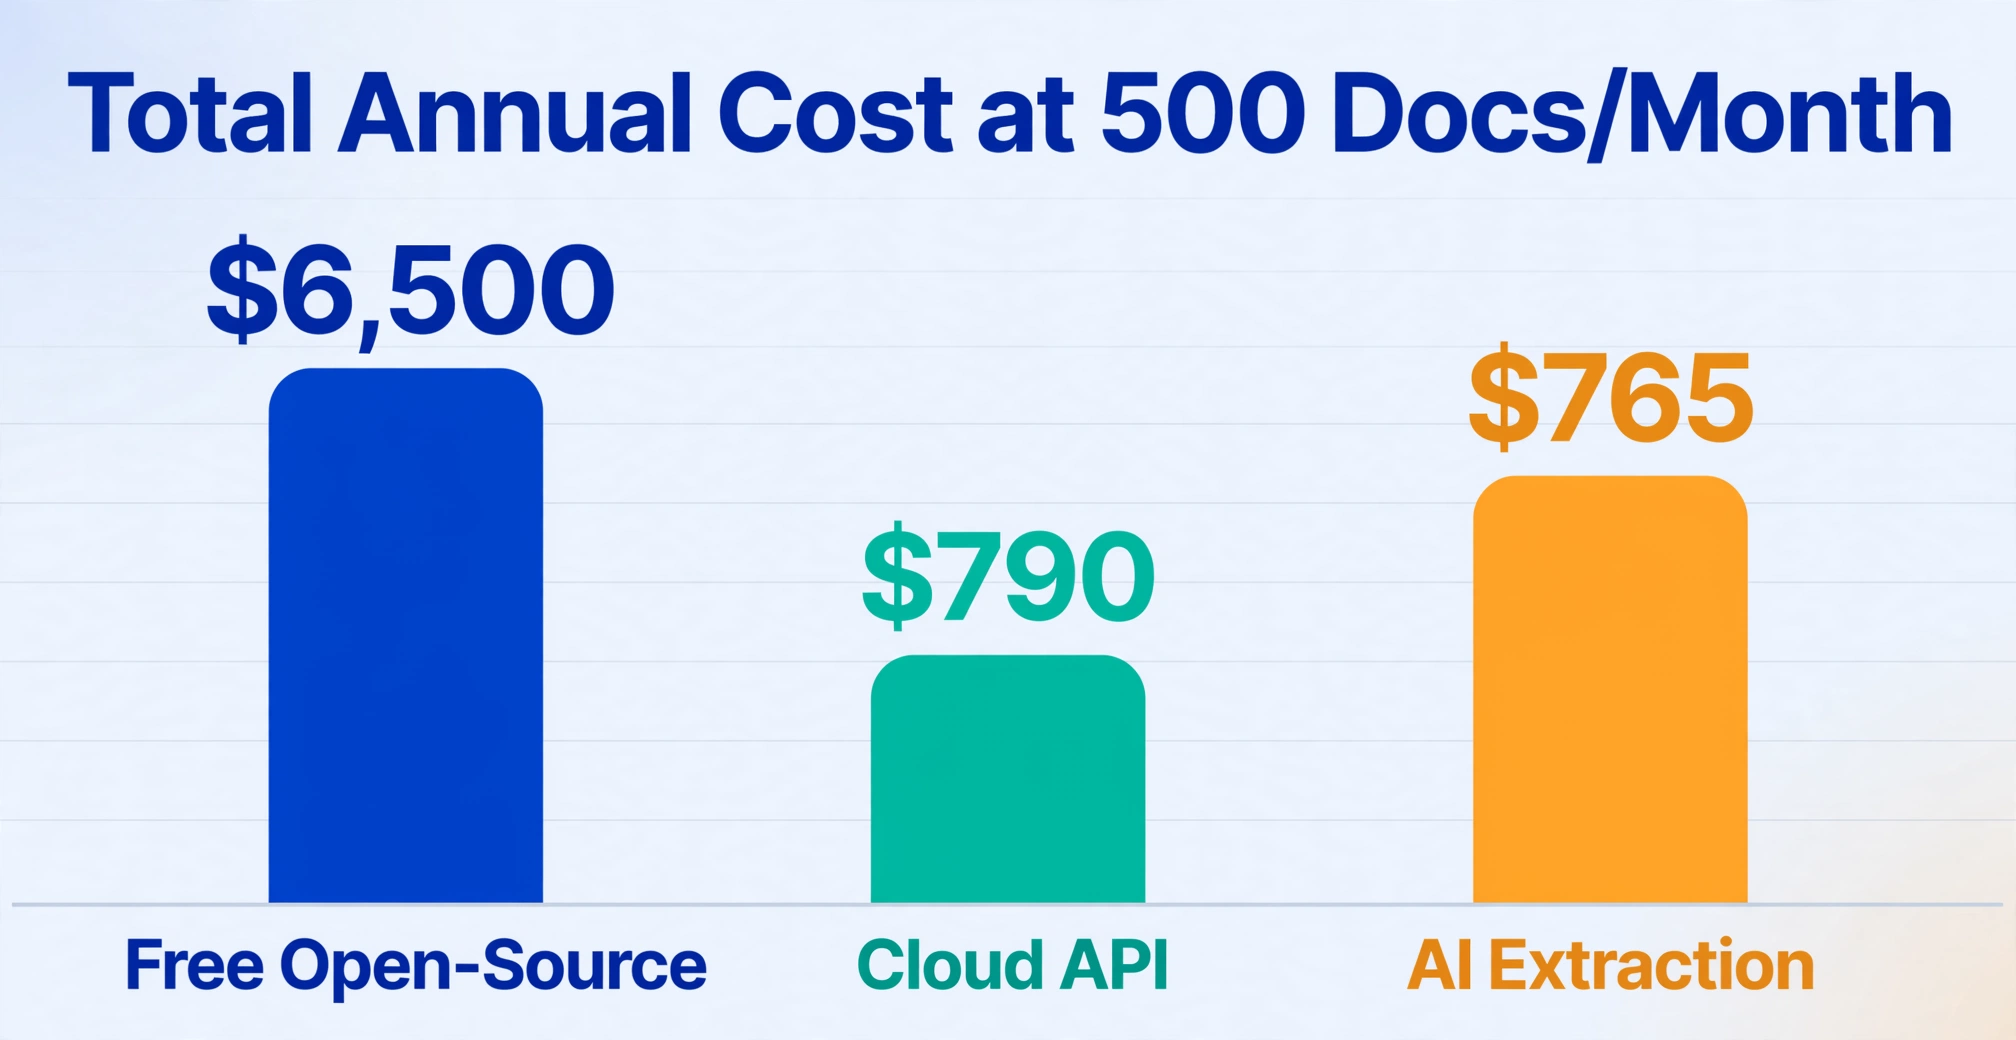
| Costo anual total | $3,400–$6,500 | $440–$790 | $295–$765 |
Aquí es donde la economía cambia de forma decisiva. Con 500 documentos al mes, la mano de obra de corrección derivada de la tasa de error del 15–25% de una herramienta gratuita en escaneos del mundo real consume más tiempo que todo el presupuesto que requeriría una herramienta de pago. El gerente de obra del subcontratista — o un administrativo a tiempo parcial — dedica de 20 a 40 horas al mes a corregir errores de extracción. Con un costo combinado de $35/hora, eso supone $700–$1,400 al mes en mano de obra invisible.
Las herramientas de OCR de código abierto se pueden ajustar para mejorar la precisión, pero el ajuste también requiere tiempo. Cada nuevo formato de proveedor que se desvía de aquello para lo que el flujo fue calibrado introduce un nuevo lote de errores. La partida de mantenimiento en la columna gratuita no es teórica: es el tiempo de desarrollo dedicado a actualizar los flujos de preprocesamiento de imágenes, reentrenar modelos o ajustar scripts de posprocesamiento cuando un proveedor cambia el diseño de sus facturas.
La opción de API en la nube elimina la configuración y el mantenimiento, pero aún puede tener dificultades con diseños de documentos inconsistentes. La categoría de extracción de IA freemium — herramientas que usan modelos de visión y lenguaje para comprender la estructura del documento de forma semántica en lugar de posicional — maneja la variación de formato sin configuración, razón por la cual su estimación de mano de obra de corrección es la más baja de las tres.
Escenario 3: 5,000 documentos al mes — la empresa en expansión
Una empresa de logística de mercado medio procesa 5,000 documentos al mes: una mezcla de órdenes de compra, albaranes, confirmaciones de entrega y facturas de cientos de proveedores. Los documentos llegan en todos los formatos imaginables: PDF por correo electrónico, TIFF escaneado de varias páginas, fotos de teléfono móvil de papeleo de almacén.
| Componente de costo | Código abierto gratuito | API en la nube | Extracción de IA freemium |
|---|---|---|---|
| Licencia / suscripción | $0 | ~$900/año (60k páginas × $1.50/1k) | ~$600–$2,400/año |
| Configuración (amortizado a 3 años) | $600–$900/año | $0 | $0 |
| Mano de obra de corrección (est.) | ~$21,000–$42,000/año (~15–20% de tasa de error, ~10 min/doc) | ~$3,500–$7,000/año | ~$1,750–$3,500/año |
| Mantenimiento | ~$3,500–$7,000/año | $0 | $0 |
| Costo anual total | $25,100–$49,900 | $4,400–$7,900 | $2,350–$5,900 |
Con 5,000 documentos al mes, la diferencia de costo entre lo gratuito y lo de pago se vuelve de un orden de magnitud. Incluso las estimaciones más agresivas sitúan la ruta de código abierto gratuito en más de $25,000 al año, casi en su totalidad en mano de obra de corrección y mantenimiento. Un solo empleado de entrada de datos que gane $35,000 al año puede manejar aproximadamente el 25–30% de la carga de corrección en este volumen, asumiendo tasas de error en el rango del 15–20%. Lo más realista es que la empresa necesite 1–2 personas a tiempo completo solo para corregir errores de OCR. Ese costo de personal por sí solo supera todas las opciones de pago.
Este es también el volumen donde la gravedad del error importa más. Un monto de factura mal leído que pasa desapercibido durante semanas — $14,500 reconocidos como $74,500 — puede tomar de 2 a 4 horas de rastreo y corrección en su sistema contable, como señaló un usuario de Reddit en r/Accounting. Con 5,000 documentos al mes, incluso una tasa de error crítico del 1% significa 50 incidentes de este tipo al mes.
Las API en la nube y las herramientas de extracción con IA no eliminan todos los errores, pero su precisión del 97–99% en documentos del mundo real significa que las correcciones restantes son manejables dentro de la capacidad del equipo existente. La suscripción de pago es un error de redondeo en comparación con la mano de obra que reemplaza.
Los costos ocultos del OCR «gratuito»
La licencia cuesta cero. El costo total no. Estos son los costos que no aparecen en la página de precios, pero que sí se reflejan en las horas de trabajo de su equipo:
1. Tiempo de configuración de ingeniería
Instalar Tesseract toma cinco minutos. Lograr que produzca resultados confiables y estructurados a partir de documentos comerciales del mundo real toma semanas. Debe seleccionar el modo de segmentación de página correcto, preprocesar las imágenes con OpenCV (enderezar, binarizar, eliminar ruido), escribir scripts de posprocesamiento para limpiar la salida sin procesar y crear un flujo de trabajo que conecte el motor de OCR con su base de datos u hoja de cálculo. El repositorio de Tesseract en GitHub señala explícitamente que necesitará mejorar la calidad de la imagen para obtener mejores resultados; ese trabajo de mejora es tiempo de ingeniería.
Con 40 a 80 horas para un flujo de trabajo de producción, y suponiendo que cuenta con un desarrollador que cuesta $70–$100 por hora con todos los costos incluidos, eso representa $2,800–$8,000 por adelantado, antes de procesar un solo documento.
2. Trabajo de corrección de errores
Los motores de OCR gratuitos alcanzan una precisión del 70–85% en documentos escaneados y fotografías, los formatos que dominan los flujos de trabajo comerciales del mundo real. Los PDF impresos limpios son la excepción, no la regla. Cada error de extracción requiere que una persona encuentre, verifique y corrija el fallo. A gran escala, este se convierte en el costo dominante.
El aspecto más insidioso de la corrección de errores es que no se percibe como un costo. Nadie emite un cheque por «corregir errores de OCR». Se manifiesta como el administrador que dedica una hora extra al día, el contador que revisa dos veces cada asiento o el auxiliar de cuentas por pagar que trabaja hasta tarde. Pero es un costo real, visible en la nómina aunque no en el presupuesto de software.
3. Mantenimiento continuo
Los documentos empresariales cambian. Un proveedor rediseña el formato de sus facturas. Una empresa de envíos introduce un nuevo formato de albarán. Un proveedor empieza a enviar PDFs que son imágenes escaneadas en lugar de archivos digitales. Cada cambio puede degradar la precisión del OCR hasta que se actualice el proceso. Alguien debe supervisar estas regresiones, investigar la causa y ajustar la lógica de preprocesamiento o posprocesamiento. Ese alguien no es el proveedor del software, porque con herramientas de código abierto no hay proveedor.
4. Soluciones alternativas para funciones faltantes
Los motores de OCR gratuitos no manejan escritura a mano, no extraen tablas en filas estructuradas, no entienden la semántica de las casillas de verificación y no reconocen firmas ni sellos. Si sus documentos contienen alguno de estos elementos — y la mayoría de los documentos empresariales los contienen — necesitará crear soluciones alternativas. Esa solución es otro proyecto no presupuestado.
Aquí es donde la brecha entre el OCR tradicional y la extracción moderna con IA se hace más visible. Los motores de OCR tradicionales son herramientas de reconocimiento: convierten píxeles en caracteres. Las herramientas modernas como el software de OCR con IA utilizan modelos de visión y lenguaje que entienden la estructura del documento semánticamente — saben la diferencia entre un encabezado y una celda de datos, pueden identificar tablas incluso sin bordes explícitos y extraen significado en lugar de solo texto.
Cuándo el OCR gratuito es la opción correcta
El OCR gratuito de código abierto no es una trampa. Es genuinamente la herramienta adecuada en situaciones específicas:
- Eres un desarrollador que crea un proceso personalizado y tienes experiencia interna en OCR. La flexibilidad de Tesseract o PaddleOCR te permite ajustar cada parámetro e integrarte profundamente en tu stack.
- Procesas solo PDFs digitales limpios con diseños consistentes. La precisión de Tesseract en texto impreso por máquina con una fuente estándar se acerca al 99%.
- Tu volumen es muy bajo — menos de 50 documentos al mes. A este nivel, incluso un proceso gratuito subóptimo cuesta menos en mano de obra total que la carga cognitiva de evaluar y adoptar una herramienta de pago.
- Estás sujeto a requisitos estrictos de residencia de datos o aislamiento de red y no puedes enviar documentos a ningún servicio en la nube. El OCR de código abierto autoalojado es tu única opción.
- Estás haciendo investigación o digitalización de archivos donde la salida no alimenta un proceso empresarial que exija datos estructurados.
Estos casos comparten un hilo común: o ya tienes los recursos de ingeniería para absorber el costo de configuración y mantenimiento, o los requisitos de calidad de salida son lo suficientemente bajos como para que la corrección de errores sea mínima.
Cuándo el OCR de pago es realmente más barato
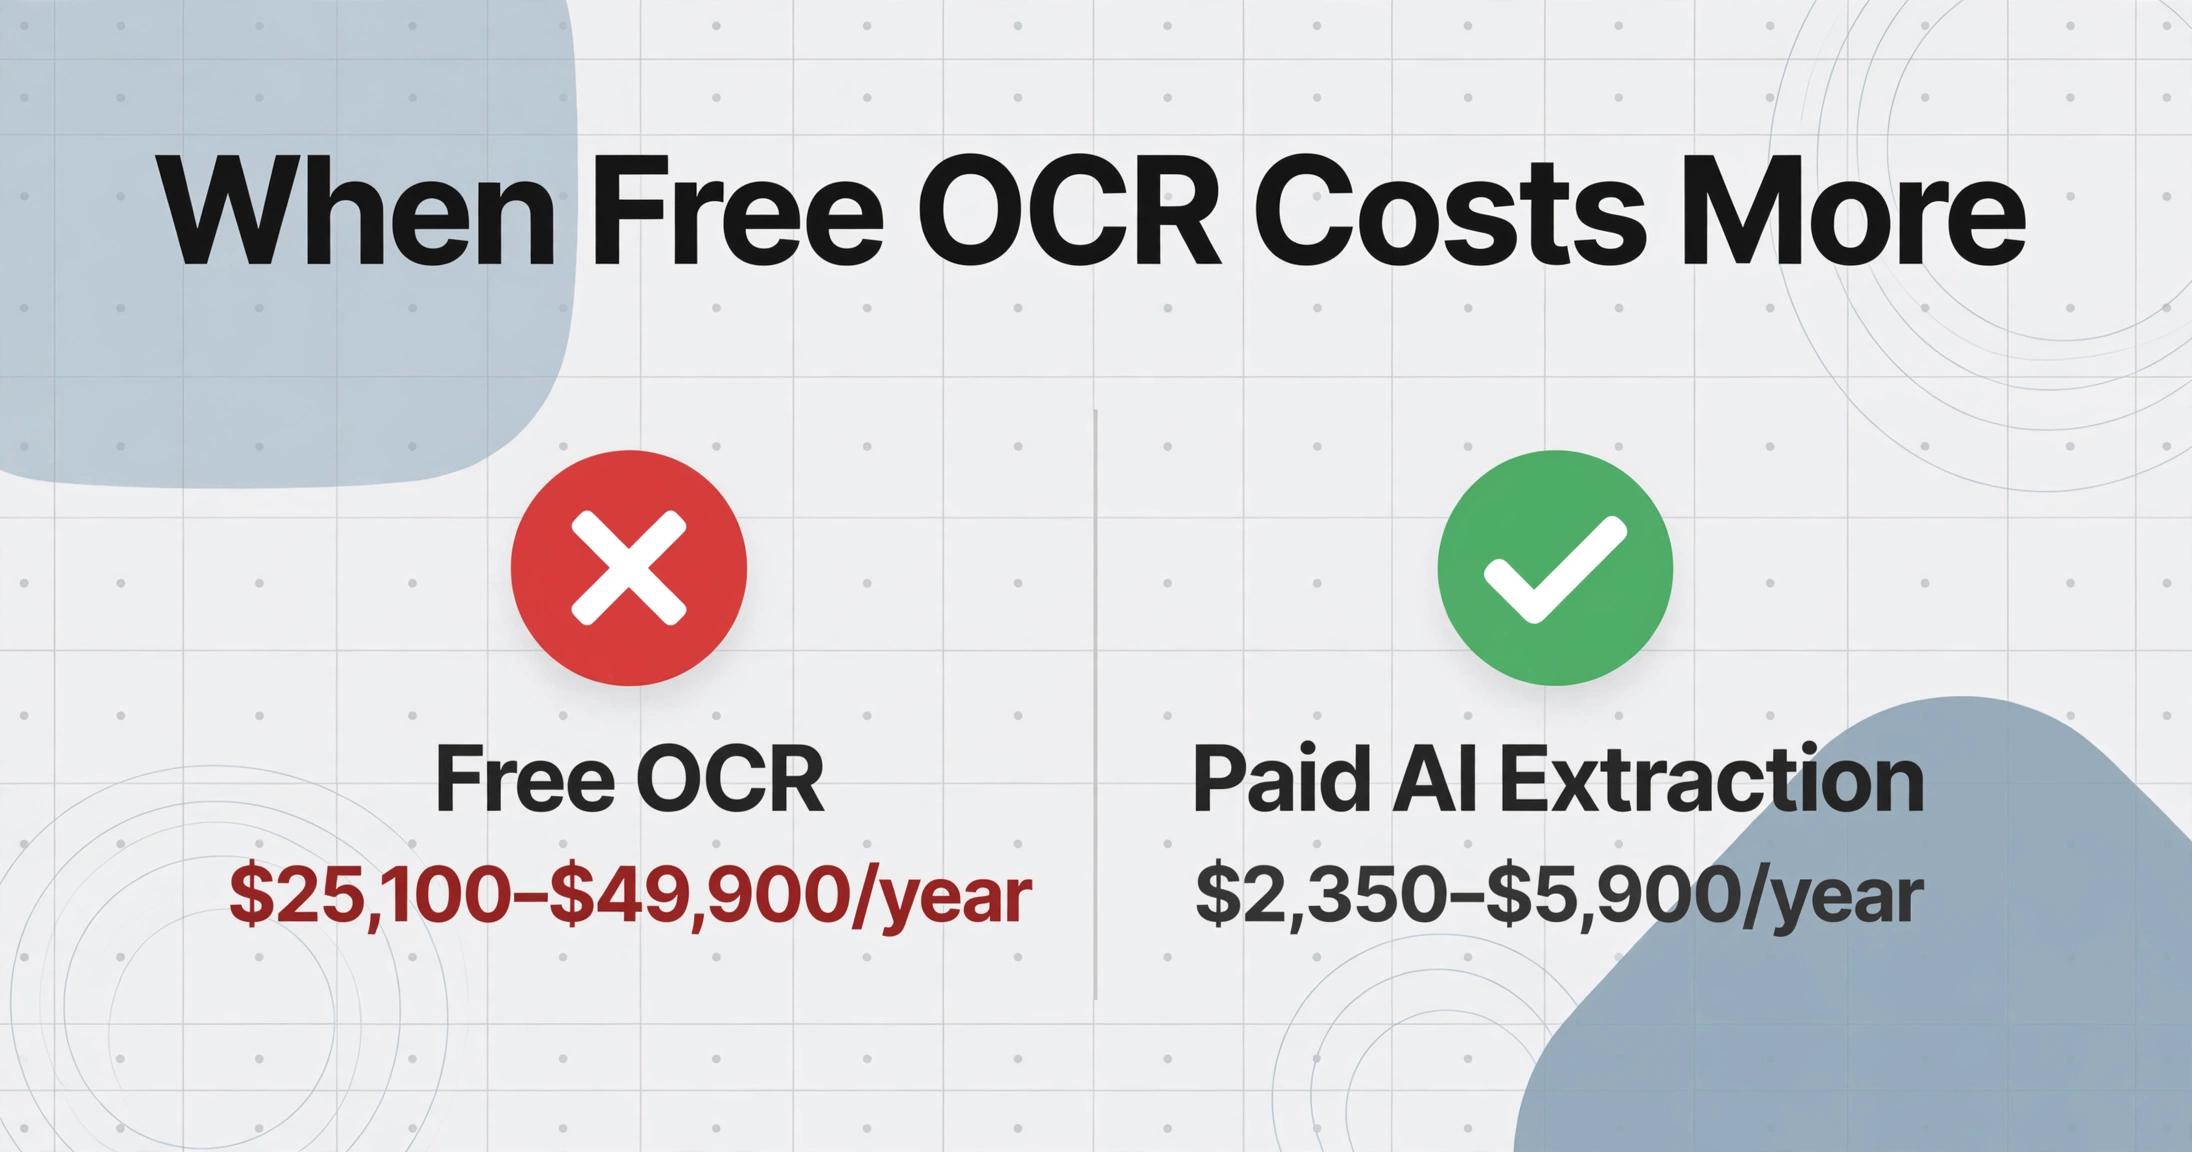
Si tu situación se parece a alguna de estas, una opción de pago probablemente cueste menos en total:
- Procesas más de 100 documentos al mes de múltiples fuentes con formatos variados. El trabajo de corrección que genera el OCR gratuito a este volumen ya supera el costo de una suscripción.
- Tus documentos incluyen escaneos, fotos o escritura a mano. La precisión del OCR gratuito en entradas no ideales cae al 70–85%, y la diferencia frente al 97–99% de las herramientas de pago se amplía rápidamente con el volumen.
- Necesitas salida de datos estructurados — filas de Excel con columnas específicas, no texto sin procesar. Construir extracción de tablas sobre OCR de código abierto es un proyecto de ingeniería significativo.
- No cuentas con un equipo de ingeniería dedicado. Si tu configuración de OCR depende de un contratista o de la "persona más tecnológica de la oficina", el conocimiento se va cuando ellos se van.
- Los errores de precisión conllevan riesgo de cumplimiento o financiero. Un total de factura incorrecto, un ID fiscal mal leído o una fecha errónea en un albarán pueden generar sanciones, hallazgos de auditoría o disputas con clientes.
El error más común que vemos es estimar solo el costo de la licencia. Una suscripción de $20/mes que elimina 15 horas de corrección manual se paga sola a cualquier tarifa horaria razonable. El software casi nunca cuesta más que la mano de obra que reemplaza.
Este es el núcleo de lo que el software OCR moderno ofrece: no solo reconocimiento de texto, sino un pipeline completo desde el documento hasta los datos utilizables con una intervención humana mínima. La suscripción paga por el pipeline, no por el reconocimiento.
Preguntas frecuentes
¿Es el OCR gratuito lo bastante preciso para uso empresarial en 2026?
Depende de la calidad de sus documentos. El OCR gratuito, como Tesseract, alcanza un 95–99 % de precisión en PDFs impresos limpios con fuentes estándar. Pero en documentos escaneados, fotos o diseños no estándar —que constituyen la mayoría de los documentos empresariales reales—, la precisión cae al 70–85 %. En ese nivel, 1 de cada 4 a 6 documentos tendrá al menos un error de extracción significativo. Para uso personal ocasional, puede ser aceptable. Para procesos empresariales donde los datos alimentan la contabilidad, el inventario o el cumplimiento normativo, introduce un riesgo inaceptable y una carga de corrección adicional.
¿Pueden las herramientas de OCR gratuitas extraer tablas a Excel?
No de forma fiable. Tesseract y otros motores de código abierto generan texto sin formato o hOCR (formato OCR basado en HTML). No entienden la estructura de las tablas: no saben qué celdas pertenecen a cada fila, si un encabezado de columna se aplica a los datos inferiores o cómo deben comportarse las celdas combinadas. Convertir esa salida en una tabla de Excel utilizable requiere código de posprocesamiento personalizado. Las API en la nube, como Google Document AI y AWS Textract, tienen modelos dedicados de formularios y extracción de tablas que gestionan esto de forma nativa. Algunas herramientas de OCR gratuitas con niveles freemium ofrecen salida estructurada, pero el nivel gratuito suele estar limitado en páginas por mes.
¿Cuánto tiempo se tarda en configurar un flujo de trabajo de OCR gratuito?
Instalar el motor lleva minutos. Crear un flujo de trabajo de producción que gestione de forma fiable documentos del mundo real lleva de 40 a 80 horas para un desarrollador con experiencia en OCR, y más tiempo sin ella. Esto incluye el preprocesamiento de imágenes (enderezado, binarización, reducción de ruido), la selección del modo de segmentación de página correcto, la escritura de scripts de posprocesamiento para limpiar la salida, la creación de un flujo de ingesta de documentos y la configuración de la supervisión de errores. El coste de configuración es el mayor coste oculto del OCR gratuito que la mayoría de las comparaciones ignoran.
¿Puede el OCR gratuito leer escritura a mano?
No. Tesseract y PaddleOCR fueron diseñados para el reconocimiento de texto impreso. No tienen capacidad de reconocimiento de escritura a mano. Algunas API en la nube ofrecen soporte limitado para escritura a mano, pero la extracción confiable de escritura a mano — especialmente para letra cursiva o formas mixtas escritas a mano — requiere modelos modernos de visión-lenguaje entrenados específicamente en conjuntos de datos de documentos escritos a mano. Este es un dominio de funciones donde las herramientas gratuitas simplemente no compiten.
¿A qué volumen el OCR de pago se vuelve más barato que el gratuito?
Según nuestro modelo de costos, el punto de equilibrio es alrededor de 100–150 documentos por mes. Por debajo de eso, el trabajo de corrección de la herramienta gratuita es lo suficientemente pequeño como para que el costo de configuración (amortizado) domine, pero puede justificarse si ya tiene la infraestructura. Por encima de 150 documentos por mes, el trabajo de corrección por la menor precisión de una herramienta gratuita supera consistentemente el costo de suscripción de una alternativa de pago cuando se considera el tiempo invertido. Con 500+ documentos por mes, la brecha es lo suficientemente amplia como para que la opción de pago sea inequívocamente más barata.
Encuentra tu punto de equilibrio
Las cifras cambian para cada empresa. La calidad real de tus documentos, los formatos que recibes y la precisión que necesitas alteran los números. La única forma de saber qué opción te ahorra dinero es probarla con tus documentos reales.