OCR gratuito vs OCR pago 2026
Quando o gratuito custa mais que uma assinatura
Esta não é uma comparação de recursos. É uma análise de custo de propriedade usando três volumes reais de documentos: 10 por mês, 500 por mês e 5.000 por mês. A questão não é se o OCR gratuito existe — é se o tempo de configuração, o trabalho de correção e a manutenção escondidos no "gratuito" realmente custam mais que uma assinatura.
Principais Conclusões
- $0 é o preço mais perigoso na automação de documentos porque transfere o custo da sua linha de orçamento de software para a sua folha de pagamento.
- Uma única assinatura de $20/mês elimina 15 horas de correção manual por mês — só a mão de obra custa mais que a licença em qualquer taxa horária razoável.
- O único número que vale comparar entre ferramentas gratuitas e pagas é o custo total por documento: some amortização de configuração, trabalho de correção, manutenção e licença, depois divida pelo volume.
O Framework: Custo Total do OCR
A maioria das comparações entre OCR gratuito e pago para na taxa de licenciamento. Uma licença custa $0 versus $X por mês, então o gratuito vence, fim de história. Mas essa abordagem ignora quase tudo que determina se uma ferramenta de OCR realmente economiza dinheiro para o seu negócio.
O reconhecimento óptico de caracteres — a tecnologia que converte texto em imagens e documentos digitalizados em dados legíveis por máquina — compreende apenas a etapa de reconhecimento. O que importa na prática é o pipeline completo: colocar o documento na ferramenta, fazer com que ela extraia dados utilizáveis, corrigir o que ela errou e exportar esses dados para onde você precisa. As ferramentas gratuitas transferem o custo do licenciamento para todas as outras etapas desse pipeline.
Este artigo avalia as opções de OCR em quatro dimensões de custo:
- Custo de configuração — tempo para instalar, configurar e integrar a ferramenta a um fluxo de trabalho
- Trabalho de correção por documento — tempo gasto corrigindo erros de extração
- Despesas de manutenção — esforço para manter o pipeline funcionando à medida que os formatos de documento mudam
- Taxa de licença ou assinatura — o pagamento inicial ou recorrente
Cada dimensão de custo importa de forma diferente, dependendo de quantos documentos você processa. É por isso que calculamos os números em três níveis de volume.
Comparação Rápida: OCR Gratuito vs Pago em 2026
O cenário de OCR em 2026 se divide em três grandes categorias. Ferramentas de código aberto gratuitas como Tesseract e PaddleOCR não cobram nada pelo software, mas exigem configuração técnica. Serviços de API em nuvem como Google Cloud Vision, AWS Textract e Azure Document Intelligence cobram por página com configuração zero. E APIs modernas de extração de IA oferecem extração sem modelo a uma taxa fixa de assinatura ou por página.
| Dimensão | Código aberto gratuito (Tesseract, PaddleOCR) | API em nuvem (Google, AWS, Azure) | Extração de IA freemium |
|---|---|---|---|
| Precisão — PDF limpo | 95–99% | 99%+ | 99%+ |
| Precisão — digitalização ou foto | 70–85% | 97–99% | 95–99% |
| Custo de configuração | 40–80 horas de engenharia | 2–8 horas (integração de API) | 0–1 hora (envie e pronto) |
| Exportação de tabela / estruturada | Ruim — exige código personalizado | Boa — integrada | Excelente — Excel / Planilhas nativos |
| Suporte a escrita manual | Não suportado | Parcial | Suportado via modelos de visão |
| Extração sem modelo | Exige treinamento personalizado | Depende do layout | Nativa — extração semântica |
| Manutenção | Tempo contínuo de desenvolvimento | Gerenciada pelo fornecedor | Gerenciada pelo fornecedor |
| Custo de licença | $0 | $1,50 / 1.000 páginas | Plano gratuito + a partir de ~$10/mês |
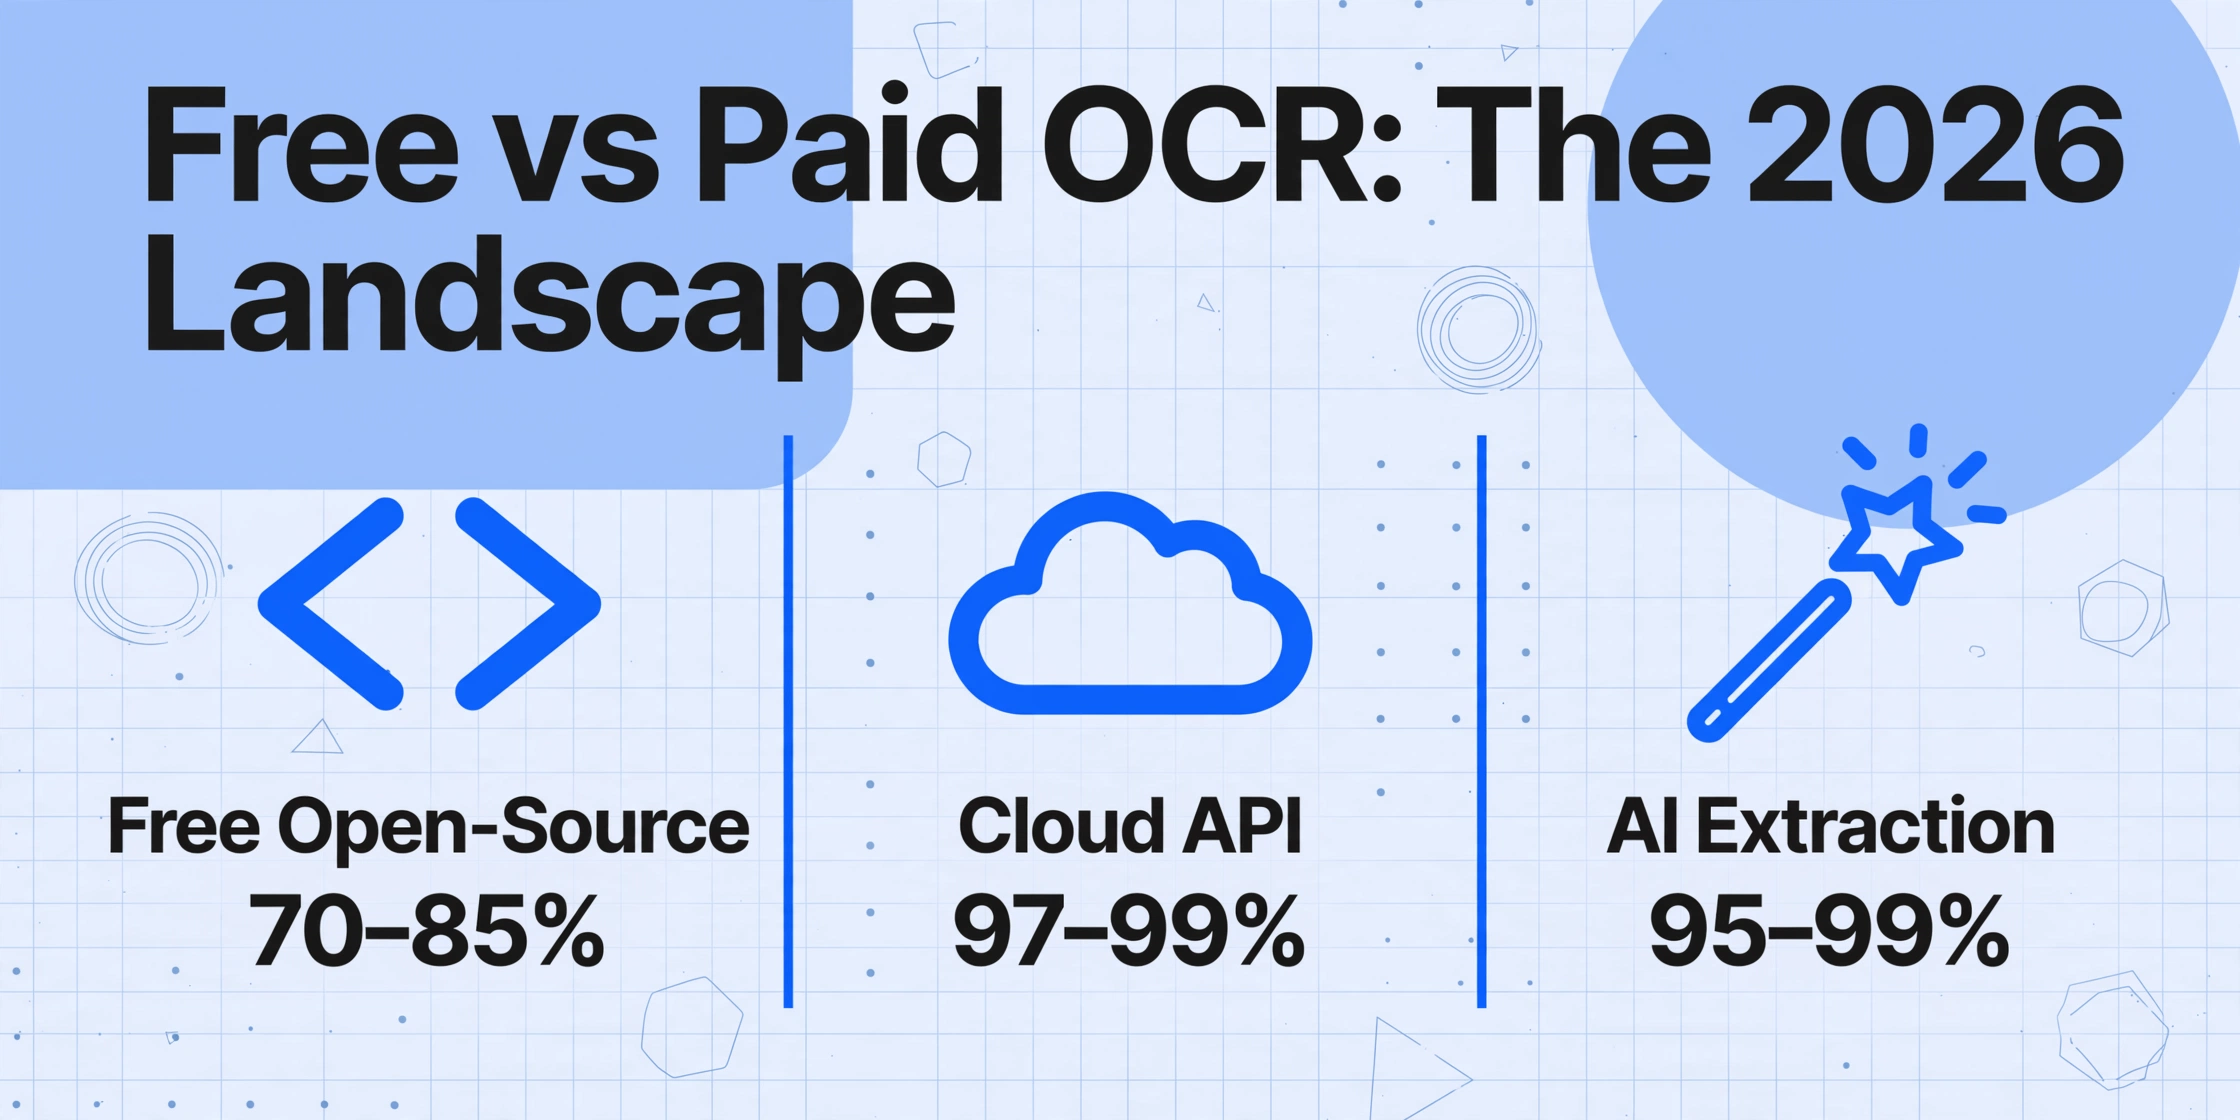
A tabela mostra o que cada categoria pode fazer. Mas a questão não é capacidade — é o custo dessas lacunas de capacidade no seu fluxo de trabalho específico.
A Estrutura de Custo Real
Para tornar isso concreto, usamos uma fórmula simples:
Custo Anual Total = Taxa de Licença + Configuração (amortizada em 3 anos) + Mão de Obra de Correção + Manutenção
Amortizamos a configuração em 3 anos porque um pipeline de OCR bem construído deve durar esse tempo antes de uma grande reformulação. A mão de obra de correção é calculada a uma taxa horária efetiva de $35/hora — aproximadamente o custo combinado de um funcionário assalariado ou operador freelancer que lida com processamento de documentos em um contexto de pequena empresa.
Os três cenários a seguir representam os volumes de documentos mais comuns que vemos na prática, com base em conversas com usuários que avaliam ferramentas de OCR para seus fluxos de trabalho.
Cenário 1: 10 Documentos por Mês — O Usuário Ocasional
Um contador freelancer recebe 10 PDFs de faturas por mês de clientes. Os documentos são limpos, os volumes são baixos e o objetivo é a extração básica de texto para verificação cruzada com os registros do cliente.
| Componente de Custo | Código Aberto Gratuito | API em Nuvem | Extração de IA Freemium |
|---|---|---|---|
| Licença / assinatura | $0 | $0 (permanece no nível gratuito) | $0 (o nível gratuito cobre isso) |
| Configuração (amortizada em 3 anos) | $600–$900/ano (40–80 h × $35 / 3) | $0 | $0 |
| Mão de obra de correção | ~$140–$210/ano (~10 min/doc × 120 docs × lacuna) | ~$35–$70/ano | ~$35–$70/ano |
| Custo anual total | $740–$1.110 | $35–$70 | $35–$70 |
Com 10 documentos por mês, o custo de configuração de uma ferramenta gratuita de código aberto supera tudo o mais. Mesmo amortizado em três anos, as 40–80 horas que um desenvolvedor precisa para construir um pipeline de produção tornam a opção "gratuita" a mais cara por uma ampla margem.
Para o usuário ocasional, a jogada inteligente é usar um nível gratuito de API em nuvem (a maioria oferece 500–1.000 páginas gratuitas por mês) ou uma ferramenta freemium com um nível de uso gratuito. Ambos oferecem alta precisão em PDFs limpos com zero configuração. O caminho do código aberto só faz sentido se você já tiver a infraestrutura técnica e o pipeline atender a mais do que este único caso de uso.
Cenário 2: 500 Documentos por Mês — A Pequena Empresa em Crescimento
Uma pequena subempreiteira de construção processa 500 faturas e recibos de entrega por mês. Os documentos vêm de vários fornecedores — alguns enviados por e-mail como PDFs limpos, outros fotografados por supervisores de obra nos seus celulares. A inconsistência de formato é a norma, não a exceção.
| Componente de Custo | Open-Source Gratuito | API em Nuvem | Extração de IA Freemium |
|---|---|---|---|
| Licença / assinatura | $0 | ~$90/ano (6.000 páginas × $1,50/1 mil) | ~$120–$240/ano |
| Configuração (amortizada em 3 anos) | $600–$900/ano | $0 | $0 |
| Mão de obra de correção (estimativa) | ~$2.100–$4.200/ano (~20% de taxa de erro, 10–15 min/correção de documento) | ~$350–$700/ano | ~$175–$525/ano |
| Manutenção | ~$700–$1.400/ano (mudanças de formato do fornecedor, desvio de modelo) | $0 | $0 |
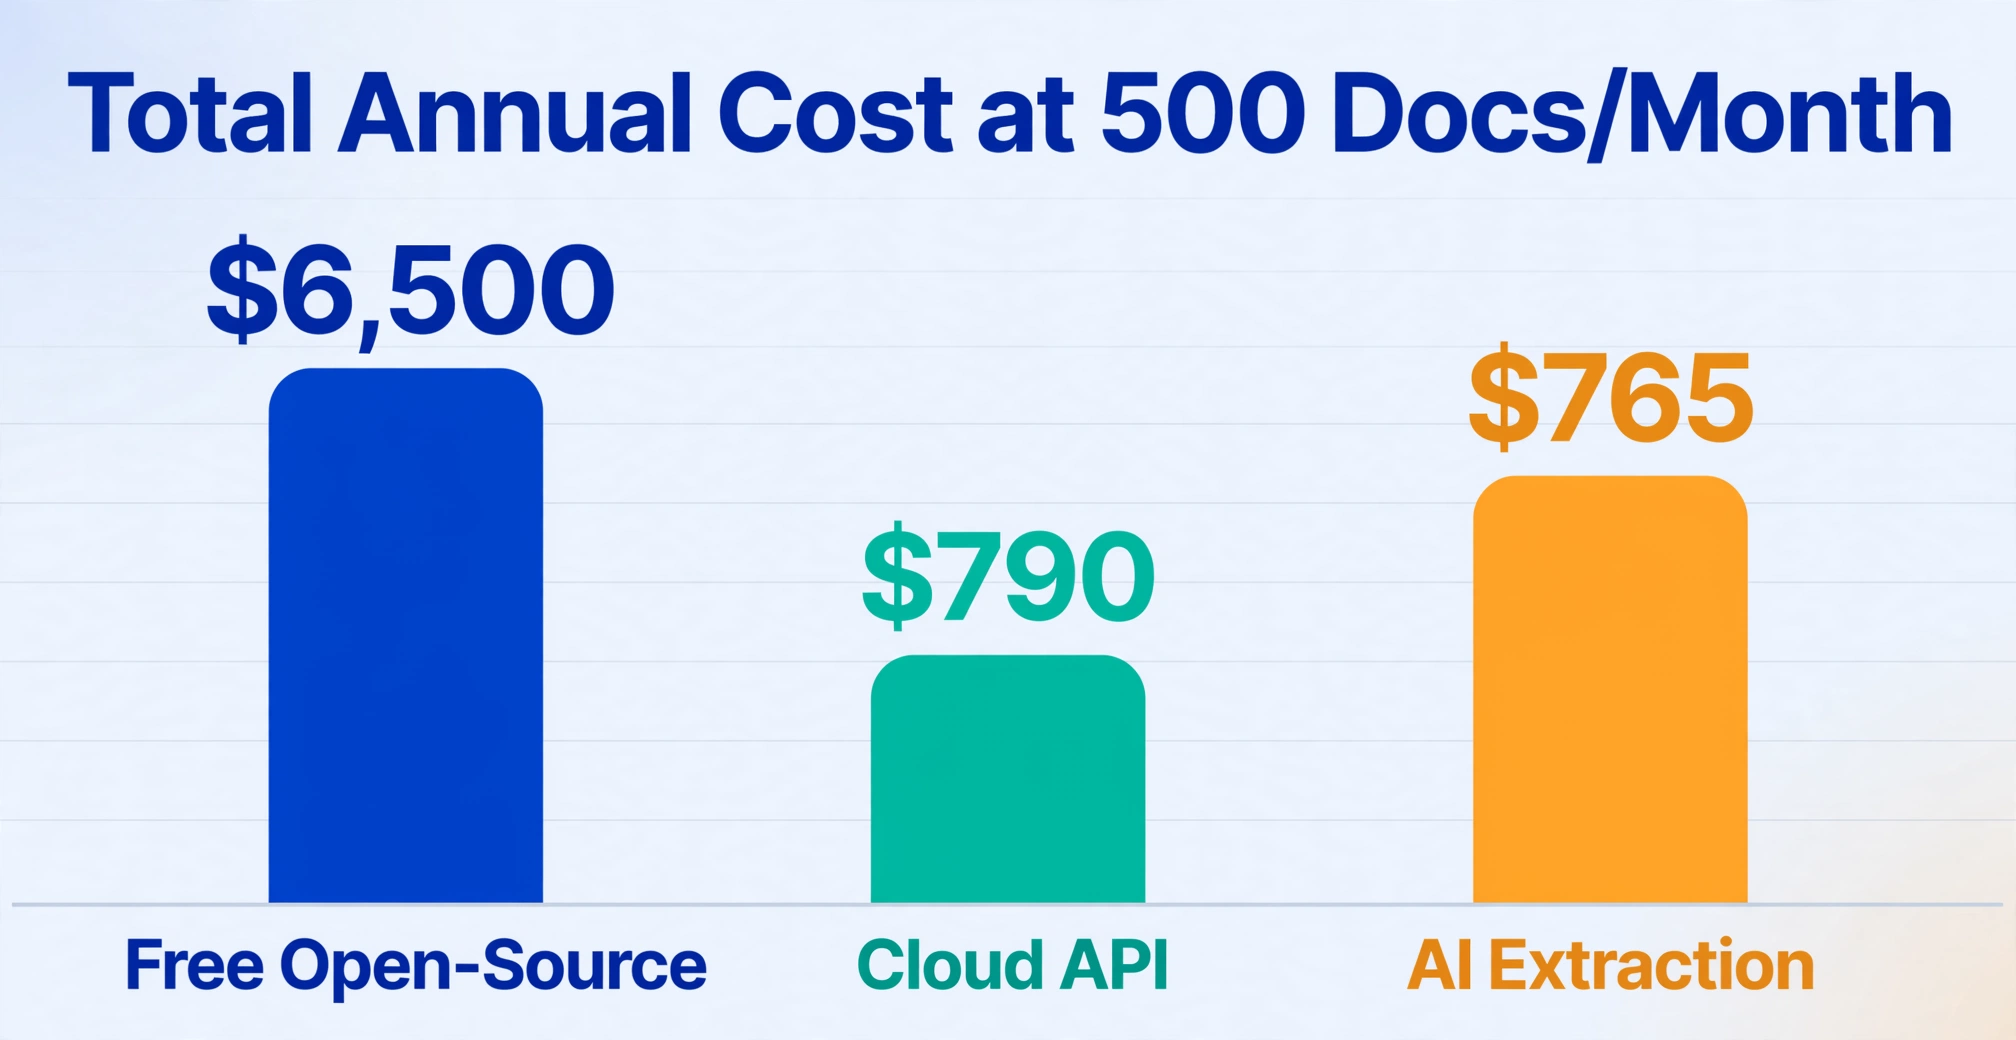
| Custo anual total | $3.400–$6.500 | $440–$790 | $295–$765 |
É aqui que a economia muda de forma decisiva. A 500 documentos por mês, a mão de obra de correção decorrente da taxa de erro de 15–25% de uma ferramenta gratuita em digitalizações do mundo real consome mais tempo do que todo o orçamento que uma ferramenta paga exigiria. O gerente de obra da subempreiteira — ou um administrador de meio período — gasta 20–40 horas por mês corrigindo erros de extração. A um custo combinado de $35/hora, isso representa $700–$1.400 por mês em mão de obra invisível.
Ferramentas de OCR open-source podem ser ajustadas para melhorar a precisão, mas o ajuste em si leva tempo. Cada novo formato de fornecedor que se desvia do que o pipeline foi calibrado para processar introduz um novo lote de erros. O item de manutenção na coluna gratuita não é teórico — é o tempo do desenvolvedor gasto na atualização de pipelines de pré-processamento de imagem, no re-treinamento de modelos ou no ajuste de scripts de pós-processamento quando um fornecedor muda o layout da fatura.
A opção de API em nuvem elimina a configuração e a manutenção, mas ainda pode ter dificuldades com layouts de documentos inconsistentes. A categoria de extração de IA freemium — ferramentas que usam modelos de visão-linguagem para entender a estrutura do documento semanticamente, em vez de posicionalmente — lida com a variação de formato sem configuração, e é por isso que sua estimativa de mão de obra de correção é a mais baixa das três.
Cenário 3: 5.000 Documentos por Mês — A Empresa em Expansão
Uma empresa de logística de médio porte processa 5.000 documentos mensalmente: uma mistura de pedidos de compra, romaneios, confirmações de entrega e faturas de centenas de fornecedores. Os documentos chegam em todos os formatos imagináveis — PDF por e-mail, TIFF digitalizado de várias páginas, fotos de celular de papéis do armazém.
| Componente de Custo | Código Aberto Gratuito | API em Nuvem | Extração de IA Freemium |
|---|---|---|---|
| Licença / assinatura | $0 | ~$900/ano (60 mil páginas × $1,50/1 mil) | ~$600–$2.400/ano |
| Configuração (amortizada em 3 anos) | $600–$900/ano | $0 | $0 |
| Mão de obra de correção (estimativa) | ~$21.000–$42.000/ano (~15–20% de taxa de erro, ~10 min/doc) | ~$3.500–$7.000/ano | ~$1.750–$3.500/ano |
| Manutenção | ~$3.500–$7.000/ano | $0 | $0 |
| Custo anual total | $25.100–$49.900 | $4.400–$7.900 | $2.350–$5.900 |
Com 5.000 documentos por mês, a diferença de custo entre gratuito e pago se torna uma ordem de magnitude. Mesmo as estimativas mais agressivas colocam a rota de código aberto gratuito em mais de $25.000 por ano — quase inteiramente em mão de obra de correção e manutenção. Um único auxiliar de digitação que ganha $35.000 por ano pode lidar com cerca de 25–30% da carga de correção neste volume, assumindo taxas de erro na faixa de 15–20%. O mais realista é que a empresa precise de 1–2 pessoas em tempo integral apenas para corrigir erros de OCR. Esse custo de pessoal sozinho excede todas as opções pagas.
Este também é o volume onde a gravidade do erro importa mais. Um valor de fatura lido incorretamente que passa despercebido por semanas — $14.500 reconhecidos como $74.500 — pode levar de 2 a 4 horas para rastrear e corrigir em todo o seu sistema contábil, como observou um usuário do Reddit em r/Accounting. Com 5.000 documentos por mês, mesmo uma taxa de erro crítico de 1% significa 50 desses incidentes por mês.
As APIs em nuvem e as ferramentas de extração de IA não eliminam todos os erros, mas sua precisão de 97–99% em documentos do mundo real significa que as correções restantes são gerenciáveis dentro da capacidade existente da equipe. A assinatura paga é um erro de arredondamento em comparação com a mão de obra que ela substitui.
Os Custos Ocultos do OCR "Gratuito"
A taxa de licença é zero. O custo total não é. Aqui estão os custos que não aparecem na página de preços, mas que aparecem na planilla de horas da sua equipe:
1. Tempo de Configuração de Engenharia
Instalar Tesseract leva cinco minutos. Fazer que ele produza resultados confiables e estruturados a partir de documentos empresariales do mundo real leva semanas. Você precisa seleccionar o Modo de Segmentação de Página correto, pré-processar imagens com OpenCV (endireitar, binarizar, reduzir ruido), escrever scripts de pós-processamento para limpar a saída bruta e construir um pipeline que conecte o motor de OCR ao seu banco de dados ou planilla de cálculo. O repositorio de GitHub de Tesseract nota explicitamente que você precisará melhorar a qualidade da imagem para obter melhores resultados — esse trabalho de melhora é tempo de engeniería.
Com 40–80 horas para um pipeline de produção, e suponiendo que você tem um desenvolvedor que custa $70–$100 por hora totalmente cargado, isso é $2,800–$8,000 adiantado — antes de que um único documento seja processado.
2. Trabalho de Correção de Errores
Os motores de OCR gratuitos alcanzan 70–85% de precisión em documentos escaneados e fotos — os formatos que dominan os fluxos de trabalho empresariales do mundo real. PDFs limpos impressos por máquina são a excepción, não a regra. Cada error de extracción requer que um humano encontre, verifique e corrija o erro. A escala, isso se torna o custo dominante.
O aspecto más insidioso da corrección de errores é que não se siente como um custo. Ninguém escreve um cheque por "corregir errores de OCR". Isso aparece como o administrador gastando uma hora extra por dia, o contador verificando duas vezes cada entrada, ou o empregado de contas a pagar trabalhando até tarde. Mas é um custo real, visível na nómina se não no orçamento de software.
3. Manutenção Contínua
Documentos empresariais mudam. Um fornecedor reformula o layout da fatura. Uma transportadora introduz um novo formato de remessa. Um vendedor começa a enviar PDFs que são imagens digitalizadas em vez de arquivos digitais. Cada mudança pode degradar a precisão do OCR até que o pipeline seja atualizado. Alguém precisa monitorar essas regressões, investigar a causa e ajustar a lógica de pré-processamento ou pós-processamento. Esse alguém não é o fornecedor do software — porque, com ferramentas de código aberto, não há fornecedor.
4. Soluções Alternativas para Recursos Ausentes
Os mecanismos de OCR gratuitos não lidam com escrita manual, não extraem tabelas em linhas estruturadas, não entendem a semântica de caixas de seleção e não reconhecem assinaturas ou carimbos. Se seus documentos contêm algum desses elementos — e a maioria dos documentos empresariais contém — você precisará criar soluções alternativas. Essa solução é outro projeto não orçado.
É aqui que a lacuna entre o OCR tradicional e a extração moderna com IA se torna mais visível. Os mecanismos de OCR tradicionais são ferramentas de reconhecimento: eles convertem pixels em caracteres. Ferramentas modernas como software de OCR com IA usam modelos de visão e linguagem que entendem a estrutura do documento semanticamente — eles sabem a diferença entre um cabeçalho e uma célula de dados, identificam tabelas mesmo sem bordas explícitas e extraem significado, não apenas texto.
Quando o OCR Gratuito é a Escolha Certa
O OCR gratuito de código aberto não é uma armadilha. Ele é genuinamente a ferramenta certa em situações específicas:
- Você é um desenvolvedor criando um pipeline personalizado e tem experiência interna em OCR. A flexibilidade do Tesseract ou PaddleOCR permite ajustar cada parâmetro e integrar profundamente à sua stack.
- Você processa apenas PDFs digitais limpos com layouts consistentes. A precisão do Tesseract em texto impresso por máquina em fonte padrão se aproxima de 99%.
- Seu volume é muito baixo — menos de 50 documentos por mês. Nesse nível, até um pipeline gratuito abaixo do ideal custa menos em mão de obra total do que a sobrecarga cognitiva de avaliar e adotar uma ferramenta paga.
- Você está sob requisitos rígidos de residência de dados ou isolamento de rede e não pode enviar documentos a nenhum serviço em nuvem. O OCR de código aberto auto-hospedado é sua única opção.
- Você está fazendo pesquisa ou digitalização de arquivos onde a saída não alimenta um processo de negócios que exija dados estruturados.
Esses casos compartilham um ponto em comum: ou você já tem os recursos de engenharia para absorver o custo de configuração e manutenção, ou os requisitos de qualidade da saída são baixos o suficiente para que a correção de erros seja mínima.
Quando o OCR Pago é Realmente Mais Barato
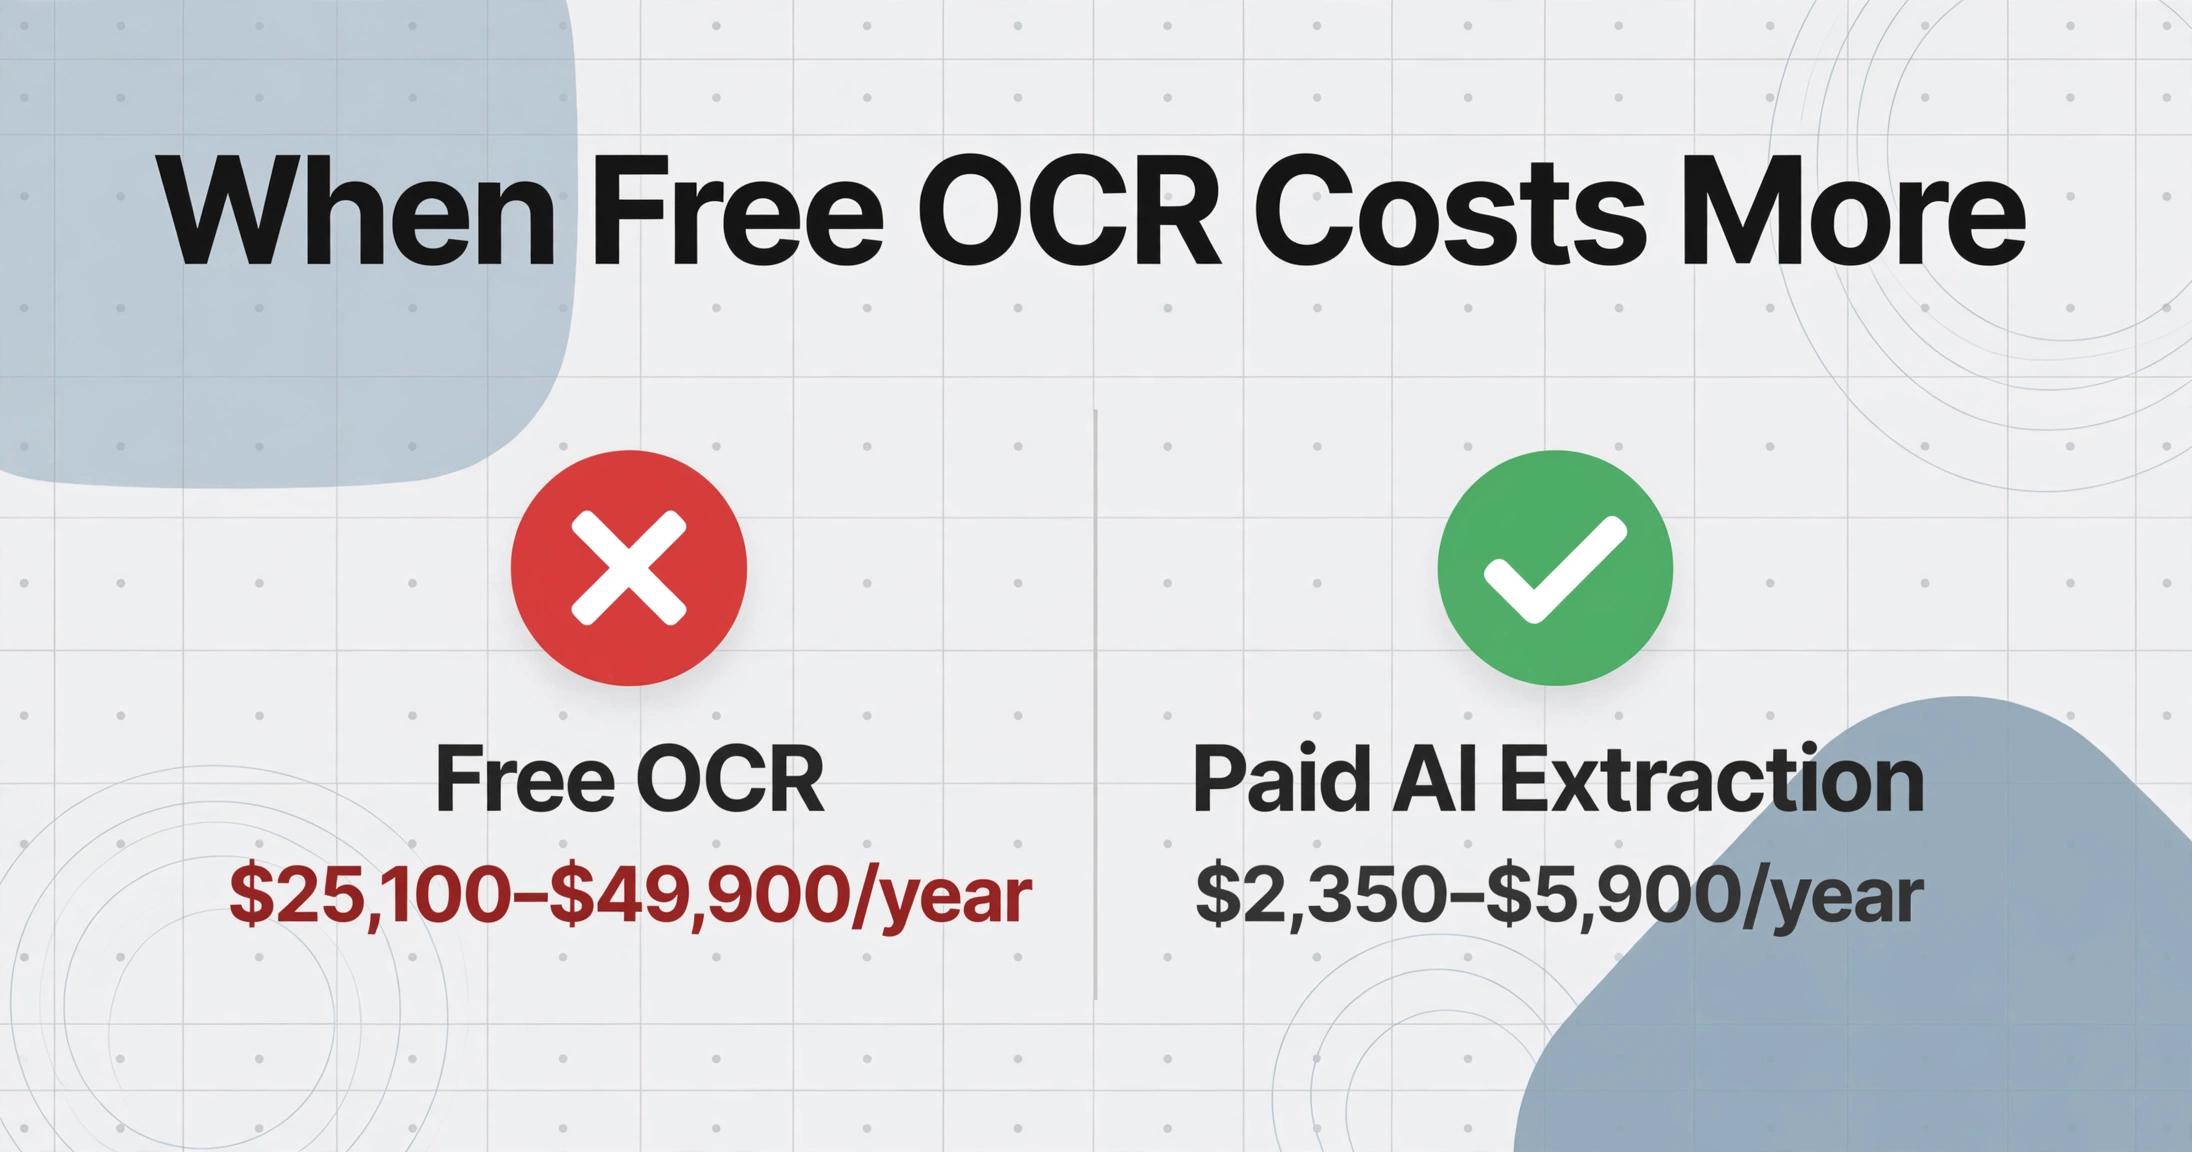
Se a sua situação se parece com alguma destas, uma opção paga provavelmente custa menos no total:
- Você processa mais de 100 documentos por mês de múltiplas fontes com formatos variados. O trabalho de correção do OCR gratuito nesse volume já supera o custo de uma assinatura.
- Seus documentos incluem digitalizações, fotos ou manuscritos. A precisão do OCR gratuito em entradas não ideais cai para 70–85%, e a diferença em relação aos 97–99% das ferramentas pagas aumenta rapidamente com o volume.
- Você precisa de saída de dados estruturados — linhas de Excel com colunas específicas, não texto bruto. Construir extração de tabelas sobre OCR de código aberto é um projeto de engenharia significativo.
- Você não tem uma equipe de engenharia dedicada. Se a sua configuração de OCR depende de um contratado ou da "pessoa mais técnica do escritório", o conhecimento vai embora quando essa pessoa sai.
- Erros de precisão trazem risco de conformidade ou financeiro. Um total de fatura errado, um ID de imposto mal lido ou uma data incorreta em um comprovante de entrega podem gerar multas, achados de auditoria ou disputas com clientes.
O erro mais comum que vemos é estimar apenas o custo da licença. Uma assinatura de US$ 20/mês que elimina 15 horas de correção manual se paga em qualquer taxa horária razoável. O software quase nunca custa mais do que o trabalho que ele substitui.
Este é o núcleo do que o software de OCR moderno entrega: não apenas reconhecimento de texto, mas um pipeline completo do documento ao dado utilizável com intervenção humana mínima. A assinatura paga pelo pipeline, não pelo reconhecimento.
FAQ
O OCR gratuito é preciso o suficiente para uso empresarial em 2026?
Depende da qualidade dos seus documentos. O OCR gratuito, como o Tesseract, alcança 95–99% em PDFs impressos por máquina, limpos e com fontes padrão. Mas em documentos digitalizados, fotos ou layouts não padronizados — que compõem a maioria dos documentos empresariais reais — a precisão cai para 70–85%. Nesse nível, a cada 4º a 6º documento, haverá pelo menos um erro significativo de extração. Para uso pessoal ocasional, isso pode ser aceitável. Para processos empresariais em que os dados alimentam sistemas de contabilidade, inventário ou conformidade, isso introduz risco inaceitável e custo de correção.
Ferramentas de OCR gratuito conseguem extrair tabelas para o Excel?
Não de forma confiável. O Tesseract e outros mecanismos de código aberto geram texto puro ou hOCR (formato OCR baseado em HTML). Eles não entendem a estrutura da tabela — não sabem quais células pertencem a quais linhas, se um cabeçalho de coluna se aplica aos dados abaixo ou como células mescladas devem se comportar. Converter essa saída em uma tabela Excel utilizável exige código de pós-processamento personalizado. APIs de nuvem, como Google Document AI e AWS Textract, têm modelos dedicados de extração de formulários e tabelas que lidam com isso nativamente. Algumas ferramentas de OCR gratuito com planos freemium oferecem saída estruturada, mas o plano gratuito geralmente é limitado em páginas por mês.
Quanto tempo leva para configurar um pipeline de OCR gratuito?
Instalar o mecanismo leva minutos. Construir um pipeline de produção que lide de forma confiável com documentos do mundo real leva de 40 a 80 horas para um desenvolvedor com experiência em OCR, e mais tempo sem ela. Isso inclui pré-processamento de imagem (correção de inclinação, binarização, redução de ruído), seleção do Modo de Segmentação de Página correto, escrita de scripts de pós-processamento para limpar a saída, construção de um fluxo de trabalho de ingestão de documentos e configuração do monitoramento de erros. O custo de configuração é o maior custo oculto do OCR gratuito que a maioria das comparações ignora.
O OCR gratuito consegue ler manuscritos?
Não. O Tesseract e o PaddleOCR foram projetados para reconhecimento de texto impresso. Eles não têm capacidade de reconhecimento de manuscritos. Algumas APIs em nuvem oferecem suporte limitado a manuscritos, mas a extração confiável de manuscritos — especialmente de escrita cursiva ou formulários manuscritos mistos — exige modelos modernos de visão e linguagem treinados especificamente em conjuntos de dados de documentos manuscritos. Este é um domínio de recursos em que as ferramentas gratuitas simplesmente não competem.
A partir de qual volume o OCR pago fica mais barato que o gratuito?
Com base em nossa modelagem de custos, o ponto de equilíbrio é de cerca de 100 a 150 documentos por mês. Abaixo disso, o trabalho de correção da ferramenta gratuita é pequeno o suficiente para que o custo de configuração (amortizado) domine, mas pode ser justificado se você já tiver a infraestrutura. Acima de 150 documentos por mês, o trabalho de correção decorrente da menor precisão de uma ferramenta gratuita supera consistentemente o custo da assinatura de uma alternativa paga quando você considera o tempo gasto. Com 500 ou mais documentos por mês, a diferença é grande o suficiente para que a opção paga seja inequivocamente mais barata.
Encontre Seu Ponto de Equilíbrio
A matemática muda para cada negócio. A qualidade real dos seus documentos, os formatos que você recebe e a precisão que você precisa alteram os números. A única forma de saber qual opção economiza dinheiro é testá-la nos seus documentos reais.