OCR gratuit ou payant 2026
Quand le gratuit coûte plus cher qu'un abonnement
Ce n'est pas une comparaison de fonctionnalités. C'est une analyse du coût de possession sur trois volumes réels de documents : 10 par mois, 500 par mois et 5 000 par mois. La question n'est pas de savoir si l'OCR gratuit existe — c'est de savoir si le temps de configuration, le travail de correction et la maintenance cachés dans le « gratuit » coûtent réellement plus qu'un abonnement.
Points clés à retenir
- 0 $ est le prix le plus dangereux dans l'automatisation de documents car il transfère le coût de votre ligne budgétaire logicielle vers votre masse salariale.
- Un abonnement à 20 $/mois élimine 15 heures de correction manuelle par mois — la main-d'œuvre seule coûte plus cher que la licence, quel que soit le taux horaire raisonnable.
- Le seul chiffre qui vaut la peine d'être comparé entre les outils gratuits et payants est le coût total par document : additionnez l'amortissement de la configuration, le travail de correction, la maintenance et la licence, puis divisez par le volume.
Le cadre : le coût total de l'OCR
La plupart des comparaisons entre l'OCR gratuit et payant s'arrêtent aux frais de licence. Une licence coûte 0 $ contre X $ par mois, donc le gratuit gagne, point final. Mais ce cadre ignore presque tout ce qui détermine si un outil OCR fait réellement économiser de l'argent à votre entreprise.
La reconnaissance optique de caractères — la technologie qui convertit le texte des images et des documents numérisés en données exploitables par machine — ne comprend que l'étape de reconnaissance. Ce qui compte en pratique, c'est l'ensemble du pipeline : faire entrer le document dans l'outil, faire extraire des données exploitables par l'outil, corriger ce qu'il a mal fait, et exporter ces données là où vous en avez besoin. Les outils gratuits déplacent le coût de la licence vers toutes les autres étapes de ce pipeline.
Cet article évalue les choix d'OCR selon quatre dimensions de coût :
- Coût de mise en place — temps d'installation, de configuration et d'intégration de l'outil dans un flux de travail
- Travail de correction par document — temps passé à corriger les erreurs d'extraction
- Frais de maintenance — effort pour maintenir le pipeline opérationnel à mesure que les formats de documents changent
- Frais de licence ou d'abonnement — le paiement initial ou récurrent
Chaque dimension de coût compte différemment selon le nombre de documents que vous traitez. C'est pourquoi nous effectuons les calculs à trois niveaux de volume.
Comparaison rapide : OCR gratuit ou payant en 2026
Le paysage de l'OCR en 2026 se divise en trois grandes catégories. Les outils open source gratuits comme Tesseract et PaddleOCR ne facturent rien pour le logiciel mais nécessitent une configuration technique. Les services d'API cloud comme Google Cloud Vision, AWS Textract et Azure Document Intelligence facturent par page sans configuration. Et les API d'extraction IA modernes offrent une extraction sémantique sans modèle à un tarif forfaitaire ou par page.
| Dimension | Open Source gratuit (Tesseract, PaddleOCR) | API Cloud (Google, AWS, Azure) | Extraction IA freemium |
|---|---|---|---|
| Précision — PDF propre | 95–99 % | 99 % et plus | 99 % et plus |
| Précision — scan ou photo | 70–85 % | 97–99 % | 95–99 % |
| Coût de mise en place | 40 à 80 heures d'ingénierie | 2 à 8 heures (intégration API) | 0 à 1 heure (téléversement et c'est tout) |
| Export tableau / structuré | Médiocre — nécessite du code personnalisé | Bon — intégré | Excellent — Excel / Sheets natif |
| Prise en charge de l'écriture manuscrite | Non prise en charge | Partielle | Prise en charge via les modèles de vision |
| Extraction sans modèle | Nécessite un entraînement personnalisé | Dépend de la mise en page | Native — extraction sémantique |
| Maintenance | Temps de développement continu | Gérée par le fournisseur | Gérée par le fournisseur |
| Coût de licence | 0 $ | 1,50 $ / 1 000 pages | Offre gratuite + à partir d'environ 10 $/mois |
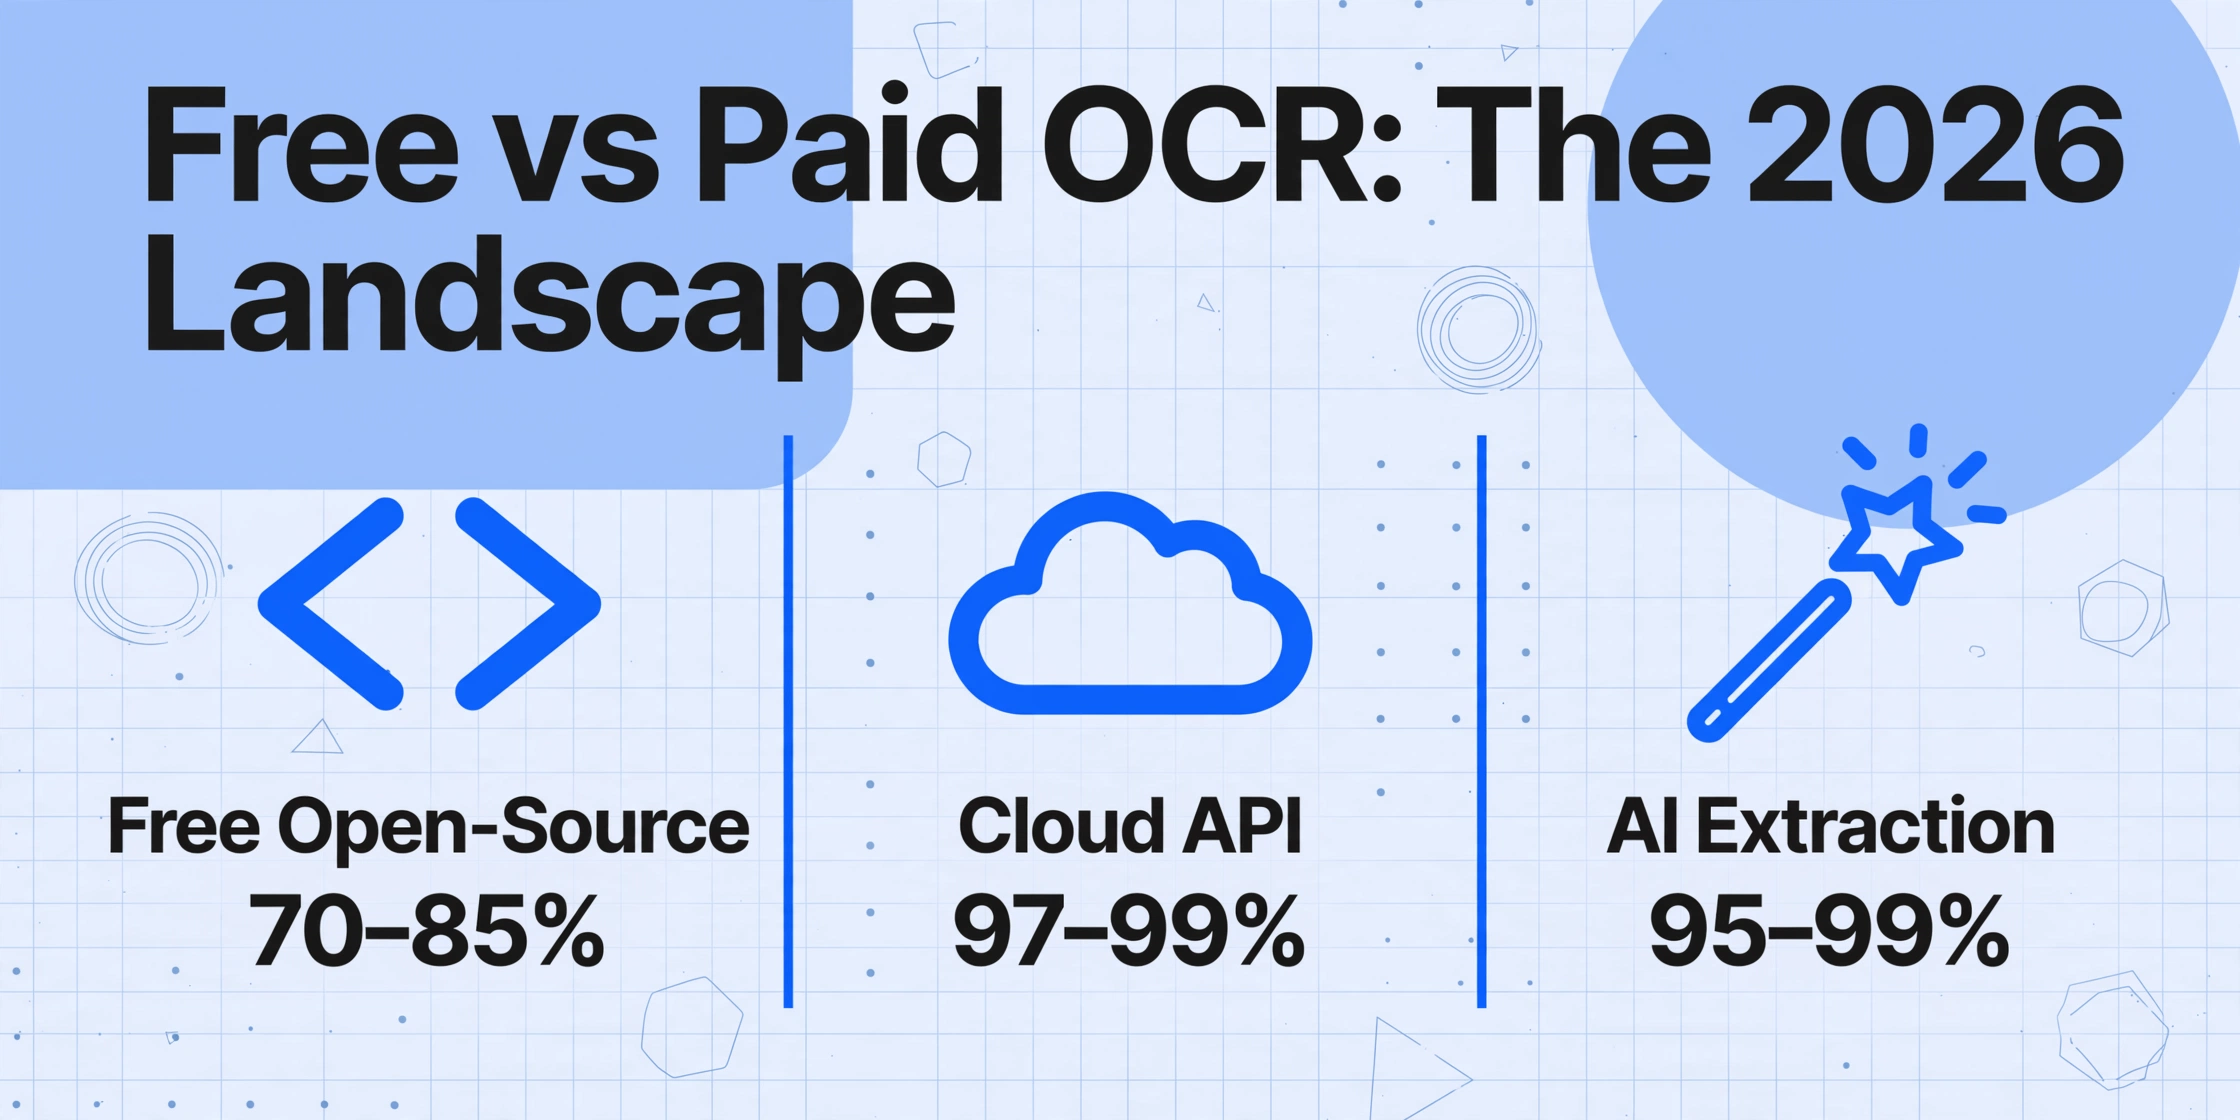
Le tableau montre ce que chaque catégorie peut faire. Mais la question n'est pas la capacité — c'est le coût de ces écarts de capacité dans votre flux de travail spécifique.
Le cadre du coût réel
Pour rendre cela concret, nous utilisons une formule simple :
Coût annuel total = Frais de licence + Configuration (amortie sur 3 ans) + Travail de correction + Maintenance
Nous amortissons la configuration sur 3 ans, car un pipeline OCR correctement conçu devrait durer aussi longtemps avant une refonte majeure. Le travail de correction est calculé à un taux horaire effectif de 35 $/heure — approximativement le coût combiné d'un employé salarié ou d'un opérateur indépendant traitant des documents dans un contexte de petite entreprise.
Les trois scénarios qui suivent représentent les volumes de documents les plus courants que nous observons en pratique, sur la base de conversations avec des utilisateurs qui évaluent des outils OCR pour leurs flux de travail.
Scénario 1 : 10 documents par mois — l'utilisateur occasionnel
Un teneur de livres indépendant reçoit 10 factures PDF par mois de ses clients. Les documents sont propres, les volumes sont faibles, et l'objectif est une extraction de texte de base pour recoupement avec les registres du client.
| Composante du coût | Open source gratuit | API cloud | Extraction IA freemium |
|---|---|---|---|
| Licence / abonnement | 0 $ | 0 $ (dans la limite de l'offre gratuite) | 0 $ (l'offre gratuite couvre ce besoin) |
| Configuration (amortie sur 3 ans) | 600–900 $/an (40–80 h × 35 $ / 3) | 0 $ | 0 $ |
| Travail de correction | ~140–210 $/an (~10 min/doc × 120 docs × écart) | ~35–70 $/an | ~35–70 $/an |
| Coût annuel total | 740–1 110 $ | 35–70 $ | 35–70 $ |
À 10 documents par mois, le coût de configuration d'un outil open source gratuit éclipse tout le reste. Même amorti sur trois ans, les 40 à 80 heures qu'un développeur doit consacrer à la création d'un pipeline de production font de l'option « gratuite » la plus coûteuse, et de loin.
Pour l'utilisateur occasionnel, la décision judicieuse est d'utiliser un niveau gratuit d'API cloud (la plupart offrent 500 à 1 000 pages gratuites par mois) ou un outil freemium avec une offre gratuite. Les deux offrent une grande précision sur des PDF propres, sans aucune configuration. La voie open source n'a de sens que si vous disposez déjà de l'infrastructure technique et que le pipeline sert plus que ce seul cas d'utilisation.
Scénario 2 : 500 documents par mois — la petite entreprise en croissance
Un petit sous-traitant du bâtiment traite 500 factures et bons de livraison par mois. Les documents proviennent de plusieurs fournisseurs — certains envoyés par e-mail sous forme de PDF propres, d'autres photographiés par les chefs de chantier sur leur téléphone. L'incohérence des formats est la norme, pas l'exception.
| Composante du coût | Open source gratuit | API cloud | Extraction IA freemium |
|---|---|---|---|
| Licence / abonnement | $0 | ~90 $/an (6 000 pages × 1,50 $/1 000) | ~120–240 $/an |
| Configuration (amortie sur 3 ans) | 600–900 $/an | $0 | $0 |
| Main-d'œuvre de correction (est.) | ~2 100–4 200 $/an (~20 % de taux d'erreur, 10–15 min/correction de doc) | ~350–700 $/an | ~175–525 $/an |
| Maintenance | ~700–1 400 $/an (changements de format fournisseur, dérive du modèle) | $0 | $0 |
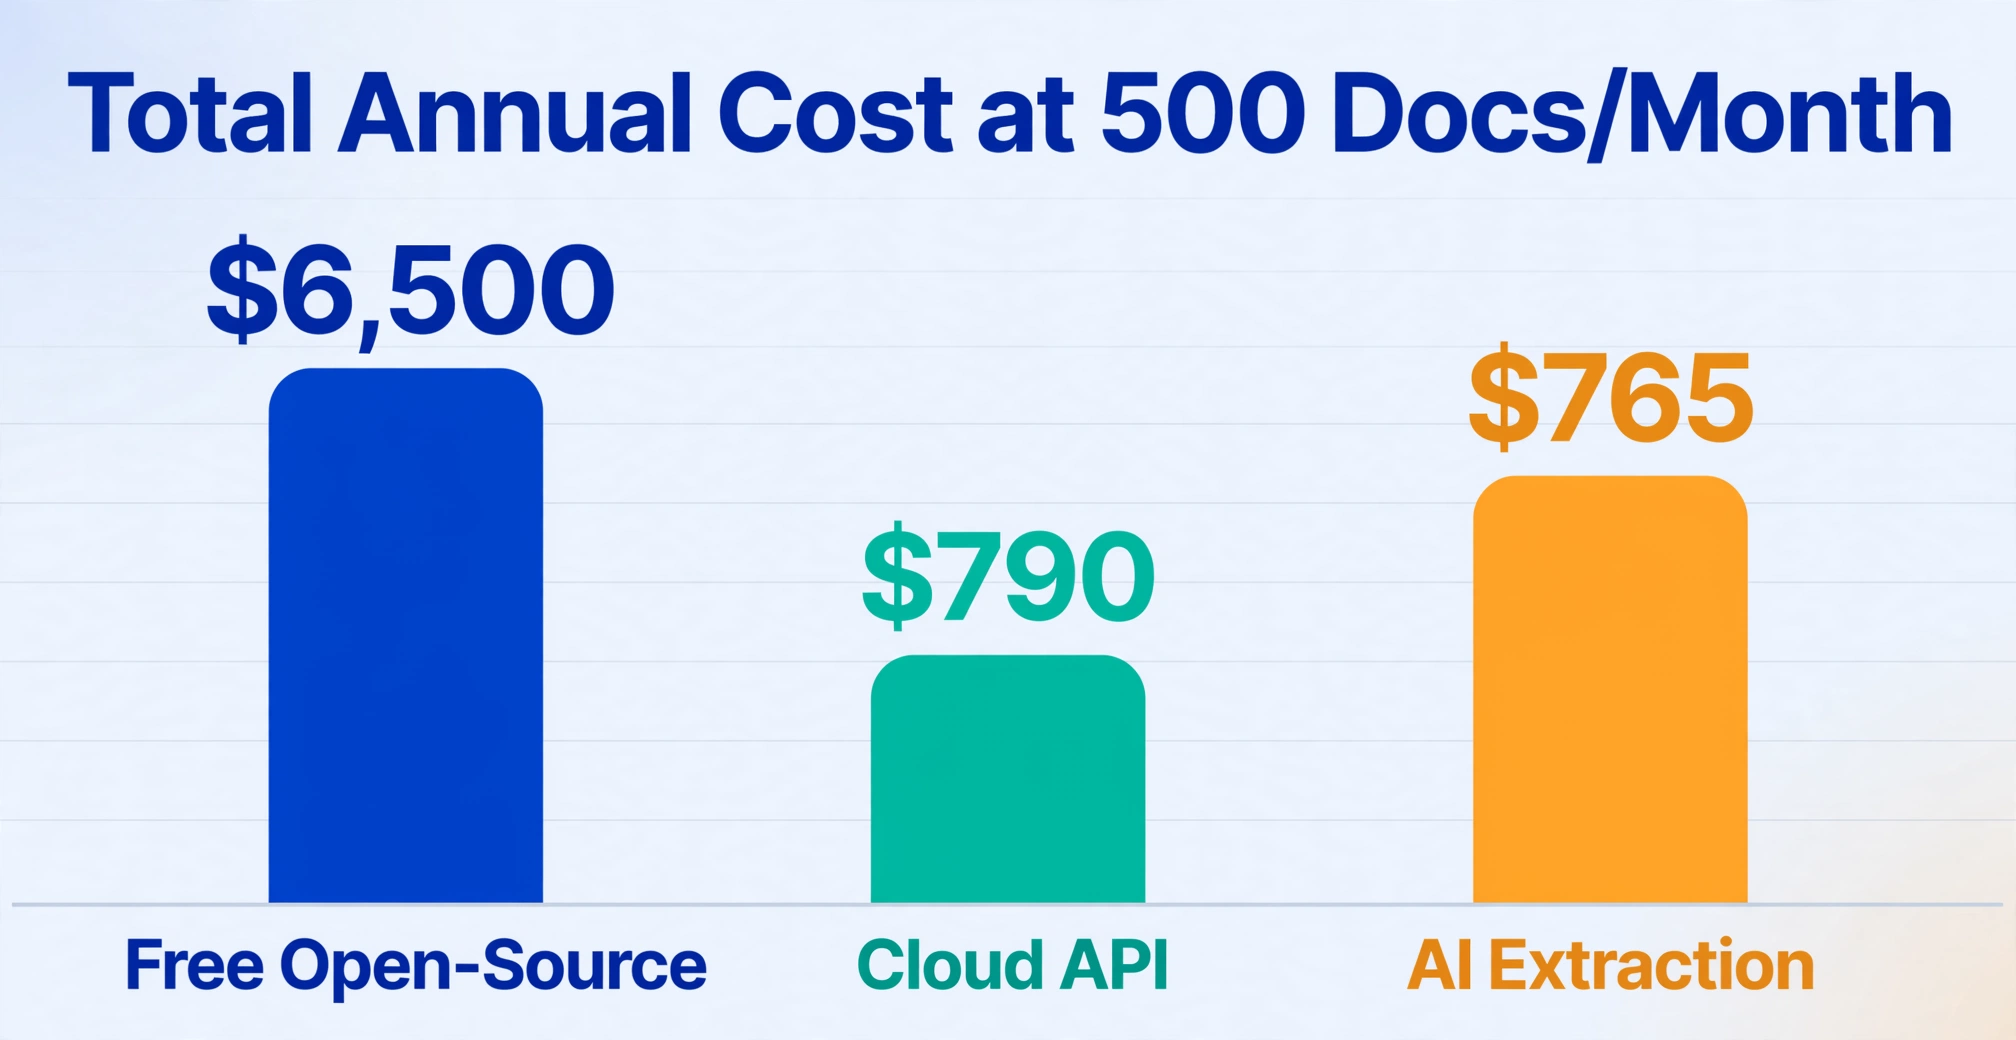
| Coût annuel total | 3 400–6 500 $ | 440–790 $ | 295–765 $ |
C'est ici que l'économie bascule de manière décisive. À 500 documents par mois, la main-d'œuvre de correction liée au taux d'erreur de 15–25 % d'un outil gratuit sur des scans réels consomme plus de temps que l'ensemble du budget qu'exigerait un outil payant. Le chef de chantier du sous-traitant — ou un administrateur à temps partiel — passe 20 à 40 heures par mois à corriger les erreurs d'extraction. À un coût mixte de 35 $/heure, cela représente 700 à 1 400 $ par mois en travail invisible.
Les outils OCR open source peuvent être réglés pour améliorer leur précision, mais le réglage prend lui-même du temps. Chaque nouveau format fournisseur qui s'écarte de ce pour lequel le pipeline a été calibré introduit un nouveau lot d'erreurs. La ligne de maintenance dans la colonne gratuite n'est pas théorique — c'est le temps de développeur consacré à la mise à jour des pipelines de prétraitement d'images, au réentraînement des modèles ou à l'ajustement des scripts de post-traitement lorsqu'un fournisseur modifie la mise en page de ses factures.
L'option API cloud élimine la configuration et la maintenance, mais peut encore avoir du mal avec des mises en page de documents incohérentes. La catégorie extraction IA freemium — des outils qui utilisent des modèles vision-langage pour comprendre la structure des documents de manière sémantique plutôt que positionnelle — gère la variation des formats sans configuration, ce qui explique pourquoi son estimation de main-d'œuvre de correction est la plus faible des trois.
Scénario 3 : 5 000 documents par mois — l'entreprise en pleine croissance
Une entreprise de logistique de taille moyenne traite 5 000 documents par mois : un mélange de bons de commande, de bordereaux d'expédition, d'accusés de réception et de factures provenant de centaines de fournisseurs. Les documents arrivent dans tous les formats imaginables — PDF envoyés par e-mail, TIFF multipages numérisés, photos de documents d'entrepôt prises avec un téléphone portable.
| Composant du coût | Open source gratuit | API cloud | Extraction IA freemium |
|---|---|---|---|
| Licence / abonnement | $0 | ~900 $/an (60 000 pages × 1,50 $/1 000) | ~600–2 400 $/an |
| Configuration (amortie sur 3 ans) | 600–900 $/an | $0 | $0 |
| Main-d'œuvre de correction (est.) | ~21 000–42 000 $/an (~15–20 % de taux d'erreur, ~10 min/doc) | ~3 500–7 000 $/an | ~1 750–3 500 $/an |
| Maintenance | ~3 500–7 000 $/an | $0 | $0 |
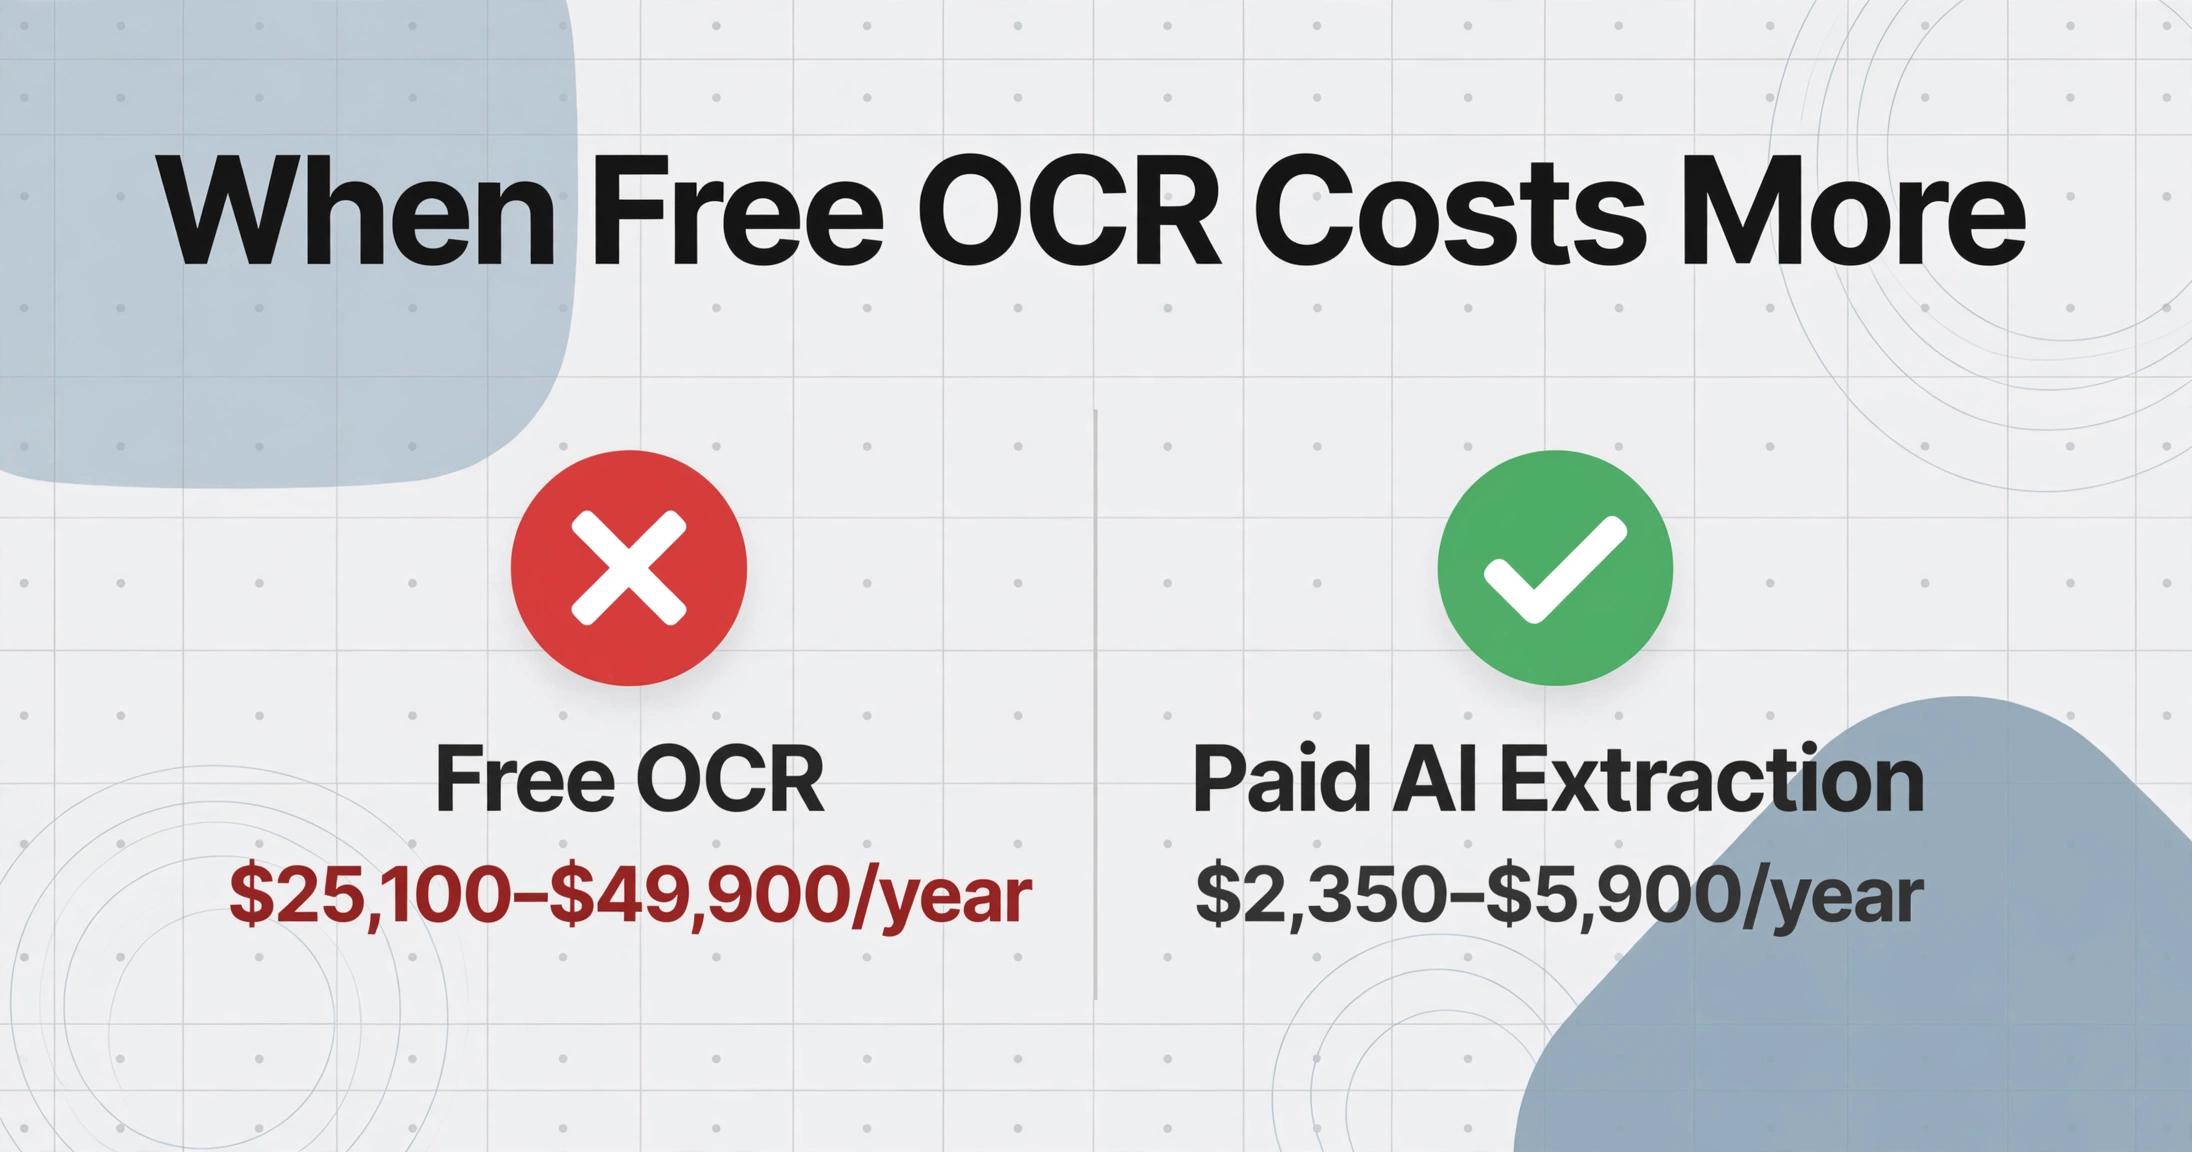
| Coût annuel total | 25 100–49 900 $ | 4 400–7 900 $ | 2 350–5 900 $ |
À 5 000 documents par mois, l'écart de coût entre le gratuit et le payant devient un ordre de grandeur. Même les estimations les plus optimistes placent la voie open source gratuite à plus de 25 000 $ par an — presque entièrement en main-d'œuvre de correction et en maintenance. Un commis à la saisie de données gagnant 35 000 $ par an peut gérer environ 25 à 30 % de la charge de correction à ce volume, en supposant des taux d'erreur de 15 à 20 %. Plus réaliste : l'entreprise a besoin de 1 à 2 employés à temps plein rien que pour corriger les erreurs d'OCR. Ce coût de personnel à lui seul dépasse toutes les options payantes.
C'est également le volume où la gravité des erreurs compte le plus. Un montant de facture mal lu qui passe inaperçu pendant des semaines — 14 500 $ reconnus comme 74 500 $ — peut prendre 2 à 4 heures à retracer et à corriger dans votre système comptable, comme l'a noté un utilisateur de Reddit sur r/Accounting. À 5 000 documents par mois, même un taux d'erreur critique de 1 % signifie 50 incidents de ce type par mois.
Les API cloud et les outils d'extraction IA n'éliminent pas toutes les erreurs, mais leur précision de 97 à 99 % sur des documents réels rend les corrections restantes gérables au sein de la capacité d'équipe existante. L'abonnement payant n'est qu'une erreur d'arrondi par rapport à la main-d'œuvre qu'il remplace.
Les coûts cachés de l'OCR « gratuit »
La licence est gratuite. Le coût total, lui, ne l'est pas. Voici les coûts qui n'apparaissent pas sur une page de tarification, mais qui se retrouvent sur la feuille de temps de votre équipe :
1. Temps de configuration technique
Installer Tesseract prend cinq minutes. Obtenir des résultats fiables et structurés à partir de documents professionnels réels prend des semaines. Vous devez sélectionner le bon mode de segmentation de page, prétraiter les images avec OpenCV (redressement, binarisation, débruitage), écrire des scripts de post-traitement pour nettoyer la sortie brute, et construire un pipeline qui relie le moteur OCR à votre base de données ou à votre tableur. Le dépôt GitHub de Tesseract précise explicitement que vous devrez améliorer la qualité des images pour obtenir de meilleurs résultats — ce travail d'amélioration est du temps d'ingénierie.
Pour un pipeline de production de 40 à 80 heures, en supposant un développeur à 70–100 $ de l'heure, charges comprises, cela représente 2 800–8 000 $ au départ — avant même le traitement d'un seul document.
2. Travail de correction des erreurs
Les moteurs OCR gratuits atteignent une précision de 70 à 85 % sur les documents numérisés et les photos — les formats qui dominent les flux de travail professionnels réels. Les PDF imprimés propres font figure d'exception, pas de règle. Chaque erreur d'extraction nécessite qu'une personne trouve, vérifie et corrige l'erreur. À grande échelle, cela devient le coût dominant.
L'aspect le plus insidieux de la correction des erreurs est qu'elle ne ressemble pas à un coût. Personne n'écrit de chèque pour « corriger les erreurs d'OCR ». Cela se manifeste par l'administrateur qui passe une heure supplémentaire par jour, le comptable qui vérifie chaque saisie, ou l'agent des comptes fournisseurs qui travaille tard. Mais c'est un coût réel, visible sur la masse salariale, sinon dans le budget logiciel.
3. Maintenance continue
Les documents professionnels évoluent. Un fournisseur repense la mise en page de ses factures. Une entreprise de livraison introduit un nouveau format de bon de livraison. Un prestataire commence à envoyer des PDF qui sont des images scannées plutôt que des fichiers numériques. Chaque changement peut dégrader la précision de l'OCR jusqu'à ce que le pipeline soit mis à jour. Quelqu'un doit surveiller ces régressions, en rechercher la cause et ajuster la logique de prétraitement ou de post-traitement. Cette personne n'est pas l'éditeur du logiciel — car avec des outils open source, il n'y a pas d'éditeur.
4. Contournements pour les fonctionnalités manquantes
Les moteurs OCR gratuits ne gèrent pas l'écriture manuscrite, n'extraient pas les tableaux en lignes structurées, ne comprennent pas la sémantique des cases à cocher et ne reconnaissent ni les signatures ni les tampons. Si vos documents contiennent l'un de ces éléments — et c'est le cas de la plupart des documents professionnels — vous devrez créer des contournements. Ce contournement est un autre projet non budgété.
C'est là que l'écart entre l'OCR traditionnel et l'extraction IA moderne devient le plus visible. Les moteurs OCR traditionnels sont des outils de reconnaissance : ils convertissent les pixels en caractères. Les outils modernes comme le logiciel OCR IA utilisent des modèles vision-langage qui comprennent la structure sémantique des documents — ils font la différence entre un en-tête et une cellule de données, ils peuvent identifier les tableaux même sans bordures explicites, et ils extraient le sens plutôt que le simple texte.
Quand l'OCR gratuit est le bon choix
L'OCR open source gratuit n'est pas un piège. C'est véritablement le bon outil dans des situations spécifiques :
- Vous êtes un développeur créant un pipeline personnalisé et vous disposez d'une expertise OCR en interne. La flexibilité de Tesseract ou de PaddleOCR vous permet de régler chaque paramètre et de l'intégrer profondément dans votre pile technique.
- Vous ne traitez que des PDF numériques propres avec des mises en page cohérentes. La précision de Tesseract sur du texte imprimé par machine dans une police standard approche les 99 %.
- Votre volume est très faible — moins de 50 documents par mois. À ce niveau, même un pipeline gratuit sous-optimal coûte moins cher en main-d'œuvre totale que la charge cognitive liée à l'évaluation et à l'adoption d'un outil payant.
- Vous êtes soumis à des exigences strictes de résidence des données ou de réseau isolé et vous ne pouvez pas envoyer de documents à un service cloud. L'OCR open source auto-hébergé est votre seule option.
- Vous faites de la recherche ou de la numérisation d'archives où la sortie n'alimente pas un processus métier exigeant des données structurées.
Ces cas partagent un point commun : soit vous disposez déjà des ressources d'ingénierie pour absorber le coût de mise en place et de maintenance, soit les exigences de qualité de sortie sont suffisamment faibles pour que la correction des erreurs soit minimale.
Quand l'OCR payant est en réalité moins cher
Si votre situation ressemble à l'un de ces cas, une option payante coûte probablement moins cher au total :
- Vous traitez plus de 100 documents par mois provenant de sources multiples avec des formats variés. Le travail de correction lié à l'OCR gratuit à ce volume dépasse déjà un abonnement.
- Vos documents incluent des scans, des photos ou de l'écriture manuscrite. La précision de l'OCR gratuit sur des entrées non idéales chute à 70–85 %, et l'écart par rapport aux 97–99 % des outils payants se creuse rapidement avec le volume.
- Vous avez besoin d'une sortie de données structurées — des lignes Excel avec des colonnes spécifiques, pas du texte brut. Construire une extraction de tableaux à partir d'un OCR open source est un projet d'ingénierie considérable.
- Vous n'avez pas d'équipe d'ingénierie dédiée. Si votre configuration OCR dépend d'un prestataire ou de la « personne la plus à l'aise avec la technologie au bureau », le savoir-faire disparaît avec eux.
- Les erreurs de précision comportent un risque de conformité ou financier. Un total de facture erroné, un numéro d'identification fiscale mal lu ou une date incorrecte sur un bon de livraison peuvent entraîner des pénalités, des constats d'audit ou des litiges clients.
L'erreur la plus courante que nous constatons est de n'estimer que le coût de la licence. Un abonnement à 20 $/mois qui élimine 15 heures de correction manuelle est rentabilisé à tout taux horaire raisonnable. Le logiciel ne coûte presque jamais plus cher que la main-d'œuvre qu'il remplace.
C'est le cœur de ce que les logiciels OCR modernes offrent : non seulement la reconnaissance de texte, mais aussi un pipeline complet du document aux données exploitables avec une intervention humaine minimale. L'abonnement paie pour le pipeline, pas pour la reconnaissance.
FAQ
L'OCR gratuit est-il assez précis pour un usage professionnel en 2026 ?
Cela dépend de la qualité de vos documents. L'OCR gratuit comme Tesseract atteint 95–99 % sur des PDF imprimés proprement avec des polices standard. Mais sur des documents scannés, des photos ou des mises en page non standard — qui constituent la majorité des documents professionnels réels — la précision chute à 70–85 %. À ce niveau, un document sur quatre à six contiendra au moins une erreur d'extraction significative. Pour un usage personnel occasionnel, cela peut être acceptable. Pour des processus métier où les données alimentent la comptabilité, les stocks ou la conformité, cela introduit un risque inacceptable et une charge de correction importante.
Les outils OCR gratuits peuvent-ils extraire des tableaux dans Excel ?
Pas de manière fiable. Tesseract et les autres moteurs open source produisent du texte brut ou du hOCR (format OCR basé sur HTML). Ils ne comprennent pas la structure des tableaux — ils ne savent pas quelles cellules appartiennent à quelle ligne, si un en-tête de colonne s'applique aux données en dessous, ou comment les cellules fusionnées doivent se comporter. Convertir cette sortie en tableau Excel utilisable nécessite un code de post-traitement personnalisé. Les API cloud comme Google Document AI et AWS Textract disposent de modèles dédiés d'extraction de formulaires et de tableaux qui gèrent cela nativement. Certains outils OCR gratuits avec des offres freemium proposent une sortie structurée, mais le niveau gratuit est généralement limité en pages par mois.
Combien de temps faut-il pour configurer un pipeline OCR gratuit ?
L'installation du moteur prend quelques minutes. La création d'un pipeline de production qui gère de manière fiable les documents réels prend 40 à 80 heures pour un développeur ayant de l'expérience en OCR, et plus longtemps sans cette expérience. Cela inclut le prétraitement d'image (redressement, binarisation, réduction du bruit), la sélection du mode de segmentation de page correct, l'écriture de scripts de post-traitement pour nettoyer la sortie, la création d'un flux de travail d'ingestion de documents et la mise en place d'une surveillance des erreurs. Le coût de configuration est le coût caché le plus important de l'OCR gratuit, que la plupart des comparaisons ignorent.
Un OCR gratuit peut-il lire l'écriture manuscrite ?
Non. Tesseract et PaddleOCR ont été conçus pour la reconnaissance de texte imprimé. Ils n'ont aucune capacité de reconnaissance d'écriture manuscrite. Certaines API cloud offrent une prise en charge limitée de l'écriture manuscrite, mais une extraction fiable de l'écriture manuscrite — en particulier pour l'écriture cursive ou les formes manuscrites mixtes — nécessite des modèles modernes de vision-langage spécifiquement entraînés sur des ensembles de données de documents manuscrits. C'est un domaine où les outils gratuits ne peuvent tout simplement pas rivaliser.
À quel volume un OCR payant devient-il moins cher qu'un OCR gratuit ?
Selon notre modélisation des coûts, le seuil de rentabilité se situe autour de 100 à 150 documents par mois. En dessous de ce seuil, le travail de correction de l'outil gratuit est suffisamment faible pour que le coût de mise en place (amorti) domine, mais il peut se justifier si vous disposez déjà de l'infrastructure. Au-delà de 150 documents par mois, le travail de correction dû à la moindre précision d'un outil gratuit dépasse systématiquement le coût d'abonnement d'une alternative payante lorsque l'on tient compte du temps passé. À partir de 500 documents par mois, l'écart est suffisamment large pour que l'option payante soit sans ambiguïté moins chère.
Trouvez votre point d'équilibre
Les calculs changent pour chaque entreprise. La qualité réelle de vos documents, les formats que vous recevez et la précision dont vous avez besoin modifient tous les chiffres. Le seul moyen de savoir quelle option vous fait économiser de l'argent est de la tester sur vos propres documents.