Kostenlose OCR vs. kostenpflichtige OCR 2026
Wenn „Gratis“ teurer ist als ein Abo
Dies ist kein Feature-Vergleich, sondern eine Analyse der Gesamtbetriebskosten anhand von drei realen Dokumentvolumina: 10 pro Monat, 500 pro Monat und 5.000 pro Monat. Die Frage ist nicht, ob kostenlose OCR existiert – sondern ob Einrichtungszeit, Korrekturaufwand und Wartung, die in „Gratis“ versteckt sind, tatsächlich mehr kosten als ein Abonnement.
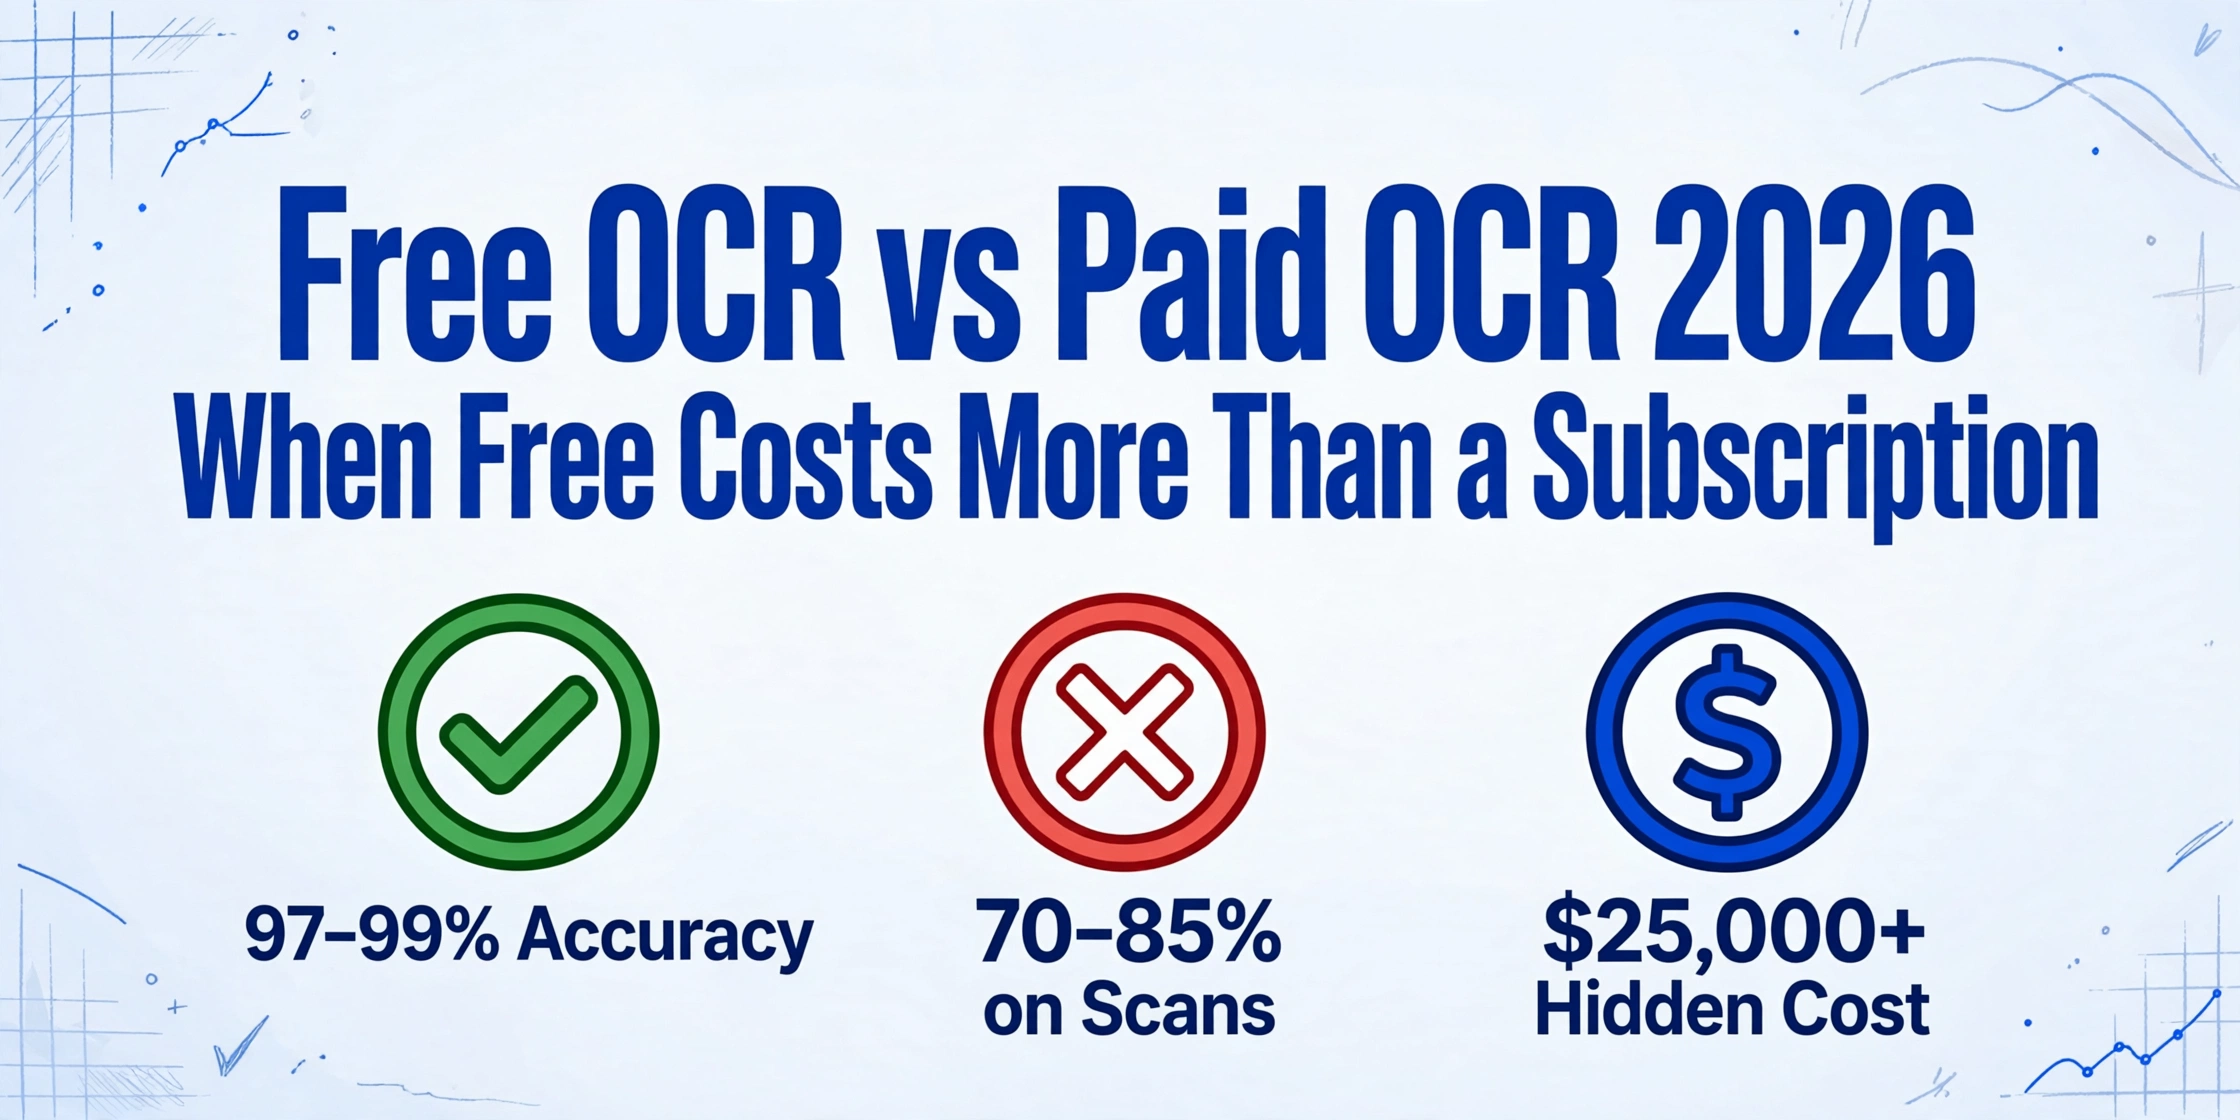
Die wichtigsten Erkenntnisse
- 0 $ ist der gefährlichste Preis in der Dokumentenautomatisierung, weil er die Kosten von Ihrer Software-Budgetzeile in Ihre Lohnkosten verschiebt.
- Ein einziges Abonnement für 20 $/Monat eliminiert 15 Stunden manuelle Korrektur pro Monat – die Arbeitskosten allein übersteigen die Lizenzgebühr bei jedem vernünftigen Stundensatz.
- Die einzige Zahl, die bei kostenlosen und kostenpflichtigen Tools verglichen werden sollte, sind die Gesamtkosten pro Dokument: Addieren Sie Einrichtungsamortisation, Korrekturaufwand, Wartung und Lizenz und teilen Sie durch das Volumen.
Das Framework: Gesamtkosten der OCR
Die meisten Vergleiche zwischen kostenloser und kostenpflichtiger OCR enden bei der Lizenzgebühr. Eine Lizenz kostet $0 gegenüber $X pro Monat, also gewinnt die kostenlose Variante – Ende der Geschichte. Doch diese Betrachtung ignoriert fast alles, was tatsächlich darüber entscheidet, ob ein OCR-Tool Ihrem Unternehmen Geld spart.
Optische Zeichenerkennung – die Technologie, die Text in Bildern und gescannten Dokumenten in maschinenlesbare Daten umwandelt – umfasst nur den Erkennungsschritt. Was in der Praxis zählt, ist die gesamte Pipeline: das Dokument in das Tool bekommen, das Tool nutzbare Daten extrahieren lassen, Fehler korrigieren und die Daten dorthin exportieren, wo Sie sie benötigen. Kostenlose Tools verlagern die Kosten von der Lizenzierung in jeden anderen Schritt dieser Pipeline.
Dieser Artikel bewertet OCR-Optionen anhand von vier Kostendimensionen:
- Einrichtungskosten – Zeit für Installation, Konfiguration und Integration des Tools in einen Workflow
- Korrekturaufwand pro Dokument – Zeit für die Behebung von Extraktionsfehlern
- Wartungsaufwand – Aufwand, um die Pipeline bei sich ändernden Dokumentformaten am Laufen zu halten
- Lizenz- oder Abonnementgebühr – die einmalige oder wiederkehrende Zahlung
Jede Kostendimension hat je nach Dokumentvolumen unterschiedliches Gewicht. Deshalb berechnen wir die Zahlen auf drei Volumenstufen.
Schnellvergleich: Kostenlose vs. kostenpflichtige OCR im Jahr 2026
Die OCR-Landschaft 2026 teilt sich in drei große Kategorien. Kostenlose Open-Source-Tools wie Tesseract und PaddleOCR verlangen kein Geld für die Software, erfordern aber technische Einrichtung. Cloud-API-Dienste wie Google Cloud Vision, AWS Textract und Azure Document Intelligence berechnen pro Seite ohne Einrichtungsaufwand. Und moderne KI-Extraktions-APIs bieten ohne Vorlage semantische Extraktion zu einem festen Abonnement- oder Pro-Seite-Preis.
| Dimension | Kostenlose Open-Source-Lösung (Tesseract, PaddleOCR) | Cloud-API (Google, AWS, Azure) | Freemium-AI-Extraktion |
|---|---|---|---|
| Genauigkeit – sauberes PDF | 95–99 % | 99 %+ | 99 %+ |
| Genauigkeit – Scan oder Foto | 70–85 % | 97–99 % | 95–99 % |
| Einrichtungskosten | 40–80 Entwicklungsstunden | 2–8 Stunden (API-Integration) | 0–1 Stunde (hochladen und loslegen) |
| Tabellen-/strukturierter Export | Schwach – erfordert eigenen Code | Gut – integriert | Hervorragend – nativ in Excel/Sheets |
| Handschriftunterstützung | Nicht unterstützt | Teilweise | Unterstützt über Vision-Modelle |
| Extraktion ohne Vorlage | Erfordert individuelles Training | Layoutabhängig | Nativ – semantische Extraktion |
| Wartung | Laufender Entwicklungsaufwand | Vom Anbieter verwaltet | Vom Anbieter verwaltet |
| Lizenzkosten | $0 | $1,50 / 1.000 Seiten | Kostenlose Stufe + ab ca. $10/Monat |
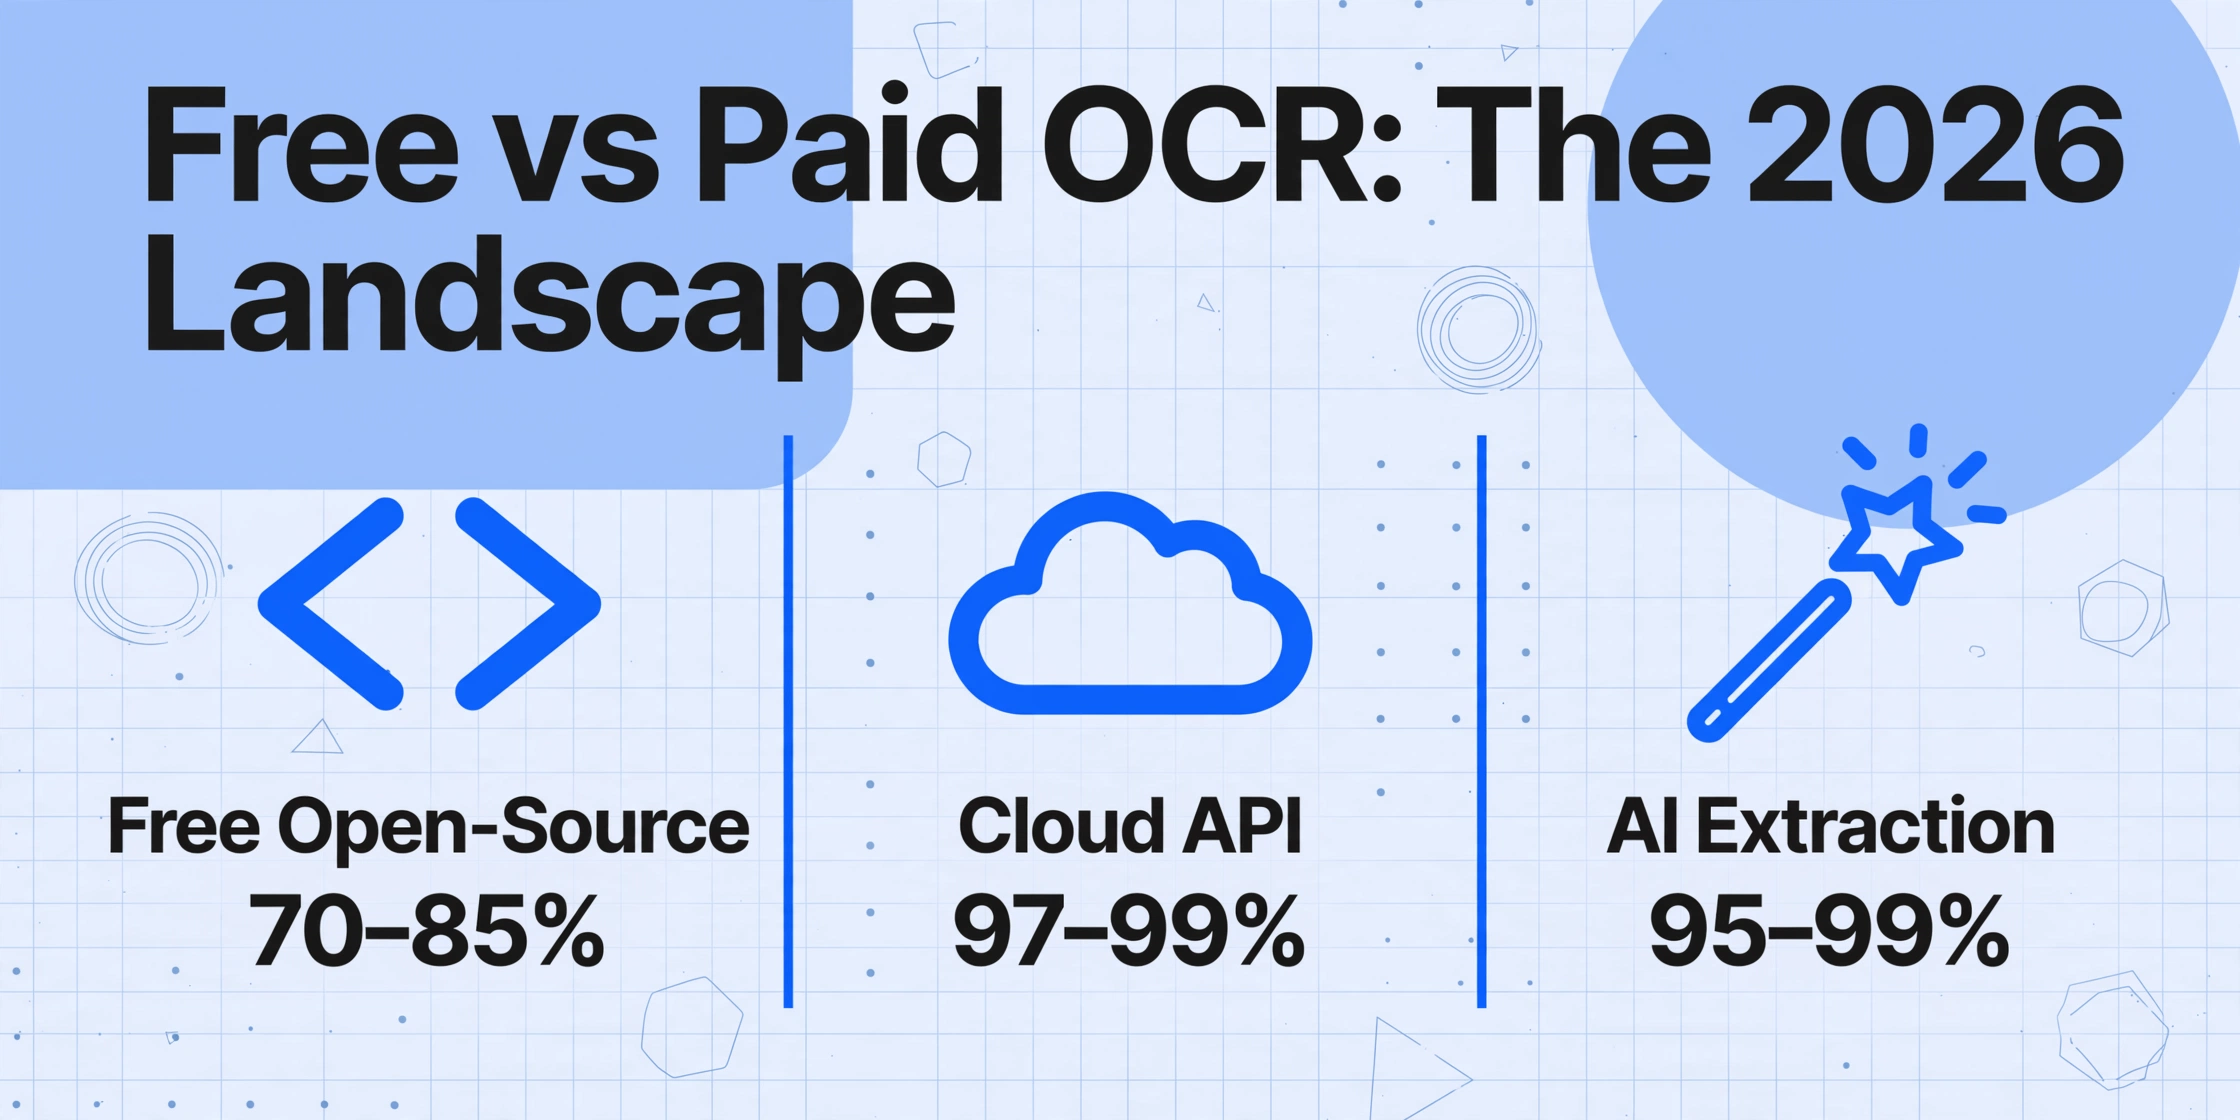
Die Tabelle zeigt, was jede Kategorie kann. Aber die Frage ist nicht die Leistungsfähigkeit – sondern was diese Leistungslücken in Ihrem spezifischen Workflow kosten.
Das Framework der tatsächlichen Kosten
Um dies konkret zu machen, verwenden wir eine einfache Formel:
Gesamtkosten pro Jahr = Lizenzgebühr + Einrichtung (über 3 Jahre amortisiert) + Korrekturaufwand + Wartung
Wir amortisieren die Einrichtung über 3 Jahre, da eine ordentlich aufgebaute OCR-Pipeline so lange halten sollte, bevor ein größerer Umbau nötig wird. Der Korrekturaufwand wird mit einem effektiven Stundensatz von $35/Stunde berechnet – ungefähr die Mischkalkulation aus einem festangestellten Mitarbeiter oder freiberuflichen Operator, der Dokumentenverarbeitung im Kontext eines kleinen Unternehmens übernimmt.
Die drei folgenden Szenarien repräsentieren die häufigsten Dokumentvolumina, die wir in der Praxis sehen, basierend auf Gesprächen mit Nutzern, die OCR-Tools für ihre Arbeitsabläufe evaluieren.
Szenario 1: 10 Dokumente pro Monat – Der Gelegenheitsnutzer
Ein freiberuflicher Buchhalter erhält 10 Rechnungs-PDFs pro Monat von Kunden. Die Dokumente sind sauber, die Volumina gering, und das Ziel ist die grundlegende Textextraktion zum Abgleich mit den Aufzeichnungen des Kunden.
| Kostenkomponente | Kostenlose Open-Source-Lösung | Cloud-API | Freemium-AI-Extraktion |
|---|---|---|---|
| Lizenz / Abonnement | $0 | $0 (bleibt innerhalb des kostenlosen Kontingents) | $0 (kostenloses Kontingent deckt dies ab) |
| Einrichtung (3 Jahre amortisiert) | $600–$900/Jahr (40–80 Std. × $35 / 3) | $0 | $0 |
| Korrekturaufwand | ~$140–$210/Jahr (~10 Min./Dok. × 120 Dok. × Lücke) | ~$35–$70/Jahr | ~$35–$70/Jahr |
| Gesamtkosten pro Jahr | $740–$1.110 | $35–$70 | $35–$70 |
Bei 10 Dokumenten pro Monat übertrifft der Einrichtungsaufwand einer kostenlosen Open-Source-Lösung alles andere. Selbst über drei Jahre amortisiert, machen die 40–80 Stunden, die ein Entwickler für den Aufbau einer Produktionspipeline benötigt, die „kostenlose“ Option mit Abstand zur teuersten.
Für den Gelegenheitsnutzer ist der kluge Schritt, ein kostenloses Cloud-API-Kontingent zu nutzen (die meisten bieten 500–1.000 kostenlose Seiten pro Monat) oder ein Freemium-Tool mit kostenlosem Nutzungskontingent. Beide liefern hohe Genauigkeit bei sauberen PDFs ohne Einrichtungsaufwand. Der Open-Source-Weg ist nur dann sinnvoll, wenn Sie bereits über die technische Infrastruktur verfügen und die Pipeline mehr als diesen einen Anwendungsfall bedient.
Szenario 2: 500 Dokumente pro Monat – Das wachsende Kleinunternehmen
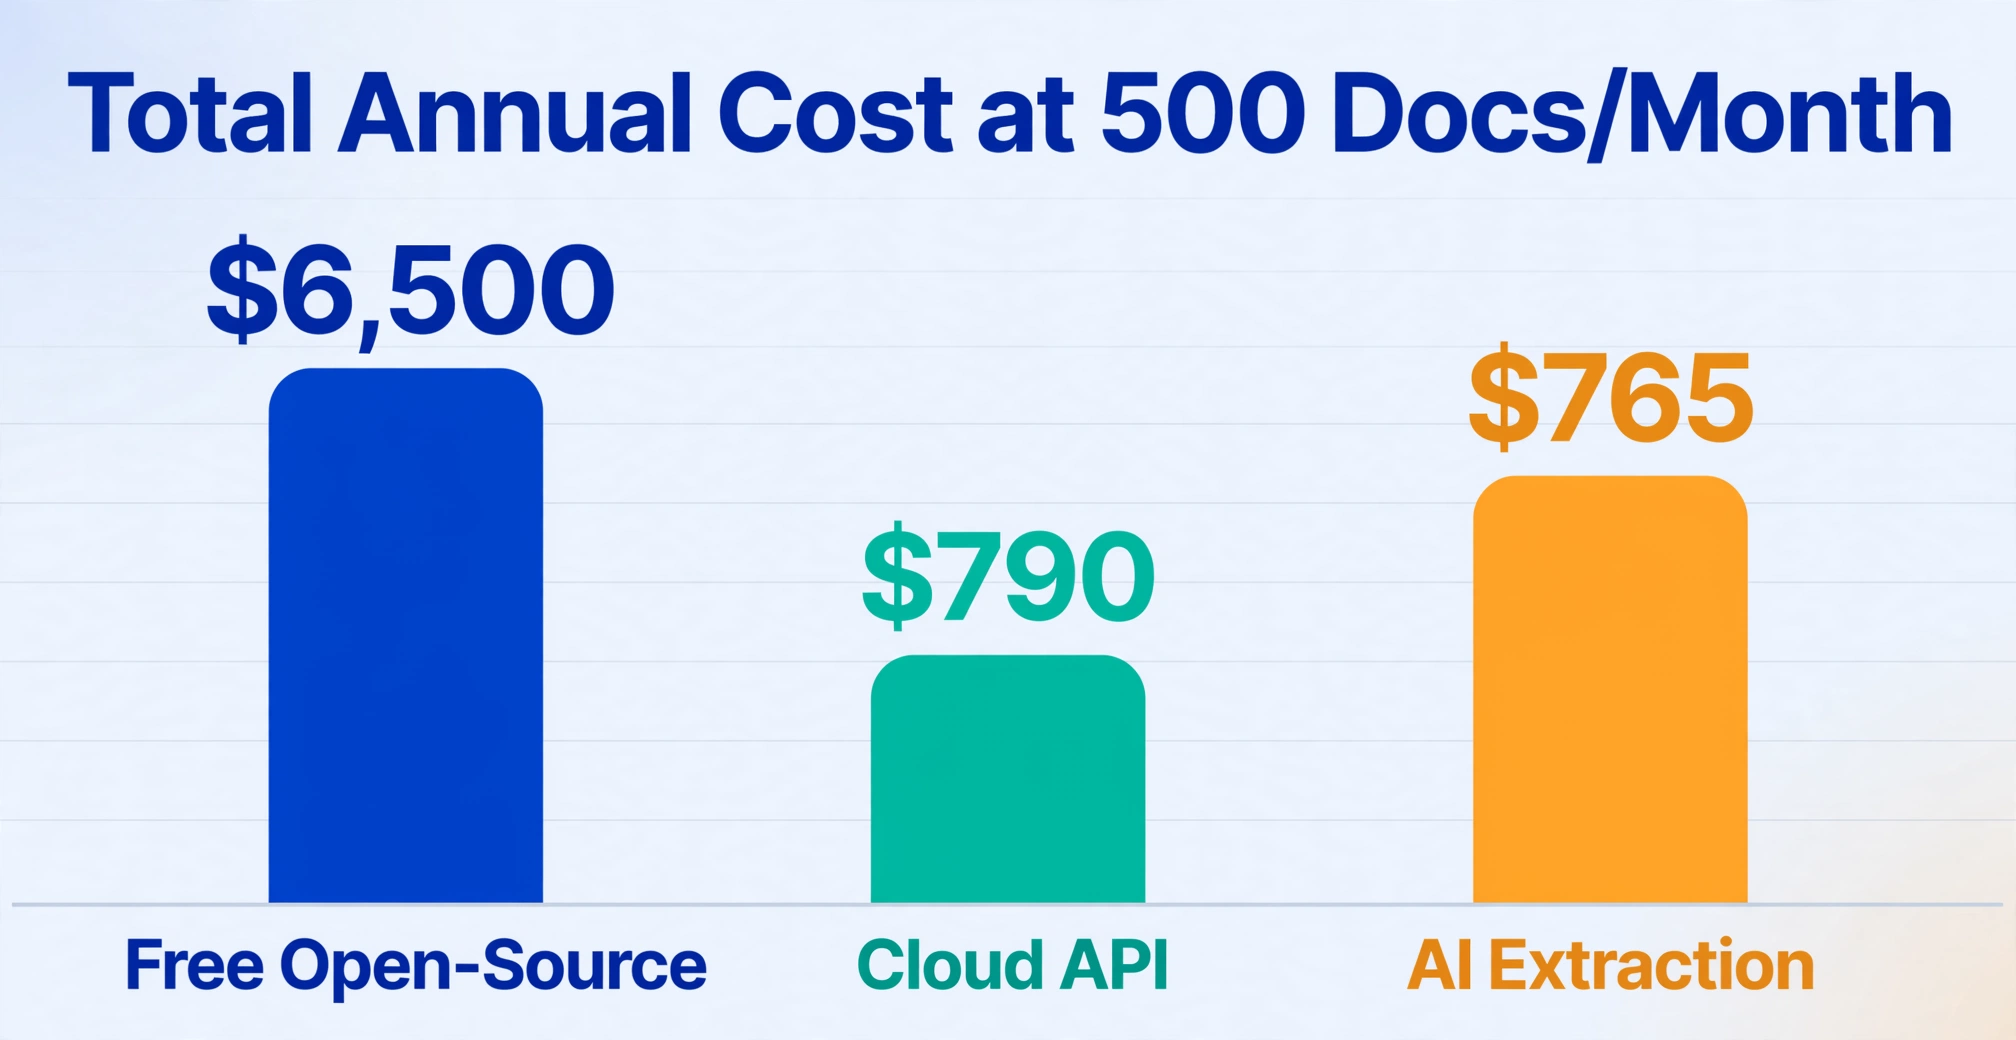
Ein kleiner Bauunternehmer verarbeitet 500 Rechnungen und Lieferscheine pro Monat. Die Dokumente stammen von mehreren Lieferanten – einige werden als saubere PDFs per E-Mail gesendet, andere werden von Bauleitern vor Ort mit dem Handy fotografiert. Formatinkonsistenz ist die Norm, nicht die Ausnahme.
| Kostenkomponente | Kostenlose Open-Source | Cloud-API | Freemium-AI-Extraktion |
|---|---|---|---|
| Lizenz / Abonnement | $0 | ~$90/Jahr (6.000 Seiten × $1,50/1k) | ~$120–$240/Jahr |
| Einrichtung (über 3 Jahre abgeschrieben) | $600–$900/Jahr | $0 | $0 |
| Korrekturaufwand (geschätzt) | ~$2.100–$4.200/Jahr (~20 % Fehlerquote, 10–15 Min./Dokument Korrektur) | ~$350–$700/Jahr | ~$175–$525/Jahr |
| Wartung | ~$700–$1.400/Jahr (Lieferantenformatänderungen, Modelldrift) | $0 | $0 |
| Jährliche Gesamtkosten | $3.400–$6.500 | $440–$790 | $295–$765 |
Hier kippt die Wirtschaftlichkeit entscheidend. Bei 500 Dokumenten pro Monat kostet die Korrekturarbeit aufgrund der 15–25 % Fehlerquote eines kostenlosen Tools bei realen Scans mehr Zeit als das gesamte Budget, das ein kostenpflichtiges Tool erfordern würde. Der Bauleiter des Unternehmens – oder ein Teilzeit-Administrator – verbringt 20–40 Stunden pro Monat damit, Extraktionsfehler zu beheben. Bei Mischkosten von $35/Stunde sind das $700–$1.400 pro Monat an unsichtbarer Arbeit.
Open-Source-OCR-Tools können zur Verbesserung der Genauigkeit optimiert werden, aber die Optimierung selbst kostet Zeit. Jedes neue Lieferantenformat, das von dem abweicht, worauf die Pipeline kalibriert wurde, bringt eine neue Reihe von Fehlern mit sich. Der Wartungsposten in der kostenlosen Spalte ist nicht theoretisch – es ist die Entwicklerzeit, die für die Aktualisierung von Bildvorverarbeitungs-Pipelines, das Neulernen von Modellen oder die Anpassung von Nachbearbeitungsskripten aufgewendet wird, wenn ein Lieferant sein Rechnungslayout ändert.
Die Cloud-API-Option eliminiert Einrichtung und Wartung, kann aber bei inkonsistenten Dokumentlayouts weiterhin Probleme bereiten. Die Kategorie Freemium-AI-Extraktion – Tools, die Vision-Language-Modelle verwenden, um die Dokumentstruktur semantisch statt positionell zu verstehen – bewältigt Formatvariationen ohne Konfiguration, weshalb ihre Schätzung für Korrekturaufwand die niedrigste der drei ist.
Szenario 3: 5.000 Dokumente pro Monat – Das wachsende Unternehmen
Ein mittelständisches Logistikunternehmen verarbeitet monatlich 5.000 Dokumente: eine Mischung aus Bestellungen, Lieferscheinen, Lieferbestätigungen und Rechnungen von Hunderten von Lieferanten. Die Dokumente treffen in jedem erdenklichen Format ein – per E-Mail gesendete PDFs, gescannte mehrseitige TIFF-Dateien, Handyfotos von Lagerpapierkram.
| Kostenkomponente | Kostenlose Open-Source | Cloud-API | Freemium-AI-Extraktion |
|---|---|---|---|
| Lizenz / Abonnement | $0 | ~900 $/Jahr (60.000 Seiten × 1,50 $/1.000) | ~600–2.400 $/Jahr |
| Einrichtung (über 3 Jahre abgeschrieben) | 600–900 $/Jahr | $0 | $0 |
| Korrekturaufwand (geschätzt) | ~21.000–42.000 $/Jahr (~15–20 % Fehlerquote, ~10 Min./Dokument) | ~3.500–7.000 $/Jahr | ~1.750–3.500 $/Jahr |
| Wartung | ~3.500–7.000 $/Jahr | $0 | $0 |
| Jährliche Gesamtkosten | 25.100–49.900 $ | 4.400–7.900 $ | 2.350–5.900 $ |
Bei 5.000 Dokumenten pro Monat wird der Kostenvorteil zwischen kostenlos und kostenpflichtig zu einer Größenordnung. Selbst die optimistischsten Schätzungen beziffern den kostenlosen Open-Source-Weg auf über 25.000 $ pro Jahr – fast vollständig durch Korrekturaufwand und Wartung. Ein einzelner Datenerfasser mit einem Jahresgehalt von 35.000 $ kann bei diesem Volumen etwa 25–30 % des Korrekturaufwands bewältigen, vorausgesetzt die Fehlerquote liegt im Bereich von 15–20 %. Realistischer ist, dass das Unternehmen 1–2 Vollzeitkräfte allein für die Behebung von OCR-Fehlern benötigt. Diese Personalkosten allein übersteigen jede kostenpflichtige Option.
Dies ist auch das Volumen, bei dem die Schwere der Fehler am wichtigsten ist. Ein unerkannt gebliebener, falsch erfasster Rechnungsbetrag – 14.500 $ statt 74.500 $ – kann 2–4 Stunden dauern, um ihn in Ihrem Buchhaltungssystem aufzuspüren und zu korrigieren, wie ein Reddit-Nutzer in r/Accounting anmerkte. Bei 5.000 Dokumenten pro Monat bedeutet selbst eine kritische Fehlerquote von 1 % 50 solcher Vorfälle pro Monat.
Cloud-APIs und KI-Extraktionstools eliminieren nicht alle Fehler, aber ihre 97–99 % Genauigkeit bei realen Dokumenten bedeutet, dass die verbleibenden Korrekturen innerhalb der bestehenden Teamkapazität bewältigbar sind. Das kostenpflichtige Abonnement ist im Vergleich zu der Arbeit, die es ersetzt, eine vernachlässigbare Größe.
Die versteckten Kosten „kostenloser“ OCR
Die Lizenzgebühr ist null. Die Gesamtkosten sind es nicht. Hier sind die Kosten, die nicht auf einer Preisseite erscheinen, aber auf dem Stundenzettel Ihres Teams auftauchen:
1. Technische Einrichtungszeit
Die Installation von Tesseract dauert fünf Minuten. Es so weit zu bringen, dass es zuverlässige, strukturierte Ergebnisse aus realen Geschäftsdokumenten liefert, dauert Wochen. Sie müssen den richtigen Seitensegmentierungsmodus auswählen, Bilder mit OpenCV vorverarbeiten (Entzerren, Binarisieren, Entrauschen), Nachbearbeitungsskripte schreiben, um die Rohausgabe zu bereinigen, und eine Pipeline aufbauen, die die OCR-Engine mit Ihrer Datenbank oder Tabellenkalkulation verbindet. Das Tesseract-GitHub-Repository weist ausdrücklich darauf hin, dass Sie die Bildqualität verbessern müssen, um bessere Ergebnisse zu erzielen – diese Verbesserungsarbeit ist Ingenieurszeit.
Bei 40–80 Stunden für eine Produktionspipeline und einem Entwickler, der voll belastet $70–$100 pro Stunde kostet, sind das $2.800–$8.000 im Voraus – bevor ein einziges Dokument verarbeitet wird.
2. Arbeitsaufwand für Fehlerkorrektur
Kostenlose OCR-Engines erreichen eine Genauigkeit von 70–85 % bei gescannten Dokumenten und Fotos – den Formaten, die in realen Geschäftsabläufen dominieren. Saubere maschinell gedruckte PDFs sind die Ausnahme, nicht die Regel. Jeder Extraktionsfehler erfordert einen Menschen, der den Fehler findet, überprüft und korrigiert. In großem Maßstab wird dies zum dominierenden Kostenfaktor.
Der heimtückischste Aspekt der Fehlerkorrektur ist, dass sie sich nicht wie eine Kosten anfühlt. Niemand schreibt einen Scheck für „OCR-Fehler beheben“. Sie zeigt sich darin, dass die Verwaltungskraft täglich eine Stunde länger arbeitet, der Buchhalter jeden Eintrag doppelt prüft oder der Kreditorenbuchhalter Überstunden macht. Aber es sind echte Kosten, sichtbar in der Gehaltsabrechnung, wenn auch nicht im Softwarebudget.
3. Laufende Wartung
Geschäftsdokumente ändern sich. Ein Lieferant gestaltet sein Rechnungslayout neu. Ein Versandunternehmen führt ein neues Packzettelformat ein. Ein Anbieter beginnt, PDFs als gescannte Bilder statt als digitale Dateien zu versenden. Jede Änderung kann die OCR-Genauigkeit beeinträchtigen, bis die Pipeline aktualisiert wird. Jemand muss diese Regressionen überwachen, die Ursache untersuchen und die Vor- oder Nachbearbeitungslogik anpassen. Dieser Jemand ist nicht der Softwareanbieter – denn bei Open-Source-Tools gibt es keinen Anbieter.
4. Workarounds für fehlende Funktionen
Kostenlose OCR-Engines verarbeiten keine Handschrift, extrahieren keine Tabellen in strukturierte Zeilen, verstehen keine Kontrollkästchen-Semantik und erkennen keine Signaturen oder Stempel. Wenn Ihre Dokumente eines dieser Elemente enthalten – und die meisten Geschäftsdokumente tun das –, müssen Sie Workarounds entwickeln. Dieser Workaround ist ein weiteres nicht eingeplantes Projekt.
Hier wird die Kluft zwischen traditioneller OCR und moderner KI-Extraktion am deutlichsten sichtbar. Traditionelle OCR-Engines sind Erkennungswerkzeuge: Sie wandeln Pixel in Zeichen um. Moderne Tools wie KI-OCR-Software verwenden Vision-Language-Modelle, die die Dokumentstruktur semantisch verstehen – sie kennen den Unterschied zwischen einer Kopfzeile und einer Datenzelle, sie können Tabellen auch ohne explizite Rahmen identifizieren und sie extrahieren Bedeutung statt nur Text.
Wann kostenlose OCR die richtige Wahl ist
Kostenlose Open-Source-OCR ist keine Falle. Sie ist in bestimmten Situationen wirklich das richtige Werkzeug:
- Sie sind Entwickler und bauen eine eigene Pipeline und verfügen über OCR-Expertise im Haus. Die Flexibilität von Tesseract oder PaddleOCR ermöglicht es Ihnen, jeden Parameter abzustimmen und tief in Ihren Stack zu integrieren.
- Sie verarbeiten nur saubere digitale PDFs mit konsistenten Layouts. Die Genauigkeit von Tesseract bei maschinengedrucktem Text in einer Standardschrift liegt bei nahezu 99 %.
- Ihr Volumen ist sehr gering – unter 50 Dokumenten pro Monat. Auf dieser Ebene kostet selbst eine suboptimale kostenlose Pipeline insgesamt weniger Arbeitsaufwand als der kognitive Overhead, ein kostenpflichtiges Tool zu evaluieren und einzuführen.
- Sie unterliegen strengen Datenresidenz- oder Air-Gap-Anforderungen und können Dokumente an keinen Cloud-Dienst senden. Selbst gehostete Open-Source-OCR ist Ihre einzige Option.
- Sie arbeiten an Forschung oder Archivdigitalisierung, bei der die Ausgabe nicht in einen Geschäftsprozess einfließt, der strukturierte Daten erfordert.
Diese Fälle haben einen gemeinsamen Nenner: Entweder verfügen Sie bereits über die technischen Ressourcen, um die Einrichtungs- und Wartungskosten zu tragen, oder die Anforderungen an die Ausgabequalität sind so gering, dass die Fehlerkorrektur minimal ist.
Wann bezahlte OCR tatsächlich günstiger ist
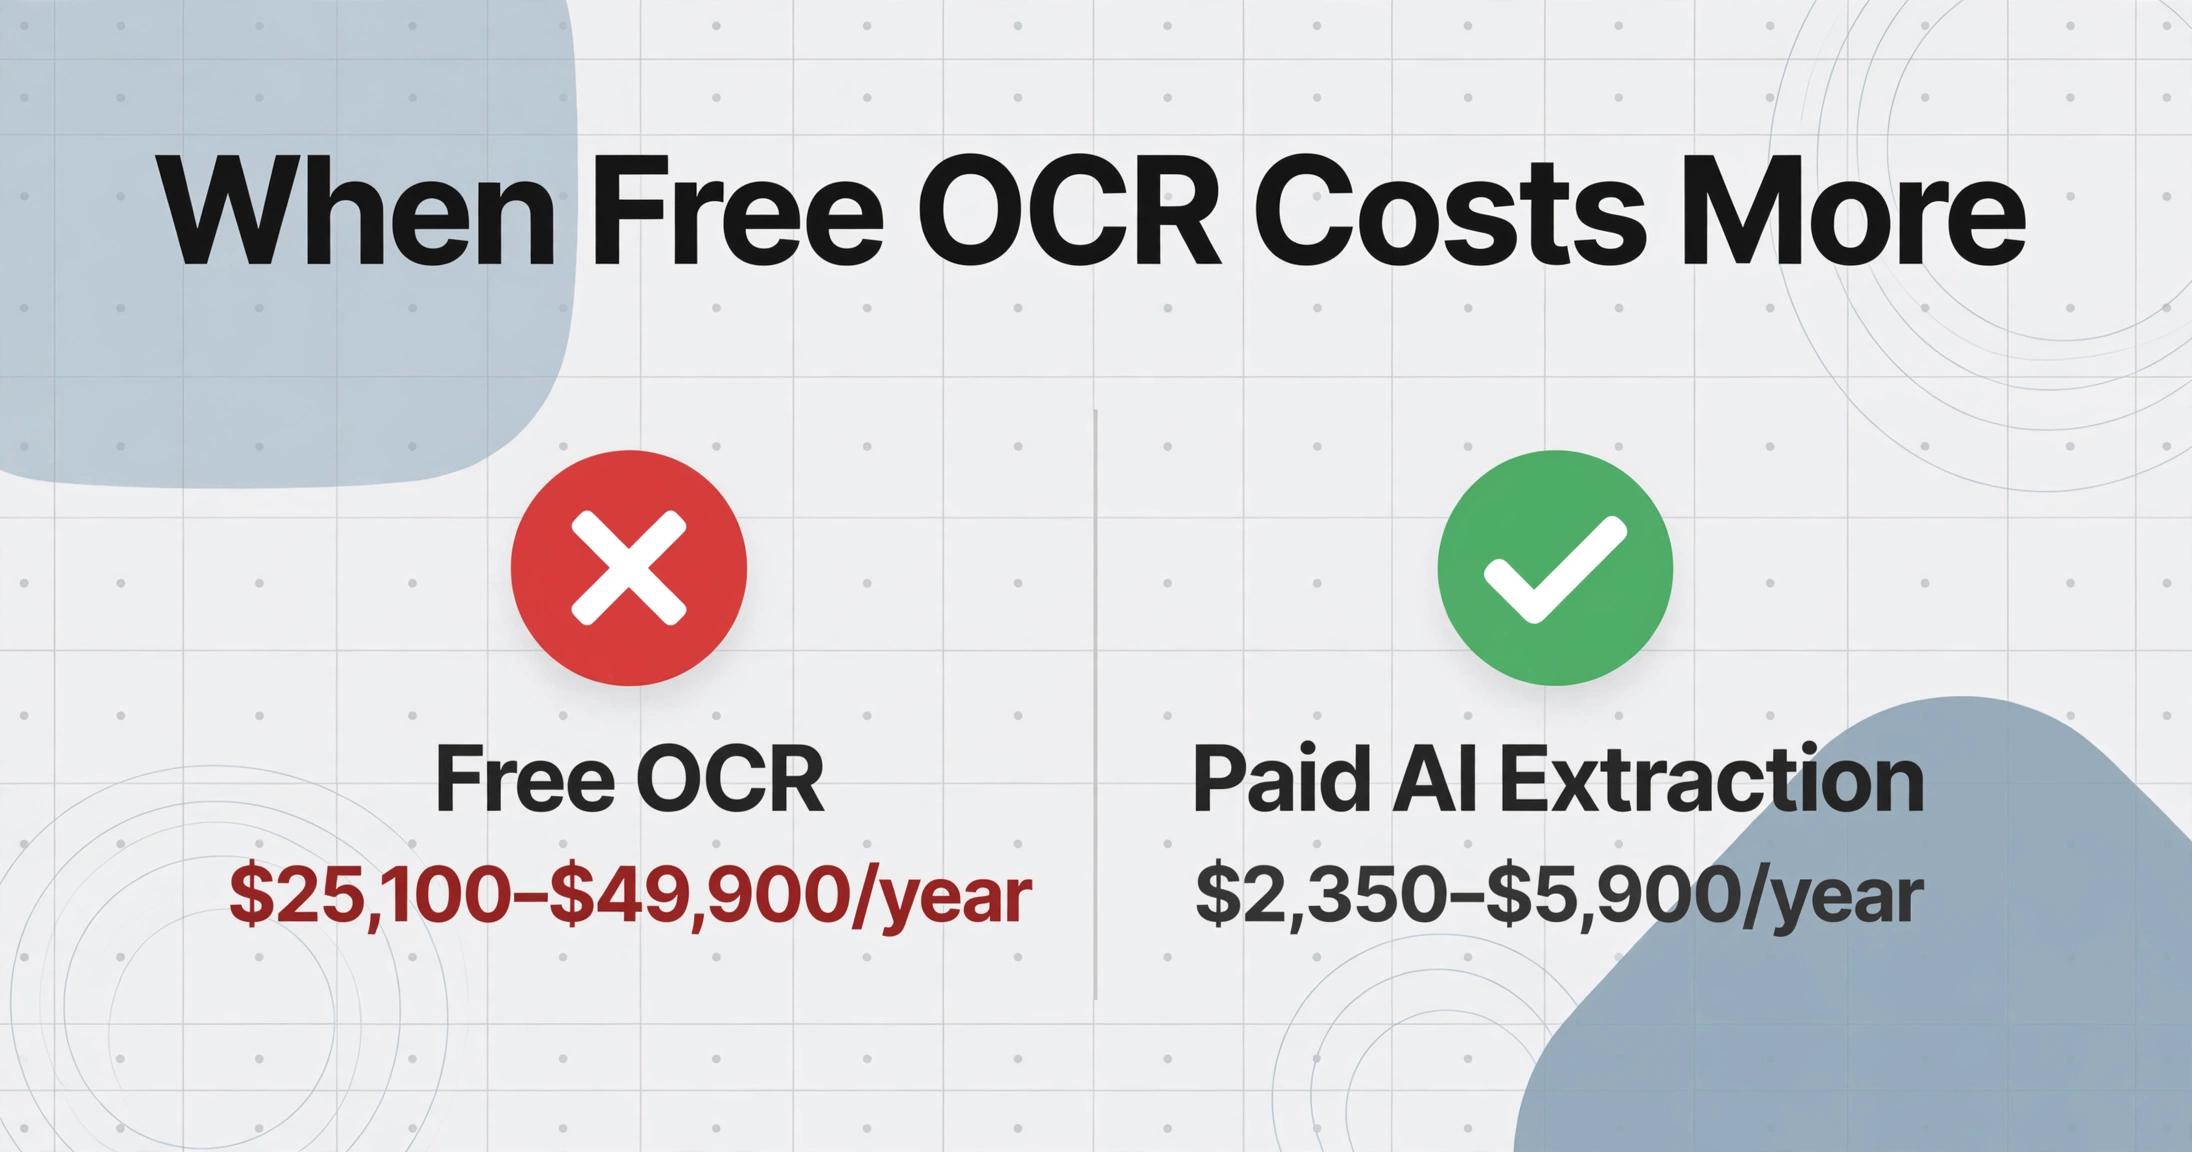
Wenn Ihre Situation einem dieser Punkte entspricht, ist eine kostenpflichtige Option in der Gesamtrechnung wahrscheinlich günstiger:
- Sie verarbeiten über 100 Dokumente pro Monat aus mehreren Quellen mit unterschiedlichen Formaten. Der Korrekturaufwand durch kostenlose OCR übersteigt bei diesem Volumen bereits ein Abonnement.
- Ihre Dokumente enthalten Scans, Fotos oder Handschrift. Die Genauigkeit kostenloser OCR sinkt bei nicht idealen Eingaben auf 70–85 %, und die Lücke zu 97–99 % bei kostenpflichtigen Tools wächst mit dem Volumen schnell.
- Sie benötigen strukturierte Datenausgabe – Excel-Zeilen mit bestimmten Spalten, nicht nur Rohtext. Die Tabellenextraktion auf Basis von Open-Source-OCR zu entwickeln, ist ein erhebliches Engineering-Projekt.
- Sie haben kein dediziertes Engineering-Team. Wenn Ihre OCR-Einrichtung von einem Auftragnehmer oder der „technisch versierten Person im Büro" abhängt, geht das Wissen mit ihnen verloren.
- Genauigkeitsfehler bergen Compliance- oder Finanzrisiken. Eine falsche Rechnungssumme, eine falsch gelesene Steuernummer oder ein falsches Datum auf einem Lieferschein können Strafen, Prüfungsfeststellungen oder Kundenstreitigkeiten auslösen.
Der häufigste Fehler, den wir sehen, ist die Schätzung nur der Lizenzkosten. Ein Abonnement für 20 $/Monat, das 15 Stunden manuelle Korrektur einspart, amortisiert sich bei jedem vernünftigen Stundensatz. Die Software kostet fast nie mehr als die Arbeit, die sie ersetzt.
Das ist der Kern dessen, was moderne OCR-Software leistet: nicht nur Texterkennung, sondern eine vollständige Pipeline vom Dokument zu nutzbaren Daten mit minimalem menschlichem Eingriff. Das Abonnement bezahlt die Pipeline, nicht die Erkennung.
FAQ
Ist kostenlose OCR für den Geschäftsgebrauch im Jahr 2026 genau genug?
Das hängt von der Qualität Ihrer Dokumente ab. Kostenlose OCR wie Tesseract erreicht 95–99 % bei sauberen maschinell gedruckten PDFs mit Standard-Schriftarten. Bei gescannten Dokumenten, Fotos oder nicht standardmäßigen Layouts – die den Großteil realer Geschäftsdokumente ausmachen – sinkt die Genauigkeit auf 70–85 %. Bei diesem Niveau weist jedes 4. bis 6. Dokument mindestens einen erheblichen Extraktionsfehler auf. Für gelegentliche private Nutzung mag das akzeptabel sein. Für Geschäftsprozesse, bei denen Daten in Buchhaltung, Inventar oder Compliance einfließen, birgt es ein inakzeptables Risiko und Korrekturaufwand.
Können kostenlose OCR-Tools Tabellen in Excel extrahieren?
Nicht zuverlässig. Tesseract und andere Open-Source-Engines geben Rohtext oder hOCR (HTML-basiertes OCR-Format) aus. Sie verstehen keine Tabellenstruktur – sie wissen nicht, welche Zellen zu welcher Zeile gehören, ob eine Spaltenüberschrift für die darunterliegenden Daten gilt oder wie verbundene Zellen behandelt werden sollen. Die Umwandlung dieser Ausgabe in eine nutzbare Excel-Tabelle erfordert benutzerdefinierten Nachbearbeitungscode. Cloud-APIs wie Google Document AI und AWS Textract verfügen über spezielle Formular- und Tabellenextraktionsmodelle, die dies nativ handhaben. Einige kostenlose OCR-Tools mit Freemium-Stufen bieten zwar strukturierte Ausgabe, aber die kostenlose Stufe ist in der Regel auf Seiten pro Monat begrenzt.
Wie viel Zeit kostet die Einrichtung einer kostenlosen OCR-Pipeline?
Die Installation der Engine dauert Minuten. Der Aufbau einer Produktionspipeline, die reale Dokumente zuverlässig verarbeitet, dauert 40–80 Stunden für einen Entwickler mit OCR-Erfahrung, ohne diese Erfahrung länger. Dies umfasst Bildvorverarbeitung (Entzerrung, Binarisierung, Rauschunterdrückung), Auswahl des korrekten Seitensegmentierungsmodus, Schreiben von Nachbearbeitungsskripten zur Bereinigung der Ausgabe, Aufbau eines Dokumenten-Ingestion-Workflows und Einrichtung der Fehlerüberwachung. Die Einrichtungskosten sind die größten versteckten Kosten kostenloser OCR, die die meisten Vergleiche ignorieren.
Kann kostenlose OCR Handschrift lesen?
Nein. Tesseract und PaddleOCR wurden für die Erkennung von Druckschrift entwickelt. Sie besitzen keine Handschrifterkennung. Einige Cloud-APIs bieten eine begrenzte Handschriftunterstützung, aber eine zuverlässige Handschriftextraktion – insbesondere bei Schreibschrift oder gemischten handschriftlichen Formularen – erfordert moderne Vision-Language-Modelle, die speziell mit handschriftlichen Dokumentdatensätzen trainiert wurden. Dies ist ein Funktionsbereich, in dem kostenlose Tools schlicht nicht mithalten können.
Ab welchem Volumen wird bezahlte OCR günstiger als kostenlose?
Basierend auf unserer Kostenmodellierung liegt der Break-even-Punkt bei etwa 100–150 Dokumenten pro Monat. Darunter ist der Korrekturaufwand des kostenlosen Tools gering genug, sodass die (amortisierten) Einrichtungskosten dominieren, sich aber rechtfertigen lassen, wenn die Infrastruktur bereits vorhanden ist. Über 150 Dokumente pro Monat übersteigt der Korrekturaufwand durch die geringere Genauigkeit eines kostenlosen Tools die Abonnementkosten einer kostenpflichtigen Alternative, wenn man die aufgewendete Zeit einrechnet. Ab 500+ Dokumenten pro Monat ist die Lücke so groß, dass die kostenpflichtige Option eindeutig günstiger ist.
Finden Sie Ihren Break-even-Punkt
Die Rechnung ist für jedes Unternehmen anders. Ihre tatsächliche Dokumentqualität, die Formate, die Sie erhalten, und die Genauigkeit, die Sie benötigen, verschieben die Zahlen. Der einzige Weg, um herauszufinden, welche Option Ihnen Geld spart, ist ein Test mit Ihren echten Dokumenten.