図面OCRが6をGと誤読し、
見積もりが狂う
6をGと読むのは、劇的な失敗ではありません。フラット化された図面では、それが部品番号を別の部品番号に変え、その別の番号を基に見積もりシステムが価格を決め、材料を発注し、機械加工を計画します。この問題をr/pdfで提起したエンジニアは、こう簡潔に述べています。「当社が受け取るPDFのFC図面パックの大半はフラット化されているため、OCRを入力しない限り当社のプログラムはほぼ役に立たない。しかしOCRは、6をGに置き換えるなど、あまり信頼性が高くない。」
重要なポイント
- 8%の文字誤読率は、10桁や12桁の部品番号に直面するまでは耐えられるように思えます。1文字の誤読が識別子全体を変えてしまうのです。
- 部品番号はOCRに誤りを検出する文脈を与えないため、図面に6と表示され、読み取りがGを返すと、同じ信頼度で2つの異なる部品になります。
- 6対Gの問題を解決するには、表の数字列を読み直すのではなく、寸法線内のグリフを一目見るだけで済みます。
見積ワークフローが図面から実際に読み取るもの
見積依頼は図面パッケージとして届きます。部品のマルチページPDFセット、部品表、品質条項、そして多くの場合改訂履歴です。見積担当者が価格を算出する前に、誰かがタイトルブロックを読み取ります。米国製造業で使用される図面シート規格であるASME Y14.1では、タイトルブロックは右下隅に配置され、図面番号、タイトル、改訂、材質、重量、シート数、承認データを記載します。次に、ASME Y14.5で規定される寸法線と公差枠、続いて熱処理や化成処理などの仕様呼び出しを含む注記ブロック、そしてBOMテーブルがあります。
その読み取りがそのまま見積もりになります。Epicor Kinetic、JobBOSS²、SAP Business One、またはPaperless Partsのような専用見積プラットフォームのいずれであっても、見積書の各明細項目は、見積担当者が図面から読み取った値(材質グレード、重量、重要寸法、表面仕上げ、数量)に遡ります。Mavlon見積コスト調査によると、加工工場の見積もり1件あたりの中央値は2.5〜3.5時間で、図面抽出だけで単純な単一部品図面では20〜40分、複雑なマルチシートパッケージでは60〜150分かかり、その後に価格判断が始まります。完全負担で1時間あたり$55の場合、見積もり1件は約$165の直接労務費に相当します。
見積もりのフェーズ1〜3(受付、図面抽出、過去データ調査)は、その時間の約60%を占め、価格設定の専門知識を一切含みません。すべての工場が自動化したいと望む部分であり、まさに1文字の誤読が損害をもたらす箇所です。
顧客の見積書と自社の見積書の両方がドキュメントとして存在する場合、それらをスプレッドシートの行に変換する仕組みについては、見積PDFをExcel明細項目に変換するガイドで説明しています。
フラット化でプログラムが読み取るファイルの部分が削除される
CADから作成されたPDFは、2つの側面を持つコンテナです。1つはレンダリングされたページ、つまり表示されるピクセルです。もう1つは、ソフトウェアがプログラム的に操作できる、選択可能なテキストオブジェクト、フォームフィールド、注釈、オプションのコンテンツグループのレイヤーです。フラット化は、インタラクティブレイヤーを静的ページコンテンツに統合します。ウィジェットの外観はページコンテンツストリームに直接描画され、基になる注釈とフィールドオブジェクトは削除されます。これはISO 32000 PDF仕様で定義されたメカニズムです。結果は画面上では同じように見えますが、テキストレイヤーはもう存在しません。
r/pdfの投稿者が尋ねた質問、外部プログラムによってフラット化されたPDFを元に戻せるかどうかについて、実用的な回答は5つの言葉で得られました。「一般的に、100%の精度では不可能です。」フラット化は設計上、一方向の操作です。サプライヤーが図面を単にフラット化するのではなく、印刷してラスタライズする場合、ページ全体が1つの画像になり、テキストレイヤーは納品されたファイルに最初から存在しません。これは実際によくあることで、CADファイルにはライセンスとバージョンに関する制約があるため、多くの工場は意図的にピクセル化された図面を受け取ります。
テキストオブジェクトを解析していた内部プログラムにとって、解析できるものは何も残っていません。OCRだけが元に戻す唯一の手段ですが、それは機械のために作られたものではないピクセルを読み取ることになります。スキャン文書や画像文書に対するOCRの一般的な失敗モード(低解像度、スキュー、ノイズ)は、スキャン文書のOCR精度低下の根本原因と修正方法のガイドに詳しく説明されています。
品番にOCRのやり直しが効かない理由
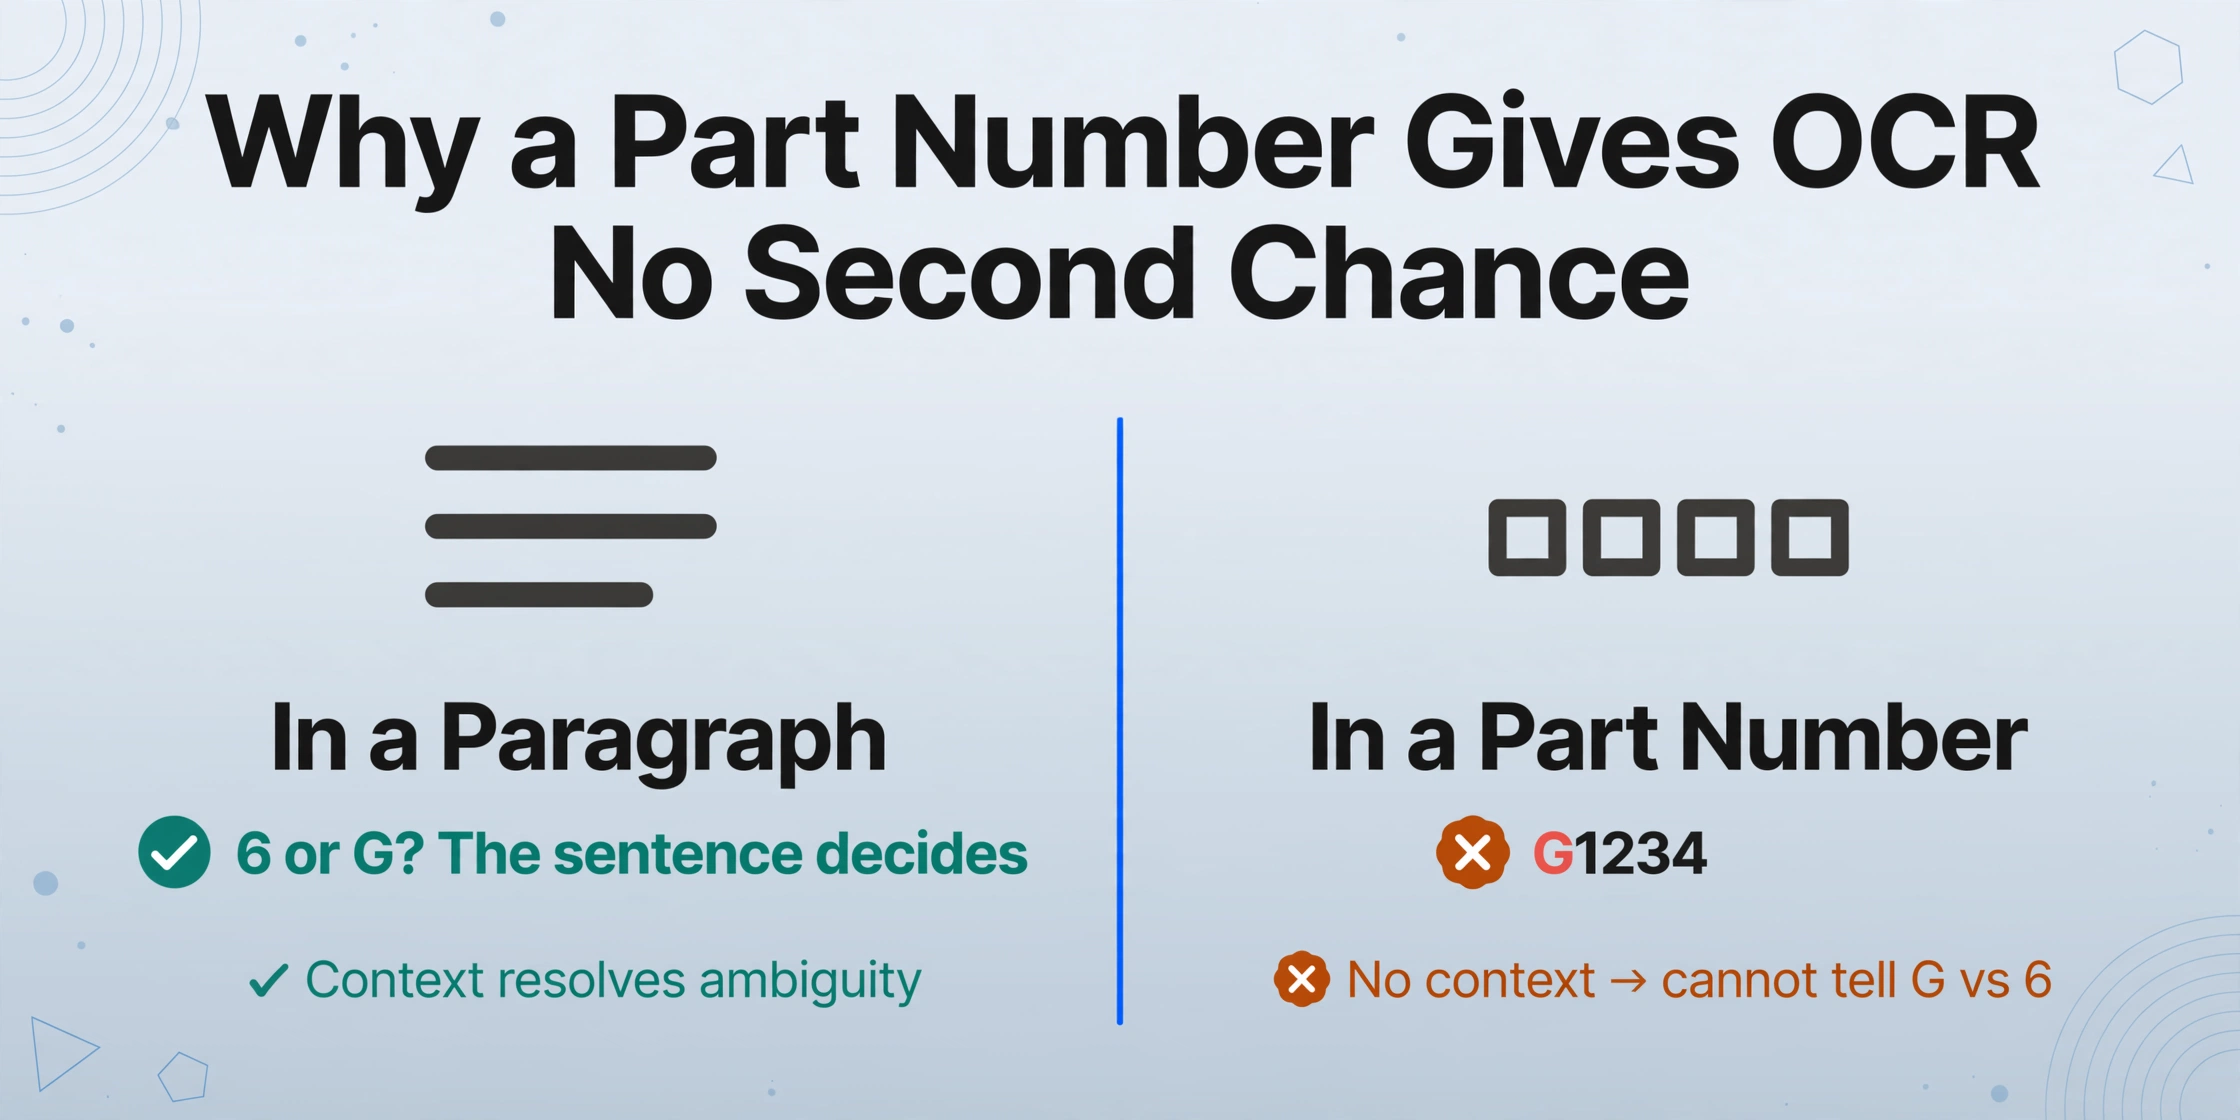
一般的なOCRは、文脈を考慮して読み取ります。段落内では、周囲の単語が安全網となります。モデルが0かOか判別できない文字を見たとき、文が判断します。品番、図面番号、リビジョン文字、材料グレードにはそのような文脈がありません。カタログ番号は設計上コンパクトであるため、モデルが頼れるものは何もなく、すべての文字を形状だけで分類する必要があります。
形状だけでは、工学図面では失敗します。2025年のヘルシンキ大学の論文は、実際の工学図面から抽出した短い英数字識別子に対してOCRエンジンを測定し、混乱パターンを直接記録しました。OCRエンジンがタイトルブロックで6をGと読んだとき、下流の処理では何も検出されませんでした。なぜなら、その文字列はまだ判読可能な識別子のように見えたからです。Tesseractは1をIとして13回、TをEとして6回、0をOとして5回読み取り、一方、クラウドOCRサービスはスラッシュをIとして、4をLとして読み取りました。著者の結論は品番に正確に当てはまります。「1文字のエラーでもIDの意味が変わる可能性があり、単純な辞書ベースの後処理は簡単ではありません。」
このエラーは低価格OCRに限った話ではありません。機械図面専用に構築されたOCRパイプラインであるeDOCrも、Frontiers in Manufacturing Technologyの研究で報告されている通り、認識において8%の文字誤読率を記録しています。このような誤読率が10桁や12桁の部品番号に及ぶ場合、問題は文字列が変わるかどうかではなく、どの文字が変わるかです。製図フォントの6とGは小さいサイズでは近い親戚のようなもので、1、I、7、0、O、2、Z、8、Bも同様です。r/pdfユーザーが遭遇した特定の組み合わせは、はるかに大きな混同行列の中の1行に過ぎません。
| 似ている文字の組み合わせ | OCRがつまずく箇所 | 事例の出典 |
|---|---|---|
| 1、I、l、7 | 部品番号、寸法値、改訂記号 | Helsinki 2025 thesis(1をIと誤読、13件) |
| 0、O | 図面番号、注記ブロックのテキスト | Helsinki 2025 thesis(0をOと誤読、5件) |
| T、E | 仕様呼び出し、注記の略語 | Helsinki 2025 thesis(TをEと誤読、6件) |
| /、Iおよび4、L | 材料グレード、仕上げコード | Helsinki 2025 thesis(クラウドOCR) |
| 6、G | 部品番号、寸法テキスト | r/pdf図面パックのスレッド |
精度は構造的な理由により文書タイプによって異なり、文書タイプ別にOCR精度が低下する理由の概要では、そのメカニズムをページレベルで解説しています。図面特有のケースは最悪の組み合わせです。入力品質の低下と、それを修正する言語モデルの欠如という二重の問題を抱えています。
文字誤読が部品製造前に及ぼすコスト
間違った部品番号は図面に留まりません。それは見積書の価格行、材料の発注書行、そしてそれに続く製造指示書になります。見積もった番号が図面で実際に指定されているものと異なる場合、工場は顧客が求めた部品とは異なる部品を見積もることで仕事を失うか、あるいは仕事を受注して、機械加工した部品が図面の実際の寸法に対して適合しないことが判明したときに初めて不一致に気づくことになります。
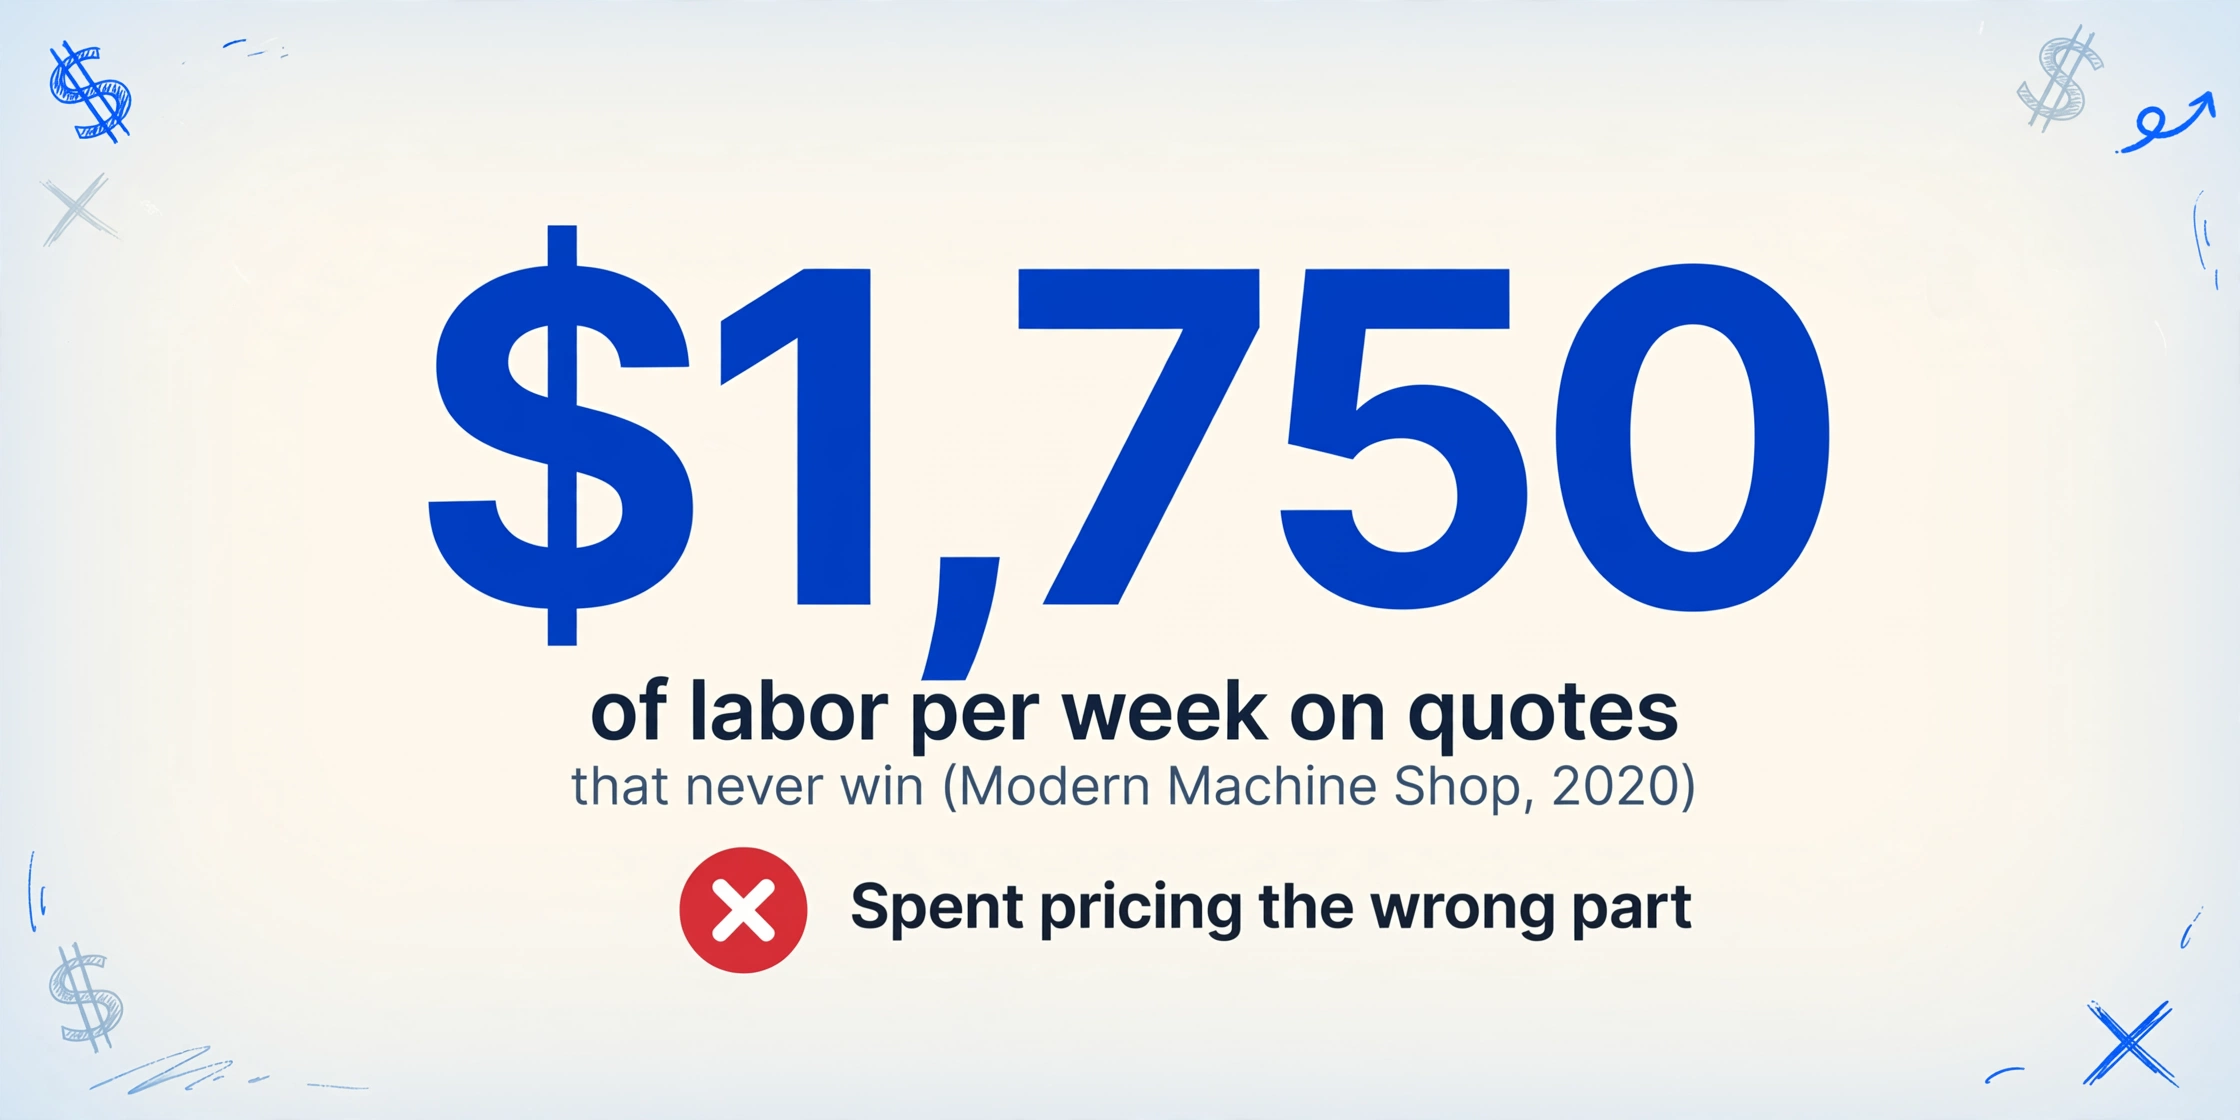
見積もり自体のコストは、無駄が集中する場所です。2020年のModern Machine Shopの分析によると、平均的な工場は受注に至らない見積もりに週あたり最大$1,750の労働力を費やしており、ほとんどの工場が見積もった仕事の約3分の1しか受注できていません。文字誤読がすり抜けると、費やした時間はすべて間違った部品の価格設定に費やされたことになります。
見積もりの背後には、エラーの生産コストがあります。Fabricators and Manufacturers Associationのベンチマークデータ(Reliable Plantがまとめたもの)によると、平均的な米国の金属加工業者ではスクラップと手直しが売上の約1.4%、上位4分の1の業者では1%未満であり、American Society for Qualityは多くのメーカーで品質関連コストの合計が売上の15%から20%になると推定しています。寸法に関して重要なエスカレーションのルールはシンプルで、業界でよく引用されます。機械で寸法の誤りに気づけば数分のコストで済みますが、最終検査で気づけば部品1個分のコストになり、顧客に気づかれれば部品代、送料、封じ込め選別、是正措置報告書、そして訪問対応のコストがかかります。
製造業はERP入力用に作られたものではないドキュメントで運用されており、発注書、見積書、受領書、請求書を構造化された行に変換するパイプラインについては、製造業向けドキュメント抽出ソフトウェアのガイドで説明しています。図面はそのパイプラインの起点であり、そこでの文字エラーは後続のすべての行に波及します。
図面の意味を読み取り、信頼できないグリフを検証する
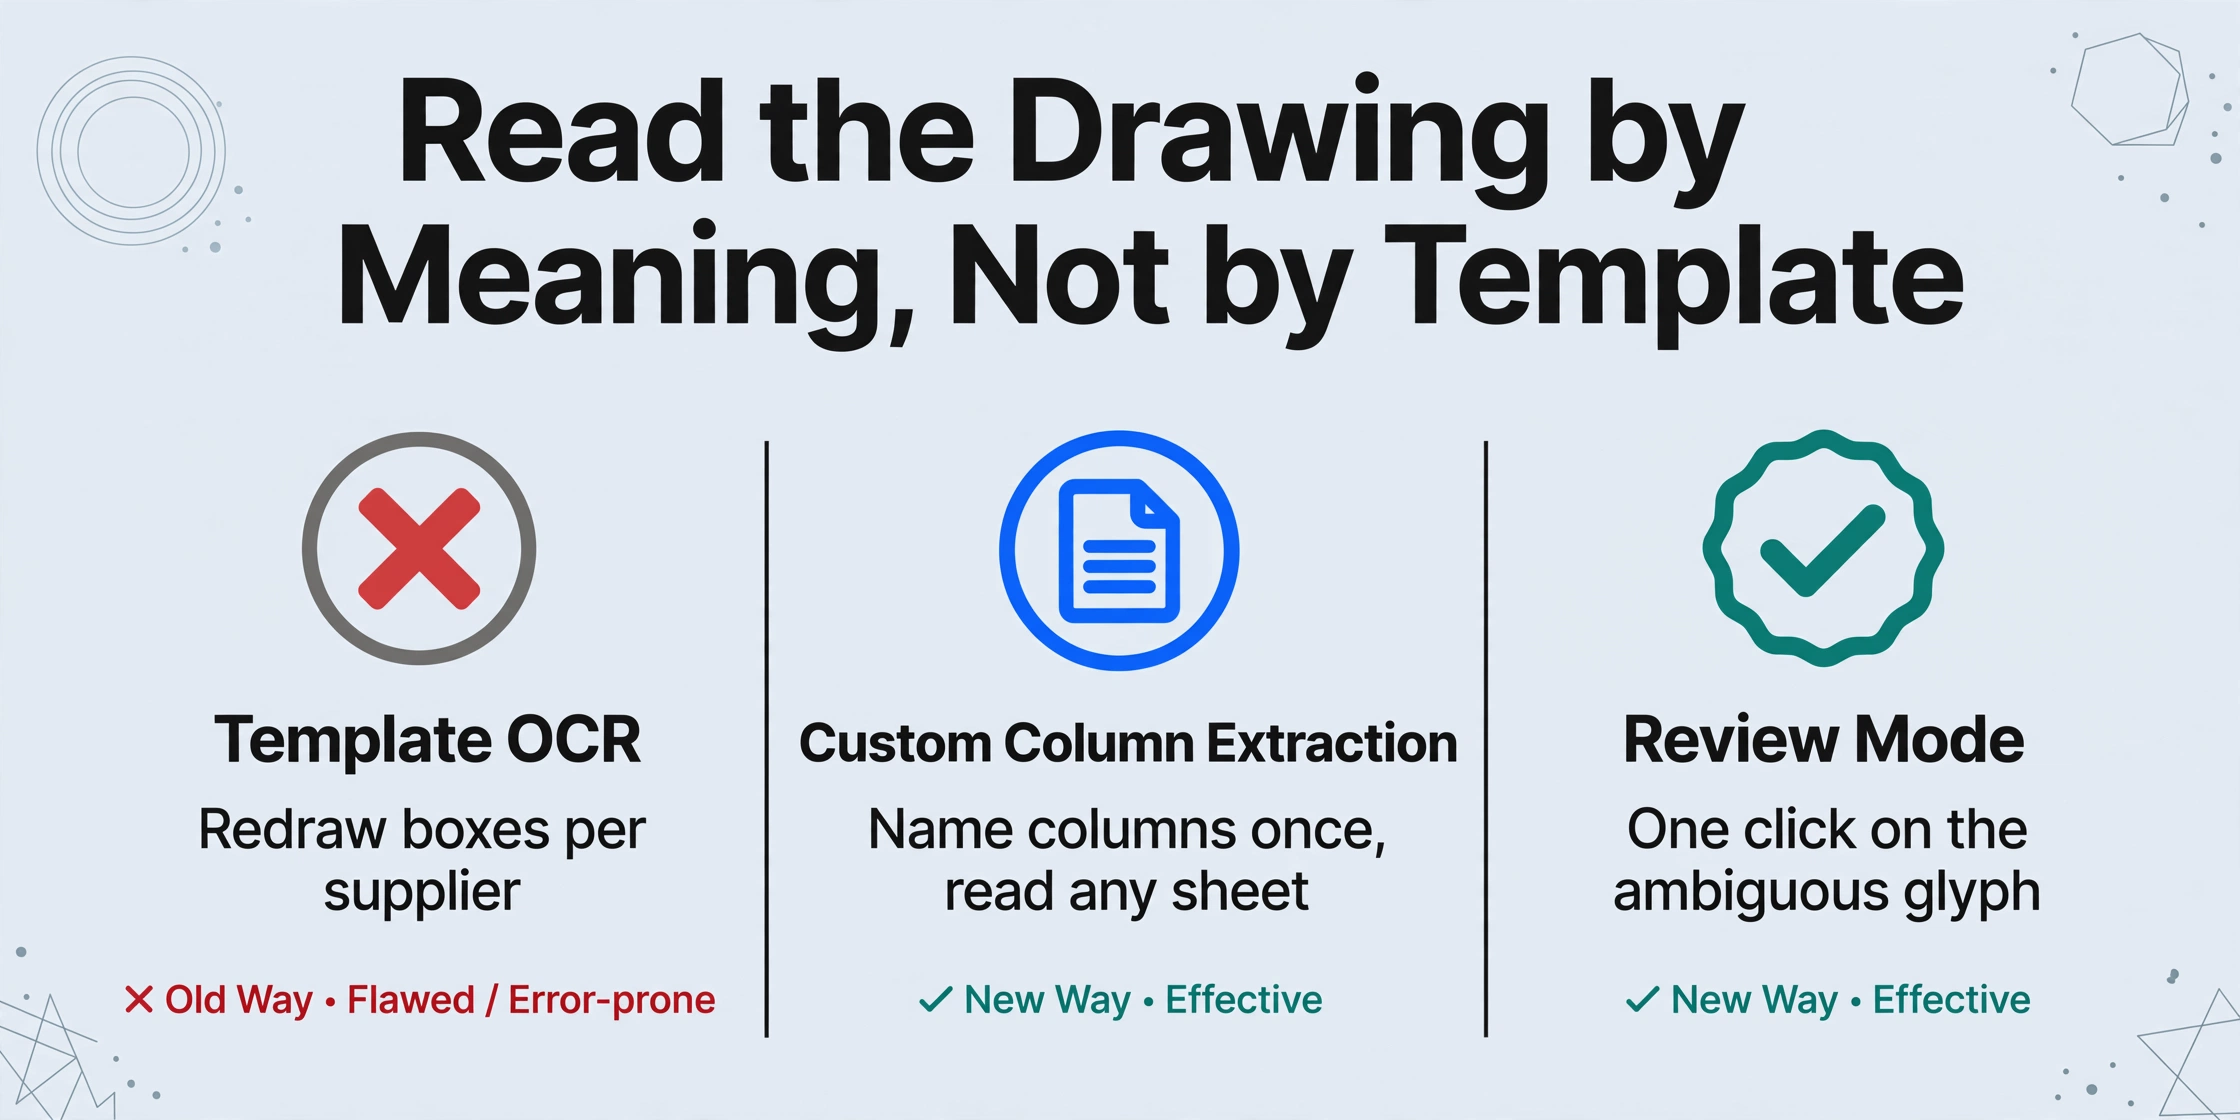
解決策は、一度設定すれば永久に信頼できる優れたOCRエンジンではありません。それはプロセス変更です。文字テンプレートではなくフィールドの意味で抽出し、図面の品質が要求する精度ティアで処理し、見積もりを送る前に曖昧な文字を元の位置で確認する。ImageToTable.aiはこの最初の部分を中心に構築されています。Custom Column Extractionでは、Part Number、Revision、Material、Weight、Quantityなどの列名を入力するだけです。AIはピクセル座標や描画テンプレートを照合するのではなく、フィールドの意味を理解してシート上のどこからでも各値を特定します。レンダリングされたページ画像を読み取るため、フラット化またはラスタライズされたPDFでも問題ありません。テキストオブジェクトは消えており、ピクセルはそのままの状態です。
これはテンプレートベースのOCRとの構造的な違いです。テンプレートベースのOCRでは、各フィールドにボックスを描き、サプライヤーが図面形式を変更するたびに描き直す必要があります。列名を一度設定すれば、異なる顧客からの図面パックのフォルダ全体で同じシート構造が機能し、バッチ全体が1つのスプレッドシートにまとまります。
見積もりに実際に必要な列名を設定する
Part Number、Revision、Material、Weight、Critical Dimensions、Surface Finish。AIはタイトルブロック、寸法線、注記の各フィールドを読み取り、指定したヘッダーでスプレッドシートを書き出します。出力を定義するのはあなたであり、図面が定義するのではありません。
処理ティアを図面の品質に合わせる
標準ティアはほとんどの印刷図面に対応します。かすれたスキャン、低コントラストのコピー、または枚数の多いマルチシートパッケージには、高精度ティアがより強力なビジョンモデルを使用するため、1つのワークフローで受領する図面パックの品質差を吸収できます。
Review Modeを開き、間違えられない文字を確認する
処理後にauto-annotateを有効にすると、抽出された各セルにソース領域が付与されます。Part Number G1234をクリックすると、その文字列が読み取られた図面上の正確な位置がハイライトされます。逆に図面上の位置をクリックすると対応するセルにジャンプし、AIの元の読み取り結果をワンクリックで確認しながら任意の値を編集できます。これが6とGの疑問を解決する方法です。寸法線上のグリフを見ることであり、数値文字列を信頼することではありません。
抽出処理で図面からデータを取り出します。レビューモードで、信頼できない1文字が見積もりに混入するのを防ぎます。この2つのステップは単一のワークフローです。パックを処理し、エクスポート前に元の画像と照合して曖昧さを確認します。
フラット化、スキャン、ネイティブPDFのいずれであっても、読み取りが必要な図面はすべて同じ意味論的経路を通ります。抽出したフィールドを使用可能なシートに変換する仕組みについては、PDFデータ抽出ソフトウェアおよびOCR PDFからExcelへの変換のガイドで説明しています。
このフローでできないこと
抽出ステップで、読めない図面が読めるようになることはありません。薄すぎて見えないテキスト、スキャン解像度以下のピクセル、手書きのマークアップはそのまま残り、元の図面または知識のある人間の確認が必要です。
コピーを繰り返して文字が欠けた図面の場合、ピクセルにもはや含まれていない情報を復元できるモデルはありません。処理前に、r/pdfの返信でフラット化を逆転させようとするよりもファイルの出所に戻るよう助言されていたのと同様に、サプライヤーに再エクスポートまたは鮮明なスキャンを依頼してください。手書きの修正マークや非標準記号も同じカテゴリです。読み取り結果を信頼するのではなく、見積もり担当者にフラグを立ててください。
正直な境界線は、このワークフローがパイプラインを自動化し、判断は人間に委ねるということです。担当者が値を承認しない限り、何も見積もりを送信しません。レビュー層が存在するのは、スキャンしたタイトルブロックに対してモデルが完全に正確であるとは保証されないからです。変わったのは、曖昧さの確認が、ハイライトされた領域への1クリックで済むようになったことです。テーブルを図面と比較する目の疲れる1時間の作業はもう必要ありません。
エンジニアリング図面のOCRとフラット化PDF:FAQ
フラット化されたPDFは元に戻せますか?
いいえ。PDF仕様において、フラット化は一方通行の操作です。テキストを保持していたオブジェクトデータは、その外観がページコンテンツに描画されるときに物理的に削除されるため、復元できるものは何も残りません。実際的な方法は、テキストレイヤーを復元するのではなく、レンダリングされた画像を読み取ることです。これはビジョンモデルが行う方法です。
図面のOCRが6をGと読み取るのはなぜですか?
部品番号は認識モデルに文脈を与えないからです。散文では、隣接する単語が6とG、0とO、1とIを区別します。短い英数字の部品番号には隣接する文字がないため、各文字は形状のみで分類され、図面でよく見られる小さくコントラストの低いグリフでは、それらの形状は実際に重なります。
スキャン済みまたはフラット化された図面はAI抽出で処理できますか?
はい。レンダリングされたページ画像を読み取る抽出は、テキストレイヤーの存在に依存しないため、スキャン済みおよびフラット化された図面は、ネイティブPDFと同じ方法で処理されます。精度はピクセル品質に左右されるため、クリーンなデジタル書き出しよりも、かすんだスキャンでは処理ティアとレビューステップがより重要になります。
ネイティブPDFからの抽出とフラット化されたPDFからの抽出に違いはありますか?
ビジョンベースの抽出ツールの場合、目に見える違いは小さく、どちらの場合もレンダリングされたページを読み取るためです。ネイティブPDFには、より単純なツールが取得できる選択可能なテキストが含まれている場合もありますが、そのテキストレイヤーにはレイアウト上の意味がありません。つまり、どの文字列が部品番号で、どの文字列が注記かを示してくれません。各値の意味を判断する作業は、どちらの場合も同じです。
部品番号が正しく読み取られたかどうかを確認するにはどうすればよいですか?
レビュー画面を開いてセルをクリックします。値の取得元となった正確な領域で図面がハイライト表示され、ページ上のグリフとテーブル内の文字列を比較できます。処理後に自動注釈を有効にすると、すべての抽出結果にソース領域が添付されるため、検証は完全な再読み取りではなく、あいまいな文字のスキャンで済みます。
この記事で取り上げるすべての見積もりエラー(間違った部品番号、間違った材料、間違った寸法)は、同じように始まります。図面から読み取られた1文字を、検証せずに信頼することから始まります。列に名前を付け、ページを画像として読み取り、間違いが許されないすべてのセルのソース領域を確認することは、モデルをトレーニングしたりテンプレートを描いたりすることなく、今日の現実的な図面パックで実行できるプロセスです。フラット化されたPDFは元に戻せませんが、それが引き起こす文字誤読は、誰かの見積もりになる前に検出できます。