OCR de Desenho de Engenharia Lê 6 como G,
e a Cotação Sai Errada
Um seis lido como G não é uma falha dramática. Em um desenho de engenharia achatado, ele transforma um número de peça em outro número de peça, e é esse outro número que o sistema de cotação precifica, encomenda material e planeja a usinagem. O engenheiro que levantou isso no r/pdf resumiu bem: "a maioria dos pacotes de desenhos FC em PDF que recebemos foi achatada, então meu programa é basicamente inútil a menos que eu use algum tipo de OCR, que não é muito confiável, no sentido de substituir um 6 por um G etc."
Principais Conclusões
- Uma taxa de erro de caracteres de 8% parece aceitável até encontrar um número de peça de dez ou doze caracteres, onde um único glifo errado muda o identificador inteiro.
- Um número de peça não dá ao OCR contexto para detectar o erro, então um desenho que mostra 6 e uma leitura que retorna G viram duas peças diferentes com a mesma confiança.
- Resolver a dúvida entre 6 e G exige uma olhada no glifo dentro da linha de cota, não uma releitura da sequência de números na tabela.
O que um fluxo de trabalho de cotação realmente lê de um desenho
Uma solicitação de cotação chega como um pacote de desenhos: um conjunto de PDFs de várias páginas da peça, uma lista de materiais, cláusulas de qualidade e, muitas vezes, um histórico de revisões. Antes que um estimador possa precificar qualquer coisa, alguém lê o bloco de título. De acordo com a ASME Y14.1, o padrão de folha de desenho usado na manufatura dos EUA, o bloco de título fica no canto inferior direito e contém o número do desenho, título, revisão, material, peso, contagem de folhas e dados de aprovação. Depois vêm as linhas de dimensão e os quadros de tolerância, especificados sob a ASME Y14.5, seguidos pelo bloco de notas com chamadas de especificação, como tratamento térmico ou conversão química, e a tabela de BOM.
Essa leitura se torna a cotação. Cada item de linha na estimativa, seja no Epicor Kinetic, JobBOSS², SAP Business One ou em uma plataforma de cotação dedicada, como Paperless Parts, remonta a um valor que o estimador extraiu do desenho: grau do material, peso, dimensões críticas, acabamento de superfície, quantidade. O estudo de custo de cotação da Mavlon em oficinas de fabricação mediu uma mediana de 2,5 a 3,5 horas por cotação, com a extração do desenho sozinha levando de 20 a 40 minutos em desenhos simples de peça única e de 60 a 150 minutos em pacotes complexos de várias folhas, antes mesmo de o julgamento de preço começar. A uma taxa totalmente carregada de $55 por hora, uma cotação representa cerca de $165 de mão de obra direta.
As fases 1 a 3 da cotação — recebimento, extração do desenho e pesquisa histórica — consomem cerca de 60% desse tempo e não contêm nenhuma expertise de precificação. Essa é a parte que toda oficina espera automatizar, e é exatamente onde um único erro de leitura de caractere causa seus danos.
Quando a folha de cotação do cliente e sua própria estimativa existem como documentos, a mecânica de transformá-los em linhas de planilha é abordada no guia sobre conversão de PDFs de cotação em itens de linha do Excel.
O achatamento exclui a parte do arquivo que um programa lê
Um PDF criado a partir de CAD é um contêiner com duas vidas. Uma é a página renderizada, os pixels que você vê. A outra é uma camada de objetos de texto selecionáveis, campos de formulário, anotações e grupos de conteúdo opcionais que o software pode acessar programaticamente. O achatamento mescla a camada interativa ao conteúdo estático da página: a aparência de um widget é desenhada diretamente no fluxo de conteúdo da página e os objetos de anotação e campo subjacentes são removidos, um mecanismo definido na especificação de PDF ISO 32000. O resultado parece idêntico na tela, mas a camada de texto não existe mais.
A pergunta do usuário do r/pdf, se um PDF achatado por um programa externo pode ser revertido, recebeu a resposta prática em cinco palavras: "Geralmente não, não com 100% de precisão." O achatamento é uma operação unilateral por design, e quando fornecedores imprimem e rasterizam um desenho em vez de apenas achatá-lo, a página inteira vira uma imagem e a camada de texto nunca existiu no arquivo entregue. Isso é comum na prática; arquivos CAD têm sensibilidade de licenciamento e versão, então muitas oficinas recebem desenhos reduzidos a pixels de propósito.
Para um programa interno que analisava objetos de texto, não resta nada para analisar. OCR é a única porta de volta, e ele lê pixels que não foram criados para máquinas. Os modos gerais de falha de OCR em documentos digitalizados e de imagem, baixa resolução, inclinação, ruído, estão descritos no guia sobre causas raiz e correções para baixa precisão de OCR em documentos digitalizados.
Por que um número de peça não dá segunda chance ao OCR
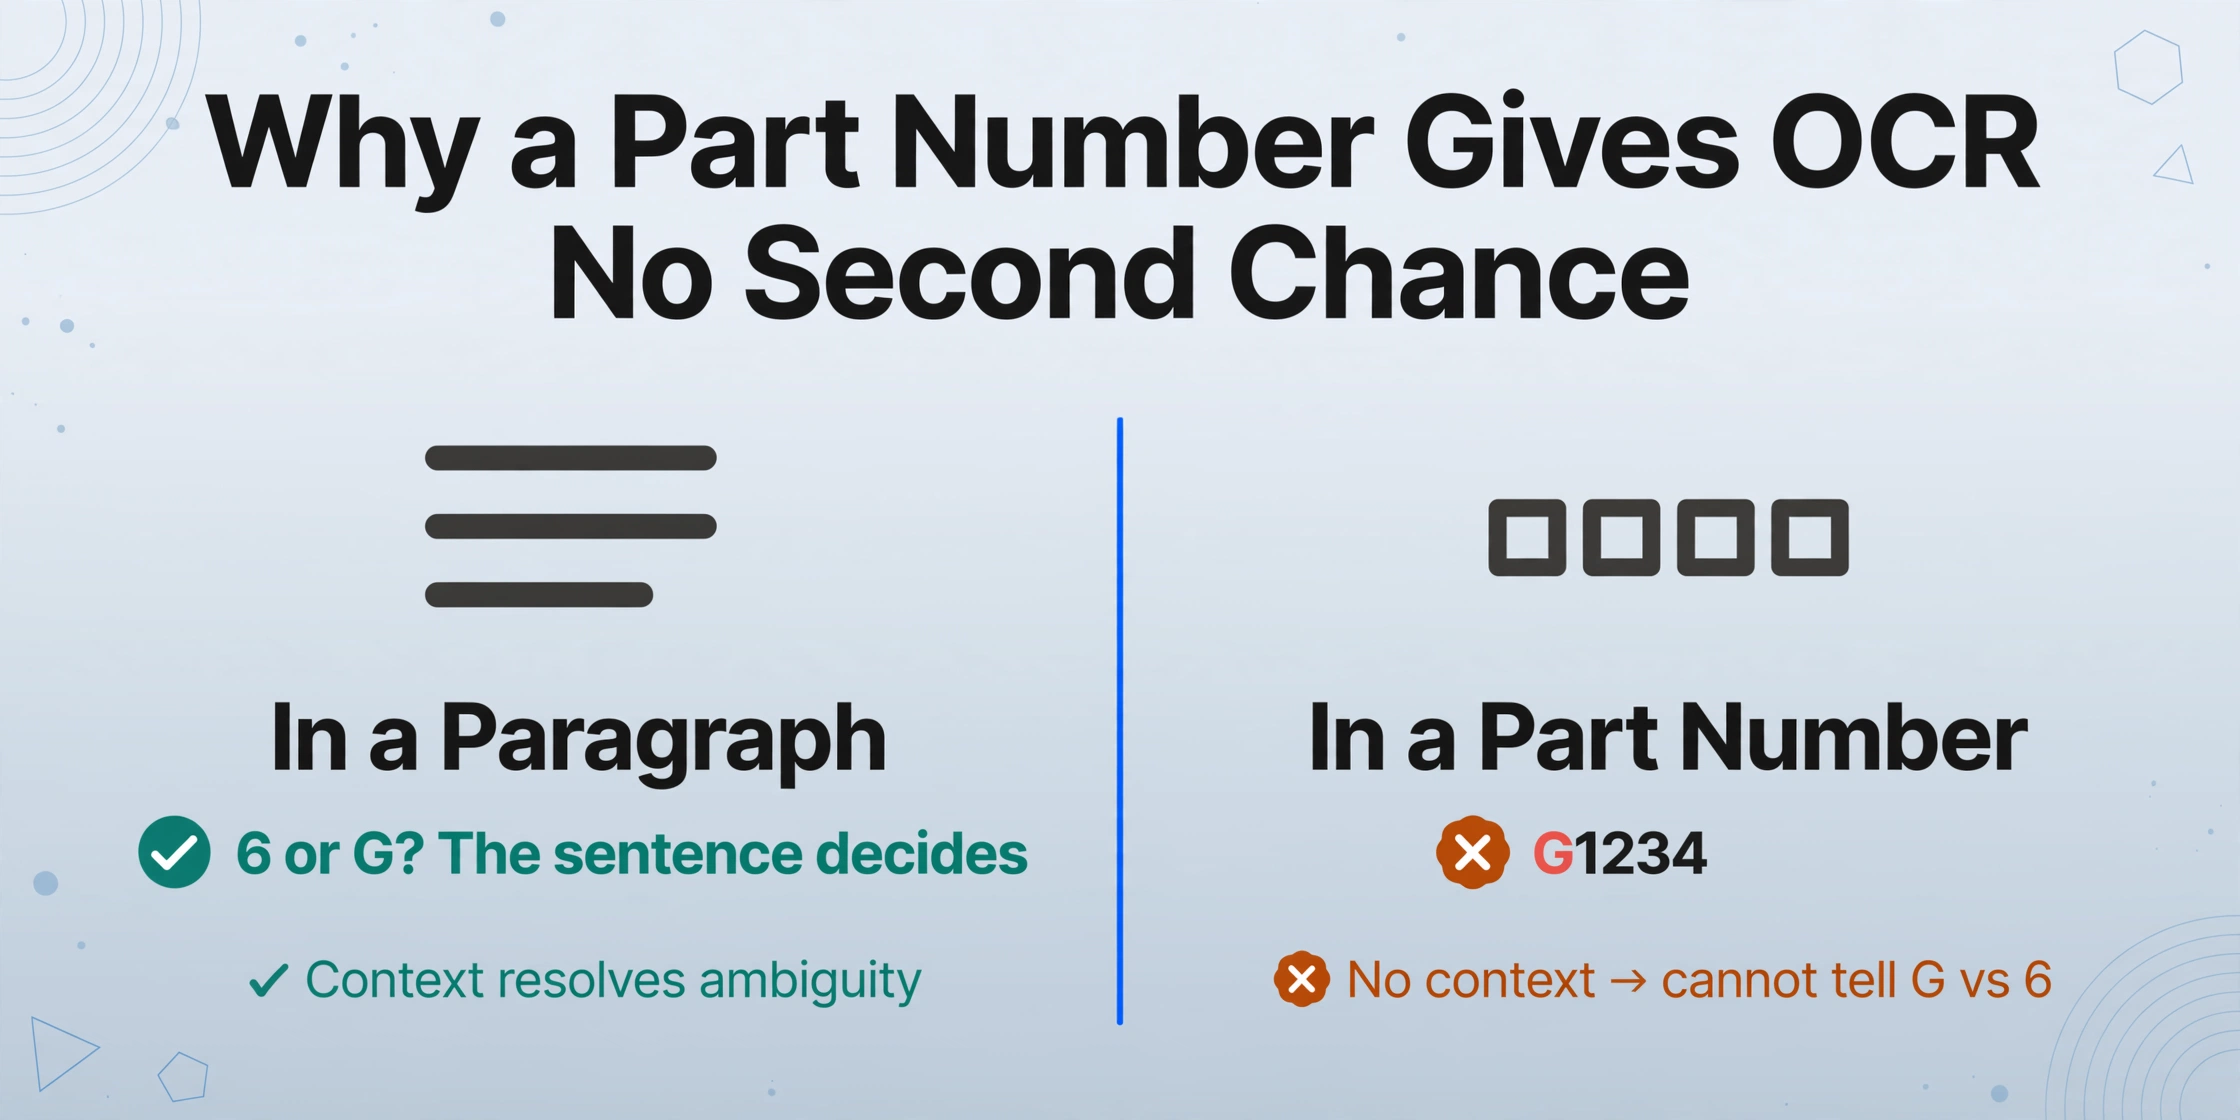
OCR genérico lê no aberto. Em um parágrafo, as palavras ao redor são a rede de segurança: quando um modelo vê um caractere que pode ser 0 ou O, a frase decide. Números de peça, números de desenho, letras de revisão e graus de material não têm esse contexto. Um número de catálogo é compacto por design, então o modelo não tem nada em que se apoiar, e cada caractere deve ser classificado apenas pela forma.
A forma sozinha falha em desenhos de engenharia. Uma tese de 2025 da Universidade de Helsinque mediu mecanismos de OCR contra identificadores alfanuméricos curtos extraídos de desenhos de engenharia reais e registrou os padrões de confusão diretamente. Quando um mecanismo de OCR leu 6 como G em um bloco de título, nada a jusante detectou, porque a string ainda parecia um identificador legível: o Tesseract leu 1 como I treze vezes, T como E seis vezes e 0 como O cinco vezes, enquanto um serviço de OCR em nuvem leu uma barra como I e um 4 como L. A conclusão do autor se aplica exatamente a números de peça: "até mesmo um erro de um único caractere pode mudar o significado de um ID, e o pós-processamento simples baseado em dicionário não é direto."
O erro não se limita a OCR de baixo custo. O eDOCr, um pipeline de OCR desenvolvido especificamente para desenhos mecânicos e relatado no estudo da Frontiers in Manufacturing Technology, ainda apresentou uma taxa de erro de 8% no reconhecimento de caracteres. Quando uma taxa de erro como essa encontra um número de peça de dez ou doze caracteres, a questão não é se a string muda, é qual caractere. Um 6 e um G da mesma fonte de desenho são parentes próximos em tamanhos pequenos, assim como 1, I e 7, 0 e O, 2 e Z, 8 e B. O par específico que o usuário do r/pdf encontrou é uma linha em uma tabela de confusão muito maior.
| Par de aparência semelhante | Onde o OCR tropeça | Exemplo de origem |
|---|---|---|
| 1, I, l, 7 | Números de peça, valores de dimensão, letras de revisão | Tese de Helsinki 2025 (1 como I, 13 casos) |
| 0, O | Números de desenho, texto do bloco de notas | Tese de Helsinki 2025 (0 como O, 5 casos) |
| T, E | Indicações de especificação, abreviações de notas | Tese de Helsinki 2025 (T como E, 6 casos) |
| /, I e 4, L | Graus de material, códigos de acabamento | Tese de Helsinki 2025 (OCR em nuvem) |
| 6, G | Números de peça, texto de dimensão | Thread do pacote de desenhos no r/pdf |
A precisão varia por tipo de documento por razões estruturais, e a visão geral de por que a precisão do OCR cai em diferentes tipos de documento cobre esses mecanismos no nível da página. O caso específico de desenhos é o pior dos dois mundos: qualidade de entrada degradada e ausência de qualquer modelo de linguagem para corrigi-la.
O que um Erro de Leitura de Caractere Custa Antes Mesmo de a Peça Ser Feita
Um número de peça errado não fica apenas no desenho. Ele se torna a linha de preço na cotação, a linha do pedido de compra do material e a ordem de produção que vem em seguida. Se o número cotado for diferente do que o desenho realmente especifica, a oficina pode perder o trabalho ao cotar uma peça diferente da que o cliente pediu, ou ganhar o trabalho e descobrir a discrepância somente quando a peça usinada falhar em relação às dimensões reais do desenho.
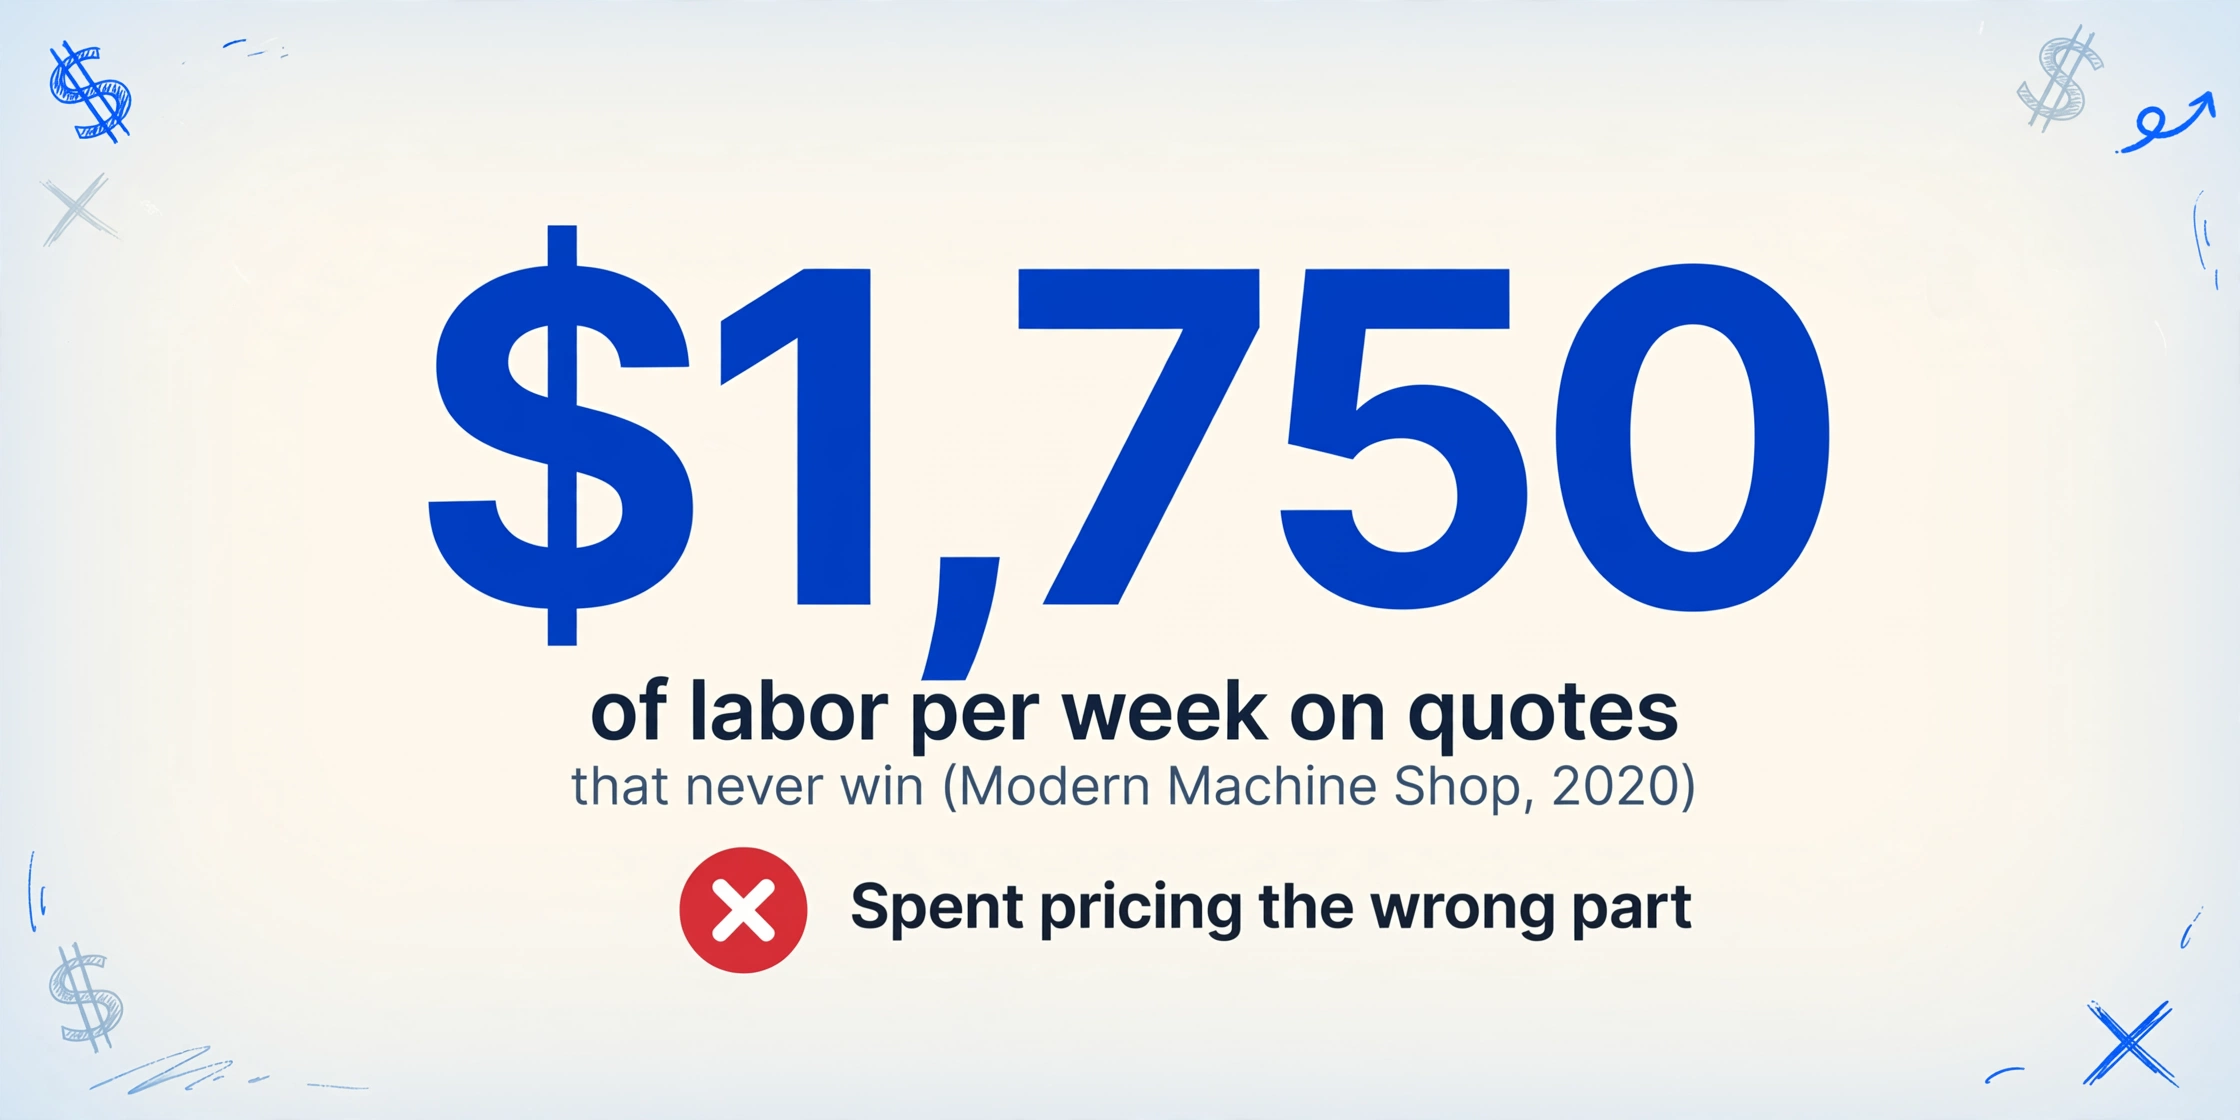
O custo da própria cotação é onde o desperdício se concentra. Uma análise da Modern Machine Shop de 2020 descobriu que a oficina média gasta até $1.750 de mão de obra por semana em cotações que nunca vence, e a maioria das oficinas conquista apenas cerca de um terço dos trabalhos que cota. Quando um erro de leitura passa despercebido, cada hora gasta é gasta precificando a peça errada.
Por trás da cotação está o custo de produção do erro. Dados de referência da Fabricators and Manufacturers Association, compilados pela Reliable Plant, colocam sucata e retrabalho em aproximadamente 1,4% das vendas para o fabricante médio de metais dos EUA e abaixo de 1% para o quartil superior, enquanto a American Society for Quality estima os custos totais relacionados à qualidade em 15% a 20% das vendas para muitos fabricantes. A regra de escalonamento que importa para dimensões é simples e frequentemente citada na indústria: uma dimensão errada percebida na máquina custa alguns minutos, percebida na inspeção final custa a peça, e percebida pelo cliente custa a peça, o frete, a triagem de contenção, o relatório de ação corretiva e a visita.
A manufatura depende de documentos que nunca foram criados para entrada em ERP, e o pipeline que transforma pedidos de compra, cotações, recibos e faturas em linhas estruturadas é abordado no guia de software de extração de documentos para manufatura. O desenho é onde esse pipeline começa, e um erro de caractere ali flui para cada linha atrás dele.
Leia o desenho pelo significado e depois verifique o glifo em que você não pode confiar
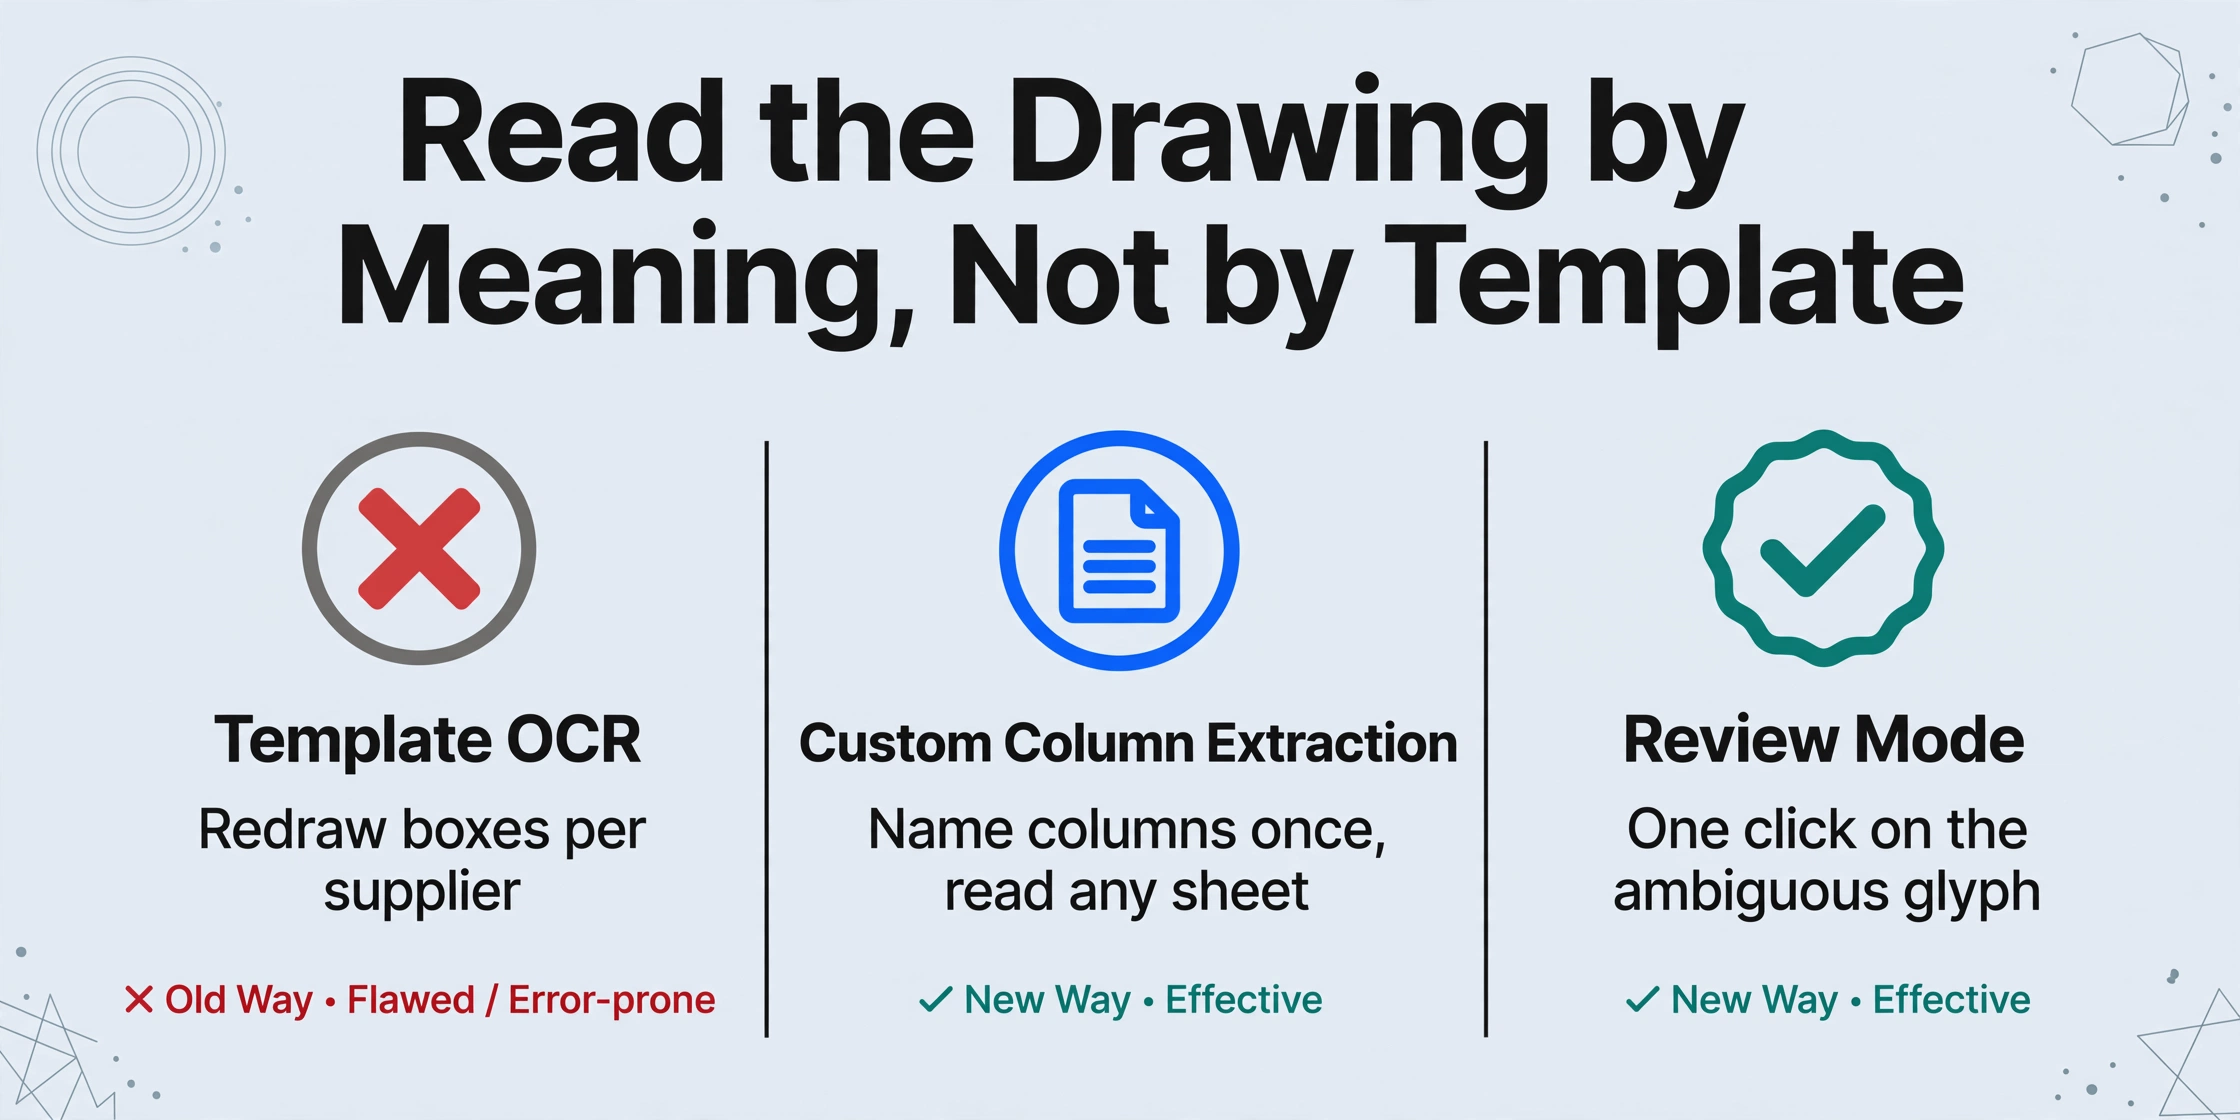
A correção não é um mecanismo de OCR melhor, configurado uma vez e confiável para sempre. É uma mudança de processo: extrair pelo significado do campo em vez de por modelos de caracteres, processar no nível de precisão que a qualidade do desenho exige e olhar o caractere ambíguo em sua localização original antes de uma cotação sair. O ImageToTable.ai é construído em torno do primeiro desses pontos. Com a Custom Column Extraction, você digita os nomes das colunas que deseja, como Part Number, Revision, Material, Weight e Quantity. A IA localiza cada valor em qualquer lugar da folha entendendo o que o campo significa, não combinando coordenadas de pixels ou um modelo desenhado. Como ela lê a imagem da página renderizada, um PDF achatado ou rasterizado não apresenta barreira; os objetos de texto desapareceram, e os pixels são o que são.
Esta é a diferença estrutural em relação ao OCR baseado em modelo, que exige que você desenhe uma caixa sobre cada campo e a redesenhe sempre que um fornecedor mudar o formato do desenho. Nomear as colunas uma única vez significa que a mesma estrutura de planilha funciona em uma pasta de pacotes de desenhos de diferentes clientes, e todo o lote chega em uma única planilha.
Nomeie as colunas que uma cotação realmente precisa
Part Number, Revision, Material, Weight, Critical Dimensions, Surface Finish. A IA lê cada campo de onde ele está no bloco de título, na linha de cotação ou nas notas, e exporta uma planilha com exatamente esses cabeçalhos. Você define a saída; o desenho não a define.
Combine o nível de processamento com a qualidade do desenho
O nível padrão cobre a maioria dos desenhos impressos. Para digitalizações fracas, cópias de baixo contraste ou pacotes densos de várias páginas, os níveis de precisão mais altos usam um modelo de visão mais forte, para que um único fluxo de trabalho possa absorver a diferença de qualidade nos pacotes de desenhos que você recebe.
Abra o Review Mode e confirme os caracteres sobre os quais você não pode errar
Ative o auto-annotate após o processamento, e cada célula extraída carrega sua região de origem. Clique em Part Number G1234 e o desenho será destacado exatamente onde essa string foi lida. Inverta clicando em um local do desenho para pular para a célula correspondente e edite qualquer valor mantendo a leitura original da IA a um clique de distância. É assim que você resolve uma dúvida entre 6 e G: olhando o glifo em sua linha de cotação, não confiando na string numérica.
A extração retira os dados do desenho. O Modo de Revisão impede que o único caractere em que você não confia chegue à cotação. As duas etapas são um único fluxo de trabalho: processe o lote e, em seguida, confirme a ambiguidade em relação à imagem original antes da exportação.
Um desenho que precisa ser lido, seja achatado, escaneado ou PDF nativo, passa pelo mesmo caminho semântico, e a mecânica de transformar os campos extraídos em uma planilha utilizável é abordada nos guias de software de extração de dados de PDF e conversão de OCR PDF para Excel.
O Que Este Fluxo Não Pode Fazer por Você
Nenhuma etapa de extração transforma um desenho ilegível em um legível. Texto fraco demais para ser visto, pixels abaixo da resolução de escaneamento e anotações manuscritas continuam como estão, e ainda precisam do desenho original ou de um humano informado.
Se uma cadeia de fotocópias degradou o desenho a caracteres quebrados, nenhum modelo recupera o que os pixels não contêm mais. Peça ao fornecedor uma reexportação ou um escaneamento limpo antes do processamento, da mesma forma que a resposta no r/pdf aconselhou voltar à fonte do arquivo em vez de tentar reverter o achatamento. Marcas de revisão manuscritas e símbolos não padronizados são da mesma categoria: sinalize-os para o orçamentista em vez de confiar na leitura.
O limite honesto é que este fluxo de trabalho automatiza o pipeline e mantém as decisões humanas. Nada envia uma cotação sem que uma pessoa aprove os valores, e a camada de revisão existe precisamente porque o modelo não é garantidamente perfeito em um bloco de título escaneado. O que muda é que verificar a ambiguidade leva um clique em uma região destacada, em vez de uma hora de olhos cruzados comparando uma tabela com um desenho.
OCR de Desenho de Engenharia e PDFs Achatados: FAQ
Um PDF achatado pode ser desfeito?
Não. O achatamento é uma operação de mão única na especificação de PDF. Os dados do objeto que carregavam o texto são fisicamente removidos quando sua aparência é desenhada no conteúdo da página, então não há nada para restaurar. O caminho prático é ler a imagem renderizada, que é o que um modelo de visão faz, em vez de recuperar a camada de texto.
Por que um OCR de desenho lê um 6 como um G?
Porque os números de peça não dão contexto ao modelo de reconhecimento. Em prosa, palavras vizinhas desambiguam um 6 de um G, um 0 de um O, ou um 1 de um I. Um número de peça alfanumérico curto não tem vizinhos, então cada caractere é classificado apenas pela forma, e nos glifos pequenos e de baixo contraste comuns em desenhos, essas formas realmente se sobrepõem.
Desenhos digitalizados ou achatados funcionam com extração por IA?
Sim. A extração que lê a imagem da página renderizada não depende da presença de uma camada de texto, então desenhos digitalizados e achatados são processados da mesma forma que PDFs nativos. A precisão acompanha a qualidade dos pixels, e é por isso que o nível de processamento e a etapa de revisão importam mais em uma digitalização desbotada do que em uma exportação digital limpa.
Há alguma diferença entre extrair de um PDF nativo e de um achatado?
Para um extrator baseado em visão, a diferença visível é pequena, porque ele lê a página renderizada em ambos os casos. Um PDF nativo também pode conter texto selecionável que ferramentas mais simples podem capturar, mas essa camada de texto não tem significado de layout: ela não informa qual string é o número da peça e qual é a nota. Decidir o que cada valor significa é o mesmo trabalho de qualquer forma.
Como sei se um número de peça foi lido corretamente?
Abra a tela de revisão e clique na célula. O desenho é destacado na região exata de onde o valor veio, e você compara o glifo na página com a string na tabela. Ativar o Auto-annotate após o processamento garante que cada extração chegue com sua região de origem anexada, então a verificação é uma varredura pelos caracteres ambíguos, em vez de uma releitura completa.
Cada erro de cotação neste artigo, o número de peça errado, o material errado, a dimensão errada, começa da mesma forma: um caractere lido de um desenho e confiado sem verificação. Nomear as colunas, ler a página como imagem e verificar a região de origem de cada célula sobre a qual você não pode errar é um processo que funciona com pacotes de desenhos realistas hoje, sem treinar um modelo ou desenhar um modelo. Um PDF achatado não pode ser desfeito, mas os erros de leitura que ele força podem ser detectados antes de se tornarem cotação de alguém.