OCR für technische Zeichnungen liest 6 als G,
und das Angebot stimmt nicht mehr
Eine als G gelesene 6 ist kein dramatischer Fehler. Auf einer flachgelegten technischen Zeichnung wird aus einer Teile-Nummer eine andere Teile-Nummer – und genau diese andere Nummer bepreist das Angebotssystem, bestellt dafür Material und plant die Bearbeitung. Der Ingenieur, der das auf r/pdf angesprochen hat, brachte es auf den Punkt: „Der Großteil der FC-Zeichnungspakete, die wir als PDF erhalten, wurde flachgelegt, daher ist mein Programm praktisch nutzlos, es sei denn, ich setze eine Art OCR ein, die nicht sonderlich zuverlässig ist – etwa wenn eine 6 durch ein G ersetzt wird usw."
Wichtigste Erkenntnisse
- Eine Zeichenfehlerquote von 8 % klingt verkraftbar – bis sie auf eine Teile-Nummer mit zehn oder zwölf Zeichen trifft, wo ein einziges falsches Zeichen die gesamte Kennung verändert.
- Eine Teile-Nummer bietet der OCR keinen Kontext, um den Fehler zu erkennen – eine Zeichnung, die 6 zeigt, und ein Leseergebnis, das G zurückgibt, werden so zu zwei verschiedenen Teilen mit gleicher Sicherheit.
- Eine 6-gegen-G-Frage lässt sich mit einem einzigen Blick auf das Zeichen in seiner Maßlinie klären – nicht durch erneutes Lesen der Zahlenfolge in der Tabelle.
Was ein Angebots-Workflow tatsächlich von einer Zeichnung abliest
Eine Angebotsanfrage kommt als Zeichnungspaket: ein mehrseitiges PDF-Set des Bauteils, eine Stückliste, Qualitätsklauseln und oft eine Revisionshistorie. Bevor ein Kalkulator irgendetwas bepreisen kann, liest jemand den Titelblock. Gemäß ASME Y14.1, dem in der US-Fertigung verwendeten Zeichnungsstandard, sitzt der Titelblock in der unteren rechten Ecke und enthält Zeichnungsnummer, Titel, Revision, Material, Gewicht, Blattanzahl und Freigabedaten. Dann folgen die Maßlinien und Toleranzrahmen, spezifiziert nach ASME Y14.5, gefolgt vom Notizblock mit Spezifikationsangaben wie Wärmebehandlung oder chemischer Konversion sowie der BOM-Tabelle.
Dieses Ablesen wird zum Angebot. Jede Position in der Kalkulation, ob in Epicor Kinetic, JobBOSS², SAP Business One oder einer dedizierten Angebotsplattform wie Paperless Parts, führt auf einen Wert zurück, den der Kalkulator von der Zeichnung übernommen hat: Materialgüte, Gewicht, kritische Maße, Oberflächengüte, Menge. Die Mavlon-Studie zu Angebotskosten von Fertigungsbetrieben maß einen Median von 2,5 bis 3,5 Stunden pro Angebot, wobei allein die Zeichnungsextraktion bei einfachen Einzelteilzeichnungen 20 bis 40 Minuten und bei komplexen mehrseitigen Paketen 60 bis 150 Minuten dauerte, bevor die Preisbeurteilung überhaupt beginnt. Bei voll belasteten $55 pro Stunde entspricht ein Angebot etwa $165 direkter Arbeitskosten.
Die Phasen 1 bis 3 der Angebotserstellung – Erfassung, Zeichnungsextraktion und historische Recherche – verbrauchen rund 60 % dieser Zeit und enthalten keinerlei Preisbildungsexpertise. Das ist der Teil, den jeder Betrieb automatisieren möchte, und genau hier richtet ein einzelnes falsch gelesenes Zeichen seinen Schaden an.
Wenn das Angebotsblatt des Kunden und Ihre eigene Kalkulation beide als Dokumente vorliegen, werden die Mechanismen zur Umwandlung in Tabellenzeilen im Leitfaden zum Konvertieren von Angebots-PDFs in Excel-Positionen behandelt.
Flattening löscht den Teil der Datei, den ein Programm liest
Ein aus CAD erstelltes PDF ist ein Container mit zwei Leben. Eines ist die gerenderte Seite, die Pixel, die Sie sehen. Das andere ist eine Ebene auswählbarer Textobjekte, Formularfelder, Annotationen und optionaler Inhaltsgruppen, die Software programmatisch adressieren kann. Flattening führt die interaktive Ebene in den statischen Seiteninhalt über: Die Darstellung eines Widgets wird direkt in den Seiteninhaltsstrom gezeichnet und die zugrunde liegenden Annotations- und Feldobjekte werden entfernt, ein Mechanismus, der in der PDF-Spezifikation ISO 32000 definiert ist. Das Ergebnis sieht auf dem Bildschirm identisch aus, und die Textebene ist nicht mehr vorhanden.
Die Frage des r/pdf-Posters, ob ein von einem externen Programm erstelltes, flaches PDF rückgängig gemacht werden kann, erhielt die funktionierende Antwort in fünf Worten: „Im Allgemeinen nein, nicht mit 100-prozentiger Genauigkeit." Flattening ist von Natur aus eine Einbahnstraße, und wenn Lieferanten eine Zeichnung drucken und rastern statt sie nur zu flatten, wird die gesamte Seite zu einem Bild und die Textebene hat im gelieferten Dokument nie existiert. Dies ist in der Praxis üblich, CAD-Dateien sind lizenz- und versionssensibel, daher erhalten viele Betriebe Zeichnungen, die absichtlich auf Pixel reduziert wurden.
Für ein internes Programm, das Textobjekte analysierte, bleibt nichts zu analysieren. OCR ist die einzige Tür zurück, und sie liest Pixel, die nicht für Maschinen erstellt wurden. Die allgemeinen Fehlermodi von OCR bei gescannten und Bilddokumenten, niedrige Auflösung, Schräglage, Rauschen, sind im Leitfaden zu Ursachen und Lösungen für niedrige OCR-Genauigkeit bei gescannten Dokumenten dargelegt.
Warum eine Teilenummer der OCR keine zweite Chance gibt
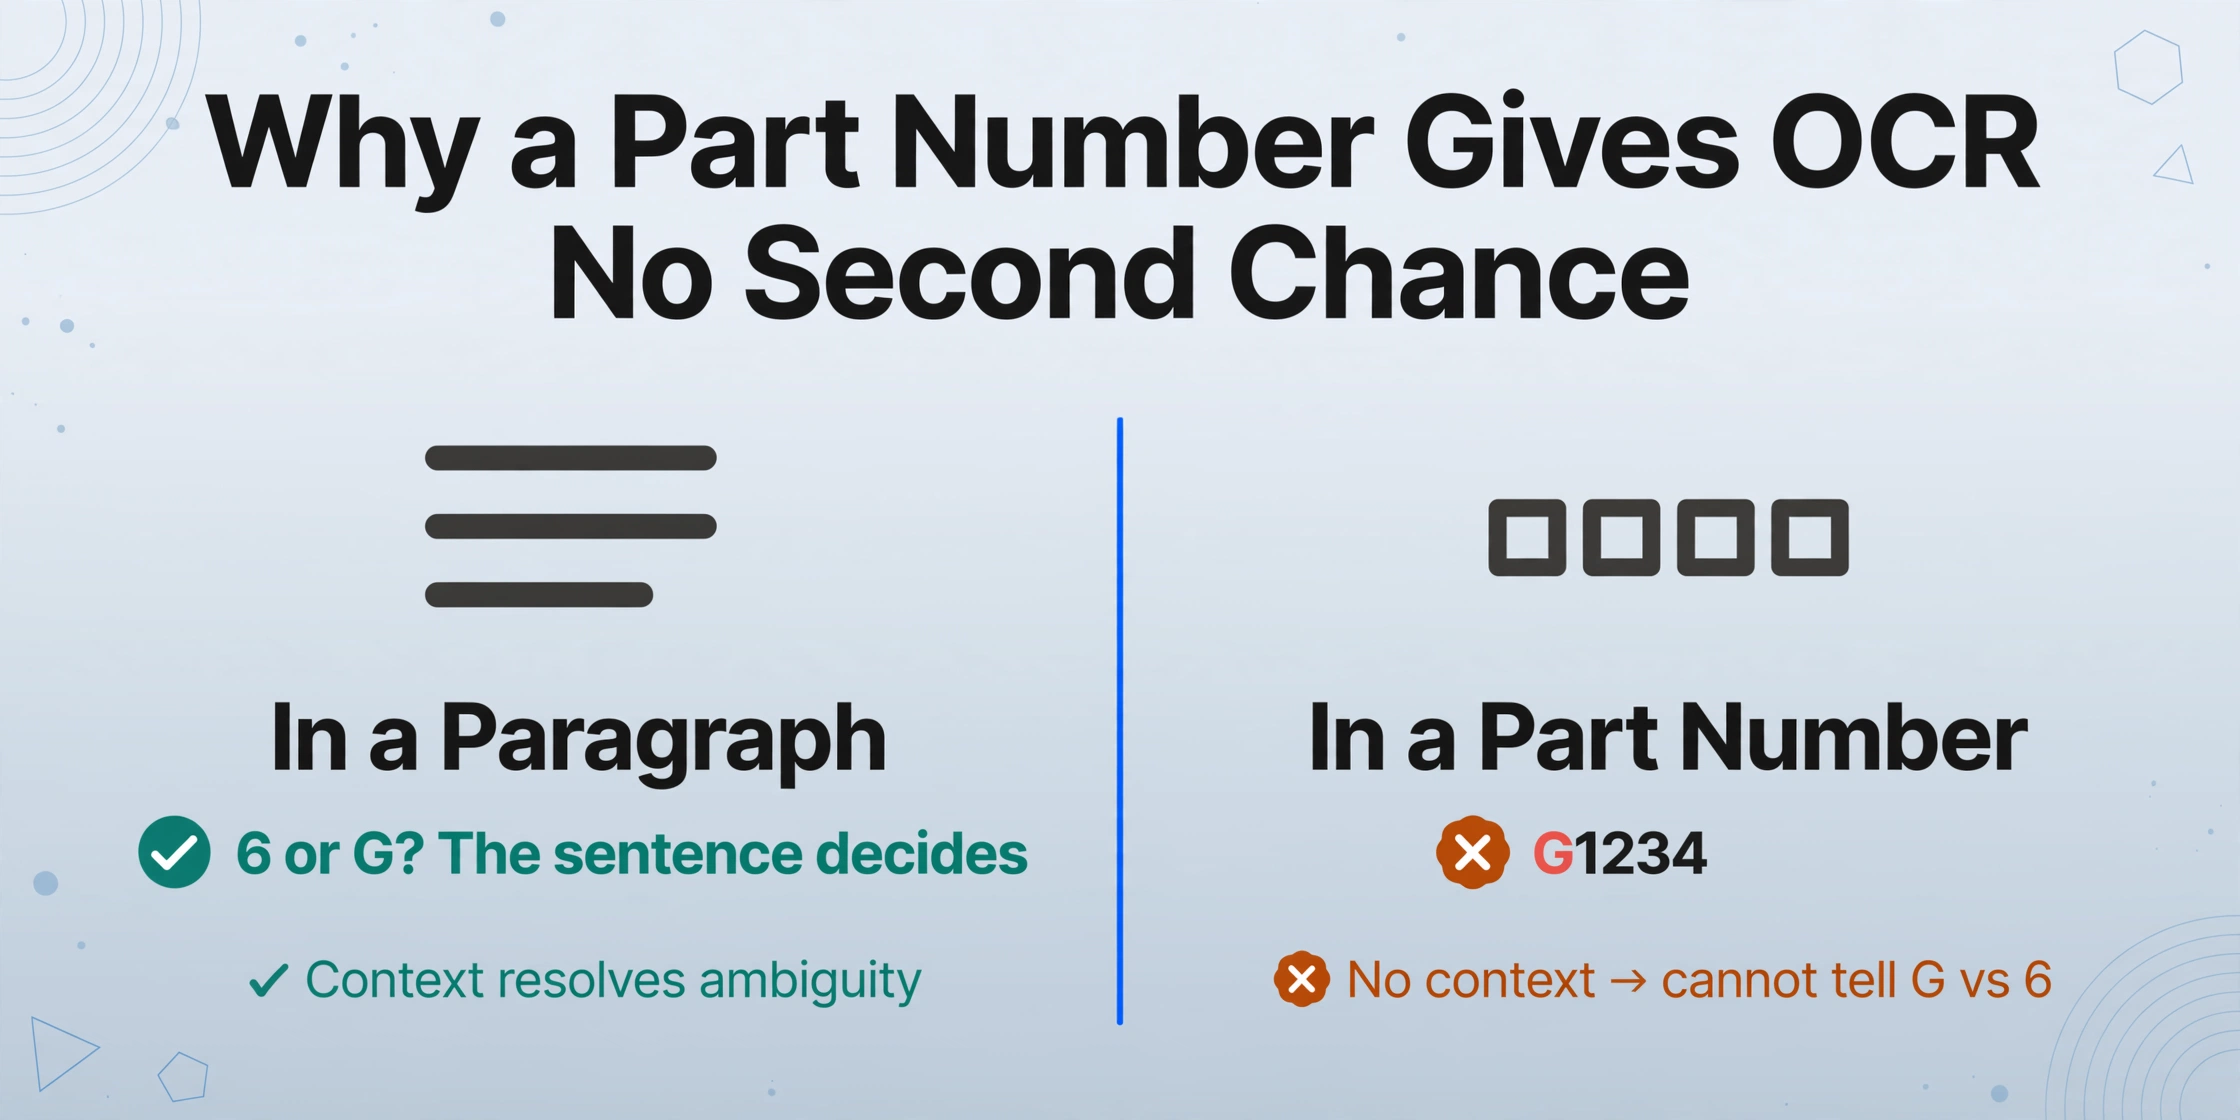
Generische OCR liest im offenen Kontext. In einem Absatz sind die umgebenden Wörter das Sicherheitsnetz: Wenn ein Modell ein Zeichen sieht, das eine 0 oder ein O sein könnte, entscheidet der Satz. Teilenummern, Zeichnungsnummern, Revisionsbuchstaben und Materialgüten haben keinen solchen Kontext. Eine Katalognummer ist von Natur aus kompakt, daher hat das Modell nichts, worauf es sich stützen kann, und jedes Zeichen muss allein anhand seiner Form klassifiziert werden.
Die Form allein versagt bei technischen Zeichnungen. Eine Masterarbeit der Universität Helsinki von 2025 maß OCR-Engines anhand kurzer alphanumerischer Kennungen, die aus echten technischen Zeichnungen extrahiert wurden, und dokumentierte die Verwechslungsmuster direkt. Wenn eine OCR-Engine 6 als G in einem Titelblock las, wurde dies nachgelagert nicht erkannt, da die Zeichenfolge immer noch wie eine lesbare Kennung aussah: Tesseract las 1 dreizehnmal als I, T sechsmal als E und 0 fünfmal als O, während ein Cloud-OCR-Dienst einen Schrägstrich als I und eine 4 als L las. Die Schlussfolgerung des Autors trifft exakt auf Teilenummern zu: „Selbst ein einzelner Zeichenfehler kann die Bedeutung einer ID ändern, und eine einfache wörterbuchbasierte Nachbearbeitung ist nicht unkompliziert."
Der Fehler ist nicht auf günstige OCR-Software beschränkt. eDOCr, eine speziell für technische Zeichnungen entwickelte OCR-Pipeline, die in der Frontiers in Manufacturing Technology-Studie vorgestellt wurde, wies bei der Erkennung dennoch eine Zeichenfehlerrate von 8 % auf. Wenn eine solche Fehlerrate auf eine Teilenummer mit zehn oder zwölf Zeichen trifft, ist nicht die Frage, ob sich die Zeichenfolge ändert, sondern welches Zeichen betroffen ist. Eine 6 und ein G aus derselben Zeichnungsschrift sind bei kleinen Größen nahe Verwandte, ebenso wie 1, I und 7, 0 und O, 2 und Z, 8 und B. Das konkrete Paar, auf das der r/pdf-Nutzer gestoßen ist, ist nur eine Zeile in einer viel größeren Verwechslungstabelle.
| Verwechslungspaar | Wo OCR stolpert | Beispielquelle |
|---|---|---|
| 1, I, l, 7 | Teilenummern, Maßwerte, Revisionsbuchstaben | Helsinki 2025-Abschlussarbeit (1 als I, 13 Fälle) |
| 0, O | Zeichnungsnummern, Notizblocktext | Helsinki 2025-Abschlussarbeit (0 als O, 5 Fälle) |
| T, E | Spezifikationsangaben, Notizabkürzungen | Helsinki 2025-Abschlussarbeit (T als E, 6 Fälle) |
| /, I und 4, L | Werkstoffgüten, Oberflächencodes | Helsinki 2025-Abschlussarbeit (Cloud-OCR) |
| 6, G | Teilenummern, Maßtext | r/pdf-Zeichnungspaket-Thread |
Die Genauigkeit variiert aus strukturellen Gründen je nach Dokumenttyp, und die Übersicht zu warum die OCR-Genauigkeit bei verschiedenen Dokumenttypen abnimmt behandelt diese Mechanismen auf Seitenebene. Der zeichnungsspezifische Fall ist das Schlimmste aus beiden Welten: verschlechterte Eingabequalität und das Fehlen eines Sprachmodells zur Korrektur.
Was ein falsch gelesenes Zeichen kostet, bevor das Teil überhaupt gefertigt ist
Eine falsche Teilenummer bleibt nicht auf der Zeichnung. Sie wird zur Preiszeile im Angebot, zur Bestellzeile für Material und zum Fertigungsauftrag, der folgt. Weicht die angebotene Nummer von dem ab, was die Zeichnung tatsächlich vorgibt, kann der Betrieb den Auftrag verlieren, weil er ein anderes Teil anbietet als vom Kunden gewünscht – oder den Auftrag gewinnen und die Abweichung erst entdecken, wenn das gefertigte Teil anhand der tatsächlichen Maße der Zeichnung durchfällt.
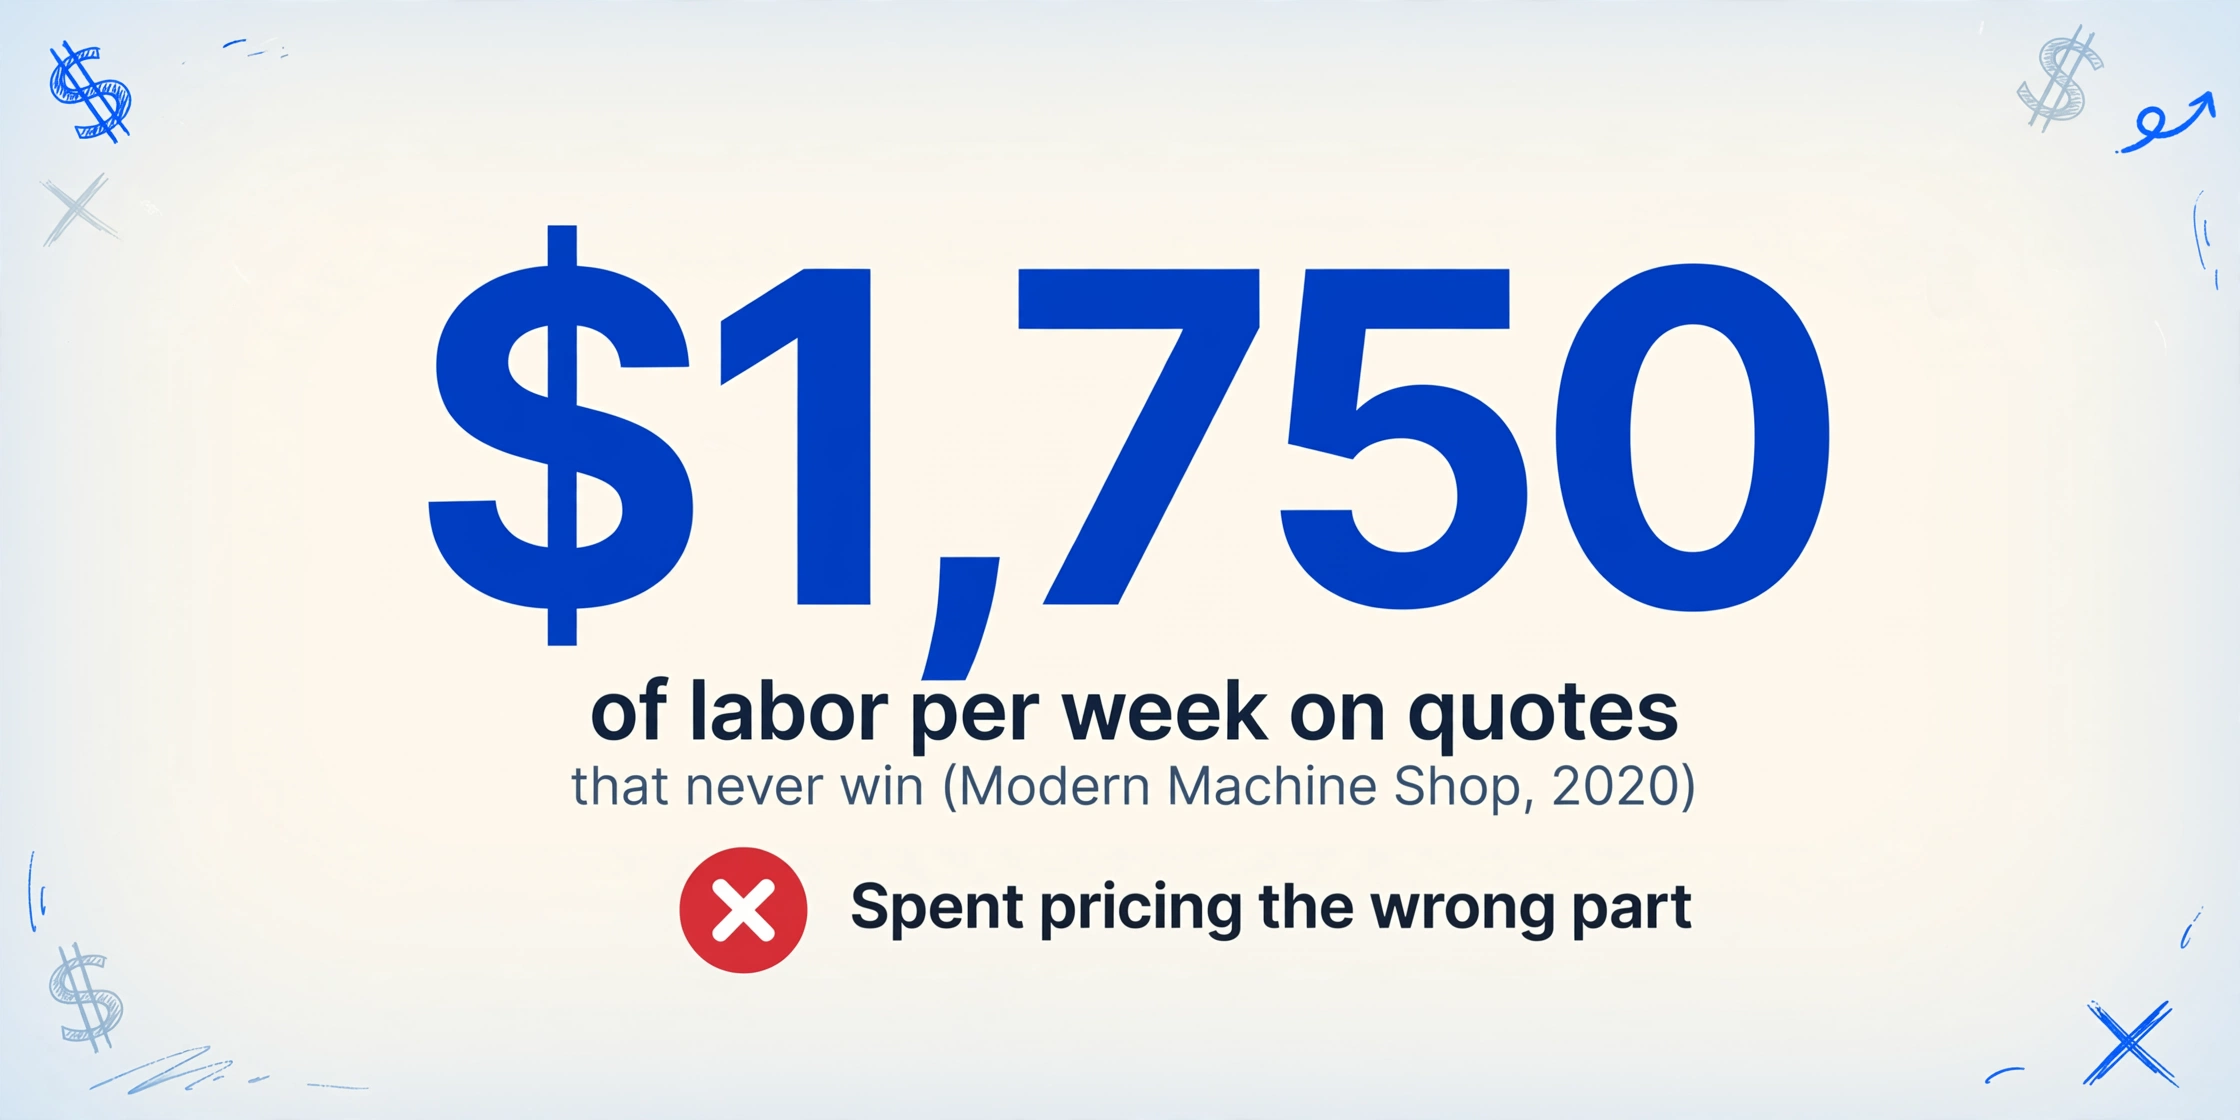
Die Kosten der Angebotserstellung selbst sind der Punkt, an dem sich die Verschwendung konzentriert. Eine Analyse von Modern Machine Shop aus dem Jahr 2020 ergab, dass der durchschnittliche Betrieb bis zu 1.750 $ Arbeitsaufwand pro Woche für Angebote ausgibt, die er nie gewinnt, und die meisten Betriebe landen nur etwa ein Drittel der Aufträge, die sie anbieten. Wenn eine Zeichenverwechslung durchrutscht, wird jede Stunde darauf verwendet, das falsche Teil zu kalkulieren.
Hinter dem Angebot stehen die Produktionskosten des Fehlers. Benchmark-Daten der Fabricators and Manufacturers Association, zusammengestellt von Reliable Plant, beziffern Ausschuss und Nacharbeit auf etwa 1,4 % des Umsatzes für den durchschnittlichen US-Metallverarbeiter und unter 1 % für das oberste Quartil, während die American Society for Quality die gesamten qualitätsbezogenen Kosten für viele Hersteller auf 15 % bis 20 % des Umsatzes schätzt. Die Eskalationsregel, die für Maße zählt, ist einfach und wird in der Branche oft zitiert: Ein falsches Maß, das an der Maschine entdeckt wird, kostet ein paar Minuten; bei der Endkontrolle entdeckt, kostet es das Teil; und vom Kunden entdeckt, kostet es das Teil, die Fracht, die Sperrsortierung, den Korrekturmaßnahmenbericht und den Besuch.
Die Fertigung läuft auf Dokumenten, die nie für die ERP-Eingabe gebaut wurden, und die Pipeline, die Bestellungen, Angebote, Lieferscheine und Rechnungen in strukturierte Zeilen verwandelt, wird im Leitfaden zur Dokumentextraktionssoftware für die Fertigung behandelt. Die Zeichnung ist der Startpunkt dieser Pipeline, und ein Zeichenfehler dort fließt in jede dahinterliegende Zeile ein.
Zeichnung nach Bedeutung lesen, dann das Glyph prüfen, dem Sie nicht vertrauen können
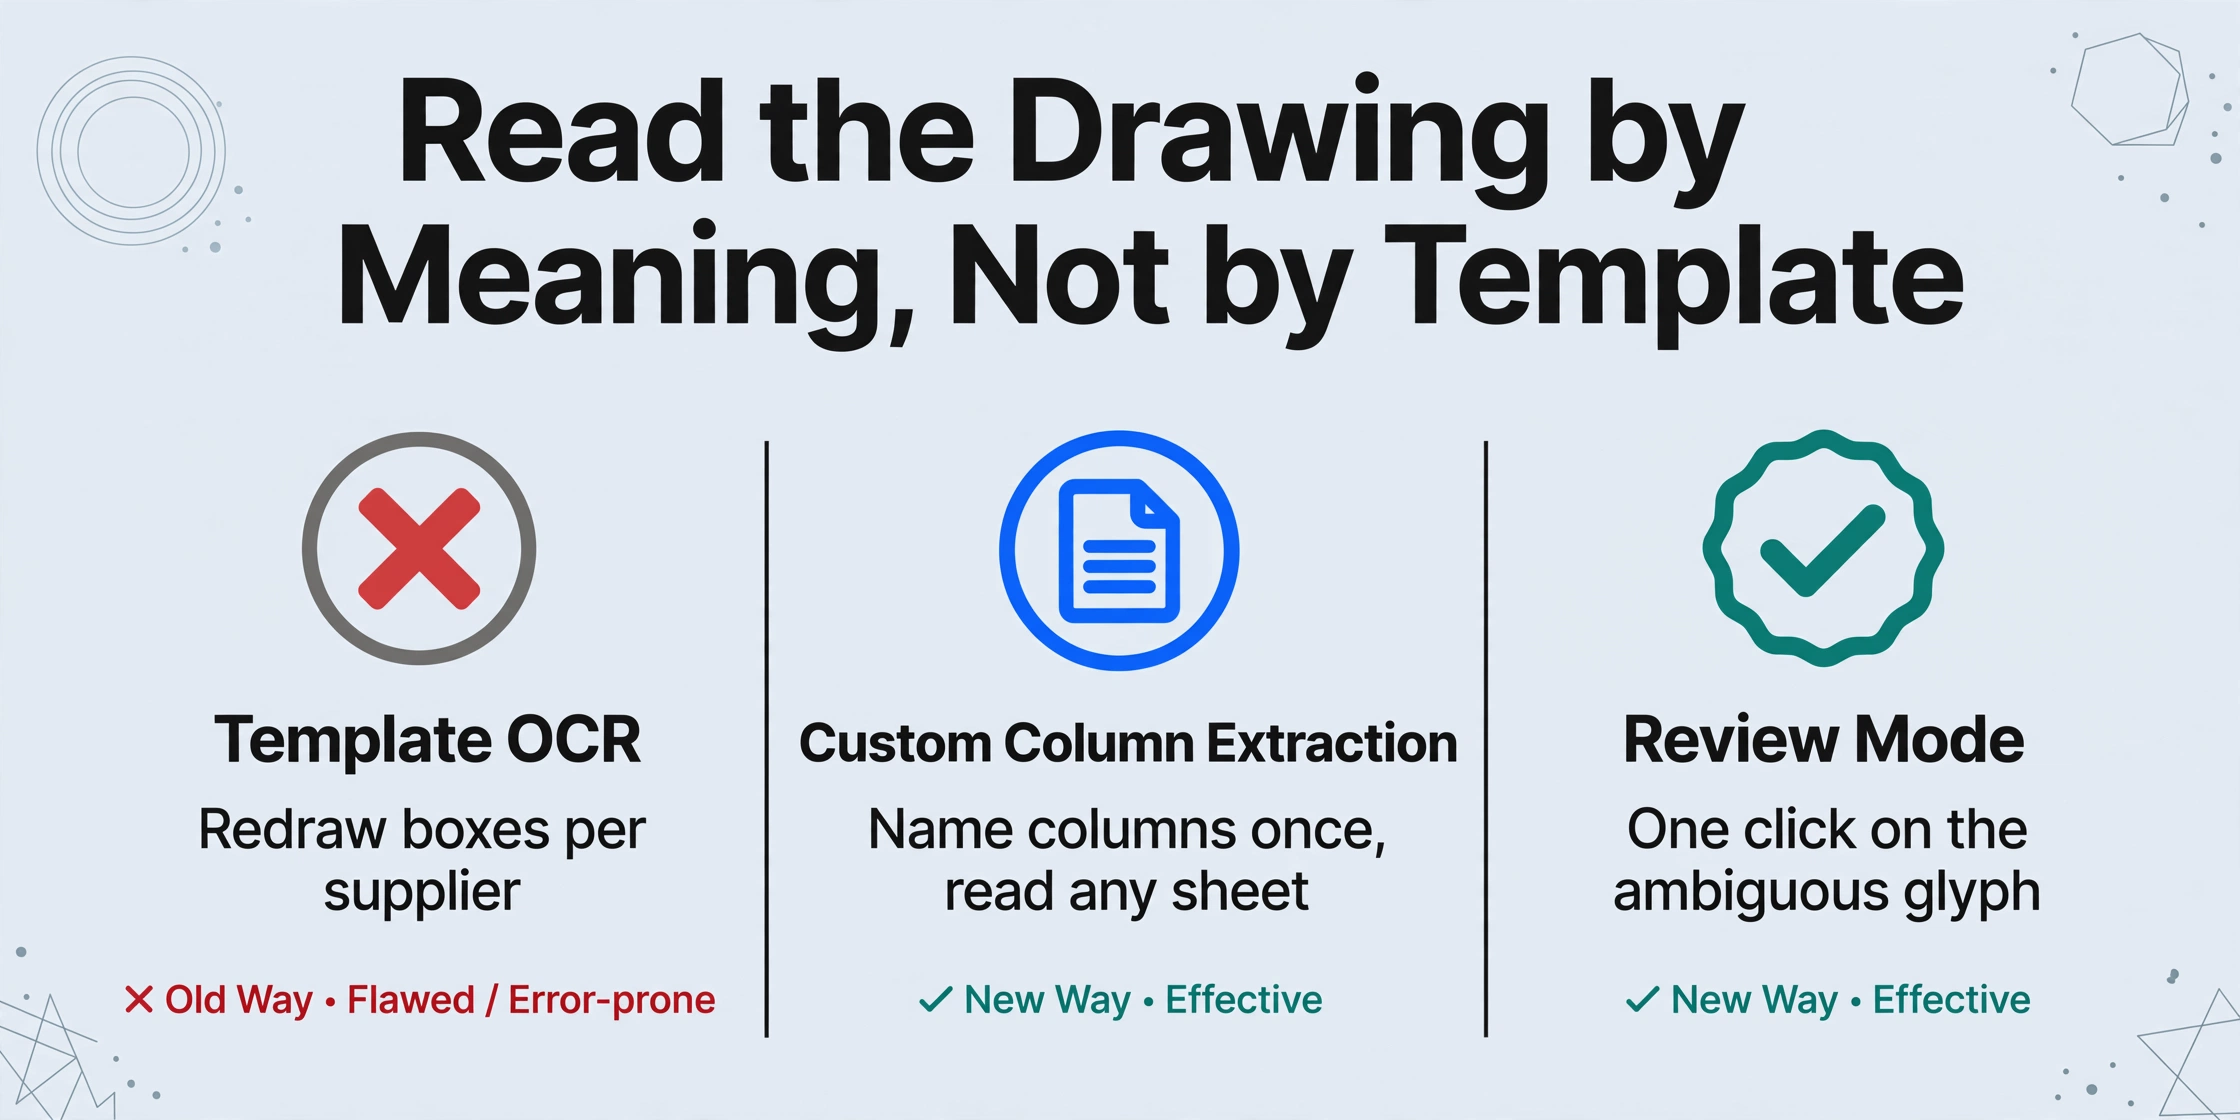
Die Lösung ist keine bessere OCR-Engine, die einmal konfiguriert wird und der man für immer vertraut. Es ist eine Prozessänderung: Extrahieren Sie nach der Bedeutung des Felds statt nach Zeichenvorlagen, verarbeiten Sie auf der Präzisionsstufe, die die Qualität der Zeichnung erfordert, und sehen Sie sich das mehrdeutige Zeichen an seiner ursprünglichen Stelle an, bevor ein Angebot das Haus verlässt. ImageToTable.ai ist auf den ersten dieser Punkte ausgelegt. Mit Benutzerdefinierte Spaltenextraktion geben Sie die gewünschten Spaltennamen ein, z. B. Teilenummer, Revision, Material, Gewicht und Menge. Die KI lokalisiert jeden Wert überall auf dem Blatt, indem sie versteht, was das Feld bedeutet – nicht durch Abgleich von Pixelkoordinaten oder einer gezeichneten Vorlage. Da sie das gerenderte Seitenbild liest, stellt ein geflattetes oder rasterisiertes PDF kein Hindernis dar; die Textobjekte sind weg, und die Pixel sind, was sie sind.
Das ist der strukturelle Unterschied zur vorlagenbasierten OCR, bei der Sie über jedes Feld ein Kästchen zeichnen und es neu zeichnen müssen, sobald ein Lieferant sein Zeichnungsformat ändert. Die Spalten einmal zu benennen bedeutet, dass dieselbe Blattstruktur über einen Ordner mit Zeichnungspaketen verschiedener Kunden funktioniert und der gesamte Batch in einer einzigen Tabelle landet.
Benennen Sie die Spalten, die ein Angebot tatsächlich benötigt
Teilenummer, Revision, Material, Gewicht, kritische Maße, Oberflächengüte. Die KI liest jedes Feld dort, wo es im Titelblock, in der Maßlinie oder in den Anmerkungen sitzt, und exportiert eine Tabelle mit genau diesen Kopfzeilen. Sie definieren die Ausgabe, nicht die Zeichnung.
Passen Sie die Verarbeitungsstufe an die Qualität der Zeichnung an
Die Standardstufe deckt die meisten gedruckten Zeichnungen ab. Für schwache Scans, kontrastarme Kopien oder dichte mehrseitige Pakete verwenden die höheren Präzisionsstufen ein stärkeres Vision-Modell, sodass ein einziger Workflow die Qualitätslücke in den Zeichnungspaketen, die Sie erhalten, abfedern kann.
Öffnen Sie den Review-Modus und bestätigen Sie die Zeichen, bei denen Sie sich keinen Fehler leisten können
Aktivieren Sie nach der Verarbeitung Auto-annotate, und jede extrahierte Zelle trägt ihren Quellbereich. Klicken Sie auf Teilenummer G1234, und die Zeichnung wird genau an der Stelle hervorgehoben, an der diese Zeichenfolge gelesen wurde. Kehren Sie es um, indem Sie auf eine Stelle in der Zeichnung klicken, um zur passenden Zelle zu springen, und bearbeiten Sie jeden Wert, während die ursprüngliche KI-Lesung nur einen Klick entfernt bleibt. So klären Sie eine 6-gegen-G-Frage: indem Sie das Glyph in seiner Maßlinie betrachten, statt der Zahlenfolge zu vertrauen.
Die Extraktion holt die Daten aus der Zeichnung. Der Review-Modus hält das eine Zeichen, dem Sie nicht vertrauen, davon ab, in das Angebot zu gelangen. Die beiden Schritte sind ein einziger Workflow: den Batch verarbeiten und dann die Unklarheit gegen das Originalbild prüfen, bevor exportiert wird.
Eine Zeichnung, die überhaupt gelesen werden muss, ob geflattet, gescannt oder als natives PDF, durchläuft denselben semantischen Pfad, und die Mechanik, die extrahierten Felder in ein nutzbares Blatt zu verwandeln, wird in den Anleitungen zu PDF-Datenextraktionssoftware und OCR-PDF-zu-Excel-Konvertierung behandelt.
Was dieser Ablauf für Sie nicht leisten kann
Kein Extraktionsschritt macht aus einer unlesbaren Zeichnung eine lesbare. Text, der zu blass zum Erkennen ist, Pixel unterhalb der Scan-Auflösung und handschriftliche Markierungen bleiben, was sie sind, und sie benötigen weiterhin die Quellzeichnung oder einen informierten Menschen.
Wenn eine Fotokopiekette die Zeichnung bis auf gebrochene Zeichen abgenutzt hat, kann kein Modell wiederherstellen, was die Pixel nicht mehr enthalten. Fragen Sie den Lieferanten vor der Verarbeitung nach einem erneuten Export oder einem sauberen Scan, so wie die r/pdf-Antwort empfahl, zur Quelle der Datei zurückzugehen, anstatt zu versuchen, das Flattening umzukehren. Handschriftliche Revisionsmarkierungen und nicht standardisierte Symbole fallen in dieselbe Kategorie: Markieren Sie sie für den Kalkulator, anstatt dem Leseergebnis zu vertrauen.
Die ehrliche Grenze ist, dass dieser Workflow die Pipeline automatisiert und die Entscheidungen menschlich bleiben lässt. Nichts sendet ein Angebot, ohne dass eine Person die Werte genehmigt, und die Review-Ebene existiert genau deshalb, weil das Modell bei einem gescannten Titelblock nicht garantiert perfekt ist. Was sich ändert, ist, dass die Prüfung der Unklarheit einen Klick auf einen hervorgehobenen Bereich erfordert, anstatt eine schielende Stunde damit zu verbringen, eine Tabelle mit einer Zeichnung zu vergleichen.
OCR für technische Zeichnungen und geflattete PDFs: FAQ
Kann ein abgeflachtes PDF wieder entflacht werden?
Nein. Flattening ist im PDF-Standard eine Einbahnstraße. Die Objektdaten, die den Text trugen, werden physisch entfernt, sobald ihre Darstellung in den Seiteninhalt gezeichnet wird – es bleibt also nichts übrig, das wiederhergestellt werden könnte. Der praktische Weg ist, das gerenderte Bild zu lesen, was ein Vision-Modell tut, anstatt die Textebene wiederherzustellen.
Warum liest eine Zeichnungs-OCR eine 6 als G?
Weil Teilenummern einem Erkennungsmodell keinen Kontext bieten. In Prosa unterscheiden benachbarte Wörter eine 6 von einem G, eine 0 von einem O oder eine 1 von einem I. Eine kurze alphanumerische Teilenummer hat keine Nachbarn, also wird jedes Zeichen nur anhand seiner Form klassifiziert – und bei den kleinen, kontrastarmen Glyphen, die auf Zeichnungen üblich sind, überlappen sich diese Formen tatsächlich.
Funktionieren gescannte oder abgeflachte Zeichnungen mit KI-Extraktion?
Ja. Eine Extraktion, die das gerenderte Seitenbild liest, ist nicht auf eine Textebene angewiesen. Gescannte und abgeflachte Zeichnungen werden daher genauso verarbeitet wie native PDFs. Die Genauigkeit hängt von der Pixelqualität ab – deshalb sind die Verarbeitungsstufe und der Prüfschritt bei einem verblassten Scan wichtiger als bei einem sauberen digitalen Export.
Gibt es einen Unterschied zwischen der Extraktion aus einem nativen PDF und einem abgeflachten?
Für einen visionbasierten Extraktor ist der sichtbare Unterschied gering, da er in beiden Fällen die gerenderte Seite liest. Ein natives PDF kann zusätzlich auswählbaren Text enthalten, den einfachere Tools nutzen können – aber diese Textebene hat keine Layout-Bedeutung: Sie verrät nicht, welche Zeichenfolge die Teilenummer und welche die Notiz ist. Zu entscheiden, was jeder Wert bedeutet, ist in beiden Fällen dieselbe Aufgabe.
Woher weiß ich, dass eine Teilenummer korrekt gelesen wurde?
Öffnen Sie den Prüfbereich und klicken Sie auf die Zelle. Die Zeichnung wird genau an der Stelle hervorgehoben, aus der der Wert stammt, und Sie vergleichen die Glyphe auf der Seite mit der Zeichenfolge in der Tabelle. Wenn Sie Auto-annotate nach der Verarbeitung aktivieren, wird jede Extraktion mit ihrer Quellregion geliefert – die Verifizierung wird so zu einem Durchsehen der mehrdeutigen Zeichen statt zu einem vollständigen erneuten Lesen.
Jeder Angebotsfehler in diesem Artikel – die falsche Teilenummer, das falsche Material, das falsche Maß – beginnt auf dieselbe Weise: ein Zeichen, das aus einer Zeichnung gelesen und ohne Verifizierung übernommen wurde. Die Spalten zu benennen, die Seite als Bild zu lesen und die Quellregion jeder Zelle zu prüfen, bei der Sie sich keinen Fehler leisten können, ist ein Prozess, der heute mit realistischen Zeichnungspaketen funktioniert – ohne ein Modell zu trainieren oder eine Vorlage zu zeichnen. Ein abgeflachtes PDF kann nicht entflacht werden, aber die Fehllesungen, die es erzwingt, können abgefangen werden, bevor sie zu einem Angebot werden.