L'OCR de dessins d'ingénierie lit 6 comme G,
et le devis se trompe
Un six lu comme un G n'est pas un échec dramatique. Sur un dessin d'ingénierie aplati, cela transforme un numéro de pièce en un autre numéro de pièce, et c'est ce numéro différent que le système de devis évalue, commande le matériel et planifie l'usinage. L'ingénieur qui a soulevé ce point sur r/pdf l'a dit clairement : « la majorité des packs de dessins FC PDF que nous recevons ont été aplatis, donc mon programme est pratiquement inutile à moins que je saisisse un type d'OCR qui n'est pas très fiable, en termes de remplacement d'un 6 par un G, etc. »
Points clés à retenir
- Un taux d'erreur de caractères de 8 % semble survivable jusqu'à ce qu'il rencontre un numéro de pièce de dix ou douze caractères, où un seul glyphe erroné change tout l'identifiant.
- Un numéro de pièce ne donne à l'OCR aucun contexte pour détecter l'erreur, donc un dessin qui montre 6 et une lecture qui renvoie G deviennent deux pièces différentes avec une confiance égale.
- Régler une question 6-contre-G prend un seul coup d'œil au glyphe dans sa ligne de cote, pas une relecture de la chaîne de numéros dans le tableau.
Ce qu'un flux de devis lit réellement sur un dessin
Une demande de devis arrive sous forme de dossier de dessins : un jeu PDF multipage de la pièce, une nomenclature, des clauses qualité et souvent un historique des révisions. Avant qu'un estimateur puisse chiffrer quoi que ce soit, quelqu'un lit le cartouche. Selon la norme ASME Y14.1, la norme de feuille de dessin utilisée dans la fabrication américaine, le cartouche se trouve dans le coin inférieur droit et contient le numéro de dessin, le titre, la révision, le matériau, le poids, le nombre de feuilles et les données d'approbation. Viennent ensuite les lignes de cote et les cadres de tolérance, spécifiés selon la norme ASME Y14.5, puis le bloc de notes avec les mentions de spécification telles que le traitement thermique ou la conversion chimique, et le tableau de nomenclature.
Cette lecture devient le devis. Chaque ligne de l'estimation, que ce soit dans Epicor Kinetic, JobBOSS², SAP Business One ou une plateforme de devis dédiée comme Paperless Parts, remonte à une valeur que l'estimateur a extraite du dessin : qualité du matériau, poids, dimensions critiques, finition de surface, quantité. L'étude Mavlon sur le coût des devis dans les ateliers de fabrication a mesuré une médiane de 2,5 à 3,5 heures par devis, l'extraction des dessins représentant à elle seule 20 à 40 minutes sur des dessins simples à pièce unique et 60 à 150 minutes sur des dossiers multipages complexes, avant même que le jugement de prix ne commence. À 55 $ par heure en charge complète, un devis représente environ 165 $ de main-d'œuvre directe.
Les phases 1 à 3 du devis — réception, extraction des dessins et recherche historique — consomment environ 60 % de ce temps et ne contiennent aucune expertise de tarification. C'est la partie que chaque atelier espère automatiser, et c'est exactement là qu'une seule erreur de lecture de caractère fait ses dégâts.
Lorsque la feuille de devis du client et votre propre estimation existent toutes deux sous forme de documents, les mécanismes pour les transformer en lignes de tableur sont couverts dans le guide sur la conversion des PDF de devis en lignes Excel.
L'aplatissement supprime la partie du fichier qu'un programme lit
Un PDF généré à partir d'un logiciel de CAO est un conteneur à double vie. L'une est la page rendue, les pixels que vous voyez. L'autre est une couche d'objets texte sélectionnables, de champs de formulaire, d'annotations et de groupes de contenu facultatifs que les logiciels peuvent adresser par programmation. L'aplatissement fusionne la couche interactive dans le contenu statique de la page : l'apparence d'un widget est dessinée directement dans le flux de contenu de la page et les objets d'annotation et de champ sous-jacents sont supprimés, un mécanisme défini dans la spécification PDF ISO 32000. Le résultat est identique à l'écran, et la couche de texte n'y est plus.
La question posée par l'utilisateur de r/pdf, à savoir si un PDF aplati par un programme externe peut être inversé, a reçu la réponse pratique en cinq mots : « Généralement non, pas avec une précision de 100 %. » L'aplatissement est une opération à sens unique par conception, et lorsque les fournisseurs impriment et pixellisent un dessin plutôt que de simplement l'aplatir, la page entière devient une image unique et la couche de texte n'a jamais existé dans le fichier livré. C'est courant en pratique : les fichiers CAO comportent des sensibilités de licence et de version, de nombreux ateliers reçoivent donc volontairement des dessins réduits en pixels.
Pour un programme interne qui analysait des objets texte, il ne reste plus rien à analyser. L'OCR est la seule porte de retour, et il lit des pixels qui n'ont pas été créés pour des machines. Les modes de défaillance généraux de l'OCR sur les documents numérisés et image, faible résolution, inclinaison, bruit, sont présentés dans le guide sur les causes profondes et correctifs pour une faible précision d'OCR sur les documents numérisés.
Pourquoi un numéro de pièce ne laisse aucune seconde chance à l'OCR
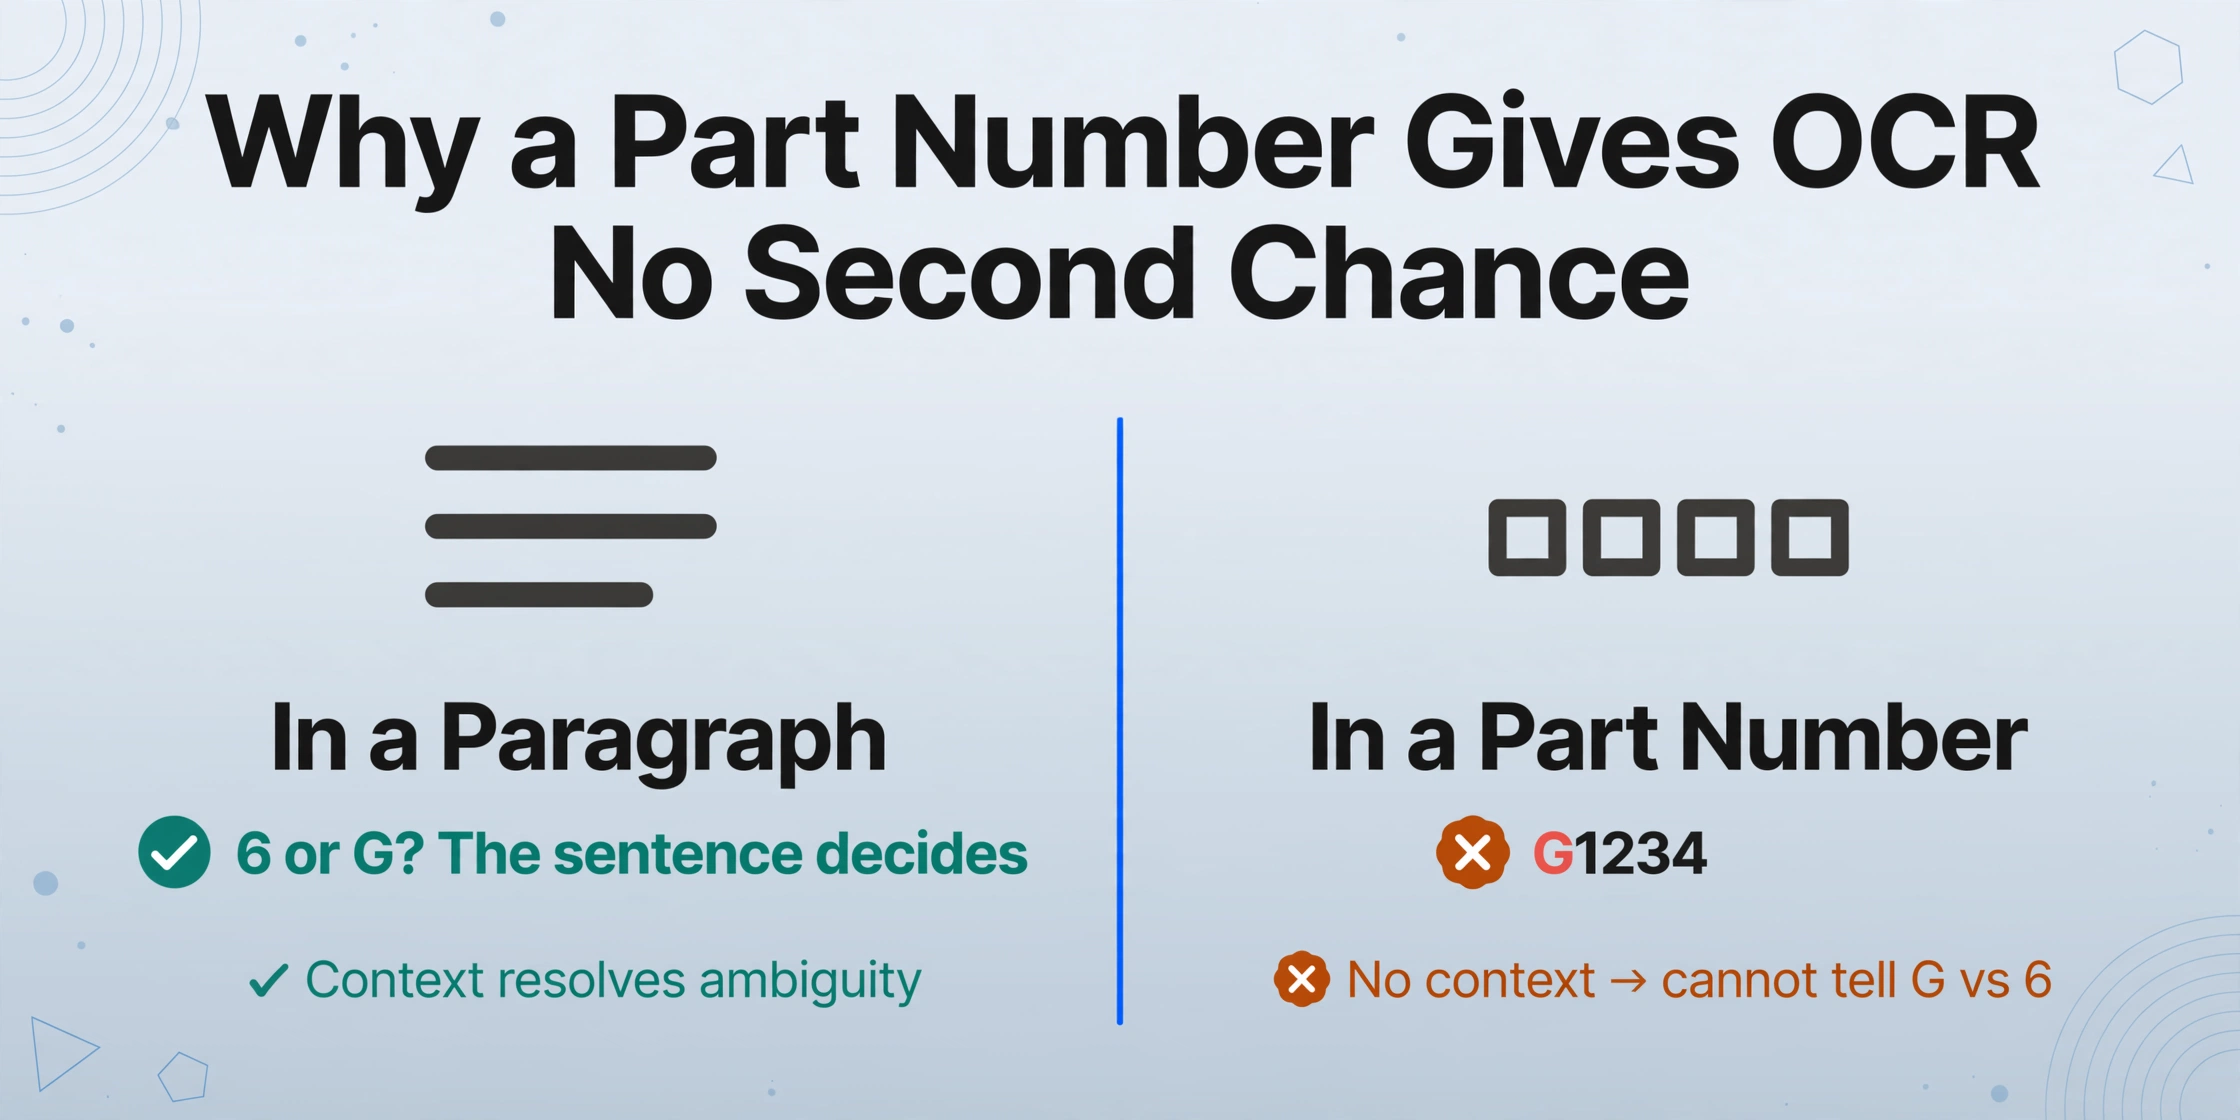
L'OCR générique lit en contexte ouvert. Dans un paragraphe, les mots environnants sont le filet de sécurité : lorsqu'un modèle voit un caractère qui pourrait être un 0 ou un O, la phrase décide. Les numéros de pièce, numéros de dessin, lettres de révision et qualités de matériaux n'ont pas ce contexte. Un numéro de catalogue est compact par conception, le modèle n'a donc rien sur quoi s'appuyer, et chaque caractère doit être classifié uniquement sur sa forme.
La forme seule échoue sur les dessins techniques. Une thèse de 2025 de l'Université de Helsinki a mesuré des moteurs d'OCR sur des identifiants alphanumériques courts extraits de dessins techniques réels et a enregistré directement les schémas de confusion. Lorsqu'un moteur d'OCR a lu 6 comme G sur un cartouche, rien en aval ne l'a détecté, car la chaîne ressemblait toujours à un identifiant lisible : Tesseract a lu 1 comme I treize fois, T comme E six fois, et 0 comme O cinq fois, tandis qu'un service d'OCR cloud a lu une barre oblique comme I et un 4 comme L. La conclusion de l'auteur correspond exactement aux numéros de pièce : « même une erreur d'un seul caractère peut changer la signification d'un ID, et le post-traitement simple basé sur un dictionnaire n'est pas simple. »
L'erreur ne se limite pas à l'OCR budgétaire. eDOCr, un pipeline OCR conçu spécifiquement pour les dessins mécaniques et présenté dans l'étude Frontiers in Manufacturing Technology, affiche toujours un taux d'erreur de caractères de 8 % en reconnaissance. Lorsqu'un tel taux d'erreur rencontre un numéro de pièce de dix ou douze caractères, la question n'est pas de savoir si la chaîne change, mais quel caractère change. Un 6 et un G issus de la même police de dessin sont proches à petites tailles, tout comme 1, I et 7, 0 et O, 2 et Z, 8 et B. La paire spécifique rencontrée par l'utilisateur de r/pdf n'est qu'une ligne dans un tableau de confusion bien plus vaste.
| Paire de caractères similaires | Là où l'OCR bute | Exemple de source |
|---|---|---|
| 1, I, l, 7 | Numéros de pièce, valeurs de cotes, lettres de révision | Thèse Helsinki 2025 (1 pour I, 13 cas) |
| 0, O | Numéros de dessin, texte de blocs de notes | Thèse Helsinki 2025 (0 pour O, 5 cas) |
| T, E | Renvois de spécifications, abréviations de notes | Thèse Helsinki 2025 (T pour E, 6 cas) |
| /, I et 4, L | Nuances de matériaux, codes de finition | Thèse Helsinki 2025 (OCR cloud) |
| 6, G | Numéros de pièce, texte de cotes | Fil de discussion du pack de dessins r/pdf |
La précision varie selon le type de document pour des raisons structurelles, et la vue d'ensemble de pourquoi la précision de l'OCR diminue selon les types de documents couvre ces mécanismes au niveau de la page. Le cas spécifique aux dessins cumule les deux inconvénients : une qualité d'entrée dégradée et l'absence de tout modèle de langage pour corriger les erreurs.
Ce qu'une erreur de lecture de caractère coûte avant même la fabrication de la pièce
Un mauvais numéro de pièce ne reste pas sur le dessin. Il devient la ligne de prix du devis, la ligne de bon de commande pour le matériau et l'ordre de production qui suit. Si le numéro devisé diffère de ce que le dessin spécifie réellement, l'atelier peut perdre le contrat en devisant une pièce différente de celle demandée par le client, ou gagner le contrat et découvrir l'écart seulement lorsque la pièce usinée échoue face aux dimensions réelles du dessin.
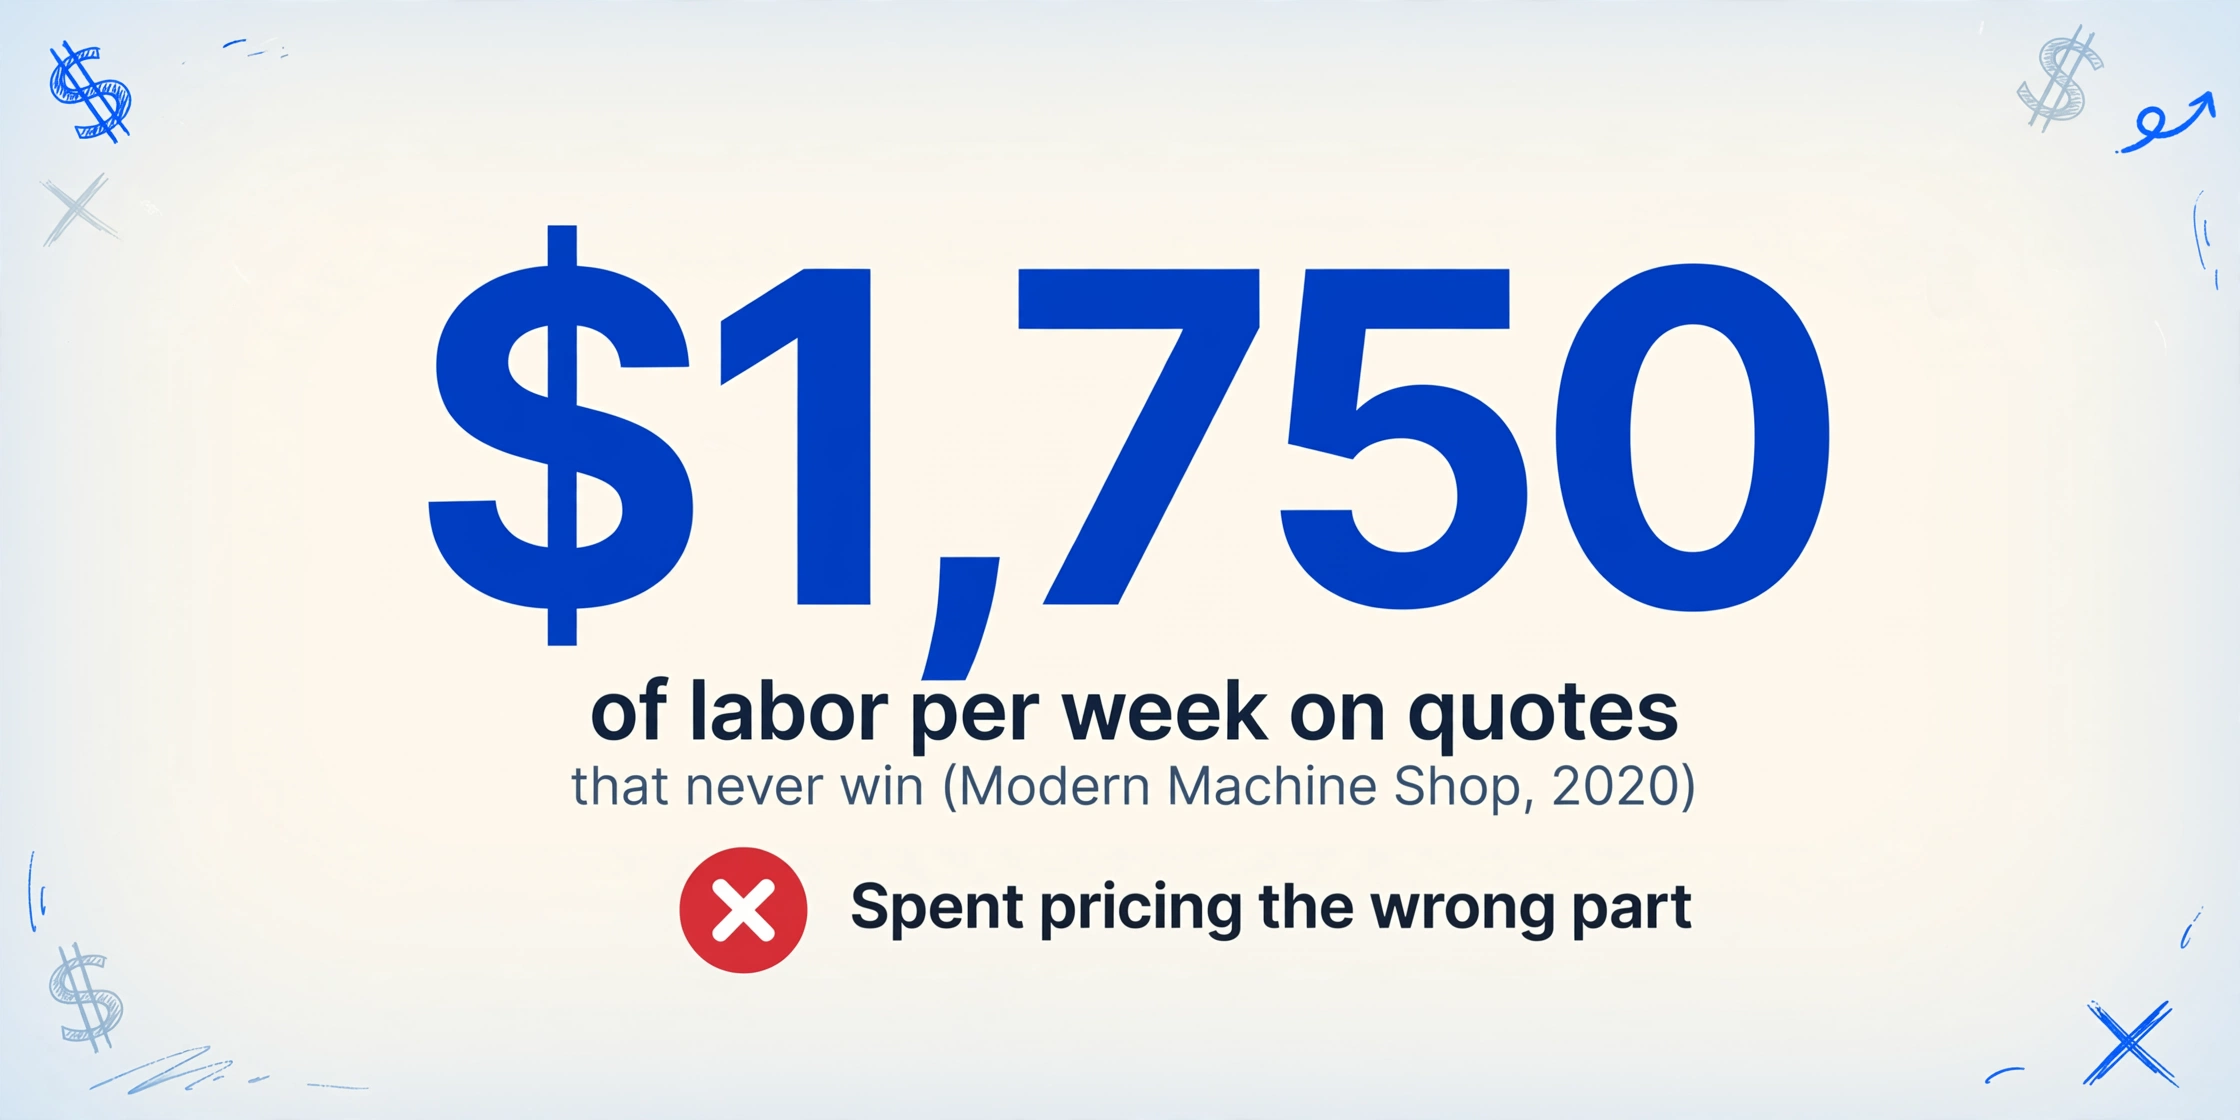
Le coût de la devis lui-même est là où le gaspillage se concentre. Une analyse de Modern Machine Shop de 2020 a révélé que l'atelier moyen dépense jusqu'à $1,750 de main-d'œuvre par semaine pour des devis qu'il ne gagne jamais, et que la plupart des ateliers ne remportent qu'environ un tiers des contrats qu'ils devisent. Lorsqu'une erreur de lecture passe à travers, chaque heure passée est une heure consacrée à chiffrer la mauvaise pièce.
Derrière le devis se trouve le coût de production de l'erreur. Les données de référence des Fabricators and Manufacturers Association, compilées par Reliable Plant, situent les rebuts et les reprises à environ 1,4 % des ventes pour le fabricant de métaux américain moyen et à moins de 1 % pour le quartile supérieur, tandis que l'American Society for Quality estime les coûts totaux liés à la qualité entre 15 % et 20 % des ventes pour de nombreux fabricants. La règle d'escalade qui compte pour les dimensions est simple et souvent citée dans l'industrie : une mauvaise dimension détectée à la machine coûte quelques minutes, détectée à l'inspection finale elle coûte la pièce, et détectée par le client elle coûte la pièce, le fret, le tri de confinement, le rapport d'action corrective et la visite.
La fabrication repose sur des documents qui n'ont jamais été conçus pour la saisie ERP, et le pipeline qui transforme les bons de commande, les devis, les reçus et les factures en lignes structurées est couvert dans le guide sur le logiciel d'extraction de documents pour la fabrication. Le dessin est le point de départ de ce pipeline, et une erreur de caractère à ce niveau se répercute dans chaque ligne qui suit.
Lire le dessin par le sens, puis vérifier le glyphe auquel vous ne pouvez pas faire confiance
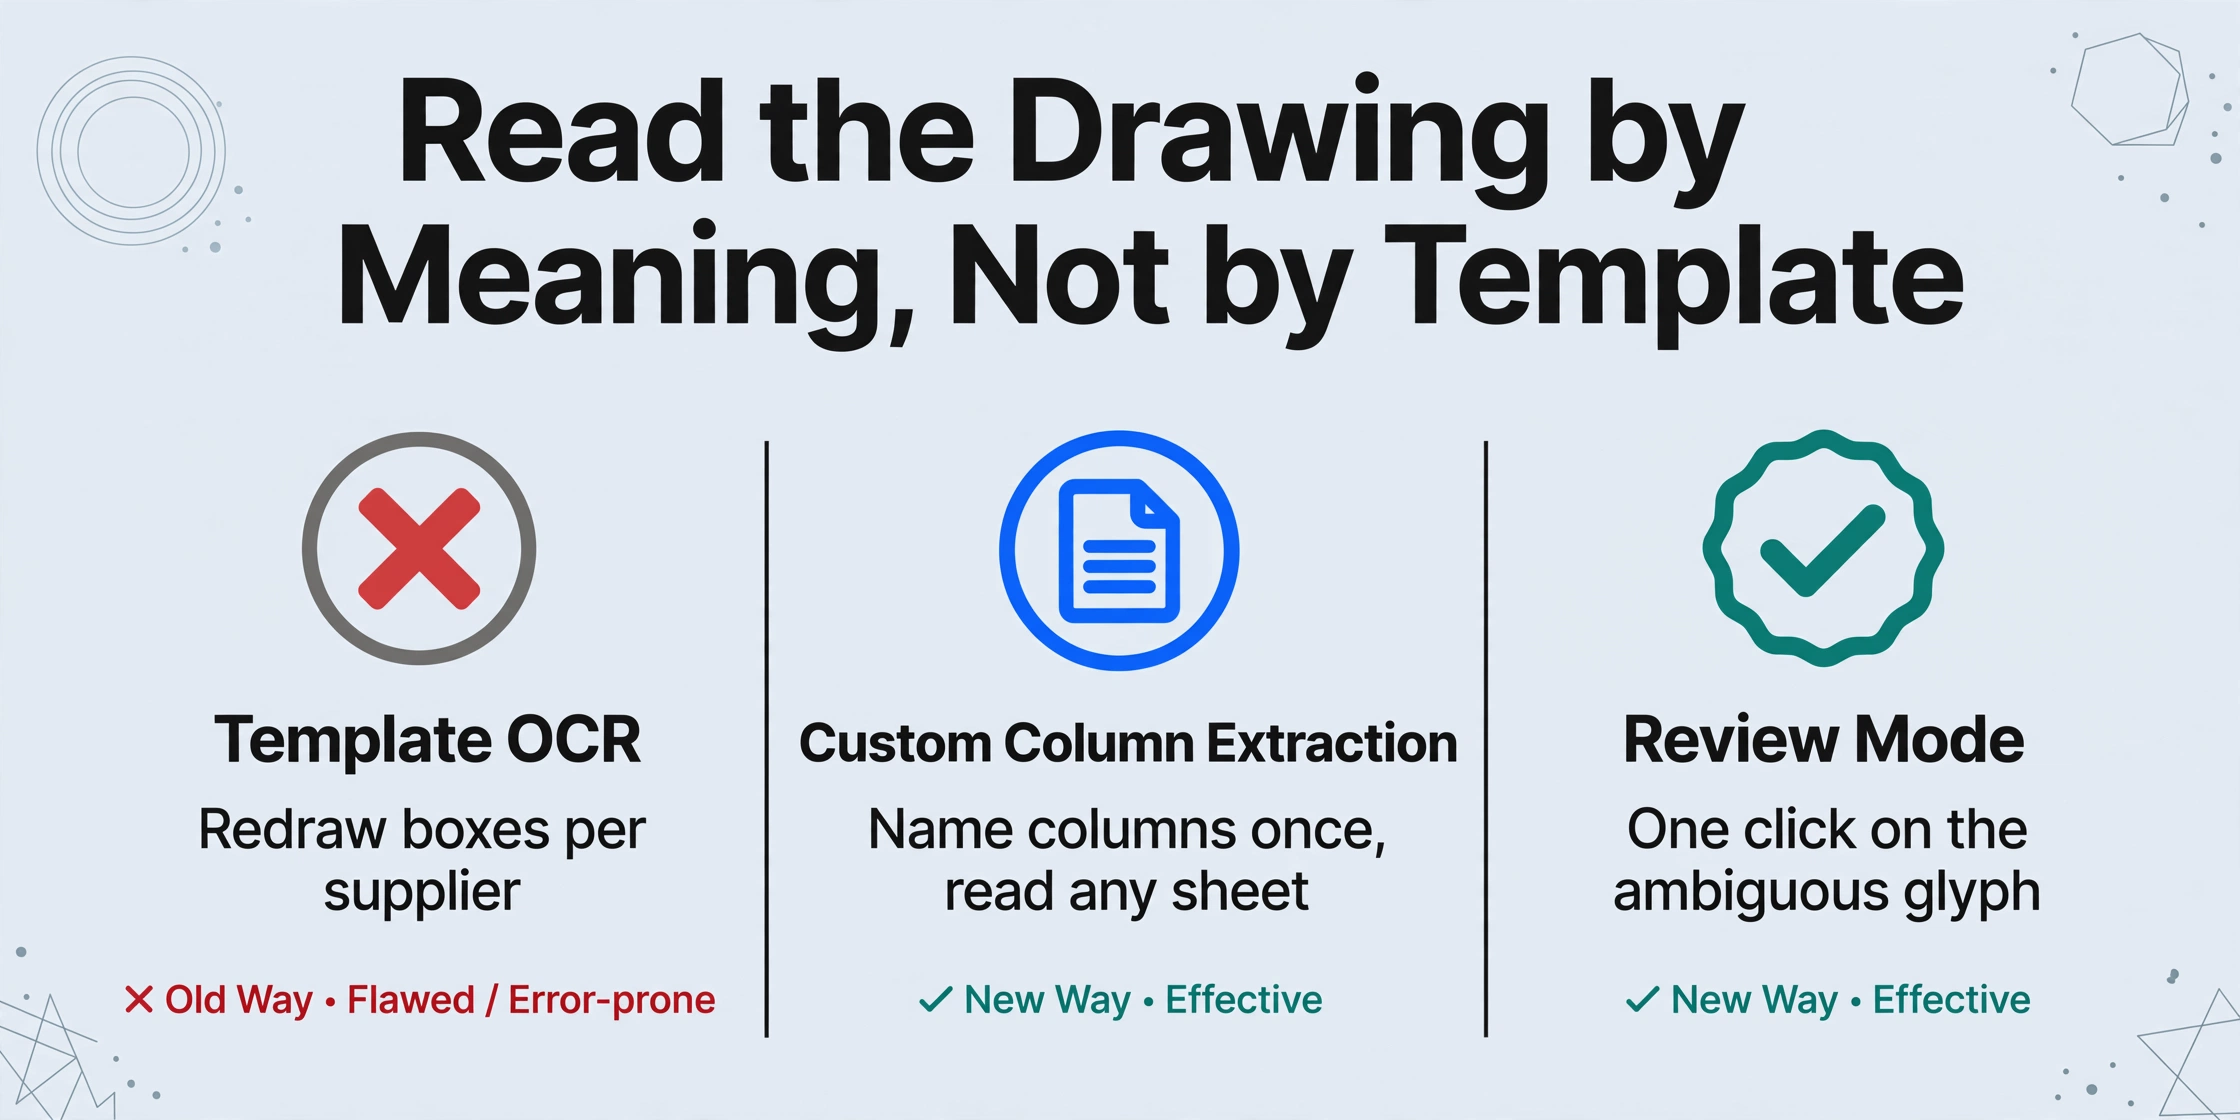
La solution n'est pas un meilleur moteur d'OCR configuré une fois pour toutes. C'est un changement de processus : extraire selon le sens du champ plutôt que selon des modèles de caractères, traiter au niveau de précision qu'exige la qualité du dessin, et examiner le caractère ambigu à son emplacement d'origine avant qu'un devis ne parte. ImageToTable.ai est conçu autour du premier point. Avec Extraction de colonnes personnalisées, vous saisissez les noms de colonnes souhaités, comme Numéro de pièce, Révision, Matériau, Poids et Quantité. L'IA localise chaque valeur n'importe où sur la feuille en comprenant ce que signifie le champ, et non en faisant correspondre des coordonnées de pixels ou un modèle dessiné. Comme elle lit l'image de la page rendue, un PDF aplati ou pixellisé ne présente aucun obstacle ; les objets texte ont disparu, et les pixels sont ce qu'ils sont.
C'est la différence structurelle avec l'OCR basé sur modèle, qui exige de dessiner une zone sur chaque champ et de la redessiner à chaque fois qu'un fournisseur modifie le format de son dessin. Nommer les colonnes une seule fois signifie que la même structure de feuille fonctionne sur un dossier de packs de dessins provenant de différents clients, et que tout le lot aboutit dans un seul tableur.
Nommez les colonnes dont un devis a réellement besoin
Numéro de pièce, Révision, Matériau, Poids, Dimensions critiques, État de surface. L'IA lit chaque champ à partir de son emplacement dans le cartouche, la ligne de cote ou les notes, et exporte un tableur avec exactement ces en-têtes. Vous définissez la sortie, le dessin ne la définit pas.
Adaptez le niveau de traitement à la qualité du dessin
Le niveau standard couvre la plupart des dessins imprimés. Pour les scans peu contrastés, les copies à faible contraste ou les packs multi-feuilles denses, les niveaux de précision supérieurs utilisent un modèle de vision plus puissant, afin qu'un seul flux de travail puisse absorber l'écart de qualité dans les packs de dessins que vous recevez.
Ouvrez le Mode de relecture et confirmez les caractères sur lesquels vous ne pouvez pas vous permettre de vous tromper
Activez l'auto-annotation après le traitement, et chaque cellule extraite porte sa région source. Cliquez sur le Numéro de pièce G1234 et le dessin est surligné exactement à l'endroit où cette chaîne a été lue. Inversez l'opération en cliquant sur un emplacement du dessin pour accéder à la cellule correspondante, et modifiez toute valeur tout en gardant la lecture d'origine de l'IA à un clic. C'est ainsi que vous tranchez une question 6-contre-G : en regardant le glyphe dans sa ligne de cote, et non en vous fiant à la chaîne numérique.
L'extraction sort les données du dessin. Le mode de revue empêche le caractère auquel vous ne faites pas confiance de se retrouver dans le devis. Les deux étapes forment un seul flux de travail : traitez le lot, puis confirmez l'ambiguïté par rapport à l'image d'origine avant l'export.
Un dessin qui doit être lu, qu'il soit aplati, scanné ou en PDF natif, suit le même chemin sémantique, et les mécanismes de transformation des champs extraits en feuille exploitable sont couverts dans les guides sur le logiciel d'extraction de données PDF et la conversion OCR PDF vers Excel.
Ce que ce flux ne peut pas faire pour vous
Aucune étape d'extraction ne transforme un dessin illisible en dessin lisible. Un texte trop pâle pour être vu, des pixels sous la résolution de numérisation et des annotations manuscrites restent ce qu'ils sont, et nécessitent toujours le dessin source ou un humain informé.
Si une chaîne de photocopies a dégradé le dessin jusqu'à des caractères brisés, aucun modèle ne récupère ce que les pixels ne contiennent plus. Demandez au fournisseur une ré-exportation ou une numérisation propre avant le traitement, de la même manière que la réponse sur r/pdf conseillait de revenir à la source du fichier plutôt que d'essayer d'inverser l'aplatissement. Les marques de révision manuscrites et les symboles non standard relèvent de la même catégorie : signalez-les à l'estimateur plutôt que de vous fier à la lecture.
La limite honnête est que ce flux automatise le pipeline et garde les décisions humaines. Rien n'envoie un devis sans qu'une personne approuve les valeurs, et la couche de revue existe précisément parce que le modèle n'est pas garanti parfait sur un cartouche scanné. Ce qui change, c'est que la vérification de l'ambiguïté prend un clic sur une région surlignée au lieu d'une heure à plisser les yeux en comparant un tableau à un dessin.
OCR de dessins techniques et PDF aplatis : FAQ
Un PDF aplati peut-il être déplissé ?
Non. L'aplatissement est une opération à sens unique dans la spécification PDF. Les données objet qui portaient le texte sont physiquement supprimées lorsque son apparence est dessinée dans le contenu de la page, il ne reste donc rien à restaurer. La voie pratique consiste à lire l'image rendue, ce que fait un modèle de vision, plutôt que de récupérer la couche texte.
Pourquoi un OCR de dessin lit-il un 6 comme un G ?
Parce que les numéros de pièce ne donnent aucun contexte au modèle de reconnaissance. Dans la prose, les mots voisins distinguent un 6 d'un G, un 0 d'un O ou un 1 d'un I. Un court numéro de pièce alphanumérique n'a pas de voisins, donc chaque caractère est classé uniquement sur la forme, et dans les petits glyphes à faible contraste courants sur les dessins, ces formes se chevauchent réellement.
Les dessins scannés ou aplatis fonctionnent-ils avec l'extraction IA ?
Oui. L'extraction qui lit l'image de page rendue ne dépend pas de la présence d'une couche texte, donc les dessins scannés et aplatis sont traités de la même manière que les PDF natifs. La précision suit la qualité des pixels, c'est pourquoi le niveau de traitement et l'étape de vérification comptent plus sur un scan délavé que sur un export numérique propre.
Y a-t-il une différence entre l'extraction d'un PDF natif et d'un PDF aplati ?
Pour un extracteur basé sur la vision, la différence visible est minime, car il lit la page rendue dans les deux cas. Un PDF natif peut également contenir du texte sélectionnable que des outils plus simples peuvent saisir, mais cette couche texte n'a aucune signification de mise en page : elle ne vous dit pas quelle chaîne est le numéro de pièce et laquelle est la note. Décider de la signification de chaque valeur est la même tâche dans les deux cas.
Comment savoir si un numéro de pièce a été lu correctement ?
Ouvrez l'écran de vérification et cliquez sur la cellule. Le dessin est mis en surbrillance exactement à la région d'où provient la valeur, et vous comparez le glyphe sur la page avec la chaîne dans le tableau. Activer l'auto-annotation après le traitement signifie que chaque extraction arrive avec sa région source attachée, donc la vérification est un balayage des caractères ambigus plutôt qu'une relecture complète.
Chaque erreur de devis dans cet article, le mauvais numéro de pièce, le mauvais matériau, la mauvaise dimension, commence de la même manière : un caractère lu sur un dessin et fié sans vérification. Nommer les colonnes, lire la page comme une image et vérifier la région source de chaque cellule dont vous ne pouvez pas vous permettre de vous tromper est un processus qui fonctionne sur des packs de dessins réalistes aujourd'hui, sans entraîner de modèle ni dessiner de modèle. Un PDF aplati ne peut pas être déplissé, mais les erreurs de lecture qu'il impose peuvent être détectées avant qu'elles ne deviennent le devis de quelqu'un.