El OCR de dibujos de ingeniería lee 6 como G,
y la cotización sale mal
Un seis leído como una G no es un fallo dramático. En un dibujo de ingeniería aplanado convierte un número de pieza en otro número de pieza distinto, y ese número distinto es el que el sistema de cotización cotiza, pide material y planifica el mecanizado. El ingeniero que lo planteó en r/pdf lo dijo sin rodeos: "la mayoría de los paquetes de dibujos FC en PDF que recibimos están aplanados, así que mi programa es básicamente inútil a menos que introduzca algún tipo de OCR que no es del todo fiable, en cuanto a sustituir un 6 por una G, etc."
Conclusiones clave
- Una tasa de error de caracteres del 8% parece soportable hasta que se encuentra con un número de pieza de diez o doce caracteres, donde un glifo equivocado cambia todo el identificador.
- Un número de pieza no le da al OCR ningún contexto para detectar el error, así que un dibujo que muestra 6 y una lectura que devuelve G se convierten en dos piezas distintas con la misma confianza.
- Resolver una duda entre 6 y G requiere una sola mirada al glifo en su línea de cota, no una relectura de la cadena de números en la tabla.
Lo que un flujo de trabajo de cotización realmente lee de un dibujo
Una solicitud de cotización llega como un paquete de dibujos: un conjunto PDF de varias páginas de la pieza, una lista de materiales, cláusulas de calidad y, a menudo, un historial de revisiones. Antes de que un estimador pueda cotizar algo, alguien lee el cajetín. Según ASME Y14.1, el estándar de hojas de dibujo utilizado en la manufactura estadounidense, el cajetín se encuentra en la esquina inferior derecha y contiene el número de dibujo, título, revisión, material, peso, número de hojas y datos de aprobación. Luego vienen las líneas de dimensión y los marcos de tolerancia, especificados bajo ASME Y14.5, seguidos del bloque de notas con referencias de especificación como tratamiento térmico o conversión química, y la tabla de BOM.
Esa lectura se convierte en la cotización. Cada línea del presupuesto, ya sea en Epicor Kinetic, JobBOSS², SAP Business One o una plataforma de cotización dedicada como Paperless Parts, se remonta a un valor que el estimador extrajo del dibujo: grado de material, peso, dimensiones críticas, acabado superficial, cantidad. El estudio de costos de cotización de Mavlon en talleres de fabricación midió una mediana de 2.5 a 3.5 horas por cotización, con la extracción del dibujo sola tomando de 20 a 40 minutos en dibujos simples de una sola pieza y de 60 a 150 minutos en paquetes complejos de varias hojas, antes de que siquiera comience el juicio de precios. A $55 por hora totalmente cargados, una cotización representa alrededor de $165 de mano de obra directa.
Las fases 1 a 3 de la cotización, recepción, extracción del dibujo e investigación histórica, consumen aproximadamente el 60% de ese tiempo y no contienen experiencia en precios. Esa es la parte que todo taller espera automatizar, y es exactamente donde un solo error de lectura de carácter causa su daño.
Cuando la hoja de cotización del cliente y tu propia estimación viven ambas como documentos, la mecánica de convertirlas en líneas de hoja de cálculo se cubre en la guía para convertir PDF de cotizaciones en líneas de Excel.
Aplanado elimina la parte del archivo que un programa lee
Un PDF creado desde CAD es un contenedor con dos vidas. Una es la página renderizada, los píxeles que se ven. La otra es una capa de objetos de texto seleccionables, campos de formulario, anotaciones y grupos de contenido opcionales que el software puede abordar mediante programación. El aplanado fusiona la capa interactiva en el contenido estático de la página: la apariencia de un widget se dibuja directamente en el flujo de contenido de la página y se eliminan los objetos subyacentes de anotación y campo, un mecanismo definido en la especificación PDF ISO 32000. El resultado se ve idéntico en pantalla, y la capa de texto ya no está allí.
La pregunta del usuario de r/pdf, si un PDF aplanado por un programa externo puede revertirse, obtuvo la respuesta práctica en cinco palabras: "Generalmente no, no con 100% de precisión." El aplanado es una operación unidireccional por diseño, y cuando los proveedores imprimen y rasterizan un dibujo en lugar de solo aplanarlo, toda la página se convierte en una imagen y la capa de texto nunca existió en el archivo entregado. Esto es común en la práctica; los archivos CAD conllevan sensibilidad de licencia y versión, por lo que muchos talleres reciben dibujos reducidos a píxeles a propósito.
Para un programa interno que analizaba objetos de texto, no queda nada que analizar. El OCR es la única puerta de regreso, y está leyendo píxeles que no fueron creados para máquinas. Los modos generales de fallo del OCR en documentos escaneados y de imagen, baja resolución, inclinación, ruido, están detallados en la guía sobre causas raíz y soluciones para la baja precisión del OCR en documentos escaneados.
Por qué un número de pieza no le da al OCR una segunda oportunidad
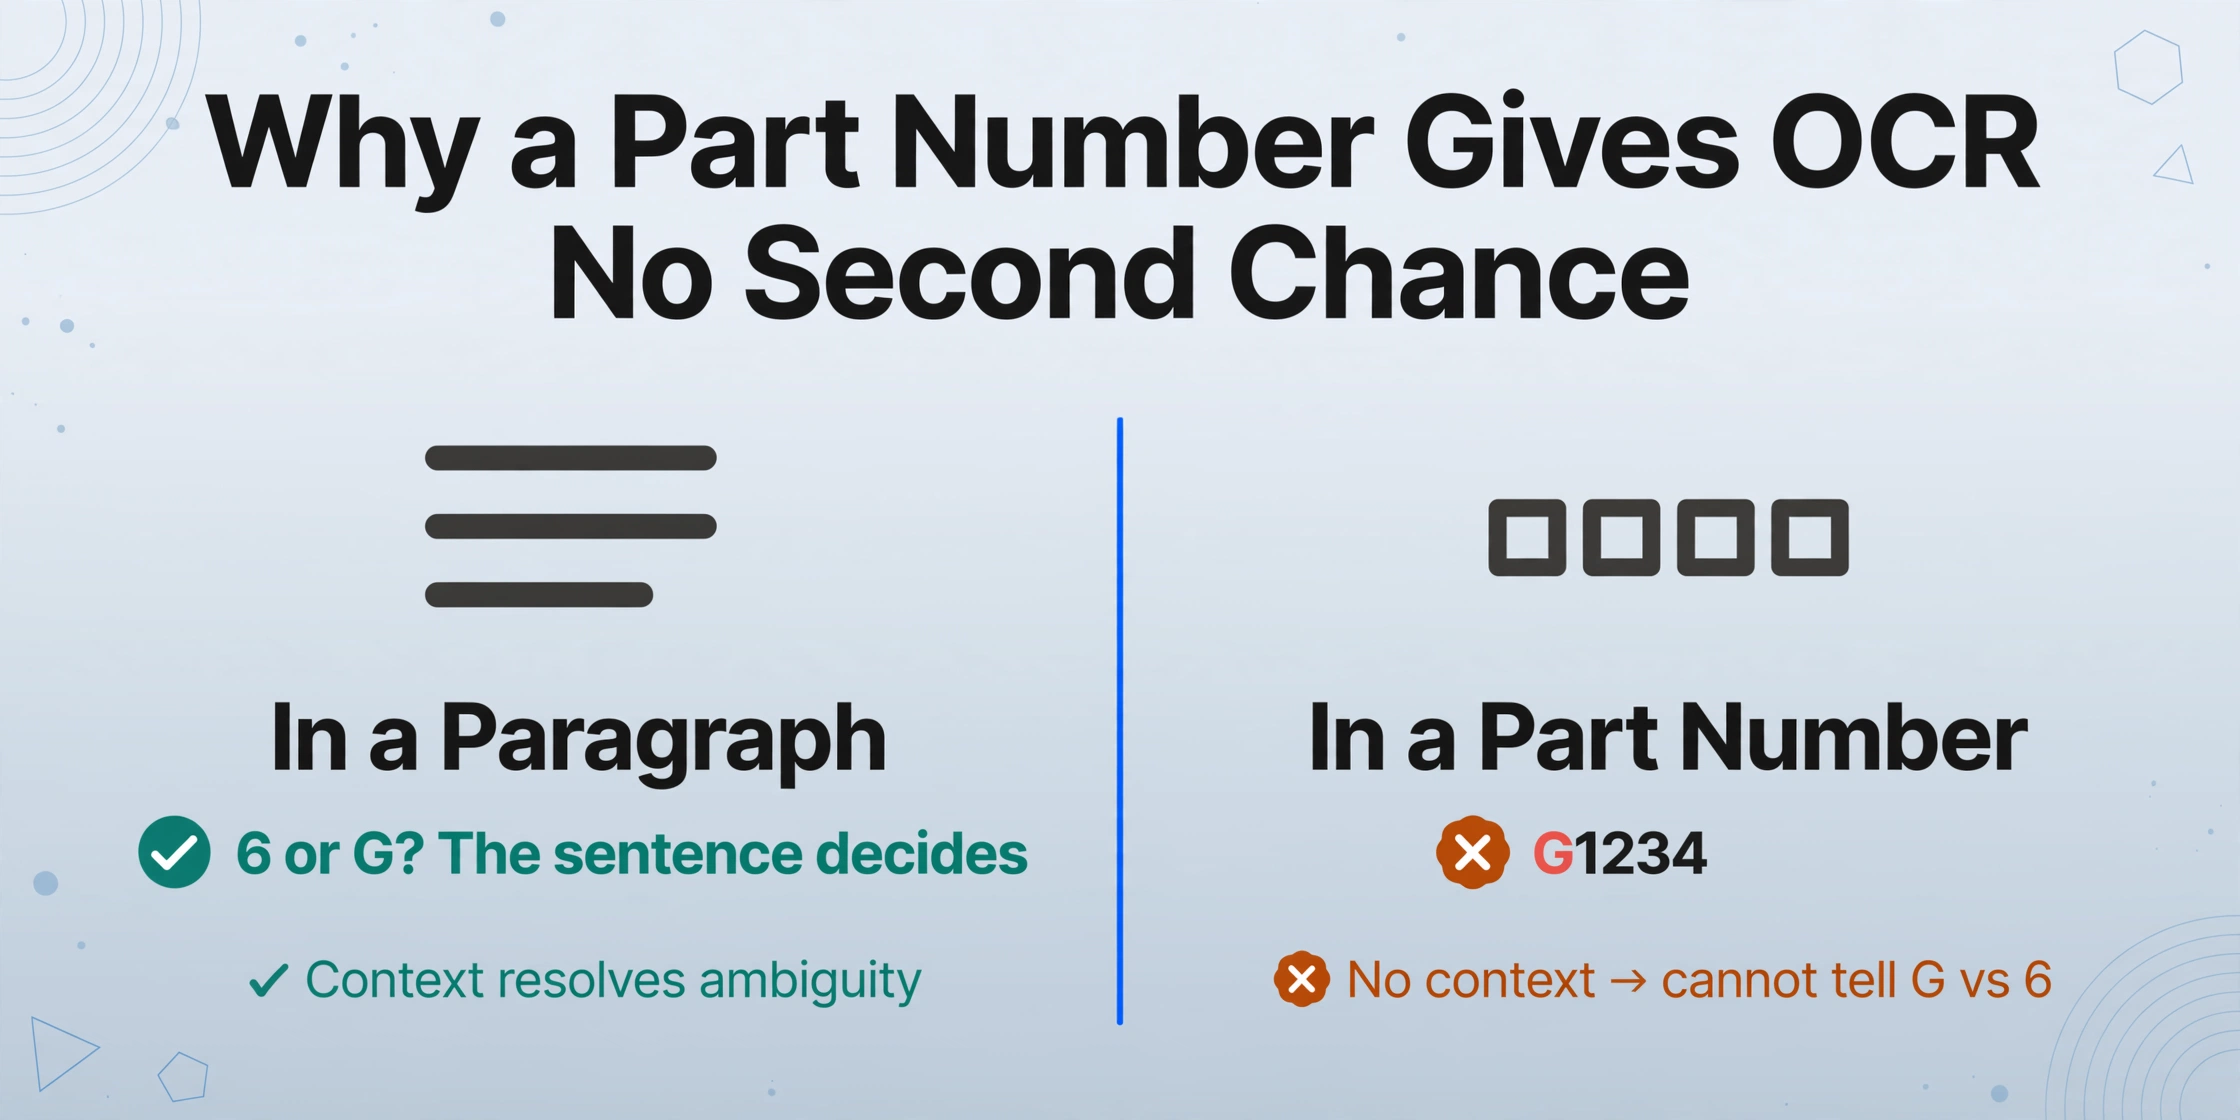
El OCR genérico lee en abierto. En un párrafo, las palabras circundantes son la red de seguridad: cuando un modelo ve un carácter que podría ser un 0 o una O, la oración decide. Los números de pieza, números de dibujo, letras de revisión y grados de material no tienen ese contexto. Un número de catálogo es compacto por diseño, por lo que el modelo no tiene nada en qué apoyarse, y cada carácter debe clasificarse solo por su forma.
Solo la forma falla en los dibujos de ingeniería. Una tesis de 2025 de la Universidad de Helsinki midió motores de OCR contra identificadores alfanuméricos cortos extraídos de dibujos de ingeniería reales y registró los patrones de confusión directamente. Cuando un motor de OCR leyó 6 como G en un cajetín, nada aguas abajo lo detectó, porque la cadena aún parecía un identificador legible: Tesseract leyó 1 como I trece veces, T como E seis veces y 0 como O cinco veces, mientras que un servicio de OCR en la nube leyó una barra como I y un 4 como L. La conclusión del autor se aplica exactamente a los números de pieza: "incluso un error de un solo carácter puede cambiar el significado de una ID, y el posprocesamiento simple basado en diccionarios no es sencillo."
El error no se limita a la OCR de presupuestos. eDOCr, un pipeline de OCR creado específicamente para dibujos mecánicos y documentado en el estudio de Frontiers in Manufacturing Technology, aún registró una tasa de error de caracteres del 8 % en el reconocimiento. Cuando una tasa de error así se encuentra con un número de pieza de diez o doce caracteres, la pregunta no es si la cadena cambia, sino qué carácter cambia. Una 6 y una G de la misma fuente de dibujo son parientes cercanos en tamaños pequeños, y también lo son 1, I y 7, 0 y O, 2 y Z, 8 y B. El par específico que afectó al usuario de r/pdf es una fila en una tabla de confusión mucho más amplia.
| Par de caracteres similares | Dónde falla la OCR | Ejemplo de origen |
|---|---|---|
| 1, I, l, 7 | Números de pieza, valores de dimensiones, letras de revisión | Tesis de Helsinki 2025 (1 como I, 13 casos) |
| 0, O | Números de dibujo, texto de bloques de notas | Tesis de Helsinki 2025 (0 como O, 5 casos) |
| T, E | Referencias de especificaciones, abreviaturas de notas | Tesis de Helsinki 2025 (T como E, 6 casos) |
| /, I y 4, L | Calidades de material, códigos de acabado | Tesis de Helsinki 2025 (OCR en la nube) |
| 6, G | Números de pieza, texto de dimensiones | Hilo de paquete de dibujos de r/pdf |
La precisión varía según el tipo de documento por razones estructurales, y la descripción general de por qué la precisión de la OCR disminuye en diferentes tipos de documentos cubre esos mecanismos a nivel de página. El caso específico de los dibujos es lo peor de ambos mundos: calidad de entrada degradada y ausencia de cualquier modelo de lenguaje que lo corrija.
Lo que cuesta un error de lectura de carácter antes de que la pieza siquiera se fabrique
Un número de pieza equivocado no se queda en el dibujo. Se convierte en la línea de precio de la cotización, en la línea de la orden de compra del material y en la orden de producción que le sigue. Si el número cotizado difiere de lo que realmente especifica el dibujo, el taller puede perder el trabajo al cotizar una pieza distinta de la que pidió el cliente, o ganar el trabajo y descubrir la discrepancia solo cuando la pieza mecanizada no cumple con las dimensiones reales del dibujo.
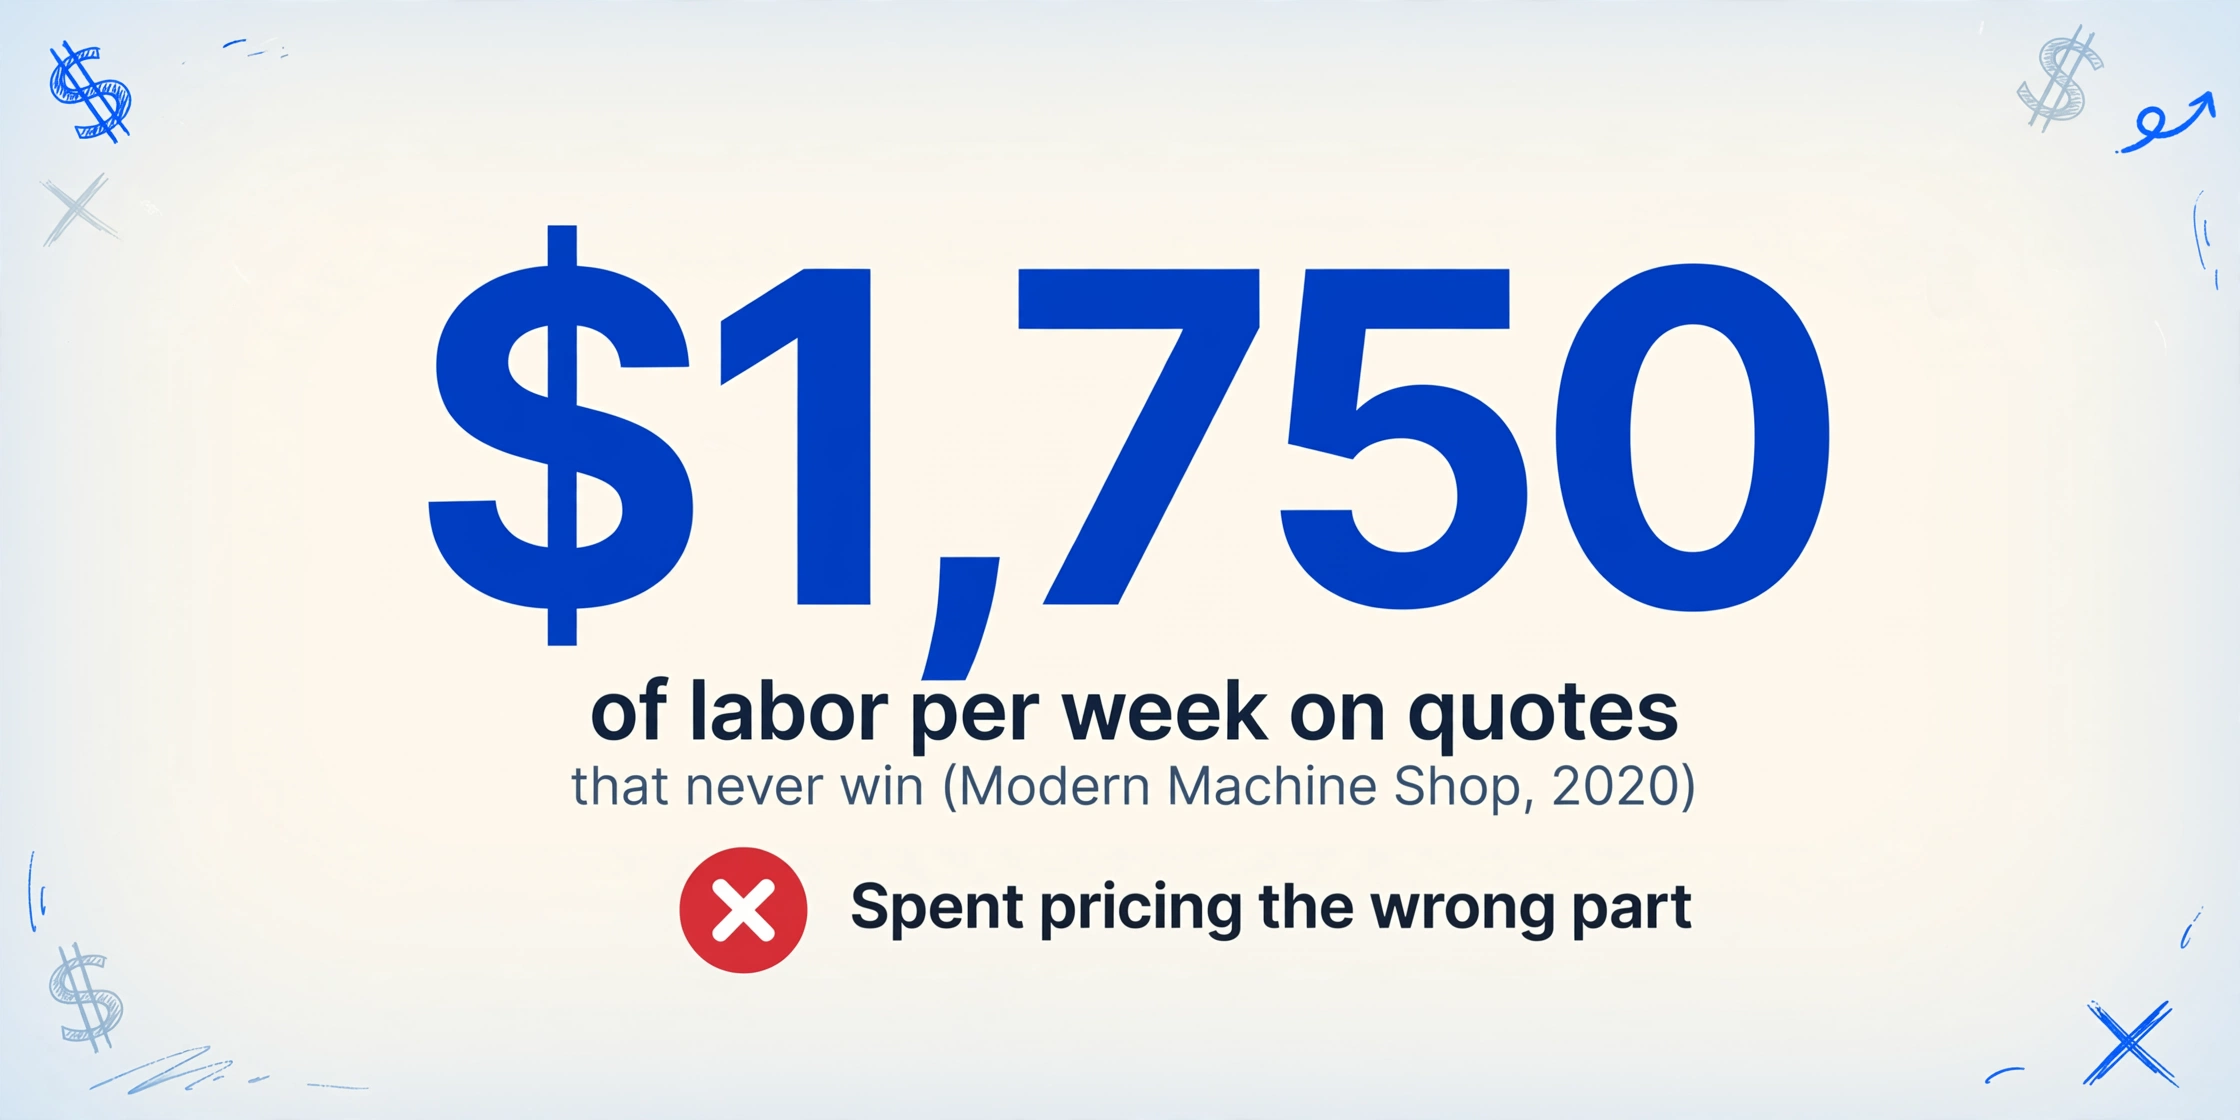
El costo de cotizar es donde se concentra el desperdicio. Un análisis de Modern Machine Shop de 2020 encontró que el taller promedio gasta hasta $1,750 de mano de obra por semana en cotizaciones que nunca gana, y la mayoría de los talleres solo gana cerca de un tercio de los trabajos que cotiza. Cuando se cuela un error de lectura, cada hora invertida se dedica a cotizar la pieza equivocada.
Detrás de la cotización está el costo de producción del error. Los datos de referencia de Fabricators and Manufacturers Association, recopilados por Reliable Plant, sitúan el desecho y el retrabajo en aproximadamente 1.4% de las ventas para el fabricante de metal estadounidense promedio y por debajo del 1% para el cuartil superior, mientras que American Society for Quality estima los costos totales relacionados con la calidad en 15% a 20% de las ventas para muchos fabricantes. La regla de escalamiento que importa para las dimensiones es simple y se cita a menudo en la industria: una dimensión equivocada detectada en la máquina cuesta unos minutos, detectada en la inspección final cuesta la pieza, y detectada por el cliente cuesta la pieza, el flete, la clasificación de contención, el informe de acción correctiva y la visita.
La manufactura funciona con documentos que nunca fueron creados para entrada en ERP, y el conducto que convierte órdenes de compra, cotizaciones, recibos y facturas en filas estructuradas se cubre en la guía de software de extracción de documentos para manufactura. El dibujo es donde comienza ese conducto, y un error de carácter allí fluye hacia cada fila que le sigue.
Lea el dibujo por su significado y luego verifique el glifo que no puede confiar
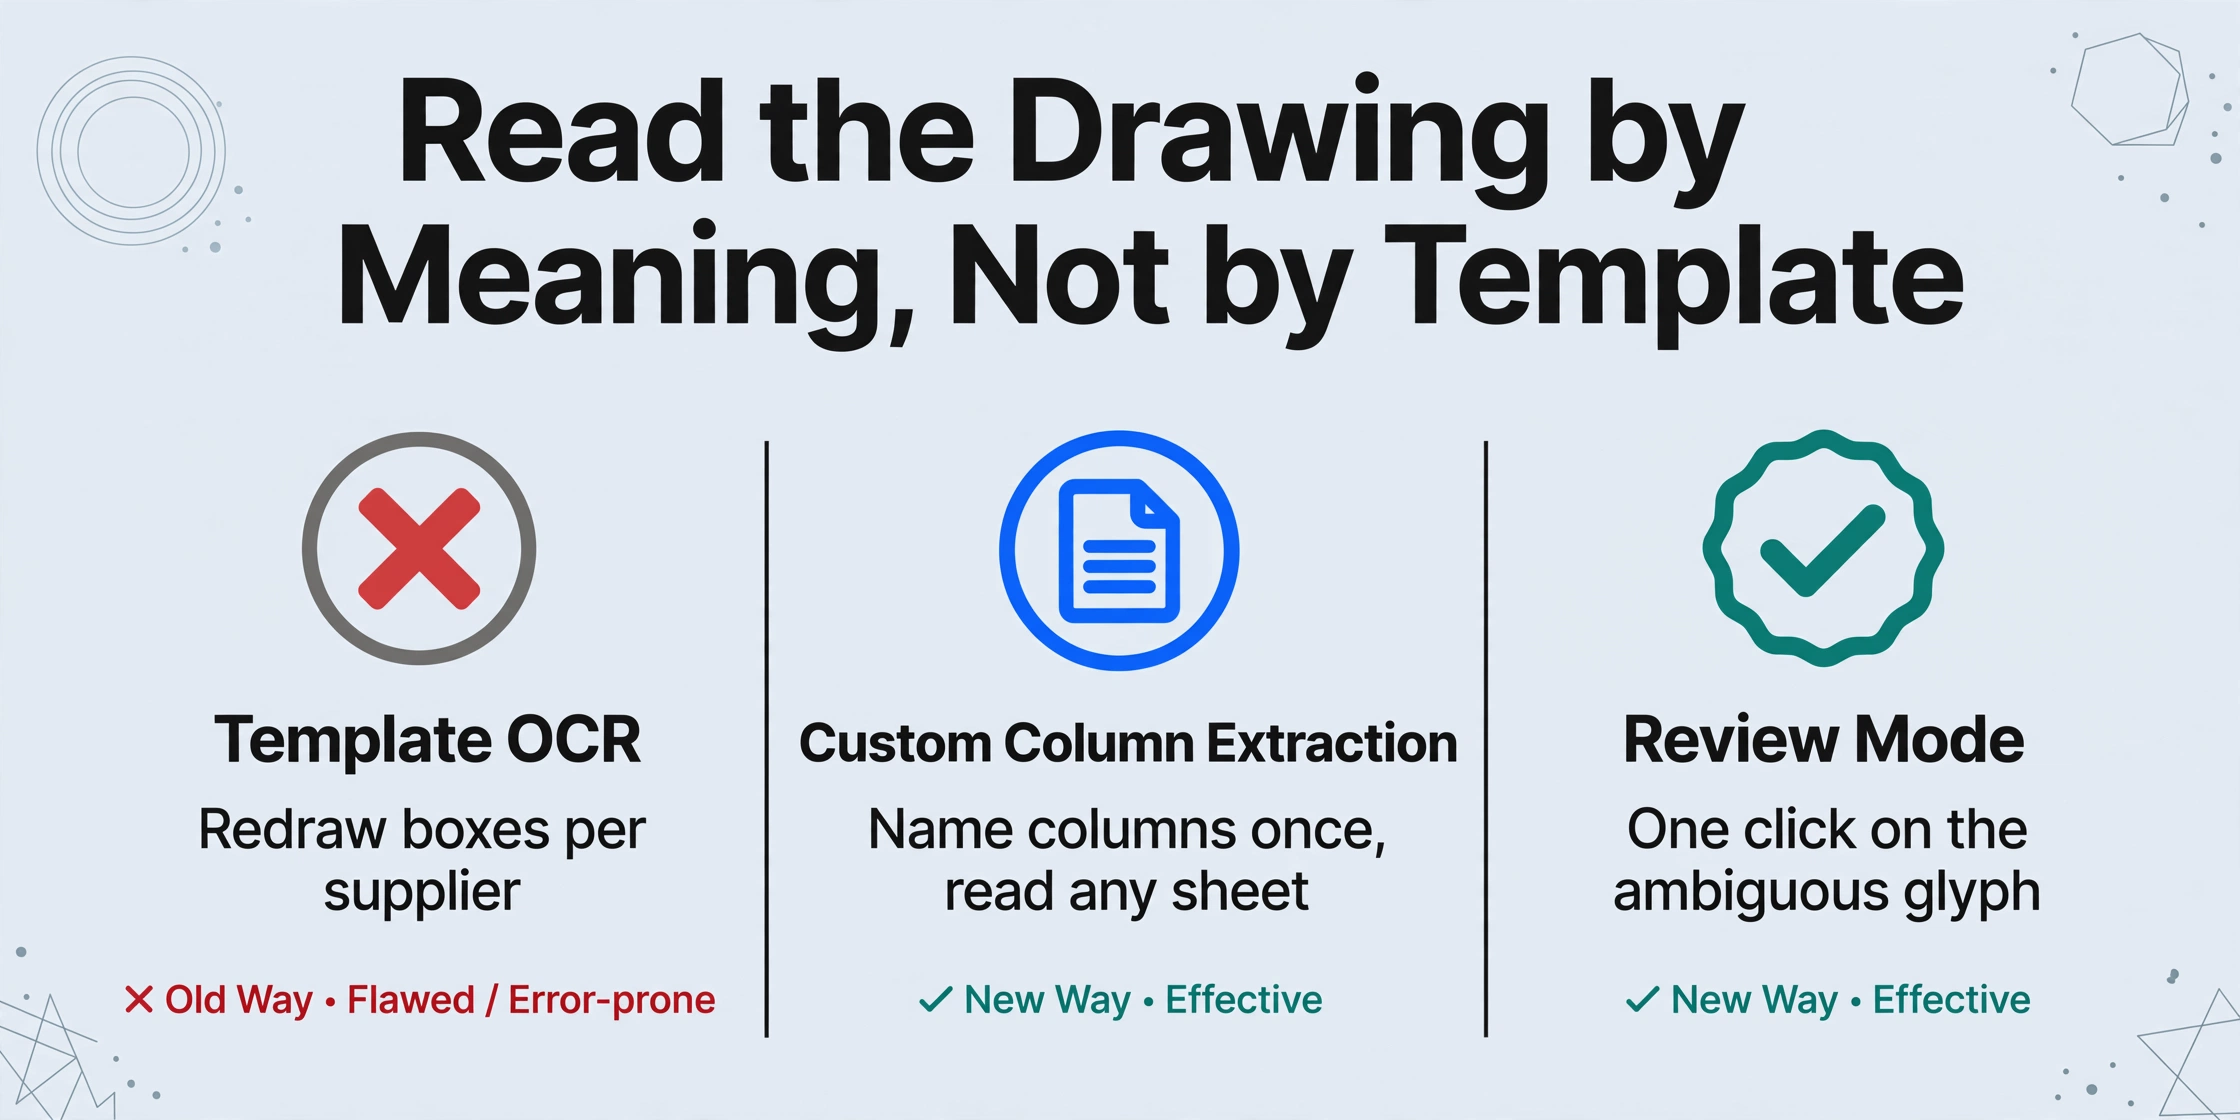
La solución no es un mejor motor de OCR configurado una vez y en el que se confíe para siempre. Es un cambio de proceso: extraer por el significado del campo en lugar de por plantillas de caracteres, procesar en el nivel de precisión que exige la calidad del dibujo y mirar el carácter ambiguo en su ubicación original antes de que salga una cotización. ImageToTable.ai está construido en torno a lo primero. Con Extracción de Columnas Personalizadas, usted escribe los nombres de las columnas que desea, como Número de pieza, Revisión, Material, Peso y Cantidad. La IA localiza cada valor en cualquier lugar de la hoja al comprender qué significa el campo, no al comparar coordenadas de píxeles ni una plantilla dibujada. Como lee la imagen de la página renderizada, un PDF aplanado o rasterizado no presenta ninguna barrera; los objetos de texto han desaparecido y los píxeles son lo que son.
Esta es la diferencia estructural con respecto al OCR basado en plantillas, que requiere dibujar un recuadro sobre cada campo y volver a dibujarlo cada vez que un proveedor cambia el formato de su dibujo. Nombrar las columnas una sola vez significa que la misma estructura de hoja funciona en una carpeta de paquetes de dibujos de diferentes clientes, y todo el lote llega a una sola hoja de cálculo.
Nombre las columnas que una cotización realmente necesita
Número de pieza, Revisión, Material, Peso, Dimensiones críticas, Acabado superficial. La IA lee cada campo desde donde se encuentra en el cajetín, la línea de cota o las notas, y exporta una hoja de cálculo con exactamente esos encabezados. Usted define la salida; el dibujo no la define.
Ajuste el nivel de procesamiento a la calidad del dibujo
El nivel estándar cubre la mayoría de los dibujos impresos. Para escaneos tenues, copias de bajo contraste o paquetes densos de varias páginas, los niveles de mayor precisión usan un modelo de visión más potente, de modo que un solo flujo de trabajo puede absorber la brecha de calidad en los paquetes de dibujos que usted recibe.
Abra el modo de revisión y confirme los caracteres en los que no puede permitirse equivocarse
Active el autoanotado después del procesamiento y cada celda extraída lleva su región de origen. Haga clic en Número de pieza G1234 y el dibujo se resaltará exactamente donde se leyó esa cadena. Inviértalo haciendo clic en una ubicación del dibujo para saltar a la celda correspondiente, y edite cualquier valor manteniendo la lectura original de la IA a un clic de distancia. Así es como se resuelve una duda entre 6 y G: mirando el glifo en su línea de cota, no confiando en la cadena numérica.
La extracción obtiene los datos del dibujo. El Modo de Revisión evita que el carácter que no le inspira confianza llegue a la cotización. Los dos pasos son un único flujo de trabajo: procese el lote y luego confirme la ambigüedad contra la imagen original antes de exportar.
Un dibujo que necesita ser leído, ya sea aplanado, escaneado o PDF nativo, pasa por la misma ruta semántica, y la mecánica de convertir los campos extraídos en una hoja utilizable se cubre en las guías de software de extracción de datos PDF y conversión de OCR PDF a Excel.
Lo que Este Flujo No Puede Hacer por Usted
Ningún paso de extracción convierte un dibujo ilegible en uno legible. El texto demasiado tenue para verse, los píxeles por debajo de la resolución de escaneo y las anotaciones manuscritas siguen siendo lo que son, y aún necesitan el dibujo fuente o un humano informado.
Si una cadena de fotocopias ha degradado el dibujo hasta caracteres rotos, ningún modelo recupera lo que los píxeles ya no contienen. Pida al proveedor una reexportación o un escaneo limpio antes de procesar, de la misma manera que la respuesta de r/pdf aconsejaba volver a la fuente del archivo en lugar de intentar revertir el aplanado. Las marcas de revisión manuscritas y los símbolos no estándar son de la misma categoría: márquelos para el estimador en lugar de confiar en la lectura.
El límite honesto es que este flujo de trabajo automatiza el proceso y mantiene las decisiones en manos humanas. Nada envía una cotización sin que una persona apruebe los valores, y la capa de revisión existe precisamente porque no se garantiza que el modelo sea perfecto en un cajetín escaneado. Lo que cambia es que verificar la ambigüedad toma un clic en una región resaltada en lugar de una hora entrecerrando los ojos comparando una tabla contra un dibujo.
OCR de Dibujos de Ingeniería y PDFs Aplanados: Preguntas Frecuentes
¿Se puede desaplanar un PDF aplanado?
No. El aplanado es una operación unidireccional en la especificación de PDF. Los datos de objeto que contenían el texto se eliminan físicamente cuando su apariencia se dibuja en el contenido de la página, por lo que no queda nada que restaurar. El camino práctico es leer la imagen renderizada, que es lo que hace un modelo de visión, en lugar de recuperar la capa de texto.
¿Por qué un OCR de dibujos lee un 6 como una G?
Porque los números de pieza no le dan contexto al modelo de reconocimiento. En prosa, las palabras vecinas distinguen una 6 de una G, una 0 de una O, o una 1 de una I. Un número de pieza alfanumérico corto no tiene vecinos, por lo que cada carácter se clasifica solo por su forma, y en los glifos pequeños y de bajo contraste comunes en los dibujos, esas formas realmente se superponen.
¿Los dibujos escaneados o aplanados funcionan con la extracción con IA?
Sí. La extracción que lee la imagen de la página renderizada no depende de que exista una capa de texto, por lo que los dibujos escaneados y aplanados se procesan igual que los PDF nativos. La precisión sigue la calidad de los píxeles, por lo que el nivel de procesamiento y el paso de revisión importan más en un escaneo desvaído que en una exportación digital limpia.
¿Hay alguna diferencia entre extraer de un PDF nativo y uno aplanado?
Para un extractor basado en visión, la diferencia visible es pequeña, porque lee la página renderizada en ambos casos. Un PDF nativo también puede tener texto seleccionable que herramientas más simples pueden capturar, pero esa capa de texto no tiene significado de diseño: no te dice qué cadena es el número de pieza y cuál es la nota. Decidir qué significa cada valor es el mismo trabajo en ambos casos.
¿Cómo sé que un número de pieza se leyó correctamente?
Abre la pantalla de revisión y haz clic en la celda. El dibujo se resalta en la región exacta de donde proviene el valor, y comparas el glifo en la página con la cadena en la tabla. Activar Auto-annotate después del procesamiento significa que cada extracción llega con su región de origen adjunta, por lo que la verificación es un repaso de los caracteres ambiguos en lugar de una relectura completa.
Cada error de cotización en este artículo, el número de pieza equivocado, el material equivocado, la dimensión equivocada, comienza de la misma manera: un carácter leído de un dibujo y confiado sin verificación. Nombrar las columnas, leer la página como imagen y verificar la región de origen de cada celda sobre la que no puedes permitirte equivocarte es un proceso que funciona con paquetes de dibujos realistas hoy en día, sin entrenar un modelo ni dibujar una plantilla. Un PDF aplanado no se puede desaplanar, pero los errores de lectura que provoca pueden detectarse antes de que se conviertan en la cotización de alguien.