タイムシート
データ抽出の完全ガイド(2026年版)
米国労働省が、WH-347認証給与フォームの記入には従業員わずか8人分で55分かかると試算し、米国給与協会(APA)が手作業によるタイムシートのエラー率を総給与の1〜8%としている現状を踏まえると、紙のタイムカードと給与計算の間にあるギャップは、もはや単なる不便さではありません。それは、人件費予算、工事原価の正確性、コンプライアンス体制に数値化できる形で影響を及ぼす損失です。タイムシートデータ抽出は、そのギャップを埋めるテクノロジーです。印刷物や手書きなど、あらゆる形式のタイムシートから従業員名、労働時間、プロジェクトコード、残業時間を読み取り、給与システムが直接取り込める構造化データを出力します。手作業による転記は一切不要です。
重要ポイント
- 60項目の建設現場タイムシートには、残業計算を始める前の段階で、週ごとに1枚あたり45〜83%の確率で少なくとも1件の入力ミスが含まれます。
- APAは、手作業によるタイムシートのエラーが総給与の1〜8%を失わせると試算していますが、より深刻な損害は目に見えません。入力ミスした労働時間はすべて、次の入札に使われる工事原価データを歪めてしまうのです。
- 必要なのは、より速いデータ入力担当者ではありません。バッチごとに240回のキー入力を、AIが確信を持てない5〜15%のフィールドだけをチェックするレビュー工程に置き換えることです。これにより、給与チームはデータ作成者からデータ検証者へと役割を変えることができます。
タイムシートデータ抽出とは(そうでないものとの違い)
タイムシートデータ抽出とは、紙またはデジタルのタイムシートから構造化されたフィールド(従業員名、勤務日、日次労働時間(通常・残業)、プロジェクトコード、コストコード、承認情報)を自動的に読み取り、給与システムがインポートできる整理されたテーブルに変換するプロセスです。これは時間追跡アプリではありません。
この区別は最も一般的な混乱の原因であり、これを正しく理解するかどうかで、実際の問題を解決できるか、机の上の紙の山に手を付けない無関係な製品を購入するかが決まります。QuickBooks Time、ADP Workforce Now、Procore Timecard、Raken、および類似のツールは時間追跡アプリです。従業員はデジタルで出退勤を記録し、労働時間は直接給与に流れ込みます。これらは紙のタイムシートが発生源で作成されるのを防ぎます。タイムシート抽出は逆の問題を解決します。紙のタイムシートがすでに存在する場合(現場監督が記入し、人材派遣会社がファックスし、現場作業員が撮影したもの)で、その労働時間を誰も再入力することなく、そのカードから給与システムに移す必要があります。
この技術の仕組みと、それが適切な解決策となる場合の詳細については、タイムシートデータ抽出とは何かのガイドをご覧ください。この記事の残りの部分では、抽出が答えであるとすでに判断したことを前提とし、それをうまく行う方法に焦点を当てます。フィールド選択やバッチ処理から、認証給与のコンプライアンスや給与システム統合まで、すべてを網羅します。
タイムシートデータ抽出が重要な理由
手動タイムシート処理のコストは、入力を行う人の給与ではありません。問題は、その入力が間違ったときに何が起こるかです。そして、それがどれほど頻繁に間違うかに関するデータは、ほとんどの給与管理者が想定しているよりも深刻です。
米国給与協会(APA)は、手動タイムシートのエラーが総給与の1〜8%を占めると推定しています。年間200万ドルの人件費予算の場合、それは毎年2万ドルから16万ドルの回収可能なコストです。建設財務管理協会(CFMA)の2024 Financial Benchmarkerによると、米国のゼネコンでは、コスト管理だけでプロジェクト収益の平均5.4%を消費しています。主な要因はソフトウェアライセンスやコンサルティング費用ではなく、最初から一致しているべきデータの照合作業です。誰かが4を9と読み間違えたために、タイムカードの時間と給与の時間が一致しないのです。
手動タイムシート入力の各キーストロークには1〜3%のエラー率があります。5人の作業員×各12データポイントの60フィールドを持つ単一の週次建設クルーシートでは、そのバッチに少なくとも1つのエラーが発生する確率は45%から83%です。シートごと、週ごとに。これを20の下請け業者のタイムシートと1年間の給与サイクルに掛け合わせると、問題は給与データにエラーが存在するかどうかではなく、どれだけが検出されずに残っているかです。
コンプライアンスの側面は、これらのコストをさらに増幅します。デービス・ベーコン法の対象となる連邦政府資金による建設プロジェクトでは、認証給与報告書における単一の職種の誤分類または時間の入力ミスが、違反1件につき最大13,508ドルの罰金につながる可能性があります。労働省自身の見積もりでは、フォームWH-347をわずか8人の従業員分完了するのに55分かかるとされており、40人のプロジェクトでは、そのフォームだけで毎週4.5時間以上の給与管理時間を消費することになります。フォームに入力するデータ入力を考慮する前の話です。
構造上の問題:手動のタイムシート入力は、量が増えるにつれてエラー率が複合的に悪化し、コンプライアンスとコストへの影響は時間とともに増大します。抽出処理はレビューの必要性をなくすわけではありませんが、給与チームの役割をデータ入力担当からデータレビュー担当へと変え、これは根本的に異なるリスクプロファイルです。
タイムシートデータ特有の課題
タイムシートは請求書ではありません。領収書でもありません。それらは、抽出を特に困難にし、そして正確に処理することに特に価値をもたらす、一連の構造上の課題を提示します。
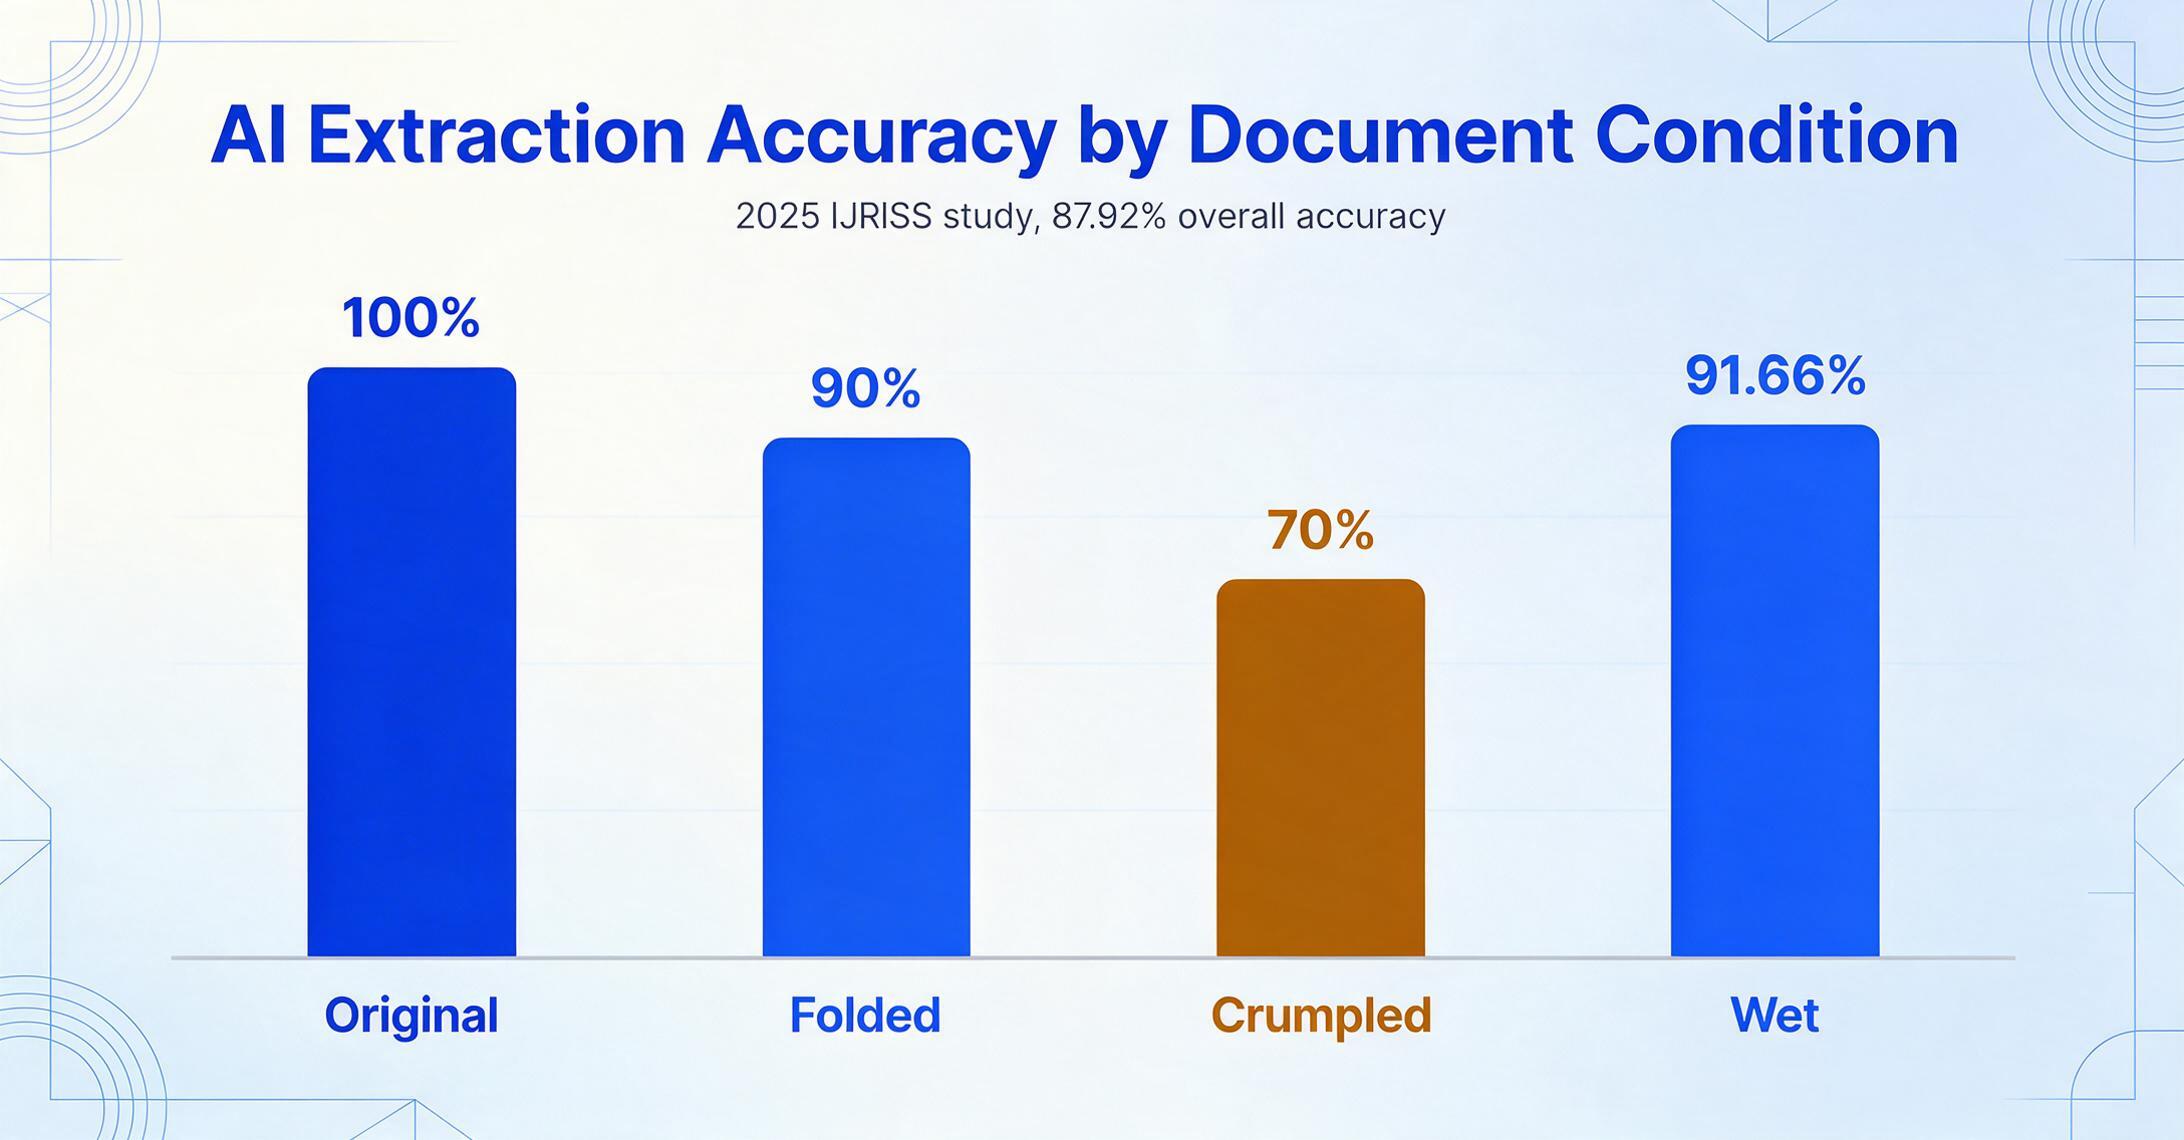
手書きが標準であり、例外ではありません。現場のタイムカード、フィールドサービスログ、派遣会社のタイムシートは、多くの場合、トラックの運転席、テールゲート、または10時間勤務の終わりに手書きで記入されます。2025年のAIを活用したタイムシートOCRに関するIJRISS調査は、4つの文書劣化状態(オリジナル(精度100%)、折れ曲がり(90%)、しわくちゃ(70%)、濡れ(91.66%))にわたるマルチモーダル抽出をテストし、総合精度87.92%を達成しました。これは従来のOCRと比較して12〜47パーセントポイントの改善です。クリーンで印刷されたPDFのみを処理する抽出ツールは、問題の簡単な30〜40%しか解決しません。手書きの残りの部分こそ、手動入力のコストが発生する場所です。
フォーム構造ではなく、テーブル構造。 ほとんどの文書抽出ツールはフォーム用に設計されています。1つのラベル、1つの値です。「請求書番号:INV-12345」はフォームフィールドです。タイムシートはグリッドです。左列に従業員名、上部に月曜日から日曜日、交差するセルに時間の値が入ります。ツールは、3行4列目の「8」がジョン・スミスの水曜日の通常労働時間であることを理解しなければならず、グリッドが5列でも14列でも、ヘッダーが「Wed」でも「Wednesday」でも「W」でも、行ラベルが「John Smith」でも「Smith, J.」でも、この関係が出力で維持される必要があります。テンプレートベースのアプローチはグリッドレイアウトが変わると機能しなくなりますが、セマンティック抽出は、各セルがどこにあるかではなく、何を表すかを理解することで構造を読み取ります。
プロジェクトコードとコストコードが抽出の複雑さを増幅させます。 給与担当者が1枚のタイムシートを読んで「8時間」を見て、1行を入力するかもしれません。しかし、その「8」は、3つのコストコード(03 30 00 — コンクリート、03 24 00 — 鉄筋、03 00 00 — 一般)に、異なる分類と場合によっては異なる賃金率で分割する必要があるかもしれません。デービス・ベーコン法プロジェクトでは、DOLは複数の分類で作業を行う労働者に対し、分類別の正確な時間内訳を示すことを要求しています。抽出出力は、すべてを1行にまとめるのではなく、労働者ごとに複数の行を生成できる必要があります。
残業計算のロジックは管轄区域によって異なります。連邦のデービス・ベーコン法プロジェクトでは、週40時間を超えると1.5倍の残業代が必要です。カリフォルニア州では、1日8時間を超える場合と週40時間を超える場合の両方で1.5倍、1日12時間を超えると2倍の割増賃金が必要です。労働組合協定により、その両方にさらに異なる基準が重なる場合もあります。カードに書かれた内容を読み取るだけで、日次の労働時間合計から残業代を計算できない抽出ツールでは、給与計算で最も難しい部分が元のまま机上に残されてしまいます。
複数プロジェクトへの配分は給与期間の境界を曖昧にします。一人の作業員が1週間に3つの異なるプロジェクトで労働時間を記録する場合があり、各プロジェクトで賃金決定、コストコード、認証給与報告要件が異なります。タイムシートにこれらの区分が明確に記録されているかどうかはともかく、給与計算には正確に反映されなければなりません。誤った賃金決定で支払われた作業員は、タイムシートが曖昧だったかどうかに関わらず、コンプライアンス違反となるからです。
従来の方法とAI抽出
現在、タイムシートから給与計算へのパイプラインでは、主に3つのアプローチが使われています。そのうち、多くの組織が実際に直面する量、多様性、コンプライアンス上の重要性に対応できるよう設計されているのは、1つだけです。
| 手動データ入力 | テンプレート型OCR | AI意味抽出 | |
|---|---|---|---|
| 仕組み | 給与担当者が紙のカードを読み、すべての項目を給与システムに入力する | OCRが所定の位置から文字を読み取り、タイムシート形式ごとに解析テンプレートが必要 | ビジョンAIが文書全体を読み取り、名前・時間・コードを位置ではなく意味で理解する |
| 手書きに対応? | 対応(人間が解読する) | 不十分 — 従来のOCRは筆記体で50%未満に低下 | 対応 — 手書きでフィールド精度85〜95%、劣化条件下で87.92% |
| 形式変更に対応? | 対応(人間が適応する) | 不可 — 新しい形式ごとに新しいテンプレートが必要 | 対応 — フォーマット非依存、初回からどのレイアウトでも読み取り可能 |
| 表グリッドに対応? | 対応(人間がグリッドを読む) | 一部 — 行と列の関係を失うことが多い | 対応 — グリッド構造、行コンテキスト、列ヘッダーを保持 |
| タイムシート1枚あたりの処理時間 | 2〜5分 | 10〜30秒(テンプレート作成後) | 5〜10秒 |
| 導入の手間 | ゼロ(タイムシートごと); 新人担当者ごとのトレーニング時間 | 高 — 形式・ベンダー・レイアウト変更ごとにテンプレートの作成と保守が必要 | ほぼゼロ — 出力列を一度定義するだけで、全形式・全ソースで再利用可能 |
| エラー特性 | 入力フィールドごとに1〜3%; 給与明細の紛争まで見えない | テンプレート品質に依存; レイアウト変更時に静かに失敗 | フィールドレベルで1〜5%; 給与実行前に人間のレビューでエラーを確認可能 |
| 量に応じて拡張可能? | 不可 — タイムシートごとに線形コスト | 不可 — テンプレート保守が形式の多様性に比例 | 可能 — 初期列定義後は限界コストがほぼゼロ |
| 最適な用途 | 週1〜5枚、単一形式 | 単一ソースからの高量・単一形式のデジタルタイムシート | 複数形式・複数ソースの手書き・印刷タイムシート; コンプライアンス重視の環境 |
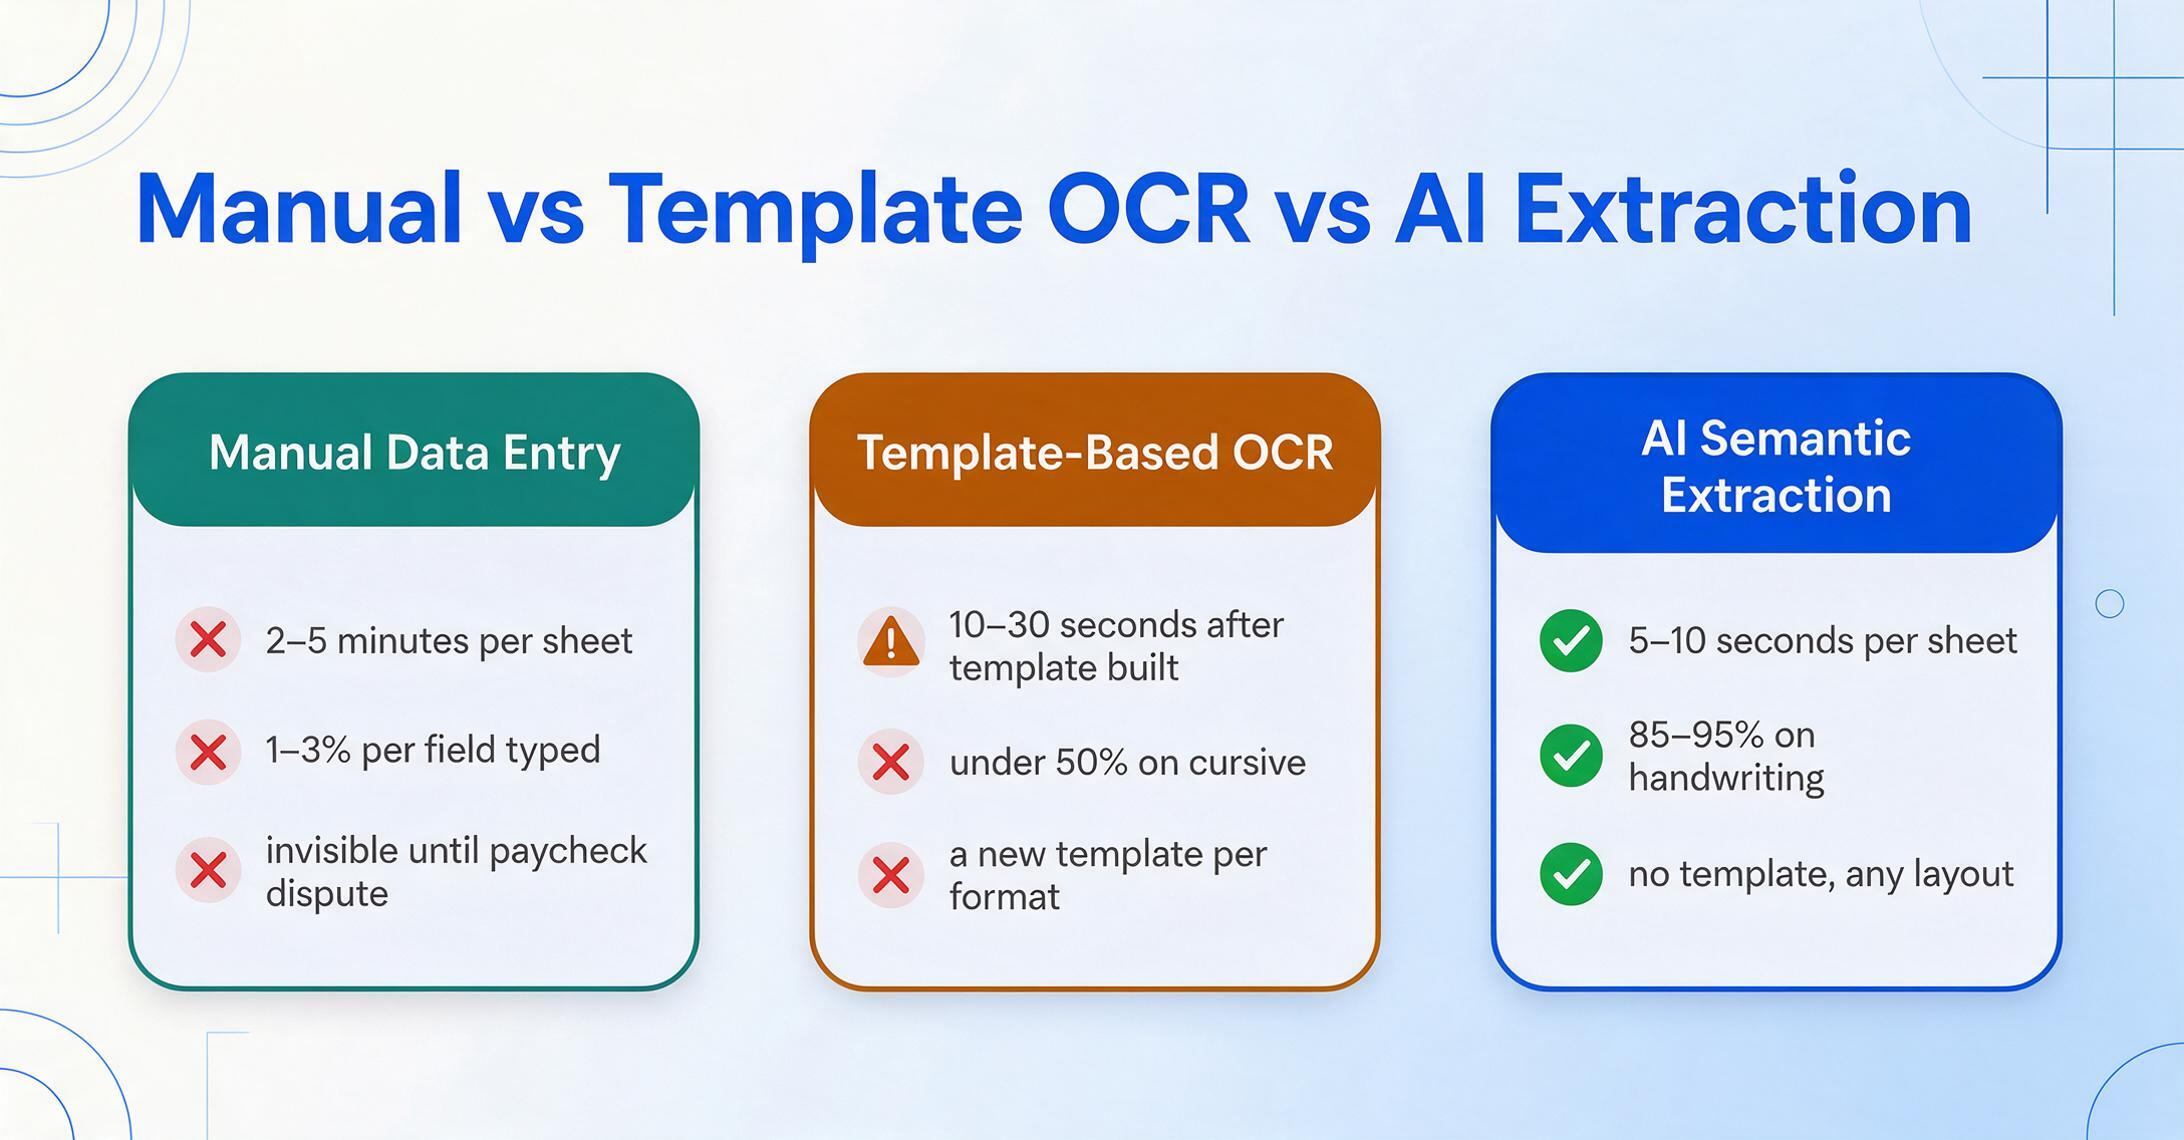
重要なポイント: テンプレートベースのOCRは、ほとんどの組織が抽出を最も必要とするまさにその時点で失敗します。 タイムシートがすべて1つのソースから1つの形式で届くなら、抽出はまったく必要ありません — 標準化されたデジタルプロセスがあるからです。抽出が必要になるのは、まさに形式が多様なときです: 5つの下請け業者が5つの異なるタイムシートレイアウトを送ってくる、独自のPDF形式を持つ人材派遣会社、アプリを使わない作業員からの旧式の紙カード。新しい形式ごとにテンプレートベースのシステムは破綻します。テンプレート不要のシステムは、同じ列定義でそれらすべてを読み取ります — 「従業員名」が何かを理解することで位置を特定し、座標(120, 45)で期待するのではありません。
これは、抽出が作業負荷を減らすのか、単に移動させるだけなのかを決定するアーキテクチャ上の判断です: 位置ベースの抽出 vs セマンティックベースの抽出。最初のカテゴリのツール — ほとんどのレガシーOCRやゾーンシステム — は、各ドキュメントのバリエーションごとに各フィールドがどこにあるかのマップを維持する必要があります。2番目のカテゴリのツール — 最新のビジョンAIプラットフォーム — は、人間と同じようにドキュメントを読み取ります: 座標を照合するのではなく、内容を理解します。3つ以上の異なるソースからタイムシートを処理する場合、テンプレート保守のコストだけで1年以内に手動入力のコストを超える可能性があります。より詳細な比較については、タイムシート抽出の定義ガイドで技術レイヤーを詳しく説明しています。
ファイルは安全に処理され、保存されません。
タイムシートデータ抽出の主要フィールド
抽出するフィールドは、データの送信先によって異なります。単純な給与計算では必要なフィールドは少なく、デービス・ベーコン法に基づく認証給与レポートではより多くのフィールドが必要で、完全なジョブコスト配分スプレッドシートではさらに多くのフィールドが必要です。出力カラムは、タイムシートのレイアウトではなく、ダウンストリームシステムの要件に基づいて定義してください。
従業員と期間
- 従業員名
- 従業員ID / バッジ番号
- 週の終了日 / 給与期間日付
- 監督者名と署名
日次勤務時間グリッド
- 通常勤務時間 — 月曜から日曜
- 時間外勤務時間(1.5倍および2倍)
- 休憩 / 食事時間の控除
- 病気 / 休暇 / 祝日の勤務時間
プロジェクトとコスト配分
- プロジェクトコード / ジョブ番号
- コストコード / フェーズコード
- 職種 / 技能区分
- 作業内容 / タスク
給与とコンプライアンス
- 時給 / 賃金率
- 通常勤務時間の合計
- 時間外勤務時間の合計
- フリンジベネフィット率
- 適正賃金決定番号
選択する抽出ツールは、カラムを一度定義すれば、組織が受け取るすべてのタイムシート形式に適用できるものでなければなりません。このアプローチはカスタムカラム抽出と呼ばれ、各タイムシートが提供する内容ではなく、給与システムやERPシステムが必要とするものに基づいて出力構造を定義することを意味します。出力の作業者名カラムは、ソースカードが左上隅に「John Smith」「Smith, John」「J. Smith」のいずれで記載していても、「John Smith」を取得します。AIは位置的なマッチングではなく、意味的な理解に基づいて各バリアントを同じ出力カラムに解決します。
バッチ処理:量が速度を構造的に変えるとき
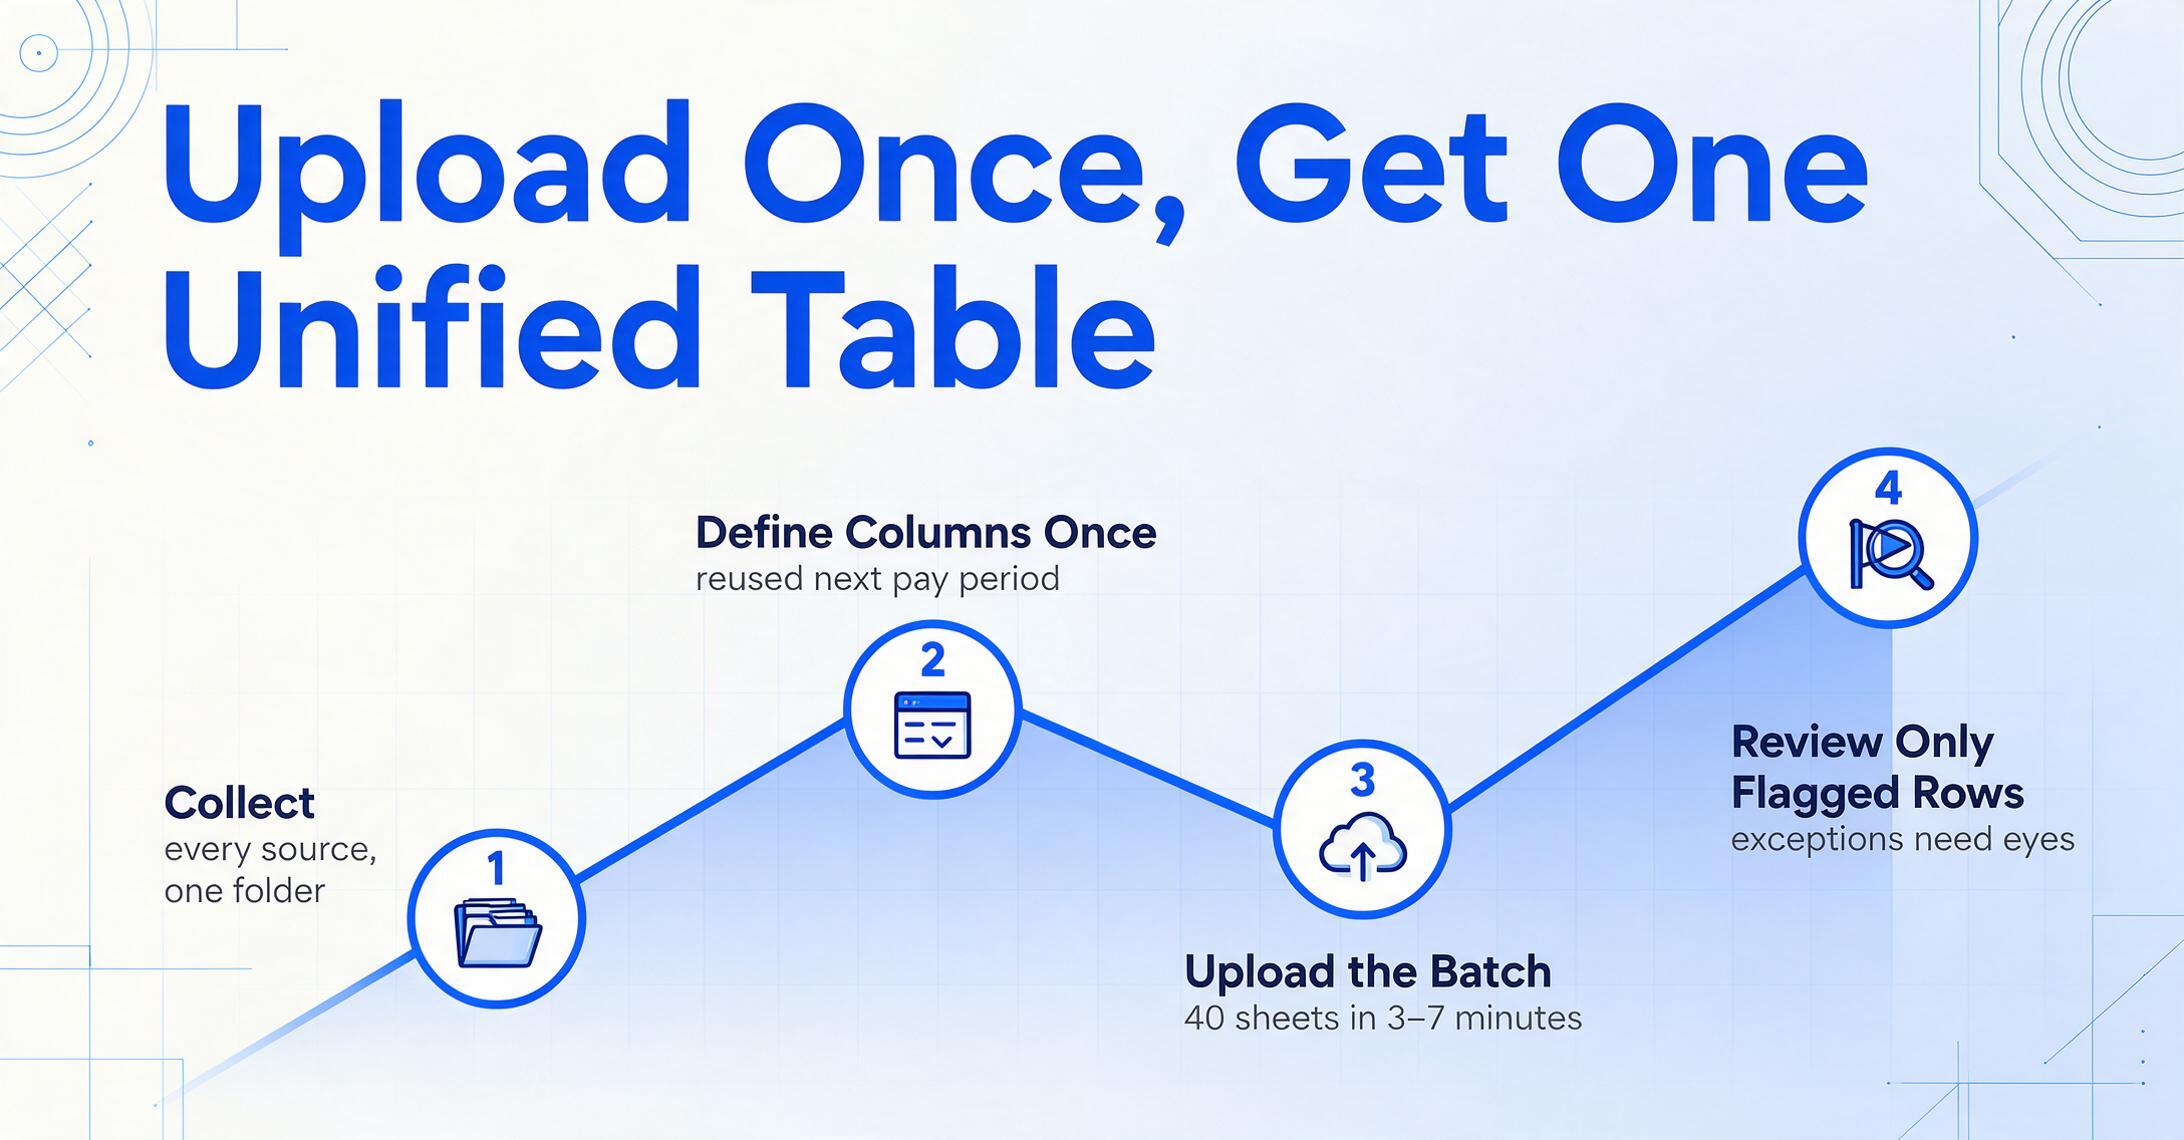
40枚のタイムシートを1枚ずつ処理するのは、各ファイルを開く手間、処理待ち、結果確認、次のファイルへの移動を考慮すると、手入力と比べて実質的に速くなりません。時間の節約が効果を発揮するのは、40枚すべてを一度にアップロードし、統合された単一のスプレッドシートを受け取れる場合だけです。
バッチ処理は、「抽出は面白いデモだ」と「抽出が給与担当者の水曜午後の作業を代替した」を分ける運用上の違いです。ワークフローはシンプルです:
給与期間のすべてのタイムシートを収集する
紙のカードを撮影し、メールで送られたPDFを転送し、ポータルのエクスポートをダウンロード — ソース形式に関係なく、すべてのタイムシートを1つのフォルダに集めます。事前の仕分けも、名前の変更も、標準化も不要です。
出力列を一度だけ定義する
給与インポート形式に合う列構造を設定します:従業員名、日付、プロジェクトコード、通常時間、残業時間、区分、コストコード。これらの列は、レイアウトに関係なくバッチ内のすべてのタイムシートに適用されます。列セットはテンプレートとして保存し、次回の給与期間に再利用できます。
すべてのタイムシートをアップロードしてバッチ処理する
フォルダ全体を一度にアップロードします。ツールは各タイムシートを個別に処理しますが、すべての結果を1つの統合テーブルにまとめます — タイムシートごとに従業員ごとの1行、定義した列に一致する形で。手入力で2〜3時間かかる40枚のバッチが、処理時間3〜7分で完了します。
すべてのフィールドではなく、フラグ付きの結果を確認する
240個の個別フィールド(40枚×6フィールド)を検証する代わりに、AIが不確実とフラグを付けたセルのみを確認します — 通常はフィールドの5〜15%です。信頼度の高い抽出結果からランダムにサンプルを抽出してスポットチェックします。確認ステップは、包括的なデータ入力検証から、例外ベースの品質保証へと変わります。
バッチファースト処理は、締め切りが厳しい給与サイクルで特に重要です。金曜日の午後にタイムシートが届き、火曜日の朝までに給与を提出しなければならない場合、順次処理を必要とするプロセスは、休暇シーズンに失敗するプロセスです。バッチ処理により、給与チームが結果を確認している間に抽出をバックグラウンドで実行できます。これまで直列的で人に依存していたワークフローを並列化します。
エクスポートと給与/ERP統合
給与システムに接続できないスプレッドシートに保存された抽出データは、手入力の形が変わっただけです。統合ステップこそ、抽出が価値を生むか、単なる研究プロジェクトになるかの分かれ目です。
最新の抽出ツールのほとんどは、Excel(XLSX)またはCSVにエクスポートします。これらの形式は、主要な給与・ERPプラットフォームがすべてインポートソースとして受け入れます。重要なのは、ツールがこれらの形式を生成できるか(ほぼすべて可能)ではなく、出力の列構造がダウンストリームシステムの期待と一致するかどうかです。給与システムが「Employee ID」という列ヘッダーをインポートし、抽出出力が「Worker Number」とラベル付けしている場合、インポート前に列名を変更するだけです。データを再入力する必要はありません。構造は正しく、命名規則は自分で制御できます。
タイムシートデータ統合のソフトウェアエコシステムは、次の3つのカテゴリに分類されます。
| カテゴリ | プラットフォーム | 統合方法 | 一般的なユースケース |
|---|---|---|---|
| 一般給与 | ADP Workforce Now、Paychex Flex、QuickBooks Payroll、Gusto、Sage | CSV/XLSXインポート | 直接雇用者の標準時間給給与、人材派遣会社や請負業者のタイムシート |
| 建設ERP | Sage 300 CRE、Viewpoint Vista、Foundation、HCSS HeavyBid、Procore | 原価コードとプロジェクトフィールドマッピングを伴うCSV/XLSXインポート | 工事原価配分、認証給与、現場からオフィスへの時間調整 |
| 認証給与 | LCPtracker、eMars、Miter、Payroll4Construction | CSVインポートまたは直接統合 | WH-347生成、適正賃金コンプライアンス、組合報告 |
Google Sheetsで作業するチーム(中小規模の建設・現場サービス事業で一般的)にとって、Google Sheetsアドオンを備えた抽出ツールは、エクスポート・インポートのステップを完全に排除します。抽出データはスプレッドシートのタブに直接配置され、給与へのインポートや経理チームとの共有にすぐ使用できます。タイムシート以外のさまざまな文書タイプを処理する組織には、関連するタイムシートをExcelに変換ツールが単一形式のバッチ抽出を処理します。
給与またはERPシステムが特定のフィールド順序や列命名規則を要求する場合、抽出ツールが列名を自由に設定できることを確認してください。ほとんどのツールは可能ですが、一部は文書フィールドラベルから列ヘッダーを自動生成するため、バッチ内でタイムシート形式が異なると列名が一貫しなくなります。列テンプレートを定義して保存できるツールを使用すれば、バッチ内のソース形式の数に関係なく、出力構造が毎回インポート形式と一致します。
認証給与、適正賃金、建設コンプライアンス
連邦政府資金によるプロジェクトに携わる建設請負業者にとって、タイムシートデータ抽出は単なる効率化の問題ではありません。クリーンな認証給与の提出と、仕事・資金・入札資格を失う可能性のあるコンプライアンス違反の違いを左右するものです。
デービス・ベーコン法(40 U.S.C. § 3141 et seq.)に基づき、$2,000を超える連邦建設契約では、請負業者は労働者に地域の適正賃金率を支払い、各労働者の氏名、職種区分、日別労働時間、賃金率、福利厚生を記載した週次認証給与報告書を提出する必要があります(通常はフォームWH-347)。32の州が連邦の枠組みに独自の適正賃金法を上乗せしており、それぞれ閾値、計算方法、報告形式が異なります。
米国労働省の指示は明確です。労働者が週内に複数の区分で作業を行った場合、認証給与には「各労働区分における労働時間の正確な内訳」を記載しなければなりません。時間データが紙のカードに手書きされた数字(「ジョン — 大工3時間、労務者5時間、オペレーター2時間」)として存在する場合、そのカードから準拠したWH-347への道のりは手動データ入力を通ります。その道のりのすべてのキーストロークには、他の手動転記と同様に1〜3%のエラー率が伴いますが、結果はより深刻です。誤分類された時間は全時間に最高適用賃金率が適用され、エラーのパターンが続くと、未払い賃金の返還、違反1件あたり最大$13,508の罰金、将来の連邦契約からの排除につながる可能性があります。
抽出が認証給与ワークフローにどのように組み込まれるか:
分類を第一級フィールドとして抽出
抽出テンプレートの列として「分類」を定義します。AIはタイムシートに記載された職種を読み取り、「大工」「電気技師」「労務者」「オペレーター」などを時間とともに出力します。作業員が電気技師として3時間、労務者として5時間を分けて記録した場合、2つの分類を持つ2行が生成されます。抽出ツールは賃金率を割り当てません(これは郡や契約によって異なるプロジェクトの賃金決定番号に依存します)が、賃金率マッピングに必要な構造化された分類データを提供します。
抽出データをWH-347フィールドにマッピング
抽出出力は、作業員名、分類、日次労働時間(通常および時間外)、賃金率、プロジェクト識別情報を提供します。これらはWH-347が要求する主要フィールドです。CSVに構造化されたこのデータは、認証給与ソフトウェア(LCPtracker、eMars、Miter)に直接取り込むか、手動フォーム作成のための検証済みソースとして使用できます。排除されるのは、紙からデジタルへの転記ステップ、つまりコンプライアンスチェーンにキーストロークエラーが入り込むステップです。
デジタル監査証跡の維持
デービス・ベーコン法の規制(29 CFR Part 3)に基づき、認証給与記録はプロジェクト完了後少なくとも3年間保管する必要があります。抽出により、元のタイムシート写真と抽出された構造化データを含むデジタル記録が作成され、紙の原本だけでは提供できない同時代の監査証跡となります。監査人が3年後に分類や時間数を疑問視した場合、ソース文書とそれに一致する抽出出力を示すことができます。
抽出が行わないこと:完成・署名済みのWH-347の生成。フォーム2ページ目のコンプライアンス声明には、給与に関する知識を持つ役員の署名が必要です。賃金が正しく、分類が正確で、福利厚生が支払われたことを証明するものです。この認証は請負業者の法的責任であり、自動化できません。抽出は、認証の失敗を引き起こすデータ入力エラーを排除しますが、認証自体を置き換えるものではありません。規制の全体像については、建設タイムシート抽出ガイドをご覧ください。
組合報告はもう一つのコンプライアンスの側面を追加します。組合の職種分類(大工、電気技師、労務者、オペレーティングエンジニア、鉄工、配管工/管工)は単なる給与カテゴリではなく、特定の賃金スケール、福利厚生拠出率、見習いから職人への比率を伴う契約上の義務です。現場監督が「ジョー — 8時間」と書き、そのうち3時間が組合大工、5時間が一般労働であることを明記しない場合、抽出ツールはカードに記録された内容のみを出力できます。構造的な修正はより良い抽出ではなく、より良いタイムカードです。ソース文書に分類を要求することは、使用する処理ツールに関係なく、建設請負業者が行える最も影響力の高いコンプライアンス改善です。
タイムシート抽出ツールに求めるべきポイント
タイムシート抽出ツールは、フォーマットごとのテンプレート設定を必要とする従来型OCRシステムから、意味を理解して読み取る最新のAIプラットフォームまで多岐にわたります。給与業務の負担を実際に減らすツールと、単に入力作業を別の画面に移すだけのツールを見分ける6つの基準があります。
1. テンプレート不要・フォーマット非依存の動作。 これは最も重要な差別化要因です。下請け業者、人材派遣会社、現場チームが増えるたびにタイムシートのフォーマットは増えていくからです。フォーマットごとに解析テンプレートの定義が必要なツールは、抽出ではなくテンプレート管理です。テンプレート不要の抽出は意味理解によって読み取ります。一度も処理したことのないソースからのタイムシートでも、最初のアップロードで機能します。ベンダーに確認しましょう。「見たことのないフォーマットのタイムシートを受け取った場合、すぐに処理できますか?」と。答えに「まず解析テンプレートを作成してください」が含まれるなら、あなたが買っているのは自動化ではなく保守作業です。
2. 実条件での手書き文字認識精度。 完璧にスキャンされたPDFを見せるデモ動画はテストになりません。実際に最も状態の悪いタイムシートでテストを依頼してください。欄外に分類が書かれた手書きのクルーカード、4が9に見えるカード、現場で夕暮れ時に撮影された写真などです。きれいな印刷済みデジタルPDFだけを処理できるツールは、タイムシート量のうち簡単な30〜40%しか解決できず、難しい60%はあなたの机に残ります。IJRISS 2025年のベンチマークである劣化条件下での87.92%の精度は参考になりますが、実際の最悪ケースでのテストこそ、公表された数値よりも多くのことを教えてくれます。
3. 表とグリッド構造の保持。 タイムシートはフォームではなくグリッドです。ツールは行と列の関係を理解し、出力でもそれを保持しなければなりません。セルに「8」とあっても、それがジョン・スミスの火曜日の通常労働時間であると正しい行で特定できなければ、給与計算には使えません。6〜12人の作業員が記載されたクルーシートでテストし、出力が作業員ごとに1行を生成し、各作業員の労働時間が正しい曜日の列に割り当てられていることを確認してください。
4. バッチファーストのアーキテクチャ。 タイムシートを1枚ずつ処理するのでは、抽出を導入する意味である時間節約がなくなります。ツールはバッチアップロード(一度に40ファイル以上)を受け付け、並列処理し、1つの統合出力テーブルを生成する必要があります。単一ドキュメント処理用に設計され、後付けでバッチ機能を追加したツールは、実際の給与処理量の前で綻びを見せます。
5. 残業計算のための計算カラム対応。 手動タイムシート処理で最も時間がかかるのは、労働時間の転記ではなく、管轄区域ごとのルールに基づく残業計算です。計算カラムを備えたツールなら、「残業時間(週40時間超→1.5倍、1日8時間超→1.5倍)」のような列を定義でき、AIが抽出中に計算を適用します。これにより、手動データ入力後に通常行われる別途のスプレッドシート計算ステップが不要になります。
6. 一貫した列構造での給与計算互換エクスポート。 抽出出力は、給与システムやERPが期待する形式(XLSXまたはCSV)と列構造の両方に一致する必要があります。インポート前に列の再構成、再フォーマット、並べ替えが必要なら、抽出は入力作業を短縮したものの、新たなデータ整形作業を生み出したことになります。最良のツールでは列テンプレートを保存でき、ソースバッチに異なるタイムシートフォーマットがいくつ含まれていても、毎給与期間同じ出力構造を生成できます。
よくある質問
AIは手書きのタイムシートを正確に読み取れますか?
はい。最新のビジョンAIモデルは、現場で記入された紙のカード上の手書きタイムシートデータ(氏名、時間、分類、コストコード)を読み取ります。2025年のIJRISS調査では、マルチモーダルAIが新品、折りたたみ、しわ、濡れた文書にわたって87.92%の精度を達成し、従来のOCRを大幅に上回りました。明瞭なブロック体は非常に信頼性が高く(95%以上)、急いで書かれた筆記体と曖昧な数字(1と7、4と9)は最も難しいケースとして残ります。AIは文脈(曜日の列ヘッダー、行ラベル、グリッド構造)を利用して、従来のOCRエンジンが推測するしかなかった文字を判別します。実際の違いは、すべてのフィールドを手入力する代わりに、事前に入力されたスプレッドシートを確認し、時折ある曖昧なエントリを修正するだけです。
タイムシート抽出はQuickBooks TimeやADPとどう違うのですか?
QuickBooks TimeとADP Workforce Nowはタイムトラッキングアプリです。従業員はデジタルで出退勤を記録し、時間は給与計算に直接流れ込みます。これらは紙のタイムシートが発生源で作成されるのを防ぎます。タイムシート抽出は、すでに存在する紙のタイムシート(下請け業者、人材派遣会社、アプリを利用できない現場チーム、または過去の記録からのもの)を処理します。これらは異なる問題を解決します。アプリは上流(記録)、抽出ツールは下流(紙に記録されたものの処理)です。多くの組織は両方を使用しています。直接雇用の従業員にはタイムトラッキングアプリ、どのアプリを導入していても紙で届く外部ソースからのタイムシートには抽出ツールを使用します。
タイムシート抽出は残業計算を自動的に処理しますか?
はい、ツールが計算カラムをサポートしている場合です。「残業時間(週40時間超→1.5倍)」のようなカラムを定義すると、AIが労働者ごとの日次エントリを合計し、どの時間がしきい値を超えるかを判断して、残業合計を出力します。建設業の残業ルールは管轄区域によって異なります。連邦のデービス・ベーコン法では週40時間後に1.5倍、カリフォルニア州では1日8時間と週40時間後に1.5倍(1日12時間後は2倍)、労働組合協定ではまったく異なるしきい値が追加される場合があります。計算カラム機能を備えたツールを使用すると、プロジェクトに適用されるルールをエンコードし、抽出中にAIが結果を計算できるため、抽出後のスプレッドシートでの計算ステップが不要になります。
労働者が複数のプロジェクトやコストコードに時間を分割している場合はどうなりますか?
紙のタイムシートに分割が記録されている場合(例:「プロジェクトA:4時間、プロジェクトB:4時間」)、抽出ツールは両方の配分を読み取り、その労働者に対して正しいプロジェクトコードと時間を持つ2つの別々の行を出力します。紙のタイムシートに分割が記録されておらず「8時間」とだけ表示されている場合、抽出ツールはカードに記載されている内容を出力します。分割を捏造することはありません。これは構造的な問題を浮き彫りにします。抽出ツールは読み取るタイムシートと同じくらい正確にしかなり得ないということです。コストコードの分割が欠落する最も一般的な原因は、職長や労働者が元の文書に記録していないことであり、抽出技術の失敗ではありません。
抽出で完成したWH-347認証給与フォームを作成できますか?
いいえ — そして、どのツールもそれを主張すべきではありません。WH-347には報告された賃金の正確性を証明する署名済みのコンプライアンス宣誓書が必要であり、これはデービス・ベーコン法に基づく請負業者の法的責任だからです。抽出が提供するのは、フォームが必要とする構造化データ、つまり労働者名、分類、日次労働時間(通常時間と残業時間)、賃金率、プロジェクト識別情報であり、WH-347のフィールドに入力したり、LCPtracker、eMars、Miterなどの認証給与ソフトウェアに直接インポートできる形式です。認証のステップは請負業者の義務のままですが、コンプライアンスエラーの大部分を生み出すデータ入力ステップは排除されます。
抽出したデータをSage 300 CREやViewpoint Vistaに取り込めますか?
はい。Sage 300 CRE、Viewpoint Vista、Foundation、HCSS HeavyBidはすべて、構造化されたExcelまたはCSVインポートに対応しています。抽出出力は、一貫した列ヘッダーを持つ標準のXLSXまたはCSVファイルであり、これらの建設ERPがインポートするのと同じ形式です。重要な要件は、出力の列構造がERPの期待するものと一致することです。Sageが「Job Code」を期待し、抽出列が「Project Number」の場合、インポート前にヘッダー名を変更します。時間、分類、コストコード、プロジェクト割り当ては正しく入力されます。列名をマッピングするだけで、データを再入力する必要はありません。
AI抽出と手動データ入力の精度の違いは何ですか?
AI抽出は、文書品質に応じてフィールドレベルで85〜99%の精度を達成します — きれいな印刷PDFでは95〜99%、手書きの現場カードでは85〜95%です。手動データ入力は、入力されたフィールドごとに1〜3%のエラー率を伴いますが、抽出エラー(レビューで確認可能)とは異なり、手動入力エラーは給与明細の紛争が表面化するまで見えません。60フィールドの週次タイムシートには、少なくとも1つのキー入力エラーが含まれる確率が45〜83%あります。抽出の構造的な利点は、必ずしも生の精度が高いことではなく、エラーが給与処理に埋もれるのではなく、レビューのために表面化されることです。
全従業員がタイムトラッキングアプリを使用している場合、抽出は必要ですか?
その従業員については不要です。タイムトラッキングアプリは、給与処理にネイティブに流れ込む構造化デジタルデータを生成するため、デジタル打刻に抽出を追加しても価値はありません。抽出が関連するのは、給与パイプラインにアプリを使用しないソースからのタイムシートが含まれる場合です:独自の紙システムを持つ下請け業者、PDFをメールで送る人材派遣会社、信頼できる携帯電話サービスがない現場の作業員、またはデジタル化が必要なレガシー紙記録などです。従業員の100%がデジタルで打刻している場合、タイムシート抽出は不要です。現場作業員が20人を超える組織のほとんどは、100%デジタル導入には遠く及ばず、そのギャップこそが抽出が手動入力を置き換える場所です。
タイムシート抽出ツールはどのファイル形式に対応していますか?
ほとんどのAI抽出ツールは、JPG、PNG、PDF、WebPに対応しており、スマートフォンでの撮影、スキャン文書、デジタル生成PDFをカバーしています。一部のツールはTIFF(企業のスキャンで一般的)やAVIFにも対応しています。重要なのはスマートフォンでの撮影に対応していることです。なぜなら、2026年における紙のタイムシートの最も一般的な発生源は、現場監督がスマートフォンで乗務員カードを撮影し、オフィスにテキストやメールで送信することだからです。フラットベッドスキャナで取り込み、傾き補正し、300 DPIを要求するツールは、2015年の問題を解決しています。実際の入力は、わずかに傾き、照明が不均一なスマートフォン写真であり、抽出は前処理なしで機能する必要があります。
手入力と比較した場合、タイムシート抽出のコストはどのくらいですか?
AI抽出ツールのコストは、個人ユーザーで月額9〜39ドル、小規模チームで月額39〜99ドルが一般的で、高ボリュームでは使用量ベースの料金体系になります。これを手入力のコストと比較してみましょう。タイムシート1枚あたり3分、給与計算担当者のフルロード人件費が時給25ドルの場合、週100枚の処理には週125ドル、年間6,500ドルの人件費がかかります。これは、APAが特定する1〜8%の給与計算エラーコストを考慮する前の数字です。このボリュームでは、抽出は最初の月で経済的に元が取れます。コンプライアンスリスクを含めると、コスト比較はさらに劇的になります。デービス・ベーコン法違反1件で、抽出ツールのサブスクリプション10年分以上のコストがかかる可能性があります。
タイムカードから給与計算実行まで
タイムシートデータ抽出は、給与ソフトウェアを置き換えるものではありません。ADP、Sage、Viewpoint、Paychexはそれぞれの役割をしっかり果たしています。重要なのは、時間データが発生する場所(紙のカード、スマホの写真、下請け業者のPDF)と、それが届くべき場所(給与システムの構造化された行、WH-347の行、原価計算台帳のコスト配分)との間のギャップを埋めることです。
そのギャップは現在、人間のキー入力によって埋められています。各入力には1〜3%のエラー発生率があり、給与計算ごとに数百のフィールドで増幅され、給与修正からコンプライアンス違反、次の入札の見積もりを誤らせる原価データの破損まで、コストは複合的に膨らみます。タイムシートを読み取る技術(グリッド構造の理解、現場の手書きの解読、職種分類の保持、コストコード化された構造化データの出力)は、テンプレート不要、トレーニング不要、あらゆるフォーマットに対応して、今日すでに存在しています。
抽出が給与ワークフローに適合するかを評価する最善の方法は、実際のタイムシート、特に毎回の給与期間に処理するのが面倒な難しいものをテストすることです。サンプルのタイムシートをアップロードして、返ってくる構造化データを確認してください — または、上記の組み込みデモでタイムシートプリセットを使って今すぐ抽出を試すこともできます。