Le guide complet de l'extraction de données
de feuilles de temps (2026)
Quand le ministère américain du Travail estime que remplir un formulaire de paie certifiée WH-347 prend 55 minutes pour seulement huit employés, et que l'American Payroll Association situe le taux d'erreur de saisie manuelle des feuilles de temps à 1–8 % de la masse salariale totale, l'écart entre une carte de temps papier et un cycle de paie n'est plus une simple gêne — c'est une perte quantifiable sur les budgets de main-d'œuvre, la précision des coûts de chantier et la conformité. L'extraction de données de feuilles de temps est la technologie qui comble cet écart : elle lit les noms des employés, les heures, les codes de projet et les heures supplémentaires depuis n'importe quel format de feuille de temps — imprimé ou manuscrit — et produit des données structurées que votre système de paie peut consommer directement, sans une seule frappe de saisie manuelle.
Points clés à retenir
- Une feuille de temps de chantier avec 60 champs a une probabilité de 45 à 83 % de contenir au moins une erreur de frappe — par feuille, par semaine, avant même que les calculs d'heures supplémentaires ne commencent.
- L'APA estime que les erreurs de saisie manuelle des feuilles de temps font perdre 1 à 8 % de la masse salariale totale, mais le vrai dommage est invisible : chaque heure mal saisie corrompt les données de coût de chantier qui alimentent votre prochaine soumission.
- Vous n'avez pas besoin d'un employé de saisie plus rapide — vous devez remplacer 240 frappes par lot par une étape de vérification qui ne contrôle que les 5 à 15 % de champs dont l'IA n'est pas sûre, transformant votre équipe de paie de créateurs de données en vérificateurs de données.
Qu'est-ce que l'extraction de données de feuilles de temps (et ce que ce n'est pas)
L'extraction de données de feuilles de temps est le processus automatisé de lecture des champs structurés — nom de l'employé, dates travaillées, heures quotidiennes (régulières et supplémentaires), codes de projet, codes de coûts et approbations — à partir d'une feuille de temps papier ou numérique, et leur conversion en un tableau organisé que votre système de paie peut importer. Ce n'est pas une application de suivi du temps.
Cette distinction est la source de confusion la plus courante, et bien la comprendre détermine si vous résolvez votre problème réel ou si vous achetez quelque chose qui ne touche pas à la pile de papier sur votre bureau. QuickBooks Time, ADP Workforce Now, Procore Timecard, Raken et les outils similaires sont des applications de suivi du temps : les employés pointent numériquement, et les heures circulent directement vers la paie. Elles empêchent la création de feuilles de temps papier à la source. L'extraction de feuilles de temps résout le problème inverse : la feuille de temps papier existe déjà — remplie par un chef d'équipe sur un chantier, faxée par une agence d'intérim, photographiée par un travailleur de terrain — et les heures doivent passer de cette carte à votre système de paie sans que personne ne les ressaisisse.
Pour une explication plus approfondie du fonctionnement de cette technologie et du moment où elle est la bonne solution, consultez notre guide sur ce qu'est l'extraction de données de feuilles de temps. Le reste de cet article suppose que vous avez déjà déterminé que l'extraction est la bonne réponse et se concentre sur comment bien la faire — couvrant tout, de la sélection des champs et du traitement par lots à la conformité de la paie certifiée et à l'intégration avec le système de paie.
Pourquoi l'extraction de données de feuilles de temps est importante
Le coût du traitement manuel des feuilles de temps n'est pas le salaire de la personne qui saisit les données. C'est ce qui se passe quand cette saisie tourne mal — et les données sur la fréquence de ces erreurs sont pires que ce que la plupart des responsables de paie supposent.
L'American Payroll Association estime que les erreurs manuelles de feuilles de temps coûtent 1 à 8 % de la masse salariale totale. Sur un budget annuel de main-d'œuvre de 2 millions de dollars, cela représente 20 000 à 160 000 dollars de coûts récupérables — chaque année. Le Financial Benchmarker 2024 de la Construction Financial Management Association (CFMA) a constaté que l'administration des coûts à elle seule consomme en moyenne 5,4 % du chiffre d'affaires du projet pour les entrepreneurs généraux américains. Le principal facteur n'est pas la licence logicielle ou les frais de conseil ; c'est le travail de rapprochement des données qui auraient dû correspondre dès le départ — des heures sur une carte de temps qui ne correspondent pas aux heures dans la paie parce que quelqu'un a mal lu un 4 pour un 9.
Chaque frappe dans la saisie manuelle des feuilles de temps comporte un taux d'erreur de 1 à 3 %. Une seule feuille hebdomadaire d'équipe de chantier avec 60 champs (5 travailleurs × 12 points de données chacun) signifie que la probabilité d'au moins une erreur dans ce lot est comprise entre 45 % et 83 % — par feuille, par semaine. Multipliez cela par 20 feuilles de temps de sous-traitants et un an de cycles de paie, et la question n'est pas de savoir si des erreurs existent dans vos données de paie, mais combien passent inaperçues.
La dimension de conformité amplifie encore ces coûts. Sur les projets de construction financés par le gouvernement fédéral soumis à la Loi Davis-Bacon, une seule classification erronée de métier ou une heure mal saisie sur un rapport de paie certifiée peut entraîner des pénalités allant jusqu'à 13 508 $ par violation. L'estimation du Département du Travail de 55 minutes pour remplir le Formulaire WH-347 pour seulement 8 employés signifie qu'un projet de 40 personnes peut consommer plus de 4,5 heures de temps d'administration de la paie par semaine pour le seul formulaire — avant de compter la saisie de données qui l'alimente.
Le problème structurel : la saisie manuelle des feuilles de temps comporte un taux d'erreur qui s'aggrave avec le volume, tandis que les conséquences en matière de conformité et de coûts s'aggravent avec le temps. L'extraction n'élimine pas la nécessité d'une vérification — mais elle fait passer le rôle de l'équipe de paie de celui de commis à la saisie de données à celui de vérificateur de données, ce qui constitue un profil de risque fondamentalement différent.
Les défis uniques des données de feuilles de temps
Les feuilles de temps ne sont pas des factures. Ce ne sont pas des reçus. Elles présentent un ensemble de défis structurels qui les rendent particulièrement difficiles à extraire — et particulièrement précieuses à bien faire.
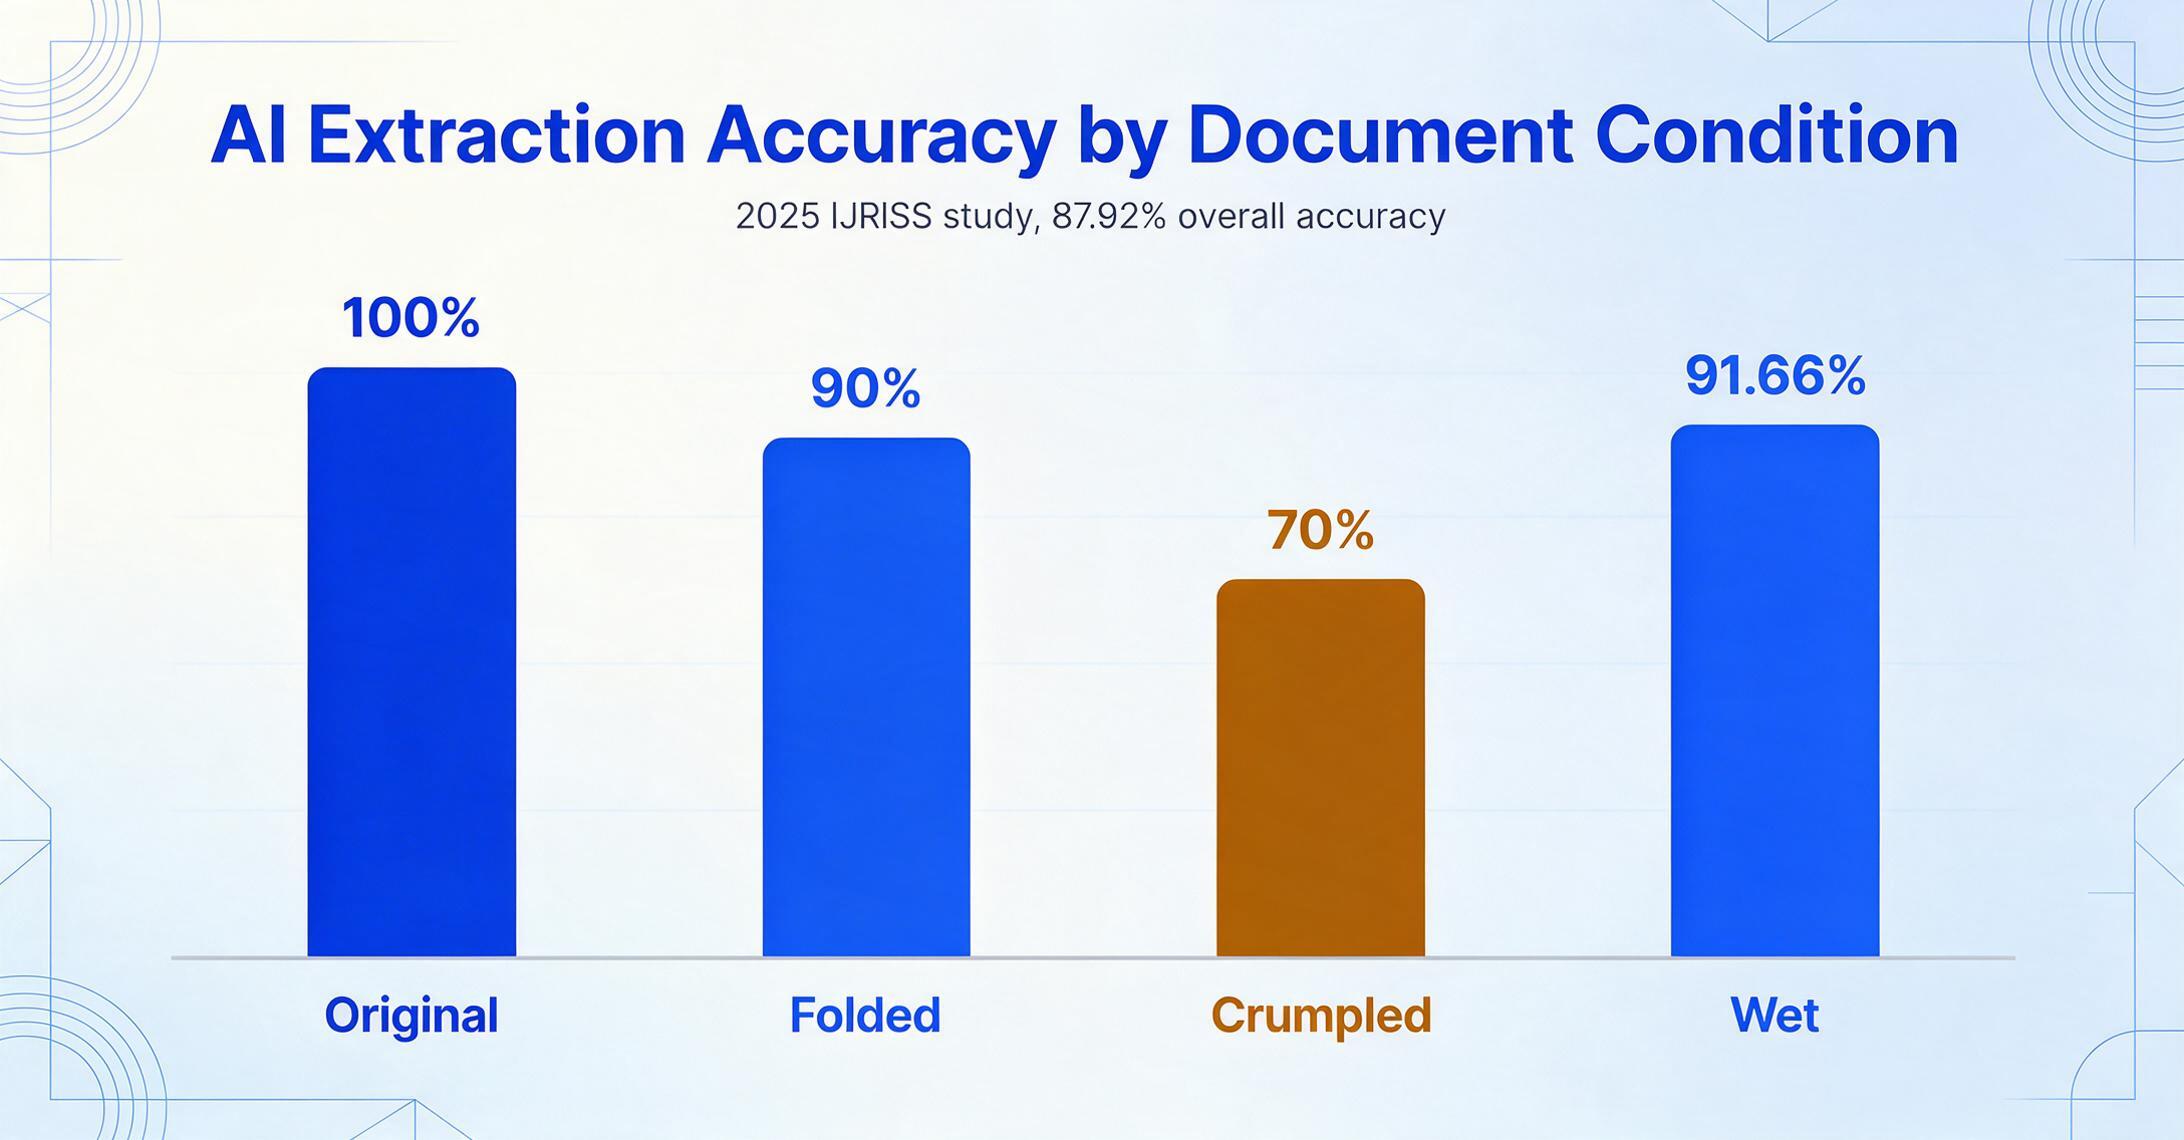
L'écriture manuscrite est la norme, pas l'exception. Les cartes de temps sur les chantiers, les journaux de service sur le terrain et les feuilles de temps des agences de personnel sont remplies à la main — souvent dans la cabine d'un camion, sur un hayon ou à la fin d'un quart de travail de 10 heures. L'étude IJRISS 2025 sur l'OCR des feuilles de temps alimentée par l'IA a testé l'extraction multimodale sur quatre états de dégradation des documents — original (précision de 100 %), plié (90 %), froissé (70 %) et mouillé (91,66 %) — atteignant une précision globale de 87,92 %, soit une amélioration de 12 à 47 points de pourcentage par rapport à l'OCR traditionnel. Un outil d'extraction qui ne gère que les PDF propres et imprimés ne résout que les 30 à 40 % faciles du problème. Le reste manuscrit est là où se trouvent les coûts de la saisie manuelle.
Structure de tableau, pas structure de formulaire. La plupart des outils d'extraction de documents sont conçus pour les formulaires : une étiquette, une valeur. « Numéro de facture : INV-12345 » est un champ de formulaire. Une feuille de temps est une grille — les noms des employés dans la colonne de gauche, du lundi au dimanche en haut, les valeurs horaires dans les cellules d'intersection. L'outil doit comprendre que le « 8 » à la ligne 3, colonne 4 correspond aux heures régulières du mercredi de John Smith — et que cette relation doit être préservée dans la sortie, que la grille ait 5 ou 14 colonnes, que l'en-tête indique « Mer » ou « Mercredi » ou « M », et que l'étiquette de ligne soit « John Smith » ou « Smith, J. ». Les approches basées sur des modèles échouent lorsque la disposition de la grille change ; l'extraction sémantique lit la structure en comprenant ce que représente chaque cellule, et non où elle se trouve.
Les codes de projet et de coûts multiplient la complexité de l'extraction. Un commis à la paie qui lit une feuille de temps pourrait voir « 8 heures » et saisir une seule ligne. Mais ce « 8 » pourrait devoir être réparti sur trois codes de coûts (03 30 00 — Béton, 03 24 00 — Armature, 03 00 00 — Général) avec des classifications différentes et potentiellement des taux de salaire différents. Sur un projet Davis-Bacon, le DOL exige que les travailleurs qui exercent plus d'une classification fournissent une ventilation précise des heures par classification. La sortie de l'extraction doit être capable de produire plusieurs lignes par travailleur — et non de tout regrouper en une seule.
La logique des heures supplémentaires varie selon la juridiction. Les projets fédéraux Davis-Bacon exigent des heures supplémentaires à 1,5× après 40 heures par semaine. La Californie exige 1,5× après 8 heures par jour et après 40 heures par semaine, avec un taux double après 12 heures dans une journée. Les conventions collectives peuvent superposer des seuils entièrement différents aux deux. Un outil d'extraction qui se contente de lire ce qui est écrit sur la carte — et qui ne peut pas calculer les heures supplémentaires à partir des totaux horaires quotidiens — laisse la partie la plus difficile du calcul de paie sur le bureau où elle a commencé.
La répartition multi-projets brouille la limite de la période de paie. Un même travailleur peut enregistrer des heures sur trois projets différents en une semaine, chacun avec des déterminations de salaire différentes, des codes de coûts différents et des exigences de déclaration de paie certifiée différentes. La feuille de temps peut ou non capturer clairement ces répartitions — mais le traitement de la paie doit les refléter avec précision, car un travailleur payé selon une mauvaise détermination de salaire constitue un échec de conformité, que la feuille de temps ait été ambiguë ou non.
Méthodes traditionnelles vs extraction par IA
Trois approches dominent aujourd'hui le pipeline feuille de temps vers paie. Une seule d'entre elles est conçue pour le volume, la variété et les enjeux de conformité auxquels la plupart des organisations sont réellement confrontées.
| Saisie manuelle des données | OCR basé sur des modèles | Extraction sémantique par IA | |
|---|---|---|---|
| Comment ça fonctionne | Le commis à la paie lit la fiche papier et saisit chaque champ dans le système de paie | L'OCR lit les caractères à une position prédéfinie ; nécessite un modèle d'analyse par format de feuille de temps | L'IA visuelle lit le document dans son ensemble, comprenant les noms, les heures et les codes par leur sens plutôt que par leur position |
| Gère l'écriture manuscrite ? | Oui (un humain la déchiffre) | Faible — l'OCR traditionnel tombe sous les 50 % sur l'écriture cursive | Oui — 85 à 95 % au niveau des champs sur l'écriture manuscrite, 87,92 % dans des conditions dégradées |
| Gère les changements de format ? | Oui (l'humain s'adapte) | Non — chaque nouveau format exige un nouveau modèle | Oui — indépendant du format, lit toute disposition dès la première rencontre |
| Gère les grilles de tableaux ? | Oui (l'humain lit la grille) | Partiellement — perd souvent les relations lignes-colonnes | Oui — préserve la structure de la grille, le contexte des lignes et les en-têtes de colonnes |
| Temps de traitement par feuille de temps | 2 à 5 minutes | 10 à 30 secondes (après création du modèle) | 5 à 10 secondes |
| Effort de configuration | Nul (par feuille de temps) ; temps de formation pour chaque nouveau commis | Élevé — créer et maintenir un modèle par format, par fournisseur, par changement de disposition | Quasi nul — définir les colonnes de sortie une fois ; réutiliser sur tous les formats et sources |
| Profil d'erreurs | 1 à 3 % par champ saisi ; invisible jusqu'à un litige sur le chèque de paie | Dépend de la qualité du modèle ; échoue silencieusement quand la disposition change | 1 à 5 % au niveau des champs ; les erreurs sont visibles pour une vérification humaine avant le traitement de la paie |
| Passe à l'échelle avec le volume ? | Non — coût linéaire par feuille de temps | Non — la maintenance des modèles augmente avec la diversité des formats | Oui — coût marginal quasi nul après la définition initiale des colonnes |
| Idéal pour | 1 à 5 feuilles de temps par semaine, format unique | Feuilles de temps numériques à volume élevé, format unique, provenant d'une seule source | Feuilles de temps manuscrites et imprimées multi-formats et multi-sources ; environnements sensibles à la conformité |
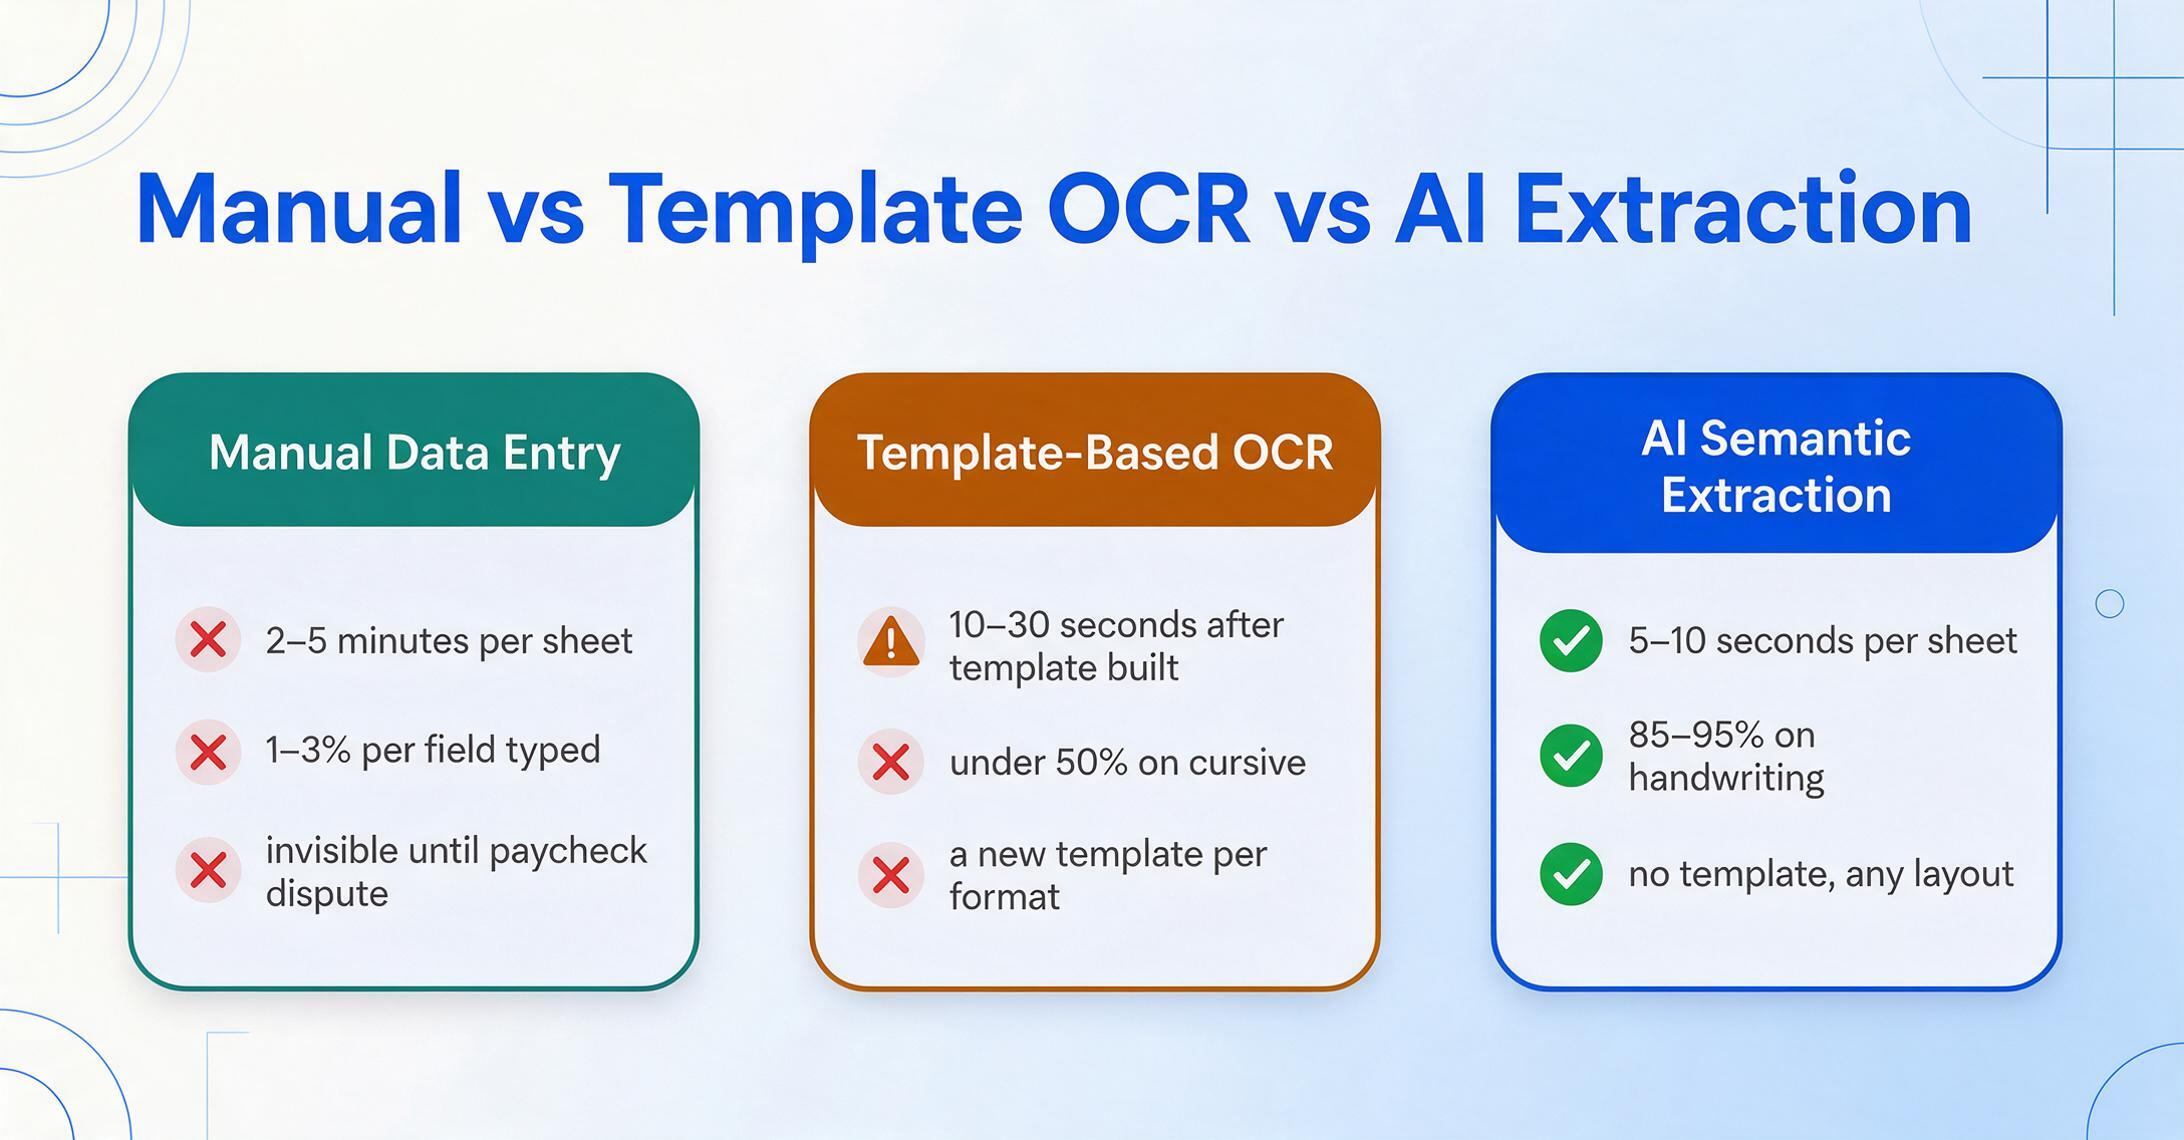
Le point crucial : l'OCR basé sur des modèles échoue précisément là où la plupart des organisations ont le plus besoin d'extraction. Si vos feuilles de temps proviennent toutes d'une seule source dans un seul format, vous n'avez pas besoin d'extraction — vous disposez d'un processus numérique standardisé. L'extraction est nécessaire précisément lorsque les formats varient : cinq sous-traitants envoyant cinq mises en page différentes de feuilles de temps, une agence d'intérim avec son propre format PDF, une fiche papier héritée d'une équipe qui n'utilise pas d'applications. Chaque nouveau format casse un système basé sur des modèles. Un système sans modèle les lit tous avec la même définition de colonnes — car il localise « Nom de l'employé » en comprenant à quoi ressemble un nom d'employé, et non en l'attendant à des coordonnées (120, 45).
C'est la décision d'architecture qui détermine si l'extraction réduit votre charge de travail ou la déplace simplement : l'extraction basée sur la position (où se trouvent les données ?) vs l'extraction basée sur la sémantique (que signifient les données ?). Les outils de la première catégorie — la plupart des systèmes OCR et zonaux hérités — exigent de maintenir une carte de l'emplacement de chaque champ sur chaque variante de document. Les outils de la deuxième catégorie — les plateformes modernes de vision IA — lisent les documents comme le ferait une personne : en comprenant le contenu, pas en faisant correspondre des coordonnées. Si vous traitez des feuilles de temps provenant de plus de trois sources différentes, le coût de la maintenance des modèles à lui seul peut dépasser le coût de la saisie manuelle en un an. Pour une comparaison plus approfondie, notre guide de définition de l'extraction de feuilles de temps couvre la couche technologique en détail.
Les fichiers sont traités en toute sécurité et ne sont pas stockés.
Champs clés pour l'extraction de feuilles de temps
Les champs que vous extrayez dépendent de la destination des données — un traitement de paie simple nécessite moins de champs qu'un rapport de paie certifiée Davis-Bacon, qui en nécessite moins qu'une feuille de calcul complète d'allocation des coûts de chantier. Définissez vos colonnes de sortie en fonction des exigences de votre système en aval, pas de la mise en page de la feuille de temps.
Employé et période
- Nom de l'employé
- Identifiant de l'employé / numéro de badge
- Fin de semaine / date de la période de paie
- Nom et signature du superviseur
Grille des heures quotidiennes
- Heures normales — du lundi au dimanche
- Heures supplémentaires (1,5× et 2×)
- Déductions pour pause / repas
- Heures de maladie / congés / jours fériés
Projet et allocation des coûts
- Code projet / numéro de chantier
- Code de coût / code de phase
- Métier / classification du corps de métier
- Description du travail / tâche
Paie et conformité
- Taux horaire / taux de rémunération
- Total des heures normales
- Total des heures supplémentaires
- Taux des avantages sociaux
- Numéro de détermination du salaire courant
L'outil d'extraction que vous choisissez doit vous permettre de définir les colonnes une seule fois et de les appliquer à chaque format de feuille de temps que votre organisation reçoit. Cette approche — appelée Extraction de colonnes personnalisées — signifie que vous définissez la structure de sortie en fonction des besoins de votre système de paie ou ERP, pas de ce que fournit chaque feuille de temps individuelle. Une colonne de nom de travailleur dans votre sortie capturera « John Smith » que la carte source l'indique comme « John Smith », « Smith, John » ou « J. Smith » dans le coin supérieur gauche — l'IA résout chaque variante vers la même colonne de sortie grâce à la compréhension sémantique, pas à la correspondance positionnelle.
Traitement par lots : quand le volume rend la vitesse structurelle
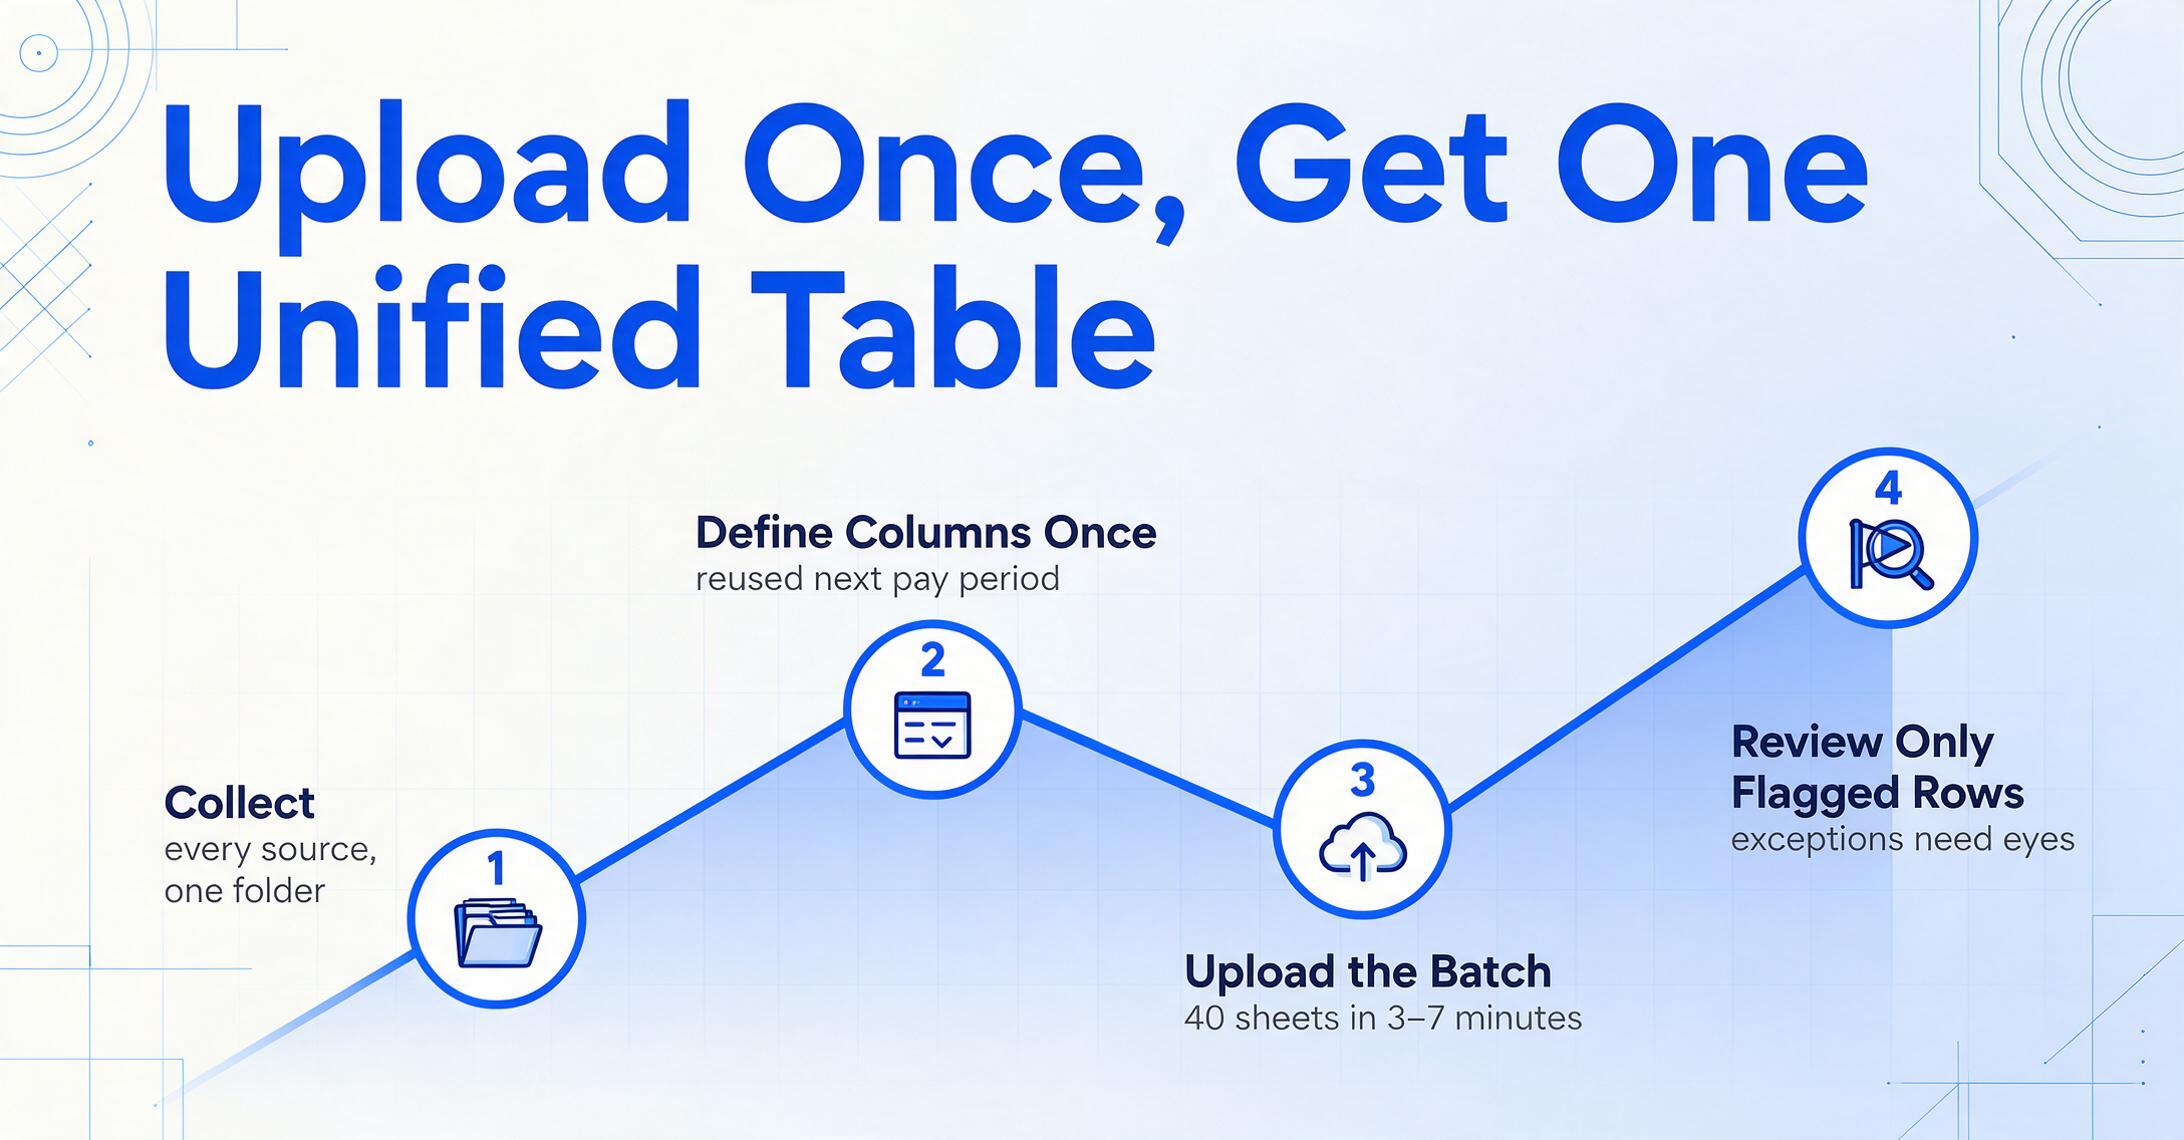
Traiter 40 feuilles de temps une par une n'est pas significativement plus rapide que la saisie manuelle une fois que l'on compte le temps passé à ouvrir chaque fichier, attendre le traitement, vérifier les résultats et passer au suivant. Les gains de temps ne se cumulent que lorsque vous pouvez téléverser les 40 feuilles d'un coup et recevoir en retour un seul tableur unifié.
Le traitement par lots fait la différence opérationnelle entre « l'extraction est une démo intéressante » et « l'extraction a remplacé le mercredi après-midi du commis à la paie ». Le flux de travail est simple :
Collecter toutes les feuilles de temps de la période de paie
Photographiez les cartes papier, transférez les PDF reçus par courriel, téléchargez les exports du portail — rassemblez chaque feuille de temps dans un seul dossier, quel que soit son format d'origine. Pas de pré-tri, pas de renommage, pas de normalisation.
Définir vos colonnes de sortie une seule fois
Configurez la structure de colonnes qui correspond à votre format d'importation de paie : Nom de l'employé, Date, Code de projet, Heures régulières, Heures supplémentaires, Classification, Code de coût. Ces colonnes s'appliquent à chaque feuille de temps du lot, quelle que soit sa mise en page. Enregistrez l'ensemble de colonnes comme modèle pour le réutiliser à la prochaine période.
Téléverser toutes les feuilles de temps et traiter en lot
Téléversez tout le dossier d'un coup. L'outil traite chaque feuille de temps indépendamment mais regroupe tous les résultats dans un seul tableau unifié — une ligne par travailleur et par feuille de temps, avec des colonnes conformes à votre définition. Un lot de 40 feuilles qui prendrait 2 à 3 heures de saisie manuelle est traité en 3 à 7 minutes.
Vérifier les résultats signalés, pas chaque champ
Au lieu de vérifier 240 champs individuels (40 feuilles × 6 champs), vérifiez uniquement les cellules que l'IA a signalées comme incertaines — généralement 5 à 15 % des champs. Contrôlez par sondage un échantillon aléatoire des extractions fiables. L'étape de vérification passe d'une validation exhaustive de la saisie de données à un contrôle qualité fondé sur les exceptions.
L'architecture de traitement par lots en priorité est particulièrement importante pour les cycles de paie soumis à des délais stricts. Si les feuilles de temps arrivent le vendredi après-midi et que la paie doit être soumise avant mardi matin, un processus nécessitant un traitement séquentiel échoue pendant la saison des vacances. Le traitement par lots permet à l'extraction de s'exécuter en arrière-plan pendant que l'équipe de paie examine les résultats — parallélisant ce qui était auparavant un flux de travail séquentiel et dépendant d'une personne.
Export et intégration paie/ERP
Des données extraites qui vivent dans un tableur que vous ne pouvez pas connecter à votre système de paie ne sont qu'une autre forme de saisie manuelle. L'étape d'intégration est celle où l'extraction apporte de la valeur ou devient un projet de recherche.
La plupart des outils d'extraction modernes exportent vers Excel (XLSX) ou CSV — des formats que toutes les grandes plateformes de paie et ERP acceptent comme source d'importation. Le facteur critique n'est pas de savoir si l'outil peut produire ces formats (presque tous le peuvent), mais si la structure des colonnes de sortie correspond à ce que votre système en aval attend. Si votre système de paie importe « ID employé » comme en-tête de colonne et que votre sortie d'extraction l'étiquette « Numéro de travailleur », vous renommez une colonne avant l'importation — vous ne retapez pas les données. La structure est correcte ; la convention de nommage vous appartient.
Les écosystèmes logiciels pour l'intégration des données de feuilles de temps se répartissent en trois catégories :
| Catégorie | Plateformes | Méthode d'intégration | Cas d'utilisation typique |
|---|---|---|---|
| Paie générale | ADP Workforce Now, Paychex Flex, QuickBooks Payroll, Gusto, Sage | Import CSV/XLSX | Paie horaire standard pour les employés directs ; feuilles de temps des agences d'intérim et des sous-traitants |
| ERP de construction | Sage 300 CRE, Viewpoint Vista, Foundation, HCSS HeavyBid, Procore | Import CSV/XLSX avec mappage des codes de coût et des champs de projet | Répartition des coûts par projet, paie certifiée, rapprochement des temps entre le terrain et le bureau |
| Paie certifiée | LCPtracker, eMars, Miter, Payroll4Construction | Import CSV ou intégration directe | Génération du formulaire WH-347, conformité au salaire courant, rapports syndicaux |
Pour les équipes qui travaillent dans Google Sheets — courant dans les opérations de construction et de service sur le terrain de petite et moyenne taille — les outils d'extraction avec un module complémentaire Google Sheets éliminent complètement l'étape d'export-import. Les données extraites arrivent directement dans un onglet de feuille de calcul, prêtes à être importées dans la paie ou partagées avec l'équipe comptable. Pour les organisations qui traitent des types de documents variés au-delà des feuilles de temps, l'outil connexe convertir les feuilles de temps en Excel gère l'extraction par lots à format unique.
Si votre système de paie ou ERP exige un ordre de champs ou une convention de nommage de colonnes spécifique, vérifiez que l'outil d'extraction vous permet de nommer librement les colonnes — la plupart le permettent, mais certains génèrent automatiquement les en-têtes de colonnes à partir des étiquettes de champs du document, ce qui produit des noms de colonnes incohérents lorsque les formats de feuilles de temps varient dans un lot. Un outil qui vous permet de définir et d'enregistrer des modèles de colonnes garantit que la structure de sortie correspond à votre format d'importation à chaque période, quel que soit le nombre de formats source différents dans le lot.
Paie certifiée, salaire courant et conformité dans la construction
Pour les entrepreneurs en construction travaillant sur des projets financés par le gouvernement fédéral, l'extraction de données de feuilles de temps ne se résume pas à de l'efficacité — c'est la différence entre une soumission de paie certifiée propre et une violation de conformité qui peut coûter des emplois, de l'argent et l'éligibilité aux appels d'offres.
En vertu de la Loi Davis-Bacon (40 U.S.C. § 3141 et seq.), tout contrat de construction fédéral dépassant 2 000 $ exige que les entrepreneurs paient les travailleurs aux taux de salaire courant localement en vigueur et soumettent des rapports de paie certifiée hebdomadaires — généralement sur le Formulaire WH-347 — documentant le nom de chaque travailleur, sa classification professionnelle, les heures travaillées par jour, le taux de salaire et les avantages sociaux. Trente-deux États ajoutent leurs propres lois sur le salaire courant au cadre fédéral, chacune avec des seuils, des méthodes de calcul et des formats de déclaration différents.
Les instructions du DOL sont explicites : si un travailleur a effectué des travaux dans plus d'une classification au cours de la semaine, la paie certifiée doit indiquer « une répartition précise des heures travaillées dans chaque classification professionnelle ». Lorsque les données de temps proviennent de chiffres manuscrits sur une carte papier — « John — Charpentier 3h, Manœuvre 5h, Opérateur 2h » — le chemin de cette carte vers un WH-347 conforme passe par la saisie manuelle des données. Chaque frappe sur ce chemin porte le même taux d'erreur de 1 à 3 % que toute autre transcription manuelle, mais les conséquences sont plus lourdes : une heure mal classée est par défaut facturée au taux de salaire applicable le plus élevé pour toutes les heures ; un schéma d'erreurs peut déclencher une restitution de salaire impayé, des pénalités allant jusqu'à 13 508 $ par violation et l'exclusion des futurs contrats fédéraux.
Comment l'extraction s'intègre dans le flux de travail de la paie certifiée :
Extraire la classification comme champ de premier ordre
Définissez « Classification » comme colonne dans votre modèle d'extraction. L'IA lit le métier tel qu'il est inscrit sur la feuille de temps — « Charpentier », « Électricien », « Manœuvre », « Opérateur » — et le restitue avec les heures. Lorsqu'un travailleur répartit 3 heures comme électricien et 5 comme manœuvre, vous obtenez deux lignes avec deux classifications. L'outil d'extraction n'attribue pas les taux de salaire (cela dépend du numéro de détermination des salaires du projet, qui varie selon le comté et le contrat), mais il fournit les données de classification structurées nécessaires au mappage des taux de salaire.
Mapper les données extraites vers les champs du formulaire WH-347
La sortie d'extraction fournit le nom du travailleur, la classification, les heures quotidiennes (normales et supplémentaires), le taux de rémunération et l'identification du projet — les champs essentiels requis par le formulaire WH-347. Structurées en CSV, ces données peuvent alimenter directement les logiciels de paie certifiée (LCPtracker, eMars, Miter), ou servir de source vérifiée pour la saisie manuelle du formulaire. L'étape éliminée est la transcription du papier au numérique — l'étape où les erreurs de frappe entrent dans la chaîne de conformité.
Maintenir une piste d'audit numérique
Selon la réglementation Davis-Bacon (29 CFR Part 3), les registres de paie certifiée doivent être conservés au moins trois ans après l'achèvement du projet. L'extraction crée un enregistrement numérique qui inclut la photo de la feuille de temps originale ainsi que les données structurées extraites — une piste d'audit contemporaine que les originaux papier seuls ne peuvent pas fournir. Si un auditeur remet en question une classification ou un nombre d'heures trois ans plus tard, vous pouvez montrer le document source et la sortie d'extraction qui lui correspond.
Ce que l'extraction ne fait pas : générer un formulaire WH-347 rempli et signé. La déclaration de conformité en page 2 du formulaire exige la signature d'un responsable ayant connaissance de la paie — attestant que les salaires sont corrects, que les classifications sont exactes et que les avantages sociaux ont été versés. Cette certification est la responsabilité légale de l'entrepreneur et ne peut pas être automatisée. L'extraction élimine les erreurs de saisie de données qui provoquent des échecs de certification ; elle ne remplace pas la certification elle-même. Pour le contexte réglementaire complet, consultez notre guide sur l'extraction de feuilles de temps dans le secteur de la construction.
Le reporting syndical ajoute une autre dimension de conformité. Les classifications de métiers syndiqués (Charpentier, Électricien, Manœuvre, Ingénieur d'exploitation, Ferronnier, Plombier/Tuyauteur) ne sont pas seulement des catégories de paie — ce sont des obligations contractuelles avec des échelles salariales spécifiques, des taux de cotisation aux avantages sociaux et des ratios apprenti-compagnon. Lorsqu'un chef d'équipe écrit « Joe — 8h » sans préciser que 3 de ces heures relevaient de la menuiserie syndiquée et 5 de la main-d'œuvre générale, l'outil d'extraction ne peut restituer que ce que la carte capture. La solution structurelle n'est pas une meilleure extraction — c'est de meilleures cartes de temps. Exiger la classification sur le document source est l'amélioration de conformité à plus fort impact qu'un entrepreneur en construction puisse apporter, quel que soit l'outil de traitement utilisé.
Ce qu'il faut rechercher dans un outil d'extraction de feuilles de temps
Les outils d'extraction de feuilles de temps vont des systèmes OCR hérités nécessitant une configuration de modèle par format aux plateformes d'IA modernes qui lisent sémantiquement. Six critères distinguent les outils qui réduisent la charge de travail de paie de ceux qui déplacent simplement la saisie vers un autre écran.
1. Fonctionnement sans modèle et indépendant du format. C'est le différenciateur le plus important — car les formats de feuilles de temps se multiplient avec chaque sous-traitant, agence de personnel et équipe de terrain ajoutée à votre opération. Un outil qui exige de définir un modèle d'analyse par format n'est pas de l'extraction ; c'est de la gestion de modèles. L'extraction sans modèle lit par compréhension sémantique : une feuille de temps provenant d'une source que vous n'avez jamais traitée fonctionne dès le premier téléversement. Demandez au fournisseur : « Si je reçois une feuille de temps dans un format que je n'ai jamais vu, fonctionne-t-elle immédiatement ? » Si la réponse implique « créez d'abord un modèle d'analyse », vous achetez de la maintenance, pas de l'automatisation.
2. Précision de l'écriture manuscrite dans des conditions réelles. La vidéo de démonstration montrant un PDF parfaitement numérisé n'est pas le test. Demandez à tester sur vos pires feuilles de temps réelles — la carte d'équipe manuscrite avec les classifications dans la marge, la carte où un 4 ressemble à un 9, la photo prise au crépuscule sur un chantier. Un outil qui ne gère que des PDF propres et imprimés résout les 30 à 40 % faciles de votre volume de feuilles de temps — et laisse les 60 % difficiles sur votre bureau. Le benchmark IJRISS 2025 de 87,92 % de précision dans des conditions dégradées est un point de référence utile, mais votre propre test dans le pire des cas vous en apprendra plus que tout chiffre publié.
3. Préservation de la structure des tableaux et des grilles. Une feuille de temps est une grille, pas un formulaire. L'outil doit comprendre les relations lignes-colonnes et les préserver dans la sortie. Si l'extraction voit « 8 » dans une cellule mais ne peut pas vous dire qu'il s'agit des heures régulières du mardi de John Smith dans la bonne ligne, la sortie est inutilisable pour la paie. Testez avec des feuilles d'équipe — une carte listant 6 à 12 travailleurs — et vérifiez que la sortie produit une ligne par travailleur, avec les heures de chacun correctement attribuées aux bonnes colonnes de jours.
4. Architecture de traitement par lots en priorité. Traiter les feuilles de temps une par une élimine les économies de temps qui justifient l'utilisation de l'extraction en premier lieu. L'outil doit accepter des téléversements par lots (40+ fichiers à la fois), les traiter en parallèle et produire une table de sortie unifiée. Un outil conçu pour le traitement de documents uniques avec des capacités de traitement par lots ajoutées après coup révélera ses failles sous un volume de paie réel.
5. Prise en charge des colonnes calculées pour les heures supplémentaires et les calculs. La partie la plus chronophage du traitement manuel des feuilles de temps n'est pas la transcription des heures — c'est le calcul des heures supplémentaires selon les règles propres à chaque juridiction. Un outil avec des colonnes calculées vous permet de définir une colonne comme « Heures supp. (heures > 40/sem. → 1,5× ; heures > 8/jour → 1,5×) » et l'IA applique le calcul pendant l'extraction. Cela élimine l'étape distincte de calcul dans un tableur qui suit généralement la saisie manuelle des données.
6. Export compatible paie avec structure de colonnes cohérente. La sortie d'extraction doit correspondre à ce que votre système de paie ou ERP attend — à la fois en format de fichier (XLSX ou CSV) et en structure de colonnes. Si vous devez restructurer, reformater ou réordonner les colonnes avant l'importation, l'extraction a raccourci l'étape de saisie mais a créé une nouvelle étape de manipulation des données. Les meilleurs outils vous permettent d'enregistrer des modèles de colonnes qui produisent une structure de sortie identique à chaque période de paie, quel que soit le nombre de formats de feuilles de temps différents dans le lot source.
Questions fréquentes
L'IA peut-elle lire avec précision les feuilles de temps manuscrites ?
Oui. Les modèles d'IA de vision modernes lisent les données des feuilles de temps manuscrites — noms, heures, classifications, codes de coûts — sur des cartes papier remplies sur le terrain. L'étude IJRISS 2025 a révélé que l'IA multimodale atteignait une précision de 87,92 % sur des documents originaux, pliés, froissés et mouillés, surpassant nettement l'OCR traditionnel. L'écriture en caractères d'imprimerie clairs est très fiable (95 %+) ; l'écriture cursive rapide avec des chiffres ambigus (1 vs 7, 4 vs 9) reste le cas le plus difficile. L'IA utilise le contexte — en-têtes de colonnes par jour, étiquettes de lignes, structure de la grille — pour lever l'ambiguïté des caractères qu'un moteur OCR traditionnel devinerait. La différence pratique : au lieu de saisir chaque champ à la main, vous vérifiez une feuille de calcul pré-remplie et corrigez l'entrée ambiguë occasionnelle.
En quoi l'extraction de feuilles de temps diffère-t-elle de QuickBooks Time ou ADP ?
QuickBooks Time et ADP Workforce Now sont des applications de suivi du temps — les employés pointent numériquement, et les heures sont directement transmises à la paie. Elles empêchent la création de feuilles de temps papier à la source. L'extraction de feuilles de temps traite les feuilles de temps papier qui existent déjà — provenant de sous-traitants, d'agences de personnel, d'équipes de terrain sans accès à l'application, ou d'archives. Elles résolvent des problèmes différents : l'application est en amont (capture), l'outil d'extraction est en aval (traitement de ce qui a été capturé sur papier). De nombreuses organisations utilisent les deux : les applications de suivi du temps pour les employés directs, l'extraction pour les feuilles de temps provenant de sources externes qui arrivent sur papier, quel que soit l'outil déployé.
L'extraction de feuilles de temps gère-t-elle automatiquement les calculs d'heures supplémentaires ?
Oui, lorsque l'outil prend en charge les colonnes calculées. Vous définissez une colonne comme « Heures supplémentaires (heures > 40/semaine → 1,5×) » et l'IA additionne les entrées quotidiennes par travailleur, détermine quelles heures dépassent le seuil et génère le total des heures supplémentaires. Les règles d'heures supplémentaires dans la construction sont spécifiques à chaque juridiction — la loi fédérale Davis-Bacon exige 1,5× après 40 heures/semaine, la Californie exige 1,5× après 8 heures/jour et 40 heures/semaine avec double temps après 12 heures/jour, et les conventions collectives peuvent ajouter des seuils entièrement différents. Un outil doté de la fonctionnalité de colonnes calculées vous permet d'encoder les règles applicables à vos projets et de laisser l'IA calculer le résultat pendant l'extraction, éliminant ainsi l'étape de calcul dans la feuille de calcul après extraction.
Que se passe-t-il lorsqu'un travailleur répartit son temps entre plusieurs projets ou codes de coûts ?
Si la feuille de temps papier capture la répartition — par exemple, « Projet A : 4 heures, Projet B : 4 heures » — l'outil d'extraction lit les deux affectations et génère deux lignes distinctes pour ce travailleur, chacune avec le bon code de projet et les bonnes heures. Si la feuille de temps papier ne capture pas la répartition et n'affiche que « 8 heures », l'outil d'extraction génère ce qui figure sur la carte — il n'inventera pas une répartition. Cela met en évidence un problème structurel : l'outil d'extraction ne peut être qu'aussi précis que la feuille de temps qu'il lit. La cause la plus courante des répartitions de codes de coûts manquantes est que le chef d'équipe ou le travailleur ne les a pas enregistrées sur le document source, et non une défaillance de la technologie d'extraction.
L'extraction peut-elle produire un formulaire de paie certifiée WH-347 complet ?
Non — et aucun outil ne devrait le prétendre, car le WH-347 exige une déclaration de conformité signée attestant l'exactitude des salaires déclarés, ce qui relève de la responsabilité légale de l'entrepreneur en vertu de la Loi Davis-Bacon. Ce que fournit l'extraction, c'est les données structurées dont le formulaire a besoin : nom du travailleur, classification, heures quotidiennes (régulières et supplémentaires), taux de rémunération et identification du projet — dans un format pouvant remplir les champs du WH-347 ou s'importer directement dans un logiciel de paie certifiée comme LCPtracker, eMars ou Miter. L'étape de certification reste l'obligation de l'entrepreneur, mais l'étape de saisie des données, source de la plupart des erreurs de conformité, est éliminée.
Les données extraites peuvent-elles alimenter Sage 300 CRE ou Viewpoint Vista ?
Oui. Sage 300 CRE, Viewpoint Vista, Foundation et HCSS HeavyBid acceptent tous les imports structurés Excel ou CSV. Le résultat de l'extraction est un fichier XLSX ou CSV standard avec des en-têtes de colonnes cohérents — le même format que ces ERP de construction importent. La condition clé est que la structure des colonnes de sortie corresponde à ce que votre ERP attend. Si Sage attend « Job Code » et que votre colonne d'extraction est « Project Number », vous renommez l'en-tête avant l'import. Les heures, classifications, codes de coûts et affectations de projet sont correctement renseignés ; vous mappez des noms de colonnes, vous ne ressaisissez pas les données.
Quelle est la différence de précision entre l'extraction par IA et la saisie manuelle des données ?
L'extraction par IA atteint une précision de 85 à 99 % au niveau des champs selon la qualité des documents — 95 à 99 % sur des PDF imprimés propres, 85 à 95 % sur des fiches manuscrites. La saisie manuelle comporte un taux d'erreur de 1 à 3 % par champ saisi, mais contrairement aux erreurs d'extraction (visibles pour examen), les erreurs de saisie manuelle restent invisibles jusqu'à ce qu'un litige de paie les révèle. Une feuille de temps hebdomadaire avec 60 champs a une probabilité de 45 à 83 % de contenir au moins une erreur de frappe. L'avantage structurel de l'extraction n'est pas nécessairement une précision brute supérieure — c'est que les erreurs sont remontées pour examen plutôt qu'enterrées dans un cycle de paie.
Ai-je besoin d'une extraction si tous mes employés utilisent une application de suivi du temps ?
Pas pour ces employés. Les applications de suivi du temps produisent des données numériques structurées qui alimentent la paie nativement — l'extraction n'apporte aucune valeur à un pointage numérique. L'extraction est pertinente lorsque votre pipeline de paie inclut des feuilles de temps provenant de sources qui n'utilisent pas votre application : sous-traitants avec leurs propres systèmes papier, agences d'intérim qui envoient des PDF par e-mail, équipes terrain sur des chantiers sans service cellulaire fiable, ou dossiers papier hérités à numériser. Si 100 % de votre main-d'œuvre pointe numériquement, vous n'avez pas besoin d'extraction de feuilles de temps. La plupart des organisations de plus de 20 travailleurs terrain sont loin d'une adoption 100 % numérique — et c'est cet écart que l'extraction comble en remplaçant la saisie manuelle.
Quels formats de fichiers les outils d'extraction de feuilles de temps acceptent-ils ?
La plupart des outils d'extraction par IA acceptent les formats JPG, PNG, PDF et WebP — couvrant les photos de téléphone, les documents scannés et les PDF générés numériquement. Certains acceptent également le TIFF (courant dans la numérisation d'entreprise) et l'AVIF. La capacité essentielle est la gestion des photos de téléphone — car la source la plus courante de feuilles de temps papier en 2026 est un chef d'équipe qui photographie une carte d'équipe avec un smartphone et l'envoie par SMS ou e-mail au bureau. Un outil qui exige des documents scannés à plat, redressés, à 300 DPI résout un problème de 2015. L'entrée réelle est une photo de téléphone légèrement inclinée et à éclairage inégal — et l'extraction doit fonctionner dessus sans prétraitement.
Combien coûte l'extraction de feuilles de temps par rapport à la saisie manuelle ?
Les outils d'extraction par IA coûtent généralement 9 à 39 $/mois pour les utilisateurs individuels ou 39 à 99 $/mois pour les petites équipes, avec des paliers basés sur l'utilisation à des volumes plus élevés. Comparez cela au coût de la saisie manuelle : à 3 minutes par feuille de temps et un taux de commis à la paie entièrement chargé de 25 $/heure, le traitement de 100 feuilles de temps par semaine coûte 125 $/semaine ou 6 500 $/an en main-d'œuvre seule — avant de tenir compte du coût d'erreur de paie de 1 à 8 % identifié par l'American Payroll Association (APA). À ces volumes, l'extraction atteint le seuil de rentabilité financière dès le premier mois. La comparaison des coûts devient plus spectaculaire lorsque vous incluez l'exposition à la conformité : une seule violation de la loi Davis-Bacon peut coûter plus qu'une décennie d'abonnements à des outils d'extraction.
De la feuille de temps au traitement de la paie
L'extraction de feuilles de temps ne vise pas à remplacer votre logiciel de paie — ADP, Sage, Viewpoint et Paychex font bien leur travail. Il s'agit de combler l'écart entre l'endroit où les données de temps sont générées (une carte papier, une photo de téléphone, un PDF de sous-traitant) et l'endroit où elles doivent aboutir (une ligne structurée dans votre système de paie, une ligne sur un WH-347, une répartition des coûts dans votre registre des coûts de chantier).
Cet écart est actuellement comblé par des saisies manuelles — chacune comportant un risque d'erreur de 1 à 3 %, multiplié par des centaines de champs à chaque traitement de paie, avec des coûts qui s'accumulent, des corrections de paie aux violations de conformité, en passant par des données de coûts de chantier corrompues qui produisent des estimations erronées pour la prochaine soumission. La technologie pour lire une feuille de temps — comprendre sa structure en grille, déchiffrer l'écriture manuscrite sur le chantier, préserver les classifications de métier et générer des données structurées avec codes de coûts — existe aujourd'hui sans modèle, sans formation et quel que soit le format.
La meilleure façon d'évaluer si l'extraction s'intègre à votre flux de paie est de la tester sur vos véritables feuilles de temps — en particulier celles que vous redoutez de traiter à chaque période de paie. Téléchargez un échantillon de feuille de temps et voyez les données structurées que vous obtenez — ou utilisez la démo intégrée ci-dessus pour essayer l'extraction dès maintenant avec le préréglage de feuille de temps.