La guía completa para la extracción de
datos de hojas de tiempo (2026)
Cuando el Departamento de Trabajo de EE. UU. estima que completar un formulario de nómina certificada WH-347 toma 55 minutos para solo ocho empleados, y la American Payroll Association sitúa las tasas de error manual en hojas de tiempo en 1–8% de la nómina total, la brecha entre una tarjeta de tiempo en papel y un ciclo de nómina ya no es solo un inconveniente: es una pérdida cuantificable en presupuestos laborales, precisión de costos de trabajo y cumplimiento normativo. La extracción de datos de hojas de tiempo es la tecnología que cierra esa brecha: lee nombres de empleados, horas, códigos de proyecto y horas extra de cualquier formato de hoja de tiempo (impreso o manuscrito) y genera datos estructurados que su sistema de nómina puede consumir directamente, sin una sola pulsación de tecla de transcripción manual.
Conclusiones clave
- Una hoja de tiempo de cuadrilla de construcción con 60 campos tiene una probabilidad del 45–83% de contener al menos un error de tecleo, por hoja, por semana, antes de que siquiera comiencen los cálculos de horas extra.
- La APA estima que los errores manuales en hojas de tiempo generan una pérdida del 1–8% de la nómina total, pero el daño más profundo es invisible: cada hora mal tecleada corrompe los datos de costos de trabajo que alimentan su próxima oferta.
- No necesita un capturista de datos más rápido: necesita reemplazar 240 pulsaciones de tecla por lote con un paso de revisión que verifique solo el 5–15% de los campos sobre los que la IA no está segura, convirtiendo a su equipo de nómina de creadores de datos en verificadores de datos.
Qué es la extracción de datos de hojas de tiempo (y qué no es)
La extracción de datos de hojas de tiempo es el proceso automatizado de leer campos estructurados — nombre del empleado, fechas trabajadas, horas diarias (regulares y extras), códigos de proyecto, códigos de costo y aprobaciones — de una hoja de tiempo en papel o digital y convertirlos en una tabla organizada que su sistema de nómina pueda importar. No es una aplicación de seguimiento de tiempo.
Esa distinción es el punto de confusión más común, y entenderla correctamente determina si resuelve su problema real o compra algo que no toca la pila de papeles en su escritorio. QuickBooks Time, ADP Workforce Now, Procore Timecard, Raken y herramientas similares son aplicaciones de seguimiento de tiempo: los empleados registran entrada y salida digitalmente, y las horas fluyen directamente a la nómina. Evitan que se creen hojas de tiempo en papel en el origen. La extracción de hojas de tiempo resuelve el problema opuesto: la hoja de tiempo en papel ya existe — llenada por un capataz en un sitio de trabajo, enviada por fax por una agencia de personal, fotografiada por un trabajador de campo — y las horas deben pasar de esa tarjeta a su sistema de nómina sin que nadie las vuelva a escribir.
Para una explicación más profunda de cómo funciona esta tecnología y cuándo es la solución adecuada, consulte nuestra guía sobre qué es la extracción de datos de hojas de tiempo. El resto de este artículo asume que ya ha determinado que la extracción es la respuesta y se centra en cómo hacerlo bien — cubriendo todo, desde la selección de campos y el procesamiento por lotes hasta el cumplimiento de nómina certificada y la integración con el sistema de nómina.
Por qué importa la extracción de datos de hojas de tiempo
El costo del procesamiento manual de hojas de tiempo no es el salario de la persona que escribe. Es lo que sucede cuando esa escritura sale mal — y los datos sobre la frecuencia con la que sale mal son peores de lo que la mayoría de los gerentes de nómina suponen.
La American Payroll Association (APA) estima que los errores manuales en hojas de tiempo cuestan del 1 al 8% de la nómina total. Con un presupuesto laboral anual de $2 millones, eso son $20,000 a $160,000 en costos recuperables — cada año. El 2024 Financial Benchmarker de la Construction Financial Management Association (CFMA) encontró que solo la administración de costos consume un promedio de 5.4% de los ingresos del proyecto para contratistas generales de EE. UU. El principal impulsor no son las licencias de software ni los honorarios de consultoría; es la mano de obra de conciliar datos que deberían haber coincidido desde el principio — horas en una tarjeta de tiempo que no coinciden con las horas en la nómina porque alguien leyó mal un 4 como un 9.
Cada pulsación de tecla en la entrada manual de hojas de tiempo conlleva una tasa de error del 1–3%. Una sola hoja semanal de cuadrilla de construcción con 60 campos (5 trabajadores × 12 puntos de datos cada uno) significa que la probabilidad de al menos un error en ese lote es entre 45% y 83% — por hoja, por semana. Multiplique eso por 20 hojas de tiempo de subcontratistas y un año de ciclos de nómina, y la pregunta no es si existen errores en sus datos de nómina, sino cuántos pasan desapercibidos.
La dimensión de cumplimiento amplifica aún más estos costos. En proyectos de construcción financiados federalmente sujetos a la Ley Davis-Bacon, una sola clasificación de oficio mal clasificada o una hora mal escrita en un informe de nómina certificada puede desencadenar sanciones de hasta $13,508 por violación. La propia estimación del Departamento de Trabajo de 55 minutos para completar el Formulario WH-347 para solo 8 empleados significa que un proyecto de 40 personas puede consumir más de 4.5 horas de tiempo administrativo de nómina por semana solo en el formulario — antes de contabilizar la entrada de datos que lo alimenta.
El problema estructural: la entrada manual de hojas de tiempo conlleva una tasa de error que se agrava con el volumen, mientras que las consecuencias de cumplimiento y costos se agravan con el tiempo. La extracción no elimina la necesidad de revisión, pero cambia el rol del equipo de nómina de capturista de datos a revisor de datos, lo cual es un perfil de riesgo fundamentalmente diferente.
Los Desafíos Únicos de los Datos de Hojas de Tiempo
Las hojas de tiempo no son facturas. No son recibos. Presentan una serie de desafíos estructurales que las hacen particularmente difíciles de extraer — y particularmente valiosas de procesar correctamente.
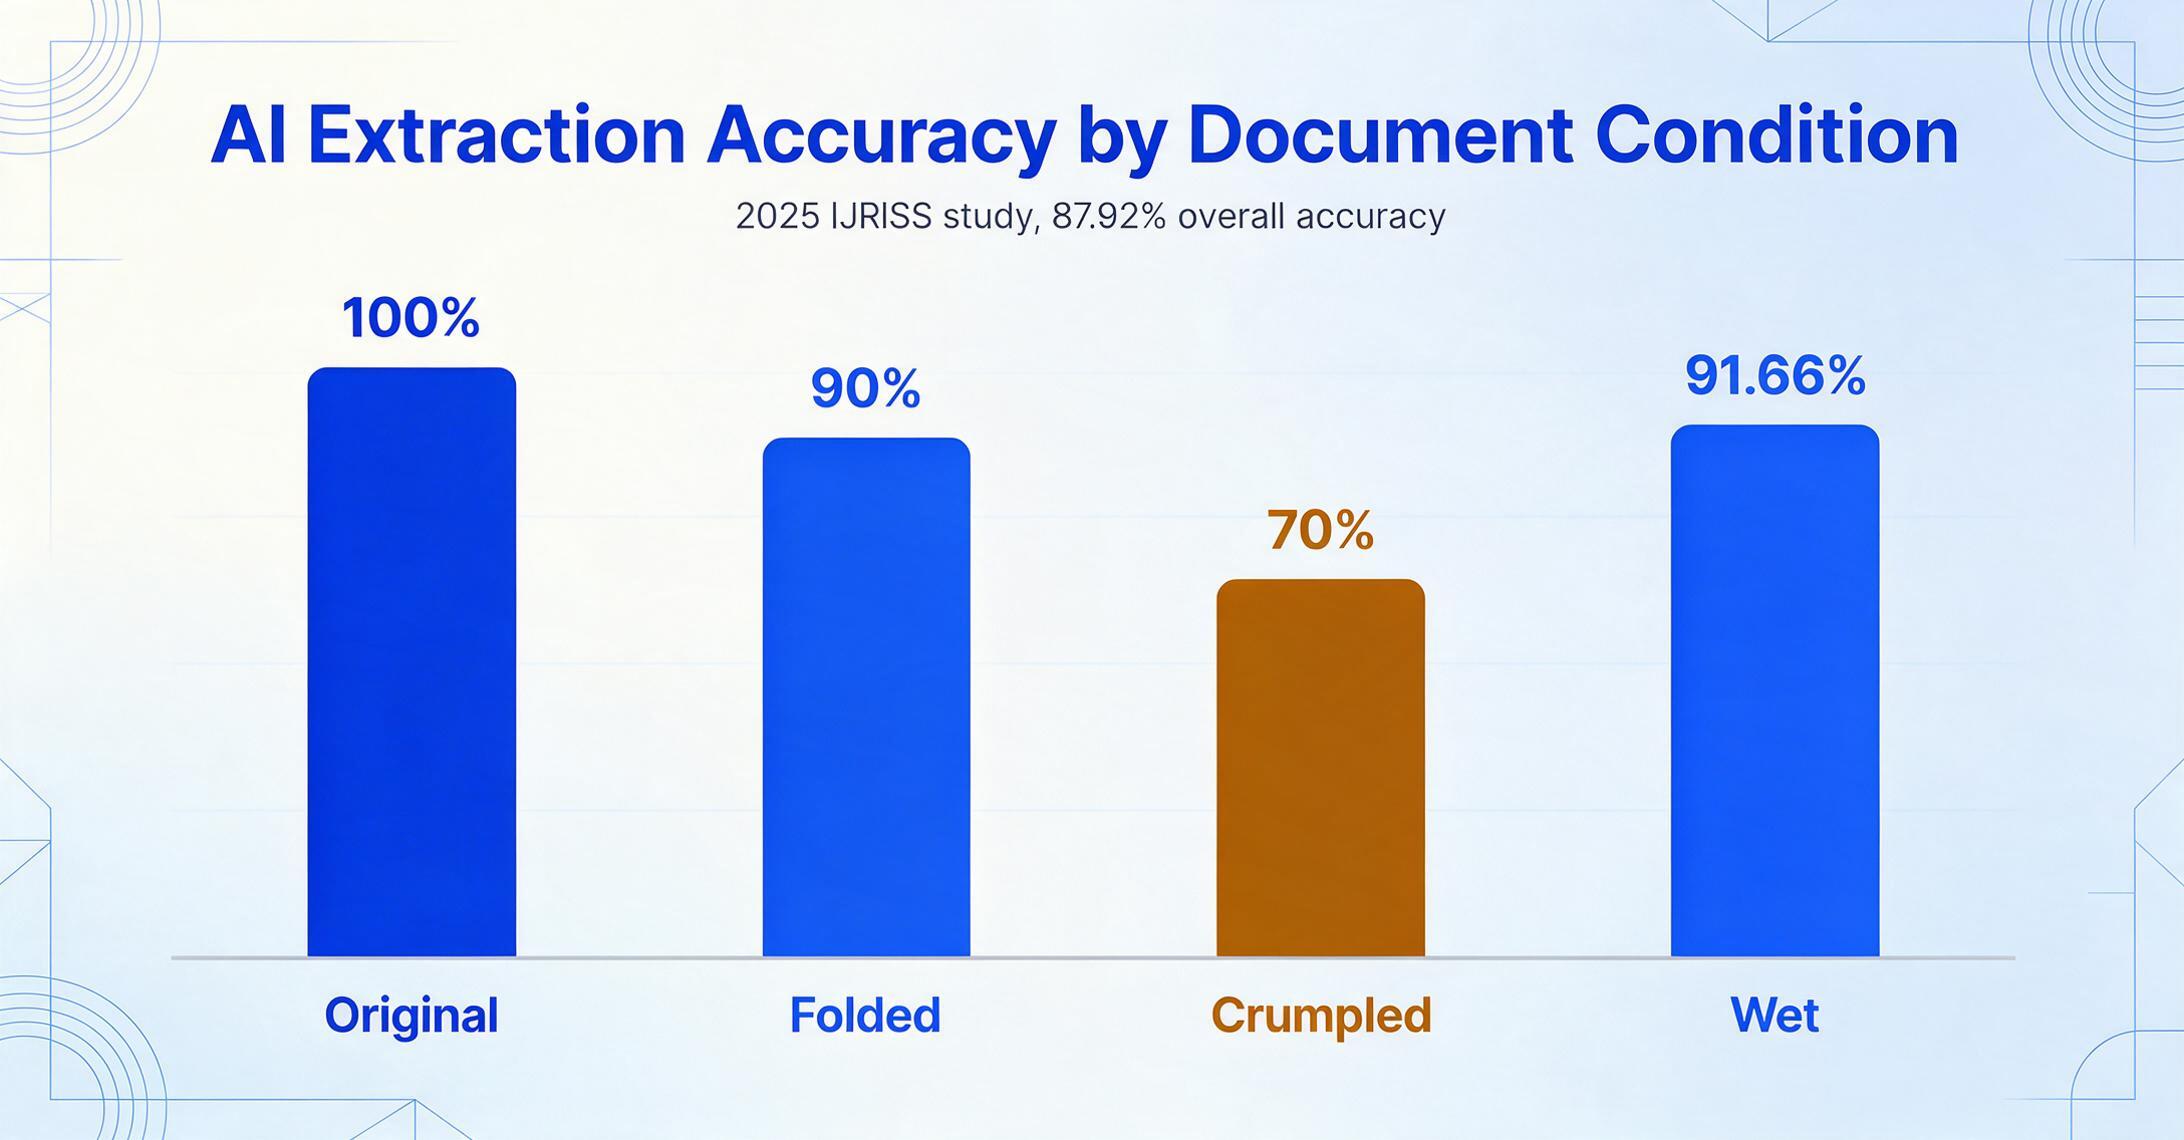
La escritura a mano es la norma, no la excepción. Las tarjetas de tiempo de obra, los registros de servicio de campo y las hojas de tiempo de agencias de personal se llenan a mano — a menudo en la cabina de un camión, sobre la compuerta trasera o al final de un turno de 10 horas. El estudio IJRISS 2025 sobre OCR de hojas de tiempo impulsado por IA probó la extracción multimodal en cuatro estados de degradación del documento — original (100% de precisión), doblado (90%), arrugado (70%) y mojado (91.66%) — logrando una precisión general del 87.92%, una mejora de 12 a 47 puntos porcentuales sobre el OCR tradicional. Una herramienta de extracción que solo maneja PDFs limpios e impresos resuelve el 30–40% fácil del problema. El resto escrito a mano es donde residen los costos de entrada manual.
Estructura de tabla, no estructura de formulario. La mayoría de las herramientas de extracción de documentos están diseñadas para formularios: una etiqueta, un valor. "Número de factura: INV-12345" es un campo de formulario. Una hoja de tiempo es una cuadrícula — nombres de empleados en la columna izquierda, lunes a domingo en la parte superior, valores de horas en las celdas de intersección. La herramienta debe entender que el "8" en la fila 3, columna 4 son las horas regulares del miércoles de John Smith — y que esta relación debe preservarse en la salida ya sea que la cuadrícula tenga 5 o 14 columnas, ya sea que el encabezado diga "Mié" o "Miércoles" o "M," y ya sea que la etiqueta de fila sea "John Smith" o "Smith, J." Los enfoques basados en plantillas fallan cuando cambia el diseño de la cuadrícula; la extracción semántica lee la estructura al comprender qué representa cada celda, no dónde se encuentra.
Los códigos de proyecto y costo multiplican la complejidad de la extracción. Un empleado de nómina que lee una hoja de tiempo podría ver "8 horas" y escribir una fila. Pero ese "8" podría necesitar dividirse entre tres códigos de costo (03 30 00 — Concreto, 03 24 00 — Acero de refuerzo, 03 00 00 — General) con diferentes clasificaciones y potencialmente diferentes tasas salariales. En un proyecto bajo la Ley Davis-Bacon, el DOL exige que los trabajadores que realizan más de una clasificación muestren un desglose preciso de horas por clasificación. La salida de extracción debe ser capaz de producir múltiples filas por trabajador — no colapsar todo en una sola.
La lógica de horas extra varía según la jurisdicción. Los proyectos federales Davis-Bacon requieren horas extra a 1.5× después de 40 horas por semana. California requiere 1.5× después de 8 horas por día y después de 40 horas por semana, con tiempo doble después de 12 horas en un día. Los convenios sindicales pueden añadir umbrales completamente diferentes además de ambos. Una herramienta de extracción que solo lee lo que está escrito en la tarjeta — y no puede calcular horas extra a partir de los totales de horas diarias — deja la parte más difícil del cálculo de nómina en el escritorio donde empezó.
La asignación multiproyecto difumina el límite del período de pago. Un solo trabajador podría registrar horas en tres proyectos diferentes en una semana, cada uno con diferentes determinaciones salariales, diferentes códigos de costo y diferentes requisitos de informes de nómina certificada. La hoja de tiempo puede o no capturar estas divisiones con claridad — pero el proceso de nómina debe reflejarlas con precisión, porque un trabajador pagado con una determinación salarial incorrecta es un fallo de cumplimiento independientemente de si la hoja de tiempo era ambigua.
Métodos tradicionales vs. Extracción con IA
Tres enfoques dominan el proceso de hoja de tiempo a nómina hoy en día. Solo uno de ellos está diseñado para el volumen, la variedad y los riesgos de cumplimiento que la mayoría de las organizaciones realmente enfrentan.
| Ingreso Manual de Datos | OCR Basado en Plantillas | Extracción Semántica con IA | |
|---|---|---|---|
| Cómo funciona | El empleado de nómina lee la tarjeta de papel y escribe cada campo en el sistema de nómina | El OCR lee caracteres desde una posición predefinida; requiere una plantilla de análisis por cada formato de hoja de tiempo | La IA de visión lee el documento de forma integral, comprendiendo nombres, horas y códigos por significado, no por posición |
| ¿Maneja escritura a mano? | Sí (una persona la descifra) | Mal — el OCR tradicional baja a <50% con letra cursiva | Sí — 85–95% a nivel de campo con escritura a mano, 87.92% en condiciones degradadas |
| ¿Maneja cambios de formato? | Sí (una persona se adapta) | No — cada formato nuevo requiere una plantilla nueva | Sí — independiente del formato, lee cualquier diseño al primer encuentro |
| ¿Maneja cuadrículas de tablas? | Sí (una persona lee la cuadrícula) | Parcial — a menudo pierde las relaciones fila-columna | Sí — conserva la estructura de la cuadrícula, el contexto de las filas y los encabezados de columna |
| Tiempo de procesamiento por hoja de tiempo | 2–5 minutos | 10–30 segundos (después de crear la plantilla) | 5–10 segundos |
| Esfuerzo de configuración | Cero (por hoja de tiempo); tiempo de capacitación por cada empleado nuevo | Alto — crear y mantener una plantilla por formato, por proveedor, por cambio de diseño | Casi cero — definir las columnas de salida una vez; reutilizar en todos los formatos y fuentes |
| Perfil de errores | 1–3% por campo escrito; invisible hasta que surge una disputa de pago | Depende de la calidad de la plantilla; falla silenciosamente cuando cambia el diseño | 1–5% a nivel de campo; los errores son visibles para revisión humana antes de ejecutar la nómina |
| ¿Escala con el volumen? | No — costo lineal por hoja de tiempo | No — el mantenimiento de plantillas escala con la diversidad de formatos | Sí — costo marginal casi nulo después de la definición inicial de columnas |
| Ideal para | 1–5 hojas de tiempo por semana, formato único | Hojas de tiempo digitales de alto volumen y formato único de una sola fuente | Hojas de tiempo manuscritas e impresas de formatos mixtos y múltiples fuentes; entornos sensibles al cumplimiento normativo |
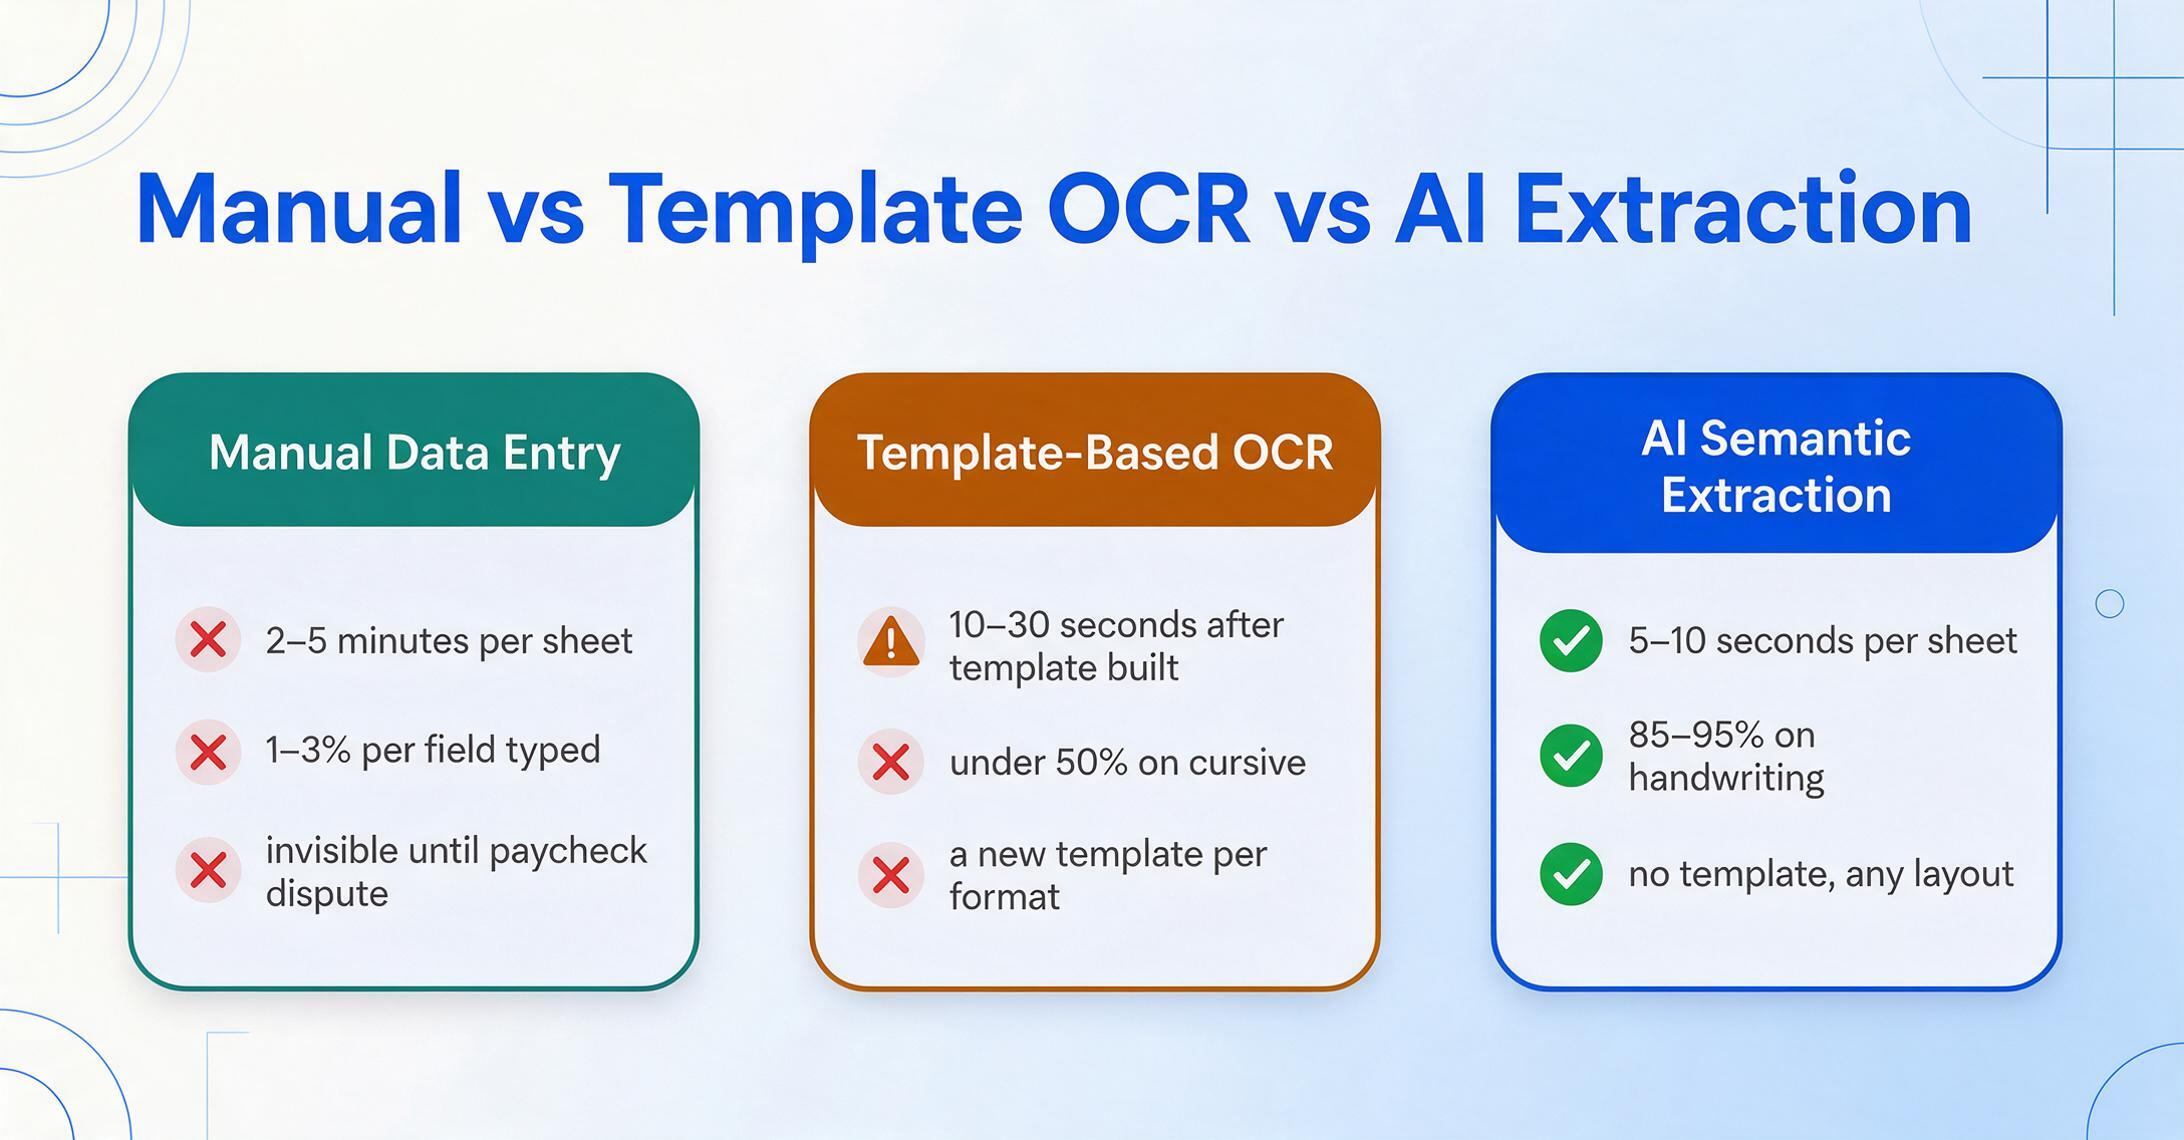
La idea clave: el OCR basado en plantillas falla exactamente en el punto donde la mayoría de las organizaciones más necesitan la extracción. Si todas tus hojas de tiempo provienen de una sola fuente con un mismo formato, no necesitas extracción en absoluto — ya tienes un proceso digital estandarizado. La extracción se necesita precisamente cuando los formatos varían: cinco subcontratistas que envían cinco diseños distintos de hojas de tiempo, una agencia de personal con su propio formato PDF, una tarjeta de papel heredada de un equipo que no usa aplicaciones. Cada formato nuevo rompe un sistema basado en plantillas. Un sistema sin plantilla los lee todos con la misma definición de columnas — porque localiza "Nombre del Empleado" entendiendo cómo se ve un nombre de empleado, no esperándolo en coordenadas (120, 45).
Esta es la decisión de arquitectura que determina si la extracción reduce tu carga de trabajo o simplemente la traslada: extracción basada en posición (¿dónde están los datos?) vs extracción basada en semántica (¿qué significan los datos?). Las herramientas de la primera categoría — la mayoría de los sistemas OCR y zonales heredados — requieren que mantengas un mapa de dónde vive cada campo en cada variante de documento. Las herramientas de la segunda categoría — plataformas modernas de visión por IA — leen los documentos como lo haría una persona: entendiendo el contenido, no comparando coordenadas. Si procesas hojas de tiempo de más de tres fuentes distintas, solo el costo de mantener plantillas puede superar el costo de la captura manual en un año. Para una comparación más profunda, nuestra guía de definición sobre extracción de hojas de tiempo cubre la capa tecnológica en detalle.
Los archivos se procesan de forma segura y no se almacenan.
Campos clave para la extracción de hojas de tiempo
Los campos que extrae dependen de adónde se dirigen los datos: una ejecución de nómina simple necesita menos campos que un informe de nómina certificada Davis-Bacon, que necesita menos campos que una hoja de cálculo completa de asignación de costos de trabajo. Defina sus columnas de salida según los requisitos de su sistema downstream, no según el diseño de la hoja de tiempo.
Empleado y período
- Nombre del empleado
- ID del empleado / número de insignia
- Fecha de fin de semana / período de pago
- Nombre y firma del supervisor
Cuadrícula de horas diarias
- Horas regulares: de lunes a domingo
- Horas extra (1.5× y 2×)
- Deducciones por descanso / período de comida
- Horas de enfermedad / vacaciones / feriados
Proyecto y asignación de costos
- Código de proyecto / número de trabajo
- Código de costo / código de fase
- Clasificación de oficio / especialidad
- Descripción del trabajo / tarea
Nómina y cumplimiento
- Tarifa por hora / tarifa de pago
- Total de horas regulares
- Total de horas extra
- Tarifa de beneficios adicionales
- Número de determinación de salario prevaleciente
La herramienta de extracción que elija debe permitirle definir columnas una vez y aplicarlas a todos los formatos de hojas de tiempo que reciba su organización. Este enfoque, llamado Extracción de Columnas Personalizadas, significa que usted define la estructura de salida según lo que su sistema de nómina o ERP necesita, no según lo que proporciona cada hoja de tiempo individual. Una columna de nombre de trabajador en su salida capturará "John Smith" ya sea que la tarjeta fuente lo liste como "John Smith", "Smith, John" o "J. Smith" en la esquina superior izquierda: la IA resuelve cada variante a la misma columna de salida basándose en la comprensión semántica, no en la coincidencia posicional.
Procesamiento por lotes: cuando el volumen hace que la velocidad sea estructural
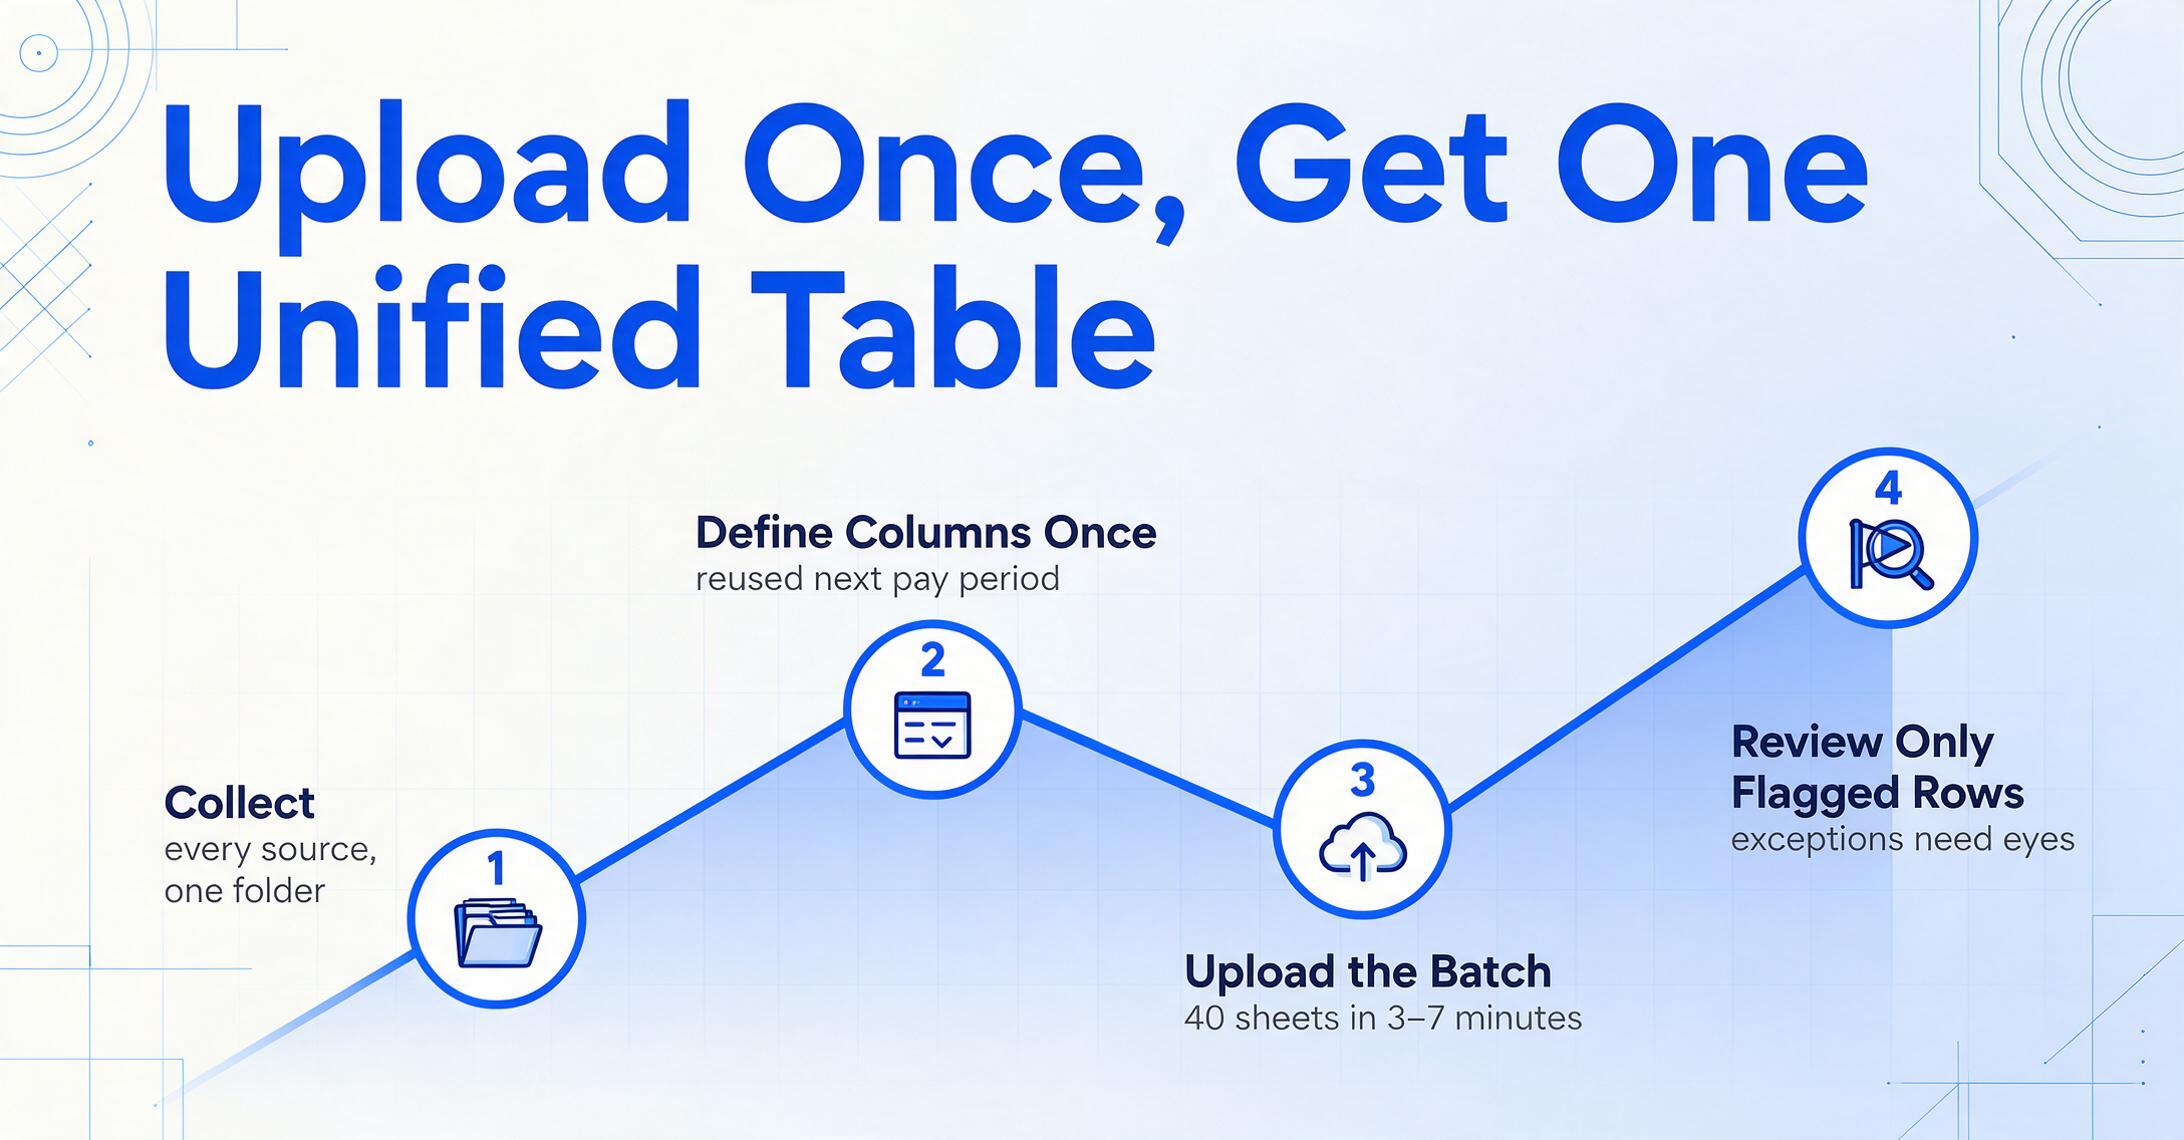
Procesar 40 hojas de tiempo una por una no es significativamente más rápido que la entrada manual si se considera el tiempo de abrir cada archivo, esperar el procesamiento, revisar los resultados y pasar al siguiente. El ahorro de tiempo se acumula solo cuando puedes subir las 40 a la vez y recibir una única hoja de cálculo unificada.
El procesamiento por lotes es la diferencia operativa entre "la extracción es una demo interesante" y "la extracción reemplazó la tarde del miércoles del empleado de nómina". El flujo de trabajo es sencillo:
Recopila todas las hojas de tiempo del período de pago
Fotografía las hojas en papel, reenvía los PDF por correo, descarga las exportaciones del portal: reúne cada hoja de tiempo en una sola carpeta sin importar su formato de origen. Sin clasificación previa, sin renombrar, sin estandarizar.
Define tus columnas de salida una vez
Configura la estructura de columnas que coincida con tu formato de importación de nómina: Nombre del empleado, Fecha, Código de proyecto, Horas regulares, Horas extra, Clasificación, Código de costo. Estas columnas se aplican a cada hoja de tiempo del lote sin importar su diseño. Guarda el conjunto de columnas como plantilla para reutilizarlo el próximo período.
Sube todas las hojas de tiempo y procesa como lote
Sube la carpeta completa de una vez. La herramienta procesa cada hoja de tiempo de forma independiente pero recopila todos los resultados en una tabla unificada: una fila por trabajador por hoja de tiempo, con columnas que coinciden con tu definición. Un lote de 40 hojas que tomaría 2–3 horas de entrada manual se completa en 3–7 minutos de tiempo de procesamiento.
Revisa los resultados marcados, no cada campo
En lugar de verificar 240 campos individuales (40 hojas × 6 campos), revisa solo las celdas que la IA marcó como inciertas, normalmente el 5–15% de los campos. Verifica por muestreo una selección aleatoria de extracciones confiables. El paso de revisión pasa de una verificación exhaustiva de entrada de datos a un control de calidad basado en excepciones.
La arquitectura de procesamiento por lotes prioritario es especialmente importante para los ciclos de nómina con plazos estrictos. Si las hojas de tiempo llegan el viernes por la tarde y la nómina debe presentarse el martes por la mañana, un proceso que requiere procesamiento secuencial es un proceso que falla durante la temporada de vacaciones. El procesamiento por lotes permite que la extracción se ejecute en segundo plano mientras el equipo de nómina revisa los resultados, paralelizando lo que antes era un flujo de trabajo serial y dependiente de una persona.
Exportación e Integración con Nómina/ERP
Los datos extraídos que viven en una hoja de cálculo que no puedes conectar a tu sistema de nómina son solo una forma diferente de ingreso manual. El paso de integración es donde la extracción entrega valor o se convierte en un proyecto de investigación.
La mayoría de las herramientas modernas de extracción exportan a Excel (XLSX) o CSV, formatos que todas las principales plataformas de nómina y ERP aceptan como fuente de importación. El factor crítico no es si la herramienta puede producir estos formatos (casi todas pueden), sino si la estructura de columnas de salida coincide con lo que tu sistema downstream espera. Si tu sistema de nómina importa "Employee ID" como encabezado de columna y tu salida de extracción lo etiqueta como "Worker Number", estás renombrando una columna antes de importar, no reescribiendo datos. La estructura es correcta; la convención de nombres es tuya para controlar.
Los ecosistemas de software para la integración de datos de hojas de tiempo se dividen en tres categorías:
| Categoría | Plataformas | Método de Integración | Caso de Uso Típico |
|---|---|---|---|
| Nómina General | ADP Workforce Now, Paychex Flex, QuickBooks Payroll, Gusto, Sage | Importación CSV/XLSX | Nómina horaria estándar para empleados directos; hojas de tiempo de agencias de personal y contratistas |
| ERP de Construcción | Sage 300 CRE, Viewpoint Vista, Foundation, HCSS HeavyBid, Procore | Importación CSV/XLSX con mapeo de código de costo y campos de proyecto | Asignación de costos por trabajo, nómina certificada, conciliación de tiempo de campo a oficina |
| Nómina Certificada | LCPtracker, eMars, Miter, Payroll4Construction | Importación CSV o integración directa | Generación de Formulario WH-347, cumplimiento de salario prevaleciente, informes sindicales |
Para equipos que trabajan en Google Sheets, algo común en operaciones de construcción y servicio de campo de pequeña y mediana escala, las herramientas de extracción con un complemento de Google Sheets eliminan por completo el paso de exportar-importar. Los datos extraídos llegan directamente a una pestaña de la hoja de cálculo, listos para importar a nómina o compartir con el equipo de contabilidad. Para organizaciones que procesan tipos de documentos variados más allá de las hojas de tiempo, la herramienta relacionada convertir hojas de tiempo a Excel maneja la extracción por lotes de formato único.
Si tu sistema de nómina o ERP requiere un orden de campos específico o una convención de nombres de columnas, verifica que la herramienta de extracción te permita nombrar columnas libremente; la mayoría lo permite, pero algunas generan automáticamente encabezados de columna a partir de las etiquetas de campos del documento, lo que produce nombres de columna inconsistentes cuando los formatos de hojas de tiempo varían dentro de un lote. Una herramienta que te permita definir y guardar plantillas de columnas asegura que la estructura de salida coincida con tu formato de importación cada período, sin importar cuántos formatos fuente diferentes haya en el lote.
Nómina certificada, salario prevaleciente y cumplimiento en la construcción
Para los contratistas de construcción que trabajan en proyectos financiados con fondos federales, la extracción de datos de hojas de tiempo no es solo una cuestión de eficiencia: es la diferencia entre una presentación de nómina certificada limpia y una infracción de cumplimiento que puede costar empleos, dinero y elegibilidad para licitaciones.
Según la Ley Davis-Bacon (40 U.S.C. § 3141 et seq.), cualquier contrato de construcción federal que supere los $2,000 exige que los contratistas paguen a los trabajadores las tarifas de salario prevaleciente locales y presenten informes de nómina certificada semanales — normalmente en el Formulario WH-347 — que documenten el nombre de cada trabajador, la clasificación de oficio, las horas trabajadas por día, la tarifa salarial y los beneficios complementarios. Treinta y dos estados añaden sus propias leyes de salario prevaleciente al marco federal, cada una con diferentes umbrales, métodos de cálculo y formatos de presentación.
Las instrucciones del DOL son explícitas: si un trabajador desempeñó labores en más de una clasificación durante la semana, la nómina certificada debe mostrar "un desglose preciso de las horas trabajadas en cada clasificación laboral". Cuando los datos de tiempo se originan como números escritos a mano en una tarjeta de papel — "John — Carpintero 3h, Peón 5h, Operador 2h" — el camino desde esa tarjeta hasta un WH-347 conforme pasa por la entrada manual de datos. Cada pulsación de tecla en ese camino conlleva la misma tasa de error del 1–3% que cualquier otra transcripción manual, pero las consecuencias son más severas: una hora mal clasificada se imputa a la tarifa salarial más alta aplicable para todas las horas; un patrón de errores puede desencadenar restitución de salarios atrasados, multas de hasta $13,508 por infracción y la inhabilitación para futuros contratos federales.
Cómo encaja la extracción en el flujo de trabajo de la nómina certificada:
Extraer la clasificación como campo de primera clase
Defina "Clasificación" como una columna en su plantilla de extracción. La IA lee el oficio o especialidad tal como aparece en la hoja de tiempo — "Carpintero", "Electricista", "Peón", "Operador" — y lo genera junto con las horas. Cuando un trabajador divide 3 horas como Electricista y 5 como Peón, obtiene dos filas con dos clasificaciones. La herramienta de extracción no asigna tarifas salariales (eso depende del número de determinación salarial del proyecto, que varía según el condado y el contrato), pero proporciona los datos de clasificación estructurados que el mapeo de tarifas salariales requiere.
Mapear los datos extraídos a los campos del Formulario WH-347
El resultado de la extracción proporciona el nombre del trabajador, la clasificación, las horas diarias (regulares y extras), la tarifa de pago y la identificación del proyecto — los campos principales que exige el Formulario WH-347. Estructurados en un CSV, estos datos pueden completar directamente el software de nómina certificada (LCPtracker, eMars, Miter), o servir como fuente verificada para el llenado manual del formulario. El paso que se elimina es la transcripción de papel a digital — el paso donde los errores de tecleo entran en la cadena de cumplimiento.
Mantener un rastro de auditoría digital
Según las regulaciones de la Ley Davis-Bacon (29 CFR Parte 3), los registros de nómina certificada deben conservarse durante al menos tres años después de la finalización del proyecto. La extracción crea un registro digital que incluye la foto de la hoja de tiempo original más los datos estructurados extraídos — un rastro de auditoría contemporáneo que los originales en papel por sí solos no pueden proporcionar. Si un auditor cuestiona una clasificación o un conteo de horas tres años después, puede mostrar el documento fuente y el resultado de extracción que coincide con él.
Lo que la extracción no hace: generar un Formulario WH-347 completo y firmado. La Declaración de Cumplimiento en la página 2 del formulario requiere la firma de un funcionario con conocimiento de la nómina — que certifique que los salarios son correctos, las clasificaciones son precisas y los beneficios complementarios fueron pagados. Esa certificación es la responsabilidad legal del contratista y no puede automatizarse. La extracción elimina los errores de entrada de datos que provocan certificaciones fallidas; no reemplaza la certificación en sí. Para el contexto regulatorio completo, consulte nuestra guía sobre extracción de hojas de tiempo en construcción.
El reporte sindical añade otra dimensión de cumplimiento. Las clasificaciones de oficios sindicales (Carpintero, Electricista, Peón, Operador de maquinaria pesada, Ferrallista, Plomero/Instalador de tuberías) no son solo categorías de nómina — son obligaciones contractuales con escalas salariales específicas, tasas de contribución a beneficios complementarios y proporciones de aprendiz a oficial. Cuando un capataz escribe "Joe — 8 horas" sin especificar que 3 de esas horas fueron de Carpintería Sindical y 5 de trabajo general, la herramienta de extracción solo puede generar lo que captura la tarjeta. La solución estructural no es una mejor extracción — es mejores tarjetas de tiempo. Exigir la clasificación en el documento fuente es la mejora de cumplimiento de mayor impacto que un contratista de construcción puede hacer, independientemente de la herramienta de procesamiento que utilice.
Qué buscar en una herramienta de extracción de hojas de tiempo
Las herramientas de extracción de hojas de tiempo van desde sistemas OCR heredados que requieren configuración de plantillas por formato hasta plataformas modernas de IA que leen semánticamente. Seis criterios separan las herramientas que reducen la carga de trabajo de nómina de las que simplemente mueven el trabajo de captura a otra pantalla.
1. Operación sin plantilla e independiente del formato. Este es el diferenciador más importante — porque los formatos de hojas de tiempo se multiplican con cada subcontratista, agencia de personal y cuadrilla de campo que se agrega a su operación. Una herramienta que requiere definir una plantilla de análisis por formato no es extracción; es gestión de plantillas. La extracción sin plantilla lee mediante comprensión semántica: una hoja de tiempo de una fuente que nunca ha procesado funciona en la primera carga. Pregunte al proveedor: "Si recibo una hoja de tiempo en un formato que nunca he visto, ¿funciona de inmediato?" Si la respuesta incluye "primero cree una plantilla de análisis", está comprando mantenimiento, no automatización.
2. Precisión de escritura a mano en condiciones reales. El video de demostración que muestra un PDF perfectamente escaneado no es la prueba. Pida probar con sus peores hojas de tiempo reales — la tarjeta de cuadrilla escrita a mano con clasificaciones en el margen, la tarjeta donde un 4 parece un 9, la foto tomada al anochecer en un sitio de trabajo. Una herramienta que solo maneja PDFs digitales limpios e impresos resuelve el 30–40% fácil de su volumen de hojas de tiempo — y deja el 60% difícil en su escritorio. El punto de referencia IJRISS 2025 de 87.92% de precisión en condiciones degradadas es una referencia útil, pero su propia prueba en el peor caso le dirá más que cualquier número publicado.
3. Preservación de la estructura de tablas y cuadrículas. Una hoja de tiempo es una cuadrícula, no un formulario. La herramienta debe comprender las relaciones fila-columna y preservarlas en la salida. Si la extracción ve "8" en una celda pero no puede decirle que son las horas regulares del martes de John Smith en la fila correcta, la salida es inutilizable para nómina. Pruebe con hojas de cuadrilla — una tarjeta que lista 6–12 trabajadores — y verifique que la salida produzca una fila por trabajador, con las horas de cada trabajador correctamente asignadas a las columnas de día correspondientes.
4. Arquitectura de procesamiento por lotes prioritario. Procesar hojas de tiempo una por una elimina el ahorro de tiempo que justifica usar extracción en primer lugar. La herramienta debe aceptar cargas por lotes (40+ archivos a la vez), procesarlos en paralelo y producir una tabla de salida unificada. Una herramienta diseñada para procesamiento de documentos individuales con capacidades de lote agregadas mostrará sus limitaciones bajo volumen real de nómina.
5. Soporte de columnas calculadas para horas extra y cálculos. La parte más lenta del procesamiento manual de hojas de tiempo no es transcribir horas — es calcular horas extra según reglas específicas de la jurisdicción. Una herramienta con columnas calculadas le permite definir una columna como "Horas OT (horas > 40/semana → 1.5×; horas > 8/día → 1.5×)" y la IA aplica el cálculo durante la extracción. Esto elimina el paso separado de cálculo en hoja de cálculo que típicamente sigue a la entrada manual de datos.
6. Exportación compatible con nómina con estructura de columnas consistente. La salida de extracción debe coincidir con lo que su sistema de nómina o ERP espera — tanto en formato de archivo (XLSX o CSV) como en estructura de columnas. Si tiene que reestructurar, reformatear o reordenar columnas antes de importar, la extracción ha acortado el paso de captura pero ha creado un nuevo paso de manipulación de datos. Las mejores herramientas le permiten guardar plantillas de columnas que producen una estructura de salida idéntica cada período de pago, sin importar cuántos formatos diferentes de hojas de tiempo haya en el lote fuente.
Preguntas Frecuentes
¿Puede la IA leer hojas de tiempo manuscritas con precisión?
Sí. Los modelos modernos de IA de visión leen datos de hojas de tiempo manuscritas — nombres, horas, clasificaciones, códigos de costo — en tarjetas de papel completadas en el campo. El estudio IJRISS de 2025 encontró que la IA multimodal logró un 87.92% de precisión en documentos originales, doblados, arrugados y mojados, superando sustancialmente al OCR tradicional. La letra de molde clara es altamente confiable (95%+); la cursiva apresurada con números ambiguos (1 vs. 7, 4 vs. 9) sigue siendo el caso más difícil. La IA utiliza el contexto — encabezados de columna por día de la semana, etiquetas de fila, estructura de cuadrícula — para desambiguar caracteres que un motor OCR tradicional adivinaría. La diferencia práctica: en lugar de escribir cada campo a mano, usted revisa una hoja de cálculo prellenada y corrige la entrada ambigua ocasional.
¿En qué se diferencia la extracción de hojas de tiempo de QuickBooks Time o ADP?
QuickBooks Time y ADP Workforce Now son aplicaciones de seguimiento de tiempo — los empleados registran entrada y salida digitalmente, y las horas fluyen directamente a la nómina. Previenen la creación de hojas de tiempo en papel desde el origen. La extracción de hojas de tiempo procesa hojas de tiempo en papel que ya existen — de subcontratistas, agencias de personal, cuadrillas de campo sin acceso a la aplicación, o registros heredados. Resuelven problemas diferentes: la aplicación es aguas arriba (captura), la herramienta de extracción es aguas abajo (procesamiento de lo capturado en papel). Muchas organizaciones usan ambas: aplicaciones de seguimiento de tiempo para empleados directos, extracción para hojas de tiempo de fuentes externas que llegan en papel independientemente de la aplicación que haya implementado.
¿La extracción de hojas de tiempo maneja cálculos de horas extra automáticamente?
Sí, cuando la herramienta admite columnas calculadas. Usted define una columna como "Horas OT (horas > 40/semana → 1.5×)" y la IA suma las entradas diarias por trabajador, determina qué horas cruzan el umbral y genera el total de horas extra. Las reglas de horas extra en construcción son específicas de cada jurisdicción — la Ley Davis-Bacon federal requiere 1.5× después de 40 horas/semana, California requiere 1.5× después de 8/día y 40/semana con tiempo doble después de 12/día, y los acuerdos sindicales pueden agregar umbrales completamente diferentes. Una herramienta con capacidad de columna calculada le permite codificar las reglas que aplican a sus proyectos y que la IA calcule el resultado durante la extracción, eliminando el paso de cálculo en hoja de cálculo posterior a la extracción.
¿Qué sucede cuando un trabajador divide su tiempo entre múltiples proyectos o códigos de costo?
Si la hoja de tiempo en papel captura la división — por ejemplo, "Proyecto A: 4 horas, Proyecto B: 4 horas" — la herramienta de extracción lee ambas asignaciones y genera dos filas separadas para ese trabajador, cada una con el código de proyecto y las horas correctos. Si la hoja de tiempo en papel no captura la división y solo muestra "8 horas," la herramienta de extracción genera lo que está en la tarjeta — no inventará una división. Esto resalta un problema estructural: la herramienta de extracción solo puede ser tan precisa como la hoja de tiempo que lee. La causa más común de divisiones de código de costo faltantes es que el capataz o el trabajador no las registren en el documento fuente, no una falla de la tecnología de extracción.
¿Puede la extracción producir un formulario de nómina certificada WH-347 completo?
No — y ninguna herramienta debería afirmar que puede, porque el WH-347 requiere una Declaración de Cumplimiento firmada que certifique la exactitud de los salarios reportados, lo cual es responsabilidad legal del contratista según la Ley Davis-Bacon. Lo que la extracción proporciona son los datos estructurados que el formulario necesita: nombre del trabajador, clasificación, horas diarias (regulares y extras), tarifa de pago e identificación del proyecto — en un formato que puede completar los campos del WH-347 o importarse directamente a software de nómina certificada como LCPtracker, eMars o Miter. El paso de certificación sigue siendo obligación del contratista, pero se elimina el paso de captura de datos que introduce la mayoría de los errores de cumplimiento.
¿Pueden los datos extraídos alimentar Sage 300 CRE o Viewpoint Vista?
Sí. Sage 300 CRE, Viewpoint Vista, Foundation y HCSS HeavyBid aceptan importaciones estructuradas de Excel o CSV. El resultado de la extracción es un archivo XLSX o CSV estándar con encabezados de columna consistentes — el mismo formato que importan estos ERP de construcción. El requisito clave es que la estructura de columnas de salida coincida con lo que su ERP espera. Si Sage espera "Código de trabajo" y su columna de extracción es "Número de proyecto", renombre el encabezado antes de importar. Las horas, clasificaciones, códigos de costo y asignaciones de proyecto se completan correctamente; está mapeando nombres de columnas, no volviendo a escribir datos.
¿Cuál es la diferencia de precisión entre la extracción con IA y la captura manual de datos?
La extracción con IA alcanza una precisión a nivel de campo del 85–99% según la calidad del documento — 95–99% en PDF impresos limpios, 85–95% en tarjetas de campo manuscritas. La captura manual de datos conlleva una tasa de error del 1–3% por campo escrito, pero a diferencia de los errores de extracción (que son visibles para revisión), los errores de captura manual son invisibles hasta que una disputa de pago los saca a la luz. Una hoja de tiempo semanal con 60 campos tiene una probabilidad del 45–83% de contener al menos un error de tecleo. La ventaja estructural de la extracción no es necesariamente una mayor precisión bruta — es que los errores salen a la superficie para revisión en lugar de quedar enterrados en una corrida de nómina.
¿Necesito extracción si todos mis empleados usan una aplicación de seguimiento de tiempo?
No para esos empleados. Las aplicaciones de seguimiento de tiempo producen datos digitales estructurados que fluyen a la nómina de forma nativa — la extracción no añade valor a un registro digital de entrada. La extracción es relevante cuando su flujo de nómina incluye hojas de tiempo de fuentes que no usan su aplicación: subcontratistas con sus propios sistemas en papel, agencias de personal que envían PDF por correo, cuadrillas de campo en sitios sin servicio celular confiable, o registros en papel heredados que necesita digitalizar. Si el 100% de su fuerza laboral registra su tiempo digitalmente, no necesita extracción de hojas de tiempo. La mayoría de las organizaciones con más de 20 trabajadores de campo están muy por debajo del 100% de adopción digital — y esa brecha es donde la extracción reemplaza la captura manual.
¿Qué formatos de archivo aceptan las herramientas de extracción de hojas de tiempo?
La mayoría de las herramientas de extracción con IA aceptan JPG, PNG, PDF y WebP, lo que cubre fotos de teléfono, documentos escaneados y PDF generados digitalmente. Algunas también aceptan TIFF (común en escaneo empresarial) y AVIF. La capacidad crítica es manejar fotos de teléfono, porque la fuente más común de hojas de tiempo en papel en 2026 es un capataz que fotografía una tarjeta de cuadrilla con un teléfono inteligente y la envía por mensaje de texto o correo electrónico a la oficina. Una herramienta que requiere documentos escaneados en plano, enderezados y a 300 DPI está resolviendo un problema de 2015. La entrada del mundo real es una foto de teléfono ligeramente inclinada y con iluminación desigual, y la extracción debería funcionar con eso sin preprocesamiento.
¿Cuánto cuesta la extracción de hojas de tiempo en comparación con la entrada manual?
Las herramientas de extracción con IA suelen costar entre $9 y $39 al mes para usuarios individuales, o entre $39 y $99 al mes para equipos pequeños, con niveles basados en el uso para volúmenes mayores. Compare esto con el costo de la entrada manual: a 3 minutos por hoja de tiempo y una tarifa de $25/hora para un empleado de nómina con carga completa, procesar 100 hojas de tiempo por semana cuesta $125/semana o $6,500/año solo en mano de obra, sin contar el costo del 1–8% de errores de nómina que identifica la APA. A esos volúmenes, la extracción alcanza el punto de equilibrio financiero en el primer mes. La comparación de costos se vuelve más dramática cuando se incluye la exposición al cumplimiento: una sola violación de la Ley Davis-Bacon puede costar más que una década de suscripciones a herramientas de extracción.
De la Tarjeta de Tiempo a la Ejecución de Nómina
La extracción de hojas de tiempo no se trata de reemplazar su software de nómina — ADP, Sage, Viewpoint y Paychex hacen bien su trabajo. Se trata de cerrar la brecha entre dónde se origina la información de tiempo (una tarjeta de papel, una foto de teléfono, un PDF de un subcontratista) y dónde debe llegar (una fila estructurada en su sistema de nómina, una línea en un WH-347, una asignación de costos en su libro de costos de trabajo).
Esa brecha actualmente se cubre con pulsaciones de teclas humanas — cada una con una probabilidad de error del 1–3%, multiplicada por cientos de campos por ejecución de nómina, con costos que se acumulan desde correcciones de nómina hasta violaciones de cumplimiento y datos de costos de trabajo corruptos que producen estimaciones incorrectas para la próxima licitación. La tecnología para leer una hoja de tiempo — entender su estructura de cuadrícula, descifrar la escritura a mano en el sitio de trabajo, preservar las clasificaciones de oficio y generar datos estructurados con códigos de costos — existe hoy sin plantillas, sin capacitación y en cualquier formato.
La mejor manera de evaluar si la extracción se ajusta a su flujo de trabajo de nómina es probarla con sus hojas de tiempo reales — particularmente las difíciles que teme procesar cada período de pago. Sube una hoja de tiempo de muestra y ve los datos estructurados que obtienes — o usa la demostración integrada arriba para probar la extracción ahora mismo con el ajuste preestablecido de hoja de tiempo.