Der vollständige Leitfaden zur Zeiterfassungs-
datenextraktion (2026)
Wenn das US-Arbeitsministerium schätzt, dass das Ausfüllen eines WH-347-Formulars für zertifizierte Lohnabrechnung 55 Minuten für nur acht Mitarbeiter dauert, und die American Payroll Association (APA) die manuelle Fehlerquote bei Stundenzetteln auf 1–8 % der gesamten Lohnsumme beziffert, ist die Kluft zwischen einem Papier-Stundenzettel und einer Lohnabrechnung kein bloßes Ärgernis mehr – sie ist eine quantifizierbare Belastung für Arbeitsbudgets, Auftragskostengenauigkeit und Compliance-Status. Zeiterfassungsdatenextraktion ist die Technologie, die diese Kluft schließt: Sie liest Mitarbeiternamen, Stunden, Projektcodes und Überstunden aus jedem Stundenzettelformat – gedruckt oder handschriftlich – und liefert strukturierte Daten, die Ihr Lohnabrechnungssystem direkt verarbeiten kann, ohne einen einzigen Tastendruck manueller Übertragung.
Wichtigste Erkenntnisse
- Ein 60-Felder-Stundenzettel für Bauarbeiter hat eine Wahrscheinlichkeit von 45–83 %, mindestens einen Tippfehler zu enthalten – pro Zettel, pro Woche, bevor die Überstundenberechnung überhaupt beginnt.
- Die APA schätzt, dass manuelle Stundenzettelfehler 1–8 % der gesamten Lohnsumme ausmachen, aber der tiefere Schaden ist unsichtbar: Jede falsch getippte Stunde verfälscht die Auftragskostendaten, die Ihr nächstes Angebot speisen.
- Sie brauchen keinen schnelleren Datenerfasser – Sie müssen 240 Tastatureingaben pro Stapel durch einen Prüfschritt ersetzen, der nur die 5–15 % der Felder kontrolliert, bei denen die KI unsicher ist, und Ihr Lohnabrechnungsteam so von Datenerstellern zu Datenprüfern macht.
Was ist Zeiterfassungsdatenextraktion (und was sie nicht ist)
Zeiterfassungsdatenextraktion ist der automatisierte Prozess, strukturierte Felder – Mitarbeitername, Arbeitstage, tägliche Stunden (regulär und Überstunden), Projektcodes, Kostencodes und Genehmigungen – aus einem Papier- oder digitalen Stundenzettel zu lesen und in eine organisierte Tabelle zu überführen, die Ihr Lohnabrechnungssystem importieren kann. Es ist keine Zeiterfassungs-App.
Diese Unterscheidung ist die häufigste Quelle von Verwirrung, und wenn Sie sie richtig treffen, entscheidet das, ob Sie Ihr eigentliches Problem lösen oder etwas kaufen, das den Papierstapel auf Ihrem Schreibtisch nicht anfasst. QuickBooks Time, ADP Workforce Now, Procore Timecard, Raken und ähnliche Tools sind Zeiterfassungs-Apps: Mitarbeiter stempeln digital ein und aus, und die Stunden fließen direkt in die Lohnabrechnung. Sie verhindern, dass Papierstundenzettel überhaupt entstehen. Zeiterfassungsextraktion löst das gegenteilige Problem: Der Papierstundenzettel existiert bereits – ausgefüllt von einem Vorarbeiter auf der Baustelle, gefaxt von einer Personalagentur, fotografiert von einem Außendienstmitarbeiter – und die Stunden müssen von dieser Karte in Ihr Lohnabrechnungssystem gelangen, ohne dass jemand sie abtippt.
Für eine ausführlichere Erklärung, wie diese Technologie funktioniert und wann sie die richtige Lösung ist, lesen Sie unseren Leitfaden zu was Zeiterfassungsdatenextraktion ist. Der Rest dieses Artikels geht davon aus, dass Sie bereits entschieden haben, dass Extraktion die Antwort ist, und konzentriert sich darauf, wie man es gut macht – von der Feldauswahl und Stapelverarbeitung bis zur Compliance bei zertifizierter Lohnabrechnung und der Integration in Lohnabrechnungssysteme.
Warum Zeiterfassungsdatenextraktion wichtig ist
Die Kosten der manuellen Stundenzettelverarbeitung sind nicht das Gehalt der Person, die tippt. Es ist das, was passiert, wenn das Tippen schiefgeht – und die Daten darüber, wie oft es schiefgeht, sind schlechter, als die meisten Lohnbuchhalter annehmen.
Die American Payroll Association (APA) schätzt, dass manuelle Stundenzettelfehler 1–8 % der gesamten Lohnkosten ausmachen. Bei einem jährlichen Arbeitsbudget von 2 Millionen US-Dollar sind das 20.000 bis 160.000 US-Dollar an vermeidbaren Kosten – jedes Jahr. Der 2024 Financial Benchmarker der Construction Financial Management Association (CFMA) ergab, dass allein die Kostenverwaltung durchschnittlich 5,4 % des Projektumsatzes für US-amerikanische Generalunternehmer verbraucht. Der Haupttreiber sind nicht Softwarelizenzen oder Beratungshonorare, sondern die Arbeit, Daten abzugleichen, die von Anfang an hätten übereinstimmen sollen – Stunden auf einer Stundenzettelkarte, die nicht mit den Stunden in der Lohnabrechnung übereinstimmen, weil jemand eine 4 als 9 gelesen hat.
Jeder Tastendruck bei der manuellen Stundenzettelerfassung trägt eine Fehlerquote von 1–3 %. Ein einzelnes wöchentliches Baustellenblatt mit 60 Feldern (5 Arbeiter × 12 Datenpunkte) bedeutet, dass die Wahrscheinlichkeit mindestens eines Fehlers in dieser Charge zwischen 45 % und 83 % liegt – pro Blatt, pro Woche. Multiplizieren Sie das mit 20 Subunternehmer-Stundenzetteln und einem Jahr Lohnabrechnungszyklen, und die Frage ist nicht, ob Fehler in Ihren Lohnabrechnungsdaten existieren, sondern wie viele unentdeckt bleiben.
Die Compliance-Dimension verstärkt diese Kosten weiter. Bei bundesfinanzierten Bauprojekten, die dem Davis-Bacon-Gesetz unterliegen, kann eine einzige falsch klassifizierte Gewerke oder ein falsch getippter Stundenzettel in einem zertifizierten Lohnbericht Strafen von bis zu 13.508 US-Dollar pro Verstoß auslösen. Die eigene Schätzung des Arbeitsministeriums von 55 Minuten für das Ausfüllen des Formulars WH-347 für nur 8 Mitarbeiter bedeutet, dass ein Projekt mit 40 Personen über 4,5 Stunden Lohnabrechnungsverwaltungszeit pro Woche allein für das Formular verbrauchen kann – bevor die Dateneingabe berücksichtigt wird, die es befüllt.
Das strukturelle Problem: Die manuelle Zeiterfassung weist eine Fehlerquote auf, die mit dem Volumen wächst, während die Compliance- und Kostenfolgen mit der Zeit zunehmen. Die Extraktion macht die Prüfung nicht überflüssig – aber sie verlagert die Rolle des Lohnabrechnungsteams vom Datenerfasser zum Datenprüfer, was ein grundlegend anderes Risikoprofil darstellt.
Die besonderen Herausforderungen von Zeiterfassungsdaten
Stundenzettel sind keine Rechnungen. Sie sind keine Belege. Sie weisen eine Reihe struktureller Herausforderungen auf, die ihre Extraktion besonders schwierig machen – und besonders wertvoll, wenn sie richtig gemacht wird.
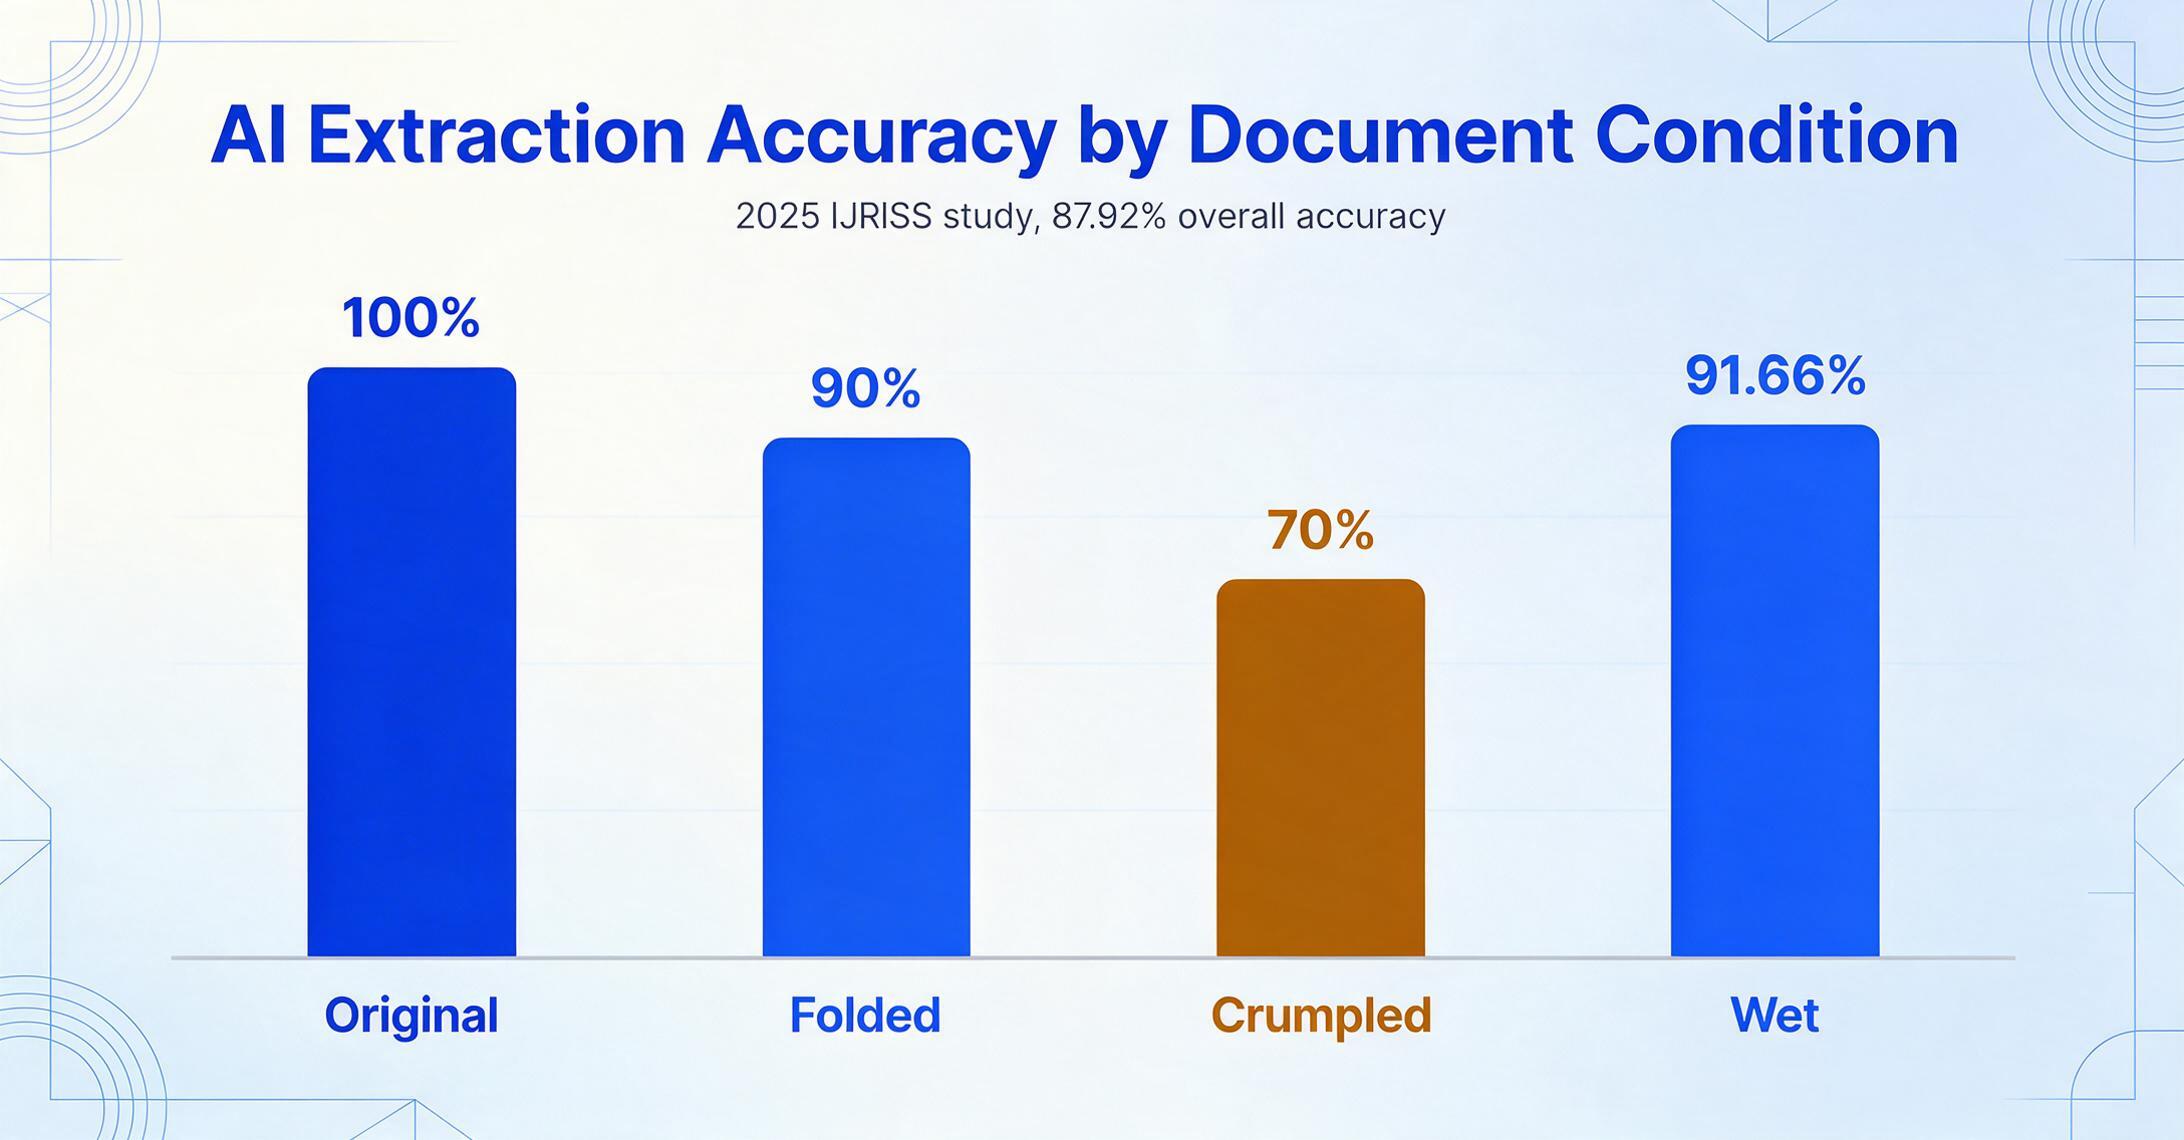
Handschrift ist die Norm, nicht die Ausnahme. Baustellen-Stundenzettel, Außendienstprotokolle und Zeiterfassungsbögen von Personaldienstleistern werden von Hand ausgefüllt – oft in einer Fahrerkabine, auf einer Ladeklappe oder am Ende einer 10-Stunden-Schicht. Die IJRISS-Studie 2025 zur KI-gestützten Stundenzettel-OCR testete multimodale Extraktion über vier Dokumentzustände hinweg – Original (100 % Genauigkeit), gefaltet (90 %), zerknittert (70 %) und nass (91,66 %) – und erreichte eine Gesamtgenauigkeit von 87,92 %, eine Verbesserung um 12–47 Prozentpunkte gegenüber herkömmlicher OCR. Ein Extraktionstool, das nur saubere, gedruckte PDFs verarbeitet, löst nur die einfachen 30–40 % des Problems. Der handschriftliche Rest ist der Bereich, in dem die Kosten der manuellen Erfassung entstehen.
Tabellenstruktur statt Formularstruktur. Die meisten Dokumentextraktionstools sind für Formulare ausgelegt: eine Bezeichnung, ein Wert. „Rechnungsnummer: INV-12345" ist ein Formularfeld. Ein Stundenzettel ist ein Raster – Mitarbeiternamen in der linken Spalte, Montag bis Sonntag in der Kopfzeile, Stundenwerte in den Schnittpunkten der Zellen. Das Tool muss verstehen, dass die „8" in Zeile 3, Spalte 4 die regulären Stunden von John Smith am Mittwoch sind – und dass diese Beziehung im Ergebnis erhalten bleiben muss, egal ob das Raster 5 oder 14 Spalten hat, ob die Kopfzeile „Mi" oder „Mittwoch" oder „M" lautet und ob die Zeilenbeschriftung „John Smith" oder „Smith, J." ist. Vorlagenbasierte Ansätze scheitern, wenn sich das Rasterlayout ändert; semantische Extraktion liest die Struktur, indem sie versteht, was jede Zelle darstellt, nicht wo sie sich befindet.
Projekt- und Kostencodes vervielfachen die Extraktionskomplexität. Ein Lohnbuchhalter, der einen Stundenzettel liest, sieht vielleicht „8 Stunden" und gibt eine Zeile ein. Aber diese „8" muss möglicherweise auf drei Kostencodes aufgeteilt werden (03 30 00 – Beton, 03 24 00 – Bewehrungsstahl, 03 00 00 – Allgemein) mit unterschiedlichen Klassifizierungen und möglicherweise unterschiedlichen Lohnsätzen. Bei einem Davis-Bacon-Projekt verlangt das Arbeitsministerium (DOL), dass Arbeitnehmer, die mehr als eine Klassifizierung ausüben, eine genaue Aufschlüsselung der Stunden nach Klassifizierung vorlegen. Das Extraktionsergebnis muss in der Lage sein, mehrere Zeilen pro Arbeitnehmer zu erzeugen – nicht alles in einer Zeile zusammenzufassen.
Die Überstundenlogik variiert je nach Rechtsgebiet. Bundesweite Davis-Bacon-Projekte erfordern Überstunden mit dem 1,5-fachen Satz nach 40 Stunden pro Woche. Kalifornien verlangt den 1,5-fachen Satz nach 8 Stunden pro Tag und nach 40 Stunden pro Woche, mit doppeltem Satz nach 12 Stunden an einem Tag. Gewerkschaftsvereinbarungen können darüber hinaus völlig andere Schwellenwerte festlegen. Ein Extraktionstool, das nur liest, was auf der Karte steht – und keine Überstunden aus den täglichen Stundensummen berechnen kann – lässt den schwierigsten Teil der Lohnabrechnung auf dem Schreibtisch liegen, wo er begonnen hat.
Die Zuordnung zu mehreren Projekten verwischt die Grenze des Abrechnungszeitraums. Ein einzelner Arbeiter könnte in einer Woche Stunden für drei verschiedene Projekte erfassen, jeweils mit unterschiedlichen Lohnfestsetzungen, unterschiedlichen Kostencodes und unterschiedlichen Anforderungen an die zertifizierte Lohnabrechnung. Der Stundenzettel erfasst diese Aufteilungen möglicherweise klar oder auch nicht – aber die Lohnabrechnung muss sie genau widerspiegeln, denn ein Arbeiter, der mit der falschen Lohnfestsetzung bezahlt wird, ist ein Compliance-Fehler, unabhängig davon, ob der Stundenzettel mehrdeutig war.
Traditionelle Methoden vs. KI-Extraktion
Drei Ansätze dominieren heute die Pipeline vom Stundenzettel zur Lohnabrechnung. Nur einer davon ist für das Volumen, die Vielfalt und die Compliance-Anforderungen ausgelegt, denen die meisten Organisationen tatsächlich gegenüberstehen.
| Manuelle Dateneingabe | Vorlagenbasierte OCR | KI-semantische Extraktion | |
|---|---|---|---|
| Funktionsweise | Lohnbuchhalter liest Papierkarte und tippt jedes Feld in das Lohnsystem ein | OCR liest Zeichen von einer vordefinierten Position; erfordert eine Parsing-Vorlage pro Zeiterfassungsformat | Vision-KI liest das Dokument ganzheitlich und versteht Namen, Stunden und Codes anhand der Bedeutung statt der Position |
| Handschrift geeignet? | Ja (Mensch entziffert sie) | Schlecht — herkömmliche OCR fällt bei Schreibschrift auf <50 % | Ja — 85–95 % auf Feldebene bei Handschrift, 87,92 % unter erschwerten Bedingungen |
| Formatänderungen geeignet? | Ja (Mensch passt sich an) | Nein — jedes neue Format erfordert eine neue Vorlage | Ja — formatunabhängig, liest jedes Layout beim ersten Kontakt |
| Tabellenraster geeignet? | Ja (Mensch liest das Raster) | Teilweise — verliert oft Zeilen-Spalten-Beziehungen | Ja — bewahrt Rasterstruktur, Zeilenkontext und Spaltenüberschriften |
| Verarbeitungszeit pro Zeiterfassung | 2–5 Minuten | 10–30 Sekunden (nach Vorlagenerstellung) | 5–10 Sekunden |
| Einrichtungsaufwand | Null (pro Zeiterfassung); Einarbeitungszeit pro neuem Sachbearbeiter | Hoch — Vorlage pro Format, Anbieter und Layoutänderung erstellen und pflegen | Nahezu null — Ausgabespalten einmal definieren; für alle Formate und Quellen wiederverwendbar |
| Fehlerprofil | 1–3 % pro eingegebenem Feld; unsichtbar bis zur Lohnstreitigkeit | Abhängig von der Vorlagenqualität; bricht still, wenn sich das Layout ändert | 1–5 % auf Feldebene; Fehler sind vor der Lohnabrechnung für die menschliche Prüfung sichtbar |
| Skalierbar mit Volumen? | Nein — lineare Kosten pro Zeiterfassung | Nein — Vorlagenpflege skaliert mit der Formatvielfalt | Ja — Grenzkosten nahezu null nach anfänglicher Spaltendefinition |
| Am besten geeignet für | 1–5 Zeiterfassungen pro Woche, ein Format | Hohes Volumen, ein Format, digitale Zeiterfassungen aus einer Quelle | Gemischte Formate, mehrere Quellen, handschriftliche und gedruckte Zeiterfassungen; compliance-sensible Umgebungen |
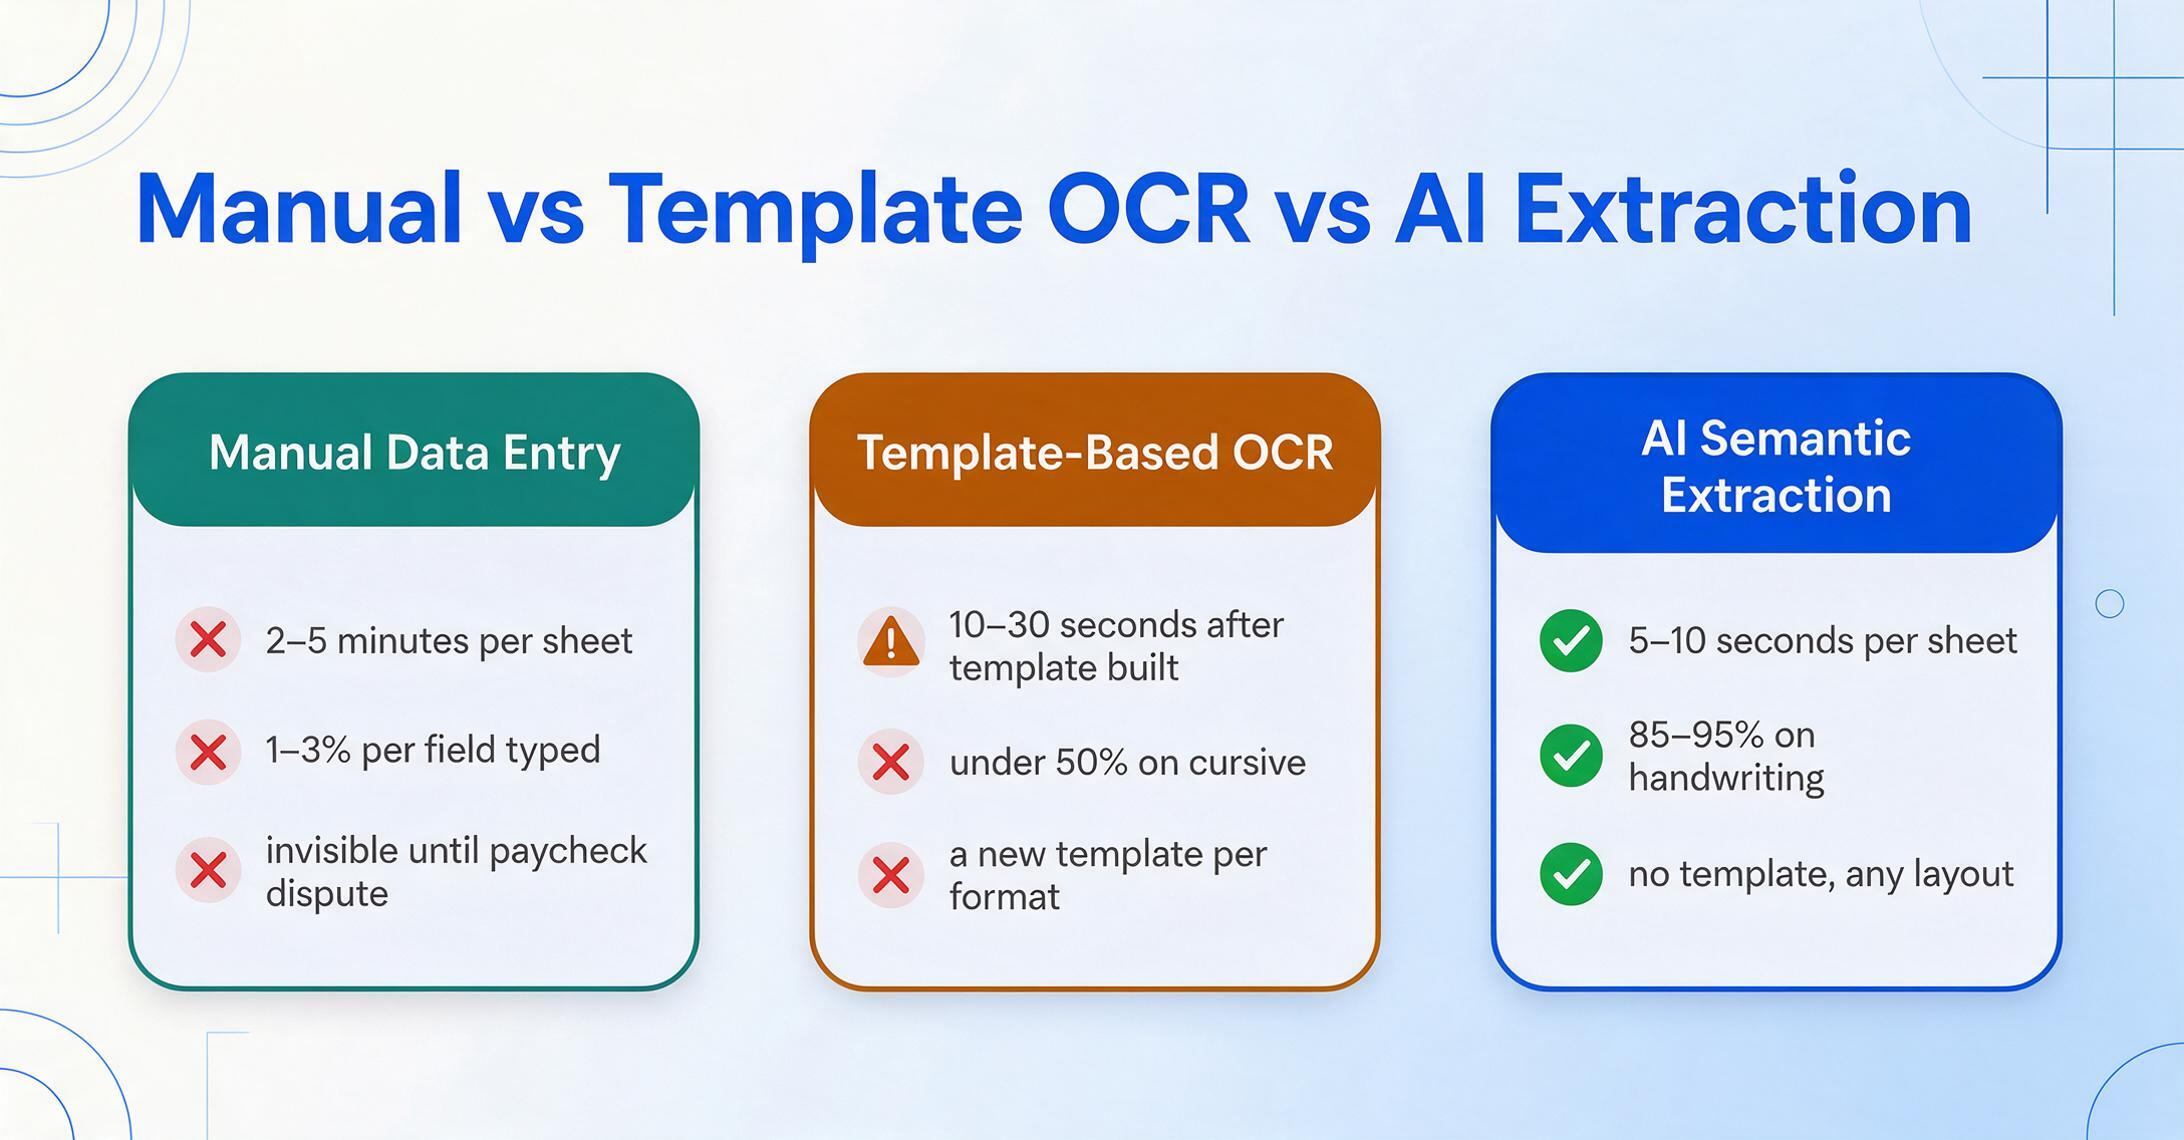
Die entscheidende Erkenntnis: vorlagenbasierte OCR versagt genau an dem Punkt, an dem die meisten Organisationen Extraktion am dringendsten benötigen. Wenn Ihre Zeiterfassungsbögen alle aus einer Quelle in einem Format stammen, benötigen Sie keine Extraktion — Sie haben einen standardisierten digitalen Prozess. Extraktion ist genau dann erforderlich, wenn Formate variieren: fünf Subunternehmer senden fünf verschiedene Zeiterfassungslayouts, eine Personalagentur mit ihrem eigenen PDF-Format, eine veraltete Papierkarte von einem Team, das keine Apps nutzt. Jedes neue Format bringt ein vorlagenbasiertes System zum Scheitern. Ein vorlagenfreies System liest sie alle mit derselben Spaltendefinition — weil es „Mitarbeitername" dadurch findet, dass es versteht, wie ein Mitarbeitername aussieht, nicht dadurch, dass es ihn an Koordinaten (120, 45) erwartet.
Dies ist die Architekturentscheidung, die bestimmt, ob Extraktion Ihre Arbeitslast reduziert oder nur verlagert: positionsbasierte Extraktion (wo sind die Daten?) vs. semantische Extraktion (was bedeuten die Daten?). Tools der ersten Kategorie — die meisten Legacy-OCR- und Zonensysteme — erfordern, dass Sie eine Karte pflegen, wo jedes Feld auf jeder Dokumentvariante liegt. Tools der zweiten Kategorie — moderne Vision-KI-Plattformen — lesen Dokumente so, wie ein Mensch es tut: durch Verständnis des Inhalts, nicht durch Koordinatenabgleich. Wenn Sie Zeiterfassungsbögen aus mehr als drei verschiedenen Quellen verarbeiten, können allein die Wartungskosten für Vorlagen innerhalb eines Jahres die Kosten der manuellen Erfassung übersteigen. Für einen tieferen Vergleich finden Sie in unserem Definitionsleitfaden zur Zeiterfassungsextraktion eine detaillierte Betrachtung der Technologieebene.
Dateien werden sicher verarbeitet und nicht gespeichert.
Wichtige Felder für die Zeiterfassungsdatenextraktion
Die Felder, die Sie extrahieren, hängen davon ab, wohin die Daten fließen – eine einfache Lohnabrechnung benötigt weniger Felder als ein zertifizierter Lohnabrechnungsbericht nach Davis-Bacon, der wiederum weniger Felder benötigt als eine vollständige Kostenzuordnungstabelle. Definieren Sie Ihre Ausgabespalten basierend auf den Anforderungen Ihres nachgelagerten Systems, nicht auf dem Layout des Stundenzettels.
Mitarbeiter & Zeitraum
- Name des Mitarbeiters
- Mitarbeiter-ID / Ausweisnummer
- Wochenende / Abrechnungszeitraum
- Name & Unterschrift des Vorgesetzten
Tägliches Stundenraster
- Reguläre Stunden – Montag bis Sonntag
- Überstunden (1,5× und 2×)
- Pausenabzüge
- Krankheits-/Urlaubs-/Feiertagsstunden
Projekt- & Kostenzuordnung
- Projektcode / Auftragsnummer
- Kostencode / Phasencode
- Gewerk / Berufsgruppe
- Arbeitsbeschreibung / Aufgabe
Lohnabrechnung & Compliance
- Stundensatz / Lohnsatz
- Gesamte reguläre Stunden
- Gesamte Überstunden
- Zusatzleistungssatz
- Bestimmungsnummer für marktüblichen Lohn
Das von Ihnen gewählte Extraktionstool sollte es Ihnen ermöglichen, Spalten einmal zu definieren und sie auf jedes Stundenzettelformat anzuwenden, das Ihr Unternehmen erhält. Dieser Ansatz – genannt Benutzerdefinierte Spaltenextraktion – bedeutet, dass Sie die Ausgabestruktur basierend auf den Anforderungen Ihres Lohnabrechnungs- oder ERP-Systems definieren, nicht auf dem, was jeder einzelne Stundenzettel bietet. Eine Arbeitnehmernamensspalte in Ihrer Ausgabe erfasst „John Smith", unabhängig davon, ob die Quellkarte ihn als „John Smith", „Smith, John" oder „J. Smith" in der oberen linken Ecke listet – die KI löst jede Variante basierend auf semantischem Verständnis derselben Ausgabespalte zu, nicht durch Positionsabgleich.
Stapelverarbeitung: Wenn das Volumen Geschwindigkeit strukturell macht
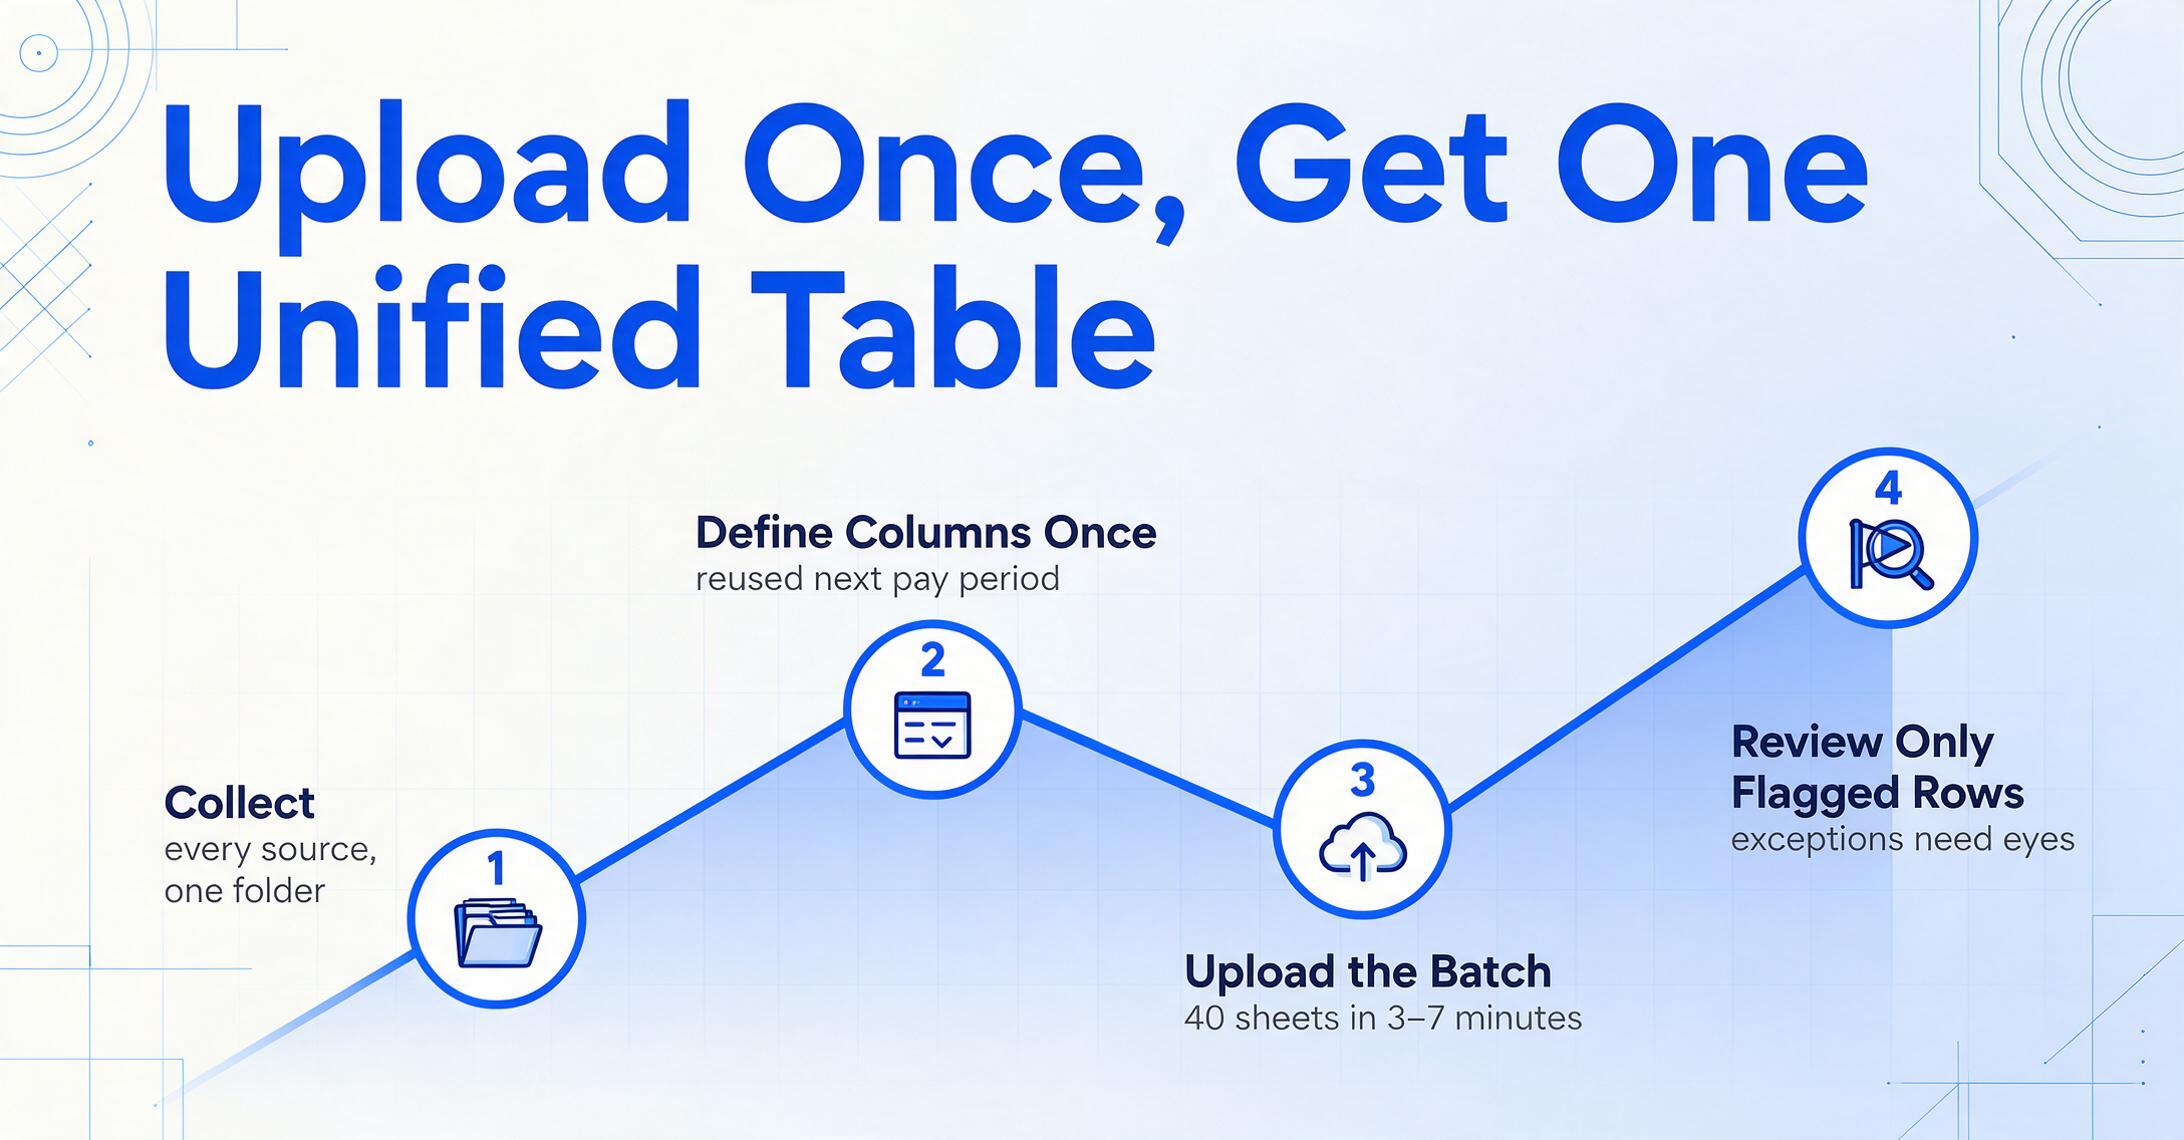
40 Zeiterfassungsbögen einzeln zu verarbeiten ist nicht wesentlich schneller als die manuelle Eingabe, wenn man den Aufwand für das Öffnen jeder Datei, das Warten auf die Verarbeitung, das Prüfen der Ergebnisse und den Wechsel zur nächsten Datei berücksichtigt. Die Zeitersparnis summiert sich nur, wenn Sie alle 40 auf einmal hochladen und eine einzige einheitliche Tabelle zurückerhalten.
Die Stapelverarbeitung ist der operative Unterschied zwischen „Extraktion ist eine interessante Demo" und „Extraktion hat den Mittwochnachmittag des Lohnbuchhalters ersetzt." Der Arbeitsablauf ist unkompliziert:
Sammeln Sie alle Zeiterfassungsbögen für den Abrechnungszeitraum
Fotografieren Sie die Papierkarten, leiten Sie die per E-Mail erhaltenen PDFs weiter, laden Sie die Portal-Exporte herunter – sammeln Sie jeden Zeiterfassungsbogen in einem Ordner, unabhängig vom Quellformat. Kein Vorsortieren, kein Umbenennen, kein Standardisieren.
Definieren Sie Ihre Ausgabespalten einmal
Richten Sie die Spaltenstruktur ein, die zu Ihrem Lohnabrechnungs-Importformat passt: Mitarbeitername, Datum, Projektcode, reguläre Stunden, Überstunden, Klassifizierung, Kostencode. Diese Spalten gelten für jeden Zeiterfassungsbogen im Stapel, unabhängig von dessen Layout. Speichern Sie den Spaltensatz als Vorlage für die Wiederverwendung im nächsten Zeitraum.
Laden Sie alle Zeiterfassungsbögen hoch und verarbeiten Sie sie als Stapel
Laden Sie den gesamten Ordner auf einmal hoch. Das Tool verarbeitet jeden Zeiterfassungsbogen unabhängig, sammelt aber alle Ergebnisse in einer einheitlichen Tabelle – eine Zeile pro Mitarbeiter und Zeiterfassungsbogen, mit Spalten, die Ihrer Definition entsprechen. Ein Stapel mit 40 Zeiterfassungsbögen, der 2–3 Stunden manuelle Eingabe erfordern würde, ist in 3–7 Minuten Verarbeitungszeit abgeschlossen.
Prüfen Sie markierte Ergebnisse, nicht jedes Feld
Überprüfen Sie statt 240 einzelner Felder (40 Blätter × 6 Felder) nur die Zellen, die die KI als unsicher markiert hat – typischerweise 5–15 % der Felder. Stichprobenartig eine zufällige Auswahl sicherer Extraktionen prüfen. Der Prüfschritt verschiebt sich von der umfassenden Dateneingabe-Verifikation zur ausnahmebasierten Qualitätssicherung.
Die Batch-First-Architektur ist besonders wichtig für Lohnabrechnungszyklen mit festen Fristen. Wenn Zeiterfassungsbögen Freitagnachmittag eintreffen und die Lohnabrechnung bis Dienstagmorgen eingereicht werden muss, ist ein Prozess, der sequenzielle Verarbeitung erfordert, ein Prozess, der in der Urlaubssaison scheitert. Die Stapelverarbeitung ermöglicht es, die Extraktion im Hintergrund auszuführen, während das Lohnabrechnungsteam die Ergebnisse prüft – was zuvor ein serieller, personengebundener Arbeitsablauf war, wird parallelisiert.
Export und Lohnabrechnungs-/ERP-Integration
Extrahierte Daten, die in einer Tabelle leben, die Sie nicht mit Ihrem Lohnabrechnungssystem verbinden können, sind nur eine andere Form der manuellen Eingabe. Der Integrationsschritt ist der Punkt, an dem die Extraktion entweder Wert liefert oder zu einem Wissenschaftsprojekt wird.
Die meisten modernen Extraktionstools exportieren nach Excel (XLSX) oder CSV – Formate, die jedes große Lohnabrechnungs- und ERP-System als Importquelle akzeptiert. Der entscheidende Faktor ist nicht, ob das Tool diese Formate erzeugen kann (fast alle können das), sondern ob die Ausgabespaltenstruktur dem entspricht, was Ihr nachgelagertes System erwartet. Wenn Ihr Lohnabrechnungssystem „Employee ID" als Spaltenüberschrift importiert und Ihre Extraktionsausgabe sie „Worker Number" nennt, benennen Sie eine Spalte vor dem Import um – nicht tippen Sie Daten neu. Die Struktur ist korrekt; die Namenskonvention liegt in Ihrer Hand.
Die Software-Ökosysteme für die Integration von Zeiterfassungsdaten fallen in drei Kategorien:
| Kategorie | Plattformen | Integrationsmethode | Typischer Anwendungsfall |
|---|---|---|---|
| Allgemeine Lohnabrechnung | ADP Workforce Now, Paychex Flex, QuickBooks Payroll, Gusto, Sage | CSV/XLSX-Import | Standardmäßige Stundenlohnabrechnung für direkte Mitarbeiter; Zeiterfassungsbögen von Personaldienstleistern und Auftragnehmern |
| Bau-ERP | Sage 300 CRE, Viewpoint Vista, Foundation, HCSS HeavyBid, Procore | CSV/XLSX-Import mit Kostencode- und Projektfeldzuordnung | Auftragskostenzuordnung, zertifizierte Lohnabrechnung, Zeitabgleich zwischen Baustelle und Büro |
| Zertifizierte Lohnabrechnung | LCPtracker, eMars, Miter, Payroll4Construction | CSV-Import oder direkte Integration | WH-347-Erstellung, Einhaltung marktüblicher Löhne, Gewerkschaftsberichterstattung |
Für Teams, die mit Google Sheets arbeiten – üblich in kleinen und mittleren Bau- und Außendienstbetrieben – machen Extraktionstools mit einem Google-Sheets-Add-on den Export-Import-Schritt vollständig überflüssig. Extrahierte Daten landen direkt in einem Tabellenblatt, bereit für den Import in die Lohnabrechnung oder die Weitergabe an die Buchhaltung. Für Organisationen, die über Zeiterfassungsbögen hinaus verschiedene Dokumenttypen verarbeiten, übernimmt das verwandte Zeiterfassungsbögen in Excel konvertieren-Tool die Einzelformat-Stapelverarbeitung.
Wenn Ihr Lohnabrechnungs- oder ERP-System eine bestimmte Feldreihenfolge oder Spaltenbenennungskonvention erfordert, stellen Sie sicher, dass das Extraktionstool Ihnen freie Spaltenbenennung ermöglicht – die meisten tun das, aber einige generieren Spaltenüberschriften automatisch aus Dokumentfeldbezeichnungen, was zu inkonsistenten Spaltennamen führt, wenn Zeiterfassungsformate innerhalb eines Stapels variieren. Ein Tool, mit dem Sie Spaltenvorlagen definieren und speichern können, stellt sicher, dass die Ausgabestruktur in jedem Abrechnungszeitraum Ihrem Importformat entspricht, unabhängig davon, wie viele verschiedene Quellformate im Stapel enthalten waren.
Zertifizierte Lohnabrechnung, marktüblicher Lohn & Bau-Compliance
Für Bauunternehmer, die an bundesfinanzierten Projekten arbeiten, ist die Zeiterfassungsdatenextraktion nicht nur eine Frage der Effizienz – es geht um den Unterschied zwischen einer sauberen Einreichung der zertifizierten Lohnabrechnung und einem Compliance-Verstoß, der Arbeitsplätze, Geld und die Angebotsberechtigung kosten kann.
Gemäß dem Davis-Bacon-Gesetz (40 U.S.C. § 3141 et seq.) müssen Auftragnehmer bei jedem bundesfinanzierten Bauvertrag über 2.000 $ den Arbeitnehmern die örtlich marktüblichen Löhne zahlen und wöchentliche Berichte zur zertifizierten Lohnabrechnung einreichen – in der Regel auf Formular WH-347 –, die den Namen jedes Arbeitnehmers, die Berufsgruppe, die täglich geleisteten Stunden, den Lohnsatz und die Zusatzleistungen dokumentieren. Zweiunddreißig Bundesstaaten legen ihre eigenen Gesetze zum marktüblichen Lohn über den bundesstaatlichen Rahmen, jeweils mit unterschiedlichen Schwellenwerten, Berechnungsmethoden und Meldeformaten.
Die Anweisungen des Arbeitsministeriums sind eindeutig: Wenn ein Arbeitnehmer in der Woche in mehr als einer Berufsgruppe gearbeitet hat, muss die zertifizierte Lohnabrechnung „eine genaue Aufschlüsselung der in jeder Berufsgruppe geleisteten Stunden" enthalten. Wenn die Zeitdaten als handschriftliche Zahlen auf einer Papierkarte vorliegen – „John – Carpenter 3h, Laborer 5h, Operator 2h" –, führt der Weg von dieser Karte zu einem konformen WH-347 über die manuelle Dateneingabe. Jeder Tastendruck auf diesem Weg trägt dieselbe Fehlerquote von 1–3 % wie jede andere manuelle Übertragung, aber die Konsequenzen sind schwerwiegender: Eine falsch zugeordnete Stunde wird standardmäßig mit dem höchsten anwendbaren Lohnsatz für alle Stunden berechnet; ein Muster von Fehlern kann zu Lohnnachzahlungen, Strafen von bis zu 13.508 $ pro Verstoß und dem Ausschluss von künftigen Bundesaufträgen führen.
So fügt sich die Extraktion in den Arbeitsablauf der zertifizierten Lohnabrechnung ein:
Klassifizierung als erstklassiges Feld extrahieren
Definieren Sie „Klassifizierung" als Spalte in Ihrer Extraktionsvorlage. Die KI liest den Gewerk oder Beruf, wie er auf dem Stundenzettel steht – „Zimmerer", „Elektriker", „Arbeiter", „Maschinenführer" – und gibt ihn zusammen mit den Stunden aus. Wenn ein Arbeiter 3 Stunden als Elektriker und 5 als Arbeiter aufteilt, erhalten Sie zwei Zeilen mit zwei Klassifizierungen. Das Extraktionstool weist keine Lohnsätze zu (das hängt von der Lohnbestimmungsnummer des Projekts ab, die je nach Landkreis und Vertrag variiert), liefert aber die strukturierten Klassifizierungsdaten, die für die Lohnsatz-Zuordnung erforderlich sind.
Extrahierte Daten den WH-347-Feldern zuordnen
Die Extraktionsausgabe liefert Arbeitername, Klassifizierung, Tagesstunden (regulär und Überstunden), Lohnsatz und Projektidentifikation – die Kernfelder, die WH-347 erfordert. Als CSV strukturiert, können diese Daten direkt in Zertifizierte-Lohnabrechnungs-Software (LCPtracker, eMars, Miter) eingespeist oder als verifizierte Quelle für die manuelle Formularerstellung dienen. Der Schritt, der entfällt, ist die Übertragung von Papier in digital – der Schritt, in dem Tippfehler in die Compliance-Kette gelangen.
Digitalen Prüfpfad pflegen
Gemäß den Davis-Bacon-Bestimmungen (29 CFR Teil 3) müssen Aufzeichnungen zur zertifizierten Lohnabrechnung mindestens drei Jahre nach Abschluss des Projekts aufbewahrt werden. Die Extraktion erstellt einen digitalen Datensatz, der das Foto des Original-Stundenzettels sowie die extrahierten strukturierten Daten umfasst – ein zeitgleicher Prüfpfad, den Papieroriginale allein nicht bieten können. Wenn ein Prüfer drei Jahre später eine Klassifizierung oder Stundenzahl in Frage stellt, können Sie das Quelldokument und die dazu passende Extraktionsausgabe vorzeigen.
Was die Extraktion nicht leistet: ein ausgefülltes, unterschriebenes WH-347 zu erstellen. Die Compliance-Erklärung auf Seite 2 des Formulars erfordert die Unterschrift eines leitenden Mitarbeiters mit Kenntnis der Lohnabrechnung – der bestätigt, dass Löhne korrekt, Klassifizierungen genau und Nebenleistungen gezahlt wurden. Diese Zertifizierung liegt in der rechtlichen Verantwortung des Auftragnehmers und kann nicht automatisiert werden. Die Extraktion beseitigt die Dateneingabefehler, die fehlgeschlagene Zertifizierungen auslösen; sie ersetzt die Zertifizierung selbst nicht. Den vollständigen regulatorischen Kontext finden Sie in unserem Leitfaden zur Extraktion von Baustellen-Stundenzetteln.
Die Gewerkschaftsberichterstattung fügt eine weitere Compliance-Dimension hinzu. Gewerkschaftliche Berufsklassifizierungen (Zimmerer, Elektriker, Arbeiter, Maschinenführer, Eisenleger, Klempner/Rohrinstallateur) sind nicht nur Lohnabrechnungskategorien – sie sind vertragliche Verpflichtungen mit spezifischen Lohnskalen, Beitragssätzen für Nebenleistungen und Auszubildenden-Gesellen-Verhältnissen. Wenn ein Vorarbeiter „Joe – 8 Std." schreibt, ohne anzugeben, dass 3 dieser Stunden gewerkschaftliche Zimmererarbeit und 5 allgemeine Arbeit waren, kann das Extraktionstool nur das ausgeben, was die Karte erfasst. Die strukturelle Lösung ist nicht bessere Extraktion – es sind bessere Stundenzettel. Die Klassifizierung auf dem Quelldokument zu verlangen, ist die wirksamste einzelne Compliance-Verbesserung, die ein Bauunternehmer vornehmen kann, unabhängig davon, welches Verarbeitungstool er verwendet.
Worauf Sie bei einem Zeiterfassungsdatenextraktionstool achten sollten
Zeiterfassungsdatenextraktionstools reichen von veralteten OCR-Systemen, die eine Vorlagenkonfiguration pro Format erfordern, bis hin zu modernen KI-Plattformen, die semantisch lesen. Sechs Kriterien trennen Tools, die den Lohnabrechnungsaufwand reduzieren, von Tools, die das Abtippen nur auf einen anderen Bildschirm verlagern.
1. Vorlagenfreier, formatunabhängiger Betrieb. Dies ist das mit Abstand wichtigste Unterscheidungsmerkmal – denn die Anzahl der Zeiterfassungsformate wächst mit jedem Subunternehmer, jeder Personalagentur und jedem Feldteam, das zu Ihrem Betrieb hinzukommt. Ein Tool, das die Definition einer Parsing-Vorlage pro Format erfordert, ist keine Extraktion, sondern Vorlagenverwaltung. Vorlagenfreie Extraktion funktioniert durch semantisches Verständnis: Ein Zeiterfassungsbogen aus einer Quelle, die Sie noch nie verarbeitet haben, funktioniert beim ersten Hochladen. Fragen Sie den Anbieter: „Wenn ich einen Zeiterfassungsbogen in einem Format erhalte, das ich noch nie gesehen habe, funktioniert er dann sofort?" Wenn die Antwort „zuerst eine Parsing-Vorlage erstellen" beinhaltet, kaufen Sie Wartung, nicht Automatisierung.
2. Handschriftgenauigkeit unter realen Bedingungen. Das Demonstrationsvideo mit einem perfekt gescannten PDF ist nicht der Test. Bitten Sie darum, mit Ihren tatsächlich schlechtesten Zeiterfassungsbögen zu testen – der handschriftlichen Crew-Karte mit Klassifizierungen am Rand, der Karte, auf der eine 4 wie eine 9 aussieht, dem Foto, das in der Dämmerung auf einer Baustelle aufgenommen wurde. Ein Tool, das nur saubere, gedruckte digitale PDFs verarbeitet, löst die einfachen 30–40 % Ihres Zeiterfassungsvolumens – und lässt die schwierigen 60 % auf Ihrem Schreibtisch liegen. Der IJRISS-Benchmark 2025 mit 87,92 % Genauigkeit unter erschwerten Bedingungen ist ein nützlicher Referenzpunkt, aber Ihr eigener Worst-Case-Test sagt Ihnen mehr als jede veröffentlichte Zahl.
3. Erhaltung der Tabellen- und Rasterstruktur. Ein Zeiterfassungsbogen ist ein Raster, kein Formular. Das Tool muss Zeilen-Spalten-Beziehungen verstehen und in der Ausgabe erhalten. Wenn die Extraktion „8" in einer Zelle sieht, aber nicht sagen kann, dass es sich um John Smiths reguläre Dienstagsstunden in der richtigen Zeile handelt, ist die Ausgabe für die Lohnabrechnung unbrauchbar. Testen Sie mit Crew-Blättern – einer Karte mit 6–12 Arbeitern – und überprüfen Sie, ob die Ausgabe eine Zeile pro Arbeiter erzeugt, wobei die Stunden jedes Arbeiters korrekt den richtigen Tagesspalten zugeordnet sind.
4. Batch-First-Architektur. Die Verarbeitung von Zeiterfassungsbögen einzeln eliminiert die Zeitersparnis, die die Extraktion überhaupt erst rechtfertigt. Das Tool sollte Batch-Uploads akzeptieren (40+ Dateien gleichzeitig), diese parallel verarbeiten und eine einheitliche Ausgabetabelle erzeugen. Ein Tool, das für die Einzeldokumentverarbeitung konzipiert wurde und dem Batch-Funktionen nachträglich hinzugefügt wurden, zeigt unter realem Lohnabrechnungsvolumen seine Schwächen.
5. Unterstützung für berechnete Spalten bei Überstunden und Berechnungen. Der zeitaufwendigste Teil der manuellen Zeiterfassungsverarbeitung ist nicht das Übertragen der Stunden – sondern die Berechnung von Überstunden basierend auf den geltenden Regeln der jeweiligen Gerichtsbarkeit. Ein Tool mit berechneten Spalten ermöglicht es Ihnen, eine Spalte wie „Überstunden (Stunden > 40/Woche → 1,5×; Stunden > 8/Tag → 1,5×)" zu definieren, und die KI wendet die Berechnung während der Extraktion an. Dies eliminiert den separaten Tabellenkalkulationsschritt, der typischerweise auf die manuelle Dateneingabe folgt.
6. Lohnabrechnungskompatibler Export mit konsistenter Spaltenstruktur. Die Extraktionsausgabe muss dem entsprechen, was Ihr Lohnabrechnungs- oder ERP-System erwartet – sowohl im Dateiformat (XLSX oder CSV) als auch in der Spaltenstruktur. Wenn Sie Spalten vor dem Import umstrukturieren, neu formatieren oder neu anordnen müssen, hat die Extraktion den Tippschritt verkürzt, aber einen neuen Datenaufbereitungsschritt geschaffen. Die besten Tools ermöglichen es Ihnen, Spaltenvorlagen zu speichern, die jede Lohnperiode eine identische Ausgabestruktur erzeugen – unabhängig davon, wie viele verschiedene Zeiterfassungsformate im Quell-Batch enthalten waren.
Häufig gestellte Fragen
Kann KI handschriftliche Stundenzettel genau lesen?
Ja. Moderne Vision-KI-Modelle lesen handschriftliche Zeiterfassungsdaten – Namen, Stunden, Klassifizierungen, Kostencodes – auf Papierkarten, die vor Ort ausgefüllt werden. Die IJRISS-Studie 2025 ergab, dass multimodale KI eine Genauigkeit von 87,92 % über Original-, gefaltete, zerknitterte und nasse Dokumente erreichte und damit herkömmliche OCR deutlich übertraf. Saubere Druckschrift ist sehr zuverlässig (95 %+); hastige Schreibschrift mit mehrdeutigen Zahlen (1 vs. 7, 4 vs. 9) bleibt der schwierigste Fall. Die KI nutzt Kontext – Spaltenüberschriften für Wochentage, Zeilenbeschriftungen, Rasterstruktur – um Zeichen zu unterscheiden, bei denen eine herkömmliche OCR-Engine raten müsste. Der praktische Unterschied: Statt jedes Feld manuell einzutippen, prüfen Sie eine vorausgefüllte Tabelle und korrigieren den gelegentlichen mehrdeutigen Eintrag.
Wie unterscheidet sich die Zeiterfassungsdatenextraktion von QuickBooks Time oder ADP?
QuickBooks Time und ADP Workforce Now sind Zeiterfassungs-Apps – Mitarbeiter stempeln digital ein und aus, und die Stunden fließen direkt in die Lohnabrechnung. Sie verhindern, dass Papierstundenzettel überhaupt entstehen. Die Zeiterfassungsdatenextraktion verarbeitet Papierstundenzettel, die bereits existieren – von Subunternehmern, Zeitarbeitsfirmen, Außenteams ohne App-Zugriff oder Altunterlagen. Sie lösen unterschiedliche Probleme: Die App ist vorgelagert (Erfassung), das Extraktionstool ist nachgelagert (Verarbeitung des auf Papier Erfassten). Viele Organisationen nutzen beides: Zeiterfassungs-Apps für direkte Mitarbeiter, Extraktion für Stundenzettel aus externen Quellen, die unabhängig von der eingesetzten App auf Papier eintreffen.
Berechnet die Zeiterfassungsdatenextraktion Überstunden automatisch?
Ja, wenn das Tool berechnete Spalten unterstützt. Sie definieren eine Spalte wie „Überstunden (Stunden > 40/Woche → 1,5×)“ und die KI summiert die täglichen Einträge pro Arbeiter, bestimmt, welche Stunden den Schwellenwert überschreiten, und gibt die Überstundensumme aus. Überstundenregeln im Baugewerbe sind je nach Rechtsgebiet unterschiedlich: Das bundesweite Davis-Bacon-Gesetz verlangt 1,5× nach 40 Stunden/Woche, Kalifornien verlangt 1,5× nach 8/Tag und 40/Woche mit Doppelzeit nach 12/Tag, und Tarifverträge können völlig andere Schwellenwerte vorsehen. Ein Tool mit Berechnete-Spalten-Funktion ermöglicht es Ihnen, die für Ihre Projekte geltenden Regeln zu kodieren und die KI das Ergebnis während der Extraktion berechnen zu lassen – der Nachbearbeitungsschritt in der Tabellenkalkulation entfällt.
Was passiert, wenn ein Arbeiter seine Zeit auf mehrere Projekte oder Kostencodes aufteilt?
Wenn der Papierstundenzettel die Aufteilung erfasst – zum Beispiel „Projekt A: 4 Stunden, Projekt B: 4 Stunden“ – liest das Extraktionstool beide Zuordnungen und gibt zwei separate Zeilen für diesen Arbeiter aus, jeweils mit korrektem Projektcode und Stunden. Wenn der Papierstundenzettel die Aufteilung nicht erfasst und nur „8 Stunden“ zeigt, gibt das Extraktionstool aus, was auf der Karte steht – es erfindet keine Aufteilung. Dies verdeutlicht ein strukturelles Problem: Das Extraktionstool kann nur so genau sein wie der Stundenzettel, den es liest. Die häufigste Ursache für fehlende Kostencode-Aufteilungen ist, dass der Vorarbeiter oder Arbeiter sie nicht auf dem Quelldokument vermerkt – nicht ein Versagen der Extraktionstechnologie.
Kann die Extraktion ein ausgefülltes WH-347-Formular für zertifizierte Lohnabrechnung erstellen?
Nein – und kein Tool sollte dies behaupten, da das WH-347 eine unterschriebene Compliance-Erklärung erfordert, die die Richtigkeit der gemeldeten Löhne bestätigt. Dies liegt in der rechtlichen Verantwortung des Auftragnehmers gemäß dem Davis-Bacon-Gesetz. Was die Extraktion liefert, sind die strukturierten Daten, die das Formular benötigt: Arbeitername, Klassifizierung, tägliche Stunden (regulär und Überstunden), Lohnsatz und Projektidentifikation – in einem Format, das WH-347-Felder befüllen oder direkt in Software für zertifizierte Lohnabrechnung wie LCPtracker, eMars oder Miter importiert werden kann. Der Zertifizierungsschritt bleibt die Pflicht des Auftragnehmers, aber der Dateneingabeschritt, der die meisten Compliance-Fehler verursacht, wird eliminiert.
Können die extrahierten Daten in Sage 300 CRE oder Viewpoint Vista eingespeist werden?
Ja. Sage 300 CRE, Viewpoint Vista, Foundation und HCSS HeavyBid akzeptieren alle strukturierte Excel- oder CSV-Importe. Das Extraktionsergebnis ist eine standardmäßige XLSX- oder CSV-Datei mit konsistenten Spaltenüberschriften – dasselbe Format, das diese Bau-ERPs importieren. Die wichtigste Anforderung ist, dass die Spaltenstruktur der Ausgabe dem entspricht, was Ihr ERP erwartet. Wenn Sage „Job Code" erwartet und Ihre Extraktionsspalte „Projektnummer" heißt, benennen Sie die Überschrift vor dem Import um. Die Stunden, Klassifizierungen, Kostencodes und Projektzuordnungen werden korrekt befüllt; Sie mappen Spaltennamen, statt Daten neu einzutippen.
Wie groß ist der Genauigkeitsunterschied zwischen KI-Extraktion und manueller Dateneingabe?
KI-Extraktion erreicht 85–99 % Feldgenauigkeit, abhängig von der Dokumentqualität – 95–99 % bei sauberen gedruckten PDFs, 85–95 % bei handschriftlichen Feldkarten. Manuelle Dateneingabe weist eine Fehlerquote von 1–3 % pro eingegebenem Feld auf, aber anders als Extraktionsfehler (die zur Überprüfung sichtbar sind) bleiben manuelle Eingabefehler unsichtbar, bis eine Gehaltsabrechnungsstreitigkeit sie aufdeckt. Ein wöchentlicher Stundenzettel mit 60 Feldern hat eine Wahrscheinlichkeit von 45–83 %, mindestens einen Tippfehler zu enthalten. Der strukturelle Vorteil der Extraktion liegt nicht unbedingt in höherer Rohgenauigkeit – sondern darin, dass Fehler zur Überprüfung sichtbar gemacht werden, statt in einem Lohnlauf verborgen zu bleiben.
Brauche ich Extraktion, wenn alle meine Mitarbeiter eine Zeiterfassungs-App nutzen?
Nicht für diese Mitarbeiter. Zeiterfassungs-Apps erzeugen strukturierte digitale Daten, die nativ in die Lohnabrechnung fließen – Extraktion bietet keinen Mehrwert für digitales Ein- und Ausstempeln. Extraktion ist relevant, wenn Ihre Lohnabrechnungs-Pipeline Stundenzettel aus Quellen umfasst, die Ihre App nicht nutzen: Subunternehmer mit eigenen Papiersystemen, Personaldienstleister, die PDFs per E-Mail senden, Feldteams auf Baustellen ohne zuverlässigen Mobilfunkempfang oder alte Papierunterlagen, die Sie digitalisieren müssen. Wenn 100 % Ihrer Belegschaft digital stempelt, benötigen Sie keine Zeiterfassungsdatenextraktion. Die meisten Organisationen mit mehr als 20 Feldarbeitern erreichen bei weitem keine 100 % digitale Nutzung – und diese Lücke ist es, in der Extraktion manuelle Eingaben ersetzt.
Welche Dateiformate akzeptieren Zeiterfassungsextraktionstools?
Die meisten KI-Extraktionstools akzeptieren JPG, PNG, PDF und WebP – das deckt Handyfotos, gescannte Dokumente und digital erstellte PDFs ab. Einige unterstützen auch TIFF (häufig im Unternehmensscanbereich) und AVIF. Entscheidend ist die Fähigkeit, Handyfotos zu verarbeiten – denn die häufigste Quelle für Papierzeiterfassungsbögen im Jahr 2026 ist ein Vorarbeiter, der eine Crewkarte mit dem Smartphone fotografiert und sie per SMS oder E-Mail ins Büro schickt. Ein Tool, das flach gescannte, entzerrte Dokumente mit 300 DPI erfordert, löst ein Problem aus dem Jahr 2015. Die reale Eingabe ist ein leicht schräges, ungleichmäßig beleuchtetes Handyfoto – und die Extraktion sollte ohne Vorverarbeitung darauf funktionieren.
Was kostet die Zeiterfassungsextraktion im Vergleich zur manuellen Erfassung?
KI-Extraktionstools kosten typischerweise $9–$39/Monat für Einzelnutzer oder $39–$99/Monat für kleine Teams, mit nutzungsbasierten Tarifen bei höheren Volumina. Vergleichen Sie das mit den Kosten der manuellen Erfassung: Bei 3 Minuten pro Zeiterfassungsbogen und einem voll belasteten Lohnbuchhaltersatz von $25/Stunde kostet die Verarbeitung von 100 Zeiterfassungsbögen pro Woche $125/Woche oder $6.500/Jahr allein an Arbeitskosten – noch bevor die von der American Payroll Association (APA) identifizierten 1–8% Lohnfehlerkosten berücksichtigt werden. Bei diesen Volumina amortisiert sich die Extraktion finanziell bereits im ersten Monat. Der Kostenvergleich wird noch deutlicher, wenn man die Compliance-Risiken einbezieht: Ein einziger Davis-Bacon-Verstoß kann mehr kosten als ein Jahrzehnt Extraktionstool-Abonnements.
Vom Stundenzettel zur Lohnabrechnung
Die Zeiterfassungsdatenextraktion ersetzt nicht Ihre Lohnabrechnungssoftware – ADP, Sage, Viewpoint und Paychex erfüllen ihre Aufgaben gut. Es geht darum, die Lücke zwischen dem Ort, an dem Zeitdaten entstehen (eine Papierkarte, ein Handyfoto, eine PDF eines Subunternehmers), und dem Ort, an dem sie ankommen müssen (eine strukturierte Zeile in Ihrem Lohnabrechnungssystem, eine Zeile auf einem WH-347, eine Kostenzuordnung in Ihrem Auftragskostenbuch), zu schließen.
Diese Lücke wird derzeit durch manuelle Tastatureingaben überbrückt – jede mit einer Fehlerwahrscheinlichkeit von 1–3 %, multipliziert über Hunderte von Feldern pro Lohnabrechnungslauf, mit Kosten, die sich von Lohnkorrekturen über Compliance-Verstöße bis hin zu verfälschten Auftragskostendaten summieren, die falsche Schätzungen für das nächste Angebot erzeugen. Die Technologie, einen Stundenzettel zu lesen – seine Tabellenstruktur zu verstehen, handschriftliche Einträge von der Baustelle zu entziffern, Berufsgruppen zu erhalten und kostenkodierte strukturierte Daten auszugeben – existiert heute ohne Vorlagen, ohne Schulung und über jedes Format hinweg.
Der beste Weg, um zu bewerten, ob die Extraktion zu Ihrem Lohnabrechnungsworkflow passt, ist, sie mit Ihren tatsächlichen Stundenzetteln zu testen – insbesondere mit den schwierigen, die Sie jeden Abrechnungszeitraum fürchten. Laden Sie einen Beispiel-Stundenzettel hoch und sehen Sie die strukturierten Daten, die Sie zurückerhalten – oder nutzen Sie die eingebettete Demo oben, um die Extraktion jetzt mit der Stundenzettel-Voreinstellung auszuprobieren.