O Guia Completo para Extração de Dados de
Folhas de Ponto (2026)
Quando o Departamento do Trabalho dos EUA estima que preencher um formulário de folha de pagamento certificada WH-347 leva 55 minutos para apenas oito funcionários, e a American Payroll Association (APA) coloca as taxas de erro manual em folhas de ponto em 1–8% da folha de pagamento total, a lacuna entre um cartão de ponto em papel e um processamento de folha não é mais apenas um inconveniente — é um dreno quantificável nos orçamentos de mão de obra, na precisão dos custos de trabalho e na posição de conformidade. A extração de dados de folhas de ponto é a tecnologia que fecha essa lacuna: lendo nomes de funcionários, horas, códigos de projeto e horas extras de qualquer formato de folha de ponto — impresso ou manuscrito — e gerando dados estruturados que seu sistema de folha pode consumir diretamente, sem uma única tecla de transcrição manual.
Principais Conclusões
- Uma folha de ponto de equipe de construção com 60 campos tem uma probabilidade de 45–83% de conter pelo menos um erro de digitação — por folha, por semana, antes mesmo de os cálculos de horas extras começarem.
- A APA estima que erros manuais em folhas de ponto custam de 1–8% da folha de pagamento total, mas o dano mais profundo é invisível: cada hora digitada incorretamente corrompe os dados de custo de trabalho que alimentam sua próxima proposta.
- Você não precisa de um digitador mais rápido — você precisa substituir 240 teclas por lote por uma etapa de revisão que verifica apenas os 5–15% dos campos sobre os quais a IA não tem certeza, transformando sua equipe de folha de pagamento de criadores de dados em verificadores de dados.
O que é a extração de dados de folhas de ponto (e o que não é)
A extração de dados de folhas de ponto é o processo automatizado de ler campos estruturados — nome do empregado, datas trabalhadas, horas diárias (regulares e extras), códigos de projeto, códigos de custo e aprobaciones — de uma folha de ponto em papel ou digital e convertí-los em uma tabela organizada que seu sistema de nómina possa importar. Não é um aplicativo de rastreo de tempo.
Essa distinção é o ponto de confusão mais comum, e acertar nela determina se você resolve seu problema real ou compra algo que não toca a pilha de papel em sua mesa. QuickBooks Time, ADP Workforce Now, Procore Timecard, Raken e ferramentas similares são aplicativos de rastreo de tempo: os empregados registram entrada e saída digitalmente, e as horas fluem diretamente à nómina. Eles evitam que folhas de ponto em papel sejam criadas na origem. A extração de folhas de ponto resolve o problema opuesto: a folha de ponto em papel já existe — preenchida por um capataz em um canteiro de obra, enviada por fax por uma agência de pessoal, fotografada por um trabalhador de campo — e as horas precisam saltar desse cartão ao seu sistema de nómina sem que ninguém as digite novamente.
Para uma explicação mais profunda de como essa tecnologia funciona e quando é a solução correta, consulte nosso guía sobre o que é a extração de dados de folhas de ponto. O resto deste artigo assume que você já determinou que a extração é a resposta e se concentra em como fazê-lo bem — cobrindo tudo, desde a seleção de campos e o processamento em lote até a conformidade com a folha de pagamento certificada e a integração com o sistema de nómina.
Por que a extração de dados de folhas de ponto é importante
O custo do processamento manual de folhas de ponto não é o salário da pessoa que digita. É o que acontece quando essa digitação dá errado — e os dados sobre com que frequência isso ocorre são peores do que a maioria dos gerentes de nómina supone.
A American Payroll Association (APA) estima que os erros manuais de folhas de ponto custan de 1–8% do total da nómina. Com um orçamento laboral anual de $2 milhões, isso representa de $20.000 a $160.000 em custo recuperável — cada ano. O 2024 Financial Benchmarker da Construction Financial Management Association (CFMA) descobriu que a administração de custos sozinha consome em média 5,4% da receita do projeto para contratistas generales dos EUA. O principal impulsionador não são licencias de software ou honorários de consultoria; é o trabalho de reconciliar dados que deverían coincidir desde o início — horas em um cartão de tempo que não coinciden com as horas na nómina porque alguien leu mal um 4 como um 9.
Cada tecla na entrada manual de folhas de ponto carrega uma taxa de erro de 1–3%. Uma única folha semanal de equipe de construção com 60 campos (5 trabalhadores × 12 pontos de dados cada) significa que a probabilidade de pelo menos um erro nesse lote está entre 45% e 83% — por folha, por semana. Multiplique isso por 20 folhas de subcontratistas e um ano de ciclos de nómina, e a pregunta não é se existem erros em seus dados de nómina, mas quantos passan desapercibidos.
A dimensão de conformidade amplifica ainda más esses custos. Em projetos de construção financiados federalmente sujeitos à Lei Davis-Bacon, um único oficio mal classificado ou uma hora mal digitada em um informe de folha de pagamento certificada pode desencadenar penalidades de até $13.508 por violación. A própria estimación do Departamento de Trabajo de 55 minutos para completar o Formulario WH-347 para apenas 8 empregados significa que um projeto de 40 personas pode consumir más de 4,5 horas de tempo administrativo de nómina por semana só no formulário — antes de contar a entrada de dados que o alimenta.
O problema estrutural: a inserção manual de folhas de ponto carrega uma taxa de erro que se agrava com o volume, enquanto as consequências de conformidade e de custo se agravam com o tempo. A extração não elimina a necessidade de revisão — mas transfere o papel da equipe de folha de pagamento de digitador de dados a revisor de dados, que é um perfil de risco fundamentalmente diferente.
Os Desafios Únicos dos Dados de Folhas de Ponto
As folhas de ponto não são faturas. Não são recibos. Elas apresentam uma série de desafios estruturais que as tornam excepcionalmente difíceis de extraer — e excepcionalmente valiosas de acertar.
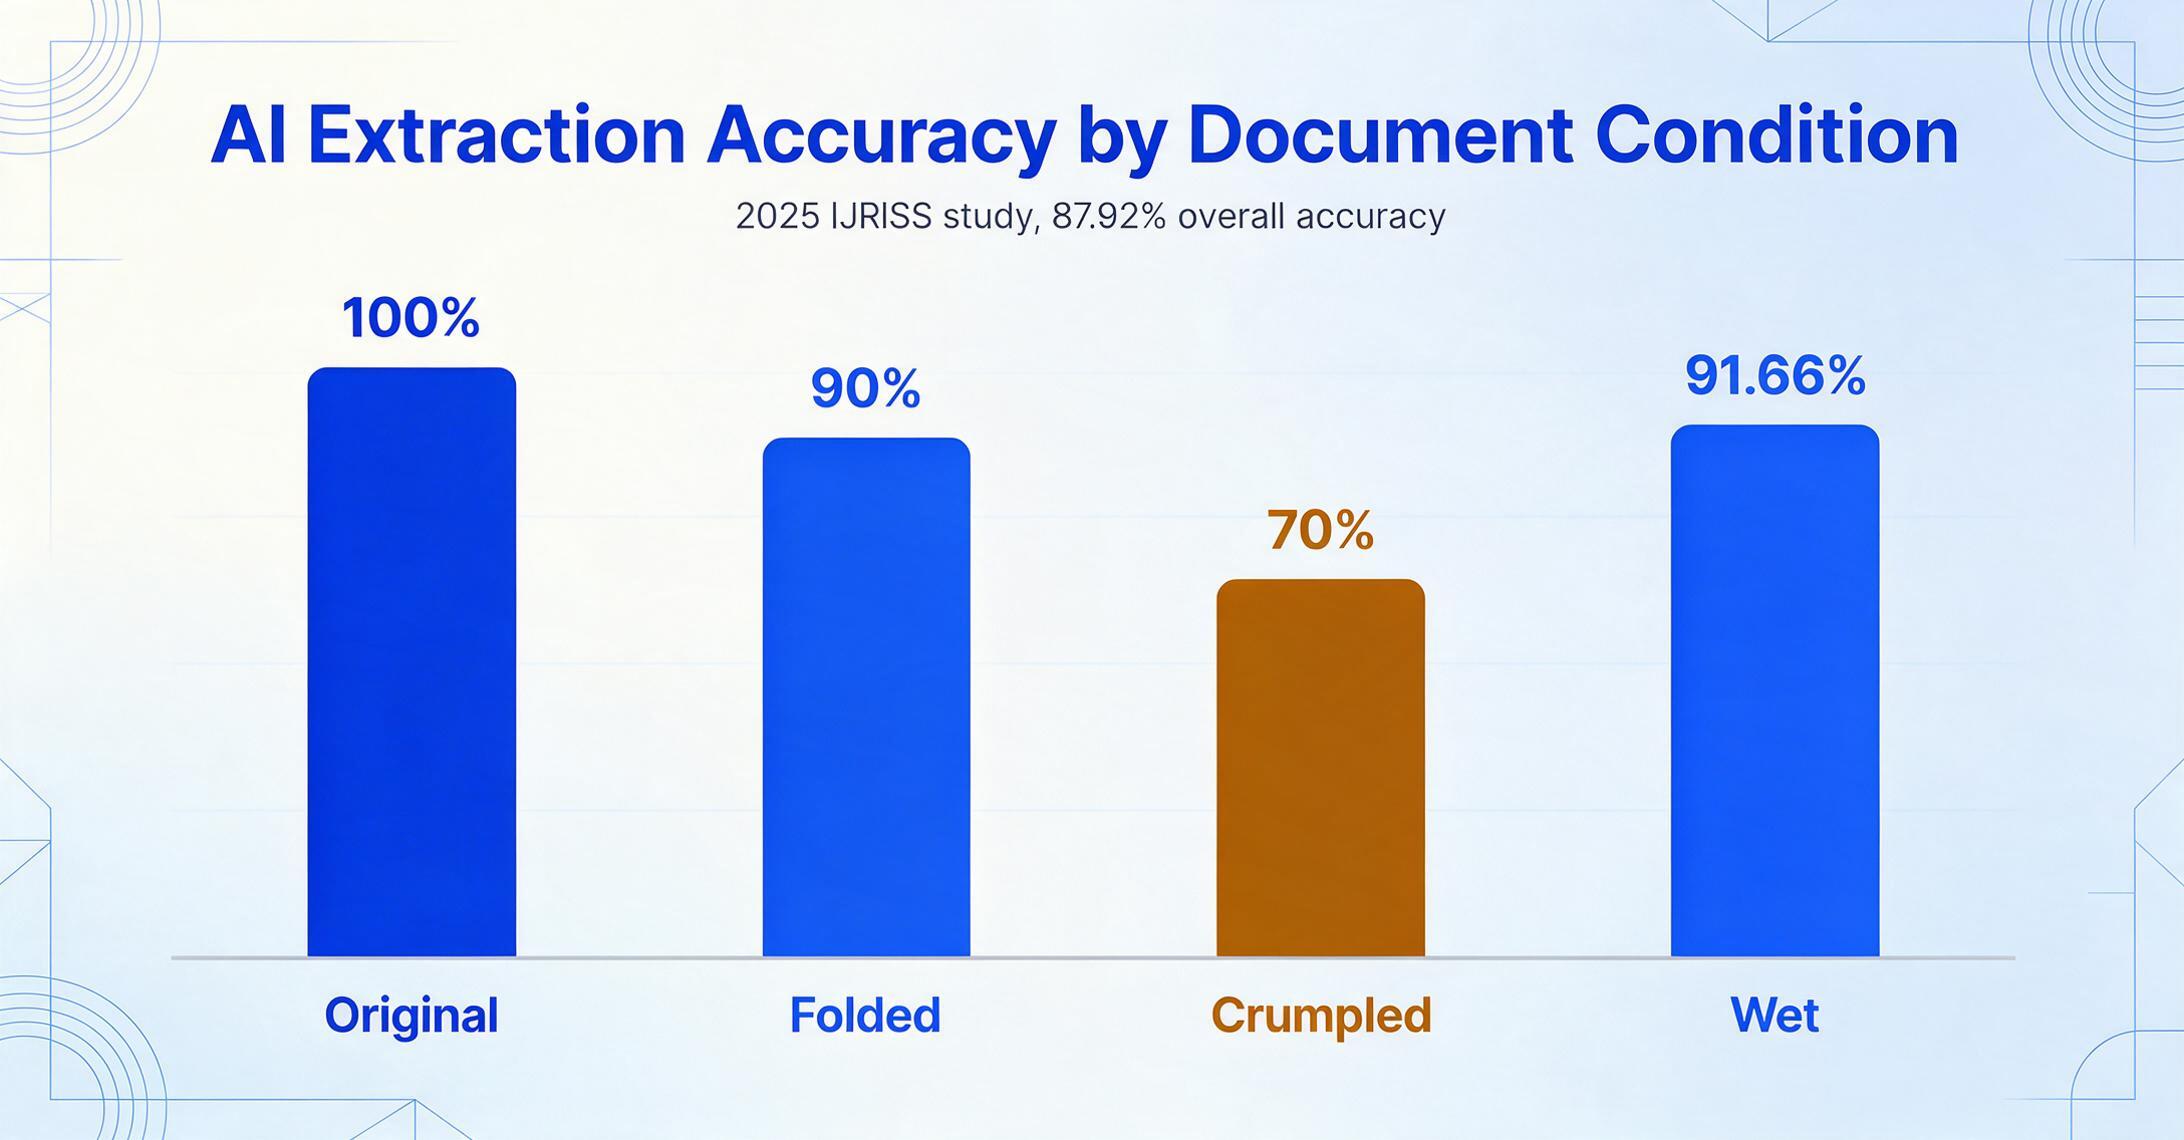
A escrita manual é a norma, não a excepção. Os cartões de ponto de obra, os registros de serviço de campo e as folhas de ponto de agências de pessoal são preenchidos à mano — muitas vezes na cabina de um caminhão, sobre a tapa da caçamba ou ao final de um turno de 10 horas. O estudio IJRISS 2025 sobre OCR de folhas de ponto com IA testou a extração multimodal em quatro estados de degradação do documento — original (100% de precisão), dobrado (90%), enrugado (70%) e molhado (91,66%) — alcanzando uma precisão geral de 87,92%, uma melhora de 12 a 47 pontos percentuais sobre o OCR tradicional. Uma ferramenta de extração que só maneja PDFs limpos e impressos resolve os 30–40% fáceis do problema. O restante manuscrito é onde residen os custos da entrada manual.
Estrutura de tabela, não estrutura de formulário. A maioria das ferramentas de extração de documentos está desenhada para formulários: uma etiqueta, um valor. "Número de fatura: INV-12345" é um campo de formulário. Uma folha de ponto é uma grade — nomes de empregados na columna esquerda, de lunes a domingo na parte superior, valores de horas nas células que se cruzan. A ferramenta deve entender que o "8" na fila 3, columna 4 são as horas regulares de John Smith do miércoles — e que essa relação deve ser preservada na saída, tenha a grade 5 ou 14 colunas, lea o cabeçalho "Mié" ou "Miércoles" ou "M", e seja a etiqueta da fila "John Smith" ou "Smith, J.". Os enfoques baseados em modelos se rompen quando o layout da grade cambia; a extração sem modelo lê a estrutura ao entender o que representa cada célula, não onde se encontra.
Os códigos de projeto e de custo multiplican a complexidade da extração. Um auxiliar de folha de pagamento que lê uma folha de ponto pode ver "8 horas" e digitar uma fila. Mas esse "8" pode precisar ser dividido entre três códigos de custo (03 30 00 — Concreto, 03 24 00 — Varilla, 03 00 00 — General) com classificações diferentes e potencialmente tarifas salariais diferentes. Em um projeto Davis-Bacon, o DOL exige que os trabalhadores que realizan mais de uma classificação mostren una repartición precisa das horas por classificação. A saída da extração deve ser capaz de produzir múltiples filas por trabalhador — não colapsar tudo em uma.
A lógica de horas extras varia conforme a jurisdição. Projetos federais da Lei Davis-Bacon exigem horas extras a 1,5× após 40 horas semanais. A Califórnia exige 1,5× após 8 horas diárias e após 40 horas semanais, com hora dupla após 12 horas no dia. Acordos sindicais podem adicionar limites totalmente diferentes sobre ambos. Uma ferramenta de extração que apenas lê o que está escrito no cartão — e não consegue calcular horas extras a partir dos totais diários — deixa a parte mais difícil do cálculo da folha de pagamento na mesa onde começou.
A alocação multi-projeto confunde o limite do período de pagamento. Um único trabalhador pode registrar horas em três projetos diferentes em uma semana, cada um com determinações salariais diferentes, códigos de custo diferentes e requisitos de relatório de folha de pagamento certificada diferentes. A folha de ponto pode ou não capturar essas divisões com clareza — mas o processamento da folha deve refleti-las com precisão, porque um trabalhador pago com a determinação salarial errada é uma falha de conformidade, independentemente de a folha de ponto ter sido ambígua.
Métodos Tradicionais vs Extração com IA
Três abordagens dominam o pipeline de folha de ponto para folha de pagamento hoje. Apenas uma delas é projetada para o volume, a variedade e os riscos de conformidade que a maioria das organizações realmente enfrenta.
| Inserção Manual de Dados | OCR Baseado em Modelo | Extração Semântica com IA | |
|---|---|---|---|
| Como funciona | O funcionário de folha de pagamento lê o cartão de papel e digita cada campo no sistema de folha de pagamento | O OCR lê caracteres de uma posição predefinida; exige um modelo de análise para cada formato de folha de ponto | A IA de visão lê o documento de forma holística, entendendo nomes, horas e códigos pelo significado, não pela posição |
| Lida com escrita manual? | Sim (um humano decifra) | Ruim — o OCR tradicional cai para <50% em letra cursiva | Sim — 85–95% em nível de campo na escrita manual, 87,92% em condições degradadas |
| Lida com mudanças de formato? | Sim (o humano se adapta) | Não — cada novo formato exige um novo modelo | Sim — independente de formato, lê qualquer layout no primeiro contato |
| Lida com grades de tabelas? | Sim (o humano lê a grade) | Parcial — frequentemente perde as relações linha-coluna | Sim — preserva a estrutura da grade, o contexto das linhas e os cabeçalhos das colunas |
| Tempo de processamento por folha de ponto | 2–5 minutos | 10–30 segundos (após a criação do modelo) | 5–10 segundos |
| Esforço de configuração | Zero (por folha de ponto); tempo de treinamento para cada novo funcionário | Alto — criar e manter um modelo por formato, por fornecedor, por mudança de layout | Quase zero — defina as colunas de saída uma vez; reutilize em todos os formatos e fontes |
| Perfil de erros | 1–3% por campo digitado; invisível até uma disputa de pagamento | Depende da qualidade do modelo; falha silenciosamente quando o layout muda | 1–5% em nível de campo; os erros ficam visíveis para revisão humana antes do processamento da folha |
| Escala com o volume? | Não — custo linear por folha de ponto | Não — a manutenção do modelo escala com a diversidade de formatos | Sim — custo marginal quase zero após a definição inicial das colunas |
| Ideal para | 1–5 folhas de ponto por semana, formato único | Folhas de ponto digitais de alto volume e formato único de uma fonte | Folhas de ponto manuscritas e impressas de formatos mistos e múltiplas fontes; ambientes sensíveis à conformidade |
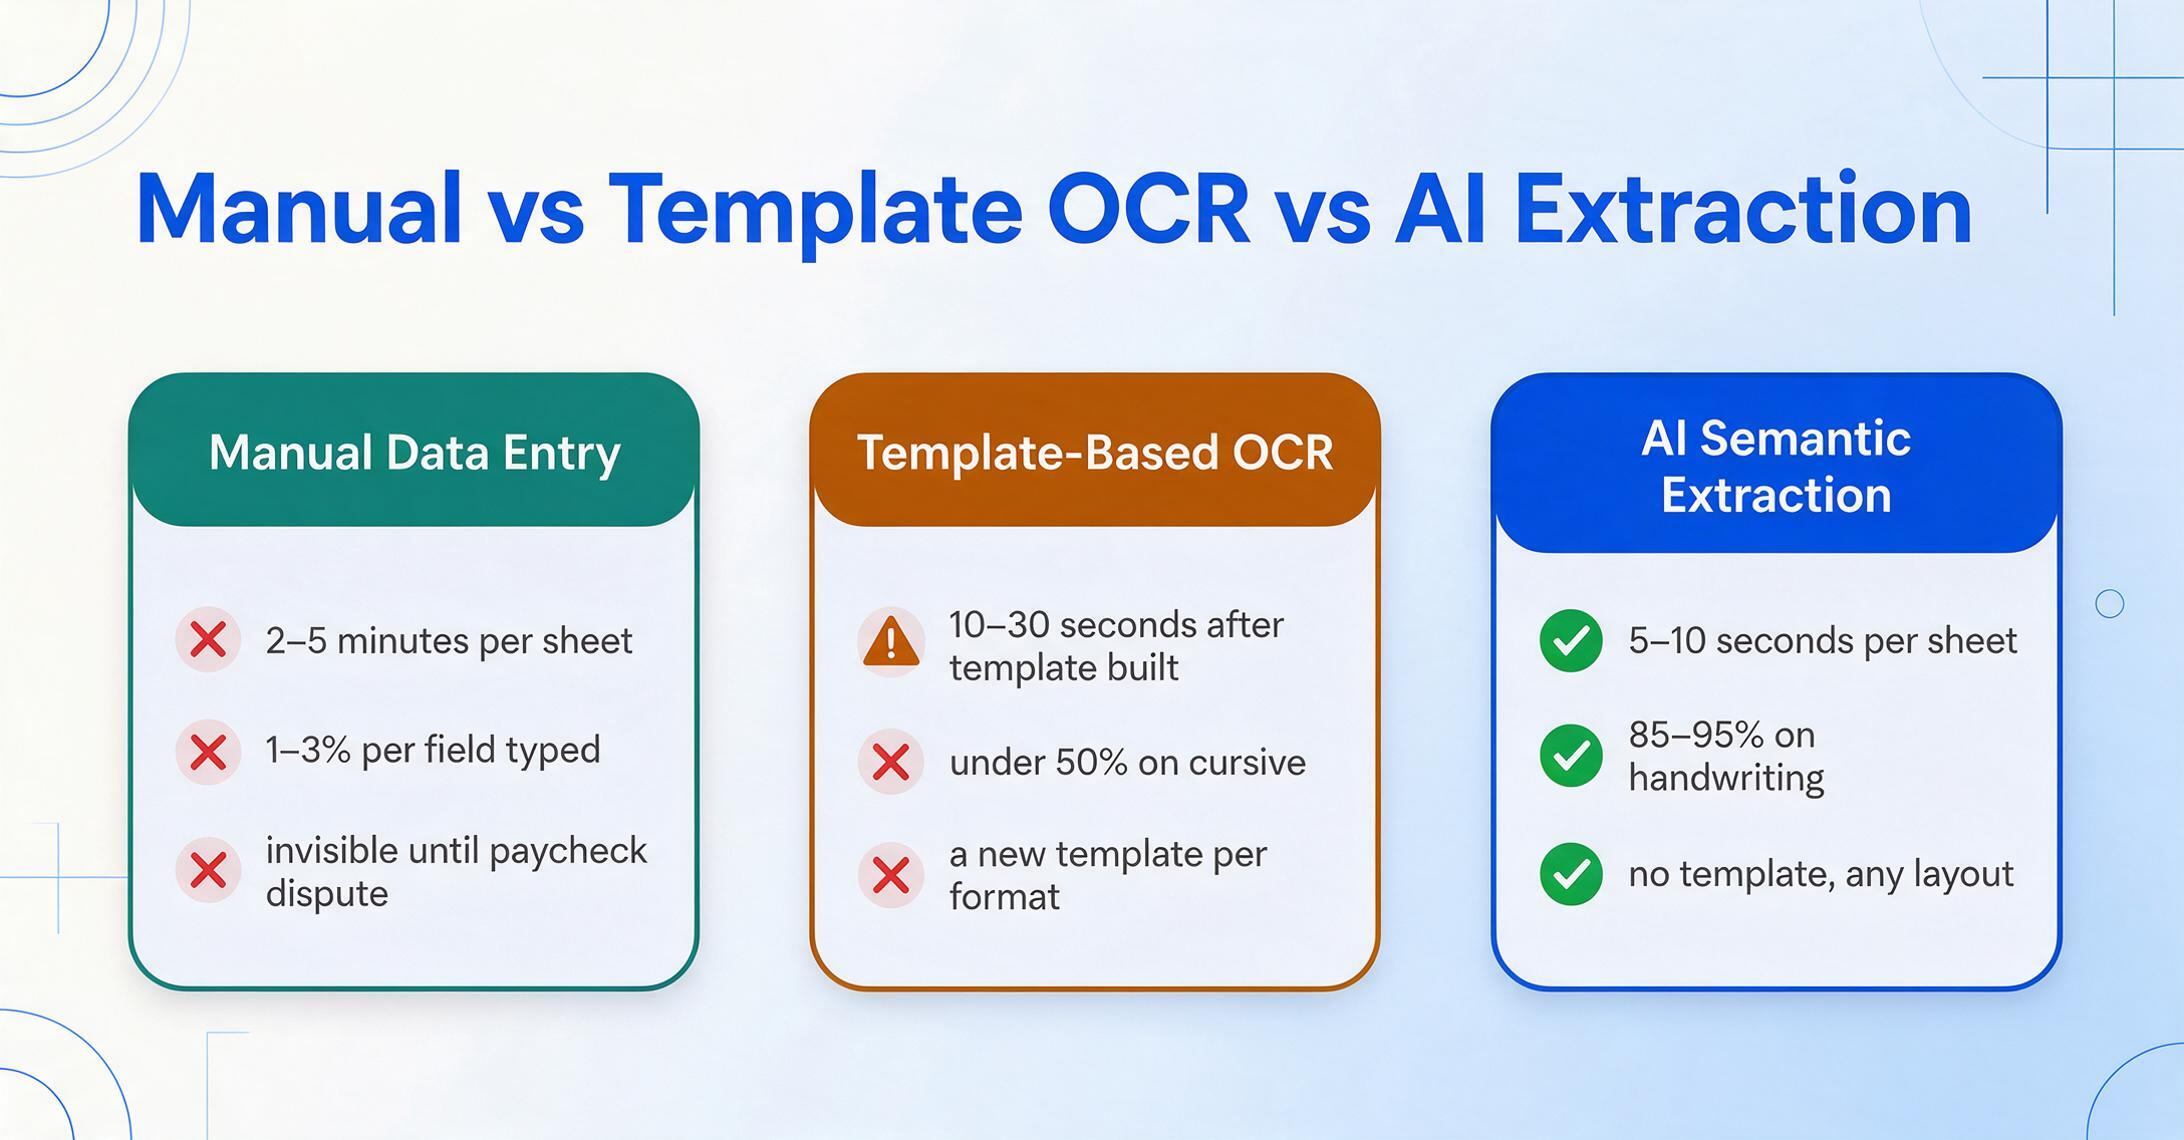
O ponto crítico: o OCR baseado em modelos falha exatamente no ponto em que a maioria das organizações mais precisa de extração. Se suas folhas de ponto vêm de uma única fonte em um único formato, você não precisa de extração — você já tem um processo digital padronizado. A extração é necessária justamente quando os formatos variam: cinco subcontratados enviando cinco layouts diferentes de folhas de ponto, uma agência de recrutamento com seu próprio formato de PDF, um cartão de papel legado de uma equipe que não usa aplicativos. Cada novo formato quebra um sistema baseado em modelos. Um sistema sem modelo lê todos eles com a mesma definição de coluna — porque localiza "Nome do Funcionário" entendendo como um nome de funcionário se parece, e não esperando encontrá-lo nas coordenadas (120, 45).
Esta é a decisão de arquitetura que determina se a extração reduz sua carga de trabalho ou apenas a transfere: extração baseada em posição (onde estão os dados?) vs extração baseada em semântica (o que os dados significam?). Ferramentas da primeira categoria — a maioria dos sistemas OCR legados e zonais — exigem que você mantenha um mapa de onde cada campo está em cada variante de documento. Ferramentas da segunda categoria — plataformas modernas de visão por IA — leem documentos como uma pessoa faria: entendendo o conteúdo, não combinando coordenadas. Se você processa folhas de ponto de mais de três fontes diferentes, o custo apenas da manutenção de modelos pode exceder o custo da entrada manual em menos de um ano. Para uma comparação mais aprofundada, nosso guia definitivo para extração de folhas de ponto cobre a camada de tecnologia em detalhes.
Os arquivos são processados com segurança e não são armazenados.
Campos Principais para Extração de Folhas de Ponto
Os campos que você extrai dependem de para onde os dados vão — uma folha de pagamento simples precisa de menos campos do que um relatório de folha de pagamento certificada Davis-Bacon, que precisa de menos campos do que uma planilha completa de alocação de custos de obra. Defina suas colunas de saída com base nos requisitos do seu sistema downstream, não no layout da folha de ponto.
Funcionário e Período
- Nome do Funcionário
- ID do Funcionário / Número do Crachá
- Fim da Semana / Data do Período de Pagamento
- Nome e Assinatura do Supervisor
Grade de Horas Diárias
- Horas Regulares — Segunda a Domingo
- Horas Extras (1,5× e 2×)
- Deduções de Pausa / Refeição
- Horas de Doença / Férias / Feriado
Projeto e Alocação de Custos
- Código do Projeto / Número da Obra
- Código de Custo / Código de Fase
- Classificação de Ofício / Especialidade
- Descrição do Trabalho / Tarefa
Folha de Pagamento e Conformidade
- Taxa Horária / Taxa de Pagamento
- Total de Horas Regulares
- Total de Horas Extras
- Taxa de Benefícios Adicionais
- Número de Determinação de Salário Vigente
A ferramenta de extração que você escolher deve permitir definir colunas uma vez e aplicá-las em todos os formatos de folha de ponto que sua organização recebe. Essa abordagem — chamada Extração de Colunas Personalizadas — significa que você define a estrutura de saída com base no que seu sistema de folha de pagamento ou ERP precisa, não no que cada folha de ponto individual fornece. Uma coluna de nome de trabalhador na sua saída capturará "John Smith" independentemente de o cartão de origem listá-lo como "John Smith", "Smith, John" ou "J. Smith" no canto superior esquerdo — a IA resolve cada variante para a mesma coluna de saída com base na compreensão semântica, não na correspondência posicional.
Processamento em lote: quando o volume torna a velocidade estrutural
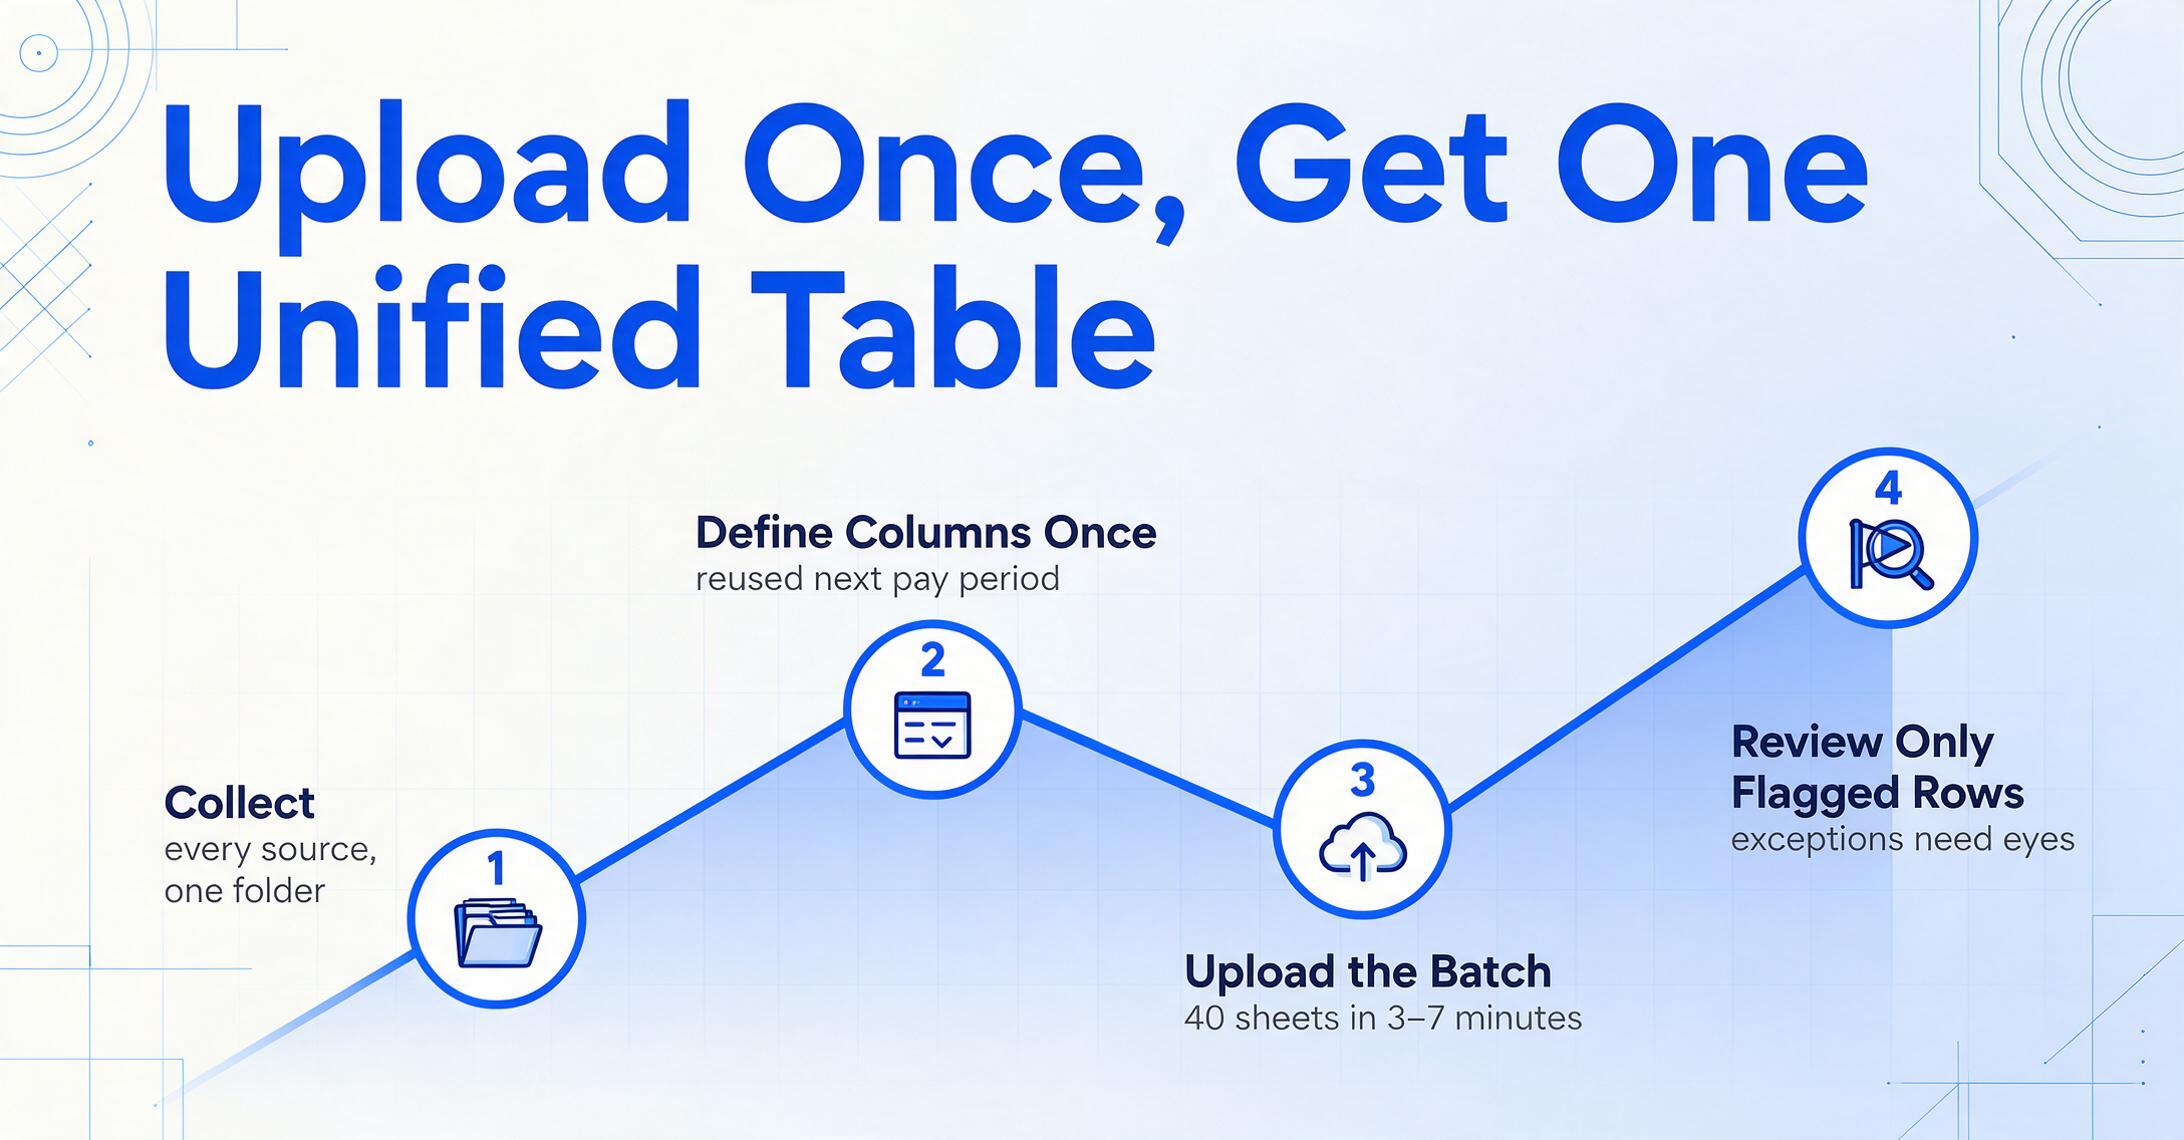
Processar 40 folhas de ponto uma a uma não é significativamente mais rápido do que a entrada manual quando você considera a sobrecarga de abrir cada arquivo, aguardar o processamento, revisar os resultados e passar para o próximo. A economia de tempo só se acumula quando você pode enviar todas as 40 de uma vez e receber uma única planilha unificada em troca.
O processamento em lote é a diferença operacional entre "a extração é uma demonstração interessante" e "a extração substituiu a tarde de quarta-feira do funcionário da folha de pagamento". O fluxo de trabalho é simples:
Colete todas as folhas de ponto do período de pagamento
Fotografe os cartões de papel, encaminhe os PDFs enviados por e-mail, baixe as exportações do portal — reúna todas as folhas de ponto em uma única pasta, independentemente do formato de origem. Sem pré-classificação, sem renomeação, sem padronização.
Defina suas colunas de saída uma vez
Configure a estrutura de colunas que corresponde ao seu formato de importação da folha de pagamento: Nome do funcionário, Data, Código do projeto, Horas regulares, Horas extras, Classificação, Código de custo. Essas colunas se aplicam a todas as folhas de ponto do lote, independentemente do layout. Salve o conjunto de colunas como um modelo para reutilização no próximo período.
Envie todas as folhas de ponto e processe como um lote
Envie a pasta inteira de uma vez. A ferramenta processa cada folha de ponto de forma independente, mas coleta todos os resultados em uma única tabela unificada — uma linha por trabalhador por folha de ponto, com colunas correspondentes à sua definição. Um lote de 40 folhas de ponto que levaria 2–3 horas de entrada manual é concluído em 3–7 minutos de tempo de processamento.
Revise os resultados sinalizados, não todos os campos
Em vez de verificar 240 campos individuais (40 planilhas × 6 campos), revise apenas as células que a IA sinalizou como incertas — normalmente 5–15% dos campos. Faça uma verificação por amostragem aleatória das extrações confiáveis. A etapa de revisão passa de verificação abrangente de entrada de dados para garantia de qualidade baseada em exceções.
A arquitetura de processamento prioritário em lote é especialmente importante para ciclos de folha de pagamento com prazos rígidos. Se as folhas de ponto chegam na sexta-feira à tarde e a folha de pagamento deve ser enviada até terça-feira de manhã, um processo que exige processamento sequencial é um processo que falha durante a temporada de férias. O processamento em lote permite que a extração seja executada em segundo plano enquanto a equipe de folha de pagamento revisa os resultados — paralelizando o que antes era um fluxo de trabalho serial e dependente de pessoas.
Exportação e Integração com Folha de Pagamento/ERP
Dados extraídos que ficam em uma planilha que você não consegue conectar ao seu sistema de folha de pagamento são apenas uma forma diferente de entrada manual. A etapa de integração é onde a extração entrega valor ou vira um projeto de pesquisa.
A maioria das ferramentas modernas de extração exporta para Excel (XLSX) ou CSV — formatos que todas as principais plataformas de folha de pagamento e ERP aceitam como fonte de importação. O fator crítico não é se a ferramenta consegue produzir esses formatos (quase todas conseguem), mas se a estrutura das colunas de saída corresponde ao que seu sistema downstream espera. Se o seu sistema de folha de pagamento importa "Employee ID" como cabeçalho de coluna e sua saída de extração rotula como "Worker Number", você está renomeando uma coluna antes da importação — não redigitando dados. A estrutura está correta; a convenção de nomenclatura é sua para controlar.
Os ecossistemas de software para integração de dados de folhas de ponto se enquadram em três categorias:
| Categoria | Plataformas | Método de Integração | Caso de Uso Típico |
|---|---|---|---|
| Folha de Pagamento Geral | ADP Workforce Now, Paychex Flex, QuickBooks Payroll, Gusto, Sage | Importação CSV/XLSX | Folha de pagamento horária padrão para funcionários diretos; folhas de ponto de agências de trabalho temporário e contratados |
| ERP para Construção | Sage 300 CRE, Viewpoint Vista, Foundation, HCSS HeavyBid, Procore | Importação CSV/XLSX com mapeamento de código de custo e campos de projeto | Alocação de custos de obra, folha de pagamento certificada, reconciliação de horas entre campo e escritório |
| Folha de Pagamento Certificada | LCPtracker, eMars, Miter, Payroll4Construction | Importação CSV ou integração direta | Geração do Formulário WH-347, conformidade com salário vigente, relatórios sindicais |
Para equipes que trabalham com Google Sheets — comum em operações de construção e serviços de campo de pequeno e médio porte — ferramentas de extração com um complemento do Google Sheets eliminam completamente a etapa de exportação-importação. Os dados extraídos chegam diretamente em uma aba da planilha, prontos para importação na folha de pagamento ou compartilhamento com a equipe de contabilidade. Para organizações que processam tipos variados de documentos além de folhas de ponto, a ferramenta relacionada converter folhas de ponto para Excel lida com extração em lote de formato único.
Se o seu sistema de folha de pagamento ou ERP exige uma ordem específica de campos ou uma convenção de nomenclatura de colunas, verifique se a ferramenta de extração permite nomear colunas livremente — a maioria permite, mas algumas geram cabeçalhos de coluna automaticamente a partir dos rótulos dos campos do documento, o que produz nomes de coluna inconsistentes quando os formatos de folha de ponto variam dentro de um lote. Uma ferramenta que permite definir e salvar modelos de coluna garante que a estrutura de saída corresponda ao seu formato de importação em todos os períodos, independentemente de quantos formatos de origem diferentes estavam no lote.
Folha de pagamento certificada, salário vigente e conformidade na construção civil
Para empreiteiros de construção que trabalham em projetos financiados pelo governo federal, a extração de dados de folhas de ponto não é apenas uma questão de eficiência — é a diferença entre uma submissão de folha de pagamento certificada limpa e uma violação de conformidade que pode custar empregos, dinheiro e elegibilidade para licitações.
De acordo com a Lei Davis-Bacon (40 U.S.C. § 3141 et seq.), qualquer contrato federal de construção que exceda $2.000 exige que os empreiteiros paguem aos trabalhadores as taxas de salário vigente local e apresentem relatórios semanais de folha de pagamento certificada — normalmente no Formulário WH-347 — documentando o nome de cada trabalhador, classificação profissional, horas trabalhadas por dia, taxa salarial e benefícios adicionais. Trinta e dois estados adicionam suas próprias leis de salário vigente sobre a estrutura federal, cada uma com diferentes limites, métodos de cálculo e formatos de relatório.
As instruções do DOL são explícitas: se um trabalhador atuou em mais de uma classificação durante a semana, a folha de pagamento certificada deve mostrar "um detalhamento preciso das horas trabalhadas em cada classificação de trabalho". Quando os dados de tempo se originam como números manuscritos em um cartão de papel — "João — Carpinteiro 3h, Servente 5h, Operador 2h" — o caminho desse cartão até um WH-347 em conformidade passa pela entrada manual de dados. Cada digitação nesse caminho carrega a mesma taxa de erro de 1–3% de qualquer outra transcrição manual, mas as consequências são mais severas: uma hora classificada incorretamente é revertida para a maior taxa salarial aplicável para todas as horas; um padrão de erros pode gerar restituição de salários atrasados, multas de até $13.508 por violação e descredenciamento de futuros contratos federais.
Como a extração se encaixa no fluxo de trabalho da folha de pagamento certificada:
Extrair a classificação como um campo de primeira classe
Defina "Classificação" como uma coluna no seu modelo de extração. A IA lê o ofício ou especialidade conforme escrito na folha de ponto — "Carpinteiro", "Eletricista", "Servente", "Operador" — e o gera junto com as horas. Quando um trabalhador divide 3 horas como Eletricista e 5 como Servente, você obtém duas linhas com duas classificações. A ferramenta de extração não atribui taxas salariais (isso depende do número de determinação salarial do projeto, que varia por condado e contrato), mas fornece os dados estruturados de classificação que o mapeamento de taxas salariais exige.
Mapear os dados extraídos para os campos do Formulário WH-347
A saída da extração fornece nome do trabalhador, classificação, horas diárias (regulares e extras), taxa de pagamento e identificação do projeto — os campos principais exigidos pelo WH-347. Estruturados em um CSV, esses dados podem alimentar diretamente softwares de folha de pagamento certificada (LCPtracker, eMars, Miter) ou servir como fonte verificada para preenchimento manual do formulário. A etapa eliminada é a transcrição do papel para o digital — a etapa onde erros de digitação entram na cadeia de conformidade.
Manter uma trilha de auditoria digital
De acordo com os regulamentos da Lei Davis-Bacon (29 CFR Parte 3), os registros de folha de pagamento certificada devem ser mantidos por pelo menos três anos após a conclusão do projeto. A extração cria um registro digital que inclui a foto original da folha de ponto mais os dados estruturados extraídos — uma trilha de auditoria contemporânea que os originais em papel sozinhos não podem fornecer. Se um auditor questionar uma classificação ou contagem de horas três anos depois, você pode mostrar o documento de origem e a saída da extração que corresponde a ele.
O que a extração não faz: gerar um WH-347 completo e assinado. A Declaração de Conformidade na página 2 do formulário exige a assinatura de um responsável com conhecimento da folha de pagamento — atestando que os salários estão corretos, as classificações são precisas e os benefícios complementares foram pagos. Essa certificação é responsabilidade legal do contratante e não pode ser automatizada. A extração elimina os erros de entrada de dados que causam falhas nas certificações; ela não substitui a certificação em si. Para o contexto regulatório completo, consulte nosso guia sobre extração de dados de folhas de ponto na construção.
Os relatórios sindicais adicionam outra dimensão de conformidade. As classificações de ofícios sindicais (Carpinteiro, Eletricista, Servente, Operador de Máquinas, Ferreiro Armador, Encanador/Canalizador) não são apenas categorias de folha de pagamento — são obrigações contratuais com escalas salariais específicas, taxas de contribuição para benefícios complementares e proporções de aprendiz para oficial. Quando um encarregado escreve "Joe — 8h" sem especificar que 3 dessas horas eram de Carpintaria Sindical e 5 eram de trabalho geral, a ferramenta de extração só pode gerar o que o cartão registra. A correção estrutural não é uma extração melhor — são cartões de ponto melhores. Exigir a classificação no documento de origem é a melhoria de conformidade de maior impacto que um contratante de construção pode fazer, independentemente da ferramenta de processamento que usar.
O Que Observar em uma Ferramenta de Extração de Dados de Folhas de Ponto
As ferramentas de extração de dados de folhas de ponto variam de sistemas OCR legados que exigem configuração de modelo por formato a plataformas modernas de IA que leem semanticamente. Seis critérios separam as ferramentas que reduzem a carga de trabalho da folha de pagamento daquelas que apenas movem a digitação para uma tela diferente.
1. Operação sem modelo e independente de formato. Este é o diferencial mais importante — porque os formatos de folhas de ponto se multiplicam a cada subcontratado, agência de recrutamento e equipe de campo adicionada à sua operação. Uma ferramenta que exige que você defina um modelo de análise por formato não é extração; é gerenciamento de modelos. A extração sem modelo lê por compreensão semântica: uma folha de ponto de uma fonte que você nunca processou antes funciona no primeiro upload. Pergunte ao fornecedor: "Se eu receber uma folha de ponto em um formato que nunca vi, ela funciona imediatamente?" Se a resposta envolver "primeiro crie um modelo de análise", você está comprando manutenção, não automação.
2. Precisão da caligrafia em condições reais. O vídeo de demonstração mostrando um PDF perfeitamente digitalizado não é o teste. Peça para testar com suas piores folhas de ponto reais — o cartão da equipe escrito à mão com classificações na margem, o cartão onde um 4 parece um 9, a foto tirada ao anoitecer em um canteiro de obras. Uma ferramenta que só lida com PDFs digitais limpos e impressos resolve os fáceis 30–40% do seu volume de folhas de ponto — e deixa os difíceis 60% na sua mesa. O benchmark IJRISS 2025 de 87,92% de precisão em condições degradadas é um ponto de referência útil, mas seu próprio teste de pior caso lhe dirá mais do que qualquer número publicado.
3. Preservação da estrutura de tabelas e grades. Uma folha de ponto é uma grade, não um formulário. A ferramenta deve entender as relações linha-coluna e preservá-las na saída. Se a extração vê "8" em uma célula, mas não consegue dizer que são as horas regulares de terça-feira de João Silva na linha correta, a saída é inutilizável para a folha de pagamento. Teste com folhas de equipe — um cartão listando 6–12 trabalhadores — e verifique se a saída produz uma linha por trabalhador, com as horas de cada um corretamente atribuídas às colunas de dias certas.
4. Arquitetura de processamento em lote em primeiro lugar. Processar folhas de ponto uma a uma elimina a economia de tempo que justifica o uso da extração em primeiro lugar. A ferramenta deve aceitar uploads em lote (40+ arquivos de uma vez), processá-los em paralelo e produzir uma tabela de saída unificada. Uma ferramenta projetada para processamento de documento único com capacidades de lote adicionadas depois mostrará suas falhas sob volume real de folha de pagamento.
5. Suporte a colunas calculadas para horas extras e cálculos. A parte mais demorada do processamento manual de folhas de ponto não é transcrever horas — é calcular horas extras com base em regras específicas da jurisdição. Uma ferramenta com colunas calculadas permite definir uma coluna como "Horas de OT (horas > 40/semana → 1,5×; horas > 8/dia → 1,5×)" e a IA aplica o cálculo durante a extração. Isso elimina a etapa separada de planilha de cálculo que normalmente segue a entrada manual de dados.
6. Exportação compatível com folha de pagamento com estrutura de colunas consistente. A saída da extração deve corresponder ao que seu sistema de folha de pagamento ou ERP espera — tanto no formato de arquivo (XLSX ou CSV) quanto na estrutura de colunas. Se você tiver que reestruturar, reformatar ou reordenar colunas antes da importação, a extração encurtou a etapa de digitação, mas criou uma nova etapa de manipulação de dados. As melhores ferramentas permitem salvar modelos de colunas que produzem estrutura de saída idêntica a cada período de pagamento, independentemente de quantos formatos diferentes de folhas de ponto estavam no lote de origem.
Perguntas Frequentes
A IA consegue ler folhas de ponto manuscritas com precisão?
Sim. Os modelos modernos de IA de visão leem dados de folhas de ponto manuscritas — nomes, horas, classificações, códigos de custo — em cartões de papel preenchidos em campo. O estudo IJRISS de 2025 constatou que a IA multimodal alcançou 87,92% de precisão em documentos originais, dobrados, amassados e molhados, superando substancialmente o OCR tradicional. A letra de forma clara é altamente confiável (95%+); a cursiva apressada com números ambíguos (1 vs. 7, 4 vs. 9) continua sendo o caso mais difícil. A IA usa o contexto — cabeçalhos de coluna por dia da semana, rótulos de linha, estrutura de grade — para desambiguar caracteres que um mecanismo de OCR tradicional adivinharia. A diferença prática: em vez de digitar cada campo manualmente, você revisa uma planilha pré-preenchida e corrige a entrada ambígua ocasional.
Como a extração de folhas de ponto difere do QuickBooks Time ou do ADP?
O QuickBooks Time e o ADP Workforce Now são aplicativos de controle de ponto — os funcionários registram entrada e saída digitalmente, e as horas fluem diretamente para a folha de pagamento. Eles evitam que folhas de ponto em papel sejam criadas na origem. A extração de folhas de ponto processa folhas de ponto em papel que já existem — de subcontratados, agências de pessoal, equipes de campo sem acesso a aplicativos ou registros legados. Eles resolvem problemas diferentes: o aplicativo é a montante (captura), a ferramenta de extração é a jusante (processamento do que foi capturado em papel). Muitas organizações usam ambos: aplicativos de controle de ponto para funcionários diretos, extração para folhas de ponto de fontes externas que chegam em papel, independentemente do aplicativo que você implantou.
A extração de folhas de ponto lida com cálculos de horas extras automaticamente?
Sim, quando a ferramenta suporta colunas calculadas. Você define uma coluna como "Horas Extras (horas > 40/semana → 1,5×)" e a IA soma as entradas diárias por trabalhador, determina quais horas ultrapassam o limite e gera o total de horas extras. As regras de horas extras na construção são específicas de cada jurisdição — a Lei Davis-Bacon federal exige 1,5× após 40 horas/semana, a Califórnia exige 1,5× após 8/dia e 40/semana, com dobro após 12/dia, e acordos sindicais podem adicionar limites totalmente diferentes. Uma ferramenta com capacidade de colunas calculadas permite codificar as regras que se aplicam aos seus projetos e fazer a IA calcular o resultado durante a extração, eliminando a etapa de cálculo em planilha após a extração.
O que acontece quando um trabalhador divide o tempo entre vários projetos ou códigos de custo?
Se a folha de ponto em papel capturar a divisão — por exemplo, "Projeto A: 4 horas, Projeto B: 4 horas" — a ferramenta de extração lê ambas as alocações e gera duas linhas separadas para esse trabalhador, cada uma com o código de projeto e as horas corretos. Se a folha de ponto em papel não capturar a divisão e mostrar apenas "8 horas", a ferramenta de extração gera o que está no cartão — ela não inventará uma divisão. Isso destaca uma questão estrutural: a ferramenta de extração só pode ser tão precisa quanto a folha de ponto que lê. A causa mais comum de divisões de código de custo ausentes é o encarregado ou trabalhador não registrá-las no documento de origem, não uma falha da tecnologia de extração.
A extração pode produzir um formulário de folha de pagamento certificada WH-347 completo?
Não — e nenhuma ferramenta deveria afirmar que pode, pois o WH-347 exige uma Declaração de Conformidade assinada atestando a precisão dos salários informados, o que é responsabilidade legal do contratante sob a Lei Davis-Bacon. O que a extração oferece são os dados estruturados que o formulário precisa: nome do trabalhador, classificação, horas diárias (regulares e extras), taxa de pagamento e identificação do projeto — em um formato que pode preencher os campos do WH-347 ou importar diretamente para softwares de folha de pagamento certificada como LCPtracker, eMars ou Miter. A etapa de certificação continua sendo obrigação do contratante, mas a etapa de entrada de dados, que causa a maioria dos erros de conformidade, é eliminada.
Os dados extraídos podem alimentar o Sage 300 CRE ou o Viewpoint Vista?
Sim. Sage 300 CRE, Viewpoint Vista, Foundation e HCSS HeavyBid aceitam importações estruturadas de Excel ou CSV. A saída da extração é um arquivo XLSX ou CSV padrão com cabeçalhos de coluna consistentes — o mesmo formato que esses ERPs de construção importam. O requisito principal é que a estrutura das colunas de saída corresponda ao que seu ERP espera. Se o Sage espera "Código do Trabalho" e sua coluna de extração é "Número do Projeto", você renomeia o cabeçalho antes da importação. As horas, classificações, códigos de custo e atribuições de projeto são preenchidos corretamente; você está mapeando nomes de colunas, não redigitando dados.
Qual é a diferença de precisão entre extração por IA e entrada manual de dados?
A extração por IA alcança 85–99% de precisão em nível de campo, dependendo da qualidade do documento — 95–99% em PDFs impressos limpos, 85–95% em cartões de campo manuscritos. A entrada manual de dados tem uma taxa de erro de 1–3% por campo digitado, mas, ao contrário dos erros de extração (que ficam visíveis para revisão), os erros manuais são invisíveis até que uma disputa de pagamento os revele. Uma folha de ponto semanal com 60 campos tem 45–83% de probabilidade de conter pelo menos um erro de digitação. A vantagem estrutural da extração não é necessariamente maior precisão bruta — é que os erros são expostos para revisão em vez de ficarem enterrados em um processamento de folha de pagamento.
Preciso de extração se todos os meus funcionários usam um aplicativo de controle de ponto?
Não para esses funcionários. Aplicativos de controle de ponto produzem dados digitais estruturados que fluem nativamente para a folha de pagamento — a extração não agrega valor a um registro digital de ponto. A extração é relevante quando seu fluxo de folha de pagamento inclui folhas de ponto de fontes que não usam seu aplicativo: subcontratados com seus próprios sistemas em papel, agências de staffing que enviam PDFs por e-mail, equipes de campo em locais sem serviço de celular confiável ou registros antigos em papel que precisam ser digitalizados. Se 100% da sua força de trabalho registra o ponto digitalmente, você não precisa de extração de folhas de ponto. A maioria das organizações com mais de 20 trabalhadores de campo fica bem abaixo de 100% de adoção digital — e é nessa lacuna que a extração substitui a entrada manual.
Quais formatos de arquivo as ferramentas de extração de folhas de ponto aceitam?
A maioria das ferramentas de extração com IA aceita JPG, PNG, PDF e WebP — cobrindo fotos de celular, documentos digitalizados e PDFs gerados digitalmente. Algumas também aceitam TIFF (comum em digitalização empresarial) e AVIF. A capacidade crítica é lidar com fotos de celular — porque a fonte mais comum de folhas de ponto em papel em 2026 é um encarregado fotografando o cartão da equipe com um smartphone e enviando por mensagem de texto ou e-mail para o escritório. Uma ferramenta que exige documentos digitalizados em scanner de mesa, com correção de inclinação e 300 DPI está resolvendo um problema de 2015. A entrada no mundo real é uma foto de celular levemente inclinada e com iluminação irregular — e a extração deve funcionar nela sem pré-processamento.
Quanto custa a extração de folhas de ponto em comparação com o lançamento manual?
As ferramentas de extração com IA normalmente custam US$ 9–US$ 39/mês para usuários individuais ou US$ 39–US$ 99/mês para pequenas equipes, com níveis baseados no uso em volumes maiores. Compare isso com o custo do lançamento manual: a 3 minutos por folha de ponto e uma taxa de US$ 25/hora para um funcionário de folha de pagamento com encargos, processar 100 folhas de ponto por semana custa US$ 125/semana ou US$ 6.500/ano apenas em mão de obra — sem contar o custo de erro de 1–8% na folha de pagamento identificado pela APA. Nesses volumes, a extração se paga financeiramente no primeiro mês. A comparação de custos se torna mais dramática quando você inclui a exposição à conformidade: uma única violação da Lei Davis-Bacon pode custar mais do que uma década de assinaturas de ferramentas de extração.
Do Cartão de Ponto à Execução da Folha de Pagamento
A extração de folhas de ponto não substitui seu software de folha de pagamento — ADP, Sage, Viewpoint e Paychex fazem bem o trabalho deles. Trata-se de fechar a lacuna entre onde os dados de tempo se originam (um cartão de papel, uma foto de celular, um PDF de subcontratado) e onde precisam chegar (uma linha estruturada no seu sistema de folha de pagamento, uma linha no WH-347, uma alocação de custo no seu razão de custos da obra).
Essa lacuna é atualmente preenchida por digitação humana — cada uma com 1–3% de chance de erro, multiplicada por centenas de campos por execução de folha, com custos que se acumulam de correções de folha a violações de conformidade e dados corrompidos de custos de obra que geram estimativas erradas para a próxima licitação. A tecnologia para ler um cartão de ponto — entender sua estrutura de grade, decifrar a caligrafia no canteiro de obras, preservar classificações de ofício e gerar dados estruturados com código de custo — existe hoje sem modelos, sem treinamento e em qualquer formato.
A melhor maneira de avaliar se a extração se encaixa no seu fluxo de folha de pagamento é testá-la nos seus cartões de ponto reais — especialmente os difíceis que você teme processar a cada período de pagamento. Envie um cartão de ponto de amostra e veja os dados estruturados que você recebe de volta — ou use a demonstração incorporada acima para testar a extração agora mesmo com o preset de cartão de ponto.