完全ガイド:
保険金請求データ抽出(2026年版)
1件の自動車事故請求では、請求者からのACORD 2フォーム、対応機関からの警察報告書、修理工場からの修理見積書、負傷がある場合の医療受付フォーム、3台のスマートフォンからの写真が発生します。各書類は異なる形式・異なる送信元・異なるレイアウトで届き、アジャスターはそれらすべての構造化データを同じ請求レコードに紐付ける必要があります。これこそが保険金請求データ抽出の真の課題であり、ほとんどの抽出ツールが対応できるように設計されていない課題です。
重要ポイント
- 請求アジャスターは、専門性が評価される補償分析・和解交渉・調査に着手する前に、データ入力に週17〜25時間を費やしており、時給35〜45ドルに相当します。
- 見える人件費は氷山の一角にすぎません。エラー修正・アジャスターの生産性低下・サイクルタイムの遅延は別々の予算に計上され、手作業による請求処理コストが給与明細の約2倍になることを示す単一のレポートは存在しません。
- 書類タイプごとに再利用可能な列定義を1つ作成するだけで(ACORDフォーム・警察報告書・修理見積書)、バッチ内のすべての書類から構造化フィールドを抽出でき、アジャスターは信頼度スコアリングでフラグが付いた例外のみをレビューします。
保険金請求データ抽出とは?
保険金請求データ抽出とは、請求関連書類(ACORD損害通知書、警察報告書、修理見積書、医療記録、その他の添付書類)から主要なフィールドを読み取り、スプレッドシート、請求管理システム、または分析プラットフォームが取り込める構造化データに変換する自動化プロセスです。単一の書類タイプを対象とする標準的な請求書や領収書の抽出とは異なり、請求抽出は、各構成要素が独自の形式、独自の主要フィールド、独自の抽出要件を持つ複数書類パケットを処理する必要があります。
その範囲はファースト・ロス・ノーティス(FNOL)だけにとどまりません。完全な請求抽出戦略は、受け付けから決済までに請求ファイルに入るすべての書類(自動車、不動産、一般賠償責任、労災のいずれかの初期ACORDフォーム、損失を裏付ける添付書類、請求の進行に伴って蓄積される継続的な通信文書や請求書類)をカバーします。特に初期ACORDフォームからAIが抽出できるものとできないものの詳細なフィールドレベルの内訳については、関連記事「AIは保険金請求FNOLフォームを読み取れるか?」をご覧ください。
このカテゴリが他の文書抽出タスクと異なる点は、請求パケットの階層構造にあります。ACORDフォームの構造化されたヘッダーフィールド(保険証券番号、事故発生日、被保険者名、事故場所)は予測可能なパターンに従い、確実に抽出できます。一方、損失説明セクションの自由記述テキストはそうではありません。添付書類(ある管轄区域の警察報告書、別のソフトウェアシステムの修理見積書、さらに別の医療記録)は、それぞれ個別の抽出戦略が必要です。完全なアプローチは、最も都合の良い層だけでなく、3つの層すべてを考慮に入れます。
手動の請求データ入力が、見た目以上にコストがかかる理由
手動の請求データ入力にかかる目に見えるコストは単純です。データ入力担当者やアジャスターが、各書類のフィールド値を請求システムに一文字ずつ入力していく作業です。McKinseyの試算では、自動化により請求処理時間を最大50%短縮し、請求プロセス全体のコストを最大30%削減できるとされています。しかし、こうした平均的な数字は、手動処理が実際に運用にもたらすコストを過小評価しています。実際の費用は、ほとんどの企業が別々の予算で管理している4つの異なる経路を通じて発生するからです。
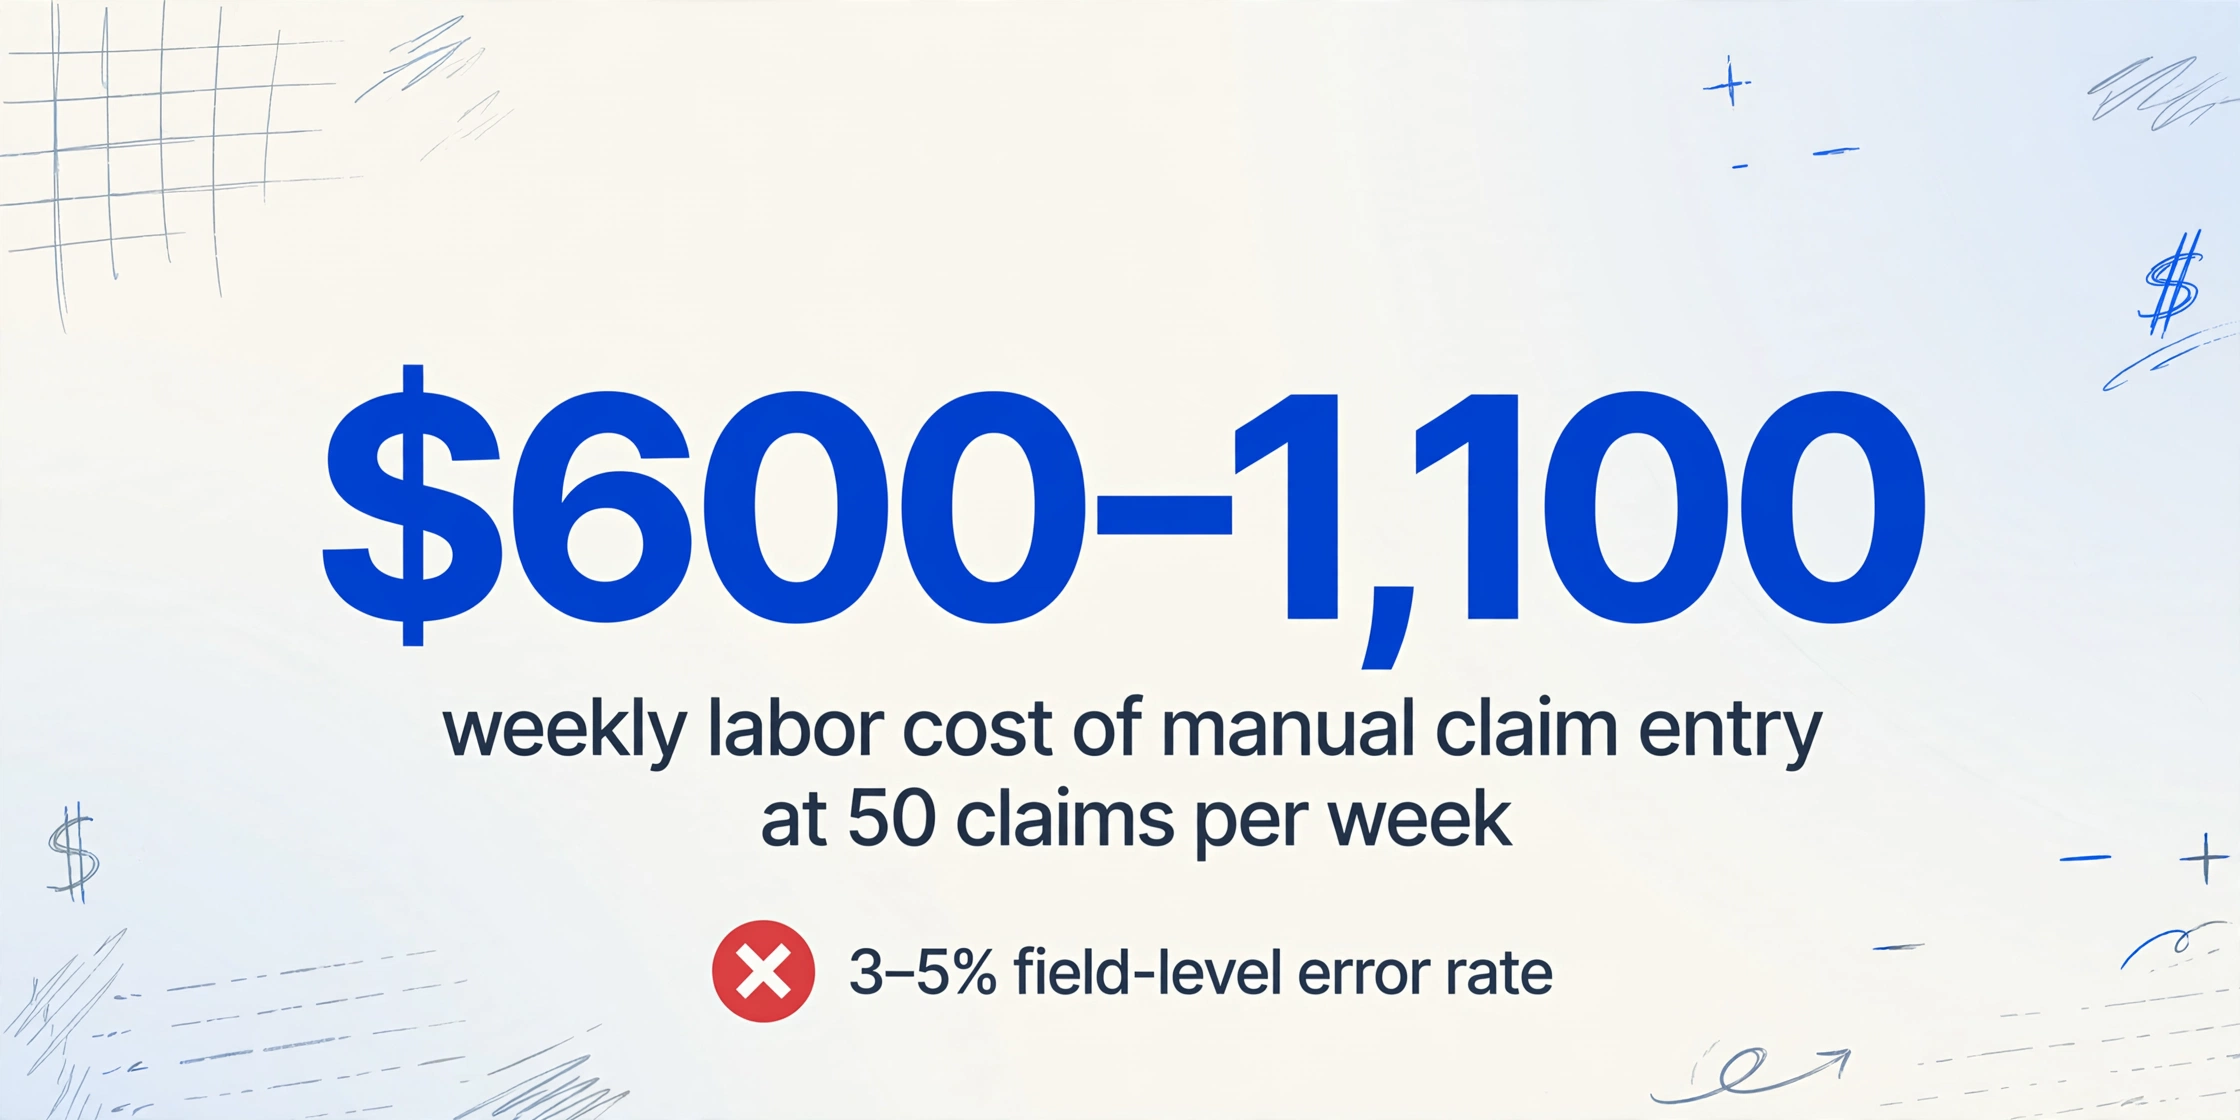
直接的な転記作業のコスト。 アジャスターや請求担当者が1件の請求パケット(ACORDフォームに加えて補助書類2〜3点)を処理する場合、データ入力だけでおよそ20〜30分かかります。週50件の請求を処理する場合、純粋なタイピング作業だけで17〜25時間になります。経験豊富な請求担当者の時間単価が35〜45ドルだとすると、週あたり600〜1,100ドルの人件費が、請求に何ら判断的価値を加えることなく消費されていることになります。
エラーによる税金。 保険書類の手動データ入力には、フィールドレベルのエラー率が推定3〜5%あります。ACORDフォームと添付書類を合わせて抽出可能なフィールドが25〜40個ある請求パケットの場合、1件あたり1〜2件のエラーが発生することになります。保険証券番号の入力ミスは資格確認を遅らせます。事故発生日の誤りは、被保険者への確認電話を引き起こします。修理見積もりの金額の桁違いは、照合に時間がかかる積立金の不一致を生みます。業界のベンチマークによると、請求1件あたりのデータ入力エラーの修正コストは15〜30ドルですが、エラーが受付時ではなく後工程で発見された場合、これらのコストはさらに膨らみます。
アジャスター時間の機会費用。 McKinseyの調査によると、引受担当者と請求アジャスターは、データ入力や書類検索などの管理業務に時間の30〜40%を費やしています。100〜150件の未処理請求を抱えるシニアアジャスターの場合、週に12〜20時間を、保険金支払い範囲の調査、和解交渉、複雑な案件の管理ではなく、タイピングに費やしていることになります。この時間のドル価値はアジャスターの給与全額に相当します。機会費用は、その時間を判断業務に振り向けていれば生み出せたであろう請求処理スピードと顧客満足度です。
サイクルタイムの遅延。 書類の受領からデータが利用可能になるまでの手動ステップは、請求ライフサイクルに何時間もの遅延を追加します。大量の請求を処理する業務(1日200件以上の請求を処理するTPA、急増する請求量に対応する災害対応チーム)では、こうした数時間の遅延が数日間に積み重なります。J.D. Powerの請求満足度調査では、FNOL処理のスピードが顧客満足度を左右する最も強い要因の一つであることが一貫して示されています。手動処理による遅延が1日増えるごとに、顧客体験は悪化し、訴訟、規制当局への苦情、エスカレーションの可能性が高まります。
これら4つのコストは代替ではなく、積み重なるものです。 直接的な請求データ入力の人件費として月2,500ドルを費やしている業務では、エラー修正、アジャスターの生産性低下、サイクルタイムの遅延において、同額のコストが発生している可能性が高いと言えます。手動の請求データ入力にかかる実際のコストは、目に見える人件費の項目のおよそ2倍であり、単一のレポートで全体像が明らかになることのない、複数の予算に分散して埋もれているのです。
保険金請求データ抽出が他の文書タイプと異なる点
保険金請求データ抽出は、請求書やレシートの抽出と技術的なDNAを共有しています。同じビジョン言語モデル、同じカスタム列アプローチを使用しますが、3つの構造的要因により、根本的により難しい問題となっています。
1. 保険会社および業務ラインごとのフォーマット差異。 ACORD 1(財産損失通知書)とACORD 2(自動車損失通知書)は、収集する情報が異なるため見た目が異なります。しかし、Applied Epic代理店管理システムで作成された同じACORD 1は、Vertafore AMS360で作成されたものとは異なる表示になり、さらに手書きで記入された紙のフォームとも異なります。ACORDは800以上の標準化されたフォームタイプを維持しています。米国の約39,000の独立系P&C代理店は、それぞれ独自のシステム設定、印刷設定、記入習慣でこれらのフォームを作成します。固定フィールド座標に依存するテンプレートベースの抽出は、レイアウトが変わるとすぐに機能しなくなります。フィールドラベルを読み取って値を特定するセマンティック抽出は、保険会社ごとの設定なしでこの差異に対応します。この違いについては、従来のOCRとAI駆動型抽出の比較に関する解説で詳しく説明しています。
2. 複数文書で構成される保険金請求パケット。 請求書抽出ツールは1枚の請求書を処理します。保険金請求抽出ワークフローはフォルダ全体を処理します。ACORDフォーム、警察報告書、修理見積書、医療記録、写真、場合によってはレッカー伝票やレンタル契約書などです。各文書タイプには、独自の標準フィールド、独自のレイアウト規則、独自の抽出列定義があります。課題は単一の文書を抽出することではなく、出力を同じ保険金請求レコードにリンクしたまま、一貫したワークフローですべてを抽出することです。
3. 構造化フィールドと自由記述テキストが1つの文書に共存。 ACORDフォームは、1ページに両方のモードを組み合わせている点で独特です。ヘッダーには明確にラベル付けされた短い値のフィールドがあり、AIは高い精度で抽出します。Description of Lossセクションは、ナラティブな散文のための空白ボックスです。50語でも500語でも、手書きでもタイプでも、焦点が定まっていても散漫でも構いません。これら2つのモードは同じ文書内に共存し、根本的に異なる処理が必要です。
構造化フィールド:確実に抽出できる項目
ACORDフォームの構造化ヘッダーフィールドは、AI抽出が最も価値を発揮する部分です。これらのフィールドには印刷されたラベル、制約された値の範囲、一貫した意味パターンがあり、ビジョン言語モデルにとって理想的な条件です。以下は、P&C保険金請求受付の大部分をカバーする4つの主要なACORD FNOLフォームタイプ別の主要フィールドです。
ACORD 1 — 財物損害通知
| フィールド | 形式 | 現実的な精度 |
|---|---|---|
| 保険証券番号 | 英数字、8〜15文字 | 95%以上 |
| 被保険者氏名・連絡先 | 氏名+住所+電話番号 | 95%以上 |
| 損害発生日時 | 日付+時刻 | 95%以上 |
| 損害発生場所 | 住所または交差点 | 90%以上 |
| 損害の種類(チェックボックス) | チェックボックス:火災・風災・雹・水災・盗難 | 85〜90% |
| NAIC保険会社コード | 5桁の数字 | 95%以上 |
| 推定損害額 | 通貨 | 90%以上 |
| 保険免責金額 | 通貨 | 90%以上 |
| 抵当権者/担保権者 | 氏名+住所 | 85%以上 |
| 警察報告番号 | 英数字 | 80%以上(未記入の場合が多い) |
ACORD 2 — 自動車事故届出
| 項目 | 形式 | 現実的な精度 |
|---|---|---|
| 保険証券番号 | 英数字 | 95%以上 |
| 被保険者氏名・連絡先 | 氏名+住所+電話番号 | 95%以上 |
| 運転者・請求者情報 | 氏名+住所+電話番号+運転免許証番号 | 90%以上 |
| 車両情報 | VIN+年式+メーカー+モデル | 85〜90%(手書きのVINが最も困難) |
| 事故発生日時・場所 | 日付+時刻+住所 | 95%以上 |
| 事故の種類 | チェックボックス:衝突/盗難/破壊行為 | 85%以上 |
| 損傷の説明 | チェックボックス欄:前面/後面/側面/上面 | 85〜90% |
| 推定損害額 | 通貨 | 90%以上 |
| 目撃者情報 | 氏名+電話番号 | 85%以上 |
| 警察報告書番号・所轄署 | 英数字+部署名 | 80%以上 |
ACORD 3 — 一般賠償責任損失通知書
| 項目 | 形式 | 現実的な精度 |
|---|---|---|
| 保険証券番号 | 英数字 | 95%以上 |
| 被保険者名および連絡先 | 氏名+住所 | 95%以上 |
| 請求者名および連絡先 | 氏名+住所+電話番号 | 90%以上 |
| 事故発生日時および場所 | 日付+時刻+住所 | 95%以上 |
| 事故の種類 | チェックボックス:敷地内/業務/製品 | 85〜90% |
| 負傷内容の説明 | チェックボックス+テキスト(負傷の性質) | 85%以上 |
| 支払済み医療費 | 通貨 | 90%以上 |
| 目撃者情報 | 氏名+電話番号 | 85%以上 |
3種類すべてのフォームに共通するパターンがあります。ラベル付きフィールドの短い値は、タイプ入力でも手書きでも85〜95%以上の精度で抽出されます。ばらつきの原因は、手書きの読みやすさ(急いで書いた「5」がVINの「S」と読まれるなど)やチェックボックスのマークの品質(薄い鉛筆のチェックが未チェックと読まれるなど)であり、AIがページ上のフィールドを特定できないことではありません。セマンティック抽出は固定座標に頼らずフィールドラベルを読み取るため、「保険証券番号」の同じ列定義が、保険会社のポータルPDFのACORD 1でも、道端で撮影したACORD 2でも機能します。テンプレートも保険会社ごとの設定も不要です。
自由記述テキスト:異なる戦略
Description of Lossセクションは、AI抽出が構造上の限界に直面するACORDフォームの部分です。このセクションには、請求者が何が起こったかを自分の言葉で書いた散文形式の説明が含まれており、通常200〜500語で、抽出可能なパターンに従いません。自動車事故の説明では「メインストリートの信号で停車中に、後ろからトラックに追突されました」といった記述があるかもしれません。物的損害の説明では「午後3時頃、キッチンの床に水があるのに気づきました。屋根裏に行くと、破裂したパイプを見つけました」といった内容です。同じ衝突シナリオでも、3人の異なる請求者が3つの異なる書き方をすることがあり、それぞれ文構造、語彙の選択、詳細のレベルが異なります。
最新のビジョンAIは、このナラティブのテキストを高い精度で抽出できます。手書きまたはタイプされた文字をページから読み取り、スプレッドシートのセルにテキストブロックとしてレンダリングします。この部分は確実に機能します。機能しないのは、請求チームが実際に望むステップ、つまりそのナラティブを「損失原因カテゴリ」「過失当事者」「傷害の重症度」などの構造化フィールドに自動的に分類することです。この分類を試みる言語モデルは25〜30%のエラー率を生み出し、結果の正確性に依存する下流プロセスにとっては高すぎます。
請求業務における推奨アプローチは、ナラティブを単一のフィールドに生テキストとして抽出することです。アジャスターは、紙のフォームから読むのとまったく同じようにそのフィールドを読みます。一方、構造化フィールド(保険証券番号、損失日、金額、車両詳細)はすでにスプレッドシートに入力されています。時間の節約は、これらの構造化フィールドを再入力する必要がないことから生まれ、ナラティブをサポートしない分類に無理やり当てはめることからではありません。
添付書類:1件の請求、複数の抽出戦略
実際の請求パケットは、ACORDフォームだけであることはほとんどありません。添付書類は通常、主要フォームの2〜3倍の数になり、それぞれの種類が独自の抽出プロファイルを必要とします。最も一般的な添付書類が抽出戦略にどのように対応するかを以下に示します。
警察報告書
警察報告書は、最も頻繁に添付される裏付け書類です。これらには重要な構造化データが含まれています — 担当捜査官の氏名とバッジ番号、報告書番号、報告書が提出された日時、過失運転者の指定、違反切符情報、天候および道路状況のメモ、そして申立人がACORDフォームに記入した内容を繰り返したり拡張したりすることが多い叙述セクションです。警察報告書の抽出課題は、フィールドの複雑さではなく、フォーマットのばらつきです。米国には約18,000の法執行機関があり、それぞれが独自の報告書レイアウトを使用しています。標準的なNHTSAモデル交通事故報告書を使用する機関もあれば、州固有のフォーム(カリフォルニア州CHP 555、テキサス州CR-3)を使用する機関もあります。多くの機関は、記録管理システムによって生成されたカスタム報告書フォーマットを使用しています。テンプレートベースのアプローチでは、各機関ごとに個別のテンプレートが必要になります。セマンティック抽出は、1つの列定義でそれらすべてを処理します。なぜなら、報告書上のラベル(「担当官名」「報告書番号」「過失」)を、ページ上の位置に関係なく読み取るからです。
修理見積書
板金工場からの自動車修理見積書と、請負業者からの不動産修理見積書には、引当金の設定や和解交渉に不可欠な明細項目の詳細が含まれています。抽出可能な主要フィールドには、工場または請負業者の名称と連絡先、見積日、車両または不動産の識別子、工数とラインごとのレート、部品コスト(OEM vs アフターマーケット vs 中古)、塗装および材料費、小計、税、合計が含まれます。修理見積書は、ラインごとの行を持つテーブルとして抽出されたときに最も価値があります — これにより、特定のコストカテゴリを省略する可能性のある単一の手書き合計に頼るのではなく、すべての項目の合計から推定損害総額を計算できます。見積書はまた、それが裏付ける請求記録にリンクされる必要があります。つまり、抽出ワークフローは、見積書に表示される請求番号または保険証券番号を、欄外に手書きされている場合でも捕捉する必要があります。
医療記録と受付フォーム
負傷を伴う請求(自動車事故、労災、施設責任)では、医療書類が迅速に請求ファイルに追加されます。救急外来の受付フォーム、救急車の走行記録、画像診断のオーダー、初期治療記録にはすべて、構造化フィールド(患者名、診療日、提供者NPI、診断コード、請求コード)と臨床メモが混在しています。抽出戦略はACORDアプローチと同様です。構造化フィールド(日付、コード、提供者情報、請求額)は列定義で抽出し、臨床メモは調整担当者や看護師ケースマネージャーが確認する自由テキストとして保持します。
写真
損傷の写真(車両衝突写真、火災損傷、水侵入、機器破損)は、従来の意味での構造化データとして抽出することはできません。写真から読み取る「金額」はありません。ただし、コンピュータビジョンモデルは、損傷タイプ(例:「前面衝突」「雹による屋根の損傷」「天井の水染み」)を識別・分類できます。これは、請求業務に自動損傷コーディングのユースケースがある場合に限ります。ほとんどの請求チームにとって、実用的なアプローチは、写真を請求受付システムが受け取り、請求記録にリンクする裏付け証拠として扱い、構造化抽出を試みないことです。
すべての補助書類タイプに共通する重要な運用上の洞察は、各書類に独自の抽出列定義が必要であり、ワークフローはすべての書類からの出力を同じ請求記録にリンクさせ続ける必要があるということです。これは単一の抽出問題ではありません。1つの請求イベントを中心に組織化された抽出問題のファミリーです。
従来の方法とAI抽出の比較
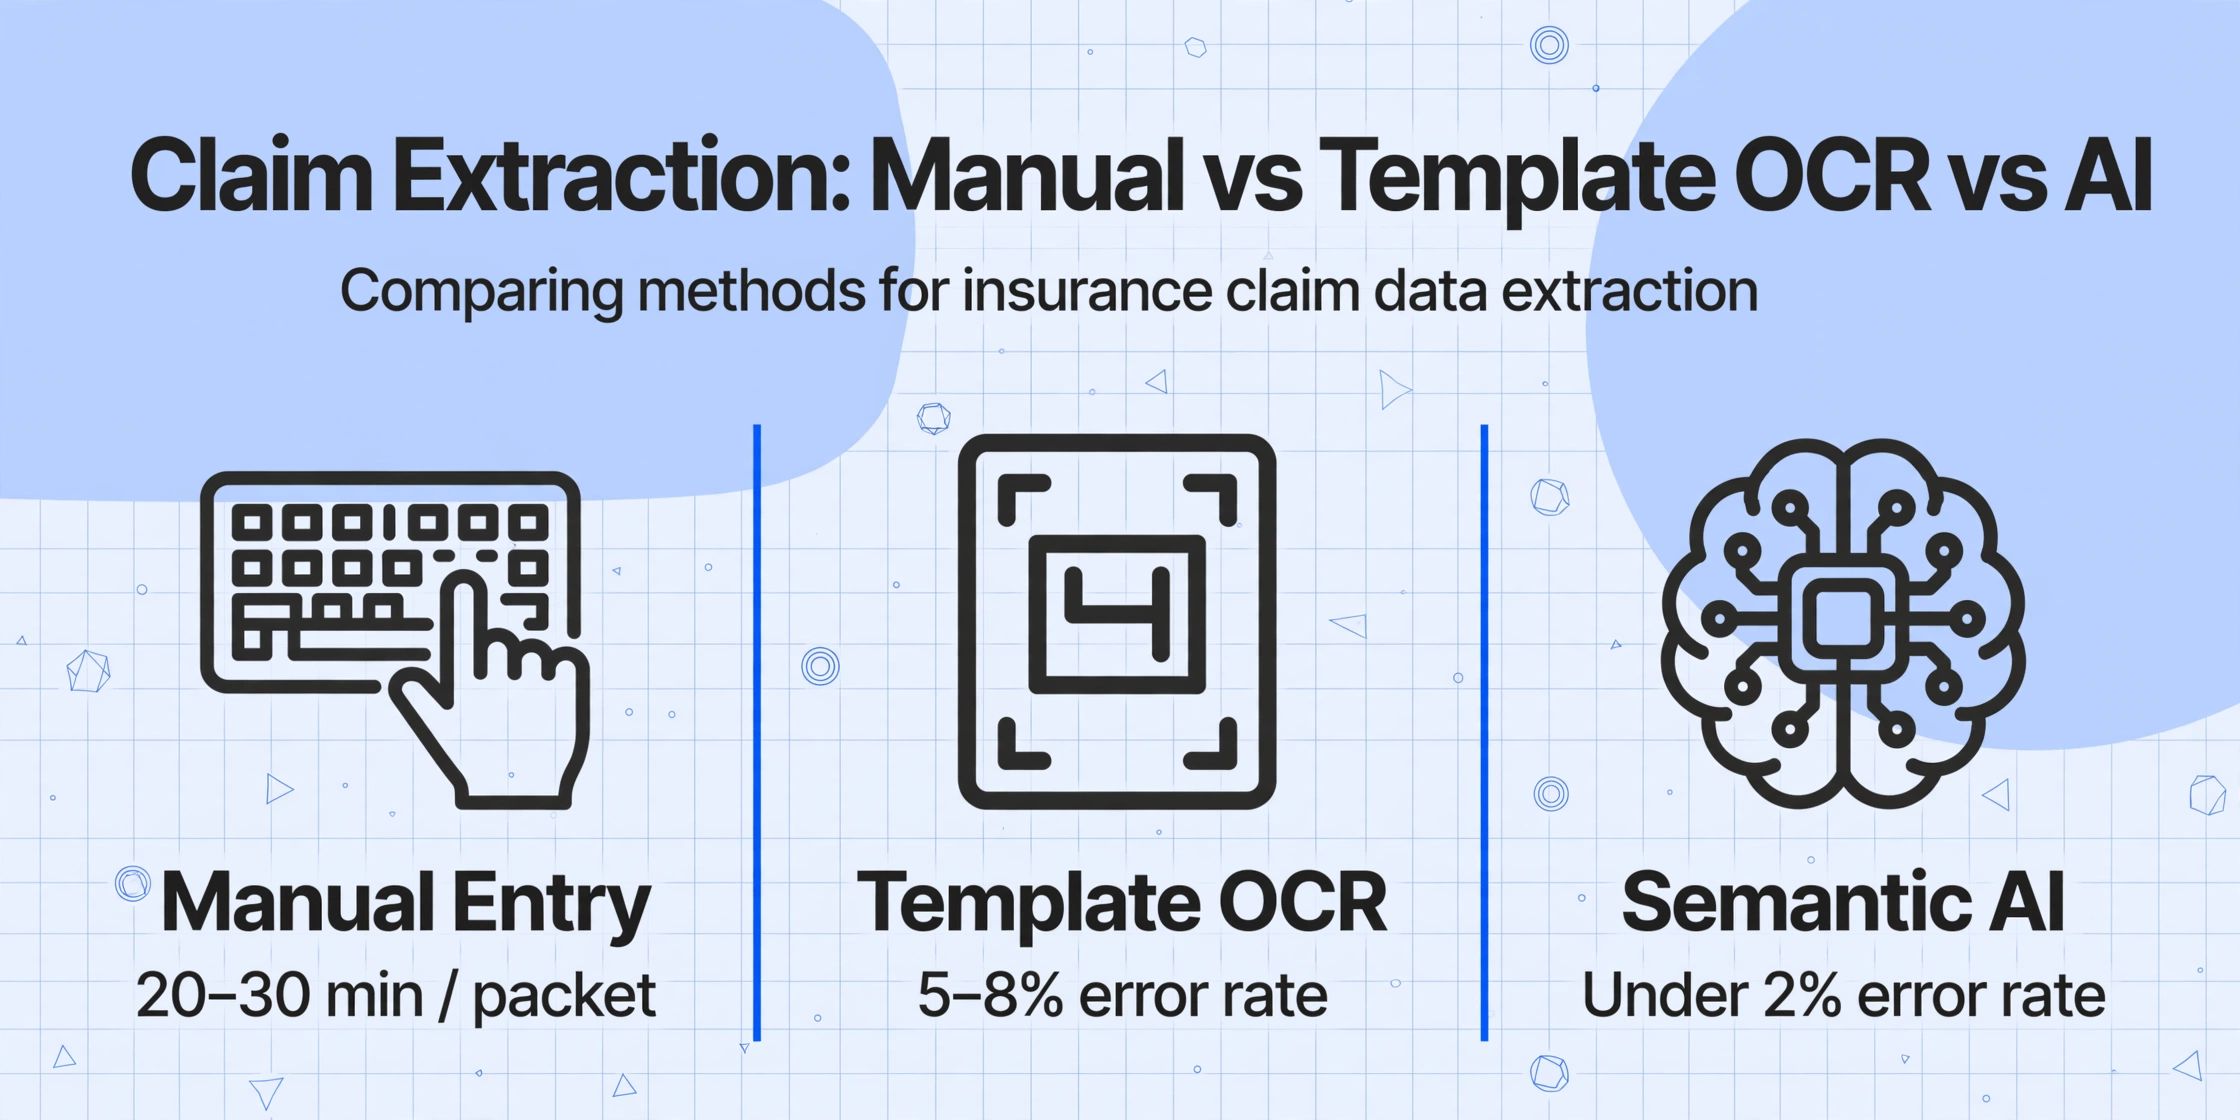
保険請求データ入力の従来のアプローチには、手動入力とテンプレートベースのOCRの2つのバリエーションがあります。両者に共通する根本的な限界は、各請求書類のレイアウトが予測可能であるかのように扱うことです。しかし、実際の請求受付ではそれは当てはまりません。
| 項目 | 手動入力 | テンプレートOCR | セマンティックAI抽出 |
|---|---|---|---|
| 保険会社のフォーム種類ごとの設定 | 不要(人が対応) | フォーム×代理店システムの組み合わせごとにテンプレートが必要 | ゼロ — フィールドごとに列定義が1つあればよい |
| 複数保険会社の混在バッチ | 順次、一度に1件ずつ | 同一レイアウトのフォームのみ対応 | 複数保険会社、複数フォーム種類に対応 |
| 添付書類 | 書類の種類ごとに個別に読取 | 書類の種類×レイアウトごとにテンプレートが必要 | 書類の種類ごとに列セットが1つあればよい |
| 構造化フィールドの手書き文字 | ほとんどの手書き文字を読取可能 | ほとんどの手書き文字で失敗 | 構造化フィールドで85〜95%の精度 |
| フォーマット変更への耐性 | 該当なし — 人が対応 | テンプレート更新まで使用不可 | 新しいレイアウトに自動対応 |
| 請求パケット1件あたりの処理時間 | 20〜30分 | 5〜10分(テンプレートがある場合) | 5〜10秒 |
| フィールド単位のエラー率(構造化) | 3〜5% | 非テンプレート形式で5〜8% | ラベル付きフィールドで2%未満 |
セマンティックAIアプローチ — テンプレート不要の文書抽出 — は、実際の請求受付におけるフォーマットの多様性を考慮すると、他のどの文書カテゴリよりも請求処理において重要です。保険会社ポータルからクリーンなPDFで届くACORD 2と、FAXで届き欄外に手書きフィールドがある同じフォームは、同じ列を必要とする同じ文書タイプですが、テンプレートベースのシステムでは2つの設定が必要になります。セマンティックシステムは1つの設定で両方に対応できます。
複数キャリアの請求書類のバッチ処理
1日50〜200件の請求を処理するクレームチームにとって実用的なワークフローはバッチ処理です。請求パケットのフォルダをアップロードし、各構成文書から構造化フィールドを抽出し、請求番号をキーとして各文書タイプの行をリンクした統合スプレッドシートにすべてをエクスポートします。
典型的なバッチワークフローは次のとおりです。
バッチファースト処理は、クレーム業務における後付けの機能ではありません。TPAが50の異なるキャリアからの請求を処理し、それぞれが異なるACORDレンダリングを使用し、補助書類が十数種類の取り込みチャネルを通じて届く場合に、スケールする唯一のワークフローです。
クレーム抽出ツールの選び方
すべての抽出ツールが保険クレームに適しているわけではありません。文書の構成 — 構造化フォーム、自由記述のナラティブ、複数ソースからの添付ファイル — には、一般的なOCRツールにはない特定の機能が求められます。ここでは、クレーム業務に特化して重要となる基準をご紹介します。
テンプレート不要か、テンプレートベースか。 これは最も重要な決定事項です。キャリアごと、フォームタイプごと、受付チャネルごとにテンプレートの作成と維持が必要なツールでは、実際のクレーム受付におけるフォーマットの多様性に対応できません。テンプレート不要のアプローチ — 列定義がフォームタイプ、キャリア、レイアウトを横断して機能するもの — は、概念実証フェーズ後にクレーム自動化パイロットが停滞する原因となる設定負荷を排除します。
複数文書タイプのサポート。 ツールはACORDフォーム、警察報告書、修理見積書、医療記録を、それぞれ別の列定義を持つ異なる文書タイプとして処理できなければなりません。すべてを「1つの文書」として扱うのではありません。
手書き文字認識機能。 クレームフォームのかなりの割合が手書きで記入されます — 路上で、病院で、クリップボードで。構造化フィールドにおける手書き文字の精度が85%未満の場合、構造化フィールドの自動化は、修正が必要な出力が多すぎるために機能しなくなります。
スプレッドシートまたはクレームシステムへの一括エクスポート。 出力は、Guidewire ClaimCenter、Duck Creek Claims、または任意のクレーム管理プラットフォームに手動での再フォーマットなしで読み込める構造化ファイル(Excel、CSV)である必要があります。
トレーニング不要の要件。 クレームチームには、カスタムモデルをトレーニングするためのデータ量がありません。フォームタイプごとに10〜50件のサンプル文書を必要としてクレームフォーマットを「学習」するツールは、新しいキャリアフォーマットや補足文書のバリエーションが定期的に発生する保険受付のユースケースには適していません。
よくある質問
保険金請求データ抽出にはどのような文書タイプが含まれますか?
請求抽出は請求パケット全体をカバーします:ACORD損害通知フォーム(不動産用ACORD 1、自動車用ACORD 2、一般賠償責任用ACORD 3、労災用ACORD 4)、警察報告書、自動車・不動産の修理見積書、医療記録・請求書、および関連する通信文書です。各文書タイプには独自の抽出列定義が必要ですが、すべての出力は請求番号または保険証券番号でリンクされ、統合処理が可能です。
保険金請求フォームにおけるAI抽出の精度は、手動入力と比較してどの程度ですか?
構造化されたヘッダー項目(保険証券番号、被保険者名、事故日・場所、金額)については、AI抽出は90〜95%以上の精度を達成しており、手動データ入力のフィールドレベル誤差率3〜5%よりも測定可能な形で優れています。残りの誤差は特定のフィールドタイプ(手書きのVIN、部分的なチェックボックスマーク)に集中しており、的を絞ったスポットチェックワークフローを構築できるほど予測可能です。対照的に、手動入力の誤差はランダムです—どのフィールドもどのような理由でも誤る可能性があり、すべての文書を完全に再読しない限り発見が困難です。
AIは請求フォームから事故状況の説明文を抽出できますか?
説明文のテキストは高い精度で抽出できます—手書きまたはタイプされた文字を読み取り、スプレッドシートのセルにテキストブロックとして表示します。ただし、その説明文を「事故原因」や「過失当事者」などの構造化フィールドに確実に分類することはできません。説明文の分類を試みる言語モデルは25〜30%の誤差率を生み出し、補償や過失の判断には信頼できない出力になります。推奨されるワークフローは、説明文を生テキストとして抽出し、アジャスターが直接読むことです。一方、データ入力の負担の大部分を占める構造化フィールドは自動化されます。
AI抽出は、異なる管轄区域の警察報告書でも機能しますか?
はい、機能します。ここでテンプレート不要の抽出が従来のOCRに対して決定的な優位性を持ちます。米国には約18,000の法執行機関があり、それぞれ異なる報告書レイアウトを使用しています。テンプレートベースのOCRでは、機関ごとに個別のテンプレートが必要になります。セマンティック抽出は各報告書のフィールドラベル(「担当官名」「報告書番号」「過失運転者」)を読み取って値を特定するため、1つの列定義で全機関の形式に対応できます。同じ原則は、見積システム(CCC、Mitchell、Audatex)によって異なる修理見積書にも適用されます。
AIは手書きの請求書フォームをどの程度うまく処理できますか?
明確なフィールドラベルがある構造化フィールドでは、手書きの請求書フォームはほとんどの筆跡品質で85〜90%の精度で抽出されます。主な失敗モードは、フィールド全体の失敗ではなく、個々の文字の誤読(手書きの「5」が「S」と読まれる、「0」が「O」と読まれるなど)です。不利な条件下(事故後の路肩、薄暗い部屋)で記入された請求書フォームは、筆跡が乱れがちで、精度はこの範囲の下限に近づく傾向があります。実用的な請求処理ワークフローには、各請求書フォームの最も重要な2〜3のフィールドをスポットチェックするための1〜2分の検証ステップが含まれます。
抽出した請求データをGuidewireやDuck Creekに直接エクスポートできますか?
はい、できます。抽出出力は構造化ファイル(Excel、CSV、JSON)であり、バッチデータアップロードを受け付ける任意の請求管理システムにインポートできます。列ヘッダーは抽出設定時に定義したフィールド名と一致するため、データは正しいシステムフィールドに配置されます。大量処理を行うチームの場合、バッチエクスポートを構成して、請求番号または保険証券番号でリンクされた各文書タイプ(ACORDフィールド、警察報告書フィールド、見積フィールド)ごとに個別のシートまたはファイルを生成することもできます。
労災申請書類にも対応していますか?
はい。労災のFNOL書式は、他のACORDベースの請求書類と同じ構造を共有しています。ラベル付きのヘッダーフィールド(雇用主名、従業員名、負傷日、負傷の種類、負傷部位、治療医)に加え、事故の状況説明があります。構造化フィールドは、物的損害や自動車の請求と同様の精度範囲で抽出されます。労災請求では、医師の初回報告書、復職フォーム、賃金明細書などの追加の補助書類も生成され、それぞれに独自の抽出列セットを設定して処理できます。
AIは車両損傷の写真からデータを抽出できますか?
従来の意味での構造化データは抽出できません。コンピュータビジョンモデルは損傷の種類(前面衝突、雹害、火災損傷)を分類し、深刻度の範囲を推定できますが、写真だけで金額や部品リストを出力することはできません。写真は請求記録にリンクされた補助証拠として扱うのが最適で、修理工場や業者からの構造化された見積もりが、財務引当金や和解金の計算に使用されるデータを提供します。
1回のバッチで処理できる請求書類は何件ですか?
AI抽出のバッチサイズに実質的な上限はありません。請求チームは通常、1回のバッチで100〜200件の請求パケットを処理しています。複数の保険会社のACORDフォーム、さまざまな機関の警察報告書、さまざまな工場の修理見積もりを混在させることができます。処理時間は文書数に比例して増加し、形式や保険会社に関係なく、1文書あたり平均5〜10秒です。大量の場合は、チームプランでバッチワークフローが並行処理をサポートします。
自分の請求書類でAI抽出のテストを始めるにはどうすればよいですか?
スキャンしたACORDフォーム(物的損害、自動車、一般賠償責任)または記入済みの請求書類の写真をアップロードしてください。初回テストには登録は不要です。請求システムに必要な列を定義します:証券番号、事故発生日、被保険者名、事故場所、見積金額、損害の種類。数秒で抽出結果を確認できます。複数の保険会社のフォームや補助書類にわたるバッチ処理の完全なチュートリアルについては、特定の請求書類タイプのステップバイステップガイドをご覧ください。
請求処理におけるセマンティック抽出の利点は、すでに手作業で管理している形式のばらつきに適応できることです — キャリアごと・フォームタイプごと・受付チャネルごとにテンプレートを作成する必要はありません。ACORDフォーム・警察報告書・修理見積書の構造化フィールドは、ポータルPDF・FAXコピー・スマートフォン写真のいずれで届いても同じフィールドです。列を一度定義すれば、AIがラベルが表示されている場所から値を自動的に見つけ出します。
ご自身の請求書類でお試しください