Guia Completo para
Extração de Dados de Sinistros de Seguro (2026)
Um único sinistro de acidente de carro gera um formulário ACORD 2 do reclamante, um boletim de ocorrência da agência responsável, um orçamento de reparo da oficina, formulários de admissão médica se houver ferimentos e fotos de três smartphones. Cada documento chega em um formato diferente, de uma fonte diferente, com um layout diferente — e o ajustador precisa dos dados estruturados de todos eles vinculados ao mesmo registro de sinistro. Esse é o verdadeiro desafio da extração de dados de sinistros de seguro, e não é um desafio para o qual a maioria das ferramentas de extração foi projetada.
Principais Conclusões
- Um ajustador de sinistros gasta de 17 a 25 horas por semana em entrada de dados — a $35-45 por hora — antes de tocar na análise de cobertura, negociação de acordo ou investigação pelas quais sua expertise é remunerada.
- O custo visível de mão de obra é apenas metade da história: correção de erros, produtividade perdida do ajustador e tempo de ciclo atrasado vivem em orçamentos separados, onde nenhum relatório isolado revela que o processamento manual de sinistros custa aproximadamente o dobro do que a linha de folha de pagamento mostra.
- Uma definição de coluna reutilizável por tipo de documento — formulários ACORD, boletins de ocorrência, orçamentos de reparo — extrai campos estruturados de todos os documentos do lote, e o ajustador revisa apenas as exceções sinalizadas pela pontuação de confiança.
O Que É Extração de Dados de Sinistros de Seguro?
A extração de dados de sinistros de seguro é o processo automatizado de leitura de campos-chave em documentos relacionados a sinistros — avisos de perda ACORD, boletins de ocorrência, estimativas de reparo, prontuários médicos e outros anexos de suporte — convertendo-os em dados estruturados que uma planilha, um sistema de gestão de sinistros ou uma plataforma de análise pode consumir. Diferentemente da extração padrão de faturas ou recibos, que tem como alvo um único tipo de documento, a extração de sinistros deve lidar com um pacote de vários documentos, em que cada componente tem seu próprio formato, seus próprios campos-chave e seus próprios requisitos de extração.
O escopo vai além do First Notice of Loss. Uma estratégia completa de extração de sinistros abrange todos os documentos que entram no arquivo do sinistro, desde a abertura até a liquidação: o formulário ACORD inicial (seja auto, propriedade, responsabilidade geral ou indenização trabalhista), os anexos de suporte que comprovam a perda e a correspondência e os documentos de cobrança que se acumulam à medida que o sinistro avança. Para um detalhamento campo a campo do que a IA pode e não pode extrair especificamente dos formulários ACORD iniciais, consulte nosso artigo complementar sobre A IA Consegue Ler Formulários FNOL de Sinistros de Seguro?
O que distingue esta categoria de outras tarefas de extração de documentos é a estrutura em camadas de um pacote de sinistro. Os campos estruturados de cabeçalho no formulário ACORD — número da apólice, data da perda, nome do segurado, local da perda — seguem um padrão previsível e são extraídos de forma confiável. O texto livre da narrativa na seção Descrição da Perda não. Os documentos de suporte — um boletim de ocorrência de uma jurisdição, uma estimativa de reparo de um sistema de software diferente, prontuários médicos de um terceiro — cada um exige uma estratégia de extração separada. Uma abordagem completa considera todas as três camadas, não apenas a mais conveniente.
Por que a Entrada Manual de Dados de Sinistros Custa Mais do que Parece
O custo visível da entrada manual de dados de sinistros é direto: um digitador ou ajustador digitando valores de campos de cada documento em um sistema de sinistros, um caractere por vez. A McKinsey estima que a automação pode reduzir o tempo de processamento de sinistros em até 50% e cortar os custos da jornada do sinistro em até 30%. Mas esses números agregados subestimam o que o processamento manual realmente custa a uma operação, porque a despesa real chega por quatro canais distintos que a maioria das empresas acompanha em orçamentos separados.
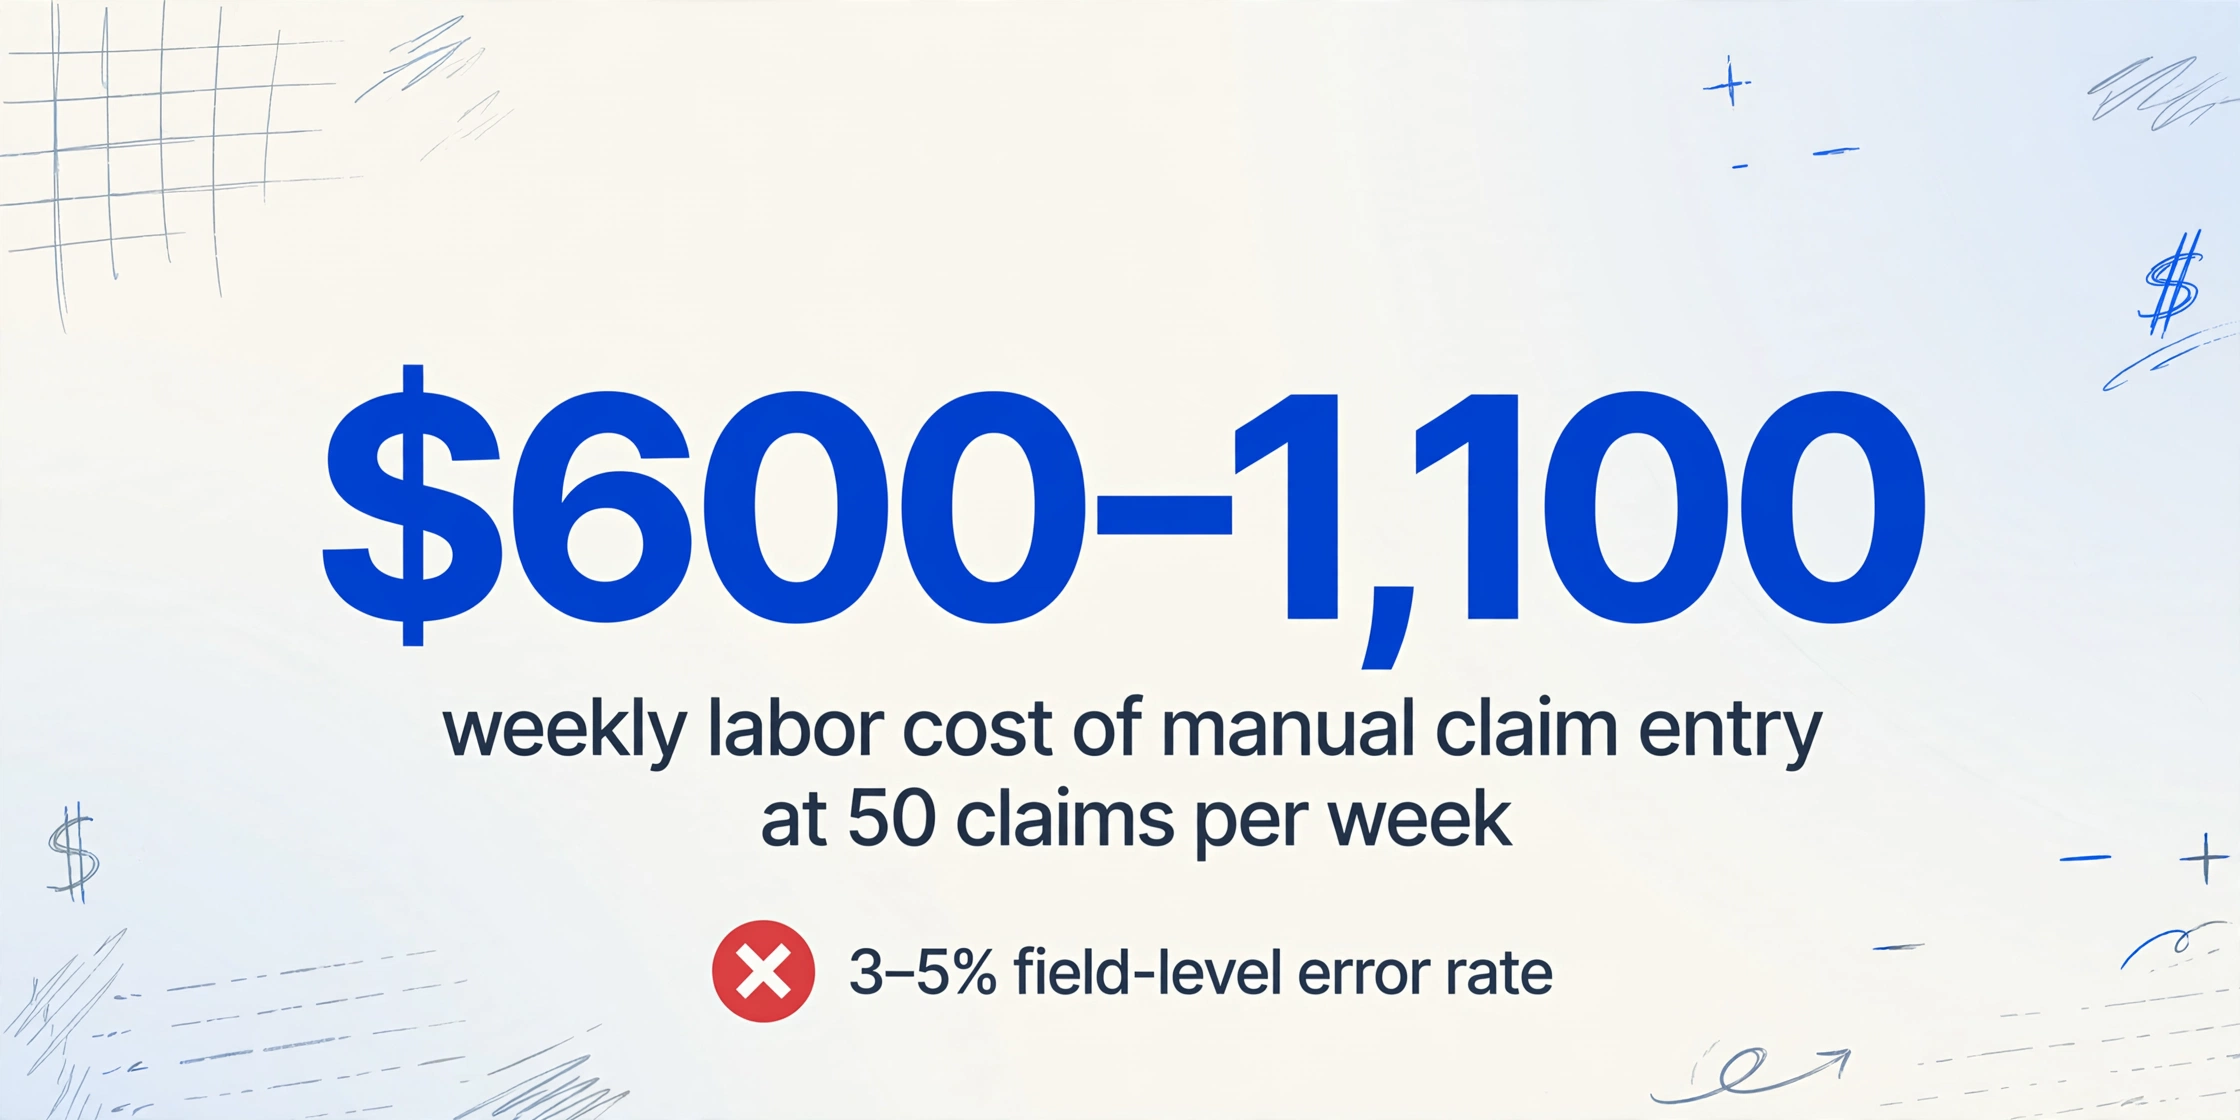
Mão de obra direta de transcrição. Um ajustador ou funcionário de sinistros processando um único pacote de sinistro — formulário ACORD mais dois ou três documentos de apoio — gasta cerca de 20 a 30 minutos apenas na entrada de dados. A 50 sinistros por semana, isso representa 17 a 25 horas de puro tempo de digitação. A um custo total de $35–45 por hora para um processador de sinistros experiente, isso se traduz em $600–1.100 por semana em mão de obra que não agrega nenhum valor de julgamento ao sinistro.
O imposto do erro. A entrada manual de dados de documentos de seguro carrega uma taxa estimada de erro de 3–5% no nível de campo. Em um pacote de sinistro com 25–40 campos extraíveis entre o formulário ACORD e os anexos, isso significa um a dois erros por sinistro. Um número de apólice digitado incorretamente atrasa a verificação de elegibilidade. Uma data de perda errada gera uma ligação de acompanhamento ao segurado. Um valor transposto na estimativa de reparo cria uma divergência de reserva que leva tempo para reconciliar. Os benchmarks do setor sugerem que cada erro de entrada de dados em um sinistro custa $15–30 para corrigir — e esses custos se acumulam quando os erros são descobertos posteriormente, em vez de na admissão.
O custo de oportunidade do tempo do ajustador. A pesquisa da McKinsey mostra que subscritores e ajustadores de sinistros gastam 30–40% do seu tempo em tarefas administrativas, incluindo entrada de dados e recuperação de documentos. Para um ajustador sênior lidando com 100–150 sinistros abertos, isso significa 12 a 20 horas por semana digitando em vez de investigar cobertura, negociar acordos ou gerenciar casos complexos. O custo em dólares desse tempo é o salário integral do ajustador. O custo de oportunidade é a velocidade dos sinistros — e a satisfação do cliente — que essas horas poderiam ter produzido se redirecionadas para trabalho de julgamento.
Tempo de ciclo atrasado. Cada etapa manual entre o recebimento do documento e a disponibilidade dos dados adiciona horas ao ciclo de vida do sinistro. Em operações de sinistros de alto volume — TPAs processando mais de 200 sinistros por dia, equipes de resposta a catástrofes lidando com volumes de pico — essas horas se acumulam em dias. Os estudos de satisfação com sinistros da J.D. Power mostram consistentemente que a velocidade de processamento do FNOL é um dos fatores mais fortes da satisfação do cliente. Cada dia adicional de processamento manual prejudica a experiência do cliente e aumenta a probabilidade de litígio, reclamações regulatórias e escalonamento.
Os quatro custos são aditivos, não alternativos. Uma operação que gasta $2.500 por mês em mão de obra direta de entrada de dados de sinistros provavelmente está incorrendo em um valor equivalente em correção de erros, produtividade perdida do ajustador e tempo de ciclo atrasado. O custo real da entrada manual de dados de sinistros é aproximadamente o dobro do item de mão de obra visível — e está enterrado em orçamentos onde nenhum relatório único revela o total.
O que torna a extração de sinistros de seguro diferente de outros tipos de documento
A extração de sinistros de seguro compartilha o DNA técnico da extração de faturas ou recibos — os mesmos modelos de visão-linguagem, a mesma abordagem de coluna personalizada —, mas três fatores estruturais a tornam um problema fundamentalmente mais difícil.
1. Variação de formato entre seguradoras e ramos de negócio. Um ACORD 1 (Property Loss Notice) e um ACORD 2 (Automobile Loss Notice) são diferentes porque coletam informações diferentes. Mas o mesmo ACORD 1 preenchido por meio de um sistema de gestão de agências Applied Epic é renderizado de forma diferente de um do Vertafore AMS360, que por sua vez é renderizado de forma diferente de um preenchido à mão em um formulário de papel. A ACORD mantém mais de 800 tipos de formulário padronizados. As aproximadamente 39.000 agências independentes de P&C nos Estados Unidos produzem esses formulários com suas próprias configurações de sistema, ajustes de impressão e hábitos de preenchimento. A extração baseada em modelo, que depende de coordenadas fixas de campo, quebra no momento em que o layout muda. A extração semântica, que lê os rótulos dos campos para localizar os valores, lida com essa variação sem configuração por seguradora. Abordamos essa diferença com mais profundidade em nosso explicador sobre OCR tradicional versus extração com IA.
2. O pacote de sinistro com vários documentos. Uma ferramenta de extração de faturas processa uma fatura. Um fluxo de trabalho de extração de sinistros processa uma pasta: um formulário ACORD, um boletim de ocorrência, um orçamento de reparo, registros médicos de admissão, fotos e, às vezes, um recibo de reboque ou contrato de aluguel. Cada tipo de documento tem seus próprios campos padrão, suas próprias convenções de layout e suas próprias definições de coluna de extração. O desafio não é extrair um único documento — é extrair todos eles em um fluxo de trabalho coerente que mantenha as saídas vinculadas ao mesmo registro de sinistro.
3. Campos estruturados + narrativa em texto livre em um único documento. O formulário ACORD é único ao combinar os dois modos em uma única página. O cabeçalho contém campos claramente rotulados, com valores curtos, que a IA extrai com alta precisão. A seção Description of Loss é uma caixa em branco para prosa narrativa — 50 palavras ou 500, manuscrita ou digitada, focada ou divagante. Esses dois modos coexistem dentro do mesmo documento e exigem tratamentos fundamentalmente diferentes.
Os Campos Estruturados: O Que Você Pode Extrair com Confiabilidade
Os campos estruturados de cabeçalho nos formulários ACORD são onde a extração por IA entrega o maior valor. Esses campos têm rótulos impressos, espaços de valores restritos e padrões semânticos consistentes — as condições ideais para um modelo de visão-linguagem. Abaixo estão os principais campos separados pelos quatro principais tipos de formulário FNOL da ACORD que cobrem a grande maioria da entrada de sinistros de P&C.
ACORD 1 — Aviso de Perda de Propriedade
| Campo | Formato | Precisão Realista |
|---|---|---|
| Número da Apólice | Alfanumérico, 8–15 caracteres | 95%+ |
| Nome e Contato do Segurado | Nome + endereço + telefone | 95%+ |
| Data e Hora da Perda | Data + hora | 95%+ |
| Local da Perda | Endereço ou cruzamento | 90%+ |
| Tipo de Perda (caixas de seleção) | Caixa de seleção: Incêndio/Vento/Granizo/Água/Roubo | 85–90% |
| Código NAIC da Seguradora | Numérico de 5 dígitos | 95%+ |
| Valor Estimado da Perda | Moeda | 90%+ |
| Franquia da Apólice | Moeda | 90%+ |
| Credor Hipotecário / Detentor de Gravame | Nome + endereço | 85%+ |
| Número do Boletim de Ocorrência | Alfanumérico | 80%+ (frequentemente em branco) |
ACORD 2 — Aviso de Perda de Automóvel
| Campo | Formato | Precisão Realista |
|---|---|---|
| Número da Apólice | Alfanumérico | 95%+ |
| Nome e Contato do Segurado | Nome + endereço + telefone | 95%+ |
| Informações do Motorista / Reclamante | Nome + endereço + telefone + nº da CNH | 90%+ |
| Informações do Veículo | VIN + ano + marca + modelo | 85–90% (VIN manuscrito é o mais difícil) |
| Data, Hora e Local da Perda | Data + hora + endereço | 95%+ |
| Tipo de Acidente | Caixa de seleção: Colisão/Roubo/Vandalismo | 85%+ |
| Descrição dos Danos | Área de caixa de seleção: Frente/Traseira/Lateral/Teto | 85–90% |
| Valor Estimado dos Danos | Moeda | 90%+ |
| Informações das Testemunhas | Nome + telefone | 85%+ |
| Número e Órgão do Boletim de Ocorrência | Alfanumérico + nome do departamento | 80%+ |
ACORD 3 — Aviso de Sinistro de Responsabilidade Geral
| Campo | Formato | Precisão Realista |
|---|---|---|
| Número da Apólice | Alfanumérico | 95%+ |
| Nome e Contato do Segurado | Nome + endereço | 95%+ |
| Nome e Contato do Reclamante | Nome + endereço + telefone | 90%+ |
| Data, Hora e Local da Ocorrência | Data + hora + endereço | 95%+ |
| Tipo de Ocorrência | Caixa de seleção: Instalações/Operações/Produto | 85–90% |
| Descrição da Lesão | Caixa de seleção + texto (natureza da lesão) | 85%+ |
| Pagamentos Médicos Incorridos | Moeda | 90%+ |
| Informações de Testemunhas | Nome + telefone | 85%+ |
O padrão nos três tipos de formulário é consistente: campos rotulados com valores curtos são extraídos com 85–95%+ de precisão, sejam digitados ou manuscritos. A variação vem da legibilidade da caligrafia (um "5" apressado lido como "S" em um VIN) e da qualidade da marcação das caixas de seleção (um traço leve a lápis lido como não marcado), não da incapacidade da IA de localizar o campo na página. Como a extração semântica lê os rótulos dos campos em vez de depender de coordenadas fixas, a mesma definição de coluna para "Número da Apólice" funciona em um ACORD 1 de um PDF de portal de seguradora e em um ACORD 2 fotografado na beira da estrada — sem modelos, sem configuração por seguradora.
A Narrativa em Texto Livre: Uma Estratégia Diferente
A seção Descrição da Perda é a parte de um formulário ACORD em que a extração por IA encontra um limite estrutural. Essa seção contém o relato do próprio reclamante sobre o que aconteceu, escrito em prosa narrativa — normalmente de 200 a 500 palavras — e não segue nenhum padrão extraível. A descrição de um acidente de carro pode dizer: "Eu estava parado no semáforo da Main Street. Um caminhão me atingiu por trás." A descrição de uma perda de propriedade: "Notei água no chão da cozinha por volta das 15h. Subi ao sótão e encontrei um cano estourado." O mesmo cenário de colisão pode ser escrito de três maneiras diferentes por três reclamantes diferentes, cada um com estruturas de frase, escolhas de palavras e níveis de detalhe distintos.
A IA de visão moderna consegue extrair o texto dessa narrativa com alta precisão — lendo as palavras manuscritas ou digitadas na página e renderizando-as como um bloco de texto em uma célula de planilha. Essa parte funciona de forma confiável. O que não funciona é a etapa que a maioria das equipes de sinistros realmente deseja: categorizar automaticamente essa narrativa em campos estruturados como "Categoria da Causa da Perda", "Parte Culpada" ou "Gravidade da Lesão". Modelos de linguagem que tentam essa classificação produzem taxas de erro de 25–30%, o que é alto demais para qualquer processo subsequente que dependa da exatidão do resultado.
A abordagem recomendada para operações de sinistros é extrair a narrativa como texto bruto em um único campo. O ajustador lê esse campo — exatamente como o leria no formulário em papel — enquanto os campos estruturados (número da apólice, data da perda, valores, detalhes do veículo) já estão preenchidos na planilha. A economia de tempo vem de não precisar redigitar esses campos estruturados, e não de tentar forçar a narrativa a uma classificação que ela não sustenta.
Documentos de Apoio: Um Sinistro, Múltiplas Estratégias de Extração
Na prática, um pacote de sinistro raramente é apenas o formulário ACORD. Os documentos de apoio normalmente superam o formulário principal em duas ou três vezes, e cada tipo exige seu próprio perfil de extração. Veja como os anexos mais comuns se mapeiam para a estratégia de extração.
Boletins de Ocorrência
Os boletins de ocorrência são o documento de suporte anexado com mais frequência. Eles contêm dados estruturados críticos — o nome e o número de identificação do policial responsável pela investigação, o número do boletim, a data e a hora em que o boletim foi registrado, a designação do motorista culpado, informações sobre a autuação, observações sobre o clima e as condições da via, e uma seção narrativa que frequentemente repete ou amplia o que o reclamante escreveu no formulário ACORD. O desafio de extração nos boletins de ocorrência não é a complexidade dos campos, mas a variação de formato. Existem cerca de 18.000 agências de aplicação da lei nos Estados Unidos, cada uma usando seu próprio layout de boletim. Algumas usam o modelo padrão de boletim de acidente de trânsito da NHTSA. Outras usam formulários específicos de cada estado (o California CHP 555, o Texas CR-3). Muitas usam formatos de boletim personalizados gerados por seu sistema de gestão de registros. Uma abordagem baseada em modelo exigiria um modelo separado para cada agência. A extração semântica lida com todos eles com uma única definição de coluna, porque lê os rótulos no boletim — "Officer Name", "Report Number", "At Fault" — independentemente de onde estejam na página.
Orçamentos de Reparo
Os orçamentos de reparo automotivo de oficinas de funilaria e os orçamentos de reparo de imóveis de empreiteiros contêm detalhamento item a item essencial para a definição de reservas e a negociação de acordos. Os principais campos extraíveis incluem: nome e contato da oficina ou do empreiteiro, data do orçamento, identificador do veículo ou do imóvel, horas de mão de obra e valor por linha, custos de peças (OEM vs. aftermarket vs. usadas), pintura e materiais, subtotal, imposto e total. Os orçamentos de reparo são mais valiosos quando extraídos como uma tabela de uma linha por item — assim, o dano total estimado pode ser calculado a partir da soma de todos os itens, em vez de depender de um único total manuscrito que pode omitir certas categorias de custo. O orçamento também precisa ser vinculado de volta ao registro de sinistro que ele respalda, o que significa que o fluxo de trabalho de extração deve capturar o número de sinistro ou de apólice que aparece no orçamento, mesmo que esteja manuscrito na margem.
Registros Médicos e Formulários de Admissão
Em sinistros envolvendo lesões — acidentes automobilísticos, compensação trabalhista, responsabilidade civil em imóveis — documentos médicos entram rapidamente no arquivo do sinistro. Formulários de admissão em pronto-socorro, fichas de atendimento de ambulância, pedidos de exames de imagem diagnóstica e notas de tratamento inicial contêm todos campos estruturados (nome do paciente, data do atendimento, NPI do prestador, códigos de diagnóstico, códigos de faturamento) misturados com notas clínicas. A estratégia de extração espelha a abordagem ACORD: extrair os campos estruturados (datas, códigos, identidades dos prestadores, valores cobrados) com definições de coluna, e manter as notas clínicas como texto livre para o ajustador ou enfermeiro gestor de casos revisar.
Fotos
Fotos de danos — fotos de colisão de veículos, danos por incêndio, infiltração de água, equipamentos quebrados — não podem ser extraídas para dados estruturados no sentido tradicional. Não há um "valor em dólares" a ser lido de uma foto. No entanto, modelos de visão computacional podem identificar e classificar tipos de danos (por exemplo, "colisão frontal", "dano no telhado por granizo", "mancha de água no teto") se a operação de sinistros tiver um caso de uso para codificação automatizada de danos. Para a maioria das equipes de sinistros, a abordagem prática é tratar as fotos como evidência de suporte que o sistema de admissão de sinistros recebe e vincula ao registro do sinistro, sem tentar extração estruturada.
O insight operacional fundamental em todos os tipos de documentos de suporte: cada um exige sua própria definição de coluna de extração, e o fluxo de trabalho deve manter as saídas de todos os documentos vinculadas ao mesmo registro de sinistro. Este não é um problema de extração única. É uma família de problemas de extração organizada em torno de um evento de sinistro.
Métodos Tradicionais vs Extração com IA
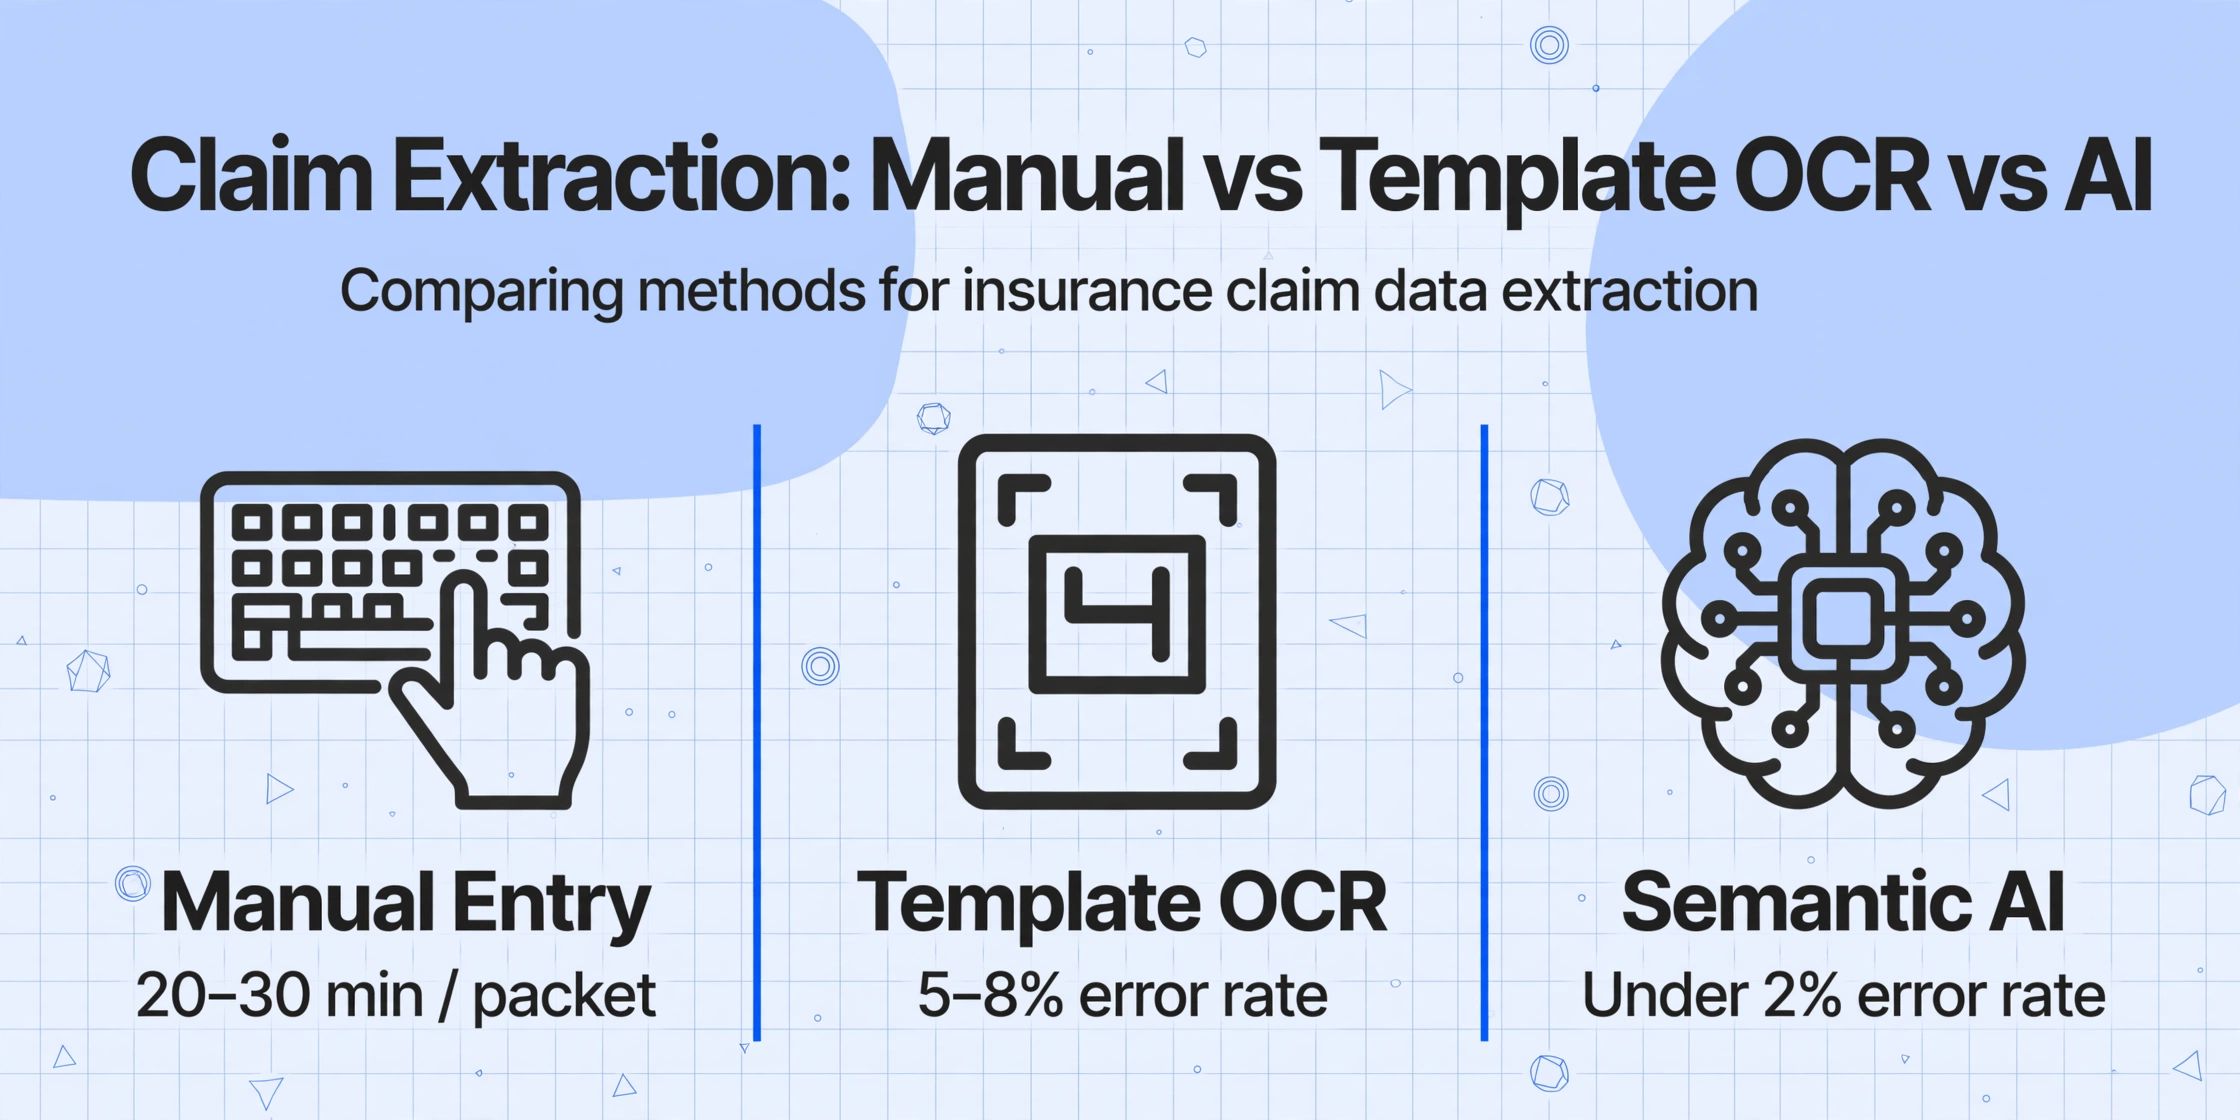
A abordagem convencional para entrada de dados de sinistros de seguro tem duas variantes: digitação manual e OCR baseado em modelo. Ambas compartilham a mesma limitação fundamental — tratam cada documento de sinistro como se seu layout fosse previsível, o que não é no recebimento de sinistros do mundo real.
| Dimensão | Entrada Manual | OCR com Modelo | Extração Semântica com IA |
|---|---|---|---|
| Configuração por tipo de formulário de seguradora | Nenhuma (o humano se adapta) | Modelo por formulário × combinação de sistema da agência | Zero — uma definição de coluna por campo |
| Lote de seguradoras mistas | Sequencial, um de cada vez | Apenas formulários com o mesmo layout | Seguradoras mistas, tipos de formulário mistos |
| Documentos de suporte | Lê cada tipo de documento separadamente | Modelo por tipo de documento × layout | Um conjunto de colunas por tipo de documento |
| Manuscrito em campos estruturados | Lê a maioria dos manuscritos | Falha na maioria dos manuscritos | 85–95% em campos estruturados |
| Resiliência a mudanças de formato | N/A — o humano se adapta | Quebra até o modelo ser atualizado | Lida com novos layouts automaticamente |
| Tempo por pacote de sinistro | 20–30 min | 5–10 min (se existirem modelos) | 5–10 segundos |
| Taxa de erro por campo (estruturado) | 3–5% | 5–8% em formatos sem modelo | Abaixo de 2% em campos rotulados |
A abordagem de IA semântica — extração de documentos sem modelo — importa mais para sinistros do que para qualquer outra categoria de documento, devido à enorme variação de formatos na entrada de sinistros do mundo real. Um ACORD 2 chegando como um PDF limpo de um portal de seguradora e o mesmo formulário chegando como uma cópia enviada por fax com campos manuscritos nas margens são o mesmo tipo de documento exigindo as mesmas colunas, mas um sistema baseado em modelo precisaria de duas configurações. Um sistema semântico lida com ambos com uma.
Processamento em Lote de Formulários de Sinistro de Diversas Seguradoras
O fluxo de trabalho prático para equipes de sinistros que processam 50–200 sinistros por dia é o processamento em lote — enviar uma pasta de pacotes de sinistro, extrair os campos estruturados de cada documento componente e exportar tudo para uma planilha unificada com uma chave de número de sinistro que vincula as linhas de cada tipo de documento.
Um fluxo de trabalho típico em lote é assim:
O processamento prioritário em lote não é um detalhe secundário para as operações de sinistros. É o único fluxo de trabalho que escala quando uma TPA processa sinistros de 50 seguradoras diferentes, cada uma usando uma renderização ACORD diferente, e os documentos de suporte chegam por uma dúzia de canais de entrada distintos.
Como Escolher uma Ferramenta de Extração de Sinistros
Nem toda ferramenta de extração é adequada para sinistros de seguros. A variedade de documentos — formulários estruturados, narrativas em texto livre, anexos de múltiplas fontes — exige capacidades específicas que ferramentas de OCR de uso geral podem não ter. Estes são os critérios que importam especificamente para operações de sinistros.
Sem modelo ou baseado em modelo. Esta é a decisão mais consequente. Se a ferramenta exige criar e manter modelos por seguradora, por tipo de formulário e por canal de entrada, ela não sobreviverá à variação de formatos da entrada real de sinistros. Uma abordagem sem modelo — em que as definições de coluna funcionam entre tipos de formulário, seguradoras e layouts — elimina a dívida de configuração que faz os pilotos de automação de sinistros travarem após a fase de prova de conceito.
Suporte a múltiplos tipos de documento. A ferramenta deve tratar formulários ACORD, boletins de ocorrência, estimativas de reparo e registros médicos como tipos de documento distintos com definições de coluna separadas — não tratar tudo como "um documento".
Capacidade de manuscrito. Uma porcentagem significativa dos formulários de sinistro é preenchida à mão — na beira da estrada, em um hospital, em uma prancheta. Se a precisão de manuscrito da ferramenta em campos estruturados for inferior a 85%, a automação de campos estruturados entra em colapso porque muitas saídas precisam de correção.
Exportação em lote para planilha ou sistema de sinistros. A saída deve ser um arquivo estruturado (Excel, CSV) que possa ser carregado no Guidewire ClaimCenter, Duck Creek Claims ou qualquer plataforma de gestão de sinistros sem reformatação manual.
Sem necessidade de treinamento. As equipes de sinistros não têm volume para treinar modelos personalizados. Uma ferramenta que exige 10–50 documentos de amostra por tipo de formulário para "aprender" seus formatos de sinistro não é adequada para o caso de uso de entrada de seguros, em que novos formatos de seguradoras e variações de documentos de suporte aparecem regularmente.
Perguntas Frequentes
Quais tipos de documento estão incluídos na extração de dados de sinistros de seguro?
A extração de sinistros abrange o pacote completo do sinistro: formulários de aviso de perda ACORD (ACORD 1 para propriedade, ACORD 2 para automóvel, ACORD 3 para responsabilidade geral, ACORD 4 para acidentes de trabalho), boletins de ocorrência, orçamentos de reparo de automóveis e propriedades, registros e faturas de admissão médica e correspondências de apoio. Cada tipo de documento exige sua própria definição de coluna de extração, mas todas as saídas são vinculadas pelo número do sinistro ou da apólice para processamento consolidado.
Qual é a precisão da extração por IA em formulários de sinistros de seguro em comparação com a entrada manual?
Nos campos estruturados de cabeçalho — número da apólice, nome do segurado, data e local da perda, valores — a extração por IA alcança 90–95%+ de precisão, o que é mensuravelmente melhor do que a taxa de erro de 3–5% por campo da entrada manual de dados. Os erros restantes se concentram em tipos específicos de campo (VINs manuscritos, marcas parciais de caixas de seleção) e são previsíveis o suficiente para criar um fluxo de verificação pontual direcionado. Os erros manuais, por outro lado, são aleatórios — qualquer campo pode estar errado por qualquer motivo — o que os torna mais difíceis de detectar sem uma releitura completa de cada documento.
A IA consegue extrair a Descrição da Perda narrativa de um formulário de sinistro?
Ela consegue extrair o texto da narrativa com alta precisão — lendo palavras manuscritas ou digitadas e renderizando-as como um bloco de texto em uma célula de planilha. Ela não consegue categorizar essa narrativa de forma confiável em campos estruturados como "Causa da Perda" ou "Parte Culpada". Modelos de linguagem que tentam classificar narrativas produzem uma taxa de erro de 25–30% que torna a saída não confiável para decisões de cobertura ou responsabilidade. O fluxo de trabalho recomendado é extrair a narrativa como texto bruto e deixar o ajustador lê-la diretamente, enquanto os campos estruturados — que representam a maior parte da carga de entrada de dados — são automatizados.
A extração por IA funciona em boletins de ocorrência de diferentes jurisdições?
Sim — e é aqui que a extração sem modelo tem uma vantagem decisiva sobre o OCR tradicional. Existem cerca de 18.000 agências de aplicação da lei nos Estados Unidos, cada uma usando um layout de relatório diferente. O OCR baseado em modelo exigiria um modelo separado por agência. A extração semântica lê os rótulos de campo em cada relatório — "Officer Name", "Report Number", "At-Fault Driver" — para localizar valores, então uma definição de coluna cobre todos os formatos de agência. O mesmo princípio se aplica a estimativas de reparo, que variam conforme o software de estimativa (CCC, Mitchell, Audatex).
Quão bem a IA lida com formulários de sinistro manuscritos?
Em campos estruturados com rótulos claros, formulários de sinistro manuscritos são extraídos com 85–90% de precisão para a maioria das qualidades de caligrafia. O principal modo de falha são leituras incorretas de caracteres individuais — um "5" manuscrito lido como "S", um "0" como "O" — e não falhas de campo inteiro. Formulários de sinistro preenchidos em condições adversas (na estrada após um acidente, em um ambiente com pouca luz) tendem a ter caligrafia mais apressada, o que empurra a precisão para o limite inferior dessa faixa. Um fluxo de trabalho prático de sinistros inclui uma etapa de validação de 1–2 minutos para verificar os 2–3 campos mais críticos em cada formulário de sinistro.
Os dados de sinistro extraídos podem ser exportados diretamente para o Guidewire ou o Duck Creek?
Sim. A saída da extração é um arquivo estruturado — Excel, CSV ou JSON — que pode ser importado em qualquer sistema de gestão de sinistros que aceite uploads de dados em lote. Os cabeçalhos das colunas correspondem aos nomes de campo que você definiu durante a configuração da extração, então os dados chegam aos campos corretos do sistema. Para equipes que processam grandes volumes, a exportação em lote também pode ser configurada para produzir planilhas ou arquivos separados para cada tipo de documento (campos ACORD, campos de boletim de ocorrência, campos de estimativa) vinculados pelo número do sinistro ou da apólice.
Isso também funciona para formulários de sinistros de acidentes de trabalho?
Sim. Formulários FNOL de acidentes de trabalho têm a mesma estrutura de outros sinistros baseados em ACORD: um conjunto de campos de cabeçalho rotulados (nome do empregador, nome do funcionário, data da lesão, natureza da lesão, parte do corpo, médico responsável) mais uma descrição narrativa do acidente. Os campos estruturados são extraídos nas mesmas faixas de precisão que sinistros de propriedade e automóvel. Sinistros de acidentes de trabalho também geram documentos de suporte adicionais — primeiro relatório do médico, formulários de retorno ao trabalho, comprovantes de salário — cada um dos quais pode ser tratado com seu próprio conjunto de colunas de extração.
A IA consegue extrair dados de fotos de danos em veículos?
Não dados estruturados no sentido tradicional. Modelos de visão computacional conseguem classificar tipos de dano (colisão frontal, danos por granizo, danos por incêndio) e estimar faixas de gravidade, mas não conseguem gerar um valor em dólares ou uma lista de peças apenas a partir de uma foto. As fotos são melhor tratadas como evidência de suporte vinculada ao registro do sinistro, enquanto estimativas estruturadas de oficinas ou prestadores fornecem os dados que alimentam reservas financeiras e cálculos de liquidação.
Quantos formulários de sinistro podem ser processados em um único lote?
Não há limite prático superior para o tamanho do lote na extração por IA. As equipes de sinistros costumam processar 100–200 pacotes de sinistros em um único lote — misturando formulários ACORD de várias seguradoras, relatórios policiais de diferentes órgãos e estimativas de reparo de diversas oficinas. O tempo de processamento escala linearmente com o número de documentos, com média de 5–10 segundos por documento, independentemente do formato ou da seguradora. Para volumes maiores, o fluxo de trabalho em lote oferece suporte a processamento simultâneo por meio dos planos de equipe.
Como começo a testar a extração por IA nos meus próprios formulários de sinistro?
Envie um formulário ACORD digitalizado — de propriedade, automóvel ou responsabilidade geral — ou uma foto de um formulário de sinistro preenchido. Não é necessário cadastro para o primeiro teste. Defina as colunas de que seu sistema de sinistros precisa: Número da Apólice, Data da Perda, Nome do Segurado, Local da Perda, Valor Estimado, Tipo de Perda. Veja os resultados da extração em segundos. Para um passo a passo completo cobrindo o processamento em lote de formulários de várias seguradoras e documentos de suporte, consulte nossos guias passo a passo para tipos específicos de documentos de sinistro.
A vantagem da extração semântica para sinistros é que ela se adapta à variação de formato que você já gerencia manualmente — sem exigir que você crie modelos para cada seguradora, tipo de formulário ou canal de entrada. Os campos estruturados em formulários ACORD, boletins de ocorrência e orçamentos de reparo são os mesmos campos, seja o documento um PDF de portal, uma cópia enviada por fax ou uma foto de smartphone. Defina suas colunas uma vez, e a IA encontra os valores onde quer que os rótulos apareçam.
Experimente em Seus Próprios Documentos de Sinistro