Guía Completa para
la Extracción de Datos de Reclamaciones de Seguros (2026)
Un solo siniestro de accidente automovilístico genera un formulario ACORD 2 del reclamante, un informe policial de la agencia que respondió, un presupuesto de reparación del taller, formularios de admisión médica si hay lesiones y fotos de tres teléfonos inteligentes. Cada documento llega en un formato diferente, de una fuente diferente, con un diseño diferente — y el ajustador necesita los datos estructurados de todos ellos vinculados al mismo registro de reclamación. Ese es el verdadero desafío de la extracción de datos de reclamaciones de seguros, y no es un desafío para el que la mayoría de las herramientas de extracción fueron diseñadas.
Conclusiones Clave
- Un ajustador de reclamaciones dedica de 17 a 25 horas por semana a la entrada de datos — a $35-45 por hora — antes de tocar el análisis de cobertura, la negociación de acuerdos o la investigación por los que se le paga su experiencia.
- El costo laboral visible es solo la mitad de la historia: la corrección de errores, la pérdida de productividad del ajustador y el retraso en el tiempo de ciclo viven en presupuestos separados donde ningún informe revela que el procesamiento manual de reclamaciones cuesta aproximadamente el doble de lo que muestra la línea de nómina.
- Una definición de columna reutilizable por tipo de documento — formularios ACORD, informes policiales, presupuestos de reparación — extrae campos estructurados de cada documento del lote, y el ajustador revisa solo las excepciones marcadas por la puntuación de confianza.
¿Qué es la extracción de datos de reclamaciones de seguros?
La extracción de datos de reclamaciones de seguros es el proceso automatizado de leer campos clave de documentos relacionados con reclamaciones — avisos de pérdida ACORD, informes policiales, estimaciones de reparación, registros médicos y otros adjuntos de respaldo — y convertirlos en datos estructurados que una hoja de cálculo, un sistema de gestión de reclamaciones o una plataforma de análisis puedan ingerir. A diferencia de la extracción estándar de facturas o recibos, que se enfoca en un solo tipo de documento, la extracción de reclamaciones debe manejar un paquete de múltiples documentos donde cada componente tiene su propio formato, sus propios campos clave y sus propios requisitos de extracción.
El alcance va más allá del Primer Aviso de Pérdida. Una estrategia completa de extracción de reclamaciones cubre todos los documentos que ingresan al expediente de la reclamación desde la recepción hasta el acuerdo: el formulario ACORD inicial (ya sea de automóvil, propiedad, responsabilidad general o compensación laboral), los adjuntos de respaldo que sustentan la pérdida, y la correspondencia y documentación de facturación en curso que se acumulan a medida que avanza la reclamación. Para un desglose detallado a nivel de campo de lo que la IA puede y no puede extraer de los formularios ACORD iniciales específicamente, consulte nuestro artículo complementario sobre ¿Puede la IA leer formularios FNOL de reclamaciones de seguros?
Lo que distingue a esta categoría de otras tareas de extracción de documentos es la estructura en capas de un paquete de reclamaciones. Los campos de encabezado estructurados del formulario ACORD — número de póliza, fecha de pérdida, nombre del asegurado, ubicación de la pérdida — siguen un patrón predecible y se extraen de manera confiable. La narrativa de texto libre en la sección de Descripción de la Pérdida no lo hace. Los documentos de respaldo — un informe policial de una jurisdicción, una estimación de reparación de un sistema de software diferente, registros médicos de un tercero — cada uno requiere una estrategia de extracción separada. Un enfoque completo considera las tres capas, no solo la más conveniente.
Por qué la entrada manual de datos de reclamaciones cuesta más de lo que parece
El costo visible de la entrada manual de datos de reclamaciones es sencillo: un empleado de entrada de datos o un ajustador teclea los valores de los campos de cada documento en un sistema de reclamaciones, carácter por carácter. McKinsey estima que la automatización puede reducir el tiempo de procesamiento de reclamaciones hasta en un 50% y recortar los costos del recorrido de la reclamación hasta en un 30%. Pero esas cifras agregadas subestiman lo que el procesamiento manual realmente cuesta a una operación, porque el gasto real llega a través de cuatro canales distintos que la mayoría de las empresas rastrean en presupuestos separados.
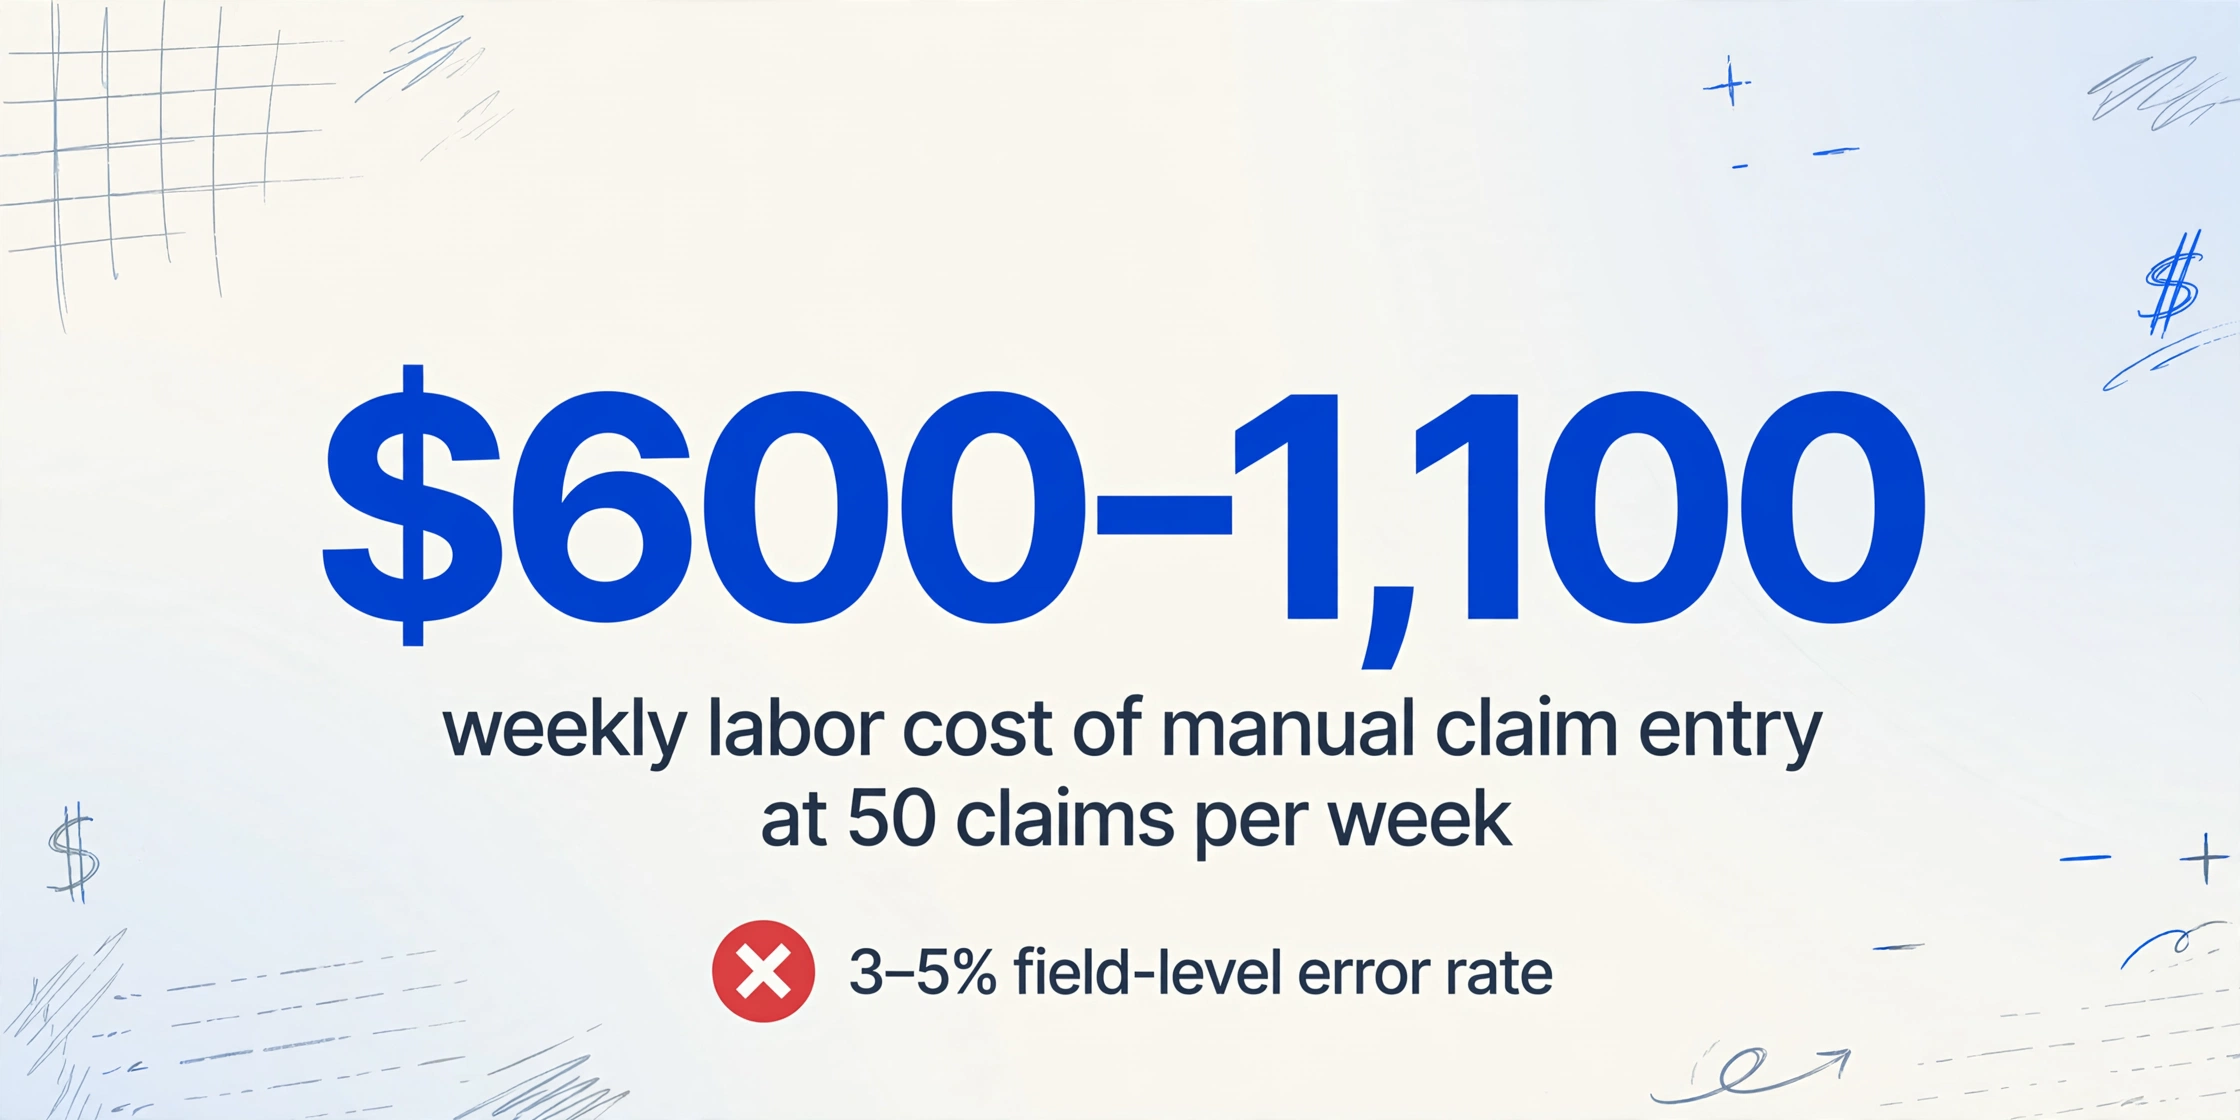
Mano de obra directa de transcripción. Un ajustador o empleado de reclamaciones que procesa un paquete de reclamación individual — formulario ACORD más dos o tres documentos de respaldo — dedica aproximadamente de 20 a 30 minutos solo a la entrada de datos. Con 50 reclamaciones por semana, eso equivale a 17 a 25 horas de pura mecanografía. Con un costo cargado de $35–45 por hora para un manejador de reclamaciones experimentado, eso se traduce en $600–1,100 por semana en mano de obra que no aporta ningún valor de juicio a la reclamación.
El impuesto del error. La entrada manual de datos de documentos de seguros conlleva una tasa de error a nivel de campo estimada del 3–5%. En un paquete de reclamación con 25–40 campos extraíbles en el formulario ACORD y los anexos, eso significa uno o dos errores por reclamación. Un número de póliza mal escrito retrasa la verificación de elegibilidad. Una fecha de pérdida incorrecta provoca una llamada de seguimiento al asegurado. Un monto transpuesto en la estimación de reparación crea un desajuste en la reserva que requiere tiempo para conciliar. Los puntos de referencia de la industria sugieren que cada error de entrada de datos en una reclamación cuesta $15–30 de corregir — y esos costos se agravan cuando los errores se descubren más adelante en el proceso en lugar de en la admisión.
El costo de oportunidad del tiempo del ajustador. La investigación de McKinsey muestra que los suscriptores y ajustadores de reclamaciones dedican el 30–40% de su tiempo a tareas administrativas, incluida la entrada de datos y la recuperación de documentos. Para un ajustador senior que maneja 100–150 reclamaciones abiertas, eso significa de 12 a 20 horas por semana dedicadas a teclear en lugar de investigar cobertura, negociar acuerdos o gestionar casos complejos. El costo en dólares de ese tiempo es el salario completo del ajustador. El costo de oportunidad es la velocidad de las reclamaciones — y la satisfacción del cliente — que esas horas podrían haber producido si se hubieran redirigido al trabajo de juicio.
Tiempo de ciclo retrasado. Cada paso manual entre la recepción del documento y la disponibilidad de los datos añade horas al ciclo de vida de la reclamación. En operaciones de reclamaciones de alto volumen — TPA que procesan más de 200 reclamaciones al día, equipos de respuesta a catástrofes que manejan volúmenes de pico — esas horas se acumulan en días. Los estudios de satisfacción de reclamaciones de J.D. Power muestran consistentemente que la velocidad de procesamiento de FNOL es uno de los impulsores más fuertes de la satisfacción del cliente. Cada día adicional de procesamiento manual perjudica la experiencia del cliente y aumenta la probabilidad de litigios, quejas regulatorias y escalamiento.
Los cuatro costos son aditivos, no alternativas. Una operación que gasta $2,500 al mes en mano de obra directa de entrada de datos de reclamaciones probablemente esté incurriendo en un monto equivalente en corrección de errores, productividad perdida del ajustador y tiempo de ciclo retrasado. El costo real de la entrada manual de datos de reclamaciones es aproximadamente el doble de la partida laboral visible — y está enterrado en presupuestos donde ningún informe individual revela jamás el total.
Qué Hace que la Extracción de Reclamaciones de Seguros sea Diferente de Otros Tipos de Documentos
La extracción de reclamaciones de seguros comparte ADN técnico con la extracción de facturas o recibos — los mismos modelos de visión-lenguaje, el mismo enfoque de columnas personalizadas — pero tres factores estructurales la convierten en un problema fundamentalmente más difícil.
1. Variedad de formatos por aseguradora y línea de negocio. Un ACORD 1 (Aviso de Pérdida de Propiedad) y un ACORD 2 (Aviso de Pérdida Automovilística) se ven diferentes porque recopilan información distinta. Pero el mismo ACORD 1 completado a través de un sistema de gestión de agencias Applied Epic se renderiza de manera diferente que uno de Vertafore AMS360, que a su vez se renderiza de manera diferente que uno llenado a mano en un formulario en papel. ACORD mantiene más de 800 tipos de formularios estandarizados. Las aproximadamente 39,000 agencias independientes de P&C en los Estados Unidos producen estos formularios con sus propias configuraciones de sistema, ajustes de impresión y hábitos de llenado. La extracción basada en plantillas, que depende de coordenadas fijas de campos, falla en el momento en que el diseño cambia. La extracción semántica, que lee las etiquetas de los campos para localizar valores, maneja esta variabilidad sin configuración por aseguradora. Cubrimos esta diferencia con más profundidad en nuestro explicador sobre OCR tradicional versus extracción impulsada por IA.
2. El paquete de reclamaciones con múltiples documentos. Una herramienta de extracción de facturas procesa una factura. Un flujo de trabajo de extracción de reclamaciones procesa una carpeta: un formulario ACORD, un informe policial, una estimación de reparación, registros médicos de admisión, fotografías y, a veces, una nota de remolque o un contrato de alquiler. Cada tipo de documento tiene sus propios campos estándar, sus propias convenciones de diseño y sus propias definiciones de columnas de extracción. El desafío no es extraer un solo documento — es extraerlos todos en un flujo de trabajo coherente que mantenga los resultados vinculados al mismo registro de reclamación.
3. Campos estructurados + narrativa de texto libre en un solo documento. El formulario ACORD es único al combinar ambos modos en una sola página. El encabezado contiene campos claramente etiquetados y de valor corto que la IA extrae con alta precisión. La sección de Descripción de la Pérdida es una caja en blanco para prosa narrativa — 50 palabras o 500, escrita a mano o a máquina, enfocada o divagante. Estos dos modos coexisten dentro del mismo documento y requieren un tratamiento fundamentalmente diferente.
Los Campos Estructurados: Lo Que Puede Extraer de Forma Fiable
Los campos de encabezado estructurados en los formularios ACORD son donde la extracción con IA ofrece el mayor valor. Estos campos tienen etiquetas impresas, espacios de valores limitados y patrones semánticos consistentes: las condiciones ideales para un modelo de visión y lenguaje. A continuación se presentan los campos clave desglosados por los cuatro tipos principales de formularios ACORD FNOL que cubren la gran mayoría de la recepción de siniestros de P&C.
ACORD 1 — Aviso de Pérdida de Propiedad
| Campo | Formato | Precisión Realista |
|---|---|---|
| Número de Póliza | Alfanumérico, 8–15 caracteres | 95%+ |
| Nombre y Contacto del Asegurado | Nombre + dirección + teléfono | 95%+ |
| Fecha y Hora del Siniestro | Fecha + hora | 95%+ |
| Ubicación del Siniestro | Dirección o intersección | 90%+ |
| Tipo de Pérdida (casillas) | Casilla: Incendio/Viento/Granizo/Agua/Robo | 85–90% |
| Código de Aseguradora NAIC | Numérico de 5 dígitos | 95%+ |
| Monto Estimado de la Pérdida | Moneda | 90%+ |
| Deducible de la Póliza | Moneda | 90%+ |
| Acreedor Hipotecario / Titular del Gravamen | Nombre + dirección | 85%+ |
| Número de Informe Policial | Alfanumérico | 80%+ (a menudo en blanco) |
ACORD 2 — Aviso de Pérdida Automovilística
| Campo | Formato | Precisión Realista |
|---|---|---|
| Número de Póliza | Alfanumérico | 95%+ |
| Nombre del Asegurado y Contacto | Nombre + dirección + teléfono | 95%+ |
| Información del Conductor / Reclamante | Nombre + dirección + teléfono + n.º de licencia | 90%+ |
| Información del Vehículo | VIN + año + marca + modelo | 85–90% (VIN manuscrito es lo más difícil) |
| Fecha, Hora y Lugar de la Pérdida | Fecha + hora + dirección | 95%+ |
| Tipo de Accidente | Casilla: Colisión/Robo/Vandalismo | 85%+ |
| Descripción de Daños | Área de casillas: Delantero/Trasero/Lateral/Superior | 85–90% |
| Monto Estimado de Daños | Moneda | 90%+ |
| Información de Testigos | Nombre + teléfono | 85%+ |
| Número de Informe Policial y Agencia | Alfanumérico + nombre del departamento | 80%+ |
ACORD 3 — Aviso de Pérdida de Responsabilidad General
| Campo | Formato | Precisión Realista |
|---|---|---|
| Número de Póliza | Alfanumérico | 95%+ |
| Nombre y Contacto del Asegurado | Nombre + dirección | 95%+ |
| Nombre y Contacto del Reclamante | Nombre + dirección + teléfono | 90%+ |
| Fecha, Hora y Lugar del Siniestro | Fecha + hora + dirección | 95%+ |
| Tipo de Siniestro | Casilla: Instalaciones/Operaciones/Producto | 85–90% |
| Descripción de la Lesión | Casilla + texto (naturaleza de la lesión) | 85%+ |
| Gastos Médicos Incurridos | Moneda | 90%+ |
| Información del Testigo | Nombre + teléfono | 85%+ |
El patrón en los tres tipos de formularios es consistente: los campos etiquetados con valores cortos se extraen con un 85–95%+ de precisión, ya sea mecanografiados o manuscritos. La variación proviene de la legibilidad de la escritura (un "5" apresurado leído como "S" en un VIN) y de la calidad de la marca en las casillas (una marca ligera de lápiz leída como no marcada), no de la incapacidad de la IA para localizar el campo en la página. Dado que la extracción semántica lee las etiquetas de los campos en lugar de depender de coordenadas fijas, la misma definición de columna para "Número de Póliza" funciona en un ACORD 1 del PDF del portal de una aseguradora y en un ACORD 2 fotografiado al borde de la carretera — sin plantillas, sin configuración por aseguradora.
La Narrativa de Texto Libre: Una Estrategia Diferente
La sección de Descripción de Pérdida es la parte de un formulario ACORD donde la extracción con IA encuentra un límite estructural. Esta sección contiene el relato del propio reclamante sobre lo sucedido, escrito en prosa narrativa — normalmente de 200 a 500 palabras — y no sigue ningún patrón extraíble. Una descripción de accidente automovilístico podría decir: "Me detuve en el semáforo en Main Street. Un camión me golpeó por detrás." Una descripción de pérdida de propiedad: "Noté agua en el piso de la cocina alrededor de las 3 PM. Subí al ático y encontré una tubería rota." El mismo escenario de colisión puede ser escrito de tres maneras diferentes por tres reclamantes distintos, cada uno con estructuras de oración, elecciones de palabras y niveles de detalle diferentes.
La IA de visión moderna puede extraer el texto de esta narrativa con alta precisión — leyendo las palabras escritas a mano o mecanografiadas de la página y convirtiéndolas en un bloque de texto en una celda de hoja de cálculo. Esa parte funciona de manera confiable. Lo que no funciona es el paso que la mayoría de los equipos de reclamaciones realmente desean: categorizar automáticamente esa narrativa en campos estructurados como "Categoría de Causa de Pérdida," "Parte Culpable," o "Severidad de la Lesión." Los modelos de lenguaje que intentan esta clasificación producen tasas de error del 25–30%, lo cual es demasiado alto para cualquier proceso posterior que dependa de que el resultado sea correcto.
El enfoque recomendado para las operaciones de reclamaciones es extraer la narrativa como texto sin formato en un solo campo. El ajustador lee ese campo — exactamente como lo leería del formulario en papel — mientras que los campos estructurados (número de póliza, fecha de pérdida, montos, detalles del vehículo) ya están completados en la hoja de cálculo. El ahorro de tiempo proviene de no tener que volver a escribir esos campos estructurados, no de intentar forzar la narrativa hacia una clasificación que no la respalda.
Documentos de Respaldo: Una Reclamación, Múltiples Estrategias de Extracción
Un paquete de reclamación en la práctica rara vez es solo el formulario ACORD. Los documentos de respaldo normalmente superan en número al formulario principal en una proporción de dos a uno o tres a uno, y cada tipo exige su propio perfil de extracción. Así es como los adjuntos más comunes se asignan a la estrategia de extracción.
Informes Policiales
Los informes policiales son el documento de respaldo que se adjunta con mayor frecuencia. Contienen datos estructurados críticos: el nombre y número de placa del oficial investigador, el número del informe, la fecha y hora en que se presentó, la designación del conductor responsable, información de citaciones, notas sobre condiciones climáticas y del camino, y una sección narrativa que a menudo repite o amplía lo que el reclamante escribió en el formulario ACORD. El desafío de extracción con los informes policiales no es la complejidad de los campos, sino la variabilidad de formatos. Hay aproximadamente 18,000 agencias de aplicación de la ley en los Estados Unidos, cada una con su propio diseño de informe. Algunas usan el modelo estándar de informe de accidentes de tránsito de la NHTSA. Otras usan formularios específicos de cada estado (el CHP 555 de California, el CR-3 de Texas). Muchas usan formatos de informe personalizados generados por su sistema de gestión de registros. Un enfoque basado en plantillas requeriría una plantilla separada para cada agencia. La extracción semántica los maneja todos con una sola definición de columna porque lee las etiquetas del informe — "Nombre del Oficial", "Número de Informe", "Responsable" — sin importar dónde se encuentren en la página.
Presupuestos de Reparación
Los presupuestos de reparación de automóviles de talleres de carrocería y los presupuestos de reparación de propiedades de contratistas contienen detalle por partida que es esencial para el establecimiento de reservas y la negociación de acuerdos. Los campos clave extraíbles incluyen: nombre y contacto del taller o contratista, fecha del presupuesto, identificador del vehículo o propiedad, horas de mano de obra y tarifa por línea, costos de piezas (OEM vs. de reemplazo vs. usadas), pintura y materiales, subtotal, impuestos y total. Los presupuestos de reparación son más valiosos cuando se extraen como una tabla con una fila por línea, de modo que el daño total estimado pueda calcularse a partir de la suma de todos los elementos en lugar de depender de un único total manuscrito que puede omitir ciertas categorías de costos. El presupuesto también debe vincularse al registro de reclamo que respalda, lo que significa que el flujo de trabajo de extracción debe capturar el número de reclamo o póliza que aparece en el presupuesto, incluso si está escrito a mano en un margen.
Registros Médicos y Formularios de Admisión
En reclamos que involucran lesiones — accidentes automovilísticos, compensación laboral, responsabilidad de locales — los documentos médicos ingresan al expediente del reclamo rápidamente. Los formularios de admisión de sala de emergencias, hojas de registro de ambulancias, órdenes de imágenes diagnósticas y notas de tratamiento inicial contienen campos estructurados (nombre del paciente, fecha del servicio, NPI del proveedor, códigos de diagnóstico, códigos de facturación) mezclados con notas clínicas. La estrategia de extracción refleja el enfoque de ACORD: extraer los campos estructurados (fechas, códigos, identidades del proveedor, montos facturados) con definiciones de columnas, y mantener las notas clínicas como texto libre para que el ajustador o el gerente de casos de enfermería las revise.
Fotos
Las fotos de daños — fotos de colisiones de vehículos, daños por incendio, intrusión de agua, equipos averiados — no pueden extraerse para datos estructurados en el sentido tradicional. No hay un "monto en dólares" que leer de una foto. Sin embargo, los modelos de visión por computadora pueden identificar y clasificar tipos de daños (p. ej., "colisión frontal," "daño en el techo por granizo," "mancha de agua en el techo") si la operación de reclamos tiene un caso de uso para la codificación automatizada de daños. Para la mayoría de los equipos de reclamos, el enfoque práctico es tratar las fotos como evidencia de respaldo que el sistema de admisión de reclamos recibe y vincula al registro del reclamo, sin intentar una extracción estructurada.
La idea operativa clave en todos los tipos de documentos de respaldo: cada uno requiere su propia definición de columna de extracción, y el flujo de trabajo debe mantener los resultados de todos los documentos vinculados al mismo registro de reclamo. Esto no es un problema de extracción único. Es una familia de problemas de extracción organizados en torno a un evento de reclamo.
Métodos Tradicionales vs. Extracción Impulsada por IA
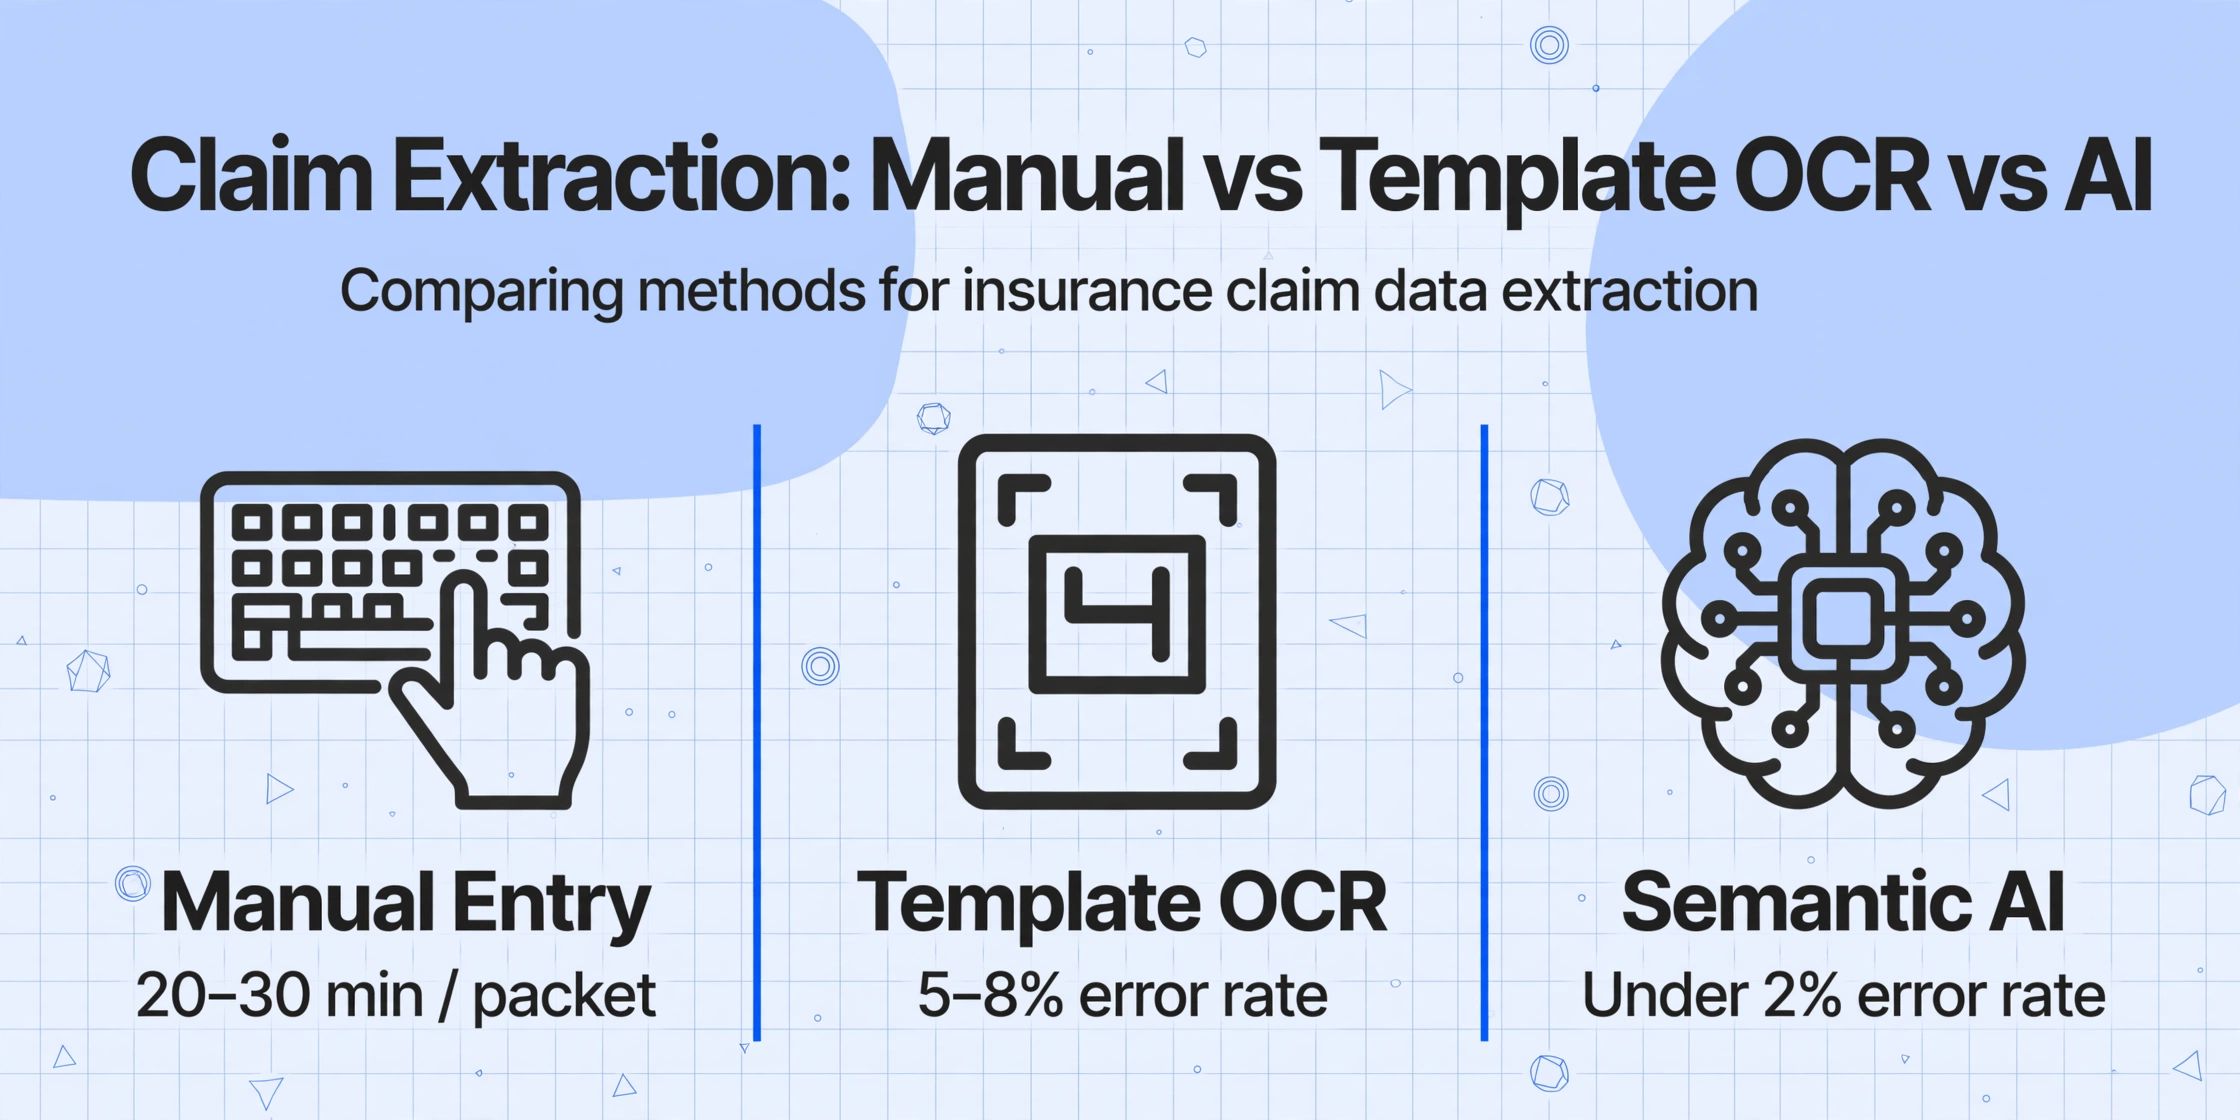
El enfoque convencional para la entrada de datos de reclamos de seguros tiene dos variantes: escritura manual y OCR basado en plantillas. Ambas comparten la misma limitación fundamental: tratan cada documento de reclamo como si su diseño fuera predecible, lo cual no es así en la admisión de reclamos del mundo real.
| Dimensión | Ingreso manual | OCR con plantilla | Extracción semántica con IA |
|---|---|---|---|
| Configuración por tipo de formulario de aseguradora | Ninguna (el humano se adapta) | Plantilla por formulario × combinación de sistema de agencia | Cero: una definición de columna por campo |
| Lote de aseguradoras mixtas | Secuencial, uno a la vez | Solo formularios con el mismo diseño | Aseguradoras mixtas, tipos de formulario mixtos |
| Documentos de respaldo | Lee cada tipo de documento por separado | Plantilla por tipo de documento × diseño | Un conjunto de columnas por tipo de documento |
| Escritura a mano en campos estructurados | Lee la mayoría de la escritura a mano | Falla con la mayoría de la escritura a mano | 85–95 % en campos estructurados |
| Resiliencia a cambios de formato | N/D: el humano se adapta | Se rompe hasta que se actualiza la plantilla | Maneja diseños nuevos automáticamente |
| Tiempo por paquete de reclamo | 20–30 min | 5–10 min (si existen plantillas) | 5–10 segundos |
| Tasa de error a nivel de campo (estructurado) | 3–5 % | 5–8 % en formatos sin plantilla | Menos del 2 % en campos etiquetados |
El enfoque de IA semántica — extracción de documentos sin plantilla — importa más para reclamos que para cualquier otra categoría de documentos debido a la gran variación de formatos en la recepción de reclamos del mundo real. Un ACORD 2 que llega como PDF limpio desde el portal de una aseguradora y el mismo formulario que llega como copia por fax con campos manuscritos en los márgenes son el mismo tipo de documento que requiere las mismas columnas, pero un sistema basado en plantillas necesitaría dos configuraciones. Un sistema semántico maneja ambos con una sola.
Procesamiento por lotes de formularios de reclamos de múltiples aseguradoras
El flujo de trabajo práctico para los equipos de reclamos que procesan de 50 a 200 reclamos por día es el procesamiento por lotes: cargar una carpeta de paquetes de reclamos, extraer los campos estructurados de cada documento componente y exportar todo a una hoja de cálculo unificada con una clave de número de reclamo que vincule las filas de cada tipo de documento.
Un flujo de trabajo por lotes típico se ve así:
El Procesamiento por lotes prioritario no es una ocurrencia tardía para las operaciones de reclamos. Es el único flujo de trabajo que escala cuando un TPA procesa reclamos de 50 aseguradoras diferentes, cada una usando una representación ACORD distinta, y los documentos de respaldo llegan a través de una docena de canales de ingreso diferentes.
Cómo elegir una herramienta de extracción de reclamos
No todas las herramientas de extracción son adecuadas para reclamos de seguros. La combinación de documentos — formularios estructurados, narrativas de texto libre, adjuntos de múltiples fuentes — exige capacidades específicas que las herramientas de OCR de propósito general pueden no tener. Estos son los criterios que importan específicamente para las operaciones de reclamos.
Sin plantilla o basado en plantillas. Esta es la decisión más importante. Si la herramienta requiere crear y mantener plantillas por aseguradora, por tipo de formulario y por canal de ingreso, no sobrevivirá a la variabilidad de formatos del ingreso de reclamos en el mundo real. Un enfoque sin plantilla — donde las definiciones de columnas funcionan entre tipos de formularios, aseguradoras y diseños — elimina la deuda de configuración que hace que los pilotos de automatización de reclamos se estanquen después de la fase de prueba de concepto.
Soporte para múltiples tipos de documentos. La herramienta debe manejar formularios ACORD, informes policiales, presupuestos de reparación y registros médicos como tipos de documentos distintos con definiciones de columnas separadas — no tratar todo como "un solo documento".
Capacidad de reconocimiento de escritura a mano. Un porcentaje significativo de formularios de reclamos se llenan a mano — al borde de la carretera, en un hospital, sobre una tabla. Si la precisión de la herramienta con escritura a mano en campos estructurados es inferior al 85%, la automatización de campos estructurados colapsa porque demasiados resultados requieren corrección.
Exportación por lotes a hoja de cálculo o sistema de reclamos. La salida debe ser un archivo estructurado (Excel, CSV) que pueda cargarse en Guidewire ClaimCenter, Duck Creek Claims o cualquier plataforma de gestión de reclamos sin reformateo manual.
Sin requisito de entrenamiento. Los equipos de reclamos no tienen el volumen para entrenar modelos personalizados. Una herramienta que requiere de 10 a 50 documentos de muestra por tipo de formulario para "aprender" sus formatos de reclamos no es adecuada para el caso de uso de ingreso de seguros, donde aparecen regularmente nuevos formatos de aseguradoras y variaciones de documentos de respaldo.
Preguntas Frecuentes
¿Qué tipos de documentos se incluyen en la extracción de datos de reclamos de seguros?
La extracción de reclamos cubre el paquete completo de reclamos: formularios de aviso de pérdida ACORD (ACORD 1 para propiedad, ACORD 2 para auto, ACORD 3 para responsabilidad general, ACORD 4 para compensación laboral), informes policiales, estimaciones de reparación de autos y propiedades, registros y facturas médicas de admisión, y correspondencia de respaldo. Cada tipo de documento requiere su propia definición de columnas de extracción, pero todos los resultados están vinculados por el número de reclamo o póliza para un procesamiento consolidado.
¿Qué tan precisa es la extracción con IA en formularios de reclamos de seguros en comparación con la captura manual?
En los campos estructurados del encabezado — número de póliza, nombre del asegurado, fecha y lugar de la pérdida, montos — la extracción con IA alcanza una precisión del 90–95%+, que es mediblemente superior a la tasa de error del 3–5% a nivel de campo de la captura manual de datos. Los errores restantes se concentran en tipos de campos específicos (VIN manuscritos, marcas parciales en casillas) y son lo suficientemente predecibles como para diseñar un flujo de verificación selectiva dirigida. Los errores manuales, por el contrario, son aleatorios — cualquier campo puede estar mal por cualquier motivo — lo que los hace más difíciles de detectar sin una relectura completa de cada documento.
¿Puede la IA extraer la narrativa de Descripción de la Pérdida de un formulario de reclamo?
Puede extraer el texto de la narrativa con alta precisión — leyendo palabras manuscritas o mecanografiadas y convirtiéndolas en un bloque de texto en una celda de hoja de cálculo. No puede categorizar de manera confiable esa narrativa en campos estructurados como "Causa de la Pérdida" o "Parte Culpable". Los modelos de lenguaje que intentan clasificar narrativas producen una tasa de error del 25–30% que hace que el resultado no sea confiable para decisiones de cobertura o responsabilidad. El flujo de trabajo recomendado es extraer la narrativa como texto sin procesar y dejar que el ajustador la lea directamente, mientras que los campos estructurados — que representan la mayor parte de la carga de captura de datos — se automatizan.
¿La extracción con IA funciona con informes policiales de diferentes jurisdicciones?
Sí — y aquí es donde la extracción sin plantilla tiene una ventaja decisiva sobre el OCR tradicional. Hay aproximadamente 18 000 agencias de aplicación de la ley en los Estados Unidos, cada una con un formato de informe diferente. El OCR basado en plantillas requeriría una plantilla separada por agencia. La extracción semántica lee las etiquetas de campo de cada informe — "Nombre del oficial", "Número de informe", "Conductor responsable" — para localizar los valores, de modo que una definición de columna cubre todos los formatos de agencia. El mismo principio se aplica a las estimaciones de reparación, que varían según el sistema de software de estimación (CCC, Mitchell, Audatex).
¿Qué tan bien maneja la IA los formularios de reclamo escritos a mano?
En campos estructurados con etiquetas de campo claras, los formularios de reclamo escritos a mano se extraen con una precisión del 85–90 % para la mayoría de las calidades de escritura. El principal modo de falla son los errores de lectura de caracteres individuales — un "5" escrito a mano leído como "S", un "0" como "O" — más que fallas de campo completo. Los formularios de reclamo completados en condiciones adversas (al costado de la carretera después de un accidente, en una habitación con poca luz) tienden a tener una escritura más apresurada que acerca la precisión al extremo inferior de ese rango. Un flujo de trabajo práctico de reclamos incluye un paso de validación de 1 a 2 minutos para verificar los 2 o 3 campos más críticos de cada formulario de reclamo.
¿Se pueden exportar los datos de reclamos extraídos directamente a Guidewire o Duck Creek?
Sí. La salida de la extracción es un archivo estructurado — Excel, CSV o JSON — que se puede importar a cualquier sistema de gestión de reclamos que acepte cargas de datos por lotes. Los encabezados de columna coinciden con los nombres de campo que definió durante la configuración de la extracción, por lo que los datos llegan a los campos correctos del sistema. Para equipos que procesan grandes volúmenes, la exportación por lotes también se puede configurar para producir hojas o archivos separados para cada tipo de documento (campos ACORD, campos de informe policial, campos de estimación) vinculados por el número de reclamo o póliza.
¿Funciona también para formularios de reclamaciones de compensación laboral?
Sí. Los formularios FNOL de compensación laboral comparten la misma estructura que otras reclamaciones basadas en ACORD: un conjunto de campos de encabezado etiquetados (nombre del empleador, nombre del empleado, fecha de la lesión, naturaleza de la lesión, parte del cuerpo, médico tratante) más una descripción narrativa del accidente. Los campos estructurados se extraen con los mismos rangos de precisión que las reclamaciones de propiedad y automóviles. Las reclamaciones de compensación laboral también generan documentos de respaldo adicionales: primer informe del médico, formularios de retorno al trabajo, declaraciones de salario — cada uno puede gestionarse con su propio conjunto de columnas de extracción.
¿Puede la IA extraer datos de fotos de daños en vehículos?
No datos estructurados en el sentido tradicional. Los modelos de visión por computadora pueden clasificar tipos de daños (colisión frontal, daño por granizo, daño por incendio) y estimar rangos de severidad, pero no pueden generar un valor en dólares ni una lista de piezas a partir de una sola foto. Las fotos se tratan mejor como evidencia de respaldo vinculada al registro de la reclamación, mientras que las estimaciones estructuradas de talleres o contratistas proporcionan los datos que alimentan las reservas financieras y los cálculos de liquidación.
¿Cuántos formularios de reclamación pueden procesarse en un solo lote?
No existe un límite superior práctico para el tamaño del lote en la extracción con IA. Los equipos de reclamaciones procesan habitualmente entre 100 y 200 paquetes de reclamaciones en un solo lote — combinando formularios ACORD de múltiples aseguradoras, informes policiales de diferentes agencias y estimaciones de reparación de varios talleres. El tiempo de procesamiento escala linealmente con el número de documentos, con un promedio de 5 a 10 segundos por documento, independientemente del formato o la aseguradora. Para volúmenes más altos, el flujo de trabajo por lotes admite procesamiento concurrente mediante planes de equipo.
¿Cómo empiezo a probar la extracción con IA en mis propios formularios de reclamación?
Sube un formulario ACORD escaneado — de propiedad, automóvil o responsabilidad general — o una foto de un formulario de reclamación completado. No se requiere registro para la primera prueba. Define las columnas que necesita tu sistema de reclamaciones: Número de Póliza, Fecha de Pérdida, Nombre del Asegurado, Ubicación de la Pérdida, Monto Estimado, Tipo de Pérdida. Ve los resultados de extracción en segundos. Para un recorrido completo que cubra el procesamiento por lotes de formularios de múltiples aseguradoras y documentos de respaldo, consulta nuestras guías paso a paso para tipos específicos de documentos de reclamación.
La ventaja de la extracción semántica para reclamaciones es que se adapta a la variabilidad de formatos que ya gestiona manualmente — sin pedirle que cree plantillas para cada aseguradora, tipo de formulario o canal de entrada. Los campos estructurados en formularios ACORD, informes policiales y presupuestos de reparación son los mismos campos, ya sea que el documento llegue como PDF de portal, copia por fax o foto de teléfono inteligente. Defina sus columnas una vez, y la IA encuentra los valores dondequiera que aparezcan las etiquetas.
Pruébelo con Sus Propios Documentos de Reclamación