Vollständiger Leitfaden zur
Extraktion von Versicherungsanspruchsdaten (2026)
Ein einziger Kfz-Unfallanspruch erzeugt ein ACORD 2-Formular vom Anspruchsteller, einen Polizeibericht der zuständigen Behörde, einen Reparaturkostenvoranschlag der Werkstatt, medizinische Aufnahmeformulare bei Verletzungen und Fotos von drei Smartphones. Jedes Dokument kommt in einem anderen Format, aus einer anderen Quelle, mit einem anderen Layout — und der Sachbearbeiter benötigt die strukturierten Daten aus allen Dokumenten, verknüpft mit demselben Anspruchsdatensatz. Das ist die eigentliche Herausforderung der Extraktion von Versicherungsanspruchsdaten, und die meisten Extraktionstools wurden nicht dafür entwickelt, sie zu bewältigen.
Wichtigste Erkenntnisse
- Ein Schadensachbearbeiter verbringt 17-25 Stunden pro Woche mit Dateneingabe — bei $35-45 pro Stunde — bevor er sich der Deckungsanalyse, Schadensregulierungsverhandlung oder Untersuchung widmen kann, für die seine Expertise bezahlt wird.
- Die sichtbaren Personalkosten sind nur die halbe Geschichte: Fehlerkorrektur, verlorene Produktivität der Sachbearbeiter und verzögerte Bearbeitungszeiten stecken in separaten Budgets, in denen kein einzelner Bericht zeigt, dass die manuelle Anspruchsbearbeitung etwa doppelt so viel kostet wie die Lohnabrechnung ausweist.
- Eine wiederverwendbare Spaltendefinition pro Dokumenttyp — ACORD-Formulare, Polizeiberichte, Reparaturkostenvoranschläge — extrahiert strukturierte Felder aus jedem Dokument im Batch, und der Sachbearbeiter prüft nur die Ausnahmen, die durch Confidence-Scoring gekennzeichnet werden.
Was ist die Extraktion von Versicherungsanspruchsdaten?
Die Extraktion von Versicherungsanspruchsdaten ist der automatisierte Prozess, bei dem Schlüsselfelder aus anspruchsbezogenen Dokumenten — ACORD-Schadenmeldungen, Polizeiberichte, Reparaturkostenvoranschläge, Krankenakten und andere unterstützende Anlagen — gelesen und in strukturierte Daten umgewandelt werden, die eine Tabellenkalkulation, ein Schadenmanagementsystem oder eine Analyseplattform aufnehmen kann. Anders als die Standardextraktion von Rechnungen oder Belegen, die auf einen einzigen Dokumenttyp abzielt, muss die Anspruchsextraktion ein Paket aus mehreren Dokumenten verarbeiten, bei dem jede Komponente ihr eigenes Format, ihre eigenen Schlüsselfelder und ihre eigenen Extraktionsanforderungen hat.
Der Umfang geht über die Erstschadenmeldung (First Notice of Loss) hinaus. Eine vollständige Strategie zur Anspruchsextraktion deckt jedes Dokument ab, das von der Annahme bis zur Regulierung in die Schadenakte gelangt: das ursprüngliche ACORD-Formular (ob Kfz-, Sach-, allgemeine Haftpflicht- oder Arbeitnehmerunfallversicherung), die unterstützenden Anlagen, die den Schaden belegen, sowie die laufende Korrespondenz und die Abrechnungsdokumente, die sich im Verlauf des Anspruchs ansammeln. Eine detaillierte Aufschlüsselung auf Feldebene, was KI speziell aus den ursprünglichen ACORD-Formularen extrahieren kann und was nicht, finden Sie in unserem Begleitartikel Kann KI Versicherungs-FNOL-Formulare lesen?
Was diese Kategorie von anderen Dokumentextraktionsaufgaben unterscheidet, ist die geschichtete Struktur eines Anspruchspakets. Die strukturierten Kopffelder des ACORD-Formulars — Policennummer, Schadendatum, Name des Versicherten, Schadenort — folgen einem vorhersehbaren Muster und lassen sich zuverlässig extrahieren. Der Freitext in der Beschreibung des Schadens (Description of Loss) nicht. Die unterstützenden Dokumente — ein Polizeibericht aus einer Gerichtsbarkeit, ein Reparaturkostenvoranschlag aus einem anderen Softwaresystem, Krankenakten aus einem dritten — erfordern jeweils eine eigene Extraktionsstrategie. Ein vollständiger Ansatz berücksichtigt alle drei Ebenen, nicht nur die bequemste.
Warum manuelle Schadendatenerfassung teurer ist, als es scheint
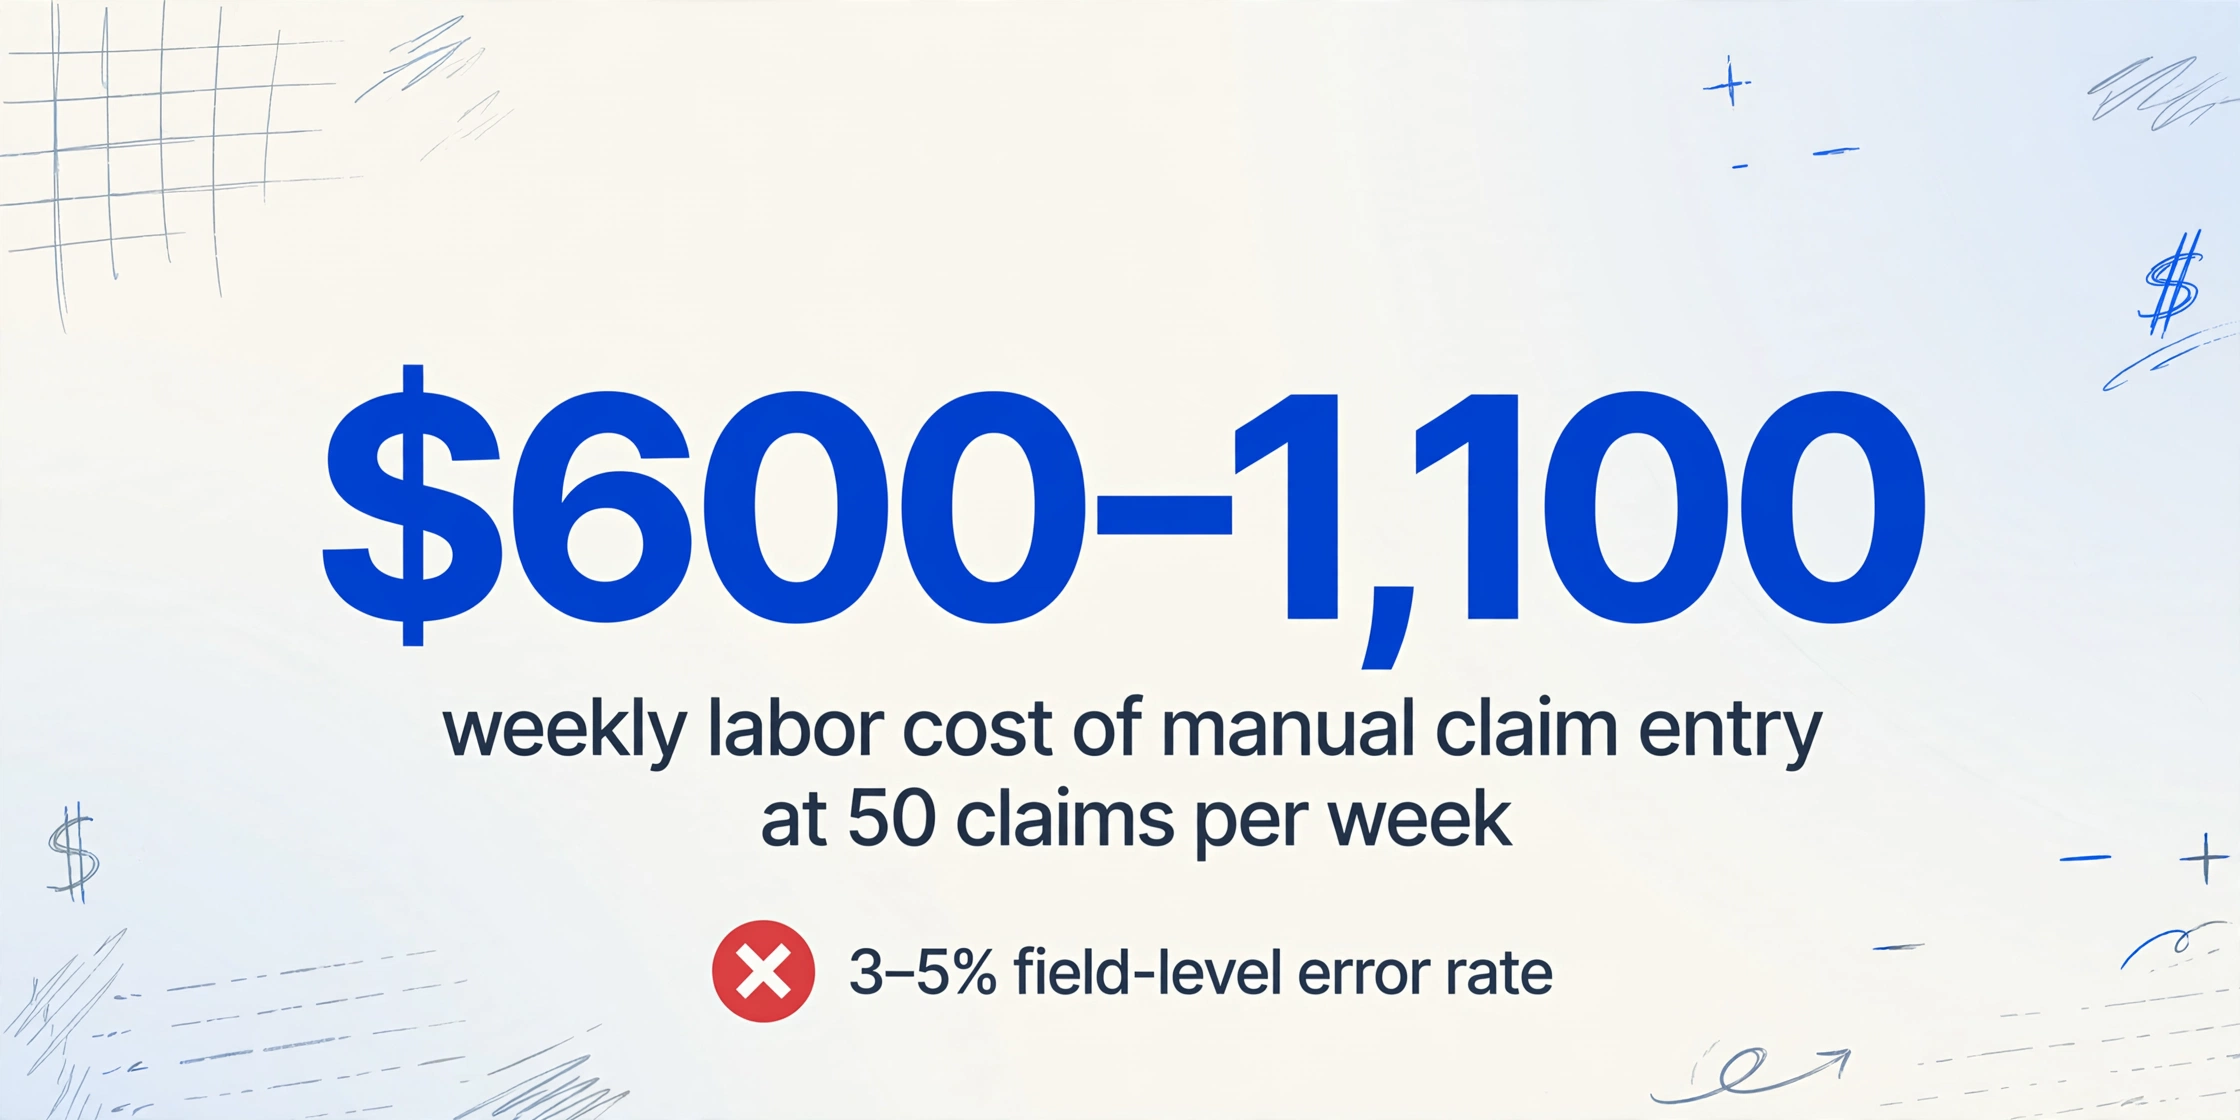
Die sichtbaren Kosten der manuellen Schadendatenerfassung sind eindeutig: Ein Datenerfassungsmitarbeiter oder Sachbearbeiter tippt Feldwerte aus jedem Dokument Zeichen für Zeichen in ein Schadensystem. McKinsey schätzt, dass Automatisierung die Schadenbearbeitungszeit um bis zu 50 % verkürzen und die Kosten des Schadenprozesses um bis zu 30 % senken kann. Doch diese aggregierten Zahlen unterschätzen, was manuelle Bearbeitung einen Betrieb tatsächlich kostet, denn der wahre Aufwand entsteht über vier verschiedene Kanäle, die die meisten Unternehmen in getrennten Budgets erfassen.
Direkter Erfassungsaufwand. Ein Sachbearbeiter oder Schadenmitarbeiter, der ein einzelnes Schadenpaket bearbeitet – ACORD-Formular plus zwei oder drei Belege –, verbringt allein mit der Dateneingabe etwa 20 bis 30 Minuten. Bei 50 Schäden pro Woche sind das 17 bis 25 Stunden reine Tippzeit. Bei Vollkosten von $35–45 pro Stunde für einen erfahrenen Schadenbearbeiter entspricht das $600–1.100 pro Woche an Arbeitsaufwand, der dem Schaden keinerlei Beurteilungswert hinzufügt.
Die Fehlersteuer. Die manuelle Dateneingabe von Versicherungsdokumenten weist eine geschätzte Fehlerquote von 3–5 % auf Feldebene auf. In einem Schadenpaket mit 25–40 extrahierbaren Feldern über das ACORD-Formular und die Anhänge bedeutet das ein bis zwei Fehler pro Schaden. Eine falsch getippte Policennummer verzögert die Anspruchsprüfung. Ein falsches Schadendatum löst einen Rückruf beim Versicherten aus. Ein vertauschter Betrag in der Reparaturschätzung erzeugt eine Rückstellungsabweichung, deren Abgleich Zeit kostet. Branchenbenchmarks legen nahe, dass jeder Dateneingabefehler bei einem Schaden $15–30 zur Korrektur kostet – und diese Kosten vervielfachen sich, wenn Fehler nachgelagert statt bei der Erfassung entdeckt werden.
Die Opportunitätskosten der Sachbearbeiterzeit. Die Forschung von McKinsey zeigt, dass Underwriter und Schadensachbearbeiter 30–40 % ihrer Zeit mit administrativen Aufgaben verbringen, einschließlich Dateneingabe und Dokumentenabruf. Für einen erfahrenen Sachbearbeiter mit 100–150 offenen Schäden bedeutet das 12 bis 20 Stunden pro Woche, die mit Tippen verbracht werden, statt Deckung zu prüfen, Vergleiche auszuhandeln oder komplexe Fälle zu bearbeiten. Die Dollarkosten dieser Zeit entsprechen dem vollen Gehalt des Sachbearbeiters. Die Opportunitätskosten sind die Schadensgeschwindigkeit – und die Kundenzufriedenheit –, die diese Stunden hätten erzeugen können, wären sie auf Beurteilungsarbeit gelenkt worden.
Verzögerte Durchlaufzeit. Jeder manuelle Schritt zwischen Dokumenteingang und Datenverfügbarkeit fügt dem Schadenlebenszyklus Stunden hinzu. In Schadenbetrieben mit hohem Volumen – TPAs, die 200+ Schäden pro Tag bearbeiten, Katastrophenreaktionsteams, die Spitzenvolumina bewältigen – summieren sich diese Stunden zu Tagen. Die Kundenzufriedenheitsstudien von J.D. Power zeigen durchgängig, dass die FNOL-Bearbeitungsgeschwindigkeit einer der stärksten Treiber der Kundenzufriedenheit ist. Jeder zusätzliche Tag manueller Bearbeitung drückt die Kundenerfahrung und erhöht die Wahrscheinlichkeit von Rechtsstreitigkeiten, regulatorischen Beschwerden und Eskalationen.
Die vier Kosten sind additiv, nicht alternativ. Ein Betrieb, der $2.500 pro Monat für direkten Arbeitsaufwand der Schadendatenerfassung ausgibt, verursacht wahrscheinlich einen gleichwertigen Betrag an Fehlerkorrektur, verlorener Sachbearbeiterproduktivität und verzögerter Durchlaufzeit. Die tatsächlichen Kosten der manuellen Schadendatenerfassung sind etwa doppelt so hoch wie der sichtbare Personalposten – und sie verteilen sich über Budgets, in denen kein einzelner Bericht jemals die Gesamtsumme offenlegt.
Was die Extraktion von Versicherungsansprüchen von anderen Dokumenttypen unterscheidet
Die Extraktion von Versicherungsansprüchen teilt technische DNA mit der Extraktion von Rechnungen oder Belegen — dieselben Vision-Language-Modelle, derselbe Ansatz mit benutzerdefinierten Spalten —, doch drei strukturelle Faktoren machen sie zu einem grundlegend schwierigeren Problem.
1. Formatvarianz bei Versicherern und Sparten. Ein ACORD 1 (Property Loss Notice) und ein ACORD 2 (Automobile Loss Notice) sehen unterschiedlich aus, weil sie unterschiedliche Informationen erfassen. Doch dasselbe ACORD 1, ausgefüllt über ein Applied Epic Agenturverwaltungssystem, wird anders dargestellt als eines aus Vertafore AMS360, und dieses wiederum anders als eines, das handschriftlich auf einem Papierformular ausgefüllt wurde. ACORD pflegt über 800 standardisierte Formulartypen. Die rund 39.000 unabhängigen P&C-Agenturen in den Vereinigten Staaten erstellen diese Formulare jeweils mit eigenen Systemkonfigurationen, Druckeinstellungen und Ausfüllgewohnheiten. Vorlagenbasierte Extraktion, die auf festen Feldkoordinaten beruht, versagt in dem Moment, in dem sich ein Layout verschiebt. Semantische Extraktion, die Feldbezeichnungen liest, um Werte zu lokalisieren, bewältigt diese Varianz ohne Konfiguration pro Versicherer. Dieser Unterschied wird ausführlicher behandelt in unserer Erläuterung zu traditioneller OCR versus KI-gesteuerter Extraktion.
2. Das mehrteilige Schadenpaket. Ein Rechnungsextraktionstool verarbeitet eine Rechnung. Ein Workflow zur Schadenextraktion verarbeitet einen Ordner: ein ACORD-Formular, einen Polizeibericht, eine Reparaturkostenschätzung, medizinische Aufnahmeunterlagen, Fotos und manchmal einen Abschleppbeleg oder Mietvertrag. Jeder Dokumenttyp hat seine eigenen Standardfelder, seine eigenen Layoutkonventionen und seine eigenen Extraktionsspaltendefinitionen. Die Herausforderung besteht nicht darin, ein einzelnes Dokument zu extrahieren — sondern alle in einem kohärenten Workflow zu extrahieren, der die Ergebnisse mit demselben Schadendatensatz verknüpft hält.
3. Strukturierte Felder + Freitextnarrativ in einem Dokument. Das ACORD-Formular ist einzigartig darin, beide Modi auf einer einzigen Seite zu verbinden. Der Kopfbereich enthält klar beschriftete Felder mit kurzen Werten, die KI mit hoher Genauigkeit extrahiert. Der Abschnitt Description of Loss ist ein leeres Feld für erzählenden Text — 50 Wörter oder 500, handschriftlich oder getippt, fokussiert oder weitschweifig. Diese beiden Modi existieren im selben Dokument nebeneinander und erfordern grundlegend unterschiedliche Behandlung.
Die strukturierten Felder: Was Sie zuverlässig extrahieren können
Die strukturierten Kopffelder auf ACORD-Formularen sind der Bereich, in dem KI-Extraktion den größten Mehrwert liefert. Diese Felder haben gedruckte Beschriftungen, eingeschränkte Wertebereiche und konsistente semantische Muster — ideale Bedingungen für ein Vision-Language-Modell. Nachfolgend finden Sie die wichtigsten Felder, aufgeschlüsselt nach den vier großen ACORD-FNOL-Formulartypen, die die überwiegende Mehrheit der P&C-Schadenaufnahmen abdecken.
ACORD 1 — Property Loss Notice
| Feld | Format | Realistische Genauigkeit |
|---|---|---|
| Policennummer | Alphanumerisch, 8–15 Zeichen | 95%+ |
| Name & Kontakt des Versicherten | Name + Adresse + Telefon | 95%+ |
| Datum & Uhrzeit des Schadens | Datum + Uhrzeit | 95%+ |
| Schadenort | Adresse oder Kreuzung | 90%+ |
| Schadenart (Kontrollkästchen) | Kontrollkästchen: Feuer/Wind/Hagel/Wasser/Diebstahl | 85–90% |
| NAIC-Versicherercode | 5-stellig, numerisch | 95%+ |
| Geschätzter Schadensbetrag | Währung | 90%+ |
| Selbstbehalt der Police | Währung | 90%+ |
| Hypothekengläubiger / Pfandgläubiger | Name + Adresse | 85%+ |
| Polizeiberichtnummer | Alphanumerisch | 80%+ (oft leer) |
ACORD 2 — Automobile Loss Notice
| Feld | Format | Realistische Genauigkeit |
|---|---|---|
| Policennummer | Alphanumerisch | 95%+ |
| Name & Kontakt des Versicherten | Name + Adresse + Telefon | 95%+ |
| Angaben zu Fahrer / Anspruchsteller | Name + Adresse + Telefon + Führerscheinnr. | 90%+ |
| Fahrzeuginformationen | VIN + Baujahr + Marke + Modell | 85–90% (handschriftliche VIN am schwierigsten) |
| Datum, Uhrzeit & Ort des Schadens | Datum + Uhrzeit + Adresse | 95%+ |
| Unfallart | Kontrollkästchen: Kollision/Diebstahl/Vandalismus | 85%+ |
| Schadensbeschreibung | Kontrollkästchenbereich: Vorne/Hinten/Seite/Dach | 85–90% |
| Geschätzter Schadensbetrag | Währung | 90%+ |
| Angaben zu Zeugen | Name + Telefon | 85%+ |
| Polizeiberichtnummer & Behörde | Alphanumerisch + Name der Dienststelle | 80%+ |
ACORD 3 — Allgemeine Haftpflicht-Schadenmeldung
| Feld | Format | Realistische Genauigkeit |
|---|---|---|
| Police Number | Alphanumerisch | 95%+ |
| Name & Kontakt des Versicherten | Name + Adresse | 95%+ |
| Name & Kontakt des Anspruchstellers | Name + Adresse + Telefon | 90%+ |
| Datum, Uhrzeit & Ort des Vorfalls | Datum + Uhrzeit + Adresse | 95%+ |
| Art des Vorfalls | Kontrollkästchen: Betriebsstätte/Betrieb/Produkt | 85–90% |
| Verletzungsbeschreibung | Kontrollkästchen + Text (Art der Verletzung) | 85%+ |
| Angefallene medizinische Zahlungen | Währung | 90%+ |
| Zeugeninformationen | Name + Telefon | 85%+ |
Das Muster ist über alle drei Formulartypen hinweg konsistent: Beschriftete Felder mit kurzen Werten werden zu 85–95%+ extrahiert, unabhängig davon, ob sie getippt oder handschriftlich ausgefüllt wurden. Die Abweichung ergibt sich aus der Lesbarkeit der Handschrift (eine hastig geschriebene „5", die auf einem VIN als „S" gelesen wird) und der Qualität der Kontrollkästchen-Markierungen (ein leichtes Bleistift-Häkchen, das als nicht angekreuzt gelesen wird), nicht aus der Unfähigkeit der KI, das Feld auf der Seite zu finden. Da die semantische Extraktion Feldbeschriftungen liest und nicht auf feste Koordinaten angewiesen ist, funktioniert dieselbe Spaltendefinition für „Police Number" bei einem ACORD 1 aus dem Portal-PDF eines Versicherers und einem ACORD 2, das am Straßenrand fotografiert wurde — ohne Vorlagen, ohne Konfiguration pro Versicherer.
Die Freitext-Erzählung: Eine andere Strategie
Der Abschnitt „Description of Loss" ist der Teil eines ACORD-Formulars, an dem die KI-Extraktion an eine strukturelle Grenze stößt. Dieser Abschnitt enthält die eigene Schilderung des Anspruchstellers zu den Ereignissen in erzählender Prosa – typischerweise 200 bis 500 Wörter – und folgt keinem extrahierbaren Muster. Eine Beschreibung eines Autounfalls könnte lauten: „Ich stand an der Ampel in der Main Street. Ein Lkw ist mir von hinten aufgefahren." Eine Beschreibung eines Sachschadens: „Gegen 15 Uhr habe ich Wasser auf dem Küchenboden bemerkt. Bin auf den Dachboden gegangen und habe ein geplatztes Rohr gefunden." Dasselbe Kollisionsszenario kann von drei verschiedenen Anspruchstellern auf drei verschiedene Arten beschrieben werden, jeweils mit unterschiedlichen Satzstrukturen, Wortwahlen und Detailtiefen.
Moderne Vision-KI kann den Text dieser Erzählung mit hoher Genauigkeit extrahieren – die handgeschriebenen oder getippten Wörter von der Seite lesen und als Textblock in eine Tabellenzelle übertragen. Dieser Teil funktioniert zuverlässig. Was nicht funktioniert, ist der Schritt, den die meisten Schadensteams sich tatsächlich wünschen: diese Erzählung automatisch in strukturierte Felder wie „Cause of Loss Category", „At-Fault Party" oder „Injury Severity" zu kategorisieren. Sprachmodelle, die diese Klassifizierung versuchen, erzeugen Fehlerraten von 25–30 %, was für jeden nachgelagerten Prozess, der auf ein korrektes Ergebnis angewiesen ist, zu hoch ist.
Der empfohlene Ansatz für den Schadenbetrieb ist, die Erzählung als Rohtext in ein einzelnes Feld zu extrahieren. Der Sachbearbeiter liest dieses Feld – genau so, wie er es vom Papierformular lesen würde –, während die strukturierten Felder (Policennummer, Schadensdatum, Beträge, Fahrzeugdetails) bereits in der Tabelle ausgefüllt sind. Die Zeitersparnis entsteht dadurch, dass diese strukturierten Felder nicht neu eingegeben werden müssen, und nicht dadurch, dass man versucht, die Erzählung in eine Klassifizierung zu zwingen, die sie nicht unterstützt.
Begleitdokumente: Ein Schaden, mehrere Extraktionsstrategien
Ein Schadenpaket besteht in der Praxis selten nur aus dem ACORD-Formular. Begleitdokumente übersteigen das Hauptformular typischerweise im Verhältnis zwei zu eins oder drei zu eins, und jeder Typ erfordert sein eigenes Extraktionsprofil. Hier ist, wie die häufigsten Anhänge der Extraktionsstrategie zugeordnet werden.
Polizeiberichte
Polizeiberichte sind das am häufigsten beigefügte Belegdokument. Sie enthalten wichtige strukturierte Daten — Name und Dienstnummer des ermittelnden Beamten, die Berichtsnummer, Datum und Uhrzeit der Berichtserstellung, die Zuordnung des unfallverursachenden Fahrers, Informationen zu Verwarnungen, Hinweise zu Wetter- und Straßenverhältnissen sowie einen narrativen Abschnitt, der oft wiederholt oder erweitert, was der Anspruchsteller auf dem ACORD-Formular geschrieben hat. Die Extraktionsherausforderung bei Polizeiberichten liegt nicht in der Feldkomplexität, sondern in der Formatvarianz. In den Vereinigten Staaten gibt es rund 18.000 Strafverfolgungsbehörden, die jeweils ihr eigenes Berichtslayout verwenden. Einige nutzen den standardmäßigen NHTSA-Musterbericht für Verkehrsunfälle. Andere verwenden bundesstaatsspezifische Formulare (das California CHP 555, das Texas CR-3). Viele nutzen individuelle Berichtsformate, die von ihrem Records-Management-System generiert werden. Ein vorlagenbasierter Ansatz würde eine separate Vorlage für jede Behörde erfordern. Die semantische Extraktion bewältigt sie alle mit einer einzigen Spaltendefinition, da sie die Beschriftungen auf dem Bericht liest — „Officer Name", „Report Number", „At Fault" — unabhängig davon, wo sie auf der Seite stehen.
Reparaturkostenvoranschläge
Kfz-Reparaturkostenvoranschläge von Karosseriewerkstätten und Immobilienreparaturkostenvoranschläge von Auftragnehmern enthalten positionsbezogene Details, die für die Rückstellungsbildung und Verhandlungen über den Schadensausgleich unerlässlich sind. Zu den wichtigsten extrahierbaren Feldern gehören: Name und Kontakt der Werkstatt oder des Auftragnehmers, Datum des Kostenvoranschlags, Fahrzeug- oder Immobilienkennung, Arbeitsstunden und Stundensatz pro Position, Teilekosten (OEM vs. Nachbau vs. gebraucht), Lackierung und Materialien, Zwischensumme, Steuer und Gesamtbetrag. Reparaturkostenvoranschläge sind am wertvollsten, wenn sie als Tabelle mit einer Zeile pro Position extrahiert werden — so kann der geschätzte Gesamtschaden aus der Summe aller Positionen berechnet werden, anstatt sich auf einen einzelnen handschriftlichen Gesamtbetrag zu verlassen, der bestimmte Kostenkategorien auslassen kann. Der Kostenvoranschlag muss zudem mit dem zugehörigen Schadenfall verknüpft werden, was bedeutet, dass der Extraktionsworkflow die Schaden- oder Policennummer erfassen muss, die auf dem Kostenvoranschlag erscheint, selbst wenn sie handschriftlich am Rand steht.
Medizinische Unterlagen & Aufnahmeformulare
Bei Schadensfällen mit Verletzungen — Verkehrsunfälle, Arbeitsunfälle, Haftpflichtfälle — gelangen medizinische Dokumente schnell in die Schadenakte. Aufnahmeformulare der Notaufnahme, Rettungsdienstprotokolle, Anordnungen für diagnostische Bildgebung und erste Behandlungsnotizen enthalten alle strukturierte Felder (Patientenname, Behandlungsdatum, NPI des Leistungserbringers, Diagnosecodes, Abrechnungscodes), vermischt mit klinischen Notizen. Die Extraktionsstrategie folgt dem ACORD-Ansatz: Extrahieren Sie die strukturierten Felder (Daten, Codes, Identitäten der Leistungserbringer, abgerechnete Beträge) mit Spaltendefinitionen und behalten Sie klinische Notizen als Freitext, damit der Sachbearbeiter oder die Fallmanagerin (Nurse Case Manager) sie prüfen kann.
Fotos
Fotos von Schäden — Fahrzeugkollisionsfotos, Brandschäden, Wassereintritt, beschädigte Ausrüstung — können nicht im herkömmlichen Sinne für strukturierte Daten extrahiert werden. Es gibt keinen „Dollar-Betrag", der aus einem Foto abgelesen werden kann. Computer-Vision-Modelle können jedoch Schadensarten identifizieren und klassifizieren (z. B. „Frontalkollision", „Dachschaden durch Hagel", „Wasserfleck an der Decke"), wenn der Schadenbetrieb einen Anwendungsfall für automatisierte Schadenscodierung hat. Für die meisten Schaden-Teams besteht der praktische Ansatz darin, Fotos als unterstützende Beweise zu behandeln, die das Schadenaufnahmesystem erhält und mit dem Schadendatensatz verknüpft, ohne eine strukturierte Extraktion zu versuchen.
Die zentrale operative Erkenntnis über alle unterstützenden Dokumenttypen hinweg: Jeder erfordert seine eigene Extraktionsspaltendefinition, und der Workflow muss die Ergebnisse aller Dokumente mit demselben Schadendatensatz verknüpft halten. Dies ist kein einzelnes Extraktionsproblem. Es ist eine Familie von Extraktionsproblemen, die um ein Schadenereignis herum organisiert sind.
Herkömmliche Methoden vs. KI-gestützte Extraktion
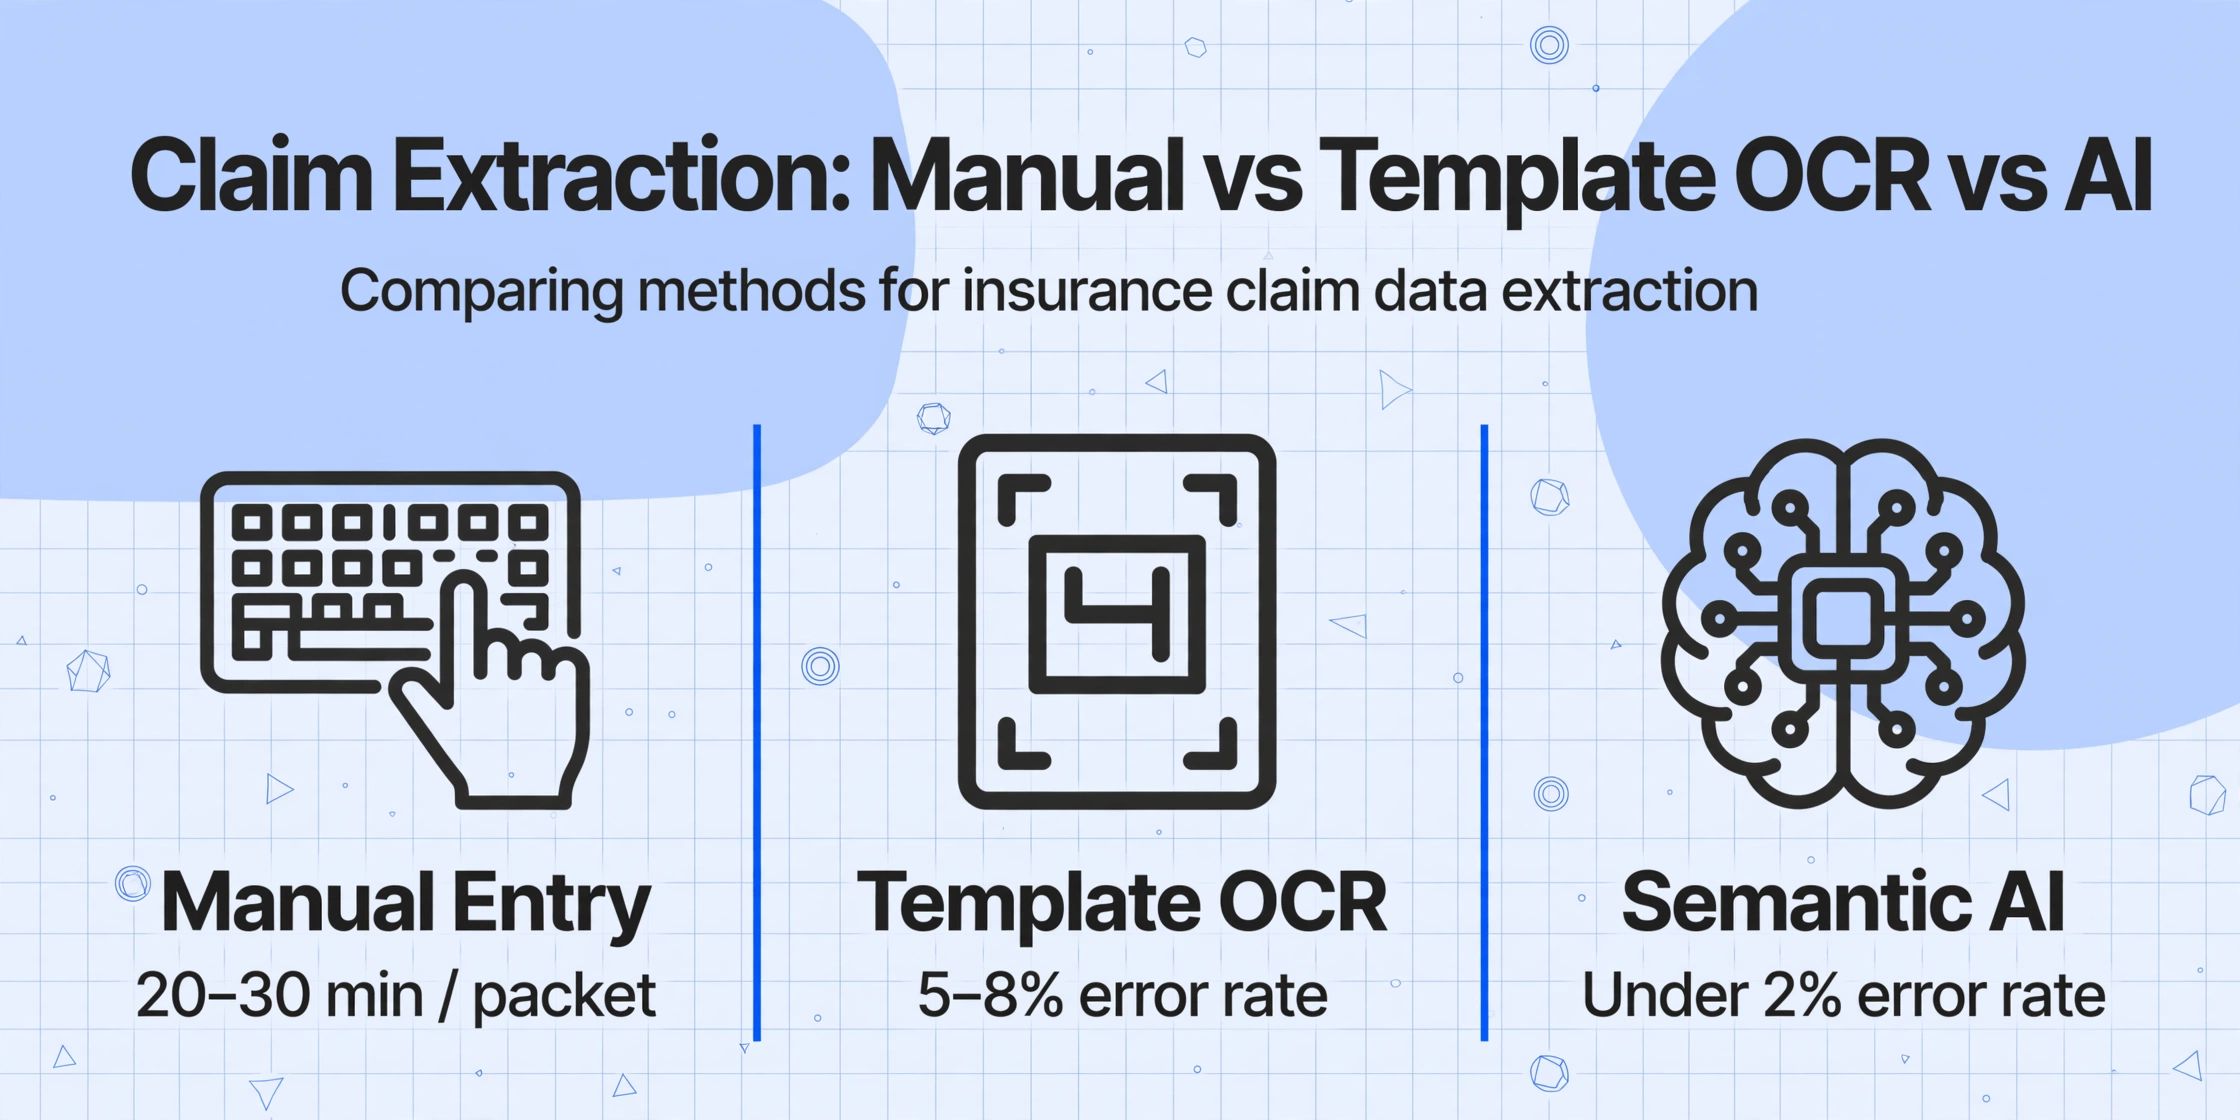
Der konventionelle Ansatz zur Dateneingabe bei Versicherungsschäden hat zwei Varianten: manuelles Tippen und vorlagenbasierte OCR. Beide teilen dieselbe grundlegende Einschränkung — sie behandeln jedes Schadendokument so, als wäre sein Layout vorhersehbar, was es in der realen Schadenaufnahme nicht ist.
| Dimension | Manuelle Eingabe | Vorlagen-OCR | Semantische KI-Extraktion |
|---|---|---|---|
| Einrichtung pro Versicherer-Formulartyp | Keine (Mensch passt sich an) | Vorlage pro Formular × Agentursystem-Kombination | Null — eine Spaltendefinition pro Feld |
| Gemischter Versicherer-Batch | Sequenziell, eins nach dem anderen | Nur Formulare mit gleichem Layout | Gemischte Versicherer, gemischte Formulartypen |
| Begleitdokumente | Liest jeden Dokumenttyp separat | Vorlage pro Dokumenttyp × Layout | Ein Spaltensatz pro Dokumenttyp |
| Handschrift in strukturierten Feldern | Liest die meiste Handschrift | Scheitert an den meisten Handschriften | 85–95% bei strukturierten Feldern |
| Widerstandsfähigkeit bei Formatänderungen | N/A — Mensch passt sich an | Bricht, bis die Vorlage aktualisiert wird | Verarbeitet neue Layouts automatisch |
| Zeit pro Schadenpaket | 20–30 Min. | 5–10 Min. (wenn Vorlagen existieren) | 5–10 Sekunden |
| Fehlerrate auf Feldebene (strukturiert) | 3–5% | 5–8% bei Nicht-Vorlagen-Formaten | Unter 2% bei beschrifteten Feldern |
Der semantische KI-Ansatz — Vorlagenfreie Dokumentenextraktion — ist für Schadenfälle wichtiger als für jede andere Dokumentenkategorie, und zwar wegen der enormen Formatvarianz bei der realen Schadenaufnahme. Ein ACORD 2, der als sauberes PDF von einem Versichererportal eingeht, und dasselbe Formular als gefaxte Kopie mit handschriftlichen Feldern am Rand sind derselbe Dokumenttyp, der dieselben Spalten erfordert, aber ein vorlagenbasiertes System bräuchte zwei Konfigurationen. Ein semantisches System bewältigt beides mit einer.
Batch-Verarbeitung gemischter Schadenformulare verschiedener Versicherer
Der praktische Workflow für Schaden-Teams, die 50–200 Schäden pro Tag bearbeiten, ist die Batch-Verarbeitung — einen Ordner mit Schadenpaketen hochladen, die strukturierten Felder aus jedem Bestandteil-Dokument extrahieren und alles in eine einheitliche Tabelle exportieren, mit einer Schadennummer als Schlüssel, der die Zeilen der einzelnen Dokumenttypen verknüpft.
Ein typischer Batch-Workflow sieht so aus:
Batch-First-Verarbeitung ist für den Schadenbetrieb keine nachträgliche Überlegung. Sie ist der einzige Workflow, der skaliert, wenn ein TPA Schäden von 50 verschiedenen Versicherern bearbeitet, von denen jeder eine andere ACORD-Darstellung verwendet und Belegdokumente über ein Dutzend verschiedener Eingangskanäle eintreffen.
So wählen Sie ein Tool zur Schadenextraktion aus
Nicht jedes Extraktionstool eignet sich für Versicherungsschäden. Die Dokumentvielfalt – strukturierte Formulare, Freitextberichte, Anhänge aus mehreren Quellen – erfordert spezifische Fähigkeiten, die universelle OCR-Tools möglicherweise nicht bieten. Hier sind die Kriterien, die speziell für den Schadenbetrieb wichtig sind.
Ohne Vorlage oder vorlagenbasiert. Dies ist die folgenreichste Entscheidung. Wenn das Tool das Erstellen und Pflegen von Vorlagen pro Versicherer, pro Formulartyp und pro Eingangskanal erfordert, wird es die Formatvielfalt der realen Schadenannahme nicht überstehen. Ein Ansatz ohne Vorlage – bei dem Spaltendefinitionen über Formulartypen, Versicherer und Layouts hinweg funktionieren – beseitigt den Konfigurationsaufwand, der dazu führt, dass Schadenautomatisierungs-Piloten nach der Proof-of-Concept-Phase ins Stocken geraten.
Unterstützung mehrerer Dokumenttypen. Das Tool muss ACORD-Formulare, Polizeiberichte, Reparaturkostenvoranschläge und medizinische Unterlagen als eigenständige Dokumenttypen mit separaten Spaltendefinitionen behandeln – nicht alles als „ein Dokument“ betrachten.
Handschrifterkennung. Ein erheblicher Prozentsatz der Schadenformulare wird handschriftlich ausgefüllt – am Straßenrand, im Krankenhaus, auf einem Klemmbrett. Wenn die Handschriftgenauigkeit des Tools bei strukturierten Feldern unter 85 % liegt, bricht die Automatisierung strukturierter Felder zusammen, weil zu viele Ausgaben korrigiert werden müssen.
Batch-Export in Tabellenkalkulation oder Schadensystem. Die Ausgabe sollte eine strukturierte Datei (Excel, CSV) sein, die ohne manuelle Neuformatierung in Guidewire ClaimCenter, Duck Creek Claims oder jede andere Schadenmanagement-Plattform geladen werden kann.
Keine Trainingsanforderung. Schadenteams haben nicht das Volumen, um benutzerdefinierte Modelle zu trainieren. Ein Tool, das 10–50 Beispieldokumente pro Formulartyp benötigt, um Ihre Schadenformate zu „erlernen“, passt nicht zum Anwendungsfall der Versicherungsannahme, bei dem regelmäßig neue Versichererformate und Variationen von Begleitdokumenten auftreten.
Häufig gestellte Fragen
Welche Dokumenttypen sind in der Extraktion von Versicherungsschadendaten enthalten?
Die Schadenextraktion deckt das vollständige Schadenpaket ab: ACORD-Schadenmeldungsformulare (ACORD 1 für Sachschäden, ACORD 2 für Kfz, ACORD 3 für allgemeine Haftung, ACORD 4 für Arbeitsunfälle), Polizeiberichte, Kfz- und Sachschadengutachten, medizinische Aufnahmeunterlagen und Rechnungen sowie begleitende Korrespondenz. Jeder Dokumenttyp erfordert eine eigene Definition der Extraktionsspalten, aber alle Ausgaben werden über die Schaden- oder Policennummer für eine konsolidierte Verarbeitung verknüpft.
Wie genau ist die KI-Extraktion bei Versicherungsschadenformularen im Vergleich zur manuellen Eingabe?
Bei den strukturierten Kopffeldern – Policennummer, Name des Versicherten, Datum und Ort des Schadens, Beträge – erreicht die KI-Extraktion eine Genauigkeit von 90–95 %+, was messbar besser ist als die feldbezogene Fehlerquote von 3–5 % bei der manuellen Dateneingabe. Die verbleibenden Fehler konzentrieren sich auf bestimmte Feldtypen (handschriftliche VINs, teilweise gesetzte Kontrollkästchen) und sind so vorhersehbar, dass sich darauf ein gezielter Stichproben-Workflow aufbauen lässt. Manuelle Fehler sind dagegen zufällig – jedes Feld kann aus jedem Grund falsch sein –, was sie ohne vollständiges erneutes Lesen jedes Dokuments schwerer zu erkennen macht.
Kann KI die narrative Schadenbeschreibung aus einem Schadenformular extrahieren?
Sie kann den Text der Schilderung mit hoher Genauigkeit extrahieren – handschriftliche oder getippte Wörter lesen und sie als Textblock in einer Tabellenkalkulationszelle wiedergeben. Sie kann diese Schilderung jedoch nicht zuverlässig in strukturierte Felder wie „Schadensursache" oder „Haftende Partei" einordnen. Sprachmodelle, die eine Klassifizierung der Schilderung versuchen, erzeugen eine Fehlerquote von 25–30 %, die die Ausgabe für Deckungs- oder Haftungsentscheidungen unbrauchbar macht. Der empfohlene Workflow besteht darin, die Schilderung als Rohtext zu extrahieren und den Sachbearbeiter sie direkt lesen zu lassen, während die strukturierten Felder – die den Großteil des Dateneingabeaufwands ausmachen – automatisiert werden.
Funktioniert die KI-Extraktion bei Polizeiberichten aus verschiedenen Rechtsordnungen?
Ja — und hier hat die Extraktion ohne Vorlage einen entscheidenden Vorteil gegenüber herkömmlicher OCR. In den Vereinigten Staaten gibt es rund 18.000 Strafverfolgungsbehörden, die jeweils ein anderes Berichtsformat verwenden. Vorlagenbasierte OCR würde eine separate Vorlage pro Behörde erfordern. Die semantische Extraktion liest die Feldbezeichnungen auf jedem Bericht — „Officer Name“, „Report Number“, „At-Fault Driver“ —, um Werte zu finden, sodass eine Spaltendefinition alle Behördenformate abdeckt. Dasselbe Prinzip gilt für Reparaturkostenschätzungen, die je nach Schätzsoftware (CCC, Mitchell, Audatex) variieren.
Wie gut verarbeitet die KI handschriftliche Schadenformulare?
Bei strukturierten Feldern mit klaren Feldbezeichnungen erreichen handschriftliche Schadenformulare eine Genauigkeit von 85–90 % für die meisten Handschriftqualitäten. Der häufigste Fehlermodus sind einzelne Zeichenfehllesungen — eine handschriftliche „5“, die als „S“ gelesen wird, eine „0“ als „O“ — und nicht ganze Feldfehler. Schadenformulare, die unter widrigen Bedingungen ausgefüllt wurden (am Straßenrand nach einem Unfall, in einem schlecht beleuchteten Raum), weisen tendenziell eine hastigere Handschrift auf, was die Genauigkeit an das untere Ende dieser Spanne drückt. Ein praktischer Schadenbearbeitungsworkflow umfasst einen Validierungsschritt von 1–2 Minuten, um die 2–3 kritischsten Felder auf jedem Schadenformular stichprobenartig zu prüfen.
Können extrahierte Schadendaten direkt in Guidewire oder Duck Creek exportiert werden?
Ja. Die Extraktionsausgabe ist eine strukturierte Datei — Excel, CSV oder JSON —, die in jedes Schadenmanagementsystem importiert werden kann, das Batch-Daten-Uploads akzeptiert. Die Spaltenüberschriften entsprechen den Feldnamen, die Sie bei der Einrichtung der Extraktion definiert haben, sodass die Daten in den richtigen Systemfeldern landen. Für Teams mit hohem Volumen kann der Batch-Export auch so konfiguriert werden, dass separate Tabellenblätter oder Dateien für jeden Dokumenttyp (ACORD-Felder, Polizeibericht-Felder, Schätzfelder) erstellt werden, die über die Schaden- oder Policennummer verknüpft sind.
Funktioniert das auch für Arbeitsunfall-Schadenformulare?
Ja. FNOL-Formulare für Arbeitsunfälle haben dieselbe Struktur wie andere ACORD-basierte Schadenmeldungen: eine Reihe beschrifteter Kopffelder (Arbeitgebername, Name des Arbeitnehmers, Verletzungsdatum, Art der Verletzung, Körperteil, behandelnder Arzt) plus eine narrative Beschreibung des Unfalls. Die strukturierten Felder werden mit derselben Genauigkeit extrahiert wie bei Sach- und Kfz-Schäden. Arbeitsunfallmeldungen erzeugen zudem zusätzliche Begleitdokumente — ärztlicher Erstbericht, Wiedereingliederungsformulare, Lohnnachweise —, die jeweils mit einem eigenen Satz von Extraktionsspalten verarbeitet werden können.
Kann KI Daten aus Fotos von Fahrzeugschäden extrahieren?
Keine strukturierten Daten im herkömmlichen Sinn. Computer-Vision-Modelle können Schadensarten klassifizieren (Frontalkollision, Hagelschaden, Brandschaden) und Schweregradbereiche schätzen, aber sie können aus einem Foto allein keinen Dollarbetrag oder eine Teileliste ausgeben. Fotos werden am besten als unterstützende Belege behandelt, die mit dem Schadendatensatz verknüpft sind, während strukturierte Kostenvoranschläge von Werkstätten oder Auftragnehmern die Daten liefern, die in finanzielle Rückstellungen und Schadenregulierungsberechnungen einfließen.
Wie viele Schadenformulare können in einem einzigen Batch verarbeitet werden?
Es gibt keine praktische Obergrenze für die Batch-Größe bei der KI-Extraktion. Schadenteams verarbeiten routinemäßig 100–200 Schadenpakete in einem einzigen Batch — gemischte ACORD-Formulare von mehreren Versicherern, Polizeiberichte von verschiedenen Behörden und Reparaturkostenvoranschläge von verschiedenen Werkstätten. Die Verarbeitungszeit skaliert linear mit der Dokumentenanzahl und beträgt durchschnittlich 5–10 Sekunden pro Dokument, unabhängig von Format oder Versicherer. Für höhere Volumina unterstützt der Batch-Workflow die gleichzeitige Verarbeitung über Team-Pläne.
Wie beginne ich mit dem Testen der KI-Extraktion an meinen eigenen Schadenformularen?
Laden Sie ein gescanntes ACORD-Formular hoch — Sach-, Kfz- oder allgemeine Haftpflicht — oder ein Foto eines ausgefüllten Schadenformulars. Für den ersten Test ist keine Registrierung erforderlich. Definieren Sie die Spalten, die Ihr Schadensystem benötigt: Police Number, Date of Loss, Insured Name, Location of Loss, Estimated Amount, Kind of Loss. Sehen Sie die Extraktionsergebnisse in Sekunden. Eine vollständige Anleitung zur Batch-Verarbeitung über mehrere Versichererformulare und Begleitdokumente hinweg finden Sie in unseren Schritt-für-Schritt-Anleitungen für bestimmte Schadendokumenttypen.
Der Vorteil der semantischen Extraktion für Ansprüche liegt darin, dass sie sich an die Formatvielfalt anpasst, die Sie bereits manuell bewältigen — ohne dass Sie Vorlagen für jeden Träger, jeden Formulartyp oder jeden Eingangskanal erstellen müssen. Die strukturierten Felder auf ACORD-Formularen, Polizeiberichten und Reparaturkostenvoranschlägen sind dieselben Felder, unabhängig davon, ob das Dokument als Portal-PDF, gefaxte Kopie oder Smartphone-Foto eingeht. Definieren Sie Ihre Spalten einmal, und die KI findet die Werte, wo auch immer die Bezeichnungen erscheinen.
Testen Sie es mit Ihren eigenen Anspruchsdokumenten