Guide complet de l'
extraction de données de sinistres d'assurance (2026)
Un seul sinistre d'accident automobile génère un formulaire ACORD 2 du demandeur, un rapport de police de l'agence concernée, un devis de réparation du carrossier, des formulaires médicaux d'admission en cas de blessures, et des photos provenant de trois smartphones. Chaque document arrive dans un format différent, d'une source différente, avec une mise en page différente — et l'expert en sinistres doit relier les données structurées de tous ces documents au même dossier de sinistre. C'est là le véritable défi de l'extraction de données de sinistres d'assurance, et ce n'est pas un défi que la plupart des outils d'extraction ont été conçus pour relever.
Points clés à retenir
- Un expert en sinistres consacre 17 à 25 heures par semaine à la saisie de données — à 35-45 $ de l'heure — avant même d'aborder l'analyse de couverture, la négociation du règlement ou l'enquête pour lesquels son expertise est rémunérée.
- Le coût de main-d'œuvre visible ne représente que la moitié de l'histoire : la correction des erreurs, la perte de productivité des experts et l'allongement des délais de traitement relèvent de budgets distincts où aucun rapport unique ne révèle que le traitement manuel des sinistres coûte environ le double de ce qu'indique la ligne de paie.
- Une définition de colonne réutilisable par type de document — formulaires ACORD, rapports de police, devis de réparation — extrait les champs structurés de chaque document du lot, et l'expert ne vérifie que les exceptions signalées par le score de confiance.
Qu'est-ce que l'extraction de données de réclamation d'assurance ?
L'extraction de données de réclamation d'assurance est le processus automatisé de lecture des champs clés des documents liés aux réclamations — avis de sinistre ACORD, rapports de police, devis de réparation, dossiers médicaux et autres pièces justificatives — et de leur conversion en données structurées qu'un tableur, un système de gestion des réclamations ou une plateforme d'analyse peut ingérer. Contrairement à l'extraction standard de factures ou de reçus, qui cible un seul type de document, l'extraction de réclamations doit traiter un dossier multi-documents où chaque composant a son propre format, ses propres champs clés et ses propres exigences d'extraction.
La portée va au-delà du premier avis de sinistre. Une stratégie complète d'extraction de réclamations couvre chaque document qui entre dans le dossier de réclamation, de la prise en charge au règlement : le formulaire ACORD initial (qu'il s'agisse d'automobile, de biens, de responsabilité civile générale ou d'indemnisation des travailleurs), les pièces justificatives qui étayent la perte, ainsi que la correspondance et les documents de facturation qui s'accumulent au fur et à mesure que la réclamation progresse. Pour une ventilation détaillée au niveau des champs de ce que l'IA peut et ne peut pas extraire des formulaires ACORD initiaux spécifiquement, consultez notre article complémentaire sur L'IA peut-elle lire les formulaires FNOL de réclamation d'assurance ?
Ce qui distingue cette catégorie des autres tâches d'extraction de documents, c'est la structure en couches d'un dossier de réclamation. Les champs d'en-tête structurés du formulaire ACORD — numéro de police, date du sinistre, nom de l'assuré, lieu de la perte — suivent un modèle prévisible et s'extraient de manière fiable. Le texte libre du récit dans la section Description de la perte ne l'est pas. Les documents justificatifs — un rapport de police d'une juridiction, un devis de réparation d'un système logiciel différent, des dossiers médicaux d'un tiers — nécessitent chacun une stratégie d'extraction distincte. Une approche complète tient compte des trois couches, pas seulement de la plus pratique.
Pourquoi la saisie manuelle des données de sinistres coûte plus cher qu'il n'y paraît
Le coût visible de la saisie manuelle des données de sinistres est simple : un employé de saisie ou un gestionnaire de sinistres qui tape les valeurs des champs de chaque document dans un système de gestion des sinistres, caractère par caractère. McKinsey estime que l'automatisation peut réduire les délais de traitement des sinistres jusqu'à 50 % et diminuer les coûts du parcours de sinistre jusqu'à 30 %. Mais ces chiffres agrégés sous-estiment ce que le traitement manuel coûte réellement à une opération, car la dépense réelle arrive par quatre canaux distincts que la plupart des entreprises suivent dans des budgets séparés.
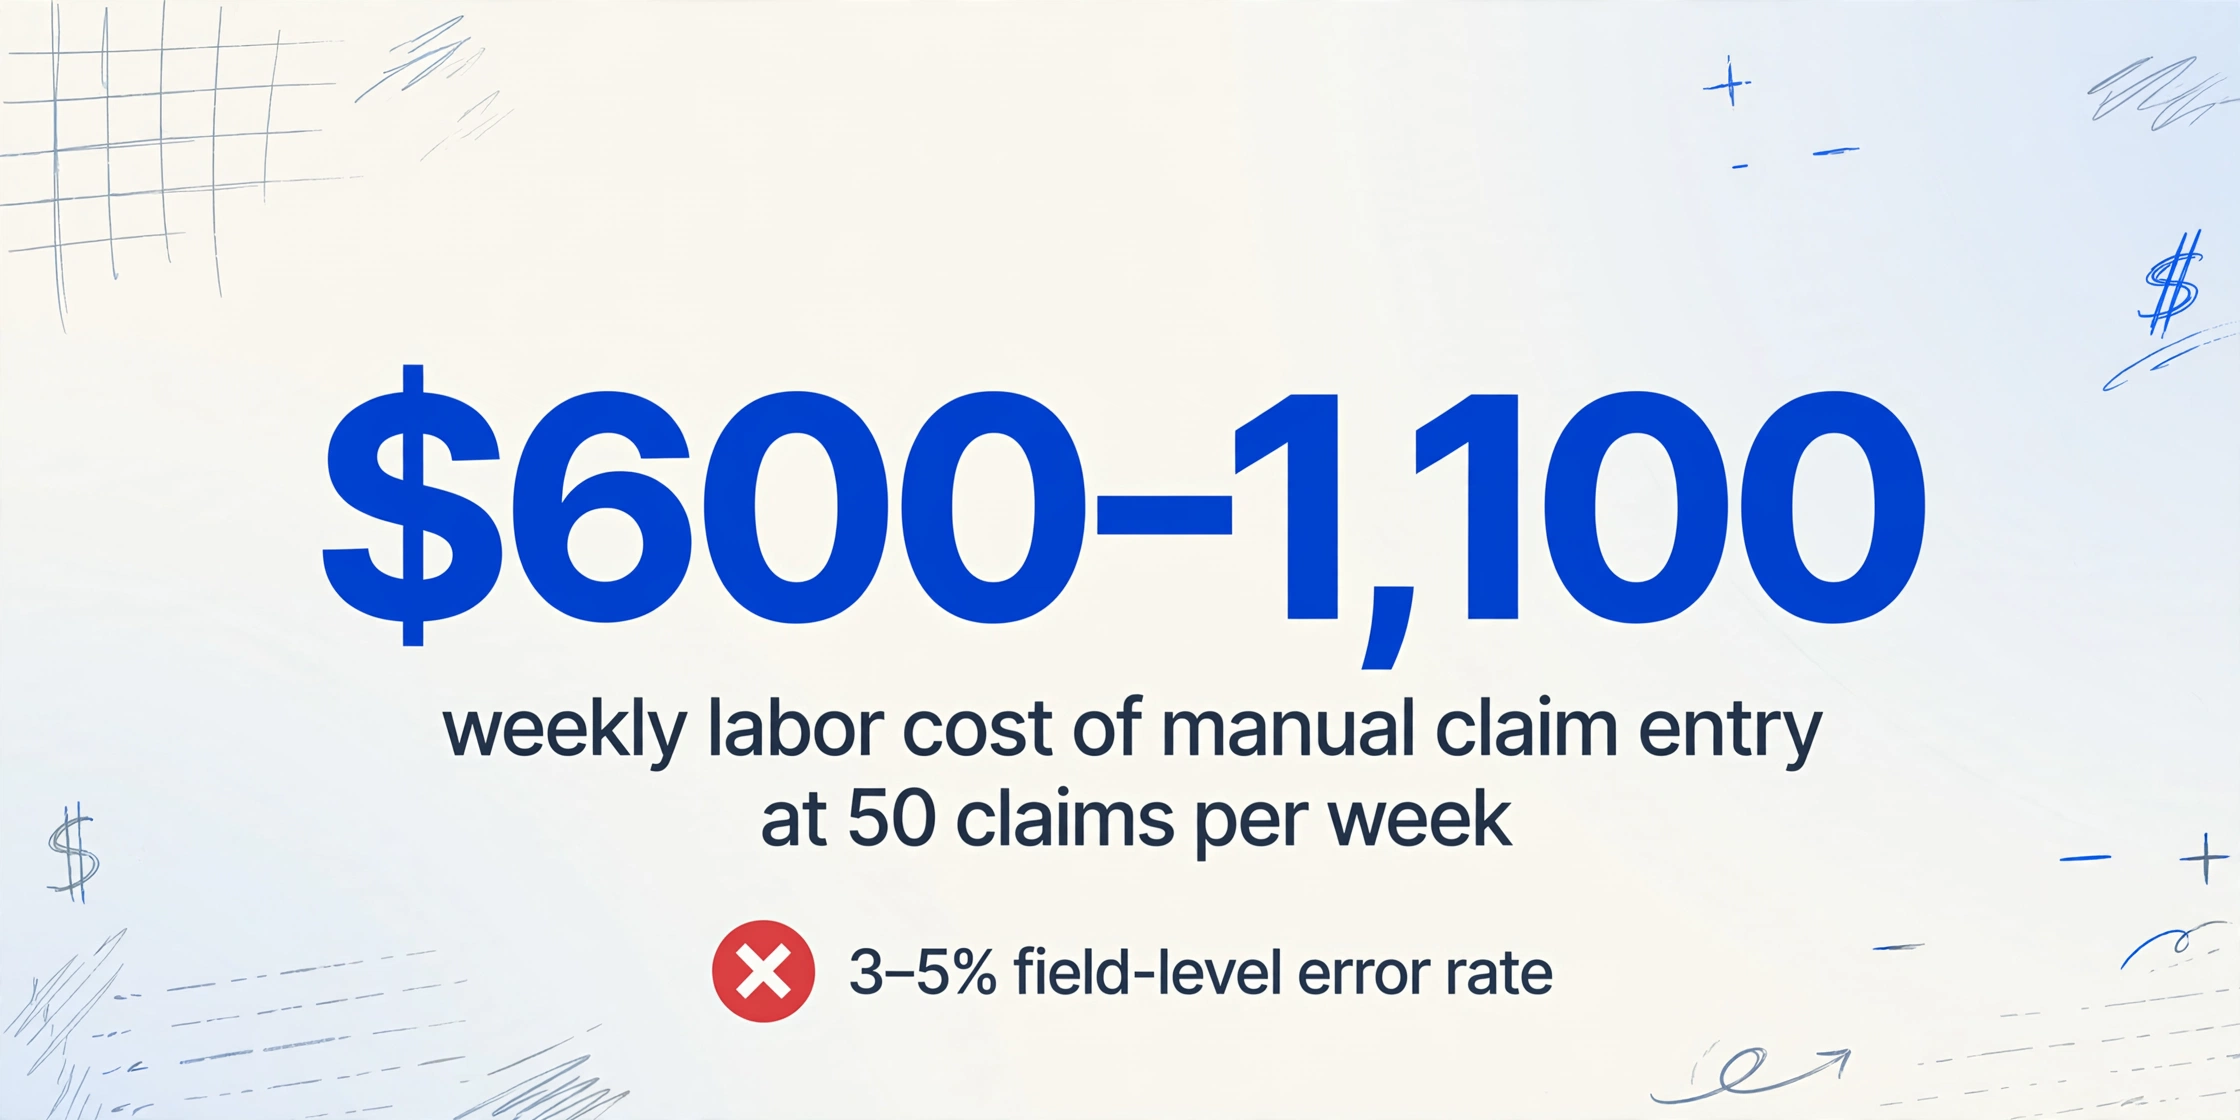
Travail de transcription direct. Un gestionnaire de sinistres ou un employé de saisie traitant un seul dossier de sinistre — formulaire ACORD plus deux ou trois documents justificatifs — consacre environ 20 à 30 minutes à la seule saisie des données. À raison de 50 sinistres par semaine, cela représente 17 à 25 heures de pure frappe. À un coût chargé de 35 à 45 $ de l'heure pour un gestionnaire de sinistres expérimenté, cela se traduit par 600 à 1 100 $ par semaine en main-d'œuvre qui n'apporte aucune valeur de jugement au sinistre.
La taxe sur les erreurs. La saisie manuelle des données des documents d'assurance comporte un taux d'erreur estimé de 3 à 5 % au niveau des champs. Dans un dossier de sinistre comptant 25 à 40 champs extractibles sur le formulaire ACORD et les pièces jointes, cela signifie une à deux erreurs par sinistre. Un numéro de police mal saisi retarde la vérification d'éligibilité. Une mauvaise date de sinistre déclenche un appel de suivi à l'assuré. Un montant transposé dans le devis de réparation crée un écart de réserve qui prend du temps à réconcilier. Les références du secteur suggèrent que chaque erreur de saisie sur un sinistre coûte 15 à 30 $ à corriger — et ces coûts se cumulent lorsque les erreurs sont découvertes en aval plutôt qu'à la réception.
Le coût d'opportunité du temps des gestionnaires de sinistres. Les recherches de McKinsey montrent que les souscripteurs et les gestionnaires de sinistres consacrent 30 à 40 % de leur temps à des tâches administratives, y compris la saisie de données et la récupération de documents. Pour un gestionnaire senior traitant 100 à 150 sinistres ouverts, cela représente 12 à 20 heures par semaine passées à taper au lieu d'enquêter sur la couverture, de négocier les règlements ou de gérer les dossiers complexes. Le coût en dollars de ce temps est le salaire complet du gestionnaire. Le coût d'opportunité est la vélocité des sinistres — et la satisfaction client — que ces heures auraient pu produire si elles avaient été redirigées vers un travail de jugement.
Délai de cycle prolongé. Chaque étape manuelle entre la réception du document et la disponibilité des données ajoute des heures au cycle de vie du sinistre. Dans les opérations de sinistres à volume élevé — les TPA traitant plus de 200 sinistres par jour, les équipes de réponse aux catastrophes gérant des volumes de pointe — ces heures s'accumulent en jours. Les études de satisfaction des sinistres de J.D. Power montrent constamment que la vitesse de traitement FNOL est l'un des moteurs les plus forts de la satisfaction client. Chaque jour supplémentaire de traitement manuel pèse sur l'expérience client et augmente la probabilité de litiges, de plaintes réglementaires et d'escalade.
Les quatre coûts sont additifs, pas alternatifs. Une opération dépensant 2 500 $ par mois en main-d'œuvre directe de saisie des données de sinistres encourt probablement un montant équivalent en correction d'erreurs, en perte de productivité des gestionnaires et en délais de cycle prolongés. Le coût réel de la saisie manuelle des données de sinistres est environ le double de la ligne budgétaire de main-d'œuvre visible — et il est réparti entre des budgets où aucun rapport unique ne révèle jamais le total.
Ce qui rend l'extraction de réclamations d'assurance différente des autres types de documents
L'extraction de réclamations d'assurance partage l'ADN technique de l'extraction de factures ou de reçus — les mêmes modèles vision-langage, la même approche de colonnes personnalisées — mais trois facteurs structurels en font un problème fondamentalement plus difficile.
1. Variation des formats selon les assureurs et les branches d'activité. Un ACORD 1 (avis de perte de biens) et un ACORD 2 (avis de perte automobile) se présentent différemment car ils collectent des informations différentes. Mais le même ACORD 1 rempli via un système de gestion d'agence Applied Epic s'affiche différemment de celui issu de Vertafore AMS360, qui s'affiche encore différemment de celui rempli à la main sur un formulaire papier. ACORD maintient plus de 800 types de formulaires standardisés. Les quelque 39 000 agences P&C indépendantes aux États-Unis produisent chacune ces formulaires avec leurs propres configurations système, paramètres d'impression et habitudes de saisie. L'extraction basée sur des modèles, qui repose sur des coordonnées de champs fixes, échoue dès qu'une mise en page change. L'extraction sémantique, qui lit les étiquettes de champs pour localiser les valeurs, gère cette variation sans configuration par assureur. Nous avons abordé cette différence plus en détail dans notre explication sur l'OCR traditionnel par rapport à l'extraction pilotée par IA.
2. Le dossier de réclamation multi-documents. Un outil d'extraction de factures traite une seule facture. Un flux de travail d'extraction de réclamations traite un dossier : un formulaire ACORD, un rapport de police, une estimation de réparation, des dossiers médicaux d'admission, des photos, et parfois un reçu de remorquage ou un contrat de location. Chaque type de document a ses propres champs standard, ses propres conventions de mise en page et ses propres définitions de colonnes d'extraction. Le défi n'est pas d'extraire un seul document — c'est de tous les extraire dans un flux de travail cohérent qui maintient les sorties liées au même dossier de réclamation.
3. Champs structurés + récit en texte libre dans un même document. Le formulaire ACORD est unique en ce qu'il combine les deux modes sur une seule page. L'en-tête contient des champs clairement étiquetés et à valeur courte que l'IA extrait avec une grande précision. La section Description de la perte est une zone vide pour un récit en prose — 50 mots ou 500, manuscrit ou tapé, ciblé ou décousu. Ces deux modes coexistent dans le même document et nécessitent un traitement fondamentalement différent.
Les champs structurés : ce que vous pouvez extraire de manière fiable
Les champs d'en-tête structurés des formulaires ACORD sont là où l'extraction par IA apporte le plus de valeur. Ces champs comportent des étiquettes imprimées, des espaces de valeurs contraints et des schémas sémantiques cohérents — les conditions idéales pour un modèle vision-langage. Voici les principaux champs répartis selon les quatre grands types de formulaires ACORD FNOL qui couvrent la grande majorité de la saisie des sinistres P&C.
ACORD 1 — Avis de sinistre immobilier
| Champ | Format | Précision réaliste |
|---|---|---|
| Numéro de police | Alphanumérique, 8–15 caractères | 95 %+ |
| Nom de l'assuré et coordonnées | Nom + adresse + téléphone | 95 %+ |
| Date et heure du sinistre | Date + heure | 95 %+ |
| Lieu du sinistre | Adresse ou intersection | 90 %+ |
| Nature du sinistre (cases à cocher) | Case à cocher : Incendie/Vent/Grêle/Eau/Vol | 85–90 % |
| Code transporteur NAIC | Numérique à 5 chiffres | 95 %+ |
| Montant estimé du sinistre | Devise | 90 %+ |
| Franchise de la police | Devise | 90 %+ |
| Créancier hypothécaire / Titulaire de privilège | Nom + adresse | 85 %+ |
| Numéro de rapport de police | Alphanumérique | 80 %+ (souvent vide) |
ACORD 2 — Avis de perte automobile
| Champ | Format | Précision réaliste |
|---|---|---|
| Numéro de police | Alphanumérique | 95 % et plus |
| Nom de l'assuré et coordonnées | Nom + adresse + téléphone | 95 % et plus |
| Informations sur le conducteur / le demandeur | Nom + adresse + téléphone + n° de permis | 90 % et plus |
| Informations sur le véhicule | VIN + année + marque + modèle | 85–90 % (VIN manuscrit le plus difficile) |
| Date, heure et lieu de la perte | Date + heure + adresse | 95 % et plus |
| Type d'accident | Case à cocher : Collision/Vol/Vandalisme | 85 % et plus |
| Description des dommages | Zone de cases à cocher : Avant/Arrière/Côté/Dessus | 85–90 % |
| Montant estimé des dommages | Devise | 90 % et plus |
| Informations sur les témoins | Nom + téléphone | 85 % et plus |
| Numéro de rapport de police et service | Alphanumérique + nom du service | 80 % et plus |
ACORD 3 — Avis de sinistre en responsabilité civile générale
| Champ | Format | Précision réaliste |
|---|---|---|
| Numéro de police | Alphanumérique | 95 % et plus |
| Nom et coordonnées de l'assuré | Nom + adresse | 95 % et plus |
| Nom et coordonnées du demandeur | Nom + adresse + téléphone | 90 % et plus |
| Date, heure et lieu de l'événement | Date + heure + adresse | 95 % et plus |
| Type d'événement | Case à cocher : Locaux/Opérations/Produit | 85–90 % |
| Description de la blessure | Case à cocher + texte (nature de la blessure) | 85 % et plus |
| Frais médicaux engagés | Devise | 90 % et plus |
| Informations sur les témoins | Nom + téléphone | 85 % et plus |
Le schéma est cohérent pour les trois types de formulaires : les champs étiquetés avec des valeurs courtes sont extraits à 85–95 % et plus, qu'ils soient tapés ou manuscrits. La variance provient de la lisibilité de l'écriture (un « 5 » écrit rapidement lu comme un « S » sur un VIN) et de la qualité des marques de cases à cocher (une coche légère au crayon lue comme non cochée), et non de l'incapacité de l'IA à localiser le champ sur la page. Comme l'extraction sémantique lit les étiquettes de champs plutôt que de s'appuyer sur des coordonnées fixes, la même définition de colonne pour « Numéro de police » fonctionne sur un ACORD 1 provenant d'un PDF du portail d'un assureur et sur un ACORD 2 photographié au bord de la route — sans modèle, sans configuration par assureur.
Le récit en texte libre : une stratégie différente
La section Description de la perte est la partie d'un formulaire ACORD où l'extraction par IA atteint une limite structurelle. Cette section contient le récit personnel du sinistre par le demandeur, rédigé en prose narrative — généralement de 200 à 500 mots — et ne suit aucun modèle extractible. Une description d'accident automobile pourrait dire : « J'étais arrêté au feu sur Main Street. Un camion m'a percuté par derrière. » Une description de perte matérielle : « J'ai remarqué de l'eau sur le sol de la cuisine vers 15 h. Je suis monté au grenier et j'ai trouvé un tuyau percé. » Le même scénario de collision peut être décrit de trois manières différentes par trois demandeurs différents, chacun avec des structures de phrases, des choix de mots et des niveaux de détail différents.
L'IA de vision moderne peut extraire le texte de ce récit avec une grande précision — en lisant les mots manuscrits ou dactylographiés sur la page et en les rendant sous forme de bloc de texte dans une cellule de feuille de calcul. Cette partie fonctionne de manière fiable. Ce qui ne fonctionne pas, c'est l'étape que la plupart des équipes de sinistres souhaitent réellement : catégoriser automatiquement ce récit en champs structurés tels que « Catégorie de cause de la perte », « Partie responsable » ou « Gravité des blessures ». Les modèles de langage qui tentent cette classification produisent des taux d'erreur de 25 à 30 %, ce qui est trop élevé pour tout processus en aval qui dépend de l'exactitude du résultat.
L'approche recommandée pour les opérations de sinistres est d'extraire le récit sous forme de texte brut dans un champ unique. L'examinateur lit ce champ — exactement comme il le lirait sur le formulaire papier — tandis que les champs structurés (numéro de police, date de la perte, montants, détails du véhicule) sont déjà renseignés dans la feuille de calcul. Le gain de temps provient du fait de ne pas avoir à ressaisir ces champs structurés, et non d'une tentative de forcer le récit dans une classification qu'il ne supporte pas.
Documents justificatifs : un sinistre, plusieurs stratégies d'extraction
Un dossier de sinistre en pratique est rarement composé uniquement du formulaire ACORD. Les documents justificatifs dépassent généralement le formulaire principal dans un rapport de deux pour un ou trois pour un, et chaque type exige son propre profil d'extraction. Voici comment les pièces jointes les plus courantes correspondent à la stratégie d'extraction.
Rapports de police
Les rapports de police sont le document justificatif le plus fréquemment joint. Ils contiennent des données structurées essentielles — le nom et le numéro de badge de l'agent enquêteur, le numéro de rapport, la date et l'heure du dépôt du rapport, la désignation du conducteur fautif, les informations de contravention, les notes sur les conditions météorologiques et routières, ainsi qu'une section narrative qui reprend ou développe souvent ce que le demandeur a écrit sur le formulaire ACORD. Le défi d'extraction des rapports de police ne réside pas dans la complexité des champs mais dans la variabilité des formats. Il existe environ 18 000 agences de forces de l'ordre aux États-Unis, chacune utilisant sa propre mise en page de rapport. Certaines utilisent le modèle standard de rapport d'accident de la circulation NHTSA. D'autres utilisent des formulaires spécifiques à leur État (le CHP 555 de Californie, le CR-3 du Texas). Beaucoup utilisent des formats de rapport personnalisés générés par leur système de gestion des dossiers. Une approche basée sur des modèles exigerait un modèle distinct pour chaque agence. L'extraction sémantique les traite tous avec une seule définition de colonne, car elle lit les libellés du rapport — « Nom de l'agent », « Numéro de rapport », « Conducteur fautif » — quel que soit leur emplacement sur la page.
Devis de réparation
Les devis de réparation automobile provenant des carrosseries et les devis de réparation immobilière provenant des entrepreneurs contiennent des détails par ligne essentiels pour la constitution des réserves et la négociation des règlements. Les champs clés extractibles comprennent : le nom et les coordonnées de l'atelier ou de l'entrepreneur, la date du devis, l'identifiant du véhicule ou du bien, les heures de main-d'œuvre et le taux par ligne, les coûts des pièces (OEM vs pièces de rechange vs pièces d'occasion), la peinture et les matériaux, le sous-total, les taxes et le total. Les devis de réparation sont plus utiles lorsqu'ils sont extraits sous forme de tableau avec une ligne par article — afin que le total des dommages estimés puisse être calculé à partir de la somme de tous les articles plutôt qu'en s'appuyant sur un seul total manuscrit qui peut omettre certaines catégories de coûts. Le devis doit également être relié au dossier de sinistre qu'il justifie, ce qui signifie que le processus d'extraction doit capturer le numéro de sinistre ou de police qui figure sur le devis, même s'il est écrit à la main dans une marge.
Dossiers médicaux et formulaires d'admission
Dans les sinistres impliquant des blessures — accidents de la route, indemnisation des travailleurs, responsabilité des locaux — les documents médicaux arrivent rapidement dans le dossier de sinistre. Les formulaires d'admission aux urgences, les rapports d'intervention ambulancière, les ordonnances d'imagerie diagnostique et les notes de traitement initiales contiennent tous des champs structurés (nom du patient, date de service, NPI du prestataire, codes de diagnostic, codes de facturation) mélangés à des notes cliniques. La stratégie d'extraction reflète l'approche ACORD : extraire les champs structurés (dates, codes, identités des prestataires, montants facturés) avec des définitions de colonnes, et conserver les notes cliniques en texte libre pour que l'expert ou l'infirmière gestionnaire de dossier puisse les examiner.
Photos
Les photos des dommages — photos de collision de véhicules, dommages par incendie, infiltration d'eau, équipement cassé — ne peuvent pas être extraites pour des données structurées au sens traditionnel. Il n'y a pas de « montant en dollars » à lire sur une photo. Cependant, les modèles de vision par ordinateur peuvent identifier et classer les types de dommages (par exemple, « collision frontale », « dommages au toit causés par la grêle », « tache d'eau au plafond ») si l'exploitation des sinistres a un cas d'usage pour le codage automatisé des dommages. Pour la plupart des équipes de sinistres, l'approche pratique consiste à traiter les photos comme des preuves à l'appui que le système de réception des sinistres reçoit et lie au dossier de sinistre, sans tenter d'extraction structurée.
L'information opérationnelle clé pour tous les types de documents justificatifs : chacun nécessite sa propre définition de colonne d'extraction, et le flux de travail doit maintenir les sorties de tous les documents liées au même dossier de sinistre. Ce n'est pas un problème d'extraction unique. C'est une famille de problèmes d'extraction organisés autour d'un seul événement de sinistre.
Méthodes traditionnelles vs extraction basée sur l'IA
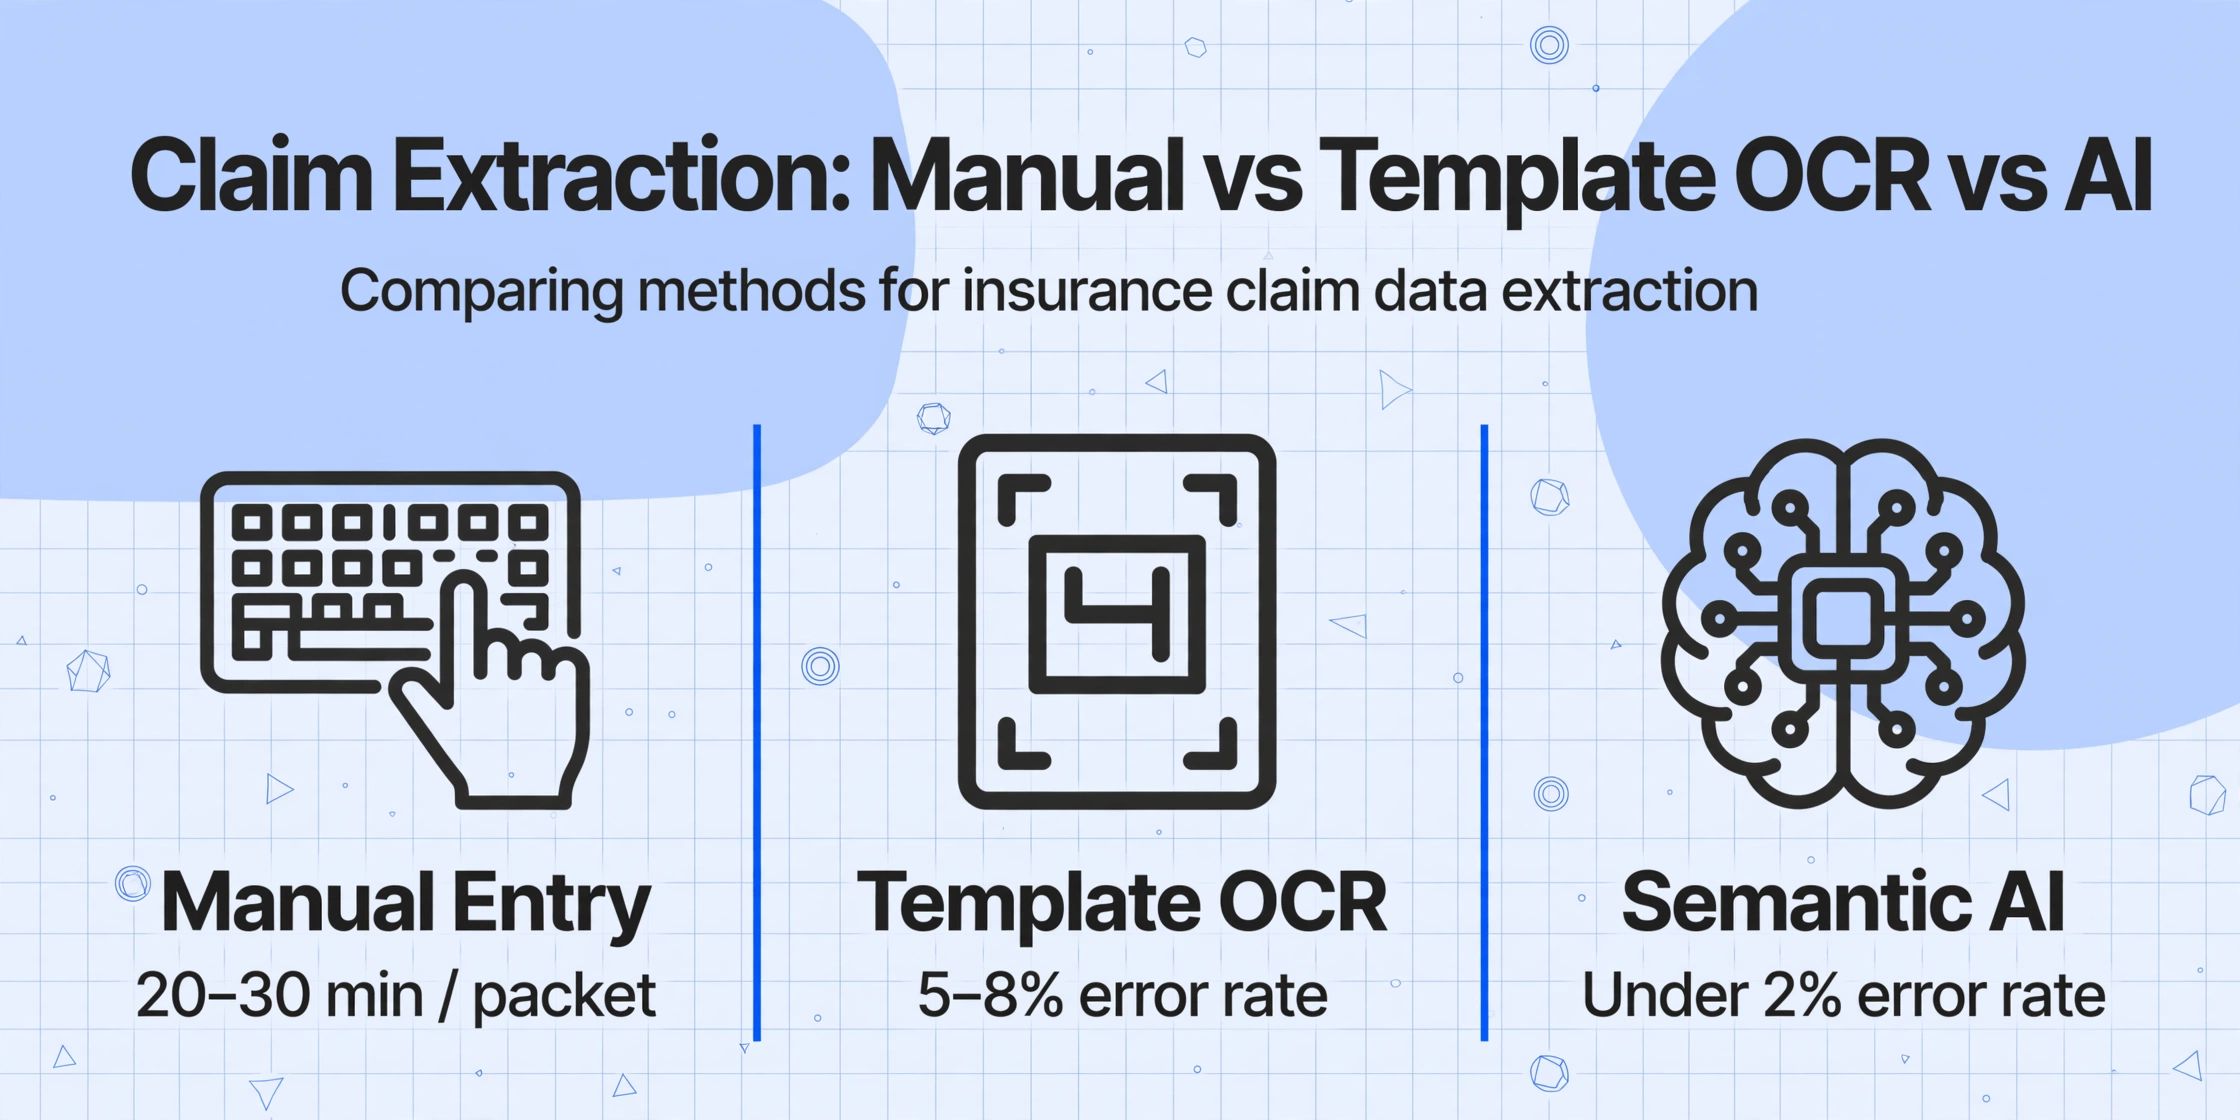
L'approche conventionnelle de la saisie de données pour les sinistres d'assurance a deux variantes : la saisie manuelle et l'OCR basé sur des modèles. Les deux partagent la même limitation fondamentale — elles traitent chaque document de sinistre comme si sa mise en page était prévisible, ce qui n'est pas le cas dans la réception réelle des sinistres.
| Dimension | Saisie manuelle | OCR par modèle | Extraction IA sémantique |
|---|---|---|---|
| Configuration par type de formulaire d'assureur | Aucune (adaptation humaine) | Modèle par formulaire × combinaison de systèmes d'agence | Zéro — une définition de colonne par champ |
| Lot d'assureurs mixtes | Séquentiel, un à la fois | Uniquement les formulaires de même mise en page | Assureurs mixtes, types de formulaires mixtes |
| Documents justificatifs | Lit chaque type de document séparément | Modèle par type de document × mise en page | Un ensemble de colonnes par type de document |
| Écriture manuscrite sur champs structurés | Lit la plupart des écritures manuscrites | Échoue sur la plupart des écritures manuscrites | 85–95 % sur champs structurés |
| Résilience aux changements de format | S.O. — adaptation humaine | Panne jusqu'à mise à jour du modèle | Gère automatiquement les nouvelles mises en page |
| Temps par dossier de sinistre | 20–30 min | 5–10 min (si les modèles existent) | 5–10 secondes |
| Taux d'erreur au niveau du champ (structuré) | 3–5 % | 5–8 % sur formats hors modèle | Moins de 2 % sur champs étiquetés |
L'approche IA sémantique — extraction de documents sans modèle — importe plus pour les sinistres que pour toute autre catégorie de documents en raison de la grande variété de formats dans la réception réelle des sinistres. Un ACORD 2 arrivant comme PDF propre depuis le portail d'un assureur et le même formulaire arrivant comme copie faxée avec champs manuscrits dans les marges sont le même type de document nécessitant les mêmes colonnes, mais un système basé sur des modèles nécessiterait deux configurations. Un système sémantique gère les deux avec une seule.
Traitement par lots des formulaires de sinistre multi-assureurs
Le flux de travail pratique pour les équipes de sinistres traitant 50 à 200 sinistres par jour est le traitement par lots — téléversement d'un dossier de dossiers de sinistre, extraction des champs structurés de chaque document composant, et exportation de l'ensemble dans une feuille de calcul unifiée avec une clé de numéro de sinistre qui relie les lignes de chaque type de document.
Un flux de traitement par lots typique ressemble à ceci :
Le traitement par lots en priorité n'est pas une réflexion après coup pour les opérations de sinistres. C'est le seul flux de travail qui passe à l'échelle lorsqu'un TPA traite des sinistres de 50 assureurs différents, chacun utilisant un rendu ACORD différent, et que les documents justificatifs arrivent par une douzaine de canaux de réception différents.
Comment choisir un outil d'extraction de réclamations
Tous les outils d'extraction ne conviennent pas aux réclamations d'assurance. Le mélange de documents — formulaires structurés, récits en texte libre, pièces jointes multi-sources — exige des capacités spécifiques que les outils OCR généralistes peuvent ne pas posséder. Voici les critères qui comptent spécifiquement pour les opérations de réclamations.
Sans modèle ou basé sur des modèles. C'est la décision la plus déterminante. Si l'outil exige de créer et de maintenir des modèles par assureur, par type de formulaire et par canal de réception, il ne survivra pas à la variété des formats des réclamations réelles. Une approche sans modèle — où les définitions de colonnes fonctionnent à travers les types de formulaires, les assureurs et les mises en page — élimine la dette de configuration qui fait échouer les pilotes d'automatisation des réclamations après la phase de preuve de concept.
Prise en charge de plusieurs types de documents. L'outil doit traiter les formulaires ACORD, les rapports de police, les devis de réparation et les dossiers médicaux comme des types de documents distincts avec des définitions de colonnes séparées — et non pas tout traiter comme « un seul document ».
Capacité de reconnaissance de l'écriture manuscrite. Un pourcentage important de formulaires de réclamation sont remplis à la main — au bord de la route, à l'hôpital, sur un presse-papiers. Si la précision de l'outil sur les champs structurés manuscrits est inférieure à 85 %, l'automatisation des champs structurés s'effondre car trop de sorties nécessitent une correction.
Exportation par lots vers un tableur ou un système de réclamations. La sortie doit être un fichier structuré (Excel, CSV) pouvant être chargé dans Guidewire ClaimCenter, Duck Creek Claims ou toute plateforme de gestion des réclamations sans reformatage manuel.
Aucune exigence de formation. Les équipes de réclamations n'ont pas le volume nécessaire pour former des modèles personnalisés. Un outil qui exige 10 à 50 documents d'échantillonnage par type de formulaire pour « apprendre » vos formats de réclamation ne convient pas au cas d'utilisation de la réception des réclamations, où de nouveaux formats d'assureurs et des variations de documents justificatifs apparaissent régulièrement.
Questions fréquemment posées
Quels types de documents sont inclus dans l'extraction de données des dossiers de sinistre en assurance ?
L'extraction des sinistres couvre l'ensemble du dossier : formulaires de notification de perte ACORD (ACORD 1 pour les biens, ACORD 2 pour l'automobile, ACORD 3 pour la responsabilité civile générale, ACORD 4 pour l'indemnisation des travailleurs), rapports de police, devis de réparation automobile et immobilière, dossiers et factures médicales, et correspondance justificative. Chaque type de document nécessite sa propre définition de colonne d'extraction, mais toutes les sorties sont liées par le numéro de sinistre ou de police pour un traitement consolidé.
Quelle est la précision de l'extraction par IA sur les formulaires de sinistre en assurance par rapport à la saisie manuelle ?
Sur les champs d'en-tête structurés — numéro de police, nom de l'assuré, date et lieu du sinistre, montants — l'extraction par IA atteint une précision de 90 à 95 % et plus, ce qui est nettement supérieur au taux d'erreur de 3 à 5 % au niveau des champs de la saisie manuelle. Les erreurs restantes se concentrent sur des types de champs spécifiques (VIN manuscrits, marques de cases partiellement cochées) et sont suffisamment prévisibles pour mettre en place un flux de vérification ciblé. Les erreurs manuelles, en revanche, sont aléatoires — n'importe quel champ peut être erroné pour n'importe quelle raison — ce qui les rend plus difficiles à détecter sans une relecture complète de chaque document.
L'IA peut-elle extraire la description narrative du sinistre d'un formulaire de réclamation ?
Elle peut extraire le texte de la narration avec une grande précision — lire des mots manuscrits ou tapés et les rendre sous forme de bloc de texte dans une cellule de feuille de calcul. Elle ne peut pas catégoriser de manière fiable cette narration en champs structurés comme « Cause du sinistre » ou « Partie responsable ». Les modèles de langage qui tentent une classification narrative produisent un taux d'erreur de 25 à 30 % qui rend la sortie non fiable pour les décisions de couverture ou de responsabilité. Le flux de travail recommandé consiste à extraire la narration comme texte brut et à laisser l'expert en sinistre la lire directement, tandis que les champs structurés — qui représentent l'essentiel de la charge de saisie — sont automatisés.
L'extraction par IA fonctionne-t-elle sur les rapports de police de différentes juridictions ?
Oui — et c'est là que l'extraction sans modèle présente un avantage décisif par rapport à l'OCR traditionnel. Il existe environ 18 000 agences de forces de l'ordre aux États-Unis, chacune utilisant une mise en page de rapport différente. L'OCR basé sur des modèles exigerait un modèle distinct par agence. L'extraction sémantique lit les étiquettes de champs sur chaque rapport — « Nom de l'agent », « Numéro de rapport », « Conducteur responsable » — pour localiser les valeurs, de sorte qu'une seule définition de colonne couvre tous les formats d'agence. Le même principe s'applique aux devis de réparation, qui varient selon le système logiciel d'estimation (CCC, Mitchell, Audatex).
Dans quelle mesure l'IA gère-t-elle les formulaires de sinistre manuscrits ?
Sur les champs structurés avec des étiquettes claires, les formulaires de sinistre manuscrits sont extraits avec une précision de 85 à 90 % pour la plupart des qualités d'écriture. Le principal mode de défaillance est la mauvaise lecture de caractères individuels — un « 5 » manuscrit lu comme « S », un « 0 » comme « O » — plutôt que des défaillances de champs entiers. Les formulaires de sinistre remplis dans des conditions difficiles (au bord de la route après un accident, dans une pièce faiblement éclairée) ont tendance à comporter une écriture plus hâtive qui fait baisser la précision vers l'extrémité inférieure de cette fourchette. Un flux de travail pratique de traitement des sinistres comprend une étape de validation de 1 à 2 minutes pour vérifier les 2 à 3 champs les plus critiques de chaque formulaire de sinistre.
Les données de sinistre extraites peuvent-elles être exportées directement dans Guidewire ou Duck Creek ?
Oui. Le résultat de l'extraction est un fichier structuré — Excel, CSV ou JSON — qui peut être importé dans tout système de gestion des sinistres acceptant les téléversements de données par lots. Les en-têtes de colonnes correspondent aux noms de champs que vous avez définis lors de la configuration de l'extraction, de sorte que les données arrivent dans les champs système corrects. Pour les équipes traitant de gros volumes, l'exportation par lots peut également être configurée pour produire des feuilles ou des fichiers distincts pour chaque type de document (champs ACORD, champs de rapport de police, champs de devis) reliés par le numéro de sinistre ou de police.
Cela fonctionne-t-il aussi pour les formulaires de réclamation en indemnisation des accidents du travail ?
Oui. Les formulaires FNOL d'indemnisation des accidents du travail partagent la même structure que les autres réclamations basées sur ACORD : un ensemble de champs d'en-tête étiquetés (nom de l'employeur, nom de l'employé, date de la blessure, nature de la blessure, partie du corps, médecin traitant) plus une description narrative de l'accident. Les champs structurés sont extraits avec les mêmes niveaux de précision que pour les réclamations immobilières et automobiles. Les réclamations en indemnisation des accidents du travail génèrent également des documents justificatifs supplémentaires — rapport initial du médecin, formulaires de retour au travail, relevés de salaire — chacun pouvant être traité avec son propre ensemble de colonnes d'extraction.
L'IA peut-elle extraire des données à partir de photos de dommages véhicules ?
Pas de données structurées au sens traditionnel. Les modèles de vision par ordinateur peuvent classer les types de dommages (collision frontale, dommages de grêle, dommages par incendie) et estimer des fourchettes de gravité, mais ils ne peuvent pas produire une valeur en dollars ou une liste de pièces à partir d'une seule photo. Les photos sont mieux traitées comme des preuves justificatives liées au dossier de réclamation, tandis que les estimations structurées des carrossiers ou des entrepreneurs fournissent les données qui alimentent les réserves financières et les calculs de règlement.
Combien de formulaires de réclamation peuvent être traités en un seul lot ?
Il n'y a pas de limite pratique supérieure pour la taille des lots en matière d'extraction par IA. Les équipes de réclamation traitent régulièrement 100 à 200 dossiers de réclamation en un seul lot — mélangeant des formulaires ACORD de plusieurs assureurs, des rapports de police de différentes agences et des estimations de réparation de divers ateliers. Le temps de traitement évolue linéairement avec le nombre de documents, avec une moyenne de 5 à 10 secondes par document, quel que soit le format ou l'assureur. Pour des volumes plus élevés, le flux de travail par lots prend en charge le traitement simultané via les formules d'équipe.
Comment commencer à tester l'extraction par IA sur mes propres formulaires de réclamation ?
Téléchargez un formulaire ACORD scanné — immobilier, automobile ou responsabilité civile générale — ou une photo d'un formulaire de réclamation rempli. Aucune inscription n'est requise pour le premier test. Définissez les colonnes dont votre système de réclamation a besoin : numéro de police, date de sinistre, nom de l'assuré, lieu du sinistre, montant estimé, type de sinistre. Consultez les résultats d'extraction en quelques secondes. Pour une procédure complète couvrant le traitement par lots de formulaires de plusieurs assureurs et de documents justificatifs, consultez nos guides étape par étape pour des types spécifiques de documents de réclamation.
L'avantage de l'extraction sémantique pour les sinistres est qu'elle s'adapte à la variabilité des formats que vous gérez déjà manuellement — sans vous demander de créer des modèles pour chaque transporteur, type de formulaire ou canal de réception. Les champs structurés des formulaires ACORD, rapports de police et devis de réparation sont les mêmes, que le document arrive sous forme de PDF de portail, de copie faxée ou de photo de smartphone. Définissez vos colonnes une seule fois, et l'IA trouve les valeurs où que les libellés apparaissent.
Essayez avec vos propres documents de sinistre