PDFからWordへの変換で発生する5つの書式崩れ
——修正に何時間も費やす原因
ほとんどのPDF変換ツールが教えてくれない真実があります。あなたが繰り返し直面する書式崩れは、バグではありません。「悪いツール」や破損ファイルのせいでもありません。これらはOCRが実際にどう機能するかによって数学的に予測可能な出力なのです——その理由を理解するまでは、どのツールを使っても手動での再フォーマットに何時間も費やし続けることになるでしょう。
重要なポイント
- 5つの書式崩れが、変換後の再作業時間の90%を占めています。そして、どのツールベンダーも教えてくれないのは、これらはバグではなく、OCRが設計通りに機能した結果だということです。
- OCRはドキュメント用に作られていません——文字をページ上のピクセル座標として認識するため、段落の区切りと行間隔、テーブルと単語のグリッド、ヘッダーと本文を文字通り区別できないのです。
- ドキュメントを視覚的に処理する——人間の読者がするのと同じように段落、テーブル、ヘッダーを認識する——ことで、個々の症状にパッチを当てるのではなく、共通の根本原因に対処し、5つの書式崩れすべてを一度に解消できます。
OCRの罠:コンバーターがドキュメントではなく文字しか見ていない理由
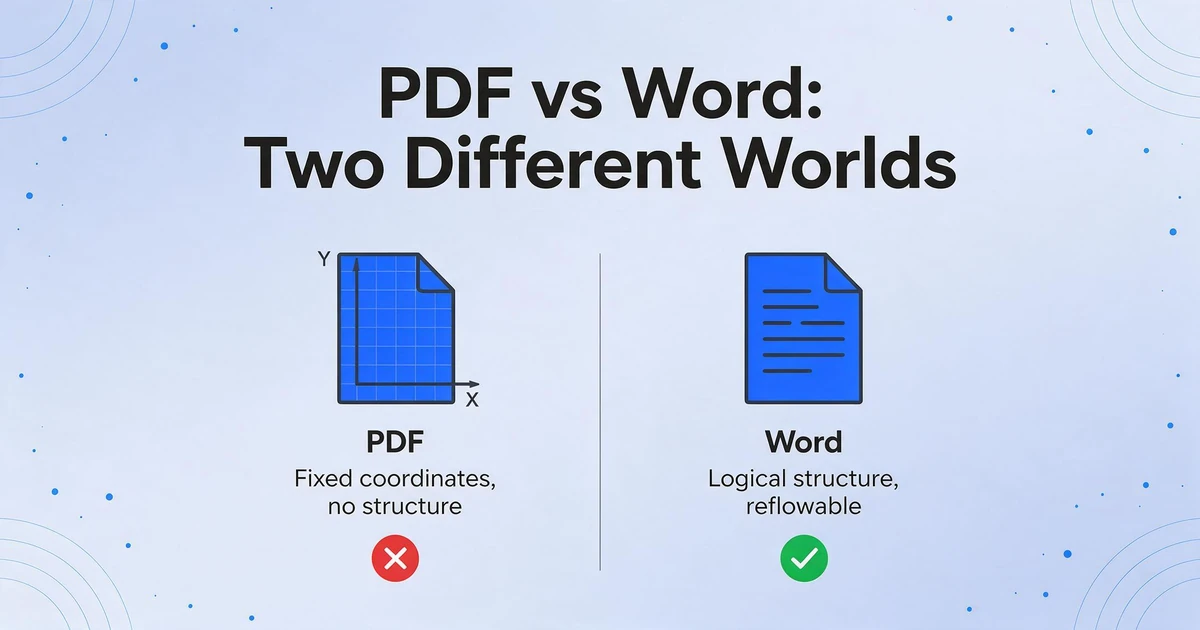
このリストにあるすべての失敗モードがなぜ起こるのかを理解するには、ひとつのことを理解する必要があります:PDFとWordは、根本的に互換性のない方法でドキュメントを表現しているということです。
PDFは本質的にデジタル印刷物です。文字、線、ロゴなど、すべての要素を2次元平面上の固定X/Y座標を持つオブジェクトとして保存します。PDFは「H」という文字が11ptのHelveticaで位置(124, 587)にあることは「知っています」が、「H」が見出しの最初の文字であること、その見出しがセクションに属していること、そのセクションが特定の情報階層を持つドキュメントの中に存在することを「知りません」。これらは人間の概念であり、PDFは設計上、それらをエンコードしていないのです。
あるRedditユーザーが述べているように:「PDFをWordに変換するのは、言語を翻訳するというより、焼き上がったケーキを小麦粉、卵、砂糖に戻そうとするようなものだ」。
従来のOCR(光学文字認識)はこれをさらに悪化させます。OCRはページ上のピクセルを読み取り、既知の文字パターンと照合しようとします——しかし、それは座標上の文字しか見ていません。PDFからWordへの変換で書式が失われる理由を理解する概念はなく、そもそもドキュメントを理解するように設計されていないのです。OCRはナンバープレートやスキャンした書籍のページを読むために設計されたもので、「この段落はどういう意味か?」という問いは問題定義に含まれていませんでした。
その結果、PDFからWordへの書式に関する苦情のほぼすべてを占める、5つの繰り返し発生する失敗パターンが生まれます。それぞれがどのようなものか、なぜOCRが原因なのか、そして根本的に異なるアプローチ——ビジョンAI——がどのように根本原因を排除するのかをご紹介します。
問題1: フォントの消失と置換
どのような症状か
美しく組版されたPDF — たとえばCalibriで太字のセクションヘッダーと斜体の財務数値を使ったクライアント向け提案書 — を変換し、結果のWordファイルを開くとします。ドキュメント全体がTimes New Romanになっています。さらに悪いことに、フォントサイズがわずかにずれてWordのリフローエンジンが作動し、慎重にページ付けした12ページのドキュメントが、ページ下部に孤立した見出しを残した14ページになってしまうのです。
場合によっては、ほぼ正しいが完全ではないフォントになることもあります — サンセリフの本文がわずかに狭いサンセリフの代替フォントになり、すべての行送りが1〜2語ずつずれます。ドキュメントは技術的には読めますが、その状態でクライアントに送ることはできないでしょう。
OCRが原因となる理由
OCRエンジンは文字の形を認識します — フォントは認識しません。OCRがPDFページを処理するとき、既知のグリフ(さまざまな形の文字「a」)に一致するピクセルパターンを見て、対応するUnicode文字を出力します。フォントのメタデータ — どの書体が、どのウェイトで、どのスタイルセットで使われたか — はPDFのフォント辞書に保存されているか(OCRはこれを無視します)、フォントがPDFに埋め込まれていない場合は完全に失われます。
Adobe自身のドキュメントは、次に何が起こるかを説明しています:フォントが欠落しているか埋め込まれていない場合、システムはMultiple Master書体 — セリフフォントの欠落にはAdobeSerifMM、サンセリフフォントの欠落にはAdobeSansMM — を代替します。これらの代替フォントは「行とページの区切りを維持するために伸縮します」が、「元の文字の形に常に一致できるわけではありません」。結果は、構造は保たれているものの視覚的に間違ったドキュメントになります。
スキャンしたPDFの場合、問題はさらに悪化します:フォントのメタデータが存在しません。OCRエンジンはピクセルパターンから文字の正体を推測しており、フォント情報は単に復元できません。すべての文字は、変換ツールが割り当てるデフォルトのフォントになります。
ビジョンAIが解決する方法
ビジョンAIはフォント名を特定しようとはしません。その代わりに、ドキュメントを視覚的に処理します。つまり、特定のテキストが周囲のテキストよりも大きく、太く、または薄いことを認識し、その視覚的な関係性を出力に保持します。PDF内で視覚的に大きくて太い見出しは、Word出力でも大きくて太い見出しとしてレンダリングされます。「Calibri Bold 16pt」であることを知る必要はありません。人間の読者が見る視覚的な重みの階層を再現するだけでよいのです。
これは根本的に異なる戦略です。OCRは「このフォントは何か?」と問いかけ、答えられないと失敗します。ビジョンAIは「このテキストはページ上の他の要素と比べてどう見えるか?」と問いかけます。これは、人間の読者と同じ方法でドキュメントを処理するため、常に答えられる質問です。
失敗例2: テーブル構造の崩壊
どのような状態か
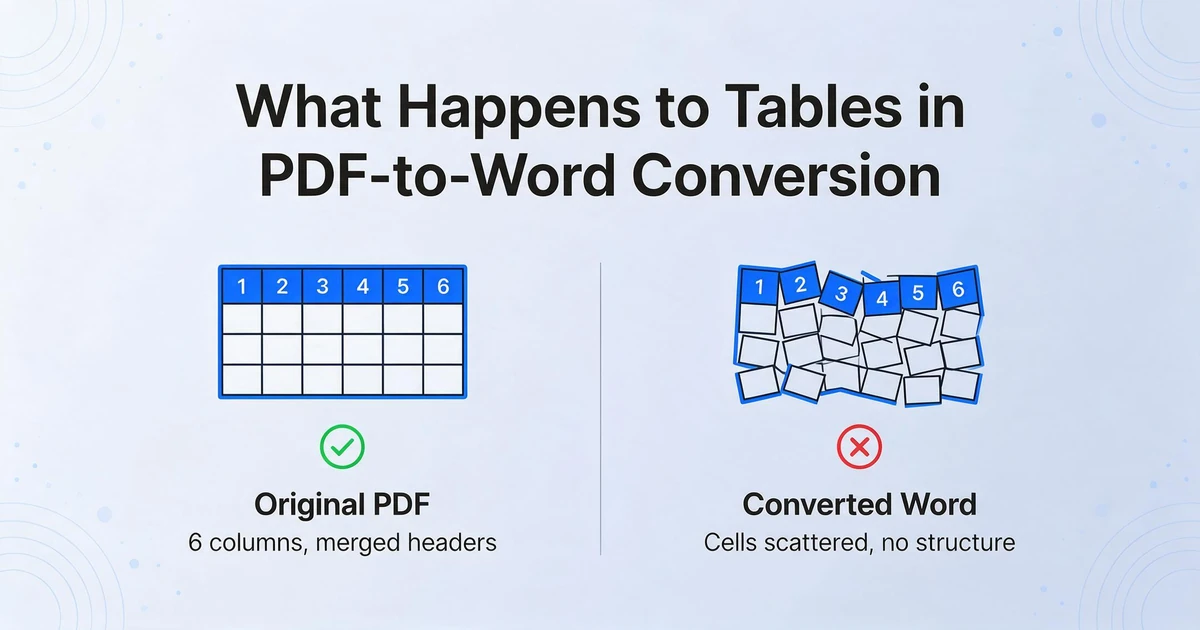
きれいにフォーマットされたテーブルを含む財務レポートを変換するとします。6つの列にわたる四半期収益の数値、結合されたヘッダーセル、小計行があります。変換後のWordドキュメントでは、各セルの内容が独立した段落になり、列の関係性が失われ、「Q1 Revenue: $142,000」が「Q3 Revenue: $156,000」のすぐ隣に、かつて異なる列にあったことを示す手がかりもなく配置されます。元のテーブルに目に見えない境界線があった場合(プロフェッショナルなレポートでは一般的なデザイン選択です)、コンバーターはテーブルが存在したこと自体を検出できないことがよくあります。
この問題についてのRedditスレッドでは、あるユーザーが「変換中に最初に壊れるのは通常テーブルだ」と指摘しており、テーブル中心のドキュメントでは、すべてのフォーマットを削除してテーブルをゼロから手動で再構築するのが最もクリーンなアプローチであるというのが一致した見解でした。それは解決策ではなく、降伏です。
OCRが原因となる理由
すべてを説明する重要な技術的詳細は次のとおりです:PDFにはネイティブの「テーブル」構造がありません。PDF内のテーブルは、グリッド状に配置されたテキストオブジェクトの集合にすぎず、必要に応じて線描画コマンドで目に見える境界線を作成します。「これらの6つのテキストオブジェクトが同じ行に属する」とか「このセルが2列にまたがる」といったメタデータは存在しません。
OCRベースのコンバーターは、視覚的な手がかりからテーブルを逆算する必要があります:整列したテキスト列を探し、罫線を検出し、どのセルが互いに関連するかを推測しようとします。列間隔が不規則な場合、セルが結合されている場合、境界線が見えない場合、またはセル内容が複数行にわたって折り返される場合、推論は失敗します。各セルは、隣接するセルとの関係を持たない独立したテキストブロックになります。
これが、テーブルを保持したままスキャン文書をWordに変換することがこれほど難しい課題であり続けてきた理由です:OCRパイプラインはテキストストリーム用に設計されており、視覚的な座標だけから2次元のデータ構造を再構築するようには設計されていません。
ビジョンAIが解決する方法
ビジョンAIは、人間と同じようにテーブルを処理します:ページを見てグリッド構造を理解します。一貫した水平間隔と行ごとの繰り返しを持つ整列したテキスト列を認識すると、目に見える境界線があるかどうかに関係なく、テーブルとして認識します。テーブルの視覚的アーキテクチャを理解するため、結合セル、列スパン、階層ヘッダーを保持します。個々のテキスト断片の座標だけを理解するのではありません。
境界線のないテーブル(ほぼすべてのOCRベースのコンバーターを壊す形式)に対して、ビジョンAIは特に効果的です。線検出のヒューリスティックではなく視覚的パターン認識に依存するため、コンテンツの整列と間隔だけで表構造を識別できます。
失敗3:画像のずれ
見た目はどうなるか
PDFの3ページ目に、説明文2段落がきれいに回り込んだグラフがあるとします。Wordに変換すると、グラフは5ページ目に移動し、無関係な本文の上に重なって表示されます。グラフの周りに配置されるはずだった2段落は、上に乱雑なブロックとして積み重なっています。あるいはさらに悪いケースとして、画像が単に消えてしまうこともあります——四半期業績グラフがあった場所に空白や画像切れのプレースホルダーだけが残るのです。
これは、マーケティング用パンフレット、図解入りの技術レポート、図とキャプションを含む学術論文など、画像が多いドキュメントで特に厄介です。必要なテキストはそこにあるのに、ドキュメントの視覚的なロジック——画像と周囲のコンテンツとの関係——が破壊されてしまっています。
OCRが原因となる理由
PDFでは、画像とテキストは同じ座標空間を占めますが、完全に別のオブジェクトタイプとして保存されています。画像は境界ボックスの座標とピクセルデータで定義され、周囲のテキストは独自のテキストラン座標で定義されます。「この画像はこの段落にアンカーされている」という明示的な関係は存在しません——ドキュメント作成者はその関係を意図していましたが、PDF形式はそれをエンコードしていないのです。
OCRはこれをさらに複雑にします。OCRエンジンはテキストを処理するように設計されており、画像は無視されるか、テキストフローの障害物として扱われます。コンバーターがWordドキュメントを再構築するとき、各画像をどこに配置するかを決定する必要があります。画像と近くのテキストとの空間的関係を理解しないまま、画像を任意の位置にアンカーすることがよくあります——あるいは、配置ロジックが有効なアンカーポイントを見つけられない場合、画像を完全に落としてしまうこともあります。
ビジョンAIが解決する方法
ビジョンAIはドキュメントを全体として処理します。「テキストチャネル」と「画像チャネル」を後で調整が必要な別々の処理ストリームとして見るのではなく、空間的関係を持つ視覚要素が1つのページとして認識します。左側にテキストが回り込んだグラフは配置パズルではなく、「左側に2段組みテキスト回り込みのあるグラフ」としてビジョンAIが理解する単一の視覚シーンです。
モデルがドキュメントを視覚的に理解するため、出力は周囲のコンテンツに対する正しい位置に画像を保持します——まるでページレイアウトを見えない人に説明するのと同じように。「右側に棒グラフがあり、テキストは左側でその周りを流れています」というふうに。
失敗4:段落の結合
どのような問題か
これは最も見落としやすい失敗の一つです。ざっと見ただけでは気づきにくいからです。契約書やレポートをPDFからWordに変換すると、読み始めるまではすべてが正しく見えます。段落の区切りがあるべき場所に、途切れのないテキストの壁が続いています。2つまたは3つの論理的な段落が1つに結合され、段落区切り(Enter)ではなく、単なる改行(WordのShift+Enter)で区切られているだけです。インデントも消えています。文書の修辞的な構造 — 議論、証拠、結論のリズム — は、区別のないテキストの流れに平らにされてしまいました。
法律文書にとって、これは危険です。結合された段落は、条項とその例外の境界を曖昧にする可能性があります。ビジネスレポートにとっては、読みやすさを損ないます。どの文書にとっても、編集者はテキスト全体を読み直し、手動で段落区切りを挿入し直さなければならないことを意味します — これは文書を最初から打ち直すのとほぼ同じ時間がかかる作業です。
OCRが原因となる理由
OCRは文字とその座標を記録します — 段落の境界は記録しません。PDFの段落区切りは特別な文字ではなく、単に2行のテキスト間のより大きな垂直方向の間隔です。OCRエンジンはこれを「Y=540のテキスト行、Y=520のテキスト行、20単位の間隔」として記録します — これは段落内の改行とまったく同じデータ構造で、Yオフセットがわずかに大きいだけです。
コンバーターは今、不可能な分類問題に直面します:18ポイントの垂直方向の間隔は段落区切りなのか、それとも単に余裕のある行間なのか?インデントのある24ポイントの間隔は新しい段落なのか、それともセクション見出しなのか?テキストの意味を理解しないまま、コンバーターはヒューリスティックなしきい値 — 「間隔がXより大きければ段落区切りを挿入」— を適用するしかなく、これは一部の文書では機能し、他の文書では壊滅的に失敗します。
複数列レイアウトは問題を倍増させます。2つの列が並んでいるとき、OCRエンジンの行ごとの左から右への読み取り順序は、無意味な出力を生成します:列Aの最初の行と列Bの最初の行が連結され、その後に各列の2行目が続きます。コンバーターは列について知りません — 2次元平面上の文字座標についてのみ知っています。
ビジョンAIが解決する方法
ビジョンAIは人間と同じようにページを読み取ります。列を認識し、インデントのパターンを把握し、段落の区切り(「一つの考えの終わり、次の考えの始まり」)と行の折り返し(「同じ考えが横のスペースに収まらない」)を区別します。文書全体のパターン(新しい段落の始まりの一貫したインデント、セクション間の広い間隔、セクション見出しの配置)を特定し、これらの視覚的な手がかりを使って文書の論理構造を再構築します。
複数列の文書の場合、ビジョンAIは各列を独立した読み取りゾーンとして処理し、その後で正しい順序(列Aの全文、次に列Bの全文)に結合します。異なる列の行を交互に混ぜることはありません。
問題5:ヘッダー、フッター、ページ番号が消える
症状
変換されたWord文書を開きます。スクロールしていくと、何かがおかしいと感じますが、すぐには特定できません。そして気づきます。PDFのすべてのページにあった「Confidential — Q3 Internal Review」というランニングヘッダーがどこにも見当たりません。ページ番号も消えています。文書参照コードが入ったフッターも消えています。元の文書のすべてのページに一貫して表示されていたこれらの要素が、変換後の出力から単に消えてしまったのです。
別のケースでは、消えるのではなく誤認識されます。ヘッダーのテキストが1ページ目の本文にランダムな文章として挿入され、「Page 3 of 12」というページ番号が3ページ目の段落の途中に、まるで文の一部であるかのように配置されます。
OCRが原因となる理由
ヘッダーとフッターは、OCRエンジンが苦手とする空間領域を占めています。理由は2つあります。第一に、ページの余白に位置しています。多くのOCRエンジンは、余白のコンテンツは情報ではなくノイズであると想定し、テキスト抽出中に低優先度として扱うか、単にスキップします。第二に、反復的であることです。同じテキストがすべてのページのほぼ同じ位置に表示されます。一部の変換ツールはこの反復を印刷のアーティファクトと解釈し、意図的に抑制します。
PDFには、「このテキストはヘッダーである」と「このテキストは本文である」という構造的な区別はありません。両方とも特定の座標に配置されたテキストオブジェクトです。変換ツールは、どのテキストがWordのヘッダー/フッターセクションになり、どのテキストが本文に残るべきかを推測する必要があります。この推測は、位置(ページの上部/下部)と反復(複数ページの同じテキスト)に関する脆弱なヒューリスティックに依存しています。これらのヒューリスティックが失敗した場合(セクションごとに一意のヘッダーがある文書、または本文テキストが誤ってヘッダーゾーンにある場合)、結果は予測不能になります。
ビジョンAIがどのように解決するか
ビジョンAIは、ヘッダーとフッターをその視覚的な役割によって識別します。つまり、ページの上部または下部の余白ゾーンに一貫して配置され、ページをまたいで繰り返されるテキストです。「Confidential — Q3 Internal Review」が毎ページ同じY座標に表示される場合、それは本文ではなく、ページ上部付近にあるランニングヘッダーであると認識します。ページ番号は、その内容パターン(ページをまたいで同じ位置にある増分する数字)と空間的な文脈(通常はフッターゾーンにあり、「Page X of Y」というテキストを伴うことが多い)によって検出します。
出力では、これらはネイティブのWordヘッダーおよびフッターセクションとして保持され、正しく機能します。つまり、すべてのページに表示され、ページを追加または削除すると自動的に更新され、ヘッダーとフッターが本来あるべき動作を正確に行います。
症状への対処を超えて:ツールよりもアプローチが重要な理由
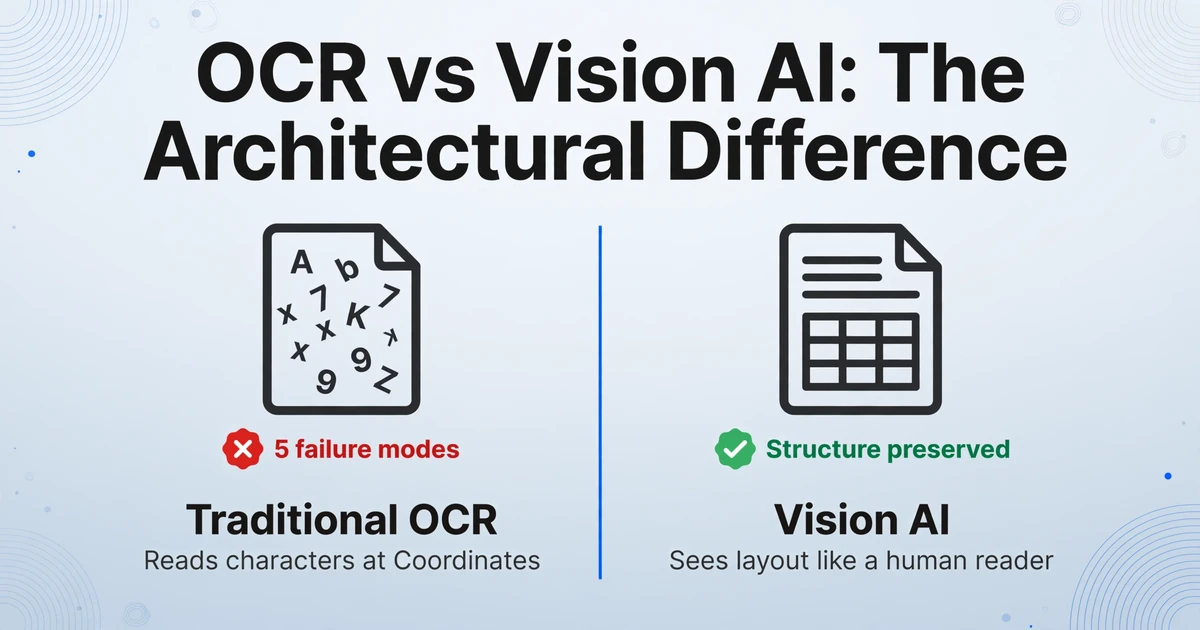
一歩引いて、これら5つの障害モードに共通する点を見てみましょう。どのケースでも根本原因は同じです:OCRはドキュメントを文字座標として処理し、視覚情報としては処理しません。フォントが失敗するのは、OCRが書体メタデータを識別できないためです。表が壊れるのは、OCRが1次元のテキストストリームから2次元の構造を推論できないためです。画像がずれるのは、OCRが画像を要素ではなく障害物として扱うためです。段落が結合されるのは、OCRが段落間隔と行間隔を区別できないためです。ヘッダーが消えるのは、OCRが空間的な繰り返しパターンを認識できないためです。
これらは、5つの別々の修正を必要とする5つの別々のバグではありません。1つのアーキテクチャ上の制限が、5つの異なる方法で現れているのです。そして、その含意は重要です:OCRパイプラインの上にパッチやヒューリスティックをいくら積み重ねても、これを解決することはできません。段落間隔のしきい値を調整し、表検出アルゴリズムを改善し、フォント置換ルールを追加しても、基盤となる処理パラダイム(ドキュメント理解を伴わない文字認識)が変わらない限り、依然として障害ケースに直面するでしょう。
ここで、ビジョンAIと従来のOCRの違いが、学術的な区別以上のものになります。ビジョンAIは文字座標からドキュメント構造を再構築しようとはしません。ドキュメントを視覚的に見て、人間の読者がするのと同じようにレイアウトを理解します。段落は垂直方向のギャップのしきい値ではなく、視覚的なパターンによって認識します。表は線検出アルゴリズムではなく、グリッド構造によって識別します。フォントは書体名を調べるのではなく、視覚的な重みの階層を再現することによって保持します。
レイアウトを保持するドキュメントからWordへの変換の完全ガイドについては、ワークフローは簡単です:ドキュメントをアップロードすると、ビジョンAIエンジンがテキスト、表、画像、ヘッダー、フッターを含むページ全体を単一の視覚シーンとして分析します。各要素が何であるか、そして他のすべての要素とどのように関連しているかを理解することで、編集可能なWord形式でドキュメントを再構築します。座標データから推測するのではありません。
これはつまり、同じエンジンがOCRパイプラインを完全に壊すエッジケースも処理できることを意味します:編集可能なWordに変換されたスクリーンショット — PDFフォントメタデータがまったくなく、ピクセルだけがある場合 — または手書きと印刷コンテンツが混在したドキュメント。ドキュメントを視覚的に処理する場合、ソース形式の重要性ははるかに低くなります。特定のツールを比較している場合は、レイアウトを保持するWord変換ツールの比較で、各アプローチがこれら5つの障害モードにどう対応するかを詳しく説明しています。
ファイルは安全に処理され、保存されません。
よくある質問
PDFは完璧に見えるのに、変換されたWordドキュメントがめちゃくちゃなのはなぜですか?
PDFが完璧に見えるのは、固定レイアウト形式だからです — すべての要素が正確な座標に固定されています。Wordドキュメントがめちゃくちゃに見えるのは、コンバーターが生の座標データから段落、表、書式を再構築する必要があり、その再構築は文字レベルのOCRでは本質的に損失が生じるためです。ドキュメントが画面上で見栄えが良いのは、PDFとして優れていたからです。編集可能な形式に変換することは、ドキュメントの論理構造をゼロから再構築することを意味し、これは根本的に異なる課題です。
PDFに全フォントを埋め込めば、フォント置換の問題は解決できますか?
フォントの埋め込みは、PDFが元々デジタルソース(Word文書をPDFとして保存し、フォントを埋め込んだ場合など)から作成された場合に役立ちます。しかし、スキャンしたPDF(紙の文書をデジタル化したもの)には、埋め込むフォントが存在しません。「テキスト」は画像の中のピクセルに過ぎないからです。OCRは文字の形を認識してUnicode値に割り当てる必要がありますが、文書がスキャンされた時点で元の書体情報は失われているため、それを復元することはできません。このような場合、ビジョンAIが書体の特定を試みるのではなく、視覚的な重みの階層を保持するアプローチが、適切にフォーマットされた出力を得るための唯一の実行可能な方法です。
オンライン変換ツールによって、特定の文書での性能が異なるのはなぜですか?
変換ツールによって、テーブル検出のヒューリスティック、段落間隔のしきい値、フォント置換ルールが異なります。行間が広い単一カラムのレポート向けに調整されたツールは、その文書タイプではきれいな出力を生成できますが、間隔が狭い複数カラムのニュースレターでは完全に失敗する可能性があります。これが、ツール間を行き来することになる理由です。各ツールは、異なる文書レイアウトの前提に合わせて調整されているからです。ビジョンAIアプローチは、レイアウト固有のヒューリスティックに依存しないため、この問題を回避します。
スキャン解像度を上げれば、PDFからWordへの変換のフォーマット問題は解決しますか?
スキャン解像度を上げる(300 DPI以上)と、OCRの文字認識精度は向上します(「0」と「O」の混同が減るなど)。しかし、このリストにある構造的な失敗は解決されません。600 DPIでスキャンしても、OCRに段落の開始位置と終了位置、テーブルセル同士の関係、出力内でのヘッダーの配置場所を教えることはできません。解像度はテキストの精度を向上させますが、レイアウトの理解は向上させません。これらは別々の能力であり、根本的に異なる処理アプローチが必要です。
Wordに変換すべきですか、それとも構造化テーブルに変換すべきですか?
出力をどう使うかによって異なります。元のレイアウトで文書を編集、レビュー、再利用する必要がある場合(修正が必要な条項を含む契約書、内容の更新が必要なレポート、テキスト変更が必要なパンフレットなど)は、Word出力が視覚的な文書を保持します。複数の文書にわたってデータを分析する必要がある場合(請求書の合計をスプレッドシートに抽出する、ベンダーの見積もりを列で比較するなど)は、構造化テーブル出力(Excel/CSV)が適切なターゲットです。当社のWordに変換 vs テーブルに変換の意思決定フレームワークでは、具体的なユースケースに基づいた選択方法を説明しています。
Vision AIは複数カラムや複雑なレイアウトの文書を処理できますか?
はい — ここがOCRとVision AIの最大の差です。OCRは左から右へ一行ずつ読み取るため、複数カラム文書では異なるカラムのテキストが混ざり、意味不明な出力になります。Vision AIは各カラムを独立した視覚ゾーンとして処理し、正しい順序で並べるため、元の読みやすさを保ちます。画像の周りにテキストが流れる文書、サイドバー、コールアウトボックスなど、非線形レイアウトにも同様に対応できます。