5 falhas de formatação de PDF-para-Word
que custam horas de retrabalho
Aqui está uma verdade que a maioria das ferramentas de conversão de PDF não conta: essas falhas de formatação que você encontra não são bugs. Não são resultado de uma "ferramenta ruim" ou de um arquivo corrompido. São a saída matematicamente previsível de como o OCR realmente funciona — e até você entender o porquê, vai continuar perdendo horas com reformatação manual, não importa qual ferramenta você tente.
Principais Conclusões
- Cinco falhas de formatação consomem 90% das suas horas de retrabalho pós-conversão — e aqui está a parte que nenhum fornecedor de ferramenta conta: elas não são bugs, são o OCR funcionando exatamente como foi projetado.
- O OCR não foi feito para documentos — ele vê caracteres como coordenadas de pixels em uma página, o que significa que literalmente não consegue distinguir uma quebra de parágrafo de um espaçamento de linha, uma tabela de uma grade de palavras, ou um cabeçalho de texto do corpo.
- Processar o documento visualmente — reconhecendo parágrafos, tabelas e cabeçalhos da mesma forma que um leitor humano — elimina todas as cinco falhas de uma vez ao abordar a causa raiz comum, não ao corrigir cada sintoma separadamente.
A Armadilha do OCR: Por que seu Conversor Vê Caracteres, Não Documentos
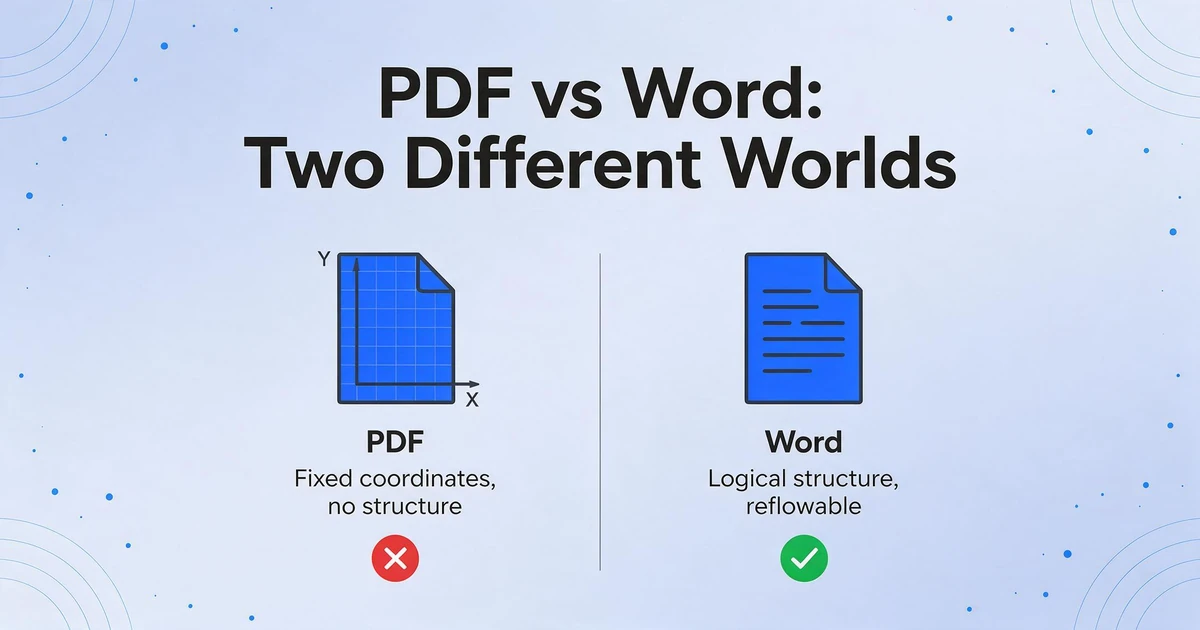
Para entender por que cada modo de falha nesta lista acontece, você precisa entender uma coisa: PDF e Word representam documentos de maneiras fundamentalmente incompatíveis.
Um PDF é essencialmente uma impressão digital. Ele armazena cada elemento — uma letra, uma linha, um logotipo — como um objeto com coordenadas X/Y fixas em um plano bidimensional. O PDF "sabe" que a letra "H" está na posição (124, 587) em Helvetica 11pt. Ele não sabe que "H" é a primeira letra de um título, ou que o título pertence a uma seção, ou que a seção vive dentro de um documento com uma hierarquia de informações específica. Esses são conceitos humanos que o PDF — por design — não codifica.
Como um usuário do Reddit disse: "Converter um PDF para Word é menos como traduzir um idioma e mais como tentar transformar um bolo assado de volta em farinha, ovos e açúcar."
O OCR tradicional (Reconhecimento Óptico de Caracteres) piora isso. O OCR lê os pixels de uma página e tenta combiná-los com padrões de caracteres conhecidos — mas ele só vê caracteres em coordenadas. Ele não tem conceito de por que a conversão de PDF para Word perde a formatação porque nunca foi projetado para entender documentos. Ele foi projetado para ler placas de veículos e páginas de livros digitalizadas — contextos em que "o que este parágrafo significa?" nunca fez parte do problema.
O resultado: cinco padrões de falha recorrentes que respondem por praticamente todas as reclamações de formatação em conversões de PDF para Word. Veja como cada um se parece, por que o OCR o causa e como uma abordagem fundamentalmente diferente — Vision AI — elimina a causa raiz.
Falha 1: Perda e Substituição de Fontes
Como Isso Se Manifesta
Você converte um PDF com tipografia bonita — talvez uma proposta para cliente em Calibri, com cabeçalhos de seção em negrito e valores financeiros em itálico — e abre o arquivo Word resultante. O documento inteiro agora está em Times New Roman. Pior: o tamanho da fonte está levemente diferente, o que aciona o mecanismo de reflow do Word e, de repente, seu documento de 12 páginas cuidadosamente paginado virou 14 páginas, com cabeçalhos órfãos perdidos no rodapé das páginas.
Em alguns casos, você recebe uma fonte que está quase certa, mas não exatamente — o texto sem serifa vira uma substituta sem serifa ligeiramente mais estreita, e cada quebra de linha muda em uma ou duas palavras. O documento é tecnicamente legível, mas você não o enviaria a um cliente nesse estado.
Por Que o OCR Causa Isso
Os mecanismos de OCR reconhecem formatos de caracteres — eles não reconhecem fontes. Quando o OCR processa uma página de PDF, ele vê padrões de pixels que correspondem a glifos conhecidos (a letra "a" em várias formas) e gera o caractere Unicode correspondente. Os metadados da fonte — qual tipo de letra foi usado, com qual peso, com qual conjunto estilístico — ou estão armazenados no dicionário de fontes do PDF (que o OCR ignora) ou se perdem completamente se a fonte não foi incorporada ao PDF.
A própria documentação da Adobe explica o que acontece em seguida: quando uma fonte está ausente ou não incorporada, o sistema substitui por um tipo de letra Multiple Master — AdobeSerifMM para fontes serifadas ausentes, AdobeSansMM para fontes sem serifa ausentes. Essas fontes de substituição "se esticam ou condensam para caber, mantendo quebras de linha e página" — mas "nem sempre conseguem corresponder ao formato dos caracteres originais". O resultado é um documento estruturalmente preservado, mas visualmente errado.
Para PDFs escaneados, o problema é pior: simplesmente não há metadados de fonte. O mecanismo de OCR está adivinhando identidades de caracteres a partir de padrões de pixels, e as informações da fonte simplesmente não são recuperáveis. Cada caractere vira a fonte padrão que o conversor atribuir.
Como a Vision AI Resolve Isso
A Vision AI não tenta identificar fontes pelo nome. Em vez disso, ela trata o documento visualmente — ela vê que determinado texto é maior, mais ousado ou mais claro que o texto ao redor, e preserva essas relações visuais na saída. Um título que é visualmente maior e mais pesado no PDF será renderizado como um título maior e mais pesado na saída do Word. Ela não precisa saber que era "Calibri Bold 16pt" — ela só precisa reproduzir a hierarquia de peso visual que o leitor humano vê.
Essa é uma estratégia fundamentalmente diferente: o OCR pergunta "qual é essa fonte?" e falha quando não consegue responder. A Vision AI pergunta "como este texto se parece em relação a tudo o mais na página?" — uma pergunta que ela sempre pode responder porque processa o documento da mesma forma que um leitor humano.
Falha 2: Colapso da Estrutura da Tabela
Como Isso Se Parece
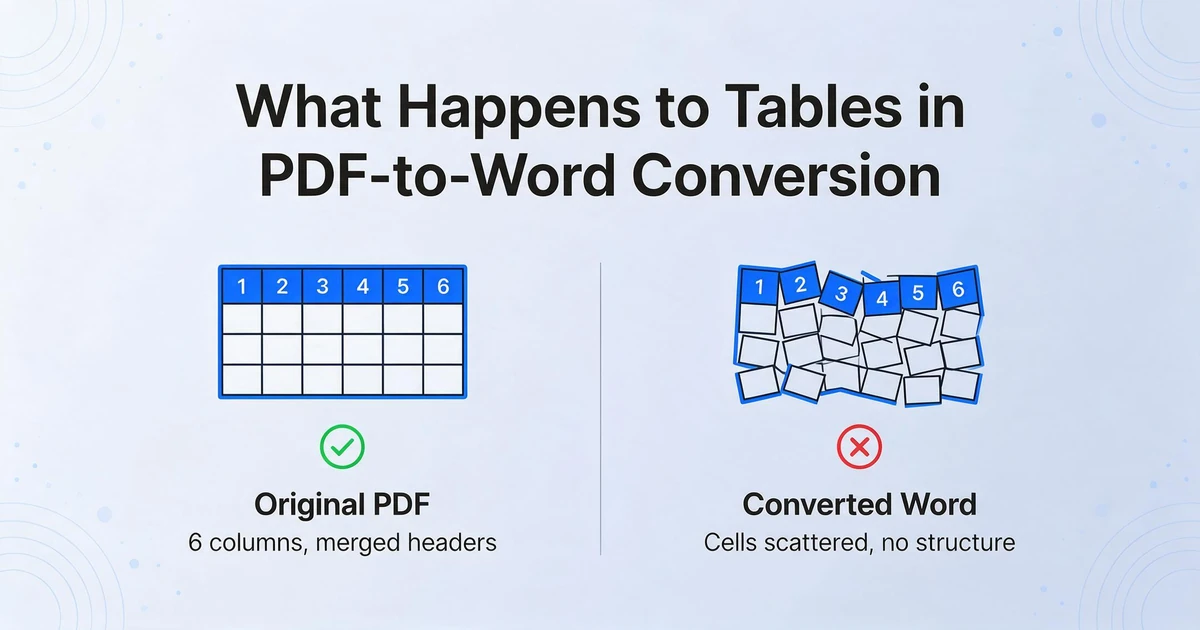
Você converte um relatório financeiro com uma tabela bem formatada — valores de receita trimestral em seis colunas com células de cabeçalho mescladas e linhas de subtotal. No documento Word resultante, o conteúdo de cada célula agora é um parágrafo independente, as relações entre colunas desapareceram, e "Receita Q1: $142.000" fica ao lado de "Receita Q3: $156.000" sem nenhuma indicação de que estavam em colunas diferentes. Se a tabela original tinha bordas invisíveis (uma escolha de design comum em relatórios profissionais), o conversor muitas vezes nem detecta que uma tabela existia.
Em um tópico do Reddit sobre exatamente esse problema, um usuário observou que "tabelas geralmente são a primeira coisa a quebrar durante a conversão" — e o consenso era que, para documentos com muitas tabelas, a abordagem mais limpa costuma ser remover toda a formatação e reconstruir as tabelas do zero manualmente. Isso não é uma solução; é uma rendição.
Por que o OCR causa isso
Aqui está o detalhe técnico crítico que explica tudo: o PDF não tem uma estrutura nativa de "tabela". Uma tabela em um PDF é simplesmente uma coleção de objetos de texto posicionados em um arranjo semelhante a uma grade, opcionalmente com comandos de desenho de linhas criando bordas visíveis. Não há metadados que digam "esses seis objetos de texto pertencem à mesma linha" ou "esta célula abrange duas colunas".
Um conversor baseado em OCR precisa reconstruir a tabela a partir de pistas visuais: ele procura colunas de texto alinhadas, detecta linhas de regra e tenta adivinhar quais células pertencem ao mesmo grupo. Quando o espaçamento entre colunas é irregular, quando células são mescladas, quando bordas são invisíveis ou quando o conteúdo da célula quebra em várias linhas — a inferência falha. Cada célula se torna um bloco de texto independente, sem relação com seus vizinhos.
É por isso que converter documentos digitalizados para Word com tabelas intactas tem sido um desafio tão persistente: o pipeline de OCR foi projetado para fluxos de texto, não para reconstruir estruturas de dados bidimensionais apenas a partir de coordenadas visuais.
Como o Vision AI resolve isso
O Vision AI processa tabelas da mesma forma que uma pessoa: olhando a página e entendendo a estrutura da grade. Quando ele vê colunas de texto alinhadas com espaçamento horizontal consistente e repetição linha por linha, ele reconhece uma tabela — independentemente de haver bordas visíveis. Ele preserva células mescladas, extensões de coluna e cabeçalhos hierárquicos porque entende a arquitetura visual da tabela, não apenas as coordenadas de fragmentos de texto individuais.
Para tabelas sem bordas — um formato que quebra praticamente todos os conversores baseados em OCR — o Vision AI é particularmente eficaz. Como ele depende do reconhecimento de padrões visuais em vez de heurísticas de detecção de linhas, ele pode identificar estruturas tabulares puramente pelo alinhamento e espaçamento do conteúdo.
Falha 3: Deslocamento de Imagem
Como Isso Se Parece
Seu PDF tem um gráfico na página 3 com dois parágrafos de texto explicativo organizados ao redor dele. Você converte para Word. O gráfico agora está na página 5, sobre texto não relacionado, e os dois parágrafos que deveriam envolvê-lo estão empilhados acima em um bloco confuso. Ou pior: a imagem simplesmente sumiu — um espaço em branco ou um marcador de imagem quebrada onde costumava estar o gráfico de desempenho trimestral.
Isso é especialmente frustrante com documentos repletos de imagens, como folhetos de marketing, relatórios técnicos com diagramas incorporados ou artigos acadêmicos com figuras e legendas. O texto que você precisava está lá, mas a lógica visual do documento — a relação entre imagens e o conteúdo ao redor — foi destruída.
Por Que o OCR Causa Isso
Em um PDF, imagens e texto ocupam o mesmo espaço de coordenadas, mas são armazenados como tipos de objetos totalmente separados. Uma imagem é definida pelas coordenadas da caixa delimitadora e pelos dados de pixel; o texto ao redor é definido pelas próprias coordenadas de execução do texto. Não existe uma relação explícita de "esta imagem está ancorada a este parágrafo" — o criador do documento pretendia essa relação, mas o formato PDF não a codifica.
O OCR complica ainda mais isso. Os mecanismos de OCR são projetados para processar texto — as imagens são ignoradas ou tratadas como obstáculos no fluxo de texto. Quando o conversor reconstrói o documento Word, ele precisa decidir onde colocar cada imagem. Sem entender a relação espacial entre a imagem e o texto próximo, ele frequentemente ancora as imagens em posições arbitrárias — ou as descarta completamente quando a lógica de posicionamento não encontra um ponto de ancoragem válido.
Como a Vision AI Corrige Isso
A Vision AI processa o documento de forma holística. Ela não vê "canais de texto" e "canais de imagem" como fluxos de processamento separados que precisam ser reconciliados depois — ela vê uma página com elementos visuais que têm relações espaciais. Um gráfico com texto ao redor do lado esquerdo não é um quebra-cabeça de posicionamento; é uma única cena visual que a Vision AI entende como "gráfico com texto em duas colunas à esquerda".
A saída preserva as imagens em suas posições corretas em relação ao conteúdo ao redor porque o modelo entende o documento visualmente — da mesma forma que você descreveria o layout da página para alguém que não pudesse vê-lo: "Há um gráfico de barras à direita, e o texto flui ao redor dele à esquerda."
Falha 4: Mesclagem de Parágrafos
Como Isso Se Parece
Esta é uma das falhas mais insidiosas porque é fácil de passar despercebida em uma verificação rápida. Você converte um contrato ou um relatório de PDF para Word, e tudo parece aproximadamente correto — até começar a ler. Onde deveria haver quebras de parágrafo, você encontra paredes contínuas de texto. Dois ou três parágrafos lógicos foram mesclados em um, separados apenas por uma quebra de linha regular (Shift+Enter no Word) em vez de uma quebra de parágrafo (Enter). O recuo desapareceu. A estrutura retórica do documento — o ritmo de argumento, evidência, conclusão — foi achatada em um fluxo de texto indiferenciado.
Para documentos legais, isso é perigoso. Um parágrafo mesclado pode borrar a fronteira entre uma cláusula e suas exceções. Para relatórios de negócios, isso prejudica a legibilidade. Para qualquer documento, significa que o editor agora tem que reler todo o texto e reinserir manualmente as quebras de parágrafo — uma tarefa que leva quase tanto tempo quanto redigitar o documento do zero.
Por Que o OCR Causa Isso
O OCR registra caracteres e suas coordenadas — ele não registra limites de parágrafo. Uma quebra de parágrafo em um PDF não é um caractere especial; é simplesmente um espaço vertical maior entre duas linhas de texto. O mecanismo de OCR registra isso como "linha de texto em Y=540, linha de texto em Y=520, espaço de 20 unidades" — exatamente a mesma estrutura de dados de uma quebra de linha dentro de um parágrafo, apenas com um deslocamento Y ligeiramente maior.
O conversor agora enfrenta um problema de classificação impossível: um espaço vertical de 18 pontos é uma quebra de parágrafo ou apenas um espaçamento de linha generoso? Um espaço de 24 pontos com recuo é um novo parágrafo ou um cabeçalho de seção? Sem entender o significado do texto, o conversor só pode aplicar limites heurísticos — "se espaço > X, insira quebra de parágrafo" — que funcionam para alguns documentos e falham catastroficamente para outros.
Layouts de várias colunas multiplicam o problema. Quando duas colunas ficam lado a lado, a ordem de leitura linha por linha, da esquerda para a direita, do mecanismo de OCR produz algo sem sentido: a primeira linha da coluna A concatenada com a primeira linha da coluna B, seguida pelas segundas linhas de cada coluna. O conversor não sabe sobre colunas — ele só sabe sobre coordenadas de caracteres em um plano bidimensional.
Como a IA de Visão Corrige Isso
A IA de Visão lê a página como um humano: ela enxerga colunas, reconhece padrões de indentação e distingue quebras de parágrafo ("fim de um pensamento, início de outro") de quebras de linha ("mesmo pensamento, espaço horizontal insuficiente"). Ela identifica padrões em nível de documento — indentação consistente no início de novos parágrafos, espaçamento maior entre seções, alinhamento de títulos de seção — e usa essas pistas visuais para reconstruir a estrutura lógica do documento.
Para documentos com várias colunas, a IA de Visão processa cada coluna como uma zona de leitura separada antes de mesclá-las na ordem sequencial correta — o texto completo da Coluna A, depois o texto completo da Coluna B — em vez de intercalar linhas de colunas diferentes.
Falha 5: Cabeçalhos, Rodapés e Números de Página Desaparecem
Como Isso Aparece
Seu documento convertido para Word abre. Você rola a página. Algo parece estranho, mas você não consegue identificar de imediato. Então você percebe: o cabeçalho que dizia "Confidencial — Revisão Interna Q3" em todas as páginas do PDF simplesmente sumiu. Os números de página desapareceram. O rodapé com o código de referência do documento se foi. Esses elementos — que apareciam consistentemente em todas as páginas do original — simplesmente desapareceram da saída convertida.
Em outros casos, eles não desapareceram, mas foram identificados erroneamente: o texto do cabeçalho aparece como uma frase aleatória inserida no corpo da primeira página, e o número "Página 3 de 12" fica estranhamente no meio de um parágrafo na página 3, como se fizesse parte da frase.
Por Que o OCR Causa Isso
Cabeçalhos e rodapés ocupam uma zona espacial com a qual os mecanismos de OCR têm dificuldade por dois motivos. Primeiro, eles ficam nas margens da página — áreas periféricas que muitos mecanismos de OCR tratam como baixa prioridade ou simplesmente ignoram durante a extração de texto, assumindo que o conteúdo nas margens é ruído, e não informação. Segundo, são repetitivos — o mesmo texto aparece aproximadamente na mesma posição em todas as páginas. Alguns conversores interpretam essa repetição como um artefato de impressão e a suprimem deliberadamente.
Em um PDF, não há distinção estrutural entre "este texto é um cabeçalho" e "este texto é conteúdo do corpo." Ambos são objetos de texto posicionados em coordenadas específicas. O conversor precisa inferir qual texto deve se tornar uma seção de cabeçalho/rodapé do Word e qual deve permanecer no corpo — e essa inferência depende de heurísticas frágeis sobre posição (topo/base da página) e repetição (mesmo texto em várias páginas). Quando essas heurísticas falham — quando um documento tem cabeçalhos únicos por seção, ou quando o texto do corpo acidentalmente fica na zona do cabeçalho — os resultados são imprevisíveis.
Como o Vision AI Resolve Isso
O Vision AI identifica cabeçalhos e rodapés pelo seu papel visual: texto posicionado de forma consistente nas zonas de margen superior ou inferior que se repete em todas as páginas. Ele reconhece que "Confidencial — Revisão Interna do Q3" aparecendo na mesma coordenada Y em cada página é um cabeçalho contínuo, não texto do corpo que por acaso está perto do topo da página. Ele detecta números de página pelo padrão de conteúdo (números incrementando na mesma posição entre páginas) e pelo contexto espacial (normalmente na zona de rodapé, muitas vezes acompanhado de texto "Página X de Y").
A saída preserva estes como seções nativas de cabeçalho e rodapé do Word, onde funcionam corretamente — aparecendo em todas as páginas, atualizando-se automaticamente se você adiciona ou remove páginas, comportándose exatamente como cabeçalhos e rodapés devem.
Para Além de Corregir Sintomas: Por Que a Abordagem Importa Mais Que a Ferramenta
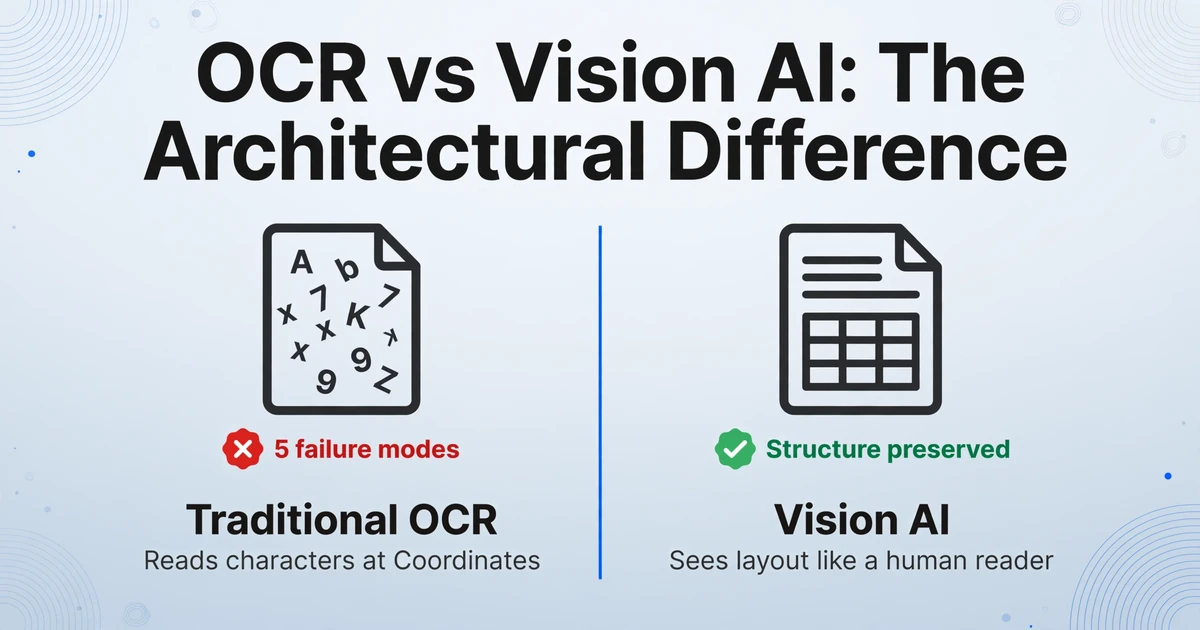
Recua e observa o que estes cinco modos de falha têm em comum. Em cada caso, a causa raíz é a mesma: OCR processa documentos como coordenadas de caracteres, não como informação visual. As fontes falham porque OCR não pode identificar metadados de tipo de letra. As tabelas se rompen porque OCR não pode inferir estrutura bidimensional de fluxos de texto unidimensionais. As imagens se deslocan porque OCR as trata como obstáculos, não como elementos. Os parágrafos se funden porque OCR não pode distinguir espaçado de parágrafo de espaçado de linha. Os cabeçalhos desaparecen porque OCR não pode reconhecer padrões de repetição espacial.
Estes não são cinco bugs separados que precisan cinco correções separadas. São uma limitación arquitetónica que se manifesta de cinco formas diferentes. E a implicación é importante: ninguna cantidad de parches ou heurísticas sobre um pipeline de OCR resolverá esto. Você pode ajustar o limiar de espaçado de parágrafo, melhorar o algoritmo de detección de tabelas, adicionar regras de substitución de fontes — e ainda assim encontrará casos de falha porque o paradigma de procesamiento subyacente (reconocimiento de caracteres sem comprensión de documento) não cambiou.
Este é o ponto onde a diferencia entre Vision AI e OCR tradicional se torna más que uma distinción académica. Vision AI não tenta reconstruir a estrutura do documento a partir de coordenadas de caracteres — ele vê o documento visualmente e comprende o layout da mesma forma que um lector humano. Ele reconoce parágrafos pelos seus padrões visuais, não por limiares de brecha vertical. Ele identifica tabelas pela sua estrutura de grade, não por algoritmos de detección de líneas. Ele preserva fontes reproduciendo jerarquías de peso visual, não buscando nomes de tipos de letra.
Para um guía completo sobre conversión de documento a Word que preserva o layout, o fluxo de trabalho é simples: envie seu documento, e o motor Vision AI analiza a página completa — texto, tabelas, imagenes, cabeçalhos, rodapés — como uma única escena visual. Ele reconstrue o documento em um formato Word editable comprendendo o que cada elemento é e como se relaciona com cada outro elemento, não adivinando a partir de dados de coordenadas.
Isso também significa que o mesmo mecanismo lida com casos extremos que quebram pipelines de OCR por completo: capturas de tela convertidas em Word editável — onde não há metadados de fonte de PDF, apenas pixels — ou documentos com conteúdo manuscrito e impresso misturado. Quando você processa o documento visualmente, o formato de origem importa muito menos. Se você está comparando ferramentas específicas, nossa comparação de conversores de Word com preservação de layout detalha como diferentes abordagens lidam com cada um desses cinco modos de falha.
Os arquivos são processados com segurança e não são armazenados.
Perguntas Frequentes
Por que meu PDF parece perfeito, mas o documento Word convertido é uma bagunça?
O PDF parece perfeito porque é um formato de layout fixo — cada elemento está preso a coordenadas exatas. O documento Word parece uma bagunça porque seu conversor teve que reconstruir parágrafos, tabelas e formatação a partir de dados de coordenadas brutos, e essa reconstrução é inerentemente perda quando feita por OCR em nível de caractere. O documento parece ótimo na tela porque era ótimo — como PDF. Convertê-lo para um formato editável significa reconstruir a estrutura lógica do documento do zero, o que é um desafio fundamentalmente diferente.
Posso incorporar todas as fontes no meu PDF para corrigir a substituição de fontes?
Incorporar fontes ajuda quando o PDF foi originalmente criado a partir de uma fonte digital (como um documento do Word salvo como PDF com fontes incorporadas). Mas para PDFs digitalizados — documentos que começaram em papel e foram digitalizados — não há fontes para incorporar. O "texto" são apenas pixels em uma imagem. O OCR precisa reconhecer as formas dos caracteres e atribuí-los a valores Unicode, mas não consegue recuperar as informações originais do tipo de fonte, pois essas informações foram perdidas quando o documento foi digitalizado. Nesses casos, a abordagem do Vision AI de preservar hierarquias de peso visual, em vez de tentar identificar tipos de fonte, é o único caminho viável para uma saída bem formatada.
Por que alguns conversores online funcionam melhor que outros para documentos específicos?
Conversores diferentes usam heurísticas de detecção de tabelas, limites de espaçamento entre parágrafos e regras de substituição de fontes distintas. Um conversor ajustado para relatórios de coluna única com espaçamento generoso entre linhas pode produzir uma saída limpa para esse tipo de documento, mas falhar completamente em um boletim informativo de várias colunas com espaçamento apertado. É por isso que você acaba pulando entre ferramentas — cada uma é calibrada para um conjunto diferente de premissas de layout de documento. Uma abordagem Vision AI contorna isso ao não depender de heurísticas específicas de layout.
Uma resolução de digitalização mais alta resolve problemas de formatação de PDF para Word?
Uma resolução de digitalização mais alta (300 DPI ou superior) melhora a precisão do reconhecimento de caracteres do OCR — menos confusões entre "0" e "O" — mas não corrige as falhas estruturais desta lista. Uma digitalização de 600 DPI ainda não dirá ao OCR onde os parágrafos começam e terminam, como as células da tabela se relacionam entre si ou onde os cabeçalhos devem ser colocados na saída. A resolução melhora a precisão do texto; ela não melhora a compreensão do layout. Essas são capacidades separadas que exigem uma abordagem de processamento fundamentalmente diferente.
Devo converter para Word ou para uma tabela estruturada?
Depende do que você precisa fazer com a saída. Se você precisa editar, revisar ou reutilizar o documento em seu layout original — um contrato que precisa de revisões de cláusulas, um relatório que precisa de atualizações de conteúdo, um folheto que precisa de alterações de texto — a saída em Word preserva o documento visual. Se você precisa analisar dados em vários documentos — extrair totais de faturas para uma planilha, comparar cotações de fornecedores em colunas — a saída de tabela estruturada (Excel/CSV) é o destino certo. Nosso framework de decisão Para Word vs Para Tabela orienta sobre como escolher com base no seu caso de uso específico.
O Vision AI consegue lidar com documentos com várias colunas e layouts complexos?
Sim — é aqui que a diferença entre OCR e Vision AI é maior. A leitura linha por linha da esquerda para a direita do OCR produz resultados confusos em documentos com várias colunas, pois mistura texto de colunas diferentes. O Vision AI processa cada coluna como uma zona visual separada antes de ordená-las na sequência correta de leitura, preservando a experiência original. Essa mesma capacidade se aplica a documentos com texto ao redor de imagens, barras laterais, caixas de destaque e outros layouts não lineares.