5 fallos de formato de PDF-a-Word
Que cuestan horas de retrabajo
Esta es una verdad que la mayoría de las herramientas de conversión de PDF no te dirán: esos fallos de formato con los que te topas una y otra vez no son errores. No son el resultado de una "mala herramienta" ni de un archivo corrupto. Son la salida matemáticamente predecible de cómo funciona realmente el OCR — y hasta que no entiendas por qué, seguirás quemando horas en reformateo manual sin importar qué herramienta pruebes.
Conclusiones clave
- Cinco fallos de formato consumen el 90% de tus horas de retrabajo posteriores a la conversión — y esta es la parte que ningún proveedor de herramientas te cuenta: no son errores, es el OCR funcionando exactamente como fue diseñado.
- El OCR no fue creado para documentos: ve los caracteres como coordenadas de píxeles en una página, lo que significa que literalmente no puede distinguir un salto de párrafo de un interlineado, una tabla de una cuadrícula de palabras, ni un encabezado del texto del cuerpo.
- Procesar el documento visualmente — reconociendo párrafos, tablas y encabezados de la misma manera que lo hace un lector humano — elimina los cinco fallos a la vez al abordar su causa raíz común, no parcheando cada síntoma.
La trampa del OCR: por qué tu conversor ve caracteres, no documentos
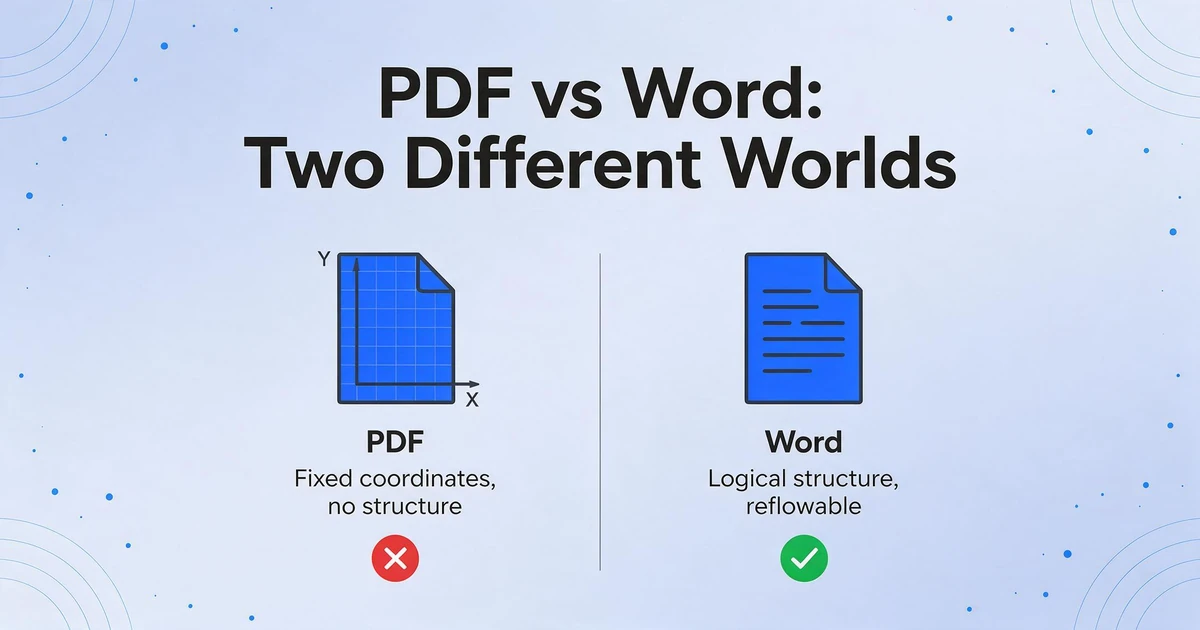
Para entender por qué ocurre cada modo de fallo de esta lista, necesitas entender una cosa: PDF y Word representan los documentos de formas fundamentalmente incompatibles.
Un PDF es esencialmente una impresión digital. Almacena cada elemento — una letra, una línea, un logotipo — como un objeto con coordenadas X/Y fijas en un plano bidimensional. El PDF "sabe" que la letra "H" está en la posición (124, 587) en Helvetica de 11pt. No sabe que "H" es la primera letra de un encabezado, ni que el encabezado pertenece a una sección, ni que la sección vive dentro de un documento con una jerarquía de información específica. Son conceptos humanos que el PDF — por diseño — no codifica.
Como dijo un usuario de Reddit: "Convertir un PDF a Word es menos como traducir un idioma y más como intentar convertir un pastel horneado de nuevo en harina, huevos y azúcar."
El OCR tradicional (reconocimiento óptico de caracteres) empeora esto. El OCR lee los píxeles de una página e intenta emparejarlos con patrones de caracteres conocidos — pero solo ve caracteres en coordenadas. No tiene concepto de por qué la conversión de PDF-a-Word pierde el formato porque nunca fue diseñado para entender documentos. Fue diseñado para leer matrículas y páginas de libros escaneados — contextos donde "¿qué significa este párrafo?" nunca fue parte del planteamiento del problema.
El resultado: cinco patrones de fallo recurrentes que explican prácticamente todas las quejas de formato en la conversión de PDF-a-Word. Esto es lo que parece cada uno, por qué lo causa el OCR y cómo un enfoque fundamentalmente diferente — Vision AI — elimina la causa raíz.
Fallo 1: Pérdida y sustitución de fuentes
Cómo se ve
Conviertes un PDF con un diseño tipográfico impecable — quizás una propuesta para un cliente en Calibri con encabezados de sección en negrita y cifras financieras en cursiva — y abres el archivo de Word resultante. Todo el documento ahora está en Times New Roman. Peor aún, el tamaño de la fuente varía ligeramente, lo que activa el motor de reflujo de Word, y de repente tu documento de 12 páginas cuidadosamente paginado se convierte en 14 páginas con encabezados huérfanos al final de las páginas.
En algunos casos, obtienes una fuente que está casi bien pero no del todo: tu texto del cuerpo en sans-serif se convierte en un sustituto sans-serif ligeramente más estrecho, y cada salto de línea se desplaza una o dos palabras. El documento es técnicamente legible, pero no se lo enviarías a un cliente en ese estado.
Por qué lo causa el OCR
Los motores de OCR reconocen formas de caracteres, no reconocen fuentes. Cuando el OCR procesa una página PDF, ve patrones de píxeles que coinciden con glifos conocidos (la letra "a" en varias formas) y genera el carácter Unicode correspondiente. Los metadatos de la fuente — qué tipografía se usó, con qué peso, con qué conjunto estilístico — se almacenan en el diccionario de fuentes del PDF (que el OCR ignora) o se pierden por completo si la fuente no estaba incrustada en el PDF.
La propia documentación de Adobe explica qué sucede después: cuando falta una fuente o no está incrustada, el sistema sustituye una tipografía Multiple Master — AdobeSerifMM para fuentes serif faltantes, AdobeSansMM para fuentes sans serif faltantes. Estas fuentes de sustitución "se estiran o condensan para ajustarse, manteniendo los saltos de línea y página" — pero "no siempre pueden coincidir con la forma de los caracteres originales". El resultado es un documento estructuralmente preservado pero visualmente incorrecto.
Para PDFs escaneados, el problema es peor: no hay metadatos de fuente. El motor de OCR está adivinando identidades de caracteres a partir de patrones de píxeles, y la información de la fuente simplemente no se puede recuperar. Cada carácter se convierte en la fuente predeterminada que asigne el convertidor.
Cómo lo soluciona Vision AI
Vision AI no intenta identificar las fuentes por nombre. En su lugar, trata el documento de forma visual: ve que cierto texto es más grande, más grueso o más claro que el texto circundante, y preserva esas relaciones visuales en el resultado. Un encabezado que es visualmente más grande y más pesado en el PDF se mostrará como un encabezado más grande y más pesado en el resultado de Word. No necesita saber que era "Calibri Bold 16pt" — solo necesita reproducir la jerarquía de peso visual que ve el lector humano.
Esta es una estrategia fundamentalmente diferente: el OCR pregunta "¿qué fuente es esta?" y falla cuando no puede responder. Vision AI pregunta "¿cómo se ve este texto en relación con todo lo demás en la página?" — una pregunta que siempre puede responder porque procesa el documento de la misma manera que lo hace un lector humano.
Fallo 2: Colapso de la estructura de la tabla
Cómo se ve
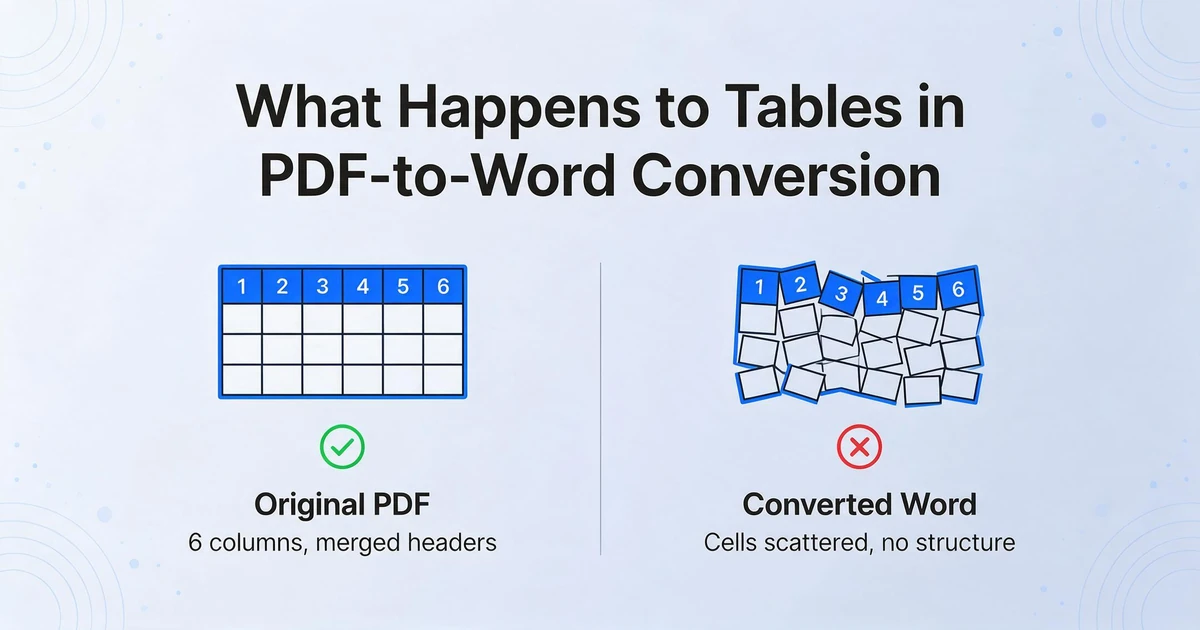
Conviertes un informe financiero con una tabla bien formateada — cifras de ingresos trimestrales en seis columnas con celdas de encabezado combinadas y filas de subtotales. En el documento de Word resultante, el contenido de cada celda es ahora un párrafo independiente, las relaciones entre columnas han desaparecido, y "Ingresos Q1: $142,000" está justo al lado de "Ingresos Q3: $156,000" sin indicación de que alguna vez estuvieron en columnas diferentes. Si la tabla original tenía bordes invisibles (una elección de diseño común en informes profesionales), el convertidor a menudo ni siquiera detecta que existía una tabla.
En un hilo de Reddit sobre este mismo problema, un usuario señaló que "las tablas suelen ser lo primero que se rompe durante la conversión" — y el consenso era que para documentos con muchas tablas, el enfoque más limpio suele ser eliminar todo el formato y reconstruir las tablas desde cero manualmente. Eso no es una solución; es rendirse.
Por qué el OCR lo causa
Aquí está el detalle técnico crítico que lo explica todo: el PDF no tiene una estructura nativa de "tabla". Una tabla en un PDF es simplemente una colección de objetos de texto posicionados en una disposición similar a una cuadrícula, opcionalmente con comandos de dibujo de líneas que crean bordes visibles. No hay metadatos que digan "estos seis objetos de texto pertenecen a la misma fila" o "esta celda abarca dos columnas".
Un convertidor basado en OCR tiene que reconstruir la tabla a partir de pistas visuales: busca columnas de texto alineadas, detecta líneas trazadas e intenta adivinar qué celdas pertenecen juntas. Cuando el espaciado de columnas es irregular, cuando las celdas están fusionadas, cuando los bordes son invisibles o cuando el contenido de una celda se divide en varias líneas, la inferencia falla. Cada celda se convierte en un bloque de texto independiente sin relación con sus vecinas.
Por eso convertir documentos escaneados a Word con tablas intactas ha sido un desafío tan persistente: el flujo de OCR fue diseñado para flujos de texto, no para reconstruir estructuras de datos bidimensionales solo a partir de coordenadas visuales.
Cómo lo soluciona Vision AI
Vision AI procesa las tablas como lo haría una persona: mirando la página y comprendiendo la estructura de la cuadrícula. Cuando ve columnas de texto alineadas con espaciado horizontal consistente y repetición fila por fila, reconoce una tabla, ya sea que haya bordes visibles o no. Preserva celdas fusionadas, extensiones de columnas y encabezados jerárquicos porque comprende la arquitectura visual de la tabla, no solo las coordenadas de fragmentos de texto individuales.
Para tablas sin bordes, un formato que rompe prácticamente todos los convertidores basados en OCR, Vision AI es particularmente eficaz. Dado que se basa en el reconocimiento de patrones visuales en lugar de heurísticas de detección de líneas, puede identificar estructuras tabulares puramente a partir de la alineación y el espaciado del contenido.
Fallo 3: Desplazamiento de imágenes
Cómo se ve
Tu PDF tiene un gráfico en la página 3 con dos párrafos de texto explicativo que lo rodean ordenadamente. Lo conviertes a Word. El gráfico ahora está en la página 5, superpuesto sobre texto del cuerpo no relacionado, y los dos párrafos que debían rodearlo están apilados arriba en un bloque desordenado. O peor: la imagen simplemente ha desaparecido — un espacio en blanco o un marcador de imagen rota donde solía estar tu gráfico de rendimiento trimestral.
Esto es especialmente frustrante con documentos cargados de imágenes, como folletos de marketing, informes técnicos con diagramas incrustados o artículos académicos con figuras y pies de foto. El texto que necesitas está ahí, pero la lógica visual del documento — la relación entre las imágenes y su contenido circundante — ha sido destruida.
Por qué lo causa el OCR
En un PDF, las imágenes y el texto ocupan el mismo espacio de coordenadas, pero se almacenan como tipos de objetos completamente separados. Una imagen se define por sus coordenadas de cuadro delimitador y datos de píxeles; el texto circundante se define por sus propias coordenadas de ejecución de texto. No existe una relación explícita de "esta imagen está anclada a este párrafo" — el creador del documento pretendía esa relación, pero el formato PDF no la codifica.
El OCR complica esto aún más. Los motores de OCR están diseñados para procesar texto: las imágenes se ignoran o se tratan como obstáculos en el flujo de texto. Cuando el convertidor reconstruye el documento de Word, tiene que decidir dónde colocar cada imagen. Sin comprender la relación espacial entre la imagen y el texto cercano, a menudo ancla las imágenes a posiciones arbitrarias — o las elimina por completo cuando la lógica de colocación no puede encontrar un punto de anclaje válido.
Cómo lo soluciona Vision AI
Vision AI procesa el documento de manera holística. No ve "canales de texto" y "canales de imagen" como flujos de procesamiento separados que deben reconciliarse más tarde — ve una página con elementos visuales que tienen relaciones espaciales. Un gráfico con texto envuelto a su lado izquierdo no es un rompecabezas de colocación; es una escena visual única que Vision AI entiende como "gráfico con ajuste de texto de dos columnas a la izquierda".
La salida preserva las imágenes en sus posiciones correctas en relación con el contenido circundante porque el modelo entiende el documento visualmente — de la misma manera en que describirías el diseño de la página a alguien que no pudiera verlo: "Hay un gráfico de barras a la derecha, y el texto fluye a su alrededor por la izquierda".
Fallo 4: Fusión de Párrafos
Cómo se Manifiesta
Este es uno de los fallos más insidiosos porque es fácil pasarlo por alto en una revisión rápida. Conviertes un contrato o un informe de PDF a Word, y todo parece más o menos correcto — hasta que empiezas a leer. Donde debería haber saltos de párrafo, encuentras muros continuos de texto. Dos o tres párrafos lógicos se han fusionado en uno, separados solo por un salto de línea normal (Shift+Enter en Word) en lugar de un salto de párrafo (Enter). La sangría ha desaparecido. La estructura retórica del documento — el ritmo de argumento, evidencia, conclusión — se ha aplanado en un flujo de texto indiferenciado.
Para documentos legales, esto es peligroso. Un párrafo fusionado puede difuminar el límite entre una cláusula y sus excepciones. Para informes empresariales, socava la legibilidad. Para cualquier documento, significa que el editor ahora tiene que releer todo el texto y reinsertar manualmente los saltos de párrafo — una tarea que lleva casi tanto tiempo como volver a escribir el documento desde cero.
Por Qué lo Causa el OCR
El OCR registra caracteres y sus coordenadas — no registra los límites de los párrafos. Un salto de párrafo en un PDF no es un carácter especial; es simplemente un espacio vertical más grande entre dos líneas de texto. El motor de OCR registra esto como "línea de texto en Y=540, línea de texto en Y=520, espacio de 20 unidades" — exactamente la misma estructura de datos que un salto de línea dentro de un párrafo, solo que con un desplazamiento Y ligeramente mayor.
El conversor ahora se enfrenta a un problema de clasificación imposible: ¿es un espacio vertical de 18 puntos un salto de párrafo o simplemente un interlineado generoso? ¿Es un espacio de 24 puntos con sangría un nuevo párrafo o un encabezado de sección? Sin comprender el significado del texto, el conversor solo puede aplicar umbrales heurísticos — "si el espacio > X, inserta un salto de párrafo" — que funcionan para algunos documentos y fallan catastróficamente para otros.
Los diseños de varias columnas multiplican el problema. Cuando dos columnas están una al lado de la otra, el orden de lectura línea por línea de izquierda a derecha del motor de OCR produce un galimatías: la primera línea de la columna A concatenada con la primera línea de la columna B, seguida de las segundas líneas de cada columna. El conversor no sabe nada sobre columnas — solo conoce las coordenadas de los caracteres en un plano bidimensional.
Cómo lo Soluciona Vision AI
Vision AI lee la página como lo haría un humano: ve columnas, reconoce patrones de sangría y distingue los saltos de párrafo ("fin de una idea, comienzo de otra") de los saltos de línea ("misma idea, se acabó el espacio horizontal"). Identifica patrones a nivel de documento — sangría consistente al inicio de nuevos párrafos, mayor espaciado entre secciones, alineación de encabezados de sección — y utiliza estas señales visuales para reconstruir la estructura lógica del documento.
Para documentos de varias columnas, Vision AI procesa cada columna como una zona de lectura separada antes de fusionarlas en el orden secuencial correcto — el texto completo de la Columna A, luego el texto completo de la Columna B — en lugar de intercalar líneas de diferentes columnas.
Fallo 5: Encabezados, Pies de Página y Números de Página Desaparecen
Cómo Se Ve
Tu documento de Word convertido se abre. Te desplazas por él. Algo parece fuera de lugar, pero no puedes identificarlo de inmediato. Entonces te das cuenta: el encabezado corrido que decía "Confidencial — Revisión Interna del T3" en cada página del PDF no aparece por ningún lado. Los números de página han desaparecido. El pie de página con el código de referencia del documento se ha esfumado. Estos elementos — que aparecían de manera consistente en cada página del original — simplemente han desaparecido de la salida convertida.
En otros casos, no han desaparecido sino que han sido mal identificados: el texto del encabezado aparece como una oración aleatoria insertada en el cuerpo de la primera página, y el número de página "Página 3 de 12" se sitúa de manera incómoda en medio de un párrafo de la página 3, como si fuera parte de la oración.
Por Qué el OCR lo Causa
Los encabezados y pies de página ocupan una zona espacial con la que los motores de OCR tienen dificultades por dos razones. Primero, se encuentran en los márgenes de la página — áreas periféricas que muchos motores de OCR tratan como de baja prioridad o simplemente omiten durante la extracción de texto, asumiendo que el contenido en los márgenes es ruido en lugar de información. Segundo, son repetitivos — el mismo texto aparece aproximadamente en la misma posición en cada página. Algunos convertidores interpretan esta repetición como un artefacto de impresión y la suprimen deliberadamente.
En un PDF, no existe una distinción estructural entre "este texto es un encabezado" y "este texto es contenido del cuerpo". Ambos son objetos de texto posicionados en coordenadas específicas. El convertidor tiene que inferir qué texto debería convertirse en una sección de encabezado/pie de página de Word y cuál debería permanecer en el cuerpo — y esta inferencia se basa en heurísticas frágiles sobre la posición (parte superior/inferior de la página) y la repetición (mismo texto en múltiples páginas). Cuando estas heurísticas fallan — cuando un documento tiene encabezados únicos por sección, o cuando el texto del cuerpo se sitúa accidentalmente en la zona de encabezado — los resultados son impredecibles.
Cómo lo soluciona Vision AI
Vision AI identifica encabezados y pies de página por su función visual: texto posicionado de manera consistente en los márgenes superior o inferior que se repite en todas las páginas. Reconoce que "Confidencial — Revisión Interna del T3" que aparece en la misma coordenada Y en cada página es un encabezado corrido, no texto del cuerpo que casualmente está cerca de la parte superior. Detecta números de página por su patrón de contenido (números incrementales en la misma posición en todas las páginas) y su contexto espacial (normalmente en la zona del pie de página, a menudo acompañados de texto "Página X de Y").
La salida conserva estos como secciones nativas de encabezado y pie de página de Word, donde funcionan correctamente: aparecen en cada página, se actualizan automáticamente si agregas o eliminas páginas, y se comportan exactamente como deben hacerlo los encabezados y pies de página.
Más allá de parchear síntomas: por qué el enfoque importa más que la herramienta
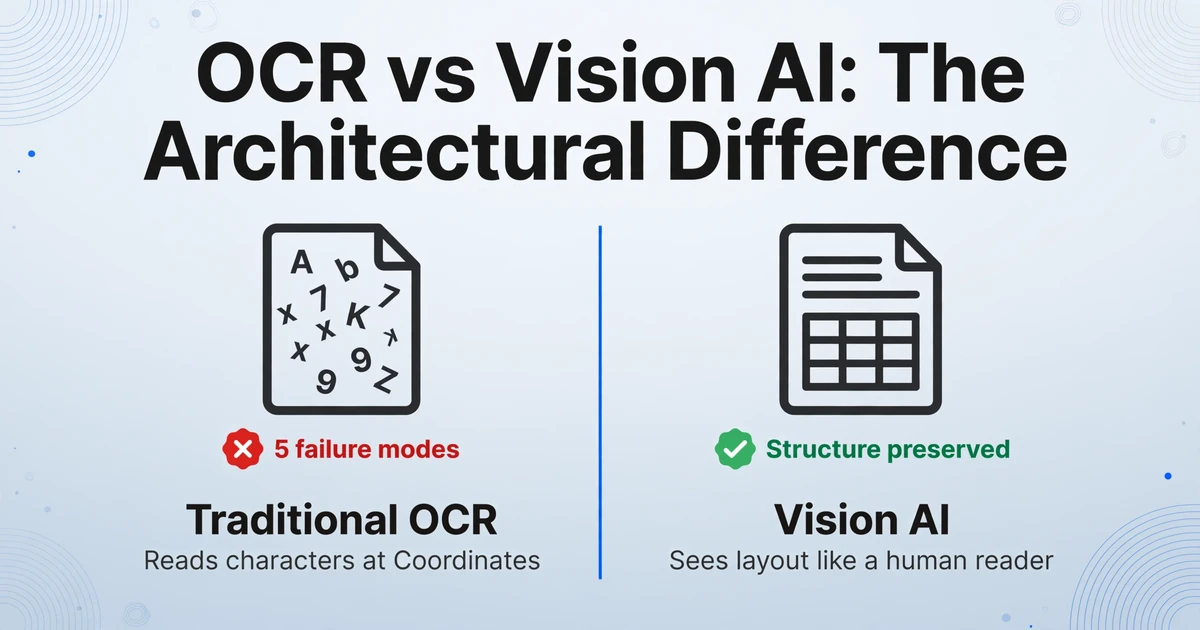
Da un paso atrás y observa qué tienen en común estos cinco modos de fallo. En cada caso, la causa raíz es la misma: el OCR procesa documentos como coordenadas de caracteres, no como información visual. Las fuentes fallan porque el OCR no puede identificar metadatos de tipografía. Las tablas se rompen porque el OCR no puede inferir estructura bidimensional a partir de flujos de texto unidimensionales. Las imágenes se desplazan porque el OCR las trata como obstáculos, no como elementos. Los párrafos se fusionan porque el OCR no puede distinguir el espaciado entre párrafos del espaciado entre líneas. Los encabezados desaparecen porque el OCR no puede reconocer patrones de repetición espacial.
Estos no son cinco errores separados que necesitan cinco correcciones separadas. Son una limitación arquitectónica que se manifiesta de cinco maneras diferentes. Y la implicación es importante: ninguna cantidad de parches o heurísticas sobre un pipeline de OCR resolverá esto. Puedes ajustar el umbral de espaciado entre párrafos, mejorar el algoritmo de detección de tablas, agregar reglas de sustitución de fuentes — y aún así encontrarás casos de fallo porque el paradigma de procesamiento subyacente (reconocimiento de caracteres sin comprensión del documento) no ha cambiado.
Aquí es donde la diferencia entre Vision AI y el OCR tradicional se vuelve más que una distinción académica. Vision AI no intenta reconstruir la estructura del documento a partir de coordenadas de caracteres — ve el documento visualmente y entiende el diseño como lo haría un lector humano. Reconoce párrafos por sus patrones visuales, no por umbrales de espacio vertical. Identifica tablas por su estructura de cuadrícula, no por algoritmos de detección de líneas. Conserva fuentes reproduciendo jerarquías de peso visual, no buscando nombres de tipografías.
Para una guía completa sobre conversión de documento a Word que conserva el diseño, el flujo de trabajo es sencillo: sube tu documento, y el motor de Vision AI analiza la página completa — texto, tablas, imágenes, encabezados, pies de página — como una sola escena visual. Reconstruye el documento en un formato de Word editable al entender qué es cada elemento y cómo se relaciona con los demás, no adivinando a partir de datos de coordenadas.
Esto también significa que el mismo motor maneja casos límite que rompen por completo los flujos de OCR: capturas de pantalla convertidas a Word editable — donde no hay metadatos de fuente PDF, solo píxeles — o documentos con contenido manuscrito e impreso mezclado. Cuando procesas el documento visualmente, el formato de origen importa mucho menos. Si estás comparando herramientas específicas, nuestra comparativa de conversores a Word que preservan el diseño desglosa cómo diferentes enfoques manejan cada uno de estos cinco modos de fallo.
Los archivos se procesan de forma segura y no se almacenan.
Preguntas Frecuentes
¿Por qué mi PDF se ve perfecto pero el documento de Word convertido es un desastre?
El PDF se ve perfecto porque es un formato de diseño fijo: cada elemento está anclado a coordenadas exactas. El documento de Word se ve como un desastre porque tu convertidor tuvo que reconstruir párrafos, tablas y formato a partir de datos de coordenadas brutos, y esa reconstrucción es inherentemente pérdida cuando se hace con OCR a nivel de caracteres. El documento se ve genial en pantalla porque era genial — como PDF. Convertirlo a un formato editable significa reconstruir la estructura lógica del documento desde cero, lo cual es un desafío fundamentalmente diferente.
¿Puedo simplemente incrustar todas las fuentes en mi PDF para solucionar la sustitución de fuentes?
Incrustar fuentes ayuda cuando el PDF se creó originalmente desde una fuente digital (como un documento de Word guardado como PDF con fuentes incrustadas). Pero para PDFs escaneados — documentos que comenzaron en papel y fueron digitalizados — no hay fuentes que incrustar. El "texto" son solo píxeles en una imagen. El OCR debe reconocer las formas de los caracteres y asignarlas a valores Unicode, pero no puede recuperar la información del tipo de letra original porque esa información se perdió cuando se escaneó el documento. En estos casos, el enfoque de Vision AI de preservar las jerarquías visuales de peso en lugar de intentar identificar tipos de letra es el único camino viable hacia un resultado bien formateado.
¿Por qué algunos convertidores en línea funcionan mejor que otros para documentos específicos?
Diferentes convertidores usan diferentes heurísticas de detección de tablas, umbrales de espaciado entre párrafos y reglas de sustitución de fuentes. Un convertidor ajustado para informes de una sola columna con espaciado generoso puede producir resultados limpios para ese tipo de documento, pero fallar por completo en un boletín de múltiples columnas con espaciado ajustado. Por eso te encuentras saltando entre herramientas — cada una está calibrada para un conjunto diferente de supuestos de diseño de documentos. Un enfoque de Vision AI evita esto al no depender de heurísticas específicas de diseño.
¿Una mayor resolución de escaneo soluciona los problemas de formato en PDF-a-Word?
Una mayor resolución de escaneo (300 DPI o más) mejora la precisión del reconocimiento de caracteres del OCR — menos confusiones entre "0" y "O" — pero no soluciona los fallos estructurales de esta lista. Un escaneo de 600 DPI aún no le dirá al OCR dónde comienzan y terminan los párrafos, cómo se relacionan las celdas de las tablas entre sí, o dónde deben colocarse los encabezados en el resultado. La resolución mejora la precisión del texto; no mejora la comprensión del diseño. Son capacidades separadas que requieren un enfoque de procesamiento fundamentalmente diferente.
¿Debo convertir a Word o a una tabla estructurada?
Depende de lo que necesites hacer con el resultado. Si necesitas editar, revisar o reutilizar el documento en su diseño original — un contrato que requiere revisiones de cláusulas, un informe que necesita actualizaciones de contenido, un folleto que requiere cambios de texto — el resultado en Word preserva el documento visual. Si necesitas analizar datos de múltiples documentos — extrayendo totales de facturas a una hoja de cálculo, comparando cotizaciones de proveedores en columnas — el resultado en tabla estructurada (Excel/CSV) es el objetivo correcto. Nuestro marco de decisión A Word vs A Tabla te guía sobre cómo elegir según tu caso de uso específico.
¿La IA de visión puede manejar documentos con varias columnas y diseños complejos?
Sí — aquí es donde la brecha entre OCR e IA de visión es más amplia. La lectura línea por línea de izquierda a derecha del OCR produce resultados confusos en documentos de varias columnas, ya que mezcla texto de diferentes columnas. La IA de visión procesa cada columna como una zona visual separada antes de ordenarlas en la secuencia correcta, preservando la experiencia de lectura original. Esta misma capacidad aplica a documentos con texto que fluye alrededor de imágenes, barras laterales, cuadros de llamada y otros diseños no lineales.