5 PDF-zu-Word-Formatierungsfehler
Die Stunden an Nacharbeit kosten
Hier ist eine Wahrheit, die die meisten PDF-Konverter-Tools Ihnen nicht verraten: Diese Formatierungsfehler, auf die Sie immer wieder stoßen, sind keine Bugs. Sie sind nicht das Ergebnis eines „schlechten Tools" oder einer beschädigten Datei. Sie sind das mathematisch vorhersehbare Ergebnis davon, wie OCR tatsächlich funktioniert – und bis Sie verstehen, warum, werden Sie weiterhin Stunden mit manueller Neuformatierung verschwenden, egal welches Tool Sie ausprobieren.
Wichtigste Erkenntnisse
- Fünf Formatierungsfehler verursachen 90 % Ihrer Nachbearbeitungsstunden – und hier ist der Teil, den Ihnen kein Tool-Anbieter verrät: Es sind keine Bugs, sondern OCR, die genau wie vorgesehen funktioniert.
- OCR wurde nicht für Dokumente entwickelt – sie erkennt Zeichen als Pixelkoordinaten auf einer Seite, was bedeutet, dass sie buchstäblich keinen Absatzumbruch von Zeilenabstand, keine Tabelle von einem Wortraster und keine Kopfzeile von Fließtext unterscheiden kann.
- Die visuelle Verarbeitung des Dokuments – das Erkennen von Absätzen, Tabellen und Kopfzeilen so, wie es ein menschlicher Leser tut – beseitigt alle fünf Fehler auf einmal, indem sie die gemeinsame Ursache angeht, statt jedes Symptom einzeln zu flicken.
Die OCR-Falle: Warum Ihr Konverter Zeichen sieht, aber keine Dokumente
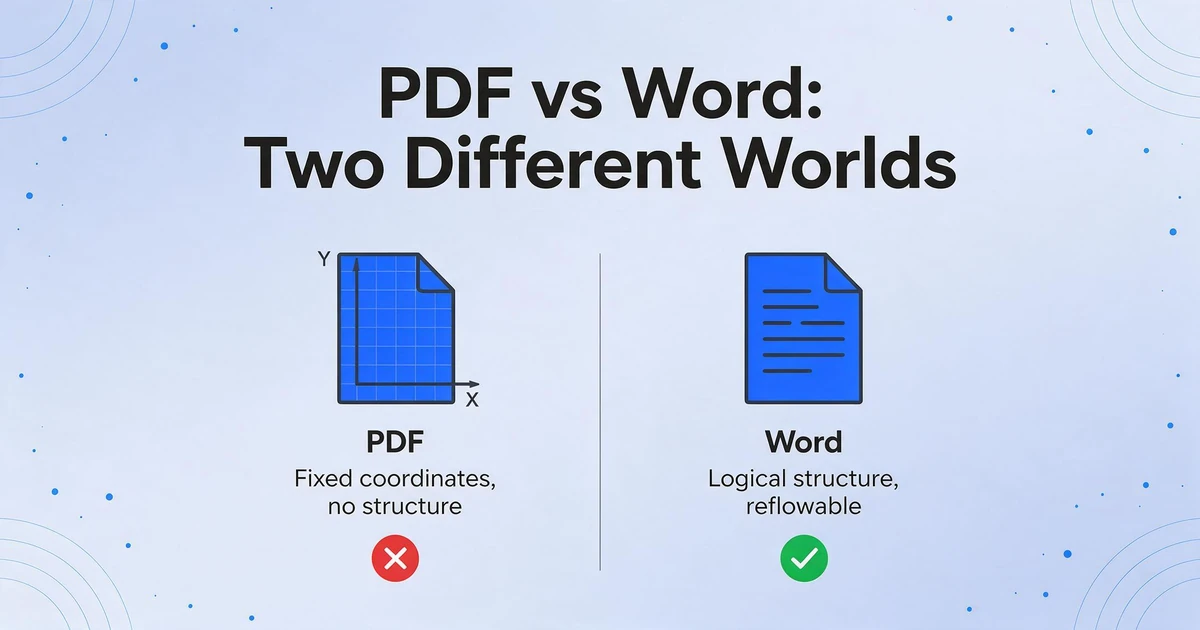
Um zu verstehen, warum jede Fehlerart auf dieser Liste auftritt, müssen Sie eines verstehen: PDF und Word stellen Dokumente auf grundlegend inkompatible Weise dar.
Ein PDF ist im Wesentlichen ein digitaler Ausdruck. Es speichert jedes Element — einen Buchstaben, eine Linie, ein Logo — als Objekt mit festen X/Y-Koordinaten auf einer zweidimensionalen Ebene. Das PDF „weiß", dass der Buchstabe „H" an Position (124, 587) in 11pt Helvetica sitzt. Es weiß nicht, dass „H" der erste Buchstabe einer Überschrift ist, oder dass die Überschrift zu einem Abschnitt gehört, oder dass der Abschnitt in einem Dokument mit einer bestimmten Informationshierarchie lebt. Das sind menschliche Konzepte, die PDF — bewusst — nicht kodiert.
Wie ein Reddit-Nutzer es formulierte: „Eine PDF in Word zu konvertieren ist weniger wie das Übersetzen einer Sprache und eher wie der Versuch, einen gebackenen Kuchen wieder in Mehl, Eier und Zucker zu verwandeln."
Traditionelle OCR (Optische Zeichenerkennung) macht das noch schlimmer. OCR liest die Pixel auf einer Seite und versucht, sie mit bekannten Zeichenmustern abzugleichen — aber sie sieht nur Zeichen an Koordinaten. Sie hat kein Konzept dafür, warum die PDF-zu-Word-Konvertierung Formatierung verliert, weil sie nie dafür entwickelt wurde, Dokumente zu verstehen. Sie wurde entwickelt, um Nummernschilder und gescannte Buchseiten zu lesen — Kontexte, in denen „Was bedeutet dieser Absatz?" nie Teil der Problemstellung war.
Das Ergebnis: fünf wiederkehrende Fehlermuster, die für praktisch alle Beschwerden über die Formatierung bei der PDF-zu-Word-Konvertierung verantwortlich sind. Hier sehen Sie, wie jedes aussieht, warum OCR es verursacht und wie ein grundlegend anderer Ansatz — Vision AI — die Ursache beseitigt.
Fehler 1: Schriftverlust und -ersetzung
Wie es aussieht
Sie konvertieren ein schön gesetztes PDF — vielleicht einen Kundenentwurf in Calibri mit fetten Abschnittsüberschriften und kursiven Finanzzahlen — und öffnen die resultierende Word-Datei. Das gesamte Dokument ist jetzt in Times New Roman. Schlimmer noch: Die Schriftgröße weicht leicht ab, was Word-Umbruchmechanik auslöst, und plötzlich ist Ihr sorgfältig paginiertes 12-seitiges Dokument zu 14 Seiten geworden, mit verwaisten Überschriften am Seitenende.
In manchen Fällen erhalten Sie eine Schrift, die fast richtig ist, aber nicht ganz — Ihr serifenloser Fließtext wird zu einer etwas schmaleren serifenlosen Ersatzschrift, und jeder Zeilenumbruch verschiebt sich um ein oder zwei Wörter. Das Dokument ist technisch lesbar, aber in diesem Zustand würden Sie es keinem Kunden schicken.
Warum OCR das verursacht
OCR-Engines erkennen Zeichenformen — sie erkennen keine Schriften. Wenn OCR eine PDF-Seite verarbeitet, sieht es Pixelmuster, die bekannten Glyphen entsprechen (der Buchstabe „a" in verschiedenen Formen) und gibt das entsprechende Unicode-Zeichen aus. Die Schriftmetadaten — welche Schriftart verwendet wurde, in welcher Stärke, mit welchem stilistischen Satz — sind entweder im Schriftwörterbuch des PDFs gespeichert (das OCR ignoriert) oder gehen vollständig verloren, wenn die Schrift nicht in das PDF eingebettet war.
Adobes eigene Dokumentation erklärt, was als Nächstes passiert: Wenn eine Schrift fehlt oder nicht eingebettet ist, ersetzt das System eine Multiple-Master-Schriftart — AdobeSerifMM für fehlende Serifenschriften, AdobeSansMM für fehlende serifenlose Schriften. Diese Ersatzschriften „dehnen oder stauchen sich, um Zeilen- und Seitenumbrüche beizubehalten" — aber sie „können die Form der ursprünglichen Zeichen nicht immer exakt treffen." Das Ergebnis ist ein Dokument, das strukturell erhalten bleibt, aber visuell falsch ist.
Bei gescannten PDFs ist das Problem schlimmer: Es gibt keine Schriftmetadaten. Die OCR-Engine rät die Zeichenidentitäten aus Pixelmustern, und Schriftinformationen sind schlicht nicht wiederherstellbar. Jedes Zeichen wird zu der Standardschrift, die der Konverter zuweist.
Wie Vision AI das Problem löst
Vision AI versucht nicht, Schriftarten namentlich zu identifizieren. Stattdessen behandelt es das Dokument visuell – es erkennt, dass bestimmter Text größer, fetter oder heller ist als der umgebende Text, und bewahrt diese visuellen Beziehungen in der Ausgabe. Eine Überschrift, die im PDF visuell größer und schwerer ist, wird als größere und schwerere Überschrift in der Word-Ausgabe dargestellt. Es muss nicht wissen, dass es sich um „Calibri Bold 16pt" handelte – es muss nur die visuelle Gewichtungshierarchie reproduzieren, die der menschliche Leser sieht.
Dies ist eine grundlegend andere Strategie: OCR fragt „Welche Schriftart ist das?" und scheitert, wenn es keine Antwort geben kann. Vision AI fragt „Wie sieht dieser Text im Verhältnis zu allem anderen auf der Seite aus?" – eine Frage, die es immer beantworten kann, weil es das Dokument auf dieselbe Weise verarbeitet wie ein menschlicher Leser.
Fehler 2: Zusammenbruch der Tabellenstruktur
Wie es aussieht
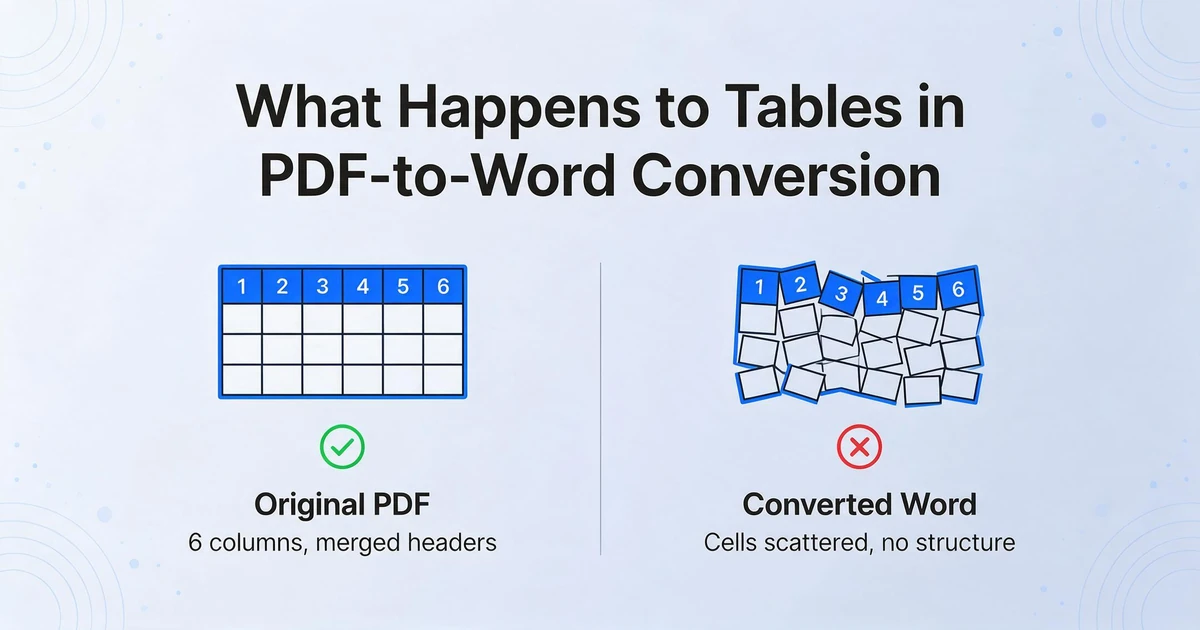
Sie konvertieren einen Finanzbericht mit einer sauber formatierten Tabelle – vierteljährliche Umsatzzahlen über sechs Spalten mit zusammengeführten Kopfzellen und Zwischensummenzeilen. Im resultierenden Word-Dokument ist der Inhalt jeder Zelle nun ein eigenständiger Absatz, die Spaltenbeziehungen sind verloren gegangen, und „Q1-Umsatz: $142.000" steht direkt neben „Q3-Umsatz: $156.000", ohne Hinweis darauf, dass sie jemals in verschiedenen Spalten standen. Wenn die Originaltabelle unsichtbare Ränder hatte (eine häufige Designentscheidung in professionellen Berichten), erkennt der Konverter oft nicht einmal, dass überhaupt eine Tabelle existierte.
In einem Reddit-Thread zu genau diesem Problem stellte ein Nutzer fest, dass „Tabellen normalerweise das Erste sind, was bei der Konvertierung kaputtgeht" – und der Konsens war, dass bei tabellenlastigen Dokumenten der sauberste Ansatz oft darin besteht, die gesamte Formatierung zu entfernen und die Tabellen von Grund auf manuell neu aufzubauen. Das ist keine Lösung; das ist Kapitulation.
Warum OCR das verursacht
Hier ist das entscheidende technische Detail, das alles erklärt: PDF hat keine native "Tabellen"-Struktur. Eine Tabelle in einem PDF ist einfach eine Sammlung von Textobjekten, die in einer gitterartigen Anordnung positioniert sind, optional mit Linienzeichnungsbefehlen, die sichtbare Ränder erzeugen. Es gibt keine Metadaten, die besagen "diese sechs Textobjekte gehören zur selben Zeile" oder "diese Zelle erstreckt sich über zwei Spalten."
Ein OCR-basierter Konverter muss die Tabelle aus visuellen Hinweisen rekonstruieren: Er sucht nach ausgerichteten Textspalten, erkennt Linien und versucht zu erraten, welche Zellen zusammengehören. Wenn der Spaltenabstand unregelmäßig ist, wenn Zellen zusammengeführt sind, wenn Ränder unsichtbar sind oder wenn Zellinhalte über mehrere Zeilen umbrechen — schlägt die Inferenz fehl. Jede Zelle wird zu einem unabhängigen Textblock ohne Beziehung zu seinen Nachbarn.
Deshalb ist das Konvertieren gescannter Dokumente in Word mit intakten Tabellen eine so hartnäckige Herausforderung: Die OCR-Pipeline wurde für Textströme entwickelt, nicht für die Rekonstruktion zweidimensionaler Datenstrukturen allein aus visuellen Koordinaten.
Wie Vision AI das behebt
Vision AI verarbeitet Tabellen so, wie es ein Mensch tut: indem es auf die Seite schaut und die Gitterstruktur versteht. Wenn es ausgerichtete Textspalten mit konsistentem horizontalem Abstand und zeilenweiser Wiederholung sieht, erkennt es eine Tabelle — ob mit oder ohne sichtbare Ränder. Es erhält zusammengeführte Zellen, Spaltenübergreifungen und hierarchische Kopfzeilen, weil es die visuelle Architektur der Tabelle versteht, nicht nur die Koordinaten einzelner Textfragmente.
Für randlose Tabellen — ein Format, das praktisch jeden OCR-basierten Konverter zum Scheitern bringt — ist Vision AI besonders effektiv. Da es auf visuelle Mustererkennung statt auf Linienerkennungs-Heuristiken setzt, kann es tabellarische Strukturen allein aus der Ausrichtung und dem Abstand des Inhalts identifizieren.
Fehler 3: Bildverschiebung
So sieht es aus
Ihr PDF enthält auf Seite 3 ein Diagramm mit zwei Absätzen erklärendem Text, die sauber darum herum angeordnet sind. Sie konvertieren in Word. Das Diagramm befindet sich nun auf Seite 5, liegt auf nicht zusammenhängendem Fließtext, und die beiden Absätze, die darum herum angeordnet sein sollten, stapeln sich darüber in einem ungeordneten Block. Oder schlimmer: Das Bild ist einfach verschwunden – ein leerer Bereich oder ein Platzhalter für ein defektes Bild, wo sich früher Ihr Quartalsdiagramm befand.
Das ist besonders frustrierend bei bildlastigen Dokumenten wie Marketingbroschüren, technischen Berichten mit eingebetteten Diagrammen oder wissenschaftlichen Arbeiten mit Abbildungen und Bildunterschriften. Der benötigte Text ist vorhanden, aber die visuelle Logik des Dokuments – die Beziehung zwischen Bildern und ihrem umgebenden Inhalt – wurde zerstört.
Warum OCR dies verursacht
In einem PDF belegen Bilder und Text denselben Koordinatenraum, werden jedoch als völlig getrennte Objekttypen gespeichert. Ein Bild wird durch seine Begrenzungsrahmen-Koordinaten und Pixeldaten definiert; umgebender Text wird durch seine eigenen Textlauf-Koordinaten definiert. Es gibt keine explizite Beziehung „dieses Bild ist an diesen Absatz gebunden“ – der Ersteller des Dokuments hat diese Beziehung beabsichtigt, aber das PDF-Format codiert sie nicht.
OCR verkompliziert dies weiter. OCR-Engines sind darauf ausgelegt, Text zu verarbeiten – Bilder werden entweder ignoriert oder als Hindernisse im Textfluss behandelt. Wenn der Konverter das Word-Dokument rekonstruiert, muss er entscheiden, wo jedes Bild platziert wird. Ohne Verständnis der räumlichen Beziehung zwischen Bild und nahegelegenem Text verankert er Bilder oft an willkürlichen Positionen – oder verwirft sie vollständig, wenn die Platzierungslogik keinen gültigen Ankerpunkt findet.
Wie Vision AI das behebt
Vision AI verarbeitet das Dokument ganzheitlich. Es betrachtet „Textkanäle“ und „Bildkanäle“ nicht als getrennte Verarbeitungsströme, die später abgeglichen werden müssen – es sieht eine Seite mit visuellen Elementen, die räumliche Beziehungen haben. Ein Diagramm mit Text, der um seine linke Seite umbrochen ist, ist kein Platzierungsrätsel; es ist eine einzige visuelle Szene, die Vision AI als „Diagramm mit zweispaltigem Textumbruch links“ versteht.
Die Ausgabe bewahrt Bilder an ihren korrekten Positionen relativ zum umgebenden Inhalt, weil das Modell das Dokument visuell versteht – genauso, wie Sie jemandem, der es nicht sehen kann, das Seitenlayout beschreiben würden: „Rechts ist ein Balkendiagramm, und der Text fließt links darum herum.“
Fehler 4: Absatzzusammenführung
Wie es aussieht
Dies ist einer der tückischsten Fehler, da er bei einer schnellen Überprüfung leicht übersehen wird. Sie konvertieren einen Vertrag oder einen Bericht von PDF zu Word, und alles sieht ungefähr richtig aus – bis Sie zu lesen beginnen. Wo Absatzumbrüche sein sollten, finden Sie durchgehende Textwände. Zwei oder drei logische Absätze wurden zu einem zusammengeführt, getrennt nur durch einen normalen Zeilenumbruch (Umschalt+Eingabetaste in Word) statt durch einen Absatzumbruch (Eingabetaste). Die Einrückung fehlt. Die rhetorische Struktur des Dokuments – der Rhythmus von Argument, Beleg, Schlussfolgerung – wurde zu einem undifferenzierten Textstrom eingeebnet.
Bei juristischen Dokumenten ist dies gefährlich. Ein zusammengeführter Absatz kann die Grenze zwischen einer Klausel und ihren Ausnahmen verwischen. Bei Geschäftsberichten untergräbt er die Lesbarkeit. Bei jedem Dokument bedeutet es, dass der Redakteur nun den gesamten Text erneut lesen und Absatzumbrüche manuell einfügen muss – eine Aufgabe, die fast so lange dauert wie das Neuabtippen des Dokuments.
Warum OCR dies verursacht
OCR erfasst Zeichen und deren Koordinaten – es erfasst keine Absatzgrenzen. Ein Absatzumbruch in einem PDF ist kein Sonderzeichen; es ist einfach ein größerer vertikaler Abstand zwischen zwei Textzeilen. Die OCR-Engine registriert dies als „Textzeile bei Y=540, Textzeile bei Y=520, Abstand von 20 Einheiten“ – exakt dieselbe Datenstruktur wie ein Zeilenumbruch innerhalb eines Absatzes, nur mit einem etwas größeren Y-Versatz.
Der Konverter steht nun vor einem unmöglichen Klassifizierungsproblem: Ist ein vertikaler Abstand von 18 Punkten ein Absatzumbruch oder nur großzügiger Zeilenabstand? Ist ein Abstand von 24 Punkten mit Einrückung ein neuer Absatz oder eine Abschnittsüberschrift? Ohne die Bedeutung des Textes zu verstehen, kann der Konverter nur heuristische Schwellenwerte anwenden – „wenn Abstand > X, Absatzumbruch einfügen“ – die für einige Dokumente funktionieren und bei anderen katastrophal versagen.
Mehrspaltige Layouts vervielfachen das Problem. Wenn zwei Spalten nebeneinander stehen, erzeugt die zeilenweise Lesereihenfolge der OCR-Engine von links nach rechts Unsinn: die erste Zeile von Spalte A verkettet mit der ersten Zeile von Spalte B, gefolgt von den zweiten Zeilen jeder Spalte. Der Konverter weiß nichts von Spalten – er kennt nur Zeichenkoordinaten auf einer zweidimensionalen Ebene.
Wie Vision AI das Problem löst
Vision AI liest die Seite so, wie es ein Mensch tut: Es erkennt Spalten, erkennt Einrückungsmuster und unterscheidet Absatzumbrüche („Ende eines Gedankens, Anfang eines neuen") von Zeilenumbrüchen („gleicher Gedanke, horizontaler Platz ging aus"). Es identifiziert dokumentweite Muster – konsistente Einrückung am Anfang neuer Absätze, größere Abstände zwischen Abschnitten, Ausrichtung von Abschnittsüberschriften – und nutzt diese visuellen Hinweise, um die logische Struktur des Dokuments zu rekonstruieren.
Bei mehrspaltigen Dokumenten verarbeitet Vision AI jede Spalte als separaten Lesebereich, bevor sie in der korrekten sequenziellen Reihenfolge zusammengeführt werden – der vollständige Text von Spalte A, dann der vollständige Text von Spalte B – statt Zeilen aus verschiedenen Spalten zu verschachteln.
Fehler 5: Kopf- und Fußzeilen sowie Seitenzahlen verschwinden
Wie es aussieht
Ihr konvertiertes Word-Dokument wird geöffnet. Sie blättern hindurch. Etwas wirkt seltsam, aber Sie können es nicht sofort benennen. Dann bemerken Sie es: Die laufende Kopfzeile mit „Vertraulich – Q3 Interne Überprüfung" auf jeder Seite des PDFs ist nirgends zu finden. Die Seitenzahlen sind verschwunden. Die Fußzeile mit dem Dokumentreferenzcode ist ebenfalls verschwunden. Diese Elemente – die auf jeder Seite des Originals konsistent erschienen – sind einfach aus der konvertierten Ausgabe verschwunden.
In anderen Fällen sind sie nicht verschwunden, sondern wurden falsch identifiziert: Der Kopfzeilentext erscheint als zufälliger Satz im Textkörper der ersten Seite, und die Seitenzahl „Seite 3 von 12" sitzt unpassend mitten in einem Absatz auf Seite 3, als wäre sie Teil des Satzes.
Warum OCR das verursacht
Kopf- und Fußzeilen befinden sich in einem räumlichen Bereich, mit dem OCR-Engines aus zwei Gründen Schwierigkeiten haben. Erstens befinden sie sich in den Seitenrändern – Randbereichen, die viele OCR-Engines als niedrig priorisiert behandeln oder bei der Textextraktion einfach überspringen, da sie davon ausgehen, dass Inhalt in den Rändern Rauschen und keine Information ist. Zweitens sind sie repetitiv – derselbe Text erscheint auf jeder Seite ungefähr an derselben Position. Einige Konverter interpretieren diese Wiederholung als Druckartefakt und unterdrücken sie bewusst.
In einem PDF gibt es keine strukturelle Unterscheidung zwischen „dieser Text ist eine Kopfzeile" und „dieser Text ist Textkörper". Beides sind Textobjekte an bestimmten Koordinaten. Der Konverter muss ableiten, welcher Text zu einem Word-Kopf-/Fußzeilenbereich werden soll und welcher im Textkörper bleiben soll – und diese Ableitung stützt sich auf fragile Heuristiken zu Position (oben/unten auf der Seite) und Wiederholung (gleicher Text auf mehreren Seiten). Wenn diese Heuristiken versagen – wenn ein Dokument abschnittsweise unterschiedliche Kopfzeilen hat oder wenn Textkörper zufällig im Kopfzeilenbereich liegt – sind die Ergebnisse unvorhersehbar.
Wie Vision AI das Problem löst
Vision AI erkennt Kopf- und Fußzeilen anhand ihrer visuellen Rolle: konsistent positionierter Text in den oberen oder unteren Randbereichen, der sich über Seiten wiederholt. Es erkennt, dass „Vertraulich – Q3-Interner Review" auf jeder Seite an derselben Y-Koordinate erscheint, als laufende Kopfzeile und nicht als Fließtext, der zufällig oben auf der Seite steht. Es erkennt Seitenzahlen anhand ihres Inhaltsmusters (fortlaufende Zahlen an derselben Position über Seiten hinweg) und ihres räumlichen Kontexts (typischerweise im Fußzeilenbereich, oft begleitet von „Seite X von Y"-Text).
Die Ausgabe bewahrt diese als native Word-Kopf- und -Fußzeilenabschnitte, wo sie korrekt funktionieren – sie erscheinen auf jeder Seite, aktualisieren sich automatisch, wenn Sie Seiten hinzufügen oder entfernen, und verhalten sich genau so, wie sich Kopf- und Fußzeilen verhalten sollten.
Über das Flicken von Symptomen hinaus: Warum der Ansatz wichtiger ist als das Werkzeug
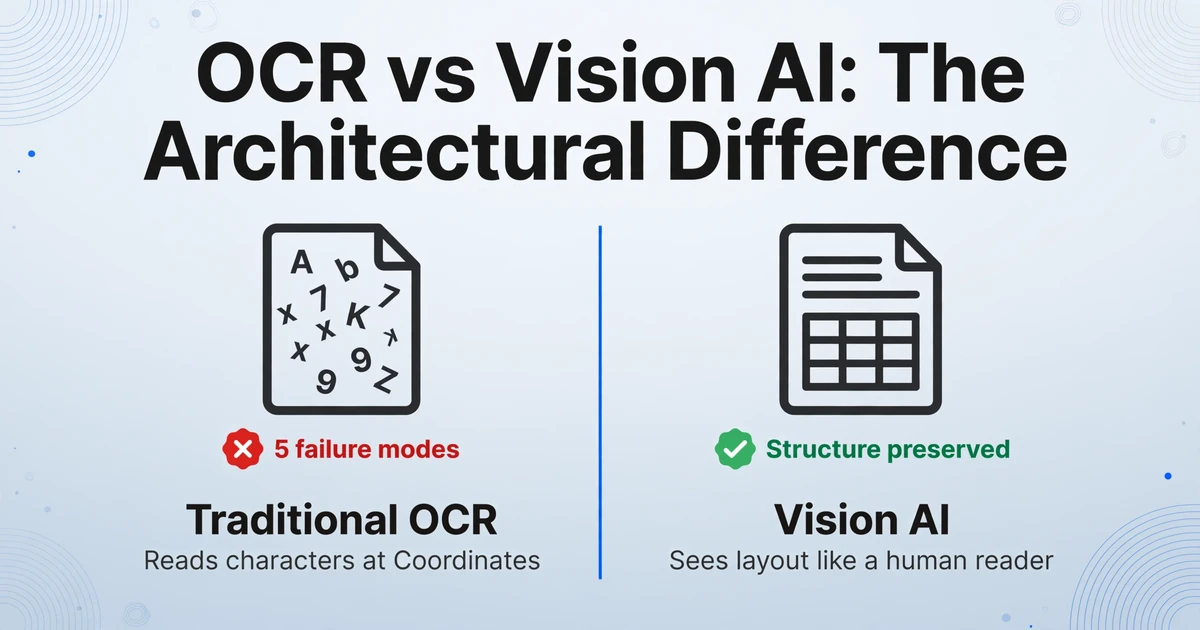
Treten Sie einen Schritt zurück und betrachten Sie, was diese fünf Fehlermodi gemeinsam haben. In jedem Fall ist die Ursache dieselbe: OCR verarbeitet Dokumente als Zeichenkoordinaten, nicht als visuelle Informationen. Schriftarten scheitern, weil OCR keine Schriftart-Metadaten identifizieren kann. Tabellen brechen, weil OCR keine zweidimensionale Struktur aus eindimensionalen Textströmen ableiten kann. Bilder verschieben sich, weil OCR sie als Hindernisse behandelt, nicht als Elemente. Absätze verschmelzen, weil OCR Absatzabstände nicht von Zeilenabständen unterscheiden kann. Kopfzeilen verschwinden, weil OCR räumliche Wiederholungsmuster nicht erkennen kann.
Das sind nicht fünf separate Fehler, die fünf separate Korrekturen benötigen. Es ist eine architektonische Einschränkung, die sich auf fünf verschiedene Arten manifestiert. Und die Implikation ist wichtig: Kein noch so großes Flicken oder Heuristiken auf einer OCR-Pipeline werden dieses Problem lösen. Sie können die Absatzabstands-Schwelle justieren, den Tabellenerkennungsalgorithmus verbessern, Schriftersetzungsregeln hinzufügen – und Sie werden trotzdem auf Fehlerfälle stoßen, weil sich das zugrunde liegende Verarbeitungsparadigma (Zeichenerkennung ohne Dokumentverständnis) nicht geändert hat.
Hier wird der Unterschied zwischen Vision AI und traditionellem OCR mehr als eine akademische Unterscheidung. Vision AI versucht nicht, Dokumentstruktur aus Zeichenkoordinaten zu rekonstruieren – es sieht das Dokument visuell und versteht das Layout so, wie es ein menschlicher Leser tut. Es erkennt Absätze anhand ihrer visuellen Muster, nicht anhand vertikaler Lückenschwellen. Es identifiziert Tabellen anhand ihrer Gitterstruktur, nicht anhand von Linienerkennungsalgorithmen. Es bewahrt Schriftarten, indem es visuelle Gewichtungshierarchien reproduziert, nicht indem es Schriftartnamen nachschlägt.
Für einen vollständigen Leitfaden zur layout-erhaltenden Dokument-zu-Word-Konvertierung ist der Arbeitsablauf unkompliziert: Laden Sie Ihr Dokument hoch, und die Vision-AI-Engine analysiert die gesamte Seite – Text, Tabellen, Bilder, Kopf- und Fußzeilen – als eine einzige visuelle Szene. Es rekonstruiert das Dokument in einem bearbeitbaren Word-Format, indem es versteht, was jedes Element ist und wie es zu jedem anderen Element in Beziehung steht, nicht indem es aus Koordinatendaten rät.
Das bedeutet auch, dass dieselbe Engine Randfälle verarbeitet, die OCR-Pipelines vollständig zum Scheitern bringen: Screenshots in bearbeitbares Word konvertieren – wo es überhaupt keine PDF-Schriftmetadaten gibt, nur Pixel – oder Dokumente mit gemischten handschriftlichen und gedruckten Inhalten. Wenn Sie das Dokument visuell verarbeiten, spielt das Quellformat eine weitaus geringere Rolle. Wenn Sie bestimmte Tools vergleichen, zeigt unser Vergleich layout-erhaltender Word-Konverter, wie verschiedene Ansätze mit jedem dieser fünf Fehlermodi umgehen.
Dateien werden sicher verarbeitet und nicht gespeichert.
Häufig gestellte Fragen
Warum sieht mein PDF perfekt aus, aber das konvertierte Word-Dokument ist ein Durcheinander?
Das PDF sieht perfekt aus, weil es ein festes Layout-Format ist – jedes Element ist an exakten Koordinaten fixiert. Das Word-Dokument sieht wie ein Durcheinander aus, weil Ihr Konverter Absätze, Tabellen und Formatierungen aus rohen Koordinatendaten rekonstruieren musste, und diese Rekonstruktion ist bei zeichenbasierter OCR von Natur aus verlustbehaftet. Das Dokument sieht auf dem Bildschirm großartig aus, weil es großartig war – als PDF. Die Konvertierung in ein bearbeitbares Format bedeutet, die logische Struktur des Dokuments von Grund auf neu aufzubauen, was eine grundlegend andere Herausforderung ist.
Kann ich einfach alle Schriftarten in meine PDF einbetten, um die Schriftsubstitution zu beheben?
Das Einbetten von Schriftarten hilft, wenn die PDF ursprünglich aus einer digitalen Quelle erstellt wurde (z. B. ein als PDF gespeichertes Word-Dokument mit eingebetteten Schriftarten). Bei gescannten PDFs – Dokumenten, die ursprünglich auf Papier vorlagen und digitalisiert wurden – gibt es jedoch keine Schriftarten zum Einbetten. Der „Text" besteht nur aus Pixeln in einem Bild. OCR muss Zeichenformen erkennen und Unicode-Werten zuordnen, kann aber die ursprünglichen Schriftinformationen nicht wiederherstellen, da diese beim Scannen des Dokuments verloren gegangen sind. In diesen Fällen ist der Ansatz von Vision AI, visuelle Gewichtungshierarchien zu erhalten statt Schriftarten zu identifizieren, der einzige gangbare Weg zu einem gut formatierten Ergebnis.
Warum funktionieren manche Online-Konverter bei bestimmten Dokumenten besser als andere?
Verschiedene Konverter verwenden unterschiedliche Heuristiken zur Tabellenerkennung, Absatzabstands-Schwellenwerte und Schriftsubstitutionsregeln. Ein Konverter, der für einspaltige Berichte mit großzügigem Zeilenabstand optimiert ist, kann für diesen Dokumenttyp saubere Ergebnisse liefern, versagt aber völlig bei einem mehrspaltigen Newsletter mit engem Abstand. Deshalb springt man zwischen verschiedenen Tools hin und her – jedes ist auf andere Annahmen zum Dokumentlayout kalibriert. Ein Vision-AI-Ansatz umgeht dieses Problem, indem er sich überhaupt nicht auf layoutspezifische Heuristiken verlässt.
Behebt eine höhere Scanauflösung PDF-zu-Word-Formatierungsprobleme?
Eine höhere Scanauflösung (300 DPI oder mehr) verbessert die Genauigkeit der OCR-Zeichenerkennung – weniger Verwechslungen zwischen „0" und „O" – behebt aber nicht die strukturellen Fehler auf dieser Liste. Ein Scan mit 600 DPI sagt OCR immer noch nicht, wo Absätze beginnen und enden, wie Tabellenzellen zueinander in Beziehung stehen oder wo Kopfzeilen im Ergebnis platziert werden sollen. Die Auflösung verbessert die Texterkennung; sie verbessert nicht das Layoutverständnis. Das sind getrennte Fähigkeiten, die einen grundlegend anderen Verarbeitungsansatz erfordern.
Soll ich in Word oder in eine strukturierte Tabelle konvertieren?
Das hängt davon ab, was Sie mit dem Ergebnis tun möchten. Wenn Sie das Dokument im ursprünglichen Layout bearbeiten, überprüfen oder weiterverwenden müssen – ein Vertrag mit Klauseländerungen, ein Bericht mit Inhaltsaktualisierungen, eine Broschüre mit Textänderungen – erhält die Word-Ausgabe das visuelle Dokument. Wenn Sie Daten über mehrere Dokumente hinweg analysieren müssen – Rechnungssummen in eine Tabelle extrahieren, Angebote von Anbietern in Spalten vergleichen – ist die strukturierte Tabellenausgabe (Excel/CSV) das richtige Ziel. Unser Entscheidungsrahmen Nach Word vs. Nach Tabelle erläutert, wie Sie basierend auf Ihrem spezifischen Anwendungsfall wählen.
Kann Vision AI Dokumente mit mehreren Spalten und komplexen Layouts verarbeiten?
Ja — hier klafft die größte Lücke zwischen OCR und Vision AI. OCR liest zeilenweise von links nach rechts und erzeugt bei mehrspaltigen Dokumenten verstümmelte Ausgaben, da sie Text aus verschiedenen Spalten vermischt. Vision AI verarbeitet jede Spalte als separate visuelle Zone, bevor sie in der korrekten Lesereihenfolge angeordnet wird, und bewahrt so das ursprüngliche Leseerlebnis. Dieselbe Fähigkeit gilt für Dokumente mit Text, der um Bilder, Seitenleisten, Hervorhebungsboxen und andere nicht-lineare Layouts fließt.