2026年、法律文書向け最高のOCRソフトウェア:
契約書・準備書面・eDiscovery向け9ツール比較
国際法務技術協会の2025年技術調査(580の法律事務所、15万2000人以上の弁護士、約30万2820人の総ユーザーを対象)によると、少なくとも76%の事務所がクラウド型文書管理システムを導入しています。しかし、同じ調査では、法務組織の57%が今も「変化への抵抗」を新技術導入の最大の障壁として挙げ、54%がセキュリティとリスクへの懸念を挙げています。デジタル化が不可避であると認識しながらも、ABAの倫理的義務と法律文書ワークフローの現実的課題の両方を満たすツールを選ぶ必要がある——この緊張関係が、本リストのすべての評価の背景にあります。本ガイドは、各ツールの公開ドキュメント、コンプライアンス認証、価格ページを調査し、ABAモデルルールの技術能力と機密保持に関する規定、公開されたILTA調査データ、r/LawFirmおよびr/legaltechの法務専門家による直接の証言を補足して作成されました。ここで取り上げるすべてのツールは、法律文書処理の具体的要件に照らして評価されています:複数ページにわたる契約書からの条項抽出、ベーツナンバリングと秘匿指定の保持、複数列の準備書面形式の処理、そしてABAモデルルール1.1および1.6が課すデータセキュリティ義務です。開示:ImageToTable.ai(最新のAI抽出ツール)が本ラウンドアップに含まれています。私は本リストの他のツールとは一切関係ありません。すべての価格は2026年6月時点のベンダー公開ページに基づき、すべての外部リンクはベンダーの製品または価格ページに直接つながっており、ご自身で情報を検証できます。
重要ポイント
- 精度99.7%のOCRツールでも、「CONFIDENTIAL」ヘッダーを本文テキストとして、ベーツ番号をページ装飾として扱うことで、秘匿ログを壊してしまう可能性があります。
- 契約書レビューが失敗するのは、OCRが単語を読み間違えたときではなく、「indemnification」を抽出しても、それが責任を制限するのか、それとも創設するのかを認識しないときです。
- 実務にとって重要な唯一の評価基準は、ツールが法律文書に法的意味を与える6つの構造要素——ベーツ番号、秘匿マーク、ページをまたぐ条項の連続性——を保持するかどうかです。
リーガルOCRが一般的なドキュメントキャプチャと異なる点
法律事務所が必要とするのは「標準的なドキュメントに対して95%の精度」のOCRではありません。ネストされた条項、別紙AからF、手書きの欄外メモ、全ページ右下のベーツスタンプを含む78ページの合併契約書を正確に読み取り、ABAモデルルールに基づく事務所の倫理的義務を満たす形でデータを出力するOCRが必要なのです。
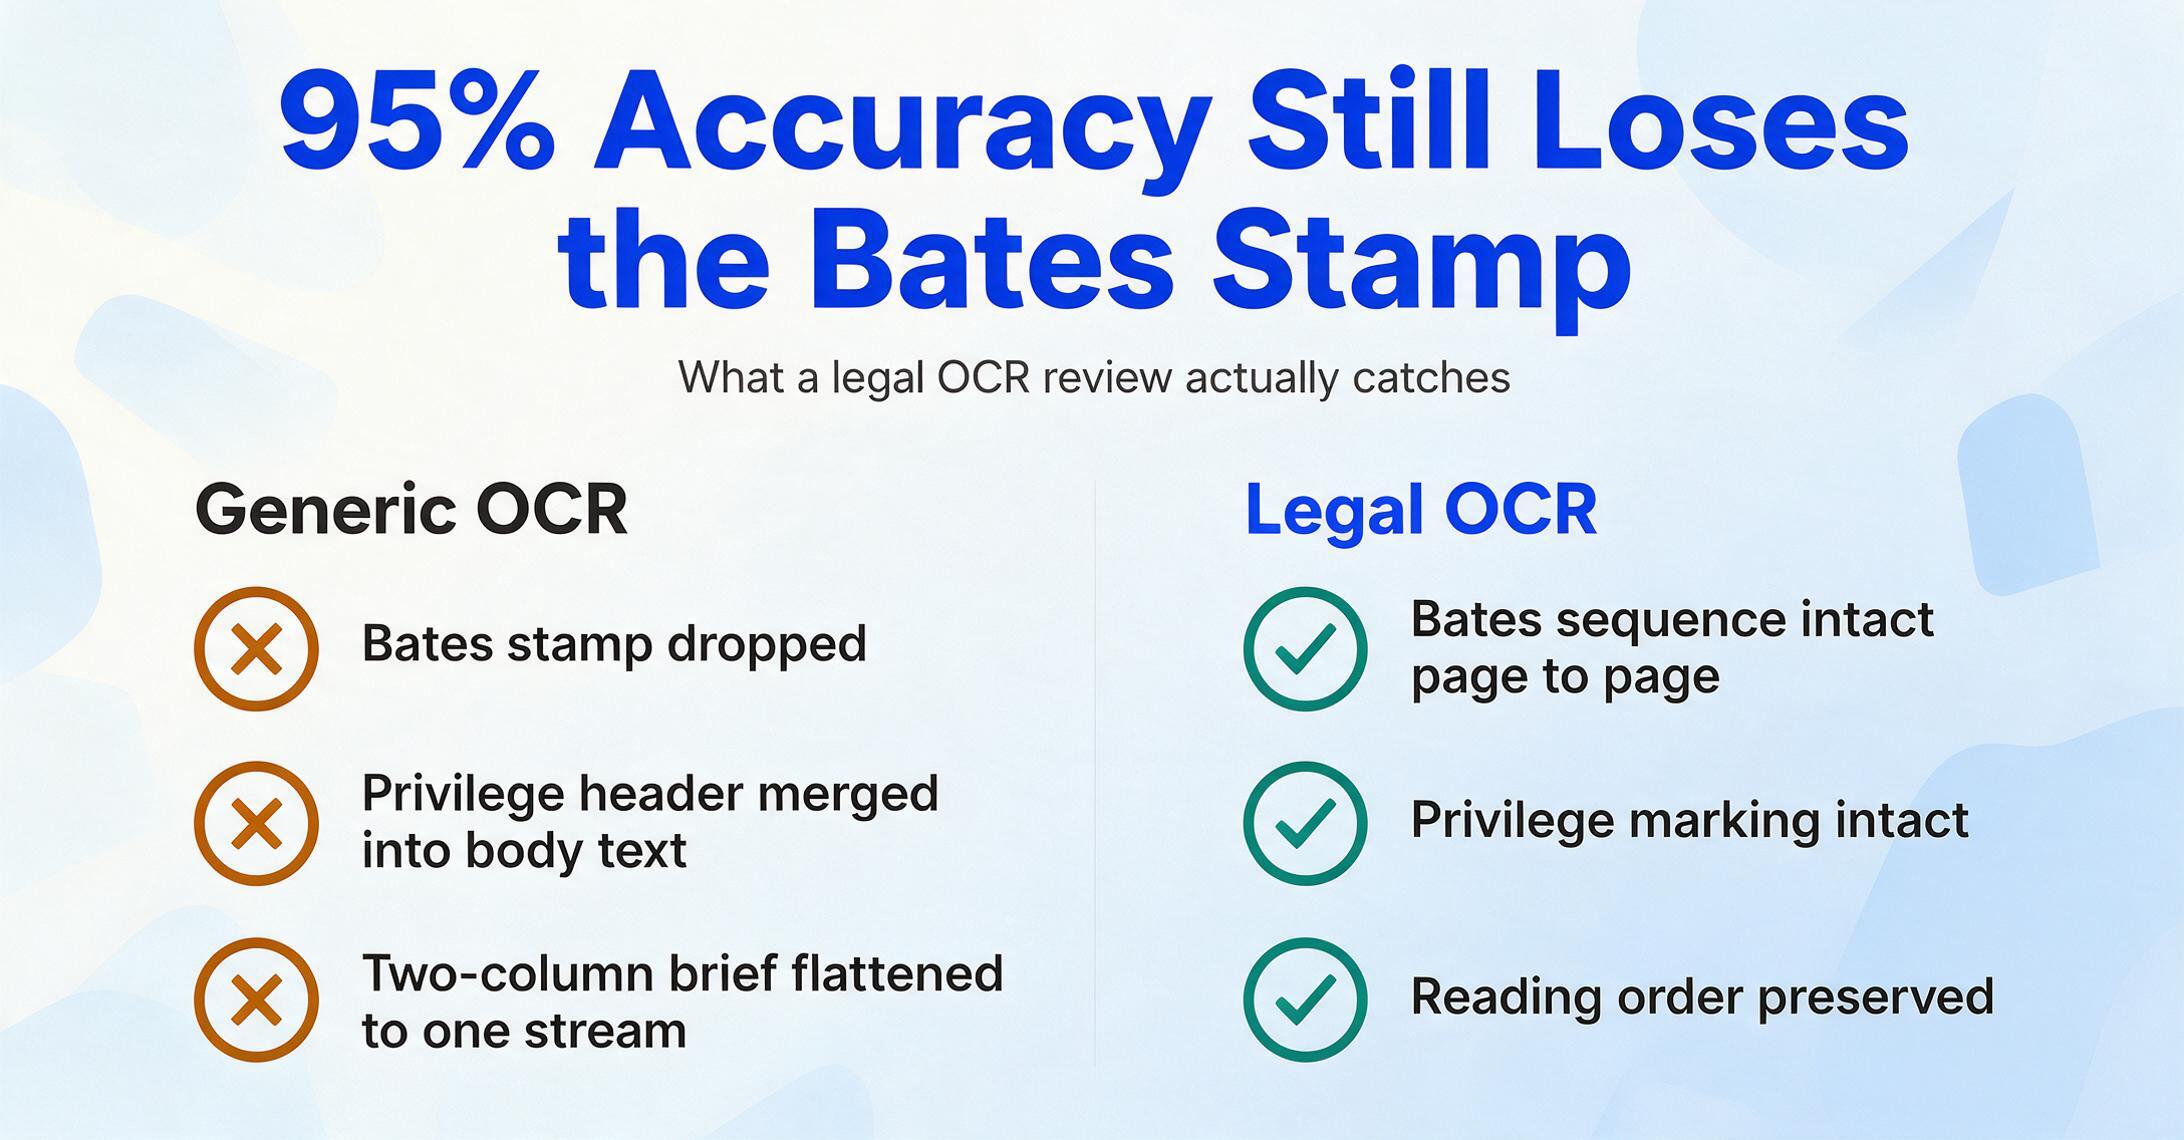
「OCR」と聞いて多くの人が思い浮かべるテキストベースのアプローチ(文字を認識してテキストファイルを出力する)は、精度をいくら調整しても解決できない構造的な理由から、法律実務では不十分です。法的文書はレイアウトに意味が込められています。ページをまたぐ条項、ヘッダー内の秘匿特権表記、最終別紙ページの署名欄などです。標準的なOCRが2カラムのブリーフを単一のテキストストリームに平坦化したり、フッターの注記を本文の最終行に統合してしまうと、結果は単に見苦しいだけでなく、職業上の害になり得ます。
リーガルOCRを明確なユースケースとして定義する要件は、いくつかの具体的な項目に整理できます。
- ベーツナンバリングの保持 — 訴訟における文書提出はベーツスタンプに依存しています。ページ番号を落としたり、統合したり、誤読するOCRは、証拠の連鎖保管を断ち切ることになります。
- 弁護士・依頼者間の秘匿特権表示 — 「PRIVILEGED AND CONFIDENTIAL」ヘッダー、墨消しゾーン、指定ラベルは抽出後もそのまま維持されなければなりません。これらを失うと権利放棄のリスクが生じます。
- マルチカラムの法務書式 — Fed. R. Civ. P. の書式で提出されるブリーフ、法令、規則は2カラムレイアウトを頻繁に使用します。OCRは左右両方を横断して左から右へではなく、カラムごとに読み順を保持しなければなりません。
- ページをまたぐ条項と表の追跡 — 商業リース契約の終了条項が12ページで始まり14ページで終わることがあります。料金表がページ境界をまたいで分割されることもあります。各ページを独立した抽出単位として扱うツールは、構造的な関係を見逃してしまいます。
- 専門用語と判例引用 — ラテン語表現(res judicata、sua sponte)、法的引用(Fed. R. Civ. P. 12(b)(6)、15 U.S.C. § 78j(b))、多様な形式の当事者名は日常的に登場します。標準的な辞書に依存するOCRエンジンはこれらをエラーとして扱います。
- ABAモデルルール1.6(c)のデータセキュリティ — 2012年8月以降、ABAモデルルール1.6(c)は弁護士に対し、「クライアントの代理に関する情報の意図しない開示や不正アクセス、または不正なアクセスを防ぐための合理的な努力を行う」ことを義務付けています。クライアント文書を処理するOCRツールは、データ暗号化、アクセス制御、アップロードされた文書がモデルトレーニングに使用されるかどうかの明確な説明を提供しなければなりません。
以下のツールは、この6つの観点を評価フレームワークとして選定・ランキングされています。OCR技術の基礎と、従来の文字認識が最新のAIベース抽出とどう異なるかの完全な概要については、OCRとは何か、実際にどう機能するかのガイドをご覧ください。
クイック比較表:法務向けOCRツール一覧
| ツール | 開始価格 | 最適な用途 | 法律特化の強み | 主な制限 |
|---|---|---|---|---|
| ABBYY FineReader | 一括$199 / 月額約$16 | デスクトップOCR+レイアウト保持 | 業界トップクラスの書式保持、オフライン対応でセキュア | デスクトップ専用、API連携に制限あり |
| Adobe Acrobat Pro | 月額$22.99 | 法務PDFワークフローと編集 | 業界標準、墨消し・比較・ベイツスタンプを内蔵 | 検索可能PDF以外の構造化データ抽出は不可 |
| Amazon Textract | 約$1.50/1,000ページ | eDiscovery向けスケーラブルなクラウドOCR | フォーム・表・手書き対応、クエリベースのフィールド抽出 | AWSの知識が必要、ボリュームに応じてコスト増加 |
| Google Document AI | 約$1.50/1,000ページ | 多言語・手書き証拠対応 | 幅広い言語対応、文書分類機能 | クラウド依存、技術的な設定が必要 |
| Azure Document Intelligence | 約$1.50/1,000ページ | Microsoft中心の法律事務所ワークフロー | 契約書モデルを標準装備、M365エコシステムとの親和性 | Azure/M365利用時は最大の価値を発揮 |
| Kira Systems | カスタムエンタープライズ価格 | 大量契約書分析とM&Aデューデリジェンス | 契約条項抽出とプレイブック準拠に特化 | 契約書のみ対応、高額、カスタム条項にはトレーニングが必要 |
| RelativityOne | カスタムエンタープライズ価格 | eDiscovery処理とレビュー | 訴訟文書レビューの市場標準、OCR内蔵 | 非訴訟事務所には過剰で高額 |
| ImageToTable.ai | 無料枠あり、有料は月額$9~ | テンプレート不要の契約データ抽出 | 意味抽出、トレーニング不要、バッチ処理でExcel出力 | 新しいツール、既存製品と比べエコシステムが小さい |
| Tesseract | 無料(オープンソース) | 予算重視の事務所や開発者向け統合 | コストゼロ、カスタムパイプライン統合が可能 | 複雑なレイアウトに弱い、GUIなし、セットアップに手間がかかる |
選定方法とテスト基準
この比較に含まれる9つのツールは、最も人気のある製品だけでなく、法務向けOCRのユースケース全体を網羅するように選定されました。選定範囲は4つのカテゴリーに及びます:デスクトップOCR(ABBYY、Adobe Acrobat Pro)— オフライン処理と手動QCを好む事務所向け。クラウドOCR API(Amazon Textract、Google Document AI、Azure Document Intelligence)— 自動化されたドキュメントパイプラインを構築する事務所向け。専門的法務プラットフォーム(Kira Systems、RelativityOne)— 契約分析やeDiscoveryなどの専用ユースケース向け。最新のAI抽出(ImageToTable.ai)およびオープンソース(Tesseract)— 従来のテンプレートベースのアプローチに代わる選択肢を必要とする事務所向けです。
各ツールは、上記のセクションで挙げた6つの法務特有の基準 — ベーツナンバリングの保持、秘匿特権マークの保持、複数列対応、ページ間追跡、語彙適合性、ABAモデルルール1.6のセキュリティ対応 — に加え、価格の透明性、導入の手間、法務ソフトウェアエコシステム(Clio、NetDocuments、iManage、Relativity)との統合といった標準的な指標に基づいて評価されました。
従来のOCR(文字を読み取る)と最新のAI抽出(文書の内容を理解する)の基本的な違いに馴染みがない場合は、AI OCRとは何か、従来のOCRとの違いに関するガイドが、個々のツールを評価する前に必要な基礎知識を提供します。
1. ABBYY FineReader — 法務におけるレイアウト保持に最適なデスクトップOCR
ABBYY FineReaderは、フォーマットの忠実性を失わずに文書をデジタル化する必要がある法務専門家にとって、長年にわたりデスクトップOCRの基準となってきました。その理由は明確です。OCRエンジンはスキャンされた法務文書に対して一貫して高い精度を達成し、レイアウト保持機能により、脚注、埋め込みテーブル、複数列テキストを含む40ページの準備書面も、元の文書と同様の見た目で出力されます。
法務業務での強み:主なユースケースはアーカイブのデジタル化です。何十年分もの閉鎖ファイルの紙文書を検索可能なPDFに変換する法律事務所には、元のページレイアウトを保持するツールが必要です。読みやすさのためだけでなく、文書の視覚的構造が証拠として重要な意味を持つことがあるからです。ABBYYの文書比較機能は、契約書のレッドライン作成にも非常に有用です。リース契約の2つのバージョンをインポートすると、テキストのみの差分比較では見逃されるフォーマット変更を含む、すべての変更箇所がハイライト表示されます。
最適なユーザー:バッチデジタル化、文書比較、手動品質管理のための信頼性の高いデスクトップOCRツールを求める事務所 — 特に、文書を社内で処理し、オフラインセキュリティを優先する個人開業医や小規模事務所に適しています。
不向きなユーザー:APIベースの抽出を必要とする自動化された文書パイプラインを構築する事務所、検索可能なPDFではなく構造化データ出力(Excel/CSV/JSON)を必要とするチーム、または大規模な契約データを処理する業務 — ABBYYのデスクトップファーストのアーキテクチャでは、すべての文書を人間が開いて確認し、エクスポートする必要があります。
2. Adobe Acrobat Pro — PDFワークフローにおける法律業界標準
Adobe Acrobat Pro DCは、純粋なOCRツールではなく、OCR機能を内蔵したPDF管理プラットフォームです。しかし、法律業界は裁判所への提出書類、証拠開示、契約書の執行副本など、PDFで業務が回っているため、Acrobat Proは多くの法律ワークフローにおいて実用的なOCRツールとなっています。
法律業務での強み: Acrobat ProのOCRエンジン(「スキャンの強化」)は、最も一般的な法律OCRタスクであるスキャン文書の検索可能化を適切に処理します。真の価値はOCRを取り巻くPDF管理機能にあります。機密テキストを恒久的に削除する墨消しツール、複数ページの文書に連番を付与するベイツ番号付け、ABAモデルルール1.6(c)の「合理的な努力」要件を満たすパスワード保護とアクセス権限、そして契約バージョン管理のための文書比較です。
最適な用途: OCR、墨消し、ベイツスタンプ、文書レビューを一手にこなす信頼性の高いオールインワンPDFツールを必要とする法律事務所(ほとんどの事務所が該当)。特に、証拠開示段階で文書にOCR処理、番号付け、墨消し、提出を単一ワークフローで行う必要がある訴訟案件に強みを発揮します。
不向きな用途: 構造化データの抽出。Acrobat Proはスキャン文書を検索可能なテキストに変換しますが、特定のデータフィールド(契約日、当事者名、条項の文言)をスプレッドシートに抽出することはできません。契約書やフォームから構造化データを抽出する必要がある事務所には、Acrobat単体では不十分です。
3. Amazon Textract — eDiscoveryと文書処理のためのスケーラブルなクラウドOCR
Amazon Textractは、AWSのマネージド文書OCRサービスであり、大量のスキャン文書を処理する必要がある法律文書処理プラットフォームのバックエンドとして一般的になっています。デスクトップツールとは異なり、TextractはAPIとして動作します。文書を送信すると構造化されたJSON出力が返されるため、自動化されたeDiscovery取り込みパイプラインに適しています。
法律業務での強み: フォームや表からテキストを抽出するTextractの機能は、大規模な法律文書処理に真に有用です。自然言語で特定のフィールドを問い合わせる「Queries」機能(「この契約の効力発生日は?」)は、法律ワークフローに必要な意味的抽出への一歩です。AWSインフラを利用するeDiscoveryチームにとって、Textractは処理パイプラインに自然に統合できます。文書をS3にアップロードし、Textract抽出をトリガーし、出力を検索プラットフォームにインデックス化します。
最適な用途: すでにAWS上で運用しており、スキャンされた証拠開示資料、アーカイブされた訴訟ファイル、企業記録など、多種多様な文書を自動処理パイプラインの一部として大量にOCR処理する必要がある、エンタープライズ法務部門およびeDiscoveryプロバイダー。
不向きな用途: 技術スタッフのいない個人開業医や小規模事務所。TextractはAPI統合とAWS設定の専門知識を必要とします。また、抽出結果を手動でレビューするためのインターフェースがないため、複雑な法律文書レイアウトでのエラー(ベイツ番号の誤認識、表のセル結合の誤り)は、人間がすべての出力を検証しない限り、検出されずに通過します。
4. Google Document AI — 多言語・手書き文書に強い
Google Document AIは、クラウドベースの文書処理においてTextractと競合しますが、より強力な多言語対応と、単なるOCRではなく文書理解(分類、エンティティ抽出、レイアウト解析)に重点を置いています。
法律業務での強み: 国際仲裁、越境訴訟、多言語契約書セットなど、複数言語にわたる証拠を扱う法律事務所にとって、Document AIの言語カバレッジはTextractよりも広範囲です。また、手書き文字認識は、注釈付きドラフト、印刷された契約書への手書きの欄外メモ、草書体で署名された宣誓供述書など、証拠として現れる実際の文書に対してより高い性能を発揮します。プリビルドの「Document AI Workbench」プロセッサには契約書やフォーム向けのオプションが含まれており、汎用的なOCRパイプラインと比較してセットアップの手間を軽減します。
最適なケース: 多言語の証拠セットを処理する法務チーム、印刷文書と手書き文書が混在するコレクションを持つ法律事務所、すでにGoogle Cloudを利用している組織。
不向きなケース: クラウドエンジニアリングのリソースが不足している法律事務所。Document AIもTextractと同様、APIファーストの製品です。プリビルドプロセッサによって統合作業の一部は軽減されますが、パイプラインの設定、テスト、保守には技術的な担当者が必要です。また、eDiscoveryのボリューム(数万~数十万ページ)では、従量課金制のコストが大きな負担になります。
5. Azure Document Intelligence — Microsoft中心の法律事務所に最適
Azure Document Intelligence(旧Azure Form Recognizer)は、Microsoftのクラウド文書処理サービスです。法律業務における主な利点は、TextractやDocument AIに対する技術的な優位性ではなく、エコシステムとの親和性にあります。2025年のILTA調査によると、法律事務所のクラウドサーバー導入の79%がMicrosoft Azureを採用しています。すでにMicrosoft 365、SharePoint、Azureを運用している事務所であれば、Document Intelligenceは新しいクラウドプラットフォームを必要とせず、既存のインフラに組み込むことができます。
法律業務での強み: Document Intelligenceには、契約書から当事者、日付、条件、条項の文言を抽出するプリビルドモデルが含まれており、CLM(契約ライフサイクル管理)統合の出発点として有用です。カスタム抽出モデルは、特定の法的フォームタイプ(インテークフォーム、エンゲージメントレター、裁判所の事件一覧表など)を比較的少数のトレーニング文書で学習させることができます。すでにeDiscoveryにMicrosoft Purviewを利用している事務所では、Document Intelligenceが抽出したテキストを同じコンプライアンスおよび検索インフラに供給できます。
最適なケース: Microsoft Azure/M365上で運用しており、2つ目のクラウドプラットフォームを導入せずに、既存のスタックに文書OCRおよび抽出機能を追加したい法律事務所および企業法務部門。
不向きなケース: Microsoftインフラを利用していない法律事務所。Azureエコシステム外では、その価値提案は大幅に弱まります。また、クラウドAPIサービスを管理するITスタッフが不足している小規模事務所にも適していません。
6. Kira Systems — M&Aやデューデリジェンスに特化した契約分析ツール
Kira Systemsは、汎用的なOCRツールではありません。主に大手法律事務所や企業法務部門が、M&Aデューデリジェンス、リース契約の要約、規制コンプライアンスの契約レビューに使用する、専門的な契約分析プラットフォームです。Kiraは、法律文書を学習した機械学習を活用し、1,300種類以上の条項タイプやデータポイント(例:経営権変更条項、譲渡条項、補償上限額、競業避止義務の範囲など)を特定・抽出します。
法律業務での強み:Kiraは、数百から数千の類似契約から同じデータポイントを抽出する作業に優れています。例えば、M&Aデューデリジェンスで1週間のうちに200件の対象企業の契約書をレビューする場合、Kiraを使えば「準拠法」条項、「重大な悪影響」条項、「同意なしの譲渡」制限などをすべて抽出し、構造化された比較表として出力できます。最終的な精査には弁護士の判断が依然として必要ですが、Kiraが読み取りと発見の作業を代行することで、通常3人のアソシエイトが1週間かかる作業を大幅に効率化します。
最適な用途:大量の契約レビューを行う大手法律事務所(M&Aデューデリジェンス、不動産ポートフォリオのリース契約要約、コンプライアンスレビュー)。また、大規模な契約データベースを管理する企業法務部門にも有用です。
不向きな用途:中小規模の法律事務所。価格はエンタープライズ向けのみで非公開ですが、通常は年間5桁(数万円~)からです。また、Kiraは契約書のみを処理対象としており、裁判所提出書類、証拠開示文書、フォーム、その他の非契約系の法律文書は扱えません。さらに、すぐに使えるAI抽出ツールとは異なり、Kiraは組み込みライブラリにないカスタム条項タイプについてはトレーニングが必要です。
7. RelativityOne — OCRを内蔵したeDiscoveryの標準
RelativityOneは、法律事務所で最も広く導入されているeDiscoveryプラットフォームであり、訴訟や調査のための文書の処理とレビューを行います。スタンドアロン機能としてではなく、文書処理パイプラインの一部としてOCR機能を備えており、アップロードされたすべての文書が自動的にOCR処理され、検索可能になります。
法務業務での強み: 訴訟業務において、RelativityOneは他のツールでは対応できないOCRの問題を解決します。それは、テキスト抽出後に何が起こるかです。eDiscoveryにおいて、OCRは最終目標ではなく、検索、レビュー、タグ付け、プロダクションのための前提条件です。RelativityOneはライフサイクル全体を処理します。文書の取り込み(スキャンされたPDFや画像のみのTIFFを含む)、OCRの実行、テキストのインデックス化、コレクション全体でのキーワード検索やブール検索の有効化、そしてベーツナンバリングと特権ログを保持したままのレスポンシブ文書のプロダクションです。訴訟ディスカバリーをある程度の量扱う法律事務所にとって、このオールインワンの処理・レビューワークフローは、単一のOCRエンジンの精度パーセンテージよりも価値があります。
最適な用途: 定期的にeDiscoveryを扱う訴訟部門や法律事務所。専任のディスカバリープラクティスグループを持つ中規模事務所から、本格的な訴訟支援チームを擁する大規模事務所まで対応します。
不向きな用途: 訴訟ディスカバリーを行わない事務所。このプラットフォームは、トランザクション文書処理、契約レビュー、一般的なオフィスのデジタル化には過剰です。価格はエンタープライズレベル(通常年間$50,000以上)から始まるため、個人開業医や小規模事務所には手が届きません。小規模チーム向けに設計された代替eDiscoveryプラットフォームとして、Everlawは、より低い導入価格で同様のOCR取り込み機能を備えたクラウドネイティブなeDiscoveryプラットフォームを提供しています。
8. ImageToTable.ai — 契約データのためのテンプレート不要抽出
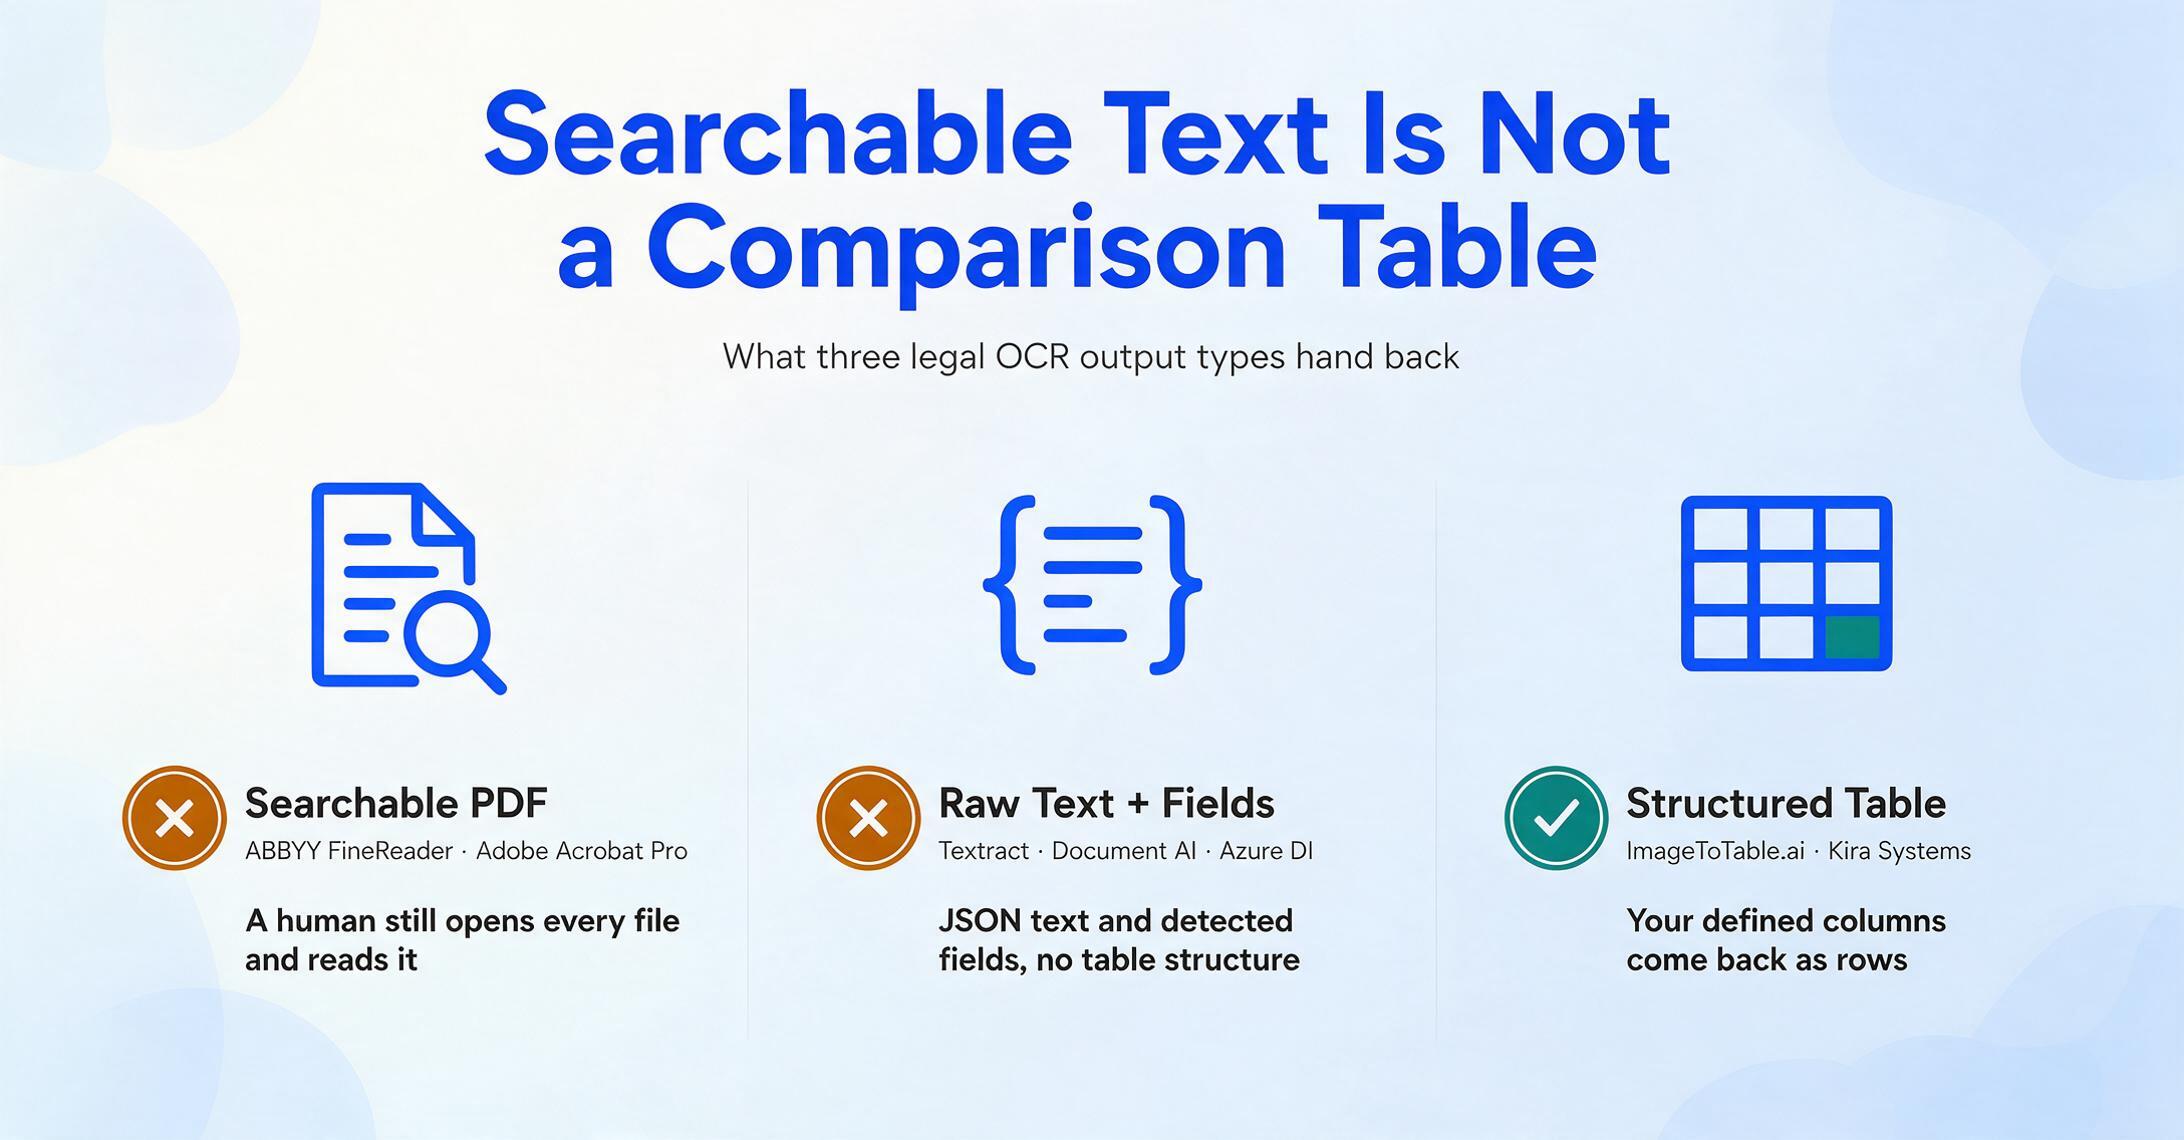
上記のツールは、ドキュメントの構造がルールを定義したりモデルをトレーニングしたりするのに十分予測可能であるという共通の前提を大きく共有しています。ABBYYはレイアウトを保持しますが、構造化データは抽出しません。Kiraは構造化データを抽出しますが、トレーニングが必要で、契約のみを処理します。クラウドOCR API(Textract、Document AI、Azure DI)は生テキストと検出されたフォームフィールドを返しますが、ほとんどの法務チームが分析に必要とするテーブル構造にデータを整理しません。
ImageToTable.aiは、この問題に異なるアプローチで取り組みます。ドキュメントのレイアウト(位置ベースの抽出)から始めるのではなく、ユーザーの出力から始めます。つまり、必要な列を定義すると、AIが各フィールドのページ上での意味を理解して一致するデータを見つけます。これはカスタム列抽出と呼ばれ、業界でAIデータ抽出と呼ばれるカテゴリに属します。これは、従来のOCR(文字を読み取るが理解しない)やインテリジェント文書処理(テンプレートとトレーニングが必要)とは異なります。
法務業務での強み:法務担当者にとっての実用的な利点はフォーマット非依存です。5つの異なる取引先からのNDAをレビューする弁護士は、5つの異なるレイアウトに直面します。1ページのものもあれば7ページのものもあり、別紙があるものもないものもあります。テンプレートベースのツールでは、各取引先のフォーマットごとに個別の設定が必要になります。ImageToTable.aiは、位置ではなく意味内容でドキュメントを読み取ります。「当事者名」「発効日」「準拠法」「秘密保持期間」「競業避止範囲(はい/いいえ)」の列を一度定義すれば、AIはページ上のどこにあっても5つのドキュメントすべてからこれらのフィールドを抽出します。結果は1つのExcelテーブルにエクスポートされます。契約ごとに1行です。
このツールはバッチファースト処理もサポートしています。デューデリジェンスのドキュメント一式をアップロードし、抽出列を定義すると、AIはバッチを単一の操作として処理し、マージされた出力を生成します。取引で30件の契約を受け取る事務所の場合、1回のアップロード、1回の抽出実行、1つのExcelファイルで済みます。30回の個別のOCR操作は不要です。
ImageToTable.aiは、PDF、JPG、PNG、WebP、AVIF入力を処理します。印刷されたテーブルデータに対して最大99%の精度をサポートし、1ページを5〜10秒で処理します。これは手動データ入力の約18倍の速さです。Google Sheetsアドオンを使用すると、法務チームはドキュメント管理環境を離れることなく、契約データをスプレッドシートに直接抽出できます。また、コレクションリンク機能(認証コード付きの共有可能なアップロードリンク)により、事務所はクライアント、相手方弁護士、または第三者から登録を必要とせずにドキュメントを収集できます。
最適な用途:複数のドキュメント形式にわたって契約、合意書、法的フォームから構造化データを抽出する必要がある法務チーム。特にM&Aデューデリジェンス、契約ポートフォリオ分析、または受入ドキュメント処理を行う事務所に適しています。無料ティアと透明な価格設定により、あらゆる規模の事務所に適しています。
以下の用途には不向きです:完全なレビュープラットフォーム機能を必要とする訴訟eDiscoveryワークフロー(そのユースケースはRelativityOneが対応)。構造化されたスプレッドシートデータではなく、フォーマットを保持したPDF出力が必要な事務所。非常にシンプルなニーズ(契約書1件の検索可能なPDF)のチームには、このツールの機能が要件を超えていると感じられるでしょう。
ファイルは安全に処理され、保存されることはありません。サンプル契約書から主要な条項、日付、当事者名の抽出をお試しください。
9. Tesseract — 開発者中心の事務所向け無料オープンソースオプション
Tesseractは、2006年からGoogleによってメンテナンスされている、最も広く使用されているオープンソースのOCRエンジンです。無料で100以上の言語に対応し、基本的なグラフィカルインターフェースを提供するラッパーやツール(OCRFeeder、gImageReader)を生み出してきた活発な開発者コミュニティがあります。
法務業務での強み:社内に技術力がある事務所にとって、Tesseractは商用ツールにはないものを提供します。それは、どのボリュームでもゼロコストで導入できることです。エンタープライズソフトウェアの予算がなく、アーカイブされた訴訟ファイル5万ページのOCR処理が必要な事務所は、単一のサーバーにTesseractパイプラインを構築し、電気代だけでコレクション全体を処理できます。カスタム統合をサポートする文書管理システムを使用している事務所は、スキャン文書の取り込み用のローカルOCRバックエンドとしてTesseractを追加できます。
最適な用途:開発者主導の法務チーム、コマンドラインツールを管理できるITスタッフがいる事務所、そして使いやすさや複雑なレイアウトでの精度よりもライセンスコストゼロを優先する予算重視の組織。
以下の用途には不向きです:非技術系の法務専門家 — TesseractにはプロフェッショナルなGUI、サポートチーム、SLAがありません。複数列の法務文書、低品質のスキャン、混在フォントの文書での精度は商用の代替製品よりも著しく劣るため、手動修正の時間が増えます。当社の最高のオープンソースOCRツール比較で述べたように、Tesseractはカスタムパイプラインを構築する開発者にとって依然として有力な選択肢ですが、製品化にはかなりのエンジニアリング作業が必要です。
法律事務所に適したOCRツールはどれ?
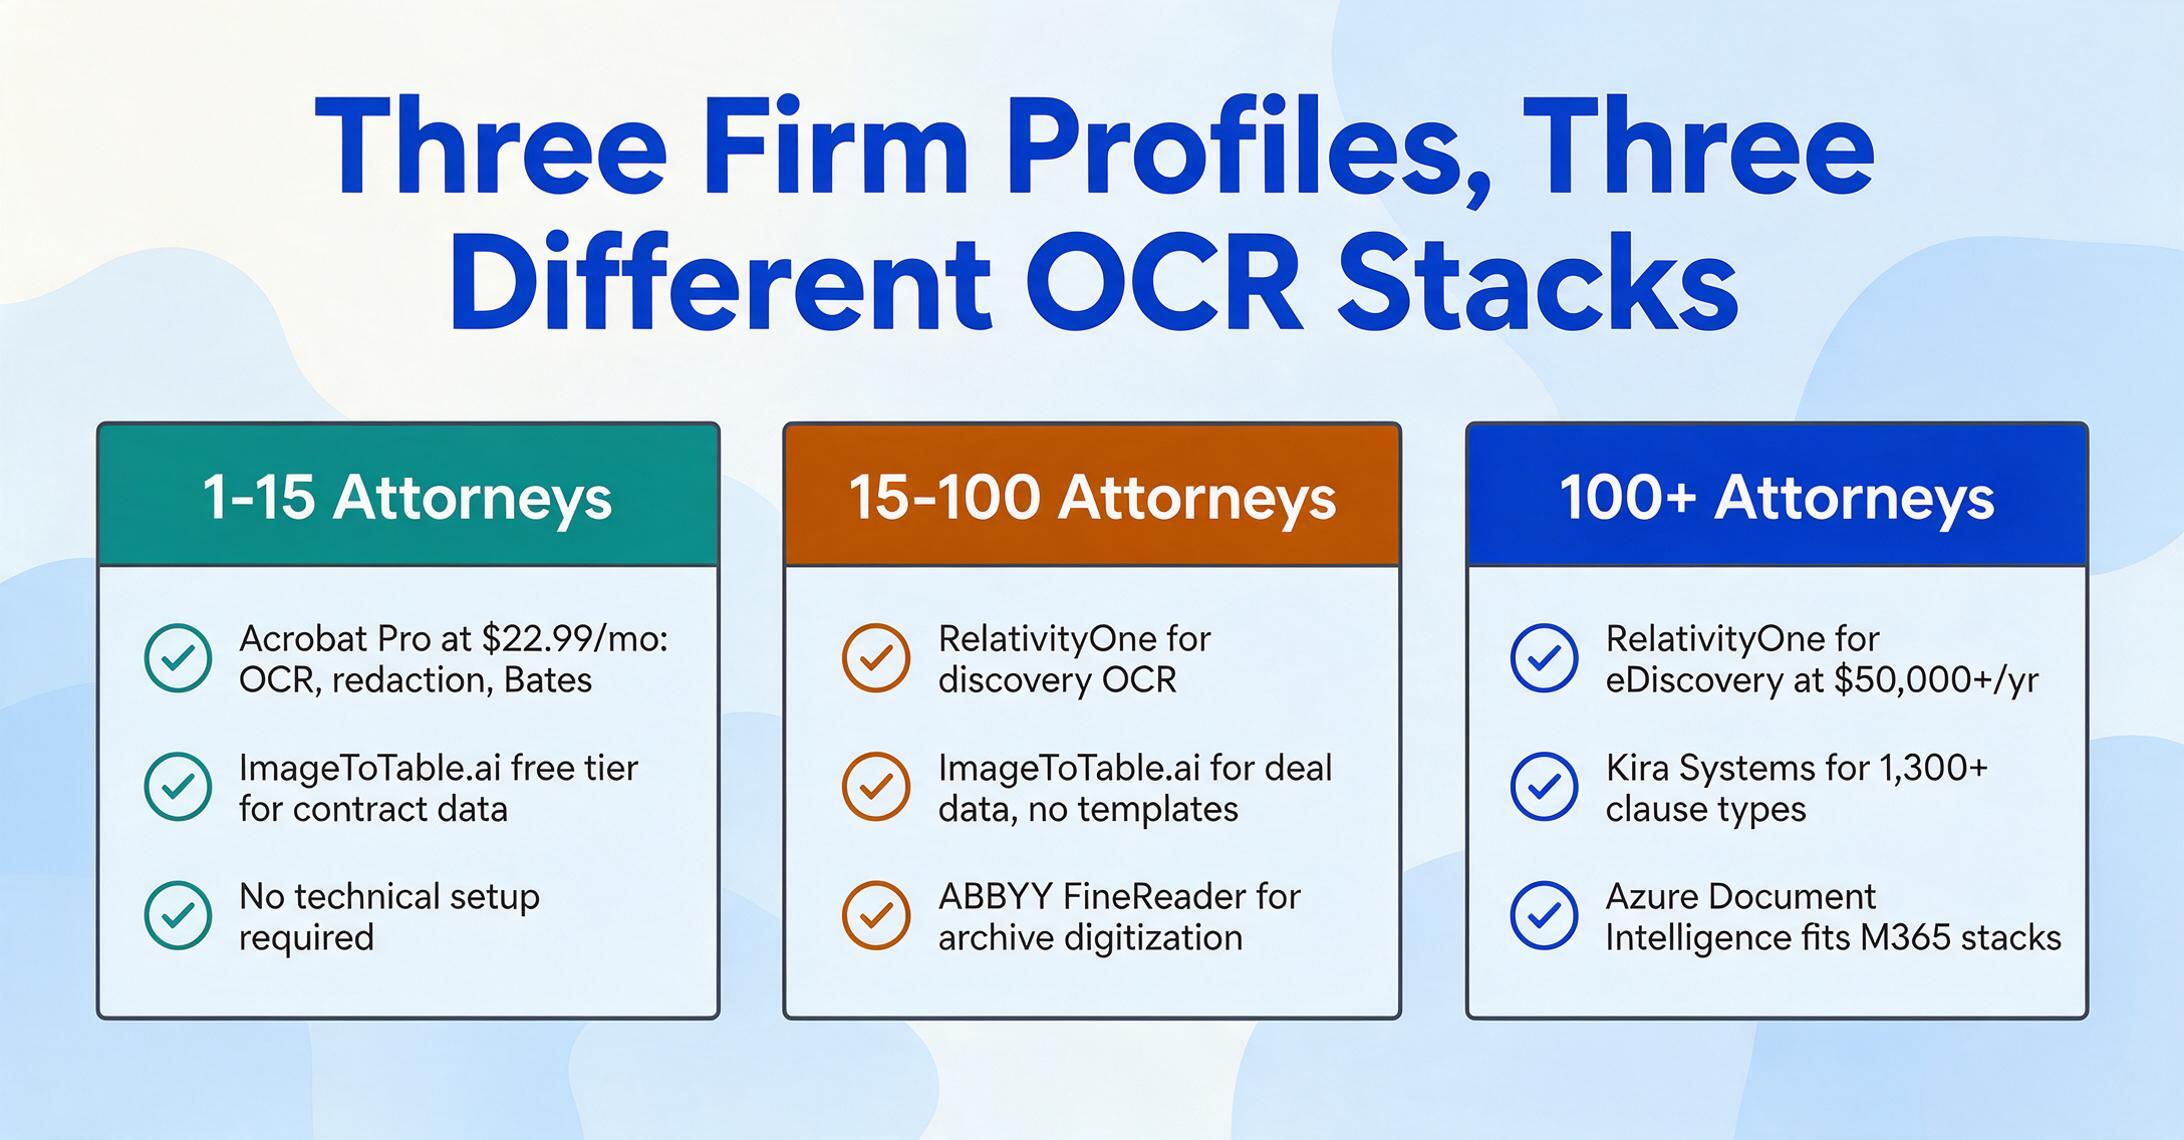
唯一の最適な法律用OCRツールというものはありません。最適な選択は、事務所の専門分野、文書量、技術的キャパシティ、主要なワークフローによって異なります。事務所の規模別に判断基準を以下に示します。
個人開業医および小規模事務所(弁護士1〜15名):このグループが最も必要とする法律用OCRは、スキャン文書の検索可能化と、契約書や裁判所書類からのデータ抽出(必要に応じて)です。Adobe Acrobat Pro(月額$22.99)は、PDFワークフロー、墨消し(レッドアクション)、ベーツナンバリング、基本の検索可能OCRを1つのツールでカバーします。構造化された契約データの抽出(リース交渉の条項文言の抽出やエンゲージメントレター条項の比較など)を必要とする事務所には、ImageToTable.aiの無料版が初期費用ゼロの出発点となります。どちらのツールも技術的なセットアップは不要です。
中規模事務所(弁護士15〜100名):このグループは通常、訴訟における証拠開示と取引業務の両方を扱います。訴訟では、RelativityOne(または低価格帯のEverlaw)が、組み込みのOCRを備えたeDiscoveryライフサイクル全体を管理します。M&A、不動産、企業実務における契約業務では、ImageToTable.aiが、エンタープライズ向け契約分析ツールのようなトレーニングの手間をかけずに、構造化データ抽出を提供します。文書比較やアーカイブのデジタル化のための信頼できるデスクトップOCRのバックアップが必要な事務所は、ABBYY FineReaderを追加するとよいでしょう。
大規模事務所および企業法務部門(弁護士100名以上):これらの組織は通常、専任のITチームと法務オペレーションチームを擁しています。最適な構成は階層型戦略です。eDiscovery処理にはRelativityOneまたはEverlaw、M&Aやコンプライアンス業務での大量契約分析にはKira Systems、カスタム文書処理パイプラインにはクラウドOCR API(Microsoft中心の事務所にはAzure Document Intelligence、AWSネイティブの事務所にはAmazon Textract)を使用します。ABBYY FineReaderやAdobe Acrobat Proなどのデスクトップツールは、文書比較、墨消し、アドホックなOCRのための部門レベルのユーティリティとして機能します。
リーガルテックを開発する開発者向け:法律アプリケーション(法律事務所の内部ツールやリーガルテック製品)向けに文書処理パイプラインを構築する場合、最初の判断基準は、生のテキスト(TextractやAzure DIなどのクラウドOCR APIを使用)が必要か、それとも構造化されたフィールドレベルのデータ(AI抽出アプローチを検討)が必要かです。Tesseractは、前処理用の無料のローカルOCRエンジンとして有効です。また、Docling(オープンソースの文書変換ライブラリ)は、生のOCR出力とLLM対応のMarkdownまたはJSONの間のギャップを埋めます。一般的なOCRソフトウェア比較ガイドでは、デプロイメントモデルやAPIベンチマークを含め、開発者向けツールをより詳しく解説しています。
よくある質問
一般文書と比べて、法律文書向けOCRソフトウェアの違いは何ですか?
法律文書向けOCRは、一般的なOCRツールが失いがちな構造要素を保持する必要があります:ベーツナンバリング、秘匿特権の表示、複数段組の読取順序(弁論要旨、法令)、ページをまたぐ条項の連続性、専門的な法律用語(ラテン語の用語、法令引用形式)などです。さらに、そのツールはABAモデルルール1.6(c)のデータセキュリティ要件を満たす必要があります—暗号化処理、アクセス制御、アップロードされた文書がベンダーのAIモデルの学習に使用されるかどうかの明確化です。
ABAモデルルール1.1は法律事務所にOCRの使用を義務付けていますか?
ABAモデルルール1.1のコメント8は、弁護士に対し「法律とその実務の変化、および関連するテクノロジーに伴う利点とリスクについていくこと」を求めています。これはOCRの採用を具体的に義務付けるものではありませんが、文書中心の業務分野を扱う弁護士が、文書処理における能力、効率性、機密性に直接影響するテクノロジーについて無知でいることはできないことを意味します。最新のABA調査時点で、38州がテクノロジー能力に関するコメントを採用していました。スキャン文書を処理する法律事務所にとって、機密性要件(ルール1.6)を満たし、正確で検証可能な出力を提供するOCRツールを選択することは、有能な業務の一環としてますます期待されています。
個人法律事務所にとって最適な無料OCRオプションは何ですか?
スキャン文書から検索可能なPDFが必要な個人開業弁護士にとって、評価期間中はAdobe Acrobat Proの無料トライアルが最も実用的な選択肢です。継続的な無料利用には、OCRFeederのようなGUIラッパーを通じたTesseractが基本的な機能を提供しますが、技術的なセットアップが必要で、複雑な法務レイアウトでは精度が低くなります。ImageToTable.aiの無料プランでは月間の抽出回数に制限がありますが、検索可能なPDFではなく契約書やフォームからの構造化データが必要な場合に最適な選択肢です。全カテゴリーの無料プランの詳細な比較は、無料OCRソフトウェアガイドをご覧ください。
OCRソフトウェアはeDiscoveryの文書処理に対応できますか?
一般的なOCRツールは証拠開示文書からテキストを抽出できますが、eDiscoveryにはテキスト抽出以上のもの、つまり文書を整理、重複排除、検索、タグ付け、そして特権ログやベイツ番号を保持したまま成果物を生成するレビュープラットフォームが必要です。RelativityOneやEverlawのようなプラットフォームは、完全なeDiscoveryワークフローの一部としてOCRを組み込んでいます。スタンドアロンのOCRツール(デスクトップ版またはAPI)はテキストをeDiscoveryプラットフォームに取り込むことはできますが、それを代替するものではありません。小規模な証拠開示(1万文書未満)では、Adobe Acrobat ProでOCR処理を行い、手動でレビューを管理する事務所もありますが、ボリュームが大きくなれば、専用のeDiscoveryプラットフォームの方が費用対効果が高く、防御可能です。
OCRは契約条項(契約解除権や免責額の上限など)を正確に抽出できますか?
従来のOCRは、最も正確なエンジンであっても、文字を抽出するのであって、意味を抽出するわけではありません。「indemnification」という文字列が7ページにあることは教えてくれますが、補償義務と補償制限を区別したり、上限額を周囲の文言から分離したりすることはできません。条項レベルの抽出には、Kira Systemsのような専門的な契約分析ツール(1,300以上の法務条項に対応した訓練済みMLモデルを搭載)か、文書を位置ではなく意味的に読み取るAI抽出ツールが必要です。例えばImageToTable.aiのカスタム列抽出では、「免責額の上限」のような列を定義できます。AIが文書を読み取り、関連条項を見つけ、上限額を特定し(条項がない場合は「見つかりません」を返します)、それをスプレッドシートのセルに入力します。
クラウドベースのOCRは機密性の高い法律文書に対して安全ですか?
これはベンダーのデータ取扱い慣行に依存するため、ABAモデル規則1.6(c)では、弁護士がクライアント文書をアップロードする前にセキュリティを評価する「合理的な努力」を行うことを求めています。OCRベンダーに使用前に尋ねるべき重要な質問:文書は転送中および保存中に暗号化されていますか?アップロードされた文書はモデルトレーニングに使用されますか(はいの場合、インフォームドコンセントなしにクライアントデータと共に使用できません)?サービスはSOC 2 Type II認証を取得していますか?処理後、文書は希望するタイミングで削除できますか?データはどこで処理されますか(データ所在地は規制遵守に関係します)?このガイドで紹介するツールのうち、RelativityOneのようなエンタープライズプラットフォームや、AWS、Google、AzureのクラウドAPIサービスは、それぞれ詳細なコンプライアンスレポートを公開しています。ImageToTable.aiはファイルをメモリ上で処理し永続的に保存せず、データ取扱い慣行に関する文書を提供しています。
従来のOCRとAI抽出の違いは、法律文書において何ですか?
従来のOCRは、スキャンされたテキストを機械読み取り可能な文字に変換します。つまり、ピクセルのページを文字・数字・スペースのページに変えるものです。AI抽出はさらに進んで、人間のように文書を読み取ります。「§ 78j(b)」が法的引用であること、署名欄の数字が補償上限であること、ヘッダーの「CONFIDENTIAL」が文書全体の取り扱いを変更することを認識します。OCRとAI抽出の違いは、あらゆる法的ユースケースにとって重要です。なぜなら、目標は「このテキストを検索可能にする」ことではなく、「一連の文書から必要な特定のデータポイントを見つける」ことだからです。当社のOCRとAI抽出の詳細な比較では、具体的な法律文書の例を用いて、技術的および実用的な違いを説明しています。
あなたの業務に合った選択をする
法律業界とOCRの関係は、ILTA調査データが明確に示す緊張関係によって常に形作られてきました。法律事務所はデジタル化が必要であることを認識しています(88%がほぼまたは完全にクラウドを利用)が、57%は新しいテクノロジー導入の最大の障壁として変化への抵抗を挙げ、54%はセキュリティ上の懸念を挙げています。この緊張関係は、「最も正確な」OCRツールを見つけることで解決されるものではありません。使用される特定のワークフローにツールを合わせ、そのツールのデータセキュリティ慣行がABAモデルルール1.6に基づく事務所の義務を満たしていることを検証することで解決されます。
ディスカバリ文書を処理する訴訟事務所にとって、適切な選択は組み込みOCRを備えたeDiscoveryプラットフォーム(RelativityOne、Everlaw)です。取引文書全体の契約データを抽出する取引実務にとって、適切な選択はテンプレートやトレーニングを必要としないツール(ImageToTable.ai、Kira Systems — ボリュームと予算に応じて)です。検索と保存のために受信文書をデジタル化する必要がある個人開業医にとって、Adobe Acrobat ProやABBYY FineReaderは基本的な機能を適切にカバーします。そして、規模に関係なくすべての事務所にとって、適切なアプローチには検証ステップが含まれます。サブスクリプションや導入を決定する前に、ベンダーのサンプルセットではなく、実際の文書でツールをテストすることです。
間違ったOCRツールを選択するコストは、サブスクリプション料金だけではありません。抽出出力を手動で修正する時間もコストです。テンプレートベースのツールがレイアウトに馴染みがないために見つけられなかった契約条項の見落としもコストです。プロダクションで特権指定が失われることもコストです。これらは比較表では予測できないコストです。そのため、このリストのすべてのツールは、無料トライアル、無料ティア、またはデモを提供しています。それらを活用してください。
あなたの事務所に最適なOCRツールへの最短ルート:デモセットではなく、あなたの文書でテストすることです。
無料ティアとトライアル期間を活用してください。検討中の各ツールに、実際の契約書、実際の裁判所提出書類、実際のディスカバリ文書をアップロードしてください。テキスト出力の精度だけでなく、データが実際に使用できる形式で出力されるかどうかも比較してください。