El mejor software OCR para documentos legales en 2026:
9 herramientas para contratos, escritos y eDiscovery comparadas
La Encuesta Tecnológica 2025 de la International Legal Technology Association — que abarca 580 bufetes, más de 152 000 abogados y aproximadamente 302 820 usuarios en total — reveló que al menos el 76 % de los bufetes han adoptado sistemas de gestión documental en la nube. Sin embargo, la misma encuesta informó que el 57 % de las organizaciones legales aún citan la "resistencia al cambio" como su principal barrera para adoptar nueva tecnología, y el 54 % señala preocupaciones de seguridad y riesgo. Esa tensión — entre saber que la digitalización es inevitable y necesitar elegir herramientas que satisfagan tanto los deberes éticos de la ABA como las realidades prácticas de los flujos de trabajo documentales legales — es el contexto de cada evaluación en esta lista. Esta guía se investigó revisando la documentación publicada de cada herramienta, sus certificaciones de cumplimiento y sus páginas de precios, complementada con las Reglas Modelo de la ABA sobre competencia tecnológica y confidencialidad, datos publicados de la encuesta de ILTA y relatos de primera mano de profesionales legales en r/LawFirm y r/legaltech. Cada herramienta aquí se evalúa según los requisitos específicos del procesamiento de documentos legales: extracción de cláusulas contractuales en acuerdos de varias páginas, preservación de la numeración Bates y las designaciones de privilegio, manejo del formato de escritos de varias columnas y las obligaciones de seguridad de datos impuestas por las Reglas Modelo de la ABA 1.1 y 1.6. Divulgación: ImageToTable.ai, una herramienta moderna de extracción con IA, está incluida en esta selección. No tengo afiliación con ninguna otra herramienta de esta lista. Todos los precios provienen de páginas públicas de los proveedores a junio de 2026, y cada enlace externo dirige a la página del producto o de precios del proveedor para que puedas verificar las afirmaciones de forma independiente.
Conclusiones clave
- Una herramienta OCR con un 99,7 % de precisión puede arruinar tu registro de privilegios al tratar un encabezado "CONFIDENCIAL" como texto del cuerpo y un número Bates como decoración de página.
- Tu revisión de contratos falla no cuando el OCR lee mal una palabra, sino cuando extrae "indemnización" sin saber si limita la responsabilidad o la crea.
- La única evaluación que importa para tu práctica es si la herramienta preserva los seis elementos estructurales que dan significado legal a los documentos legales — empezando por los números Bates, las marcas de privilegio y la continuidad de cláusulas entre páginas.
Qué Hace Que el OCR Legal Sea Diferente de la Captura Genérica de Documentos
Un bufete de abogados no necesita un OCR que sea "95% preciso en documentos estándar". Necesita un OCR que lea correctamente un acuerdo de fusión de 78 páginas con cláusulas anidadas, anexos A a F, notas manuscritas al margen y un sello Bates en la esquina inferior derecha de cada página — y luego genere los datos en una forma que cumpla con las obligaciones éticas del bufete bajo las Reglas Modelo de la ABA.
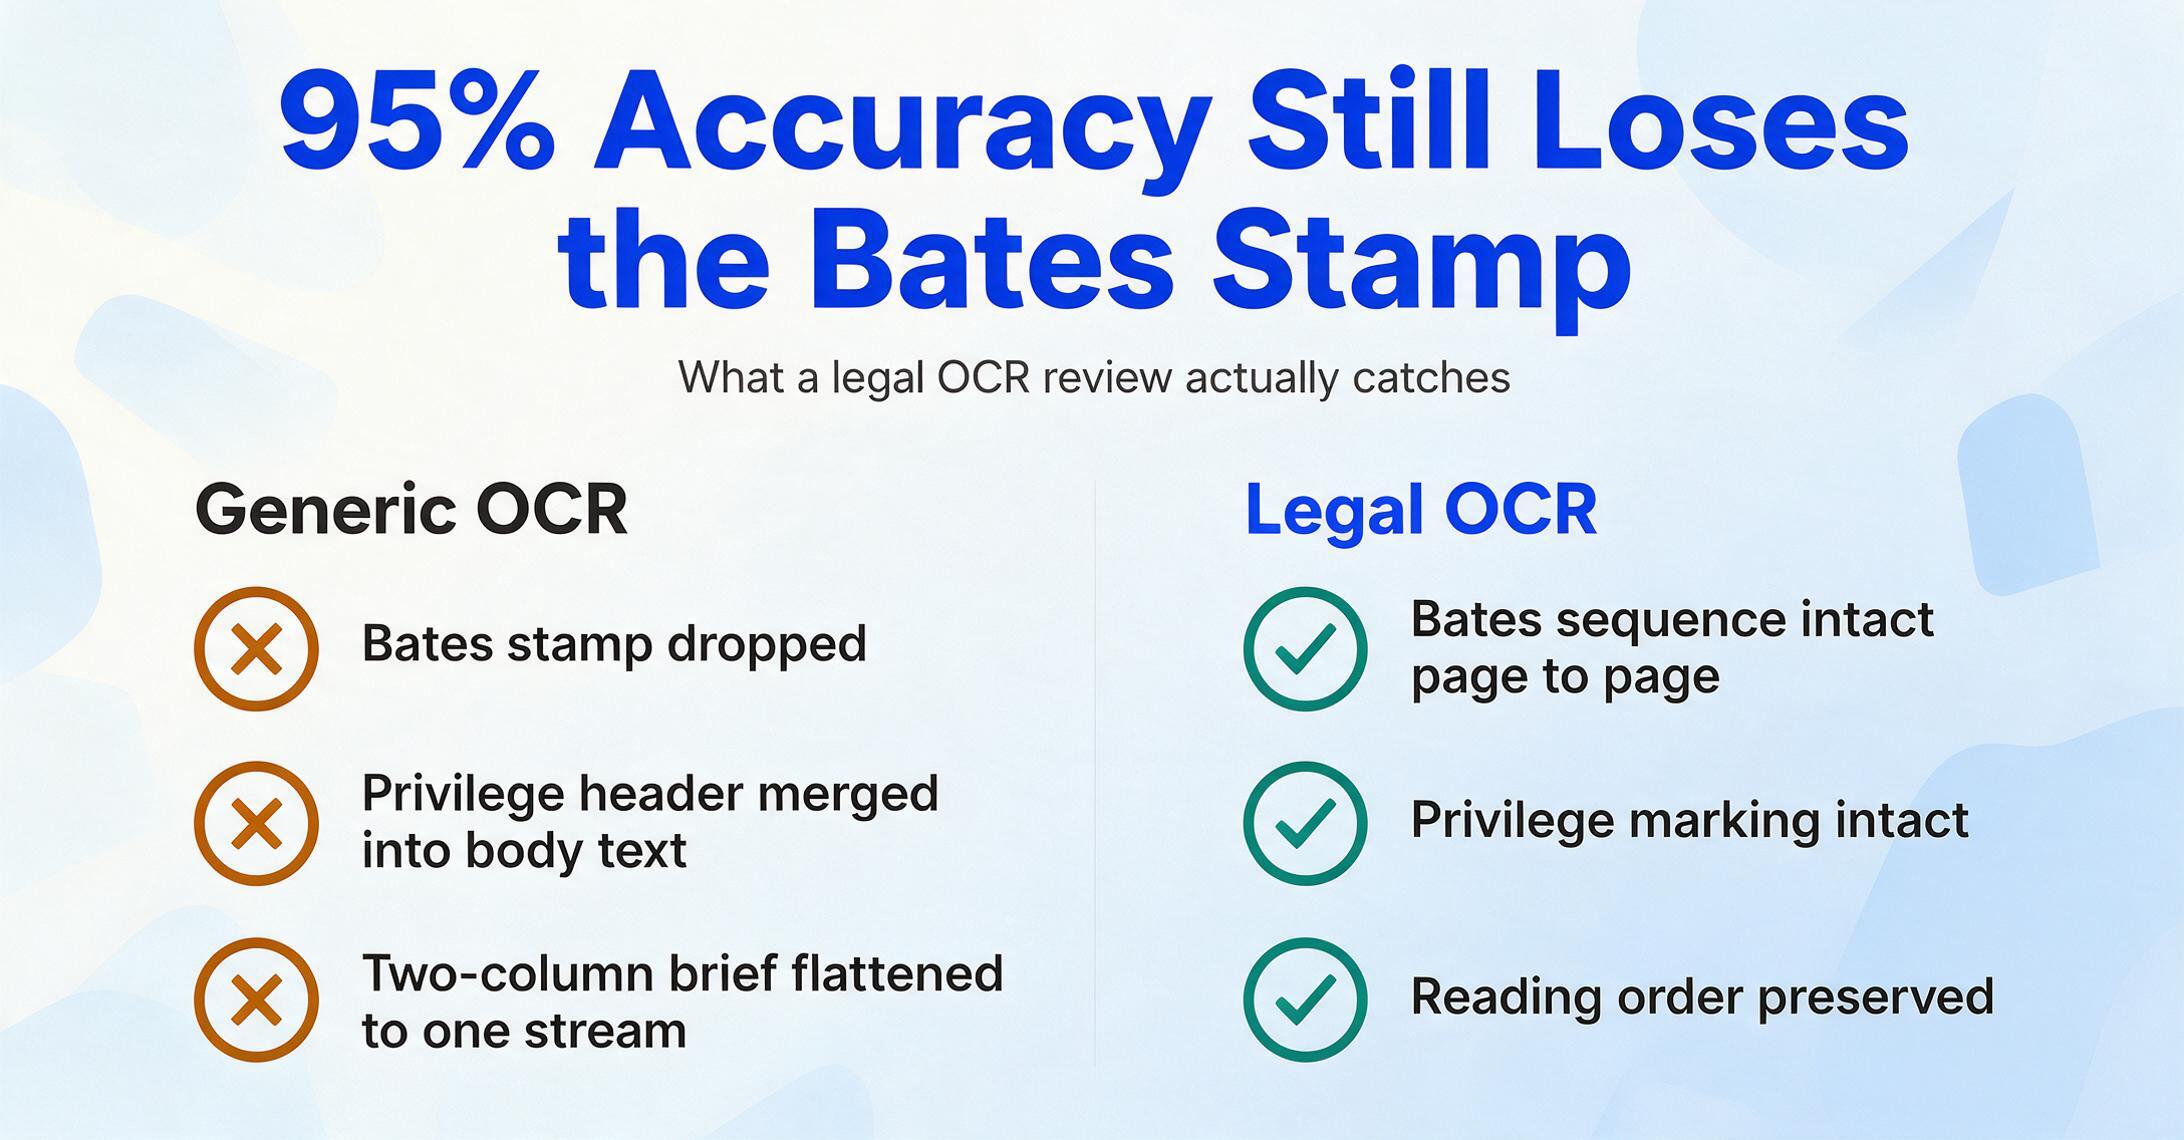
El enfoque basado en texto que la mayoría de la gente piensa cuando escucha "OCR" — reconocer caracteres, generar un archivo de texto — se queda corto en la práctica legal por razones estructurales que ningún ajuste de precisión puede corregir. Los documentos legales llevan significado en su diseño: una cláusula que abarca un salto de página, una notación de privilegio en el encabezado, un bloque de firma en la página final del anexo. Cuando el OCR estándar aplana escritos de varias columnas en un solo flujo de texto o fusiona una anotación al pie en la última línea del texto del cuerpo, el resultado no es solo desordenado — puede ser profesionalmente perjudicial.
Varios requisitos específicos definen el OCR legal como un caso de uso distinto:
- Preservación de la numeración Bates — La producción de documentos en litigios depende del sello Bates. Un OCR que omita, fusione o lea mal los números de página rompe la cadena de custodia de las pruebas.
- Marcas de secreto profesional abogado-cliente — Los encabezados "PRIVILEGED AND CONFIDENTIAL", las zonas de redacción y las etiquetas de designación deben sobrevivir intactos a la extracción. Perderlos crea riesgo de renuncia al privilegio.
- Formato legal de varias columnas — Los escritos presentados bajo el formato de la Fed. R. Civ. P., los estatutos y los reglamentos utilizan con frecuencia diseños de dos columnas. El OCR debe preservar el orden de lectura columna por columna, no de izquierda a derecha a través de ambas.
- Seguimiento de cláusulas y tablas entre páginas — Una cláusula de terminación en un arrendamiento comercial puede comenzar en la página 12 y concluir en la página 14. Una tabla de tarifas puede dividirse a través de un límite de página. Las herramientas que tratan cada página como una unidad de extracción independiente pierden la relación estructural.
- Vocabulario especializado y citas — Las frases en latín (res judicata, sua sponte), las citas legales (Fed. R. Civ. P. 12(b)(6), 15 U.S.C. § 78j(b)) y los nombres de las partes en formatos variados son habituales. Los motores de OCR que dependen de léxicos estándar los marcan como errores.
- Seguridad de datos según la Regla Modelo 1.6(c) de la ABA — Desde agosto de 2012, la Regla Modelo 1.6(c) de la ABA ha exigido a los abogados "hacer esfuerzos razonables para prevenir la divulgación inadvertida o no autorizada, o el acceso no autorizado, a información relacionada con la representación de un cliente". Cualquier herramienta de OCR que procese documentos de clientes debe ofrecer cifrado de datos, controles de acceso y claridad sobre si los documentos cargados se utilizan para el entrenamiento de modelos.
Las herramientas a continuación fueron seleccionadas y clasificadas con estas seis dimensiones como marco de evaluación. Para una visión general completa de los fundamentos de la tecnología OCR y cómo el reconocimiento tradicional de caracteres difiere de la extracción moderna basada en IA, consulte nuestra guía sobre qué es el OCR y cómo funciona realmente.
Tabla comparativa rápida: herramientas de OCR legal de un vistazo
| Herramienta | Precio inicial | Ideal para | Fortaleza legal | Limitación clave |
|---|---|---|---|---|
| ABBYY FineReader | $199 único / ~$16 al mes | OCR de escritorio + preservación de diseño | Líder en retención de formato; seguridad sin conexión | Solo escritorio; integración API limitada |
| Adobe Acrobat Pro | $22.99/mes | Flujo de trabajo legal con PDF y edición | Estándar del sector; redacción, comparación, numeración Bates integradas | Sin extracción de datos estructurados más allá de PDF buscable |
| Amazon Textract | ~$1.50/1,000 páginas | OCR en la nube escalable para eDiscovery | Formularios, tablas, escritura a mano; extracción de campos por consulta | Requiere conocimientos de AWS; costos escalan con el volumen |
| Google Document AI | ~$1.50/1,000 páginas | Evidencia multilingüe y manuscrita | Amplia cobertura de idiomas; clasificación de documentos | Dependencia de la nube; requiere configuración técnica |
| Azure Document Intelligence | ~$1.50/1,000 páginas | Flujos de trabajo para despachos centrados en Microsoft | Modelos predefinidos de contratos; integración con ecosistema M365 | Mejor valor si ya usas Azure/M365 |
| Kira Systems | Precio empresarial personalizado | Análisis de contratos de alto volumen y diligencia en fusiones y adquisiciones | Diseñado para extracción de cláusulas contractuales y cumplimiento de manuales | Solo contratos; costoso; requiere entrenamiento para cláusulas personalizadas |
| RelativityOne | Precio empresarial personalizado | Procesamiento y revisión de eDiscovery | Estándar del mercado para revisión de documentos en litigios con OCR integrado | Excesivo y demasiado caro para despachos sin litigios |
| ImageToTable.ai | Gratuito; desde $9/mes | Extracción de datos de contratos sin plantillas | Extracción semántica; sin necesidad de entrenamiento; procesamiento por lotes a Excel | Herramienta nueva; ecosistema más pequeño que los actores consolidados |
| Tesseract | Gratuito (código abierto) | Despachos con presupuesto ajustado e integraciones de desarrolladores | Cero costo; integración personalizada en procesos | Deficiente en diseños complejos; sin interfaz gráfica; esfuerzo de configuración significativo |
Cómo seleccionamos y probamos
Las nueve herramientas de esta comparativa se eligieron para representar todo el espectro de casos de uso de OCR legal, no solo los productos más populares. La selección abarca cuatro categorías: OCR de escritorio (ABBYY, Adobe Acrobat Pro) para despachos que prefieren el procesamiento sin conexión y el control de calidad manual; APIs de OCR en la nube (Amazon Textract, Google Document AI, Azure Document Intelligence) para despachos que construyen canalizaciones documentales automatizadas; plataformas legales especializadas (Kira Systems, RelativityOne) para casos de uso específicos como análisis de contratos y eDiscovery; y extracción moderna con IA (ImageToTable.ai) además de código abierto (Tesseract) para despachos que necesitan alternativas a los enfoques tradicionales basados en plantillas.
Cada herramienta se evaluó según esos seis criterios legales específicos de la sección anterior — preservación de numeración Bates, retención de marcas de privilegio, manejo de múltiples columnas, seguimiento entre páginas, ajuste de vocabulario y preparación de seguridad según la Regla 1.6 de la ABA — además de métricas estándar como transparencia de precios, esfuerzo de configuración e integración con el ecosistema de software legal (Clio, NetDocuments, iManage, Relativity).
Si no está familiarizado con la diferencia básica entre el OCR tradicional (que lee caracteres) y la extracción moderna con IA (que comprende el contenido del documento), la guía sobre qué es el OCR con IA y en qué se diferencia del OCR tradicional le proporciona la base que necesita antes de evaluar herramientas individuales.
1. ABBYY FineReader — El mejor OCR de escritorio para preservar el diseño en el ámbito legal
ABBYY FineReader ha sido el estándar de referencia en OCR de escritorio para profesionales del derecho que necesitan digitalizar documentos sin perder fidelidad de formato — y con razón. Su motor de OCR alcanza sistemáticamente una alta precisión en documentos legales escaneados, y sus capacidades de preservación del diseño hacen que un escrito de 40 páginas con notas al pie, tablas integradas y texto a varias columnas salga con el mismo aspecto que el original.
Dónde destaca en el trabajo legal: La digitalización de archivos es el caso de uso principal. Los despachos que convierten décadas de documentos en papel de expedientes cerrados a PDFs con capacidad de búsqueda necesitan una herramienta que preserve el diseño de la página original — no solo por legibilidad, sino porque la estructura visual de un documento puede tener relevancia probatoria. La función de comparación de documentos de ABBYY también es genuinamente útil para la revisión de contratos: importe dos versiones de un contrato de arrendamiento y la herramienta resalta todos los cambios, incluidos los de formato que una comparación solo de texto pasaría por alto.
Ideal para: Despachos que quieren una herramienta de OCR de escritorio fiable para digitalización por lotes, comparación de documentos y control de calidad manual — especialmente abogados independientes y pequeños despachos que procesan documentos internamente y priorizan la seguridad sin conexión.
No es ideal para: Despachos que construyen canalizaciones documentales automatizadas que requieren extracción basada en API, equipos que necesitan datos estructurados (Excel/CSV/JSON) en lugar de PDFs con capacidad de búsqueda, o cualquier práctica que procese datos de contratos a gran escala — la arquitectura de escritorio de ABBYY implica que cada documento necesita que una persona lo abra, lo revise y lo exporte.
2. Adobe Acrobat Pro — El estándar de la industria legal para flujos de trabajo con PDF
Adobe Acrobat Pro DC no es principalmente una herramienta de OCR, sino una plataforma de gestión de PDF que incluye capacidades de OCR. Pero como la profesión legal funciona con PDF — presentaciones judiciales, producciones de descubrimiento, copias de ejecución de contratos — Acrobat Pro es la herramienta de OCR práctica para gran parte de los flujos de trabajo legales.
Dónde destaca en el trabajo legal: El motor de OCR de Acrobat Pro ("Mejorar escaneos") maneja competentemente la tarea de OCR legal más común: hacer que los documentos escaneados sean buscables. Su verdadero valor está en las funciones de gestión de PDF que rodean al OCR: herramientas de redacción que eliminan permanentemente texto sensible, numeración Bates que aplica sellos secuenciales en documentos de varias páginas, controles de protección con contraseña y permisos que cumplen con el requisito de "esfuerzos razonables" de la Regla Modelo 1.6(c) de la ABA, y comparación de documentos para el seguimiento de versiones de contratos.
Ideal para: Cualquier bufete de abogados que necesite una herramienta PDF todo-en-uno confiable para OCR, redacción, numeración Bates y revisión de documentos — lo que describe a la mayoría de los bufetes. Acrobat Pro es particularmente fuerte para la fase de producción de litigios donde los documentos necesitan OCR, numeración, redacción y producción en un solo flujo de trabajo.
No es ideal para: Extracción de datos estructurados. Acrobat Pro convierte documentos escaneados en texto buscable — no extrae campos de datos específicos (fechas de contratos, nombres de partes, lenguaje de cláusulas) a una hoja de cálculo. Para bufetes que necesitan extraer datos estructurados de contratos o formularios, solo Acrobat es insuficiente.
3. Amazon Textract — OCR en la nube escalable para eDiscovery y procesamiento de documentos
Amazon Textract es el servicio de OCR de documentos gestionado de AWS, y se ha convertido en un backend común para plataformas de procesamiento de documentos legales que necesitan manejar grandes volúmenes de documentos escaneados. A diferencia de las herramientas de escritorio, Textract opera como una API — le envías un documento y recibes una salida JSON estructurada — lo que lo hace adecuado para pipelines automatizados de ingesta de eDiscovery.
Dónde destaca en el trabajo legal: La capacidad de Textract para extraer texto de formularios y tablas es genuinamente útil para el procesamiento de documentos legales a escala. La función "Consultas" — donde preguntas por campos específicos en lenguaje natural ("¿Cuál es la fecha de vigencia de este acuerdo?") — es un paso hacia la extracción semántica que requieren los flujos de trabajo legales. Para equipos de eDiscovery que usan infraestructura AWS, Textract se integra naturalmente en un pipeline de procesamiento: subir documentos a S3, activar la extracción de Textract, indexar la salida en una plataforma de búsqueda.
Ideal para: Departamentos legales empresariales y proveedores de eDiscovery que ya operan en AWS y necesitan OCR de grandes volúmenes de documentos mixtos — producciones de descubrimiento escaneadas, archivos de casos archivados, registros corporativos — como parte de un pipeline de procesamiento automatizado.
No es ideal para: Abogados independientes o pequeños bufetes sin personal técnico. Textract requiere integración API y experiencia en configuración de AWS. Además, no tiene interfaz para la revisión manual de los resultados de extracción, lo que significa que los errores en diseños legales complejos — números Bates mal leídos, celdas de tabla fusionadas — pasan desapercibidos a menos que un humano valide cada salida.
4. Google Document AI — Potente en Multilingüismo y Escritura Manual
Google Document AI compite con Textract en el procesamiento de documentos en la nube, pero ofrece un soporte multilingüe más sólido y se centra en la comprensión de documentos — clasificación, extracción de entidades y análisis de diseño — más que en el OCR puro.
Dónde destaca en el ámbito legal: Para despachos que manejan pruebas en varios idiomas — arbitrajes internacionales, litigios transfronterizos, conjuntos de contratos multilingües — la cobertura lingüística de Document AI es más amplia que la de Textract. Su reconocimiento de escritura manual también es más eficaz con documentos reales y desordenados típicos de las pruebas: borradores anotados, notas manuscritas al margen de contratos impresos, declaraciones juradas firmadas en cursiva. Los procesadores predefinidos de "Document AI Workbench" incluyen opciones para contratos y formularios que reducen el esfuerzo de configuración en comparación con un pipeline de OCR genérico.
Ideal para: Equipos legales que procesan conjuntos de pruebas multilingües, despachos con colecciones mixtas de documentos impresos y manuscritos, y organizaciones que ya operan en Google Cloud.
No es ideal para: Despachos que carecen de recursos de ingeniería en la nube. Document AI, al igual que Textract, es un producto basado en API. Los procesadores predefinidos reducen parte del trabajo de integración, pero aún se necesita personal técnico para configurar, probar y mantener el pipeline. El costo por página también se convierte en un gasto significativo en volúmenes de eDiscovery (decenas o cientos de miles de páginas).
5. Azure Document Intelligence — La Mejor Opción para Despachos Centrados en Microsoft
Azure Document Intelligence (anteriormente Azure Form Recognizer) es el servicio de procesamiento de documentos en la nube de Microsoft. Su principal ventaja para el ámbito legal no es la superioridad técnica sobre Textract o Document AI, sino el ajuste al ecosistema. La encuesta ILTA de 2025 confirmó que Microsoft Azure captura el 79% de las implementaciones de servidores en la nube en despachos de abogados. Si su despacho ya opera con Microsoft 365, SharePoint y Azure, Document Intelligence se integra en la infraestructura existente sin necesidad de adoptar una nueva plataforma en la nube.
Dónde destaca en el ámbito legal: Document Intelligence incluye modelos predefinidos para contratos que extraen partes, fechas, términos y lenguaje de cláusulas — un punto de partida útil para integraciones de CLM (Gestión del Ciclo de Vida del Contrato). Los modelos de extracción personalizados se pueden entrenar en tipos específicos de formularios legales (formularios de admisión, cartas de encargo, listados de tribunales) con relativamente pocos documentos de entrenamiento. Para despachos que ya usan Microsoft Purview para eDiscovery, Document Intelligence alimenta el texto extraído en la misma infraestructura de cumplimiento y búsqueda.
Ideal para: Despachos de abogados y departamentos legales corporativos que operan en Microsoft Azure/M365 y desean añadir capacidades de OCR y extracción de documentos a su pila existente sin adoptar una segunda plataforma en la nube.
No es ideal para: Despachos que no están en la infraestructura de Microsoft — la propuesta de valor se debilita significativamente fuera del ecosistema Azure. También es menos adecuado para despachos pequeños que carecen del personal de TI para gestionar servicios de API en la nube.
6. Kira Systems — Análisis de contratos especializado para fusiones, adquisiciones y diligencia debida
Kira Systems no es una herramienta OCR genérica. Es una plataforma especializada de análisis de contratos utilizada principalmente por grandes despachos de abogados y departamentos jurídicos corporativos para la diligencia debida en fusiones y adquisiciones, la abstracción de arrendamientos y la revisión de contratos para cumplimiento normativo. Kira utiliza aprendizaje automático entrenado en documentos legales para identificar y extraer aproximadamente más de 1300 tipos de cláusulas y puntos de datos, como disposiciones sobre cambio de control, cláusulas de cesión, límites de indemnización y el alcance de pactos de no competencia.
Dónde destaca en el trabajo legal: Kira sobresale cuando la tarea consiste en extraer los mismos datos de cientos o miles de contratos similares. Un bufete que revisa 200 contratos de una empresa objetivo en una semana de diligencia debida para una fusión o adquisición puede usar Kira para extraer cada cláusula de "ley aplicable", cada disposición de "cambio adverso significativo" y cada restricción de "cesión sin consentimiento", y exportar los resultados como una tabla de comparación estructurada. La revisión final y definitiva aún requiere el criterio de un abogado, pero Kira se encarga del trabajo de lectura y búsqueda que, de otro modo, consumiría a tres asociados durante la semana.
Ideal para: Grandes despachos de abogados que realizan revisiones de contratos de alto volumen: diligencia debida en fusiones y adquisiciones, abstracción de arrendamientos de carteras inmobiliarias y revisiones de cumplimiento normativo. También es valioso para departamentos jurídicos corporativos que gestionan grandes repositorios de contratos.
No es ideal para: Bufetes pequeños y medianos: el precio es solo para empresas y no se divulga públicamente, pero normalmente comienza en cinco cifras anuales. Kira solo procesa contratos: no maneja escritos judiciales, documentos de descubrimiento, formularios u otros tipos de documentos legales que no sean contratos. Y, a diferencia de las herramientas de extracción con IA que funcionan directamente, Kira requiere capacitación para tipos de cláusulas personalizadas más allá de su biblioteca integrada.
7. RelativityOne: el estándar de eDiscovery con OCR integrado
RelativityOne es la plataforma de eDiscovery más utilizada en los despachos de abogados, ya que procesa y revisa documentos para litigios e investigaciones. Incluye capacidades de OCR como parte de su canal de procesamiento de documentos (cada documento subido se somete a OCR y se vuelve buscable automáticamente), más que como una función independiente.
Dónde destaca en el trabajo legal: Para el trabajo de litigios, RelativityOne resuelve el problema de OCR que otras herramientas no pueden abordar: qué sucede después de que se extrae el texto. En eDiscovery, el OCR no es el objetivo final, sino el requisito previo para la búsqueda, la revisión, el etiquetado y la producción. RelativityOne gestiona todo el ciclo de vida: ingesta de documentos (incluidos PDF escaneados y TIFF de solo imagen), ejecución de OCR, indexación del texto, búsqueda por palabras clave y booleanas en toda la recopilación, y producción de documentos pertinentes con numeración Bates y registros de privilegios intactos. Para los despachos que manejan cualquier volumen de descubrimiento en litigios, este flujo de trabajo integral de procesamiento y revisión es más valioso que el porcentaje de precisión de cualquier motor de OCR individual.
Ideal para: Departamentos de litigios y despachos de abogados que manejan eDiscovery con regularidad, desde firmas de tamaño mediano con grupos de práctica de descubrimiento dedicados hasta grandes firmas con equipos de apoyo a litigios a gran escala.
No es ideal para: Despachos que no realizan descubrimiento en litigios: la plataforma es excesiva para el procesamiento transaccional de documentos, la revisión de contratos o la digitalización general de oficinas. Los precios comienzan en niveles empresariales (normalmente $50,000+ anuales), lo que la deja fuera del alcance de los profesionales independientes y las pequeñas firmas. Para una alternativa de plataforma eDiscovery diseñada para equipos más pequeños, Everlaw ofrece una plataforma eDiscovery nativa de la nube con capacidades similares de ingesta por OCR a un precio de entrada más bajo.
8. ImageToTable.ai — Extracción sin plantilla para datos de contratos
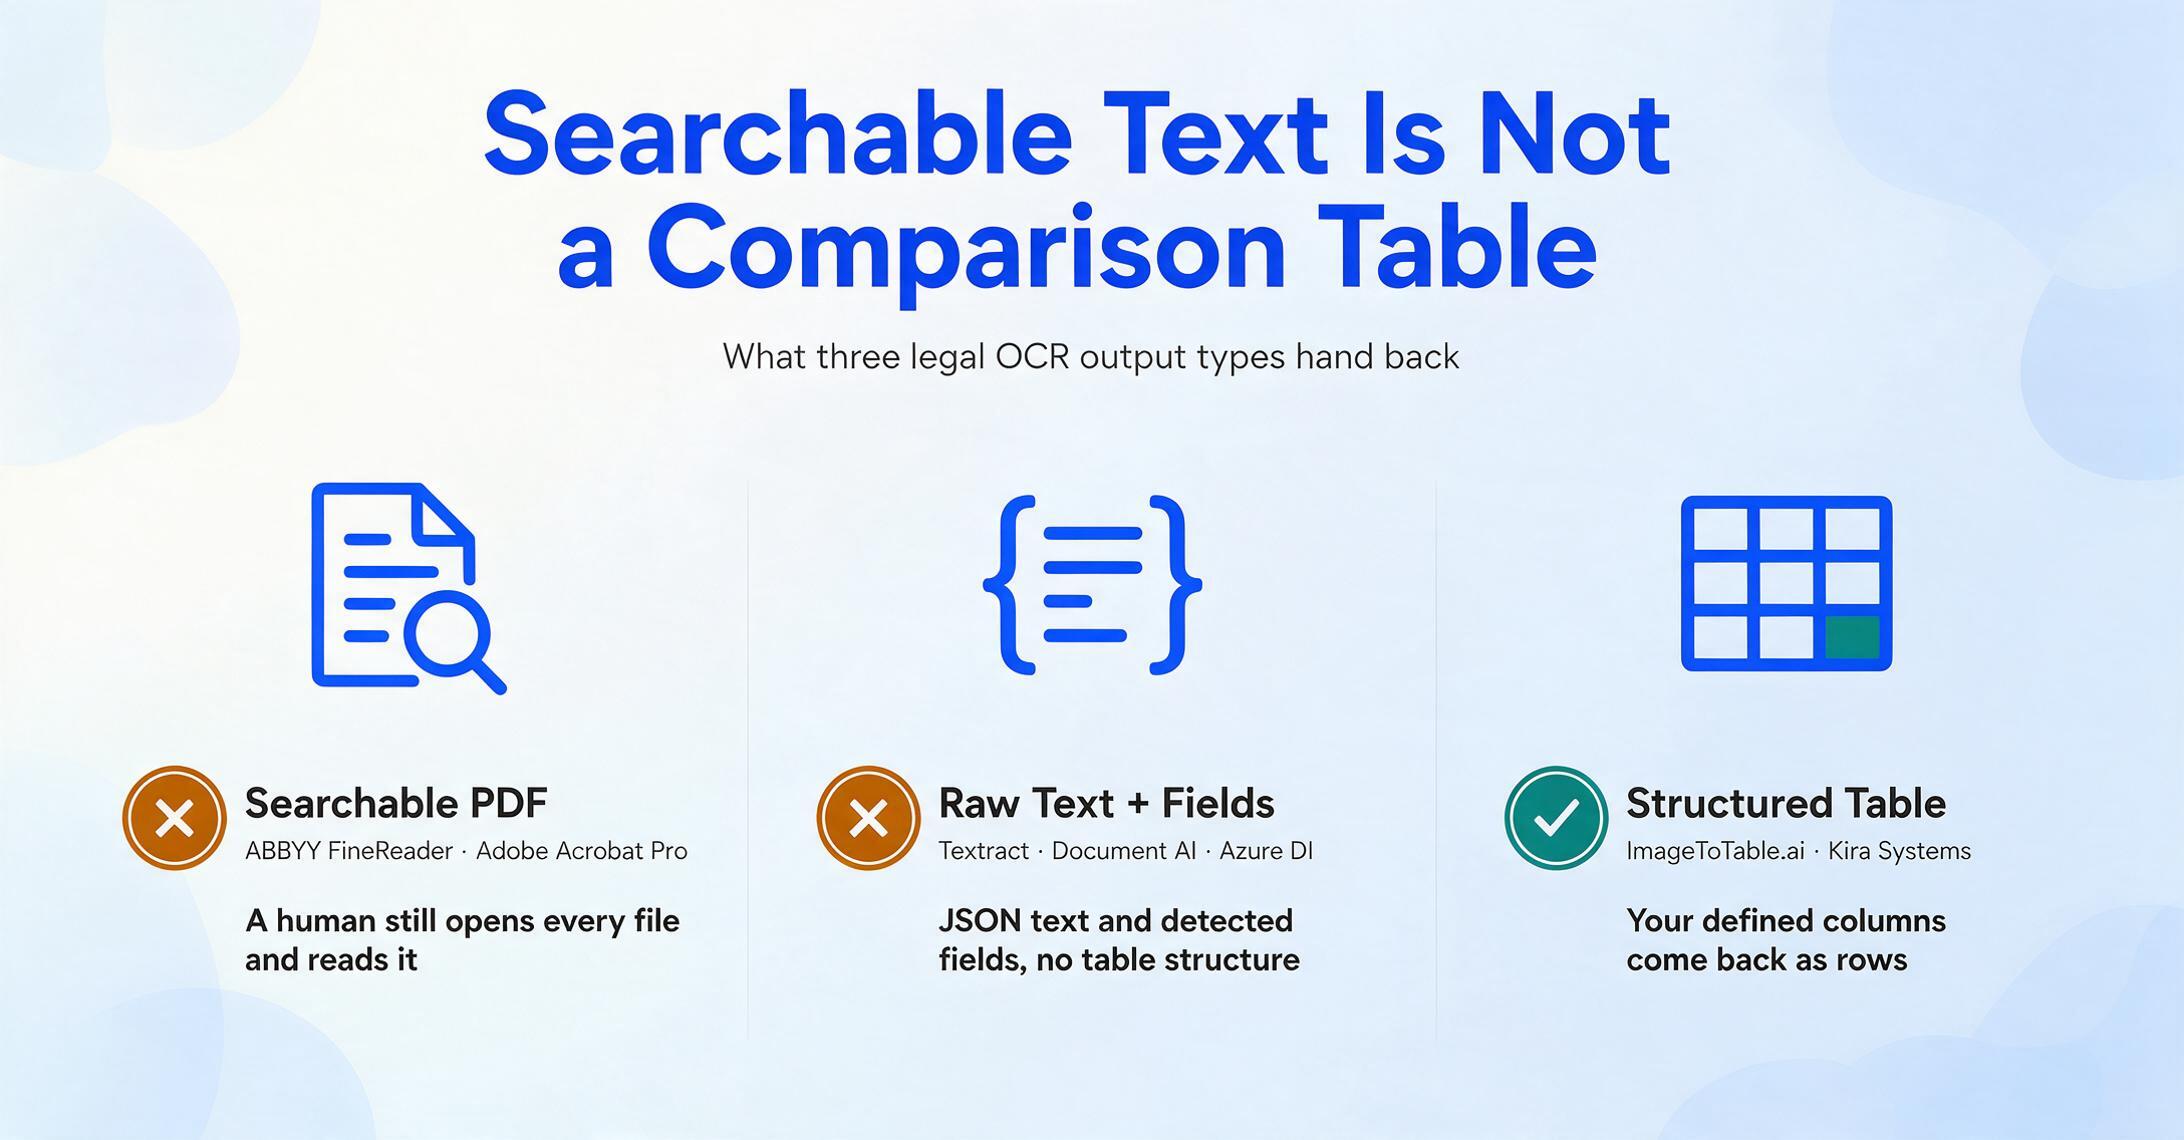
Las herramientas anteriores comparten en gran medida una suposición central: que la estructura de un documento es lo suficientemente predecible como para definir reglas o entrenar modelos para ella. ABBYY conserva el diseño pero no extrae datos estructurados. Kira extrae datos estructurados pero requiere entrenamiento y solo maneja contratos. Las API de OCR en la nube (Textract, Document AI, Azure DI) devuelven texto sin procesar y campos de formulario detectados, pero no organizan los datos en la estructura de tabla que la mayoría de los equipos legales necesitan para el análisis.
ImageToTable.ai aborda el problema de manera diferente. En lugar de partir del diseño del documento (extracción basada en posición), parte de la salida del usuario: usted define las columnas que desea y la IA encuentra los datos coincidentes al comprender qué significa cada campo en la página. Esto se llama Extracción de Columnas Personalizadas y pertenece a una categoría que la industria llama AI Data Extraction, distinta del OCR tradicional (que lee caracteres pero no los comprende) y del Procesamiento Inteligente de Documentos (que requiere plantillas y entrenamiento).
Dónde destaca en el trabajo legal: La ventaja práctica para los profesionales legales es la independencia del formato. Un abogado que revisa NDAs de cinco contrapartes diferentes encontrará cinco diseños distintos: algunos de una página, otros de siete, algunos con anexos, otros sin ellos. Una herramienta basada en plantillas necesitaría una configuración separada para el formato de cada contraparte. ImageToTable.ai lee los documentos por contenido semántico, no por posición. Defina columnas para "Party Name", "Effective Date", "Governing Law", "Confidentiality Period" y "Non-Compete Scope (Yes/No)" una sola vez, y la IA extrae estos campos de los cinco documentos sin importar dónde se encuentren en la página. Los resultados se exportan a una única tabla de Excel: una fila por contrato.
La herramienta también admite Procesamiento por lotes prioritario: suba un conjunto completo de documentos de diligencia debida, defina sus columnas de extracción y la IA procesa el lote como una sola operación con salida combinada. Para un despacho que recibe 30 contratos para una operación, eso significa una carga, una ejecución de extracción, un archivo de Excel, no treinta operaciones de OCR individuales.
ImageToTable.ai procesa entradas en PDF, JPG, PNG, WebP y AVIF. Admite hasta un 99% de precisión en datos de tablas impresas y procesa una sola página en 5-10 segundos, aproximadamente 18 veces más rápido que la entrada manual de datos. El complemento de Google Sheets permite a los equipos legales extraer datos de contratos directamente a una hoja de cálculo sin salir de su entorno de gestión de documentos. Y la función Enlace de Recopilación, un enlace de carga compartible con código de verificación, permite a los despachos recopilar documentos de clientes, abogados contrarios o terceros sin exigirles que se registren.
Ideal para: Equipos legales que necesitan datos estructurados extraídos de contratos, acuerdos y formularios legales en múltiples formatos de documento, especialmente despachos que realizan diligencia debida en M&A, análisis de carteras de contratos o procesamiento de documentos de admisión. Adecuado para despachos de todos los tamaños gracias al nivel gratuito y los precios transparentes.
No es ideal para: Flujos de trabajo de eDiscovery en litigios que requieran funciones completas de plataforma de revisión (RelativityOne cubre ese caso de uso). Firmas que necesitan salida PDF con preservación de formato en lugar de datos estructurados en hojas de cálculo. Equipos con necesidades muy simples (un PDF buscable de un contrato) encontrarán que las capacidades de la herramienta superan sus requisitos.
Los archivos se procesan de forma segura y no se almacenan. Pruebe a extraer cláusulas clave, fechas y nombres de las partes de un contrato de muestra.
9. Tesseract — Opción gratuita de código abierto para firmas lideradas por desarrolladores
Tesseract es el motor de OCR de código abierto más utilizado, mantenido por Google desde 2006. Es gratuito, admite más de 100 idiomas y cuenta con una comunidad de desarrolladores activa que ha creado envoltorios y herramientas (OCRFeeder, gImageReader) que proporcionan una interfaz gráfica básica.
Dónde destaca en el trabajo legal: Para firmas con capacidad técnica interna, Tesseract ofrece algo que ninguna herramienta comercial puede igualar: despliegue sin costo a cualquier volumen. Una firma que necesite aplicar OCR a 50,000 páginas de archivos de casos sin presupuesto para software empresarial puede configurar un flujo de Tesseract en un solo servidor y procesar toda la colección al costo de la electricidad únicamente. Las firmas que utilizan sistemas de gestión documental con soporte para integraciones personalizadas pueden añadir Tesseract como backend local de OCR para la ingesta de documentos escaneados.
Mejor para: Equipos legales liderados por desarrolladores, firmas con personal de TI que pueda gestionar herramientas de línea de comandos, y organizaciones conscientes del presupuesto que prioricen el costo cero de licencia sobre la facilidad de uso y la precisión en diseños complejos.
No es ideal para: Profesionales legales sin conocimientos técnicos — Tesseract no tiene GUI profesional, ni equipo de soporte, ni SLA. La precisión en documentos legales de varias columnas, escaneos de baja calidad y documentos con fuentes mixtas es notablemente peor que las alternativas comerciales, lo que implica más tiempo de corrección manual. Como se señala en nuestra comparativa de las mejores herramientas de OCR de código abierto, Tesseract sigue siendo una opción sólida para desarrolladores que construyen flujos personalizados, pero requiere un esfuerzo de ingeniería significativo para convertirlo en un producto.
¿Qué herramienta de OCR es la adecuada para su bufete?
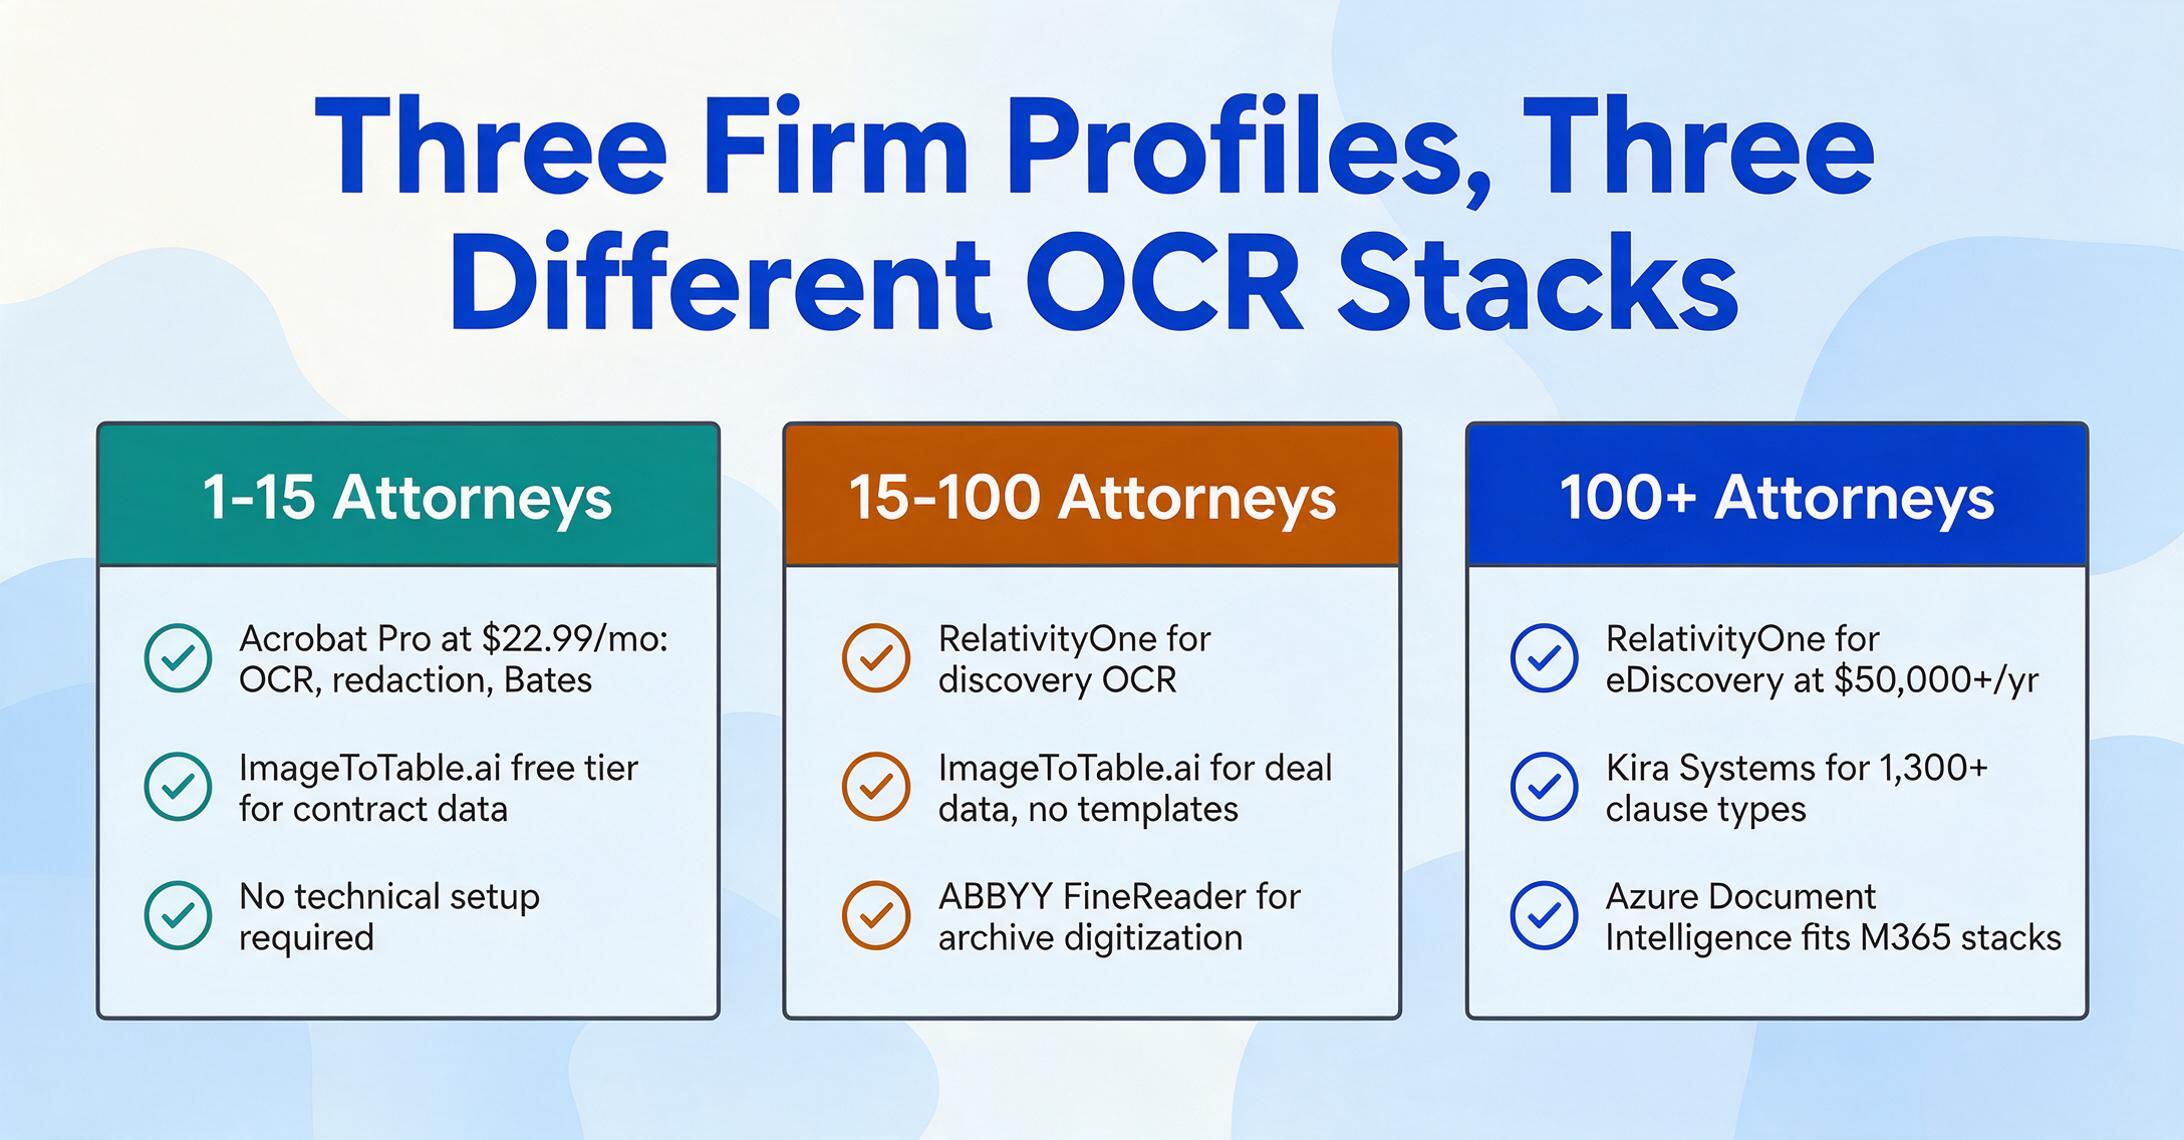
No existe una única herramienta de OCR legal que sea la mejor: la elección correcta depende del área de práctica, el volumen de documentos, la capacidad técnica y el flujo de trabajo principal de su bufete. Así se desglosa la decisión según el perfil del bufete:
Abogados en ejercicio independiente y bufetes pequeños (1-15 abogados): La necesidad de OCR legal más común para este grupo es hacer que los documentos escaneados sean buscables y, ocasionalmente, extraer datos de contratos o formularios judiciales. Adobe Acrobat Pro por $22.99/mes cubre el flujo de trabajo de PDF, redacción, numeración Bates y OCR básico buscable en una sola herramienta. Para bufetes que necesitan extracción estructurada de datos de contratos — extraer el lenguaje de cláusulas para negociaciones de arrendamiento o comparar términos de cartas de compromiso — el nivel gratuito de ImageToTable.ai ofrece un punto de partida sin costo. Ambas herramientas no requieren configuración técnica.
Bufetes medianos (15-100 abogados): Este grupo suele manejar una combinación de descubrimiento de pruebas en litigios y trabajo transaccional. Para litigios, RelativityOne (o Everlaw con un precio de entrada más bajo) gestiona todo el ciclo de vida de eDiscovery con OCR integrado. Para trabajo contractual en fusiones y adquisiciones, bienes raíces o práctica corporativa, ImageToTable.ai ofrece extracción estructurada de datos sin la carga de capacitación de las herramientas empresariales de análisis de contratos. Los bufetes que necesitan un respaldo de OCR de escritorio confiable para comparación de documentos y digitalización de archivos deben añadir ABBYY FineReader.
Bufetes grandes y departamentos legales corporativos (100+ abogados): Estas organizaciones suelen operar con equipos dedicados de TI y operaciones legales. La configuración óptima es una estrategia por niveles: RelativityOne o Everlaw para el procesamiento de eDiscovery, Kira Systems para análisis de contratos de alto volumen en fusiones y adquisiciones y trabajo de cumplimiento, y una de las API de OCR en la nube (Azure Document Intelligence para bufetes centrados en Microsoft, Amazon Textract para bufetes nativos de AWS) para pipelines personalizados de procesamiento de documentos. Herramientas de escritorio como ABBYY FineReader y Adobe Acrobat Pro sirven como utilidades a nivel de departamento para comparación de documentos, redacción y OCR ad hoc.
Para desarrolladores que crean tecnología legal: Si está construyendo un pipeline de procesamiento de documentos para una aplicación legal — herramientas internas en un bufete o un producto de tecnología legal — la pregunta inicial es si necesita texto sin procesar (use una API de OCR en la nube como Textract o Azure DI) o datos estructurados a nivel de campo (considere un enfoque de extracción con IA). Tesseract es viable como motor de OCR local gratuito para preprocesamiento, y Docling (una biblioteca de conversión de documentos de código abierto) cubre la brecha entre la salida de OCR sin procesar y Markdown o JSON listos para LLM. La guía general de comparación de software de OCR cubre las herramientas orientadas a desarrolladores con más detalle, incluidos los modelos de implementación y los puntos de referencia de API.
Preguntas Frecuentes
¿Qué hace que el OCR para documentos legales sea diferente del OCR para documentos generales?
El OCR legal debe preservar elementos estructurales que las herramientas de OCR general suelen perder: numeración Bates, marcas de privilegio, orden de lectura en varias columnas (escritos, estatutos), continuidad de cláusulas entre páginas y vocabulario legal especializado (términos en latín, formatos de citas legales). Además, la herramienta debe cumplir con los requisitos de seguridad de datos de la Regla Modelo 1.6(c) de la ABA: procesamiento cifrado, controles de acceso y claridad sobre si los documentos subidos se utilizan para entrenar los modelos de IA del proveedor.
¿La Regla Modelo 1.1 de la ABA exige que los despachos de abogados usen OCR?
El Comentario 8 de la Regla Modelo 1.1 de la ABA exige que los abogados "se mantengan al tanto de los cambios en la ley y su práctica, incluidos los beneficios y riesgos asociados con la tecnología relevante". Esto no exige específicamente la adopción de OCR, pero sí implica que un abogado que maneja áreas de práctica con muchos documentos no puede permanecer ajeno a la tecnología que afecta directamente la competencia, la eficiencia y la confidencialidad en el manejo de documentos. Treinta y ocho estados habían adoptado el comentario sobre competencia tecnológica según la encuesta más reciente de la ABA. Para un despacho que procesa documentos escaneados, seleccionar una herramienta de OCR que cumpla con los requisitos de confidencialidad (Regla 1.6) y que ofrezca resultados precisos y revisables es cada vez más esperado como parte de una práctica competente.
¿Cuál es la mejor opción de OCR gratuita para un despacho unipersonal?
Para un profesional independiente que necesita PDFs con búsqueda a partir de documentos escaneados, la prueba gratuita de Adobe Acrobat Pro es la opción más práctica durante la evaluación. Para uso gratuito continuo, Tesseract mediante una interfaz gráfica como OCRFeeder ofrece funcionalidad básica, pero requiere configuración técnica y ofrece menor precisión en diseños legales complejos. El nivel gratuito de ImageToTable.ai permite un número limitado de extracciones al mes y es la mejor opción si su necesidad son datos estructurados de contratos o formularios en lugar de PDFs con búsqueda. Consulte nuestra guía de los mejores software de OCR gratuitos para comparaciones detalladas de los niveles gratuitos en todas las categorías.
¿El software OCR puede procesar documentos de eDiscovery?
Las herramientas OCR generales pueden extraer texto de documentos de descubrimiento, pero el eDiscovery requiere más que extracción de texto: necesita una plataforma de revisión que organice, deduplique, busque, etiquete y produzca documentos con registros de privilegios y sellos Bates intactos. Plataformas como RelativityOne y Everlaw incluyen OCR como un componente de un flujo de trabajo completo de eDiscovery. Las herramientas OCR independientes (de escritorio o API) pueden alimentar texto a una plataforma de eDiscovery, pero no la reemplazan. Para descubrimientos a pequeña escala (menos de 10,000 documentos), algunos despachos usan Adobe Acrobat Pro para OCR y gestionan la revisión manualmente, pero con volúmenes significativos, una plataforma de eDiscovery especializada es más rentable y defendible.
¿El OCR extraerá con precisión cláusulas contractuales como derechos de rescisión y límites de indemnización?
El OCR tradicional —incluso los motores más precisos— extrae caracteres, no significado. Puede indicar que la cadena "indemnización" aparece en la página 7, pero no distingue entre una obligación de indemnizar y una limitación de indemnización, ni separa el monto tope del texto circundante. Para extracción a nivel de cláusulas, se necesita una herramienta especializada de análisis de contratos como Kira Systems (que tiene modelos ML entrenados para más de 1300 disposiciones legales) o una herramienta de extracción con IA que lea documentos semánticamente, no posicionalmente. La Extracción de Columnas Personalizadas de ImageToTable.ai, por ejemplo, permite definir una columna como "Tope de Indemnización": la IA lee el documento, encuentra la cláusula relevante, identifica el monto tope (o devuelve "No encontrado" si la cláusula está ausente) y lo coloca en la celda de la hoja de cálculo.
¿Es seguro el OCR en la nube para documentos legales confidenciales?
Depende de las prácticas de manejo de datos del proveedor, por lo que la Regla 1.6(c) del Código de Ética de la ABA exige que los abogados hagan "esfuerzos razonables" para evaluar la seguridad antes de subir documentos de clientes. Preguntas clave para cualquier proveedor de OCR antes de usarlo: ¿Los documentos están cifrados en tránsito y en reposo? ¿Los documentos subidos se usan para entrenar modelos (si es así, la herramienta no puede usarse con datos de clientes sin consentimiento informado)? ¿El servicio tiene certificación SOC 2 Tipo II? ¿Se pueden eliminar los documentos según su cronograma después del procesamiento? ¿Dónde se procesan los datos (la residencia de datos importa para el cumplimiento normativo)? Entre las herramientas de esta guía, plataformas empresariales como RelativityOne y servicios API en la nube de AWS, Google y Azure publican informes de cumplimiento detallados. ImageToTable.ai procesa archivos en memoria sin almacenamiento permanente y ofrece documentación sobre sus prácticas de manejo de datos.
¿Cuál es la diferencia entre el OCR tradicional y la extracción con IA para documentos legales?
El OCR tradicional convierte texto escaneado en caracteres legibles por máquina: convierte una página de píxeles en una página de letras, números y espacios. La extracción con IA va más allá: lee el documento como lo haría una persona, reconociendo que "§ 78j(b)" es una cita legal, que el número en el bloque de firma es un límite de indemnización, y que "CONFIDENCIAL" en el encabezado modifica el tratamiento de todo el documento. La distinción entre OCR y extracción con IA es importante para cada caso de uso legal porque el objetivo rara vez es "hacer que este texto sea buscable", sino "encontrar los puntos de datos específicos que necesito en un conjunto de documentos". Nuestra comparación detallada de extracción con IA vs. OCR explica las diferencias técnicas y prácticas con ejemplos concretos de documentos legales.
Cómo elegir lo que se adapta a su práctica
La relación de la profesión legal con el OCR siempre ha estado marcada por una tensión que los datos de la encuesta de ILTA hacen explícita: los despachos saben que la digitalización es necesaria —el 88% está mayormente o totalmente en la nube—, pero el 57% dice que la resistencia al cambio es la principal barrera para adoptar nueva tecnología, y el 54% menciona preocupaciones de seguridad. Esa tensión no se resuelve encontrando la herramienta de OCR "más precisa". Se resuelve haciendo coincidir la herramienta con el flujo de trabajo específico donde se utilizará, y luego verificando que las prácticas de seguridad de datos de la herramienta cumplan con las obligaciones del despacho según la Regla 1.6 de las Reglas Modelo de la ABA.
Para un despacho de litigios que procesa documentos de descubrimiento, la opción correcta es una plataforma de eDiscovery con OCR integrado (RelativityOne, Everlaw). Para una práctica transaccional que extrae datos de contratos en documentos de transacciones, la opción correcta es una herramienta que no requiera plantillas ni entrenamiento (ImageToTable.ai, Kira Systems, según el volumen y el presupuesto). Para un profesional independiente que necesita digitalizar documentos entrantes para búsqueda y almacenamiento, Adobe Acrobat Pro o ABBYY FineReader cubren lo básico de manera competente. Y para todo despacho, independientemente de su tamaño, el enfoque correcto incluye un paso de verificación: pruebe la herramienta con sus documentos reales —no con un conjunto de muestra del proveedor— antes de comprometerse a una suscripción o implementación.
El costo de elegir la herramienta de OCR equivocada no es solo la tarifa de suscripción. Es el tiempo dedicado a corregir manualmente la salida de la extracción. Es la cláusula omitida en un contrato que una herramienta basada en plantillas no encontró porque el diseño no le era familiar. Es la designación de privilegio que se perdió en una producción. Esos son costos que una tabla comparativa no puede predecir, por lo que cada herramienta en esta lista ofrece una prueba gratuita, un nivel gratuito o una demostración. Úselos.
El camino más corto hacia la herramienta de OCR adecuada para su despacho: pruebe con sus documentos, no con un set de demostración.
Aproveche los niveles gratuitos y los períodos de prueba. Suba un contrato real, una presentación judicial real y un documento de descubrimiento real a cada herramienta que esté considerando. Compare no solo la precisión de la salida de texto, sino si los datos salen en una forma que realmente pueda usar.