Beste OCR-Software für Rechtsdokumente 2026:
9 Tools für Verträge, Schriftsätze & eDiscovery im Vergleich
Die Technology Survey 2025 der International Legal Technology Association – mit 580 Anwaltskanzleien, über 152.000 Anwälten und rund 302.820 Nutzern insgesamt – ergab, dass mindestens 76 % der Kanzleien cloudbasierte Dokumentenmanagementsysteme eingeführt haben. Dieselbe Umfrage berichtete jedoch, dass 57 % der Rechtsorganisationen „Widerstand gegen Veränderungen" als größte Hürde bei der Einführung neuer Technologien nennen und 54 % Sicherheits- und Risikobedenken anführen. Diese Spannung – zwischen dem Wissen, dass die Digitalisierung unvermeidlich ist, und der Notwendigkeit, Tools zu wählen, die sowohl die ethischen Pflichten der ABA-Modellregeln als auch die praktischen Realitäten rechtlicher Dokumentenabläufe erfüllen – bildet den Kontext für jede Bewertung auf dieser Liste. Dieser Leitfaden wurde recherchiert, indem die veröffentlichten Dokumentationen, Compliance-Zertifizierungen und Preisseiten jedes Tools geprüft wurden, ergänzt durch die ABA-Modellregeln zu technologischer Kompetenz und Vertraulichkeit, veröffentlichte ILTA-Umfragedaten und Berichte aus erster Hand von Rechtsexperten auf r/LawFirm und r/legaltech. Jedes Tool hier wird anhand der spezifischen Anforderungen der Verarbeitung von Rechtsdokumenten bewertet: Extraktion von Vertragsklauseln über mehrseitige Vereinbarungen hinweg, Erhaltung der Bates-Nummerierung und Privileg-Kennzeichnungen, Handhabung mehrspaltiger Schriftsatzformate sowie die Datensicherheitspflichten gemäß ABA-Modellregeln 1.1 und 1.6. Offenlegung: ImageToTable.ai, ein modernes KI-Extraktionstool, ist in dieser Übersicht enthalten. Ich habe keine Verbindung zu einem anderen Tool auf dieser Liste. Alle Preise stammen von öffentlichen Anbieterseiten Stand Juni 2026, und jeder externe Link führt zur Produkt- oder Preisseite des Anbieters, damit Sie die Angaben unabhängig überprüfen können.
Wichtigste Erkenntnisse
- Ein OCR-Tool mit 99,7 % Genauigkeit kann Ihr Privilegienprotokoll dennoch zerstören, wenn es einen „VERTRAULICH"-Kopf als Fließtext und eine Bates-Nummer als Seitenverzierung behandelt.
- Ihre Vertragsprüfung scheitert nicht, wenn OCR ein Wort falsch liest, sondern wenn es „Freistellung" extrahiert, ohne zu wissen, ob es die Haftung begrenzt oder begründet.
- Die einzige Bewertung, die für Ihre Kanzlei zählt, ist, ob das Tool die sechs Strukturelemente erhält, die Rechtsdokumenten ihre rechtliche Bedeutung verleihen – beginnend mit Bates-Nummern, Privileg-Kennzeichnungen und klauselübergreifender Kontinuität über Seiten hinweg.
Was Rechts-OCR von generischer Dokumentenerfassung unterscheidet
Eine Anwaltskanzlei braucht kein OCR, das „zu 95 % genau bei Standarddokumenten“ ist. Sie braucht OCR, das einen 78-seitigen Fusionsvertrag mit verschachtelten Klauseln, Anlagen A bis F, handschriftlichen Randnotizen und einem Bates-Stempel in der unteren rechten Ecke jeder Seite korrekt liest – und die Daten dann in einer Form ausgibt, die den ethischen Verpflichtungen der Kanzlei gemäß den ABA-Modellregeln entspricht.
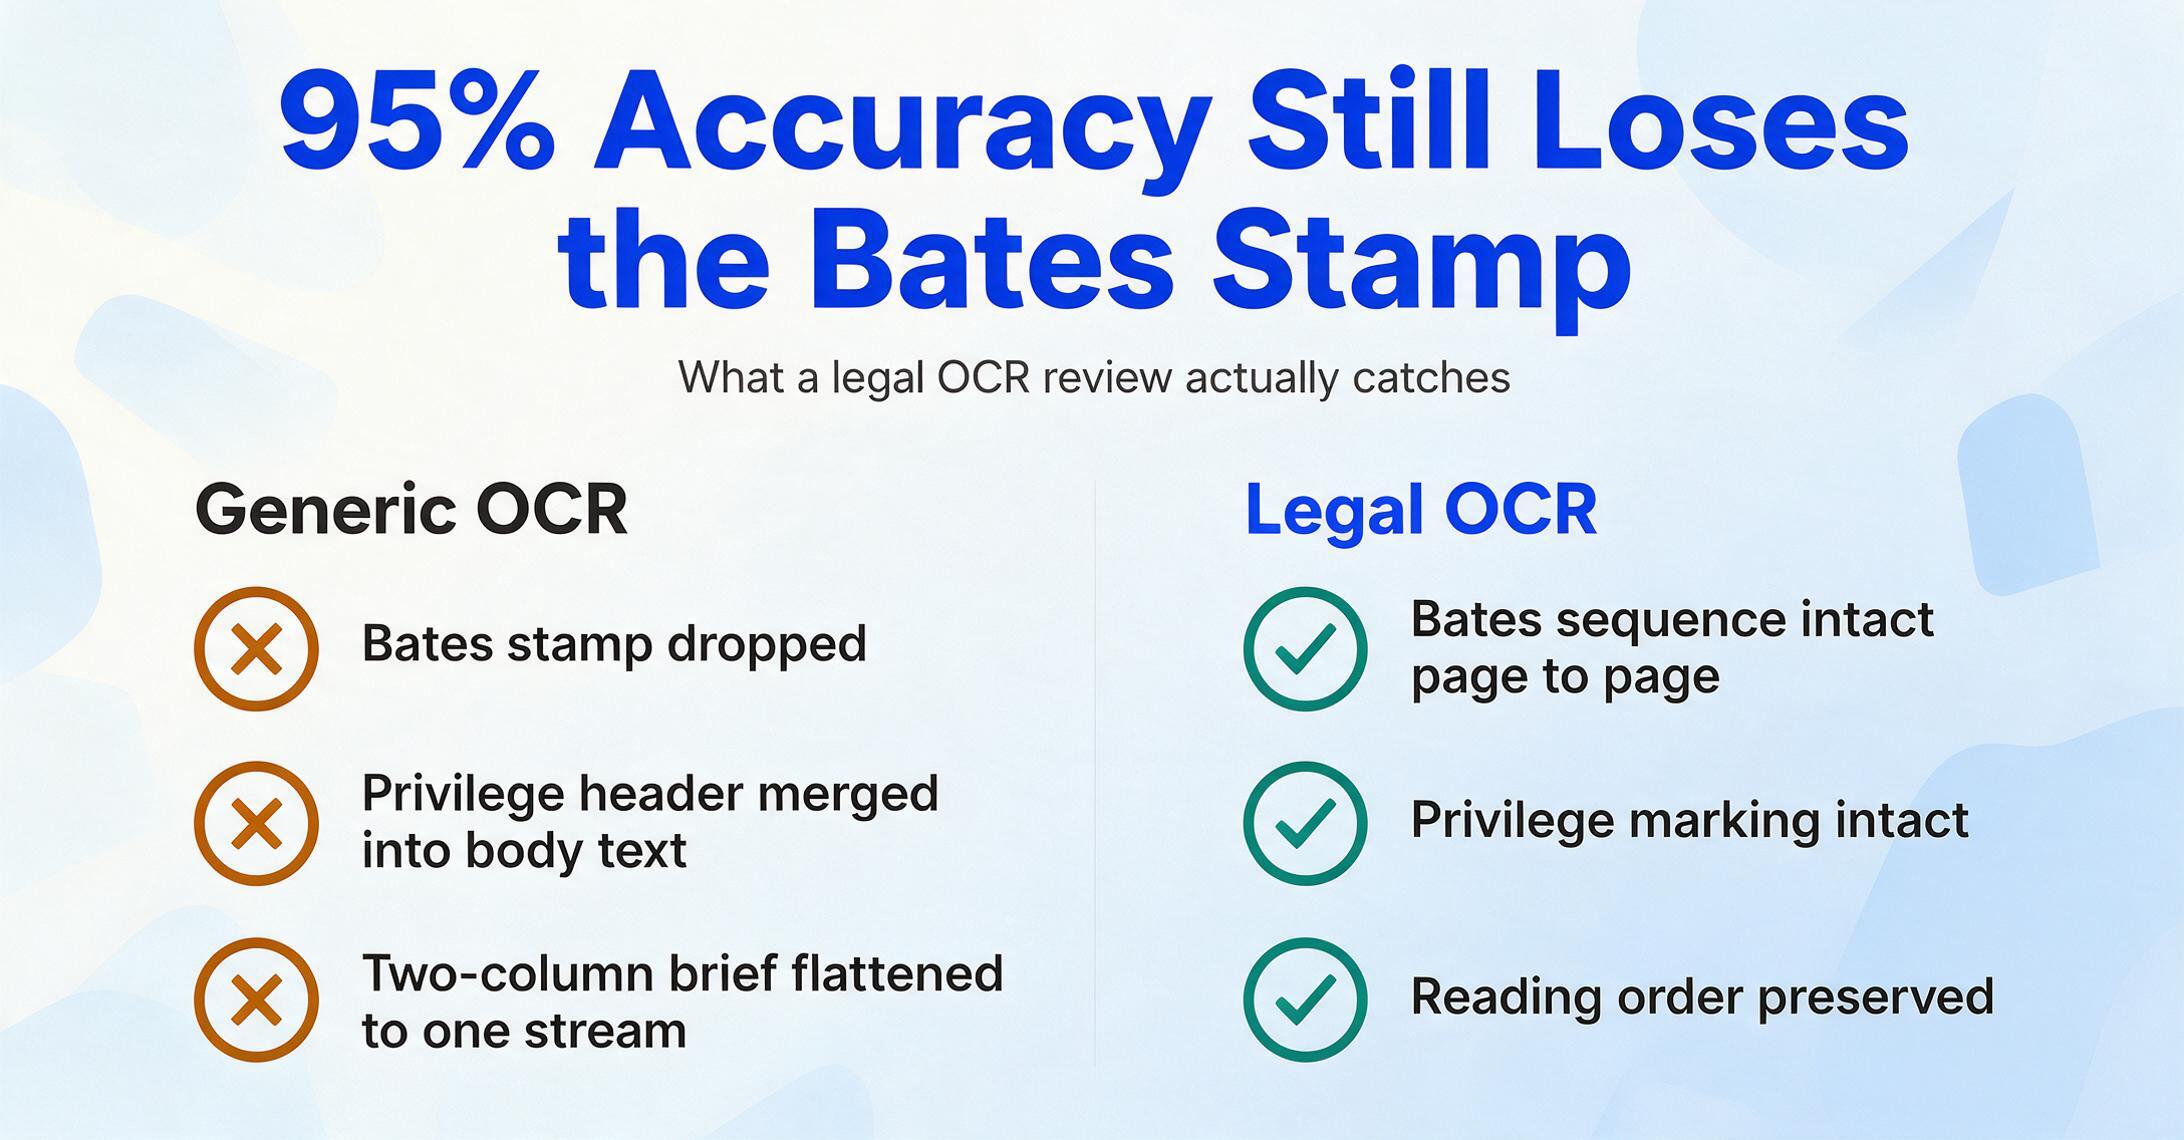
Der textbasierte Ansatz, den die meisten mit „OCR“ verbinden – Zeichen erkennen, Textdatei ausgeben –, bleibt in der Rechtspraxis aus strukturellen Gründen hinter den Anforderungen zurück, die keine noch so gute Genauigkeitsoptimierung behebt. Rechtsdokumente tragen Bedeutung in ihrem Layout: eine Klausel, die sich über einen Seitenumbruch erstreckt, eine Vertraulichkeitsvermerk in der Kopfzeile, ein Unterschriftsblock auf der letzten Anlagenseite. Wenn Standard-OCR mehrspaltige Schriftsätze zu einem einzigen Textstrom glättet oder eine Fußzeilenanmerkung in die letzte Zeile des Fließtexts einfügt, ist das Ergebnis nicht nur unordentlich – es kann beruflich schädlich sein.
Mehrere spezifische Anforderungen definieren Rechts-OCR als eigenen Anwendungsfall:
- Erhalt der Bates-Nummerierung – Die Dokumentenproduktion in Gerichtsverfahren hängt vom Bates-Stempel ab. OCR, das Seitennummern verwirft, zusammenführt oder falsch liest, unterbricht die Beweiskette.
- Kennzeichnungen zur Anwalt-Geheimhaltungspflicht – „PRIVILEGED AND CONFIDENTIAL“-Kopfzeilen, Schwärzungsbereiche und Kennzeichnungsetiketten müssen die Extraktion intakt überstehen. Ihr Verlust schafft ein Risiko des Verzichts auf den Schutz.
- Mehrspaltige Rechtsformatierung – Schriftsätze nach den Formatierungsregeln der Fed. R. Civ. P., Gesetze und Verordnungen verwenden häufig zweispaltige Layouts. OCR muss die Lesereihenfolge spaltenweise erhalten, nicht von links nach rechts über beide Spalten hinweg.
- Seitenübergreifende Klausel- und Tabellenverfolgung – Eine Beendigungsklausel in einem Gewerberaummietvertrag kann auf Seite 12 beginnen und auf Seite 14 enden. Ein Gebührenplan kann über eine Seitengrenze hinweg geteilt sein. Tools, die jede Seite als unabhängige Extraktionseinheit behandeln, übersehen die strukturelle Beziehung.
- Spezialisiertes Vokabular und Zitate – Lateinische Ausdrücke (res judicata, sua sponte), Rechtszitate (Fed. R. Civ. P. 12(b)(6), 15 U.S.C. § 78j(b)) und Parteinamen in unterschiedlichen Formaten sind Routine. OCR-Engines, die auf Standard-Lexika setzen, markieren diese als Fehler.
- Datensicherheit gemäß ABA-Modellregel 1.6(c) – Seit August 2012 verlangt ABA-Modellregel 1.6(c) von Anwälten, „angemessene Anstrengungen zu unternehmen, um die versehentliche oder unbefugte Offenlegung von oder den unbefugten Zugriff auf Informationen im Zusammenhang mit der Vertretung eines Mandanten zu verhindern.“ Jedes OCR-Tool, das Mandantendokumente verarbeitet, muss Datenverschlüsselung, Zugriffskontrollen und Klarheit darüber bieten, ob hochgeladene Dokumente für das Modelltraining verwendet werden.
Die unten aufgeführten Tools wurden anhand dieser sechs Dimensionen als Bewertungsrahmen ausgewählt und eingestuft. Für einen vollständigen Überblick über die Grundlagen der OCR-Technologie und wie sich traditionelle Zeichenerkennung von moderner KI-basierter Extraktion unterscheidet, lesen Sie unseren Leitfaden zu was OCR ist und wie es tatsächlich funktioniert.
Schnellvergleichstabelle: Legal-OCR-Tools auf einen Blick
| Tool | Startpreis | Am besten geeignet für | Stärke im Rechtsbereich | Wichtigste Einschränkung |
|---|---|---|---|---|
| ABBYY FineReader | 199 $ einmalig / ca. 16 $ mtl. | Desktop-OCR mit Layouttreue | Branchenführende Formatierungstreue; offline sicher | Nur Desktop; eingeschränkte API-Anbindung |
| Adobe Acrobat Pro | 22,99 $/Monat | Juristische PDF-Workflows & -Bearbeitung | Branchenstandard; Schwärzung, Vergleich, Bates-Stempel integriert | Keine strukturierte Datenextraktion über durchsuchbares PDF hinaus |
| Amazon Textract | ca. 1,50 $/1.000 Seiten | Skalierbare Cloud-OCR für eDiscovery | Formulare, Tabellen, Handschrift; abfragebasierte Feldextraktion | AWS-Kenntnisse nötig; Kosten steigen mit Volumen |
| Google Document AI | ca. 1,50 $/1.000 Seiten | Mehrsprachige & handschriftliche Belege | Breite Sprachabdeckung; Dokumentenklassifikation | Cloud-Abhängigkeit; technische Einrichtung erforderlich |
| Azure Document Intelligence | ca. 1,50 $/1.000 Seiten | Microsoft-zentrierte Kanzlei-Workflows | Vorgefertigte Vertragsmodelle; M365-Ökosystem-Integration | Bester Wert bei bestehender Azure/M365-Nutzung |
| Kira Systems | Individuelle Unternehmenspreise | Hochvolumige Vertragsanalyse & M&A Due Diligence | Speziell für Klausel-Extraktion und Playbook-Compliance entwickelt | Nur Verträge; teuer; Schulung für individuelle Klauseln nötig |
| RelativityOne | Individuelle Unternehmenspreise | eDiscovery-Verarbeitung & -Prüfung | Marktstandard für Dokumentenprüfung in Rechtsstreitigkeiten mit integrierter OCR | Überdimensioniert und zu teuer für Kanzleien ohne Prozessführung |
| ImageToTable.ai | Kostenlose Basisversion; kostenpflichtig ab 9 $/Monat | Vorlagenfreie Vertragsdaten-Extraktion | Semantische Extraktion; kein Training nötig; Stapelverarbeitung nach Excel | Neuere Lösung; kleineres Ökosystem als etablierte Anbieter |
| Tesseract | Kostenlos (Open Source) | Preisbewusste Kanzleien & Entwickler-Integrationen | Keine Kosten; individuelle Pipeline-Integration | Schwach bei komplexen Layouts; keine GUI; hoher Einrichtungsaufwand |
So haben wir ausgewählt und getestet
Die neun Tools in diesem Vergleich wurden ausgewählt, um das gesamte Spektrum der Legal-OCR-Anwendungsfälle abzudecken – nicht nur die beliebtesten Produkte. Die Auswahl umfasst vier Kategorien: Desktop-OCR (ABBYY, Adobe Acrobat Pro) für Kanzleien, die Offline-Verarbeitung und manuelle Qualitätskontrolle bevorzugen; Cloud-OCR-APIs (Amazon Textract, Google Document AI, Azure Document Intelligence) für Kanzleien, die automatisierte Dokumentenpipelines aufbauen; spezialisierte Legal-Plattformen (Kira Systems, RelativityOne) für dedizierte Anwendungsfälle wie Vertragsanalyse und eDiscovery; sowie moderne KI-Extraktion (ImageToTable.ai) und Open Source (Tesseract) für Kanzleien, die Alternativen zu traditionellen vorlagenbasierten Ansätzen benötigen.
Jedes Tool wurde anhand der sechs oben genannten rechtsspezifischen Kriterien bewertet – Bates-Erhaltung, Beibehaltung von Privilegien-Kennzeichnungen, mehrspaltige Verarbeitung, seitenübergreifende Verfolgung, Vokabular-Passung und ABA-Regel-1.6-Sicherheitsbereitschaft – zusätzlich zu Standardmetriken wie Preistransparenz, Einrichtungsaufwand und Integration in das Legal-Software-Ökosystem (Clio, NetDocuments, iManage, Relativity).
Wenn Sie mit dem grundlegenden Unterschied zwischen traditionellem OCR (das Zeichen liest) und moderner KI-Extraktion (die Dokumentinhalte versteht) nicht vertraut sind, bietet der Leitfaden zu was KI-OCR ist und wie es sich von traditionellem OCR unterscheidet die Grundlage, die Sie vor der Bewertung einzelner Tools benötigen.
1. ABBYY FineReader – Bestes Desktop-OCR für Layout-Erhaltung im Rechtswesen
ABBYY FineReader ist seit jeher der Desktop-OCR-Referenzstandard für Juristen, die Dokumente digitalisieren müssen, ohne die Formatierungstreue zu verlieren – und das aus gutem Grund. Seine OCR-Engine erzielt durchweg hohe Genauigkeit bei gescannten Rechtsdokumenten, und seine Layout-Erhaltungsfunktionen sorgen dafür, dass ein 40-seitiges Schriftsatzstück mit Fußnoten, eingebetteten Tabellen und mehrspaltigem Text am Ende wie das Original aussieht.
Wo es in der juristischen Arbeit glänzt: Die Archivdigitalisierung ist der primäre Anwendungsfall. Kanzleien, die Jahrzehnte alter Papierdokumente aus abgeschlossenen Akten in durchsuchbare PDFs umwandeln, benötigen ein Tool, das das ursprüngliche Seitenlayout erhält – nicht nur aus Gründen der Lesbarkeit, sondern weil die visuelle Struktur eines Dokuments beweiserhebliche Bedeutung haben kann. Die Dokumentvergleichsfunktion von ABBYY ist auch für die Vertragsredlining wirklich nützlich: Importieren Sie zwei Versionen eines Mietvertrags und das Tool hebt jede Änderung hervor, einschließlich Formatierungsänderungen, die ein reiner Textvergleich übersehen würde.
Am besten geeignet für: Kanzleien, die ein zuverlässiges Desktop-OCR-Tool für Batch-Digitalisierung, Dokumentvergleich und manuelle Qualitätskontrolle wünschen – insbesondere Einzelanwälte und kleine Kanzleien, die Dokumente intern verarbeiten und Offline-Sicherheit priorisieren.
Nicht ideal für: Kanzleien, die automatisierte Dokumentenpipelines mit API-basierter Extraktion aufbauen, Teams, die strukturierte Datenausgabe (Excel/CSV/JSON) statt durchsuchbarer PDFs benötigen, oder jede Praxis, die Vertragsdaten in großem Umfang verarbeitet – die Desktop-First-Architektur von ABBYY bedeutet, dass jedes Dokument von einem Menschen geöffnet, geprüft und exportiert werden muss.
2. Adobe Acrobat Pro — Der juristische Standard für PDF-Workflows
Adobe Acrobat Pro DC ist in erster Linie keine OCR-Software, sondern eine PDF-Management-Plattform, die auch OCR-Funktionen bietet. Da die juristische Branche auf PDF basiert – Gerichtsdokumente, Offenlegungsunterlagen, Vertragsausfertigungen – ist Acrobat Pro für viele juristische Workflows das praktische OCR-Werkzeug.
Stärken im juristischen Bereich: Die OCR-Engine von Acrobat Pro („Scans verbessern“) bewältigt die häufigste juristische OCR-Aufgabe – die Durchsuchbarmachung gescannter Dokumente – zuverlässig. Der eigentliche Wert liegt in den PDF-Management-Funktionen rund um die OCR: Schwärzungswerkzeuge zum dauerhaften Entfernen vertraulicher Texte, Bates-Stempelung für fortlaufende Nummerierungen über mehrseitige Dokumente, Passwortschutz und Berechtigungen, die die „angemessenen Bemühungen“ gemäß ABA Model Rule 1.6(c) erfüllen, sowie Dokumentenvergleich für die Vertragsversionskontrolle.
Ideal für: Jede Kanzlei, die ein zuverlässiges All-in-One-PDF-Tool für OCR, Schwärzung, Bates-Stempelung und Dokumentenprüfung benötigt – also die meisten Kanzleien. Acrobat Pro ist besonders stark in der Produktionsphase von Rechtsstreitigkeiten, in der Dokumente in einem einzigen Workflow mit OCR erfasst, nummeriert, geschwärzt und produziert werden müssen.
Weniger geeignet für: Strukturierte Datenextraktion. Acrobat Pro wandelt gescannte Dokumente in durchsuchbaren Text um – es extrahiert keine spezifischen Datenfelder (Vertragsdaten, Parteinamen, Klauseltexte) in eine Tabelle. Für Kanzleien, die strukturierte Daten aus Verträgen oder Formularen extrahieren müssen, reicht Acrobat allein nicht aus.
3. Amazon Textract — Skalierbare Cloud-OCR für eDiscovery und Dokumentenverarbeitung
Amazon Textract ist der verwaltete Dokumenten-OCR-Dienst von AWS und hat sich als gängiges Backend für juristische Dokumentenverarbeitungsplattformen etabliert, die große Mengen gescannter Dokumente verarbeiten müssen. Im Gegensatz zu Desktop-Tools funktioniert Textract als API – Sie senden ein Dokument und erhalten eine strukturierte JSON-Ausgabe – was es für automatisierte eDiscovery-Erfassungspipelines geeignet macht.
Stärken im juristischen Bereich: Die Fähigkeit von Textract, Text aus Formularen und Tabellen zu extrahieren, ist für die juristische Dokumentenverarbeitung in großem Maßstab äußerst nützlich. Die „Queries“-Funktion – bei der Sie in natürlicher Sprache nach bestimmten Feldern fragen können („Was ist das Datum des Inkrafttretens dieser Vereinbarung?“) – ist ein Schritt in Richtung der semantischen Extraktion, die juristische Workflows erfordern. Für eDiscovery-Teams, die AWS-Infrastruktur nutzen, lässt sich Textract nahtlos in eine Verarbeitungspipeline integrieren: Dokumente in S3 hochladen, Textract-Extraktion auslösen, die Ausgabe in eine Suchplattform indizieren.
Ideal für: Unternehmensrechtsabteilungen und eDiscovery-Anbieter, die bereits auf AWS arbeiten und große Mengen gemischter Dokumente – gescannte Offenlegungsunterlagen, archivierte Fallakten, Unternehmensunterlagen – als Teil einer automatisierten Verarbeitungspipeline mit OCR erfassen müssen.
Weniger geeignet für: Einzelanwälte oder kleine Kanzleien ohne technisches Personal. Textract erfordert API-Integration und AWS-Konfigurationskenntnisse. Es bietet zudem keine Oberfläche zur manuellen Überprüfung der Extraktionsergebnisse, sodass Fehler in komplexen juristischen Layouts – falsch gelesene Bates-Nummern, zusammengeführte Tabellenzellen – unentdeckt bleiben, sofern kein Mensch jede Ausgabe validiert.
4. Google Document AI — Starke Mehrsprachigkeit und Handschrifterkennung
Google Document AI konkurriert mit Textract bei der cloudbasierten Dokumentenverarbeitung, bietet aber eine stärkere Mehrsprachigkeit und legt den Schwerpunkt auf Dokumentenverständnis – Klassifizierung, Extraktion von Entitäten und Layoutanalyse – statt auf reine OCR.
Stärken in der juristischen Arbeit: Für Kanzleien, die mit Beweismitteln in mehreren Sprachen arbeiten – internationale Schiedsverfahren, grenzüberschreitende Rechtsstreitigkeiten, mehrsprachige Vertragssammlungen – ist die Sprachabdeckung von Document AI breiter als die von Textract. Die Handschrifterkennung ist zudem leistungsfähiger bei unstrukturierten, realen Dokumenten wie annotierten Entwürfen, handschriftlichen Randnotizen auf gedruckten Verträgen oder handschriftlich unterschriebenen eidesstattlichen Erklärungen. Die vorgefertigten Prozessoren des „Document AI Workbench" bieten Optionen für Verträge und Formulare, die den Einrichtungsaufwand im Vergleich zu einer generischen OCR-Pipeline reduzieren.
Am besten geeignet für: Juristische Teams, die mehrsprachige Beweismittel verarbeiten, Kanzleien mit gemischten gedruckten und handschriftlichen Dokumentenbeständen sowie Organisationen, die bereits auf Google Cloud arbeiten.
Weniger geeignet für: Kanzleien ohne Cloud-Engineering-Ressourcen. Document AI ist wie Textract ein API-first-Produkt. Die vorgefertigten Prozessoren reduzieren zwar einen Teil der Integrationsarbeit, aber Sie benötigen dennoch technisches Know-how, um die Pipeline zu konfigurieren, zu testen und zu warten. Die Kosten pro Seite werden bei eDiscovery-Volumina (Zehntausende oder Hunderttausende von Seiten) zudem zu einem erheblichen Kostenfaktor.
5. Azure Document Intelligence — Die beste Wahl für Microsoft-zentrierte Kanzleien
Azure Document Intelligence (ehemals Azure Form Recognizer) ist der Cloud-Dokumentenverarbeitungsdienst von Microsoft. Sein Hauptvorteil für juristische Zwecke liegt nicht in der technischen Überlegenheit gegenüber Textract oder Document AI, sondern in der Ökosystem-Integration. Die ILTA-Umfrage 2025 bestätigte, dass Microsoft Azure 79 % der Cloud-Server-Bereitstellungen in Kanzleien ausmacht. Wenn Ihre Kanzlei bereits mit Microsoft 365, SharePoint und Azure arbeitet, fügt sich Document Intelligence nahtlos in die bestehende Infrastruktur ein, anstatt eine neue Cloud-Plattform zu erfordern.
Stärken in der juristischen Arbeit: Document Intelligence enthält vorgefertigte Modelle für Verträge, die Parteien, Daten, Bedingungen und Klauseltexte extrahieren – ein nützlicher Ausgangspunkt für CLM-Integrationen (Contract Lifecycle Management). Die benutzerdefinierten Extraktionsmodelle können mit relativ wenigen Trainingsdokumenten auf bestimmte juristische Formulartypen (Aufnahmeformulare, Mandatsschreiben, gerichtliche Terminlisten) trainiert werden. Für Kanzleien, die bereits Microsoft Purview für eDiscovery nutzen, speist Document Intelligence extrahierten Text in dieselbe Compliance- und Suchinfrastruktur ein.
Am besten geeignet für: Kanzleien und Rechtsabteilungen von Unternehmen, die auf Microsoft Azure/M365 arbeiten und ihrem bestehenden Stack Dokumenten-OCR und Extraktionsfunktionen hinzufügen möchten, ohne eine zweite Cloud-Plattform zu adoptieren.
Weniger geeignet für: Kanzleien, die nicht auf Microsoft-Infrastruktur setzen – das Nutzenversprechen schwächt sich außerhalb des Azure-Ökosystems erheblich ab. Auch weniger geeignet für kleine Kanzleien, die nicht über das IT-Personal zur Verwaltung von Cloud-API-Diensten verfügen.
6. Kira Systems — Spezielle Vertragsanalyse für M&A und Due Diligence
Kira Systems ist kein allgemeines OCR-Tool. Es ist eine spezialisierte Plattform zur Vertragsanalyse, die hauptsächlich von großen Anwaltskanzleien und Rechtsabteilungen für M&A-Due-Diligence, Vertragsauszüge und Compliance-Prüfungen genutzt wird. Kira verwendet maschinelles Lernen, das auf Rechtsdokumenten trainiert wurde, um über 1.300 Klauseltypen und Datenpunkte zu identifizieren und zu extrahieren – darunter Change-of-Control-Klauseln, Abtretungsklauseln, Haftungsobergrenzen und Wettbewerbsverbote.
Wo es in der juristischen Arbeit glänzt: Kira ist ideal, wenn aus Hunderten oder Tausenden ähnlicher Verträge dieselben Datenpunkte extrahiert werden müssen. Eine Kanzlei, die innerhalb einer Woche 200 Zielunternehmensverträge im Rahmen einer M&A-Due-Diligence prüft, kann mit Kira jede „Governing-Law“-Klausel, jede „Material-Adverse-Change“-Klausel und jede Einschränkung zur „Abtretung ohne Zustimmung“ extrahieren – und die Ergebnisse als strukturierte Vergleichstabelle exportieren. Die abschließende Prüfung erfordert weiterhin das Urteil eines Anwalts, aber Kira übernimmt die Lese- und Sucharbeit, die sonst drei Associates für die Woche beschäftigen würde.
Am besten geeignet für: Große Anwaltskanzleien mit hohem Vertragsprüfungsaufkommen – M&A-Due-Diligence, Vertragsauszüge für Immobilienportfolios und Compliance-Prüfungen. Auch wertvoll für Rechtsabteilungen von Unternehmen mit großen Vertragsbeständen.
Weniger geeignet für: Kleine und mittelständische Kanzleien – die Preisgestaltung ist rein auf Unternehmen ausgerichtet und nicht öffentlich, beginnt aber typischerweise im fünfstelligen Bereich pro Jahr. Kira verarbeitet ausschließlich Verträge: Es bearbeitet keine Gerichtsdokumente, Discovery-Unterlagen, Formulare oder andere nicht-vertragliche Rechtsdokumente. Und im Gegensatz zu KI-Extraktionstools, die sofort einsatzbereit sind, erfordert Kira für kundenspezifische Klauseltypen über die integrierte Bibliothek hinaus ein Training.
7. RelativityOne — Der eDiscovery-Standard mit integrierter OCR
RelativityOne ist die am weitesten verbreitete eDiscovery-Plattform in Anwaltskanzleien, die Dokumente für Gerichtsverfahren und Ermittlungen verarbeitet und prüft. OCR-Funktionen sind Teil ihrer Dokumentenverarbeitungspipeline — jedes hochgeladene Dokument wird automatisch per OCR erfasst und durchsuchbar gemacht — und nicht als eigenständige Funktion.
Wo es in der juristischen Arbeit glänzt: Für Prozessarbeit löst RelativityOne das OCR-Problem, das andere Tools nicht angehen können: was nach der Textextraktion passiert. In der eDiscovery ist OCR nicht das Endziel — sie ist die Voraussetzung für Suche, Prüfung, Kennzeichnung und Produktion. RelativityOne übernimmt den gesamten Lebenszyklus: Dokumente erfassen (einschließlich gescannter PDFs und reiner Bild-TIFFs), OCR ausführen, Text indexieren, Stichwort- und Boolesche Suche über die gesamte Sammlung ermöglichen und responsive Dokumente mit Bates-Stempeln und Privilegienprotokollen intakt produzieren. Für Anwaltskanzleien, die ein beliebiges Volumen an Prozessentdeckung verwalten, ist dieser All-in-One-Workflow aus Verarbeitung und Prüfung wertvoller als die Genauigkeitsrate einer einzelnen OCR-Engine.
Am besten geeignet für: Prozessabteilungen und Anwaltskanzleien, die regelmäßig eDiscovery durchführen — von mittelgroßen Kanzleien mit speziellen Discovery-Praxisgruppen bis zu großen Kanzleien mit umfassenden Prozessunterstützungsteams.
Nicht ideal für: Kanzleien, die keine Prozessentdeckung durchführen — die Plattform ist übertrieben für transaktionale Dokumentenverarbeitung, Vertragsprüfung oder allgemeine Bürodigitalisierung. Die Preise beginnen auf Unternehmensebene (typischerweise 50.000 $+ pro Jahr), was sie für Einzelanwälte und kleine Kanzleien unerreichbar macht. Für eine alternative eDiscovery-Plattform, die für kleinere Teams entwickelt wurde, bietet Everlaw eine cloud-native eDiscovery-Plattform mit ähnlichen OCR-Erfassungsfunktionen zu niedrigeren Einstiegspreisen.
8. ImageToTable.ai — Vorlagenfreie Extraktion für Vertragsdaten
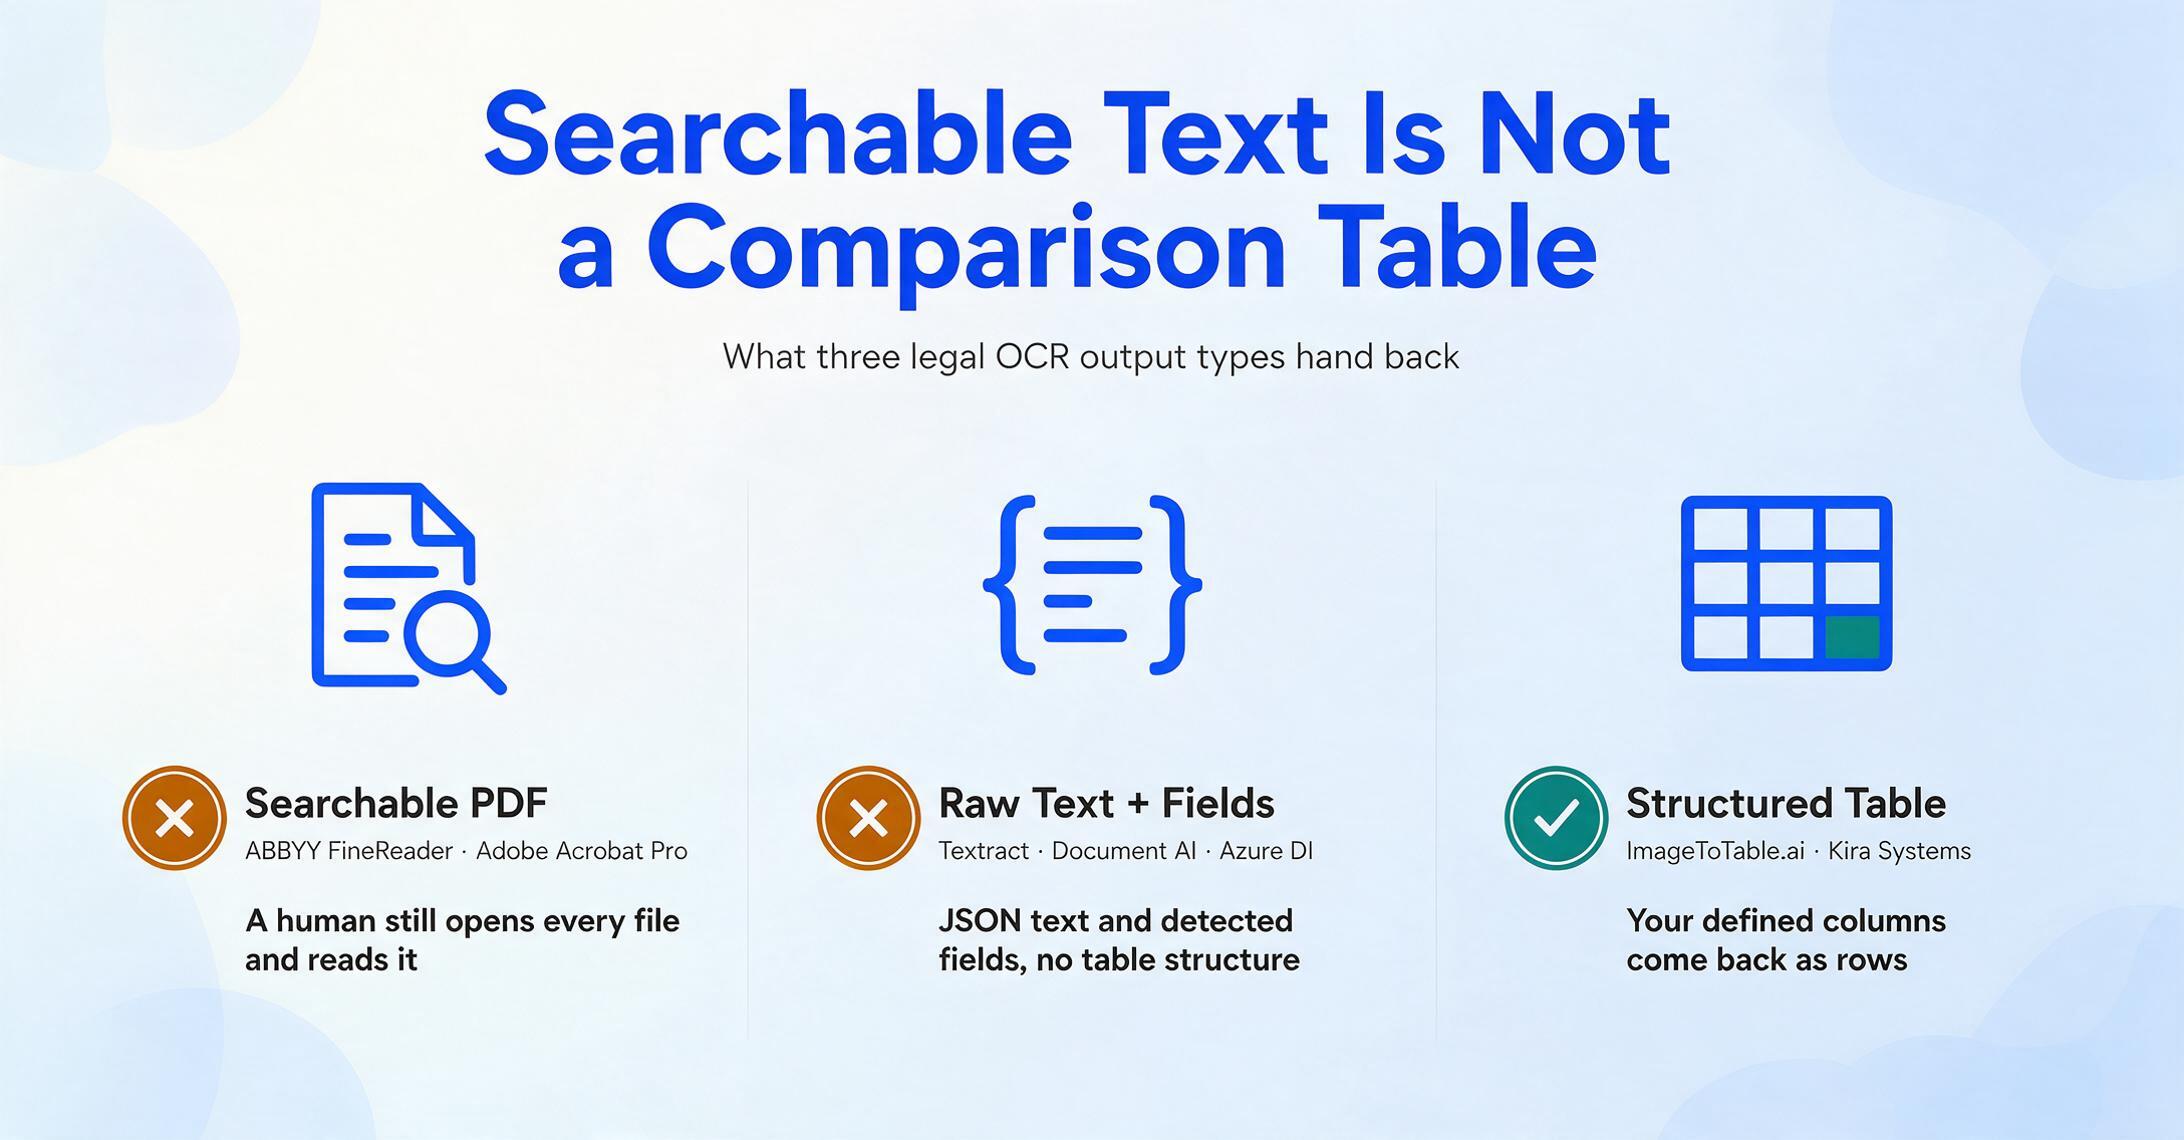
Die oben genannten Tools teilen weitgehend eine Grundannahme: dass die Struktur eines Dokuments vorhersehbar genug ist, um Regeln zu definieren oder Modelle dafür zu trainieren. ABBYY erhält das Layout, extrahiert aber keine strukturierten Daten. Kira extrahiert strukturierte Daten, erfordert jedoch ein Training und verarbeitet nur Verträge. Die Cloud-OCR-APIs (Textract, Document AI, Azure DI) liefern Rohtext und erkannte Formularfelder, organisieren die Daten aber nicht in der Tabellenstruktur, die die meisten Rechtsteams für ihre Analyse benötigen.
ImageToTable.ai geht das Problem anders an. Anstatt vom Dokumentlayout auszugehen (positionsbasierte Extraktion), geht es von der Benutzerausgabe aus – Sie definieren die gewünschten Spalten, und die KI findet die passenden Daten, indem sie versteht, was jedes Feld auf der Seite bedeutet. Dies wird als Benutzerdefinierte Spaltenextraktion bezeichnet und gehört zu einer Kategorie, die die Branche KI-Datenextraktion nennt – zu unterscheiden von traditionellem OCR (das Zeichen liest, sie aber nicht versteht) und Intelligent Document Processing (das Vorlagen und Training erfordert).
Wo es in der juristischen Arbeit glänzt: Der praktische Vorteil für Juristen ist die Formatunabhängigkeit. Ein Anwalt, der NDAs von fünf verschiedenen Gegenparteien prüft, wird auf fünf verschiedene Layouts stoßen – einige einseitig, einige siebenseitig, einige mit Anhängen, einige ohne. Ein vorlagenbasiertes Tool würde eine separate Konfiguration für das Format jeder Gegenpartei erfordern. ImageToTable.ai liest die Dokumente nach semantischem Inhalt, nicht nach Position. Definieren Sie einmal Spalten für „Parteiname", „Wirksamkeitsdatum", „Anwendbares Recht", „Vertraulichkeitsdauer" und „Umfang des Wettbewerbsverbots (Ja/Nein)", und die KI extrahiert diese Felder aus allen fünf Dokumenten, unabhängig davon, wo sie auf der Seite stehen. Die Ergebnisse werden in eine einzige Excel-Tabelle exportiert – eine Zeile pro Vertrag.
Das Tool unterstützt auch die Batch-First-Verarbeitung: Laden Sie einen gesamten Datensatz für die Due-Diligence-Prüfung hoch, definieren Sie Ihre Extraktionsspalten, und die KI verarbeitet den Batch als einen einzigen Vorgang mit zusammengeführter Ausgabe. Für eine Kanzlei, die 30 Verträge für einen Deal erhält, bedeutet das einen Upload, einen Extraktionslauf, eine Excel-Datei – nicht dreißig einzelne OCR-Vorgänge.
ImageToTable.ai verarbeitet PDF-, JPG-, PNG-, WebP- und AVIF-Eingaben. Es unterstützt bis zu 99 % Genauigkeit bei gedruckten Tabellendaten und verarbeitet eine einzelne Seite in 5–10 Sekunden – etwa 18× schneller als manuelle Dateneingabe. Das Google-Sheets-Add-on ermöglicht es Rechtsteams, Vertragsdaten direkt in eine Tabelle zu extrahieren, ohne ihre Dokumentenverwaltungsumgebung zu verlassen. Und die Sammellink-Funktion – ein teilbarer Upload-Link mit Verifizierungscode – ermöglicht es Kanzleien, Dokumente von Mandanten, gegnerischen Anwälten oder Dritten zu sammeln, ohne dass diese sich registrieren müssen.
Am besten geeignet für: Rechtsteams, die strukturierte Daten aus Verträgen, Vereinbarungen und Rechtsformularen in mehreren Dokumentformaten extrahieren müssen – insbesondere Kanzleien, die M&A-Due-Diligence, Vertragsportfolioanalysen oder die Verarbeitung eingehender Dokumente durchführen. Geeignet für Kanzleien jeder Größe dank des kostenlosen Tarifs und der transparenten Preisgestaltung.
Nicht ideal für: Litigation-eDiscovery-Workflows, die vollständige Review-Plattformfunktionen erfordern (RelativityOne deckt diesen Anwendungsfall ab). Kanzleien, die eine formatbewahrende PDF-Ausgabe statt strukturierter Tabellendaten benötigen. Teams mit sehr einfachen Anforderungen (ein durchsuchbares PDF eines einzelnen Vertrags) werden feststellen, dass die Funktionen des Tools ihre Anforderungen übertreffen.
Dateien werden sicher verarbeitet und nicht gespeichert. Versuchen Sie, wichtige Klauseln, Daten und Parteinamen aus einem Beispielvertrag zu extrahieren.
9. Tesseract — Kostenlose Open-Source-Option für entwicklergeführte Kanzleien
Tesseract ist die am weitesten verbreitete Open-Source-OCR-Engine, die seit 2006 von Google gepflegt wird. Sie ist kostenlos, unterstützt über 100 Sprachen und verfügt über eine aktive Entwickler-Community, die Wrapper und Tools (OCRFeeder, gImageReader) hervorgebracht hat, die eine grundlegende grafische Oberfläche bieten.
Wo es in der juristischen Arbeit glänzt: Für Kanzleien mit internen technischen Fähigkeiten bietet Tesseract etwas, das kein kommerzielles Tool bieten kann: Bereitstellung ohne Lizenzkosten bei jedem Volumen. Eine Kanzlei, die 50.000 Seiten archivierter Fallakten ohne Budget für Unternehmenssoftware per OCR verarbeiten muss, kann eine Tesseract-Pipeline auf einem einzelnen Server einrichten und die gesamte Sammlung allein zu den Kosten des Stroms verarbeiten. Kanzleien, die Dokumentenmanagementsysteme mit Unterstützung für benutzerdefinierte Integrationen verwenden, können Tesseract als lokales OCR-Backend für die Erfassung gescannter Dokumente hinzufügen.
Am besten geeignet für: Entwicklergeführte Rechtsteams, Kanzleien mit IT-Personal, das Kommandozeilentools verwalten kann, und kostenbewusste Organisationen, die null Lizenzkosten über Benutzerfreundlichkeit und Genauigkeit bei komplexen Layouts stellen.
Nicht ideal für: Nicht-technische juristische Fachkräfte — Tesseract hat keine professionelle GUI, kein Support-Team und keine SLA. Die Genauigkeit bei mehrspaltigen Rechtsdokumenten, Scans geringer Qualität und Dokumenten mit gemischten Schriftarten ist spürbar schlechter als bei kommerziellen Alternativen, was mehr manuelle Korrekturzeit bedeutet. Wie in unserem Vergleich der besten Open-Source-OCR-Tools erwähnt, bleibt Tesseract eine starke Wahl für Entwickler, die benutzerdefinierte Pipelines aufbauen, erfordert jedoch erheblichen technischen Aufwand für die Produktreife.
Welches OCR-Tool ist das richtige für Ihre Kanzlei?
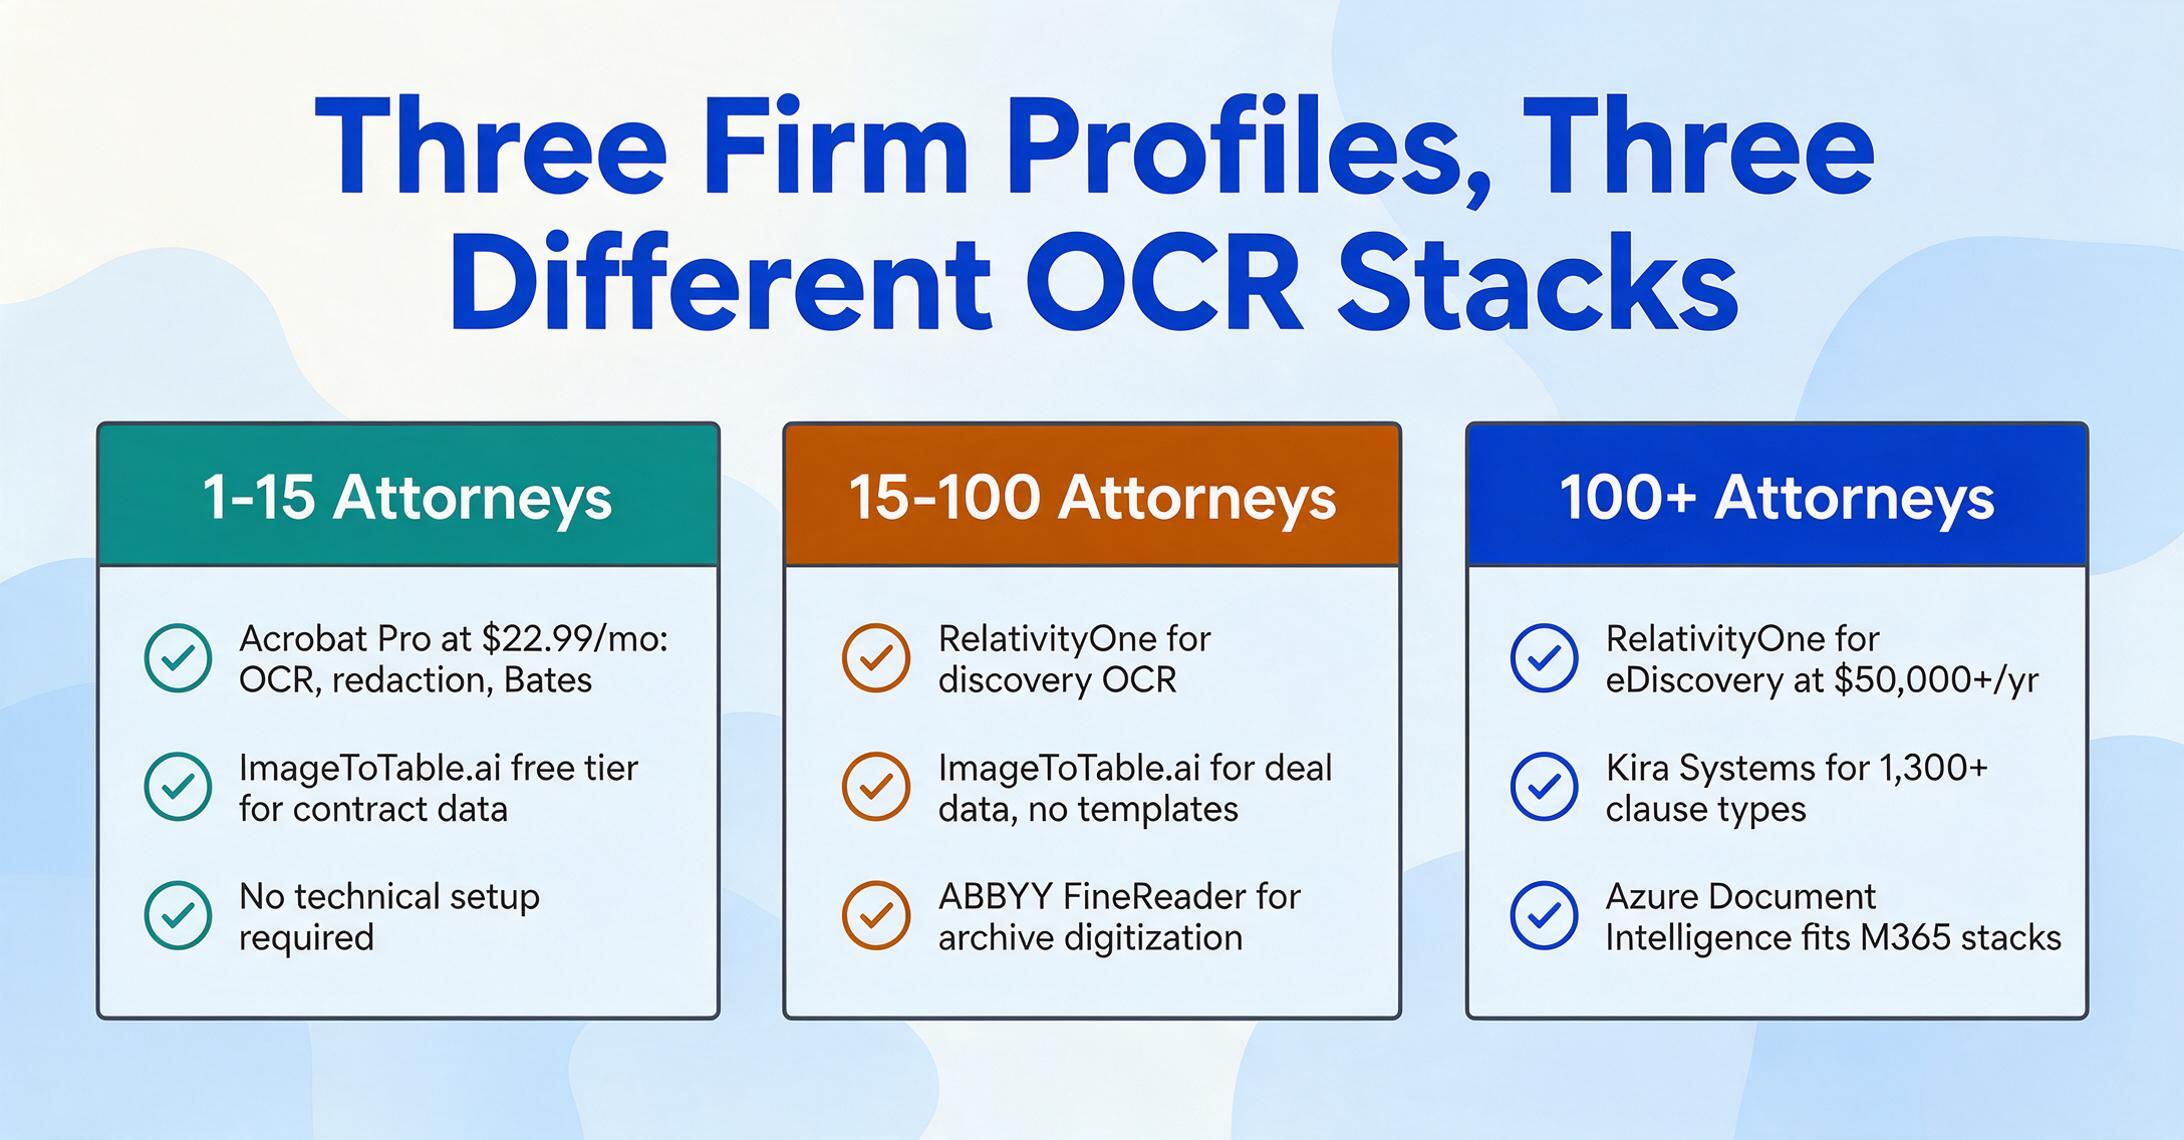
Es gibt kein einzelnes bestes juristisches OCR-Tool – die richtige Wahl hängt vom Tätigkeitsbereich Ihrer Kanzlei, dem Dokumentvolumen, der technischen Kapazität und dem primären Workflow ab. So lässt sich die Entscheidung nach Kanzleiprofil aufschlüsseln:
Einzelanwälte und kleine Kanzleien (1-15 Anwälte): Der häufigste juristische OCR-Bedarf dieser Gruppe besteht darin, gescannte Dokumente durchsuchbar zu machen und gelegentlich Daten aus Verträgen oder Gerichtsformularen zu extrahieren. Adobe Acrobat Pro für 22,99 $/Monat deckt PDF-Workflow, Schwärzung, Bates-Nummerierung und grundlegende durchsuchbare OCR in einem Tool ab. Für Kanzleien, die strukturierte Vertragsdaten extrahieren müssen – etwa Klauseltexte für Mietverhandlungen oder den Vergleich von Mandatsvertragsbedingungen – bietet der ImageToTable.ai-Kostenlostarif einen kostenlosen Einstiegspunkt. Beide Tools erfordern keine technische Einrichtung.
Mittelgroße Kanzleien (15-100 Anwälte): Diese Gruppe bearbeitet typischerweise eine Mischung aus Litigation-Discovery und Transaktionsarbeit. Für Litigation übernimmt RelativityOne (oder Everlaw zu günstigeren Einstiegspreisen) den gesamten eDiscovery-Lebenszyklus mit integrierter OCR. Für Vertragsarbeit in M&A, Immobilien oder Corporate-Praxis bietet ImageToTable.ai strukturierte Datenextraktion ohne den Schulungsaufwand von Enterprise-Vertragsanalysetools. Kanzleien, die eine zuverlässige Desktop-OCR-Lösung für Dokumentenvergleich und Archivdigitalisierung benötigen, sollten ABBYY FineReader ergänzen.
Große Kanzleien und Rechtsabteilungen von Unternehmen (100+ Anwälte): Diese Organisationen arbeiten typischerweise mit dedizierten IT- und Legal-Operations-Teams. Die optimale Konfiguration ist eine mehrstufige Strategie: RelativityOne oder Everlaw für die eDiscovery-Verarbeitung, Kira Systems für die Analyse großer Vertragsmengen in M&A- und Compliance-Arbeit sowie eine der Cloud-OCR-APIs (Azure Document Intelligence für Microsoft-zentrierte Kanzleien, Amazon Textract für AWS-native Kanzleien) für individuelle Dokumentverarbeitungspipelines. Desktop-Tools wie ABBYY FineReader und Adobe Acrobat Pro dienen als abteilungsweite Hilfsmittel für Dokumentenvergleich, Schwärzung und Ad-hoc-OCR.
Für Entwickler, die Legal Tech entwickeln: Wenn Sie eine Dokumentverarbeitungspipeline für eine juristische Anwendung aufbauen – interne Tools in einer Kanzlei oder ein Legal-Tech-Produkt – lautet die Ausgangsfrage, ob Sie Rohtext (nutzen Sie eine Cloud-OCR-API wie Textract oder Azure DI) oder strukturierte, feldebenen Daten benötigen (erwägen Sie einen KI-Extraktionsansatz). Tesseract ist als kostenlose lokale OCR-Engine für die Vorverarbeitung geeignet, und Docling (eine Open-Source-Bibliothek zur Dokumentkonvertierung) schließt die Lücke zwischen roher OCR-Ausgabe und LLM-fähigem Markdown oder JSON. Der allgemeine OCR-Software-Vergleichsleitfaden behandelt die entwicklerorientierten Tools detaillierter, einschließlich Bereitstellungsmodellen und API-Benchmarks.
Häufig gestellte Fragen
Was unterscheidet OCR-Software für Rechtsdokumente von allgemeiner OCR-Software?
Rechtsspezifische OCR muss Strukturelemente bewahren, die allgemeine OCR-Tools routinemäßig verlieren: Bates-Nummerierung, Privilegvermerke, mehrspaltige Lesereihenfolge (Schriftsätze, Gesetzestexte), seitenübergreifende Klauselkontinuität und spezielles juristisches Vokabular (lateinische Begriffe, juristische Zitierformate). Darüber hinaus muss das Tool die Datensicherheitsanforderungen der ABA-Modellregel 1.6(c) erfüllen — verschlüsselte Verarbeitung, Zugriffskontrollen und Klarheit darüber, ob hochgeladene Dokumente zum Training der KI-Modelle des Anbieters verwendet werden.
Verlangt die ABA-Modellregel 1.1 von Kanzleien den Einsatz von OCR?
Kommentar 8 zu ABA-Modellregel 1.1 verlangt von Anwälten, „mit den Änderungen im Recht und seiner Ausübung Schritt zu halten, einschließlich der Vorteile und Risiken relevanter Technologie". Dies schreibt die Einführung von OCR nicht ausdrücklich vor, bedeutet aber, dass ein Anwalt in dokumentenintensiven Praxisbereichen Technologie nicht ignorieren darf, die Kompetenz, Effizienz und Vertraulichkeit bei der Dokumentenverwaltung direkt beeinflusst. Achtunddreißig Bundesstaaten hatten den Technologiekompetenz-Kommentar zum Zeitpunkt der letzten ABA-Umfrage übernommen. Für eine Kanzlei, die gescannte Dokumente verarbeitet, wird die Auswahl eines OCR-Tools, das die Vertraulichkeitsanforderungen (Regel 1.6) erfüllt und genaue, überprüfbare Ergebnisse liefert, zunehmend als Teil kompetenter Praxis erwartet.
Was ist die beste kostenlose OCR-Option für eine Einzelkanzlei?
Für einen Einzelanwalt, der durchsuchbare PDFs aus gescannten Dokumenten benötigt, ist die kostenlose Testversion von Adobe Acrobat Pro während der Evaluierung die praktikabelste Option. Für die dauerhafte kostenlose Nutzung bietet Tesseract über eine GUI-Oberfläche wie OCRFeeder grundlegende Funktionen, erfordert jedoch technische Einrichtung und liefert bei komplexen juristischen Layouts geringere Genauigkeit. Die kostenlose Stufe von ImageToTable.ai erlaubt eine begrenzte Anzahl von Extraktionen pro Monat und ist die beste Option, wenn Sie strukturierte Daten aus Verträgen oder Formularen benötigen statt durchsuchbarer PDFs. Siehe unseren Leitfaden zur besten kostenlosen OCR-Software für detaillierte Vergleiche der kostenlosen Stufen in allen Kategorien.
Kann OCR-Software eDiscovery-Dokumente verarbeiten?
Allgemeine OCR-Tools können Text aus Discovery-Dokumenten extrahieren, aber eDiscovery erfordert mehr als Textextraktion – es braucht eine Plattform, die Dokumente organisiert, dedupliziert, durchsucht, taggt und mit Privilegienprotokollen und Bates-Stempeln ausgibt. Plattformen wie RelativityOne und Everlaw integrieren OCR als einen Bestandteil eines vollständigen eDiscovery-Workflows. Eigenständige OCR-Tools (Desktop oder API) können Text in eine eDiscovery-Plattform einspeisen, ersetzen diese aber nicht. Für kleine Discovery-Projekte (unter 10.000 Dokumenten) nutzen manche Kanzleien Adobe Acrobat Pro für OCR und verwalten die Prüfung manuell – aber ab einer nennenswerten Menge ist eine speziell entwickelte eDiscovery-Plattform kosteneffizienter und rechtssicherer.
Extrahiert OCR Vertragsklauseln wie Kündigungsrechte und Haftungsobergrenzen zuverlässig?
Herkömmliche OCR – selbst die genauesten Engines – extrahiert Zeichen, nicht Bedeutung. Sie kann feststellen, dass die Zeichenfolge "Freistellung" auf Seite 7 vorkommt, aber nicht zwischen einer Freistellungsverpflichtung und einer Freistellungsbeschränkung unterscheiden oder den Höchstbetrag vom umgebenden Text trennen. Für die Extraktion auf Klauselebene benötigen Sie entweder ein spezialisiertes Vertragsanalyse-Tool wie Kira Systems (mit trainierten ML-Modellen für über 1.300 Rechtsklauseln) oder ein KI-Extraktionstool, das Dokumente semantisch und nicht positionsbasiert liest. ImageToTable.ai's benutzerdefinierte Spaltenextraktion ermöglicht es Ihnen beispielsweise, eine Spalte wie "Haftungsobergrenze" zu definieren – die KI liest das Dokument, findet die relevante Klausel, identifiziert den gedeckelten Betrag (oder gibt "Nicht gefunden" zurück, wenn die Klausel fehlt) und trägt ihn in die Tabellenzelle ein.
Ist cloudbasierte OCR für vertrauliche Rechtsdokumente sicher?
Das hängt von den Datenverarbeitungspraktiken des Anbieters ab. Deshalb verlangt die ABA Model Rule 1.6(c) von Anwälten, vor dem Hochladen von Mandantendokumenten "angemessene Anstrengungen" zur Sicherheitsbewertung zu unternehmen. Schlüsselfragen an jeden OCR-Anbieter vor der Nutzung: Sind Dokumente während der Übertragung und im Ruhezustand verschlüsselt? Werden hochgeladene Dokumente für das Modelltraining verwendet (wenn ja, darf das Tool ohne informierte Einwilligung nicht mit Mandantendaten genutzt werden)? Ist der Dienst SOC 2 Typ II zertifiziert? Können Dokumente nach der Verarbeitung nach Ihrem Zeitplan gelöscht werden? Wo werden Daten verarbeitet (Datenresidenz ist für die Einhaltung von Vorschriften wichtig)? Unter den in diesem Leitfaden genannten Tools veröffentlichen Unternehmensplattformen wie RelativityOne und Cloud-API-Dienste von AWS, Google und Azure detaillierte Compliance-Berichte. ImageToTable.ai verarbeitet Dateien im Arbeitsspeicher ohne dauerhafte Speicherung und stellt Dokumentation zu seinen Datenverarbeitungspraktiken bereit.
Was ist der Unterschied zwischen herkömmlicher OCR und KI-Extraktion für Rechtsdokumente?
Herkömmliche OCR wandelt gescannten Text in maschinenlesbare Zeichen um – sie macht aus einer Seite voller Pixel eine Seite voller Buchstaben, Zahlen und Leerzeichen. KI-Extraktion geht weiter: Sie liest das Dokument so, wie es ein Mensch tun würde, erkennt, dass „§ 78j(b)“ eine Rechtszitierung ist, dass die Zahl im Unterschriftenblock eine Haftungsobergrenze ist und dass „VERTRAULICH“ in der Kopfzeile die Behandlung des gesamten Dokuments bestimmt. Der Unterschied zwischen OCR und KI-Extraktion ist für jeden rechtlichen Anwendungsfall wichtig, denn das Ziel ist selten „diesen Text durchsuchbar machen“ – sondern „die spezifischen Datenpunkte finden, die ich in einer Reihe von Dokumenten benötige“. Unser detaillierter Vergleich von OCR vs. KI-Extraktion erklärt die technischen und praktischen Unterschiede anhand konkreter Beispiele aus Rechtsdokumenten.
Die Wahl treffen, die zu Ihrer Kanzlei passt
Die Beziehung der Anwaltschaft zur OCR war schon immer von einer Spannung geprägt, die die ILTA-Umfragedaten deutlich machen: Anwaltskanzleien wissen, dass die Digitalisierung notwendig ist – 88 % sind größtenteils oder vollständig in der Cloud –, doch 57 % geben an, dass Veränderungsresistenz das größte Hindernis bei der Einführung neuer Technologien ist, und 54 % nennen Sicherheitsbedenken. Diese Spannung wird nicht gelöst, indem man das „genaueste“ OCR-Tool findet. Sie wird gelöst, indem man das Tool an den spezifischen Workflow anpasst, in dem es eingesetzt werden soll, und dann verifiziert, dass die Datensicherheitspraktiken des Tools den Verpflichtungen der Kanzlei gemäß ABA-Modellregel 1.6 entsprechen.
Für eine Prozesskanzlei, die Discovery-Dokumente verarbeitet, ist die richtige Wahl eine eDiscovery-Plattform mit integrierter OCR (RelativityOne, Everlaw). Für eine Transaktionskanzlei, die Vertragsdaten aus Transaktionsdokumenten extrahiert, ist die richtige Wahl ein Tool, das keine Vorlagen oder Schulungen erfordert (ImageToTable.ai, Kira Systems – je nach Volumen und Budget). Für einen Einzelanwalt, der eingehende Dokumente für Suche und Archivierung digitalisieren muss, decken Adobe Acrobat Pro oder ABBYY FineReader die Grundlagen kompetent ab. Und für jede Kanzlei, unabhängig von der Größe, gehört zur richtigen Vorgehensweise ein Verifizierungsschritt: Testen Sie das Tool mit Ihren tatsächlichen Dokumenten – nicht mit einer Beispielsammlung des Anbieters – bevor Sie sich für ein Abonnement oder eine Bereitstellung entscheiden.
Die Kosten für die Wahl des falschen OCR-Tools sind nicht nur die Abonnementgebühr. Es ist die Zeit, die für die manuelle Korrektur der Extraktionsergebnisse aufgewendet wird. Es ist die übersehene Klausel in einem Vertrag, die ein vorlagenbasiertes Tool nicht gefunden hat, weil das Layout ungewohnt war. Es ist die Vertraulichkeitskennzeichnung, die bei einer Produktion verloren ging. Das sind Kosten, die eine Vergleichstabelle nicht vorhersagen kann – weshalb jedes Tool auf dieser Liste entweder eine kostenlose Testversion, einen kostenlosen Tarif oder eine Demo anbietet. Nutzen Sie sie.
Der kürzeste Weg zum richtigen OCR-Tool für Ihre Kanzlei: Testen Sie mit Ihren Dokumenten, nicht mit einer Demo-Sammlung.
Nutzen Sie kostenlose Tarife und Testzeiträume. Laden Sie einen echten Vertrag, eine echte Gerichtseinreichung und ein echtes Discovery-Dokument in jedes Tool hoch, das Sie in Betracht ziehen. Vergleichen Sie nicht nur die Genauigkeit der Textausgabe, sondern auch, ob die Daten in einer Form herauskommen, die Sie tatsächlich verwenden können.